Amazon Web Services ブログ
Amazon S3 Tables で Apache Hive テーブルから Apache Iceberg へのマネージドな移行が可能に
本記事は 2026 年 11 月 4 日 に公開された「Amazon S3 Tables now offer managed migration of Apache Hive tables to Apache Iceberg」を翻訳したものです。
本日から、データレイクのモダナイゼーションをシンプルかつ低コストで進められるよう、Amazon S3 Tables で Apache Hive テーブルから Apache Iceberg へのマネージド移行が利用できるようになりました。対象となるのは、AWS Glue Data Catalog に登録された Amazon S3 上の Parquet テーブルです。パイプラインの構築やコンピューティングのプロビジョニングをせずに、本番ワークロードを動かしたままデータレイクをアップグレードできます。
Apache Iceberg は、大規模な分析データセットのオープンスタンダードになりました。スキーマ進化、hidden partitioning、タイムトラベルクエリなどの機能でペタバイト規模のテーブルを管理でき、データはオープンな形式のまま、Iceberg 互換の任意のエンジンからクエリできます。Amazon S3 Tables は、Iceberg テーブルが大きくなってもパフォーマンスとコスト効率を保てるように設計されたフルマネージドのストレージです。自動メンテナンス、最適化、レプリケーション、S3 Intelligent-Tiering などの機能を標準で備えています。
新機能の概要
これまで Apache Hive テーブルを Apache Iceberg に移行するには、必要なインフラの構築と管理に数週間のエンジニアリング作業がかかることもありました。データ型の変換やロールバックの仕組みづくりも運用を複雑にしていました。今回、移行を API で操作できるマネージドな処理として利用できるようになりました。
S3 Tables は、データ検証、互換性チェック、型変換、ファイルの再圧縮、コンパクションを含む移行ワークフロー全体を処理します。データをコピーする前に、S3 Tables は対象となるソースオブジェクトをすべて洗い出し、互換性レポートを生成します。同期は必要な回数だけ実行でき、ソーステーブルへの書き込みを止める必要があるのは切り替え時の数分間だけです。準備が整ったら移行を完了でき、テーブルがオフラインになる時間を最小限に抑えられます。
S3 Tables のマネージド移行は、自前で移行する方法と比べてコストを抑えられます。料金はコピーしたデータ分のみで、Hive から Iceberg への変換自体には料金がかからず、S3 Intelligent-Tiering 上のソースオブジェクトは現在のアクセス階層に留まるためです。
移行を試してみる
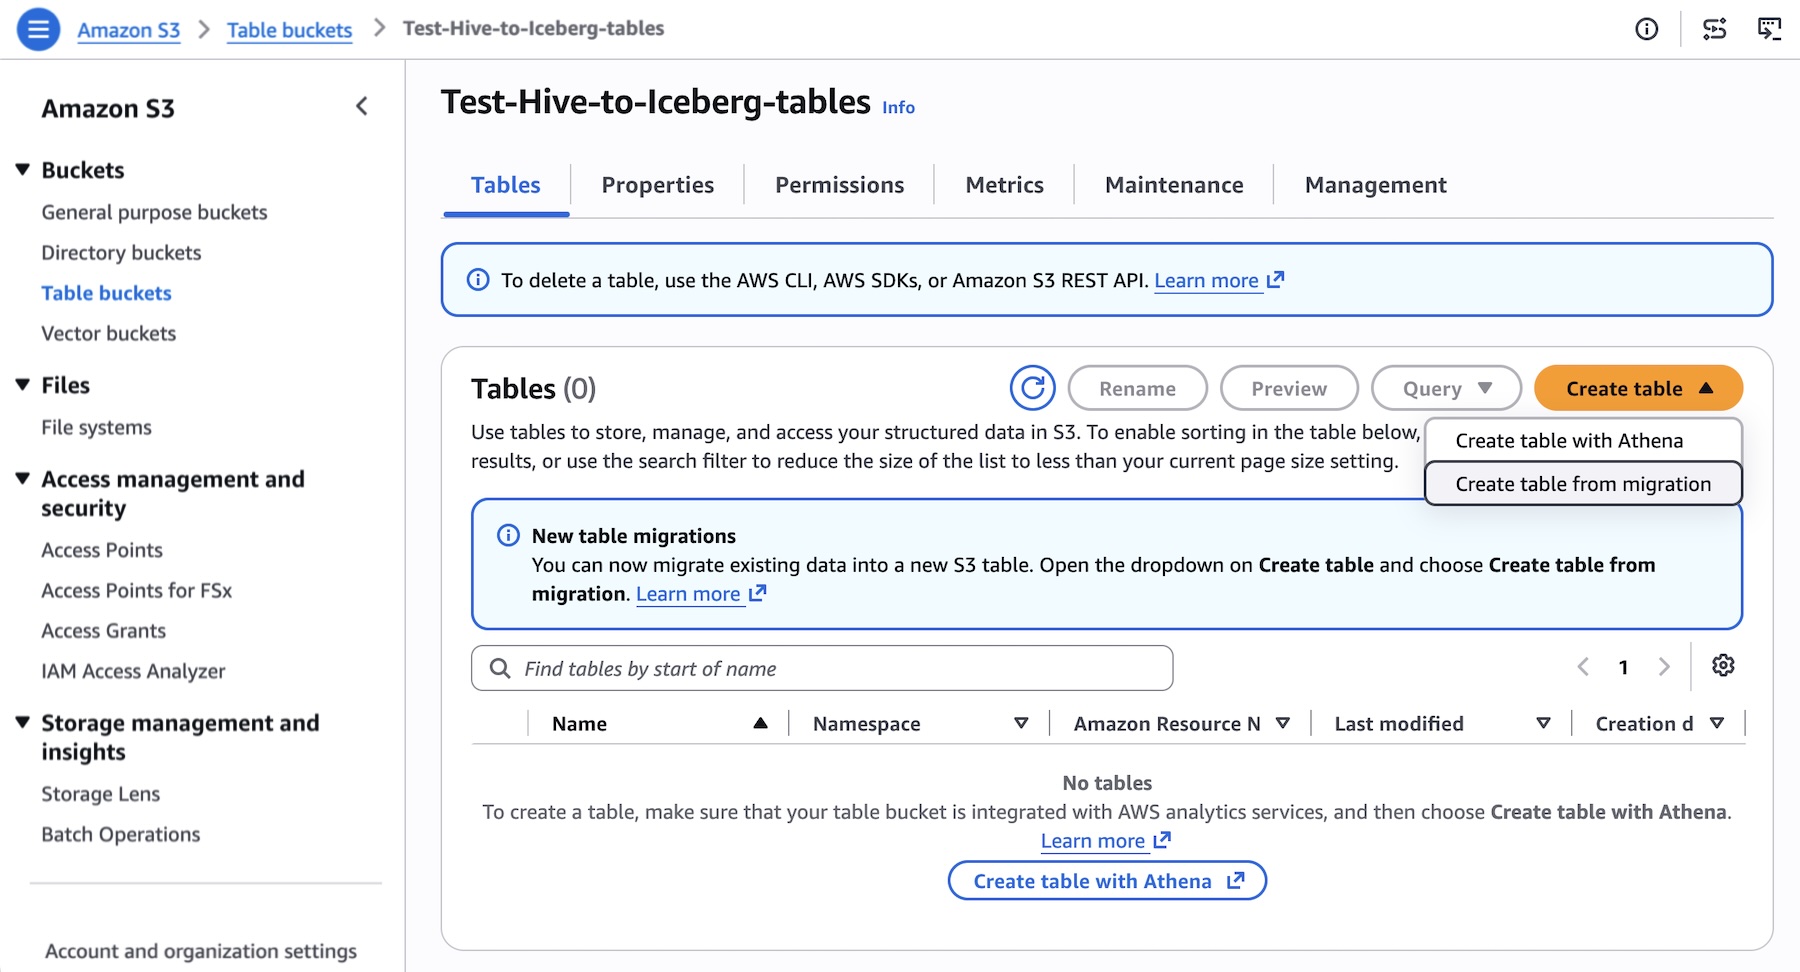
AWS Glue の Hive テーブルを移行するには、S3 コンソールで移行先のテーブルバケットを選び、Create table from migration を選択します。
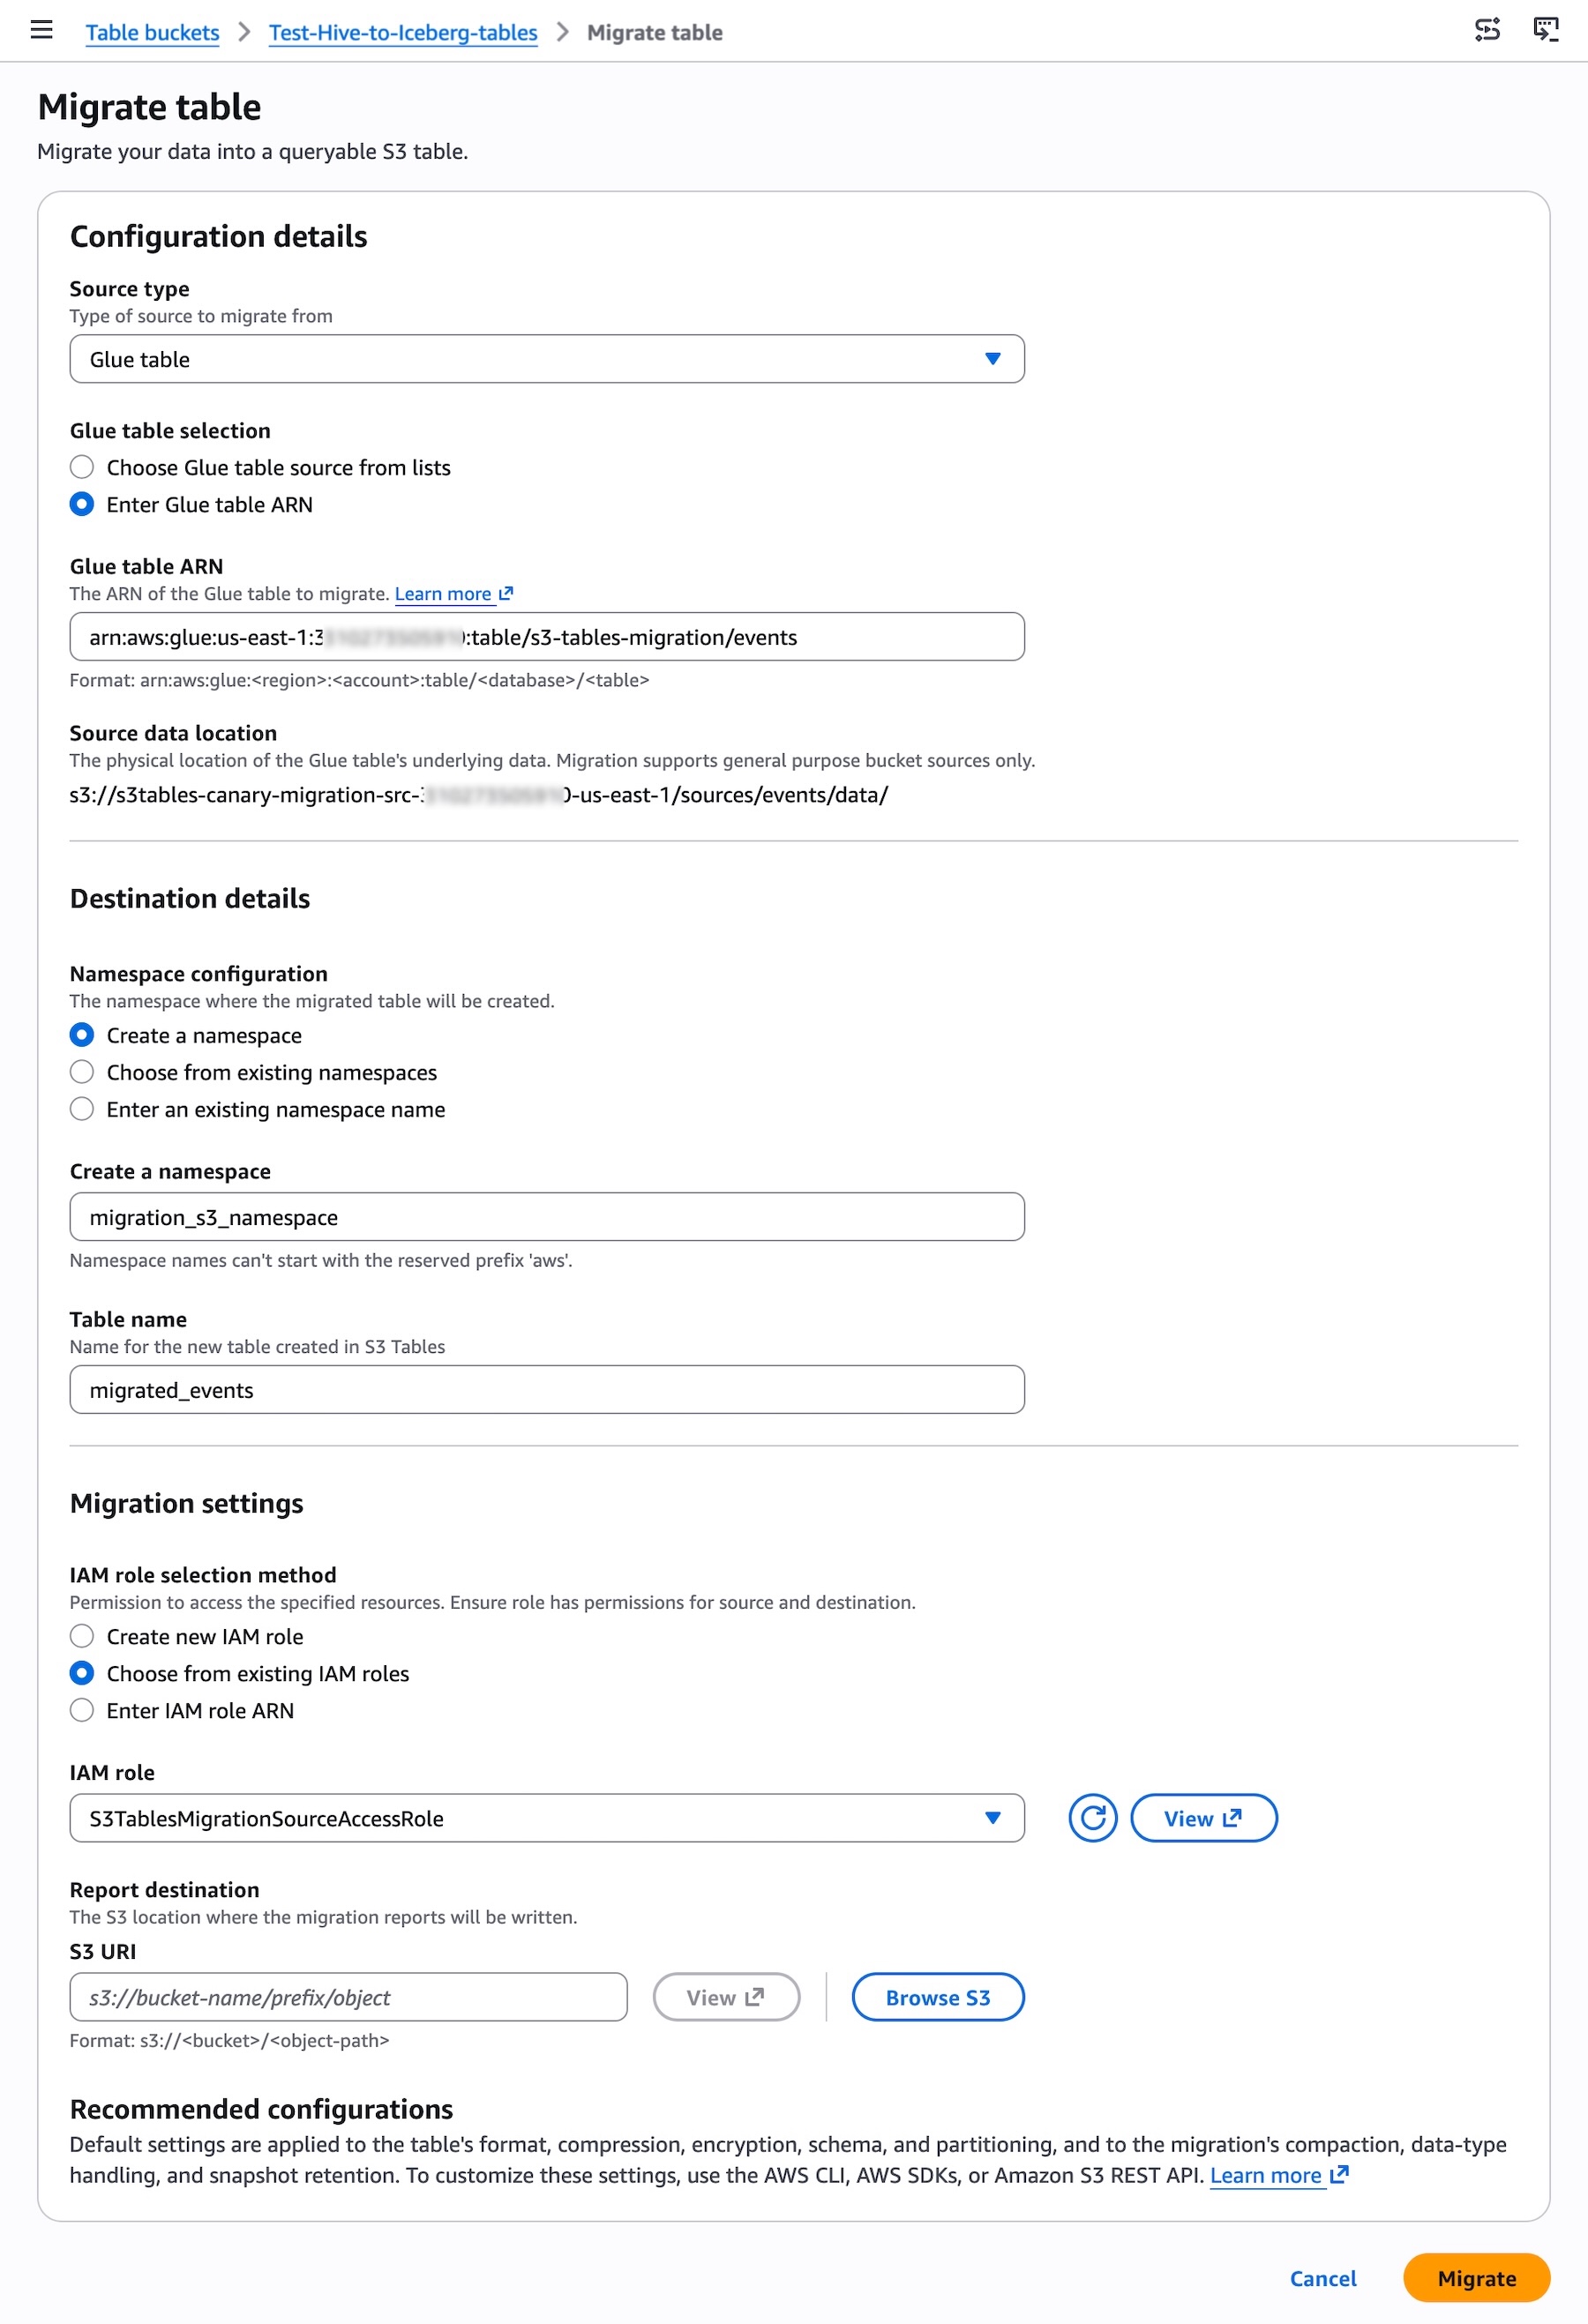
移行先の Iceberg テーブルの名前空間とテーブル名を指定します。移行先テーブルは、クエリパフォーマンスとストレージ効率に合わせて調整された推奨のデフォルト設定で作成されます。
移行を開始すると、S3 Tables はソーステーブルを検証して互換性レポートを生成し、データのコピーを始めます。移行中、移行先テーブルは読み取り専用です。移行を完了すると、移行先テーブルは読み書き可能になります。
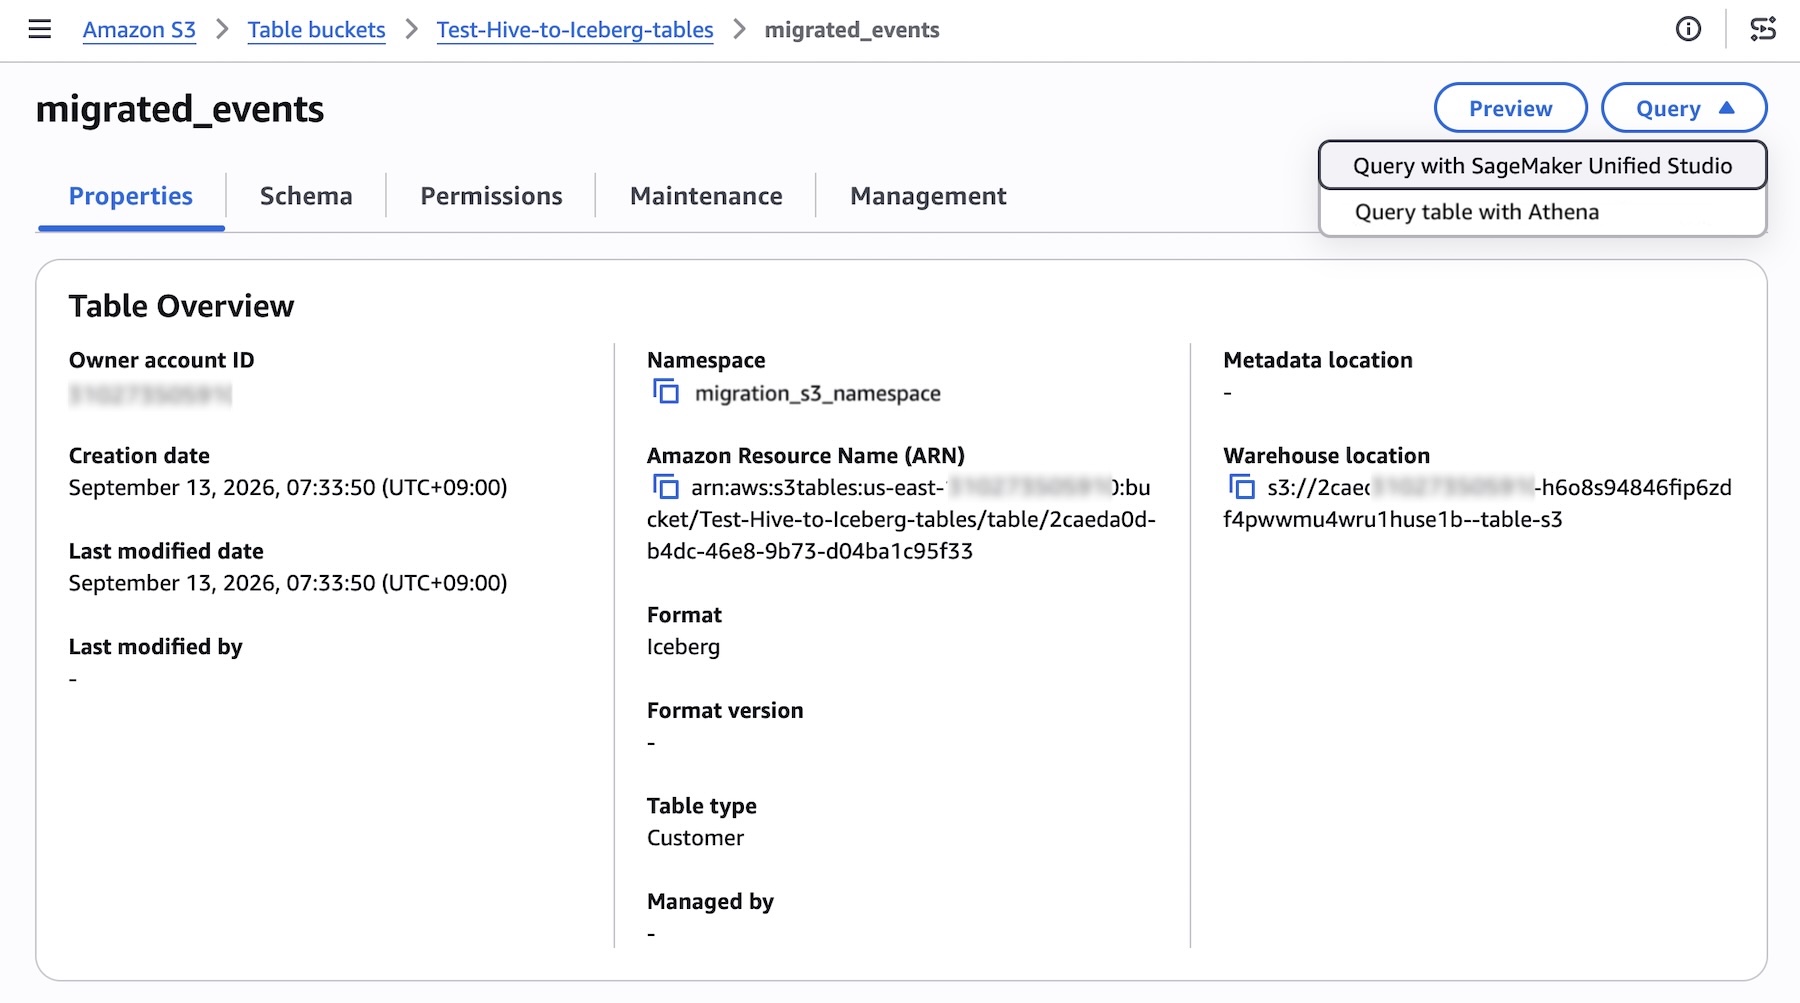
AWS コンソールから Amazon Athena や Amazon SageMaker Unified Studio との直接統合を使ってすぐにデータを扱えるほか、Apache Iceberg REST API 互換の任意のツールからテーブルを直接クエリすることもできます。詳しくは S3 Tables の移行に関するドキュメントをご覧ください。
AWS Command Line Interface (AWS CLI)、AWS SDK、Agent Toolkit for AWS も利用できます。たとえば、移行ジョブを設定して start-table-migration コマンドを呼び出します。
cat > /tmp/start-migration.json <<'EOF'
{
  "roleARN": "arn:aws:iam::123456789012:role/S3TablesMigrationRole",
  "destinationTable": {
    "tableBucketARN": "arn:aws:s3tables:us-east-1:123456789012:bucket/my-destination-bucket",
    "namespace": "mynamespace",
    "name": "my_destination_table",
    "encryptionConfiguration": {
      "sseAlgorithm": "aws:kms",
      "kmsKeyArn": "arn:aws:kms:us-east-1:123456789012:key/1234abcd-12ab-34cd-56ef-1234567890ab"
    },
    "storageClassConfiguration": { "storageClass": "INTELLIGENT_TIERING" },
    "tags": { "team": "s3tables", "purpose": "migration" },
    "properties": {
      "writeFormat": "parquet",
      "icebergFormatVersion": 2,
      "compressionCodec": "zstd",
      "dictionaryEncoding": true
    },
    "schema": {
      "type": "struct",
      "schemaId": 0,
      "identifierFieldIds": [1],
      "fields": [
        { "id": 1, "name": "id",      "type": "long",   "required": true, "doc": "primary key" },
        { "id": 2, "name": "payload", "type": "string", "required": false }
      ]
    },
    "icebergSortOrder": {
      "orderId": 1,
      "fields": [ { "sourceId": 1, "transform": "identity", "direction": "asc", "nullOrder": "nulls-first" } ]
    }
  },
  "sourceType": "glueTable",
  "source": {
    "glueTable": {
      "catalogId": "123456789012",
      "databaseName": "my_glue_database",
      "tableName": "my_source_table"
    }
  },
  "dataMigration": {
    "maintenanceSettings": {
      "icebergCompaction": { "targetFileSizeMB": 512, "strategy": "binpack" },
      "icebergSnapshotManagement": { "minSnapshotsToKeep": 3, "maxSnapshotAgeHours": 168 }
    },
    "migrationPolicies": {
      "unmatchedSourceFieldsPolicy": "fail",
      "incompatibleValuesPolicy": "fail"
    }
  },
  "reviewMigrationPlan": false,
  "migrationOutput": {
    "bucket": "arn:aws:s3:::my-report-bucket",
    "prefixes": {
      "tableCompatibilityReport": "reports/table-compatibility/",
      "objectCompatibilityReport": "reports/object-compatibility/",
      "objectMigrationReport": "reports/object-migration/"
    }
  }
}
EOF

aws s3tables start-table-migration \
  --cli-input-json file:///tmp/start-migration.json
ソース側の変更を移行先テーブルに反映するには、移行を完了する前に sync-table-migration を必要な回数だけ呼び出します。同期のたびにコピーされるのは変更分だけです。
Kiro などのコーディングエージェントを使っている場合は、Agent Toolkit for AWS の migrating-hive-tables-to-s3-tables スキルが、エージェント向けの安全ガードレール付きで移行を段階的にガイドします。このスキルでは次のことができます。
- 既存の IAM ポリシーを分析し、移行先で同等になるポリシーを提案する
- 開始前に移行計画を検証する
- Start → Sync → Complete の API 呼び出しを実行する
- ジョブの進行状況を監視し、検証と切り替えをガイドする
詳しくは、スキルの GitHub README ページをご覧ください。
提供開始
Amazon S3 Tables のマネージド移行は、本日から米国東部 (バージニア北部、オハイオ)、米国西部 (オレゴン)、アジアパシフィック (ムンバイ、シンガポール、シドニー、東京)、欧州 (フランクフルト、アイルランド、ストックホルム) リージョンで利用できます。提供開始時点では、同一の AWS アカウントかつ同一の AWS リージョン内にある、AWS Glue に登録された Parquet 形式の Hive テーブルに対応しています。新機能について API の呼び出し、ドキュメントの検索、リージョンごとの提供状況の確認、トラブルシューティングをしたい場合は、お好みの AI ツールで AWS MCP Server とプラグインをお試しください。
ぜひ Amazon S3 コンソールでお試しいただき、AWS re:Post for Amazon S3 または普段ご利用の AWS サポート窓口からフィードバックをお寄せください。
— Channy
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Sotaro Hikita がレビューしました。