Amazon Web Services ブログ
Category: Storage
【開催報告】ランサムウェアに備える「防御」「復旧」「説明責任」— AI エージェント時代に見直す対策と次の一歩
2026 年 10 月 26 日に開催したセキュリティセミナーの開催報告です。「防御・検知」「説明責任」「復旧」の 3 つの軸で、AWS とパートナー 5 社のセッション内容と、軸ごとにまず着手したい対策をまとめました。

Rivian が Amazon Bedrock 上の AI エージェントで財務オペレーションを加速した方法
Rivian は Amazon Bedrock AgentCore 上に構築した ERP AI エージェントで発注(PO)の会計計上を自動化し、月次決算の手作業をサイクルあたり 15 日超削減しました。SOP をナレッジベースに保存し、Strands Agent が MCP サーバー経由で SAP S/4HANA と連携、Amazon DynamoDB・AWS Lambda・Amazon SES を活用してヒューマン・イン・ザ・ループで会計計上を実行します。R2 ローンチに伴う発注急増にもスケールし、精度・コンプライアンス・決算早期化を実現した事例を紹介します。
Amazon S3 Tables で Apache Hive テーブルから Apache Iceberg へのマネージドな移行が可能に
Amazon S3 Tables で、AWS Glue Data Catalog に登録された Parquet 形式の Apache Hive テーブルを Apache Iceberg へマネージドに移行できるようになりました。パイプラインの構築やコンピューティングのプロビジョニングは不要で、本番ワークロードを動かしたまま移行でき、料金はコピーしたデータ分のみです。
AWS Weekly Roundup: GPT-6.1 Terra on Bedrock、エージェントツールとしての Step Functions など (2026 年 11 月 2 日)
2026 年 10 月 26 日週、特に印象に残ったエージェント関連の発表は、モデルの性能そのものとはまったく […]
Amazon EVS と FSx for ONTAP における Oracle Database のデプロイステップ
この記事では、NFS データストアストレージとして Amazon FSx for NetApp ONTAP を使用して、Amazon Elastic VMware Service (Amazon EVS) 上に Oracle Database をデプロイするためのステップバイステップの手順を紹介します。ストレージボリュームのプロビジョニング、NFS データストアのマウント、Oracle のインストール、そしてクロスリージョンディザスタリカバリのための SnapMirror レプリケーションの設定を行います。
VMware 上で Oracle データベースを稼働させている企業は、再設計や再教育を行うことなく既存の運用ワークフローを維持できる AWS への移行パスを求めています。関連記事「Amazon EVS と FSx for ONTAP 上で高可用性の Oracle Database を設計する」では、Amazon Elastic Compute Cloud (Amazon EC2) ベアメタルインスタンスの選択、VM のサイジング、vSAN と FSx for ONTAP 間でのストレージの分割、クロスリージョン DR のための SnapMirror レプリケーションの計画など、環境を設計する方法を説明しました。
この記事は、アーキテクチャ編の続きです。Oracle VM のプロビジョニングと FSx for ONTAP ボリュームの作成から、NFS データストアのマウント、Oracle 19c のインストール、SnapMirror と SnapCenter の設定まで、スタック全体をデプロイするためのステップバイステップの手順を紹介します。また、既存のオンプレミス Oracle ワークロードを Amazon EVS に移行するための 4 つの移行パスと、スナップショットバックアップ、ポイントインタイムリカバリ、データベースクローニングを含む Day 2 運用についても説明します。
AWS Weekly Roundup: Amazon Polly の Generative エンジン、Trainium 向け TorchNeuron など (2026 年 10 月 26 日)
数週間前、サンパウロにある AWS オフィスで、ブラジルの農業関連ビジネスに携わるビジネス部門と技術部門のリー […]
Amazon Bedrock AgentCore を使用した電力・公益事業向けのインテリジェントなアラーム管理
北米の大手電力会社が Amazon Bedrock AgentCore 上で運用しているマルチエージェント AI アーキテクチャを紹介します。このアーキテクチャにより、オペレーターがシフトごとに何十回も、複数のシステムをまたいで手作業で行っていた調査が不要になり、アラームのトリアージにかかる時間が数時間から数分に短縮されています。業界の課題、マルチエージェントの設計、GitHub 上のリファレンス実装について説明します。
Amazon OpenSearch intelligent ingestion で Amazon S3 のデータから RAG 対応インデックスを構築する
契約書、製品マニュアル、調査レポートなど、企業の価値ある知識は Amazon S3 に保存されたドキュメントに蓄積されています。本記事では、Amazon OpenSearch Serverless (NextGen) の新機能である Amazon OpenSearch intelligent ingestion を使い、こうしたドキュメントの解析、画像の説明生成、チャンク分割、ベクトル埋め込みの生成、インデックス化までを、取り込みパイプラインを運用せずに実行する方法を紹介します。
AWS ウィークリーラウンドアップ: AWS Lambda Web Functions、Vercel Marketplace の Amazon S3 など (2026 年 10 月 19 日)
2026 年 10 月 13 日週に起きたことは、新しい種類のコンピュートを追加したわけではありません。代わり […]
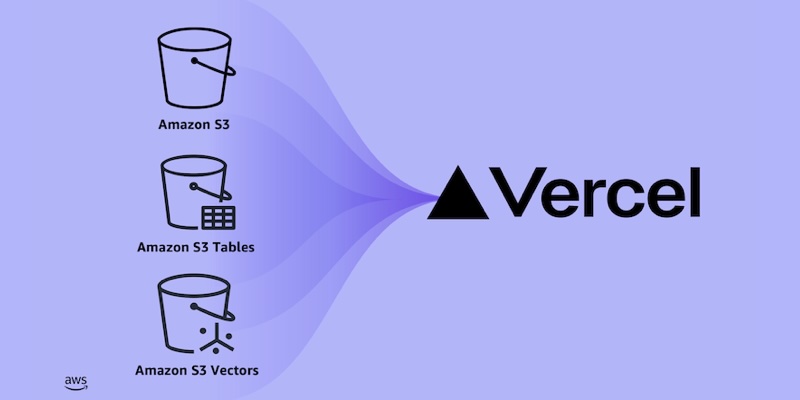
Amazon S3 が Vercel Marketplace と v0 by Vercel で入手可能になりました
Vercel でウェブおよび AI アプリケーションを構築している開発者は、Vercel Marketplac […]