Amazon Web Services ブログ
一度作れば、どこでも使える – Amazon Redshift の Iceberg マテリアライズドビューの紹介
本記事は 2026 年 10 月 5 日 に公開された「Materialize once, query anywhere: Introducing Iceberg materialized views in Amazon Redshift」を翻訳したものです。
Amazon Redshift は Apache Iceberg との統合を段階的に深めてきました。今年初めには、AWS Graviton を搭載した Amazon Redshift RG を発表しました。RG にはデータレイク向けにゼロから設計・統合されたベクトル化クエリエンジンが搭載されています。スキャンを別のフリートに送信するのではなく、ベクトル化された Parquet スキャン、スマートプリフェッチ I/O サブシステム、パーティションおよびファイルレベルのプルーニング、改良されたブルームフィルター、JIT Analyze による Iceberg 統計の自動収集を活用し、クラスター上でネイティブにスキャンを実行します。これらを組み合わせることで、RA3 と比較して Apache Iceberg クエリが最大 2.4 倍高速化され、vCPU あたりのコストは 30% 低く、データレイククエリにテラバイト単位のスキャン課金も発生しません。このパフォーマンス基盤の上で、INSERT、CTAS、UPDATE、DELETE、MERGE による完全な ACID 準拠の Iceberg テーブルへの直接書き込みも可能です。アクセス制御は、外部スキーマの IAM ロールを通じた AWS Identity and Access Management (IAM) 権限、またはエンジン横断できめ細かな制御を行う AWS Lake Formation で管理できます。
Amazon Redshift は Iceberg マテリアライズドビューの作成と更新にも対応しました。マテリアライズドビュー (MV) は、コストの高い結合や集計を一度だけ事前計算し、その結果を Amazon Simple Storage Service (Amazon S3) または Amazon S3 Table Buckets 上の標準的な Apache Iceberg テーブルとして、AWS Glue Data Catalog に登録した状態で格納します。おなじみの SQL (CREATE MATERIALIZED VIEW ... USING ICEBERG) で作成でき、Amazon Athena、Amazon EMR 上の Apache Spark、AWS Glue をはじめとする Iceberg 互換エンジンからすぐにクエリできます。Amazon Redshift はインクリメンタルリフレッシュで MV を最新に保ち、結果は AWS Glue Data Catalog 上の通常の Iceberg テーブルであるため、他のカタログテーブルと同様にガバナンスや検出が可能です。
あるチームが Amazon Redshift で分析を行っているケースを考えてみましょう。変換処理はすでに Amazon Redshift SQL で書かれており、メンバーは Amazon Redshift に精通し、クエリエンジンへの投資も行っています。足りないのは、コストの高い事前計算済みの結果を、組織内の他のエンジン (Spark を使うデータサイエンスチームや Athena を使うアドホックレポーティングチームなど) と共有する手段です。データのエクスポートや別の変換スタックの構築なしにはそれができません。すでに運用しているエンジンから相互運用性と高速化を両立させたい、というのがこのチームの課題です。
Iceberg マテリアライズドビューを使えば、普段書いている SQL で Amazon Redshift 上に MV を作成するだけで、事前計算された結果がオープンな Iceberg テーブルとして格納されます。Spark や Athena のチームは、コピーや別パイプラインを管理せずに同じ結果を直接読み取れます。新しいデータが到着すると、インクリメンタルリフレッシュが変更分のみを再計算します。最もコストの高いクエリに対する単一の信頼できるデータソースを、すべてのエンジンで共有できるようになります。Amazon Redshift チームは 1 つのエンジンでエンドツーエンドの変換パイプラインを実行し、MV を生データ、クレンジング済みデータ、サービングレイヤー間のビルディングブロックとして活用できます。複数のエンジンをステージごとにつなぎ合わせる必要はありません。
オープンか高速かの二択ではありません。レイテンシーに敏感なダッシュボード向けには、Iceberg マテリアライズドビューを Amazon Redshift Managed Storage (RMS) にロードし、ネイティブな RMS マテリアライズドビューとして利用できます。
Iceberg MV と Amazon Redshift (RMS) マテリアライズドビューの使い分け
Iceberg マテリアライズドビューは Amazon Redshift の標準的なマテリアライズドビューを置き換えるものではなく、異なるニーズに対応します。Amazon Redshift マテリアライズドビューは結果を Amazon Redshift Managed Storage (RMS) に格納し、Amazon Redshift からの高速な読み取りに最適化されています。一方、Iceberg マテリアライズドビューは結果をオープンな Iceberg テーブルとして Amazon S3 に格納し、任意のエンジンから読み取れます。結果をどこでどのように使うかに応じて選択してください。
Amazon Redshift (RMS) マテリアライズドビューを使う場面:
- クエリを Amazon Redshift からのみ実行する場合。
- 最も低い読み取りレイテンシーが必要な場合。インタラクティブなダッシュボードやサブ秒のルックアップでは、RMS からの読み取りは Amazon S3 上の Iceberg テーブルからの読み取りよりも大幅に高速です。
- Amazon Redshift のみのワークロードで最もシンプルな選択肢を求める場合。
Iceberg マテリアライズドビューを使う場面:
- 事前計算した結果を Amazon Redshift 以外のエンジン (Athena、Spark、Amazon SageMaker AI、サードパーティエンジン) からデータのコピーなしに読み取りたい場合。
- 相互運用性のために Apache Iceberg を標準化しており、高速化を Amazon Redshift 専用のストレージ形式に依存させたくない場合。
- エンドツーエンドのパイプラインを 1 つのエンジンで実行し、すべての下流コンシューマーが同じオープンな結果を共有する構成にしたい場合。
両者は補完関係にあります。一般的なパターンとして、まずオープン性とエンジン横断アクセスのために Iceberg マテリアライズドビューでデータを構築・変換し、最もパフォーマンスが求められる結果だけを RMS マテリアライズドビューにロードしてインタラクティブなダッシュボードに使います。データはデフォルトでオープン、必要なところだけ高速にする構成です。
本記事では、以下の内容を扱います。
- Iceberg マテリアライズドビューの意義と主なユースケース
- インクリメンタルリフレッシュとエンジン横断アクセスの仕組み
- 前提条件の設定 (IAM、Amazon S3、AWS Glue)
- 最初の Iceberg マテリアライズドビューの作成
- Amazon Athena と PyIceberg からのエンジン横断アクセスの検証
このソリューションでは以下の AWS サービスを使用します。
- Amazon Redshift (Serverless またはプロビジョニングされた RG)
- AWS Glue Data Catalog
- Amazon S3 (汎用バケットまたは Amazon S3 Tables)
- AWS Identity and Access Management (IAM)
- AWS Lake Formation (オプション、ガバナンス付きアクセス制御用)
ソリューションの概要
Iceberg マテリアライズドビューを使えば、Amazon Redshift で集計を一度計算し、結果を Amazon S3 または Amazon S3 Table Buckets 上の標準的な Apache Iceberg テーブルとして格納できます。Iceberg 互換エンジンは、事前計算された結果を直接クエリできます。
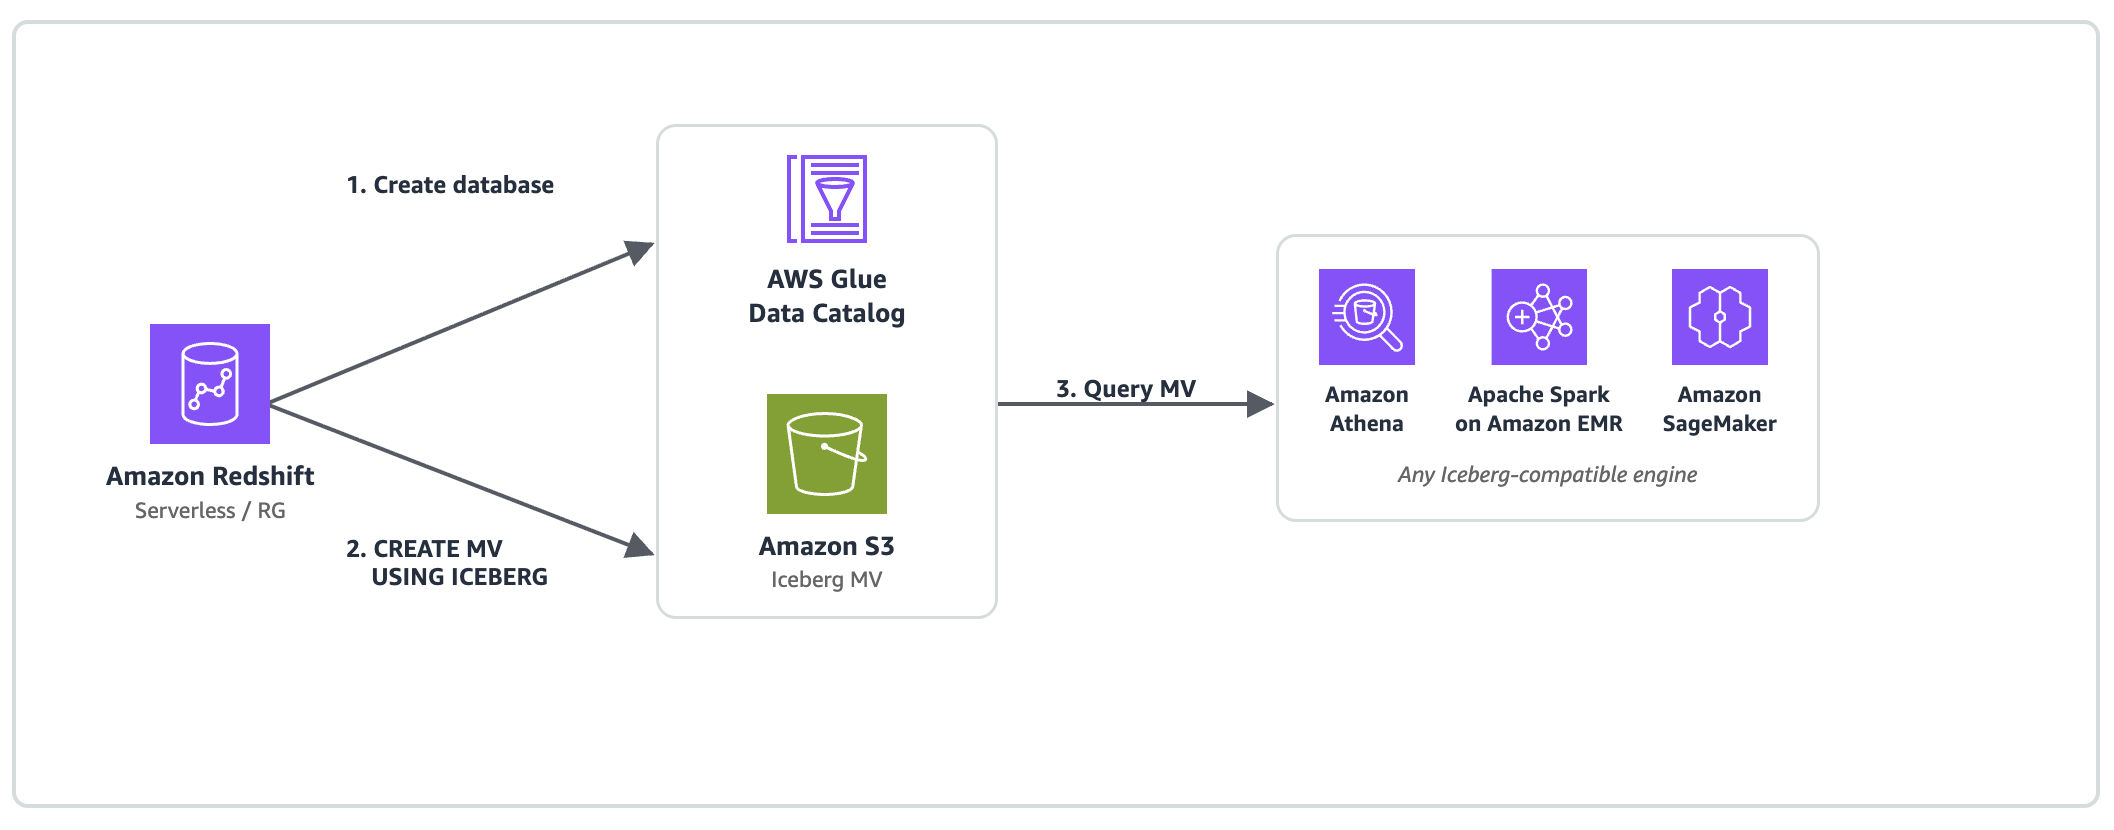
図 1: Iceberg 互換エンジンが Amazon S3 から事前計算済みの MV を直接クエリ
Amazon Redshift Serverless と Amazon Redshift RG で動作
Iceberg マテリアライズドビューは以下の環境でサポートされます。
Amazon Redshift Serverless – フルマネージドでオートスケーリングするコンピューティング。MV のリフレッシュとアドホッククエリを容量計画なしに並行実行できる、ワークロードが変動する環境に適しています。
Amazon Redshift RG (AWS Graviton 搭載のプロビジョニングインスタンス) – AWS Graviton プロセッサ上で動作するプロビジョニングクラスターで、独自に構築・統合されたベクトル化クエリエンジンを搭載。データレイクワークロードで RA3 インスタンスと比較して最大 2.4 倍のパフォーマンスを vCPU あたり 30% 低い価格で実現します。
注: Amazon Redshift RA3 および DC2 インスタンスタイプでは Iceberg マテリアライズドビューはサポートされません。
Amazon Redshift が Serverless またはプロビジョニングされた RG インスタンスで重い計算を一度実行します。すべての Iceberg 互換エンジン (Athena、Spark、SageMaker、AWS Glue) は、Amazon S3 または Amazon S3 Tables から事前計算済みの Iceberg MV を標準的な Amazon S3 の読み取りコストで利用できます。コンシューマー側に追加のコンピューティング課金は発生しません。
ユースケース
Iceberg マテリアライズドビューは、分析、コスト最適化、AI ワークロードにわたるさまざまなパターンをサポートします。
1. 最適化を共有するメダリオンアーキテクチャ
課題: Bronze → Silver → Gold アーキテクチャでは、Silver/Gold レイヤーでの最適化は計算を実行したエンジンだけが恩恵を受けます。
Iceberg MV の場合: Amazon Redshift RG がインクリメンタルリフレッシュ付きで Silver と Gold レイヤーを Iceberg MV として計算します。出力は Amazon S3 上の標準的な Iceberg テーブルなので、追加のコンピューティングなしにすべてのコンシューマーが恩恵を受けます。
2. エージェント型 AI、フィーチャーストア、生成 AI ワークロードの強化
課題: AI エージェント、機械学習 (ML) パイプライン、生成 AI アプリケーションは、移動平均、顧客生涯価値、エンゲージメントスコアなどの事前計算済みフィーチャーを、データウェアハウスへの直接接続なしにフレームワークが利用できる形式で必要とします。
Iceberg MV の場合: 重い計算 (複雑な結合、ウィンドウ関数、統計集計) は Amazon Redshift Serverless または RG で一度だけ実行されます。ウィンドウ関数や COUNT、SUM 以外の集計を使用するマテリアライズドビューは、リフレッシュのたびにインクリメンタルではなく全体が再計算されます。MV が計算されて標準的な Iceberg テーブルとして Amazon S3 に格納されると、さまざまなコンシューマーがネイティブにアクセスできます。
- Amazon SageMaker ノートブックとトレーニングジョブは、JDBC ドライバー不要で PyIceberg を通じて Amazon S3 からフィーチャーを直接読み取ります。
- Amazon Bedrock エージェントは、Retrieval Augmented Generation (RAG) 用の構造化データとして事前計算済みの分析結果にアクセスします。
- Amazon EMR 上の Apache Spark は、大規模 ML トレーニングパイプライン向けに
spark.table()でフィーチャーを利用します。 - Amazon Athena は、アドホック分析やダッシュボード向けにマテリアライズ済みフィーチャーへのサーバーレス SQL アクセスを提供します。
インクリメンタルリフレッシュでフィーチャーを最新に保てます。インクリメンタルリフレッシュの対象条件については、Apache Iceberg テーブルとして格納されたマテリアライズドビューを参照してください。
3. コンピューティング統合によるコスト最適化
課題: 同じ集計を複数のエンジン (Amazon Redshift、Athena、Spark、サードパーティツール) で個別に再実行すると、各エンジンで重複したコンピューティングに課金が発生し、コンシューマーの数に比例してコストが増加します。
Iceberg MV の場合: Amazon Redshift Serverless または RG の 1 回のリフレッシュで集計を一度だけ計算します。コンシューマーは事前計算済みの結果を Amazon S3 から標準的なストレージ読み取りコストで直接読み取り、エンジン間の重複コンピューティングを解消します。統合するコンシューマーエンジンの数に応じてコスト削減効果は拡大します。
4. データ移動なしのガバナンス付きデータ共有
課題: チーム間で分析結果を共有するには、データのコピーやエンジン固有の共有メカニズムが必要です。
Iceberg MV の場合: 出力は AWS Lake Formation で管理されます。単一の権限モデルでアクセスを付与し、コンシューマーは好みのエンジンを使用できます。
5. 分析エンジン全体で単一の信頼できるデータソース
課題: 複数のチームが Spark、Amazon Redshift、Athena、カスタムツールにわたって同じ指標を個別に再計算し、不整合な数値が生まれます。
Iceberg MV の場合: 1 つの CREATE MATERIALIZED VIEW ... USING ICEBERG で Amazon Redshift Serverless または RG 上で指標を一度だけ計算します。すべてのエンジンが Amazon S3 から同じ Iceberg テーブルを読み取り、同じ数値、同じスナップショットで、突合作業は不要です。
仕組み
Iceberg MV は Amazon Redshift のネイティブなマテリアライズドビュー機能を USING ICEBERG 句で拡張します。
MV は Amazon S3 Table Buckets にも格納できます。LOCATION 句を省略すると、Amazon S3 Tables がストレージを自動管理します。
インクリメンタルリフレッシュ
Amazon Redshift はリフレッシュ間で Iceberg スナップショット ID を追跡します。REFRESH MATERIALIZED VIEW の実行時に、変更されたソースパーティションを特定し、差分のみを再計算します。
インクリメンタルリフレッシュをサポートするパターン:
- GROUP BY 付きの SUM および COUNT 集計
- 集計なしのクエリ (行レベルの差分追跡)
- Iceberg テーブル間の INNER JOIN
フルリフレッシュとなる構文 (サポートはされています):
- DISTINCT、外部結合、ウィンドウ関数、サブクエリ
- 集合演算 (UNION ALL、UNION、INTERSECT、EXCEPT)
- MIN、MAX、AVG、COUNT(DISTINCT)、SUM(DISTINCT)
- GROUPING SETS、ROLLUP、CUBE
クロスクラスターリフレッシュ
MV は作成したクラスターに紐付きません。適切な IAM ロールを持つ Amazon Redshift クラスターや Serverless ワークグループからリフレッシュできます。複数のクラスターが同じ MV を同時にリフレッシュしようとした場合、Amazon Redshift は AWS Glue Data Catalog を通じて調整し、一度に 1 つのリフレッシュのみが成功するようにして競合を自動的に防止します。同時実行の処理の詳細については、Amazon Redshift Iceberg マテリアライズドビューのドキュメントを参照してください。
エンジン横断アクセス
結果は標準的な Iceberg テーブルであり、特別なドライバーは不要です。以下の例のように、さまざまなエンジンから MV を読み取れます。
Amazon Athena:
Amazon EMR 上の Apache Spark:
Amazon SageMaker / PyIceberg:
前提条件
Iceberg MV のセットアップには IAM、Amazon S3、AWS Glue の設定が必要です。以下の手順に従って環境を準備してください。
コンソールのスクリーンショット付きの詳細な手順については、Amazon Redshift ドキュメントの Iceberg マテリアライズドビューの開始方法を参照してください。
設定するリソースの一覧は以下の通りです。
| リソース | 用途 | 作成するステップ |
| IAM ロール (IcebergMvDefiner) | MV 操作用の definer ロール (2 サービスの信頼ポリシー) | ステップ 1–2 |
| S3 バケット | Iceberg MV データ (Parquet ファイル) の格納 | ステップ 3 |
| AWS Glue データベース | AWS Glue Data Catalog で MV メタデータを管理 | ステップ 4 |
| クラスターロールの関連付け | Amazon Redshift クラスターに definer ロールの引き受け権限を付与 | ステップ 5 |
ステップ 1: IAM ロールの作成
以下の信頼ポリシーを持つ IcebergMvDefiner という名前の IAM ロールを作成します。2 つのサービスプリンシパルが必要な点に注意してください。
2 つのプリンシパルが必要な理由: Amazon Redshift はマテリアライズドビュー操作を実行するためにロールを引き受ける必要があります。AWS Glue はマテリアライズドビューの definer ロールに代わって、ベーステーブルの権限を確認する必要があります。
ステップ 2: IAM ポリシーのアタッチ
IcebergMvDefiner ロールに以下のスコープ付きインラインポリシーをアタッチします。Iceberg マテリアライズドビュー操作に必要な最小限の権限を提供します。
S3 アクセス (バケットにスコープ):
s3-mv-access という名前のインラインポリシーを作成します。
AWS Glue Data Catalog アクセスポリシー (データベースにスコープ):
glue-mv-access という名前のインラインポリシーを作成します。
IAM PassRole ポリシー (definer ロールにスコープ):
mv-access という名前のインラインポリシーを作成します。
ステップ 3: S3 バケットの作成
MV ストレージ用の S3 バケットを作成します。命名規則として iceberg-mv- を推奨します。デフォルト暗号化 (SSE-S3) を有効にし、パブリックアクセスをすべてブロックしてください。
ステップ 4: AWS Glue データベースの作成
AWS Glue Data Catalog に iceberg_mv という名前のデータベースを作成します。シンプルな create-database コマンドを使用します。データベースはデフォルトで IAM_ALLOWED_PRINCIPALS を継承し、Amazon Athena などのエンジンからのアクセスが可能です。
ステップ 5: ロールと Redshift の関連付け
IcebergMvDefiner ロールを Amazon Redshift クラスターまたは Serverless 名前空間に関連付けます。
ステップ 6: 大文字小文字の区別の設定
Amazon Redshift クラスターに接続し、以下を実行します。
最初の Iceberg MV の作成
前提条件が整ったら、外部スキーマ、ベースの Iceberg テーブル、最初のマテリアライズドビューを作成できます。
ステップ 7: 外部スキーマの作成
ステップ 8: サンプルデータ付き Iceberg ベーステーブルの作成
ステップ 9: Iceberg マテリアライズドビューの作成
ステップ 10: MV の内容の確認
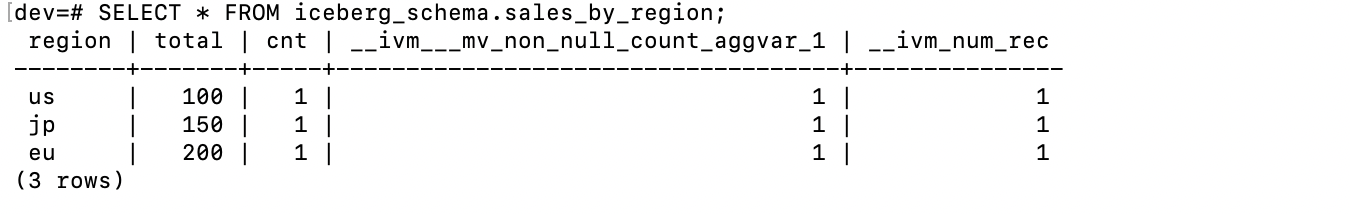
図 2: リージョン別に集計されたマテリアライズドビューの初回クエリ結果
ステップ 11: インクリメンタルリフレッシュのテスト
ベーステーブルに新しい行を挿入し、MV をリフレッシュします。
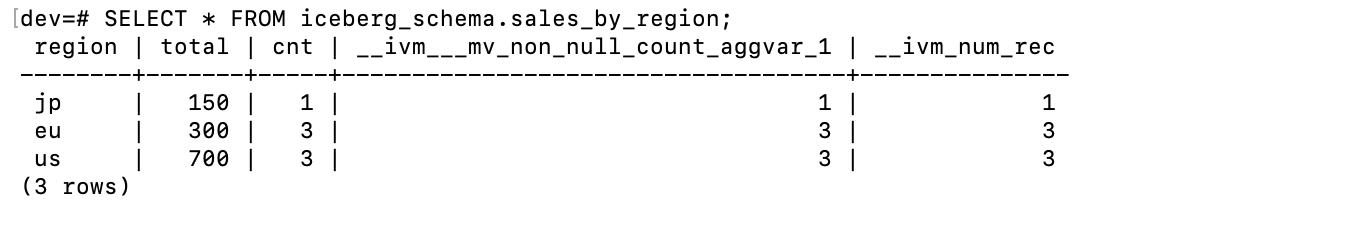
図 3: 新しい行の挿入とリフレッシュ後のマテリアライズドビュークエリ結果
エンジン横断での検証
マテリアライズドビューは AWS Glue Data Catalog 上の標準的な Iceberg テーブルとなり、Amazon Redshift への接続なしに互換エンジンからアクセスできます。
Amazon Athena:
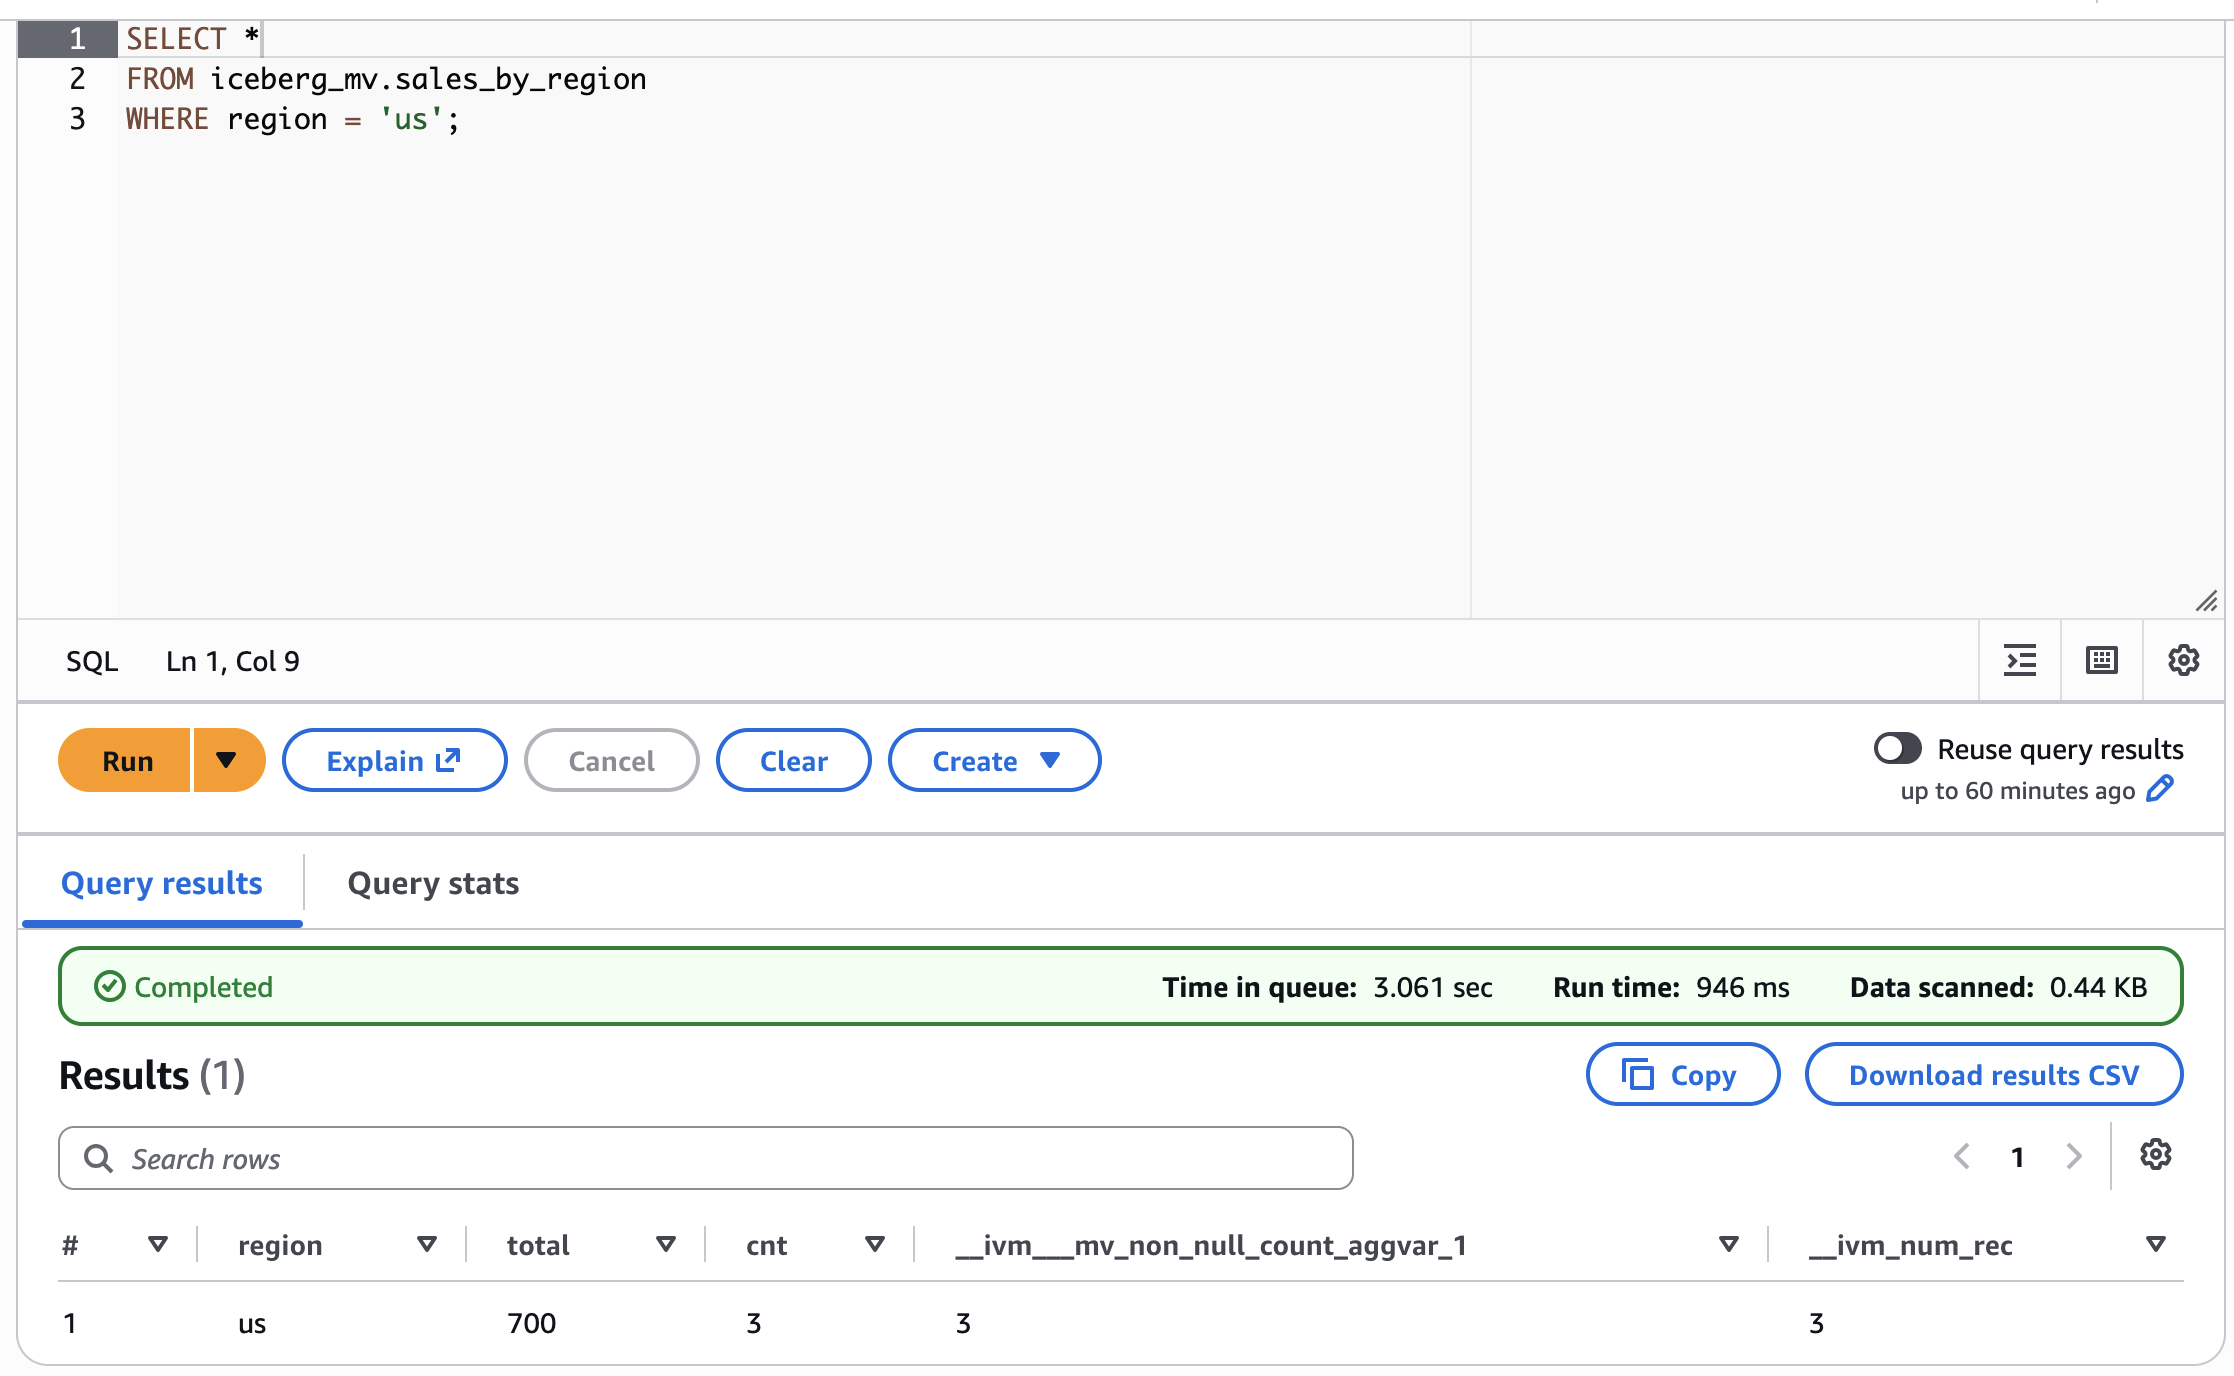
図 4: Amazon Athena からのマテリアライズドビューのクエリ
Amazon SageMaker / PyIceberg:
Amazon EMR 上の Apache Spark:
ビジネスケース
以下の表は、複数のエンジンで共通の集計を計算する代表的なシナリオを示しています。
| 比較項目 | 従来型 (サイロ化) | Serverless/RG での Iceberg MV |
| コンピューティングコスト | 月額約 $7,500 (4 エンジン) | 月額約 $1,500 (1 回のリフレッシュ) |
| 指標の整合性 | 3~4 バージョン | 1 バージョン |
| 新しい指標の追加所要時間 | 数日 (エンジンごと) | 数時間 (1 つの定義) |
| ガバナンス | エンジンごとの ACL | IAM + オプションで Lake Formation |
コスト試算は、中規模の集計 (入力 1 TB、出力 100 GB) を Athena ($5/TB スキャン)、Amazon EMR 上の Spark ($0.096/hr × 4 ノード)、Amazon Redshift Serverless (8 RPU)、サードパーティエンジンの 4 つで日次実行する想定です。実際の削減額はワークロードにより異なります。
現在の制限事項
サポートされる SQL 構文、インクリメンタルリフレッシュの対象条件、既知の制限事項の最新リストについては、Amazon Redshift ドキュメントの Apache Iceberg テーブルとして格納されたマテリアライズドビューを参照してください。
(オプション) Lake Formation ガバナンスの追加
組織でエンジン横断の一元的なアクセス制御が必要な場合は、IAM のみの設定に加えて AWS Lake Formation ガバナンスをレイヤーとして追加できます。Iceberg MV に対する Lake Formation 権限は粗粒度 (データベースおよびテーブルレベル) です。きめ細かなアクセス制御 (行フィルター、列フィルター) は Iceberg マテリアライズドビューではサポートされません。以下の追加手順は、本記事のウォークスルーと同じ環境で検証済みです。
- IAM ロールの信頼ポリシーに lakeformation.amazonaws.com を追加します (redshift.amazonaws.com と glue.amazonaws.com に加えて)。
- ロールのインラインポリシーに lakeformation:GetDataAccess を追加します。
- S3 バケットを Lake Formation データロケーションとして登録します。
- AWS Glue データベースを空の CreateTableDefaultPermissions で再作成します (Lake Formation がテーブルレベルのアクセス制御の権限を持つようになります)。
- definer ロールに Lake Formation 権限を付与します。S3 バケットへの DATA_LOCATION_ACCESS、データベースへの CREATE_TABLE/DESCRIBE/ALTER/DROP、テーブルへの ALL (付与オプション付き) を設定します。
Lake Formation の詳細な手順については、Amazon S3 Tables と Iceberg マテリアライズドビューの合理化された権限の使い方を参照してください。
クリーンアップ
継続的な課金を避けるため、本記事のウォークスルーで作成したリソースを削除してください。
注: DROP MATERIALIZED VIEW は AWS Glue カタログのエントリを削除しますが、Amazon S3 上の基盤データは削除されません。データを削除するには、Amazon S3 プレフィックスを手動で削除してください。
まとめ
Iceberg マテリアライズドビューは、オープンレイクハウスの約束をさらに前進させます。最適化そのものがポータブルになるのです。Amazon Redshift は Serverless または AWS Graviton 搭載の RG インスタンスで重い計算を一度だけ実行し、他のすべてのエンジンや ML パイプラインが追加のコンピューティングなしにその恩恵を受けます。まず 1 つの MV から始めてみてください。初めてエンジン間で数値が一致するのを確認できるはずです。そこからスケールしていきましょう。
参考資料
Getting started with Iceberg materialized views (Amazon Redshift documentation)
- Getting started with Apache Iceberg write support in Amazon Redshift (AWS Blog, Nov 2025)
- Achieve 2x faster data lake query performance with Apache Iceberg on Amazon Redshift
- How to use streamlined permissions for Amazon S3 Tables and Iceberg materialized views
- Meet Amazon Redshift RG
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Yui Numazawa がレビューしました。