Amazon Web Services ブログ
Category: Amazon Redshift

日本通運の AI 搭載型物流 Web アプリ「DCX」— AWS で実現する次世代サプライチェーンの可視化と予測
物流業界では、EC 市場の急拡大、販売チャネルの多様化、商品ライフサイクルの短期化が同時に進み、サプライチェー […]
AWS Weekly Roundup:数字で見るプライムデー2026、クロード・ハイク 5.5、Amazon Nova 2.5 Sonic など (2026 年 10 月 13 日)
数字の中には、しばらく向き合ってみないと想像しにくいものもあります。2026 年 10 月 5 日週、プライム […]
一度作れば、どこでも使える – Amazon Redshift の Iceberg マテリアライズドビューの紹介
Amazon Redshift で Iceberg マテリアライズドビューが利用可能になりました。コストの高い結合や集計を一度計算し、その結果を Amazon S3 上の標準的な Apache Iceberg テーブルとして格納できます。Amazon Athena、Apache Spark、AWS Glue などの Iceberg 互換エンジンから、コピーや別パイプラインなしに同じ事前計算済みの結果を直接クエリ可能です。
United Airlines が Amazon Redshift と AWS Glue Data Catalog フェデレーションで Databricks が管理するデータをクエリする方法
United Airlines は、AWS Glue Data Catalog フェデレーションで Amazon Redshift Serverless と Databricks Unity Catalog を接続し、データを複製せずに Databricks が管理するデータをクエリしています。本記事では、Lake Formation の設定、リソースリンクの作成、IAM ロールと権限の設定、外部スキーマの作成までの手順と、United Airlines が得たビジネスへの効果を紹介します。
AWS Weekly Roundup: AWS 版 Claude Fable 5.1、Amazon Linux 2027 プレビュー、AWS Certified AI Business Strategist など (2026 年 9 月 7 日)
2026 年 8 月 31 日週、Claude Fable 5.1 が AWS で利用可能になりました。Ant […]
Razor Group が AWS でモダンなデータレイクハウスを構築するまでの道のり
Razor Group は 250 以上のブランドを展開する欧州有数の EC アグリゲーターです。本記事では、同社が AWS 上に Apache Iceberg と Amazon S3 Tables を軸としたレイクハウスアーキテクチャを構築し、データプラットフォームを最適化した道のりを紹介します。段階的な移行アプローチ、アーキテクチャ上の意思決定、そしてインフラコスト 63% 削減やクエリ 65% 高速化といった測定可能な成果を取り上げます。
DuckDB で Amazon S3 Tables に格納された表形式データセットへのアクセスを効率化する
DuckDB は軽量なインメモリ SQL エンジンで、追加のサーバー運用なしに対話型のデータ分析を実現します。本記事では、Amazon SageMaker Lakehouse Iceberg REST エンドポイントと AWS Lake Formation のアクセス許可を利用して、AWS CloudShell 上の DuckDB から Amazon S3 Tables に格納された Iceberg テーブルにアクセスし、クエリを実行する手順を紹介します。
Amazon S3 Tables による Amazon Redshift システムテーブルの長期保持
Amazon Redshift システムテーブルと Amazon S3 Tables の統合により、システムテーブルのログデータを Apache Iceberg 形式で自動的に保存し、7 日間の上限を超えて保持期間を設定できます。独自の ETL パイプラインやクラスターリソースを使わずに、長期的なコンプライアンス対応、監査、ウェアハウス横断の可観測性を実現します。本記事では、機能の仕組み、セットアップ手順、代表的なユースケースを解説します。
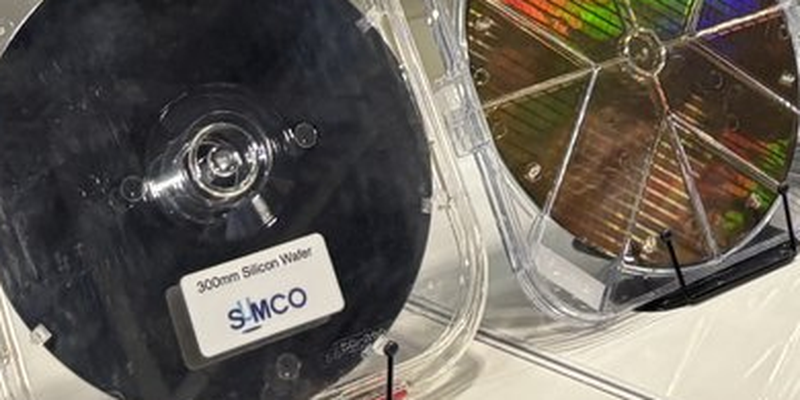
【開催報告】AWS Summit Japan 2026 レポート:SUMCO が挑む、Amazon Redshift × 生成 AI による半導体ウェーハ製造 DX
本記事は 2026 年 6 月 25 日から 26 日に幕張メッセで開催された AWS Summit Japan 2026 の開催報告です。AWS for Industries Zone に出展した株式会社 SUMCO のブース展示 「Amazon Redshift × 生成 AI で挑む 半導体ウェーハメーカーの DX」 の内容を、SUMCO と AWS が共同で振り返ります。
Amazon Redshift のモダナイゼーション: RA3 から RG への移行ベストプラクティス
Amazon Redshift RA3 クラスターを Graviton ベースの RG インスタンスに移行する方法を解説します。Elastic Resize、Classic Resize、Snapshot/Restore の 3 つの移行戦略を比較し、スムーズな移行のための考慮事項とベストプラクティスを紹介します。