Amazon Web Services ブログ
Category: Amazon Athena
Amazon Athena がクエリ実行のオブザーバビリティを高めるシステムテーブルを導入
Amazon Athena にシステムテーブルが加わり、第一弾として query_executions の提供が始まりました。すべてのワークグループで実行したクエリの記録が Amazon S3 Tables 上の Apache Iceberg テーブルに自動で保存され、Athena から直接クエリできます。本記事では、システムテーブルの概要と始め方に加え、コストの配分、パフォーマンス分析、監査、運用監視、キャパシティ予約の最適化に使えるクエリの例を紹介します。
Kiro の利用状況とコストを把握する ― Part 1: Kiro のクレジット消費量とコストはどこで確認できるか
組織で Kiro を導入すると、誰がどれだけ使い、そのコストがどこで発生しているのかを継続的に把握する必要が出 […]
AWS Weekly Roundup:数字で見るプライムデー2026、クロード・ハイク 5.5、Amazon Nova 2.5 Sonic など (2026 年 10 月 13 日)
数字の中には、しばらく向き合ってみないと想像しにくいものもあります。2026 年 10 月 5 日週、プライム […]
DuckDB で Amazon S3 Tables に格納された表形式データセットへのアクセスを効率化する
DuckDB は軽量なインメモリ SQL エンジンで、追加のサーバー運用なしに対話型のデータ分析を実現します。本記事では、Amazon SageMaker Lakehouse Iceberg REST エンドポイントと AWS Lake Formation のアクセス許可を利用して、AWS CloudShell 上の DuckDB から Amazon S3 Tables に格納された Iceberg テーブルにアクセスし、クエリを実行する手順を紹介します。
パート2: Amazon AthenaとCUDOSを使用したAmazon Bedrockのコスト配分
本記事は2026年8月12日に公開された「Part 2: Amazon Bedrock cost attrib […]
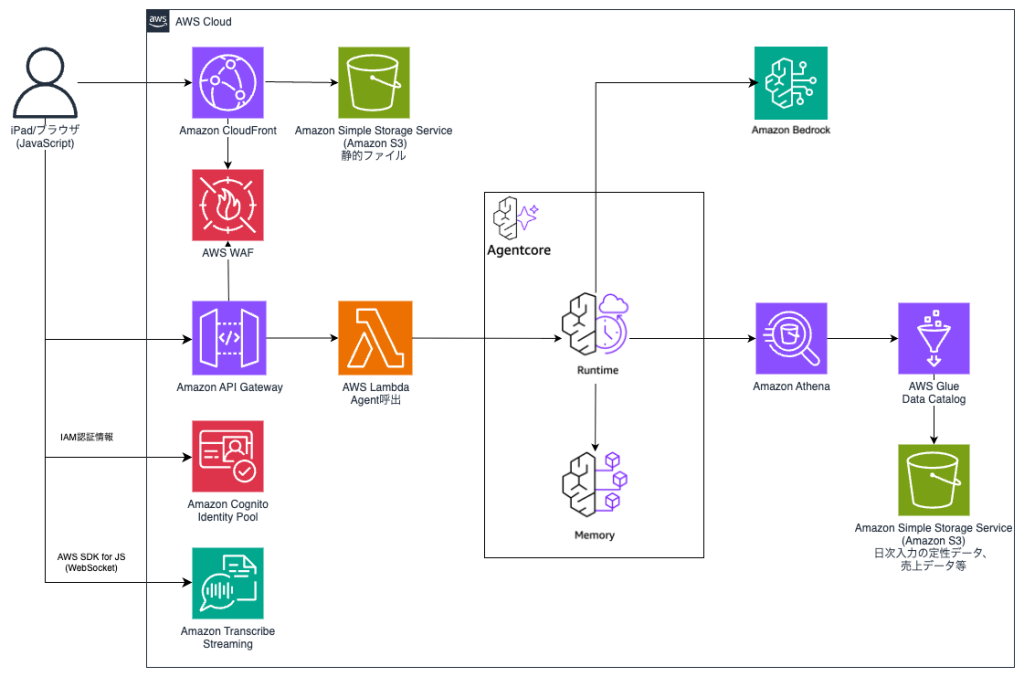
店舗の気づきを本部に届ける AI エージェント SMART のご紹介 — Amazon Bedrock AgentCore × Strands Agents によるユナイテッドアローズでの取り組み
本記事では、AWS サンプルアセットである AI エージェント SMART(Store Manager Agent for Retail Tech) についてのご紹介と、それを活用した株式会社ユナイテッドアローズ(以下、ユナイテッドアローズ)の取り組みについてご紹介します。小売業にとって、店舗の声をどう本部に届けるかは永遠のテーマです。売上数字の裏には、現場スタッフだけが感じている気づきが必ずあります。しかし店舗の日報や週報のフォーマットだけでは、その気づきを届けるのは難しいのが実情です。SMART は、店舗の気づきを AI の力で引き出し言語化して、本部に届けることを支援するために誕生しました。
AWS Cost and Usage Reports データを使用したセキュリティリスクの特定
AWS の請求書からわかるのは、支出パターンだけではありません。セキュリティ上の問題を特定することもできます。 […]
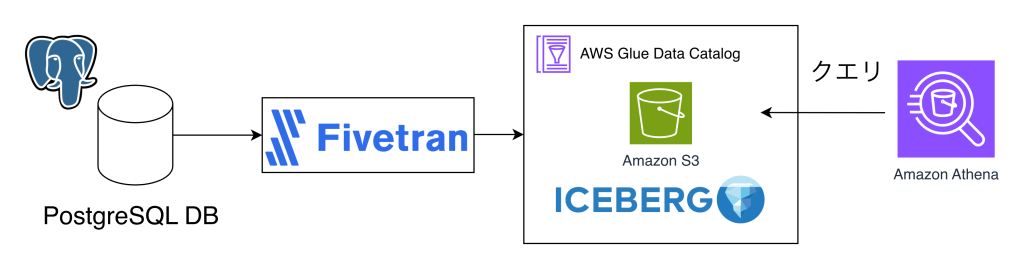
Fivetran の Managed Data Lake Service の CDC で実現する業務システムから Apache Iceberg へのリアルタイムデータ連携
本記事は アマゾン ウェブ サービス ジャパン合同会社 ソリューションアーキテクト 疋田、畠 と、Fivetr […]
BMW Group が AWS 上のエージェンティック検索でペタバイト規模のデータからインサイトを引き出す
BMW Group が AWS 上でエージェント検索ソリューションを構築し、ペタバイト規模のデータからインサイトを引き出す取り組みを紹介します。同社の Cloud Data Hub は 20 PB のデータを保存し、1 日平均 110 TB を取り込んでいますが、従来は専門知識がないユーザーにとってデータ分析が困難でした。AWS Professional Services と協力し、Amazon S3 Vectors、Amazon Bedrock、Strands Agents を組み合わせたソリューションを開発。ハイブリッド検索、網羅的検索、SQL クエリの 3 つのアプローチにより、技術スキルに関係なく自然言語でデータにアクセス可能になりました。サーバーレスアーキテクチャによりコスト効率も実現しています 。

【寄稿】SIEMからデータ基盤へ – 三井物産デジタルアセットマネジメントのAWS Security Lake活用事例
こんにちは。ソリューションアーキテクトの松本 敢大です。三井物産デジタル・アセットマネジメント株式会社(以下、 […]