Amazon Web Services ブログ
Amazon Redshift で Apache Iceberg テーブルへの同時書き込みの競合を解決する
本記事は 2026 年 10 月 13 日 に公開された「Resolving concurrent write conflicts for Apache Iceberg tables in Amazon Redshift」を翻訳したものです。
Amazon Redshift の Apache Iceberg 書き込みサポート入門 – Part 1 では、Apache Iceberg テーブルを作成し、INSERT で書き込む方法を紹介しました。Part 2 では、DELETE、UPDATE、MERGE を使って行レベルでデータを変更しました。どちらの記事も、テーブルに書き込むのは自分の処理だけという前提でした。しかし本番環境でそうなることはまれで、ストリーミングジョブ、スケジュール実行のパイプライン、1 回限りの変換処理が同じテーブルに同時に書き込むことはよくあります。Amazon Redshift は、こうした同時書き込みで起きる競合の多くを自動的に解決するようになりました。以前は失敗して再試行を強いられていた変更も、そのままコミットできます。本記事では、Iceberg テーブルへの同時書き込みで競合が起きる理由、実際には重なっていない競合を Amazon Redshift が解決するしくみ、エンジンがチェックの単位を操作からパーティション、個々のファイルへと段階的に細かくしていく流れ、そしてスループットの改善効果を説明します。
同時書き込みの課題
Apache Iceberg は、複数のライターが同時にコミットしてもテーブルの一貫性を保てるよう、楽観的同時実行制御 (OCC) を採用しています。各ライターはテーブルの現在のバージョンを基に変更を準備し、他のライターが先にバージョンを進めていないことを条件に、カタログ上のテーブルバージョンをアトミックに進めることでコミットします。その間に別のライターがコミットしていると条件が満たされず、書き込み全体が破棄されます。条件を厳格にしているのは、スナップショット分離のセマンティクスを保つためです。後のコミットを構わず適用すると、先のライターの変更を含まないテーブルバージョンで置き換えることになり、コミット済みの書き込みが知らないうちに失われてしまいます。
読み取り側では、こうした競合は起きません。Iceberg のスキャンは常にコミット済みのスナップショットを読むので、同時書き込みによって読み取りが無効になることはありません。したがって、エンジンが解決しなければならないのは書き込み同士の競合だけです。書き込み同士の競合を正しく解決することで、テーブルのスナップショット分離のセマンティクスが保たれます。
問題は、チェックが粗すぎることです。条件はテーブルバージョンで判定され、各ライターが変更した行やパーティションは考慮されません。テーブルバージョンという粒度で見れば、バージョンは実際に変わっているので、判定としては正しいといえます。しかし、2 つの書き込みが実際のデータで重なっていたかどうかについては、何もわかりません。完全に別々のパーティションを変更した 2 つのライターも、それぞれ独立に新しいデータを挿入した 2 つのライターも、同じ行を書き換えた 2 つのライターとまったく同じように競合します。クエリの開始からコミットまでの時間帯が重なれば、必ずそうなります。
例として、customer_orders という Iceberg テーブルを持つ小売分析プラットフォームを考えてみます。ストリーミングパイプラインが、1 分間に数百回の挿入で新しい注文を絶えず取り込んでいるとします。毎晩実行されるコンプライアンスジョブは 7 年より古いレコードを削除し、実行に約 1 時間かかります。ストリームとコンプライアンスジョブの書き込みが同じデータに触れることはありません。ストリームは最近の注文を追加するだけで、コンプライアンスジョブは古い注文を削除するだけだからです。しかし、基本的な楽観的同時実行制御では、データが重ならないことは考慮されません。コンプライアンスジョブが実行されている 1 時間のうちに 1 回でもストリーミングの挿入がコミットされると、コンプライアンスジョブは先を越され、1 時間分の作業が破棄されます。次の試行では数テラバイトのデータを再スキャンしたあげく、また同じコミット競争に巻き込まれるだけです。データの競合はなかったのに、テーブルバージョンの競合は実際に起きていたのです。
こうした失敗を避ける一般的な方法はどれも手作業で、それぞれに代償があります。ライターを直列化して一度に 1 つだけコミットさせる方法では、同時実行を完全にあきらめることになります。1 つの論理テーブルを複数の物理テーブルに分け、2 つのライターが同じテーブルを共有しないようにする方法もあります。テーブルを分けると、並列に書き込めるようになる代わりに、すっきりしたデータモデルと、テーブルをまたいでクエリできる利点を手放すことになります。あるいは、すべての書き込みをアプリケーション側の再試行ループで囲み、実際には競合していなかったステートメントを再実行するコストを受け入れる方法もあります。いずれの場合も、データそのものではなく、コミットプロトコル関連の処理に労力を割くことになります。
Amazon Redshift が書き込みの競合を解決するしくみ
コミットが先を越されたとき、Amazon Redshift はあきらめる前に、もう一歩踏み込んで確かめるようになりました。確かめるのは、先にコミットしたライターが、先を越された書き込みと同じパーティション、ファイル、行を本当に変更したのかどうかです。答えが「いいえ」であれば、作業を破棄する理由はありません。Amazon Redshift は書き込みを中止する代わりに、git rebase と同様に変更をリベースし、準備済みの書き込みをテーブルの最新バージョンに再適用して、その結果をコミットします。再スキャンも再実行も、アプリケーション側の再試行ループも必要なく、両方の書き込みが反映されます。
先ほどの小売の例では、これまでコンプライアンスジョブの削除は、実行中にストリーミングの挿入がコミットされた時点で失敗していました。現在は、Amazon Redshift が両方の書き込みを調べ、挿入はデータファイルを追加しただけで、削除は別のデータファイルを削除しただけであることから、両者が同じデータに触れていないことを確かめます。変更が独立していると証明できるため、Amazon Redshift は削除を更新後のテーブルバージョンにリベースしてコミットします。両方の書き込みが成功し、1 時間分の作業は無駄にならず、下流のコンシューマーからは両方の変更が見えます。
対象となる書き込みでは競合が自動的に解決され、クラスタリングキーの選択も、パーティションの再構成も、設定の有効化も必要ありません。2 つの書き込みが本当に競合している場合の動作は、これまでと変わりません。競合が報告され、後からコミットするライターは失敗して再試行が必要になります。
競合の解決は 2 つの原則に基づいています。1 つ目は、競合かどうかは粒度の問題だということです。コミット競争に負けたからといって、そのまま競合になるわけではありません。競合かどうかは、さまざまな細かさで問える問題です。エンジンが問えるのは、そもそもいずれかのライターがデータを削除したのか、それとも追加しただけなのか、そしてデータが削除されていた場合は、現在の書き込みが変更したのと同じパーティション、同じファイル、同じ行から削除されたのか、といった点です。調べる粒度が細かいほど、見かけ上の競合のうち、実は安全に共存できる独立した変更だとわかるものが増えます。ただし、細かいチェックほどコストもかかります。突き詰めれば、エンジンは 2 つの変更セットの共通部分を行単位で求めることもできますが、コストが高く、通常は必要ありません。そこで Amazon Redshift は、最もコストの低いレベルから評価し、必要な場合にだけ、より細かいレベルを調べます。
2 つ目は、同時実行性より正しさを優先することです。競合の解決にはテーブルのメタデータだけを使い、データの再スキャンやクエリの再計画は一切行いません。2 つの書き込みが独立していると証明できない場合、エンジンは推測で判断しません。競合の解決を見送り、書き込みはこれまでとまったく同じように再試行となります。不要な再試行で失うのはわずかな時間ですが、誤った解決はデータを失うおそれがあるため、あえて安全側に倒す設計になっています。競合の解決は、Amazon Redshift が Iceberg の読み取りですでに使っているのと同じ、スナップショット分離のモデルで行われます。Apache Spark、Amazon EMR、Amazon Athena などのエンジンも、テーブルの分離レベルのプロパティに基づいてスナップショット分離を守るため、複数のエンジンで共有するテーブルでもセマンティクスが一貫します。書き込みの分離レベルのプロパティを serializable に設定したテーブルでは、Amazon Redshift はより厳格な保証を守り、競合を解決せずにすべて報告します。ここでいう分離レベルのプロパティは、Iceberg のテーブルプロパティ write.*.isolation-level です。ALTER DATABASE … ISOLATION LEVEL で設定する Amazon Redshift のデータベースの分離レベルとは関係ありません。データベースの分離レベルは Amazon Redshift のトランザクションを制御するもので、Iceberg のコミット時の競合解決には影響しません。
適切な粒度で解決する
コミットが先を越されると、エンジンはコストの最も低いものから最も精密なものへと、順にチェックを進めます。どのレベルもそれ単独で解決が完結しており、あるチェックで書き込みが独立していると証明できれば、リベースした結果がコミットされ、それより細かいチェックは実行されません。次の図は、まず操作レベル、次にパーティションレベル、最後にファイルレベルと進むチェックの流れを示しています。各レベルでは、書き込みが独立していると証明するか、次のレベルに進むかのどちらかで、本当の競合が報告されるのは最後のレベルを経た後だけです。
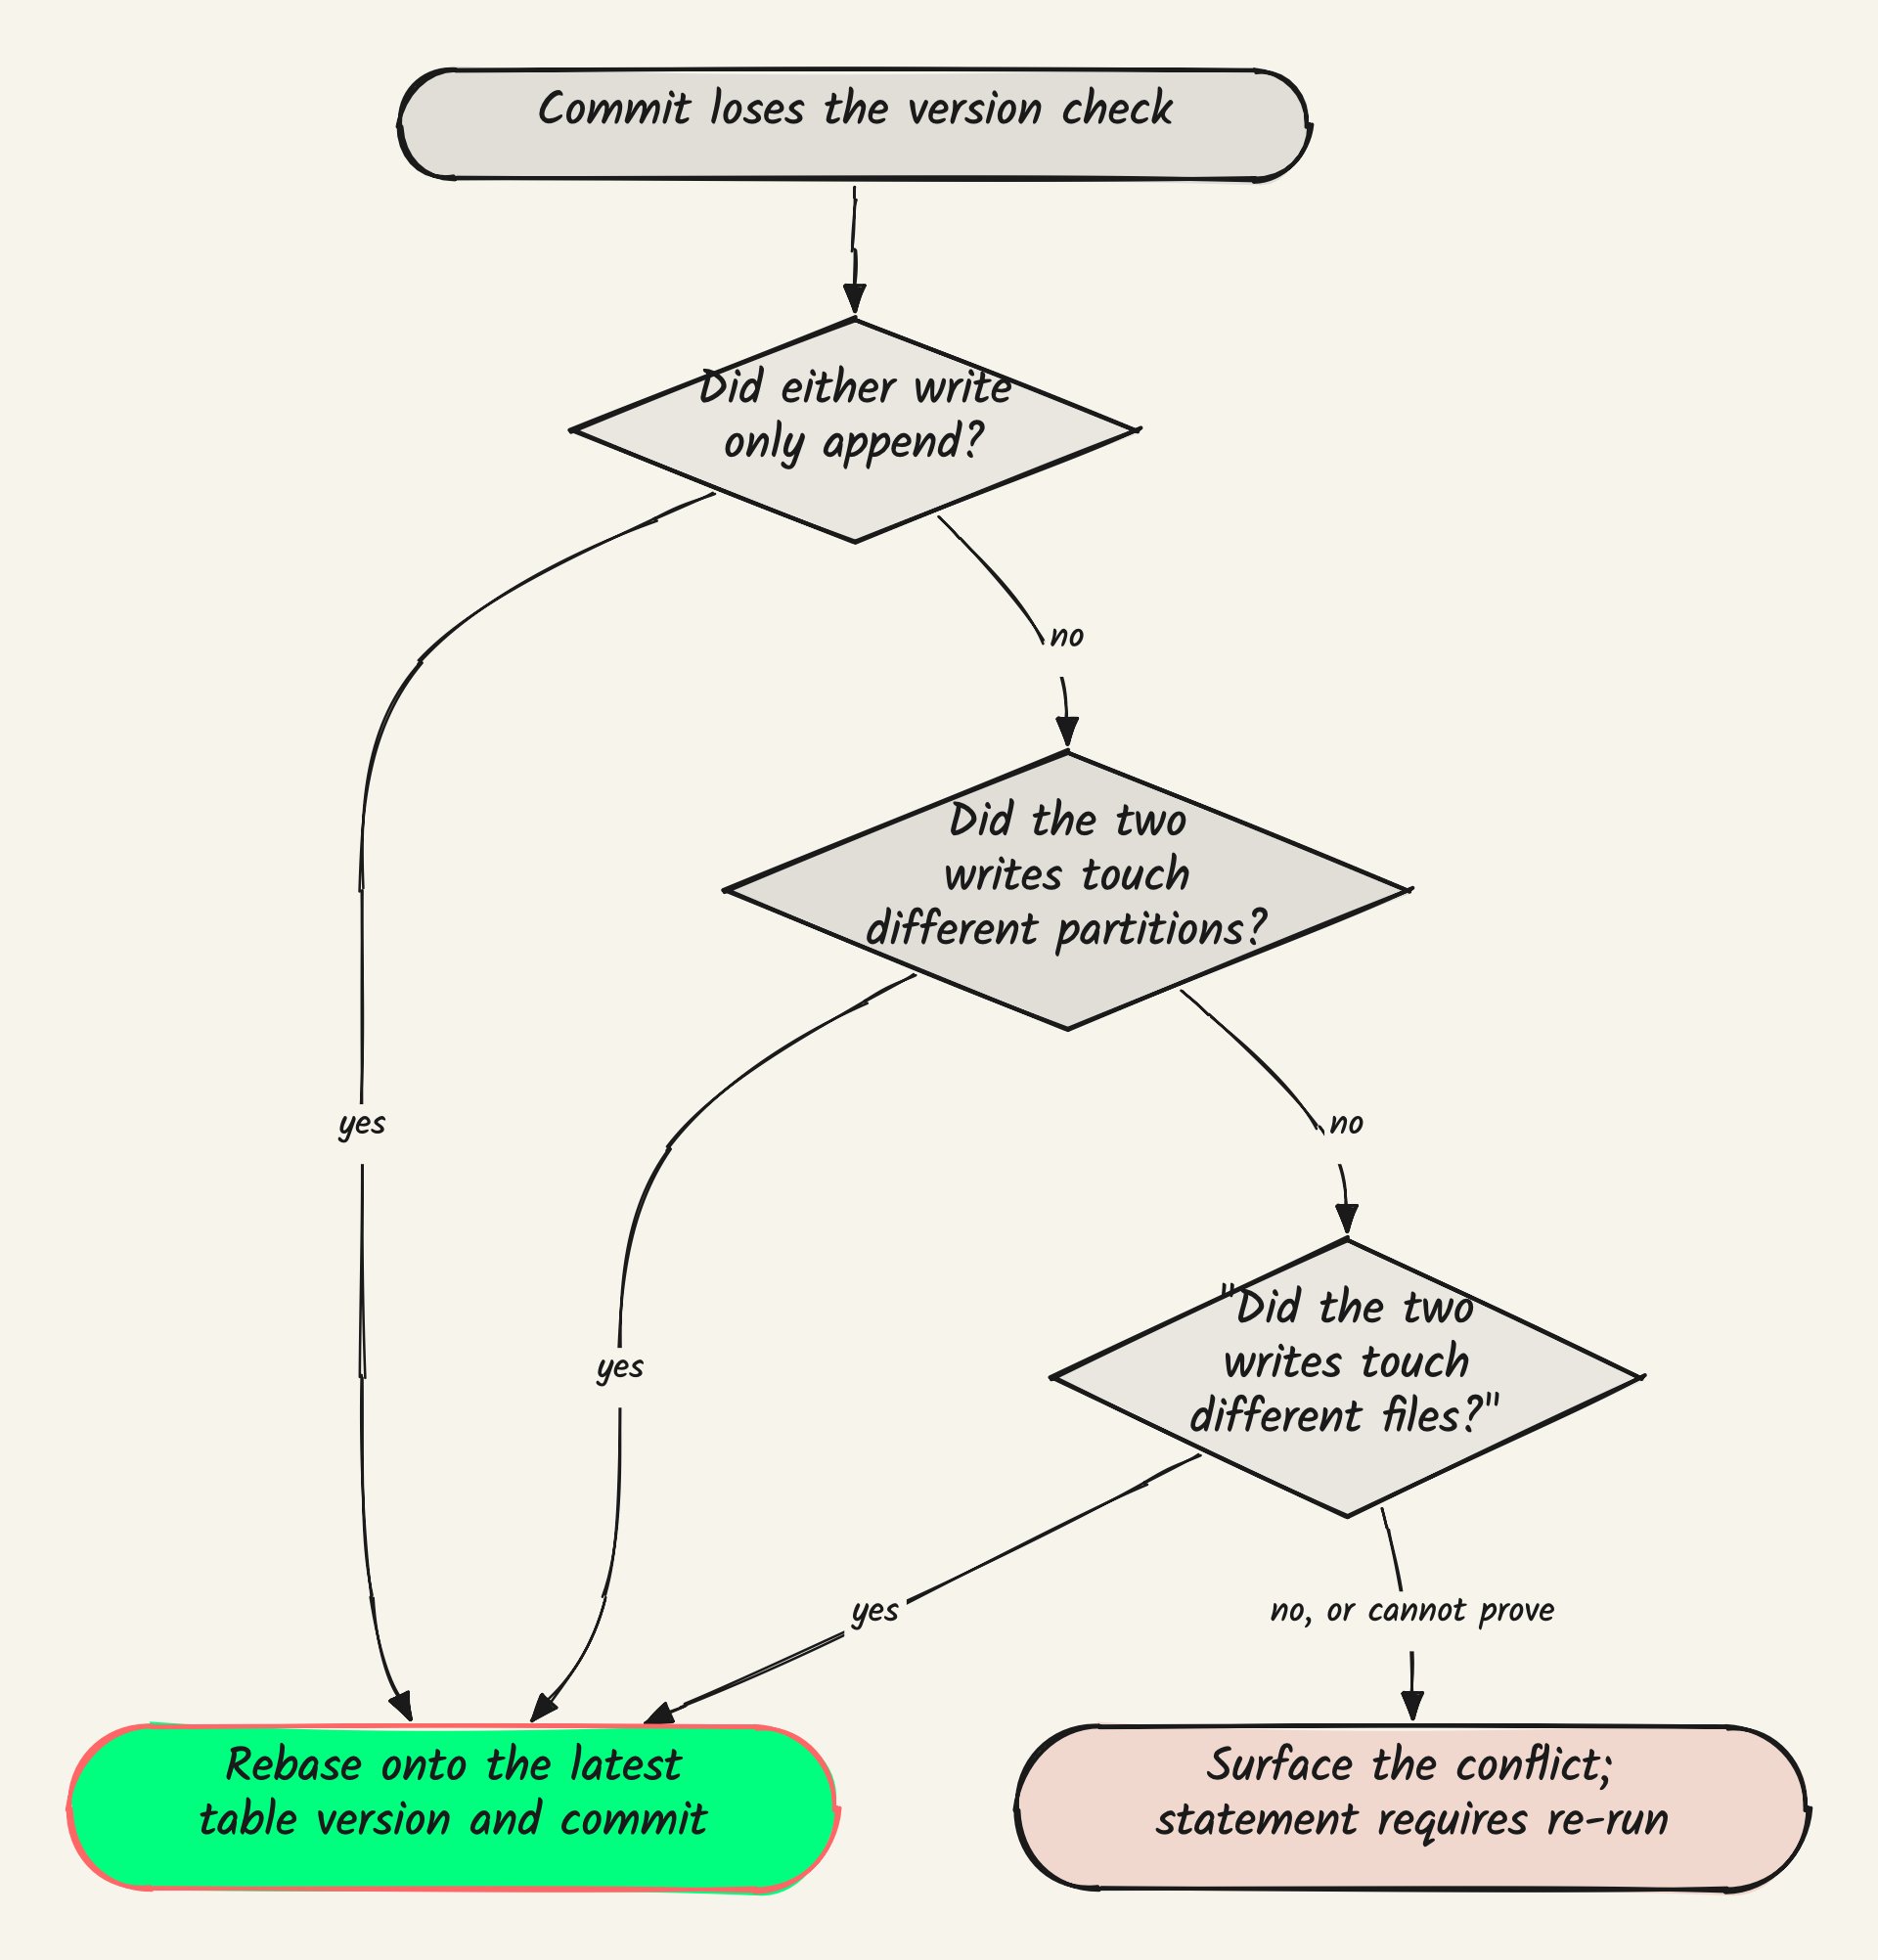
図 1: 操作レベルからパーティションレベル、ファイルレベルへと進む競合解決のチェック
最初のチェックは操作単位です。データを追加しただけの書き込み (たとえば、ストリーミングジョブから届いた新しいデータを書き込む INSERT) は、他のライターが前提としていたものを削除しているはずがないので、どの書き込みもその上にリベースできます。追加だけの書き込みに対するルール 1 つで、2 つの書き込みの少なくとも一方が追加だけだった組み合わせはすべて解決できます。DELETE、UPDATE、MERGE は、同時に流れ込む挿入があっても問題なくコミットできます。INSERT は、コンパクションを含め、同時に行われた他のどの変更があっても問題なくコミットできます。
次に、両方の書き込みがデータを削除していた場合、エンジンはそれぞれが変更したパーティションを比較します。重ならないパーティションを変更した書き込み (たとえば、別々の日付を更新するバッチジョブや、1 つのテーブルをリージョンごとに分担して管理するパイプライン) は、構造上独立しているので、どちらも問題なくコミットできます。
最後に、両方の書き込みが同じパーティションを変更していた場合、エンジンはそれぞれが変更した個々のファイルを比較します。同じ日付のパーティションで異なる行を削除する 2 つのジョブは、たいてい別々のファイルを変更します。その場合は、どちらも問題なくコミットできます。2 つの書き込みが同じファイルを変更した場合にだけ、競合が報告され、ステートメントの再実行が必要になります。さらにプロトコルには、1 つのファイル内の異なる行への変更を区別するという、もう 1 つのレベルを加える余地もあります。
次の表は、操作の組み合わせごとの結果をまとめたものです。先にコミットされた同時書き込みは列を縦に、自分の書き込みは行を横にたどって見てください。
| 自分の書き込み ↓ / 同時書き込み → |
INSERT |
DELETE / UPDATE / MERGE |
コンパクション | ALTER |
|
| 1 | INSERT |
解決 | 解決 | 解決 | 再実行が必要 |
| 2 | DELETE / UPDATE / MERGE |
解決 | 変更したパーティションまたはファイルに応じて解決。同じファイルへの変更は競合として報告 | 変更したパーティションまたはファイルに応じて解決。同じファイルへの変更は競合として報告 | 再実行が必要 |
| 3 | ALTER |
再実行が必要 | 再実行が必要 | 再実行が必要 | 再実行が必要 |
パフォーマンス
効果を測るため、1 つの Iceberg テーブルにコミットする同時ライターの数を増やしながら、一定の時間枠で書き込みを実行しました。先を越されたコミットを中止して再実行する基本的な楽観的同時実行制御のモード (Without conflict resolution) と、自動競合解決を有効にしたモード (With conflict resolution) を比較しました。すべてのライターが同じ単一ステートメントの INSERT を発行するため、実行ごとに変わるのはワークロードではなく、ライター同士の競り合いの度合いだけです。同時ライター数を 1 から 16 まで増やし、構成ごとに、成功したコミットの数と、競合として拒否されたコミットの数を記録しました。
測定条件: 米国東部 (バージニア北部) リージョン (us-east-1) の AWS Glue Data Catalog に登録した、パーティション分割されていない Iceberg テーブル 1 つ。各ライターは独立したセッションで、60 秒間にわたり、自動コミットの INSERT ステートメントをループで発行します。構成ごとに、完了したコミットの数と、競合として拒否された試行の数を示します。
最初の図は、ライターを増やしたときの書き込みスループットを示しています。インスタンスタイプやテーブルサイズに左右されずに比較できるよう、ライターが 1 つの場合を基準に正規化しています。
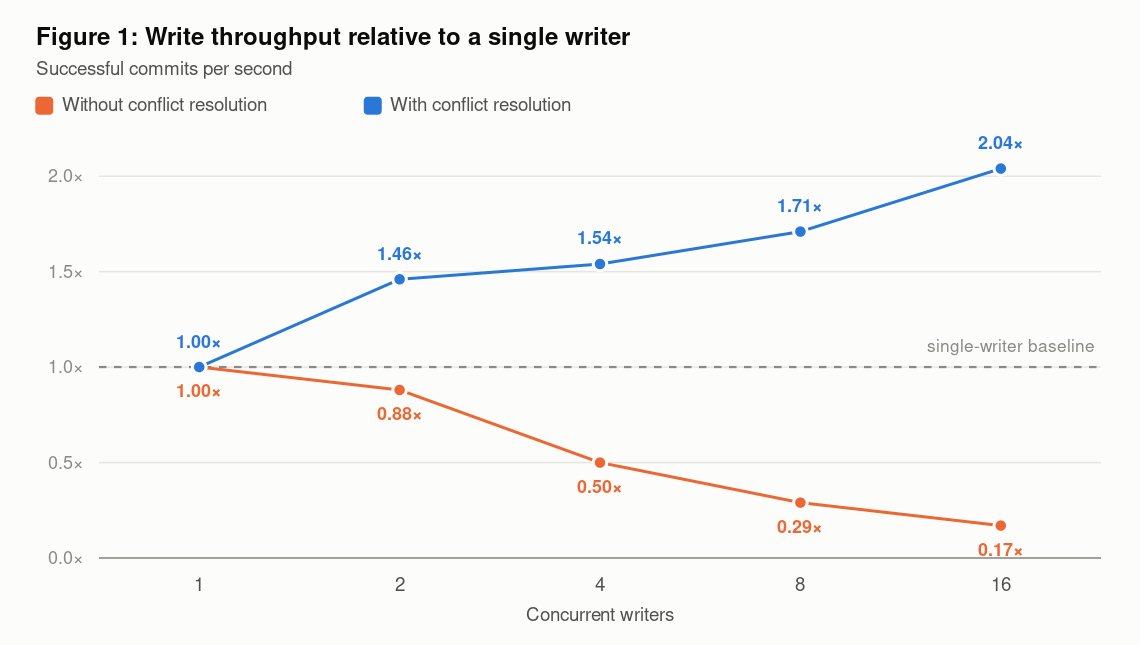
図 2: 同時ライター数を増やしたときの書き込みスループット (自動競合解決の有無で比較)
基本的な楽観的同時実行制御では、ライターを増やすほどテーブルへの書き込みが遅くなります。ライターが 16 になると、ほぼすべてのライターの作業がコミットされずに破棄されてやり直しになるため、スループットはライターが 1 つのときの 0.17 倍 (4÷24) まで落ち込みます。自動競合解決を有効にすると、同じワークロードのスループットは約 2 倍まで伸び、測定したどの構成でも拒否されたコミットはありませんでした。同時ライターが 16 の場合、同じ時間内に完了するコミットの数は 12 倍になります。その理由は 2 つ目の図からわかります。
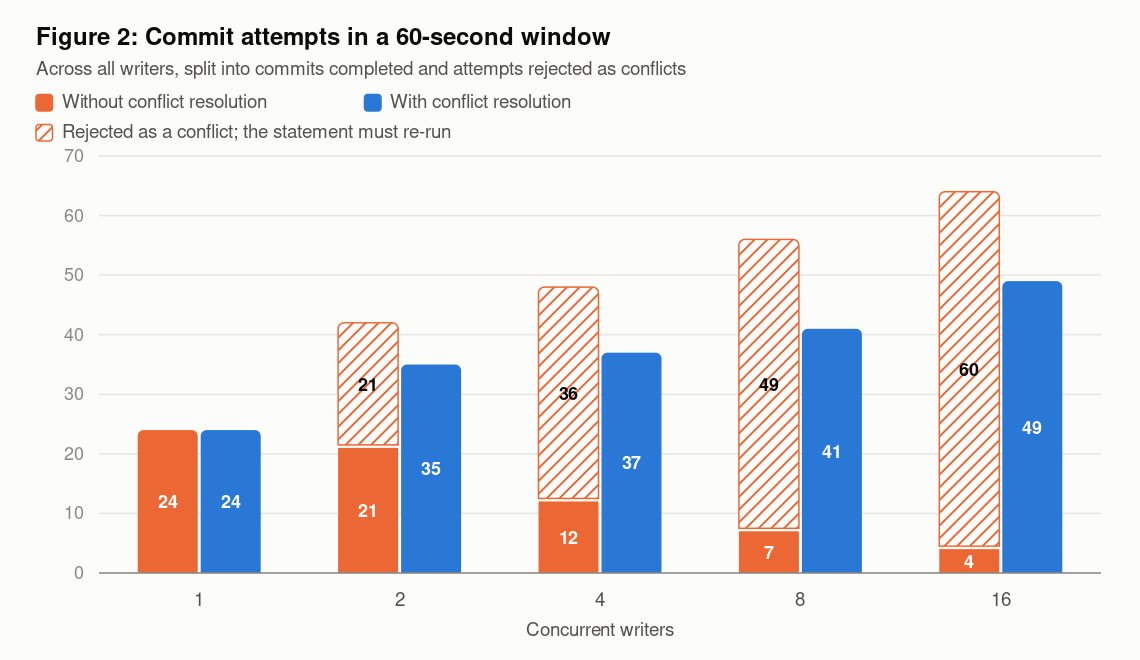
図 3: 同時ライター数を増やしたときのコミット失敗率 (自動競合解決の有無で比較)
ベースラインの失敗率はほぼ (N−1)/N のとおりで、たとえばライター数が 2 なら 50%、4 なら 75%、16 なら 94% です。従来のテーブルレベルのチェックがどう働いていたかがよくわかります。コミットの各ラウンドで勝てるのは 1 つのライターだけで、実行中の他のライターはすべて拒否されます。ライターを増やしても、増えた分のほとんどは、処理の進展ではなく作業のやり直しに費やされます。競合解決を有効にした場合は、同じ実行で競合が 1 件も記録されませんでした。このワークロードの書き込みはすべて追加であり、追加は他のライターが前提としているデータを削除しないためです。
このベンチマークでは、あえて最も基本的な追加のケースに絞っています。パーティション分割されていない単一のテーブルに、挿入だけを行うライターが書き込む構成で、継続的なデータ取り込みの基本となるパターンです。データを削除するワークロードでは、前述のパーティションとファイルのチェックが働き、結果は 2 つの書き込みが同じパーティション、同じファイルを変更したかどうかで決まります。
フリート全体での結果
競合解決を導入する前は、Amazon Redshift で Iceberg への書き込みが失敗する原因のうち、最も多いのが同時書き込みの競合で、毎週、失敗した Iceberg 書き込みクエリのおよそ 5 件に 1 件を占めていました。競合解決の機能は、同時に行われる追加に対応する操作レベルのチェックから、段階的に展開しました。2026 年 9 月上旬に操作レベルのチェックが Amazon Redshift のフリート全体に行き渡ると、フリート上の Iceberg 書き込み量が 2 倍以上に増えたにもかかわらず、同時書き込みによる競合エラーはほぼゼロになりました。次の図に 1 か所だけ残っているスパイクは、UPDATE ステートメントを同時に発行するワークロードによるものです。UPDATE の同時実行による競合は、後続のパーティションレベルとファイルレベルのチェックがフリート全体に展開されるにつれて解決されます。
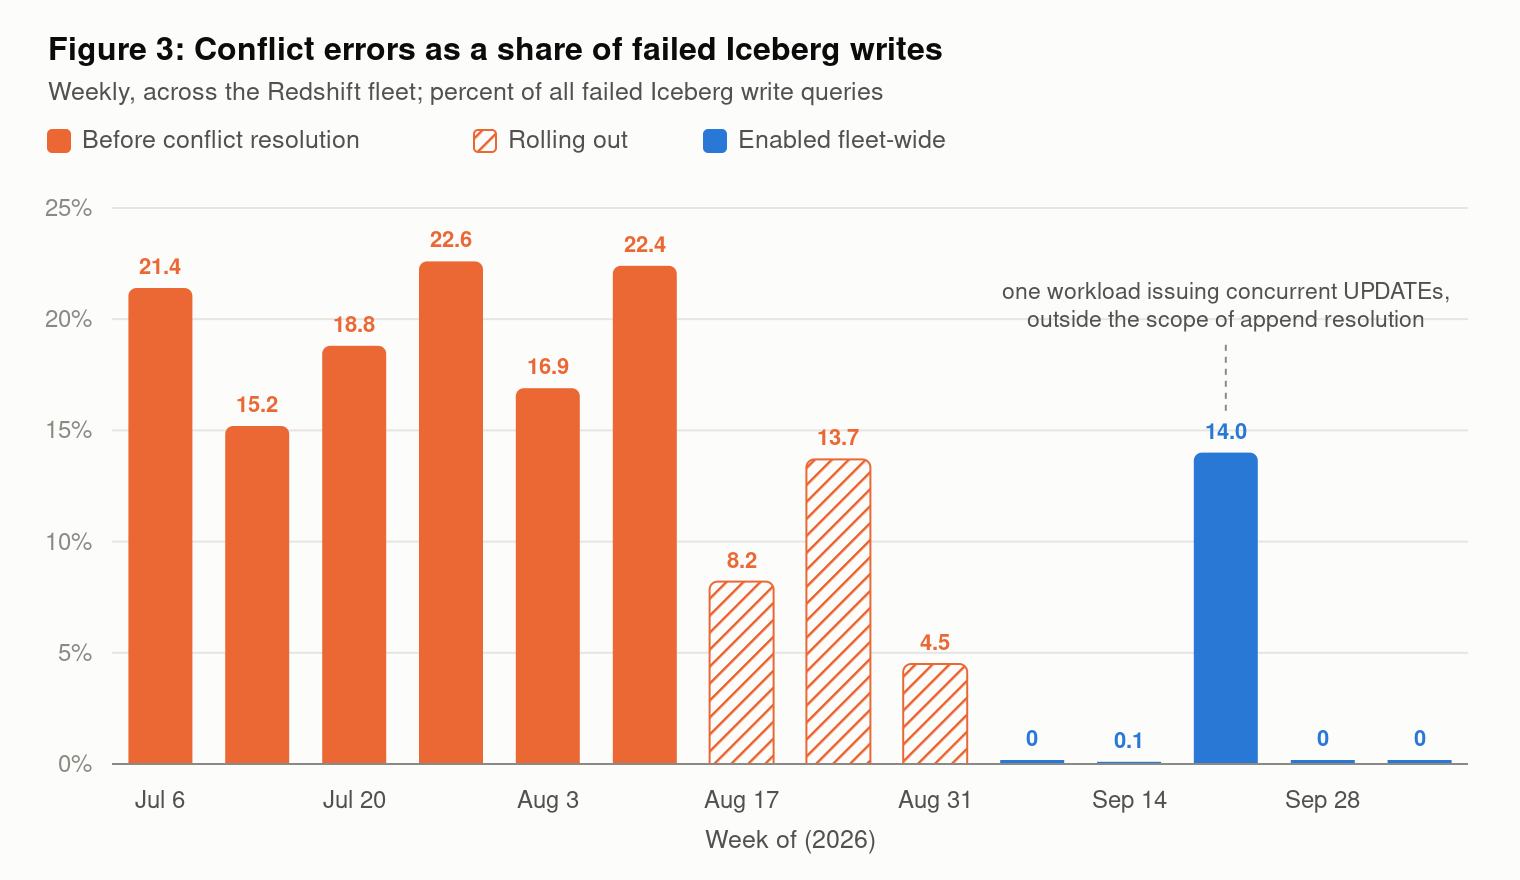
図 3: 失敗した Iceberg 書き込みに占める競合エラーの割合
競合解決の状況を確認する
Iceberg のコミットの試行はすべて stl_iceberg_commit システムテーブルに記録されます。記録される内容には、結果、試行回数、書き込みのリベース先となった同時操作、リベースにかかった時間が含まれます。サンプルのテーブルで競合解決がどのくらいの頻度で働いているかは、次のクエリで確認できます。
まとめ
同時書き込みは本番環境のデータレイクにはつきもので、これまではライターを直列化するか、問題を回避するようにテーブルを分割するか、再試行するしかありませんでした。自動競合解決により、Amazon Redshift は実際には重なっていない同時書き込みをコミットします。対象となるのは、同時に行われる追加とあらゆる書き込みとの組み合わせ、そして同じテーブルの異なるパーティションまたは異なるファイルを変更した行レベルの書き込みです。使い始めるには、パッチ 203 以降で複数のジョブから Iceberg テーブルに書き込んでください。競合しないコミットは、自動的に解決されるようになります。Amazon Redshift の Iceberg 書き込みサポートの詳細については、Part 1 と Part 2 を参照してください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Woosuk Choi がレビューしました。