Amazon Web Services ブログ
Amazon Redshift の Apache Iceberg 書き込みサポート入門 – Part 2
本記事は 2026 年 4 月 15 日 に公開された「Getting started with Apache Iceberg write support in Amazon Redshift – Part 2」を翻訳したものです。
「Amazon Redshift の Apache Iceberg 書き込みサポート入門 – Part 1」では、Apache Iceberg テーブルを作成し、Amazon Redshift からデータレイクにデータを直接書き込む方法を紹介しました。外部スキーマを設定し、Amazon Simple Storage Service (Amazon S3) と S3 Tables の両方にテーブルを作成したうえで、ACID (原子性、一貫性、独立性、永続性) 準拠を保ったまま INSERT を実行しました。
Amazon Redshift で、Amazon S3 と S3 テーブルバケットに保存された Apache Iceberg テーブルに DELETE、UPDATE、MERGE を実行できるようになりました。3 つの操作を使えば、使い慣れた SQL 構文で、トランザクションの一貫性を保ちながら行レベルでデータを変更したり、アップサートのパターンを実装したり、データのライフサイクルを管理したりできます。Amazon Redshift で複雑な変換を実行して結果を Apache Iceberg テーブルに書き込めば、Amazon EMR や Amazon Athena などの他の分析エンジンからすぐにクエリできます。
本記事では、前述の記事で作成した customer と orders のデータセットを引き続き使い、データ同期のシナリオに沿って 3 つの操作を紹介します。
ソリューションの概要
本ソリューションでは、よくあるデータ同期のパターンを例に、Amazon Redshift で Apache Iceberg テーブルに DELETE、UPDATE、MERGE を実行します。題材は、ステージングテーブルと本番テーブルにまたがる顧客レコードと注文データの管理です。ワークフローには、次の 3 つの主な操作があります。
- DELETE – オプトアウトの申し出に基づいて顧客レコードを削除する
- UPDATE – 既存の顧客情報を変更する
- MERGE – アップサートのパターンで、ステージングテーブルと本番テーブルの間で注文データを同期する
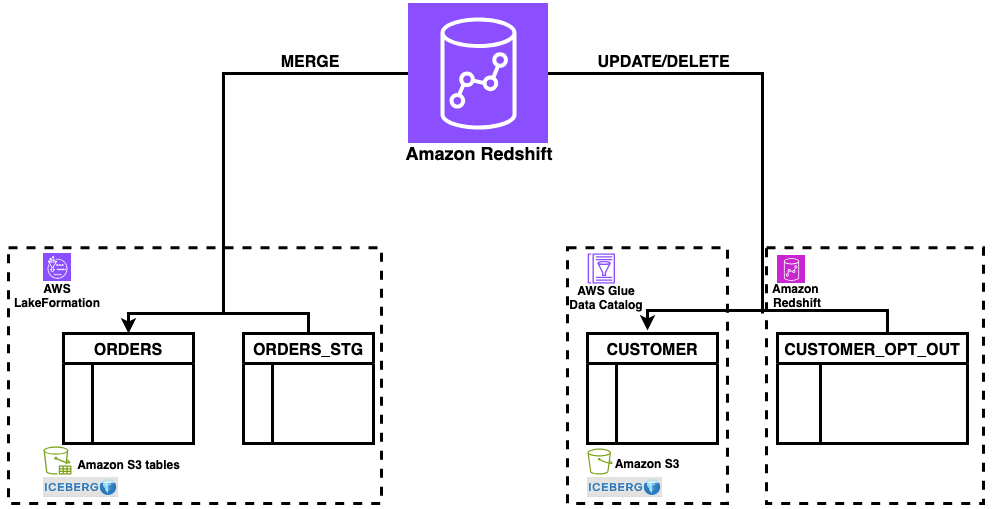
図 1: ソリューションの概要
新しく取り込むデータには S3 テーブルバケットに保存したステージングテーブル (orders_stg) を、データのライフサイクルを管理する操作には Amazon Redshift の参照テーブル (customer_opt_out) を使います。この構成なら、2 種類のストレージのどちらでも ACID 準拠を保ちながら、変更を効率よく処理できます。
前提条件
本記事の手順を進める前に、「Amazon Redshift の Apache Iceberg 書き込みサポート入門 – Part 1」のセットアップ手順を済ませておく必要があります。主な内容は次のとおりです。
- Amazon Redshift のデータウェアハウス (プロビジョニング型または Serverless) を作成する
- 必要な IAM ロール (
RedshifticebergRole) に適切な権限を設定する - Amazon S3 バケットと S3 テーブルバケットを作成する
- AWS Glue Data Catalog のデータベースを構成し、アクセスを設定する
- AWS Lake Formation の権限を設定する
- Amazon S3 の汎用バケットに、サンプルの顧客データを入れた Apache Iceberg テーブル
customerを作成する - Amazon S3 のテーブルバケットに、サンプルの注文データを入れた Apache Iceberg テーブル orders を作成する
- p200 以降のバージョンの Amazon Redshift データウェアハウスを使う
データの準備
このセクションでは、MERGE、UPDATE、DELETE の動作を確かめるためのサンプルデータを用意します。次の手順でデータを準備してください。
- Query Editor V2 の Federated user オプションで Amazon Redshift にログインします。
orders_stgテーブルとcustomer_opt_outテーブルを作成し、サンプルデータを入れます。
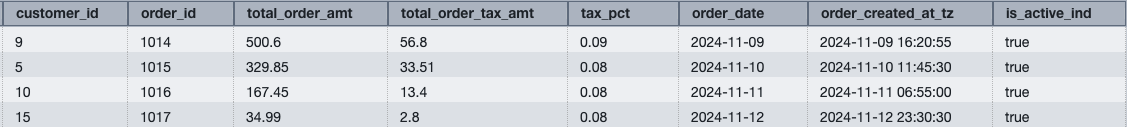
図 2: orders_stg の結果セット
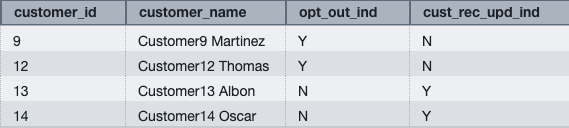
図 3: customer_opt_out の結果セット
これで、orders_stg テーブルと customer_opt_out テーブルを使って、前提条件で作成した orders テーブルと customer テーブルのデータを操作する準備が整いました。
MERGE
MERGE は、ソーステーブルとの結合の結果に基づいて、ターゲットテーブルの行を条件付きで挿入、更新、削除します。MERGE を使えば、一方のテーブルで見つかった差分に基づいてもう一方のテーブルの行を挿入、更新、削除し、2 つのテーブルを同期できます。
MERGE を実行する手順
- orders テーブルで、注文 ID 1014、1015、1016、1017 の現在のデータを確認します。このサンプルデータは Part 1 で読み込みました。

図 4: orders_stg の注文に対応する、orders テーブルの既存の注文データ
orders テーブルには、注文 ID 1014 と 1015 の行が既にあります。
- order_id をキー列にして orders テーブルと orders_stg テーブルの行を突き合わせる、次の MERGE を実行します。
既存の行 (1014 と 1015) は更新され、orders テーブルにない注文 ID (1016 と 1017) の行は新しく挿入されます。
- orders テーブルで、更新後のデータを確認します。
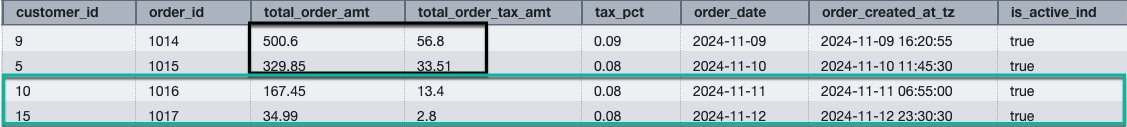
図 5: orders_stg から orders にマージされたデータ
MERGE による変更は次のとおりです。
- 既存の行の更新 – 注文 ID 1014 と 1015 の total_order_amt と total_order_tax_amt が、orders_stg テーブルの値に更新される
- 新しい行の挿入 – 注文 ID 1016 と 1017 は orders テーブルになかったため、挿入される
キー列が一致するかどうかで MERGE が行の更新と挿入を切り替える、アップサートのパターンを確認できました。
UPDATE
UPDATE は、指定した条件や別のテーブルの値に基づいて、テーブルの既存の行を変更します。
Amazon Redshift のネイティブテーブル customer_opt_out のデータを使って、Apache Iceberg テーブル customer を更新します。UPDATE では cust_rec_upd_ind 列で絞り込み、値が ‘Y’ の行だけを更新します。
UPDATE を実行する手順
customer_opt_outテーブルと、Part 1 でサンプルデータを読み込んだcustomerテーブルで、顧客 ID 13 と 14 の現在のcustomer_nameの値を確認します。
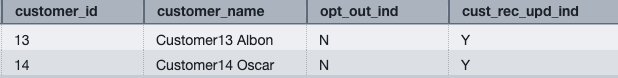
図 6: customer_opt_out にある顧客の既存データを確認
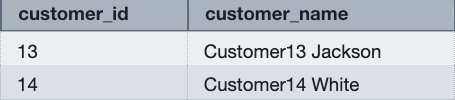
図 7: customer_opt_out にある顧客の、既存の顧客名を確認
- 次の UPDATE を実行し、
customer_opt_outのcust_rec_upd_indに基づいて顧客名を変更します。
- 顧客 ID 13 と 14 の変更を確認します。
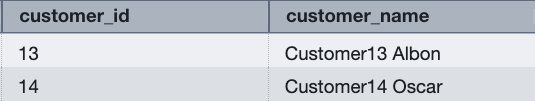
図 8: customer テーブルで更新された顧客名
UPDATE は、customer_opt_out テーブルとの結合条件に基づいて customer_name の値を変更しました。顧客 ID 13 と 14 の名前が更新され、Customer13 Albon と Customer14 Oscar になっています。
DELETE
DELETE は、指定した条件に基づいてテーブルから行を削除します。WHERE 句がない場合、DELETE はテーブルのすべての行を削除します。
Amazon Redshift のネイティブテーブル customer_opt_out のデータを使って、Apache Iceberg テーブル customer から行を削除します。DELETE では opt_out_ind 列で絞り込み、値が ‘Y’ の行だけを削除します。
DELETE を実行する手順
customer_opt_outテーブルで、オプトアウトのフラグのデータを確認します。
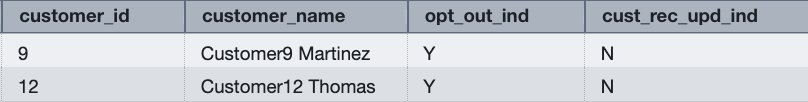
図 9: オプトアウト対象の顧客レコードを確認
- 顧客 ID 9 と 12 の現在の顧客データを確認します。
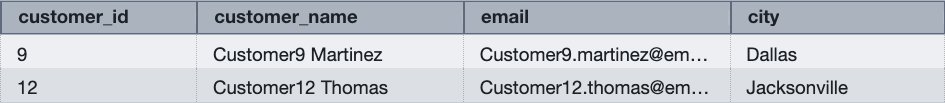
図 10: customer テーブルにあるオプトアウト対象の顧客のデータを確認
- クエリの実行計画を確認します。
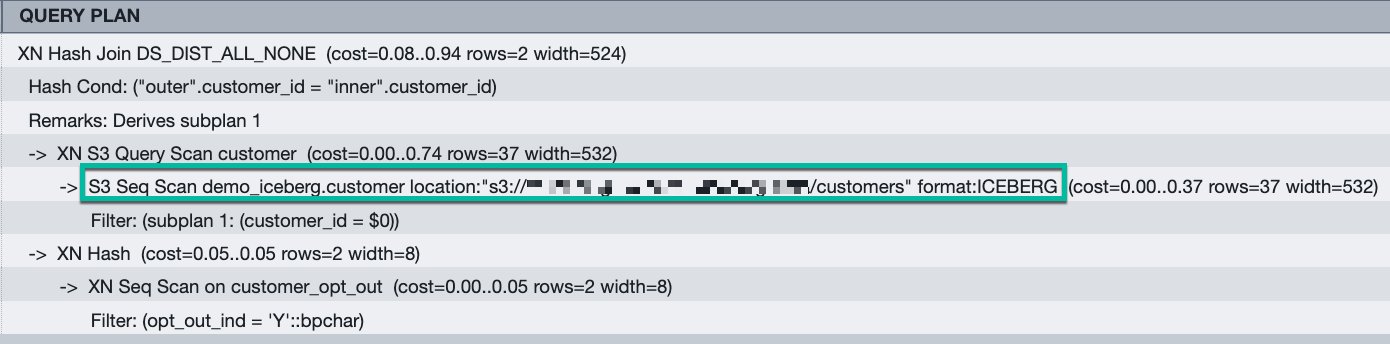
図 11: DELETE クエリの実行計画。Apache Iceberg 形式のテーブルを対象とする Amazon S3 のスキャンが実行計画に含まれており、Amazon Redshift が Amazon S3 バケットから行を直接削除することがわかります。
- 次の DELETE を実行します。
- 行が削除されたことを確認します。
図 12: 削除後に customer テーブルからオプトアウト対象の顧客を検索した結果セット
クエリは行を返さないので、顧客 ID 9 と 12 が customer テーブルから削除されたことを確認できます。
ベストプラクティス
UPDATE や DELETE を何度も実行した後は、読み取りのパフォーマンスを最適化するため、テーブルのメンテナンスを検討してください。
- AWS Glue のテーブルの場合 – AWS Glue のテーブルオプティマイザーを使います。詳しくは、AWS Glue ユーザーガイドの「Iceberg テーブルの最適化」を参照してください。
- S3 Tables の場合 – S3 Tables のメンテナンス操作を使います。詳しくは、Amazon S3 ユーザーガイドの「テーブルのメンテナンス」を参照してください。
テーブルのメンテナンスでは、Merge-on-Read の操作で生成された削除ファイルをマージしてコンパクションするので、以降の読み取りでクエリのパフォーマンスが向上します。
まとめ
Amazon Redshift が Apache Iceberg テーブルの DELETE、UPDATE、MERGE に対応したことで、データウェアハウスのパフォーマンスとデータレイクのスケーラビリティを兼ね備えたデータアーキテクチャを構築できます。ACID 準拠を保ちながら行レベルでデータを変更できるので、Apache Iceberg テーブルでも Amazon Redshift のネイティブテーブルと同じように柔軟にデータを扱えます。
始めるには
- 構文のリファレンス全体は、Amazon Redshift の Iceberg 統合に関するドキュメントで確認してください。
- 詳しい例は、「Apache Iceberg テーブルへの書き込み」を参照してください。
- AWS Glue のテーブルについては、テーブルメンテナンスのベストプラクティスを確認してください。
- クエリのパフォーマンスを高めるには、S3 Tables のメンテナンス操作を確認してください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Woosuk Choi がレビューしました。