Amazon Web Services ブログ
【寄稿】株式会社レスター、Amazon Bedrock で顧客課題とグループの解決力をつなぐ情報プラットフォームを構築
はじめに
本記事は、株式会社レスター(以下、レスター)の加瀬 友基 氏による寄稿記事です。
レスターでは、各社・各部門に分散していた営業情報を一つの土台に集める AI 情報プラットフォームを構築しています。中核となるレスターマッチングサービス(以下、RMS)は、顧客ニーズと企業・技術・製品などの解決手段を結びつけるマッチングの仕組みであると同時に、顧客・仕入先、取引実績、担当者との接点、商材、案件、議事録などを相互の関係性を保ったまま蓄積する、グループ共通のデータウェアハウスです。商談時の録音データを AI が議事録としてデータ化し、RMS へ取り込み、AI チャットボット機能で RMS 内の蓄積された情報から必要な知見を引き出します。これにより、ある部門がつかんだ顧客課題を、別部門が持つ人・商材・技術へつなげます。本稿では、この仕組みを構築した背景、Amazon Web Services(以下、AWS)の活用、そして情報を蓄積し続けるための運用についてご紹介します。
レスターとは
レスターグループは、「情報と技術で、新しい価値、サービスを創造・提供し、社会の発展に貢献します」の経営理念のもと、半導体・電子部品の販売・ソリューション提供をはじめ、映像・音響・通信機器の取り扱い、太陽光発電などの再生可能エネルギーの企画・オペレーション、完全閉鎖型植物工場の運営、ソフトウェア開発、産業用PCの設計・製造など多岐にわたる事業活動を行っています。
グループの多様な強みを一つの提案力に変えるために
事業領域の拡大とグループ再編の結果、グループが持つ顧客基盤、商材、技術、知見は大きく広がりました。一方で、各社・各事業は、もともとの顧客や商流、情報の持ち方、業務プロセスが異なります。子会社・事業・部門が「どの顧客と接点を持ち、何を得意とし、どのような商材や知見を持つのか」を、日々の営業活動の中で十分に把握することは容易ではありませんでした。
お客様の課題は、必ずしも一つの事業領域だけで完結するものではありません。グループ内に解決手段があっても、必要な情報や担当者にたどり着けなければ、提案にはつながりません。グループの多様な強みを一つの提案力に変えるためには、会社・事業・部門を越えて情報を見つけ、活用できる仕組みが必要です。レスターは「あらゆるニーズに対応できる『エレクトロニクスの情報プラットフォーマー』」をビジョンに掲げています。このビジョンが目指しているのは、例えばステークホルダーの課題を自部門の知識だけで答えるのではなく、グループ全体から最適な人・商材・技術を探し出し、事業横断で提案できる状態を指しています。一つひとつの顧客課題と、グループが持つ多様な解決力を結び付け、あらゆるニーズに応えられるエレクトロニクスの総合商社へと進化することを目指しています。
現場で起きていた、4 つの情報の断絶
背景にある課題を営業の現場で分解すると、単に情報が複数のシステムへ分散していたというだけではありません。会社・事業・部門の境界を越えて、情報の所在と文脈を理解し、次の行動へ移すまでの各段階に断絶がありました。
- 商談内容の属人化: 商談の詳細は個人のメモやファイルに残り、組織の知識になりにくい
- SFA では残らない文脈: 営業支援システム(SFA)は案件金額や進捗管理に有効でも、顧客の背景や会話の文脈までは十分に残りにくい
- グループ理解の属人化: 会社・事業への理解が担当者の経験に依存し、他部門の得意分野、取扱商材、顧客接点まで把握しにくい
- 訪問前準備の負荷: 情報収集が担当者の経験と人脈に依存し、訪問前準備に時間がかかる
この状態でチャットボットだけを導入しても、参照する情報が古い、少ない、偏っているという問題は解消しません。私たちは、情報が生まれる現場から、会社・事業を越えた蓄積、検索、提案までをつなぐ必要があると考えました。
RMS を中核に、商談の会話から次の提案までをつなぐ
こうした 4 つの情報の断絶を解消するため、情報の流れを「データ化する」「蓄積・統合する」「引き出し、提案へつなぐ」の 3 段階に整理しました。それぞれを AI 議事録、RMS、AI チャットボットが担い、商談で得た情報が次の提案に使われるまでを一本につなぎます。

図 1:顧客課題とグループの解決力をつなぐ情報プラットフォーム
1. AI 議事録:会話を「検索できる営業資産」に変える
AI 議事録では、オンライン会議や対面商談の録音データと、会議で使用した資料を取り込みます。音声ファイルを Amazon Simple Storage Service (Amazon S3) に保存し、Amazon Transcribe で文字起こしと話者分離を行います。その結果を Amazon Bedrock 上の Anthropic Claude に渡し、会議概要、発言内容、顧客課題、決定事項、次回アクションなどを所定の形式で整理します。生成した議事録や案件情報は、必要に応じて RMS や SFA へ連携します。
Amazon Transcribe では、独自の音声認識モデルを構築することなく音声をテキスト化し、話者分離によって複数人の会議を発言者単位で整理できます。Amazon Bedrock については、社内外の商談情報を扱うため、安全性と統制を効かせながら生成 AI を利用できる点を重視しました。
従来、議事録は会議後の記録作業でした。今回の構想では、議事録を営業データの入口と位置づけています。会話には、顧客の言葉、困りごとの背景、検討状況、関係者、次の打ち手といった、SFA の数値項目だけでは表現しきれない鮮度の高い情報が含まれるためです。
2. RMS:全社の営業情報をつなぐデータウェアハウス
RMS には、顧客・仕入先の基礎情報、取引実績、名刺・接点、従業員、商材、SFA の商談情報、Web サイト経由の問い合わせ、そして AI 議事録などを集約しています。単にファイルを保管するのではなく、顧客、担当者、商材、課題、案件の関係性を保ったまま蓄積することが特徴です。
この構造により、顧客を起点に、グループ各社の取引実績、過去の商談、社内の担当者、関連する商材や解決策を横断的にたどることができます。部門ごとに分かれていた情報を、次の提案に使える形で結びつけることが RMS の役割です。
また、レスターグループ各社で取り扱っている多様な商材ごとにビジネスオーナーを置き、内容の最新化、公開範囲、分類を管理する運用を整えています。AI の回答品質は、モデルの性能だけでなく、参照データの鮮度と網羅性に左右されます。そのため、コンテンツマネジメントをシステム運用の一部ではなく、事業側の役割として設計しました。
3. AI チャットボット:必要な情報を引き出し、次の一手へつなぐ
AI チャットボットは、RMS に蓄積された情報を業務で使うための対話型インターフェースです。LangGraph で構築した AI エージェントを Amazon Bedrock AgentCore Runtime 上で動作させ、RMS から呼び出した回答をストリーミング表示します。独自に設計した検索・回答の処理を維持しながら、AWS 上の実行環境として RMS と連携できる点を評価しました。
社内文書や議事録の検索には、Amazon Bedrock Knowledge Bases と、そのベクトルストアである Amazon OpenSearch Serverless を利用しています。Amazon S3 は元データの保管先であり、質問のたびにファイルを直接検索するのではありません。会社、商材、案件、担当者などの構造化データが必要な場合は、Catalog API を通じて PostgreSQL から取得します。標準設定では外部 Web 検索を行わず、社内情報に基づく回答を優先しています。
代表的な利用シーンは次の通りです。
- 訪問前準備: 対象企業の取引実績、接点、過去の議事録、進行中の商談をまとめる
- クロスセル: 別部門の議事録にある潜在ニーズと、グループ内の商材・ソリューションを結びつける
- 提案準備: 顧客の状況に応じた提案の骨子やトークスクリプトを作る
- 社内探索: 商材の担当者、類似案件の経験者、協業可能な部門を探す
利用場面に応じたボタンを用意しており、選択すると「明日この会社へ訪問するので、グループ全体の取引と商談を整理して」といった質問文が自動入力されます。利用者は最初から精緻なプロンプトを書く必要はなく、回答を見ながら追加質問で深掘りできます。回答は結論ではなく、営業が原典や担当者を確認し、次の行動を考えるための出発点です。
AWS を活用した構成と、安全な利用のための設計
AWS を採用した理由は、音声データの保管、文字起こし、議事録の生成、社内情報の検索、回答生成までを、一つのクラウド環境で連携できることです。Amazon S3、Amazon Transcribe、Amazon Bedrock、Amazon Bedrock Knowledge Bases、Amazon OpenSearch Serverless、Amazon Bedrock AgentCore Runtime を組み合わせることで、システム間連携の複雑さを抑えながら、情報が増え続ける前提の基盤を構築しました。また、当社の汎用生成 AI 環境では、AWS がオープンソースで公開する Generative AI Use Cases(GenU)も活用し、そこで得た知見を社内ユースケースの設計に生かしています。
図 2 は、RMS、AI 議事録、AI チャットボットと、今回利用している主な AWS サービスの関係を示したものです。
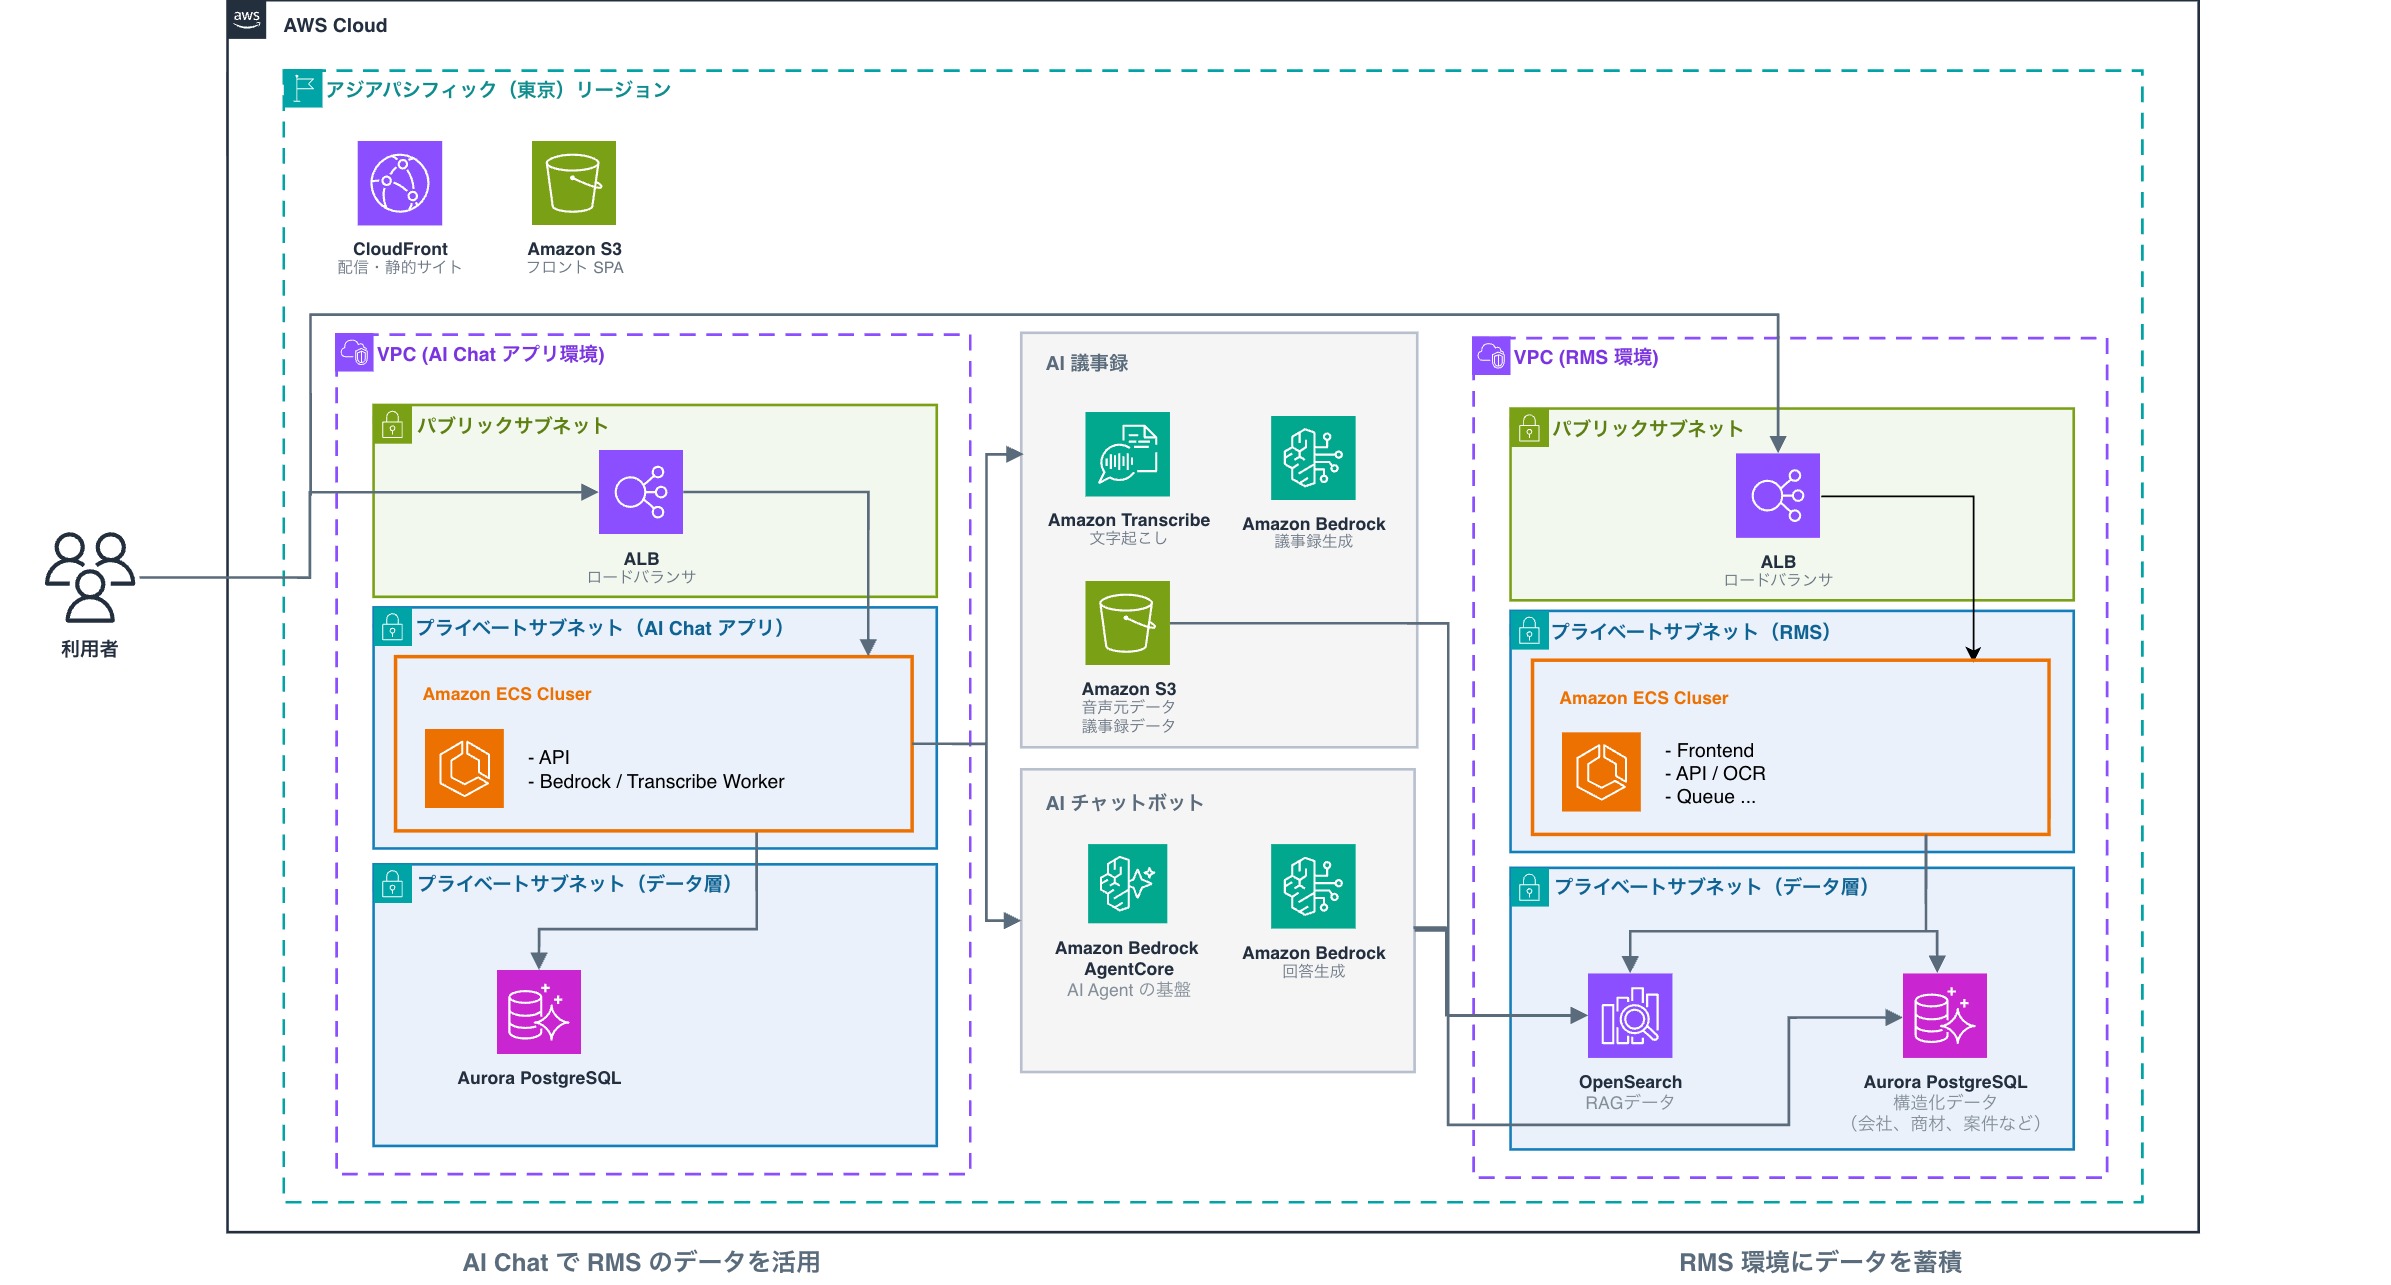
図 2:AI 情報プラットフォームの AWS アーキテクチャ
主な AWS サービスと役割
- Amazon S3: 音声・資料・正規化済みドキュメントの保管
- Amazon Transcribe: 音声の文字起こしと話者分離
- Amazon Bedrock: Anthropic Claude による議事録の要約・構造化と、チャット回答の生成
- Amazon Bedrock AgentCore Runtime: LangGraph で構築した AI エージェントの実行
- Amazon Bedrock Knowledge Bases / Amazon OpenSearch Serverless: 社内文書・議事録の RAG 検索
Amazon Bedrock では、入力したデータや生成結果が基本モデルの改善に使用されることはなく、モデルプロバイダーと共有されることもありません。また、Amazon Bedrock 内のデータは転送中も保管中も暗号化されます。商談や取引に関する情報を扱うため、こうした AWS 側の仕組みに加え、レスター独自の権限設定と運用ルールを設けています。主な対策は次の通りです。
- 録音時の同意: 社外商談は事前に相手先の許可を得る
- 参照対象の選択: 議事録ごとに社内 AI チャットボット回答時の参照対象へ含めるかを選択し、秘匿性の高い会議は除外する
- 競合情報の制御: 担当サプライヤーに応じて競合情報の閲覧を制限する仕組みを設ける
- 人による最終判断: AI 回答は参考情報として扱い、重要な判断や社外提出前には原典・担当部署を確認する
特に、「AI に学習させる」という言葉は、モデル自体の追加学習と RAG での参照を混同しやすいため、運用説明では「社内 AI 回答時の参照対象に含めるか」と表現するようにしています。技術的な安全性だけでなく、利用者が誤解しない言葉を選ぶことも重要だと考えています。
導入で難しかったのは、技術よりも「情報が集まり続ける運用」
AI チャットボットの回答は、参照する情報以上には良くなりません。特定の利用者だけが議事録を登録すれば、回答もその部門や担当者に偏ります。商材情報が更新されなければ、AI は古い内容を基に回答します。
そこで、半導体・電子部品を扱うデバイス事業部門から段階的に利用を開始し、社員を対象とした説明会(延べ 500 名以上が参加)、商材ビジネスオーナーへの登録レクチャー、利用フィードバックの回収を実施しました。スマートフォンから録音・登録できる導線も整え、現場が無理なく情報を残せるよう改善を続けています。
運用上の学び: 情報を集めたい運営側は入力項目を増やしがちですが、現場はまず「楽になること」を求めます。AI 議事録で日常業務の負担を下げ、その結果として質の高いデータが蓄積される順序が重要でした。
現在の活用と、見えてきた効果
情報を蓄積する側では、AI 議事録が営業データの入口として回り始めています。社内調査を基に、1 件あたり約 23 分の議事録作成時間を削減できると試算しており、2026 年 7 月現在、月間 2,000 件を超える議事録が作成されています。ただし、私たちが重視しているのは削減時間よりも、毎月 2,000 件を超える商談・会議の情報が、統一形式で検索・分析・再利用できるデータとして蓄積されていく点です。長期的にはこちらの方が大きな価値を生むと考えています。
情報を引き出す側では、2026 年 6 月に AI チャットボットを公開し、利用データと現場の声を基にチューニングを続けています。RMS には取引・接点情報、AI 議事録、SFA 情報、商材情報などが連携され、これまで人に聞くか複数システムを調べていた作業を、1 つの対話画面から始められるようになりました。たとえば、訪問先についてグループ内の取引金額と担当者、過去の商談経緯をまとめる、別部門の顧客課題に対して自部門のソリューションを提案できないか探索する、特定製品を扱う担当者と関連商材を同時に確認する、といった使い方が始まっています。
一方で、現時点は完成形ではありません。登録されていない取引や議事録があれば回答には現れず、情報を入力する利用者が偏れば結果にも偏りが出ます。こうした不足を可視化し、システム、データ、運用の 3 つを同時に改善できることも、パイロット運用の成果だと捉えています。
今後の展開:事業横断で、提案と行動を生む基盤へ
生成 AI を業務に定着させるために必要なのは、高性能なモデルだけではなく、日常業務の中で情報が生まれ、整い、使われ、更新され続ける仕組みです。AWS では、AI を安全に利用するための機能が揃っており、新しい機能も継続的に追加されるという点で、当社の取り組みのような社内横断的な情報の整備、AI 活用を推し進めることができると考えています。今後は、顧客ニーズとグループ内の商材を継続的に照合し、AI が提案候補や新規開拓リストを提示する仕組み、部門を越えて適切な担当者や知見へつなぐ仕組みも検討しており、実際の利用状況と蓄積データを見ながら、顧客・商談・商材・担当者・議事録の関係性をより活用しやすい形へ発展させます。
営業担当者個人の経験や人脈だけに依存せず、ある部門が捉えた顧客課題を、別部門の商材やソリューションへつなげます。半導体・電子部品からシステム、映像・通信、エネルギーまで、レスターグループが持つ幅広い解決手段を一つの営業基盤から活用できる状態を目指します。目指しているのは、社内検索の効率化だけではありません。顧客との会話から課題を捉え、グループ全体の知識と解決手段を組み合わせ、顧客自身も気づいていない潜在ニーズに対して最適な解決策を提案できる営業基盤です。その結果として、新しい顧客と新しいビジネスが継続的に生まれる状態を目指します。
おわりに
レスターが構築しているのは、単体のチャットボットではなく、営業活動で生まれた情報を会社の資産に変え、再び営業へ戻す仕組みです。商談の会話がデータになり、関係性を保ったまま蓄積され、必要なときに引き出される。この循環が回るほど、商談を重ねた分だけ会社の知識が積み上がり、事業横断の提案力が高まります。AWS のサービスを活用しながら、この情報循環をレスターグループ全体へ広げ、各事業の強みを一つの提案力へ変えていきます。「まずレスターに相談すれば、解決の糸口が見つかる」という世界を実現し、「エレクトロニクスの情報プラットフォーマー」というビジョンにつなげていきます。
著者について
 |
加瀬 友基(Yuki Kase)株式会社レスター Data Analysis Management |