AWS JAPAN APN ブログ
AI エージェントが約 3 分で障害の初期見立てを提示:ハートビーツによる AWS DevOps Agent 活用
この記事は、以下の 4 名による共著です。
- 株式会社ハートビーツ エンジニアリングチーム マネージャー 佐藤 司
- 株式会社ハートビーツ エンジニアリングチーム チームマネージャー 北岡 俊樹
- 株式会社ハートビーツ 運用チーム チームマネージャー 上筋 蒼
- アマゾン ウェブ サービス ジャパン合同会社 パートナーソリューションアーキテクト 尾﨑 周也
本稿では、株式会社ハートビーツが AWS DevOps Agent を MSP(Managed Service Provider)運用のうちアラート調査業務に適用した検証事例を紹介します。ハートビーツは AWS でのマネージドセキュリティサービスを AWS MSSP(Managed Security Service Provider)コンピテンシーパートナーとして提供するとともに、マルチクラウド/オンプレミス環境での MSP サービスを手掛けています。
1. MSP 運用の課題と検証の背景
MSP における監視業務では、監視アラートの一次切り分けがエンジニアの手作業に依存しています。ハートビーツではこの課題の解決策として AWS DevOps Agent の適用を検証しました。
ハートビーツの運用チームでは、監視アラートが発報されるたびに、当番エンジニアがサーバーへログインして手順書に基づき負荷・ディスク・ログなどを確認し、過去の対応履歴と突き合わせ、一次切り分けを行ってきました。1 件あたり約 10〜20 分を要しており、案件が増える中で、調査の負担を抑えつつ、初動の品質を揃える必要がありました。課題は、手作業による一次切り分けの負担、監視仕様や過去の対応履歴が複数のツールに分散していること、担当者の経験への依存です。そこで「どのアラートも、発報した瞬間に、経験豊富なシニアエンジニアと同等レベルの『最初の見立て』がチャットツールに出る」ことを目標に掲げました。
なお、顧客システムを預かる立場として、万が一のエージェントの誤判断がサービス影響に直結するリスクを排除するため、本取り組みは「調査は AI、判断は人」という advise-only を原則としています。エージェントが行うのは読み取りによる調査と、見立て・推奨手順の提示までです。対応の要否や優先度の最終判断、サービスの再起動や設定変更といった実施、顧客への連絡は必ず人が行います。
2. AWS DevOps Agent の概要
AWS DevOps Agent は、インシデントへの自律対応とその予防を運用チームメンバーとして行う Frontier Agents です。アラートや障害チケットが発生した瞬間に調査を自動開始し、テレメトリ・コード変更・デプロイ履歴を横断的に相関分析して根本原因を特定、具体的な復旧アクションを含む緩和計画を出力します。調査完了後は蓄積した調査履歴を基に再発防止の改善提案も行い、運用の継続改善を支援します。なお DevOps Agent はデフォルトでは読み取りしか行わない read-only の設計です。変更を伴う操作は、明示的に有効化したうえで人が承認したときにだけ実行されます。本稿ではこのデフォルトのまま、変更操作を有効にせずに利用しています。
DevOps Agent では、エージェントがアクセスできるツールやインフラの範囲を Agent Space と呼ばれる論理コンテナで管理します。ハートビーツではこの Agent Space を案件単位で分離し、各コンテナに案件固有の調査手順や監視ガイダンスを Skills として登録することで、調査の精度を高めています。Skills はエージェントが調査時に参照する知識です。登録しているのは 3 種類です。案件ごとの監視仕様書、監視設定そのもの、そして過去の対応履歴です。監視仕様書には監視項目の意味・閾値・アラート時の確認手順が含まれ、監視設定はどのホストにどの監視が付いているかを示し、対応履歴は同種のアラートに人がどう対処したかの記録です。いずれも元は人が読むために書かれた資料で、そのまま渡しても量が多く目的の記述にたどり着けません。エージェントが参照しやすい粒度に整えたうえで登録し、原本が変わったら自動で追従させます。この作り込みによる精度の向上について 5 章で紹介します。
3. アーキテクチャと運用設計
DevOps Agent を既存の運用に組み込むにあたり、Nagios などの監視システムはそのまま稼働させつつ、そこから送られてくるアラートを共通形式に正規化し、案件ごとの Agent Space へ振り分ける仕組み(以下、アラート受付基盤)を新たに AWS 上に構築しました。
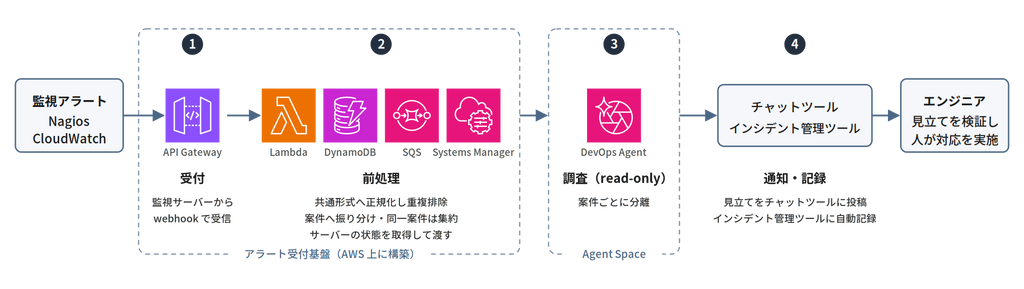
図 1. AWS DevOps Agent によるアラート調査フロー
運用設計の要点は次の通りです。
- 案件コードを識別子にする: Nagios のホストグループ名の先頭部分をそのまま案件コード、すなわち顧客案件を識別する社内 ID として扱い、案件コードごとに Agent Space を対応付けています。監視・チケット・エージェントを 1 つのコードで結び、追加の案件マッピングを不要にしました。
- いったんキューで受けてから渡す(ノイズ制御と相関分析): 本構成では、受け付けたアラートをいったんキューに保持し、既存のアラート基盤で重複を排除します。短時間に発報と復旧を繰り返すアラート、いわゆるフラッピングは調査を起動せず通知にとどめ、同一案件の関連アラートは短時間待ち合わせて 1 回の調査に集約します。たとえば、共有ストレージの障害で 3 台のサーバーが同時に発報した場合は、個別に 3 回調査するのではなく、まとめて共通の原因を調べるよう促します。DevOps Agent にも関連インシデントのリンクや条件に応じた調査スキップの機能がありますが、本構成では既存基盤の機能を活用しました。調査すべき情報をまとめて渡す設計にすることで、不要な起動を抑えながら、関連する症状を一緒に分析できるようにしています。
- AWS 以外のリソースも同じフローに載せる: ハートビーツでは Google Cloud、Microsoft Azure、オンプレミスの環境も運用しています。本構成では AWS 以外の状態をアラート受付基盤側で収集し、AWS のリソース情報と同じ形式に整えてエージェントへ渡します。たとえば Google Cloud のメトリクスは Cloud Monitoring から取得し、オンプレミスのサーバーの状態は AWS Systems Manager を介して収集します。Google Cloud への認証には Workload Identity Federation を用い、受付基盤の AWS 側の実行ロールから必要な認証情報を取得します。権限はメトリクスの読み取りに限定しています。後述の 3 クラウドにまたがるクラスタの調査も、このデータ収集を前提としています。
統制の観点では、顧客システムを預かる MSP として、エージェントの行動範囲を運用ルールではなく技術的な仕組みで制限しています。
- Agent Space の案件分離: Agent Space を案件単位で分離し、参照用 IAM ロールと Skills もそれぞれ案件ごとに用意することで、エージェントがアクセスできる情報とリソースを必要な範囲に制限します。案件固有の知見を活用しながら、案件をまたいだ情報の参照を防ぐ設計です。
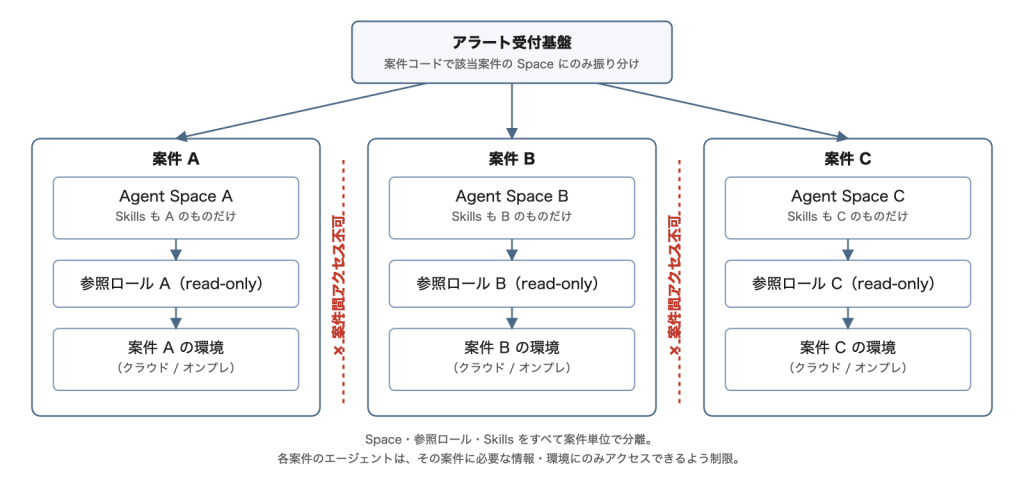
図 2. Agent Space による案件単位の分離設計
- 読み取り専用のガードレール: 前述の通り DevOps Agent はデフォルトでは読み取りしか行いません。そのうえで、サーバーの内部を調べる部分にも別の制限をかけています。サーバーで実行するコマンドは AWS Systems Manager に登録した状態確認用の固定コマンドだけです。これを実行するのはアラート受付基盤で、エージェントはその結果を受け取るだけでサーバーへコマンドを送ることはありません。
- 出力先の制限と監査: 調査結果の出力先を社内のチャットツールとインシデント管理ツールに限定しています。顧客環境への変更や顧客向けの発信は人が行い、エージェントの操作や参照内容は監査ログで確認できるようにしています。
4. 検証結果
この仕組みを検証するため、社内で運用する 9 案件・計 36 台(Amazon EC2、Azure 上の VM の両環境を含む)を対象にパイロット検証を行い、調査(Investigation)を 30 件実行しました。
当初は、発報した指標の判定は正確な一方で、周辺の異常(ディスクの逼迫やサービスの停止)を見落とすことがありました。原因はエージェントの能力ではなく渡す情報と指示の不足にあり、これらを段階的に改善した結果、評価対象としたすべての調査で、運用チームが一次切り分けに使える水準の見立てを確認できました。
本検証で確かめたかったのは、精度の数字そのものではなく運用チームの初動がどう変わるかです。当番の仕事が「ゼロから調べる」から「見立てを検証する」へ変わったことが最大の変化です。
具体例(実際に発報したアラート): 深夜 23 時台、AWS・Google Cloud・Azure の 3 つのクラウドにまたがる社内データベースクラスタの 1 台で、データ複製を行うレプリケーションの異常を検知するアラートが発報したケースです。
エージェントはまず CPU・メモリ・ディスクの実測値から OS 側に異常がないことを確かめ、「サーバーではなくレプリケーション機能そのものの障害」と高い確信度で絞り込みました。さらに、3 日前に同じクラスタの別ノードで発報していた疎通異常の履歴を引用して前兆の可能性を指摘し、本題とは別に「自動セキュリティ更新が数週間失敗し続けている」という隠れた問題も発見しています。推奨手順には「プライマリノードの場合は特に慎重に」という運用上の注意点まで含まれ、発報からレポートの到着まで 2 分 53 秒で完了しました。深夜の当番が着手する前に「何をどの順で確認すべきか」が手元に揃っていた形です。DevOps Agent は表面的な症状で止まらず、収集した全データから根本原因の仮説まで一気に組み立てます。この点が単なる閾値通知との決定的な違いであり、経験豊富なシニアエンジニアが行うような観点を含む見立てとして、実用水準に達していました。
同時多発への対応も実運用で機能しています。ある朝、外部の死活監視と内部の監視から 6 件のアラートが同時に発報した際は、アラート受付基盤が 1 回の調査にまとめ、エージェントは外部と内部の症状を突き合わせて原因仮説を確度順に提示したうえで、過去 1 週間の発報履歴との照合から「同じパターンの再発傾向があり、根本原因が未解決」という指摘まで行いました。
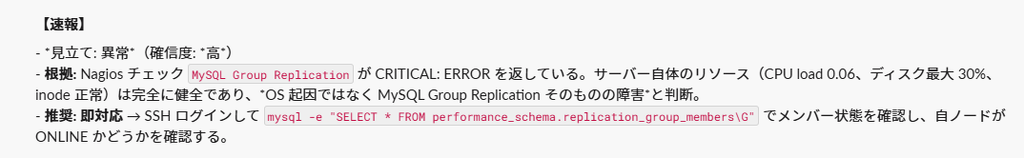
図 3. レプリケーション障害のトラブルシューティング
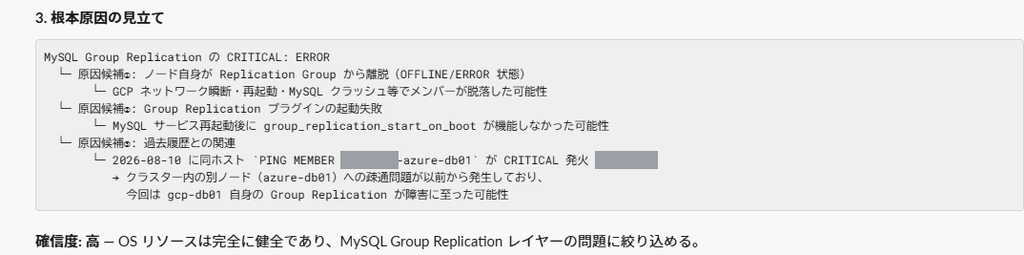
図 4. 根本原因の信頼度評価
5. DevOps Agent 導入のポイント
DevOps Agent を実際に活用する中で、調査の精度を高めながら意図通りのふるまいをさせ、コストを抑えるためには次の 5 点が重要であるとわかりました。
- 渡す情報が精度を決める: 初期はアラートが発報した数値、たとえば CPU 使用率のみを渡していたため、分析範囲が限定されていました。そこで、各ディスクの使用状況・停止中のサービス・ログなどの周辺情報を併せて渡す仕組みへ変更し、プロンプトで「全データを走査して隣接する異常も指摘すること」を明示的に指示した結果、見立ての精度が大きく向上しました。改善のたびに同じサーバーへテスト発報を行い、以前は見落としていた異常を拾えるようになったことを確認しながら進めました。また、一度に渡せる情報量には上限があるため、重要な情報から先に載せる「順序の設計」も効きました。エージェントは渡されていないものを見ることができません。本検証では、入力する情報と指示の改善が、見立ての品質向上につながりました。
- Skills は渡し方まで設計する: 案件ごとの監視仕様書は、監視項目の意味と閾値、アラートが出たときの確認手順、障害時の復旧手順を章立てでまとめたドキュメントです。人が読むために書かれているので、1 案件で数万字になります。そのまま渡せば、発報した項目と関係のない記述が限られた枠を埋めてしまいます。そこで渡し方を 2 系統にしました。全文は Skills として登録し、エージェントが必要に応じて参照できるようにしておきます。これに加えて、調査を起動するときのプロンプトに、発報した監視項目に該当する章と、そこが参照している復旧手順だけを抜き出して入れています。Skills だけでも動きますが、エージェントが該当箇所を引き当てられないと手順が届きません。プロンプトに入れておけば、発報した項目の手順は必ず手元にあります。原本の章立ては案件によって揃っていないため、章構造を読み取れないときは先頭から一定量を切り出す方式に落とします。
- 出力を標準化する: 「結論を先に」を原則に、調査を起動する際の指示(プロンプト)に出力テンプレートを含めて渡し、見立てを速報→発報の検証→周辺の異常→根本原因→推奨アクション→エスカレーション要否の順に固定しています。毎回同じ形式で届くため、当番は「どこに何が書いてあるか」を覚えられ、最初の数行だけで様子見か対応かを判断できます。この出力形式を Skills としてではなくプロンプトに置いているのは、案件によって変わらないからです。監視仕様書のように案件ごとに異なるものは Skills として登録し、全案件で共通の指示は起動時のプロンプトで渡します。こう分けておくと、テンプレートを直したときに全案件へ一度に反映できます。実はこの「結論が先」は運用チームからの要望で後から直した点で、当初は生の調査ログが先頭に並ぶ読みにくいレポートでした。使う人の読み方に合わせた出力設計は、見立ての精度と並んで現場への定着を左右します。
- 暗黙知を資産化する: Skills の更新は 2 系統で自動化しています。1 つ目は監視仕様書です。案件ごとの原本はドキュメント管理のリポジトリにあり、そこが更新されると CI が動いて該当案件の Agent Space の Skills を書き換えます。人が登録し直す必要はなく、原本を直せばエージェントの参照先も変わります。2 つ目は過去の対応履歴です。インシデント管理ツールに溜まったチケットを日次で案件別に読み、症状・原因・対処の 3 点にまとめ直してから Skills に反映します。全文をそのまま渡すと量が多く、必要な事例を見つけにくいためです。人が読んで学ぶための資料が「エージェントが毎回の調査で参照する Skills」に変わり、対応を重ねるほど参照できる事例が増え、見立ての根拠が厚くなる循環ができました。類似のアラートでは、過去の対応事例が根拠として引用されます。
- コストは「起動を減らす・短くする設計」が効く: DevOps Agent はエージェントの実行時間に応じた課金のため、調査の回数と時間を抑える設計がそのまま費用削減になります。重複排除と集約は調査の回数を減らし、緊急度に応じて調査の深さを 2 段階に分けることで 1 回あたりの時間を短くします。緊急度の低いアラート向けには簡易的な調査を実行するようにしています。実測でフル分析の約半分の時間で完了しており、調査コストの増加を抑えられる見通しです。
6. 今後の展望
現在は社内システムでの実運用に加えて、顧客案件への展開を進めています。顧客環境に変更を加えない範囲から始め、了承をいただいた案件から順次広げています。中期的には、過去チケットやメール履歴との連携で見立ての根拠をさらに厚くし、どの顧客・どの環境からのアラートでも、発報した瞬間に信頼できる最初の見立てが届く状態を目指しています。
まとめ
ハートビーツは AI エージェントを「人の判断を置き換えるもの」ではなく「エンジニアの初動を戦力増幅するもの」と位置づけています。AWS DevOps Agent と既存の監視・チケット運用を組み合わせることで、属人化していた一次切り分けを、read-only と案件分離で安全性を技術的に担保しながら仕組みに落とし込みました。どの案件でも一定品質の初動を数分で提供できる見通しが得られたことが、本検証の成果です。同じ課題を持つパートナー・運用チームの皆さまの一助になれば幸いです。
MSP 運用の効率化や AWS DevOps Agent の活用にご関心のある方は、ぜひハートビーツまでお気軽にお問い合わせください。
ハートビーツ – AWS パートナースポットライト
ハートビーツはお客様が提供されている Web サービスのインフラにおける導入・設計・構築から日々のサーバー管理者作業・24 時間 365 日有人監視・運用保守までをマネージドサービスでご提供します。クラウドを始め豊富なサーバー管理の経験と知識を持った専門エンジニアがお客様のインフラ運用に関する業務の負担軽減をお手伝いいたします。