Amazon Web Services 한국 블로그
Amazon EC2 P6-B300 인스턴스, 서울 리전 정식 출시 – NVIDIA Blackwell Ultra GPU 기반
오늘부터 아시아 태평양(서울) 리전에서 Amazon Elastic Cloud Compute(Amazon EC2) P6-B300 인스턴스가 cnftl 됩니다. P6-B300 인스턴스는 8개의 NVIDIA Blackwell Ultra GPU를 제공하며, 2.1TB 고대역폭 GPU 메모리, 6.4 Tbps EFA 네트워킹, 300 Gbps 전용 ENA 처리량, 4TB 시스템 메모리를 지원합니다.
P6-B300 인스턴스는 P6-B200 인스턴스에 비해 2배의 네트워킹 대역폭, 1.5배의 GPU 메모리 크기, 1.5배의 GPU TFLOPS(희소성 없음 FP4 기준)를 제공하여, 정교한 기법으로 대규모 수조 매개변수 기초 모델(FM)과 대형 언어 모델(LLM)을 학습 및 배포하는 데 매우 적합합니다. 더 높은 네트워킹과 더 큰 메모리는 더 빠른 학습 시간과 더 많은 토큰 처리량을 AI 워크로드에 제공합니다.
향상된 성능 덕분에 P6-B300 인스턴스는 Mixture of Expert(MoE)와 멀티모달 프로세싱처럼 정교한 기술이 필요한 대규모 AI 모델을 훈련하고 지원하는 데 특히 적합합니다. 이 인스턴스는 1조 단위의 파라미터 모델을 사용하고 수천 개의 GPU에 분산 훈련을 해야 하는 조직에게 완벽하게 균형 잡힌 컴퓨팅, 메모리, 네트워킹 기능을 제공합니다.
EC2 P6-B300 인스턴스의 사양은 다음과 같습니다.
| 인스턴스 크기 | VCPU | 시스템 메모리 | GPU | GPU 메모리 | GPU 간 상호 연결 | EFA 네트워크 대역폭 | ENA 대역폭 | EBS 대역폭 | 로컬 스토리지 |
| P6-B300.48xLarge | 192 | 4TB | 8x B300 GPU | 2,144GB HBM3e | 1,800GB/s | 6.4Tbps | 300Gbps | 100Gbps | 8x 3.84TB |
영구 스토리지의 경우, AI 워크로드는 가격 대비 성능을 고려하여 주로 Amazon FSx for Lustre, Amazon S3 Express One Zone, Amazon Elastic Block Store(Amazon EBS) 등의 고성능 영구 스토리지 옵션 조합을 사용합니다. 예를 들어, P6-B300 기반의 전용 300Gbps Elastic Network Adapter(ENA) 네트워킹은 S3 Express One Zone을 통해 처리량이 높은 핫 스토리지에 액세스하도록 하여 대규모 훈련 워크로드를 지원합니다. FSx for Lustre를 사용하는 경우, 이제 GPUDirect Storage(GDS)와 EFA를 함께 활용하여 P6-B300 인스턴스 기반 Lustre 파일 시스템에 최대 1.2Tbps의 처리량을 제공할 수 있으며 모델을 빠르게 로드할 수 있습니다.
정식 출시
P6-B300 인스턴스는 서울 리전에서 Amazon EC2 Capacity Blocks for ML 및 Savings Plan으로 사용할 수 있습니다.
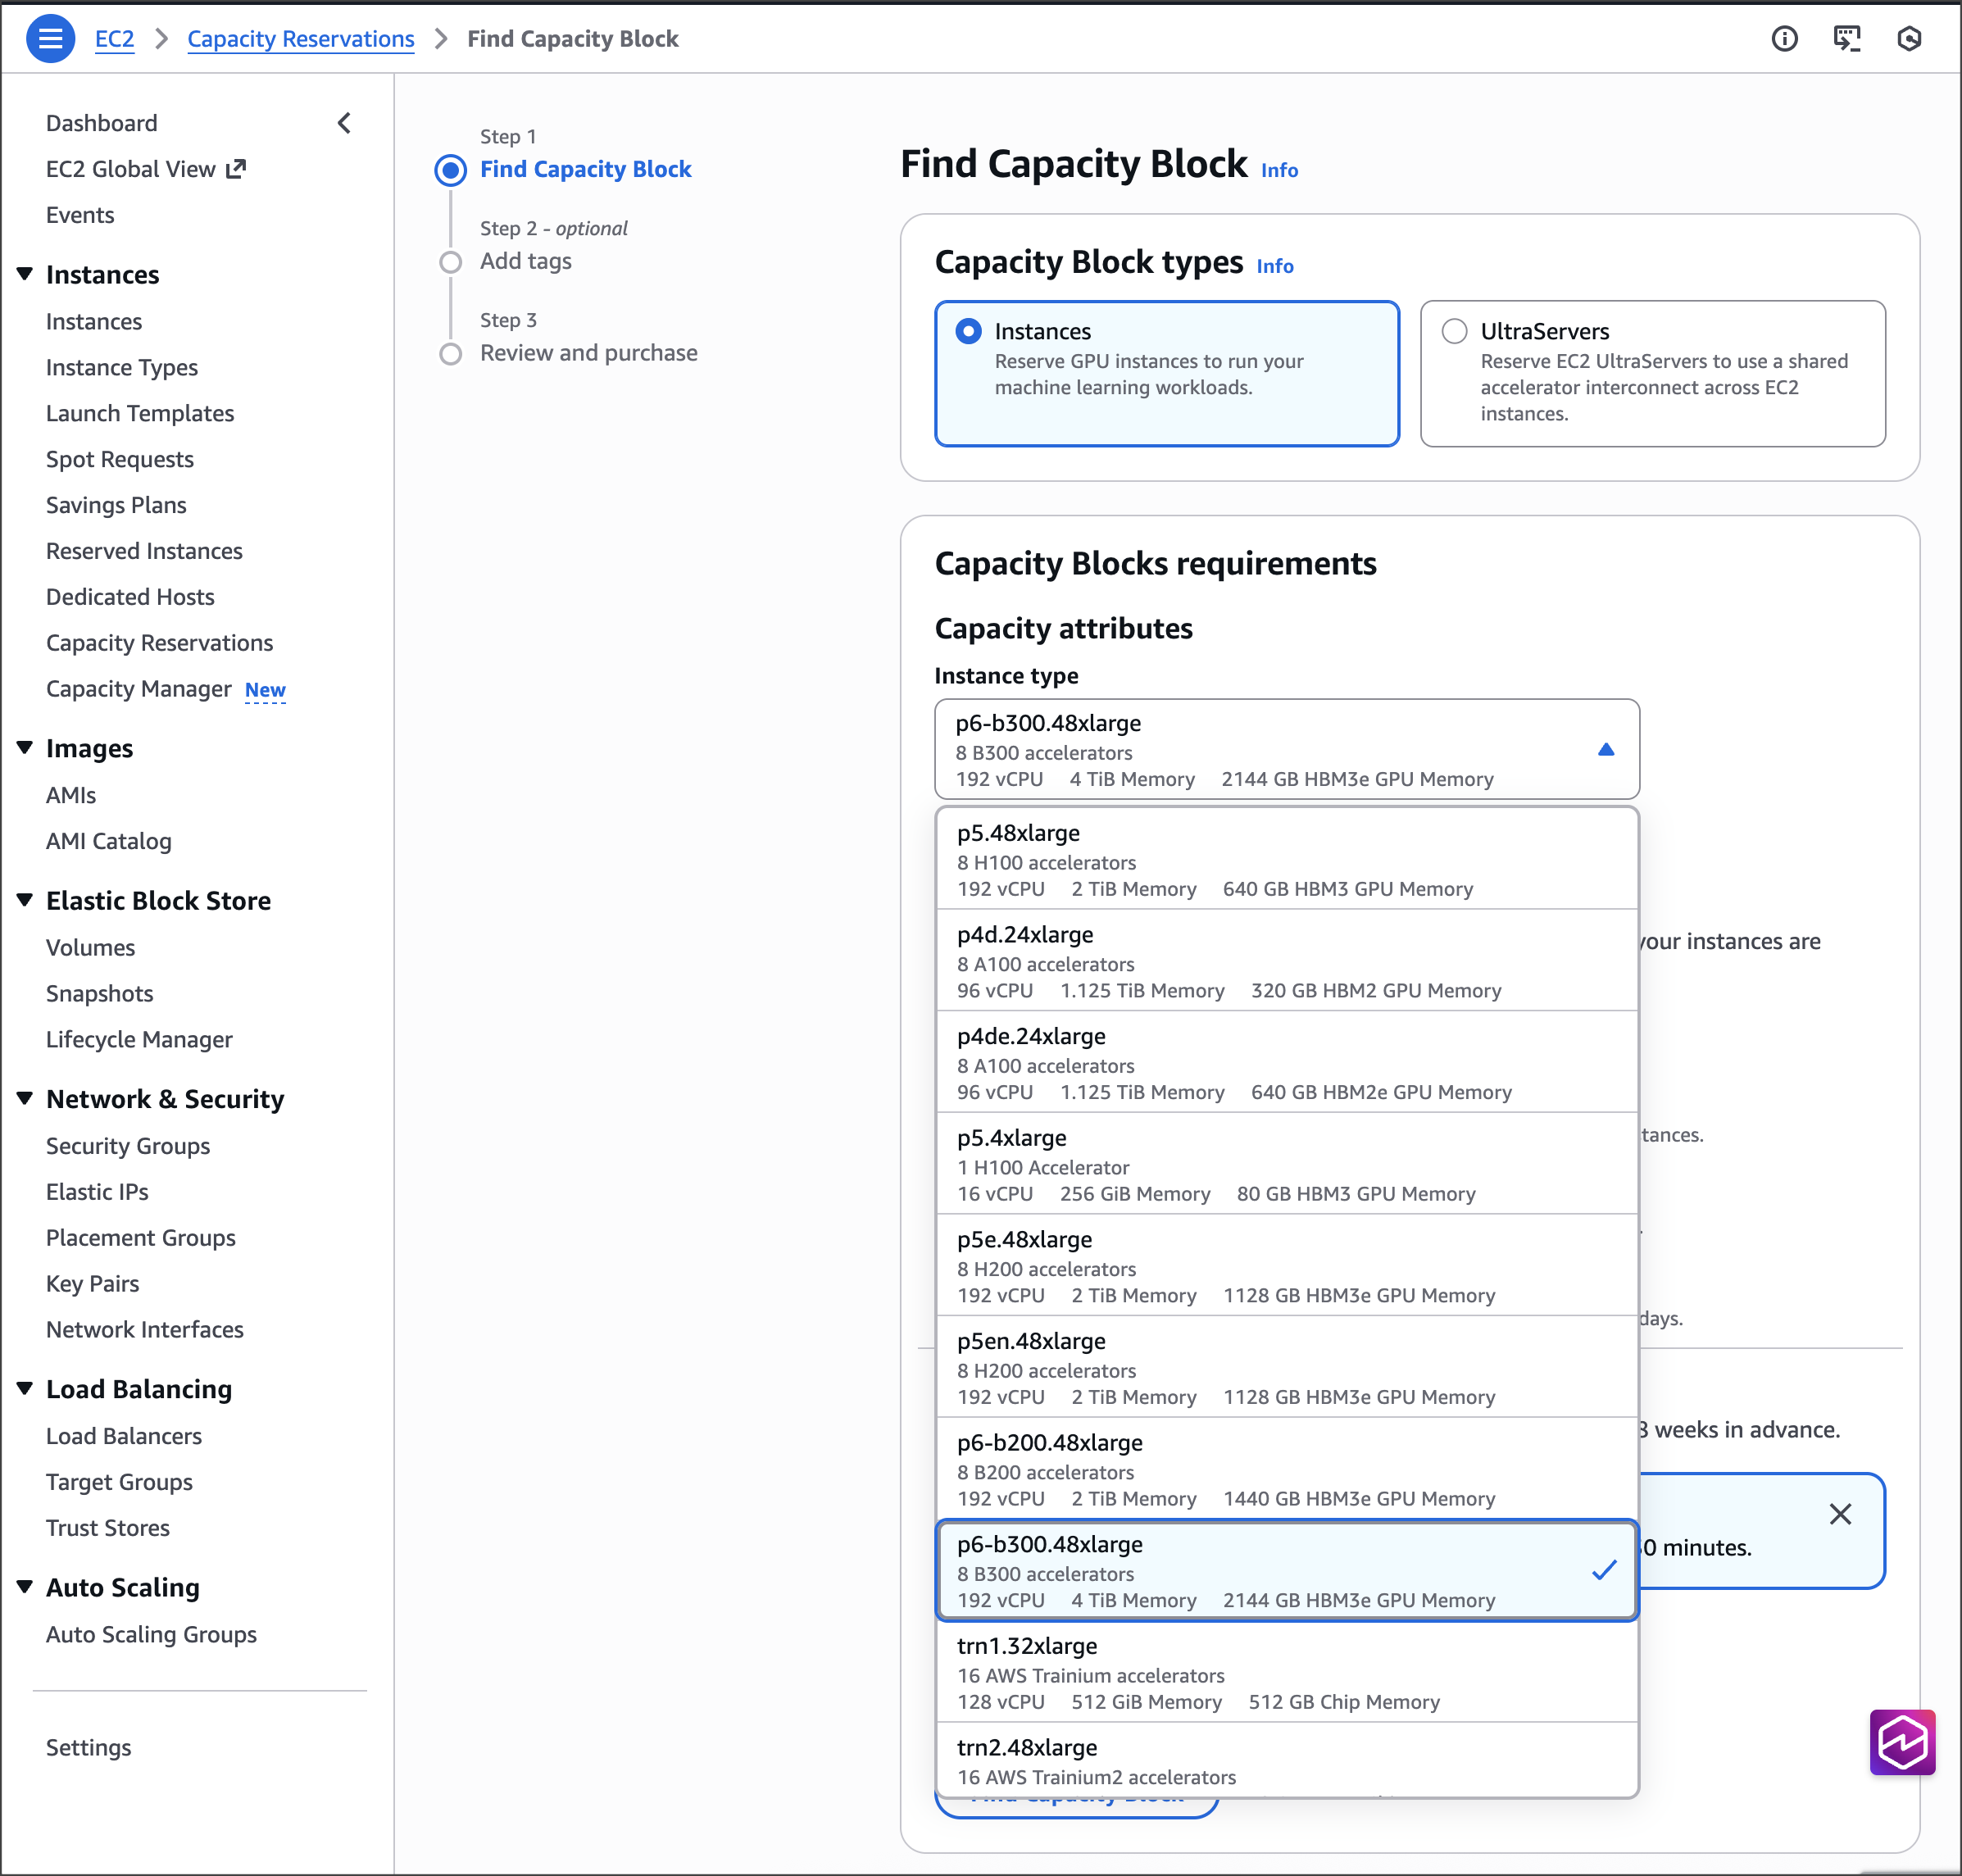
P6-B300 인스턴스의 온디맨드 예약은 계정 관리자에게 문의하세요. Amazon EC2와 마찬가지로 사용한 만큼만 비용을 지불하면 됩니다. 자세한 내용은 Amazon EC2 요금을 참조하세요. 애플리케이션 마이그레이션을 시작하는 데 도움이 되는 가속 컴퓨팅 인스턴스의 전체 컬렉션을 확인해 보세요.
자세한 내용은 Amazon EC2 P6-B300 인스턴스 페이지를 참조하세요. AWS re:Post for EC2 또는 AWS Support 담당자를 통해 피드백을 보내 주세요.
— Channy