Amazon Web Services 한국 블로그
Amazon S3 Tables, Apache Hive 테이블을 Apache Iceberg로의 관리형 마이그레이션 제공
오늘 데이터 레이크 현대화를 위한 간단하고 비용 효율적인 경로를 발표했습니다. 이제 Amazon S3 Tables는 Apache Hive 테이블에 대해 Apache Iceberg로의 관리형 마이그레이션을 지원합니다. 마이그레이션은 AWS Glue Data Catalog에 등록된 Amazon S3의 Parquet 테이블에서 작동하며, 이를 통해 파이프라인을 구축하거나 컴퓨팅을 프로비저닝하지 않고도 프로덕션 워크로드를 계속 실행하면서 데이터 레이크를 업그레이드할 수 있습니다.
Apache Iceberg는 대규모 분석 데이터세트를 위한 개방형 표준으로 자리 잡았습니다. 이를 통해 모든 Iceberg 호환 엔진으로 데이터를 개방형 데이터로, 쿼리 가능하게 유지하면서, 스키마 진화, 숨겨진 파티셔닝, 시간 여행 쿼리와 같은 기능을 사용하여 페타바이트 규모의 테이블을 관리할 수 있습니다. Amazon S3 Tables는 자동 유지 관리, 최적화, 복제 및 S3 Intelligent-Tiering과 같은 기본 제공 기능을 통해 데이터가 증가하더라도 Iceberg 테이블의 성능과 비용 효율성을 유지할 수 있도록 특별히 설계된 완전관리형 스토리지를 제공합니다.
새로운 기능
이전에는 Apache Hive 테이블을 Apache Iceberg로 마이그레이션하는 데 필요한 인프라를 구축하고 관리하는 데 몇 주간의 엔지니어링 작업이 필요했습니다. 데이터 유형을 변환하고 롤백 기능을 구축하면 운영 복잡성도 더 늘어났습니다. 이제는 API 기반 관리형 작업으로 수행할 수 있습니다.
S3 Tables는 데이터 검증, 호환성 검사, 유형 변환, 파일 재압축 및 압축을 포함한 전체 마이그레이션 워크플로를 처리합니다. 데이터를 복사하기 전에 S3 Tables는 범위 내 모든 소스 객체를 식별하고 호환성 보고서를 생성합니다. 컷오버 중 몇 분은 예외적이지만, 소스 테이블에 대한 쓰기를 중단하지 않으면서 필요한 만큼 동기화할 수 있습니다. 준비가 되면 마이그레이션을 완료하여 테이블이 오프라인으로 있는 시간을 최소화할 수 있습니다.
자체 관리형 접근 방식에 비해, S3 Tables 관리형 마이그레이션은 복사한 데이터에 대해서만 비용을 지불하고 Hive에서 Iceberg로 변환할 때 비용이 들지 않으며 S3 Intelligent-Tiering의 소스 객체가 현재 액세스 티어에 그대로 유지되기 때문에 비용 효율적입니다.
마이그레이션에 대한 첫 번째 살펴보기
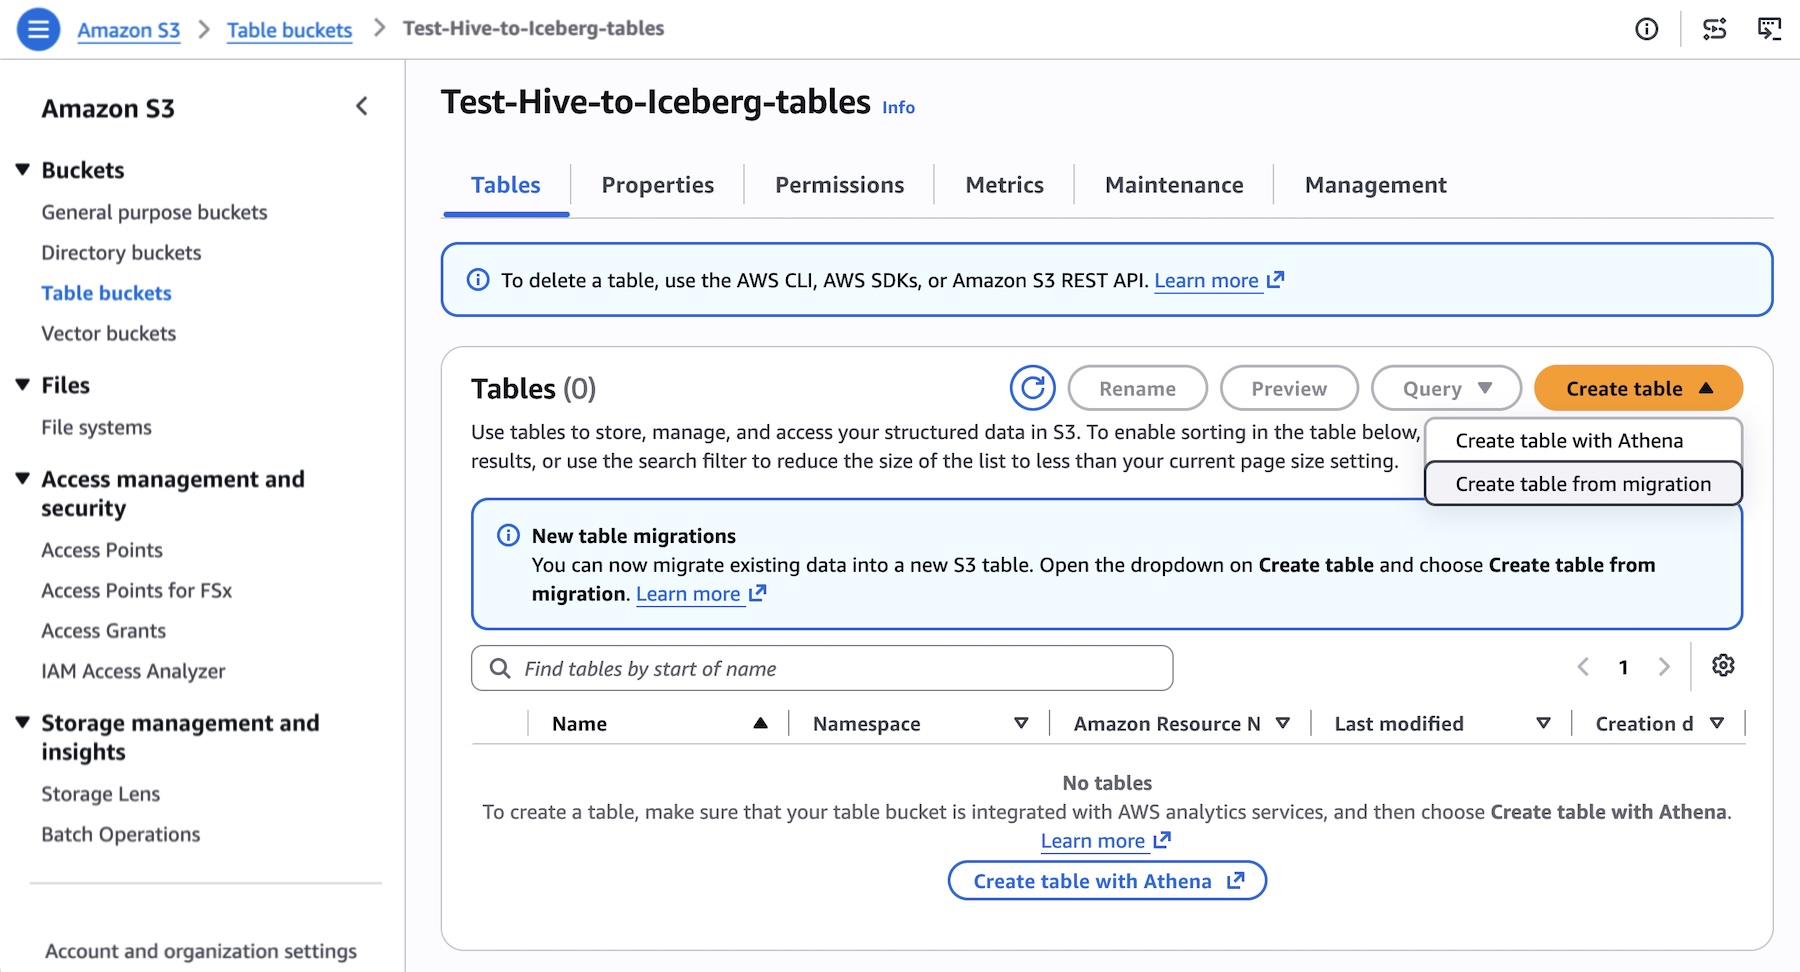
AWS Glue Hive 테이블을 마이그레이션하려면 S3 콘솔에서 대상 테이블 버킷을 선택한 다음, 마이그레이션에서 테이블 생성을 선택하세요.
대상 Iceberg 테이블의 네임스페이스와 테이블 이름을 생성하세요. 쿼리 성능 및 스토리지 효율성에 맞게 조정된 권장 기본 설정을 사용하여 대상 테이블이 생성됩니다.
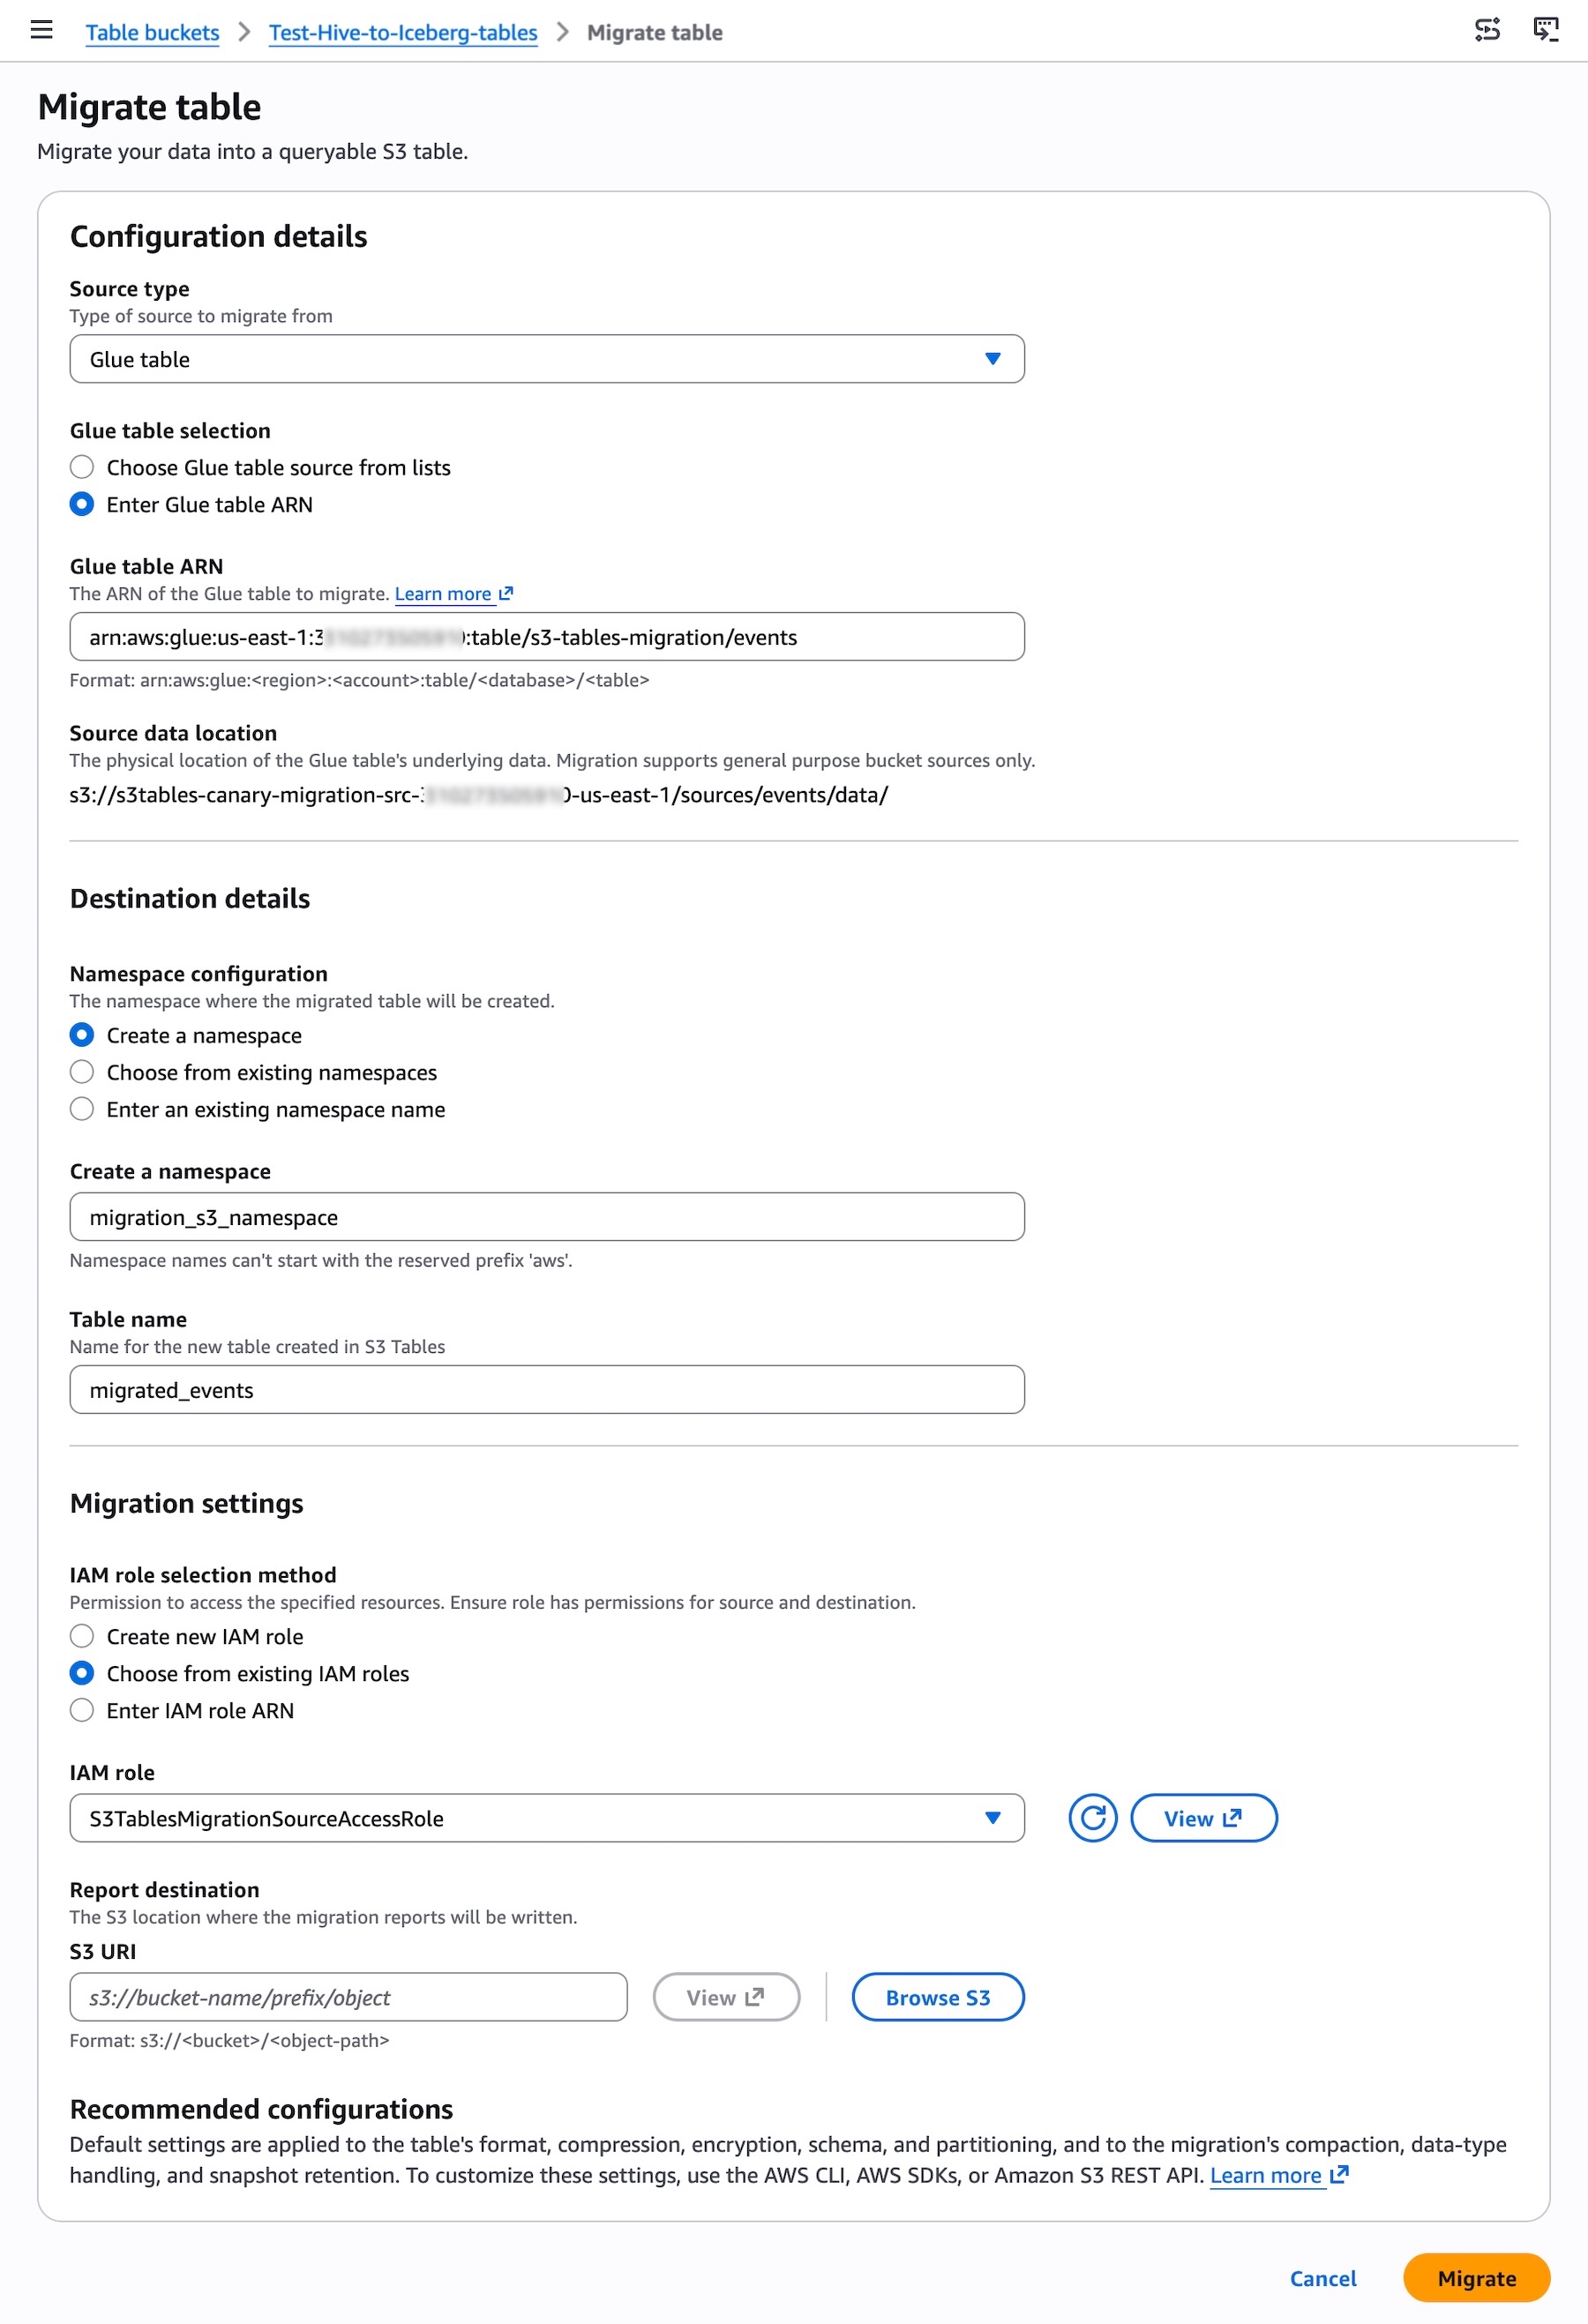
마이그레이션을 시작하면 S3 Tables가 소스 테이블을 검증하고 호환성 보고서를 생성하며 데이터 복사를 시작합니다. 대상 테이블은 마이그레이션 동안 읽기 전용입니다. 마이그레이션을 완료하면 대상 테이블이 읽기-쓰기로 승격됩니다.
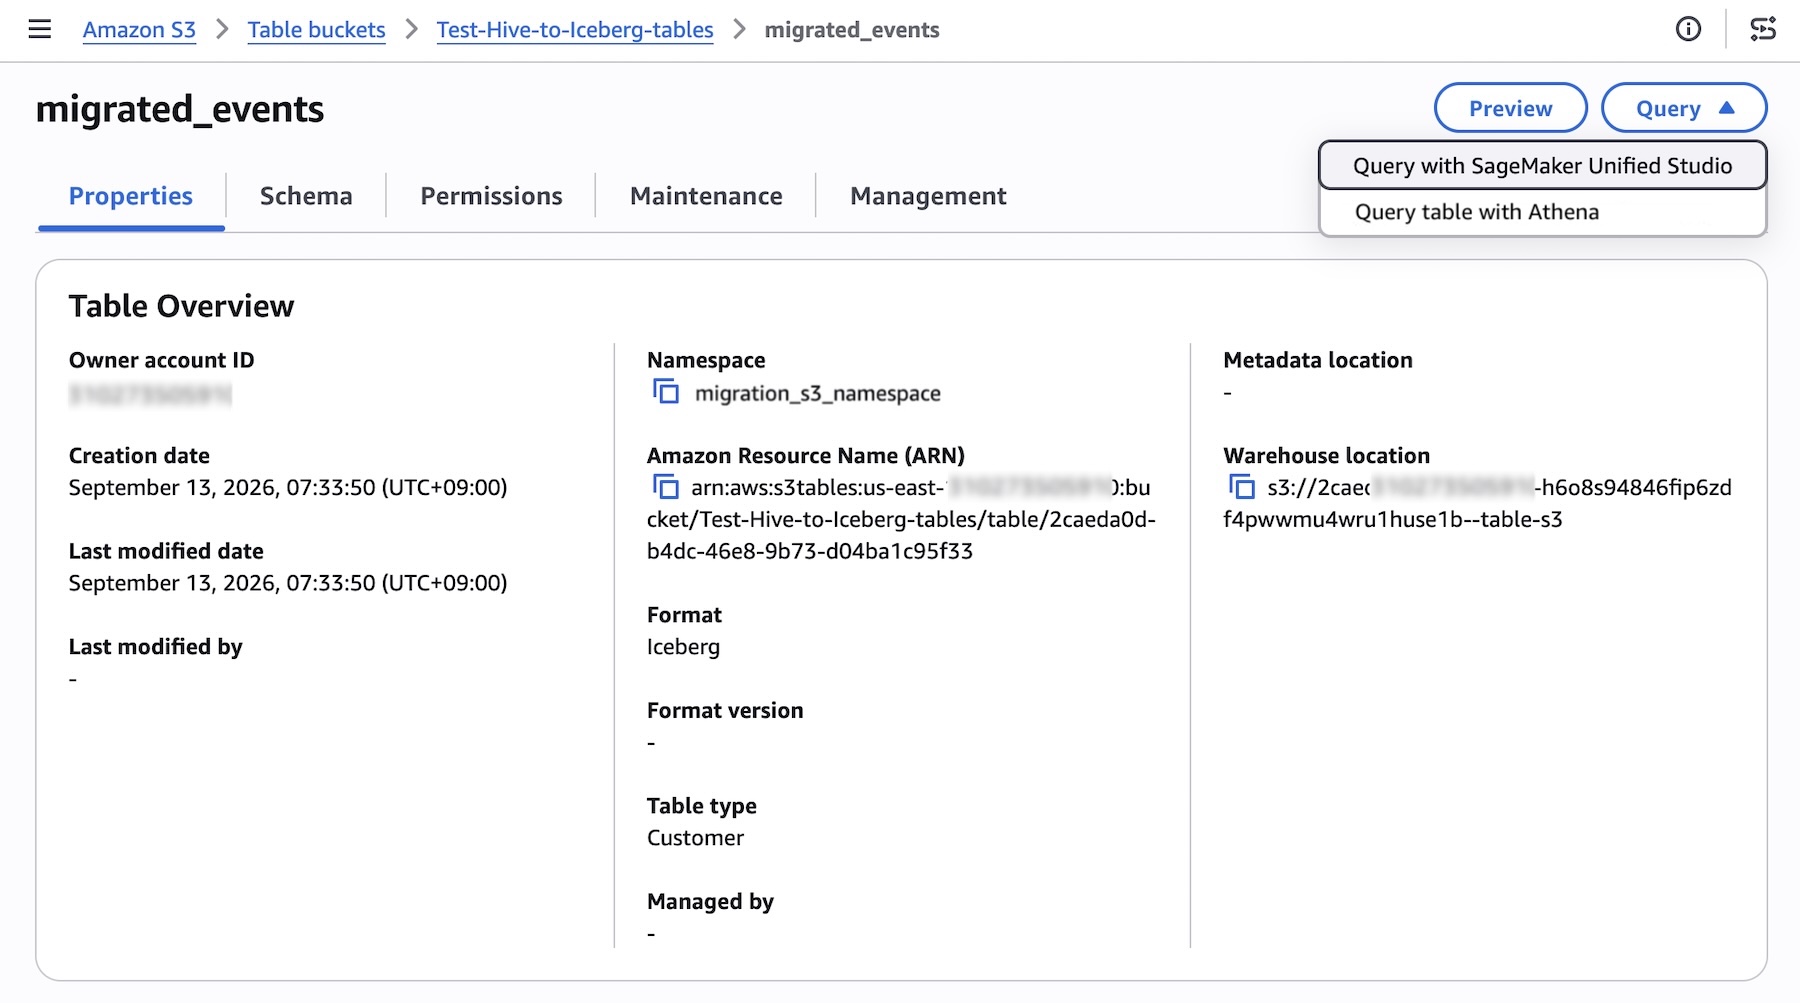
AWS 콘솔에서 Amazon Athena 및 Amazon SageMaker Unified Studio와의 직접 통합을 통해 바로 데이터 작업을 시작하거나 Apache Iceberg REST API와 호환되는 도구를 사용하여 테이블을 직접 쿼리할 수 있습니다. 자세한 내용은 S3 Tables 마이그레이션 설명서를 참조하세요.
또한 AWS Command Line Interface(AWS CLI), AWS SDK 또는 AWS용 에이전트 툴킷을 사용할 수도 있습니다. 예를 들어 마이그레이션 작업을 설정하고 start-table-migration 명령을 직접 호출하세요.
cat > /tmp/start-migration.json <<'EOF'
{
  "roleArn": "arn:aws:iam::123456789012:role/S3TablesMigrationRole",
  "destinationTable": {
    "tableBucketARN": "arn:aws:s3tables:us-east-1:123456789012:bucket/my-destination-bucket",
    "namespace": "mynamespace",
    "name": "my_destination_table",
    "encryptionConfiguration": {
      "sseAlgorithm": "aws:kms",
      "kmsKeyArn": "arn:aws:kms:us-east-1:123456789012:key/1234abcd-12ab-34cd-56ef-1234567890ab"
    },
    "storageClassConfiguration": { "storageClass": "INTELLIGENT_TIERING" },
    "tags": { "team": "s3tables", "purpose": "migration" },
    "properties": {
      "writeFormat": "parquet",
      "icebergFormatVersion": 2,
      "compressionCodec": "zstd",
      "dictionaryEncoding": true
    },
    "schema": {
      "type": "struct",
      "schema-id": 0,
      "identifier-field-ids": [1],
      "fields": [
        { "id": 1, "name": "id",      "type": "long",   "required": true, "doc": "primary key" },
        { "id": 2, "name": "payload", "type": "string", "required": false }
      ]
    },
    "icebergSortOrder": {
      "orderId": 1,
      "fields": [ { "sourceId": 1, "transform": "identity", "direction": "asc", "nullOrder": "nulls-first" } ]
    }
  },
  "sourceType": "glueTable",
  "source": {
    "glueTable": {
      "catalogId": "123456789012",
      "databaseName": "my_glue_database",
      "tableName": "my_source_table"
    }
  },
  "dataMigration": {
    "maintenanceSettings": {
      "icebergCompaction": { "targetFileSizeMB": 512, "strategy": "binpack" },
      "icebergSnapshotManagement": { "minSnapshotsToKeep": 3, "maxSnapshotAgeHours": 168 }
    },
    "migrationPolicies": {
      "unmatchedSourceFieldsPolicy": "fail",
      "incompatibleValuesPolicy": "fail"
    }
  },
  "reviewMigrationPlan": false,
  "migrationOutput": {
    "bucket": "arn:aws:s3:::my-report-bucket",
    "prefixes": {
      "tableCompatibilityReport": "reports/table-compatibility/",
      "objectCompatibilityReport": "reports/object-compatibility/",
      "objectMigrationReport": "reports/object-migration/"
    }
  }
}
EOF

aws s3tables start-table-migration \
  --cli-input-json file:///tmp/start-migration.json
대상 테이블에 소스의 변경 내용을 적용하려면 마이그레이션을 완료하기 전에 sync-table-migration을 필요한 만큼 직접 호출하세요. 동기화할 때마다 변경된 내용만 복제됩니다.
Kiro와 같은 코딩 에이전트를 사용하는 경우 AWS용 에이전트 툴킷의 migrating-hive-tables-to-s3-tables 스킬은 에이전트를 위한 안전 가드레일과 함께 단계별 마이그레이션 지침을 제공합니다. 이 스킬은 다음을 수행할 수 있습니다.
- 기존 IAM 정책을 분석하고 이에 상응하는 대상 정책 권장
- 시작하기 전에 마이그레이션 계획 검증
- 실행: 시작 → 동기화 → API 직접 호출 완료
- 작업 진행 상황을 모니터링하고 검증 및 컷오버 안내
자세한 내용은 해당 스킬에 대한 GitHub README 페이지를 참조하세요.
현재 사용 가능
현재 Amazon S3 Tables 관리형 마이그레이션은 미국 동부(버지니아 북부, 오하이오), 미국 서부(오리건), 아시아 태평양(뭄바이, 싱가포르, 시드니, 도쿄), 유럽(프랑크푸르트, 아일랜드, 스톡홀름) 리전에서 사용할 수 있습니다. 출시 시점을 기준으로 이 기능은 동일한 AWS 계정 및 AWS 리전 내에서 Parquet 형식으로 저장된 AWS Glue 등록 Hive 테이블을 지원합니다. API를 직접 호출하고, 문서를 검색하며, 리전별 가용성을 확인하고, 이 새로운 기능에 대한 문제를 해결하려면 선호하는 AI 도구에서 AWS MCP 서버 및 플러그인을 활용하세요.
지금 바로 Amazon S3 콘솔에서 사용해 보고 AWS re:Post for Amazon S3 또는 평소 이용하는 AWS Support 연락처로 피드백을 보내주세요.
— Channy