AWS 기술 블로그
AI 에이전트 시대의 기업 토큰 경제학: 비용 방정식으로 측정하고 Amazon Bedrock에서 줄이기
지난 반년 동안 여러분 조직의 AI 청구서는 몇 배가 되었습니까? 그 증가분에서 사람이 요청한 일과 에이전트가 스스로 벌인 일을 지금 대시보드에서 구분해 볼 수 있습니까?
Claude Code, Codex 같은 코딩 에이전트가 코드 작성과 리뷰, 장애 분류, 데이터 조회를 맡으면서 토큰(token, 모델이 텍스트를 읽고 쓰는 최소 단위)은 CPU 시간이나 데이터 전송량 같은 비용 단위가 되었습니다. 다른 점은 소비의 주체입니다. 서버는 사람이 동작시킨 만큼만 구동되지만 에이전트는 요청 하나 위에 도구 호출과 컨텍스트 재전송을 스스로 더합니다. 그래서 사용량 캡(cap)만으로는 도입 효과와 비용 절감을 함께 놓칩니다. 이 글은 필자가 지난 반년 동안 기업 고객과 토큰 비용을 주제로 나눈 미팅의 경험과 Uber Engineering이 2026년 8월 공개한 운영 사례를 함께 정리했습니다.
1. 토큰이 비용 단위가 된 이유
1.1 에이전트가 만드는 소비 구조
Uber의 사례로 시작하겠습니다. 2026년 2월부터 8월까지 Uber에서 에이전트 도구의 주간 활성 사용자는 7배, 주간 에이전트 요청은 9.4배 늘었습니다. 전체 PR(pull request)의 70% 이상이 로컬이나 클라우드 에이전트에서 나오고 엔지니어들이 만든 스킬 3,600여 개가 하루 3만 회 이상 실행됩니다. 그런데도 전체 AI 지출은 4월 이후 비교적 안정되었습니다. 모델을 하나로 고정해 비교하면 1,000회 요청당 비용은 피크 대비 약 34%, 세션당 비용은 6월 피크 대비 52% 낮아졌습니다.
눈여겨볼 것은 절감률보다 소비 구조입니다. Uber에서는 코드 리뷰, CI 실패 자가 복구, 온콜 알림 분류처럼 사람이 아니라 관리형 에이전트(managed agent, 목적과 모델과 예산을 회사가 정해 두고 자동으로 실행되는 에이전트)가 시작하는 세션의 비중이 커지고 있습니다. 사람이 직접 의도해서 동작시키는 세션은 그 일부일 뿐입니다. 요청 한 번 뒤에서 에이전트가 수십 번의 모델 호출을 만들기 때문에 토큰 청구서는 더 이상 직원 수에 비례하지 않습니다.
1.2 통제력이 다른 세 계층
AI 청구서는 한 줄로 오지만 그 안에는 통제력이 다른 계층이 섞여 있습니다. Uber는 에이전트 사용을 가장 특화된 계층부터 가장 범용적인 계층까지 네 계층으로 나누고 위 계층일수록 비용, 품질, 모델 선택을 더 통제할 수 있다고 설명합니다. 이 글은 이를 세 계층으로 줄여 다룹니다. 목적과 입력이 정해진 특화 에이전트는 모델, 예산, 도구를 회사가 모두 정합니다. 개발자가 터미널에서 자유롭게 대화하는 세션은 사람의 습관이 비용을 좌우합니다. 이 계층에서 회사가 손댈 수 있는 것은 기본값과 실시간 피드백 정도입니다.
| 계층 | 예시 | 비용이 새는 지점 | 회사가 정하는 것 |
|---|---|---|---|
| 특화 관리형 에이전트 |
PR 리뷰 봇, CI 자가 복구, 알림 분류. 같은 작업을 하루 수천 번 반복 | 작업에 비해 과한 모델을 기본값으로 방치 | 모델, 하네스(harness, 에이전트를 실행하는 프로그램 틀), 도구, 예산, 캐시 정책 전부 |
| 범용 관리형 에이전트 |
이슈를 받아 PR을 완성. 작업마다 턴 수 편차가 큼 | 그라운딩 부족으로 탐색 턴 증가, 서브에이전트의 상위 모델 상속 | 모델 기본값, 도구 목록, 예산 티어, 미리 제공하는 컨텍스트 |
| 개인 인터랙티브 세션 |
개발자 수백 명의 코딩 에이전트. 같은 작업도 사람마다 비용 편차가 큼 | MCP 서버 과다 설치, 자리 비움으로 인한 캐시 만료, 단순 질문에 최상위 모델 사용 | 초기 모델, 서브에이전트 모델, 컴팩션 임계값 같은 기본값과 실시간 비용 표시 |
표 1. 통제력 기준으로 나눈 AI 사용 계층 (Uber의 네 계층 구분을 세 계층으로 단순화)
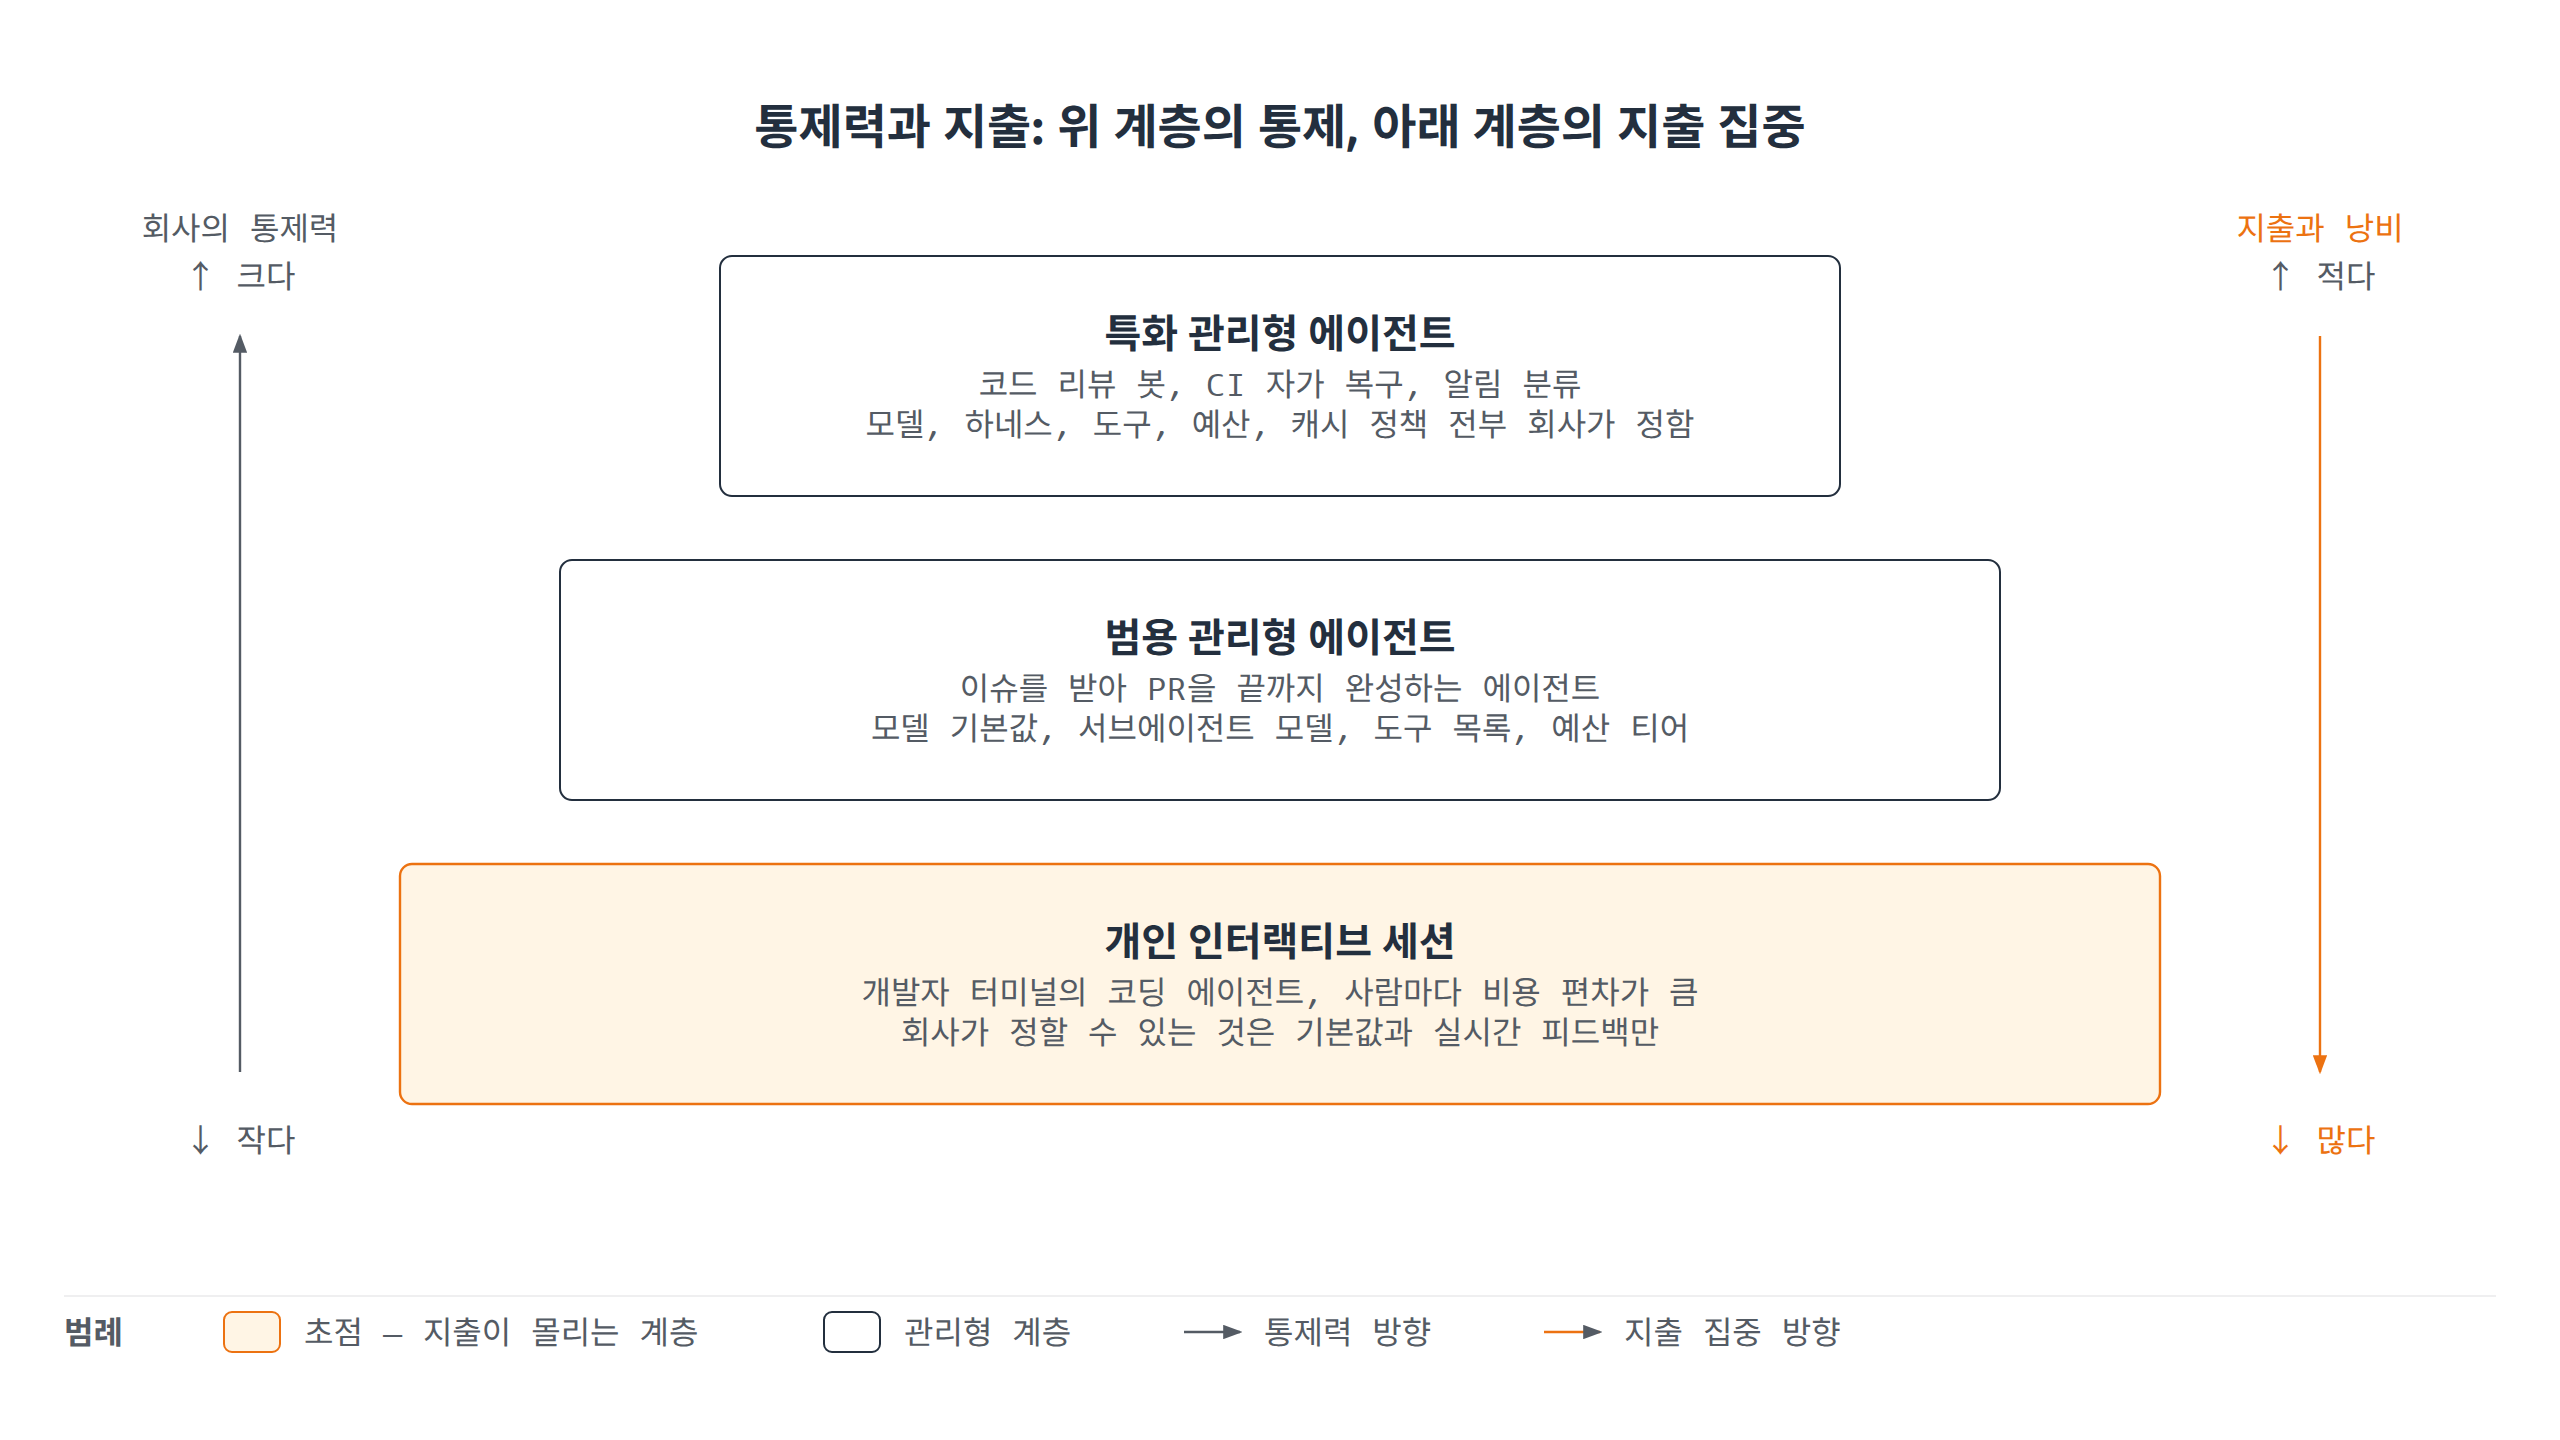
그림 1. 통제력 기준 AI 사용 계층 – 위로 갈수록 회사가 정하는 것이 많고 지출은 아래 계층에 몰립니다
표와 그림이 보여 주는 역설이 있습니다. 통제력은 아래 계층으로 갈수록 줄어드는데 지출과 낭비는 아래 계층에 몰립니다. 그래서 전략은 두 개의 축으로 나누는 것을 권장합니다. 관리형 계층은 벤치마크와 모델 선택 루프로 정밀하게 조이고 인터랙티브 계층은 기본값과 넛지(nudge, 강제 없이 행동을 유도하는 장치)로 넓게 덮습니다.
여기서 많은 조직이 개인의 에이전트 사용을 하나씩 통제하려 듭니다. 모델 선택 금지, 도구 설치 승인제, 사용자별 토큰 한도가 대표적입니다. IT 역사에서 이 접근은 여러 번 실패했습니다. 클라우드 초기에 인스턴스마다 티켓 승인을 요구한 조직에서는 개인 카드로 만든 계정, 즉 섀도 IT(shadow IT, 승인 없이 사용하는 IT 자원)가 자랐습니다. 스마트폰 업무 사용을 금지한 조직은 결국 기기를 허용하고 관리하는 BYOD로 방향을 바꿨습니다. 메일함 용량을 빠듯하게 제한한 조직은 로컬 보관에 따른 자료 유실과 규정 위반을 겪었습니다. 개인의 생산성 도구를 통제하면 사용은 줄지 않고 보이지 않는 곳으로 옮겨 갑니다.
에이전트도 같습니다. 인터랙티브 계층에서 회사의 몫은 기본값을 효과적으로 두고 비용을 보이게 하는 데까지입니다. 큰 절감은 반복 작업을 통제력이 큰 관리형 계층으로 옮길 때 나옵니다. Uber도 수천 명의 터미널 세션을 하나씩 최적화하기보다 관리형 에이전트로 옮기는 편이 비용 효율과 확장성이 높다고 결론짓습니다. Claude Code와 Codex는 헤드리스 모드(claude -p, codex exec)로 CI와 봇에서도 실행되므로 같은 도구와 같은 지표로 관리형 계층을 만들 수 있습니다.
2. 비용 방정식
비용을 곱셈으로 쪼개 항목마다 책임자를 두는 방식은 익숙합니다. 예를 들어 EC2 비용을 인스턴스 수 × 가동 시간 × 시간당 단가로, 매출을 방문자 × 전환율 × 객단가로 나누는 식입니다. 항목이 나뉘면 “비용이 늘었다”는 보고가 “어느 항목이 왜 늘었다”로 바뀝니다. 이 글에서 사용한 여섯 항목 분해와 지표 체계, 항목별 해결책 분류는 Uber Engineering이 2026년 8월 공개한 Running a Software Factory Efficiently at Uber Scale의 틀을 바탕으로 했습니다.
총 비용 = 사용자 수 × 사용자당 세션 수 × 세션당 턴 수 × 턴당 요청 수 × 요청당 토큰 수 × 토큰당 가격세션(session)은 한 작업을 위해 이어지는 대화 단위입니다. 턴(turn)은 사용자 입력 한 번부터 응답 완료까지입니다. 요청(request)은 한 턴 안에서 모델에 보내는 개별 API 호출로, 에이전트가 도구를 한 번 부를 때마다 하나씩 늘어납니다.
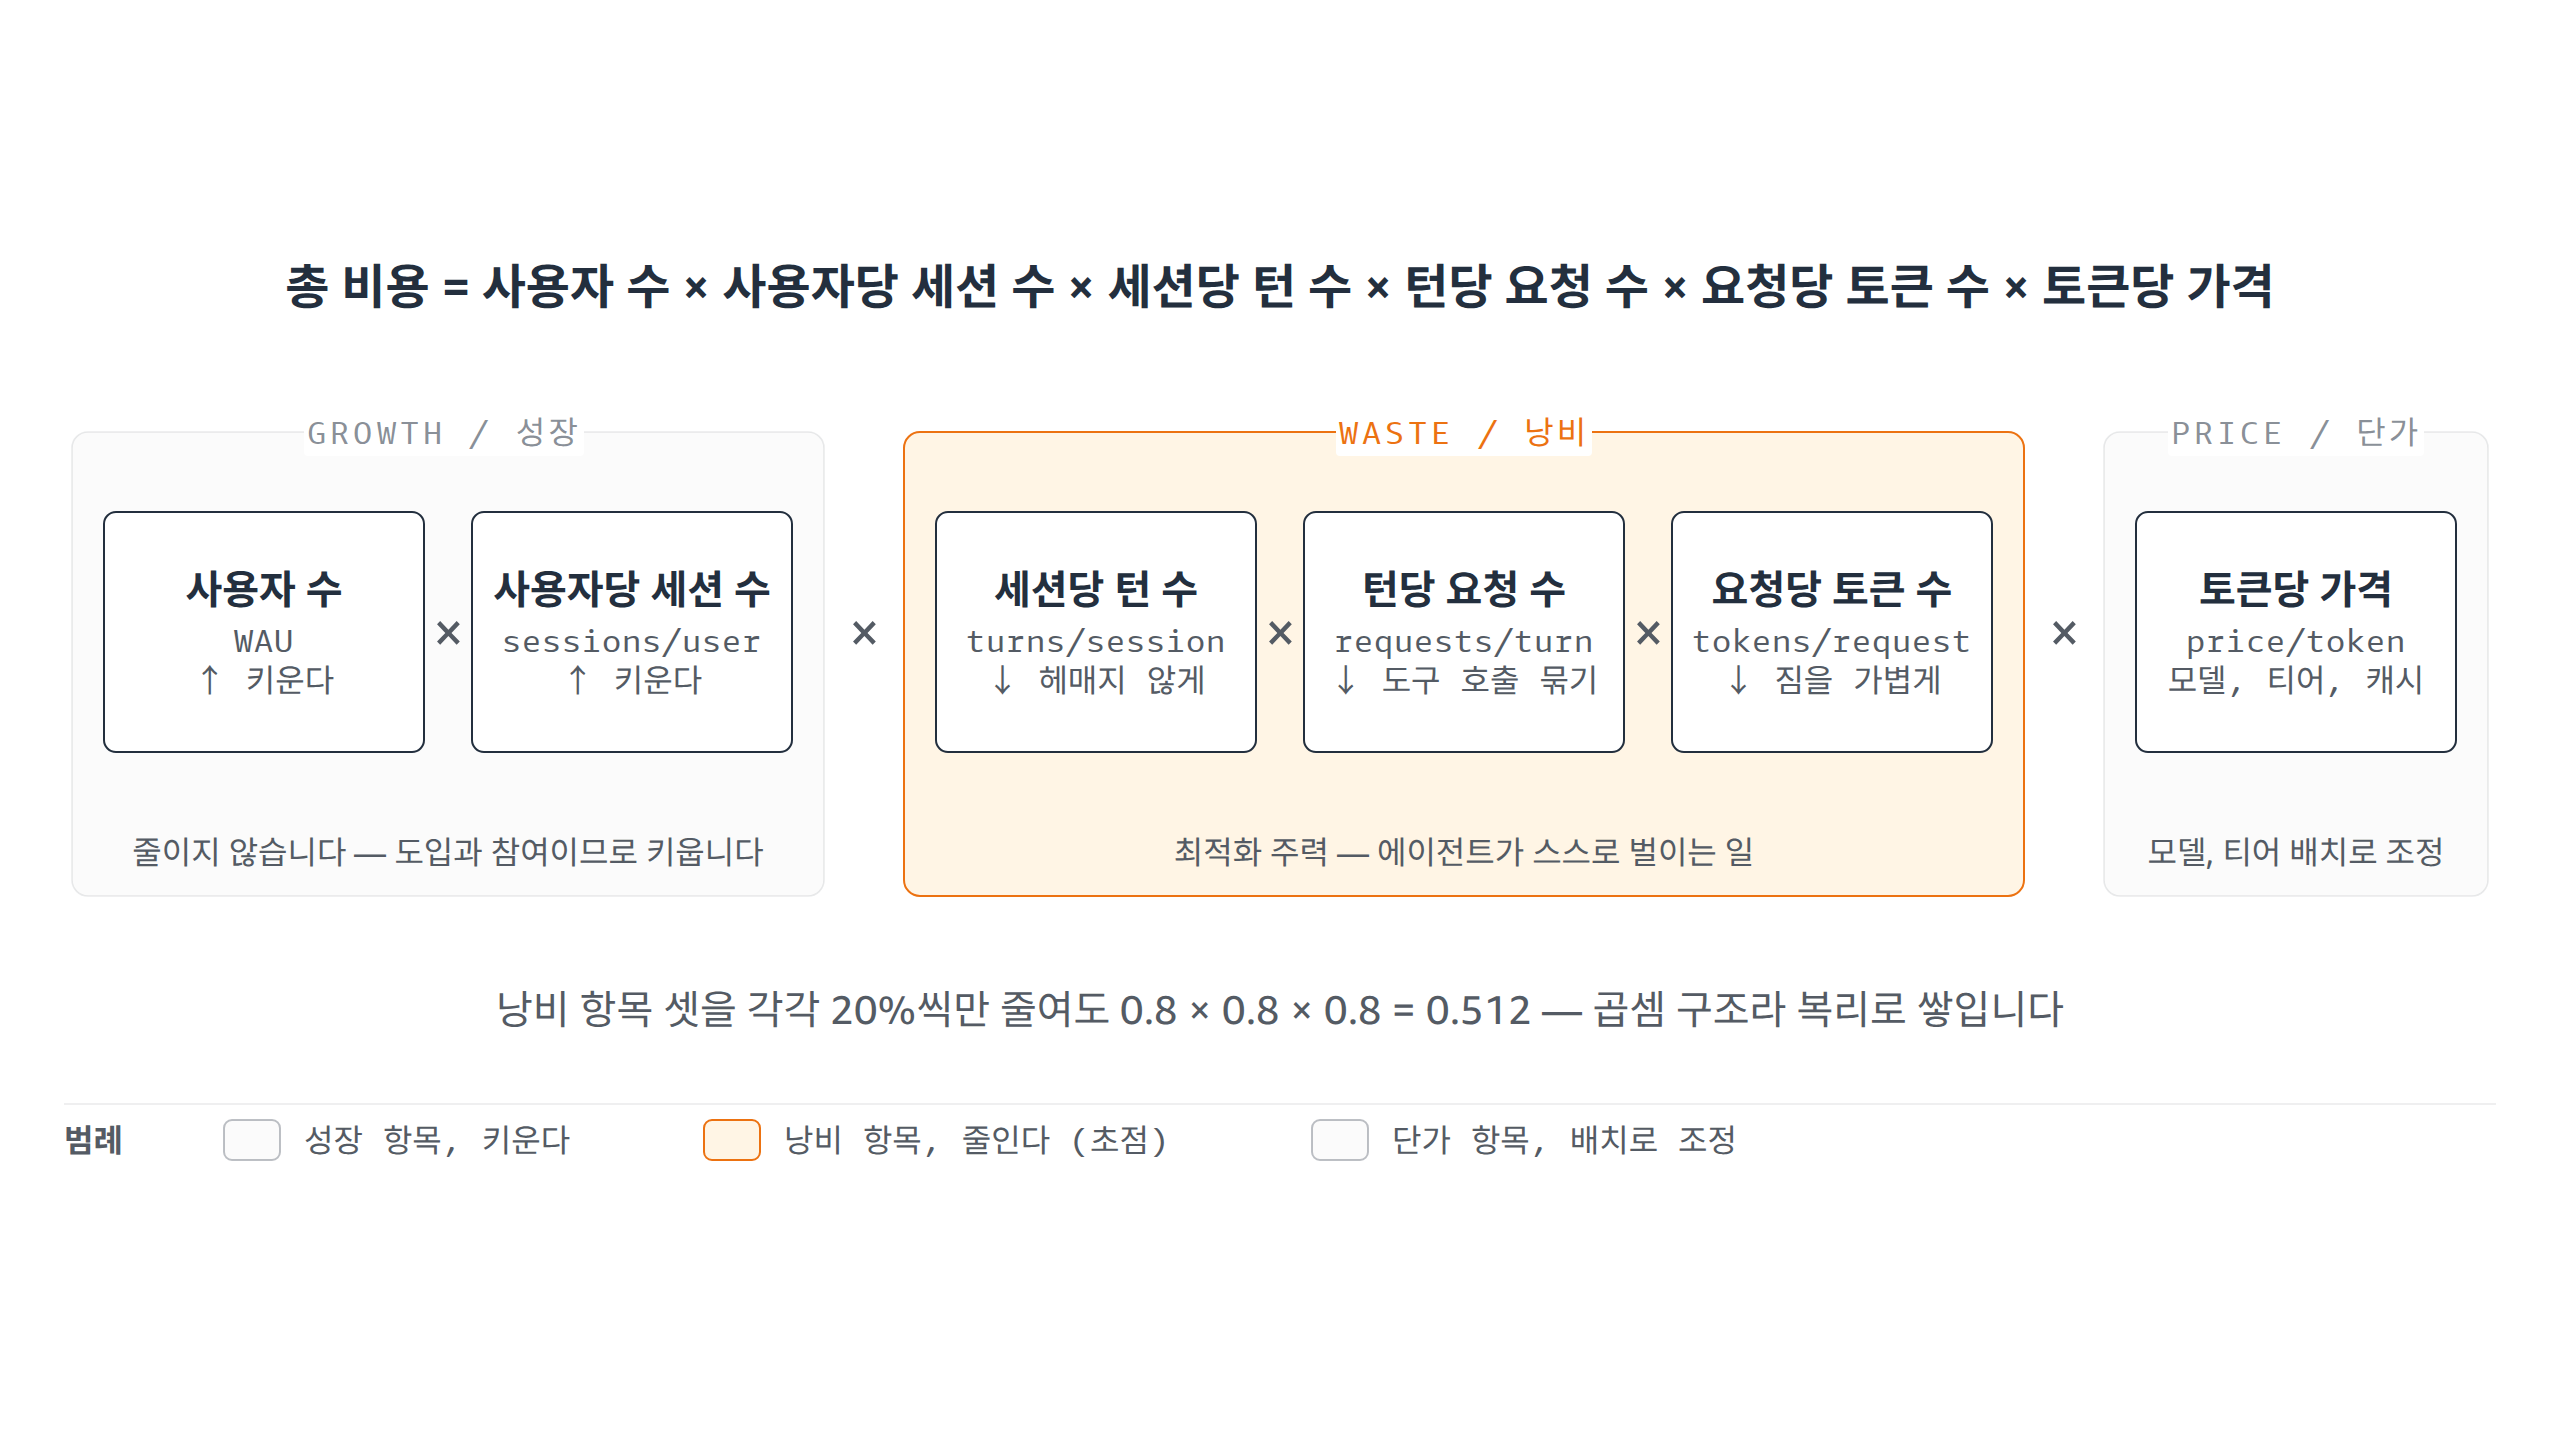
그림 2. 비용 방정식의 여섯 항목과 세 묶음 – 성장 항목은 키우고 낭비 항목은 줄이며 단가 항목은 배치로 다룹니다
여섯 항목은 세 묶음으로 나뉘며 묶음마다 담당과 다루는 방식이 다릅니다.
| 묶음 | 항목 | 국내 기업에서 보이는 모습 | 다루는 방식 |
|---|---|---|---|
| 성장 | 사용자 수, 사용자당 세션 수 | 한 금융사는 전 임직원 AI 활용률을 경영 목표로 걸어 반년 만에 주간 활성 사용자가 3배가 됐습니다 | 줄이지 않고 KPI로 관리합니다. 비용 보고에서 성장분과 낭비분을 분리합니다 |
| 낭비 | 세션당 턴 수, 턴당 요청 수, 요청당 토큰 수 | 한 커머스 기업의 상담 요약 에이전트는 상담 1건에 평균 14턴이 걸렸습니다. 트레이스를 보니 턴마다 같은 주문 정보를 다시 조회했습니다 |
최적화의 주력입니다. 세션 트레이스로 원인을 찾아 그라운딩, 캐싱, 도구 정리로 줄입니다 |
| 단가 | 토큰당 가격 | 한 게임사는 QA 로그 분류까지 최상위 모델로 처리했습니다. 소형 모델로 바꾸자 품질은 그대로였고 단가는 몇 분의 일이 됐습니다 |
작업별 벤치마크로 모델을 고르고 서비스 티어와 배치 추론을 배치합니다 |
표 2. 비용 방정식의 세 묶음과 대응 방식 (국내 기업 사례는 합성 데이터)
곱셈 구조이므로 낭비 항목 셋을 20%씩만 줄여도 곱은 0.8 × 0.8 × 0.8 = 0.512로 절반 가까이 내려갑니다. 성장과 낭비가 한 식 안에서 분리되므로 “AI 사용을 늘리자”와 “AI 비용을 줄이자”도 충돌하지 않습니다. 사용자가 늘어 오른 비용은 예상된 결과이고 요청당 토큰이 부풀어 오른 비용은 고쳐야 할 개선 항목입니다.
3. 매주 볼 지표와 측정 파이프라인
3.1 다섯 계층의 지표
방정식의 항목은 측정될 때만 관리 대상이 됩니다. 비용 관리가 자리 잡은 기업의 대시보드에는 공통으로 다섯 계층이 있고 계층마다 답하려는 질문이 다릅니다.
| 계층 | 보는 것 | 답하려는 질문 |
|---|---|---|
| 포트폴리오 | 귀속 비용, 고유 사용자 수, 도구별 비용과 점유율 | 돈이 어디로 가고 이번 주에 무엇이 움직였나? |
| 도구별 단위 경제 |
사용자당, 1,000요청당, 세션당 비용, 요청당 토큰, 캐시 히트율 | 도구가 실제로 저렴해지는가? 사용량이 옮겨 갔을 뿐인가? |
| 모델 경제 | 모델별 비용, 요청 점유율, 100만 토큰당 비용 | 어느 모델 출시가 청구서 비용을 변화시켰나? |
| 드라이버 분해 | 비용 변동을 사용자, 참여, 입력, 출력 순으로 분해 | 비용 변동의 원인을 요인별로 빠짐없이 설명하는가? |
| 성과 단위 비용 | 머지된 PR당, 리뷰당 비용과 품질(되돌리기 비율, 리뷰 정확도) | 가치 한 단위의 비용이 내려가고 품질은 유지되는가? |
표 3. 토큰 비용을 관리하는 다섯 계층의 지표
경영진 보고에 가장 유용한 것은 드라이버 분해와 성과 단위 비용(outcome-denominated cost)입니다. 이번 달 비용이 40% 늘었다면 사용자 +25%, 사용자당 요청 +5%, 요청당 입력 토큰 +8%, 출력 토큰 -1%로 쪼갭니다. 각 요인을 곱하면 1.25 × 1.05 × 1.08 × 0.99 = 1.40이 되어 성장분과 낭비분이 한 줄로 설명됩니다. 실제 보고에서는 요인별 기여분을 금액으로 차례로 나눠 적어 그 합이 총 변동과 정확히 같아지게 합니다. 성과 단위 비용은 나눗셈 한 번입니다. 코드 리뷰 에이전트의 주간 청구액을 같은 주의 리뷰 수로 나누고 사람이 채택한 코멘트 비율을 옆에 둡니다. 모델을 낮춰 리뷰당 비용이 30% 내려갔는데 채택률이 절반이 되었다면 그 절감은 절감이 아닙니다.
3.2 AWS 측정 파이프라인
다섯 계층을 채우려면 청구액, 요청 한 건의 토큰 수, 세션 안의 흐름처럼 수집 단위가 서로 다른 데이터가 필요합니다. Amazon Bedrock과 코딩 에이전트 도구는 이를 서로 다른 기능으로 제공하므로 하나만 활성화해서는 표가 채워지지 않습니다.
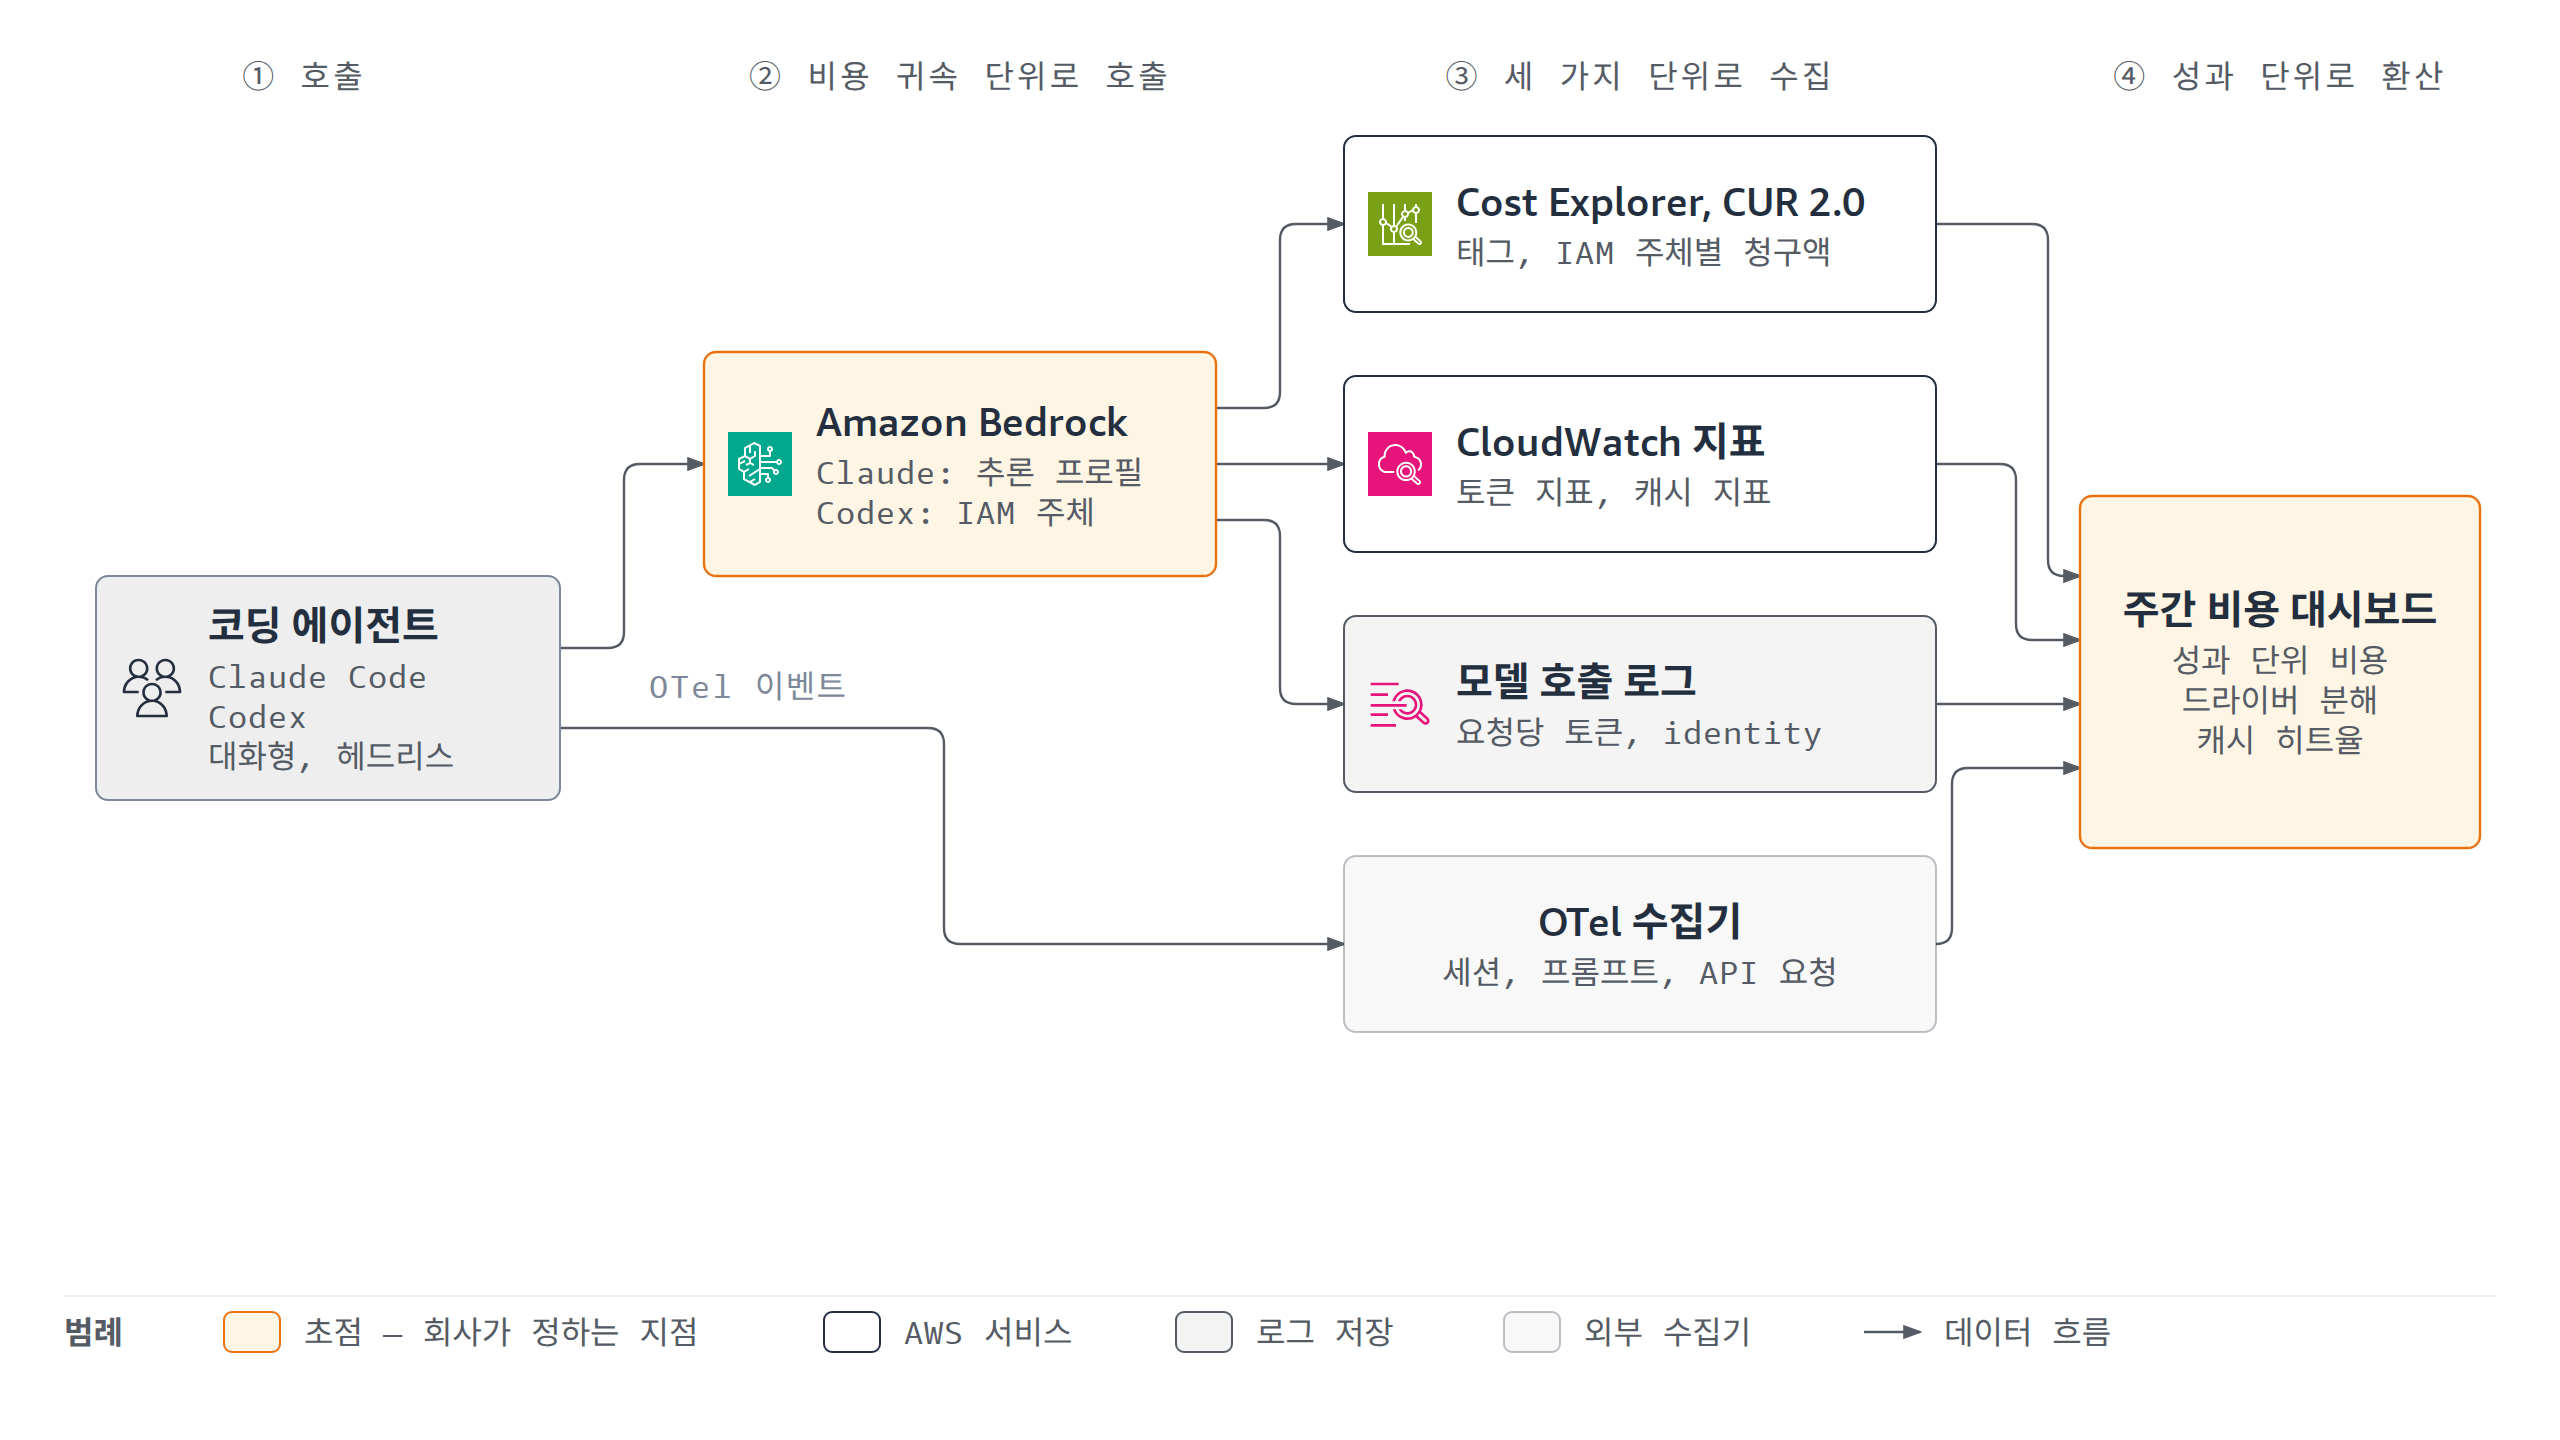
그림 3. 토큰 비용 측정 파이프라인 – Bedrock 쪽 청구액, 지표, 로그와 코딩 도구의 OpenTelemetry 이벤트를 한 대시보드로 모읍니다
| 데이터 | 수집 수단 | 수집 단위 | 채우는 지표 |
|---|---|---|---|
| 청구액 | 애플리케이션 추론 프로필과 비용 할당 태그, IAM 주체 귀속 | 일별, 사용 유형별 금액 | 포트폴리오, 모델 경제 |
| 요청 단위 토큰 | 모델 호출 로깅, 요청 메타데이터 태그 | 호출 한 건 | 도구별 단위 경제, 드라이버 분해 |
| 실시간 지표 | AWS/Bedrock 네임스페이스의 CloudWatch 지표 |
ModelId, ServiceTier, ResolvedServiceTier 차원 |
캐시 히트율, 스로틀링 경보 |
| 코딩 도구의 세션 |
Claude Code, Codex의 OpenTelemetry 내보내기 | 세션, 프롬프트, API 요청 | 세션당 턴, 턴당 요청, 세션 비용 |
표 4. 측정 데이터의 네 가지 원천
추론 프로필 ARN으로 InvokeModel이나 Converse API를 호출하면 프로필의 비용 할당 태그가 AWS Cost Explorer와 CUR 2.0(Cost and Usage Report)으로 이어집니다. 태그는 활성화 이후 비용에만 적용되므로 프로필을 만들자마자 Billing 콘솔에서 태그를 활성화합니다. bedrock-mantle 엔드포인트로 OpenAI 호환 API나 Anthropic Messages API를 호출하는 워크로드는 추론 프로필 대신 Projects와 Workspaces로 태깅합니다.
# 코드 리뷰 에이전트용 추론 프로필을 만들고 비용 할당 태그를 붙입니다
# 리전 안에서 직접 제공되지 않는 모델은 시스템 정의 추론 프로필(global.* 등)의 ARN을 지정합니다
aws bedrock create-inference-profile \
  --inference-profile-name "code-review-agent-prod" \
  --model-source "copyFrom=<MODEL_OR_SYSTEM_INFERENCE_PROFILE_ARN>" \
  --tags key=agent,value=code-review key=env,value=prod key=cost-center,value=platform \
  --region ap-northeast-2
# 반환된 inferenceProfileArn을 modelId 대신 사용해 호출합니다
모델 호출 로깅은 기본으로 비활성화되어 있어 계정과 리전마다 활성화해야 합니다. 레코드에는 입력, 출력 토큰 수와 호출 주체, modelId가 담기며 requestMetadata에 실어 보낸 팀, 기능 키도 함께 남습니다. bedrock-mantle 엔드포인트 호출은 로깅 대상이 아니므로 해당 워크로드는 Projects 단위 청구액으로 봅니다. 캐시 히트율은 CloudWatch 지표로 CacheReadInputTokenCount ÷ (InputTokenCount + CacheReadInputTokenCount + CacheWriteInputTokenCount)를 계산하고 경보를 걸어 둡니다. 지표 이름이 틀리면 경보가 오류 없이 데이터 부족 상태에 머물므로 지표 목록에서 이름을 먼저 확인합니다.
세션당 턴 수와 턴당 요청 수는 호출 단위 데이터에 없으므로 에이전트가 실행되는 쪽, 즉 Claude Code와 Codex에서 수집합니다. 두 도구 모두 OpenTelemetry 내보내기를 내장하고 있으므로 이를 활성화해 사내 OTel 수집기로 모읍니다. 헤드리스 실행에도 같은 설정이 적용됩니다.
Claude Code는 CLAUDE_CODE_ENABLE_TELEMETRY=1로 텔레메트리를 활성화합니다. 그러면 프롬프트마다 user_prompt, API 호출마다 api_request 이벤트가 나옵니다. 모든 이벤트에 session.id와 prompt.id가 포함되므로 프롬프트 이벤트를 세션 ID로 묶으면 세션당 턴, api_request를 프롬프트 ID로 묶으면 턴당 요청이 나옵니다. Codex CLI는 config.toml의 [otel] 설정으로 codex.user_prompt와 codex.api_request 이벤트를 대화 ID와 함께 내보냅니다. codex.api_request는 재시도를 포함한 시도 단위로 기록되므로 턴당 요청은 성공한 시도나 codex.sse_event의 response.completed 이벤트로 셉니다. 두 도구 모두 프롬프트 원문은 기본적으로 기록하지 않습니다.
LLM 게이트웨이가 여러 사용자를 대신해 호출하면 Bedrock은 게이트웨이의 IAM 역할을 호출자로 기록합니다. Amazon Bedrock 문서에 따르면 청구서에서 사용자별 금액을 보려면 게이트웨이가 사용자마다 RoleSessionName이나 세션 태그로 역할을 맡아야 합니다. 프롬프트 단위 상세만 필요하면 요청 메타데이터에 사용자를 싣는 것으로 충분합니다.
4. 항목별 해결책
측정이 되면 어느 항목이 부풀었는지 보입니다. 해결책은 항목마다 다르며 코드 변경이 가장 적은 단가부터 살펴봅니다.
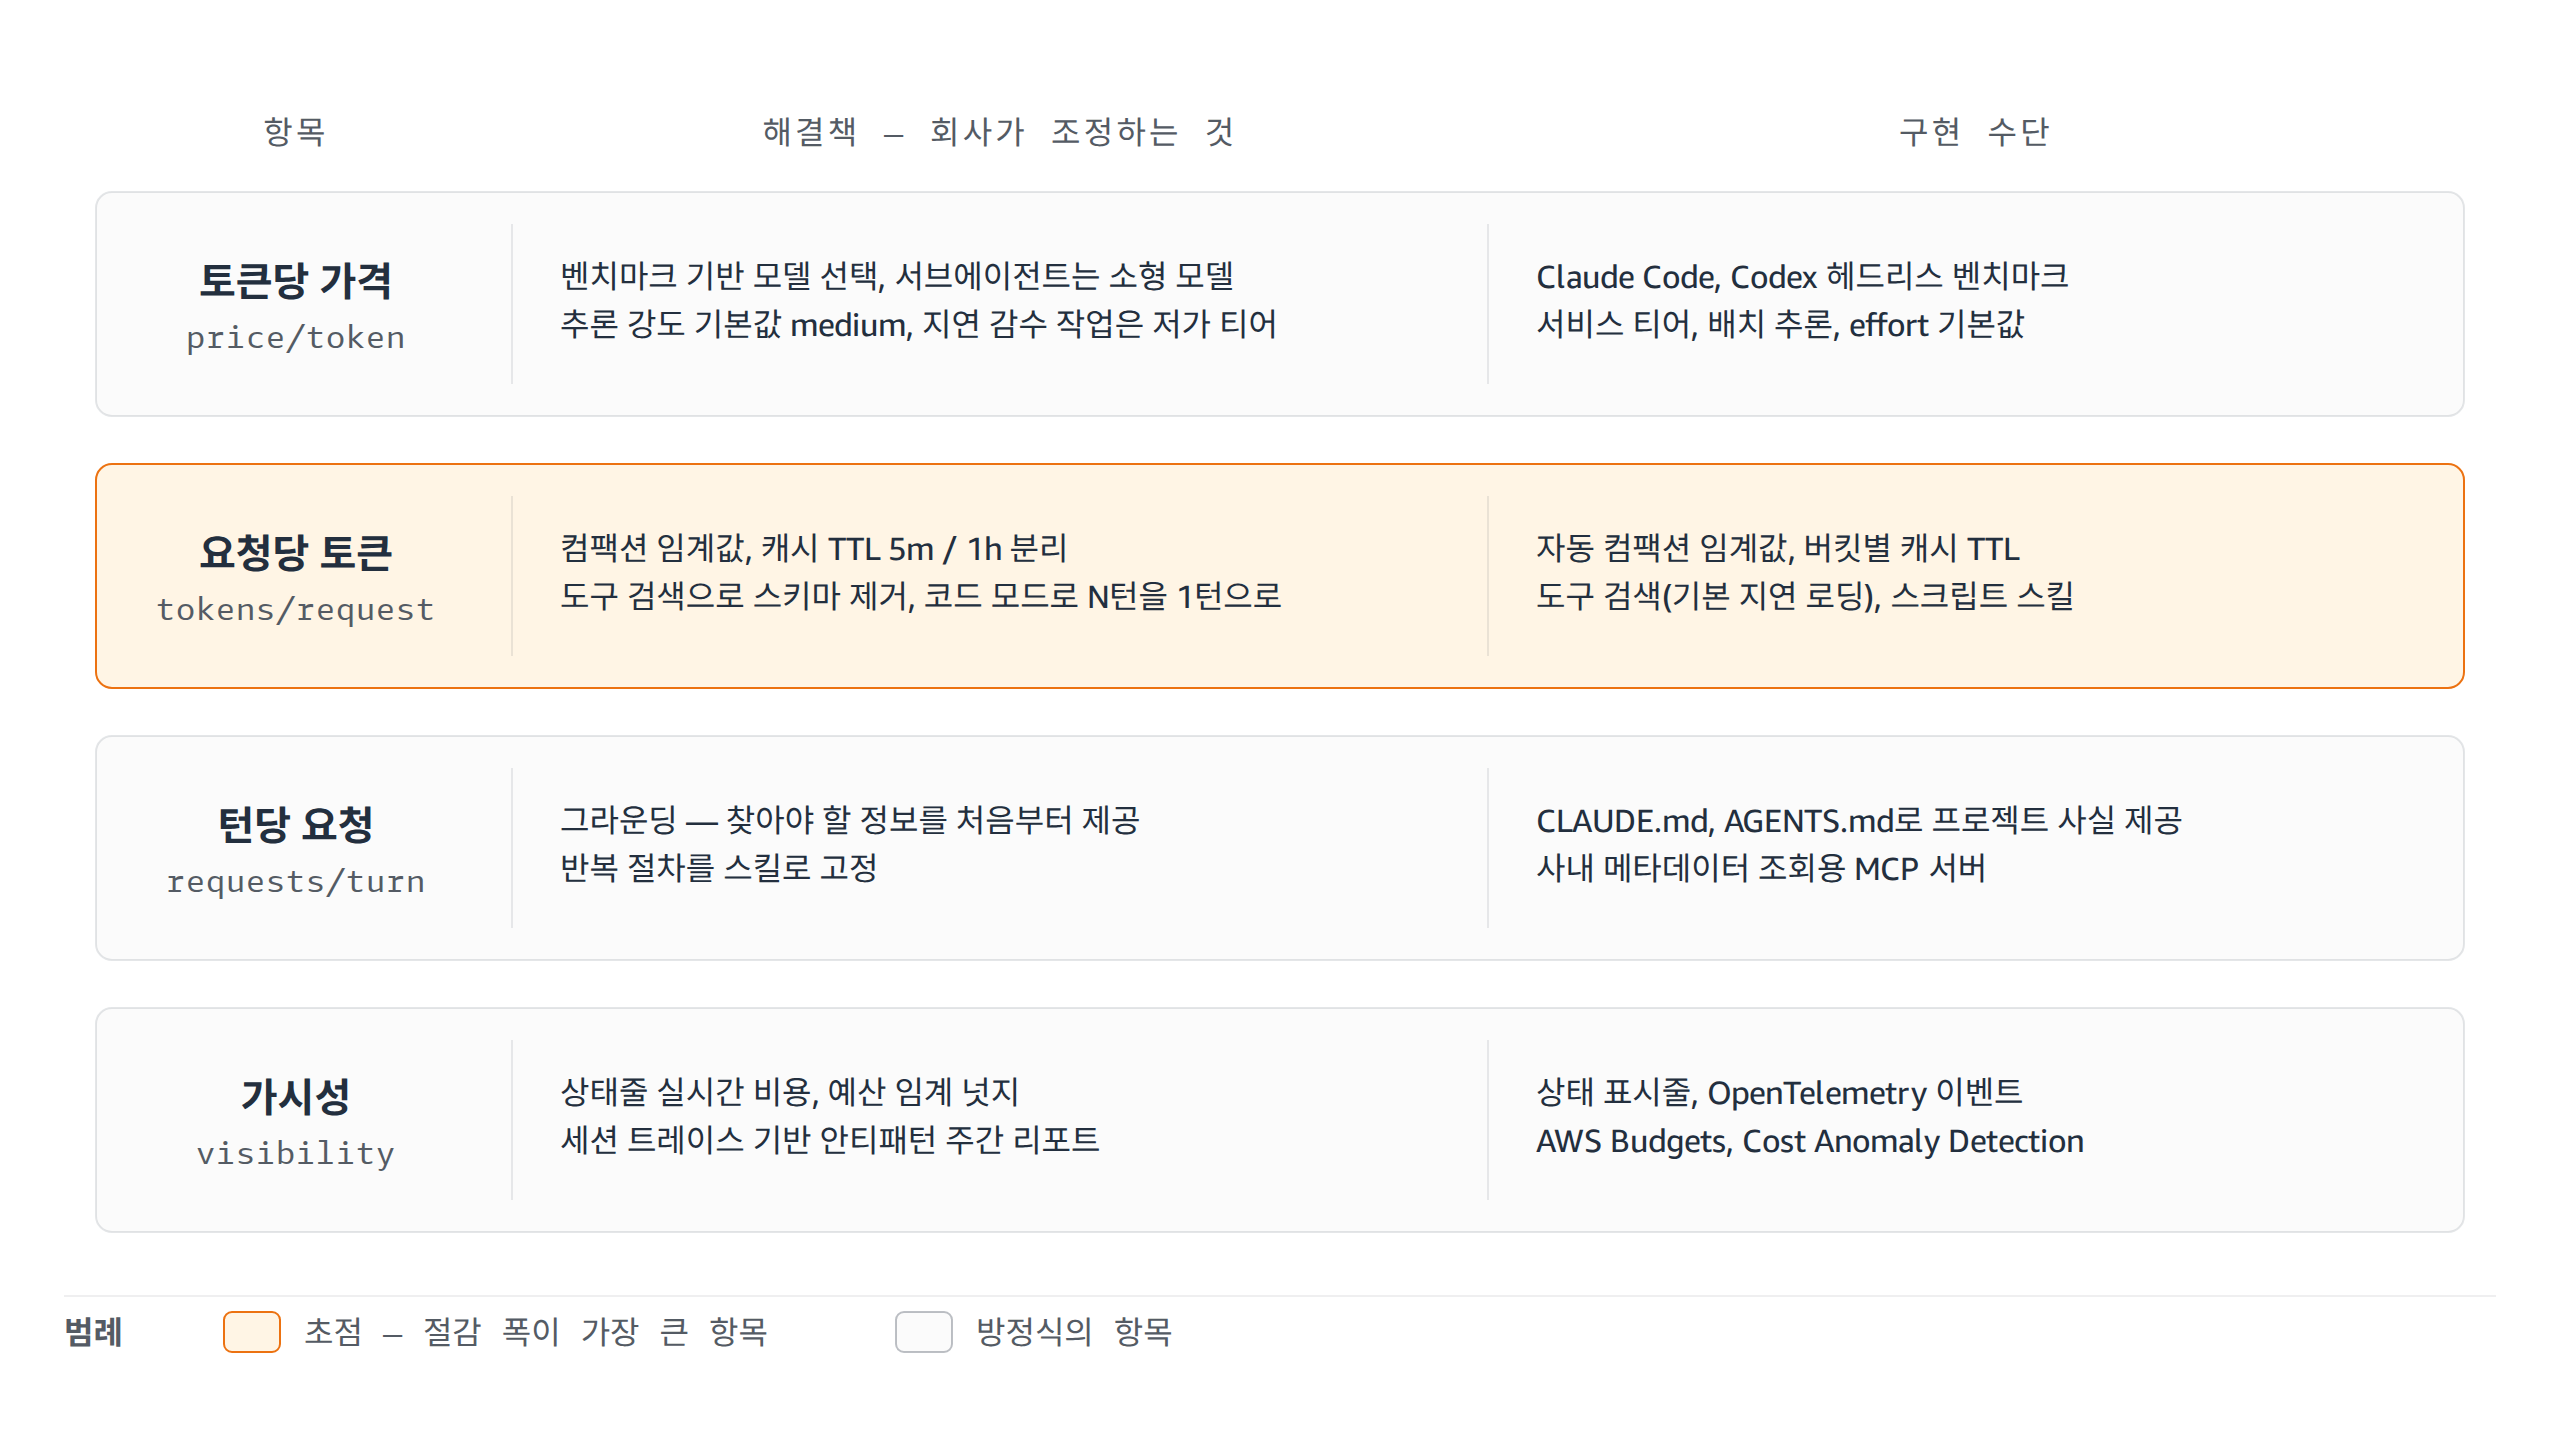
그림 4. 항목별 해결책 맵 – 방정식의 각 항목을 어떤 해결책과 도구 설정, Bedrock 기능으로 움직이는지 보여 줍니다
4.1 토큰당 가격
단가표는 공급자가 정하지만 같은 작업의 토큰당 가격은 회사가 고르는 세 가지로 달라집니다. 어떤 모델에 맡길지, 그 모델을 어떤 서비스 티어로 호출할지, 얼마나 깊게 추론하게 할지입니다. 이 순서대로 살펴봅니다.
모델 선택
어떤 일을 어떤 모델에 맡길지 정하는 출발점은 실제 업무로 만든 벤치마크입니다. Uber는 모든 PR의 AI 코드 리뷰를 맡는 uReview의 벤치마크를 알려진 버그가 든 실제 PR로 만들어 리뷰 정확도와 리뷰당 비용, 지연을 함께 채점합니다. 리뷰 정확도는 지적한 것 가운데 실제 버그의 비율(정밀도)과 실제 버그 가운데 찾아낸 비율(재현율)을 함께 반영하는 F1 점수입니다. Uber에 따르면 모델을 바꾼 뒤 리뷰 정확도는 올라가고 PR당 비용은 크게 내려갔습니다.
Claude Code와 Codex라면 헤드리스 모드(claude -p, codex exec)로 같은 벤치마크 작업을 후보 모델마다 실행하고 결과를 자체 채점 스크립트로 비교합니다. 같은 실행의 OpenTelemetry 이벤트로 완료 작업당 비용을 계산해 CI/CD 게이트에 두면 모델 교체가 배포 절차의 일부가 됩니다. 비교할 때는 한 번에 한 변수만 바꿉니다.
인터랙티브 계층에서 가장 큰 해결책은 서브에이전트(subagent, 주 에이전트가 하위 작업을 위임하는 에이전트)의 기본 모델입니다. 서브에이전트는 입력이 명확한 작업을 맡으므로 프론티어급 추론이 필요 없는 경우가 많습니다. Uber는 서브에이전트의 기본 모델을 더 저렴한 모델로 낮추되 수동 오버라이드는 허용하는 설정이 가장 효과가 큰 해결책이었다고 밝힙니다. 주 모델은 작업 분해와 평가를, 서브에이전트는 실행을 맡습니다.
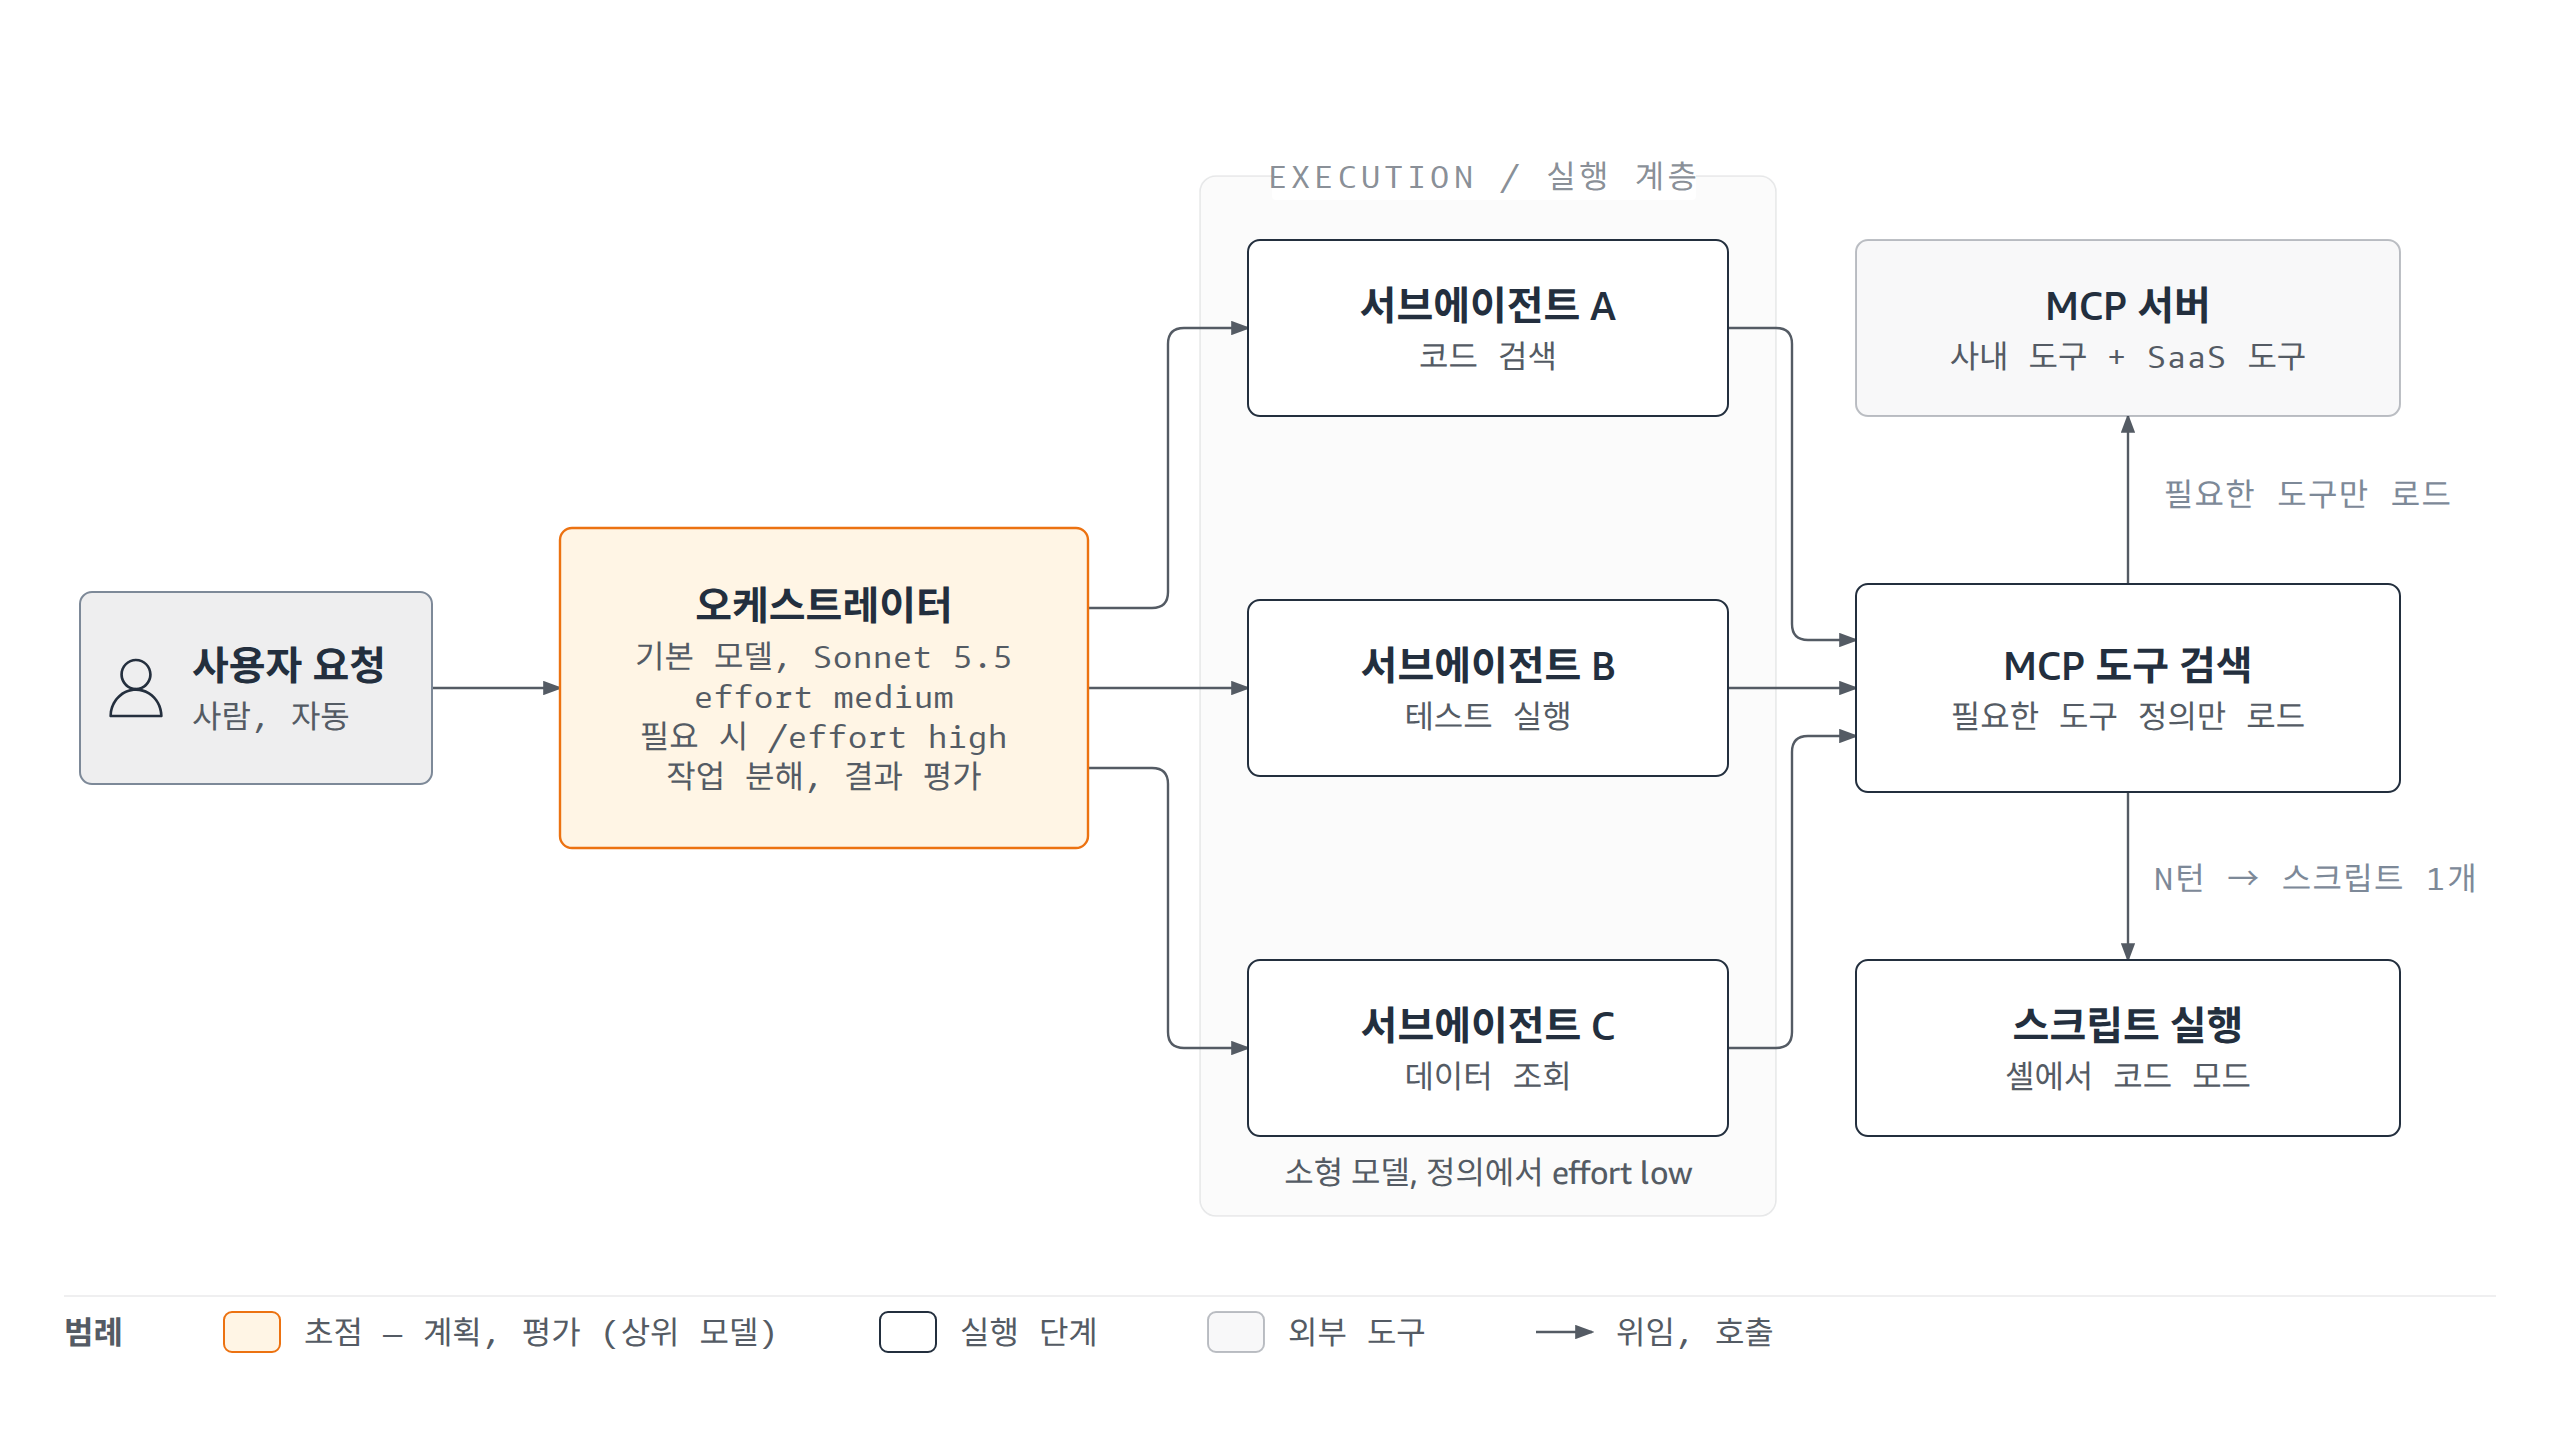
그림 5. 오케스트레이터와 서브에이전트의 모델, 추론 강도 분리 – 계획하는 모델과 실행하는 모델의 단가 차이가 총비용을 좌우합니다
Amazon Bedrock에서는 오케스트레이터에 Claude Opus 5.5나 Claude Sonnet 5.5를, 서브에이전트에 Claude Haiku 5.5를 둡니다. Claude Code에서는 ANTHROPIC_DEFAULT_HAIKU_MODEL이 haiku 별칭이 가리킬 소형 모델, 곧 Haiku 5.5의 추론 프로필을 정합니다. CLAUDE_CODE_SUBAGENT_MODEL=haiku는 서브에이전트의 기본 모델을 그 별칭으로 내립니다. 서브에이전트 정의의 model 필드나 호출별 모델 지정이 있으면 그쪽이 우선하므로 수동 오버라이드 경로는 남습니다. 다만 호출별 모델은 Claude가 서브에이전트를 띄울 때 넘기는 값이기도 해서 사용자가 요청하지 않아도 Haiku 기본값을 벗어날 수 있습니다. 서브에이전트 요청의 모델 비중은 Claude Code 비용, 토큰 지표의 model과 query_source 속성으로 확인합니다.
내장 Explore와 Plan 서브에이전트는 주 대화 모델을 상속합니다. 이들까지 바꾸려면 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1이 필요하며 이때는 오버라이드도 막힙니다. 세션 제목 생성 같은 배경 작업은 이와 별개로 Bedrock에서 ANTHROPIC_DEFAULT_HAIKU_MODEL이 없으면 기본 모델이 처리합니다. 두 설정은 각각 한 줄이지만 Global 단가 기준으로 Sonnet 5.5와 Haiku 5.5는 입력과 출력 단가 모두 20배 차이가 납니다.
Codex(GPT 모델)도 같은 방식을 따릅니다. Codex 문서에 따르면 Amazon Bedrock에서 Codex가 지원하는 모델은 GPT-6 Astra, Sol, Luna이며 새 구성에는 Bedrock Runtime 공급자(amazon-bedrock-runtime)를 권장합니다. GPT-6 Sol은 기능 구현, 디버깅, 리팩터링, 코드 리뷰 같은 개발 작업을 위한 모델이고 GPT-6 Luna는 요약, 추출, 분류 같은 대량 작업을 위한 가장 효율적인 모델입니다. 그래서 기본 모델은 global.openai.gpt-6-sol로 지정합니다. 서브에이전트는 [agents]의 default_subagent_model로 global.openai.gpt-6-luna를 지정하고 최상위 모델인 GPT-6 Astra는 설계처럼 어려운 작업에만 고릅니다. Bedrock에는 9월 29일 출시된 GPT-6.1 Sol도 있고 최신 Codex의 모델 목록에도 올라와 있습니다. 입력과 출력 단가는 GPT-6 Sol과 같고 캐시 읽기 단가는 절반입니다.
| 역할 | Claude Code (Claude 5.5) | Codex (GPT-6) |
|---|---|---|
| 어려운 설계와 분석 |
Claude Opus 5.5 | GPT-6 Astra |
| 기본 모델 (오케스트레이터) |
Claude Sonnet 5.5 | GPT-6 Sol |
| 서브에이전트, 대량 작업 |
Claude Haiku 5.5 | GPT-6 Luna |
| 지정 위치 | ANTHROPIC_MODEL, ANTHROPIC_DEFAULT_HAIKU_MODEL, CLAUDE_CODE_SUBAGENT_MODEL |
model, [agents]의 default_subagent_model |
| effort 기본값 (API) |
Opus 5.5 medium, Sonnet 5.5 high, Haiku 5.5 medium | GPT-6 Sol medium |
| effort 기본값 (도구) |
Claude Code는 세 모델 모두 medium | model_reasoning_effort로 지정 |
표 5. Claude Code와 Codex의 모델 분리 (Amazon Bedrock 기준, 2026년 10월)
두 도구 모두 모델 지정 몇 줄만 바꾸면 되므로 실제 절감은 소형 모델로 보내는 작업의 비중에서 나옵니다.
GPT 모델은 같은 모델이라도 호출 경로와 요청 크기에 따라 단가가 달라집니다. GPT-6 Sol 모델 카드에 따르면 Global CRIS(전 세계 교차 리전 추론)는 OpenAI 직접 판매 단가와 같고 Mantle In-Region과 US Geo CRIS에는 10% 할증이 부과됩니다. 서울 리전에서는 Global CRIS로만 호출하므로 할증 없는 단가가 적용됩니다. 입력이 272,000토큰을 넘으면 요청 전체에 장문 단가가 적용되어 입력 단가는 2배, 출력 단가는 1.5배가 됩니다. 그래서 Codex의 자동 컴팩션 임계값은 272K 아래에 둡니다.
Claude Haiku 5.5에도 비슷한 경계가 있습니다. Haiku 5.5 모델 카드에 따르면 10만 토큰을 넘는 프롬프트는 입력, 출력, 캐시 읽기와 쓰기 모두 더 높은 장문 단가로 청구됩니다. Amazon Bedrock 요금표 기준 배율은 5배로 GPT보다 크고 기준선도 훨씬 낮습니다. 10만 토큰을 넘으면 Sonnet 5.5 대비 입력과 출력 단가 절감률이 95%에서 75%로 줄어들므로 서브에이전트 작업은 작게 나눕니다. 정의 파일을 둔 서브에이전트는 정의의 autoCompactWindow로 컴팩션 창을 따로 낮출 수 있습니다. 내장 general-purpose와 Explore 서브에이전트는 주 대화와 같은 창을 사용하므로 작업을 작게 나누는 것이 유일한 대응입니다.
서비스 티어
모델을 정했으면 그 모델을 어떤 서비스 티어로 호출할지 고릅니다. 요청에 service_tier 파라미터 하나를 더하면 됩니다.
| 선택지 | 단가 | 맞는 작업 | 제약 |
|---|---|---|---|
| Standard | 기준 단가 | 일반 실시간 요청 | 없음 |
| Flex | Standard 대비 50% 할인 | 모델 평가, 요약, 에이전트 워크 플로우처럼 지연을 감수하는 작업 | 응답 지연 감수 |
| Priority | 75% 프리미엄 | 고객 대면처럼 응답 속도가 중요한 요청 | 없음 |
| 배치 추론 | 50% 할인 | 야간 대량 평가, 분류 | Converse 타입 도구 호출과 프롬프트 캐싱 미지원, 작업별 타임아웃 24~168시간(timeoutDurationInHours) |
표 6. Amazon Bedrock 서비스 티어와 배치 추론의 단가 (티어 지원 여부는 모델 카드에서 확인)
티어 지원은 모델마다 다릅니다. 2026년 10월 현재 Claude Opus 5.5, Sonnet 5.5, Haiku 5.5와 GPT-6 Sol, Luna는 모두 Standard만 지원하므로 Flex와 배치 추론은 이를 지원하는 모델에 맡기는 작업에 적용합니다. 배치 추론은 Converse 호출 타입에서 도구 호출을 지원하지 않고 InvokeModel 네이티브 형식으로만 가능하므로 에이전트 루프를 그대로 옮기기 어렵습니다. 실무에서는 평가와 요약처럼 지연을 감수하는 요청부터 Flex 지원 모델로 보냅니다.
추론 강도
추론(thinking) 토큰은 입력보다 단가가 몇 배 높은 출력 토큰으로 과금됩니다. Uber는 추론 강도 기본값을 medium으로 두었고 상당수 작업에서 비용 대비 품질의 균형점이 여기에 있었다고 밝힙니다. Amazon Bedrock의 Claude 모델은 적응형 사고(adaptive thinking)의 effort 값으로 이 강도를 정하며 API 기본값은 모델마다 다릅니다. Claude Opus 5.5는 적응형 사고가 항상 활성화되어 있어 비활성화할 수 없고 effort 기본값은 medium입니다. Claude Sonnet 5.5는 적응형 사고가 기본으로 활성화되어 있고 effort 기본값이 high입니다. Claude Haiku 5.5는 적응형 사고가 기본이고 effort 기본값이 medium입니다.
Claude Code는 이와 달리 세 모델 모두 medium으로 시작합니다. 회사 기본값을 따로 두려면 관리형 설정의 최상위 effortLevel을 사용합니다. 사용자는 /effort로, 서브에이전트는 정의의 effort 필드로 이 값을 바꿀 수 있으므로 입력이 명확한 서브에이전트 작업은 low로 낮춥니다. 환경 변수 CLAUDE_CODE_EFFORT_LEVEL은 이 모든 오버라이드보다 우선하므로 회사 표준에는 넣지 않습니다.
Amazon Bedrock API에서 GPT-6 Sol의 추론 강도는 none부터 max까지 여섯 단계이고 기본값은 medium입니다. Codex는 단계 체계가 달라 low, medium, high, xhigh, max, ultra를 받고 none은 없습니다. 기본 모델의 강도는 model_reasoning_effort로, 서브에이전트의 강도는 default_subagent_reasoning_effort로 따로 정합니다.
4.2 요청당 토큰
모델은 상태를 기억하지 않으므로 매 턴 대화 이력, 프로젝트 컨텍스트, 도구 결과가 다시 전송됩니다. 세션 시작 때 들고 있는 5만 토큰은 100턴 세션에서 500만 토큰이 됩니다. 요청당 페이로드를 줄이는 조치가 세션 길이만큼 복리로 작용하는 이유입니다.
첫째, 컨텍스트 창은 용량이지 목표가 아닙니다. Uber는 100만 토큰 컨텍스트 모델에서도 40만 토큰에서 자동 컴팩션(compaction, 오래된 대화를 요약해 컨텍스트를 압축하는 것)을 발동시켜 전사 요청당 입력 토큰을 의미 있게 줄였습니다. 이 임계값은 개인 설정에 맡기지 않고 회사가 배포하는 하네스 설정으로 표준화해야 효과가 납니다. Claude Code는 관리형 설정의 최상위 autoCompactWindow로 컴팩션 기준 창을 줄입니다. Codex는 model_auto_compact_token_limit로 임계값을 정하되 GPT 모델은 입력이 272K를 넘으면 장문 단가가 적용되므로 그보다 낮은 25만 토큰으로 둡니다.
둘째, 프롬프트 캐시 TTL(time-to-live, 캐시 유지 시간)은 사람의 휴식 패턴에 맞춥니다. 캐시 읽기는 Opus 5.5와 Sonnet 5.5가 입력 단가의 0.05배, Haiku 5.5가 0.1배인 반면 캐시 쓰기는 세 모델 모두 5분 TTL이 1.25배, 1시간 TTL이 2배입니다. 엔지니어가 세션을 5분 넘게 비우는 일이 잦으면 5분 캐시는 만료되고 Prefix(요청의 앞부분) 전체를 다시 써야 합니다. Uber는 이런 휴식이 잦은 인터랙티브 세션을 1시간 TTL로 바꾸었습니다. 짧은 단일 작업에 집중하는 서브에이전트는 5분 TTL을 유지했습니다.
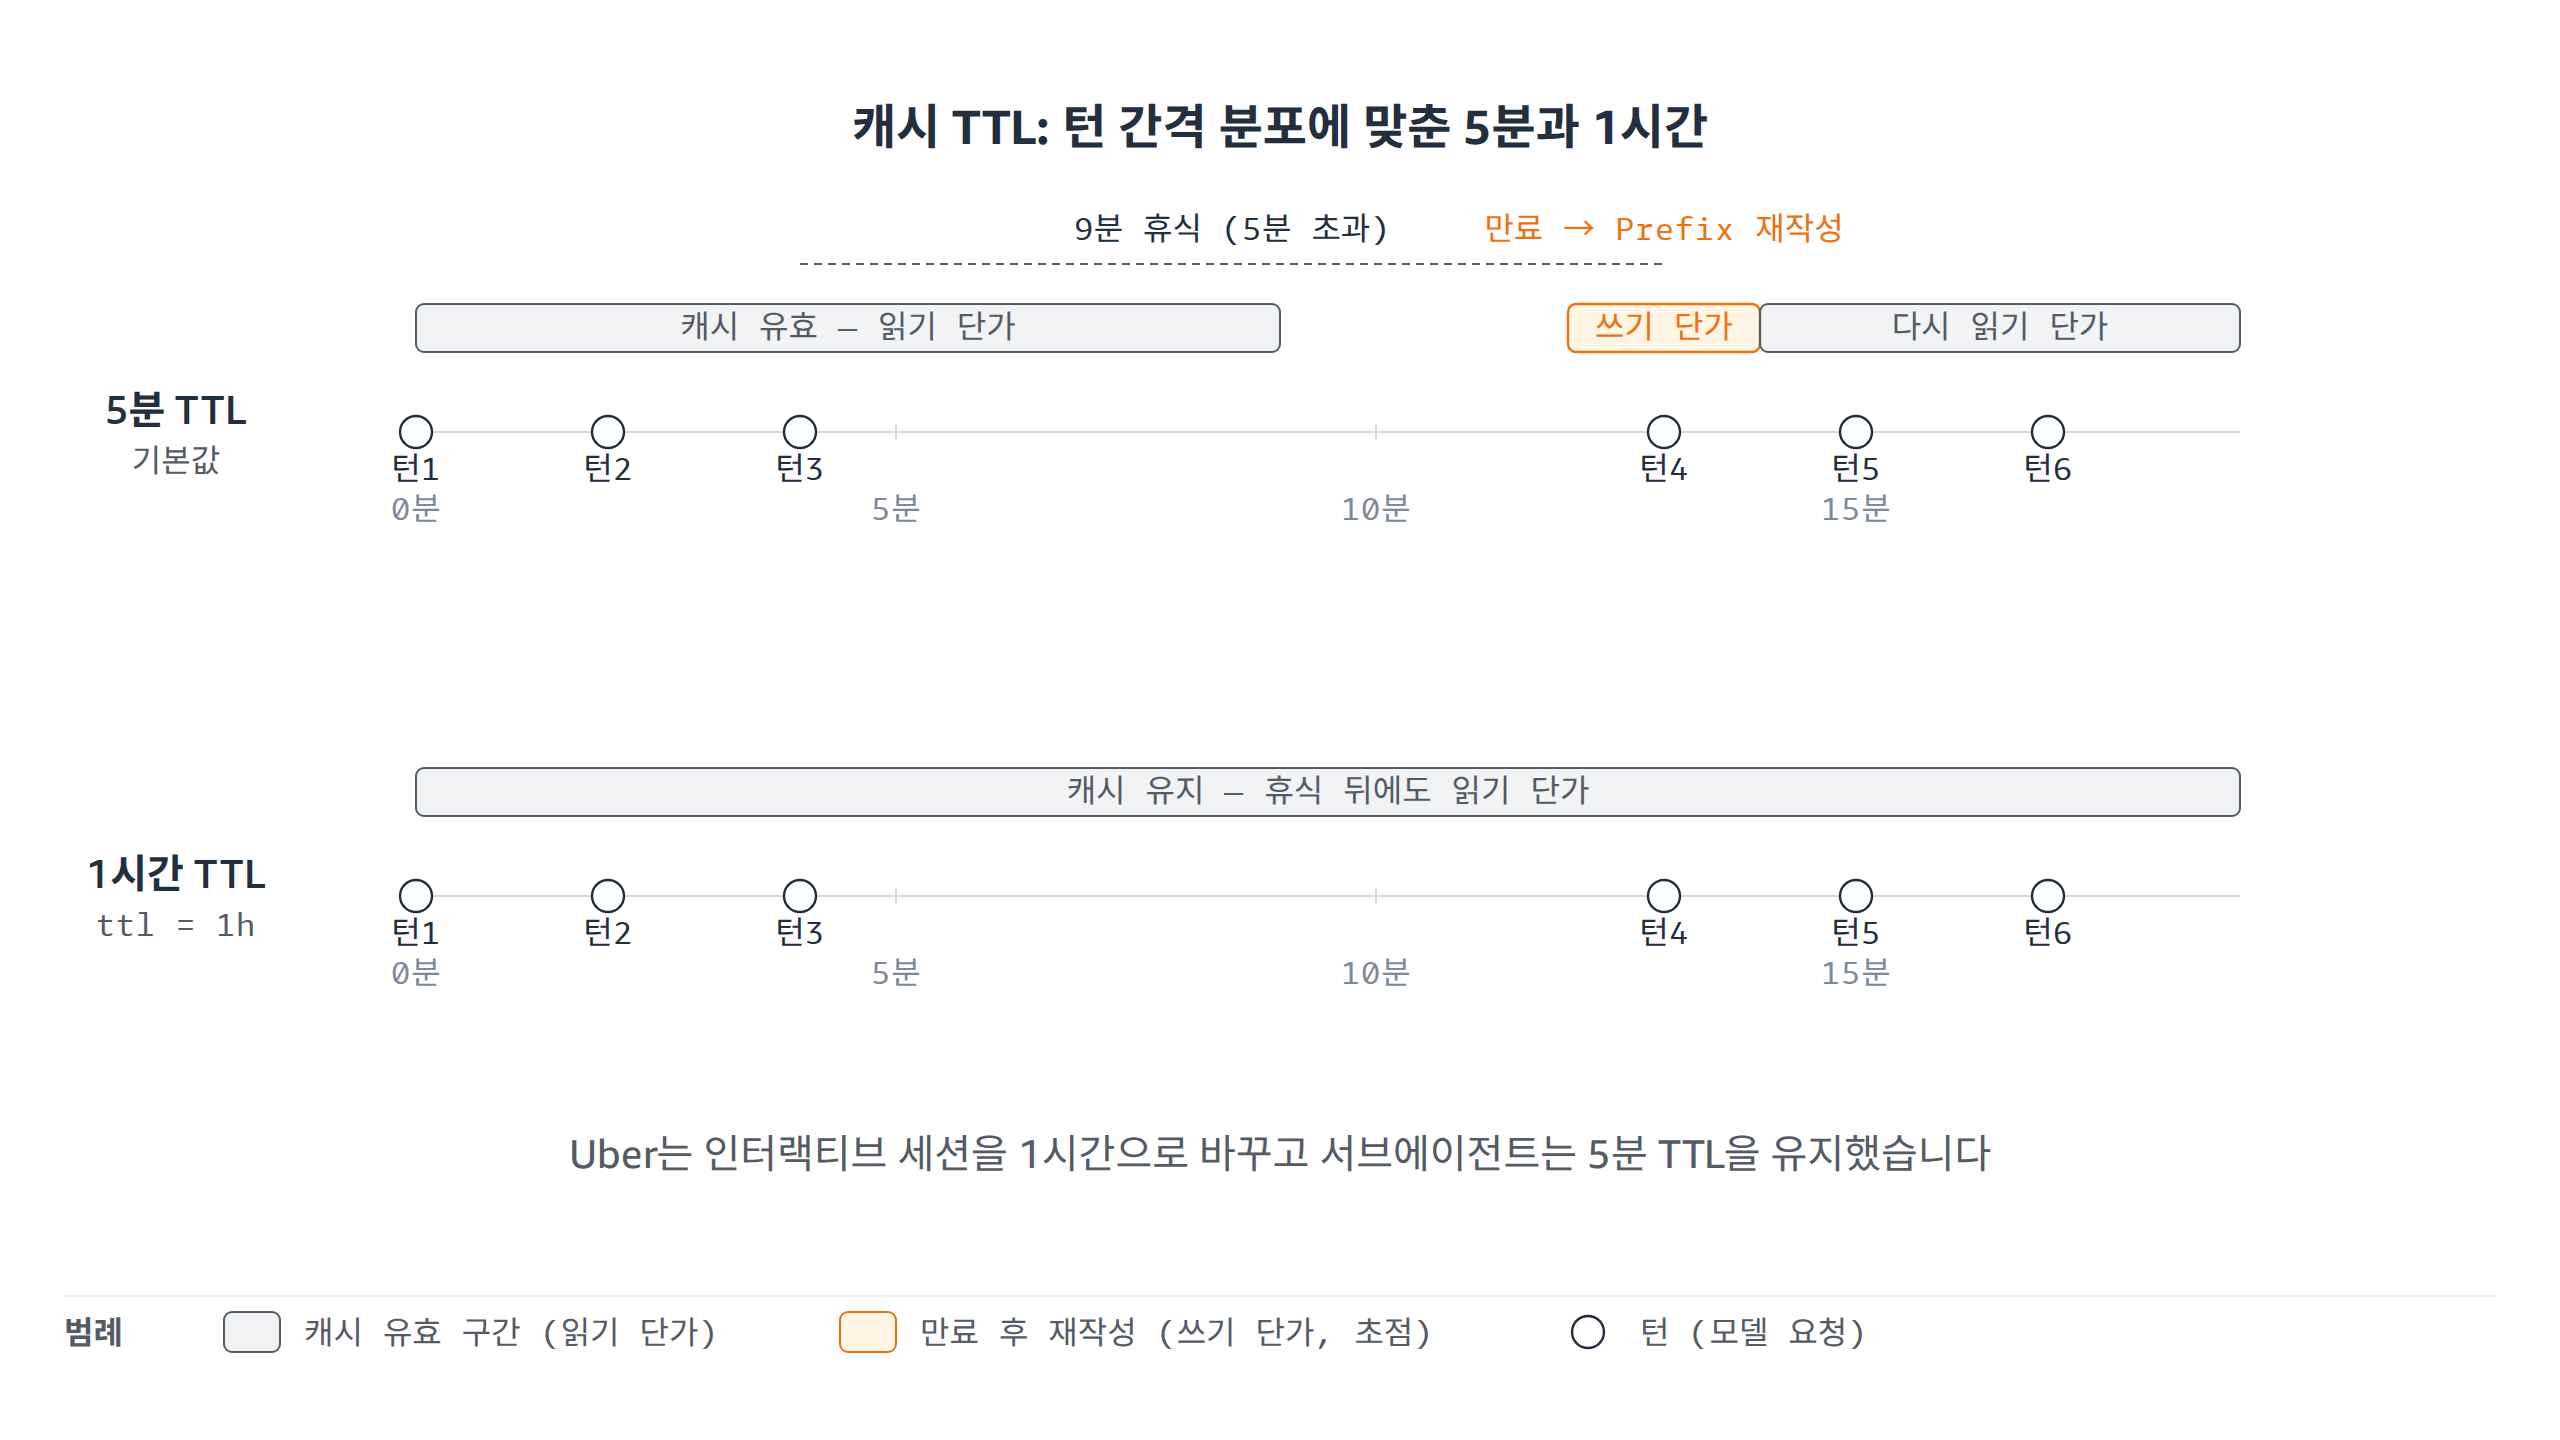
그림 6. 프롬프트 캐시 TTL과 턴 간격 – 9분 휴식 뒤 5분 캐시는 만료되어 다시 쓰이고 1시간 캐시는 읽기 단가로 이어집니다
Claude Code는 캐시 체크포인트를 스스로 배치하므로 사용자가 정할 것은 TTL입니다. Claude Code는 요청을 주 대화(인터랙티브 턴과 -p 실행)와 그 외(서브에이전트, 컴팩션, 세션 제목 생성 등)의 두 버킷으로 나눕니다. ENABLE_PROMPT_CACHING_1H=1은 Bedrock에서도 1시간 TTL을 요청하지만 두 버킷 모두에 적용됩니다. 그래서 Uber와 같은 분리는 버킷별 변수로 지정합니다. 주 대화는 CLAUDE_CODE_PROMPT_CACHE_TTL=1h, 그 외는 CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL=5m로 둡니다. 헤드리스 작업만 실행되는 CI 러너에는 FORCE_PROMPT_CACHING_5M=1을 둡니다. Codex가 사용하는 GPT-6 계열은 캐시 TTL이 30분으로 고정되어 있어 별도 설정이 필요 없습니다. 캐시 히트는 처리량 한도(rate limit)에서 차감되지 않으므로 히트율은 스로틀링 여유와도 직결됩니다.
셋째, MCP 도구 스키마를 컨텍스트에 미리 싣지 않습니다. MCP(Model Context Protocol, 에이전트가 외부 도구를 발견하고 호출하는 개방형 프로토콜) 도구 정의는 생각보다 무겁습니다. Uber에 따르면 도구 100개 이상을 설치한 환경에서 표준 MCP 방식의 사전 적재만으로 첫 프롬프트에 약 5만~7만 토큰이 더해졌고 이 고정비가 매 턴 다시 전송됐습니다. Claude Agent SDK 문서도 도구 50개의 정의가 1만~2만 토큰을 차지하며 한 번에 30~50개를 넘게 실으면 도구 선택 정확도가 떨어진다고 설명합니다.
Claude Code는 Anthropic API나 Amazon Bedrock에 직접 연결하면 도구 검색(tool search)이 기본으로 활성화됩니다. 도구 정의를 미리 싣지 않고 컨텍스트에는 도구 이름과 검색 도구만 남기며 필요한 도구 정의는 검색할 때마다 다섯 개까지 불러옵니다. 그래서 Bedrock 직접 연결에서는 아무것도 설정하지 않는 것이 지연 로딩입니다. 사정이 달라지는 것은 ANTHROPIC_BASE_URL로 사내 LLM 게이트웨이나 프록시를 거칠 때입니다. 대부분의 프록시가 지연 로딩에 필요한 도구 참조 블록을 전달하지 못하므로 Claude Code는 사전 적재로 돌아갑니다. 이때 지연 로딩을 유지하려면 ENABLE_TOOL_SEARCH=true를 설정합니다. 게이트웨이가 도구 참조 블록을 전달하지 않으면 요청이 실패하므로 지원 여부를 먼저 확인합니다. Bedrock 형식 게이트웨이(CLAUDE_CODE_USE_BEDROCK=1과 ANTHROPIC_BEDROCK_BASE_URL)는 도구 검색이 기본으로 유지되므로 설정을 바꾸지 않습니다. 대신 이 게이트웨이는 anthropic_beta와 anthropic_version 본문 필드를 그대로 전달해야 합니다. auto:N 값은 반대로 도구 정의가 컨텍스트의 N% 미만이면 미리 싣는 임계 모드라서 도구 스키마를 미리 싣지 않으려는 목적에는 맞지 않습니다.
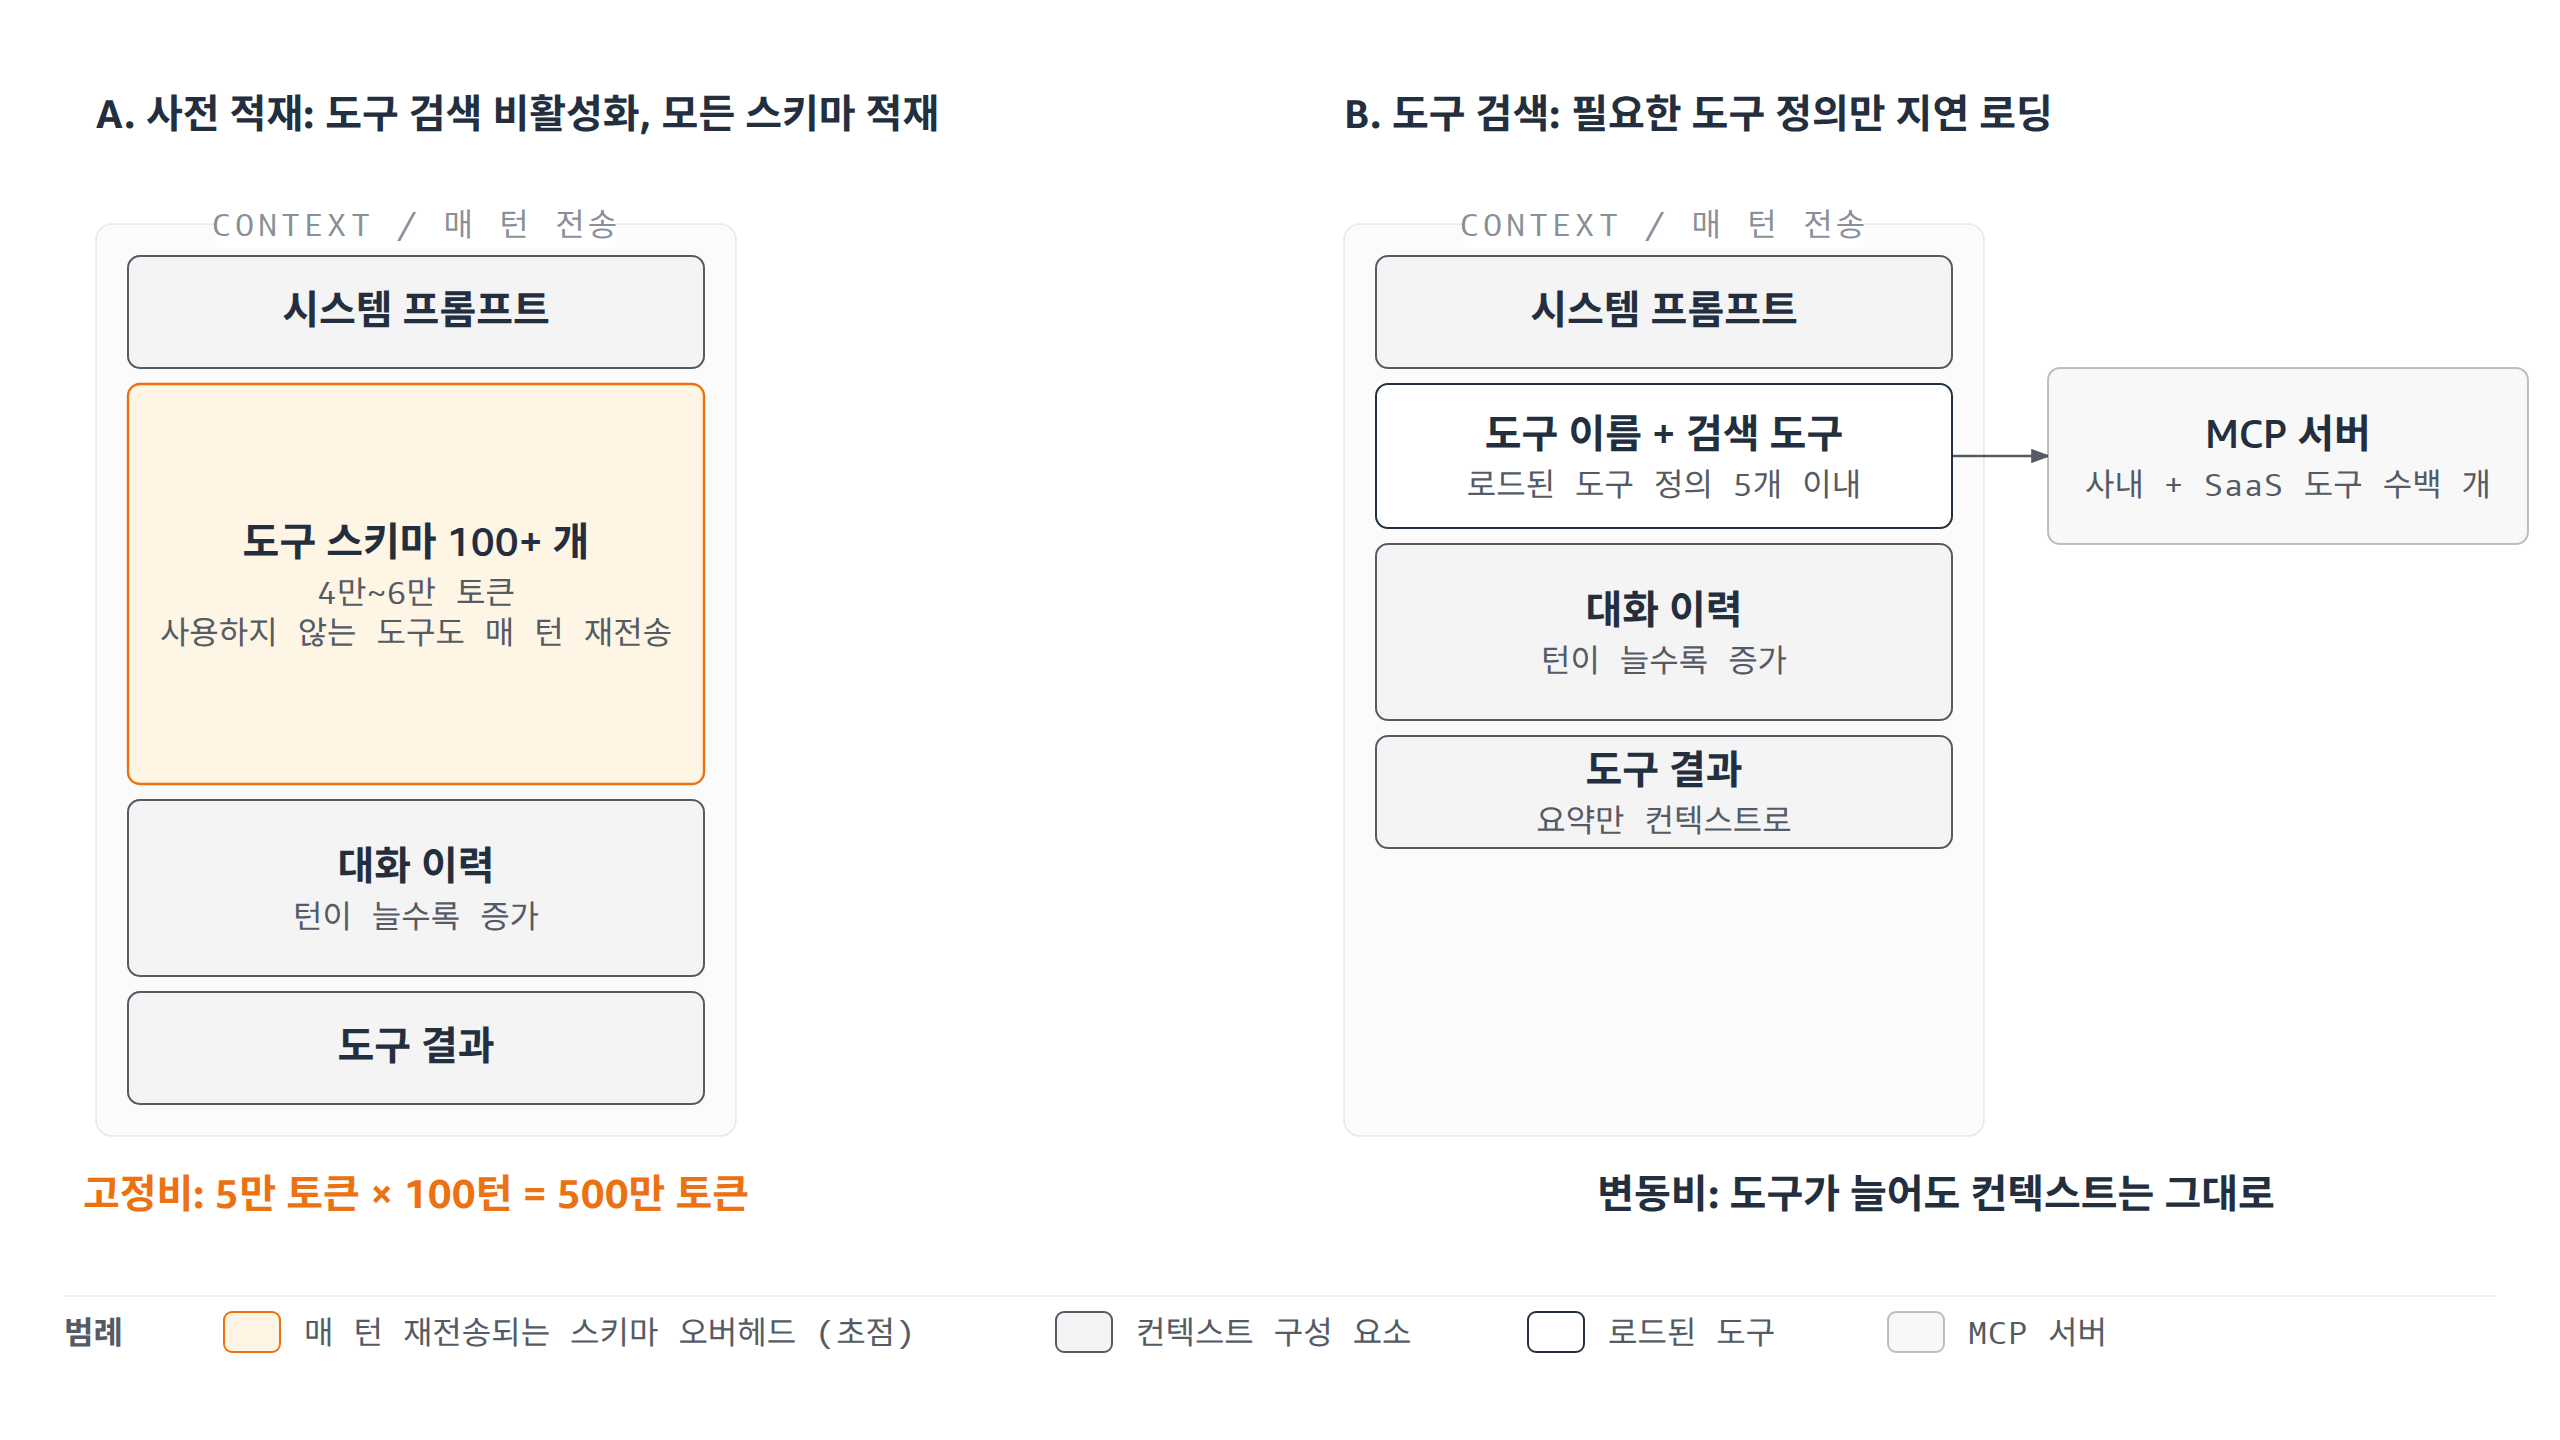
그림 7. 도구 스키마 사전 적재와 도구 검색 – 왼쪽은 매 턴 재전송되는 고정비, 오른쪽은 필요할 때만 드는 변동비입니다
넷째, N번의 턴을 스크립트 하나로 바꿉니다. 표준 도구 호출은 동작마다 모델 턴이 필요합니다. Uber의 예에서는 SQL 한 건도 제출, 상태 폴링 2~5회, 결과 조회를 거칩니다. 코드 모드(code mode)는 이 흐름을 코드 루프로 묶어 중간 폴링을 컨텍스트 밖에 두고 요약만 돌려받습니다. Uber가 같은 Claude Code 세션에서 같은 SQL 쿼리를 두 경로로 측정했더니 1행짜리 결과에서도 코드 모드의 토큰이 절반 넘게 줄었습니다. N턴이 스크립트 하나가 되는 대량 작업에서는 절감률이 90%를 넘었습니다. Claude Code와 Codex는 셸에서 스크립트를 직접 실행하므로 별도 실행 환경 없이 이 방식을 적용합니다. Uber는 가장 많이 사용하는 MCP 서버를 위한 코드 모드 스킬(skill, 에이전트가 재사용하는 절차 정의)을 25개 넘게 미리 만들어 표준 워크 플로우가 가장 저렴한 경로를 기본으로 타게 했습니다.
4.3 턴당 요청
그라운딩되지 않은 에이전트는 저렴하게 실패하지 않고 천천히 고비용으로 실패합니다. 커지는 컨텍스트를 매번 다시 보내며 “한 곳만 더 찾아보는” 일을 반복하기 때문입니다. Uber가 공개한 비교 실험에서 사내 시스템 30여 개의 메타데이터를 통합한 컨텍스트 그래프를 조회한 에이전트는 50명 이상의 분석가가 사용하는 테이블을 찾아 38초 만에 정답을 냈습니다. 그래프가 없는 에이전트는 20분 동안 코드를 뒤지며 서브에이전트 2개를 띄우고 오류 3번을 겪은 끝에 잘못된 결론에 도달했습니다. 그라운딩은 토큰 절약이 아니라 턴당 요청 절약입니다.
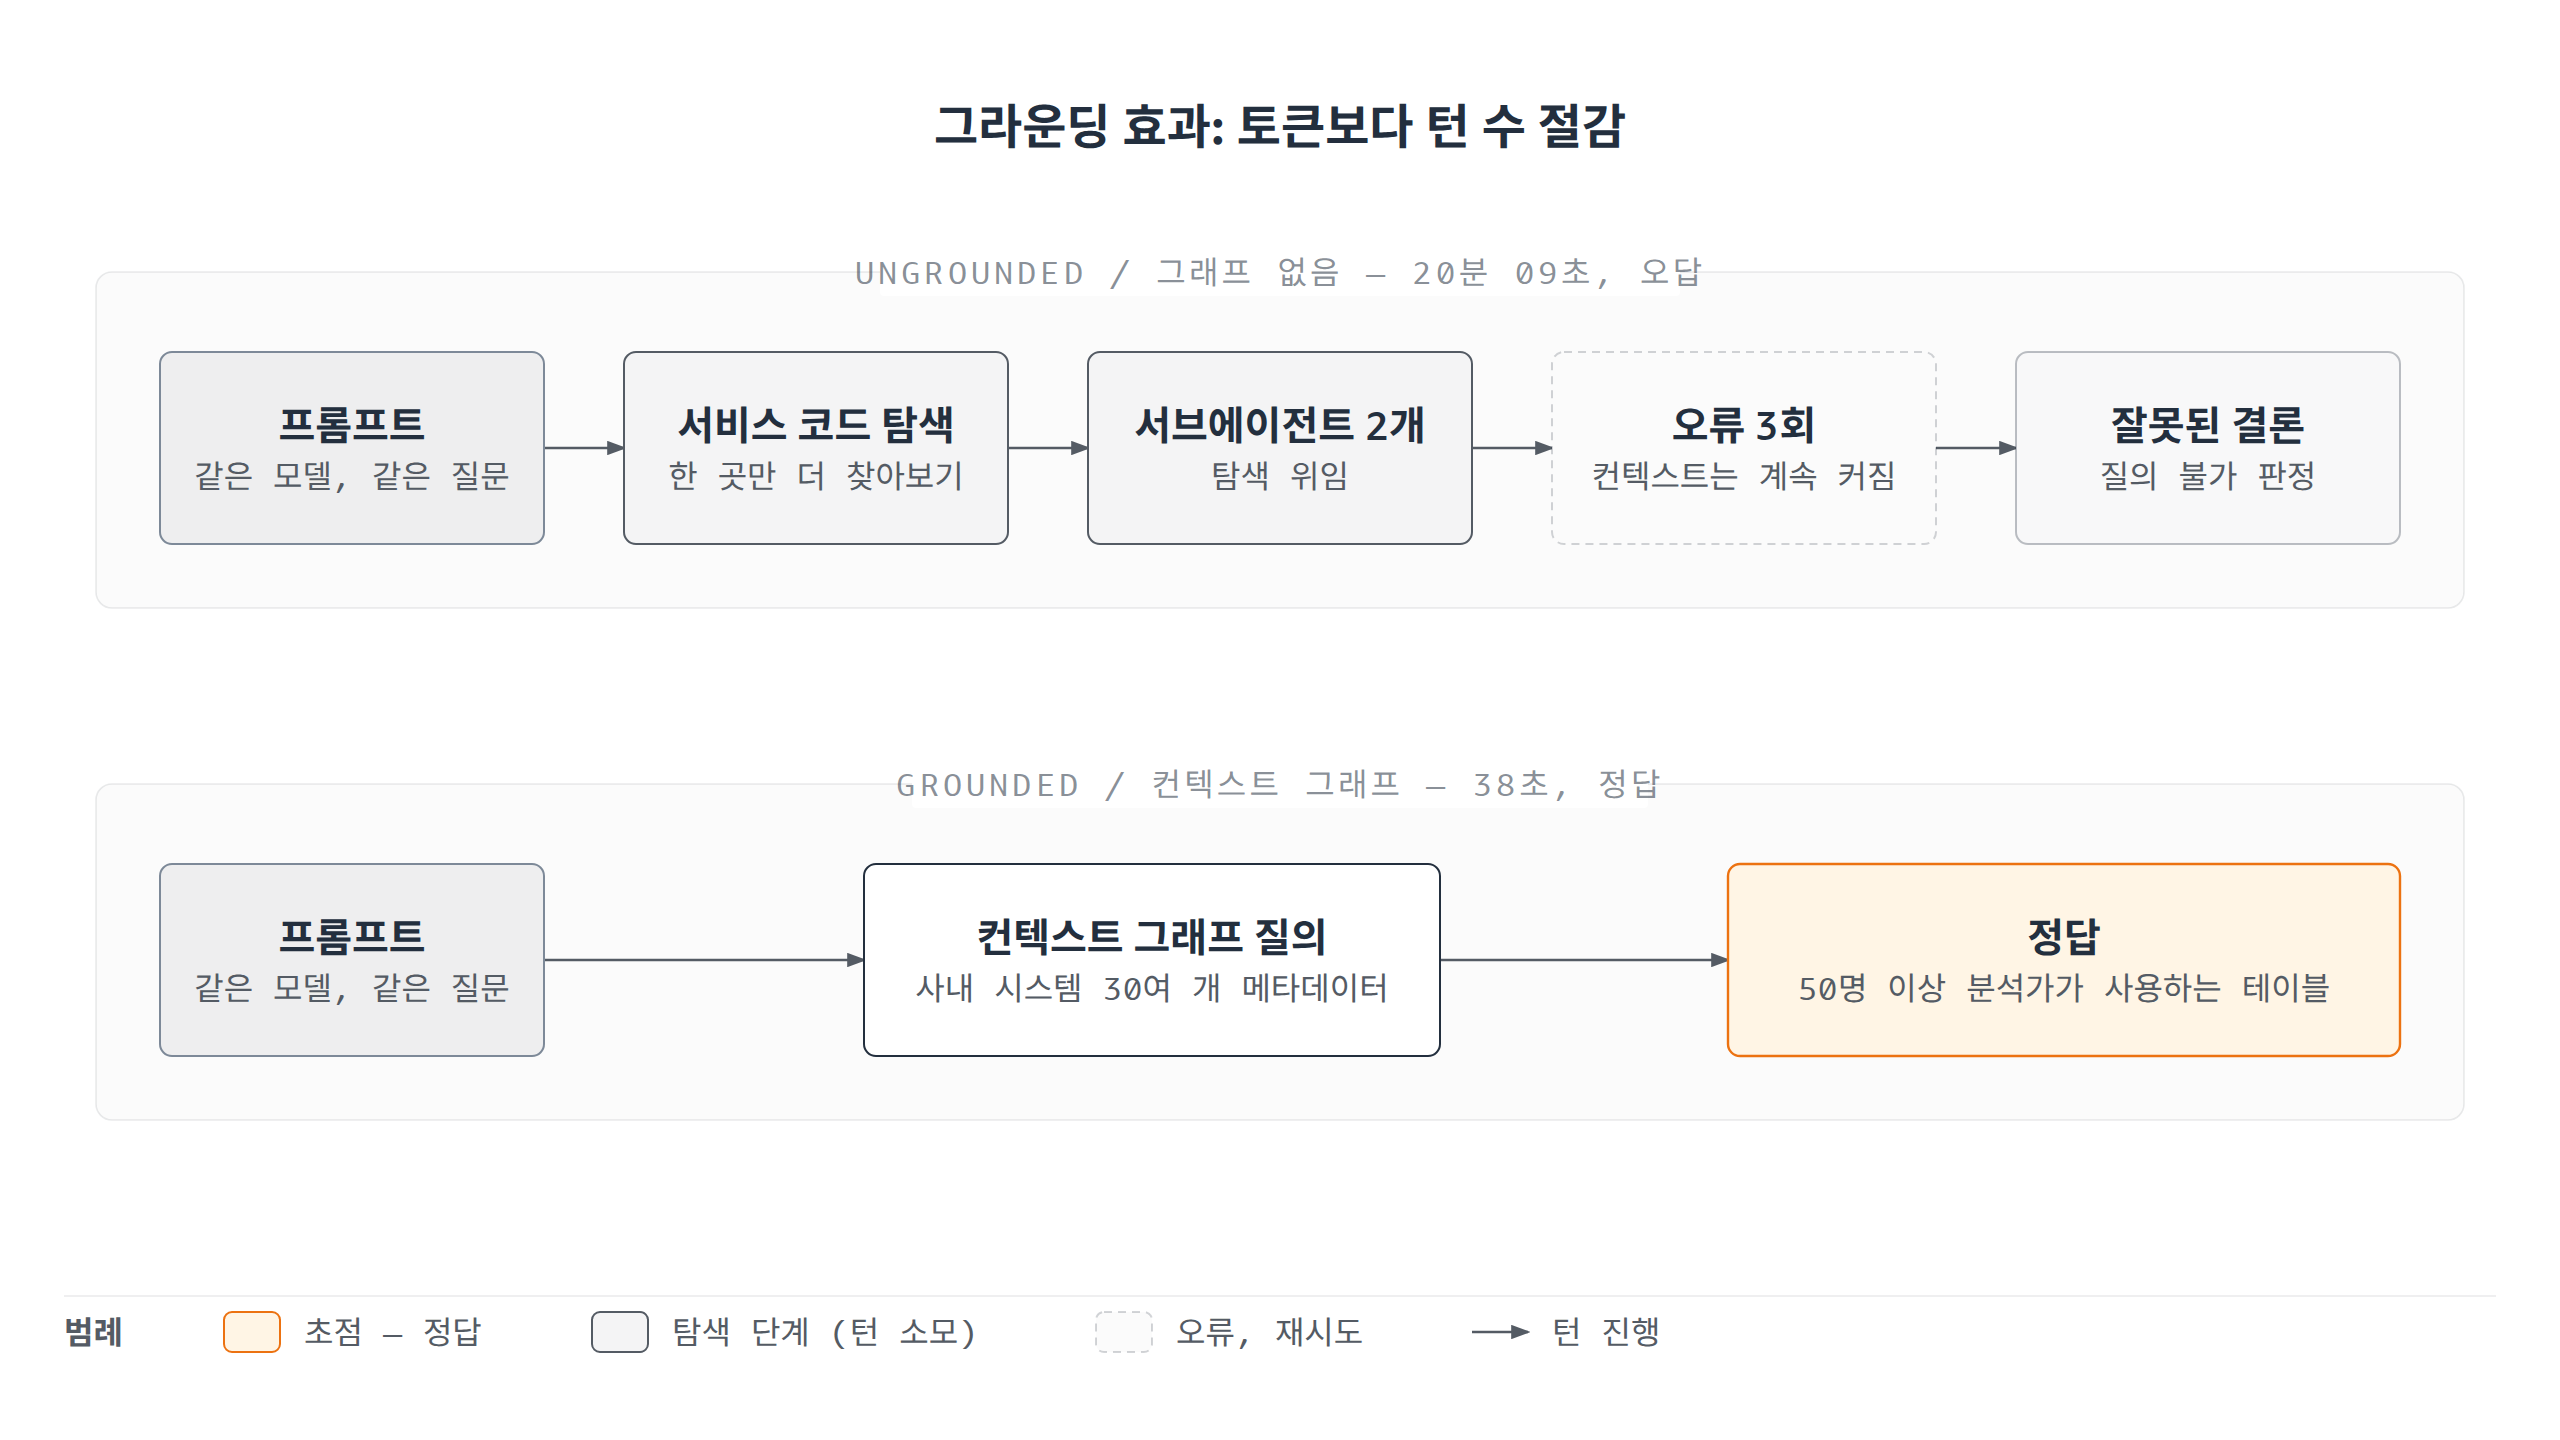
그림 8. 그라운딩 유무에 따른 턴 수 비교 – Uber가 공개한 실험 기준으로 한 경로는 20분 뒤 오답, 다른 경로는 38초 만에 정답을 냈습니다
Uber의 그래프는 2,400만 노드 규모의 투자지만 원리는 어느 조직에나 적용됩니다. 에이전트가 매번 다시 찾는 정보를 처음부터 전달하면 됩니다. Claude Code는 CLAUDE.md, Codex는 AGENTS.md를 세션 시작 때 읽으므로 빌드 명령, 디렉터리 구조, 자주 조회하는 테이블 같은 사실을 여기에 적어 둡니다. 이 파일은 매 요청에 함께 실리므로 짧게 유지하는 것이 좋습니다. 서비스 카탈로그, 테이블 사용 이력, 배포 기록 같은 사내 메타데이터는 조회용 MCP 서버로 노출해 에이전트가 코드를 뒤지는 대신 한 번의 질의로 답을 얻게 합니다. 효과는 OpenTelemetry 이벤트의 턴당 요청 수와 세션당 도구 오류 수로 확인합니다.
4.4 가시성과 넛지
Uber는 엄격한 캡 대신 실시간 추적과 자동 넛지를 택했습니다. 하네스 상태 표시줄에 세션 비용을 항상 띄웁니다. 예산은 도구별로 쪼개지 않고 인터랙티브 하네스 전체가 공유하는 티어 하나로 운영하며 관리형 에이전트는 별도 티어로 둡니다. 예상 지출의 50/80/100% 시점에 Slack 알림이 가고 매니저 승인으로 티어를 빠르게 올립니다. 엔지니어가 ROI를 스스로 판단하게 두면서 대규모 지출만 막는 설계입니다.
AWS에서는 이 구조를 주기가 다른 세 계층으로 만듭니다. 세션 중에는 실시간 비용을 보여 주고, 하루 몇 차례 예산 임계 알림을 보내고, 매주 안티패턴 리포트로 원인과 처방을 찾습니다.
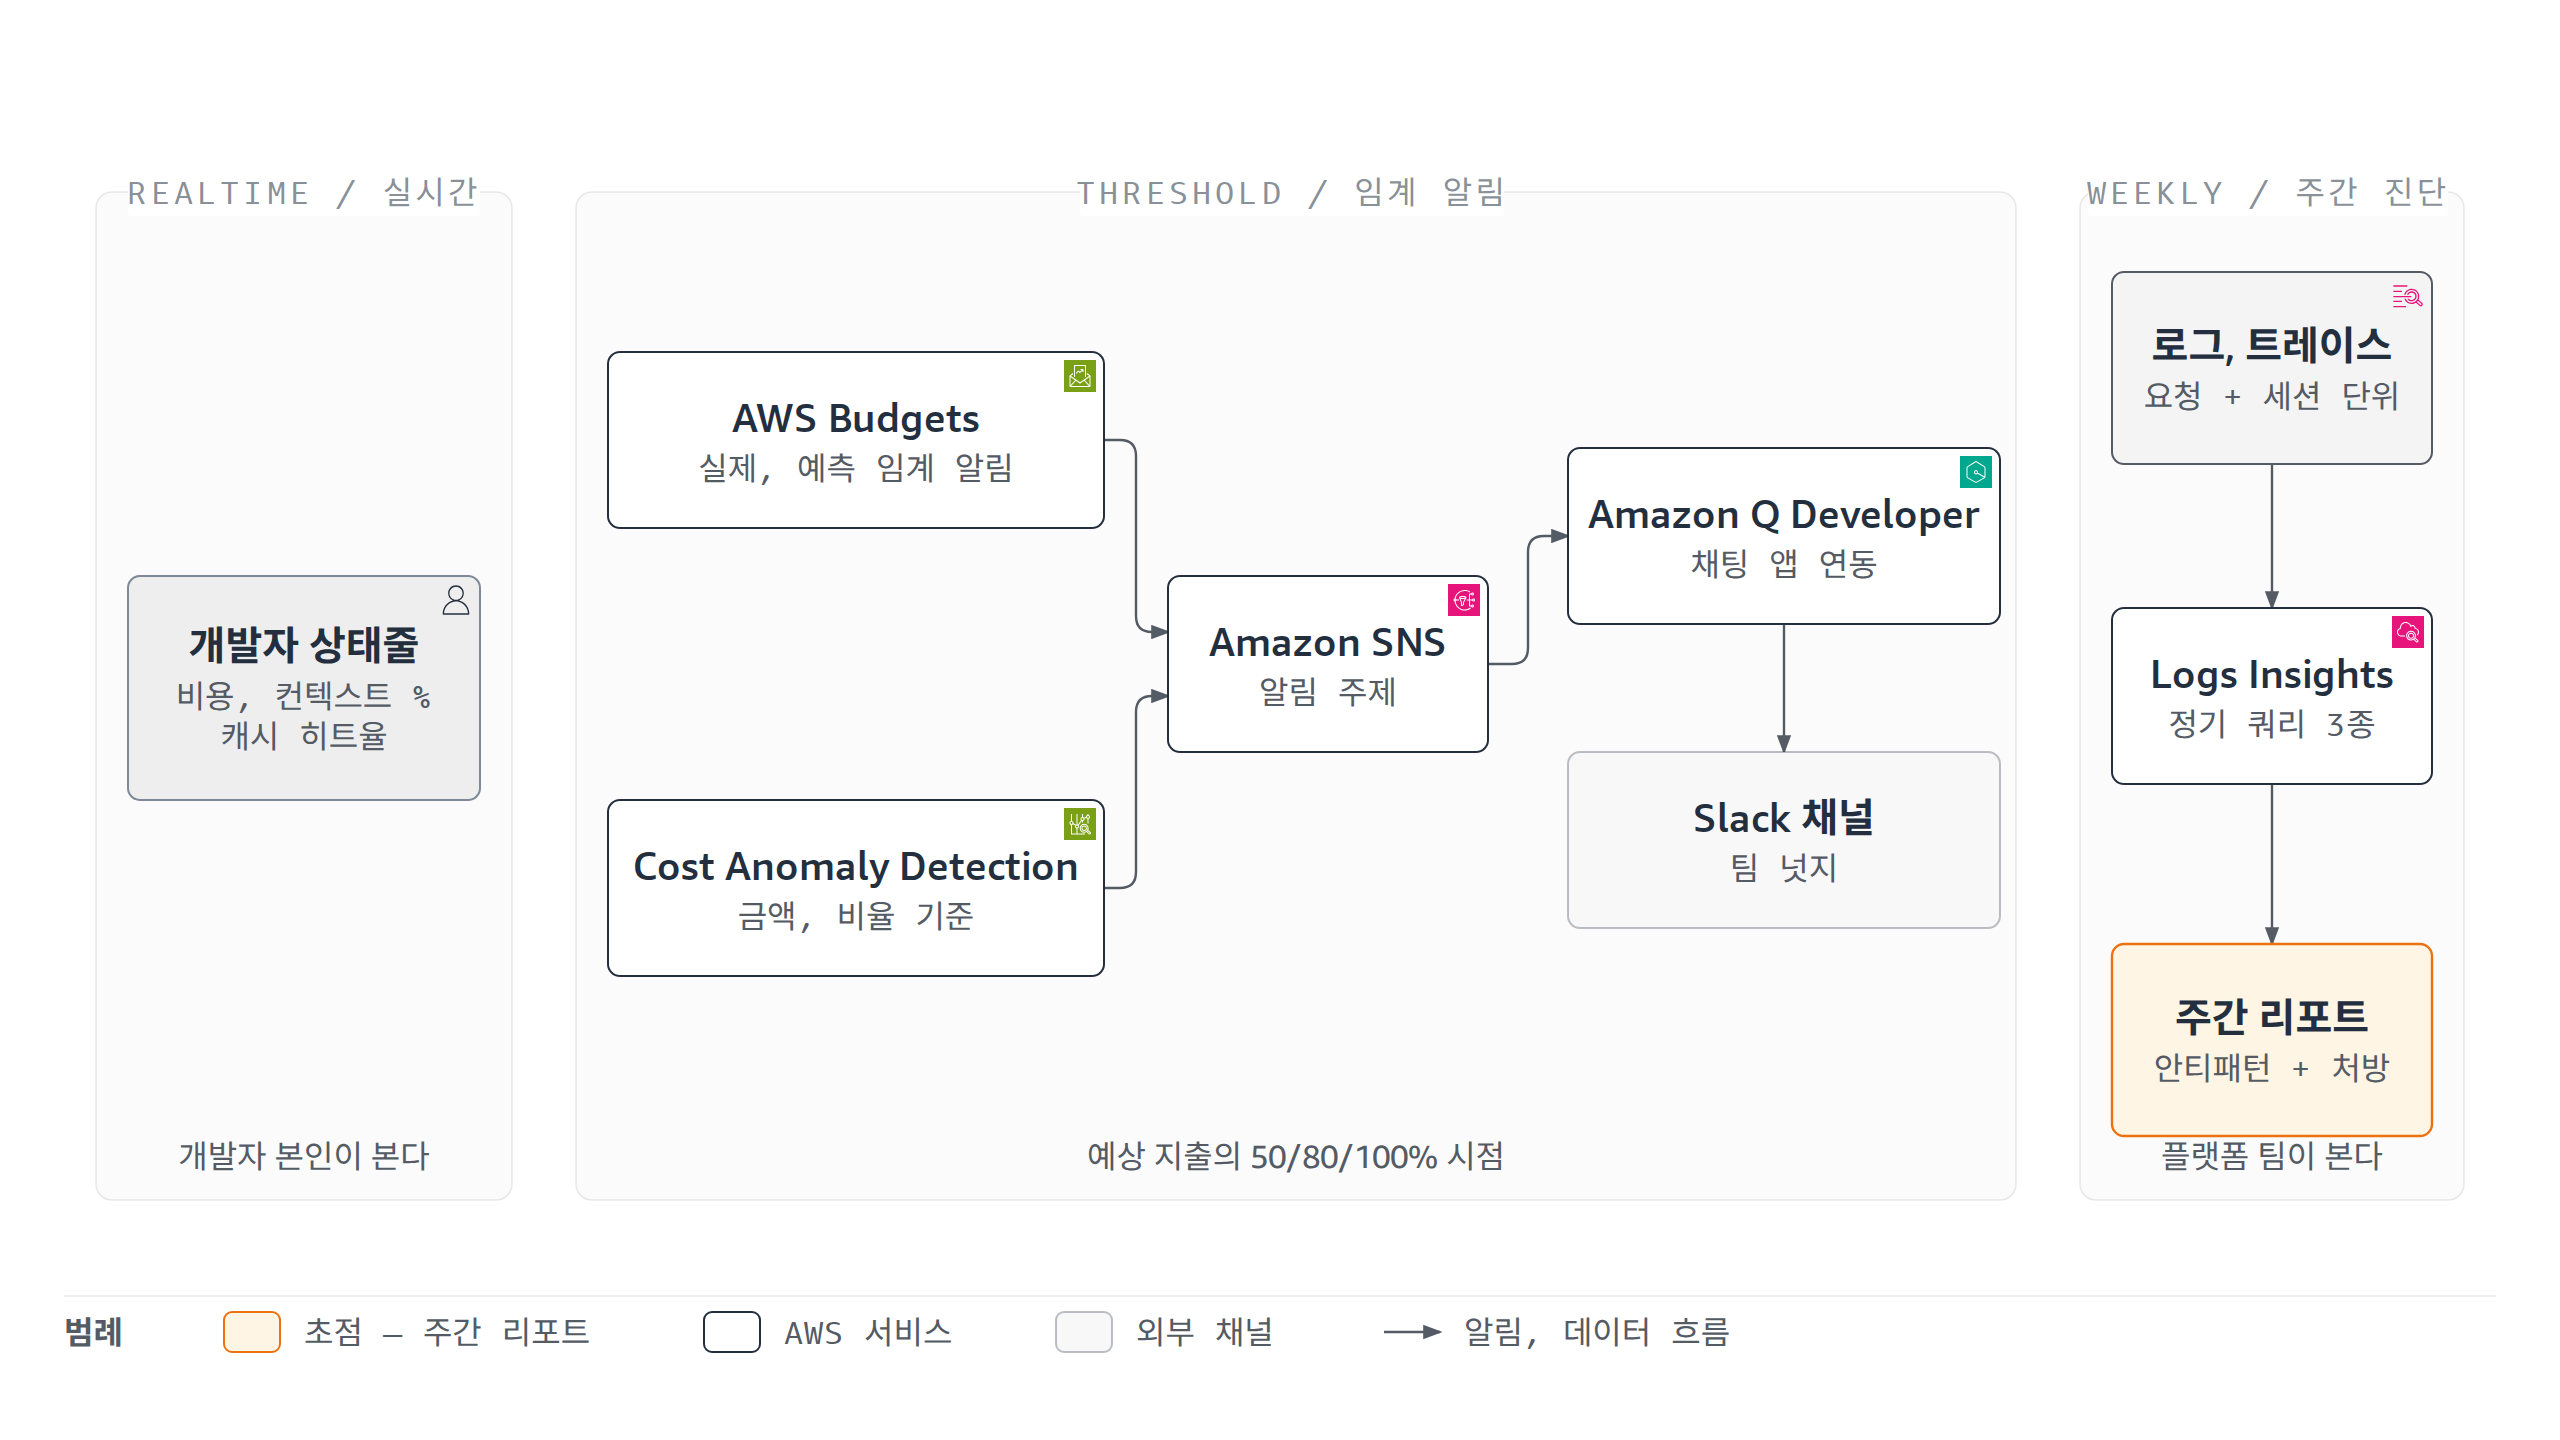
그림 9. AWS 위의 가시성과 넛지 세 계층 – 실시간 비용, 예산 임계 알림, 주간 안티패턴 리포트가 서로 다른 주기로 작동합니다
실시간 비용
상태 표시줄은 널리 사용되는 코딩 에이전트에서 설정 한 번으로 활성화됩니다. Claude Code는 ~/.claude/settings.json의 statusLine에 셸 명령을 등록하면 세션 데이터를 JSON으로 표준 입력(stdin)에 넘겨 줍니다. 아래 스크립트는 이 JSON에서 세션 누적 비용, 컨텍스트 사용률, 캐시 히트율을 꺼내 한 줄로 출력합니다. 전체 필드는 Claude Code 문서에 있습니다. 표시 비용은 정가 기준 클라이언트 추정치이므로 실제 청구는 Bedrock 측정으로 확인합니다. 컴팩션 창을 따로 설정해도 used_percentage는 모델의 전체 컨텍스트 창을 기준으로 계산되므로 ctx 값을 컴팩션까지 남은 양으로 읽지 않습니다.
#!/bin/bash
# ~/.claude/statusline.sh
# 등록: ~/.claude/settings.json 에 "statusLine": {"type": "command", "command": "~/.claude/statusline.sh"}
input=$(cat)
MODEL=$(echo "$input" | jq -r '.model.display_name')
CTX=$(echo "$input"   | jq -r '.context_window.used_percentage // 0' | cut -d. -f1)
COST=$(echo "$input"  | jq -r '.cost.total_cost_usd // 0')
HIT=$(echo "$input"   | jq -r '((.prompt_cache.hit_ratio // 0) * 100) | floor')
printf '[%s] ctx %s%% | $%.2f | cache %s%%\n' "$MODEL" "$CTX" "$COST" "$HIT"
Codex CLI는 /statusline 피커에서 모델과 추론 강도, 컨텍스트 사용률, 토큰 누계, 사용 한도 같은 내장 항목을 고르면 config.toml의 tui.status_line에 저장됩니다. 비용 항목은 아직 내장되어 있지 않으므로 Codex 사용자에게는 Bedrock 측 예산 알림으로 비용을 보이게 하는 편이 현실적입니다.
예산 임계 알림
AWS Budgets는 추론 프로필의 비용 할당 태그 단위로 실제 지출과 예측 지출에 임계 알림을 겁니다. 알림을 Amazon SNS 토픽으로 보내고 Amazon Q Developer in chat applications(SNS 알림을 Slack 같은 채팅 채널로 전달하는 서비스)로 Slack 채널에 연결하면 Uber의 50/80/100% 넛지와 같은 구조가 됩니다. Budgets 데이터는 하루 최대 세 번 갱신되므로 세션 단위 반응은 실시간 비용 계층이 맡습니다. 예산 안에서 벌어지는 급증은 AWS Cost Anomaly Detection이 잡습니다.
다만 AWS Budgets의 예측 지출 알림은 약 5주의 사용 데이터가 쌓여야 만들어지고, 앞서 말한 태그 활성화 시점 때문에 프로필과 태그를 새로 만든 팀은 처음 몇 주 동안 실제 지출 기준 알림만 받습니다. AWS Organizations를 사용한다면 비용 할당 태그 단위의 이상 탐지 모니터는 관리 계정에서만 만들 수 있습니다.
주간 안티패턴 리포트
상태 표시줄과 예산 알림은 총액만 보여 주므로 원인과 처방을 알려 주는 계층이 따로 필요합니다. Uber가 공개한 사례에서는 세션 분석 대시보드가 모든 세션 트레이스에서 16가지 안티패턴을 찾아 재무 영향과 처방을 붙입니다. 대표적인 범주는 네 가지입니다.
- 잘못된 모델 라우팅: 단순 세션을 최상위 모델로 처리합니다
- 컨텍스트 비대화: 40KB짜리 도구 응답이 이후 요청마다 재전송됩니다
- 캐시 만료: 긴 휴식 뒤 재개하면 캐시를 다시 씁니다
- 초기화 오버헤드: 첫 입력 전에 10만 토큰을 적재합니다
안티패턴은 모델 호출 로그와 코딩 도구의 OpenTelemetry 이벤트에 주간 쿼리를 거는 것으로 시작합니다. 요청당 입력 토큰이 임계를 넘는 세션, 캐시 쓰기가 읽기를 압도하는 사용자, 단순 세션의 최상위 모델 비율만 뽑아도 네 범주 가운데 셋이 잡힙니다.
4.5 회사 표준 설정
앞의 해결책 가운데 도구 설정으로 구현되는 것을 Claude Code와 Codex 각각 한 장으로 모았습니다. Claude Code는 관리형 설정 파일(managed-settings.json)로 배포하면 개인 설정보다 우선합니다.
{
  "effortLevel": "medium",
  "autoCompactWindow": 400000,
  "env": {
    "CLAUDE_CODE_USE_BEDROCK": "1",
    "AWS_REGION": "ap-northeast-2",
    "ANTHROPIC_MODEL": "<SONNET_5_5_PROFILE_ARN>",
    "ANTHROPIC_DEFAULT_HAIKU_MODEL": "<HAIKU_5_5_PROFILE_ARN>",
    "CLAUDE_CODE_SUBAGENT_MODEL": "haiku",
    "CLAUDE_CODE_PROMPT_CACHE_TTL": "1h",
    "CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL": "5m",
    "CLAUDE_CODE_ENABLE_TELEMETRY": "1",
    "OTEL_METRICS_EXPORTER": "otlp",
    "OTEL_LOGS_EXPORTER": "otlp",
    "OTEL_EXPORTER_OTLP_PROTOCOL": "grpc",
    "OTEL_EXPORTER_OTLP_ENDPOINT": "<OTEL_COLLECTOR_URL>"
  }
}
JSON에는 주석을 달 수 없으므로 줄마다 어떤 해결책을 구현하는지 표로 정리합니다.
| 설정 | 값 | 구현하는 해결책 | 주의할 점 |
|---|---|---|---|
effortLevel |
medium | 추론 강도 기본값 | 사용자는 /effort, 서브에이전트는 정의의 effort로 바꿀 수 있음. CLAUDE_CODE_EFFORT_LEVEL은 오버라이드를 모두 막으므로 넣지 않음 |
ANTHROPIC_MODEL |
Sonnet 5.5 추론 프로필 ARN | 기본 모델과 비용 할당 태그 귀속 | bedrock:GetInferenceProfile 권한 필요 |
ANTHROPIC_DEFAULT_HAIKU_MODEL |
Haiku 5.5 추론 프로필 ARN | haiku 별칭과 배경 작업의 소형 모델 |
지정하지 않으면 배경 작업도 기본 모델이 처리 |
CLAUDE_CODE_SUBAGENT_MODEL |
haiku | 서브에이전트 기본 모델 하향 | 정의의 model이 우선. Explore, Plan까지 바꾸려면 CLAUDE_CODE_SUBAGENT_MODEL_FORCE=1 |
autoCompactWindow |
400000 | 컴팩션 임계값 | 사용자의 /autocompact로는 바뀌지 않고 실행별 --autocompact만 우선. Haiku 5.5 서브에이전트는 정의의 autoCompactWindow로 따로 낮춤. 환경 변수 CLAUDE_CODE_AUTO_COMPACT_WINDOW는 이 필드를 무효로 만들므로 넣지 않음 |
CLAUDE_CODE_PROMPT_CACHE_TTL, CLAUDE_CODE_SUBAGENT_PROMPT_CACHE_TTL |
1h, 5m | 주 대화만 1시간 캐시 | CI 러너에는 FORCE_PROMPT_CACHING_5M=1 |
CLAUDE_CODE_ENABLE_TELEMETRY, OTEL_* |
1, otlp, grpc | 세션당 턴, 턴당 요청 수집 | 프로토콜 기본값이 없어 빠뜨리면 전송되지 않으므로 수집기에 맞춰 grpc 또는 http/protobuf로 지정. 프롬프트 원문은 기본적으로 기록하지 않음 |
ENABLE_TOOL_SEARCH |
넣지 않음 | 도구 검색 지연 로딩 | Bedrock 직접 연결과 Bedrock 형식 게이트웨이는 미설정이 지연 로딩(게이트웨이는 anthropic_beta 본문 필드 전달). ANTHROPIC_BASE_URL 게이트웨이일 때만 true |
표 7. Claude Code 회사 표준 설정의 줄별 설명 (Claude Code 2.1.296 기준)
ANTHROPIC_MODEL에 애플리케이션 추론 프로필 ARN을 지정하면 Claude Code는 bedrock:GetInferenceProfile로 ARN 뒤의 기반 모델을 확인합니다. 이 권한과 bedrock:ListInferenceProfiles가 빠지면 세션마다 첫 요청이 거부된 뒤 200K 창과 effort가 빠진 요청으로 이어지므로 IAM 정책에 반드시 포함합니다. Bedrock API 키(AWS_BEARER_TOKEN_BEDROCK)로 배포할 때 특히 빠지기 쉽습니다. 권한에 기대지 않으려면 ANTHROPIC_MODEL에는 모델 ID를 두고 modelOverrides로 ARN을 매핑합니다.
Codex는 ~/.codex/config.toml 한 장에 같은 기본값을 설정 키로 고정합니다. model_provider = "amazon-bedrock-runtime"으로 Amazon Bedrock의 OpenAI 모델을 사용하면 공급자 설정도 같은 파일에서 관리됩니다. 이 Runtime 경로는 모델 호출 로깅을 지원하지만 Responses API에서는 애플리케이션 추론 프로필을 사용할 수 없으므로 비용 귀속은 IAM 주체 단위로 합니다. Runtime 공급자는 호스팅 웹 검색을 스스로 제외하므로 웹 검색 설정은 따로 두지 않습니다.
# ~/.codex/config.toml (하네스 래퍼가 배포하는 회사 표준 기본값)
model_provider = "amazon-bedrock-runtime"       # Bedrock Runtime, 교차 리전 추론
model = "global.openai.gpt-6-sol"               # 기본 모델 (Global CRIS 추론 프로필)
model_context_window = 272000                   # 기본 창을 명시해 장문 단가 구간 진입 방지
model_auto_compact_token_limit = 250000         # 272K 아래에서 자동 컴팩션
model_reasoning_effort = "medium"               # 추론 강도 기본값

[agents]
default_subagent_model = "global.openai.gpt-6-luna"   # 서브에이전트 기본 모델
default_subagent_reasoning_effort = "low"

[otel]                                          # 세션당 턴, 턴당 요청 수집
log_user_prompt = false
exporter = { otlp-http = { endpoint = "<OTEL_COLLECTOR_URL>/v1/logs", protocol = "binary" } }
5. 조직 규모별 로드맵
측정 없이 최적화를 시작하면 무엇이 효과를 냈는지 알 수 없습니다. 규모와 무관하게 측정부터 시작하고 해결책은 플랫폼 팀의 역량에 맞춰 늘려 가는 것을 권고드립니다.
| 단계 | 먼저 할 일 | 구현 수단 |
|---|---|---|
| 모든 조직 (이번 분기) |
여섯 항목 지표 정의, 서브에이전트 기본 모델 하향, 캐시 히트율 측정, 코딩 도구 OpenTelemetry 활성화, MCP 서버 점검, 추론 강도 기본값 검토 | 추론 프로필과 비용 할당 태그, 모델 호출 로깅, CloudWatch 경보, AWS Budgets |
| 플랫폼 팀이 있는 중규모 |
반복 도구 워크 플로우의 코드 모드 스킬 전환, 안티패턴 주간 리포트, 성과 단위 비용 정의 | 관리형 설정 배포(managed-settings.json, config.toml), OTel 수집기, CloudWatch Logs Insights, 캐시 TTL 분리 |
| 대규모 | 사내 메타데이터 MCP 서버 구축, 게이트웨이 경로의 도구 검색 정책, 헤드리스 에이전트별 벤치마크와 모델 선택 루프 | 헤드리스 벤치마크(claude -p, codex exec) CI/CD 게이트, 추론 프로필별 예산, 서비스 티어 정책 |
표 8. 조직 규모별 적용 순서와 구현 수단
첫 단계는 대부분 설정 변경입니다. 서브에이전트 모델과 추론 강도는 설정 파일 한 줄, 캐시 히트율은 CloudWatch 지표의 나눗셈입니다. 이 단계의 측정치가 다음 단계에서 무엇을 코드 모드로 옮기고 어떤 에이전트에 벤치마크를 먼저 붙일지 정하는 근거가 됩니다.
6. 적용 전 확인할 것
사례와 수치를 자기 조직에 옮기기 전에 여덟 가지를 확인하는 것을 권고드립니다.
| 항목 | 주의할 점 | 대응 |
|---|---|---|
| 총비용 곡선 | Uber의 “지출 안정화”는 비용이 사용량보다 완만하게 늘었다는 뜻입니다. 단위 비용 절감률은 모델을 고정한 조건의 값입니다 | 총액과 단위 비용을 따로 보고 |
| 1시간 캐시 TTL | 1시간 캐시 쓰기는 입력 단가의 2배(5분은 1.25배)라 턴 간격이 대부분 5분 이내면 오히려 손해입니다 | OpenTelemetry 이벤트로 턴 간격 분포를 먼저 확인하고 서브에이전트는 5분 유지 |
| medium 추론 기본값 |
어려운 설계, 디버깅 작업에서는 품질이 떨어질 수 있습니다 | 관리형 effortLevel로 두어 오버라이드 경로를 열고 헤드리스 벤치마크 점수로 확인 |
| 코드 모드 절감률 |
Uber 측정의 넓은 테이블 조회처럼 거의 100%에 이르는 극단 사례는 평균이 아닙니다 | 소형 결과셋 기준 50~70%대로 기대 |
| 인프라 전제 | 사내 컨텍스트 저장소와 대규모 MCP 서버 운영에는 전담 플랫폼 팀이 필요합니다 | CLAUDE.md, AGENTS.md와 작은 MCP 서버부터 시작 |
| AWS 기능 제약 | 비용 할당 태그는 활성화 이후 비용만, 호출 로깅은 bedrock-runtime만, 배치 추론은 캐싱과 도구 호출 미지원 |
Models at a glance에서 모델, 리전 지원 확인 |
| Claude 5.5 모델 |
Opus 5.5, Sonnet 5.5, Haiku 5.5는 Standard 티어만 지원합니다. AWS Marketplace로 과금되어 Cost Explorer에서 모델 제공자 항목으로 표시되며 서울 리전에서는 Global 교차 리전 추론으로만 제공됩니다 |
비용 대시보드의 서비스 필터와 데이터 상주 요건 점검, 태그 활성화 뒤 첫 청구 주기에 Marketplace 청구 항목의 태그별 집계 확인 |
| 추론 프로필 ARN 지정 |
bedrock:GetInferenceProfile 권한이 없으면 세션마다 첫 요청이 거부되고 200K 창, effort 미전송 상태로 이어집니다 |
IAM 정책에 권한을 포함하거나 modelOverrides로 매핑 |
표 9. 사례를 옮기기 전에 확인할 여덟 가지
Uber도 밝히듯 수치는 각 회사 환경에 특화된 값이고 보편적인 것은 방법론입니다.
7. 마치며
기업의 토큰 청구서는 앞으로도 매달 늘어날 것입니다. 과제는 그 증가분을 설명할 수 있어야 한다는 것입니다. 드라이버 분해를 거치면 청구서의 배수는 “사용자 증가”와 “요청당 토큰 증가”로 분기됩니다. 사람이 요청한 토큰과 에이전트가 스스로 소모한 토큰의 구분은 성장 항목과 낭비 항목의 구분과 같습니다. 이 두 가지를 대시보드에서 보려면 추론 프로필의 비용 할당 태그, 호출 로그의 요청 단위 토큰, 코딩 도구의 OpenTelemetry 세션 이벤트를 한 파이프라인으로 연결해야 합니다.
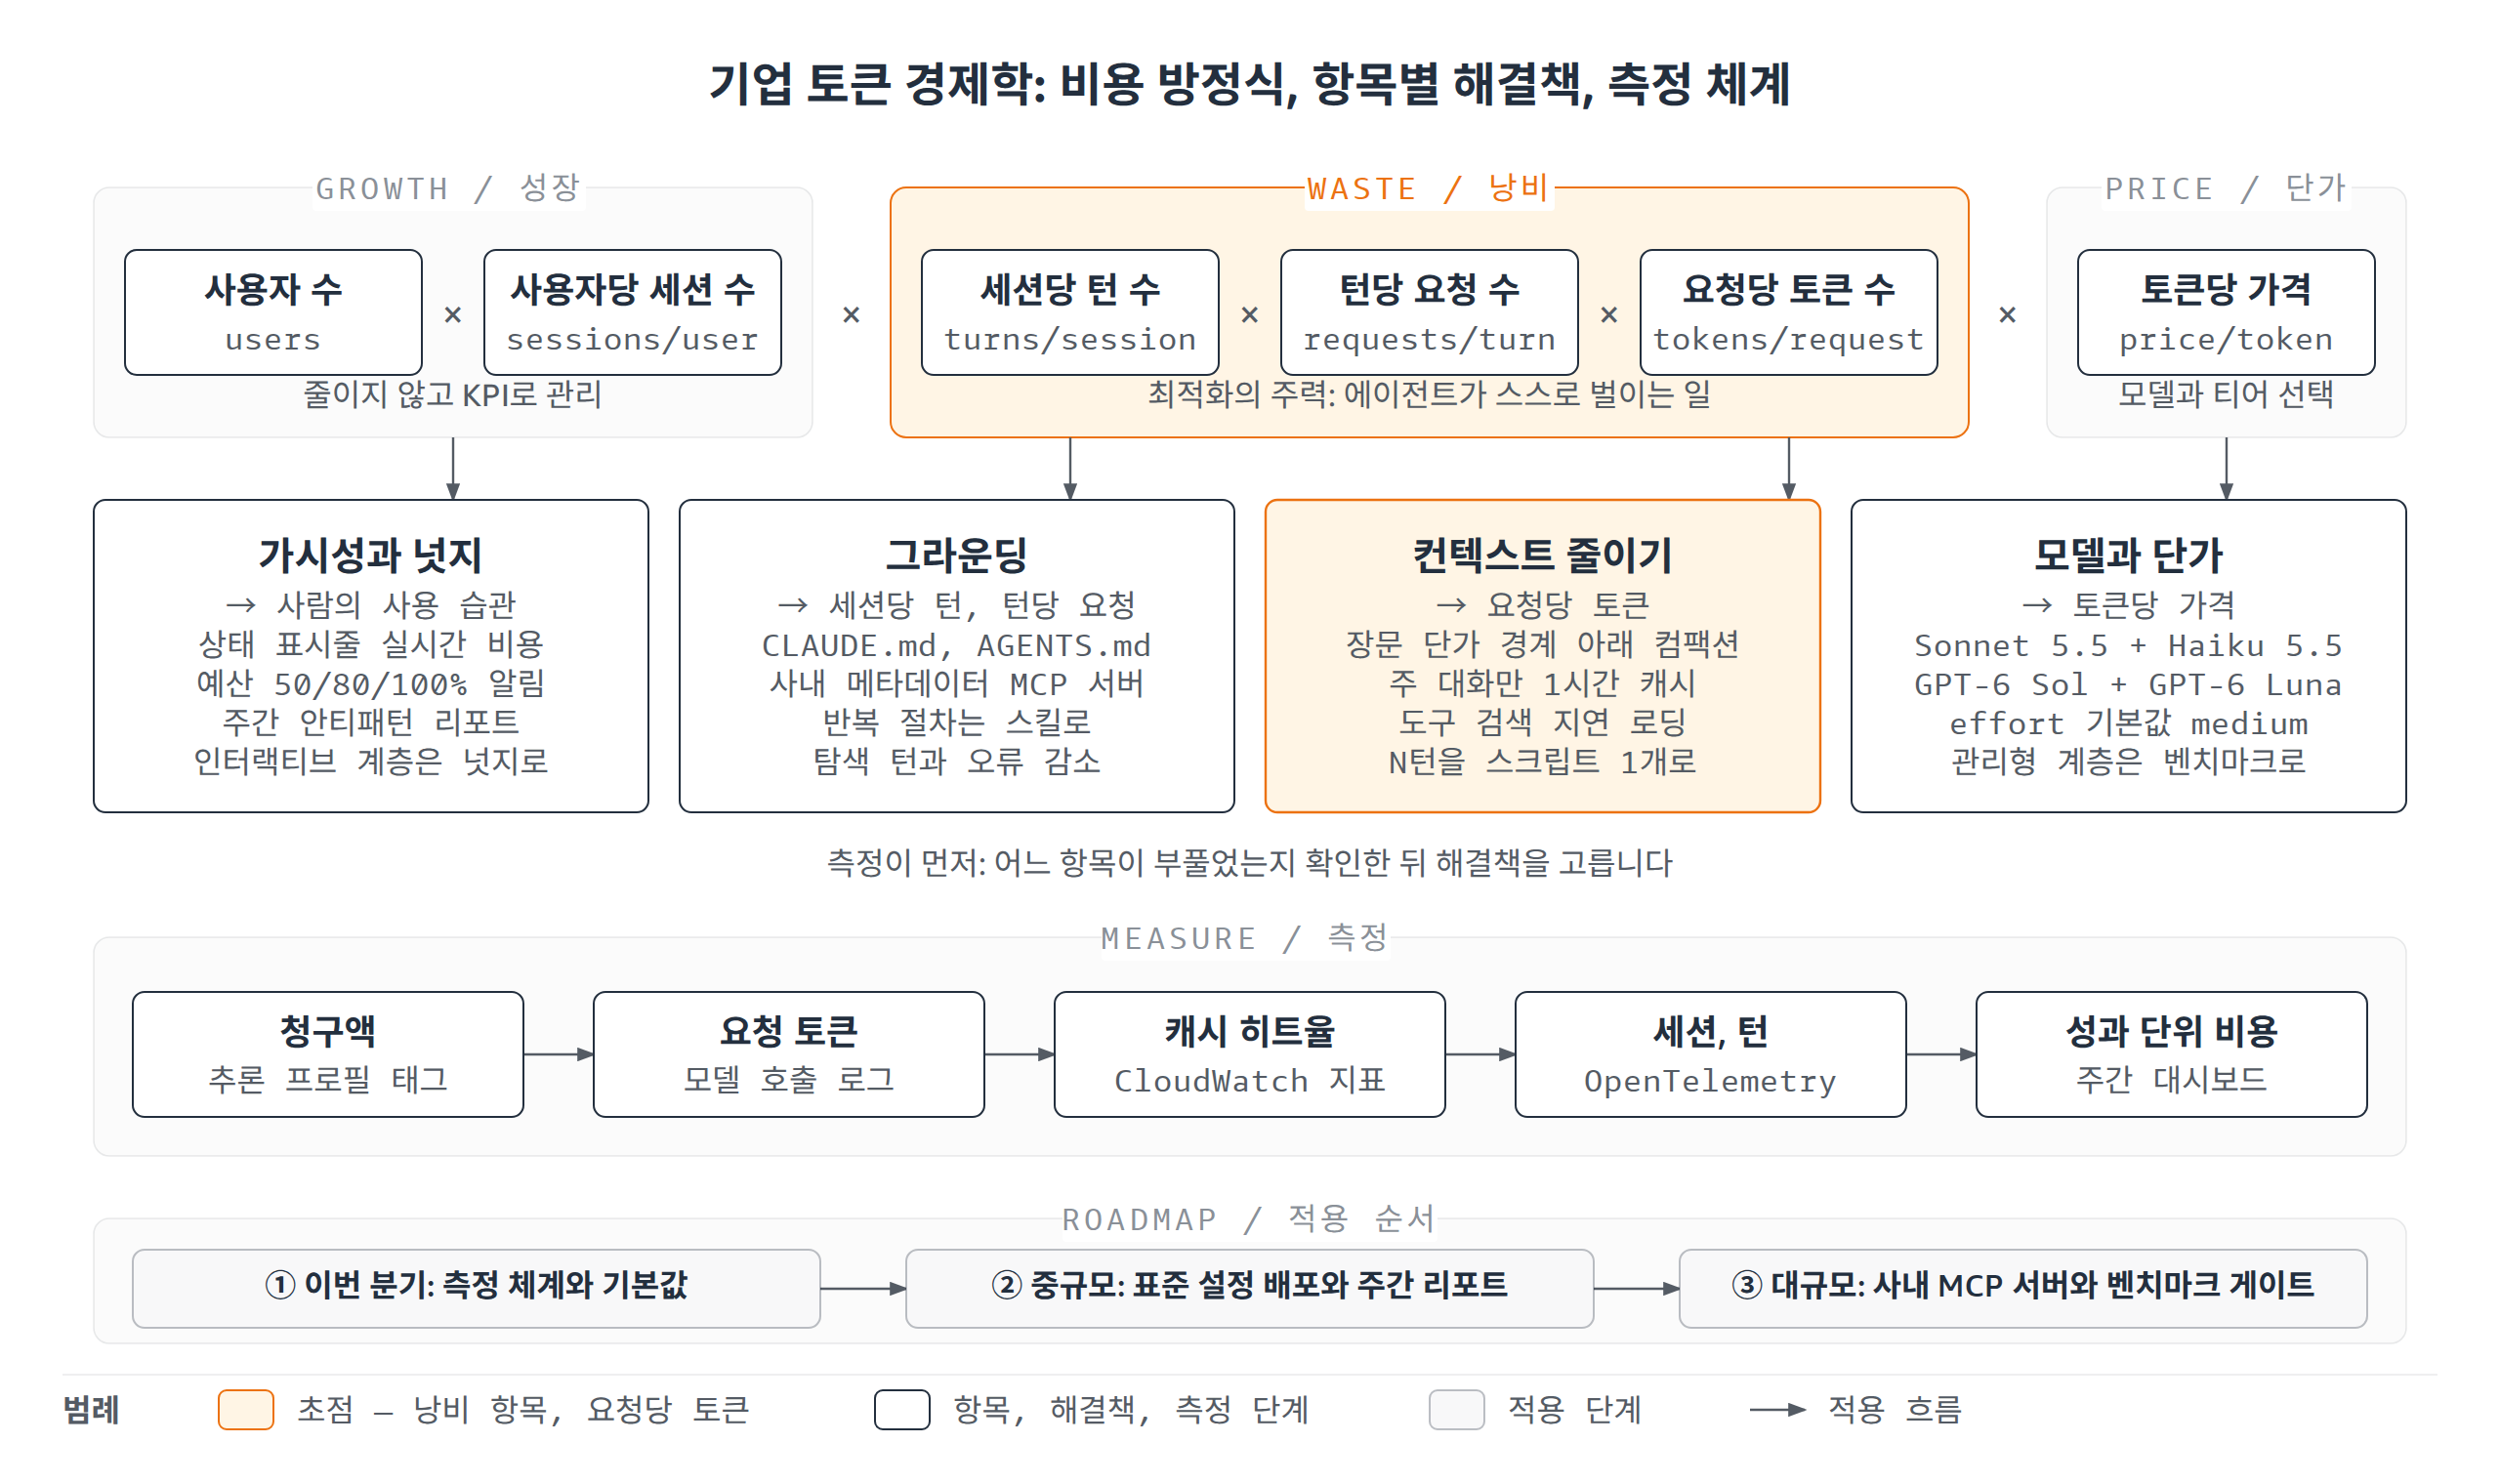
그림 10. 기업 토큰 경제학 한눈에 보기 – 비용 방정식의 항목마다 해결책을 대응시키고 측정으로 효과를 확인합니다
정리하면 세 가지입니다. 매 턴 다시 전송되는 컨텍스트에서 일하지 않는 토큰을 빼는 것이 최적화의 절반 이상입니다. 계획하는 모델과 실행하는 모델을 나누는 것이 가장 저렴한 해결책입니다. 그라운딩은 턴 수를 줄여 비용을 낮춥니다. 이 구조의 구성요소들은 이미 갖춰져 있습니다. Claude Code와 Codex에는 서브에이전트 모델, 컴팩션, 도구 검색, 상태 표시줄, OpenTelemetry 설정이 있고 Amazon Bedrock에는 비용 추적, 호출 로깅, 프롬프트 캐싱, 예산 알림이 있습니다. 이 글에서 정리한 비용 방정식과 지표가 조직의 AI 비용 구조를 설계하는 분들께 실질적인 참고가 되기를 바랍니다.
참고 자료
- Claude Code 토큰 비용 최적화하기 – 1부: 비용 구조와 세션 습관
- Claude Code 토큰 비용 최적화하기 – 2부: 캐시 경제학과 Amazon Bedrock 조직 비용 관리
- Track usage and costs in Amazon Bedrock
- Application inference profiles
- IAM principal attribution
- Per-request metadata tagging
- Monitor model invocation using CloudWatch Logs and Amazon S3
- Monitor bedrock-runtime inference using CloudWatch metrics
- Prompt caching for faster model inference
- Service tiers for optimizing performance and cost
- Adaptive thinking (Anthropic Claude on Amazon Bedrock)
- Claude Opus 5.5 (Amazon Bedrock model card)
- Claude Sonnet 5.5 (Amazon Bedrock model card)
- Claude Haiku 5.5 (Amazon Bedrock model card)
- GPT-6 Sol (Amazon Bedrock model card)
- GPT-6.1 Sol (Amazon Bedrock model card)
- GPT-6 Luna (Amazon Bedrock model card)
- OpenAI GPT-6 Sol and GPT-6 Luna are now generally available on Amazon Bedrock
- Amazon Bedrock Pricing
- Best practices for AWS Budgets
- Getting started with AWS Cost Anomaly Detection
본문의 할인율과 기능 지원 범위는 2026년 10월 기준 공개 문서를 바탕으로 했으며 모델과 리전에 따라 다를 수 있습니다. Uber의 수치는 2026년 8월 공개된 원문을 인용했고 국내 기업 사례의 수치는 여러 고객 미팅의 패턴을 합성한 예시입니다. Claude Code 설정의 동작은 Claude Code 2.1.296 기준입니다.