AWS 기술 블로그
Amazon OpenSearch Service 고급 활용 – 자체 빌드 Nori 분석기를 통한 사용자 사전 미세 조정
검색 서비스에서는 브랜드명이나 상품명처럼 해당 분야에서 사용하는 도메인 용어를 정확하게 처리하는 것이 중요합니다. 이런 용어가 의도와 다르게 분리되면 사용자가 찾는 상품을 놓치거나 관련 없는 결과가 검색될 수 있으며 점진적으로 사용자 경험 저하라는 악순환이 반복됩니다.
Amazon OpenSearch Service는 커스텀 패키지를 통해 사용자 사전과 동의어 사전을 적용할 수 있습니다. 이를 활용하면 서비스에 필요한 용어를 추가하고 서로 다른 검색 표현을 연결할 수 있습니다. 다만, 기본 Nori 형태소 분석기를 베이스로 사용하기 때문에 커스텀 패키지의 사용자 사전 설정만으로는 용어별 품사 태그를 지정하거나 토큰별 가중치에 해당하는 형태소 분석시 Term별 비용을 세밀하게 조정하는 데 제약이 있습니다.
이 글에서는 MeCab-Ko를 직접 빌드하고, 사전의 품사와 단어 비용, 복합명사 분해 정보를 조정하는 방법을 소개합니다. 수정한 사전을 Nori 플러그인으로 빌드하여 Amazon OpenSearch Service 커스텀 플러그인으로 만들고, 상품명 예제로 기본 Nori와 분석 결과를 비교합니다.
솔루션 개요
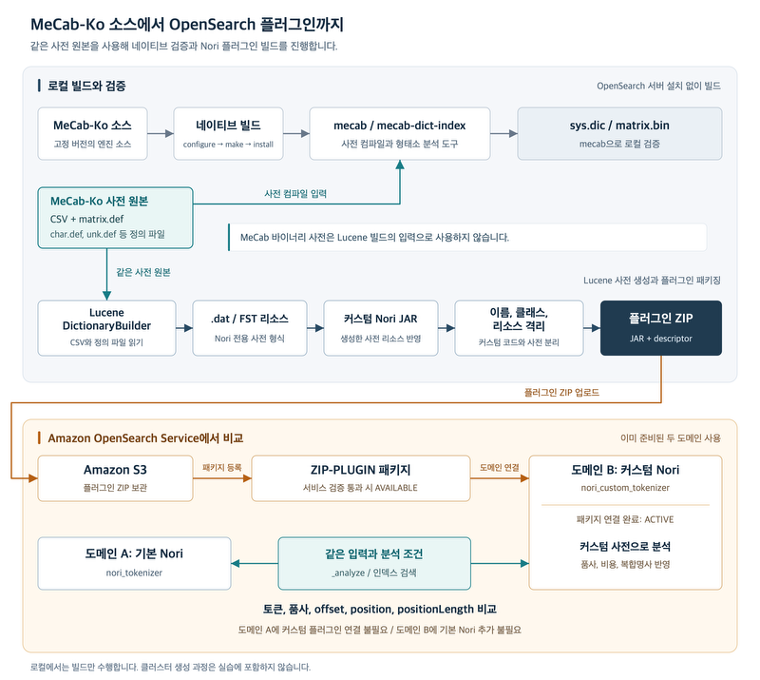
그림 1. 같은 CSV와 정의 파일을 MeCab 검증과 Lucene Nori 사전 생성에 각각 사용합니다. 생성한 ZIP은 커스텀 도메인 B에 연결하고, 기본 Nori를 사용하는 도메인 A와 같은 입력을 분석합니다.
- 이 글에서 제공되는 샘플 코드는 커스텀 Nori를 빌드하는 데 초점을 맞추었습니다. 로컬에서는 MeCab-Ko 엔진과 사전, Lucene Nori JAR, 플러그인 ZIP을 생성합니다. 빌드 시 내려받는 OpenSearch 소스는 버전과 빌드 호환성을 확인하기 위한 것이며, 검색 요청은 Amazon OpenSearch Service에서 실행합니다.
- 비교에는 이미 준비된 도메인 두 개를 사용합니다.
| 구분 | 도메인 A | 도메인 B |
|---|---|---|
| 역할 | 기본 Nori 비교군 | 커스텀 Nori 적용군 |
| 엔진 | OpenSearch 3.5 | OpenSearch 3.5 |
| tokenizer | nori_tokenizer |
nori_custom_tokenizer |
| 사전 | AWS 제공 Nori 사전 | 이 글에서 빌드한 상품 사전 |
| 연결할 플러그인 | AWS 제공 Nori | analysis-nori-commerce |
A에 커스텀 플러그인을 설치하거나 B에 기본 Nori를 추가할 필요는 없습니다. 이미 설치된 플러그인은 그대로 두고, 각 도메인에서 사용할 tokenizer를 명시합니다. 비교할 문장, 분해 모드와 필터 조건은 같게 유지합니다.
사전 준비
버전과 로컬 도구
예제 코드는 AWS 한국어 기술 블로그 샘플 저장소의 opensearch_custom_nori_build에 있습니다.
| 구성요소 | 예제 버전 |
|---|---|
| OpenSearch | 3.5.0 |
| Lucene | 10.3.2 |
| MeCab-Ko 엔진 | 0.996-ko-0.9.2 |
| mecab-ko-dic | 2.1.1-20180720 |
| 빌드 JDK | 21 |
| 보조 스크립트 | Python 3.12 |
OpenSearch 3.5.0 소스의 Lucene 의존성은 10.3.2입니다. 다른 OpenSearch 엔진 버전을 사용한다면 대상 버전의 의존성을 확인하고 플러그인을 다시 빌드해야 합니다.
이 글의 로컬 빌드는 macOS에서 검증했습니다. Homebrew와 Xcode Command Line Tools를 준비합니다. Command Line Tools가 없다면 xcode-select --install로 설치한 뒤 진행하세요.
이 명령은 누락된 빌드 도구를 준비하고 공개 소스를 다운로드한 뒤 MeCab 엔진부터 ZIP 생성까지 실행합니다. MeCab이 미리 설치되어 있을 필요는 없습니다. 이후 도구를 다시 설치하지 않고 빌드하려면 bash build-all.sh를 사용합니다. 특정 JDK는 NORI_JAVA_HOME으로 지정할 수 있습니다.
OpenSearch와 Lucene은 고정한 소스 커밋을 사용하며, MeCab-Ko 엔진과 사전 압축 파일은 SHA-256을 검사합니다.
다음 절에서는 이 통합 명령이 수행하는 단계를 나눠 살펴봅니다. 기본 출력 경로는 build/입니다. 사전을 수정한 뒤에는 기존 결과를 보존하도록 새 출력 경로를 사용합니다.
Amazon OpenSearch Service 비교 환경
도메인 A에는 엔진 버전에 맞는 AWS 제공 Nori가 준비되어 있어야 합니다. 선택적 플러그인 연결 방법은 지원 플러그인 문서를 참고하세요. 도메인 B에는 이 글에서 생성한 ZIP을 연결합니다.
B는 저장 데이터 암호화, 노드 간 암호화, HTTPS 강제 적용과 Policy-Min-TLS-1-2-PFS-2023-10 TLS 정책 등 커스텀 플러그인 전제조건을 충족해야 합니다. 이미 준비된 도메인의 보안 설정을 실습을 위해 완화하지 않습니다.
두 도메인의 OpenSearch Dashboards와 실습 인덱스에 접근할 권한, B의 패키지 관리 권한 및 같은 계정과 리전의 비공개 S3 버킷을 준비합니다. VPC 도메인은 접근 가능한 네트워크에서 진행합니다.
이후 실제 형태소 분석 결과나 인덱스 정보를 확인하기 위한 OpenSearch API 요청은 각 도메인의 OpenSearch Dashboards > Dev Tools에서 실행합니다. A와 B를 서로 다른 브라우저 탭으로 열고 요청을 보낼 도메인을 확인하세요. AWS CLI는 패키지 등록과 연결에 사용하며, 도메인 생성 명령은 포함하지 않습니다.
1. 상품 샘플과 사전 CSV 만들기
샘플은 실제 고객 데이터가 아닌 가상의 상품 네 개입니다.
| 상품명 | 확인할 동작 |
|---|---|
| 노을빛무선청소기 | 낮은 단어 비용으로 전체 상품명 선택 |
| 구름결캠핑의자 | 원형 유지와 구름결/캠핑/의자 분해 |
| 별하늘진공텀블러 | 추가 복합명사 사례 |
| 초록별접이식선반 | Nori 사용자 사전의 분해 규칙 |
dictionaries/low.csv에는 다음 세 항목이 있습니다
MeCab-Ko CSV의 12개 열을 구름결캠핑의자로 살펴보겠습니다.
| 열 | 값 | 의미 |
|---|---|---|
| 1 | 구름결캠핑의자 | 표면형 |
| 2 | 1786 | 왼쪽 문맥 ID |
| 3 | 3545 | 오른쪽 문맥 ID |
| 4 | -10000 | 단어 경로에 따른 선호도 비용 |
| 5 | NNP | 품사: 고유명사 |
| 6 | * | 의미 분류 미지정 |
| 7 | F | 마지막 음절에 종성이 없음 |
| 8 | 구름결캠핑의자 | 발음 |
| 9 | Compound | 복합명사 유형 |
| 10 | * | 시작 품사 보조 정보 미지정 |
| 11 | * | 끝 품사 보조 정보 미지정 |
| 12 | 구름결/NNP/*+캠핑/NNG/*+의자/NNG/* | 분해 형태소와 품사 |
각 값이 형태소 분석에서 하는 역할
표면형과 읽기
구름결캠핑의자는 입력 문자열에서 찾을 사전 항목입니다.
왼쪽과 오른쪽 문맥 ID
1786과 3545는 연결 비용 자체가 아니라 사전의 연결 비용 행렬을 참조하는 식별자입니다. 앞 항목의 오른쪽 문맥 ID와 현재 항목의 왼쪽 문맥 ID 1786을 조합해 앞쪽 연결 비용을 찾습니다. 뒤 항목과 연결할 때는 현재 항목의 오른쪽 문맥 ID 3545와 뒤 항목의 왼쪽 문맥 ID를 사용합니다. 따라서 ID의 숫자가 작다고 더 잘 선택되는 것은 아닙니다.이 두 값은 고정한 원본 사전의 left-id.def와 right-id.def에서 확인했습니다. 예제의 왼쪽 ID는 NNP 항목에, 오른쪽 ID는 NNP이면서 종성이 없는 항목에 대응합니다. 사전 버전, 품사나 종성이 달라지면 그대로 복사하지 마세요. scripts/prepare_dictionary.py는 이 매핑과 비용 범위, 중복 항목 및 복합명사 분해 표현을 검사합니다.
단어 경로에 따른 선호도 비용
-10000은 구름결캠핑의자라는 사전 항목을 분석 경로에 포함할 때 더하는 비용입니다. 분석기는 이 상품명을 하나의 항목으로 선택하는 경로와 여러 항목으로 나누는 경로를 비교합니다. 각 경로의 단어 비용, 연결 비용과 공백 관련 페널티를 합산하며, 총비용이 낮은 경로를 선택합니다.
음수인 -10000은 해당 항목을 선택한 경로의 누적 비용을 낮추므로 전체 상품명 항목이 선택되기 유리해집니다. 다만 주변 문맥과 경쟁 경로의 비용도 영향을 주므로 모든 문장에서 선택을 보장하지는 않습니다. 이 값은 출현 횟수나 확률, BM25 검색 점수를 의미하지 않으며, 검색 점수에 10,000을 더하는 설정도 아닙니다. 이 예제에서는 분석 차이를 관찰하기 위해 직접 지정했습니다.
품사, 의미 분류와 종성
NNP는 전체 상품명 항목을 고유명사로 다루겠다는 뜻입니다. 분해된 구성 형태소의 품사는 12열에 별도로 지정합니다. 고유명사라는 이유만으로 검색 점수가 자동으로 올라가지는 않습니다.
*는 의미 분류를 따로 지정하지 않았다는 표시입니다. 여기서 *는 검색의 와일드카드나 모든 의미 분류를 지정하는 표현이 아닙니다.
F는 표면형의 마지막 음절에 종성이 없다는 뜻입니다. 구름결캠핑의자는 마지막 음절이 받침 없는 자이므로 F입니다. 단어 안의 다른 음절에 받침이 있는지는 이 값과 무관합니다.
복합명사 유형과 시작/끝 품사
Compound는 이 항목에 복합명사 분해 정보가 있음을 나타냅니다. 이 예제의 복합명사 항목에서는 10열과 11열을 *로 두며, 이 칸에 12열의 첫 번째와 마지막 형태소 품사를 복사하지 않습니다. 현재 Nori 사전 빌더는 Compound 항목 자체의 좌우 품사를 5열의 품사로 처리하고, 구성 형태소의 품사는 12열에서 읽습니다.
분해 형태소와 품사
구름결/NNP/*+캠핑/NNG/*+의자/NNG/*에서 +는 구성 형태소를 구분합니다. 각 요소의 첫 번째 값은 표면형이고 두 번째 값은 품사이므로, 구름결은 고유명사 NNP, 캠핑과 의자는 일반명사 NNG로 지정한 것입니다. 각 요소의 마지막 *는 추가 정보를 지정하지 않은 자리이며, 구성 토큰의 비용을 넣는 칸이 아닙니다. 현재 Nori 빌더는 이 분해 표현에서 표면형과 품사를 사용합니다.
-10000은 복합명사 항목 전체에 적용됩니다. 분해해서 출력되는 구름결, 캠핑, 의자 각각에 같은 비용을 부여하거나 비용을 나누어 배분하지 않습니다. 먼저 비용으로 분석 경로를 선택하고, 선택된 복합명사 항목을 decompound_mode에 따라 출력합니다.
| 분해 모드 | 이 복합명사 항목을 선택했을 때의 출력 |
|---|---|
none |
구름결캠핑의자 |
discard |
구름결, 캠핑, 의자 |
mixed |
구름결캠핑의자, 구름결, 캠핑, 의자 |
즉, 단어 비용은 어떤 사전 항목을 선택할지에 영향을 주고, 분해 정보와 분해 모드는 선택된 항목을 어떤 토큰으로 출력할지 결정합니다. 이 예제의 첫 번째 상품 노을빛무선청소기는 단일 항목으로 보존하도록 품사의 시작과 끝정보를 *로 지정했습니다. 나머지 두 상품은 Compound와 분해 표현을 함께 지정했으며, 분해된 표면형을 이어 붙이면 원래 상품명이 되어야 합니다.
단어 비용만 바꾼 비교군
dictionaries/high.csv는 같은 항목의 비용만 30000으로 설정합니다. 단어 비용 이외의 열은 같습니다.
Nori는 가능한 분석 경로 중 비용이 낮은 경로를 선택합니다. 항목 비용을 낮추면 그 항목을 포함한 경로가 유리해지지만, 연결 비용과 경쟁 경로도 영향을 줍니다.
30000과 -10000은 차이를 관찰하기 위한 실험값이며 운영 권장값이 아닙니다. 사전 빌더가 단어 비용을 signed 16-bit 값으로 읽는 점도 확인해야 합니다. 단어 비용은 검색 점수의 boost가 아닙니다.
high/low 비교군은 로컬 사전 검증에서 비용 효과를 확인하는 용도입니다. AWS 도메인 A와 B에서는 각각 기본 사전과 low 비용 커스텀 사전을 비교하며, high 비용 ZIP을 추가 배포하지 않습니다.
2. MeCab-Ko 엔진과 네이티브 사전 빌드
통합 빌드 대신 단계별로 진행한다면 샘플 루트에서 실행합니다.
make mecab-engine은 고정한 MeCab-Ko 소스를 새 작업 디렉터리에 풀고 configure, make, make install을 실행합니다. 네이티브 도구는 시스템 경로 대신 build/toolchain/에 설치합니다. 기존 실행 파일이 있어도 새 소스를 컴파일합니다.make mecab-dictionary는 이번에 만든 mecab-dict-index에 build/dictionary-high/와 build/dictionary-low/를 각각 전달합니다. 주요 산출물은 다음과 같습니다.
| 경로 | 내용 |
|---|---|
build/toolchain/bin/mecab |
새로 빌드한 MeCab-Ko 실행 파일 |
build/toolchain/libexec/mecab/mecab-dict-index |
네이티브 사전 컴파일 도구 |
build/dictionary-low/commerce.csv |
원본 사전에 추가한 낮은 비용 상품 항목 |
build/dictionary-high/commerce.csv |
비용만 바꾼 비교 항목 |
build/native-high/, build/native-low/ |
sys.dic, matrix.bin 등의 네이티브 사전 |
build/native-build.json |
엔진 소스, 빌드 명령과 도구 해시 |
이 네이티브 사전은 OpenSearch 배포 파일이 아닙니다. 로컬 MeCab으로 원본 사전의 동작을 먼저 검사하는 데 사용합니다.
로컬 네이티브 검증에서는 비용 30000일 때 노을빛 + 무선 + 청소기가, -10000일 때 노을빛무선청소기가 선택됐습니다. 뒤의 조사 에서는 두 경우 모두 분리됐습니다. 이 단계는 OpenSearch 서버를 실행하지 않습니다.
3. 같은 사전 원본으로 Lucene Nori JAR 생성
이 단계는 Lucene core, analysis-common과 analysis-nori를 빌드한 뒤 DictionaryBuilder로 high/low 사전을 각각 변환합니다. scripts/build.sh의 lucene() 함수에서 입력과 출력 경로를 확인할 수 있습니다.
Lucene은 MeCab에서 만든 sys.dic이나 matrix.bin을 읽지 않습니다. 같은 CSV와 정의 파일을 읽어 Lucene 자체 사전 형식으로 변환합니다. MeCab 네이티브 빌드 결과를 OpenSearch 플러그인에 그대로 넣는 방식과는 다릅니다.
빌드 스크립트는 기본 Nori JAR의 사전 리소스를 생성한 .dat와 FST로 교체합니다. high/low 두 JAR를 만들지만, 다음 플러그인 단계는 build/lucene-analysis-nori-low.jar를 사용합니다.
4. 커스텀 플러그인 ZIP 만들기
예제 플러그인은 AnalysisPlugin을 구현하고 다음 이름으로 분석 구성요소를 등록합니다.
| 구성요소 | 커스텀 이름 |
|---|---|
| 플러그인 | analysis-nori-commerce |
| tokenizer | nori_custom_tokenizer |
| analyzer | nori_custom |
| 품사 필터 | nori_custom_part_of_speech |
| 읽기 필터 | nori_custom_readingform |
| 숫자 필터 | nori_custom_number |
scripts/build.sh는 Gradle에 -PnoriJar=.../lucene-analysis-nori-low.jar를 전달합니다. plugin/build.gradle의 implementation files(noriJar)가 이 파일을 참조하므로, 앞 단계에서 만든 사전이 최종 플러그인에 포함됩니다.
Gradle Shadow는 org.apache.lucene.analysis.ko를 example.opensearch.nori.internal.ko로 이동하면서 사전 리소스도 함께 옮깁니다. 빌드의 verifyCoexistence 역시 한 JVM에서 클래스와 리소스를 검사하며 OpenSearch 클러스터를 실행하지 않습니다.
커스텀 tokenizer의 내부 품사 attribute도 이동하므로, 커스텀 tokenizer에는 nori_custom_* 필터를 사용합니다. lowercase 같은 일반 필터는 별도로 조합할 수 있습니다.최종 산출물은 다음 파일입니다.
ZIP에는 플러그인 JAR, plugin-descriptor.properties와 관련 LICENSE/NOTICE가 들어갑니다. descriptor의 플러그인 버전은 1.0.0, 대상 엔진 버전은 opensearch.version=3.5.0입니다.
5. Amazon OpenSearch Service 도메인 B에 연결
AWS CLI가 사용하는 계정과 대상 도메인을 확인합니다. 변수는 자신의 환경으로 바꿉니다.
두 도메인 이름이 다르고 모두 OpenSearch_3.5인지 확인합니다. 도메인 B가 다른 구성 변경을 처리 중이면 완료될 때까지 기다립니다. Processing=false와 describe-domain-change-progress의 완료 상태를 함께 확인하세요. 같은 계정과 리전의 기존 비공개 S3 버킷에 ZIP을 업로드하고 패키지를 등록합니다. 새 패키지 이름과 객체 키를 사용해 기존 결과를 덮어쓰지 않습니다.
패키지 생성 API의 엔진 표기는 OpenSearch_3.5입니다. ZIP descriptor의 3.5.0과 혼동하지 마세요. 패키지가 AVAILABLE이 되면 B에만 연결합니다. 검증 실패 시에는 ErrorDetails를 확인하고 원인을 수정합니다.
연결은 blue/green 배포로 진행됩니다. 패키지가 ACTIVE이고 도메인 구성 변경이 완료된 뒤 분석을 시작합니다. 로컬 빌드 성공, 패키지 검증 통과와 도메인 연결 완료는 서로 다른 확인 단계입니다.
6. 두 도메인에서 분석 결과 비교
먼저 A와 B 각각의 Dev Tools에서 엔진 버전과 플러그인 목록을 확인합니다.
A에서는 AWS 제공 Nori를, B에서는 analysis-nori-commerce를 확인합니다. 기본 Nori 플러그인이 적용된 클러스터 테스트에서 기본 Nori의 component 이름은 opensearch-analysis-nori였습니다. 두 플러그인이 한 응답에 모두 나타날 필요는 없습니다.
이 절의 응답 예시는 앞서 Amazon OpenSearch Service에서 확인한 토큰입니다. 그 테스트는 한 임시 도메인에서 두 플러그인을 사용했습니다. 아래 실습에서는 기본 요청은 A에, 커스텀 요청은 B에 보내고 실제 응답을 다시 기록합니다.
상품명 보존
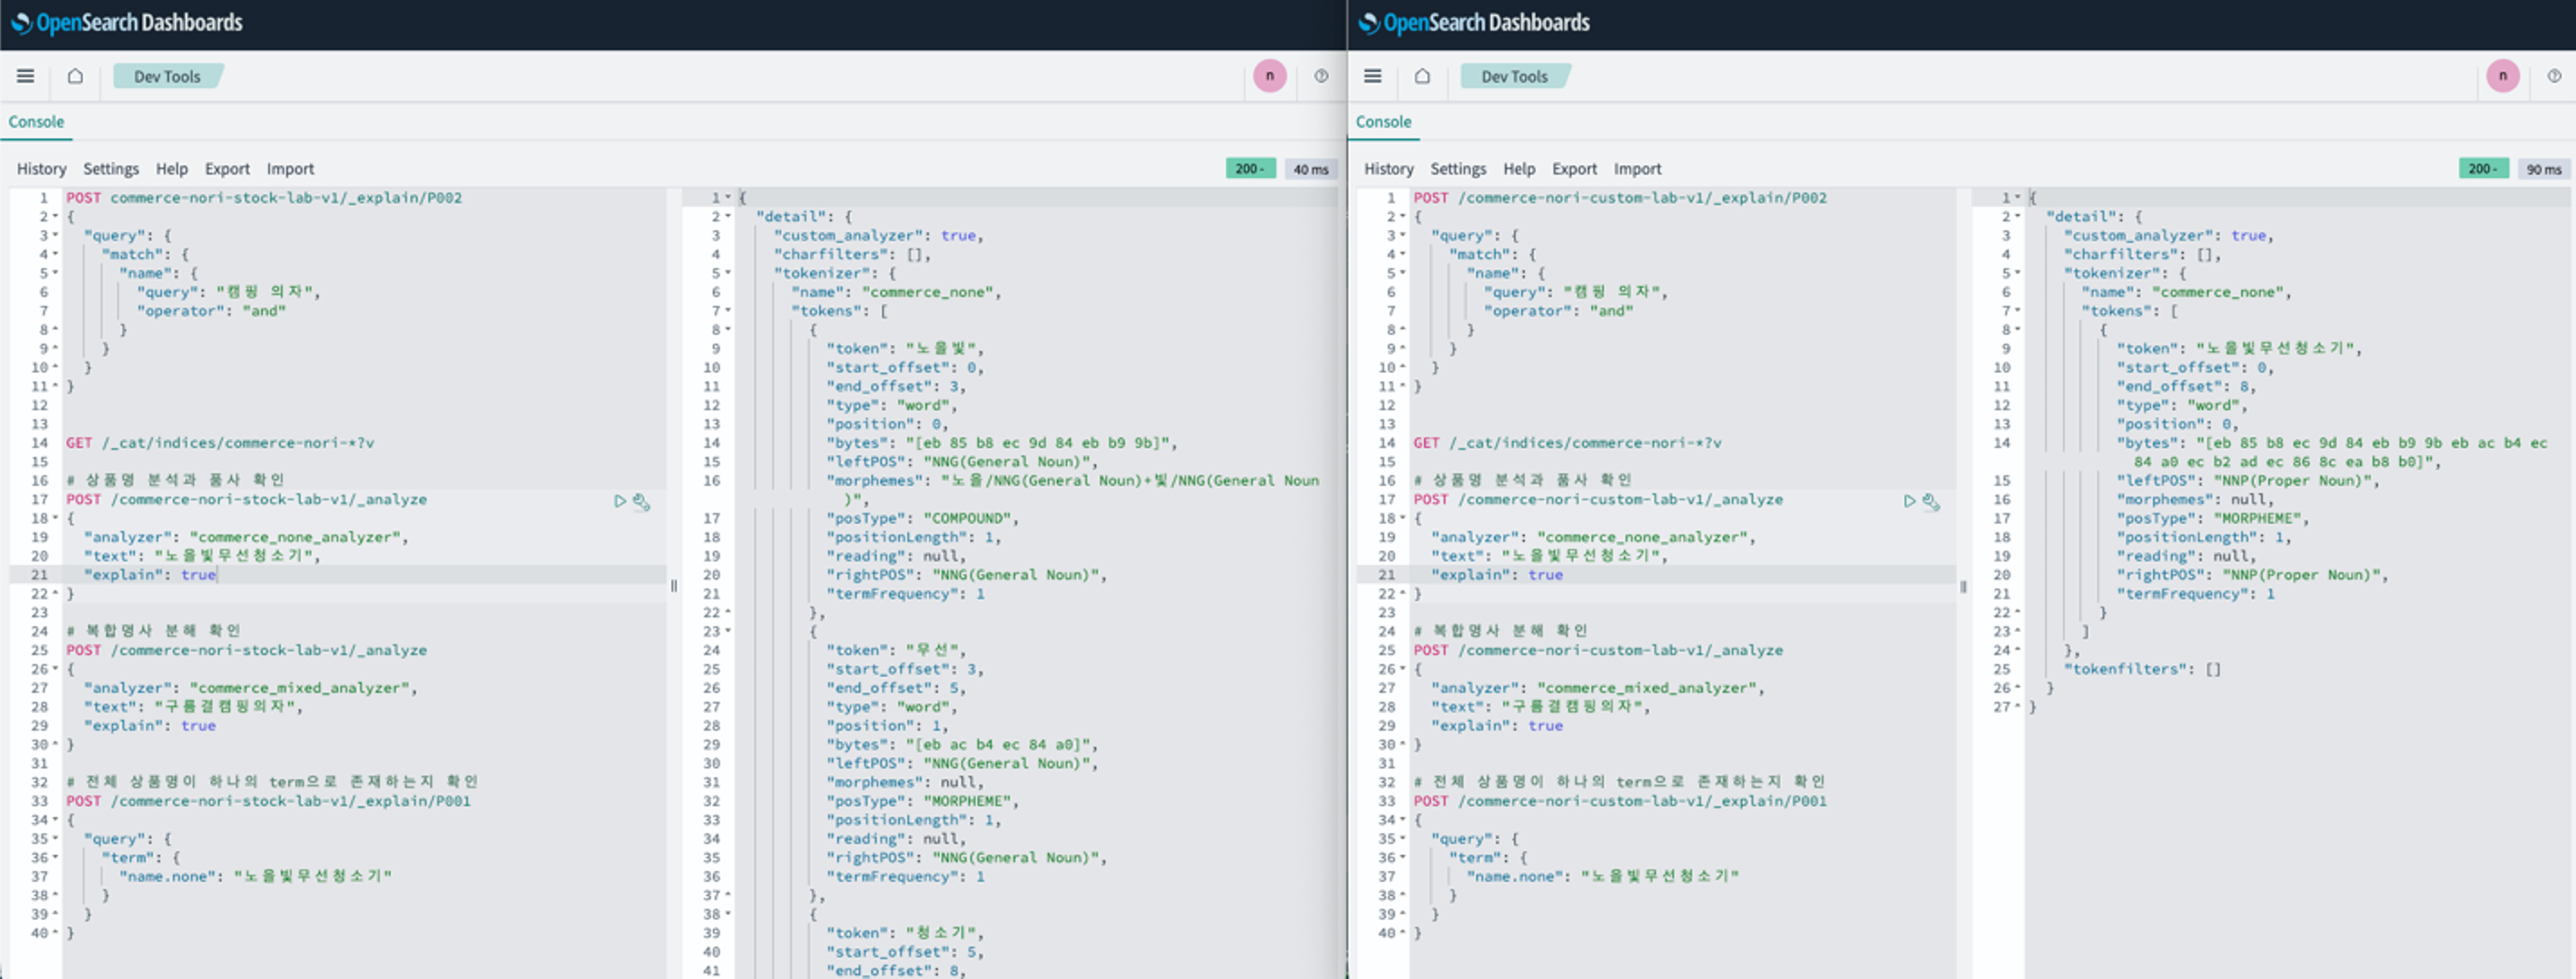
그림 2. AWS 제공 Nori 분석기 적용 클러스터(왼쪽) 과 Custom Nori 분석기 적용 클러스터(오른쪽) 분석 결과 비교
비용에 따른 토큰화를 비교할 때는 analyzer에 포함된 필터가 개입하지 않도록 tokenizer만 사용하고 분해 모드를 같게 둡니다.
도메인 A:
도메인 B:
기본 Nori 플러그인이 적용된 OpenSearch 도메인에서 기본 Nori는 노을빛 + 무선 + 청소기를, 커스텀 Nori는 노을빛무선청소기를 반환했습니다. A와 B의 비교는 기본 사전과 커스텀 사전의 차이를 보여줍니다. 비용만 바꾼 실험 결과는 앞서 로컬에서 수행한 high/low 검증으로 구분합니다.
복합명사 분해 모드
같은 방식으로 입력을 구름결캠핑의자로 바꾸고 두 도메인에 none, discard, mixed를 각각 지정합니다. 커스텀 Nori에서는 다음 결과를 확인합니다.
| 모드 | 커스텀 토큰 |
|---|---|
none |
구름결캠핑의자 |
discard |
구름결, 캠핑, 의자 |
mixed |
구름결캠핑의자, 구름결, 캠핑, 의자 |
mixed에서는 원형과 분해 토큰을 함께 출력하므로 토큰 문자열뿐 아니라 position과 positionLength도 확인합니다. CSV에 지정한 구름결/NNP, 캠핑/NNG, 의자/NNG의 품사 정보도 살펴봅니다.
사용자 사전 규칙은 두 도메인에 동일하게 적용
시스템 CSV에 넣지 않은 이 상품으로 사용자 사전의 동작을 따로 확인합니다. B의 Dev Tools에서 다음 요청을 실행하고, A에서는 tokenizer 이름만 nori_tokenizer로 바꿔 실행합니다.
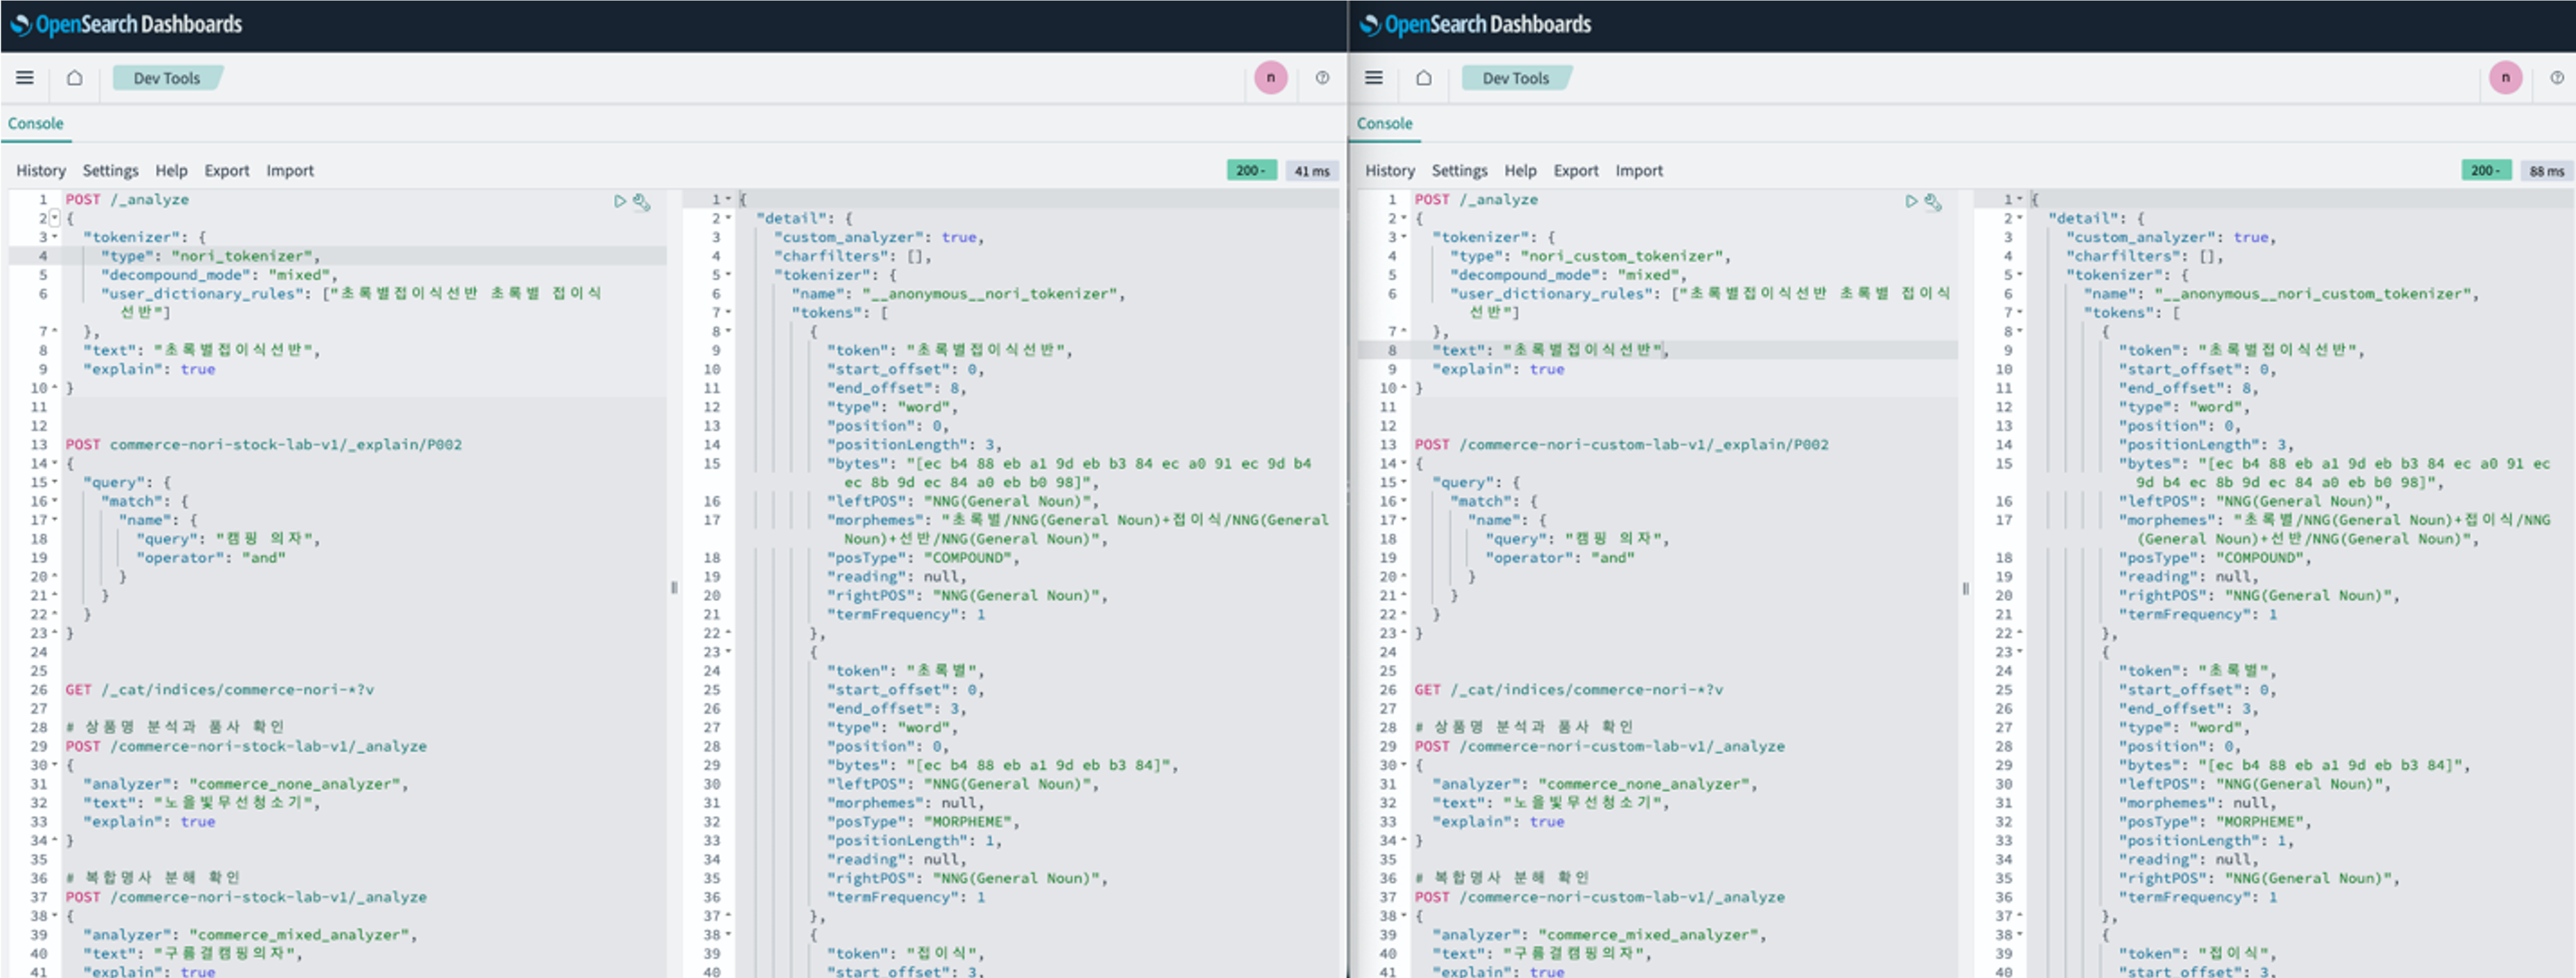
그림 3. AWS 제공 Nori 분석기 적용 클러스터(왼쪽) 과 Custom Nori 분석기 적용 클러스터(오른쪽) 사용자 사전 규칙 적용 결과 확인
원형과 초록별 + 접이식 + 선반이 함께 나오는지 비교합니다. 이 버전의 사용자 사전은 원형과 분해 토큰을 NNG로 처리하며, 임의 품사나 항목별 비용 열을 제공하지 않습니다. 같은 상품명을 시스템 사전 비용 실험과 사용자 사전에 동시에 넣으면 두 기능이 개입하므로 실험 대상을 분리했습니다.
이 실습은 AWS에서 검증한 user_dictionary_rules를 사용합니다. 별도 파일 패키지의 연결 방법은 커스텀 패키지 문서를 참고하세요. 파일 패키지를 이 커스텀 플러그인에 연결하는 조합은 이번 검증 범위에 포함하지 않습니다.
품사 표기의 차이
기존 AWS 테스트의 기본 Nori 비교 54건 중 30건은 로컬 기준과 품사 표기가 달랐습니다. 조사 JKB, JKO, JKS, JX는 J로, 어미 EC, EP는 E로 표시됐습니다. 토큰 문자열과 위치 정보는 같았습니다. 커스텀 tokenizer 27건은 품사를 포함해 로컬 기대값과 일치했습니다.
7. 각 도메인에 동일한 상품 색인
샘플의 인덱스 설정을 도메인별로 분리했습니다. A의 JSON에는 기본 Nori 구성요소만, B의 JSON에는 커스텀 Nori 구성요소만 들어 있습니다. analyzer 이름과 필드 매핑은 같으므로 동일한 요청으로 비교할 수 있습니다.
| 도메인 | 생성할 인덱스 | Dev Tools의 PUT 요청 뒤에 붙일 본문 |
|---|---|---|
| A | commerce-nori-stock-lab-v1 |
samples/index-settings-stock.json |
| B | commerce-nori-custom-lab-v1 |
samples/index-settings-custom.json |
먼저 HEAD /인덱스이름으로 실습 이름이 비어 있는지 확인합니다. 기존 인덱스가 있으면 삭제하지 말고 새 이름을 사용하세요. 각 Dev Tools에 PUT /인덱스이름을 입력하고 다음 줄에 해당 JSON 파일 전체 내용을 붙여 실행합니다. 로컬 파일 경로를 서비스에 전달하는 방식이 아닙니다.
두 설정의 name 필드는 사용자 사전, mixed와 해당 플러그인의 품사 및 읽기 필터를 조합합니다. 원문 문자열은 name.raw라는 keyword 하위 필드에 보관합니다. 샤드 1개, 복제본 1개로 준비했으며 데이터 노드 수에 맞춰 두 도메인에 같은 값을 적용합니다. 단일 노드에서는 복제본을 할당할 수 없습니다.
A의 Dev Tools에서 다음을 실행합니다.
B에서는 경로를 /commerce-nori-custom-lab-v1/_bulk?refresh=true로 바꾸고 같은 본문을 실행합니다. Bulk 본문 마지막에 줄바꿈을 유지하고 응답의 errors=false와 각 항목의 성공 상태를 확인합니다.각 도메인의 인덱스에 같은 검색을 실행합니다.
다음은 A의 요청이며 B에서는 인덱스 이름만 바꿉니다.
두 도메인에서 P002, 구름결캠핑의자가 반환되는지 확인합니다. 이 검색은 분석기 적용 후 색인과 검색이 동작하는지 검사하는 용도입니다. 두 파일은 같은 순서로 기본 tokenizer, 복합명사, 사용자 사전, 등록 analyzer와 인덱스 검색을 확인합니다.
검증 결과와 운영 시 고려사항
Amazon OpenSearch Service 3.5 도메인에서 패키지 검증 AVAILABLE, 연결 ACTIVE, 분석 요청 88건, 상품 색인 4건과 검색을 확인했습니다.
이 기록은 한 도메인에서 기본/커스텀 Nori를 함께 검증한 결과입니다.
운영 적용 전에는 다음을 확인하세요.
- 단어 비용을 과도하게 낮추면 기존 문장의 분석도 바뀔 수 있습니다. 조사가 붙은 상품명, 일부 글자만 겹치는 표현과 일반 명사 문장을 회귀 데이터에 포함합니다.
- 사전 변경은 이미 색인한 문서를 다시 분석하지 않습니다. 새 분석 설정의 인덱스에 재색인하고 검증 후 alias를 전환하는 절차와 롤백을 준비가 필요합니다.
- 토큰화 예제와 검색 품질 평가는 다릅니다. 자신의 상품과 검색어로 별도의 품질 평가를 수행합니다.
- 커스텀 플러그인 사용시 사전 조건에 대한 상세 내용은 공식 문서를 참고하세요.
실습 리소스 정리
이 실습에서 만든 인덱스인지 확인한 뒤 A와 B 각각에서 삭제합니다.
다른 인덱스나 클라이언트가 커스텀 플러그인을 사용하지 않는지 확인합니다. 이번 실습에서 새로 등록한 패키지일 때만 B에서 연결을 해제합니다.
연결 해제와 구성 변경 완료 후 다른 도메인에서도 사용하지 않는 것을 확인하고, 실습 패키지와 이번에 업로드한 S3 객체만 삭제합니다.
삭제 결과도 확인합니다. 버전 관리 버킷이라면 이번 객체의 버전 정리 여부를 추가 확인하세요. 기존 도메인 두 개, AWS 제공 기본 Nori, 기존 패키지와 S3 버킷 자체는 삭제하지 않습니다.
결론
이 글에서는 MeCab-Ko 엔진과 사전을 로컬에서 빌드하고, 상품명에 맞춰 품사와 단어 비용, 복합명사 정보를 조정했습니다. 네이티브 사전으로 분석 결과를 검증한 뒤 같은 사전 원본에서 Lucene Nori 리소스를 생성해 커스텀 플러그인으로 패키징했습니다. Amazon OpenSearch Service의 두 도메인에서 기본 Nori와 커스텀 Nori의 분석 결과를 비교하는 방법도 살펴봤습니다.
기본 Nori에 사용자 사전과 동의어 사전 패키지를 적용하는 방식은 도메인 용어를 추가하고 검색 표현을 보완하는 데 유용합니다. 플러그인을 직접 빌드하면 사전 항목별 품사와 단어 비용, 복합명사를 구성하는 형태소의 품사까지 조정할 수 있어 한국어 분석을 더 세밀하게 구성할 수 있습니다.
각 단어의 비용을 조정하면 상품명이나 브랜드명을 하나의 항목으로 인식할지, 여러 항목으로 나눌지에 영향을 주는 분석 경로를 제어할 수 있습니다. 이를 실제 상품과 검색어에 맞춰 검증하고 반복적으로 조정하면, 도메인 용어를 의도에 맞게 처리하고 보다 정확한 검색을 위한 튜닝에 활용할 수 있습니다. 운영에 적용하기 전에는 원하는 상품명의 분석 결과뿐 아니라 기존 문장의 분석과 검색 결과에 미치는 영향도 함께 확인하세요.