AWS 기술 블로그
AWS에서 AI 에이전트 실행 환경 격리하기 3부: 에이블리의 Amazon EKS 기반 Agent Sandbox 운영 사례
에이블리코퍼레이션(ABLY Corp, 이하 에이블리)은 “셀러와 유저가 상생하는 스타일 생태계”를 목표로 스타일 커머스 플랫폼 에이블리를 운영하는 기업입니다. 자체 개발한 AI 개인화 추천 기술을 기반으로 이용자 취향에 맞는 쇼핑 경험을 제공하고 있으며, 국내를 넘어 글로벌 시장으로도 사업을 확장하고 있습니다. 에이블리 앱의 월간 활성 사용자(MAU)는 1,000만 명을 돌파했으며, 누적 다운로드는 6,000만 회, 누적 리뷰는 1억 개를 넘어섰습니다.
에이블리는 사내 구성원이 자연어로 업무용 웹 애플리케이션을 만드는 AI Builder도 운영합니다. 구성원이 요청하면 에이전트가 프로젝트 파일을 고치고 패키지를 설치하며, 구성원은 프리뷰로 결과를 확인한 뒤 다음 작업을 요청합니다. 그래서 프로젝트마다 파일과 실행 도구를 갖춘 작업환경이 필요합니다. 문제는 이 환경을 언제 만들고 언제 회수하느냐였습니다. 작업은 대화가 끝난 뒤에도 이어질 수 있지만, 사용하지 않는 환경을 계속 켜 둘 이유는 없습니다.
에이블리는 Amazon Elastic Kubernetes Service(Amazon EKS)에서 작업환경의 수명 주기(lifecycle) 관리를 Agent Sandbox에 맡깁니다. 노드의 공급과 회수는 Karpenter에 연결했습니다. 1부는 Agent Sandbox와 gVisor로 격리 계층을 구성했고, 2부는 NetworkPolicy, Warm Pool, 격리 비용, 수명 주기를 다뤘습니다. 3부는 실제 서비스에서 작업환경을 언제 만들고 언제 회수하는지를 에이블리 사례로 살펴봅니다.
시리즈 블로그 보기
- AWS에서 AI 에이전트 실행 환경 격리하기 1부: Amazon EKS와 Agent Sandbox, 개념과 구성
- AWS에서 AI 에이전트 실행 환경 격리하기 2부: Amazon EKS와 Agent Sandbox, 개념과 구성
- AWS에서 AI 에이전트 실행 환경 격리하기 3부: 에이블리의 Amazon EKS 기반 Agent Sandbox 운영 사례
1. Agent Sandbox를 선택한 이유
에이블리에 필요한 것은 프로젝트별 작업공간은 남기고, 사용하지 않을 때는 실행 자원을 회수했다가 다시 준비하는 수명 주기였습니다. 먼저 Kubernetes 기본 워크로드로 구현하는 방법을 검토했습니다.
| 방식 | 원래 용도 | 작업환경에 적용할 때 남는 과제 |
|---|---|---|
| Deployment | 정해진 수의 Pod 유지, 배포와 갱신 | 중단, 재개, 만료 규칙을 따로 만들어야 함 |
| Job | 작업의 완료 관리 | 실행 한 번이 끝나도 환경은 남아야 하므로 작업 완료와 환경 수명 주기를 분리해야 함 |
| Pod 직접 생성 | 단일 Pod | 생성, 중단, 재생성, 만료를 애플리케이션이 모두 관리해야 함 |
| Agent Sandbox | 작업환경 하나를 Sandbox 커스텀 리소스로 표현 |
실행 스펙, 실행 상태, 만료를 한 리소스에 선언 |
표 1. 에이블리가 검토한 작업환경 관리 방식
세 가지 기본 워크로드로도 구현은 가능합니다. 다만 수명 주기를 애플리케이션이 모두 책임져야 합니다. 에이블리는 이 역할을 컨트롤러에 맡기는 편이 낫다고 판단했고, 작업환경 단위의 리소스를 제공하는 Agent Sandbox를 선택했습니다.
2. Sandbox 리소스로 작업환경 관리하기
AI Builder 애플리케이션은 프로젝트마다 Sandbox를 하나 만듭니다. Agent Sandbox 컨트롤러는 이 스펙(Spec)대로 작업 Pod를 만들고, Pod는 전용 Karpenter NodePool의 노드에 배치됩니다. 언제 멈출지는 애플리케이션이 정하고, Pod와 노드의 실제 상태는 각 컨트롤러가 맞춥니다.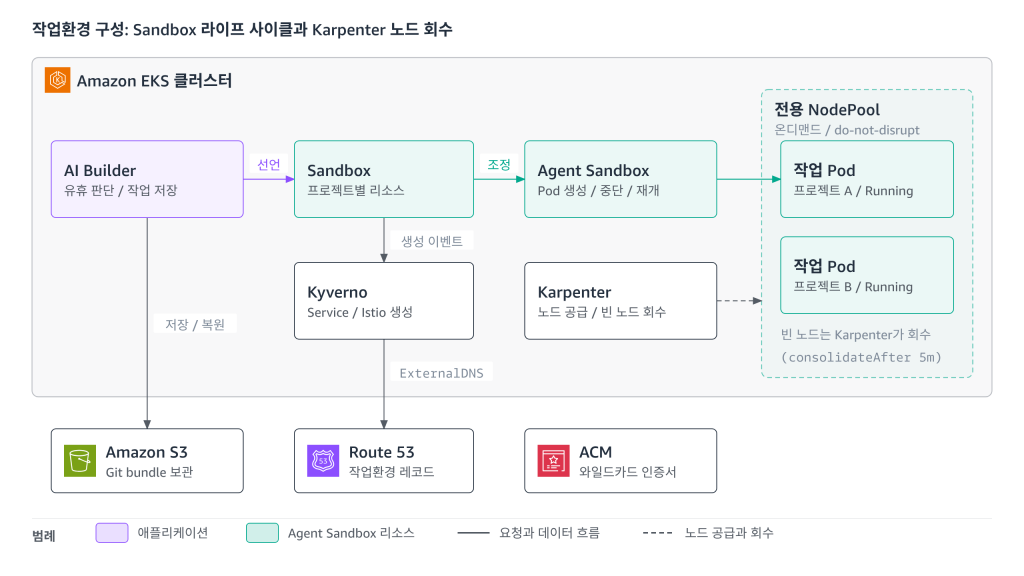
그림 1. 작업환경과 노드의 수명 주기를 연결한 에이블리 구성 (Istio 진입점과 로드 밸런서는 간략화했습니다)
AI Builder 애플리케이션이 프로젝트별 Sandbox를 생성하면 Agent Sandbox 컨트롤러가 전용 Karpenter NodePool에 작업 Pod를 만듭니다. Kyverno는 Service와 Istio 접속 리소스를 생성하고, ExternalDNS는 호스트 레코드를 Route 53에 반영합니다. 작업 코드는 Amazon S3에 보관합니다.
아래는 Sandbox 스펙의 주요 부분입니다. 이름, 만료 시각, 프로젝트 식별자는 예시 값이고 이미지와 나머지 환경변수는 생략했습니다.
apiVersion: agents.x-k8s.io/v1beta1
kind: Sandbox
metadata:
  name: workspace-example
spec:
  operatingMode: Running
  shutdownPolicy: Delete
  shutdownTime: "2026-11-01T00:00:00Z" # 예시 만료 시각
  podTemplate:
    metadata:
      annotations:
        karpenter.sh/do-not-disrupt: "true"
    spec:
      schedulerName: most-allocated-scheduler
      automountServiceAccountToken: false
      containers:
        - name: sandbox
          env:
            - name: PROJECT_UID
              value: project-example
          resources:
            requests:
              cpu: 500m
              memory: 2Gi
            limits:
              cpu: "2"
              memory: 4Gi
# ...podTemplate에는 실행 도구와 프리뷰 환경, 자원 요청과 상한을 담고 ServiceAccount 토큰 자동 마운트는 비활성화합니다. 애플리케이션은 Pod를 직접 만들거나 지우지 않고 operatingMode만 바꿉니다. Agent Sandbox API Reference에 따르면 Suspended로 바꾸면 Pod는 종료되고 Sandbox 객체와 볼륨은 남습니다. Running으로 되돌리면 Pod가 다시 만들어집니다. 프로젝트는 같은 리소스로 계속 관리하고 실행 자원은 필요할 때만 사용하는 셈입니다. 업스트림 문서 첫 페이지에는 ‘네트워크 요청이 들어오면 자동으로 재개’한다는 소개가 있지만, v1.0.8의 컨트롤러와 sandbox-router에는 operatingMode를 Running으로 되돌리는 코드가 없습니다. 그래서 재개 시점은 애플리케이션이 판단해 직접 바꿔야 합니다.
다만 상태를 바꿨다고 바로 작업할 수 있는 것은 아닙니다. 애플리케이션은 Sandbox의 상태 조건과 코드, 의존성 준비 여부를 따로 확인합니다.
2.1 Python에서 상태 변경하기
AI Builder 백엔드는 Agent Sandbox SDK 대신 Kubernetes Python 클라이언트의 CustomObjectsApi로 Sandbox를 다룹니다. 아래는 상태를 바꾸는 호출을 단순화한 코드입니다. 생성은 같은 리소스 정보로 create_namespaced_custom_object를 호출합니다.
from kubernetes import client

api = client.CustomObjectsApi()  # in-cluster 인증 설정 이후 생성
resource = {"group": "agents.x-k8s.io", "version": "v1beta1", "plural": "sandboxes"}


def set_operating_mode(namespace, name, mode, shutdown_time):
    return api.patch_namespaced_custom_object(
        **resource,
        namespace=namespace,
        name=name,
        body={"spec": {
            "operatingMode": mode,
            "shutdownPolicy": "Delete",
            "shutdownTime": shutdown_time,
        }},
    )
상태와 만료 시각을 한 patch에 담아 중단과 보관 기한 변경을 한 번에 처리합니다. 실제 재개 코드는 여기에 토큰 갱신을 더하고, Pod가 없는 중단 상태에서만 스케줄러와 자원 설정을 바꿉니다. 동시에 들어온 재개 요청이 서로 덮어쓰지 않도록 resourceVersion으로 충돌도 확인합니다.
3. 기존 EKS 운영 구성에 연결하기
Sandbox가 생성되면 Kyverno가 Service와 Istio 접속 리소스를 만들고, ExternalDNS가 호스트 정보를 Amazon Route 53에 등록합니다. 공통 진입점과 AWS Certificate Manager(ACM) 와일드카드 인증서를 함께 사용하므로 작업환경마다 로드 밸런서나 인증서를 만들지 않습니다. 와일드카드 인증서는 한 단계 하위 도메인만 보호하므로, 호스트 이름도 그 범위 안에 두어야 합니다.
아래는 Kyverno 정책 중 Service 생성 규칙입니다. 정책 이름은 예시이고 레이블 조건, selector, 포트는 생략했습니다.
apiVersion: kyverno.io/v1
kind: ClusterPolicy
metadata:
  name: workspace-access
spec:
  background: false
  generateExisting: false
  rules:
    - name: service
      match:
        any:
          - resources:
              kinds: ["agents.x-k8s.io/*/Sandbox"]
              operations: [CREATE]
      generate:
        apiVersion: v1
        kind: Service
        name: "{{request.object.metadata.name}}"
        namespace: "{{request.namespace}}"
        synchronize: true
        data:
          metadata:
            ownerReferences:
              - apiVersion: agents.x-k8s.io/v1beta1
                kind: Sandbox
                name: "{{request.object.metadata.name}}"
                uid: "{{request.object.metadata.uid}}"
          # ...
Sandbox 생성 이벤트가 들어오면 같은 네임스페이스에 Service를 만듭니다. synchronize: true는 생성된 리소스를 정책과 계속 맞춥니다. ownerReferences는 Sandbox가 삭제될 때 이 리소스도 함께 정리되게 합니다(Kyverno Generate Rules). Gateway와 VirtualService에도 같은 소유 관계를 설정했습니다. 그래서 중단할 때는 주소와 라우팅이 그대로 남고, Sandbox를 삭제하면 접속 리소스도 함께 사라집니다.
Agent Sandbox 컨트롤러도 spec.service: true이면 Sandbox와 같은 이름의 헤드리스 Service를 만듭니다. Kyverno가 만든 Service는 이름이 같지만 컨트롤러 소유(controller: true)가 아니므로, 이 구성에서는 spec.service를 지정하지 않아야 합니다. true로 두면 컨트롤러가 기존 Service를 넘겨받지 못해 Sandbox가 Ready 상태가 되지 않습니다.
4. 작업을 보존하면서 유휴 환경 회수하기
Sandbox를 중단하면 프로세스와 메모리 상태가 사라집니다. 그래서 작업물은 Pod 밖에 보관합니다. 에이블리는 작업 코드를 Git bundle로 묶어 Amazon S3에 저장하고, 프로젝트와 대화 정보는 애플리케이션이 관리합니다.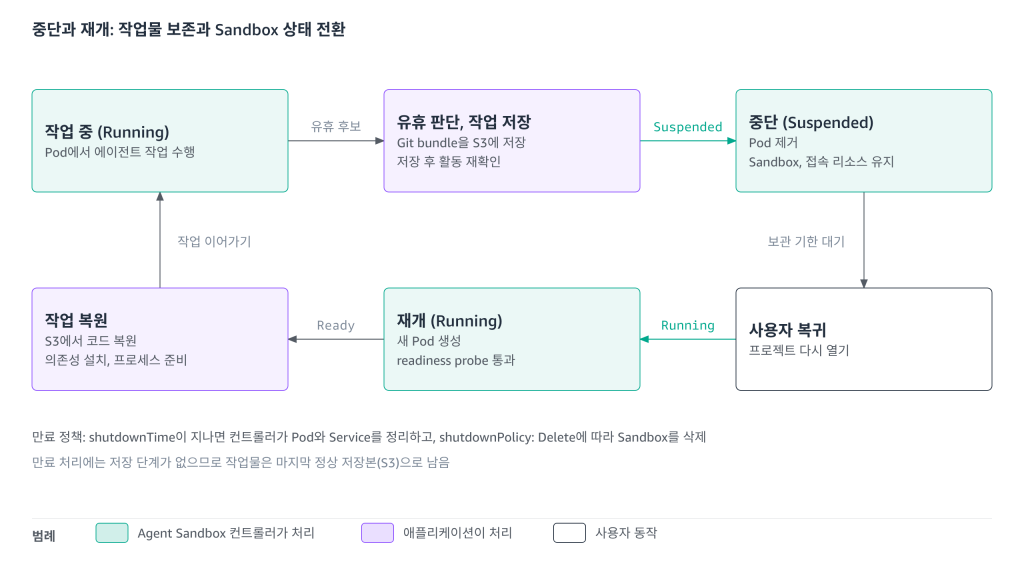
그림 2. 작업물 보존과 Sandbox의 중단, 재개 흐름 (일반적인 경로를 나타낸 개념도입니다)
애플리케이션은 Running 상태의 작업환경이 유휴 상태인지 확인하고 작업을 S3에 저장한 뒤 Suspended로 전환합니다. 사용자가 돌아오면 Running으로 재개해 새 Pod를 준비하고, 저장된 코드와 의존성을 복원해 작업을 이어갑니다.
유휴 여부는 마지막 대화 시각만으로 판단하지 않습니다. 에이전트가 긴 명령을 실행 중이거나 사용자가 프리뷰를 보고 있으면 대화가 없어도 환경이 필요하기 때문입니다. 실행 중인 작업과 화면 활동 신호를 함께 봅니다.
중단할 때는 작업물을 저장한 뒤 활동 여부를 한 번 더 확인하고 Suspended로 바꿉니다. 저장하는 사이 사용자가 돌아올 수 있어서 이 재확인 단계를 뒀습니다. 사용자가 돌아오면 환경을 재개하고 코드와 의존성을 복원합니다. 동작별 리소스 처리는 아래와 같이 나눴습니다.
| 동작 | 시작 주체 | 작업 Pod | Sandbox와 접속 리소스 | 작업물 |
|---|---|---|---|---|
중단 (Suspended) |
애플리케이션의 유휴 판단 | 제거 | 유지 (주소와 라우팅 유지) | 중단 전에 S3로 저장 |
재개 (Running) |
사용자 복귀 | 새로 생성 | 기존 리소스 재사용 | S3에서 복원 |
| 삭제 | 애플리케이션 | 제거 | Sandbox 제거, ownerReferences로 연결 리소스 정리 |
S3와 애플리케이션이 계속 관리 |
만료 (shutdownTime 경과) |
Agent Sandbox 컨트롤러 | 제거 | shutdownPolicy: Delete에 따라 Sandbox 제거 |
만료 처리에는 저장 단계가 없음 |
표 2. 작업환경 동작별 리소스 처리 (만료 동작은 Agent Sandbox API Reference 기준)
Sandbox를 삭제해도 프로젝트 데이터는 지워지지 않습니다. 나중에 다시 열면 환경을 새로 만들고 S3에 보관한 작업물을 복원합니다.
4.1 만료 정책으로 방치된 환경 정리하기
유휴 판단을 맡은 애플리케이션 작업이 멈출 때를 대비해 만료 정책도 설정했습니다. API Reference에 따르면 shutdownTime이 지나면 Pod와 Service는 항상 삭제되고, shutdownPolicy: Delete이면 Sandbox 객체까지 지워집니다. 기본값 Retain은 객체를 남깁니다.
실행 중인 환경은 애플리케이션이 만료 시각을 계속 늦추고, 중단된 환경에는 보관 기한을 따로 줍니다. 연장이 멈추거나 기한이 지나면 컨트롤러가 Sandbox를 정리합니다. 한쪽이 멈춰도 환경이 무기한 남지 않는 구조입니다. 만료 처리는 작업물을 저장하지 않으므로 정상 중단 경로의 저장 절차와는 별도로 운영합니다.
5. 운영하며 보완한 점
5.1 프로젝트별 설정과 Warm Pool
작업환경은 어느 프로젝트를 어떤 설정으로 실행할지 알고 시작해야 합니다. 에이블리는 프로젝트 식별자와 실행 설정을 컨테이너 환경변수로 전달하므로, 프로젝트가 정해진 뒤에 스펙을 만듭니다. 재개할 때는 보존된 스펙의 토큰 값만 갱신합니다.
이 구조에서는 Warm Pool의 이점을 얻기 어렵습니다. 업스트림 v1.0.8은 SandboxClaim.spec.env로 환경변수를 넘길 수 있습니다. 하지만 소스 주석에 따르면 이 필드를 사용하면 미리 준비한 Pod 대신 항상 템플릿에서 새로 기동합니다(sandboxclaim_types.go). Warm Pool을 활용하려면 공통 환경을 먼저 준비하고, 할당 후 받은 설정으로 작업 프로세스를 시작하도록 초기화 흐름을 바꿔야 합니다.
5.2 Pod 기동과 작업 준비 구분
초기에는 컨테이너가 떴지만 실행 API가 아직 요청을 받지 못하는 구간에 호출이 들어가 503 오류가 났습니다. 실행 API 포트를 확인하는 readiness probe를 추가해 해결했습니다. 이후 트래픽은 준비된 Pod로만 보내고, 코드 복원과 의존성 준비는 애플리케이션이 따로 확인합니다. 시작 시간도 Pod가 Ready가 될 때까지와 실제 작업이 가능할 때까지를 나눠 측정합니다.
접속 문제는 Pod 준비 상태, Service 엔드포인트, 라우팅, DNS 응답 순으로 나눠 봅니다. 재개할 때는 주소와 라우팅을 재사용하므로 새 Pod의 준비 상태와 엔드포인트 갱신만 보면 됩니다.
5.3 활성 작업 보호와 빈 노드 회수
운영 중 노드 통합(Consolidation)으로 노드가 교체되면서 실행 중인 명령이나 스트리밍 응답이 끊기는 문제가 있었습니다. 에이블리는 작업 Pod를 전용 온디맨드 NodePool에 두고, karpenter.sh/do-not-disrupt 어노테이션과 Disruption budget을 함께 적용했습니다. 사용 중인 노드는 보호하고 빈 노드는 회수하는 것이 목표입니다.
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: workspace-pool
spec:
  template:
    spec:
      expireAfter: Never
      requirements:
        - key: karpenter.sh/capacity-type
          operator: In
          values: [on-demand]
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 5m
    budgets:
      - nodes: "1"
        reasons: [Empty]
      - nodes: "0"
        reasons: [Underutilized, Drifted]
        schedule: "0 0 * * mon-fri"   # 예시: UTC 00:00(KST 09:00)부터
        duration: 10h                 # 10시간 동안 차단
빈 노드는 한 번에 하나씩 회수합니다. 사용 중인 노드의 통합과 드리프트 교체는 업무 시간에 막고 그 밖의 시간에만 허용합니다. 예산의 schedule과 duration은 예산이 적용되는 시간대이므로, nodes: "0" 예산을 업무 시간대에 걸어 그 시간에만 막습니다. 두 필드를 생략하면 예산이 항상 적용되어 해당 사유의 교체가 영구히 차단됩니다. Karpenter 문서에 따르면 consolidateAfter는 새 Pod를 기다리는 시간이며, Pod가 추가되거나 빠질 때마다 다시 시작됩니다. expireAfter: Never는 노드 최대 수명에 따른 교체를 비활성화합니다.
do-not-disrupt는 자발적 중단만 막습니다. 만료, 인스턴스 중단(Interruption), 수동 삭제는 막지 못하므로 작업물 보존은 여전히 필요합니다. 또 보호만 강하게 걸고 유휴 환경을 정리하지 않으면 회수할 노드가 생기지 않습니다. 유휴 판단, Pod 중단, 노드 회수가 이어져야 비용이 줄어듭니다.
5.4 재개 구간의 부하를 반영한 requests
작업환경은 대기 중에는 가볍지만, 재개할 때는 코드 복원과 의존성 설치로 CPU, 메모리, 디스크 I/O를 많이 사용합니다. 유휴 사용량에 맞춰 requests를 작게 잡으면 한 노드에 Pod가 몰리고, 여러 프로젝트가 동시에 재개될 때 부하가 겹칩니다. 에이블리는 requests를 CPU 500m, 메모리 2Gi로, limits를 CPU 2, 메모리 4Gi로 정했습니다.
EKS Best Practices Guide는 통합을 사용할 때 CPU 외 자원의 requests와 limits를 같게 두도록 권고합니다. 통합은 requests만 보고 Pod를 모으므로 requests를 넘어 메모리를 사용하는 Pod는 메모리 부족으로 종료될 수 있습니다. 메모리 limits를 더 크게 둔 구성이라면 재개 구간의 메모리 사용량을 함께 관찰하는 것을 권고합니다.
5.5 MostAllocated 스케줄러 적용
클러스터에는 NodeResourcesFit 플러그인의 MostAllocated 전략을 사용하는 별도 스케줄러가 있습니다. CPU와 메모리 요청량의 할당 비율이 높은 노드를 우선하므로 Pod를 적은 수의 노드에 모읍니다(Resource Bin Packing). 대신 동시 재개 때 부하가 한 노드에 몰릴 수 있어 함께 평가해야 합니다.
새 Sandbox는 schedulerName: most-allocated-scheduler로 만들고, 기존 Sandbox는 Pod가 완전히 사라진 중단 상태에서 재개할 때 스펙을 갱신합니다. 실행 중인 Pod는 옮기지 않고 다음 실행부터 적용하는 방식입니다. 전환 조건을 확인할 수 없으면 기존 설정을 유지합니다.
6. Agent Sandbox로 얻은 장점
가장 큰 장점은 작업환경을 Kubernetes 리소스로 다룰 수 있다는 점입니다. 작업환경이 애플리케이션 코드 안의 개념에 머무르지 않고 Kubernetes API로 조회하고 변경하는 객체가 됐습니다. 서비스는 환경이 언제 필요한지만 판단하고 실행, 중단, 재개, 만료는 컨트롤러에 맡깁니다. Pod 배치와 노드 회수는 Karpenter로, 접속 리소스는 Kyverno로 연결해 기존 EKS 운영 방식을 그대로 이어갈 수 있었습니다.
7. 향후 방향
7.1 격리 강화
지금의 작업환경은 runc 기반 일반 컨테이너라 호스트 커널을 공유합니다. 1부에서 다룬 gVisor에 이어, 에이블리는 Kata Containers처럼 별도 커널을 사용하는 경량 VM(microVM) 런타임을 검토하려 합니다. Agent Sandbox API는 그대로 두고 런타임만 바꾸는 방향입니다. EKS 노드의 가상화 지원, 패키지 설치와 빌드, 브라우저 실행의 호환성, 기동 시간과 메모리 비용을 함께 검증할 계획입니다.
7.2 사내 공통 실행 기반
Agent Sandbox는 Python, Go SDK와 TypeScript 클라이언트를 제공합니다. Python SDK로는 Sandbox 생성, 조회, 삭제와 commands.run, files.read, files.write 호출을 사용할 수 있습니다(Python SDK). Pod 안의 sandboxd는 프로세스 실행(gRPC)과 파일 작업(REST)용 런타임 API를 제공합니다(Runtime API).
에이블리는 이 인터페이스 위에 인증과 권한, 자원과 만료 정책, 접속 경로, 작업물 보관 방식을 갖춘 사내 공통 실행 기반을 만들려 합니다. 다만 업스트림 SDK는 SandboxClaim과 Warm Pool, 호환 런타임 API를 전제로 하므로, 현재의 이미지와 실행 하네스 중 무엇을 공식 인터페이스로 바꿀지부터 검토할 계획입니다.
8. 마치며
1부와 2부가 에이전트 실행 환경을 어떻게 격리하고 운영할지를 다뤘다면, 에이블리 사례는 같은 구성 요소로 작업환경의 수명 주기를 관리하는 방법을 보여 줍니다. 핵심은 책임 분리입니다. 애플리케이션은 유휴 판단과 작업물 보존을, Agent Sandbox는 Pod의 중단과 재개를, Karpenter는 빈 노드 회수를 맡고, 만료 정책이 마지막 안전장치가 됩니다.
운영에서 얻은 교훈도 분명합니다. Pod의 Ready와 작업 준비 완료는 다른 시점입니다. 노드 보호 설정은 유휴 환경 정리와 함께 설계해야 회수로 이어집니다. requests는 재개 구간의 부하까지 보고 정해야 합니다.
직접 구성해 보려면 1부의 설치 절차로 Agent Sandbox와 gVisor를 준비하고, 2부의 NetworkPolicy와 만료 설정을 적용한 뒤, 이 글의 중단·재개 흐름과 Karpenter 예산 설정을 더해 보시기 바랍니다. EKS에서 Agent Sandbox를 Karpenter와 함께 바로 띄우려면 AI on EKS의 Agent Sandbox 블루프린트를 시작점으로 쓸 수 있습니다.
참고 자료
- AWS에서 AI 에이전트 실행 환경 격리하기 1부: Amazon EKS와 Agent Sandbox, 개념과 구성 – AWS 기술 블로그
- AWS에서 AI 에이전트 실행 환경 격리하기 2부: Amazon EKS와 Agent Sandbox, 운영 심화 – AWS 기술 블로그
- Scale cluster compute with Karpenter and Cluster Autoscaler – Amazon EKS User Guide
- Karpenter – Amazon EKS Best Practices Guide
- AWS Certificate Manager public certificate characteristics and limitations – AWS Certificate Manager User Guide
본문의 설정 값은 2026년 10월 기준 에이블리 운영 환경에서 발췌했으며, Agent Sandbox 동작 설명은 업스트림 v1.0.8 소스와 API Reference를 기준으로 정리했습니다. 업스트림 API와 기본 동작은 버전에 따라 달라질 수 있습니다.