AWS 기술 블로그
AWS에서 AI 에이전트 실행 환경 격리하기 4부: Amazon Bedrock AgentCore Runtime, 관리형 샌드박스의 동작과 선택 기준
1부와 2부에서는 Amazon EKS에 Agent Sandbox와 gVisor를 구성하고, 모델이 생성한 코드를 막으려면 Pod 보안 설정, gVisor, NetworkPolicy, 전용 노드 그룹의 IMDS 설정이라는 4개 계층이 함께 있어야 한다는 것을 확인했습니다. 3부에서는 에이블리가 Agent Sandbox와 Karpenter로 사내 AI Builder 작업 환경의 수명 주기를 관리하는 사례를 살펴보았습니다. 애플리케이션은 유휴 판단과 작업물 보존을, Agent Sandbox는 Pod의 중단과 재개를, Karpenter는 빈 노드 회수를 맡는 책임 분리가 핵심이었습니다. 에이블리는 다음 단계로 Kata Containers 같은 microVM 런타임을 검토한다고 밝혔습니다.
시리즈의 마지막 편인 4부에서는 그 microVM 격리에 더해 세션의 생성, 회수, 확장까지 서비스가 맡는 Amazon Bedrock AgentCore로 같은 문제를 풀고, EKS와 같은 기준으로 비교합니다. EKS에서는 2부의 도입 전 확인 항목처럼 gVisor 전용 노드 그룹, VPC CNI의 NetworkPolicy 활성화, 샌드박스 DNS와 Egress 경로, sandbox-router 인증, Pod IP 재사용 대기와 그에 맞춘 Warm Pool 크기를 플랫폼 팀이 직접 구성하고 운영했습니다. 이 운영이 서비스로 넘어가면 무엇이 줄고 무엇이 애플리케이션에 남는지가 이 글의 질문입니다.
관리형 서비스는 노드와 런타임 버전 관리, 미리 띄워 두는 용량, 쓰지 않는 샌드박스의 정리를 서비스가 맡아 총소유비용(TCO)을 낮출 수 있는데, 그 근거도 측정값으로 확인합니다. 기준은 1부의 두 가지 설계 원칙인 격리와 격리 비용이고, 비교 항목은 2부에서 확인한 네트워크, 자격 증명, 시작 지연, 시스템 콜 비용, 수명 주기와 상태 보존입니다. 서비스 소개나 사용법은 다루지 않습니다. 대신 문서만으로는 알기 어려운 내부 동작과 세션 수명 주기의 규칙, 실행 환경을 고르는 기준을 측정값으로 정리합니다. 측정하지 못한 Instances 컴퓨팅 유형은 문서를 기준으로 덧붙입니다.
시리즈 블로그 보기
- AWS에서 AI 에이전트 실행 환경 격리하기 1부: Amazon EKS와 Agent Sandbox, 개념과 구성
- AWS에서 AI 에이전트 실행 환경 격리하기 2부: Amazon EKS와 Agent Sandbox, 개념과 구성
- AWS에서 AI 에이전트 실행 환경 격리하기 3부: 에이블리의 Amazon EKS 기반 Agent Sandbox 운영 사례
- AWS에서 AI 에이전트 실행 환경 격리하기 4부: Amazon Bedrock AgentCore Runtime, 관리형 샌드박스의 동작과 선택 기준
1. 코드가 실행되는 위치와 AgentCore가 대신 맡는 일
1.1 코드가 실행되는 두 위치
실행 환경 격리 관점에서 AgentCore의 코드 실행 위치는 두 가지 방식으로 설정할 수 있습니다. 에이전트 자체(프레임워크 코드, MCP 서버, A2A 서버)는 AgentCore Runtime(이하 Runtime)에서, 에이전트가 생성한 Python, JavaScript, 셸 명령은 AgentCore Code Interpreter(이하 Code Interpreter)에서 실행할 수 있으며, 둘 다 세션마다 microVM 하나를 씁니다. 1부와 2부의 Agent Sandbox에 대응하는 것은 Runtime이고, Code Interpreter는 Runtime의 에이전트뿐 아니라 다른 애플리케이션에서도 API로 직접 호출할 수 있는 코드 실행 도구입니다. 이 글은 Runtime을 중심으로 측정 결과를 정리하고, Code Interpreter는 Runtime과 다른 점만 7장과 8장의 표에서 다룹니다. Browser, Gateway, Memory, Identity 같은 나머지 구성 요소는 이 글에서 다루지 않습니다.
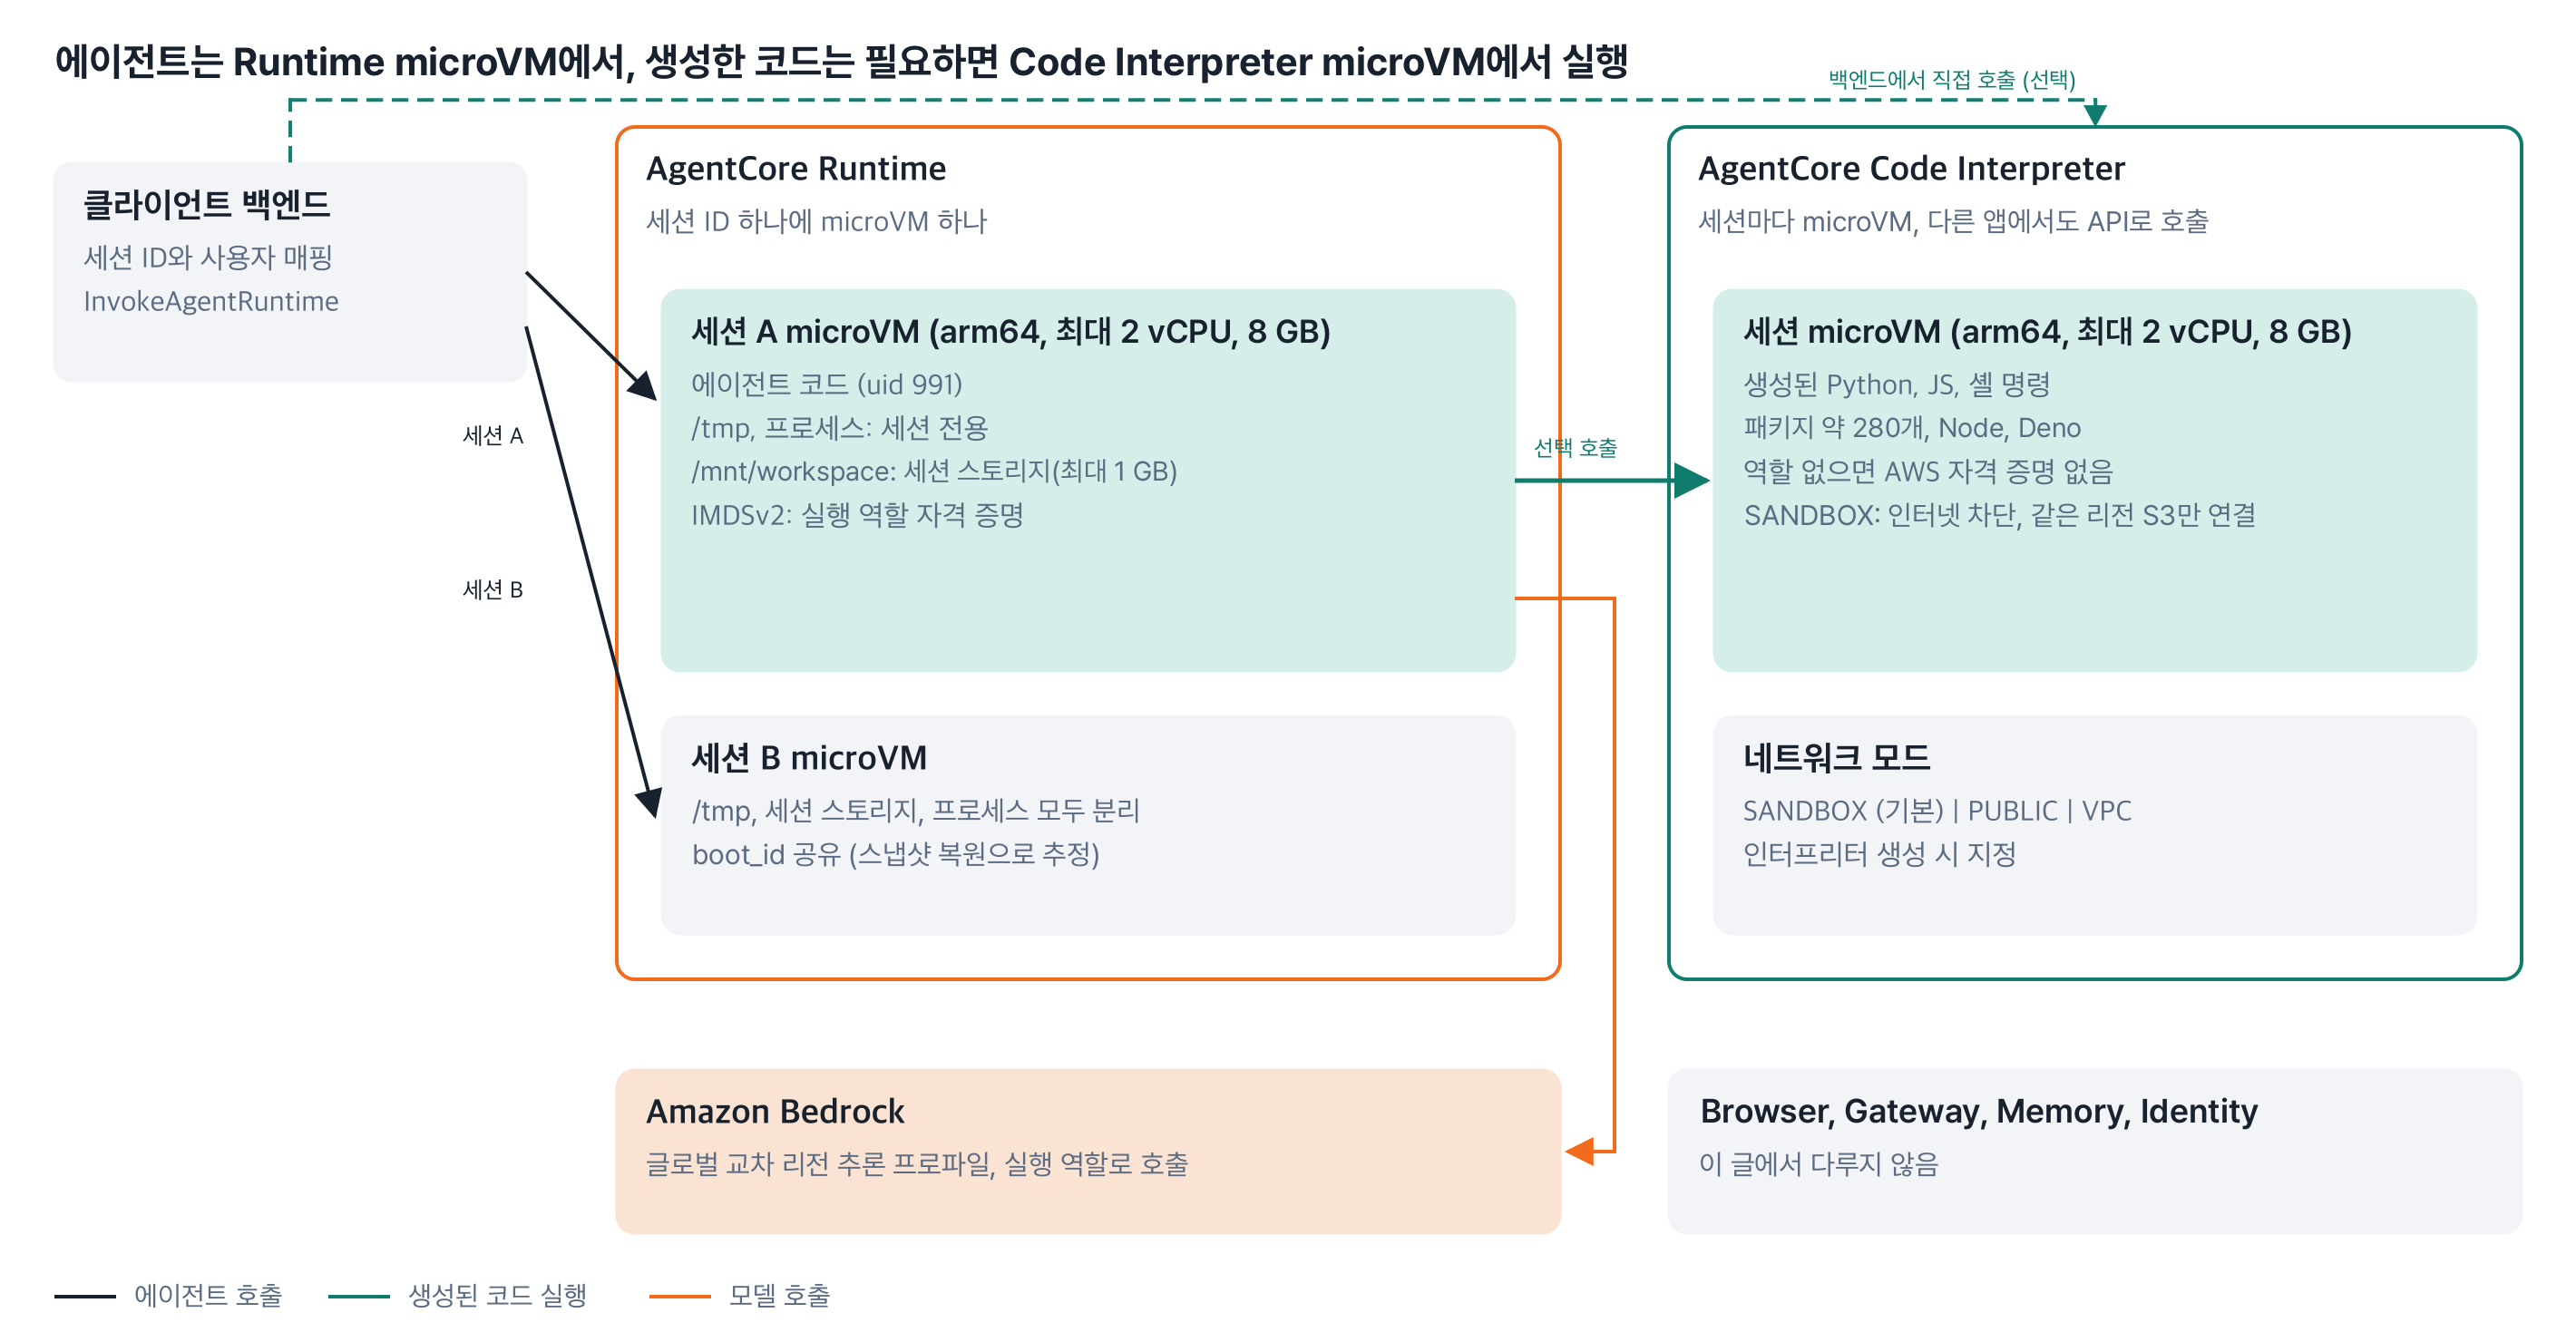
그림 1. 에이전트를 실행하는 Runtime 세션 microVM과 필요할 때 호출하는 Code Interpreter 세션 microVM
1.2 관리형으로 넘어가는 일과 측정으로 확인한 것
1부와 2부에서 플랫폼 팀이 직접 구성하고 운영한 일 가운데 상당 부분을 AgentCore는 관리형 서비스 기능으로 제공합니다. Runtime 개요와 세션 문서가 설명하는 기능을 본 블로그에서 직접 측정한 결과와 나란히 놓으면 다음과 같습니다.
| 항목 | EKS에서 직접 한 일 (1, 2부) | AgentCore 문서의 설명 | 직접 측정한 결과 |
|---|---|---|---|
| 세션 격리 | gVisor 노드 그룹, RuntimeClass, Pod 보안 설정 | 세션마다 전용 microVM, 세션이 끝나면 microVM 종료와 메모리 정리 | 세션 전용 게스트 커널, 세션 사이 /tmp, 세션 스토리지, 프로세스 비공개 (2.1절, 4.1절) |
| 준비 용량 | Warm Pool 크기, 노드 용량, Prefix Delegation | 세션이 즉시 시작되고 수요에 따라 확장 | Runtime 새 세션 1.4초, 준비 없이 세션 200개 동시 생성 2.6초 안에 완료 (2.2절, 5.5절) |
| 쓰지 않는 샌드박스 정리 | shutdownTime, 별도 정리 작업 | 유휴 15분(기본값) 또는 최대 수명 8시간에 자동 종료 | 방치된 세션 1,154개 모두 유휴 타임아웃에 맞춰 과금 종료 (5.3절) |
| 대기 중 비용 | 노드 가동 시간만큼 과금 | 실제 사용량 과금, I/O 대기 중 CPU 비과금 | 240초 대기 세션의 과금 CPU 2.9초 (5.2절) |
| 작업 상태 유지 | volumeClaimTemplates로 Amazon EBS PVC 연결 | 세션 스토리지(Preview, 세션당 최대 1 GB)가 microVM 종료 뒤에도 유지되게 설정 가능 | VM 교체 뒤에도 같은 세션 ID의 /mnt/workspace 유지 (4.1절) |
| 자격 증명 | IMDSv2 필수, 홉 제한 1, 샌드박스에는 자격 증명을 주지 않음 | 실행 역할로 임시 자격 증명 전달 | VM 안의 IMDSv2로만 전달, 토큰 없는 IMDSv1 요청은 401 (3.2절) |
| 세션별 비용 | 노드 단위 비용에서 직접 계산할 수 있도록 설정 | 세션별 사용량 로그와 Amazon CloudWatch 사용량 지표 | 지표 합계가 AWS Cost Explorer 청구 수량과 소수점 넷째 자리까지 일치 (5.1절) |
표 1. EKS에서 직접 구성한 일과 AgentCore가 제공하는 기능 (문서는 2026년 10월 기준)
문서가 설명하는 기능은 대부분 측정에서도 그대로 확인됐습니다. 특히 준비 용량, 정리, 대기 중 비용은 EKS에서 Warm Pool 크기와 노드 수를 정하며 플랫폼 팀이 계속 조율해야 했던 항목인데, AgentCore에서는 설정 값 몇 개로 바뀝니다. 대신 서비스가 세션을 관리하는 만큼 애플리케이션이 따라야 할 규칙이 있고, 4.1절의 /ping 유휴 판정처럼 문서의 설명과 다르게 동작한 부분도 있어 SDK가 제공하는 대응 방법과 함께 정리했습니다. 이 글의 나머지는 표 1의 각 항목을 측정으로 풀어 보고, 그 규칙을 정리합니다.
측정은 서울 리전(ap-northeast-2)에서 했고, 서울 리전에 아직 출시되지 않은 Runtime 플랫폼 버전 V2(이하 V2)가 필요한 측정과 V1, V2를 나란히 비교한 측정(표 6, 9, 10)은 도쿄 리전(ap-northeast-1)에서 했습니다. Runtime은 직접 코드 배포(Python 3.13, zip)로 올렸습니다. 본문의 수치는 2026년 10월 기준 이 환경에서 잰 참고치이며, 서비스 업데이트, 리전, 앱 구성에 따라 달라질 수 있습니다.
2장부터 4.1절의 측정은 같은 스크립트로 한 번 더 실행해 결과를 확인했습니다. 7.2절의 강화학습 예시는 같은 달 미국 서부(오리건) 리전에서 실행한 결과이고, 비용은 측정 시점의 소비 기반(consumption) 단가로 환산했습니다. 실험에 사용한 리소스는 측정 후 모두 삭제했습니다.
2. 세션마다 전용 게스트 커널을 가진 microVM이 할당됩니다
2.1 microVM 내부
세션 안에서 1부와 같은 항목을 확인했습니다.
| 확인 항목 | Runtime | EKS gVisor (1부) |
|---|---|---|
| uname -r | 6.1.161-18.298.amzn2023.aarch64 (세션 전용 게스트 커널) | 4.19.0-gvisor |
| 보이는 CPU, 메모리 | 2 vCPU, 약 7.75 GiB (VM 전체) | CPU 2개(quota 기준, 최솟값 2), 1 GiB(limit 반영) |
| /proc/modules | 파일 없음 | 0바이트 |
| 사용자, 권한 | uid 991, setuid(0) 차단, capability 없음 | uid 1000, capability 전체 제거 |
| seccomp | 0 (필터 없음) | 0 (Sentry 바깥에서 적용) |
| /proc/cmdline | pci=off overlay_root=vdb init=/sbin/overlay-init.sh 등 경량 VM의 부팅 인자 | 해당 없음 |
표 2. 세션 내부와 1부 gVisor 샌드박스 비교
gVisor에서는 사용자 공간 커널이 시스템 콜을 대신 처리했지만, 여기서는 세션 전용 게스트 커널이 처리하고 그 바깥은 하드웨어 가상화 경계가 막습니다. 격리를 VM 경계에 맡기는 설계이므로, 게스트 안에 seccomp 필터가 없는 것도 이 설계에서 나온 것으로 보입니다. 관찰한 결과로는 주된 격리 계층은 VM 경계였고, 게스트 안의 권한 제한은 보조 수단이었습니다.
서울에서 연 Runtime 세션의 커널 boot_id는 2026년 10월 기준으로 모두 같은 값이었고(재측정에서도 동일), 도쿄의 Runtime 세션 240개에서도 플랫폼 버전마다 두 가지 값뿐이었습니다. 서울과 도쿄의 V1 세션에서 같은 값이 나오기도 했습니다. 서울 V1 세션의 첫 호출 시점 uptime은 13.0~13.8초였습니다. 반면 V1에서 앱이 기동하며 생성한 난수 ID는 세션마다 달랐습니다(4.2절). 커널은 미리 부팅한 VM의 스냅샷에서 복원하고, 앱은 세션마다 새로 시작하는 방식으로 보입니다.
공식 문서의 설명이 아니라 관찰에서 나온 추론이지만, 실무에서 주의할 점은 분명합니다. boot_id, hostname(localhost), 게스트 내부 IP는 여러 세션이 같은 값을 공유하므로 세션을 구분하는 값으로 써서는 안 되고, 세션 구분에는 서비스가 전달하는 세션 ID를 써야 합니다.
2.2 시작 지연과 시스템 콜 비용
3부에서 에이블리는 microVM 런타임을 검토하며 기동 시간과 메모리 비용도 함께 검증하겠다고 밝혔습니다. 이 절에서는 AgentCore에서 기동 시간과 시스템 콜 비용을 재어 2부의 EKS 측정값과 나란히 놓았고, 메모리 비용은 5장에서 다룹니다.
| 실행 환경 | 측정 항목 | 중앙값 (p90) | 출처 |
|---|---|---|---|
| EKS gVisor, Warm Pool | SandboxClaim부터 Ready까지 | 57 ms (76 ms) | 2부 |
| EKS gVisor, Cold Start | SandboxClaim부터 Ready까지 | 2,047 ms (2,554 ms) | 2부 |
| Runtime V1 | 새 세션 첫 호출 | 1.41초 (1.91초) | 직접 측정(재측정 1.40초) |
| Runtime V1 | 같은 세션 재호출 | 70 ms (76 ms) | 직접 측정(재측정 70 ms) |
| Runtime V1 (도쿄) | 새 세션 첫 호출 | 1.39초 (1.45초) | 직접 측정(도쿄, 클라이언트는 서울) |
| Runtime V2 (도쿄) | 새 세션 첫 호출 | 1.87초 (2.10초) | 직접 측정(도쿄, 클라이언트는 서울) |
표 3. 시작 지연 (AgentCore는 서울 측정, 도쿄 행은 V2 비교를 위한 도쿄 측정, 오류 0건, 2부 값은 VPC CNI NetworkPolicy 활성화 전 측정)
Runtime의 새 세션은 1.4초에 준비됐습니다. 2부에서 잰 EKS의 Cold Start(약 2초)보다 빠르고 Warm Pool(57 ms)보다는 느립니다. 스냅샷 복원으로 보이지만 세션마다 microVM을 새로 할당하는 시간은 피할 수 없습니다. 대화형 에이전트라면 모델 호출이 수 초씩 걸리므로 세션을 처음 열 때의 1.4초는 크게 체감되지 않고, 같은 세션의 재호출은 70 ms입니다. 이 값은 Warm Pool 크기를 정하거나 노드를 미리 띄워 두지 않은 상태에서 나온 것입니다.
V2는 서울에 없어 도쿄에서 V1과 함께 쟀는데, 초기화가 없는 앱에서는 V2가 V1보다 약 0.5초 느렸습니다. V2가 유리해지는 조건은 4.2절에서 다룹니다. 반대로 샌드박스 결과를 GPU가 기다리는 작업에서는 세션 시작 지연이 비용이 되며, 7.2절에서 예를 듭니다.
| 벤치마크 (5회 중앙값, 초) | EKS runc | EKS gVisor | Runtime V1 |
|---|---|---|---|
| 순수 연산(300만 회 루프) | 0.144 | 0.146 | 0.274 |
| getppid 20만 회 | 0.035 | 0.444 | 0.0407 |
| /bin/true 50회 실행 | 0.030 | 0.192 | 0.037 |
표 4. 실행 환경별 소요 시간 (EKS는 2부의 x86 m7i.xlarge와 CPU limit 1, AgentCore는 arm64 2 vCPU)
시스템 콜 비용은 gVisor만 크게 달랐습니다. 2부의 격리 비용 측정에서 gVisor는 시스템 콜 한 번이 runc의 약 12.5배였고, 이번 측정에서 microVM은 runc와 비슷했습니다. 장비 차이를 배제하려고 같은 스크립트를 arm64 Linux VM 한 대에서 runc와 gVisor로 다시 실행했더니 getppid 13.2배, /bin/true 3.1배(2부는 6.5배), 순수 연산 1.0배로, 시스템 콜이 많을수록 gVisor 비용이 커지는 경향은 같았습니다. 데이터 분석처럼 연산 위주의 코드는 런타임과 상관없이 비슷하지만, 패키지 설치, 빌드, 테스트를 반복하는 코딩 에이전트라면 gVisor의 이 비용을 감안해야 합니다. 순수 연산 행은 격리 방식보다 하드웨어와 Python 버전(AgentCore는 3.13, EKS 샌드박스는 3.12)의 영향이 커서 참고용입니다.
3. 네트워크와 자격 증명
3.1 네트워크는 PUBLIC과 VPC 모드 중에서 고릅니다
2부에서는 VPC CNI에서 NetworkPolicy를 활성화해야 정책이 동작했습니다. 템플릿 기본 정책은 인터넷 Egress를 열어 두었으므로, 목적지를 제한하려면 사용자 정의 networkPolicy나 Egress 프록시, AWS Network Firewall을 따로 구성해야 했습니다.
Runtime은 생성할 때 네트워크 모드를 PUBLIC과 VPC 중에서 고릅니다. PUBLIC 모드에서는 측정에서도 외부 DNS와 HTTPS(example.com, pypi.org)가 모두 연결되어, 인터넷 Egress가 열린 2부의 템플릿 기본 정책과 비슷한 상태였습니다. 다만 2부의 기본 정책이 막았던 169.254.0.0/16과 달리, VM 안의 메타데이터 엔드포인트에서 실행 역할 자격 증명을 받을 수 있습니다(3.2절). 모델이 생성한 코드를 실행하거나 민감한 데이터를 다룬다면 VPC 모드로 만들고, 연결 범위를 사용자의 서브넷 라우팅, 보안 그룹, VPC 엔드포인트로 제한하는 것이 2부의 EKS와 같은 설계입니다.
VPC 모드라면 Amazon S3 게이트웨이 엔드포인트 정책에 aws:ResourceAccount나 aws:ResourceOrgID 조건을 넣어, 접근할 수 있는 버킷을 조직 안으로 제한하는 것이 좋습니다. 이때 AgentCore가 쓰는 서비스 버킷(코드 아티팩트, 컨테이너 이미지 레이어, 세션 스토리지)은 문서에 나온 대로 별도로 허용해야 런타임이 동작합니다. 자기 계정 버킷의 정책으로는 샌드박스 코드가 다른 계정의 버킷에 데이터를 쓰는 것까지 막을 수 없기 때문이며, AWS의 데이터 경계(data perimeter) 지침과 같은 방식입니다. NAT 게이트웨이로 인터넷 경로를 열면 이 제한을 우회할 수 있다는 점도 함께 고려해야 합니다.
3.2 자격 증명은 VM 안의 IMDSv2로만 들어옵니다
Runtime은 실행 역할이 필수이고, 그 임시 자격 증명은 환경 변수가 아니라 VM 안의 메타데이터 엔드포인트로 제공됐습니다. 2026년 10월 측정에서 토큰 없는 IMDSv1 방식의 요청은 401로 막혀 IMDSv2만 쓸 수 있었습니다. Unit 42 보고에 따르면 AWS는 2026년 2월 14일부터 이 서비스를 처음 쓰는 계정에서 Runtime과 도구를 모두 IMDSv2 전용으로 시작하게 했습니다. 기존 계정에서는 새로 배포하는 에이전트만 IMDSv2 전용이 되고, 기존 에이전트에는 IMDSv1을 끄는 API가 제공됐습니다. 기존 계정의 Code Interpreter와 Browser는 IMDSv1과 IMDSv2가 모두 기본으로 열려 있었으므로, 2026년 2월 14일 이전에 만든 런타임과 도구는 설정을 확인해 IMDSv2 전용으로 바꿔 두는 것이 좋습니다.
1부에서 구성하고 2부의 인스턴스 메타데이터 보호에서 확인한 홉 제한 1이 노드 자격 증명을 샌드박스에서 떼어 놓았던 것과 달리, 여기서는 실행 역할의 자격 증명이 샌드박스 코드에 그대로 전달됩니다. 에이전트가 모델이 생성한 코드를 같은 Runtime 세션에서 바로 실행하면 그 코드도 에이전트와 같은 권한을 갖게 됩니다. 그래서 2부의 Amazon Bedrock 연동 구성에서 에이전트와 샌드박스의 역할 분리가 자격 증명 계층에서 성립했던 것처럼, 생성된 코드는 실행 역할 없이 만들 수 있는 Code Interpreter나, 권한을 아주 좁힌 실행 역할을 준 별도 런타임에서 실행하는 분리를 권고합니다.
4. 세션 수명 주기: 애플리케이션이 지켜야 할 규칙
2부의 EKS에서는 플랫폼 팀이 shutdownTime과 operatingMode로 Sandbox의 만료와 일시 중지를 정했고, 일시 중지 뒤에도 작업 디렉터리를 이어 쓰려면 volumeClaimTemplates로 EBS PVC를 붙여야 했습니다. 3부의 에이블리는 작업 디렉터리를 볼륨으로 이어 쓰는 대신 작업 코드를 Git bundle로 묶어 Amazon S3에 보관했고, 유휴 판단은 애플리케이션이 맡았습니다. AgentCore는 서비스가 정한 규칙에 따라 microVM을 회수하거나 교체하므로, 그 규칙을 애플리케이션이 알고 있어야 합니다.
4.1 Runtime의 유휴 판정은 진행 중인 요청이 아니라 /ping으로 합니다
Runtime 앱은 8080 포트의 /ping에 Healthy 또는 HealthyBusy로 응답하고, 플랫폼은 이 응답을 주기적으로 확인합니다. 실험 앱은 요청을 처리하는 중에도 /ping에 응답하도록 멀티스레드 서버(ThreadingHTTPServer)로 만들었습니다.
# 발췌: /ping 핸들러만 표시
BUSY = 0  # 오래 걸리는 작업을 시작할 때 1로 바꿉니다

class H(BaseHTTPRequestHandler):
    def do_GET(self):   # /ping: 유휴 판정의 근거
        self._send(200, {"status": "HealthyBusy" if BUSY else "Healthy"})
유휴 타임아웃을 60초로 두고, 클라이언트 재시도를 끈 상태에서 100초 걸리는 동기 요청을 보냈습니다.
| /ping 응답 | 100초 요청의 결과 (유휴 타임아웃 60초) |
|---|---|
| 계속 Healthy (첫 측정) | 처리 중에 VM 회수, 약 97초 뒤 새 VM에서 같은 요청이 처음부터 다시 시작됨, 226.8초 뒤 Runtime initialization time exceeded 오류 |
| 계속 Healthy (재측정, 3회) | 요청 시작 약 60초 뒤 VM 회수, 재실행 없음, 약 130초 뒤 같은 메시지의 오류(HTTP 424) |
| 처리 중 HealthyBusy (두 측정 모두) | 약 100초에 정상 완료, 같은 VM 유지 |
표 5. 긴 요청과 유휴 타임아웃 (서울, Runtime V1, 클라이언트 재시도 끔)
문서는 동기 요청을 처리하는 동안은 세션이 자동으로 활성 상태로 집계되고, HealthyBusy는 백그라운드 작업을 알리는 용도라고 설명합니다. 그러나 측정에서는 두 측정 모두 처리 중인 동기 요청이 있어도 /ping이 Healthy면 유휴 타임아웃에 맞춰 VM이 회수됐습니다. 회수 뒤의 동작은 측정마다 달랐습니다. 첫 측정에서는 세션 스토리지에 남긴 로그로 같은 요청이 새 VM에서 다시 시작된 것을 확인했지만, 3회의 재측정에서는 재실행 없이 요청과 무관해 보이는 초기화 시간 초과 오류로 끝났습니다.
어느 쪽이든 해결 방법은 같습니다. AgentCore SDK의 add_async_task와 complete_async_task로 작업을 등록하면 SDK가 /ping 상태를 자동으로 관리하므로, 유휴 타임아웃보다 오래 걸릴 수 있는 작업은 이 방식으로 실행해 처리 중에 HealthyBusy가 응답되도록 합니다. 3부에서 에이블리가 유휴 여부를 마지막 대화 시각만으로 판단하지 않고 실행 중인 작업과 화면 활동 신호를 함께 본 것과 같은 원칙입니다. 결제, 메일 발송, 외부 시스템 쓰기처럼 두 번 실행되면 안 되는 작업은 플랫폼이나 클라이언트의 재실행에 대비해 요청 ID로 중복 실행을 걸러 내도록 만들어야 합니다.
나머지 종료 경로도 확인했습니다. 노드를 직접 다루지 않으므로 3부에서 다룬 노드 통합 같은 중단은 신경 쓸 필요가 없지만, 최대 수명에 이르면 VM은 교체됩니다. 최대 수명을 120초로 두면 10초마다 호출해도 약 127초에 클라이언트 오류 없이 새 VM으로 교체됐고, 세션 스토리지(/mnt/workspace)는 같은 세션 ID 기준으로 남았습니다. 2부에서 EBS PVC로 얻은 효과를 볼륨 구성 없이 런타임 설정으로 얻는 셈이지만, 세션 스토리지는 Preview이고 세션당 1 GB이며 14일 미사용이나 런타임 버전 업데이트 때 초기화됩니다. 새 VM으로 바뀌므로(boot_id가 다른 값으로 바뀜) /tmp와 프로세스는 이어지지 않습니다.
메모리 7.75 GiB에서 OOM이 나면 앱 서버 프로세스까지 종료되고 자동으로 다시 시작되지 않아, 유휴 회수 전까지 약 80초 동안 502가 이어졌습니다. 이런 세션은 StopRuntimeSession으로 바로 정리하는 편이 낫습니다.
세션 사이에서는 /tmp, 세션 스토리지, 프로세스가 서로 보이지 않았습니다. 세션 ID와 사용자의 매핑은 문서대로 애플리케이션의 몫이고, 같은 세션에 2초짜리 요청 5개를 동시에 보내면 2.15초에 모두 끝나 한 세션 안의 요청은 직렬화되지 않았습니다. 세션 안의 동시성 처리도 애플리케이션이 맡아야 합니다.
4.2 V2는 앱 초기화를 한 번만 하고 스냅샷으로 복원합니다
Runtime V2는 앱의 /ping이 처음 정상으로 응답한 시점의 상태를 런타임 버전마다 스냅샷으로 떠 두고, 새 세션마다 그 스냅샷에서 복원합니다(문서). 앱이 시작 후 120초 안에 정상으로 응답하지 않으면 런타임 생성이 실패합니다(플랫폼 버전). 효과를 확인하려고 초기화가 없는 앱과, 서버를 띄우기 전에 CPU를 10초 쓰고 메모리 1 GiB를 채우는 앱을 도쿄에 V1과 V2로 각각 올렸습니다.
| 앱 | 플랫폼 | 새 세션 순차 10회 중앙값 (p90) | 새 세션 50개 동시 중앙값 (최대) | 세션 시작 30초간 과금 CPU |
|---|---|---|---|---|
| 초기화 없음 | V1 | 1.39초 (1.45초) | 1.61초 (2.11초) | 1.3 vCPU-초 |
| 초기화 없음 | V2 | 1.87초 (2.10초) | 1.85초 (2.71초) | 2.6 vCPU-초 |
| 초기화 10초, 1 GiB | V1 | 11.63초 (12.09초) | 11.60초 (12.14초) | 11.6 vCPU-초 |
| 초기화 10초, 1 GiB | V2 | 2.56초 (2.74초) | 2.53초 (3.27초) | 4.8 vCPU-초 |
표 6. 앱 초기화 비용과 새 세션 지연 (도쿄, 클라이언트는 서울, 오류 0건)
V1에서는 초기화 10초가 새 세션마다 지연과 과금에 그대로 더해졌고, V2에서는 2.6초였습니다. 초기화가 없는 앱에서는 V2가 오히려 약 0.5초 느렸으므로, V2의 이점은 Cold Start 자체가 아니라 무거운 초기화를 세션 경로에서 빼내는 데 있습니다. 대신 런타임을 만들 때 READY까지 V1은 수 초에서 약 10초(도쿄 2~3초, 서울 약 10초), V2는 약 3~4분이 걸렸고, 세션 시작 때의 과금 메모리도 V2가 컸습니다(무거운 앱 기준 V1 2.0 GB, V2 4.1 GB).
지켜야 할 규칙도 생깁니다. 앱이 시작할 때 만든 무작위 ID는 V1에서는 세션마다 달랐지만, V2에서는 순차로 연 10개 세션이 모두 같았고 동시에 연 50개 세션에서도 두 가지 값뿐이었습니다. 동시에 연 세션에서 값이 두 가지였던 것은 여러 스냅샷 사본에서 복원된 것으로 보이므로, 이런 값으로 세션을 구분하거나 충돌을 감지해서도 안 됩니다.
난수, 토큰, 자격 증명을 요청 처리 중에 만들어야 한다는 원칙과 암호화 라이브러리의 난수 상태가 복원 뒤 다시 초기화되지 않는다는 제약은 문서에 정리되어 있습니다. 3부에서 프로젝트별 설정을 환경 변수로 넘기는 구조로는 Warm Pool의 이점을 얻기 어려웠던 것과 같은 이유입니다. 미리 준비한 상태를 공유하려면 세션마다 다른 값은 준비가 끝난 뒤, 요청을 처리할 때 넣어야 합니다.
5. 회수, 과금, 확장은 서비스가 맡습니다
5.1 세션별 사용량 로그는 청구와 같은 기준입니다
EKS에서는 쓰지 않는 샌드박스의 정리, 대기 중의 비용, 몰림에 대비한 용량을 Warm Pool 크기, shutdownTime과 일시 중지, 노드 그룹 용량으로 플랫폼 팀이 정했습니다. AgentCore에서 이를 확인하려면 세션 단위의 기록이 필요합니다. AgentCore는 세션별 사용량을 1초 단위로 남기는 사용량 로그(USAGE_LOGS)를 제공하며, 레코드마다 세션 ID와 그 1초 동안 쓴 vCPU-시간, GB-시간이 들어 있습니다. 로그 전달을 설정하는 주체에 logs:PutResourcePolicy 등의 권한이 없거나 로그 그룹 리소스 정책이 크기 한도에 걸리면 delivery.logs.amazonaws.com의 쓰기를 허용하는 정책이 자동으로 만들어지지 않아 레코드가 쌓이지 않으므로, 이때는 정책을 직접 추가해야 합니다(CloudWatch Logs 문서).
문서는 이 값이 텔레메트리이고 최대 60분 늦을 수 있으며 실제 청구와 다를 수 있다고 밝힙니다. 그래서 하루(UTC) 동안의 사용량을 세 가지 경로로 대조했습니다.
| 리전 (하루, UTC) | 사용량 로그 합계 | CloudWatch 지표 합계 | Cost Explorer 청구 수량 |
|---|---|---|---|
| 도쿄, Runtime V2 메모리 | 2.076 GB-시간 | 2.122 GB-시간 | 2.122 GB-시간 ($0.0359) |
| 도쿄, Runtime V2 CPU | 0.2301 vCPU-시간 | 0.2352 vCPU-시간 | 0.2352 vCPU-시간 ($0.0300) |
| 서울, Runtime V1 메모리 | 4.257 GB-시간 | 5.154 GB-시간 | 5.154 GB-시간 ($0.0487) |
| 서울, Runtime V1 CPU | 0.2811 vCPU-시간 | 0.2885 vCPU-시간 | 0.2885 vCPU-시간 ($0.0258) |
표 7. 사용량 로그, CloudWatch 지표, 청구 수량 비교 (Cost Explorer 값은 월 마감 전 추정치)
CloudWatch 사용량 지표(CPUUsed-vCPUHours, MemoryUsed-GBHours)의 리전 합계는 Cost Explorer의 청구 수량과 소수점 넷째 자리까지 같았고, 청구 단가도 가격 페이지 값과 맞았습니다. 서울의 차이(0.90 GB-시간) 대부분인 0.89 GB-시간은 같은 날 계정에서 돌던 다른 런타임 몫으로, 런타임별 지표에서 확인했습니다. 도쿄에서 사용량 로그 쪽이 약 2% 적었던 것은 레코드가 다 도착하기 전에 내려받은 탓으로 보입니다. 이후 실험에서는 레코드가 모두 도착할 때까지 반복해 내려받았고(실험 시작 후 약 45분), 런타임 5개 모두 사용량 로그 합계와 CloudWatch 지표가 소수점 다섯째 자리까지 같았습니다.
런타임 단위 비용은 CloudWatch 지표로, 세션 단위 비용은 사용량 로그로 청구와 같은 기준에서 계산할 수 있습니다. 5.2절부터 5.4절의 과금 수치는 모두 이 사용량 로그를 세션 ID별로 더한 값입니다.
5.2 기다리는 동안 CPU는 거의 과금되지 않습니다
메모리 1 GiB를 잡은 세션을 240초 동안 잠들게 한 경우와, 같은 시간 CPU 코어 하나를 돌린 경우를 세션 3개씩 비교했습니다.
| 시나리오 (세션당, 3개 평균) | V1 과금 CPU | V1 과금 메모리 | V1 환산 비용 | V2 과금 CPU | V2 과금 메모리 | V2 환산 비용 |
|---|---|---|---|---|---|---|
| 240초 대기(sleep) | 2.9 vCPU-초 | 0.126 GB-시간 | $0.0013 | 9.4 vCPU-초 | 0.167 GB-시간 | $0.0031 |
| 240초 CPU 사용(코어 1개) | 242.6 vCPU-초 | 0.125 GB-시간 | $0.0072 | 249.4 vCPU-초 | 0.156 GB-시간 | $0.0115 |
표 8. 대기와 CPU 사용의 과금 비교 (V1 서울, V2 도쿄)
240초 동안 잠든 세션에 과금된 CPU는 2.9초였고, CPU를 돌린 세션은 실제로 쓴 242.6초가 그대로 과금됐습니다. “I/O 대기 중에는 CPU가 0으로 내려간다”는 가격 페이지의 설명이 세션 단위 기록에서 확인됐습니다. 반면 메모리는 두 경우가 같아서, V1 단가로 환산하면 대기 세션 비용의 94%가 메모리였습니다.
모델 응답을 기다리는 시간이 긴 에이전트일수록 비용은 CPU가 아니라 세션이 잡은 메모리와 세션이 살아 있는 시간으로 정해집니다. EKS에서 대기 Pod가 요청한 자원을 노드에서 계속 차지해 비용이 노드의 가동 시간으로 정해지는 것과 대비됩니다. 3부에서 재개 구간의 부하까지 보고 requests를 정해야 했던 것과 달리, AgentCore에는 미리 정할 requests가 없고 실제로 쓴 CPU와 메모리로 과금됩니다.
5.3 버려진 세션은 유휴 타임아웃에 맞춰 사라집니다
사용자가 창을 닫고 떠난 상황처럼, 세션을 열고 호출 한 번만 한 뒤 아무 정리 없이 버렸습니다.
| 버려진 세션 (도쿄, 기본 유휴 900초) | 마지막 호출부터 과금이 멈출 때까지 | 방치 구간 평균 과금 메모리 | 세션당 비용 |
|---|---|---|---|
| V1, 호출 한 번 | 904~915초 | 0.76 GB | $0.0020 |
| V1, 초기화 때 1 GiB 로딩 | 904~912초 | 1.67 GB | $0.0044 |
| V2, 호출 한 번 | 915~923초 | 0.99 GB | $0.0046 |
| V2, 초기화 때 1 GiB 로딩 | 916~925초 | 2.81 GB | $0.0131 |
표 9. 기본 수명 주기에서 버려진 세션 하나의 비용 (도쿄)
모든 세션이 유휴 타임아웃 900초에 맞춰 과금을 멈췄습니다. 규모를 키워도 같았습니다. 서울에서 유휴 타임아웃을 60초로 둔 런타임에 버린 세션 1,154개(두 차례 실험 합계)가 모두 마지막 호출 뒤 61~76초 사이에 과금을 멈췄고 남은 세션은 없었습니다. 이때 세션당 과금은 약 0.013 GB-시간으로 기본값(0.192 GB-시간)의 약 15분의 1이었습니다.
하루에 10만 세션이 버려진다면 V1 단가로 기본값에서 약 $200, 60초에서 약 $16입니다. EKS라면 이런 샌드박스의 정리를 shutdownTime이나 별도의 정리 작업으로 직접 보장해야 합니다.
5.4 V1은 메모리를 해제해도 과금이 줄지 않습니다
세션마다 2 GiB를 할당해 붙잡은 그룹과, 할당했다가 바로 해제한 그룹을 3개씩 버렸습니다. 해제한 세션은 프로세스 RSS가 2,065 MiB에서 17 MiB로 돌아온 것을 확인했습니다.
| 시나리오 (도쿄, 유휴 900초) | 마지막 호출 직후 10초 | 5분 뒤 | 세션당 비용 |
|---|---|---|---|
| V1, 2 GiB 보유 | 3.02 GB | 2.81 GB | $0.0069 |
| V1, 2 GiB 해제 | 3.02 GB | 2.82 GB | $0.0068 |
| V2, 2 GiB 보유 | 3.37 GB | 2.85 GB | $0.0134 |
| V2, 2 GiB 해제 | 2.30 GB | 1.08 GB | $0.0052 |
표 10. 메모리를 붙잡은 세션과 해제한 세션의 과금 메모리 (도쿄, 세션 3개 평균)
V1에서는 프로세스가 메모리를 해제해도 과금 메모리가 붙잡은 세션과 같았습니다. 한 번 커진 세션의 메모리는 세션이 끝날 때까지 거의 줄지 않는다고 보고 설계해야 합니다. V2에서는 해제 직후 10~20초 안에 과금 메모리가 약 0.9 GB 줄어(세션 3개 평균), 가격 페이지가 말하는 120초보다 빨랐습니다. 그래서 큰 메모리를 잠깐 쓰고 내려놓는 세션에서는 단가가 높은 V2가 V1보다 쌌고($0.0052 대 $0.0068), 계속 붙잡는 세션에서는 약 2배 비쌌습니다.
정리하면 유휴 타임아웃은 수명 설정이면서 비용 설정입니다. 기본값 900초는 대화가 다시 이어질 가능성을 넉넉히 보는 값이므로 사용 패턴에 맞춰 줄이고, 끝난 것이 확실한 세션은 StopRuntimeSession으로 바로 닫을 것을 권고합니다. StopRuntimeSession으로 종료한 세션은 V1에서 7~8초, V2에서 17~18초 뒤 과금이 끝났습니다.
5.5 세션이 몰려도 자동으로 용량이 확장됩니다
서울의 V1 런타임에 새 세션을 미리 준비 없이 한꺼번에 열었습니다. 새 세션 생성 한도는 문서 기본값과 같은 초당 25개입니다.
| 동시 새 세션 | SDK 재시도 | 성공 | 오류 | 중앙값 | 최대 | 전체 완료 |
|---|---|---|---|---|---|---|
| 100 | 끔 | 100 | 0 | 1.34초 | 3.79초 | 3.85초 |
| 200 | 끔 | 200 | 0 | 1.96초 | 2.51초 | 2.57초 |
| 400 | 끔 | 379 | 21 (ThrottlingException) | 1.41초 | 15.4초 | 180.3초 |
| 400 | 표준 재시도 모드(최대 8회 시도) | 400 | 0 | 2.21초 | 29.9초 | 30.1초 |
표 11. 동시 새 세션 호출 (서울, Runtime V1, 중앙값과 최대는 성공한 호출 기준)
200개를 한꺼번에 열어도 오류 없이 2.6초 안에 모두 응답했습니다. 초당 25개라는 한도는 초 단위로 엄격하게 적용되지 않았고 짧은 몰림은 허용됐습니다. 400개에서는 21개가 스로틀로 실패했는데, 2개는 약 180초를 기다린 뒤에야 실패가 돌아왔고 이 2개에는 약 1분 분량의 사용량 기록이 남아 있었습니다. 실패가 곧 세션이 만들어지지 않았다는 뜻은 아니므로, 재시도할 때도 같은 세션 ID를 써야 합니다. SDK 표준 재시도로 보내면 400개 모두 성공했지만 일부는 20~30초가 걸렸습니다.
2부의 EKS 측정에서는 Pod IP 재사용 대기가 겹치자 Warm Pool을 넘는 요청 일부가 약 15초 걸렸고, 이를 줄이려면 Prefix Delegation, WARM_IP_TARGET, Warm Pool 크기를 피크에 맞춰 미리 조정해야 했습니다. AgentCore는 미리 준비한 용량 없이도 수요에 따라 세션을 자동으로 늘리므로, 피크에 대비해 확인할 것은 노드나 IP가 아니라 클라이언트의 재시도 설정과 계정 할당량입니다. 자동 확장의 상한이 이 할당량이어서, 400개 시험처럼 기본값을 넘는 몰림에서는 스로틀이 났습니다. 피크가 수백 개 단위로 몰린다면 새 세션 생성 속도(기본 초당 25개)와 동시 활성 세션 수(서울 기본 2,500개) 한도 조정을 미리 요청하고, 사용자 응답 경로에서는 재시도 횟수와 전체 대기 시간의 상한을 정해 두어야 합니다.
6. microVM 한도를 넘는 작업은 Instances 컴퓨팅 유형으로 넘깁니다
microVM 세션은 최대 2 vCPU, 8 GB 메모리(조정 불가, VM 안에서는 약 7.75 GiB로 보임)와 최대 8시간으로 제한되고, KVM도 없습니다. 대형 저장소의 빌드, 며칠씩 이어지는 작업, GPU가 필요한 작업에는 부족합니다. 2026년 8월 정식 출시된 AgentCore Runtime의 Instances 컴퓨팅 유형은 이 한도를 관리형으로 넘는 선택지입니다. 사용자 계정 안의 Amazon EC2 관리형 인스턴스에서 에이전트를 실행하고, 프로비저닝, 패치, 확장, 정리는 AgentCore가 맡습니다. 이 글을 쓰는 시점에 서울 리전에는 출시되지 않았고(도쿄, 싱가포르 등 9개 리전에서 제공), 이 시리즈에서는 측정하지 않았으므로 아래 내용은 문서를 기준으로 정리했습니다.
| 항목 | microVM (이 글의 측정 대상) | Instances |
|---|---|---|
| 실행 위치 | AgentCore가 운영하는 세션 전용 microVM | 사용자 계정의 Amazon EC2 관리형 인스턴스, 세션 하나에 인스턴스 하나 |
| 세션 최대 길이 | 8시간 | 14일 |
| 하드웨어 | arm64, 세션당 최대 2 vCPU, 8 GB | capacity provider에서 고른 인스턴스 유형(x86_64, arm64), GPU(g4dn, g5, g6, g6e, g7e 등)와 inf2 |
| 네트워크 | PUBLIC 또는 VPC | VPC |
| 세션과 에이전트 | 런타임 하나에 에이전트 하나 | 세션 하나에 여러 에이전트, 파일 시스템 공유 |
| 상태 보존 | 세션 스토리지(Preview, 세션당 최대 1 GB) | capacity provider에 정의한 Amazon EBS 볼륨, 세션을 삭제할 때까지 유지 |
| 과금 | CPU와 메모리 실제 사용량 | EC2 인스턴스 요금과 관리 요금, Savings Plans와 온디맨드 용량 예약(ODCR) 적용 가능 |
표 12. microVM과 Instances 컴퓨팅 유형 비교 (2026년 10월 문서 기준, 측정하지 않음)
격리 관점에서 가장 큰 차이는 경계의 단위입니다. Instances에서는 세션 하나가 EC2 인스턴스 하나에 대응하고, 이 세션이 격리 단위입니다. 같은 세션에 올린 여러 에이전트는 컨테이너나 프로세스로 실행되어 서로 보안 경계가 없으므로, 문서는 서로 신뢰하는 에이전트만 한 세션에 두라고 권고합니다. 인스턴스에서 실행되는 코드는 자기에게 제공된 실행 역할의 자격 증명을 읽을 수 있으므로 문서는 런타임마다 실행 역할을 최소 권한으로 두라고 권고하며, 세션 ID와 사용자의 매핑을 서비스가 강제하지 않는 점은 microVM과 같습니다. 대신 인스턴스가 사용자 계정에 있으므로 AWS Organizations의 서비스 제어 정책(SCP), 권한 경계, VPC 통제, AWS CloudTrail과 VPC Flow Logs 같은 기존 계정 통제를 그대로 적용할 수 있습니다.
운영 측면에서는 microVM의 일부 장점을 내려놓고 EKS에 가까운 자원을 관리형으로 얻는 선택입니다. 세션의 첫 호출에는 인스턴스 프로비저닝이 포함되어 더 오래 걸리고, 사용량이 아니라 EC2 인스턴스 요금에 관리 요금이 더해져 과금됩니다. 대신 노드 그룹이나 Karpenter 없이 같은 InvokeAgentRuntime 호출로 대형 빌드, 긴 작업, GPU 작업을 실행할 수 있습니다.
EKS에서 microVM 수준의 하드웨어 가상화 경계를 Pod 단위로 직접 구성하려면 Kata Containers를 쓸 수 있습니다. 예전에는 베어메탈 인스턴스가 필요했지만 2026년 2월 C8i, M8i, R8i를 시작으로 일반 인스턴스에서도 중첩 가상화가 지원되고, 6월에는 지원 범위가 넓어졌습니다. 3부에서 에이블리가 검토하겠다고 한 방향이기도 하며, 이 시리즈에서는 Kata 구성을 측정하지 않았습니다.
7. 실행 환경 선택 기준
7.1 1부의 4개 계층으로 다시 보기
| 1부의 계층 | EKS에서 구성한 것 | AgentCore에서 확인한 것 | 직접 확인할 항목 |
|---|---|---|---|
| Pod 보안 설정 | PSA restricted, 비루트 UID, capability 제거, ServiceAccount 토큰 미마운트 | 비특권 사용자(uid 991)라 /var/task, /home 쓰기 불가, seccomp 없음 | 없음 |
| gVisor | 사용자 공간 커널(Sentry)이 시스템 콜 중재 | 세션마다 microVM, 자체 게스트 커널 | 없음 |
| NetworkPolicy | VPC CNI에서 활성화해야 동작, 템플릿 기본 정책은 인터넷 허용 | Runtime은 PUBLIC 또는 VPC 모드 선택. Code Interpreter의 SANDBOX 모드는 인터넷은 막지만 같은 리전 S3로는 연결됨 | 모드 선택, S3 반출 경로 |
| 전용 노드 그룹의 IMDS 설정 | IMDSv2 필수, 홉 제한 1 | 노드 개념 없음. 실행 역할 자격 증명이 VM 안의 IMDSv2로 전달(Runtime은 역할 필수, Code Interpreter는 역할 지정 시) | 실행 역할 최소 권한, 세션 ID와 사용자 매핑 |
표 13. 1부의 4개 격리 계층과 AgentCore의 대응
EKS에서 직접 확인한 항목은 대부분 Managed Node Group 구성, VPC CNI NetworkPolicy 활성화, Egress와 DNS 경로, sandbox-router 인증, Pod IP 재사용 대기, gVisor와 AMI 버전 관리처럼 플랫폼 구성이었습니다. AgentCore에는 업그레이드 때마다 다시 확인할 인프라 항목이 없는 대신, 4장과 5장에서 본 세션 수명 주기의 규칙을 애플리케이션 코드에 반영하는 일이 남습니다. 4.1절의 /ping 유휴 판정이나 5.4절의 V2 메모리 회수처럼 실제 동작이 문서나 가격 페이지의 설명과 다른 경우가 있었으므로(V2 메모리 회수는 설명보다 빨랐습니다), 서비스가 업데이트되면 이 규칙을 다시 확인할 것을 권고합니다.
7.2 워크로드별 선택
| 워크로드 | 권장 | 근거 |
|---|---|---|
| 세션별 대화형 에이전트, 사내 업무 에이전트 | AgentCore Runtime | 세션마다 microVM, 같은 세션 재호출 70 ms, 대기 중 CPU 거의 비과금, 유휴 세션 자동 회수 |
| 에이전트가 생성한 데이터 분석 코드 실행 | AgentCore Code Interpreter | 세션 시작 0.8초(10월 서울 측정), 사전 설치 Python 패키지 약 280개(세션 안 pip list 기준), SANDBOX 모드 기본값(S3 경로는 별도 검토) |
| 코딩 에이전트의 빌드, 테스트 | AgentCore Runtime(microVM, Instances) 또는 EKS | microVM 한도를 넘는 빌드는 Instances 컴퓨팅 유형이나 EKS Pod로. 시스템 콜이 많아 gVisor보다 microVM이 유리(runc Pod는 신뢰할 수 있는 코드에만) |
| GPU가 필요하거나 며칠 이어지는 에이전트 작업 | AgentCore Runtime의 Instances | 최대 14일 세션, GPU, Amazon EBS 볼륨. 서울 미출시, 측정하지 않음(6장) |
| 모바일 앱 QA 에이전트(Android 에뮬레이터) | EKS 중첩 가상화 노드 | microVM에는 KVM이 없음. 중첩 가상화를 지원하는 C8i, M8i, R8i 등 인스턴스 사용 |
| 강화학습 롤아웃 | 대규모는 자체 호스팅 microVM, 소규모는 AgentCore Runtime | 샌드박스 대기가 GPU 시간이 됨. 규모가 작고 간헐적이면 사용량 과금과 운영 부담이 없는 쪽이 유리 |
| 여러 고객의 코드를 한 플랫폼에서 실행 | AgentCore 또는 EKS + Kata | 테넌트마다 하드웨어 가상화 경계 |
| 이미 EKS 플랫폼이 있고 세밀한 통제가 필요 | EKS + Agent Sandbox + gVisor | 기존 노드, 네트워크, AWS IAM 통제 재사용. Warm Pool 57 ms |
표 14. 워크로드별 권장 실행 환경
표에서 비용 판단이 갈리는 기준은 샌드박스를 무엇이 기다리는가입니다. 예를 들어 Amazon SageMaker HyperPod에서 GRPO 강화학습 롤아웃을 자체 호스팅 E2B(Firecracker 기반)와 AgentCore Runtime V2로 각각 실행한 실험에서는, 사용한 만큼만 내는 AgentCore의 샌드박스 비용이 약 5분의 1이었고 롤아웃 실패와 스로틀도 없었습니다. 하지만 GPU 노드가 샌드박스 결과를 기다리는 시간이 늘면서 GPU 비용이 더 커져, 총비용은 지연이 짧은 자체 호스팅 쪽이 낮았습니다. 반대로 사람이나 모델 응답을 기다리는 시간이 대부분인 대화형 에이전트에서는 5.2절과 5.3절에서 본 대기 중 CPU 비과금과 자동 회수가 그대로 비용 이점이 됩니다.
관리형 microVM 선택지는 AgentCore만이 아닙니다. 2026년 6월 출시된 AWS Lambda MicroVMs는 최대 16 vCPU, 32 GB(arm64 전용)의 Firecracker 샌드박스를 스냅샷에서 재개하는 방식입니다. 2026년 10월 현재 서울 리전에는 없어 측정하지 않았으며, 서울에 출시되면 표 14의 빌드와 강화학습 롤아웃 항목의 권장이 달라질 수 있습니다.
8. 도입 전 확인 항목
2부의 도입 전 확인 항목과 같은 형식으로 AgentCore의 도입 전 확인 항목을 정리했습니다. EKS의 항목이 대부분 노드, 네트워크, router 같은 플랫폼 구성이었던 것과 달리, 여기서는 주로 애플리케이션과 계정 설정에서 처리합니다. 11개 항목 중 앞의 세 개는 격리, 나머지 여덟 개는 수명 주기, 비용, 패키징과 운영에 관한 것입니다.
| 확인 항목 | 증상 | 조치 |
|---|---|---|
| 세션 ID와 사용자 | 서비스가 세션 ID와 사용자의 관계를 강제하지 않음 | 백엔드에서 사용자별 세션 ID 발급과 검증 |
| 실행 역할 | microVM 안의 모든 코드가 역할을 사용 | 최소 권한, 생성된 코드는 역할 없는 Code Interpreter나 권한을 좁힌 별도 런타임으로 분리 |
| Code Interpreter의 SANDBOX 모드 | 인터넷은 막히지만 같은 리전 S3로는 연결됨(Unit 42, Sonrai Security 보고와 측정 결과) | 민감한 데이터는 VPC 모드와 S3 게이트웨이 엔드포인트 정책으로 제한 |
| 긴 요청과 유휴 판정 | /ping이 Healthy면 동기 요청을 처리하는 중에도 유휴 타임아웃에 회수됨(요청 실패 또는 새 VM에서 재실행) | 처리 중 HealthyBusy 응답, 요청 ID로 중복 실행 방지 |
| V2 스냅샷 | 초기화 때 만든 난수, ID, 자격 증명이 모든 세션에 복제됨 | 무거운 초기화는 시작 시점에, 고유 값과 자격 증명은 요청 처리 중에 |
| 유휴 세션의 메모리 | 대기 중에도 메모리 과금, 기본 유휴 900초, V1은 해제한 메모리도 계속 과금 | 유휴 타임아웃 단축, 끝난 세션은 즉시 종료, 큰 메모리를 잠깐 쓰는 세션은 V2 검토 |
| Code Interpreter 타임아웃 | 유휴 시간이 아니라 절대 수명 | 예상 작업 시간에 맞춘 타임아웃, 종료 시 재생성 로직, 작업 후 명시적 종료 |
| 세션 몰림 | 수백 개 단위의 동시 생성에서 ThrottlingException | 같은 세션 ID로 재시도, 대기 상한 설정, 피크에 맞춘 한도 조정 요청 |
| 세션 크기 한도 | 세션당 최대 2 vCPU, 8 GB(조정 불가), KVM 없음. OOM 뒤 앱이 재시작되지 않고 502 | 큰 작업은 Instances 컴퓨팅 유형이나 EKS로 분리, OOM 세션은 즉시 종료 |
| 패키징 | arm64 전용, 직접 코드 배포 런타임에 boto3 기본 미포함, 세션 ID 33자 이상, V2 없는 리전은 platformVersion 파라미터 거부 | arm64 휠로 패키징, 의존성 포함, 리전별 배포 설정 분리 |
| VPC 모드 정리 | 런타임이나 인터프리터를 지운 뒤에도 서비스 관리 ENI가 남아 보안 그룹 삭제 실패(인터프리터에서 측정 2시간 이상, 문서상 최대 8시간 뒤 자동 제거) | 정리 작업에 재시도와 대기 시간 반영, 서브넷과 보안 그룹 재사용 |
표 15. 도입 전 확인 항목과 권장 조치
9. 마치며
1부와 2부가 Amazon EKS에서 에이전트 실행 환경을 격리하고 운영하는 방법을, 3부가 에이블리의 실제 운영 사례를 다뤘다면, 4부는 같은 문제를 Amazon Bedrock AgentCore의 관리형 microVM으로 풀었습니다. 측정으로 확인한 내용은 세 가지로 정리할 수 있습니다.
첫째, 격리 경계는 runc, gVisor, microVM 순으로 강해지지만, 1부에서 시험한 네 항목 중 세 항목은 런타임이 아니라 Pod 보안 설정과 컨트롤러 기본값이 막았습니다. AgentCore에서는 Pod 보안 설정과 gVisor를 세션 전용 microVM이 대신했지만, 실행 역할의 자격 증명은 샌드박스 코드에 그대로 전달됐습니다. 어느 쪽이든 런타임을 고르기 전에 샌드박스 안에 어떤 자격 증명과 데이터가 들어가는지부터 정해야 합니다.
둘째, 격리의 비용은 시작 지연과 시스템 콜에서 나옵니다. 시작 지연은 EKS에서는 Warm Pool로 줄였고, AgentCore에서는 미리 준비할 용량 없이도 1.4초였습니다. 시스템 콜 비용은 gVisor에서만 두드러졌습니다. 이 비용이 문제가 되는지는 샌드박스를 기다리는 것이 사람인지, GPU인지, 아무것도 아닌지에 달려 있습니다. 모델 응답 대기가 긴 에이전트라면 대기 중 CPU를 과금하지 않는 AgentCore가 유리하고, GPU가 샌드박스를 기다리는 작업이라면 지연이 총비용을 좌우하며, 7.2절의 실험에서는 지연이 짧은 자체 호스팅 쪽의 총비용이 낮았습니다.
셋째, 운영 부담은 사라지지 않고 위치가 바뀝니다. EKS에서는 노드, 네트워크, 런타임 버전 같은 플랫폼 구성이 남고, AgentCore에서는 세션의 생성, 회수, 확장을 서비스가 맡았습니다. 준비 없이 연 세션 200개가 2.6초 안에 모두 응답했고, 버린 세션 1,154개가 모두 유휴 타임아웃에 맞춰 과금을 멈췄으며, 세션별 사용량이 청구와 같은 기준으로 남았습니다. 노드와 런타임 버전을 관리하는 인력, 미리 띄워 두는 용량, 대기 중의 CPU 비용이 줄어드는 만큼, 운영 인력이 적거나 사용량 변동이 큰 팀이라면 관리형 서비스로 샌드박스 운영의 TCO를 낮출 수 있습니다. 대신 /ping의 유휴 판정과 처리 중 회수, V2 스냅샷의 값 복제, 대기 중의 메모리 과금처럼 서비스가 정한 규칙은 애플리케이션 코드가 지켜야 합니다.
3부에서 본 책임 분리처럼, AgentCore에서도 애플리케이션이 맡을 몫은 /ping 상태, 세션 ID와 사용자의 매핑, 세션 스토리지 범위를 넘는 작업물 보존으로 정리됩니다. 둘 중 하나만 고를 필요는 없으며, 에이전트는 microVM에 두고 큰 작업만 Instances 컴퓨팅 유형이나 EKS로 넘기는 구성도 현실적인 선택지입니다. 이 시리즈의 측정값과 사례가 조직에 맞는 에이전트 실행 환경을 고르고 설계하는 데 도움이 되길 바랍니다.
참고 자료
- Use isolated sessions for agents, AgentCore Developer Guide
- Resource and session management, AgentCore Developer Guide
- Configure Amazon Bedrock AgentCore lifecycle settings, AgentCore Developer Guide
- HTTP protocol contract, AgentCore Developer Guide
- Optimize your agent for Amazon Bedrock AgentCore Runtime V2, AgentCore Developer Guide
- AgentCore generated runtime observability data, AgentCore Developer Guide
- Quotas for Amazon Bedrock AgentCore
- Amazon Bedrock AgentCore pricing
- The new AgentCore Runtime is now available in Amazon Bedrock AgentCore, AWS What’s New (2026-09-18)
- AgentCore runtime instances are now generally available, AWS What’s New (2026-08-06)
- Instances, AgentCore Developer Guide
- Security model and permissions for Runtime Instances, AgentCore Developer Guide
- Handle asynchronous and long running agents, AgentCore Developer Guide
- File system configurations for AgentCore Runtime, AgentCore Developer Guide
- Configure VPC for AgentCore, AgentCore Developer Guide
- Stop a running session, AgentCore Developer Guide
- Amazon EC2 supports nested virtualization on virtual Amazon EC2 instances, AWS What’s New (2026-02-16)
- Nested virtualization is now available on additional Intel platforms and AWS GovCloud (US) regions, AWS What’s New (2026-06-18)
- Run isolated sandboxes with full lifecycle control: AWS Lambda introduces MicroVMs, AWS News Blog (2026-06-22)
- Cracks in the Bedrock: Escaping the AWS AgentCore Sandbox, Palo Alto Networks Unit 42 (2026-04-07)
- Global S3: Another C2 Channel for AgentCore Code Interpreters, Sonrai Security (2026-04-22)
- hsr87/sample-agentic-rl-sandboxes-on-sagemaker-hyperpod, GitHub