AWS 기술 블로그
AWS에서 Laya를 통한 Decision Model 학습 및 배포 환경 구성하기
2026년 9월 TypeSafe AI가 공개한 Jev를 계기로, 텍스트를 생성하지 않고 판단 결과를 선택지별 확률로 돌려주는 Decision Model이 LLM을 대신하여 판단을 처리하는 옵션으로 등장했습니다. 이 글은 두 가지를 다룹니다. 하나는 오픈소스 Decision Model인 Laya를 Amazon SageMaker에서 추가 학습하고 실시간 엔드포인트로 배포해 호출하는 구성 가이드이고, 다른 하나는 동일한 판단을 구현하는 네 가지 방식(Jev, Strands Decider, Laya, SGLang으로 서빙한 LLM)을 같은 문장으로 비교한 벤치마크 결과입니다. 예제 과제는 한국어 텍스트에 개인정보보호법상 개인정보가 들어 있는지 판단하는 모델입니다. 추가 학습한 Laya는 처음 보는 문장에서 학습 없이 쓴 Jev나 수백 배 큰 LLM과 비슷한 수준의 오류를 보였고, 가장 작은 GPU 인스턴스(ml.g4dn.xlarge, T4 1장)에서 판정 1건을 수십 ms에 처리했습니다. 본문의 코드는 구성을 설명하기 위한 발췌이며, 학습 데이터는 과제에 맞게 직접 준비해야 합니다. 같은 구성을 다른 판단 과제로 옮길 때 무엇을 바꾸면 되는지도 정리했습니다.
Decision Model이 필요한 순간
LLM은 사람이 읽을 글을 만드는 데 강하지만, 워크로드에 필요한 판단 하나를 얻으려고 LLM을 호출하면 여러 부담이 따릅니다. 응답이 토큰 단위로 생성되므로 수백 ms에서 수천 ms가 걸리고, JSON으로 답하라고 해도 파싱이 깨질 수 있으며, 같은 입력에 다른 답이 나오기도 합니다. “이 요청을 막아야 하는가”, “이 티켓은 어느 부서로 보내야 하는가”, “이 도구 호출을 실행해도 되는가” 같은 결정은 에이전트 루프 안에서 수십 번씩 반복되기 때문에, 호출마다 드는 지연과 비용이 누적되어 전체 워크로드에 부담이 됩니다.
TypeSafe AI의 Jev는 이 문제를 겨냥해 System One Model이라는 이름으로 등장했습니다. TypeSafe AI는 System One Model을 소프트웨어가 바로 쓸 수 있는 빠르고 구조화된 결정을 내리도록 만든 새로운 모델 부류라고 소개합니다. 상태(텍스트나 JSON)와 타입이 정해진 질문(선택형, 점수형, 예/아니오)을 보내면 토큰을 하나씩 생성하지 않고 선택지별 확률을 한꺼번에 돌려줍니다. TypeSafe AI는 이 확률이 보정(Calibration)돼 있다고 설명합니다. 보정은 모델이 내놓는 확률을 실제로 맞는 비율과 일치시키는 작업입니다. 모델이 확률 0.9로 답한 건을 모았을 때 그중 약 90%가 실제로 맞으면 보정된 확률입니다. 확률을 그대로 믿을 수 있으므로 0.9 이상은 자동으로 처리하고 그 아래는 사람이 검토하는 식으로 임계값을 정해 가를 수 있습니다. 다만 Jev는 호스팅 API로만 제공되고 가중치가 공개돼 있지 않고 고객 데이터로 모델 학습이 불가합니다. 데이터를 외부로 내보낼 수 없는 워크로드, 한국어 도메인에 맞춰 재학습해야 하는 워크로드, 지연과 비용을 인프라 단위로 통제해야 하는 워크로드에는 고객이 직접 학습하고 배포할 수 있는 모델이 필요합니다.
Laya는 같은 방식으로 동작하는 Apache-2.0 오픈소스 Decision Model입니다. 인코더(다국어 체크포인트는 mmBERT-base, 약 3억 2천만 파라미터)에 결정 헤드를 얹은 구조로, 텍스트 생성 없이 각 질문마다 선택지별 확률과 신뢰도를 한 번에 돌려줍니다. 100개 이상 언어를 지원하고 입력 길이는 기본 1,024토큰입니다. 제작자는 문서에서 체크포인트가 제로샷으로도 동작하지만 정확도는 도메인 데이터로 추가 학습할 때 크게 오른다고 설명합니다. 이 글의 한국어 개인정보 과제에 추가 학습 없이(제로샷) 적용했을 때는 거의 모든 문장을 개인정보로 판정해 쓸 수 없었습니다. 따라서 Laya를 활용하려면 학습 데이터 준비, 학습 작업 실행, 서빙 컨테이너 구성, 호출 측 결정 규칙 구현까지 전체 환경을 직접 구성해야 했습니다. 이 글에서는 각 단계에 필요한 구성 방법을 설명합니다.
| 항목 | LLM 프롬프트 방식 | Decision Model (Laya) |
|---|---|---|
| 출력 | 자유 텍스트 (JSON 요청 가능) | 질문마다 선택지별 확률과 신뢰도 |
| 건당 판정 지연 시간 | 수백 ms에서 수천 ms | 수십 ms (GPU 1장) |
| 비용 구조 | 입출력 토큰 과금 | 인스턴스 시간 과금, 요청 수와 무관 |
| 일관성 | 샘플링에 따라 변동 | 같은 입력에 같은 확률 |
| 사용자 정의 | 프롬프트 수정 | 학습 데이터로 재학습 |
| 못 하는 것 | – | 텍스트 생성, 스팬 추출(마스킹), 학습 범위 밖 입력의 예측 가능한 동작 |
동일한 판단을 구현하는 네 가지 방식
판단 결과를 선택지별 확률로 돌려주도록 구현하는 방법은 Laya 하나가 아닙니다. 관리형 API인 Jev, AWS Strands Labs가 공개한 오픈소스 Decision Model Strands Decider, 학습해서 사용하는 작은 오픈소스 모델 Laya, 그리고 오픈 웨이트 LLM을 SGLang 같은 서빙 엔진으로 띄워 기준 프롬프트를 주는 방식이 있습니다.
네 가지 방식은 제공 형태뿐 아니라 기업별 판단 기준을 반영하는 방법과 데이터 처리 경로에서도 차이가 있습니다.
| 비교 기준 | Jev | Strands Decider | Laya | SGLang + LLM |
|---|---|---|---|---|
| 제공 형태 | 관리형 Decision Model API | 오픈소스 Decision Model | 학습해서 쓰는 오픈소스 Decision Model | 선택한 오픈 웨이트 LLM과 서빙 엔진 |
| 회사 기준 반영 | 기준과 예시를 호출에 전달 | 기준 전달 또는 미세조정 | 라벨 데이터로 가중치 학습 | 기준 프롬프트 또는 별도 학습 |
| 모델 크기 | 비공개 | 약 19억~260억 파라미터 | 약 3.2억 파라미터 | 수십억~수천억 파라미터 |
| 자체 배포 | 불가 (API로만 제공) | 가능 | 가능 | 가능 |
| 운영 책임 | API 연동 | GPU 서빙, 평가 | 학습, 배포, 평가 | GPU, 모델, 서빙 |
| 데이터 경로 | 외부 서비스로 전송 | 계정 안 | 계정 안 | 계정 안 |
생성 모델이 하던 분류를 Decision Model로 옮긴 공개 사례도 있습니다. Amazon은 사내 티켓을 20개 유형으로 분류하는 작업을 생성 모델에서 Strands Decider로 바꾸어 호출당 시간을 4,215 ms에서 897 ms로, 티켓 100만 건의 비용을 약 22,200달러에서 약 500달러로 줄였다고 Strands Agents 블로그에서 밝혔습니다. 이 글에서는 네 가지 방식 가운데 Laya의 구성을 설명합니다. Laya는 가장 작은 모델을 회사 데이터로 직접 학습해서 쓰는 방식입니다. 네 가지 방식을 같은 문장으로 비교한 결과는 하단 결과 섹션에 있습니다.
이 글에서 다루는 범위
- 질문 스키마 설계와 Laya 학습 데이터 형식
- 학습과 서빙을 겸하는 SageMaker 컨테이너
- SageMaker 학습 작업 실행
- 실시간 엔드포인트 배포, 검증, 롤백
- 호출 코드와 ALLOW / BLOCK / REVIEW 결정 규칙
- 네 가지 방식의 벤치마크 결과, 장단점, 적용 가이드
- 다른 과제에 적용하는 방법, 필요한 데이터 규모, 구축 로드맵
이 글은 따라 하면 같은 모델이 나오는 실습이 아니라 구성 가이드입니다. 본문 코드는 컨테이너, 학습 작업, 배포, 호출의 구조를 보여 주는 발췌이고, 학습 데이터와 데이터 생성기는 제공하지 않습니다. 학습 데이터는 과제의 특성에 따라 달라지므로 직접 준비해야 합니다. Step 1에서는 학습 데이터의 구성 방법과 준비 시 고려할 원칙을 설명합니다. 예제 과제는 LLM 호출 앞단의 개인정보 필터입니다. 사용자의 프롬프트, 모델 응답, 첨부 문서가 LLM으로 나가기 전에 “개인정보보호법상 개인정보가 들어 있는가”를 판정하고, 들어 있으면 종류(고유식별정보, 민감정보, 금융 개인정보, 일반 개인정보)와 등급을 함께 돌려줍니다. 이 글의 모든 예시 문장은 생성기가 만든 합성 문장이며 실제 개인정보가 아닙니다. 주민등록번호 형식의 값은 검증번호가 맞지 않게 바꿔 실었고, 계좌번호 형식의 값은 실제 계좌와 겹치지 않도록 숫자를 0으로 바꿔 실었습니다.
이 방식이 맞는 과제인지 먼저 확인
Decision Model은 모든 판단 과제에 맞는 도구는 아닙니다. 과제가 아래 조건에 대부분 해당하면 이 글의 구성을 출발점으로 삼을 수 있습니다.
- 답이 유한한 선택지, 예/아니오, 점수 가운데 하나로 정해지고, 선택지를 한두 문장으로 정의할 수 있습니다.
- 판단 1건마다 지연과 비용이 중요합니다. LLM 호출 앞뒤의 검사, 에이전트의 도구 호출 승인, 요청 라우팅처럼 하루 수만 건 이상 반복됩니다.
- 확률이 필요합니다. 신뢰도가 낮은 건을 사람이나 더 큰 모델로 넘기는 분기가 있어야 합니다.
- 데이터를 계정 밖으로 보낼 수 없거나, 한국어 도메인 어휘에 맞춰 재학습해야 합니다.
- 정답을 규칙이나 기존 시스템의 처리 기록에서 뽑을 수 있어, 이를 바탕으로 라벨 데이터를 구축할 수 있습니다.
위의 조건들과 달리 요약이나 답변처럼 텍스트를 생성해야 하면 LLM이 적절하고, 개인정보 값의 위치를 찾아 가려야(마스킹)하면 정규표현식 기반 스크립트, 관리형 LLM 기반 필터링 등이 필요하면 Amazon Bedrock Guardrails가 적절합니다.
왜 일반 분류기가 아니라 Laya인가
한국어 BERT 계열 인코더에 분류 헤드를 얹어 미세 조정을 해도 비슷한 지연으로 같은 과제를 풀 수 있습니다. 이 글에서 Laya를 선택한 이유는 크게 세 가지입니다. 다만, 사용 시 고려해야 할 한계도 있습니다.
- 선택한 이유 1. 질문과 선택지 설명이 입력의 일부입니다. 질문 세 개(민감 여부, 종류, 등급)를 한 번의 호출로 답하고, 라벨 체계가 바뀌면 코드가 아니라 질문 파일을 고칩니다.
- 선택한 이유 2. 확률을 운영에 바로 쓰기 위한 장치가 두 가지 있습니다. 하나는 학습 함수에 들어 있는 확률 보정(온도 조정) 단계입니다. 다른 하나는 교차 검증입니다. 한 번의 호출로 여러 질문에 답하므로 두 질문의 답이 서로 어긋나는 건을 REVIEW로 보낼 수 있습니다.
- 선택한 이유 3. 데이터 형식, 학습, 보정, 추론 서버가 한 패키지에 들어 있어 SageMaker 학습 진입점 구현이 수십 줄로 끝납니다.
- 한계. 이 글의 예시인 한국어 개인정보 필터링 모델 과제에서는 추가 학습 없이(제로샷) 쓸 수 없었습니다. 추가 학습 전 모델은 KDPII 테스트 발화의 96%를 개인정보로 판정했습니다(정확도 19.6%). 그래서 학습 데이터를 직접 준비해야 하고, 모델의 성능도 그 데이터의 품질에 따라 달라집니다.
이 글의 용어
| 용어 | 뜻 |
|---|---|
| 상태(state) | 모델이 판단할 입력 텍스트 |
| 질문(questions) | 타입(noul, choice, score)과 선택지 설명이 든 JSON. 학습과 서빙에서 같은 파일을 씀 |
| 질문 헤드 | 모델 입력에서 질문 문장과 선택지 설명이 차지하는 앞부분. 그 뒤에 상태가 이어짐. 기본 256토큰(head_max_len)까지 쓸 수 있고 넘으면 잘림. 모델 구조의 결정 헤드(출력층)와는 다른 말 |
| 단위(unit) | 라벨이 붙은 텍스트 한 건. 단문, 다중 턴 대화, 장문 문서가 모두 한 단위 |
| 학습 행(row) | 단위 하나를 Laya 학습 입력(state, questions, gold)으로 바꾼 JSON Lines 한 줄 |
| 아이템(item) | 학습 행 하나의 질문 하나. 질문이 세 개면 단위 하나가 아이템 세 개 |
| 문장 틀(template) | 실제 값이 들어갈 자리에 변수를 둔 문장. 교사 모델이 쓰고 코드가 값을 채움 |
| 교사 모델(teacher model) | 학습 데이터를 만드는 데 쓰는 LLM. 이 글에서는 자체 호스팅한 오픈소스 LLM이 문장 틀을 씀. 학습 대상인 Laya와는 다른 모델 |
| 결정 규칙 | 응답 확률을 ALLOW, BLOCK, REVIEW로 바꾸는 호출 측 코드 |
아래 그림은 이 용어들이 학습 데이터 준비와 추론에서 어떻게 이어지는지 보여 줍니다.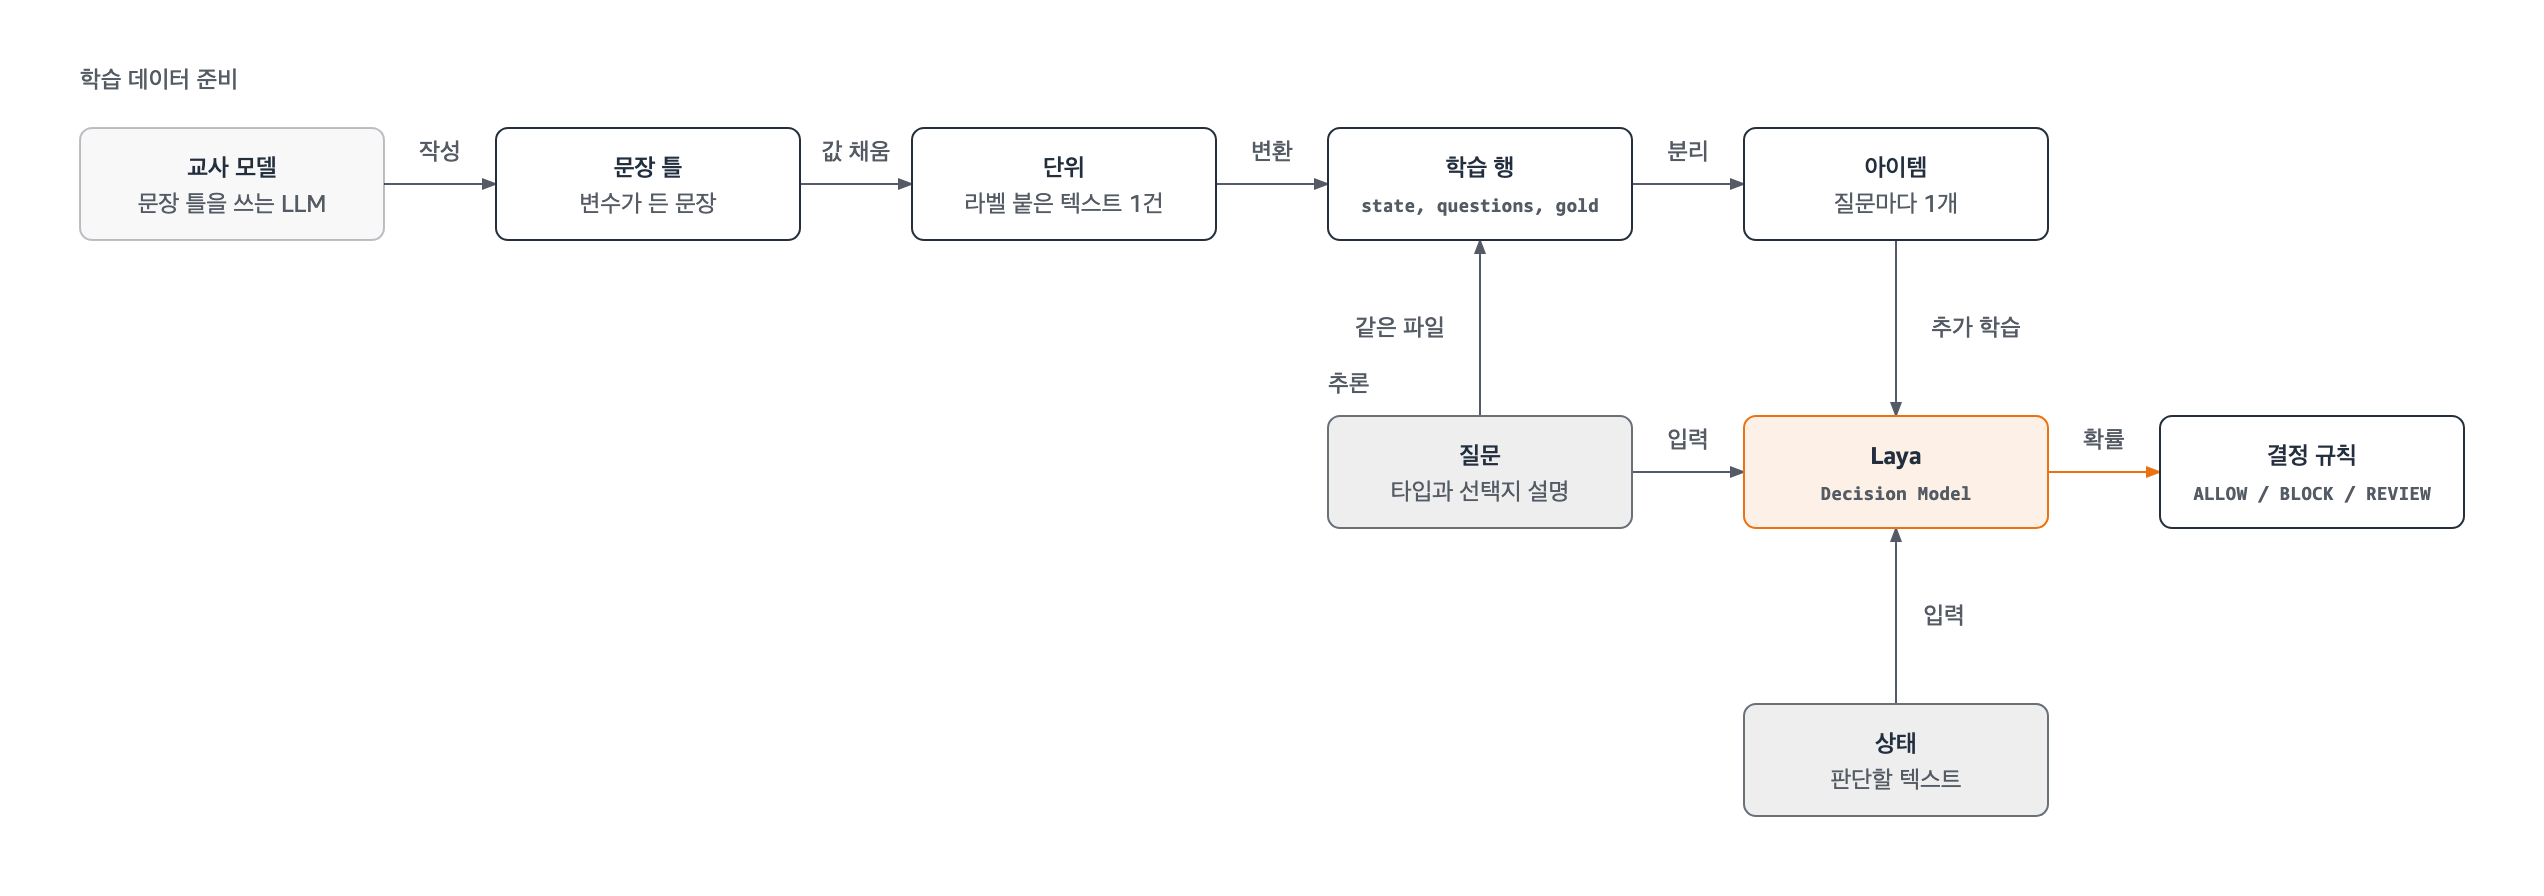
그림 1. 용어 사이의 관계. 학습 데이터 준비는 학습 데이터를 만드는 흐름이고, 추론은 학습한 모델로 판정하는 흐름입니다.
솔루션 개요
전체 흐름은 데이터 준비, 학습, 배포, 호출의 네 단계입니다. 학습과 서빙은 하나의 컨테이너 이미지로 처리하며, SageMaker가 학습 작업에서는 train, 호스팅에서는 serve 명령을 실행합니다.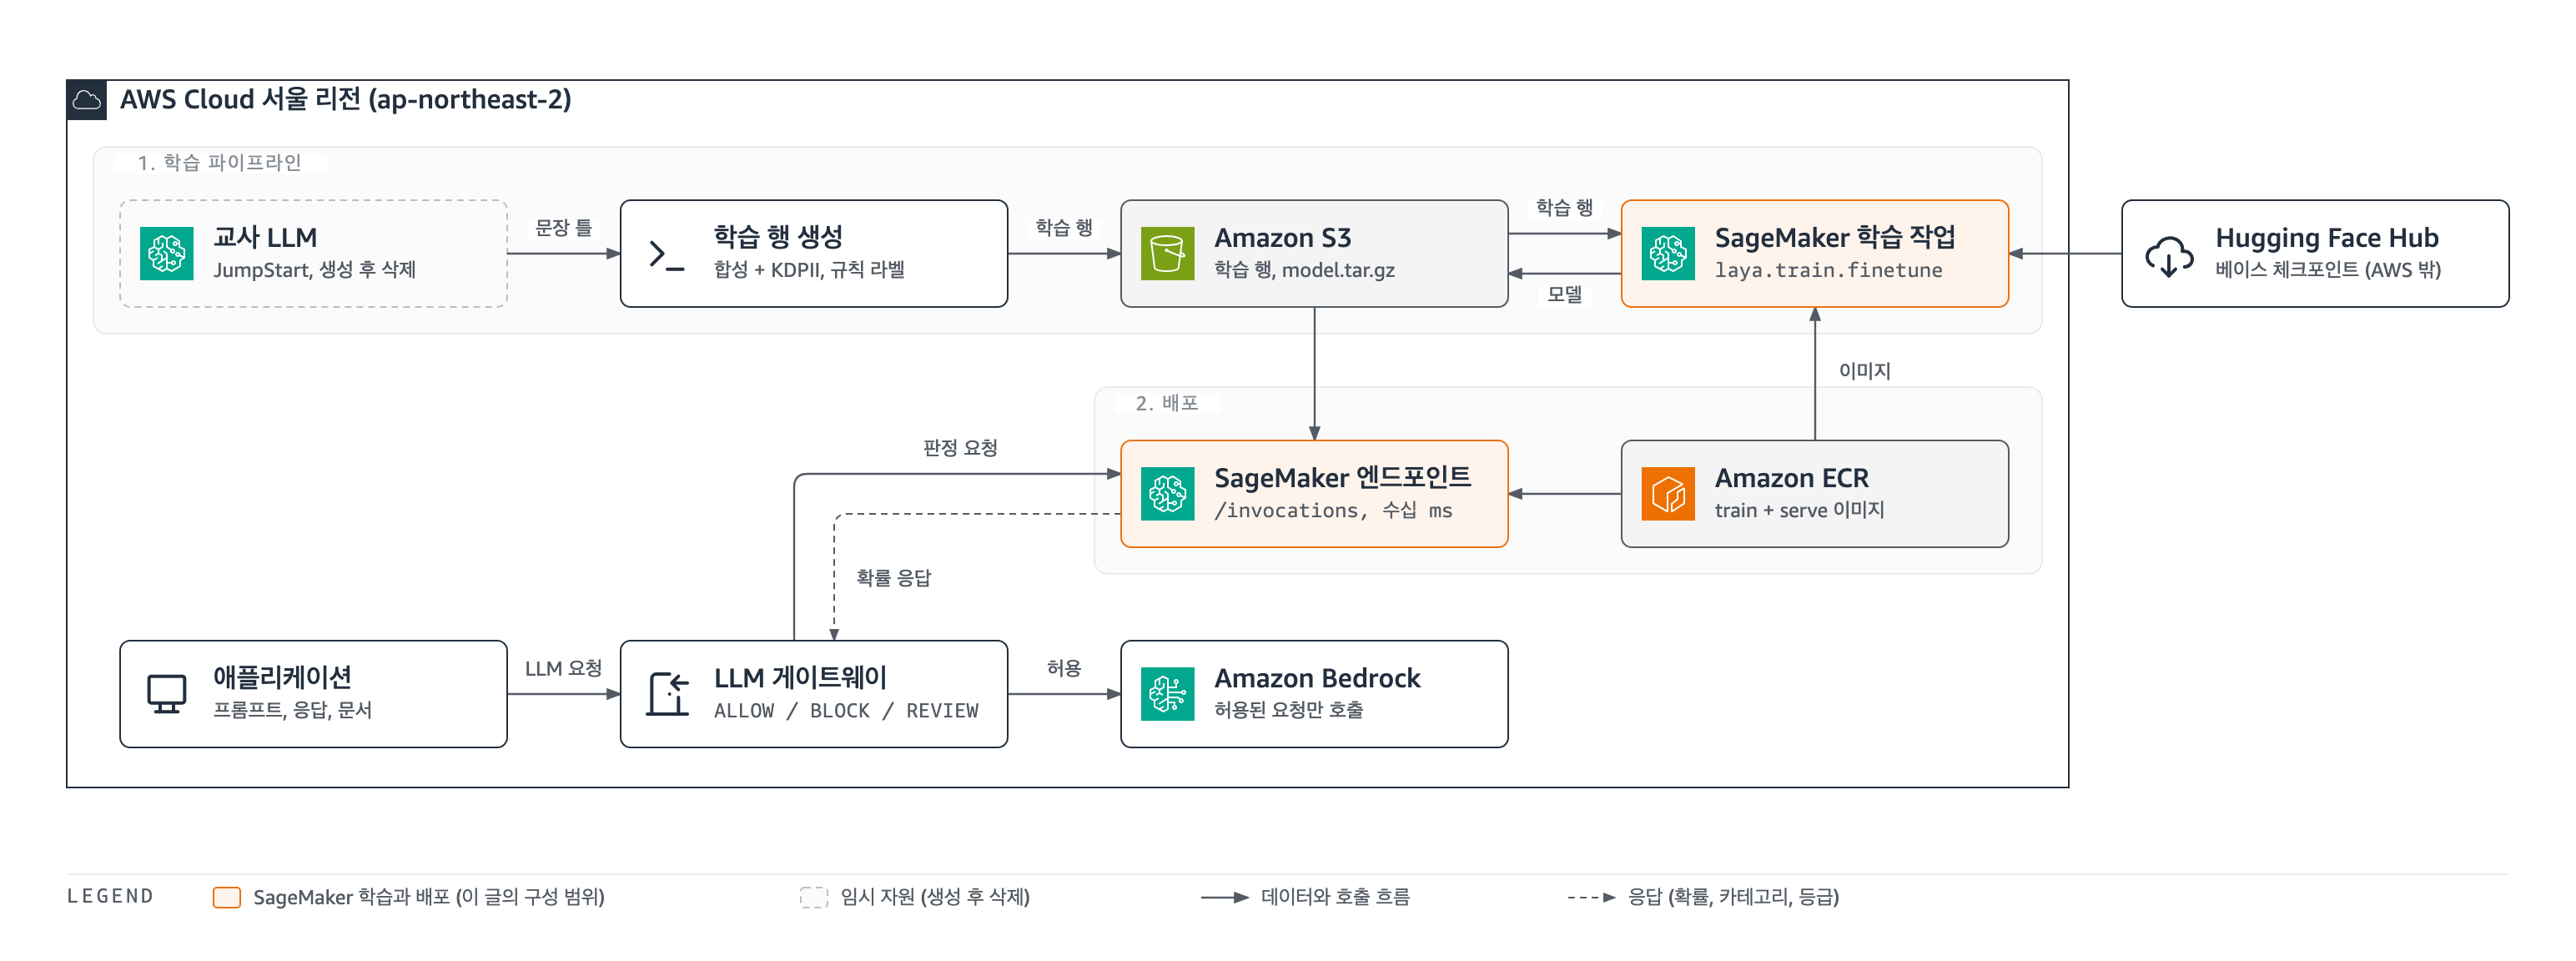
그림 2. Laya Decision Model 학습 및 배포 환경.
교사 모델과 공개 데이터셋으로 만든 학습 행을 Amazon S3에 올려 SageMaker 학습 작업으로 Laya를 추가 학습하고, Amazon ECR의 학습/서빙 겸용 이미지와 모델 산출물로 실시간 엔드포인트를 배포합니다. LLM 게이트웨이는 엔드포인트에 판정을 요청해 확률을 받고 허용(ALLOW)된 요청만 Amazon Bedrock에 전달합니다. 베이스 체크포인트는 기본 설정에서 AWS 밖의 Hugging Face Hub에서 내려받으며, 외부망을 막은 환경에서는 S3 채널로 넘깁니다.
| 구성 요소 | 역할 | 이 글의 선택 |
|---|---|---|
| 학습 데이터 | Laya 학습 행 (텍스트, 질문, 정답 확률) | 합성 데이터 77,269건 + 공개 데이터셋 KDPII 40,109건 |
| 컨테이너 이미지 | 학습(train)과 서빙(serve) 겸용 |
pytorch/pytorch:2.14.1-cuda12.6 기반에 laya[serve] 설치 |
| 학습 | SageMaker Training Job, 자체 컨테이너 | ml.g6e.12xlarge 1대 (GPU 1장만 사용), 3 epoch |
| 서빙 | SageMaker 실시간 엔드포인트, 자체 컨테이너 | ml.g6e.2xlarge 1대 (검증용), 운영 권장은 ml.g4dn.xlarge 2대 |
| 결정 규칙 | 호출 측에서 확률을 ALLOW / BLOCK / REVIEW로 바꿈 | 민감 확률 0.5, 카테고리 최대 확률 0.6 기준 |
| 보조 규칙 | 모델 범위 밖인 인증정보(API 키, 토큰) 탐지 | 호출 측 정규식 규칙 |
사전 준비
- 본 글에서 AWS 리전은 서울(ap-northeast-2)을 기준으로 합니다. 다른 리전도 같은 코드로 동작하지만 인스턴스 가용성과 단가는 다를 수 있습니다.
- SageMaker 실행 역할: 학습 작업과 엔드포인트가 쓸 IAM 역할입니다. S3 버킷 읽기와 쓰기, ECR 이미지 읽기, CloudWatch Logs 쓰기, KMS 키 사용 권한이 필요합니다.
- S3 버킷: 학습 데이터와 모델 산출물을 둡니다. 이 글에서는 SSE-KMS 암호화를 활성화했습니다.
- Amazon ECR 리포지토리: 학습과 서빙에 함께 쓸 이미지를 올립니다.
- 서비스 할당량: 학습용 GPU 인스턴스(본 글 기준 ml.g6e.12xlarge)와 엔드포인트용 GPU 인스턴스(ml.g4dn.xlarge 또는 ml.g6e.2xlarge) 할당량이 0이면 미리 증설을 신청합니다. 새 계정은 대부분 0입니다.
- 로컬 환경: Docker, Python 3.12, boto3, AWS CLI
Step 1. 질문 스키마와 학습 데이터
질문 스키마
Laya는 “상태(state)”인 텍스트와 “질문(questions)”을 함께 입력받습니다. 질문은 세 타입 가운데 고릅니다. noul은 예/아니오 형식의 질문으로, ‘예’에 해당하는 확률을 반환합니다. choice는 여러 선택지 가운데 하나를 선택하고 각 선택지의 확률을 반환하며, score는 낮음, 보통, 높음처럼 순서가 있는 단계 가운데 하나를 점수로 고르고 단계별 확률을 반환합니다. 질문 문장과 선택지 설명은 상태와 함께 모델 입력에 들어갑니다. 입력에서 질문 문장과 선택지 설명이 차지하는 앞부분을 이 글에서는 질문 헤드라고 부릅니다. 그래서 선택지 설명은 짧고 서로 구별되게 작성합니다. 질문 헤드에 배정된 토큰은 기본 256개라 선택지 수가 너무 많거나 설명이 길면 내용이 잘립니다. Laya는 질문 하나마다 질문 헤드 뒤에 상태를 이어 붙인 입력 시퀀스를 하나씩 만듭니다. 질문이 세 개면 시퀀스도 세 개이고, 이 세 개를 한 묶음(배치)으로 모델에 넣어 한 번의 실행으로 세 질문의 답을 함께 얻습니다. 한 시퀀스의 길이 상한은 max_len이며 이 글에서는 1,024토큰입니다. 상태에 쓸 수 있는 토큰은 max_len에서 그 질문의 헤드 길이와 구분 토큰 1개를 뺀 만큼이라, 헤드가 256토큰을 다 쓰면 1,024 – 256 – 1 = 767토큰입니다.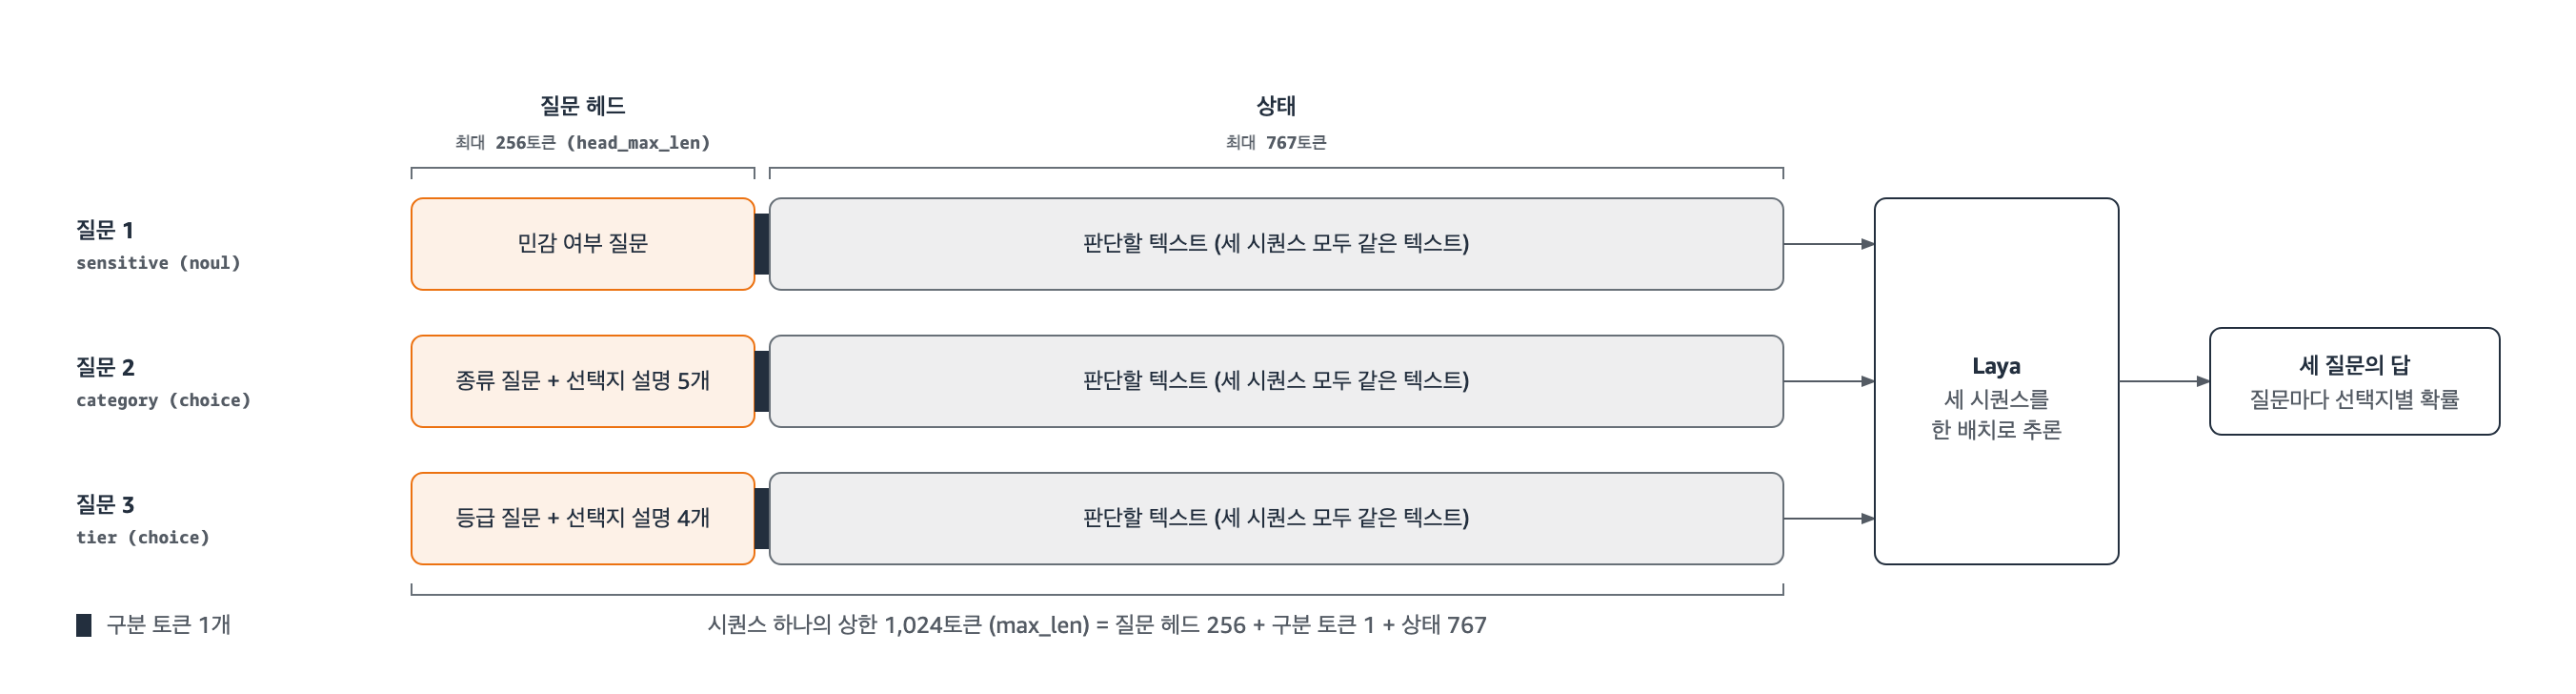
그림 3. 질문 헤드와 입력 시퀀스. Laya는 질문마다 질문 헤드 뒤에 같은 상태를 이어 붙인 시퀀스를 하나씩 만들고, 세 시퀀스를 한 배치로 추론해 세 질문의 답을 함께 돌려줍니다.
예제 과제는 질문 세 개를 씁니다. 첫 질문이 민감 여부, 둘째가 개인정보 종류, 셋째가 민감 등급입니다. 개인정보 종류는 개인정보보호법의 고유식별정보(제24조)와 민감정보(제23조) 구분을 따르고 별도로 추가적인 금융 개인정보(계좌번호, 신용카드번호, 대출·신용 정보)를 별도 종류로 더했습니다. 아래는 questions.json 파일의 예제입니다.
{
  "sensitive": {
    "type": "noul",
    "instructions": "텍스트에 개인정보보호법상 개인정보(살아 있는 개인을 알아볼 수 있는 정보)가 포함되어 있는가?"
  },
  "category": {
    "type": "choice",
    "instructions": "포함된 개인정보의 종류는? 여러 개면 가장 위험한 것.",
    "criteria": {
      "unique_id": "고유식별정보(주민등록번호, 여권번호, 운전면허번호, 외국인등록번호)",
      "sensitive_personal": "민감정보(사상·신념·종교, 노조·정당, 정치적 견해, 건강, 성생활, 유전, 범죄경력, 생체, 인종·민족)",
      "financial": "금융 개인정보(계좌번호, 신용카드번호, 대출·신용 정보)",
      "identifier": "일반 개인정보(성명, 주소, 전화번호, 이메일, 생년월일, 차량번호, IP 주소, 사번·계정 ID)",
      "none": "해당 없음(공개 정보, 기업·기관 정보, 대표번호, 주문번호, 테스트값)"
    }
  },
  "tier": {
    "type": "choice",
    "instructions": "민감도 등급은?",
    "criteria": {
      "critical": "CRITICAL(고유식별정보, 민감정보)",
      "high": "HIGH(금융 개인정보)",
      "medium": "MEDIUM(일반 개인정보만)",
      "none": "NONE(없음)"
    }
  }
}
이 질문 파일은 학습할 때와 서빙할 때 내용이 같아야 합니다. 모델은 학습 때 본 질문과 선택지 설명에 맞춰 확률을 내도록 학습되므로, 서빙에서 다른 질문 파일을 쓰면 학습하지 않은 선택지가 섞여 결과를 믿을 수 없습니다. laya.train.finetune은 학습이 끝나면 학습에 쓴 questions.json을 모델 폴더에 함께 저장합니다. 서빙 컨테이너가 이미지에 넣어 둔 파일 대신 모델 폴더(체크포인트)에 저장된 이 파일을 읽게 하면 학습과 서빙의 질문이 항상 같습니다. Step 4에서 환경 변수 LAYA_QUESTIONS로 이 경로를 지정합니다.
학습 행 형식
Laya 학습 행은 텍스트, 질문, 정답 확률의 세 필드로 구성된 JSON Lines 형식입니다. 정답은 선택지별 확률로 작성하며, 라벨이 하나로 정해진 데이터면 선택지의 정답 확률에 1.0을 줍니다. 아래는 주민등록번호가 포함된 합성 문장의 학습 행입니다.
{
  "state": "내일 2025년 1월 9일까지 접수해야 하는 신규 직원 보험 가입 서류에서 650622-2345678 항목이 누락돼 있어 차장께서 확인을 요청하셨습니다.",
  "questions": "...(위 questions.json 전체)",
  "gold": {
    "sensitive": {"probabilities": {"true": 1.0, "false": 0.0}},
    "category": {"probabilities": {"unique_id": 1.0, "sensitive_personal": 0.0, "financial": 0.0, "identifier": 0.0, "none": 0.0}},
    "tier": {"probabilities": {"critical": 1.0, "high": 0.0, "medium": 0.0, "none": 0.0}}
  }
}
라벨이 붙은 단위를 학습 행으로 변환하는 코드입니다. 질문 파일의 선택지 순서를 그대로 따릅니다.
def units_to_laya_rows(units, questions):
    """{text, category, tier, policy_sensitive} -> laya.train.finetune 입력 행"""
    cat_keys = list(questions["category"]["criteria"])
    tier_keys = list(questions["tier"]["criteria"])
    rows = []
    for u in units:
        gold = {
            "sensitive": {"probabilities": {"true": 1.0 if u["policy_sensitive"] else 0.0,
                                            "false": 0.0 if u["policy_sensitive"] else 1.0}},
            "category": {"probabilities": {k: 1.0 if k == u["category"] else 0.0 for k in cat_keys}},
            "tier": {"probabilities": {k: 1.0 if k == u["tier"] else 0.0 for k in tier_keys}},
        }
        rows.append({"state": u["text"], "questions": questions, "gold": gold})
    return rows
학습 데이터를 어떻게 만들었나
개인정보가 포함된 실제 데이터를 학습에 사용할 수는 없으므로, 실제 데이터 없이 아래 세 단계로 데이터를 만들었습니다.
- 문장 틀 생성: 서울 리전 SageMaker JumpStart에 띄운 오픈소스 LLM(Apache-2.0, 이하 교사 모델)이 한국어 문장 틀을 생성합니다. 문장 틀은 주민등록번호, 계좌번호, 날짜 같은 실제 값이 들어갈 자리에
{RRN},{ACCOUNT},{DATE}같은 변수를 둔 문장입니다. 입력 유형(프롬프트, 응답, 문서)과 문서 종류를 조합하고 코드와 로그, 다중 턴 대화 구성을 더해 다양성을 확보하고, 문장 틀 생성이 끝나면 교사 모델 엔드포인트는 바로 삭제합니다. - 값 채우기와 규칙 라벨: 코드가 변수 자리에 가짜 값을 넣고 라벨을 규칙으로 붙입니다. 각 변수에는 카테고리가 미리 정해져 있습니다. 한 문장에 여러 유형의 개인정보가 들어 있으면 위험도가 가장 높은 항목을 기준으로 문장 전체의 카테고리와 등급을 정합니다. 그래서 사람이 라벨을 달지 않아도 코드로 정답을 만들 수 있습니다. 같은 문장 틀에 서로 다른 값을 여러 번 채워 넣고, 일부 데이터에는 띄어쓰기 변경, 한글 숫자 표기, 전각 문자 사용 같은 변형을 적용합니다. 학습, 검증, 테스트 데이터는 문장 틀을 기준으로 나눕니다. 테스트 데이터를 만든 문장 틀이 학습 데이터에 들어가지 않게 하기 위해서입니다.
- 실제 대화 분포 보완: 공개 한국어 대화 개인정보 데이터셋 KDPII(CC BY 4.0, 개정판 데이터)의 학습 분할을 섞어 짧은 구어체 발화의 분포를 보완합니다. KDPII의 33개 라벨을 다섯 카테고리(고유식별정보, 민감정보, 금융 개인정보, 일반 개인정보, 해당 없음)로 매핑했습니다.
RANK = ["unique_id", "sensitive_personal", "financial", "identifier", "none"]   # 위험한 순서
TIER = {"unique_id": "critical", "sensitive_personal": "critical", "financial": "high",
        "identifier": "medium", "none": "none"}
SLOT_CATEGORY = {"RRN": "unique_id", "ACCOUNT": "financial", "PHONE": "identifier",
                 "DATE": "none", "POSITION": "none"}                             # 변수마다 정해 둔 카테고리 (일부)

def label_from_slots(slot_names):
    """위험도가 가장 높은 변수가 문장의 카테고리를 정한다."""
    cats = [SLOT_CATEGORY[s] for s in slot_names if SLOT_CATEGORY[s] != "none"]
    return min(cats, key=RANK.index) if cats else "none"

category = label_from_slots(["DATE", "RRN", "POSITION"])   # "unique_id"
tier = TIER[category]                                       # "critical"
이 방식으로 만든 데이터 규모는 아래와 같습니다. 예제 과제의 질문 파일에는 질문이 세 개(민감 여부, 종류, 등급) 있고, 학습 행 하나에는 텍스트 한 건과 이 세 질문의 정답이 함께 들어갑니다. Laya는 질문 하나와 그 정답을 학습 아이템 하나로 세므로 아이템 수는 단위 수의 세 배입니다.
| 데이터 | 단위 수 | 구성 |
|---|---|---|
| 학습 | 117,378 | 합성 77,269 + KDPII 학습 분할 40,109 |
| 검증 (학습 중 평가) | 14,820 | 합성 9,809 + KDPII 검증 분할 5,011 |
| 합성 테스트 (학습에 쓰지 않은 틀) | 9,507 | 해당 없음 5,469, 민감정보 2,080, 일반 개인정보 1,113, 고유식별정보 477, 금융 368 |
| KDPII 테스트 (실제 대화 분포) | 4,891 | 공개 벤치마크의 테스트 분할 |
데이터를 만들 때 지킨 원칙도 적어 둡니다. 학습 데이터는 자체 호스팅한 오픈소스 교사 모델의 출력과 코드가 채운 값, 그리고 재배포가 허용된 공개 데이터셋으로만 구성했습니다. 상용 API나 관리형 서비스로 제공되는 모델의 출력은 서비스 약관상 경쟁 모델 학습에 쓸 수 없는 경우가 많으므로 학습 데이터 생성에는 사용하지 않았고, 평가(블라인드 재라벨)에만 사용했습니다. 주민등록번호 같은 고유식별정보는 실제 값을 수집하지 않고 형식만 맞춘 합성값을 사용했습니다.
Step 2. 학습과 서빙을 겸하는 컨테이너
SageMaker는 자체 컨테이너를 활용할 때 학습 작업에서는 컨테이너의 train 명령을, 호스팅에서는 serve 명령을 실행합니다. 하나의 이미지에 두 명령을 모두 넣으면 이미지 하나로 학습과 배포를 끝낼 수 있습니다.
Dockerfile
FROM pytorch/pytorch:2.14.1-cuda12.6-cudnn9-runtime
ENV PYTHONUNBUFFERED=1 PIP_NO_CACHE_DIR=1 HF_HUB_CACHE=/opt/ml/hf-cache TOKENIZERS_PARALLELISM=false
RUN pip install --upgrade pip && pip install "laya[serve]==<버전 고정>" fastapi "uvicorn[standard]"

# ml.g4dn / ml.g5 호스트의 NVIDIA 드라이버(470, CUDA 11.4)는 CUDA 12.6 휠보다 오래돼 GPU를 인식하지 못하고
# 오류 없이 CPU로 폴백합니다. CUDA forward compatibility 패키지를 넣고 serve 스크립트에서 드라이버가 오래됐을 때만 켭니다.
ARG CUDA_COMPAT_DEB=cuda-compat-12-6_560.35.05-0ubuntu1_amd64.deb
RUN apt-get update && apt-get install -y --no-install-recommends curl ca-certificates \
 && curl -fsSL -o /tmp/compat.deb "https://developer.download.nvidia.com/compute/cuda/repos/ubuntu2204/x86_64/${CUDA_COMPAT_DEB}" \
 && dpkg -i /tmp/compat.deb && rm -f /tmp/compat.deb && rm -rf /var/lib/apt/lists/*

WORKDIR /opt/program
COPY app.py serve train train.py questions.json ./
RUN chmod +x /opt/program/serve /opt/program/train
ENV PATH="/opt/program:${PATH}"
EXPOSE 8080
학습 진입점 train.py
SageMaker는 입력 채널을 /opt/ml/input/data/<채널 이름>/에, 하이퍼파라미터를 /opt/ml/input/config/hyperparameters.json에 문자열로 넣어 주고, /opt/ml/model/에 남긴 파일을 model.tar.gz로 묶어 S3에 올립니다. 학습 진입점은 이 규약에 맞춰 입력 데이터와 하이퍼파라미터를 읽어 laya.train.finetune 함수에 전달하면 됩니다.
"""SageMaker 학습 진입점: 컨테이너의 train 명령이 실행합니다."""
import json, os, pathlib, sys, time, traceback
import torch
from laya.train import TrainConfig, finetune, resolve_checkpoint_dir

hp = json.loads(pathlib.Path("/opt/ml/input/config/hyperparameters.json").read_text())
num = lambda k, d, cast=float: cast(hp[k]) if k in hp else d
flag = lambda k, d: str(hp.get(k, d)).lower() in ("1", "true", "yes")

train_rows = "/opt/ml/input/data/train/rows.jsonl"
eval_rows = "/opt/ml/input/data/eval/rows.jsonl"          # 선택: 학습 중 평가용
model_in = "/opt/ml/input/data/model"                     # 선택: 베이스 체크포인트를 S3로 줄 때 (외부망 차단 환경)
out_dir = "/opt/ml/model/laya-multilingual"
out_data = pathlib.Path("/opt/ml/output/data"); out_data.mkdir(parents=True, exist_ok=True)

try:
    if os.path.isdir(model_in) and any(pathlib.Path(model_in).iterdir()):
        model_dir = model_in
    else:
        model_dir = resolve_checkpoint_dir(hp.get("base_model", "convaiinnovations/laya-multilingual"))
    cfg = TrainConfig(
        epochs=num("epochs", 4, int), micro_batch=num("micro_batch", 8, int), grad_accum=num("grad_accum", 4, int),
        encoder_lr=num("encoder_lr", 2.5e-5), head_lr=num("head_lr", 1e-4),
        max_len=num("max_len", 1024, int), head_max_len=num("head_max_len", 256, int),
        amp=flag("amp", True), gradient_checkpointing=flag("gradient_checkpointing", True),
        calib_max=num("calib_max", 400, int), log_every=num("log_every", 50, int),
        eval_data=eval_rows if os.path.exists(eval_rows) else None,
    )
    t0 = time.time()
    summary = finetune(data=train_rows, model_dir=model_dir, output_dir=out_dir, config=cfg,
                       device="cuda" if torch.cuda.is_available() else "cpu")
    summary["train_seconds"] = round(time.time() - t0, 1)
    (out_data / "summary.json").write_text(json.dumps(summary, ensure_ascii=False, indent=1, default=str))
except Exception as e:
    traceback.print_exc()
    pathlib.Path("/opt/ml/output/failure").write_text(f"{type(e).__name__}: {e}")   # 콘솔의 실패 사유에 표시됩니다
    sys.exit(1)
train 스크립트는 exec python /opt/program/train.py 한 줄입니다. 위 코드에서 눈여겨볼 점은 세 가지입니다.
- 베이스 체크포인트 위치. 베이스 체크포인트는 기본적으로 Hugging Face Hub에서 내려받습니다. 외부망이 막힌 VPC 학습 환경에서는 체크포인트를 S3에 올리고
model채널로 넘깁니다. gradient_checkpointing기본값. Laya 자체는 이 값을 지정하지 않으면amp설정을 따라 켭니다. 위 코드는 하이퍼파라미터가 없을 때true를 넘기므로 기본으로 켜집니다. 메모리가 넉넉한 GPU에서는 속도를 위해 Step 3처럼 하이퍼파라미터로false를 넘겨 끕니다.- GPU 확인. 현재 구현은 GPU가 인식되지 않으면 CPU로 학습을 시작해 오류 없이 느려집니다. 운영용으로 쓸 때는 GPU가 없으면 실패하도록 바꾸는 편이 안전합니다.
서빙 앱 예시 app.py
SageMaker 호스팅은 컨테이너의 8080 포트로 GET /ping(상태 확인)과 POST /invocations(추론)를 호출합니다. 모델 파일은 /opt/ml/model/에 풀려 있습니다. Laya의 Router로 체크포인트를 로드합니다. 요청에 texts가 여러 건 담겨 있으면 최대 32건씩 배치로 묶어 추론하고, 한 건이면 단건으로 추론합니다.
"""SageMaker 호환 Laya 추론 서버 (/ping, /invocations)"""
import json, os, pathlib, time
from fastapi import FastAPI, Request, Response
from laya import Router

MODEL_DIR = os.environ.get("SM_MODEL_DIR", "/opt/ml/model")
DEFAULT_MAX_LEN = int(os.environ.get("LAYA_MAX_LEN", "1024"))
QUESTIONS_PATH = os.environ.get("LAYA_QUESTIONS", "/opt/program/questions.json")   # 체크포인트의 질문 파일을 가리키게 합니다

app = FastAPI()
router = Router(models={"multilingual": str(pathlib.Path(MODEL_DIR) / "laya-multilingual")}, preload=True)
questions = json.loads(pathlib.Path(QUESTIONS_PATH).read_text())

@app.on_event("startup")
def warm():
    router.predict("안녕하세요", questions, model="multilingual")   # 첫 요청 지연을 없애는 예열

@app.get("/ping")
def ping():
    return Response(status_code=200)

@app.post("/invocations")
async def invocations(request: Request):
    body = await request.json()
    texts = body["texts"] if "texts" in body else [body["text"]]
    q = body.get("questions") or questions
    max_len = int(body.get("max_len", DEFAULT_MAX_LEN))
    t0 = time.time()
    if len(texts) > 1:
        reqs = [{"state": t, "questions": q, "model": "multilingual", "max_len": max_len} for t in texts]
        results = router.predict_batch(reqs, batch_size=min(32, len(reqs)))
    else:
        results = [router.predict(texts[0], q, model="multilingual", max_len=max_len)]
    return {"results": results, "model": "multilingual", "latency_ms": round((time.time() - t0) * 1000, 1)}
이 앱은 요청 본문의 questions로 질문을 바꿔 보낼 수 있게 열어 두었습니다. 학습하지 않은 질문에는 정해진 동작이 없으므로 운영 환경에서는 이 필드를 받지 않게 막거나 호출 권한을 좁힙니다. 추론은 워커(worker) 프로세스 1개가 요청을 순서대로 실행합니다. 그래서 긴 배치를 처리하는 동안에는 /ping 상태 확인 응답도 그만큼 늦어집니다.
serve 스크립트는 호스트 드라이버 버전을 확인해 필요할 때만 CUDA 호환 라이브러리를 활성화한 뒤 uvicorn app:app --host 0.0.0.0 --port 8080 --workers 1을 실행합니다.
#!/bin/bash
COMPAT_DIR=/usr/local/cuda-12.6/compat
if [ -d "$COMPAT_DIR" ] && [ -r /proc/driver/nvidia/version ]; then
  DRV=$(grep -oE 'Kernel Module +[0-9]+' /proc/driver/nvidia/version | grep -oE '[0-9]+$' | head -1)
  if [ -n "$DRV" ] && [ "$DRV" -lt 560 ]; then
    export LD_LIBRARY_PATH="$COMPAT_DIR${LD_LIBRARY_PATH:+:$LD_LIBRARY_PATH}"
    echo "laya-serve: host driver $DRV < 560, CUDA forward compatibility enabled"
  fi
fi
exec uvicorn app:app --host 0.0.0.0 --port 8080 --workers 1
이미지 빌드와 푸시
export ACCOUNT_ID=$(aws sts get-caller-identity --query Account --output text)
export REGION=ap-northeast-2
export ECR_REPO=${ACCOUNT_ID}.dkr.ecr.${REGION}.amazonaws.com/laya-serve
export TAG=v1

aws ecr create-repository --repository-name laya-serve --region $REGION
aws ecr get-login-password --region $REGION | docker login --username AWS --password-stdin ${ACCOUNT_ID}.dkr.ecr.${REGION}.amazonaws.com
docker build --platform linux/amd64 -t laya-serve:$TAG serving/laya-serve
docker tag laya-serve:$TAG $ECR_REPO:$TAG
docker push $ECR_REPO:$TAG
Apple Silicon 맥에서 빌드할 때는 --platform linux/amd64를 빠뜨리지 않습니다.
Step 3. SageMaker 학습 작업 실행
학습 행을 S3에 올리고 CreateTrainingJob API를 호출합니다. 입력 채널은 train(필수)과 eval(선택)이고, 하이퍼파라미터는 모두 문자열로 넘깁니다.
import boto3, time

REGION = "ap-northeast-2"
sm = boto3.client("sagemaker", region_name=REGION)
s3 = boto3.client("s3", region_name=REGION)

job = f"laya-pii-{time.strftime('%Y%m%d-%H%M%S')}"
prefix = f"training/{job}"
s3.upload_file("data/train_rows.jsonl", BUCKET, f"{prefix}/train/rows.jsonl")
s3.upload_file("data/valid_rows.jsonl", BUCKET, f"{prefix}/eval/rows.jsonl")

def channel(name):
    return {"ChannelName": name, "InputMode": "File",
            "DataSource": {"S3DataSource": {"S3DataType": "S3Prefix", "S3DataDistributionType": "FullyReplicated",
                                            "S3Uri": f"s3://{BUCKET}/{prefix}/{name}/"}}}

sm.create_training_job(
    TrainingJobName=job,
    AlgorithmSpecification={"TrainingImage": f"{ECR_REPO}:{TAG}", "TrainingInputMode": "File"},
    RoleArn=ROLE_ARN,
    InputDataConfig=[channel("train"), channel("eval")],
    OutputDataConfig={"S3OutputPath": f"s3://{BUCKET}/{prefix}/output/", "KmsKeyId": KMS_KEY_ID},
    # 이 글의 측정은 ml.g6e.12xlarge로 했지만 GPU는 1장만 씁니다. 같은 L40S 1장인 ml.g6e.xlarge나 ml.g6e.2xlarge로 충분합니다.
    ResourceConfig={"InstanceType": "ml.g6e.12xlarge", "InstanceCount": 1, "VolumeSizeInGB": 100},
    StoppingCondition={"MaxRuntimeInSeconds": 12 * 3600},
    HyperParameters={"epochs": "3", "micro_batch": "16", "grad_accum": "2", "calib_max": "3000",
                     "amp": "true", "gradient_checkpointing": "false", "log_every": "200"},
    Environment={"HF_HUB_CACHE": "/opt/ml/hf-cache", "TOKENIZERS_PARALLELISM": "false"},
    Tags=[{"Key": "Project", "Value": "laya-decision-model"}],
)
print("model artifact:", f"s3://{BUCKET}/{prefix}/output/{job}/output/model.tar.gz")
진행 상황은 CloudWatch Logs의 /aws/sagemaker/TrainingJobs 로그 그룹이나 다음 명령으로 확인합니다.
aws sagemaker describe-training-job --training-job-name $JOB --region ap-northeast-2 \
  --query '{status:TrainingJobStatus,secondary:SecondaryStatus,seconds:TrainingTimeInSeconds}'
하이퍼파라미터와 학습 결과
| 항목 | 값 | 비고 |
|---|---|---|
| 베이스 모델 | convaiinnovations/laya-multilingual |
mmBERT-base 인코더 + 결정 헤드, 3억 2천만 파라미터 |
| epochs / micro_batch / grad_accum | 3 / 16 / 2 | 유효 배치 32 |
| encoder_lr / head_lr | 2.5e-5 / 1e-4 | Laya 기본값 |
| max_len / head_max_len | 1,024 / 256 | 전체 입력 토큰 상한과 질문 헤드 토큰 예산 (Laya 다국어 체크포인트 기본값) |
| amp / gradient_checkpointing | true / false | 메모리 여유가 있어 체크포인팅은 하이퍼파라미터로 false를 넘겨 끔 |
| calib_max | 3,000 | 학습 뒤 확률 보정(온도)에 쓰는 보류 아이템 수 |
| 학습 아이템 | 349,134개 | 117,378 단위 × 질문 3개, 보정용 3,000개 제외 |
| 학습 시간 / 비용 | 3시간 27분 / 약 56달러 | ml.g6e.12xlarge, 시간당 16.13달러, GPU 1장만 사용 |
| 처리 속도 | 약 80 items/s | |
| 에폭별 손실 | 0.150, 0.031, 0.006 | |
| 컨테이너 안 검증 정확도 | 0.9945 | 검증 44,460 아이템 |
| 보정 온도 | [1.0, 1.0, 1.0] | 보정 분할 3,000개에 오답이 없었고, 온도는 기본값 1.0으로 저장됨. 이 학습에서는 보정이 확률을 바꾸지 않음 |
Laya의 학습 함수는 손실 함수(RLCD, 엄밀 적정 점수 규칙을 보상으로 쓰는 강화학습)와 보정 단계를 내장하고 있어, 호출하는 쪽은 데이터와 하이퍼파라미터만 넘기면 됩니다. 학습이 끝나면 /opt/ml/output/data/summary.json에 에폭별 손실과 검증 정확도가 남고, model.tar.gz 안에 laya-multilingual/ 폴더(가중치, 토크나이저, questions.json, 보정 설정)가 들어갑니다.
학습은 GPU 1장만 쓰므로 ml.g6e.12xlarge가 필요하지 않습니다. ml.g6e.xlarge와 ml.g6e.2xlarge도 같은 L40S GPU 1장을 씁니다. 학습 시간이 비슷하다면 비용은 시간당 단가 비율만큼 줄어듭니다.
Step 4. 실시간 엔드포인트 배포
배포는 SageMaker 모델 생성, 엔드포인트 구성, 실시간 엔드포인트 생성의 세 단계를 거칩니다. 같은 이름의 엔드포인트가 이미 있으면 새 엔드포인트 구성으로 UpdateEndpoint를 호출해 무중단으로 교체합니다.
import boto3, time

REGION = "ap-northeast-2"
sm = boto3.client("sagemaker", region_name=REGION)

ENDPOINT = "laya-pii-filter"
stamp = time.strftime("%Y%m%d-%H%M%S")
model_name = f"{ENDPOINT}-{stamp}"
config_name = f"{ENDPOINT}-cfg-{stamp}"

sm.create_model(
    ModelName=model_name, ExecutionRoleArn=ROLE_ARN,
    PrimaryContainer={
        "Image": f"{ECR_REPO}:{TAG}",
        "ModelDataUrl": MODEL_DATA_S3_URI,            # 학습 작업이 남긴 model.tar.gz
        "Environment": {
            "LAYA_MAX_LEN": "1024",
            # 이미지에 들어 있는 기본 질문 파일 대신 체크포인트에 저장된 질문 파일을 읽게 합니다
            "LAYA_QUESTIONS": "/opt/ml/model/laya-multilingual/questions.json",
        },
    },
)
sm.create_endpoint_config(
    EndpointConfigName=config_name,
    ProductionVariants=[{
        "VariantName": "AllTraffic", "ModelName": model_name,
        "InstanceType": "ml.g6e.2xlarge", "InitialInstanceCount": 1,     # 운영은 2 이상 (SageMaker가 가용 영역에 분산)
        "ContainerStartupHealthCheckTimeoutInSeconds": 1200,            # 체크포인트 로드와 예열 시간을 고려
        "ModelDataDownloadTimeoutInSeconds": 1200,
    }],
)
try:
    sm.describe_endpoint(EndpointName=ENDPOINT)
    exists = True
except sm.exceptions.ClientError as e:
    if "Could not find endpoint" not in e.response["Error"]["Message"]:
        raise                                    # 권한 오류나 스로틀링을 '엔드포인트 없음'으로 처리하지 않습니다
    exists = False
if exists:
    sm.update_endpoint(EndpointName=ENDPOINT, EndpointConfigName=config_name)   # 무중단 교체
else:
    sm.create_endpoint(EndpointName=ENDPOINT, EndpointConfigName=config_name)
sm.get_waiter("endpoint_in_service").wait(EndpointName=ENDPOINT)
이 글의 환경에서는 UpdateEndpoint 호출부터 InService까지 4분 36초가 소요되었고, 교체 중에도 기존 인스턴스가 응답해 중단은 없었습니다.
배포 뒤 확인할 것
questions없이 호출했을 때 응답의 카테고리 선택지가 학습 때와 같은 다섯 개인지 확인합니다. 환경 변수LAYA_QUESTIONS가 빠지면 이미지의 기본 질문 파일이 쓰여 학습하지 않은 선택지가 섞일 수 있습니다.- CloudWatch
/aws/sagemaker/Endpoints네임스페이스의GPUMemoryUtilization이 0보다 큰지, 컨테이너 로그에The NVIDIA driver on your system is too old경고가 없는지 확인합니다. GPU 폴백이 발생하면 오류 없이 지연만 수십 배 증가할 수 있으므로 이 두 가지를 확인하지 않으면 지연 지표를 통해서야 문제를 뒤늦게 발견할 수 있습니다.GPUUtilization은 1분에 한 번 기록되는 순간값이라 부하가 짧으면 GPU를 사용하더라도 0으로 표기될 수 있습니다. - 학습에 쓰지 않은 테스트 세트 일부를 엔드포인트로 보내 로컬 예측과 비교합니다. 이 글에서는 128건을 보냈을 때 이진 판정과 카테고리 불일치 0건, 민감 확률 최대 차이 0.0007이었습니다.
롤백
UpdateEndpoint는 이전 엔드포인트 구성을 지우지 않으므로 이름만 알면 바로 되돌릴 수 있습니다.
aws sagemaker list-endpoint-configs --name-contains laya-pii-filter-cfg --sort-by CreationTime --sort-order Descending \
  --region ap-northeast-2 --query 'EndpointConfigs[].EndpointConfigName'
aws sagemaker update-endpoint --endpoint-name laya-pii-filter --endpoint-config-name <이전 구성 이름> --region ap-northeast-2
aws sagemaker wait endpoint-in-service --endpoint-name laya-pii-filter --region ap-northeast-2
Step 5. 호출과 결정 규칙
invoke_endpoint로 엔드포인트에 텍스트 목록을 JSON으로 보내면 건마다 questions.json에 기재된 세 질문의 답이 돌아옵니다. 아래는 합성 문장 다섯 건을 보냈을 때 실제로 돌아온 응답 가운데 첫 건을 필요한 필드만 남겨 옮긴 것입니다.
- 호출 예시
import json, boto3

rt = boto3.client("sagemaker-runtime", region_name="ap-northeast-2")
texts = [
    "내일 2025년 1월 9일까지 접수해야 하는 신규 직원 보험 가입 서류에서 650316-1386151 항목이 누락돼 있어 차장께서 확인을 요청하셨습니다.",
    "결재 대기중인 사원의 신용점수 784점 기록을 확인해 주세요. 지급 예정 계좌 농 협 0 0 0 - 0 0 0 0 - 0 0 0 0 - 0 0와 일치하는지 재확인 필요합니다.",
    "사거리에 밀알교회 다니지 않았어? 거기 청년부 모임 요즘도 나가?",
    "redis-cli -h 127.0.0.1 -p 6379 ping 결과가 PONG인데 애플리케이션에서는 연결이 안 됩니다. 어디를 봐야 할까요?",
    "가나다생명 2023년 3분기 영업이익 8006억원 공시(DART 게재) 수치를 참고해 주세요. 세부 내역은 cs@example.com으로 문의 바랍니다.",
]
res = rt.invoke_endpoint(EndpointName="laya-pii-filter", ContentType="application/json",
                         Body=json.dumps({"texts": texts, "max_len": 1024}))
body = json.loads(res["Body"].read())- 응답 예시
{
  "results": [
    {
      "answers": {
        "sensitive": {"type": "noul", "noul": 1.0, "confidence": 1.0},
        "category": {
          "type": "choice", "choice": "unique_id",
          "probabilities": {"unique_id": 1.0, "sensitive_personal": 0.0, "financial": 0.0, "identifier": 0.0, "none": 0.0},
          "confidence": 1.0
        },
        "tier": {"type": "choice", "choice": "critical",
                 "probabilities": {"critical": 1.0, "high": 0.0, "medium": 0.0, "none": 0.0}}
      },
      "usage": {"input_tokens": 517, "state_tokens": 63, "truncated": false}
    },
    "...(나머지 4건)"
  ],
  "model": "multilingual",
  "latency_ms": 25.0
}sensitive.noul이 개인정보가 들어 있을 확률, category.probabilities가 종류별 확률, usage.truncated가 입력이 1,024토큰을 넘어 잘렸는지 여부입니다. 다섯 개 입력 문장에 대한 판정 결과는 다음과 같습니다.
| 입력 (합성 문장) | 민감 확률 | 카테고리 | 등급 | 결정 |
|---|---|---|---|---|
| 주민등록번호 모양의 값이 포함된 보험 서류 요청 | 1.00 | unique_id | critical | BLOCK |
| 신용점수와 띄어 쓴 계좌번호가 포함된 결재 요청 | 1.00 | financial | high | BLOCK |
| 상대방에게 특정 교회에 다니는지 묻는 대화 | 1.00 | sensitive_personal | critical | BLOCK |
| 루프백 주소만 있는 redis-cli 질문 | 0.00 | none | none | ALLOW |
| 공시된 영업이익과 회사 대표 메일만 포함된 문의 | 0.00 | none | none | ALLOW |
확률을 결정으로 바꾸는 규칙
모델은 각 선택지에 대한 확률만 반환하며, 이를 바탕으로 ALLOW, BLOCK, REVIEW 여부를 결정하는 로직은 호출하는 쪽(예: LLM 게이트웨이)에서 구현합니다. 질문이 두 개 이상이면 확률을 기반으로 서로 교차 검증할 수 있다는 점이 Decision Model의 장점입니다. 민감 여부 질문과 카테고리 질문이 어긋나거나(민감 확률은 0.5 이상인데 카테고리가 none, 또는 그 반대) 카테고리 최대 확률이 0.6 미만이면 사람 검토로 보내고, 나머지는 민감 확률 0.5를 기준으로 BLOCK과 ALLOW를 가릅니다. 응답을 기다리는 동기 요청에서는 사람이 그 자리에서 검토할 수 없으므로, REVIEW일 때 요청을 차단하고 검토 대기열에 등록할지, 아니면 더 큰 모델에 추가 판정을 요청할지 사전에 결정해야 합니다.
CRITICAL = {"unique_id", "sensitive_personal"}

def decide(answers, p_block=0.5, p_margin=0.6):
    p_sensitive = answers["sensitive"]["noul"]
    category = answers["category"]["choice"]
    max_p = max(answers["category"]["probabilities"].values())
    if (p_sensitive >= p_block) != (category != "none") or max_p < p_margin:
        return {"decision": "REVIEW", "category": category, "tier": answers["tier"]["choice"]}
    decision = "BLOCK" if p_sensitive >= p_block else "ALLOW"
    return {"decision": decision, "category": category, "tier": answers["tier"]["choice"]}

for text, r in zip(texts, body["results"]):
    d = decide(r["answers"])
    print(d["decision"], d["category"], d["tier"], text[:30])
KDPII 테스트에서 REVIEW로 넘어간 비율은 0.2%였습니다. 카테고리 최대 확률 대신 응답에 함께 오는 confidence를 기준으로 쓰면 결과가 조금 달라지므로, 임계값을 정할 때 어느 값을 기준으로 삼았는지, 호출 측과 평가 코드가 같은 값을 쓰는지 확인합니다.
엔드포인트 호출이 실패하거나 정해진 시간 안에 응답하지 않을 때의 동작도 호출 측이 정합니다. 개인정보 필터라면 판정을 받지 못한 요청은 통과시키지 않는 것이 기본입니다. 응답의 usage.truncated가 참이면 잘린 부분은 검사되지 않았으므로 ALLOW로 처리하지 않고 텍스트를 나눠 다시 보냅니다.
임계값 정하기
임계값은 학습에 쓰지 않은 검증 분할에서 고릅니다. 민감 확률 기준은 0.5로 두었습니다. 이 모델이 반환하는 확률은 대부분 0이나 1에 근접하게 있어 기준을 옮겨도 판정이 거의 바뀌지 않습니다. REVIEW를 가르는 카테고리 최대 확률 기준(여기서는 0.6)은 검증 분할에서 REVIEW 비율과 자동 판정 정확도를 함께 보며 정합니다. 기준을 올리면 REVIEW가 늘고 자동 판정 정확도가 오르므로, 운영에서 사람이 감당할 REVIEW 비율(예: 1% 이하)을 먼저 정하고 그 안에서 정확도가 가장 높은 값을 선택합니다. 개인정보 판단 모델에서는 0.6에서 KDPII 테스트 REVIEW 0.2%, 자동 판정 정확도 98.6%였습니다. 선택한 값은 테스트 세트에 한 번만 적용해 보고하고, 테스트 세트를 보면서 다시 고치지 않습니다.
모델 범위 밖은 규칙으로 보완
Decision Model은 학습 범위 안에서는 안정적이지만 범위 밖 입력에는 정해진 동작이 없습니다. 예제 과제에서 API 키, 토큰, 개인키, 접속 문자열 같은 인증정보는 개인정보보호법상 개인정보가 아니므로 모델의 선택지에 넣지 않았는데, 그렇다고 LLM으로 흘려보낼 수는 없습니다. 이런 항목은 공개된 키 형식(AWS, GitHub, Slack 등의 접두어), PEM 블록, JWT 형식, password= 같은 키-값 패턴을 탐지하는 정규식 규칙을 호출 측에 두어 모델 판정과 무관하게 막습니다. 자리표시자(${VAR}, os.environ)와 문서 예시 키는 제외합니다. 모델이 할 일과 규칙이 할 일을 가르면 모델의 학습 범위를 좁게 유지할 수 있습니다.
final = secret_rule.apply(text, decide(r["answers"])) # secret_rule은 위 정규식을 묶은 호출 측 모듈입니다 (이 글에는 싣지 않았습니다). 비밀값 리터럴이 있으면 BLOCK / credential / HIGH로 덮어씀개인정보 판정 과제 결과 예시와 다른 방법과 비교
세 가지 평가 세트와 운영 전환 기준
평가에는 성격이 다른 세 가지 세트를 사용합니다. 학습에 쓰지 않은 문장 틀로 만든 합성 테스트는 생성기 분포 안에서의 상한을 보여 줍니다. KDPII 테스트는 공개 벤치마크의 테스트 분할로 짧은 구어체 대화에서의 수치를 보여 주지만, 같은 데이터셋의 학습 분할을 학습에 넣었으므로 처음 보는 분포에서의 성능은 아닙니다. 학습 데이터와 무관하게 따로 쓴 기준 검증 세트가 처음 보는 문장에서의 동작과 약점의 방향을 보여 줍니다. 다만 세 평가 세트의 결과만으로 실제 운영 환경에서의 성능을 보장할 수는 없습니다. 운영 환경에 적용하기 전에 고객 환경에서 수집한 실제 샘플로 성능을 따로 검증해야 합니다. 평가 전용 세트는 문장 틀을 설계하기 전에 먼저 작성하고 고정해 둡니다. 오류를 보고 문장 틀을 보강한 뒤 같은 세트로 다시 측정하면 그 세트는 더 이상 독립적인 추정치가 아니기 때문입니다. 베이스라인(제로샷 Laya, 관리형 필터, LLM 프롬프트)은 첫 학습 전에 같은 세트로 측정해 두어야 개선 폭을 확인할 수 있습니다.
운영 전환 여부는 미리 정한 기준으로 판단합니다. 개인정보 판단 모델의 기준은 KDPII 테스트 정확도가 이전 모델 이상일 것, 같은 세트에서 가장 위험한 등급(CRITICAL)의 새 미탐이 없을 것, 합성 테스트 정확도가 99% 이상일 것, 수십 문장 규모로 따로 작성한 함정 문장 세트의 점수가 떨어지지 않을 것이었습니다. 새 모델이 한 조건이라도 충족하지 못하면 운영에 적용하지 않고 데이터 보강 단계로 돌아갑니다.
정확도
합성 테스트는 학습에 쓰지 않은 문장 틀로 만든 세트, KDPII 테스트는 공개 벤치마크의 테스트 분할(학습에 쓴 데이터셋의 다른 분할), 기준 검증 세트는 개인정보보호법 조항별로 긍정 문장과 같은 어휘의 부정 문장을 짝지어 따로 쓴 1,000건입니다. 기준 검증 세트는 평가 전용 LLM이 명세서를 받아 썼고 학습에는 쓰지 않았습니다. 다른 계열의 LLM이 다시 라벨링했을 때 962건이 작성 라벨과 같았습니다. 표의 기준 검증 세트 행은 모델 판정에 호출 측 비밀값 규칙을 더한 결과이며, 모델만으로는 이진 정확도가 0.77입니다.
| 세트 | 건수 | 이진 정확도 (Wilson 95%) | 재현율 | 오탐률 | CRITICAL 재현율 |
|---|---|---|---|---|---|
| 합성 테스트 | 9,507 | 0.9954 (0.9938~0.9966) | 4,018/4,038 (99.5%) | 24/5,469 (0.44%) | 2,539/2,557 (99.3%) |
| KDPII 테스트 (학습 분할을 학습에 사용) | 4,891 | 0.9849 (0.9810~0.9879) | 773/818 (94.5%) | 29/4,073 (0.71%) | 102/102 (100%) |
| 기준 검증 세트 (처음 보는 문장, 모델 + 규칙) | 1,000 | 0.7890 (0.7626~0.8132) | 494/555 (89.0%) | 150/445 (33.7%) | 246/279 (88.2%) |
KDPII 테스트에서 개인정보를 찾고 카테고리까지 맞힌 건수는 고유식별정보 58/58, 민감정보 43/44, 금융 개인정보 152/152, 일반 개인정보 520/564입니다. 민감정보 1건은 개인정보로는 판정했지만 카테고리를 다르게 답했습니다. 놓친 45건은 대부분 짧은 이름과 호칭, 희귀한 이름처럼 정책 해석이 갈리는 문장이고, 잘못 막은 29건은 종교 단어가 든 일반 질문문과 지명, 호칭 문장입니다. CRITICAL 102건은 모두 탐지했습니다.
기준 검증 세트는 학습 데이터와 무관하게 쓴 문장이라 수치가 가장 낮습니다. 서술형 민감정보(정치 성향, 임신, 치료 서술)의 미탐과 주민등록번호 모양의 다른 번호, 민감 어휘의 일반 용법 오탐에서 나온 값이고, 임계값 조정이 아니라 데이터 보강으로 풀어야 할 유형입니다. 오류 유형을 겨냥해 판단 기준과 합성 데이터를 두 차례 보강해 재학습한 결과는 아래 네 가지 방식 벤치마크 표에 있습니다.
같은 KDPII 테스트에서 다른 방식과 비교한 값입니다. 이 세트는 4,891건 가운데 4,073건이 개인정보 없음이라 전부 통과시켜도 이진 정확도가 83.3%입니다. 그래서 이진 정확도 하나로 비교하지 않고 재현율과 오탐률을 함께 적었습니다. 추가 학습한 Laya는 KDPII의 학습 분할을 학습에 사용했지만 나머지 방식은 이 데이터를 학습에 사용하지 않았습니다. 모든 방식을 같은 조건에서 평가한 것은 아니라는 점에 유의해야 합니다.
| 판정 방식 | 이진 정확도 | 재현율 | 오탐률 | CRITICAL 재현율 |
|---|---|---|---|---|
| 전부 통과 (기준선) | 83.3% | 0% | 0% | 0% |
| 추가 학습 전 Laya (제로샷) | 19.6% | 98.0% | 96.1% | 95.1% |
| Amazon Bedrock Guardrails PII 필터 + 한국 식별자 정규식 | 90.9% | 79.6% | 6.8% | 58.8% |
| Claude Sonnet 5 (Amazon Bedrock) + 정책 프롬프트, 평가 전용 | 92.3% | 88.9% | 7.1% | 93.1% |
| 추가 학습한 Laya (이 글, KDPII 학습 분할 포함) | 98.5% | 94.5% | 0.7% | 100% |
제로샷 Laya는 거의 모든 발화를 개인정보로 판정해 이 과제에서는 활용할 수 없었고, 추가 학습 뒤에는 같은 세트에서 재현율과 오탐률이 모두 가장 좋았습니다. Amazon Bedrock Guardrails는 이 측정(2026년 10월)에서 주민등록번호와 금융 정보 같은 구조화된 식별자는 탐지했지만 건강, 종교 같은 서술형 민감정보는 탐지하지 못했습니다.
네 가지 방식 벤치마크
KDPII 비교는 Laya만 학습 분할을 본 조건이라, 어느 방식도 본 적 없는 398건으로 다시 비교했습니다. 비교 대상과 계열이 다른 오픈 웨이트 LLM(DeepSeek V3.2)이 판단 기준 문서만 보고 쓴 문장으로, 개인정보가 있는 문장이 158건, 없는 문장이 240건입니다. 없는 문장 가운데 100건은 개인정보처럼 보이는 닮은꼴 문장입니다. Laya는 판단 기준과 합성 데이터를 두 차례 보강해 재학습한 모델이고, 이 398건은 학습에 쓰지 않았습니다. Jev와 Strands Decider에는 판단 기준을 한 문단으로 요약해 전달했고, LLM에는 기준 문서 전체를 프롬프트로 주었습니다. 전달한 기준의 양이 달라 같은 입력 조건의 비교는 아니며, 더 자세한 기준이나 예시를 주면 결과가 달라질 수 있습니다.
Strands Decider(E4B, 2B)와 Qwen3(32B, 235B)는 학습 없이 GPU 인스턴스에 직접 올려 측정했고, Qwen3-235B는 4비트 양자화본을 썼습니다. Claude Haiku 5.5는 같은 기준 문서를 주고 Amazon Bedrock으로 호출했고, 그 응답은 평가에만 썼습니다.
| 방식 | 놓침 (158건 중) | 잘못 막음 (240건 중) | 건당 판정 지연 시간 | 판정 100만 건당 비용 |
|---|---|---|---|---|
| 추가 학습한 Laya (SageMaker 엔드포인트, ml.g4dn.xlarge) | 2건 | 3건 | 35~39 ms | 건수와 무관 (인스턴스 1대 월 약 661달러) |
| Jev 1.14, 학습 없이 (호스팅 API) | 4건 | 20건 | 약 400 ms | 토큰 과금 |
| Strands Decider E4B, 학습 없이 (ml.g5.xlarge) | 7건 | 17건 | 약 130 ms | 건수와 무관 (인스턴스 1대 월 약 1,260달러) |
| Strands Decider 2B, 학습 없이 (ml.g5.xlarge) | 53건 | 28건 | 약 90 ms | 건수와 무관 (인스턴스 1대 월 약 1,260달러) |
| Qwen3-235B + 기준 프롬프트 (SGLang, ml.g6e.12xlarge, 4비트 양자화본) | 5건 | 7건 | 220~300 ms | 건수와 무관 (인스턴스 1대 월 약 11,800달러) |
| Qwen3-32B + 기준 프롬프트 (SGLang, ml.g6e.12xlarge) | 8건 | 13건 | 약 700 ms | 건수와 무관 (인스턴스 1대 월 약 11,800달러) |
| Claude Haiku 5.5 + 기준 프롬프트 (Amazon Bedrock), 평가 전용 | 7건 | 1건 | 약 1,250 ms | 약 450달러 |
| 보강 전 Laya | 4건 | 49건 | 35~39 ms | 건수와 무관 (인스턴스 1대 월 약 661달러) |
3억 2천만 파라미터인 Laya를 GPU 1장에서 추가 학습한 결과가, 학습 없이 쓴 Jev나 수백 배 큰 LLM(Qwen3-235B, Claude Haiku 5.5)에 기준 프롬프트를 준 방식과 비슷한 수준의 오류를 보였습니다. Strands Decider 2B처럼 오류가 뚜렷하게 많은 방식도 있었습니다. 평가 데이터가 398건이라 몇 건의 오류 차이로 우위를 판단하기는 어렵습니다. 이 세트는 보강한 유형과 같은 유형 목록으로 만들었고 정답을 사람이 다시 검수하지 않았으므로, 전혀 다른 유형의 문장에서는 결과가 다를 수 있습니다.
차이가 뚜렷한 것은 지연과 장비입니다. Laya는 T4 GPU 1장(ml.g4dn.xlarge)에서 판정 1건을 35~39 ms에 처리합니다. Qwen3를 SGLang으로 띄우는 데에는 48GB GPU 4장(ml.g6e.12xlarge, 월 약 11,800달러)이 필요했고 판정 1건에 220~700 ms가 걸렸습니다. Claude Haiku 5.5는 판정 1건에 약 1,250 ms가 걸렸고 100만 건에 약 450달러가 듭니다. Laya를 자체 호스팅하면 요청 건수나 토큰 수와 무관하게 인스턴스 비용만 들고, 판정할 텍스트도 고객 AWS 계정 안에서 처리합니다.
보강 전 Laya는 같은 398건에서 53건을 틀렸고 두 차례 재학습 뒤 5건으로 줄었습니다. 이 수준은 재학습 루프를 거쳐 얻은 결과입니다. 표의 지연은 Laya와 SGLang은 서버 안에서, Jev와 Haiku는 호출한 쪽에서 측정한 값입니다. 월 비용은 서울 리전 SageMaker 온디맨드 단가에 730시간을 곱한 값이고, Haiku의 건당 비용은 호출을 측정한 도쿄 리전의 온디맨드 단가와 응답에 기록된 토큰 수(입력 약 3,500, 출력 약 120)로 계산했습니다.
자체 배포가 가능한 방식은 필요한 장비가 크게 다릅니다. 아래는 서울 리전 SageMaker에서 직접 올려 확인한 구성이고, 월 고정비는 인스턴스 1대를 730시간 가동한 값입니다.
| 방식 | 인스턴스 | GPU 구성 | 월 고정비 | 확인한 사실 |
|---|---|---|---|---|
| 추가 학습한 Laya | ml.g4dn.xlarge | T4 16GB 1장 | 약 661달러 | 요청을 한 건씩 보낼 때 초당 18~25건 |
| Strands Decider 2B | ml.g5.xlarge | A10G 24GB 1장 | 약 1,260달러 | GPU 메모리 약 8GB 사용. T4에서는 판정 1건에 약 400 ms |
| Strands Decider E4B | ml.g5.xlarge | A10G 24GB 1장 | 약 1,260달러 | GPU 메모리 약 18GB 사용. T4 16GB에는 올라가지 않음 |
| Qwen3-32B (SGLang) | ml.g6e.12xlarge | L40S 48GB 4장 | 약 11,800달러 | A10G 24GB 4장(ml.g5.12xlarge)에는 올라가지 않음 |
| Qwen3-235B, 4비트 양자화본 (SGLang) | ml.g6e.12xlarge | L40S 48GB 4장 | 약 11,800달러 | GPU 1장당 약 43GB 사용, 서버 기동에 16분. 원본은 약 470GB |
Laya multilingual 모델의 인스턴스별 지연과 처리량 비교
| 구성 | 단건 지연 (서버 기준) | 배치 처리량 | 시간당 비용 (서울, 온디맨드) |
|---|---|---|---|
| ml.g6e.2xlarge (L40S) | p50 32.7 ms, p95 34.8 ms, p99 36.6 ms | 32건 배치 호출당 590 ms, 초당 약 48건 | 3.45달러 |
| ml.g4dn.xlarge (T4), 운영 권장 | p50 약 37 ms, p95 약 69 ms | 길이 정렬 배치 시 초당 약 32건 | 0.906달러 |
| CPU ml.m5.large | 1,800~2,400 ms (장문 약 11,600 ms) | 배치 호출 시간 초과와 메모리 부족 | 0.142달러 |
인스턴스 벤치마크는 같은 컨테이너 이미지와 같은 크기의 이전 체크포인트로 측정했습니다. 표의 ml.g6e.2xlarge 행만 이 글의 최종 모델로 따로 측정한 값이고, 같은 벤치마크에서 ml.g6e.2xlarge의 단건 지연은 p50 20.2 ms였습니다. 그래서 첫 행의 32.7 ms를 다른 행의 값과 직접 비교할 수는 없습니다. 인스턴스 1대에 클라이언트 1개가 길이가 섞인 요청을 하나씩 보낸 직렬 호출이고, 지연은 컨테이너가 측정한 모델 실행 시간이라 네트워크 왕복과 동시 요청의 대기 시간은 포함되어 있지 않습니다. ml.g4dn.xlarge의 판정 1,000건은 ml.g6e.2xlarge와 모두 같았습니다. 모델 크기가 3억 2천만 파라미터라 GPU 메모리 16 GB인 T4로 충분하며, CPU 인스턴스는 모델을 올릴 수는 있어도 실시간 필터에는 맞지 않습니다. 단가는 SageMaker 요금 페이지의 2026년 10월 서울 리전 온디맨드 값입니다.
장단점과 적용 가이드
개인정보 판단 모델 기준 다른 방식과의 선택 참고
| 요구 사항 | 권장 |
|---|---|
| 영어 중심 PII 탐지와 마스킹, 트래픽이 적고 운영 부담을 최소로 | Amazon Bedrock Guardrails |
| 판단 기준이 자주 바뀌고 호출 수가 적으며 판단 이유 설명문이 필요 | LLM + 정책 프롬프트 |
| 선택지가 고정된 판단을 대량으로, 수십 ms 안에, 데이터 반출 없이 | 자체 Decision Model (이 글) |
| 값의 위치를 찾아 가려야 함 | 토큰 분류 모델 또는 Guardrails 마스킹을 Decision Model과 조합 |
장점
- 건당 판정 시간이 수십 ms 수준이므로, LLM 호출 전후의 필터링 단계에 추가하더라도 전체 응답 지연에 미치는 영향을 최소화할 수 있습니다.
- 비용이 인스턴스 시간으로 고정됩니다. 요청 건수나 입력 길이가 증가하더라도 인스턴스 운영 비용은 동일하며, 처리량과 응답 지연에만 영향을 미칩니다. ml.g4dn.xlarge 2대(가용 영역 2곳)로 월 약 1,323달러이고, 사용률 60% 기준으로 하루 약 240만 건을 처리할 수 있습니다(단건 서버 지연 평균 42 ms에 트래픽이 하루 종일 고르다고 가정한 상한).
- 판정할 텍스트가 계정 밖으로 나가지 않습니다. 학습 데이터와 추론 요청은 고객 계정의 S3와 SageMaker 안에서만 처리됩니다. 컨테이너가 베이스 체크포인트를 받으러 Hugging Face Hub에 접속하는 점은 아래 주의할 점에 적었습니다.
- 질문 여러 개를 교차 검증해 답이 어긋나는 건을 REVIEW로 넘길 수 있습니다.
- 한국어 도메인에 맞춰 재학습할 수 있습니다. 문장 틀을 더하고 다시 학습하는 데 학습 작업 3시간 반과 약 56달러면 됩니다(교사 모델로 문장 틀을 생성하는 시간은 별도).
단점과 주의할 점
- 텍스트를 생성하지도 스팬을 찾지도 않으므로 마스킹은 할 수 없습니다. 마스킹이 필요하면 토큰 분류 모델이나 Bedrock Guardrails의 마스킹 기능과 조합합니다.
- 입력은 질문을 포함해 1,024토큰까지입니다. 넘는 부분은 잘리므로 긴 문서는 나눠 보내고 응답의
usage.truncated와usage.state_tokens_dropped를 확인합니다. 잘린 부분은 검사되지 않으므로truncated가 참인 응답은 ALLOW로 쓰지 않습니다. 인코더 자체는 8,192토큰까지 지원하므로 필요하면max_len을 늘려 재학습할 수 있습니다. - 학습 범위 밖 입력에는 정해진 동작이 없습니다. 인증정보처럼 모델에 가르치지 않은 항목은 규칙으로 보완합니다.
- 성능은 학습 데이터의 품질에 따라 달라집니다. 합성 데이터와 KDPII 학습 분할로 만든 이 모델은 KDPII 테스트에서 94.5%, 처음 보는 문장으로 쓴 기준 검증 세트에서 89%의 재현율을 보였고 기준 검증 세트의 오탐률은 33.7%였습니다. 판단 기준과 합성 데이터를 두 차례 보강해 재학습하자 처음 보는 398건에서 오류가 53건에서 5건으로 줄었습니다. 그래서 운영 전에 고객 환경의 실제 샘플 1~2천 건으로 재측정하고 문장 틀을 보강하는 반복이 필요합니다.
- 트래픽이 적으면 고정비가 더 비쌉니다. ml.g4dn.xlarge 2대의 월 1,323달러와 비교한 계산 예입니다. 정책 프롬프트를 포함해 입력 2,000토큰을 100만 토큰당 0.2달러인 LLM에 보내면 100만 건에 약 400달러라, 월 330만 건 아래에서는 LLM 호출이 더 비용효율적입니다. 그 위로는 요청이 늘어도 비용이 같은 자체 모델이 유리합니다.
- 이 글의 서빙 컨테이너는 처음 기동할 때 Hugging Face Hub에 접속해 쓰지 않는 다른 Laya 체크포인트까지 내려받고, 다시 기동할 때도 리비전을 확인하러 접속합니다. 외부망이 막힌 환경에서는 필요한 파일을 이미지에 넣고
HF_HUB_OFFLINE=1로 기동되는지 먼저 확인합니다. 이미지를 다시 빌드할 때는laya버전을 고정합니다.
인스턴스와 용량 산정
- 실시간 필터에는 ml.g4dn.xlarge를 권장합니다. 다만 ml.g4dn과 ml.g5의 SageMaker 호스트는 NVIDIA 드라이버 470이라 CUDA 12.x 이미지가 GPU를 인식하지 못하고 CPU로 폴백하므로, Step 2의 CUDA 호환 패키지를 넣은 이미지를 씁니다. 지연 상한이 더 엄격하면 ml.g6.xlarge를 씁니다.
- 서빙 앱은 워커 프로세스 1개가 요청을 순서대로 처리하므로 1대의 초당 처리 한계는 단건 서버 지연 평균의 역수입니다. 필요한 대수는 초당 요청 수 × 평균 서버 지연(ms) ÷ 1,000 ÷ 목표 사용률(0.6)로 구합니다. 예를 들어 초당 50건에 평균 42 ms(ml.g4dn.xlarge에서 길이가 섞인 세트로 측정한 값)면 3.5대라 4대를 둡니다.
- 사용률이 60%를 넘으면 대기 시간이 더해져 평균 응답이 처리 시간의 2.5배 이상으로 늘어납니다. 인스턴스 기동에 4~5분이 소요되므로 오토스케일링에는 여유 대수를 둡니다.
- 여러 텍스트를 한 요청에 묶을 때는 길이순으로 정렬하고 건수 × 최대 토큰 길이를 2,048 이하로 유지합니다. 정렬 없이 32건을 보내면 장문 하나 때문에 전부 1,024토큰으로 패딩돼 처리량이 3분의 1로 떨어집니다. 호출 전 검사처럼 지연이 중요한 자리에서는 단건 호출이 맞습니다.
- 운영은 가용 영역 2곳에 2대 이상을 둡니다. SageMaker는 인스턴스가 2대 이상이면 가용 영역에 자동으로 분산합니다.
Bedrock Guardrails와의 역할 분담
트래픽이 적고 PII 필터만 필요하면 Amazon Bedrock Guardrails가 운영 부담 없이 더 비용효율적입니다. Guardrails는 텍스트 1,000자 단위로 과금하므로 요청이 길고 많아질수록 비용이 비례해 늘고, 이 글의 측정(2026년 10월, 내장 PII 필터)에서는 한국 고유식별자 유형이 없어 정규식을 더해야 했고 건강, 종교 같은 서술형 민감정보는 탐지되지 않았습니다. Guardrails의 지원 범위는 변경될 수 있으므로 적용 시점의 문서를 확인합니다. 월 텍스트 단위가 약 1,300만을 넘거나 한국어 민감정보 재현율이 중요하면 이 글의 구성이 유리합니다. 두 방식은 배타적이지 않습니다. 민감 여부 판정은 Decision Model이 맡고 마스킹과 콘텐츠 필터는 Guardrails에 맡기는 식으로 함께 쓸 수 있습니다.
재학습 루프
운영 중 오탐과 미탐을 모으면 다음 순서로 반복합니다. 먼저 오류 유형을 분석하고, 각 유형을 보완할 수 있는 문장 틀을 교사 모델로 추가 생성합니다. 이후 학습에 사용하지 않을 평가 전용 세트를 별도로 구성하고 고정합니다. 마지막으로 동일한 하이퍼파라미터를 적용해 모델을 재학습하고, 이전 모델과 동일한 테스트 세트에서 성능을 비교합니다. 새 모델이 기준(KDPII 테스트 정확도 유지, CRITICAL 미탐 없음, 합성 테스트 99% 이상)을 넘으면 Step 4의 UpdateEndpoint로 교체하고, 문제가 생기면 이전 엔드포인트 구성으로 되돌립니다.
다른 과제에 적용하기
이 글에서 소개한 구성 중 과제별로 새롭게 정의해야 하는 부분은 질문 파일, 학습 데이터, 평가 세트입니다. 컨테이너, 학습 작업, 배포, 호출 코드, 결정 규칙의 뼈대는 그대로 씁니다.
| 구성 요소 | 다른 과제로 옮길 때 |
|---|---|
질문 파일 (questions.json) |
새로 씁니다. 질문 1~3개, 선택지는 한두 문장으로 서로 구별되게 |
| 학습 데이터 생성기 | 새로 씁니다. 변수 정의, 값 생성기, 라벨 규칙이 과제마다 다름 |
| 평가 세트 | 새로 씁니다. 합성 테스트, 실제 분포 샘플, 함정 세트의 세 가지 |
| 컨테이너 이미지 (train, serve) | 그대로 |
| 학습 작업 호출과 하이퍼파라미터 | 그대로. epochs와 micro_batch만 데이터 크기에 맞춰 조정 |
| 배포, 롤백, 모니터링 | 그대로 |
| 결정 규칙 | 임계값과 등급 매핑만 바꿈. 질문이 하나면 교차 검증 대신 최대 확률 기준만 씀 |
| 보조 규칙 | 과제에 따라 생략하거나 바꿈 |
예: 고객 문의 라우팅
고객 문의를 담당 부서로 보내고 당일 처리 여부를 가르는 과제라면 질문 파일은 다음처럼 바뀝니다. 선택지 설명에 부서 이름이 아니라 부서가 맡는 일을 적어 두면 모델은 설명을 보고 배웁니다.
{
  "department": {
    "type": "choice",
    "instructions": "이 문의를 처리할 부서는?",
    "criteria": {
      "billing": "결제, 환불, 청구서, 요금제 변경",
      "tech": "로그인 오류, 앱 오류, 연동 실패, 속도 저하",
      "account": "회원 정보 변경, 탈퇴, 본인 확인",
      "general": "그 밖의 일반 문의와 제안"
    }
  },
  "urgent": {
    "type": "noul",
    "instructions": "서비스 중단이나 금전 피해가 진행 중이어서 당일 처리가 필요한가?"
  }
}
학습 데이터를 만드는 방법은 두 가지입니다. 과거 문의와 실제 처리 부서 기록이 있으면 그것이 가장 좋은 학습 행이며, 개인정보가 섞여 있으면 가명처리한 뒤에 씁니다. 기록이 없거나 부족하면 이 글처럼 교사 모델이 문의 문장 틀을 쓰고 코드가 상품명, 금액, 오류 코드 같은 값을 채우되, 라벨은 어느 부서의 업무 내용이 들어갔는지를 기준으로 규칙에 따라 붙입니다. 라벨이 규칙으로 정해지지 않는 과제(예: 문의 어조의 불만 정도)는 사람이 소량을 라벨링하고, 자체 호스팅한 허용적 라이선스의 교사 모델이 붙인 라벨과 대조해 일치하는 것만 쓰는 편이 안전합니다. 어떤 경우든 상용 API나 관리형 서비스 모델의 출력을 학습 데이터로 쓰기 전에 서비스 약관을 확인합니다.
데이터는 얼마나 필요한가
개인정보 판단 모델에서 확인한 내용입니다. 첫 모델은 문장 틀 3,938개를 10번씩 채운 합성 데이터 약 3만 단위에 KDPII 학습 분할의 25%(약 1만 단위)를 더한 약 4만 단위로 54분 학습했고 KDPII 테스트 정확도 98.1%가 나왔습니다. 이후 학습 데이터를 세 배로 확대했지만 전체 정확도 향상은 0.4%p에 그쳤습니다. 성능 개선에 더 크게 기여한 것은 데이터의 양보다는 특정 오류 유형을 보완하기 위해 추가한 문장 틀이었습니다. 예를 들어 격식 있는 문서에서의 호칭과 이름, 일반적인 의미로 사용된 종교 관련 단어, 코드에 포함된 주소 등이 이에 해당합니다. 권장 순서는 선택지마다 수천 단위 규모의 첫 데이터로 빨리 학습해 오류를 보고, 오류 유형별로 긍정과 부정을 같은 어휘로 짝지어 보강하는 것입니다. 부정(해당 없음) 사례를 긍정과 같은 어휘로 만들지 않으면 모델은 어휘만 외웁니다.
운영에서 볼 지표
- REVIEW 비율과 BLOCK 비율의 추이. 갑자기 오르면 입력 분포가 바뀐 신호이고, REVIEW로 넘어간 건은 다음 재학습 데이터의 후보입니다.
- 카테고리 분포와 민감 확률 분포. 0.4~0.6 구간의 비중이 커지면 모델의 신뢰도가 낮은 입력이 늘었다는 뜻이라 입력 분포 변화를 의심합니다. 이 구간이 비어 있다고 오류가 없다는 뜻은 아니므로 ALLOW와 BLOCK 판정도 주기적으로 표본을 뽑아 사람이 확인합니다.
- 서버 지연 p50/p95와 GPU 메모리 사용률. 지연이 수십 배 늘었는데 오류가 없으면 GPU 폴백을 의심합니다.
- 응답의
usage.truncated비율. 잘린 입력이 많으면 분할 전송이나max_len조정이 필요합니다.
참고사항
- GPU가 꼭 필요한가: 학습은 GPU 1장이 필요합니다. 추론은 CPU에서도 돌지만 단건 1,800~2,400 ms라 실시간 필터에는 맞지 않고, 배치 처리라면 CPU도 가능합니다.
- 한국어 외 언어도 되는가: 다국어 체크포인트는 100개 이상 언어를 지원합니다. 다만 학습 데이터가 그 언어로 있어야 합니다.
- 입력이 길면: 1,024토큰을 넘는 부분은 잘립니다. 문서는 문단 단위로 나눠 보내고 결과를 합칩니다. 인코더는 8,192토큰까지 지원하므로
max_len을 늘려 재학습할 수도 있지만 지연과 메모리가 늘어납니다. - 선택지가 많으면: 질문 헤드의 토큰 예산(기본 256)을 선택지 수로 나눈 만큼만 설명을 쓸 수 있습니다. 설명을 20토큰 안팎으로 쓸 수 있는 10개 안팎까지가 무리가 없고, 그 이상이면 질문을 계층으로 나눕니다.
- 라이선스: Laya 패키지와 체크포인트는 Apache-2.0입니다. 교사 모델은 출력물을 학습에 써도 되는 라이선스인지, 공개 데이터셋은 재배포와 출처 표기 조건이 무엇인지 확인합니다.
마치며
Decision Model은 LLM을 대체하기 위한 모델이 아니라, LLM을 활용하는 과정에서 반복적으로 발생하는 판단을 더 빠르고 효율적으로 처리하기 위한 모델입니다. 이 글에서는 오픈소스 Laya를 SageMaker 자체 컨테이너로 학습하고 배포해, 합성 데이터와 공개 대화 데이터셋으로 한국어 개인정보 판정 모델을 만들어 판정 1건을 30 ms 안팎에 처리하는 환경을 구성했습니다. 기준과 데이터를 보강해 재학습한 모델은 처음 보는 398건에서 학습 없이 쓴 Jev, SGLang으로 띄운 Qwen3-235B에 기준 프롬프트를 준 방식과 비슷한 수준의 오류를 보였습니다. 지연은 약 5~6분의 1이고, 비용은 요청 수와 무관한 인스턴스 고정비이며, 판정할 텍스트는 계정 밖으로 나가지 않습니다. 자체 Decision Model을 검토하는 팀이라면 다음 순서로 진행하기를 권합니다. 결정 항목과 선택지를 질문 파일로 먼저 적고, 실제 분포 샘플과 함정 세트를 라벨링해 베이스라인을 측정한 다음, 데이터 생성기를 만들어 첫 학습을 실행합니다. 컨테이너, 학습 작업, 배포, 결정 규칙은 이 글의 구성을 출발점으로 삼을 수 있으므로 더 많은 시간을 질문 설계와 데이터에 활용하시기를 권합니다. 모델의 성능은 결국 학습 데이터의 품질에 달려 있습니다. 실제 운영 환경에 적용하기 전에는 고객 환경의 데이터로 충분히 검증이 선행되어야 합니다.