AWS 기술 블로그
유진그룹의 온톨로지 여정: Amazon Neptune과 Amazon Bedrock으로 건자재 유통 데이터를 지식 그래프로 전환하기
유진그룹 AI CoE가 주관하고, 메가존클라우드(MZC)가 수행사로, AWS가 기술 지원으로 참여한 온톨로지 기반 지식 그래프 프로젝트 사례입니다. 그룹 내 건자재 유통 회사인 유진홈센터의 운영 데이터를 대상으로, 검증된 학술 방법론(R2G, GRAD)과 산업 표준 온톨로지(GoodRelations, schema.org, GS1)를 결합해 관계형 데이터베이스(RDBMS)를 Amazon Neptune 기반 지식 그래프로 전환한 과정을 공유합니다. 건자재 유통처럼 상품과 거래 구조가 복잡한 도메인에서 온톨로지 모델링을 직접 시도하려는 분께 참고가 되기를 바랍니다.
1. 회사소개
유진그룹은 건자재 제조 및 유통을 비롯하여 금융, 물류, 미디어 등 다양한 산업 분야에서 사업을 영위하고 있는 기업집단입니다. 각 계열사는 서로 다른 사업 구조와 운영 시스템을 보유하고 있으며, 데이터 인프라와 AI 기술 활용 수준에서도 차이를 보이고 있습니다.
유진그룹은 이러한 산업적 다양성을 바탕으로 그룹 전체의 AI 전환을 체계적으로 진행하기 위해 그룹혁신부문 비전추진본부 산하에 AI CoE(AI Center of Excellence)를 운영하고 있습니다.
AI CoE는 그룹 차원의 AI 전문성을 집적하고, 공통 기술 아키텍처와 데이터 표준을 수립하며, 계열사별 AI 프로젝트의 실질적인 사업 성과 창출과 확산을 주도하는 조직입니다. 개별 계열사의 AI 과제가 일회성 기술 검증이나 독립적인 시스템 구축에 머무르지 않도록, 검증된 기술과 데이터, 개발 성과를 재사용 가능한 그룹 공통 자산으로 축적하는 것을 중요한 목표로 삼고 있습니다.
이를 위해 AI CoE는 네 가지 역할을 수행합니다. 첫째, AI 기술의 직접적인 활용과 구현을 통해 전문 역량을 확보하고, 둘째, 공통 데이터 모델과 시스템 아키텍처를 설계하여 기술적 표준과 거버넌스를 정립합니다. 셋째, 실제 사업 현장의 문제를 해결하는 AI 시스템을 구축하여 매출 확대와 수익 창출 등 실질적인 사업 가치를 추구하며, 넷째, 검증된 기술과 도구, 구축 경험을 계열사 전반으로 확산하여 그룹 전체의 AI 활용 역량을 높입니다.
유진그룹의 AI 전환은 임직원 개개인의 AI 활용과 업무 자동화를 확산하는 바텀업(Bottom-up) 접근과, 기업의 데이터와 업무 프로세스, 의사결정 구조를 통합하여 조직 전반의 AI 시스템을 구축하는 탑다운(Top-down) 접근을 병행합니다.
특히 탑다운 전략에서는 개별 시스템에 분산된 데이터를 기업의 업무 맥락에 따라 연결하고, 이를 AI가 이해하고 활용할 수 있는 공통 데이터 체계로 발전시키는 것을 주요 과제로 보고 있습니다.
이러한 방향에서 데이터 온톨로지는 그룹의 공통 데이터 아키텍처를 구성하는 중요한 기술적 기반이며, 이번 유진홈센터 PoC(Proof of Concept, 개념 검증)는 그 실현 가능성을 검증하기 위한 첫 번째 시도입니다.
2. 프로젝트 배경
유진그룹 AI CoE는 그룹 공통 데이터 온톨로지의 기술적 실현 가능성을 검증하기 위해 제조, 금융, 유통 영역을 첫 번째 PoC 대상으로 검토했습니다.
제조 영역은 스마트팩토리와 디지털 트윈 등 온톨로지의 활용 가능성이 높았으나, 레거시 시스템과 공정 노하우 유출 위험을 고려해야 했고, 금융 영역은 망분리와 데이터 거버넌스 제약이 있었습니다.
반면 건자재 유통 사업을 담당하는 유진홈센터는 상품, 재고, 주문, 배송 등 주요 업무 영역이 비교적 명확하고, 데이터 구조화 수준도 초기 PoC에 적합했습니다. 또한 향후 유진기업과 동양 등 그룹 내 건자재 사업을 연결하는 통합 유통 플랫폼으로의 확장 가능성도 고려했습니다.
유진홈센터의 운영 데이터베이스는 수천 개 규모의 테이블로 구성되어 있었으며, 온라인 쇼핑몰, 매출(POS), 재고 및 물류(WMS), ERP 연계 등 업무 영역별로 데이터가 분산되어 있었습니다.
다음과 같은 문제를 확인했습니다.
- 현장 관용어와 표준 상품명의 불일치: 건설 및 시공 현장에서 사용하는 관용어와 시스템에 등록된 표준 상품명이 달라, 고객의 자연어 표현만으로 정확한 상품을 식별하기 어려웠습니다.
- 상품 코드와 식별 체계의 분산: 동일하거나 연관된 상품이 규격, 색상, 포장 단위 등에 따라 서로 다른 상품 코드와 바코드로 관리되어, 상품군 단위의 통합 조회와 집계가 어려웠습니다.
- 복잡한 거래 및 소싱 관계: 동일한 상품이라도 공급사, 지역, 고객 유형, 거래 조건에 따라 가격과 공급 방식이 달라지는 다대다 관계가 존재했으며, 이러한 판단 기준의 일부는 시스템보다 담당자의 경험과 업무 지식에 의존하고 있었습니다.
- 업무 시스템 간 데이터 분절: 온라인 쇼핑몰, POS, WMS, ERP 등에서 서로 다른 코드와 데이터 구조를 사용하여, 판매부터 재고 확인, 발주, 배송에 이르는 업무 흐름을 통합적으로 조회하기 어려웠습니다.
- 현업 암묵지에 대한 의존: 견적 산출, 대체품 선정, 재고 이동, 배차 및 납기 판단 등에 필요한 업무 규칙과 경험적 판단 기준이 충분히 구조화되어 있지 않았습니다.
관계형 데이터베이스는 개별 업무의 데이터를 체계적으로 저장하고 처리하는 데 효과적이지만, 여러 시스템에 걸친 복잡한 관계와 업무적 의미를 통합적으로 표현하려면 별도의 의미 모델이 필요합니다. 예를 들어 특정 상품의 가용 재고를 판단하기 위해서는 상품 식별뿐 아니라 지점별 재고, 안전재고, 입고 예정 수량, 대체품 및 배송 조건 등을 함께 고려해야 합니다.
이에 유진그룹 AI CoE는 문제의 원인을 분산된 데이터에 업무적 의미와 관계를 부여하는 문맥화 계층(Contextualization Layer)의 부재로 정의했습니다.
이를 해결하기 위해 기존 관계형 데이터베이스의 구조를 분석하고, 상품, 지점, 재고, 거래 등 주요 엔터티(Entity, 업무 대상)와 그 관계를 온톨로지 기반 지식 그래프(Knowledge Graph)로 재구성하는 접근을 채택했습니다. 나아가 현업의 판단 기준을 업무 규칙으로 모델링해, AI가 업무 맥락에 따라 정보를 탐색하고 판단 근거를 제시할 수 있는 구조를 검증하고자 했습니다.
이번 PoC는 이 접근이 실제 운영 데이터에 적용 가능한지 확인하고, 향후 그룹 공통 데이터 모델과 AI 시스템으로 발전시키기 위해 필요한 기술적 조건과 데이터 정비 과제를 도출하는 데 목적을 두었습니다.
3. 사용한 AWS 서비스
- Amazon Neptune Database: 상품, 지점, 재고, 판매, 공급사를 노드와 관계로 저장하는 완전관리형 그래프 데이터베이스입니다. 이번 PoC는 RDF가 아니라 LPG(Labeled Property Graph) 모델로 구축했으며, openCypher로 업무 질의를 표현합니다. 다중 홉(multi-hop) 경로 탐색과 속성 기반 집계에 적합합니다.
- Amazon Bedrock: Claude Sonnet 4.5를 사용해 자연어 질문을 그래프 스키마 기반의 openCypher 쿼리로 변환하고, 조회 결과를 한국어로 요약합니다.
- Amazon Neptune Analytics: 그래프 전용 분석 엔진으로, Louvain(커뮤니티 탐지), PageRank(중심성), WCC(Weakly Connected Components, 약연결 요소) 등의 알고리즘을 메모리 상에서 수행합니다. 규칙 기반 조회와 비교할 그래프 분석 응답 경로를 구성하기 위해 추가했습니다.
- Amazon EC2 (AI 에이전트 애플리케이션): 그래프 질의응답 에이전트를 호스팅하는 실행 환경입니다. React 기반 프론트엔드와 FastAPI 기반 백엔드로 구성한 풀스택 애플리케이션으로, 추론 과정을 실시간(SSE)으로 보여줍니다.
- 데이터 파이프라인 (Amazon S3 + AWS Lambda + Neptune Bulk Loader): 관계형 원천 데이터를 R2G/GRAD 방법론 기반으로 변환하여 그래프 노드, 엣지로 정제한 뒤 S3에 적재하고, Lambda가 Neptune Loader API를 호출하여 Neptune이 IAM 역할로 S3에서 직접 대량 적재합니다.
4. Solution 개요
4.1 왜 온톨로지인가?
온톨로지는 데이터에 문맥(context)을 부여하는 의미 계층입니다. 데이터를 노드와 관계로 연결해 현장의 사고 방식대로 질의할 수 있게 합니다. “같은 상품을 지역, 고객 유형, 수량에 따라 다르게 판다”는 다대다 거래 구조는 단일 테이블로 표현하기 어렵지만, 그래프에서는 표현할 수 있습니다.
지식 그래프를 구현하는 방식에는 RDF/OWL(트리플 + SPARQL)과 LPG(Labeled Property Graph + openCypher) 두 갈래가 있습니다. 이번 PoC는 LPG를 선택했습니다. 유진홈센터의 질의가 재고 롤업, 공급망 추적, 대체품 탐색처럼 경로 탐색과 집계 중심이어서 LPG와 openCypher가 직관적이고 성능상 유리하기 때문입니다.
4.2 전체 흐름
| ① 자연어 질문 → ② 규칙, 스키마 조립(업무 규칙 + 그래프 스키마를 LLM에 전달) → ③Amazon Bedrock의 Claude Sonnet 4.5가 openCypher 조회 명령 생성 → ④ Amazon Neptune에서 그래프 탐색 → ⑤ 결과 요약 및 근거(추론) 경로 제시 |
온톨로지 기반 접근의 강점은 답과 함께 “왜 그런 답이 나왔는지”를 그래프 경로(근거)로 보여줄 수 있다는 점입니다.
5. Solution 구현 상세: 관계형 데이터를 지식 그래프로 모델링하기
5.0 PoC Architecture
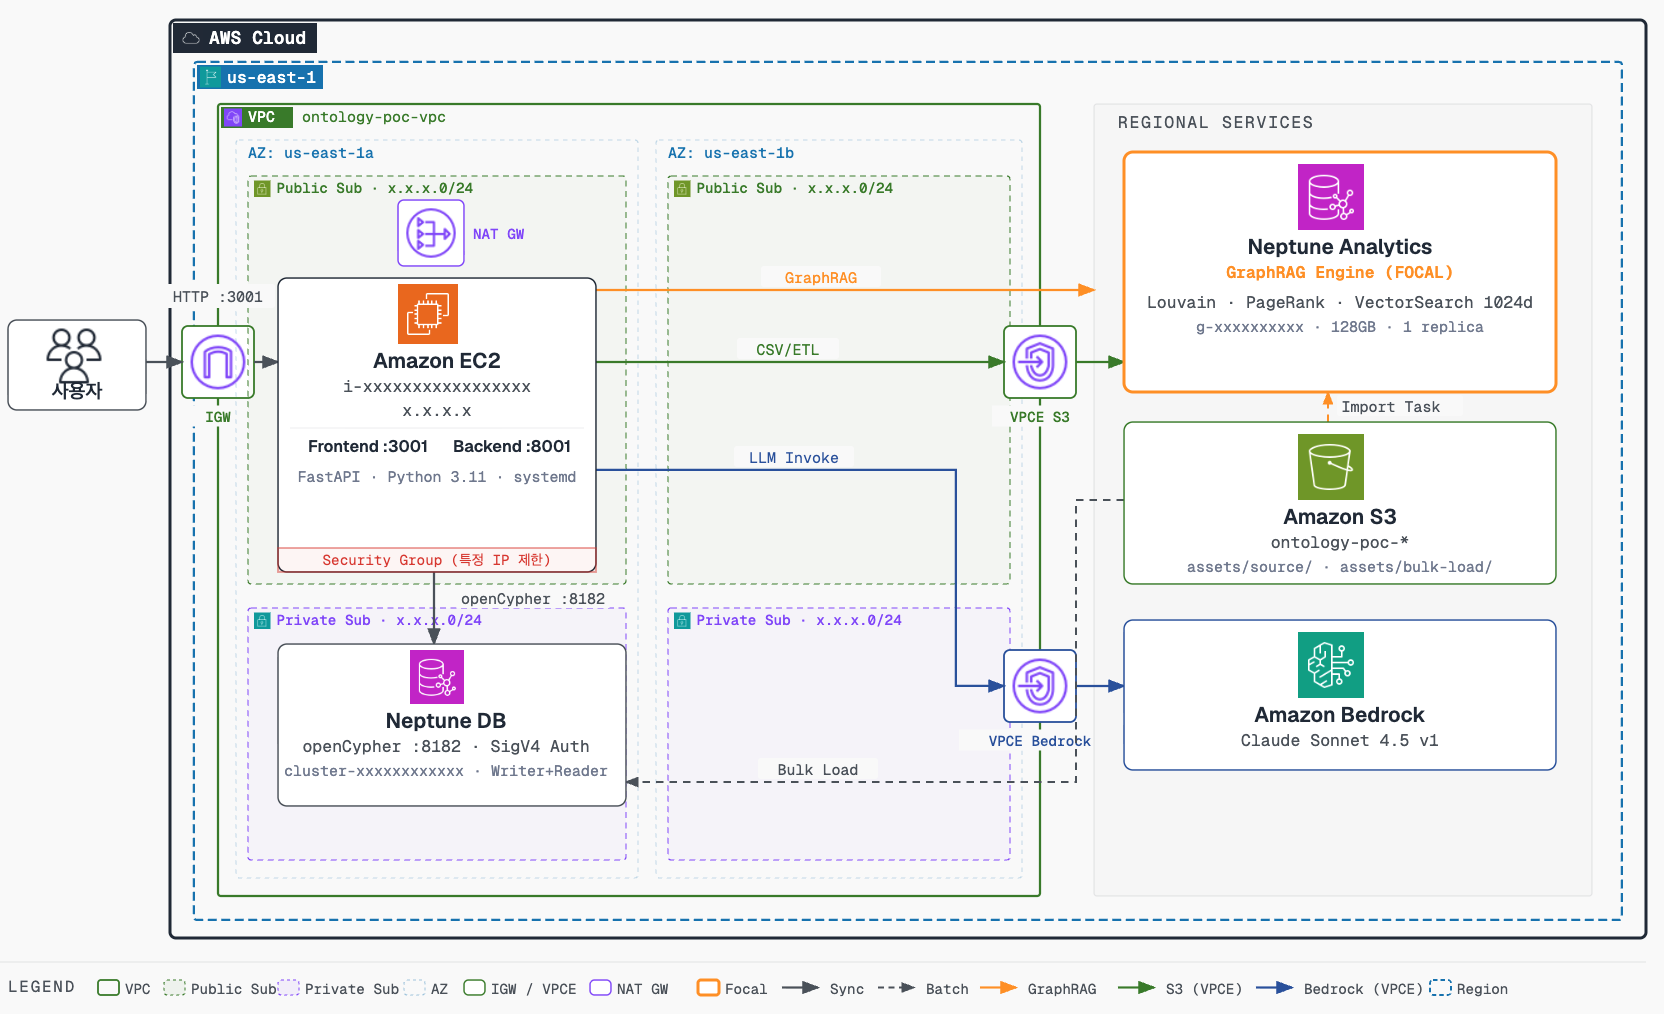
[그림: PoC 아키텍처]
5.1 프로젝트 진행 방식: Discovery → Design → Build
- Discovery: 2026년 6월 현업 워크숍에서 지식 그래프가 답해야 할 전체 질문 풀 15개를 역량 질문(CQ, Competency Question)으로 수집했습니다. 이후 데이터 가용성과 현업 우선순위를 검토하여 이 가운데 7개 업무 CQ를 PoC 구현, 검증 대상으로 선정했습니다.
- Design: 관계형 데이터베이스를 그래프로 변환하는 모델을 설계했습니다. R2G, GRAD 기반 방법론과 산업 표준 온톨로지를 적용해 노드, 엣지, 속성 구조를 확정했습니다.
- Build: Amazon Neptune에 그래프를 구축하고 데이터를 적재한 뒤, 정의한 CQ에 그래프 질의로 답할 수 있는지 검증했습니다. 변환, 적재 과정은 화면에서 단계별로 실행하고 결과를 확인할 수 있게 구성해, 원천 데이터가 갱신되면 그래프를 반복 재구축할 수 있습니다.
5.2 학술 연구에 기반한 RDBMS → LPG 방법론
온톨로지 모델링에서 가장 흔한 실수는 “튜플을 노드로, 외래키(FK)를 엣지로” 기계적으로 1:1 변환하는 것입니다. 이렇게 하면 관계형 구조가 복제될 뿐, 그래프의 장점인 의미 기반 탐색이 살지 않습니다. 이를 피하기 위해 두 학술 방법론을 토대로 삼았습니다.
- R2G (Converting Relational to Graph Databases, De Virgilio 외, GRADES@SIGMOD 2013): RDB 스키마, 데이터, 쿼리를 그래프로 자동 변환하는 방법론입니다. “함께 조회되는 값을 한 노드에 집약”하여 FK 1:1 변환을 회피합니다. “어떻게 옮기나”(변환 절차)를 담당합니다.
- GRAD (On Graph Database Modeling, Ghrab 외, 2016): 그래프 DB의 완전한 논리 모델입니다. Entity/Attribute/Literal 노드 계층, 관계(Edge) 4유형, Identifier, Multiplicity, Assertion 제약을 정의합니다. “무엇으로 담나”(논리 모델과 제약)를 담당합니다.
이번 PoC의 방법론은 이 둘을 결합하고, R2G의 SQL 워크로드 자리에 CQ를 투입했습니다. “현장에서 실제로 던지는 질문”이 노드 집약/분리(모델링 입력)와 모델 완성 여부(검증 기준)를 모두 결정하는 요구사항 주도 모델링입니다.
전체 절차 (3개 Phase, 9단계)
| 단계 | 내용 |
|---|---|
| 메타데이터 | ① 메타데이터 추출(DDL, PK, FK, 데이터 프로파일) → ② Schema Graph 생성(컬럼=노드, Key/FK 의존=엣지) → ③ 구조 판정(Source, Hub, Sink, N:M 경계 식별) |
| CQ 정의 | 업무 질문 수집 → 그래프 패턴 초안 (R2G의 ‘SQL 워크로드’ 자리를 CQ가 대체) |
| 논리모델 | ④ Unifiability 판정(집약 vs 분리) → ⑤ 5-Case 변환 → ⑥ GRAD 의미 계층(Identifier, 관계(Edge) 4유형, Hypernode) |
| 물리투영 | ⑦ 제약 정의(Uniqueness, Multiplicity, Assertion) → ⑧ LPG 물리 투영(Node Label, Property, Edge Type) → ⑨ CQ Traversal 검증(모든 CQ에 1~3홉(hop) 탐색으로 답할 수 있는지) |
5-Case 변환 규칙
| Case | 처리 | 적용 예 |
|---|---|---|
| Case 1. NewNode | 엔터티 테이블을 노드로 | 상품, 지점 |
| Case 2. Property | 안정적 스칼라 컬럼을 노드 속성으로 | 상품명, 규격 |
| Case 3. NodeEdge | 헤더-라인 N:M을 노드 + 관계로 분리 | 판매(헤더) + 판매라인 |
| Case 4. NewEdge | FK 참조를 방향 엣지로 | OF_PRODUCT 등 |
| Case 5. Skip | 중복, 무의미 컬럼 제외 | 임시, 백업 컬럼 |
5.3 단계별 적용: 물리 ERD에서 LPG까지
STEP 1. 물리 ERD: 원천 구조 파악 (방법론 ①~③)
원천 파일의 Grain과 키를 확정하고 허브, N:M 경계를 판정했습니다. 상품 코드와 지점 코드가 두 허브로 재고, 판매, 배송, 이동, 발주를 연결하며, 판매, 이동, 발주는 공통적으로 “헤더-라인” 2계층 구조였습니다.
STEP 2. 프로파일링: 조인 키 검증과 품질 이슈 (방법론 ① 심화)
| 품질 이슈 | 처리 방안 |
|---|---|
| 상품 마스터 말미의 빈 행 | 키 결측 행 제거 |
| 소스에 없는 고아 상품 | 스텁 노드 + :Unresolved 라벨 |
| 배송 리드타임 음수 | 이상치 플래그 속성, 집계 시 필터 |
| 소분류명 중복 | 카테고리 키를 경로 합성(대 > 중 > 소) |
| 원가, 마진, 공급사 | 민감 정보 범위 제외, 속성 자리만 예약 |
STEP 3. 논리 ERD: 정규화된 개념 모델 (방법론 ④~⑥)
어떤 값을 독립 노드로 승격할지는 CQ가 결정했습니다. 파생 엔터티 승격(지점, 카테고리 3계층, 브랜드, 판매 헤더, 고객, 배송기사), 헤더-라인 Reify(CONTAINS), n-ary 재고 노드화(INVENTORY)를 적용했습니다. 그 결과 상품, 지점 2대 허브를 중심으로 공급망 흐름(발주 → 입고 → 이동 → 지점 재고 → 판매 → 배송)이 그래프 경로로 표현되었습니다.
5.4 상품, 거래 의미 모델링: 산업 표준 온톨로지 3계층
| 계층 | 표준 | 역할 |
|---|---|---|
| ① 의미 기반 | GoodRelations | 상품, 공급자, 가격, 소싱 의미론의 형식적 기반. gr:Offering으로 다대다 거래 reify |
| ② 표층 어휘 | schema.org | 상품 변형(ProductGroup/Product), 오퍼 표현 |
| ③ 식별, 분류 | GS1(GTIN, GPC) + GS1 Korea | GTIN 전역 단일 식별(바코드 분산 해결), GPC 표준 분류, 국내 발급, 한국어는 GS1 Korea |
중요한 설계 결정: 위 표준 어휘는 본래 RDF/OWL 기반이지만, 이번 PoC는 이를 RDF 트리플로 적재한 것이 아니라 표준이 정의한 개념, 관계를 LPG의 노드 라벨, 엣지 타입, 속성(property)에 투영하는 “의미 설계 기준”으로 활용했습니다. 예를 들어 ProductGroup은 RDF 클래스가 아니라 LPG 노드 라벨로, GTIN은 트리플이 아니라 노드의 gtin 속성으로 표현됩니다. 표준 온톨로지는 의미를 규율하고, 구현은 Property Graph로 수행했습니다.
건자재 기술 속성(규격, 재질, 등급)은 ETIM, eCl@ss 건자재 특화 분류를 병행 검토했고, 용어 통합에는 SKOS(prefLabel/altLabel)로 현장 관용어를 표준어의 동의어로 연결했습니다.
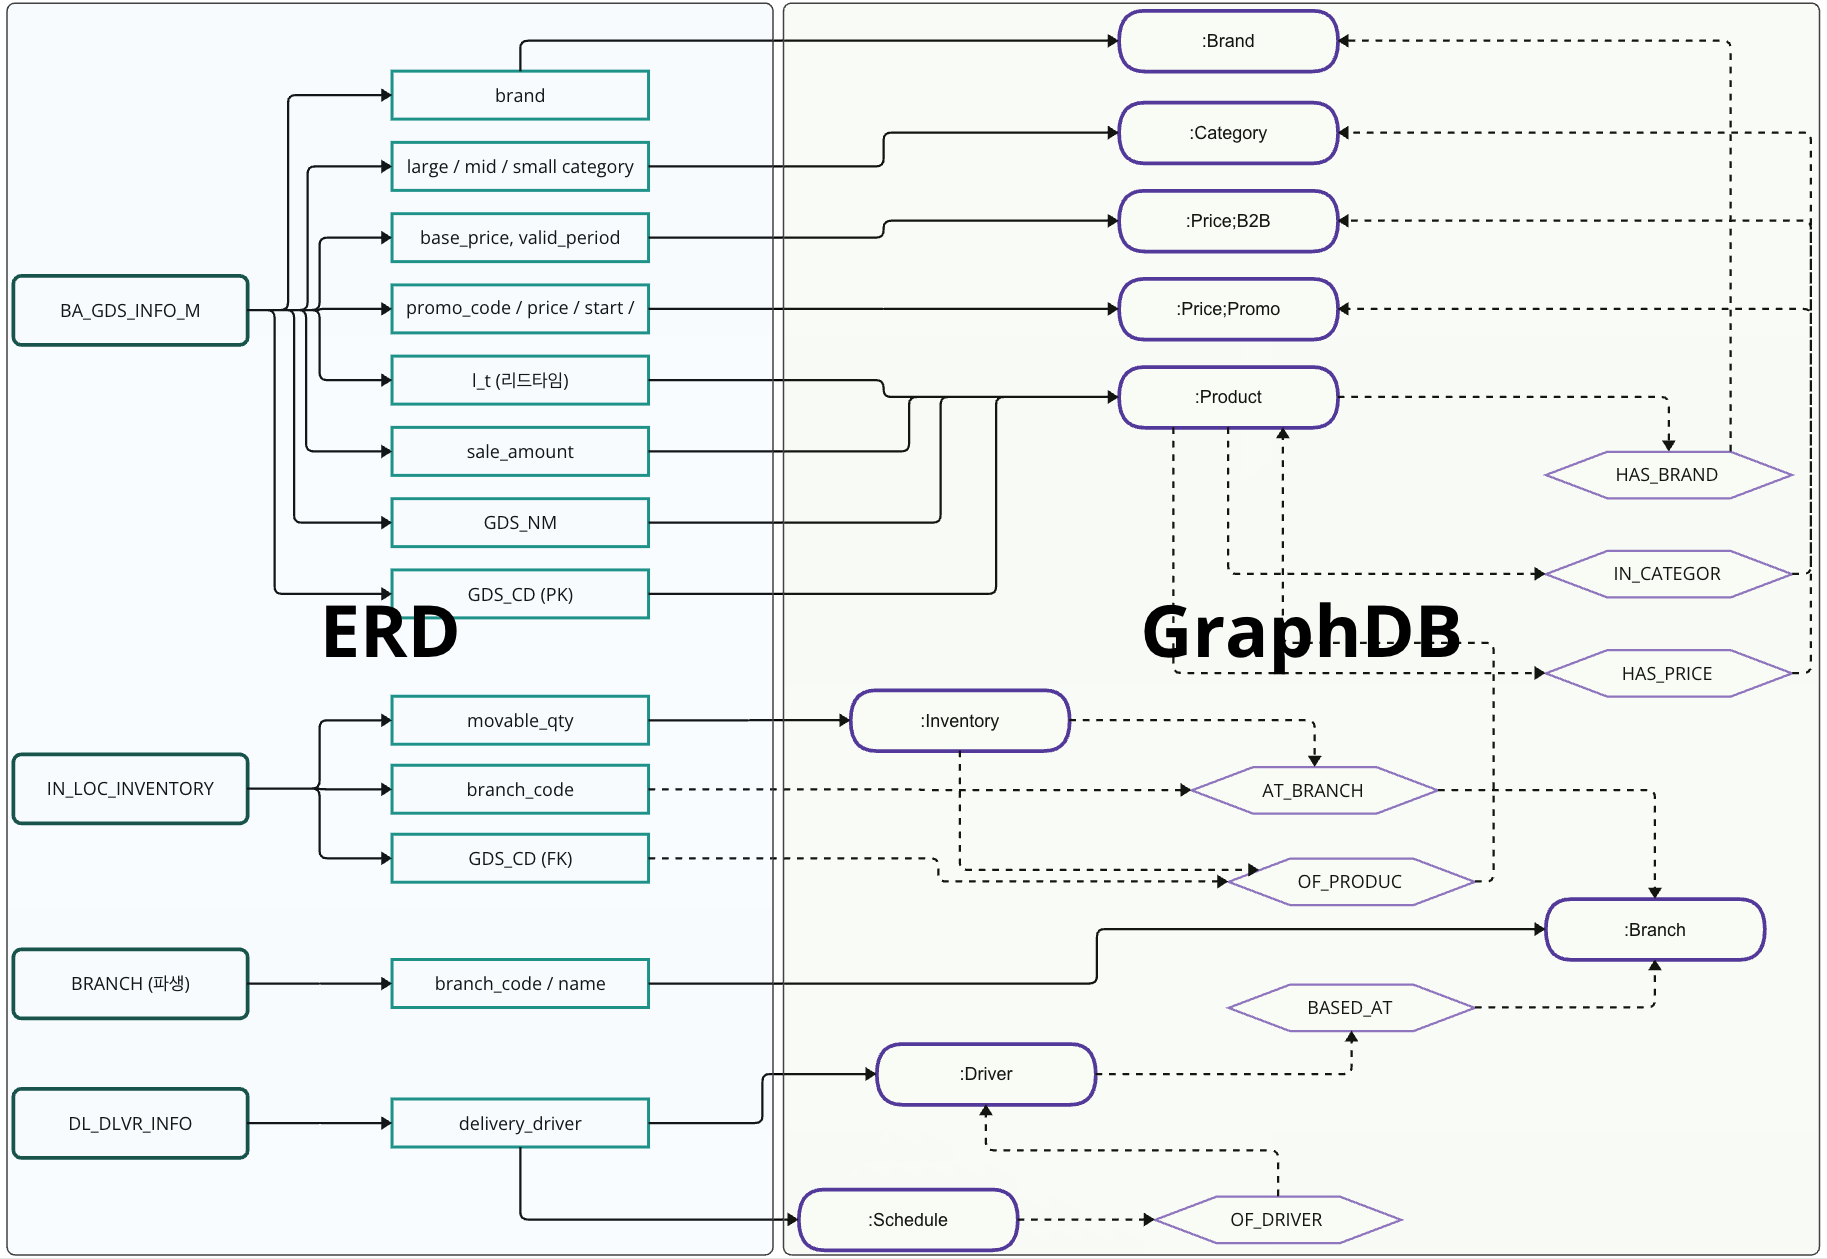
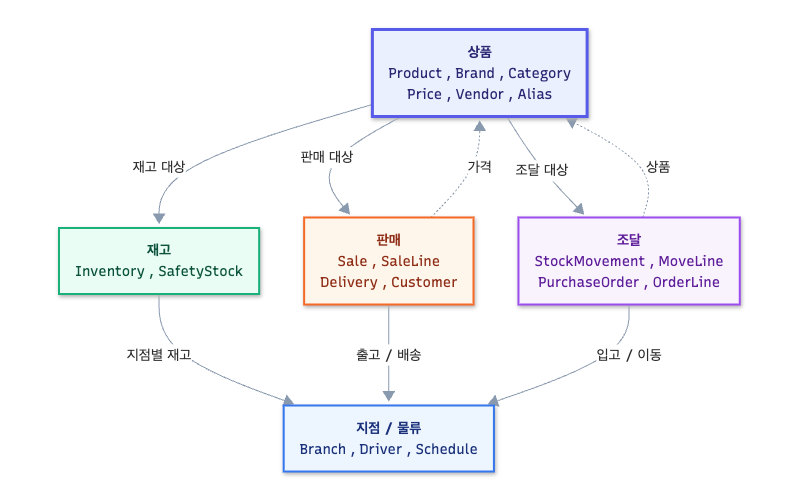
[그림: 모델링 변환 결과]
5.5 암묵지와 규칙을 그래프에 담기
데이터 모델(5.2~5.4)이 “무엇이 있는가”를 담았다면, 운영 현장의 지식은 “어떻게 판단하는가”입니다. 업무 규칙을 애플리케이션에 하드코딩하면 변경, 추적, 설명이 어렵습니다. 이번 PoC는 암묵지와 업무 규칙을 애플리케이션 코드와 분리해, 그래프의 노드, 엣지, 제약으로 직접 모델링했습니다. 즉 규칙을 데이터와 동등한 그래프 구성 요소(first-class citizen)로 다뤘습니다.
이렇게 하면 규칙이 바뀔 때 코드 수정 없이 그래프만 갱신하면 되고, AI는 질의할 때 그래프에 저장된 규칙을 읽어 추론 절차를 따릅니다.
5.5.1 암묵지와 제약의 노드화
- 암묵지의 노드화: 음성, 인터뷰의 비정형 지식을 LLM으로 구조화해 Rule/Constraint 노드로 reify(구체화, 개념을 독립 노드로 표현)하고, 개별 상품 대신 카테고리, 그룹 레벨에 APPLIES_TO로 부착했습니다. 예: “시멘트류는 비 오는 날 배송 주의” → (:WeatherConstraint)-[:APPLIES_TO]→(:Category 시멘트)
- 규칙 유형별 표현: 하드 규칙은 위반 검사 쿼리로, 판단 로직은 파생 엣지(SUBSTITUTE_FOR)로, 계산 규칙은 속성으로 표현했습니다. 규칙 노드에는 출처와 버전 속성을 두어 근거를 추적할 수 있게 했습니다.
- 추론 전파와 설명 가능성: 카테고리 지식이 분류 체계(taxonomy) 경로를 따라 상품 단위로 자동 적용됩니다(1~2홉). 신규 상품은 분류 소속만으로 규칙을 상속하며, 답변 시 근거 경로를 함께 제시합니다.
5.5.2 Competency Question의 규칙 그래프 (Meta-Rule) 모델링
업무 질문의 판단 절차 자체도 그래프 데이터로 모델링했습니다. 5.1에서 선정한 7개 업무 CQ(재고 가용성 2건, 납기 1건, 배송 수단 및 기사 배차 1건, 타점 재고 이동 1건, 견적 1건, 대체품 1건)를 공통 메타모델로 분해했습니다. 질의가 들어오면 AI 에이전트는 해당 Rule을 선택하고, Rule에 연결된 Step, Condition, Property, PathPattern을 따라 조회와 판단을 수행합니다.
| 메타노드 | 역할 | 예 |
|---|---|---|
| Rule | CQ 1건 = 규칙 1개 (질문/우선순위/범위) | 재고 확인 및 입고 리드타임 안내 |
| Step | 규칙의 순차 실행 단계 | 상품매칭 → 재고합산 → 가용판단 → 부족수량 산출 → 리드타임 조회 |
| Condition | 분기 판단식 (operator/left/right) | effectiveMovableQty > N |
| Output | 분기 결과 (Type: SUCCESS/ACTION_REQUIRED) | 즉시 가능 / 추가 발주 필요 |
| Property/PathPattern | Step이 읽는 속성/순회 경로의 메타정의 | (inv:Inventory)-[:OF_PRODUCT]->(p:Product) |
규칙의 순서와 분기를 엣지로 표현해, 쿼리 한 번으로 절차 전체를 따라갈 수 있게 했습니다.
- HAS_STEP (seq): Rule이 Step을 순서대로 연결합니다.
- HAS_CONDITION → ON_TRUE / ON_FALSE: 판단식과 참/거짓 분기를 표현합니다.
- READS_PROPERTY (role: 매칭키/판단기준/비교대상): Step이 읽는 속성을 지정합니다.
- TRAVERSES: Step이 사용하는 승인된 경로를 지정합니다.
- FALLBACK / REQUIRES_NODE: 속성 누락 시 대체 값과 규칙 실행에 필요한 노드를 선언합니다.
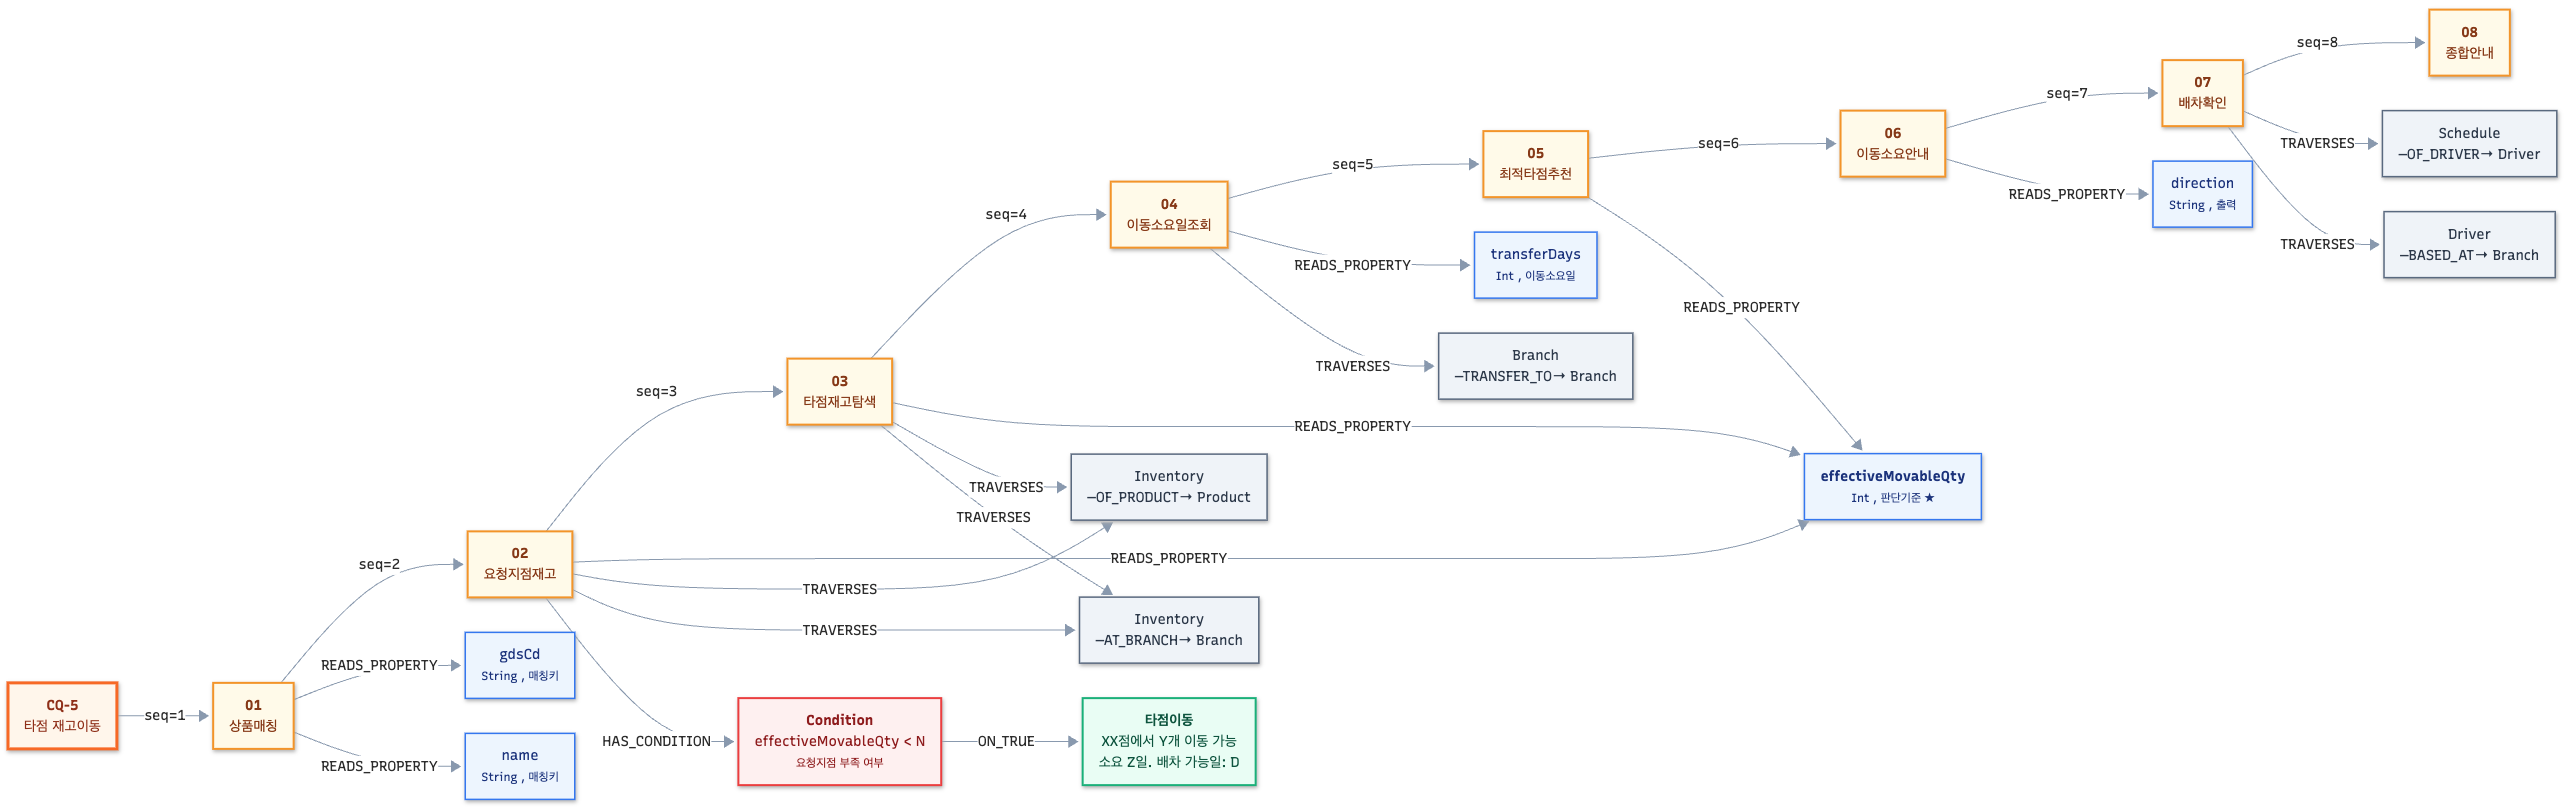
[그림: Rule (타점 재고 이동 판단)]
5.6 AI 에이전트 개발
자연어 질의를 그래프 질의로 바꾸는 방식에는 LLM이 스키마만 보고 생성하는 Text-to-Cypher와, 외부 지식을 검색해 결합하는 GraphRAG가 있습니다. 이번 PoC는 둘을 결합하되, 5.5의 규칙 그래프를 “검색되는 컨텍스트”로 주입하는 Rule-grounded 방식을 차별점으로 적용했습니다.
화면은 같은 질문에 대해 두 응답 경로, 즉 “규칙 기반 조회 경로(Neptune Database, Rule-grounded Text-to-Cypher)”와 “그래프 분석 경로(Neptune Analytics, 알고리즘, 벡터 검색)”의 결과와 근거를 나란히 비교할 수 있도록 구성했습니다.
5.6.1 아키텍처 (EC2 자체 구축 풀스택)
- 프론트엔드(Frontend): React + Vite (질의 UI, 추론 과정 실시간 표시, 그래프 시각화)
- 백엔드(Backend): FastAPI + Uvicorn (에이전트 오케스트레이션)
- LLM: Amazon Bedrock의 Claude Sonnet 4.5
5.6.2 에이전트 처리 파이프라인
자연어 질의 → Rule 매칭 → 그룹 분리 → 그룹별 Cypher → Neptune 실행 → 결과 요약
- Rule 매칭: 키워드 기반 1차 매칭과 그래프 Rule 노드 폴백으로 단일 Rule을 확정합니다. 향후 의미 기반 의도 분류로 고도화할 예정입니다.
- 그룹 분리: TRAVERSES 경로가 바뀌는 지점을 경계로 Step을 그룹화합니다.
- 그룹별 Cypher: 그룹마다 Bedrock으로 Cypher를 생성하고, 이전 결과를 다음 입력으로 전달합니다(다단계 추론).
5.6.3 신뢰성 핵심 기법
- Rule 그라운딩: 규칙 컨텍스트(Step, Property, Path)를 주입해 할루시네이션(Hallucination, 사실과 다른 응답 생성)을 억제합니다.
- 자기교정 루프(최대 3회): 오류 발생 시 오류 메시지를 다시 전달해 재생성하고, 0건 응답 시 실제 DISTINCT 값을 참고해 재생성합니다.
- toLower 후처리: 영문 대소문자와 표기 편차를 방지합니다.
- 별칭 강제 탐색: Alias → ALIAS_OF → Product 경로를 UNION으로 항상 포함해 은어 질의에 대응합니다.
- 다단계 추론: 규칙을 그룹으로 나눠 순차 실행하고 중간 결과를 전달합니다(요청 지점 재고 → 부족 → 타점 → 배차).
- 모드별 LLM 가드레일: 엔진별로 프롬프트 제약을 둡니다. Neptune Analytics에서 지원하지 않는 함수는 금지하고, 분석 경로에서는 PageRank, Louvain 등 알고리즘 호출을 허용합니다.
6. 검증 결과
이번 PoC에서 구현한 7개 업무 CQ는 결과를 읽기 쉽게 5개 검증 영역으로 묶어 제시했습니다.
이번 PoC는 운영 적용 전에 “지식 그래프 온톨로지 접근이 유효한가”를 확인하는 타당성 검증 단계였습니다. 검증 결과는 다음과 같습니다.
| 영역 | 현장 질문 | 검증된 내용 |
|---|---|---|
| 재고 가용성 조회 | 재고가 있는가, 추가 발주가 필요한가 | 상품-재고 경로로 가용 수량을 조회하고, 안전재고 기준으로 발주 필요 여부를 판정하는 질의 성립 |
| 납기 | 특정 상품을 언제까지 N개 받을 수 있는가 | 입고 리드타임 기준으로 납기를 안내하는 질의 성립 |
| 대체품 탐색 | 품절 시 무엇을 대신 제안할 수 있는가 | 브랜드, 카테고리 경로로 대체 후보 탐색 가능 |
| 견적 | 상품에 대한 견적가 산출이 가능한가 | 행사 기간과 유효 기간을 반영해 견적가를 산출하는 질의 성립 |
| 타점 재고 이동 | 타점 재고 확인하여 최적의 타점 선정할 수 있는가 | 최적의 타점 선정 + 배차 가능한 기사 연동 |
6.1 확인된 성과
첫째, 기존 관계형 구조에서는 표현하기 어려웠던 질의가 그래프 모델에서 성립함을 확인했습니다. 흩어진 상품 코드를 상위 단위로 롤업하고, 현장 관용어(은어, 별칭)를 표준 상품으로 연결하며, 발주부터 배송까지의 공급망 흐름을 하나의 경로로 추적하는 질의가 그래프상에서 동작했습니다.
둘째, 답변과 함께 근거가 된 그래프 경로를 제시하는 설명 가능한(explainable) 구조를 구현했습니다. 또한 SSE 기반 Think Block(추론 과정 실시간 시각화)을 통해 ‘어떤 규칙을 따라 어떤 경로로 탐색했는지’가 화면에 드러나므로, 사용자가 답의 근거를 직접 확인할 수 있습니다.
6.2 검증을 통해 확인한 개선 경로
검증은 주요 시나리오를 두 응답 경로(규칙 기반 조회 경로, 그래프 분석 경로)에서 각각 여러 차례 반복 호출하여, 최종 답변뿐 아니라 생성된 조회(Cypher)와 반환 결과가 회차마다 일관되게 재현되는지를 함께 확인하는 방식으로 진행했습니다. 응답 시간과 처리 흐름은 안정적으로 유지되었으며, 이번 단계의 목표가 기능 타당성 검증이었던 만큼 운영 수준의 정확도와 재현성 확보는 다음 단계의 과제로 정의했습니다.
주목할 점은 기대와 다른 답변이 나온 사례를 분석한 결과, 대부분 필요한 정보가 이미 그래프에 존재했다는 것입니다. 즉 ‘정답에 이르는 경로가 그래프에 존재하는가’는 이번 검증에서 확인되었고, 남은 과제는 ‘그 경로가 매번 안정적으로 선택되도록 안내하는 계층’을 갖추는 것입니다.
실제로 동일한 데이터와 모델에서 LLM에 전달하는 스키마 정보를 보강하고 상품 검색 방식을 개선한 버전을 비교했습니다. 그 결과 기존에는 ‘상품을 찾을 수 없다’고 답하던 질의가 개선 후에는 실제 상품과 가격 정보를 제시하는 것을 확인했습니다.
이번 검증을 바탕으로 운영 수준 확장을 위해 도출한 설계 보완 방향은 다음 네 가지입니다.
- 의미 기반 의도 분류: 같은 뜻의 질문이 항상 같은 규칙으로 연결되도록, 키워드 우선순위 방식을 질문의 의미를 분석하는 의도 분류 단계로 고도화합니다.
- 그래프 스키마의 완전한 전달: 노드 속성과 관계(엣지) 속성을 LLM에 빠짐없이 전달하여, 그래프에 존재하는 정보를 모델이 충분히 활용하도록 합니다.
- 답변 검증 계층: 생성된 조회가 규칙 조건을 반영했는지, 답변 수치가 조회 결과에서 나왔는지 대조하는 확인 단계를 추가하여 재현성을 높입니다.
- 실데이터 기반 정답 기준 확립: 이번 PoC는 원가, 공급사 등 민감 정보를 범위에서 제외하고 검증용 데이터로 구성했습니다. 다음 단계에서는 실제 운영 데이터와 업무 기준을 바탕으로 정답 기준을 확정합니다.
이번 결과는 ‘지식 그래프로 이러한 질의가 가능하다’는 기능적 가능성을 검증한 것입니다. 또한 납기, 배차, 견적처럼 담당자의 경험으로 운영되어 온 영역은 실제 운영 기준이 확정되면 동일한 모델로 확장할 수 있습니다.
7. 결론 및 향후 계획
이번 PoC는 복잡한 건자재 유통 데이터를 Amazon Neptune 기반 지식 그래프로 전환하는 접근이 유효함을 확인했습니다. 재고, 발주, 대체품, 견적, 타점 재고 이동 등 주요 운영 영역에서 현장 질문이 그래프 경로로 답할 수 있음을 검증했습니다. 검증 과정에서는 온톨로지의 성능이 모델 자체뿐 아니라 입력 데이터의 품질과 표준화 수준, 업무 규칙의 정비 상태, AI의 그래프 탐색 방식에 함께 영향을 받는다는 점도 확인했습니다.
온톨로지 성공의 두 축
지식 그래프의 가능성을 운영 수준의 가치로 전환하려면 두 가지가 함께 뒷받침되어야 합니다. 이 두 가지는 향후 그룹 내 다른 사업 영역에 온톨로지를 적용할 때도 공통 조건입니다.
① 데이터 표준화: 그 출발점은 용어집과 데이터 딕셔너리
온톨로지는 준비된 데이터에 문맥을 입혀 가치를 키우는 기술입니다. 따라서 현장 관용어와 표준 상품명을 잇는 용어집, 흩어진 코드를 하나로 모으는 분류, 코드 표준이 먼저 갖춰져야 그래프가 “현장 관용어로 질문하면 답하는” 상태에 도달합니다. 이번 검증에서도 안전재고, 업체 리드타임, 지점 간 이동일수처럼 판단의 기준이 되는 데이터가 확정되지 않아, 모델 설계는 끝났음에도 실데이터 기준 정답 검증은 다음 단계로 판단되었습니다. 용어집과 코드 표준이 먼저 갖춰질수록 온톨로지가 커버하는 업무 범위가 넓어지고, 답변의 정확도와 재현성도 함께 올라갑니다.
② 도메인 전문가(SME)와의 협업
온톨로지는 결국 “비즈니스를 데이터로 어떻게 이해하고 표현할 것인가”의 문제입니다. 어떤 개념을 노드로 승격할지, 현장 관용어와 암묵지를 어떻게 규칙으로 구조화할지는 기술보다 업무 지식에서 나옵니다. 특히 건자재 유통처럼 현장 관용어와 경험칙이 중요한 도메인에서는, 그 지식을 보유한 현업 담당자가 Discovery부터 검증까지 함께 참여해야 모델 품질이 높아집니다. 이때 용어집과 CQ를 공통 언어로 삼으면 현업 전문가도 수월하게 참여할 수 있습니다.
이번 PoC를 통해, 현업의 요구사항을 전달받는 데 그치지 않고 이를 직접 구현으로 연결하는 협업이 중요하다는 점을 확인했습니다. 현장의 업무 지식과 판단 기준을 이해하고, 이를 데이터 모델과 업무 규칙, AI 시스템의 구현으로 연결할 수 있는 기술 인력의 역할이 중요합니다. 여러 계열사로 확장하려면 각 현장의 도메인 지식을 습득해 공통 아키텍처에 반영할 역량이 필요합니다.
이에 유진그룹 AI CoE는 이번 PoC에서 얻은 경험을 바탕으로, 현업에 밀착하여 업무를 이해하고 이를 데이터 모델과 AI 시스템으로 직접 설계, 구현하는 전방배치엔지니어(FDE, Forward Deployed Engineer)를 그룹 차원에서 육성하는 AX 전략을 구상하게 되었습니다. 이를 통해 도메인 전문가와 AI 엔지니어링 조직 간의 협업을 늘리고, 개별 계열사에서 확보한 업무 지식과 기술적 성과를 그룹 공통의 데이터 및 AI 자산으로 축적하고자 합니다.
향후 계획 (Next Step)
유진그룹은 이번 PoC에서 확인한 기술적 가능성과 교훈을 바탕으로, 온톨로지를 그룹 차원의 AI 시스템으로 발전시키기 위한 후속 과제를 진행하고 있습니다.
첫째, 통합 건자재 유통 AI 플랫폼 구축입니다. 유진그룹은 유진홈센터에서 검증한 기술과 업무 모델을 토대로, 유진기업, 유진홈센터 등 유통 계열사를 연결하는 통합 건자재 유통 AI 플랫폼을 기획하고 구축하고 있습니다. 상품 검색과 견적, 주문, 재고 확인, 배송 등 유통 업무 전반을 AI로 연결하는 것을 목표로 하며, 이번 PoC에서 개발한 온톨로지 기반 지식 그래프를 플랫폼의 AI 엔진으로 발전시키고자 합니다.
이를 통해 개별 업무 기능 자동화에 더해, 상품과 거래, 재고와 물류의 관계를 AI가 이해하고 활용할 수 있는 통합적인 업무 체계를 구현하는 것이 목표입니다.
둘째, SAP 기반 차세대 통합 ERP 구축과 연계한 데이터 현대화 및 표준화입니다. 현재 유진그룹은 유진기업과 동양 등 레미콘 제조 및 건자재 유통 관련 계열사를 대상으로 SAP 기반 차세대 통합 ERP 구축을 추진하고 있습니다. 이 과정에서 상품, 거래처, 재고, 구매 및 판매 등 주요 업무 데이터의 현대화와 표준화를 함께 진행할 계획입니다.
특히 계열사별로 상이한 코드와 분류 체계를 정비하고 데이터 딕셔너리를 체계적으로 구축함으로써, 온톨로지의 정확도와 신뢰성을 높이고, 여러 계열사의 데이터와 업무 관계를 일관된 의미 체계로 연결할 수 있도록 기반을 마련하고자 합니다.
이를 위한 세부 실행 과제는 다음과 같습니다.
- 용어집, 데이터 딕셔너리 구축: 현장 관용어와 표준 상품명을 잇는 용어집을 1차 산출물로 확정합니다. 모든 후속 작업의 기준이 됩니다.
- 상품 마스터, 코드 표준화: 분산된 SKU, 바코드를 정비하고 분류 체계를 표준화하여, 그래프가 신뢰할 수 있는 식별 기반을 마련합니다.
- 암묵지 데이터화: 담당자 경험으로 운영되던 소싱, 견적, 배차 정보를 수집, 정형화하여, 모델 설계는 완료되었으나 데이터가 없어 보류된 영역을 활성화합니다.
- 검증/운영 체계 정비: 생성된 질의가 규칙과 데이터에 부합하는지 대조하는 검증 절차와 규칙 관리 체계를 갖춰, 답변의 재현성과 신뢰성을 운영 수준으로 끌어올립니다.
- 적용 범위의 점진적 확장: 위 기반 위에서 지식 그래프가 커버하는 운영 영역을 단계적으로 넓힙니다.
셋째, 그룹 계열사 간 데이터 연결과 온톨로지의 단계적 확장입니다.유통과 물류 영역에서는 인테리어 건자재 유통을 담당하는 유진홈센터, 건자재 유통을 담당하는 유진기업, 배송 물류를 담당하는 유진로지스틱스, 라스트마일 배송을 담당하는 유진소닉의 데이터와 업무를 연결하는 방향을 구상할 수 있습니다.
각 계열사가 보유한 상품, 주문, 재고, 운송 및 배송 정보를 공통 의미 체계로 연결한다면, 그룹 전체의 상품 공급과 물류 흐름을 통합적으로 이해하고 계열사 간 의사결정을 지원할 수 있습니다.
유진그룹은 이번 유진홈센터 PoC를 출발점으로, 데이터 표준화와 현업 중심의 기술 구현을 병행하며 온톨로지의 적용 범위를 단계적으로 확대하고자 합니다. 이를 통해 서두에서 소개한 탑다운(Top-down) 방식의 AI 전환, 즉 계열사별로 분산된 데이터와 업무, 의사결정 구조를 하나의 의미 체계로 연결하고 이를 활용하는 AI 시스템이 그룹 전반에 자리 잡는 것을 지향하고 있습니다.