AWS 기술 블로그
아이지에이웍스 클레어의 Agentic AI PoC 여정: Amazon Bedrock AgentCore로 설계하고 평가하기
이 글은 AWS와 아이지에이웍스가 함께 진행한 프로토타입 검증 프로젝트를 아이지에이웍스 문석민·장소진 님과 공동으로 작성했습니다. 1부는 프로토타입 설계와 평가를, 2부는 프로덕션 이관과 운영 경험을 다룹니다.
들어가며
아이지에이웍스는 AI 기반의 SCI(Synthetic Consumer Intelligence) 기술로 기업이 소비자를 이해하고 시장을 예측해 성장할 수 있도록 돕는 AI 빅데이터 테크 기업입니다. 20년간 축적해 온 실제 소비자 행동 데이터를 학습해, 과거 데이터를 해석하는 데 그치지 않고 개별 소비자의 다음 행동(구매·이탈·전환)을 확률로 예측합니다. 이를 바탕으로 정밀한 마케팅 전략 수립, 경쟁사 분석, 시장 점유율 확대를 지원합니다. 디파이너리(DFINERY)는 이 예측을 실제 고객 데이터와 마케팅 실행으로 연결하는 CDP & CRM 통합 플랫폼입니다. 앱·웹·오프라인에 흩어진 고객 데이터를 통합 ID 하나로 묶어 분석하고, 카카오 알림톡·문자·앱푸시 등 국내 채널로 CRM 캠페인을 실행하는 과정을 하나의 환경에서 제공합니다. 그리고 이번 도입기에서 주로 다룬 클레어(Claire)는 디파이너리에 내장된 AI 분석 에이전트입니다. Text-to-SQL 기반으로, SQL을 모르는 마케터가 “최근 30일간 고객들의 연령대별 매출 분석해줘”라고 물으면 클레어가 관련 테이블 스키마를 찾아 SQL을 생성·실행하고 결과를 해석해 줍니다.
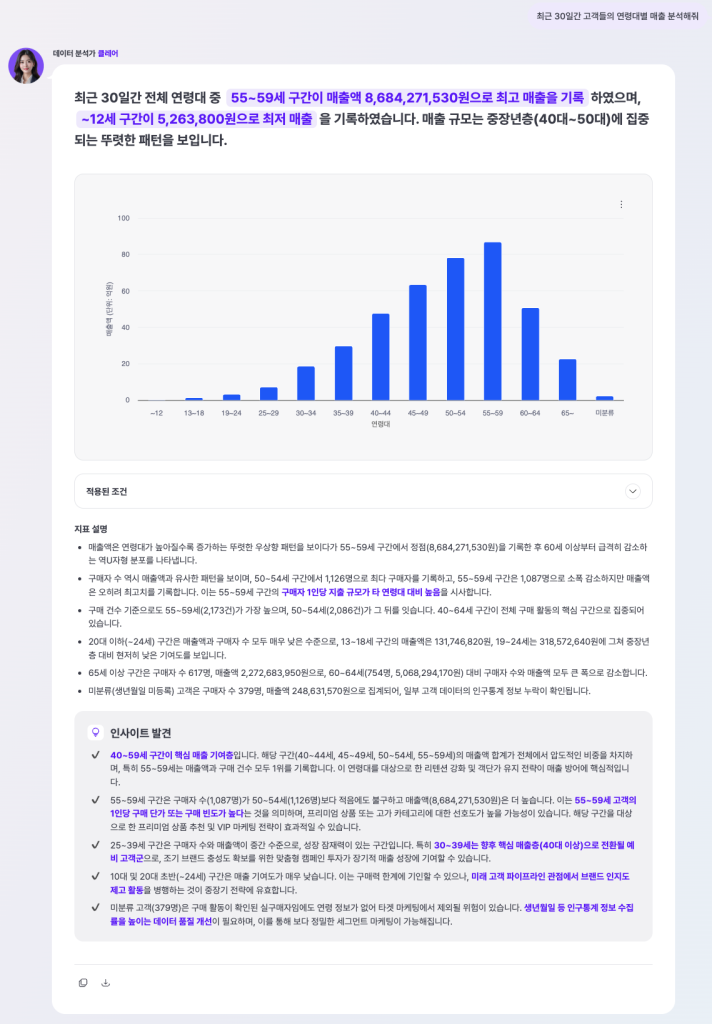
그림 1. 디파이너리에서 클레어가 연령대별 매출 분석 질문에 답변하는 화면
운영 중인 클레어에는 두 가지 한계가 나타나고 있었습니다:
- 단일 컨테이너 구조에서 동시 요청이 늘수록 응답이 느려지고 에이전트를 개별적으로 배포·확장할 수 없다는 실행 모델의 한계
- 흐름이 고정된 워크플로우가 처리하지 못하는 질문 유형이 늘어나는 에이전트 구조의 한계
이 한계를 극복하고자 AWS의 3A(Agentic AI Acceleration) 프로그램을 통해 약 1개월의 집중 스프린트에서 Agentic 아키텍처와 평가(Evaluations) 기반 개선 루프를 프로토타입으로 검증했고, 프로덕션에서는 기존 LangGraph 워크플로우를 유지한 채 실행 환경만 Amazon Bedrock AgentCore Runtime으로 이관했습니다.
1부인 이 글은 PoC 과정을 다룹니다. 에이전트를 개발할 때 어떤식으로 접근을 할 수 있으며, 특히 AgentCore와 관련된 도구들을 어떻게 활용할 수 있는지를 보여줍니다. 그 후에 프로덕션 이관과 운영에서 확인한 성능·복원력 특성은 2부에서 다룹니다.
| 항목 | 1부 – PoC | 2부 – 운영 |
| 에이전트 구조 | LangGraph supervisor — triage/clarify/SQL ReAct | 기존 LangGraph 워크플로우 유지 |
| 도구 연결 | AgentCore Gateway + MCP 분리 도구 서버 | 워크플로우 내 직접 호출 — Gateway/MCP는 향후 도입 검토 |
| 세션 연속성 | AgentCore Memory | LangGraph checkpointer — AgentCore Memory 도입 검토 중 |
| 실행 환경 | 기본 네트워크 구성 | VPC 모드 Runtime, 에이전트별 IAM 역할·보안 그룹 분리 |
| 메타 DB | 검증 환경 구성 | Amazon RDS for MySQL |
1. 기존 클레어의 한계: 흐름이 고정된 워크플로우
기존 클레어는 LangGraph와 FastAPI로 구현된 결정론적(deterministic) 워크플로우 에이전트로, 질문이 들어오면 항상 같은 순서로 실행됩니다.
질문 정제 → SQL 생성 → SQL 실행 → [결과 저장, 답변 생성, 시각화]
이 구조는 Text-to-SQL이라는 단일 경로에서는 안정적이었지만, 실제 사용자 질문은 그 경로를 벗어나기 시작했습니다.
- “현재 진행 중인 캠페인 목록을 보여줘” → DW가 아닌 운영 DB의 캠페인 설정값을 조회해야 합니다.
- “특정 캠페인의 운영 상태와 성과를 함께 확인해줘” → 운영 데이터와 집계 데이터를 결합해야 하는 복합 질의입니다.
흐름이 고정된 워크플로우에서는 이런 질문을 처리할 노드 자체가 없고, 질문 유형마다 분기를 추가하는 방식은 유지보수 비용을 계속 키웁니다. PoC의 목표는 LLM이 도구를 자율적으로 선택·조합하는 Agentic 구조를 통해 구조적 한계에 대해 유효한지 검증하는 것이었습니다.
2. 왜 Amazon Bedrock AgentCore인가
전환 결정에서 가장 크게 작용한 것은 AgentCore Runtime의 실행 모델이었습니다. 세션마다 격리된 전용 MicroVM에서 에이전트가 실행되어 세션 간 리소스 간섭과 장애의 영향 범위를 줄이고, 에이전트와 도구 서버를 독립적으로 배포·확장할 수 있습니다. PoC 과정 중 관심사는 Agentic 구조를 빠르게 만들고 검증할 수 있는가였습니다. AgentCore는 프레임워크를 강제하지 않으므로 LangGraph 자산과 경험을 그대로 활용할 수 있었고, 도구 연결(Gateway·MCP), 세션 연속성(Memory), 평가(Evaluations), 관측성(Observability)까지 검증에 필요한 구성 요소를 한 플랫폼에서 조합할 수 있었습니다. Evaluations는 도입을 결정한 근거였다기보다 전환 이후 품질을 확인하는 방법으로 가치를 증명했습니다.
3. Agentic 클레어 PoC 아키텍처
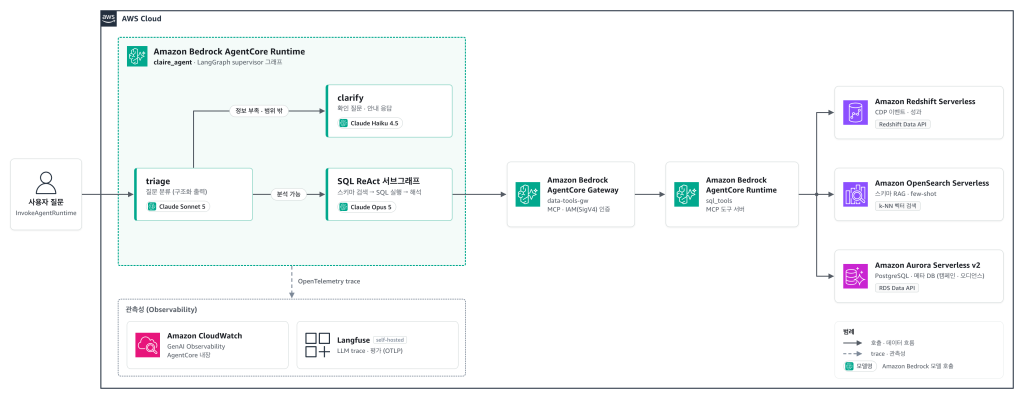
그림 2. Agentic 클레어 PoC에서 구축한 아키텍처
3-1. supervisor 그래프: 질문 성격에 따른 모델·경로 분리
PoC 과정 중의 Agentic 클레어는 LangGraph supervisor 그래프로 구성됩니다. 핵심은 질문의 성격에 따라 다른 모델과 경로를 쓰는 것입니다.
- triage (Claude Sonnet 5): 질문을 분석 가능 / 정보 부족 / 범위 밖으로 분류합니다. 구조화 출력(structured output)을 사용해 라우팅을 LLM의 자유 텍스트가 아닌 코드가 결정하도록 했습니다.
- clarify (Claude Haiku 4.5): 정보가 부족하거나 범위 밖인 질문에는 가장 빠르고 저렴한 모델이 짧은 안내로 응답합니다.
- SQL ReAct 서브그래프 (Claude Opus 5): 스키마 검색 → SQL 생성·실행 → 해석이라는 무거운 추론에만 최상위 모델을 씁니다.
class Triage(BaseModel):
    """supervisor 노드의 분류 결과."""

    intent: Literal["analyzable", "needs_clarification", "out_of_scope"] = Field(
        description="질문 분류: 분석 가능 / 정보 부족 / 범위 밖"
    )
    missing_info: list[str] = Field(
        default_factory=list,
        description="needs_clarification일 때 부족한 정보 항목",
    )
    resolved_question: str = Field(
        description="후속 질문이면 직전 조건을 병합한 완전한 질문, 아니면 원문"
    )

supervisor_llm = models["supervisor"].with_structured_output(Triage)

def route(state: ClaireState) -> str:
    intent = (state.get("triage") or {}).get("intent", "analyzable")
    return "sql" if intent == "analyzable" else "clarify"

g.add_conditional_edges("triage", route, {"sql": "sql", "clarify": "clarify"})
라우팅을 구조화 출력 + 코드 분기로 처리하면 분류 결과가 스키마로 강제되어 자유 텍스트 파싱으로 라우팅이 흔들리는 일이 없고, 분류가 실패했을 때의 동작(분석 가능으로 폴백해 일단 시도)을 코드에서 명시적으로 통제할 수 있습니다.
3-2. 멀티턴 처리와 세션 연속성
멀티턴 대화는 Text-to-SQL 에이전트에서 특히 까다로운 영역입니다. “6월로 보여줘”가 기존 조건의 변경인지 추가인지 모호하고, 대화가 길어질수록 유지해야 할 조건의 문맥이 혼선이 생기며, 첫 턴의 잘못된 해석이 이후 턴의 SQL로 누적됩니다. PoC에서 접근한 방법은 triage 노드의 resolved_question입니다. 후속 질문이 들어오면 triage가 직전 대화의 조건을 병합한 완전한 질문으로 재작성해 SQL 서브그래프에 전달합니다. SQL 서브그래프는 매 턴 독립적인 완전한 질문을 받으므로, 대화가 길어져도 조건 해석이 흔들리지 않습니다. 또한 SQL 생성 과정의 중간 도구 호출 기록은 대화 히스토리에 남기지 않고 최종 답변만 병합해, 턴이 쌓여도 컨텍스트가 불필요하게 비대해지지 않도록 했습니다.
세션 연속성은 AgentCore Memory로 검증했습니다. 애플리케이션이 대화 이벤트를 Memory에 기록해 두고, 실행 환경이 재시작되면 최근 대화를 조회해 복원하는 구성입니다. 프로덕션에서는 현재 LangGraph checkpointer가 같은 역할을 맡고 있습니다.
3-3. 도구 연결: MCP 도구 서버와 Gateway
프로토타입이 검증해야 할 에이전트 구조 측 과제는 캠페인·오디언스 운영 데이터를 도구로 여는 것이었습니다. 스키마 검색·SQL 실행·캠페인/오디언스 메타 조회를 20여 개의 MCP(Model Context Protocol) 도구로 표준화했습니다. 도구는 일반적인 Python 함수에 데코레이터를 붙이는 방식으로 정의합니다.
@mcp.tool()
def search_table_schemas(
    org_id: str, service_id: str, question: str, top_k: int = 3
) -> dict[str, Any]:
    """사용자 질문과 관련된 Redshift 테이블 스키마를 벡터 검색으로 찾습니다.

    질문을 임베딩해 테이블 설명·트리거 키워드 두 축으로 KNN 검색합니다.
    반환된 schema(테이블 경로/컬럼/타입/가이드라인)를 SQL 생성 컨텍스트로 사용하세요.
    """
도구 설명(docstring)은 곧 LLM이 도구를 선택하는 기준이 됩니다. “무엇을 반환하는지”뿐 아니라 “반환값을 어떻게 쓰라”까지 적어두면 에이전트의 도구 조합이 안정적으로 됩니다.
MCP 서버 호스팅은 AgentCore Runtime의 MCP 프로토콜 옵션을 선택했습니다. agentcore.json에 "protocol": "MCP"만 지정하면 이미 작성한 streamable-http 기반 MCP 서버를 그대로 Runtime에 배포할 수 있고, 에이전트와 같은 배포 라이프사이클로 관리되며, enableOtel 설정으로 도구 서버의 span이 에이전트 trace에 이어집니다. AgentCore CLI를 사용해 agentcore add agent 명령어를 실행하게 되면, MCP 프로토콜을 사용하는 서버 개발을 위한 준비를 쉽게 마칠 수 있습니다. 배포된 도구 서버는 AgentCore Gateway 뒤에 연결해, 도구 발견과 인증(IAM SigV4)·라우팅을 플랫폼이 처리하도록 했습니다.
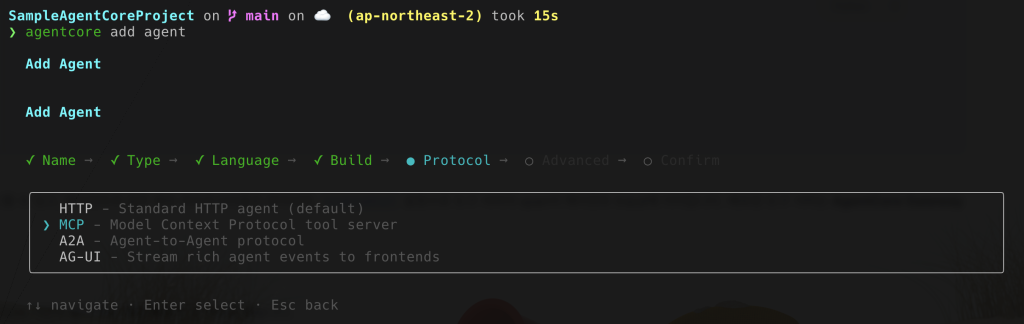
그림 3. AgentCore CLI 실행 예시
4. 품질 검증: 평가 주도 개선 루프
잘 설계된 아키텍처가 곧 좋은 응답 품질을 보장하지는 않습니다. LLM 기반의 에이전트는 비결정론적이기 때문에, 실제로 우리가 예상하는 질문에 대해 답변이 어떻게 나오는지를 직접 확인해야 했습니다. 특히 에이전트 구조를 크게 바꾼 뒤에는 “품질이 나빠지지 않았는가, 실제로 더 나은 답을 내는가”를 확인할 방법이 필요했고, AgentCore Evaluations 기반의 평가 주도 개선 루프가 그 역할을 했습니다. 이 과정에서, AgentCore의 API를 직접 사용해 테스트 코드를 만들기 보다는 AgentCore CLI의 기능을 최대한 활용했습니다.
4-1. 평가 데이터셋: JSONL 시나리오와 assertions
AgentCore CLI가 사용하는 평가 데이터셋은 JSONL 파일입니다. 한 줄이 하나의 평가 시나리오이고, 각 시나리오는 사용자 질문(turns, 멀티턴이면 여러 개), 기대 응답(expectedResponse), 채점 시 반드시 확인해야 할 조건(assertions)으로 구성됩니다. 데이터셋을 agentcore.json에 리소스로 선언해 두면 개발 중에는 로컬 파일로 빠르게 재평가하고, 기준선 시점에 불변(immutable) 버전을 발행해 전후 비교의 재현성을 확보할 수 있습니다. 아래는 AgentCore CLI가 사용하는 평가 데이터셋 예시입니다.
{
  "scenario_id": "revenue-last-month",
  "turns": [
    {
      "input": "지난달 매출 얼마야?",
      "expectedResponse": "조회 시점(KST) 기준 직전 달력월 전체를 '지난달'로
       해석하여 해당 기간의 매출액을 제시한다. 조회 기간과 집계 기준
       (구매 이벤트, 주문 단위 중복 제거)을 명시한다."
    }
  ],
  "assertions": [
    "'지난달'을 조회 시점 기준 직전 달력월 전체(1일~말일, KST)로 해석하고 그 기간을 답변에 명시해야 한다",
    "답변의 매출 수치가 에이전트가 실제 실행한 쿼리 결과와 일치해야 한다",
    "주문 단위 중복 제거 등 집계 기준을 답변에 명시해야 한다"
  ]
}
두 번째 assertion을 눈여겨볼 필요가 있습니다. “매출이 1,234만 원이어야 한다”가 아니라 “에이전트가 실제 실행한 쿼리 결과와 일치해야 한다” 입니다. 데이터가 갱신될 때마다 깨지는 절대 수치 대신, 채점자가 도구 호출 기록(trajectory)과 답변을 대조하게 만드는 상대 기준입니다.
4-2. agentcore run eval: 평가 실행 흐름
평가는 터미널에서 한 명령으로 실행합니다.
agentcore run eval --runtime claire_agent --dataset predefined_dataset -e Builtin.GoalSuccessRate Builtin.Correctness Builtin.Helpfulness- CLI가 데이터셋의 각 시나리오마다 새 세션을 만들어 배포된 에이전트를 실제로 호출합니다. 멀티턴 시나리오는 턴 순서대로 이어서 호출합니다. 목(mock)이 아니라 프로토타입 배포 환경과 동일한 경로(Runtime → Gateway → 도구)를 그대로 통과합니다.
- 호출로 생성된 trace(도구 호출 기록 포함)가 수집됩니다.
- 지정한 evaluator가 LLM-as-a-judge 방식으로 채점합니다.
Builtin.GoalSuccessRate는 세션이 사용자 목표를 달성했는지,Builtin.Correctness는 응답이 기대 응답·assertions에 부합하는지,Builtin.Helpfulness는 응답의 유용성을 평가합니다. - 결과는 시나리오별 점수와 채점 근거(explanation) 를 포함한 JSON으로 저장되고,
agentcore evals history로 지난 실행을 조회할 수 있습니다.
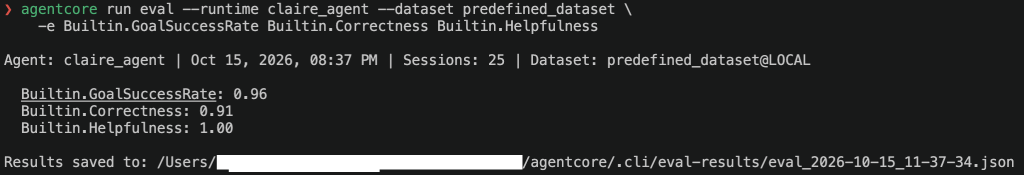
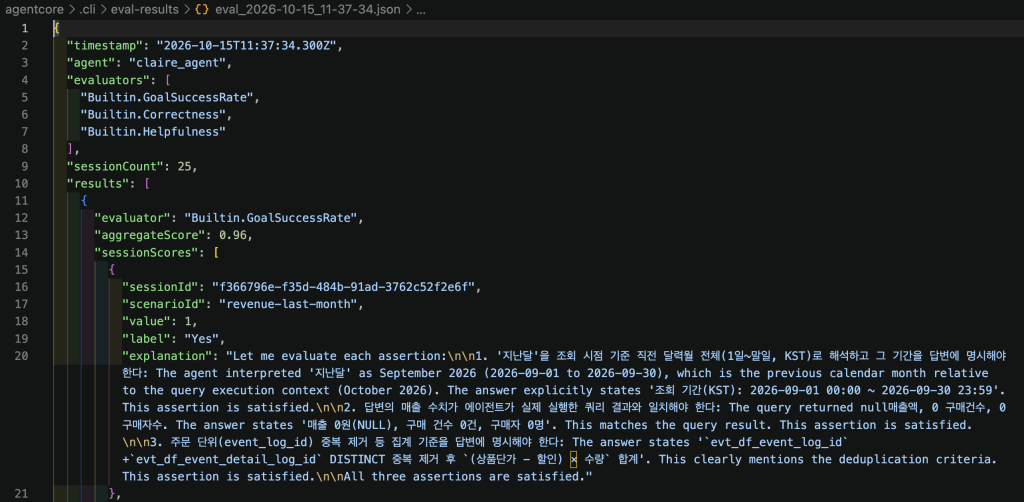
그림 4. AgentCore Evaluation 실행과 평가 결과 예시
실무적으로 중요한 것은 점수가 아니라 explanation입니다. 점수는 결론이 아니라 단서이며, 채점 근거를 trace의 실제 도구 호출과 교차 확인해야 실패의 원인이 에이전트인지, 평가 설정인지, 데이터셋인지 가려집니다. 참고로 데이터셋 없이 운영 중 쌓인 trace를 그대로 채점하는 모드(--days 7)도 있어, 재호출 비용 없이 최근 세션의 품질을 훑어볼 때 유용합니다.
4-3. 첫 평가: 에이전트보다 평가 체계가 먼저였다
재구축한 에이전트를 배포하고 처음 평가를 돌렸을 때, 목표 달성률(GoalSuccessRate)은 절반에도 미치지 못했습니다. 수동 테스트에서는 문제없이 동작하던 에이전트였기에 당황스러운 결과였습니다. 그런데 trace를 전수 조사해 보니 실패의 다수는 에이전트의 결함이 아니라, 품질을 재는 쪽인 평가 체계(평가 데이터셋과 evaluator 구성)의 결함이었습니다. 평가 시나리오가 도구에 placeholder 파라미터를 넘기고 있었고, 정답 기준에는 시점에 따라 달라지는 절대 수치가 하드코딩되어 있었습니다. 에이전트가 정확히 답해도 “실패”로 채점되는, 거짓 실패(false failure)가 섞여 있었던 것입니다.
여기서 확인할 수 있는 원칙은 분명합니다. 에이전트를 고치기 전에 평가 체계부터 검증해야 합니다. 평가 데이터셋은 다음 원칙으로 재설계했습니다.
- 절대 수치를 정답으로 두지 않는다. 답이 아니라 trajectory(도구 호출 과정) 를 상대적으로 판정한다.
- 에이전트가 가진 도구로 실제 수행 가능한 것만 요구한다.
- 정답 기준을 과잉 명세하지 않는다.
- 사용자의 모호한 질문은 모호한 채로 둔다. 되묻는 것도 정답 행동이다.
평가 체계를 고치고 나서야 남은 실패가 진짜 에이전트 결함으로 보이기 시작했고, 개선 루프가 회전하기 시작했습니다. 관측(Langfuse trace 분해) → 개선(프롬프트·구조 수정) → 배포(agentcore deploy) → 평가(agentcore run eval) → 채택 또는 롤백(agentcore cb versions / cb diff). 이 사이클을 하루에도 수차례 반복할 수 있었던 것은, 로컬 hot-reload 실행(agentcore dev)부터 배포·평가·롤백까지 전 과정이 하나의 CLI로 이어져 있었기 때문입니다.
agentcore dev                            # 개발: 로컬 hot-reload 실행·디버깅
agentcore deploy                         # 배포: 선언적 구성 기반 일괄 배포
agentcore invoke "질문" --session-id s1   # 확인: 멀티턴 호출
agentcore run eval --dataset predefined_dataset -e Builtin.GoalSuccessRate ...
                                         # 검증: 데이터셋 기반 품질 평가
agentcore cb versions / cb diff          # 관리: 프롬프트 버전 관리·롤백
4-4. 멀티턴 시나리오 확장
단일 질문 시나리오에서 전 항목을 통과한 뒤, 평가 데이터셋에 멀티턴 시나리오를 추가했습니다. 예를 들어 두 오디언스 집단의 합집합 인원을 묻고, 두 번째 턴에서 사용자가 틀린 수치(“합집합이 500명쯤 된다는 거지?”)를 제시하는 시나리오입니다. assertions는 합집합의 중복 제거와 함께, 사용자의 틀린 수치에 동조하지 않고(sycophancy 검증) 근거와 함께 정확한 수치를 유지하는지를 확인합니다. 시나리오를 추가하자마자 새로운 실패가 재현되었습니다. 만점이었던 데이터셋에 변별력이 다시 생긴 것입니다. 멀티턴 조건 병합과 응답 일관성을 개선한 뒤, 확장된 데이터셋에서도 전 시나리오 통과(만점) 를 회복했습니다.
4-5. 응답 시간 최적화
품질 다음은 속도였습니다. 복합 분석 질문은 응답까지 수 분이 걸리기도 했습니다. Langfuse에서 trace를 구간별로 분해해 보니 의외의 결과가 나왔습니다. 병목은 SQL 실행도 도구 호출도 아닌, 최종 답변을 생성하는 LLM 호출의 출력 토큰량이었습니다. 출력이 길수록 생성 시간이 비례해서 늘어난 것입니다.
해결책은 프롬프트에 응답 분량 지침을 추가하는 것 즉, 프롬프트 엔지니어링이었습니다.
- 수치 하나를 묻는 질문에는 해당 수치와 기간·집계 기준만 답합니다. - 인사이트·분석처럼 열린 요청은 핵심 발견 2~3개로 답하고, 표는 답변 전체에서 2개 이내로 유지합니다.
“간결하게 답하라” 같은 막연한 지시 대신 셀 수 있는 구체적 기준을 준 것이 효과적이었습니다. 여기에 도구 로딩을 질문 분류와 병렬로 시작하고 MCP 세션을 프로세스 수명 동안 유지하는 구조 최적화를 더해, 복합 분석 질문의 응답 시간을 프로토타입 기준 약 60% 단축했습니다. 품질 회귀가 없는지는 매번 같은 평가 데이터셋으로 확인했으므로, 속도를 얻기 위해 품질을 잃는 일은 없었습니다.
5. 마치며
약 1개월의 PoC 과정 중 확인한 것을 세 가지로 정리합니다.
- 구조: supervisor 기반 Agentic 구조는 기존 워크플로우가 답하지 못했던 복합 질의를 처리했고, 질문 성격별로 모델과 경로를 달리해 비용과 품질을 함께 잡을 수 있었습니다.
- 프로세스: “평가 체계부터 고친다”는 원칙 위에서, 데이터셋 기반 평가와 trace 관측으로 회전하는 개선 루프가 하루 수 회의 개선 사이클을 가능하게 했습니다.
- 한계 인지: 평가 만점은 끝이 아니라 데이터셋의 한계이며, 시나리오를 확장할 때마다 변별력이 되살아났습니다.
이 검증이 남긴 산출물은 프로토타입 코드 자체가 아니라 두 가지 자산입니다. 하나는 평가 체계입니다. 검증을 거친 평가 원칙과 데이터셋은 에이전트의 아키텍처가 무엇이든 클레어의 품질을 확인하는 방법으로 계속 쓰입니다. 다른 하나는 검증을 마친 로드맵입니다. supervisor 구조, Gateway + MCP 도구 서버, AgentCore Memory는 에이전트와 도구가 늘어나는 시점에 바로 도입할 수 있도록, 동작과 가치가 확인된 상태로 준비되어 있습니다.
아이지에이웍스가 프로덕션에서 먼저 선택한 것은 검증된 기존 LangGraph 워크플로우를 재작성 없이 AgentCore Runtime으로 이관하는 경로였습니다. 그 이관 과정과 부하 테스트·운영에서 확인한 성능·복원력 특성, 그리고 위 로드맵의 도입 계획을 2부에서 다룹니다.
1부 참고 자료
- Amazon Bedrock AgentCore 개발자 안내서
- AgentCore Evaluations
- AgentCore Observability 시작하기
- Amazon Bedrock AgentCore로 살펴보는 AgentOps 아키텍처 (Part 1)

문석민
문석민 아이지에이웍스 Data & AI Engineer 님은 디파이너리의 AI 에이전트 서비스와 데이터 플랫폼(파이프라인·DB)의 개발·운영 전반을 담당하고 있습니다. AI 서비스의 아키텍처 설계부터 실행 환경·배포 파이프라인·LLMOps(Langfuse, LiteLLM) 구축까지 기술 기반 전반을 책임지며, 테스트와 관측 데이터를 근거로 서비스의 성능과 운영 안정성을 개선해 나가고 있습니다.

장소진
장소진 아이지에이웍스 Data & AI Engineer 님은 디파이너리에서 데이터 분석과 CRM 마케팅 의사결정을 지원하는 AI 에이전트를 만들고 있습니다. Text-to-SQL과 시맨틱 레이어, AI 에이전트 아키텍처를 연구·개발하며, 평가·관측 데이터를 바탕으로 제품 품질과 운영 안정성을 지속적으로 개선하고 있습니다.