AWS 기술 블로그
기존 LangGraph 워크플로우를 Amazon Bedrock AgentCore Runtime으로: 아이지에이웍스 클레어의 프로덕션 이관과 운영 경험
이 글은 AWS와 아이지에이웍스가 함께한 프로젝트의 프로덕션 이관 경험을 다룹니다. 1부에서는 Agentic 프로토타입의 설계와 평가를 소개했습니다. 2부에서는 기존 서비스의 실행 환경을 이관한 과정과 이관에서 확인한 성능·운영 특성을 살펴봅니다.
들어가며
클레어(Claire)는 아이지에이웍스의 CDP & CRM 통합 플랫폼 디파이너리(DFINERY)에 내장된 AI 분석 에이전트입니다. Text-to-SQL 기반으로 마케터의 자연어 질문을 정확한 SQL 쿼리로 변환해 실행하고, 결과를 해석한 답변까지 제공합니다. 1부에서는 3A 프로그램으로 검증한 Agentic 아키텍처와 평가 주도 개선 루프를 다뤘습니다.
프로덕션 이관을 결정하게 한 것은 실행 모델의 한계였습니다. 기존 클레어는 여러 LangGraph 워크플로우가 Amazon ECS의 단일 컨테이너에서 실행되는 구조였습니다. LLM 에이전트의 요청 하나가 수십 초 이상의 I/O·연산 리소스를 점유하다 보니 동시 요청이 늘수록 응답 지연이 함께 커졌습니다. 대화형 분석 서비스에서 이 지연은 곧 사용자 경험의 저하였습니다. 또한 여러 워크플로우를 하나의 컨테이너로 운영하던 구성에서는 에이전트별 개별 배포와 독립적인 확장이 어려웠고, 한 워크플로우의 장애가 다른 워크플로우에도 영향을 줄 수 있었습니다. ECS에서도 서비스를 나누고 태스크를 늘려 대응할 수 있습니다. 하지만 클레어가 AgentCore Runtime을 선택한 이유는 이러한 실행 환경의 관리와 세션 라우팅을 플랫폼에 맡기면서, 에이전트별 분리 배포와 세션 단위의 실행 환경 격리를 확보하기 위해서였습니다. 이관의 원칙은 검증된 기존 자산을 재작성하지 않는 것이었습니다. 먼저 기존 LangGraph 워크플로우를 유지한 채 실행 환경을 옮기고, 그다음 관측과 부하 테스트를 바탕으로 애플리케이션을 최적화했습니다. 이 과정에서는 관측 데이터를 바탕으로 판단하고 개선했으며, 이를 뒷받침한 관측 체계는 4장에서 정리합니다. 1부의 프로토타입 구성과 프로덕션 구성은 다음과 같습니다.
|
항목 |
프로토타입 (1부, 검증) |
프로덕션 이관 (2부, 운영) |
| 에이전트 구조 | LangGraph supervisor — triage/clarify/SQL ReAct | 기존 LangGraph 워크플로우 유지 |
| 도구 연결 | AgentCore Gateway + MCP 분리 도구 서버 | 워크플로우 내 직접 호출 — Gateway/MCP는 향후 도입 검토 |
| 세션 연속성 | AgentCore Memory | LangGraph checkpointer — AgentCore Memory 도입 검토 중 |
| 실행 환경 | 기본 네트워크 구성 | VPC 모드 Runtime, 에이전트별 IAM 역할·보안 그룹 분리 |
| 메타 DB | 검증 환경 구성 | Amazon RDS for MySQL |
1. 프로덕션 이관
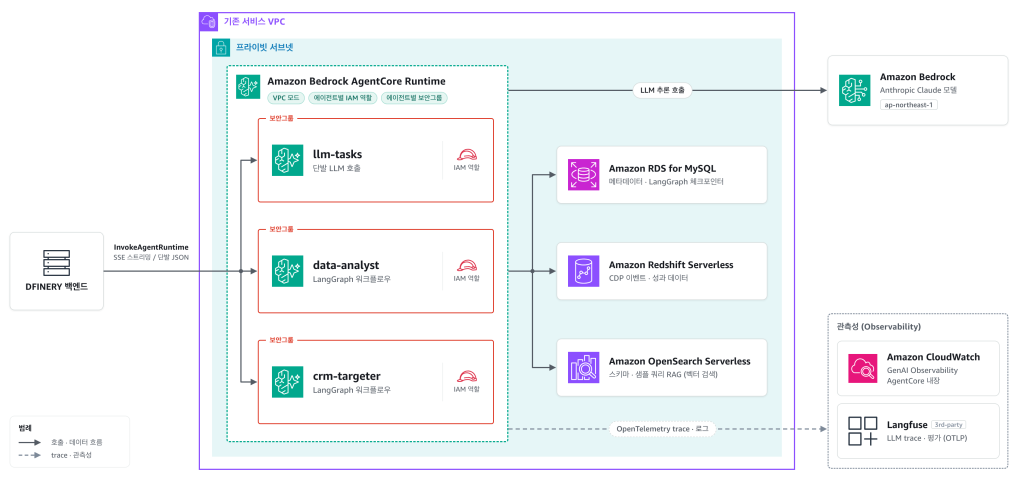
그림 1. 프로덕션 아키텍처
1-1. 프로토콜: /invocations와 /ping
AgentCore Runtime의 HTTP 프로토콜(공식 문서의 ‘서비스 계약‘)에서 핵심 애플리케이션 인터페이스는 두 엔드포인트입니다. 컨테이너가 POST /invocations로 요청을 받고 GET /ping으로 헬스 상태를 알리면, 내부 구현은 자유입니다. 기존 FastAPI + LangGraph 앱에는 이 인터페이스를 맞추는 어댑터 수준의 수정만 필요했습니다.
app = FastAPI()

@app.get("/ping")
async def ping() -> dict:
    # 컨테이너가 뜨면 healthy (의존성은 첫 invoke에 lazy 구성)
    return {"status": "Healthy"}

@app.post("/invocations")

async def invocations(request: Request) -> StreamingResponse:
    payload = await request.json()
    # 기존 LangGraph 워크플로우를 재작성 없이 그대로 호출
return StreamingResponse(run_workflow(payload), media_type="text/event-stream")/ping은 컨테이너가 뜨면 바로 Healthy를 반환합니다. 플랫폼이 이 응답으로 실행 환경의 준비 상태를 판단하므로, 시크릿 로딩 같은 의존성 초기화를 기동 시점에 모두 끝내려 하면 서빙 가능 시점만 늦어집니다. 의존성은 첫 요청에서 한 번만 구성하고 이후 재사용하는 lazy 방식을 택했습니다. 프레임워크 교체도, 그래프 재설계도 없었습니다. AgentCore 도입을 위해 기존 워크플로우를 Agentic 구조로 바꿀 필요는 없었습니다. 결정론적 워크플로우도 프로토콜만 맞추면 세션 격리·분리 배포라는 실행 모델의 이점을 그대로 얻습니다. 구조 전환은 그 위에서 별도로 진행할 수 있는 독립적인 결정입니다.
1-2. 호출과 세션 식별자
호출하는 쪽은 기존 내부 HTTP 호출을 InvokeAgentRuntime API로 전환했습니다. 인증은 IAM(SigV4)으로 통일되고, runtimeSessionId가 세션 라우팅을 담당합니다. 같은 세션 ID의 요청은 같은 실행 환경으로 이어지므로, 대화 중인 세션은 warm 상태의 환경을 재사용합니다. 응답은 두 형태를 모두 사용합니다. 사용자와 대화하는 채팅 경로는 text/event-stream으로 SSE 스트리밍을, 스트리밍이 필요 없는 단발 작업은 application/json으로 단발 JSON을 받습니다.
여기서 한 가지 설계 결정이 필요했습니다. runtimeSessionId는 요청을 실행 환경으로 연결하는 인프라 세션의 식별자이고, LangGraph의 thread_id는 저장된 대화와 워크플로우 상태를 찾는 식별자입니다. 처음에는 세션 ID를 checkpointer의 thread_id로 그대로 쓰는 것도 검토했지만, 두 식별자는 수명이 다릅니다. 실행 환경은 유휴 후 종료되거나 교체될 수 있는 반면, 대화 상태는 그보다 오래 살아남아야 합니다. 그래서 워크플로우 상태의 키(thread_id)는 애플리케이션이 독립적으로 발급해 checkpointer에 저장했습니다. 이렇게 분리하면 사용자 확인을 기다렸다가 이어가는 human-in-the-loop 재개가 실행 환경과 무관하게 동작합니다. 어떤 세션에서 재개 요청이 오든 checkpointer에서 상태를 복원하면 되기 때문입니다. 반대로 진행 중인 작업의 취소는 같은 세션 ID로 보내야 합니다. 실행 중인 작업은 그 실행 환경의 메모리에 있기 때문입니다. 인프라 세션과 대화 상태를 분리한 덕분에, 라우팅은 플랫폼에 맡기고 연속성은 기존 checkpointer 자산으로 유지할 수 있었습니다.
1-3. VPC와 권한 분리
클레어는 Redshift, OpenSearch, RDS MySQL 등 기존 데이터 계층과 통신해야 하므로, Runtime을 VPC 모드로 구성하고 기존 서비스가 사용하는 프라이빗 서브넷과 보안 그룹을 지정해, 데이터 계층에 프라이빗 경로로 접근하도록 했습니다. 지정한 서브넷에 생성되는 ENI를 통해 에이전트의 아웃바운드 트래픽이 VPC를 거치므로, 데이터 계층 접근을 기존과 같은 프라이빗 경로와 보안 그룹 규칙으로 통제할 수 있습니다. 여기에 에이전트별 IAM 역할과 보안 그룹을 분리해, 에이전트가 늘어나도 각자 필요한 최소 권한만 갖도록 했습니다. 단일 컨테이너에서 모든 워크플로우가 하나의 태스크 역할을 공유하던 것과 대비되는 지점입니다.
2. 부하 테스트와 최적화
클레어와 같은 Text-to-SQL 서비스의 사용 패턴은 반복적인 대화에 가깝습니다. 사용자는 한 번의 질문으로 분석을 끝내기보다, 조회 결과를 확인한 뒤 조건을 바꾸거나 파생 질문을 이어가며 데이터를 탐색합니다. 질문과 결과 확인이 여러 차례 반복되는 과정에서는 매 요청의 응답 지연이 누적되고, 특히 첫 응답까지의 대기가 길어질수록 분석의 흐름이 끊깁니다. 그래서 클레어는 전체 처리 시간과 함께 사용자가 질문한 뒤 첫 응답을 받기까지의 시간(TTFT) 을 핵심 성능 지표로 삼았습니다. 문서를 읽는 것과 실제 부하를 걸어 사용자 응답을 확인하는 것은 다릅니다. 문서로 이해한 실행 모델이 실제 동시 요청과 세션의 첫 요청에서 어떤 사용자 경험으로 나타나는지는 직접 측정해야 했습니다.
결과부터 말하면, 단일 컨테이너에서 커지던 고동시성 지연은 실행 단위를 나누면 완화되고, 기존 워크플로우를 그대로 옮긴 AgentCore에서도 고동시성에서 ECS scaleout과 대등한 수준의 첫 응답 성능을 확인했습니다. 여기서 이관 후 드러난 첫 응답 경로를 최적화한 결과, 동시성 16의 초기화된 세션 기준 TTFT p95는 기존 ECS single 대비 약 5.5초 줄었습니다. 아래에서는 기준선 비교, 첫 응답 경로의 최적화, 개선 후 결과 순으로 설명합니다.
2-1. 이관 전후 기준선
비교의 출발점은 기존 워크플로우 코드를 그대로 AgentCore Runtime으로 이관한 버전입니다. 비교군은 기존 단일 태스크 구성(ECS single)과 여러 태스크에 요청을 분산한 구성(ECS scaleout)입니다. AgentCore는 초기화된 세션을 재사용하는 Warm과 사전 호출 없이 새 세션을 사용하는 두 조건으로 측정했습니다. 각 실행 환경과 세션 조건에서 동일한 질문 16개를 동시성 1·4·8·16으로 요청하고, 각 동시성 조건을 3회 반복했습니다. 조건별로 총 48건의 첫 응답 시간을 집계해 95백분위수(TTFT p95)를 비교했습니다. 짧은 시간에 신규 세션이 몰릴 때의 초기화 특성은 3-1에서 별도로 다룹니다.
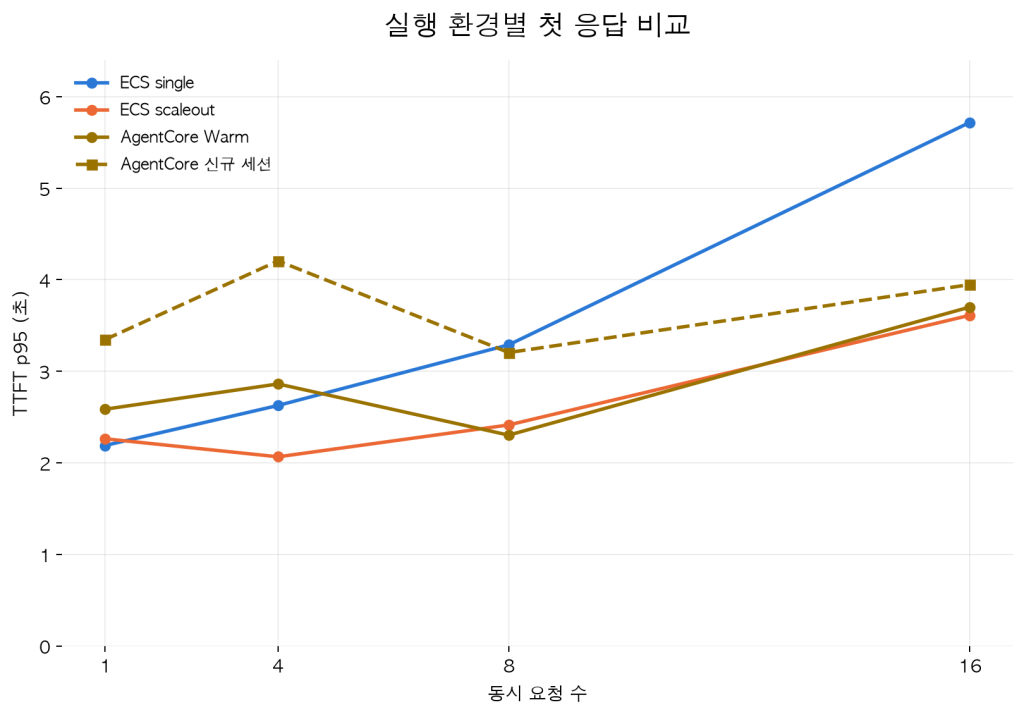
그림 2. ECS와 AgentCore의 TTFT p95 비교
ECS single은 동시 요청이 늘면서 첫 응답 지연이 커졌고, 동시성 16에서 TTFT p95가 5.719초까지 증가했습니다. ECS scaleout은 같은 조건에서 3.612초로 지연을 완화했습니다. AgentCore는 동시성 16에서 Warm 3.702초, 신규 세션 3.947초로 ECS scaleout과 대등한 수준을 보였습니다. 기존 워크플로우를 그대로 옮긴 상태에서도 고동시성 기준선 성능을 유지한 것입니다. AgentCore에서는 각 Runtime 세션에 격리된 실행 환경을 할당하고, 프로비저닝과 세션 라우팅을 플랫폼이 담당합니다. ECS scaleout과 대등한 고동시성 성능을 확보하면서, 태스크 수와 Auto Scaling 정책을 직접 관리하는 부담을 줄이고 세션 단위 격리를 얻을 수 있다는 점을 이관의 이점으로 판단했습니다.
2-2. 첫 응답 경로 최적화
실행 환경을 옮긴 뒤에는 애플리케이션이 첫 응답을 만들기까지 수행하는 작업을 살폈습니다. 요청마다 반복되는 준비 비용과 불필요한 모델 호출을 줄이고, 신규 세션에서 필요한 초기화 시간을 단축하는 데 집중했습니다.
첫째, 반복되는 그래프 준비를 줄였습니다. 최적화 전에는 요청마다 LangGraph 그래프를 다시 컴파일했습니다. 최적화 후에는 실행 환경에서 컴파일한 그래프를 재사용하도록 해, 같은 환경에서 요청할 때 반복되는 준비 비용을 줄였습니다.
둘째, 요청 경로에서 불필요한 작업을 줄였습니다. 질문을 정제하는 단계에서 불필요한 LLM 호출을 제거하고, 모든 요청에 넣던 쿼리 생성 규칙은 필요한 경우에만 주입하도록 바꿨습니다. 모델 호출 단계와 입력을 간소화하는 애플리케이션 수준의 개선입니다.
셋째, 초기화 시간을 줄였습니다. 시크릿 로딩과 클라이언트 구성 등 독립적으로 준비할 수 있는 의존성을 병렬로 초기화해 순차 대기 시간을 줄였습니다.
함께 적용한 데이터 계층 개선. Redshift Serverless는 유휴 후 첫 쿼리에서 간헐적으로 수십 초 지연되는 특성이 있습니다. 질문이 DB 질의로 판별되는 시점에 워밍 쿼리를 fire-and-forget으로 먼저 보내, 스키마 검색과 쿼리 생성이 진행되는 동안 웜업이 겹쳐 일어나도록 했습니다. 한 가지 주의할 점은 SELECT 1처럼 리더 노드에서 끝나는 쿼리로는 컴퓨트가 깨어나지 않는다는 것입니다. 실제 테이블을 읽는 가벼운 쿼리를 사용해야 했습니다.
2-3. 최적화 후 재측정
같은 부하 조건에서 개선 적용 전·후의 첫 응답 시간을 다시 측정했습니다. 신규 세션과 초기화된 세션을 재사용하는 Warm 조건을 각각 비교했습니다.
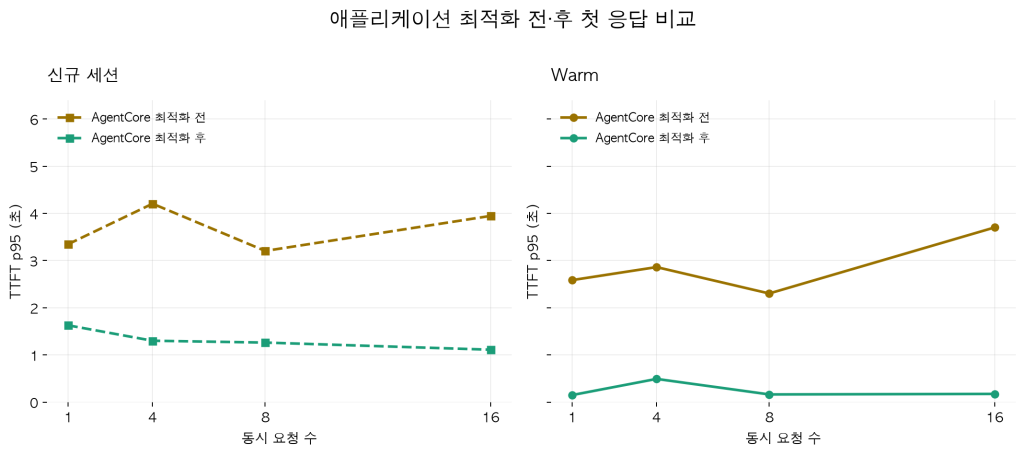
그림 3. 애플리케이션 최적화 전·후 TTFT p95 비교
동시성 16에서 신규 세션의 TTFT p95는 3.947초에서 1.111초로 줄었습니다. 초기화된 Warm 세션에서는 3.702초에서 0.174초로 줄어, 신규 대화의 첫 요청과 같은 세션의 후속 요청 모두에서 더 빠르게 첫 응답을 전달할 수 있었습니다.
3. 세션 단위 실행 모델과 운영
성능 개선과 함께, 세션 단위로 실행 환경이 생성되고 종료되는 모델에 맞춰 운영 방식도 조정해야 했습니다. 다음은 신규 세션이 몰릴 때의 시작 지연부터 커넥션 관리, 종료 처리까지 운영에서 고려해야 했던 특성과 대응을 정리합니다.
3-1. 신규 세션 급증과 콜드 스타트
동일 세션을 재사용하며 요청량을 늘리는 것과 짧은 시간에 새로운 세션이 몰리는 것은 다른 부하 패턴입니다. 전자는 이미 준비된 실행 환경의 처리 능력을 확인하지만, 후자는 새 실행 환경을 확보하는 경로까지 수행합니다. 따라서 동시 요청 수뿐 아니라 신규 세션의 유입 속도는 별도의 축으로 봐야 했습니다.
신규 세션의 시작 지연은 곧 새 대화를 시작한 사용자가 첫 응답을 기다리는 시간이기도 합니다. 별도 버스트 테스트에서 이 차이가 수치로 드러났습니다. 단발로 들어오는 신규 세션은 약 1초에 첫 응답이 시작됐고, 21시간 완전 유휴 후의 첫 호출도 0.9초에 시작됐습니다. 그런데 단시간에 신규 세션이 일정 수준을 넘어서는 순간부터는 첫 응답까지 9.5~10.8초(p90 9.65초) 가 일정하게 소요됐고, 그보다 더 몰리면 일부 요청은 초기화 실패(“Runtime initialization time exceeded”)로 이어졌습니다. 이때 애플리케이션 초기 구동은 0.6초에 불과했으므로, 지연의 지배 요소는 앱이 아니라 실행 환경을 새로 준비하는 구간이었습니다.
원인 구조는 AWS의 지원을 받아 함께 확인했습니다. AgentCore Runtime은 시작 지연을 줄이기 위해 미리 프로비저닝한 실행 환경(pre-warmed)을 엔드포인트 단위로 유지하고, 신규 세션 요청에 이를 배정합니다. 21시간 유휴 후에도 0.9초로 시작될 수 있었던 이유입니다. 따라서 단시간 신규 세션 수가 미리 준비된 용량을 초과하는 순간부터, 초과분은 VM 프로비저닝·이미지 풀링(Pull)·컨테이너 기동·앱 초기화를 모두 거치는 콜드 스타트 경로를 타게 됩니다. 이는 API 스로틀링이 아니라 컴퓨트 프로비저닝 계층의 동작이어서 Service Quota 사용률과 무관했고, 관련 지표에도 잡히지 않았습니다. 외부에서 첫 응답 시간을 직접 측정하지 않았다면 원인을 좁히기 어려웠을 특성입니다.
3-2. 콜드 스타트 완화
먼저 콜드 스타트를 완화하기 위한 시도로 앱 쪽에서 컨테이너 이미지를 가볍게 유지했습니다. 빌드 도구와 캐시, 실행에 필요 없는 바이너리가 최종 이미지에 남지 않도록 관리했습니다. 이미지 경량화는 개별 콜드 스타트를 줄일 뿐 아니라 pre-warmed 용량의 보충 속도를 높여 같은 용량으로 흡수할 수 있는 신규 세션 수를 늘리는 이중 효과가 있습니다. 적용을 마친 조치와 별개로 검토 단계의 대안도 있습니다. 트래픽을 여러 엔드포인트로 분산하는 구성은 warm 용량이 엔드포인트 단위로 유지되는 특성상 전체 warm 용량을 비례로 늘릴 수 있어, 향후 유입 패턴에 따라 검토하는 방안으로 남겼습니다. 세션을 미리 만들어 두는 사전 생성 풀 패턴도 대안이지만, 유휴 세션도 메모리 비용은 발생하므로 비용과 함께 판단할 문제입니다. 이와 별개로 warm pool 관리 없이 저지연 초기화를 제공하는 기능이 준비 중이라는 안내를 받아, 정식 출시 이후 전환을 검토할 계획입니다(AgentCore Runtime V2에 대한 언급이며, 블로그 작성 당시에는 출시 전이었음을 밝힙니다).
3-3. 커넥션 관리
기존 ECS에서는 하나의 컨테이너가 오래 실행되며, 메타데이터 조회와 LangGraph 상태 저장에 사용하는 RDS MySQL 커넥션 풀을 여러 요청이 공유했습니다. 세션별 실행 환경에서는 각각의 수명과 유휴 시간이 달라지므로 같은 가정을 그대로 사용할 수 없었습니다. 그래서 먼저 풀 크기부터 다시 정했습니다. ECS에서는 컨테이너 하나가 여러 동시 요청을 처리하므로 넉넉한 풀이 정당했지만, 세션별 실행 환경은 세션 하나만 서빙합니다. 큰 풀 설정을 그대로 유지하면, 활성 세션이 늘어날수록 각 실행 환경의 풀이 확보할 수 있는 연결 수도 함께 증가해 DB 연결 한도에 부담을 줄 수 있습니다. 따라서 풀 크기를 실행 환경 하나가 실제로 사용하는 수준으로 줄였습니다.
실행 환경이 유지된 채 세션이 한동안 쉬었다가 다시 요청을 받을 때(유휴 세션은 기본 15분 후 종료되므로, 그 안에서 재개되는 경우입니다), DB 커넥션은 이미 끊겼거나 한쪽만 연결이 살아 있다고 판단하는 half-open 상태일 수 있습니다. 커넥션을 사용하기 전에 유효성을 확인하는 pool_pre_ping 같은 옵션을 적용해, 유휴 중 끊긴 커넥션을 그대로 사용하는 문제를 줄였습니다. Runtime의 실행 환경 자체가 종료된 경우에는 다음 요청에서 새 환경이 필요합니다. 반면 실행 환경은 남아 있고 DB 연결만 끊긴 경우에는 커넥션 검증과 재연결이 필요합니다. 두 상황을 구분해 세션과 데이터 연결의 수명을 관리했습니다.
3-4. 종료 처리
세션 단위 실행 환경에서는 종료를 정상적인 수명 주기의 일부로 다뤄야 합니다. 종료 신호를 받으면 진행 중인 작업을 정리하고, 버퍼에 남은 로그와 Langfuse span을 flush하는 graceful shutdown을 구현했습니다. 종료 시 정리는 실행 가능한 시간 안에서 최선을 다하는 처리입니다. 갑작스러운 종료까지 모든 작업과 관측 데이터의 보존을 보장한다고 가정하지 않았습니다. 중요한 실행 상태는 메모리에만 의존하지 않고 기존 checkpointer 등 상위 계층을 통해 이어갈 수 있도록 했습니다.
4. 관측성
4-1. 기존 관측의 한계
실행 환경을 옮길 때 기능이 정상적으로 동작하는 것만큼 중요한 조건은 문제가 발생했을 때 원인을 추적할 수 있는가였습니다. 세션마다 실행 환경이 나뉘는 AgentCore에서는 개별 실행 환경에 흩어진 기록을 요청 단위로 연결하는 일이 더욱 중요해졌습니다. 이전 ECS 환경에서 짧은 Bedrock 호출이 약 1분 동안 지연된 적이 있었습니다. 관련 trace와 AWS 기록을 대조했지만, 애플리케이션 로그에 timeout 예외와 재시도 과정이 남아 있지 않아 원인을 확정하기 어려웠습니다. 이 경험을 계기로, 이관 과정에서는 지연이 발생한 워크플로우 단계뿐 아니라 모델 호출의 실패와 재시도까지 연결해 추적할 수 있도록 관측을 보완했습니다.
4-2. 워크플로우와 Runtime 기록 연결
워크플로우 수준에서는 기존 Langfuse 자산을 유지했습니다. 요청마다 trace_id를 생성하고 LangGraph 실행에 Langfuse의 LangChain 콜백 핸들러를 주입해, 각 노드의 LLM 호출과 시작·소요 시간을 하나의 trace에서 확인했습니다. 대화 ID와 에이전트 태그를 함께 기록해 같은 대화의 여러 요청과 에이전트 유형도 구분했습니다. 실행 환경이 바뀌어도 워크플로우를 분석하는 관점은 유지할 수 있었습니다. CloudWatch에는 애플리케이션의 구조화 로그를 수집했습니다. 모델 호출을 위한 BEDROCK_CALL, 요청의 오류·취소를 위한 AGENT_ERROR, 애플리케이션 초기화를 위한 COLD_START를 구분했습니다. trace_id는 워크플로우 trace와 오류 로그를, job_id는 오류 로그와 모델 호출 로그를 이어주는 기준으로 사용했습니다.
|
기록 |
확인하려는 내용 |
주요 연결 정보 |
| Langfuse trace | 요청 내부의 노드·LLM 실행 흐름과 소요 시간 | trace_id, 대화 ID, 에이전트 태그 |
| BEDROCK_CALL | 모델 호출 결과, 경과 시간, 재시도와 예외 | job_id, 실행 단계, AWS request ID |
| AGENT_ERROR | 요청의 오류·취소와 실행 컨텍스트 | trace_id, job_id, 에이전트 유형 |
| COLD_START | 의존성 초기화와 그래프 준비에 걸린 시간 | 에이전트 유형, 해당 실행 환경의 로그 스트림 |
BEDROCK_CALL은 모델 호출의 실패와 재시도를 워크플로우 단계에 연결하기 위한 기록입니다. 호출 시도 번호와 예외 유형 등을 남기고, 비동기 워커 스레드에서도 어떤 요청과 단계의 호출인지 식별할 수 있도록 실행 컨텍스트를 전달했습니다. 요청 수립 단계뿐 아니라 응답 스트림을 읽는 도중에도 실패가 발생할 수 있으므로, SDK 이벤트 훅만으로 포착되지 않는 스트리밍 예외는 애플리케이션 코드에서 별도로 기록했습니다.
AGENT_ERROR는 처리된 예외, 처리되지 않은 예외, 취소를 구분했습니다. CloudWatch Logs의 구독 필터와 Lambda를 통해 오류 알림을 Slack으로 전달하고, 알림에 해당 Langfuse trace 링크를 포함했습니다. 이를 통해 오류를 확인한 운영자가 해당 요청의 워크플로우 흐름을 이어서 살펴볼 수 있도록 했습니다.
COLD_START는 워크플로우 실행 전에 수행되는 애플리케이션 준비 시간을 별도로 기록했습니다. 이를 외부에서 측정한 TTFT와 함께 살펴, 첫 응답 대기 시간 중 애플리케이션 초기화가 차지하는 부분을 확인했습니다. 이 기록은 초기화 개선 효과를 확인하고, 신규 세션의 시작 지연을 분석하는 데 활용했습니다.
클레어에서는 Langfuse로 요청 하나의 내부 실행 흐름을 살피고, CloudWatch의 구조화 로그로 여러 실행 환경에서 발생한 timeout·재시도·오류 패턴과 초기화 소요 시간을 함께 확인했습니다. 이렇게 요청의 실행 흐름, 모델 호출, 초기화 기록을 연결해 지연이나 오류가 발생했을 때 확인해야 할 구간을 좁힐 수 있었습니다.
이 관측 기반은 앞서 살펴본 이관 전후의 성능 비교와 초기화 개선, 신규 세션 급증과 Runtime 종료에 대한 운영 대응을 뒷받침했습니다.
5. 앞으로의 확장
이번 이관에서는 기존 워크플로우를 유지한 채 실행 환경을 전환하는 데 집중했습니다. 이후에는 에이전트와 도구의 활용 범위에 맞춰, 1부에서 살펴본 Gateway·MCP와 AgentCore Memory의 도입을 검토하려고 합니다. AgentCore Gateway와 MCP 도구 서버는 도구를 여러 에이전트가 공유해야 하는 시점의 확장 방향입니다. 현재는 도구가 워크플로우 안에 있어 직접 호출하지만, 에이전트가 늘면 도구를 별도 서버로 분리하고 발견·인증을 표준화하는 구성이 재사용과 관리에 도움이 될 수 있습니다. 대화 중 워크플로우의 상태 저장과 재개는 현재 LangGraph checkpointer로 처리합니다. 여러 대화에 걸쳐 사용자의 분석 패턴이나 자주 사용하는 지표를 기억할 필요가 커지면, AgentCore Memory의 도입 범위를 별도로 검증할 계획입니다.
6. 마치며
클레어의 이관은 기존 LangGraph 워크플로우를 재작성하지 않고 실행 환경을 전환하는 것에서 시작했습니다. 세션 단위 격리와 에이전트별 분리 배포를 확보하고, 실행 환경의 프로비저닝과 세션 라우팅은 플랫폼에 맡겼습니다. 부하 테스트에서는 단일 컨테이너에서 커지던 높은 동시성 지연이 ECS scaleout으로 완화되는 것을 확인했습니다. 기존 워크플로우를 그대로 이관한 AgentCore에서도 ECS scaleout과 대등한 수준의 첫 응답 성능을 확인했고, 이후 애플리케이션의 초기화와 요청 처리 경로를 최적화해 첫 응답 시간을 줄였습니다. 실행 환경의 수명이 세션 단위로 바뀐 만큼 신규 세션 유입에 대한 용량 대응, 커넥션 관리, 종료 처리도 함께 조정했습니다. Langfuse와 CloudWatch의 기록을 연결한 관측 기반은 문제의 원인을 좁히고 코드와 운영 정책을 개선하는 근거가 됐습니다.
이번 이관은 검증된 기존 자산을 유지하면서도 서비스의 확장과 운영 방식을 바꿀 수 있음을 보여줬습니다. 실행 모델을 전환한 뒤에도 실제 부하와 운영 기록을 바탕으로 개선을 이어가는 것이 중요했습니다. 클레어의 경험이 기존 에이전트 서비스를 확장하려는 팀에 참고가 되기를 바랍니다.
2부 참고 자료
- Amazon Bedrock AgentCore 개발자 안내서
- AgentCore Runtime HTTP 프로토콜
- AgentCore Runtime 세션 격리와 수명 주기
- AgentCore Runtime 수명 주기 설정
- AgentCore Runtime VPC 연결

문석민
문석민 아이지에이웍스 Data & AI Engineer 님은 디파이너리의 AI 에이전트 서비스와 데이터 플랫폼(파이프라인·DB)의 개발·운영 전반을 담당하고 있습니다. AI 서비스의 아키텍처 설계부터 실행 환경·배포 파이프라인·LLMOps(Langfuse, LiteLLM) 구축까지 기술 기반 전반을 책임지며, 테스트와 관측 데이터를 근거로 서비스의 성능과 운영 안정성을 개선해 나가고 있습니다.

장소진
장소진 아이지에이웍스 Data & AI Engineer 님은 디파이너리에서 데이터 분석과 CRM 마케팅 의사결정을 지원하는 AI 에이전트를 만들고 있습니다. Text-to-SQL과 시맨틱 레이어, AI 에이전트 아키텍처를 연구·개발하며, 평가·관측 데이터를 바탕으로 제품 품질과 운영 안정성을 지속적으로 개선하고 있습니다.