AWS 기술 블로그
모두의주차장 AI 음성 주차 개발기: AWS AI-DLC 워크숍에서 출시까지
모두의주차장 소개
모두의주차장은 쏘카가 운영하는 온라인 주차 플랫폼으로, 2013년 서비스를 시작했습니다. 일주차와 월주차, 공유주차 정보를 제공하며, 사용자는 앱에서 목적지 주변 주차장의 위치와 요금, 이용 시간을 비교하고 제휴 주차장의 할인 주차권을 구매할 수 있습니다. 주차장을 선택한 뒤에는 티맵이나 카카오내비로 길 안내를 받을 수 있습니다.
주차장 운영자에게는 비어 있는 주차 공간을 운전자와 연결하고, 판매와 정산을 관리할 수 있는 서비스를 제공합니다. 건물 주차장의 유휴 시간대나 집 앞·가게 앞의 주차 공간을 공유해 수익을 얻을 수 있도록 지원하고 있습니다.
|
주차장 조회 |
이용권 결제 |
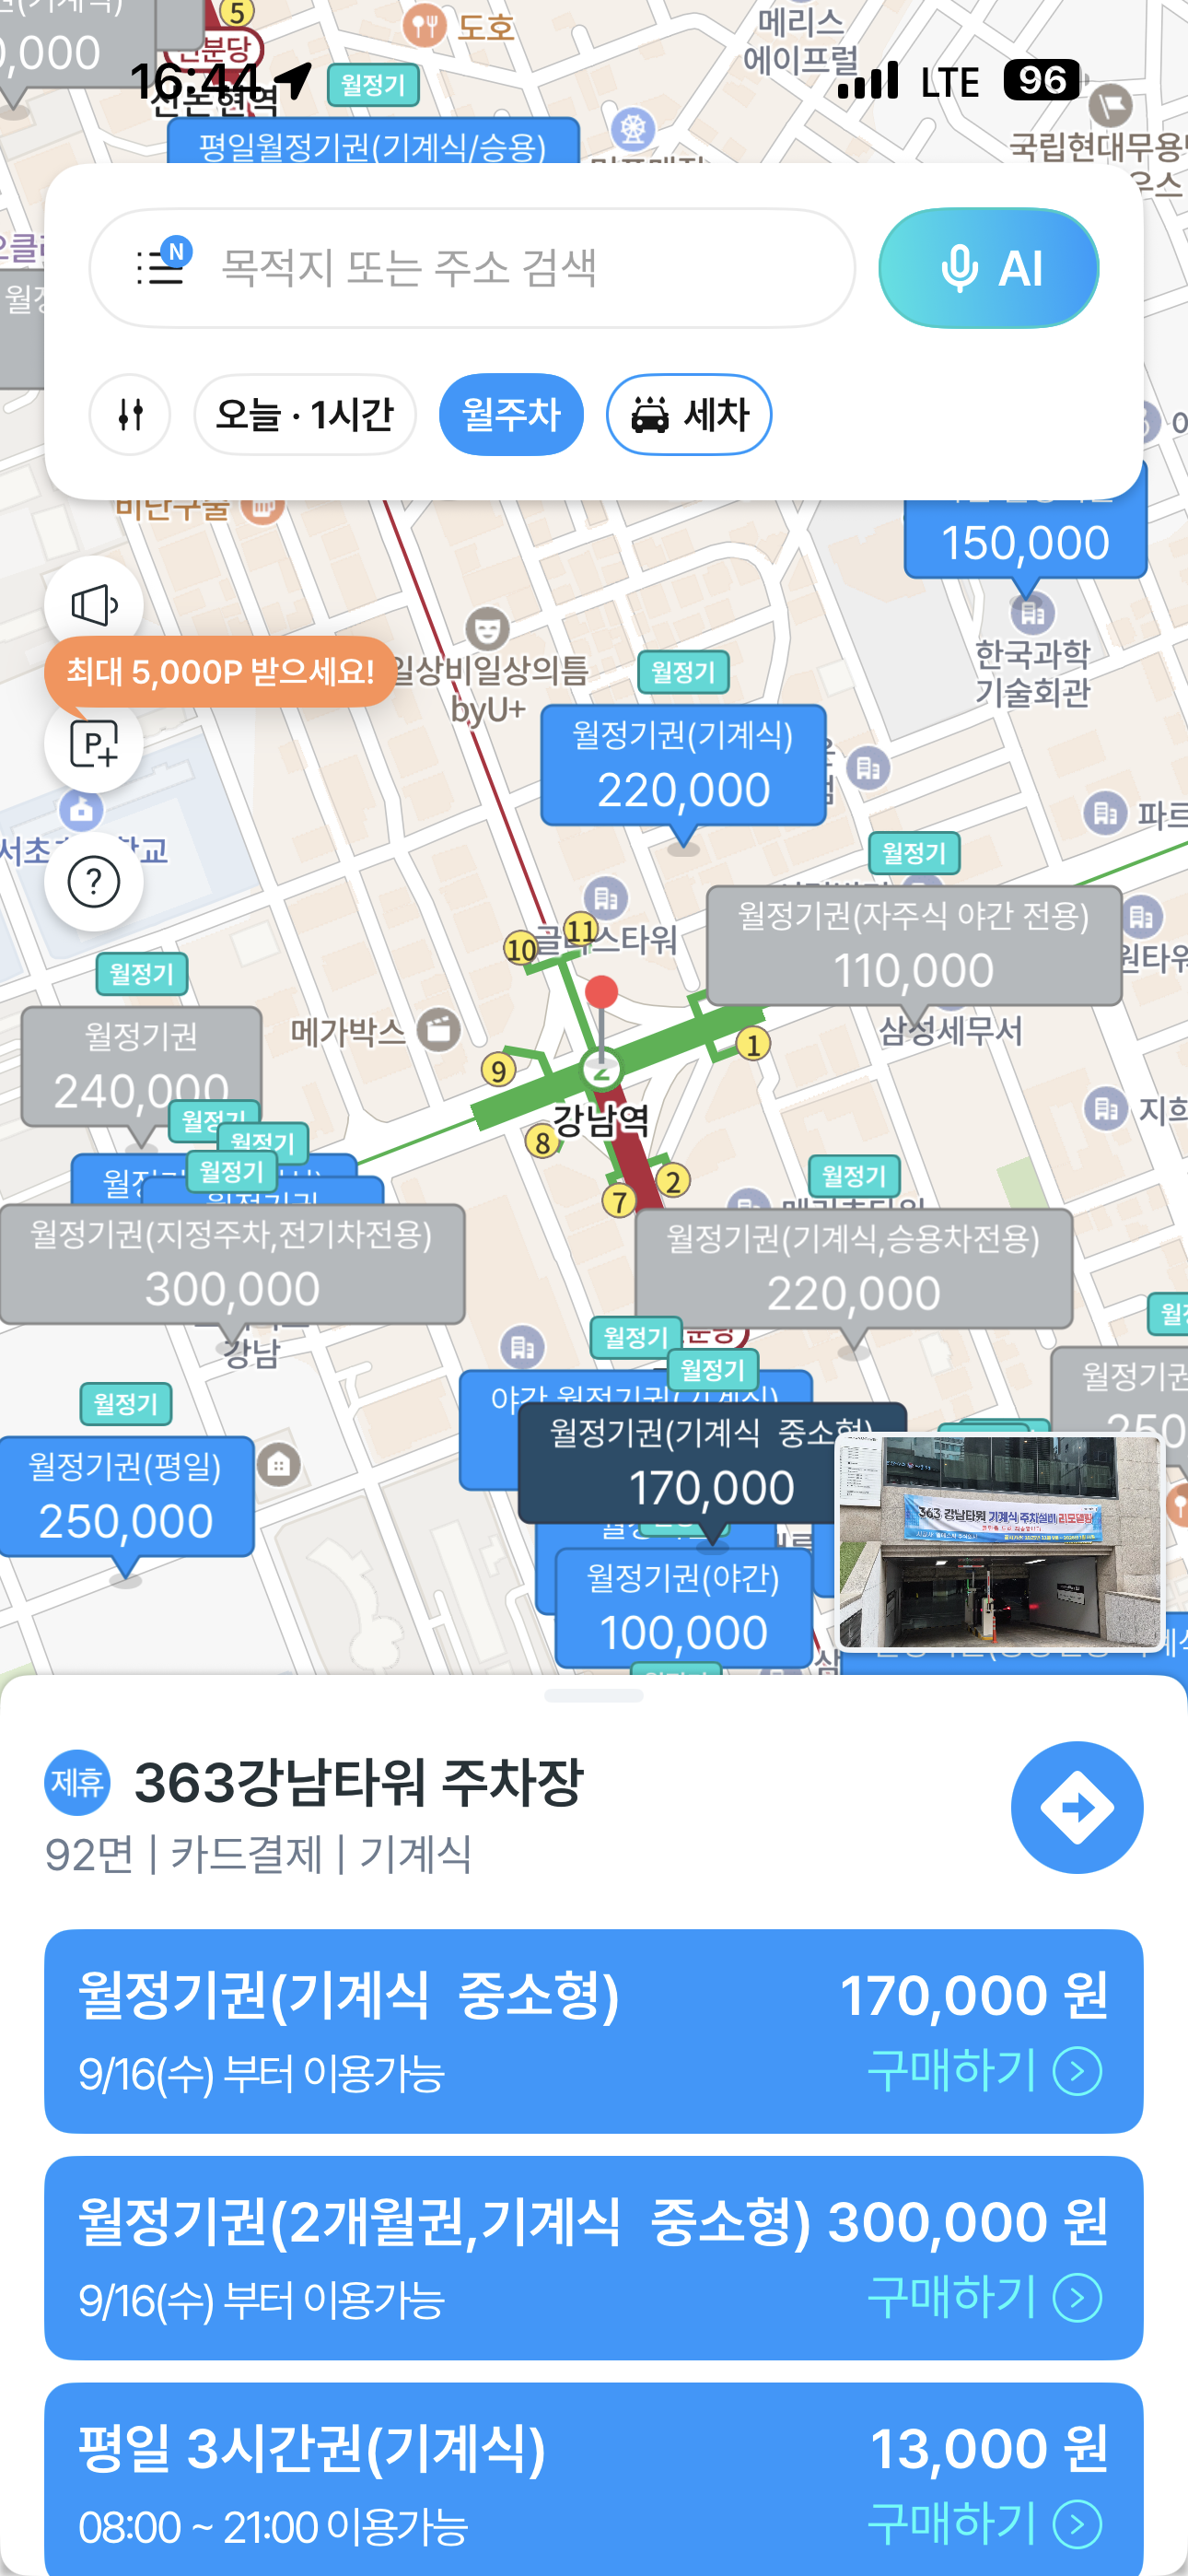
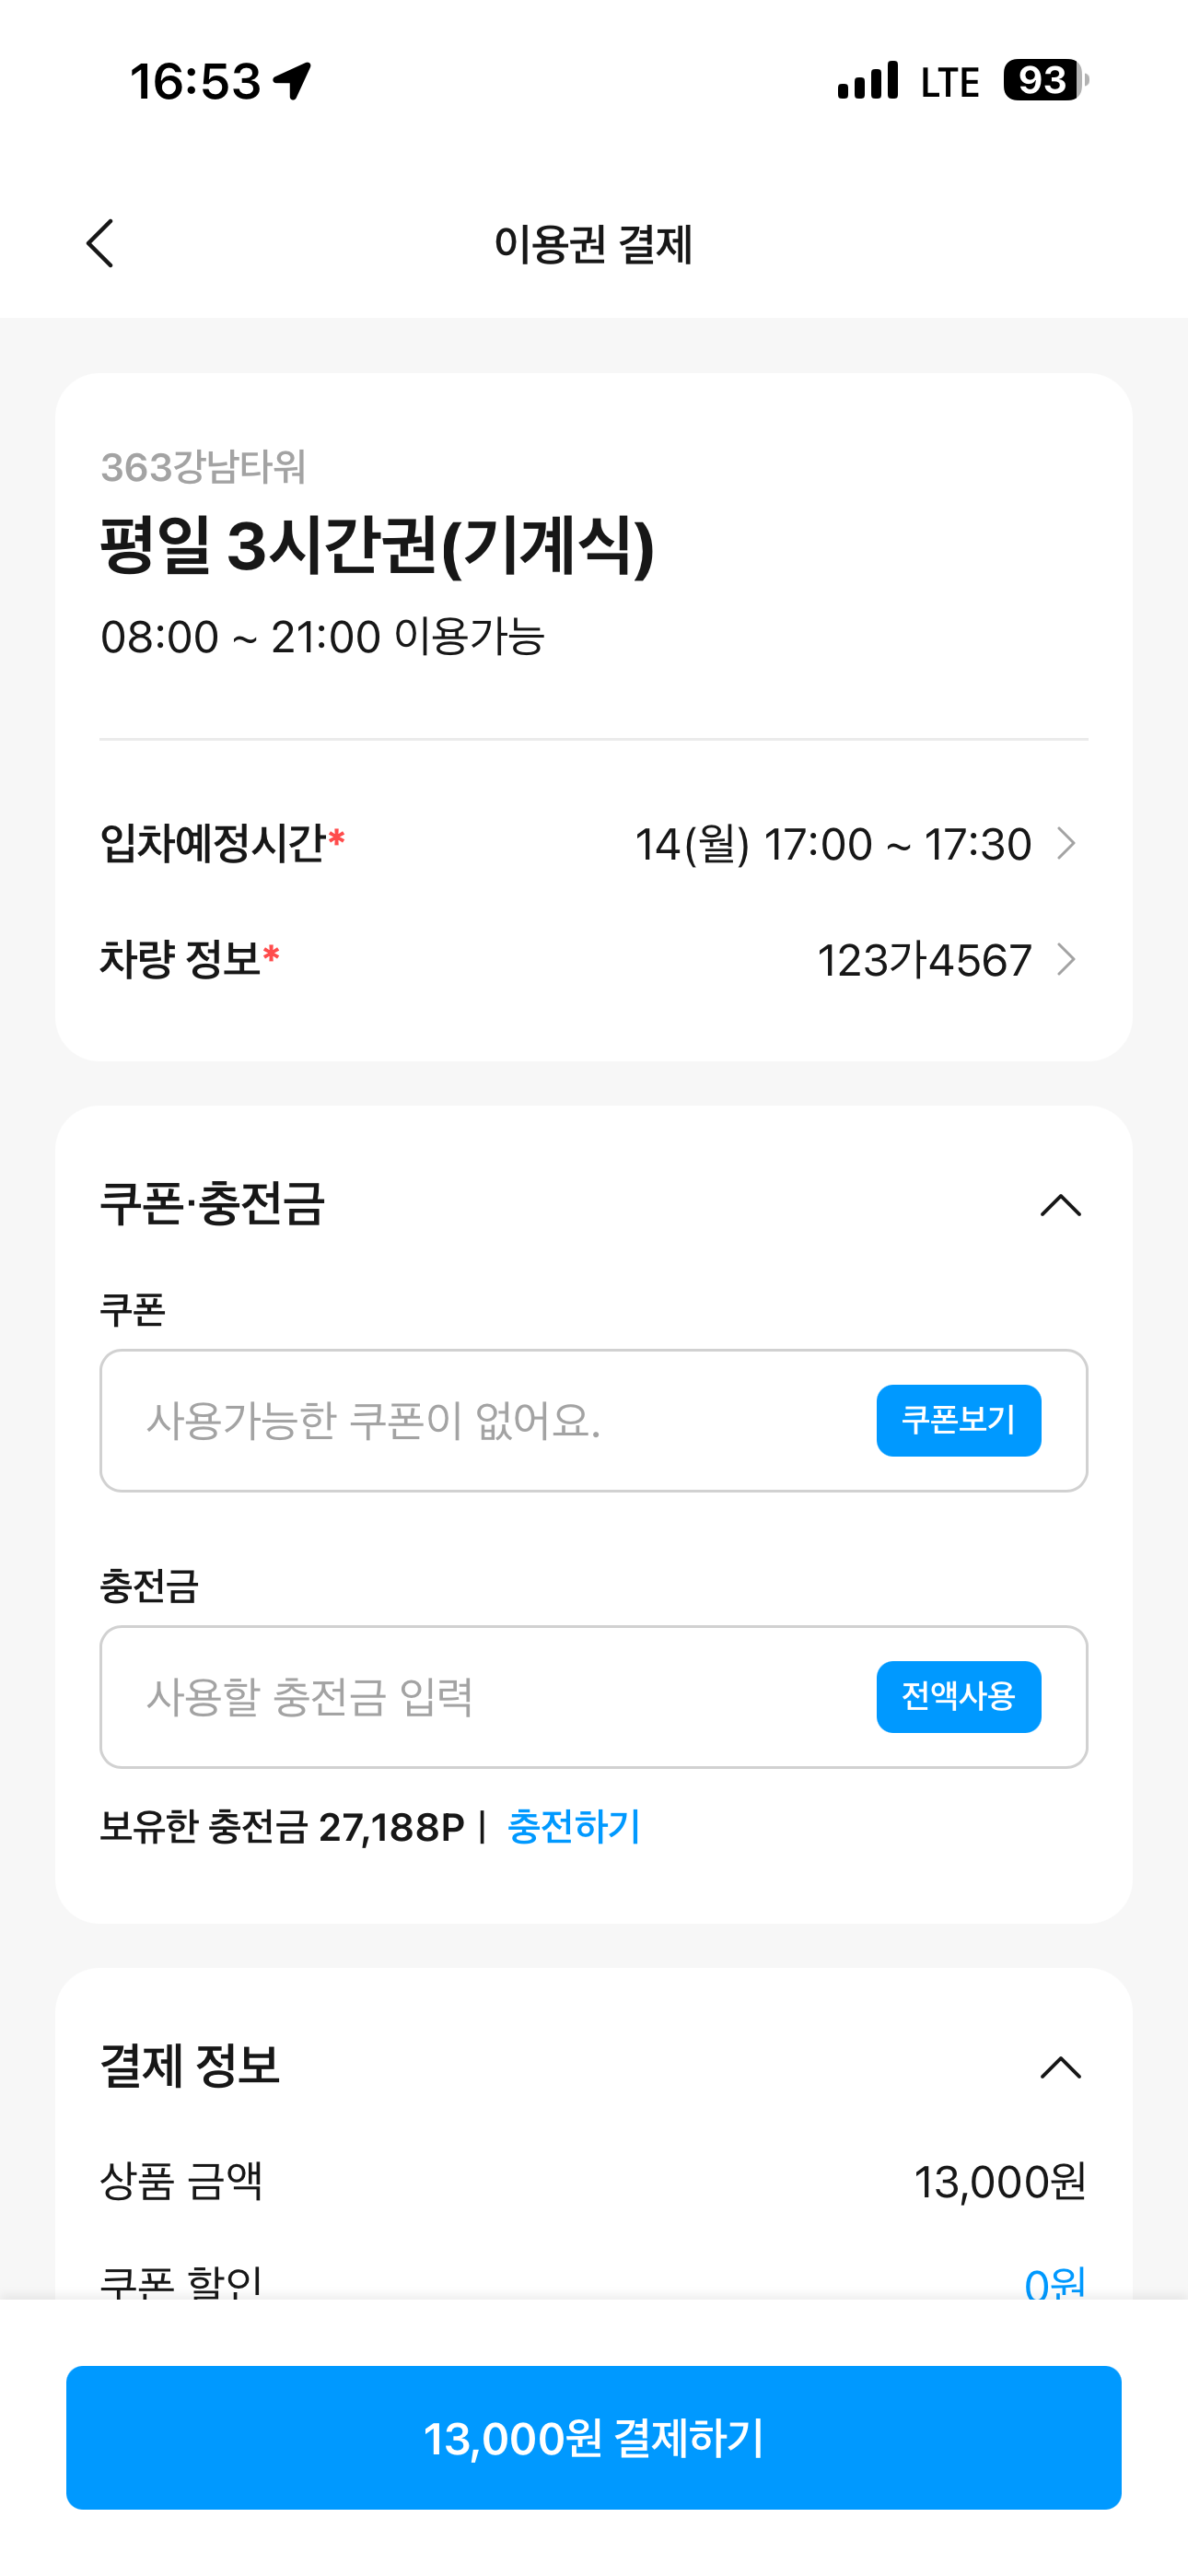
그림 1. 모두의주차장 앱의 주차장 조회 화면과 이용권 결제 화면. 작성자 제공.
AI 주차 프로젝트의 출발점
기존 앱에서 주차권을 구매하려면 목적지 검색과 주차장 목록 비교, 상세 내역 확인, 권종 선택, 시간 설정, 차량 확인, 결제 등 최대 12단계를 거쳐야 했습니다. 앱에 익숙한 사용자도 약 2분이 걸렸고, 처음 이용하는 사용자는 더 많은 시간이 필요해 구매 도중 이탈하기도 했습니다. 화면을 보며 여러 조건을 직접 선택해야 하는 만큼, 이동 중에 이용하기는 어려운 과정이었습니다.
그런데 내부 이용 데이터를 살펴보니 주차권 구매자의 약 62%가 결제 후 1시간 안에 입차했습니다. 모두의주차장은 이 데이터를 근거로 목적지로 이동하는 도중 주차권을 구매하려는 사용자도 있다고 보았습니다. 이런 이용 상황을 고려하면 구매 단계를 줄이는 것과 함께, 화면을 계속 보며 조작해야 하는 불편도 개선할 필요가 있었습니다.
모두의주차장은 사용자가 목적지와 이용 시간을 말하면 주차권을 추천받고, 마지막에 결제 버튼을 눌러 구매할 수 있는 음성 UX를 목표로 삼았습니다. 주차장을 찾고 조건을 선택하는 과정을 대화로 바꿔, 운전자의 이용 경험을 개선하려는 취지였습니다.
2026년 7월에는 목적지와 이용 시간을 입력하면 주차권을 추천하고 결제로 연결하는 텍스트 기반 에이전트의 개발을 마친 상태였습니다. 안정적인 출시를 위해 9월에는 텍스트 기반 서비스를 먼저 선보이는 Phase 1을 진행하고, 이후 Phase 2에서 말로 요청하고 응답을 듣는 음성 기능을 추가할 계획이었습니다.
마침 AWS의 AI-DLC 워크숍인 Unicorn Gym을 통해 음성 기능을 빠르게 개발해볼 기회가 생겼습니다. 모두의주차장은 7월 28일부터 29일까지 이틀간의 워크숍에서 기존 에이전트에 음성 기능을 추가하고, 직접 대화해보며 동작을 확인했습니다. 이 글에서는 이틀 동안 음성 기능을 개발한 과정과, 그 결과를 바탕으로 출시 계획을 바꾼 이야기를 소개합니다.
기존 프로젝트에서 시작한 AI-DLC
AI-DLC(AI-Driven Development Life Cycle)는 요구사항 정의부터 설계, 구현, 검증까지 AI와 협업하는 개발 방법론입니다. AI가 계획을 세우고 문서와 코드를 작성하면, 사람이 검토해 다음 단계로 넘어갈지 결정합니다.
이번 프로젝트는 기존 코드에 기능을 더하는 브라운필드(Brownfield) 과제였습니다. 주차장 탐색과 추천, 회원 정보 처리, 결제 연결은 이미 텍스트 기반으로 구현되어 있었습니다. 이 기능들은 유지하고 음성 입력과 출력을 추가하기로 했습니다. STT(Speech-to-Text)로 사용자의 말을 텍스트로 변환해 에이전트에 전달하고, 에이전트의 응답은 TTS(Text-to-Speech)로 읽어주도록 했습니다. STT 서비스로는 Amazon Transcribe를, TTS 서비스로는 Amazon Polly를 사용하기로 했습니다.
워크숍을 준비하며 AWS와 함께 정한 두 문서, Vision과 Tech Environment를 작성했습니다. Vision 문서에는 현재 구현된 기능과 추가할 기능, 유지해야 할 조건, 아직 결정하지 못한 문제를 정리했습니다. 음성을 추가하더라도 기존 개인정보 처리 절차를 유지하고, 결제는 사용자가 버튼을 눌러 확인한 뒤 서버에서 실행한다는 조건도 분명히 했습니다.
Tech Environment 문서에는 이러한 기능을 구현할 기술 스택과 코드 작성 규칙, 배포 환경, 테스트 기준을 정리했습니다. 프로젝트에 AI-DLC 워크플로 규칙을 적용한 뒤에는 AI가 두 문서를 읽고 작업을 시작하도록 했습니다.
첫째 날: 음성 기능의 요구사항과 검증 기준 정하기
AI-DLC의 라이프사이클은 요구사항과 개발 범위를 정하는 Inception, 설계·구현·테스트를 진행하는 Construction, 배포와 운영을 다루는 Operations로 나뉩니다. 각 단계의 세부 작업은 프로젝트 상황에 맞게 선택합니다.
저희는 첫날 Inception 단계에서 AI가 기존 코드를 분석한 문서를 검토하고, 음성 기능의 요구사항을 정리했습니다. 준비한 Vision 문서에는 추가할 기능과 유지할 조건을 적어두었지만, 실제 구현을 위해 정해야 할 사항도 남아 있었습니다.
AI는 준비 문서와 코드 분석 결과를 바탕으로 결정이 필요한 사항을 질문과 선택지로 정리했습니다. 저희가 질문 문서의 답변란에 선택한 내용이나 의견을 적으면, AI는 기존 문서와 비교하고 뜻이 분명하지 않은 답변은 추가 질문으로 확인했습니다.
예를 들어, 주차 에이전트의 답변을 사용자에게 어떻게 들려줄지도 정해야 했습니다. AI는 답변 전체를 음성으로 만든 뒤 재생할지, 문장별로 나눠 재생할지 물었습니다. 저희가 문장별 재생을 선택하자, AI는 완성된 응답을 나눠 읽는 것인지 에이전트가 응답을 생성하는 도중부터 읽는 것인지 다시 확인했습니다.
저희는 기존 에이전트의 응답 처리 구조를 유지하면서, 완성된 응답을 문장별로 합성해 재생하기로 했습니다. AI는 이 결정을 요구사항 문서인 requirements.md에 반영하고, 응답을 생성하는 도중부터 읽는 기능은 이번 구현 범위에서 제외한다고 명시했습니다. 저희는 이 문서에 정리된 기능과 제외 범위, 검증 조건을 검토한 뒤 다음 단계 진행을 승인했습니다.
질문과 답변, 단계별 결과는 프로젝트 저장소의 aidlc-docs/ 아래에 Markdown 파일로 저장했습니다. 첫날에 사용한 주요 파일은 그림 2와 같습니다.
aidlc-docs/
└── inception/
    ├── requirements/
    │   ├── requirement-verification-questions.md    # 구현 범위·설계 확인 질문
    │   ├── requirements-clarification-questions.md  # 답변의 모순·모호함 재확인
    │   └── requirements.md                          # 기능·제외 범위·검증 조건
    ├── user-stories/
    │   └── stories.md                               # 사용자 스토리·수용 기준
    ├── plans/
    │   └── execution-plan.md                        # 실행할 단계와 작업 순서
    └── application-design/
        ├── application-design.md                    # 전체 구조와 처리 흐름
        ├── unit-of-work.md                          # 유닛별 작업 범위
        ├── unit-of-work-story-map.md                # 스토리별 담당 유닛
        └── unit-of-work-dependency.md               # 유닛 간 의존 관계·작업 순서
그림 2. 첫날 사용한 문서의 저장 위치와 역할. 설명에 필요한 주요 파일만 표시했습니다.
사용자 스토리로 QA 기준 정하기
다음으로 AI는 승인한 요구사항을 바탕으로 stories.md에 사용자 스토리를 작성했습니다. 사용자가 어떤 상황에서 무엇을 할 수 있어야 하는지를 쓰고, 테스트를 통과하려면 충족해야 할 수용 기준도 적었습니다. 수용 기준은 주어진 상황(Given), 행동(When), 기대 결과(Then)로 나누었습니다.
두 문서에서 문장별 재생과 관련된 부분을 발췌하면 그림 3과 같습니다.
requirements.md
FR-7 문장 단위 순차 합성·재생

- AC-7.2 첫 문장 합성이 끝나는 대로 재생을 시작한다
  (전체 합성 완료를 기다리지 않는다)
stories.md
S-07
추적: FR-7, …

Given 응답 텍스트가 여러 문장인 상태에서
When 재생이 시작되면
Then 전체 합성이 끝나기를 기다리지 않고 첫 문장부터 재생된다
그림 3. 두 문서의 재생 조건 발췌. 다른 참조와 수용 기준은 생략하고 줄바꿈을 조정했습니다.
위 예시에서 S-07 스토리의 추적: FR-7은 requirements.md의 문장별 재생 요구사항을 가리킵니다. 요구사항에서 정한 재생 조건이 스토리의 수용 기준이 되고, QA(품질 검증)에서도 같은 조건을 확인합니다. 여러 문장으로 된 응답에서 첫 문장 합성이 끝나는 대로 소리가 나야 하며, 전체 합성이 끝날 때까지 기다린다면 테스트를 통과하지 못합니다.
이후 AI는 두 문서를 바탕으로 execution-plan.md를 작성했습니다. AI-DLC에서 이 문서는 어떤 단계를 실행하고 어떤 단계를 건너뛸지 정하는 용도인데, 저희 프로젝트에서는 여기에 구현할 작업과 진행 순서도 함께 정리했습니다.
둘째 날: 음성 입력부터 응답 재생까지 연결하기
둘째 날에는 Construction 단계에서 유닛별 설계와 구현, 테스트를 진행했습니다. 작업 단위(Unit of Work, 이하 유닛)는 관련 기능을 묶어 설계하고 구현하는 단위입니다. 저희는 첫날 요구사항과 설계를 정리하면서 이번 음성 기능을 일곱 개의 유닛으로 나누어두었습니다.
유닛의 범위와 작업 순서 정하기
첫날 유닛을 나눌 때, AI는 서버와 클라이언트 같은 패키지별로 구분할지, 여러 패키지에 걸치더라도 기능별로 묶을지 물었습니다. 저희는 한 기능에 필요한 변경을 함께 검토할 수 있도록 기능별로 나누었습니다. AI는 각 유닛이 구현할 기능과 관련 사용자 스토리, 수정할 파일, 완료 기준을 unit-of-work.md에 정리했습니다.
| 유닛 | 구현 범위 |
|---|---|
| U1 · 음성 통신 규약 | 클라이언트와 서버가 주고받는 음성 관련 메시지 정의 |
| U2 · 기존 코드 정리 | 사용하지 않는 초기 음성 타입 정리, 도구 실패 처리 보완 |
| U3 · 음성 입력 | 서버의 오디오 수신과 STT 연결 |
| U4 · 음성 출력 | TTS 합성과 전송, 읽어줄 내용의 처리 규칙 |
| U5 · 마이크 캡처 | 클라이언트에서 음성을 수집하고 전송하는 기능 |
| U6 · 음성 화면과 재생 | 음성 상태 표시, 재생과 중단, 마이크 전환 |
| U7 · 음성 응답 스타일 | 에이전트에 음성 모드를 전달하고 낭독용 응답 생성 |
둘째 날 구현은 클라이언트와 서버가 함께 사용할 메시지 형식부터 시작했습니다. 마이크에서 보낸 오디오를 서버가 처리하려면 양쪽이 같은 통신 규약을 따라야 했기 때문입니다. 녹음 시작 신호와 음성 데이터, 인식 중인 문장과 확정된 문장의 형식을 공통 코드에 정의한 뒤, 마이크 입력과 서버의 음성 인식 기능을 이 규약에 맞춰 구현했습니다.
음성 출력 유닛을 구현한 과정
음성 출력 유닛에서는 에이전트의 응답을 Polly로 합성해 클라이언트에 보내는 기능을 구현했습니다. 설계 단계에서 AI는 화면에 표시할 응답 중 어떤 내용을 읽을지 물었습니다. 저희는 화면에 보여줄 상세 설명과 음성 안내용 응답을 따로 생성하고, 음성으로는 주차장의 핵심 정보만 짧게 안내하기로 했습니다.
AI는 문장을 나누는 기준도 물었습니다. 저희는 마침표·물음표 등의 구두점에서 나누되 너무 짧은 조각은 합치기로 했습니다. AI는 첫 문장을 Polly로 합성해 클라이언트에 보낸 뒤 다음 문장을 처리하도록 설계했습니다.
AI는 읽어줄 내용을 고르고, 문장을 나누고, 합성한 오디오를 보내는 코드를 어느 파일에 추가할지 정리했습니다. 저희는 수정할 파일과 작업 순서, 테스트 항목을 검토하고 구현을 승인했습니다. AI는 승인된 계획에 따라 코드와 자동 테스트를 작성했습니다.
자동 테스트에서는 Polly 대신 테스트용 오디오를 사용해, 두 문장의 오디오가 순서대로 전송되고 마지막 문장에 종료 표시가 붙는지 확인했습니다. 테스트를 마친 코드는 PR(Pull Request)을 올려 리뷰했습니다.
다만 테스트용 오디오로는 실제 음질이나 안내 길이를 판단할 수 없었습니다. 이 부분은 클라이언트의 재생 기능까지 연결한 뒤 직접 들어보며 확인하기로 했습니다.
음성 기능을 연결한 서비스 구성
유닛별 구현과 테스트를 마친 뒤, 기존 텍스트 기반 에이전트에 음성 입력과 재생을 연결해 직접 대화해볼 수 있는 초기 제품을 만들었습니다. 기존 주차 에이전트와 서버를 활용하면서 음성 기능을 연결한 시스템 구성은 그림 4와 같습니다.
오케스트레이션 서버는 앱에서 받은 오디오를 Transcribe로 보내고, 인식한 텍스트에서 개인정보를 치환한 뒤 주차 에이전트를 호출했습니다. 에이전트의 응답은 검증을 거쳐 문장별로 Polly에서 합성하고 앱에 전송했습니다.
오케스트레이션 서버와 주차 에이전트는 개발 Amazon EKS 클러스터에서 실행했습니다. 회원 정보 조회와 주차장 탐색, 주차권 조회·결제에는 기존 서버를 이용했고, 같은 클러스터 안의 서버끼리는 HTTP로 통신했습니다. 에이전트의 모델 호출은 별도 AI 클러스터의 사내 LLM 라우터를 거쳤습니다.
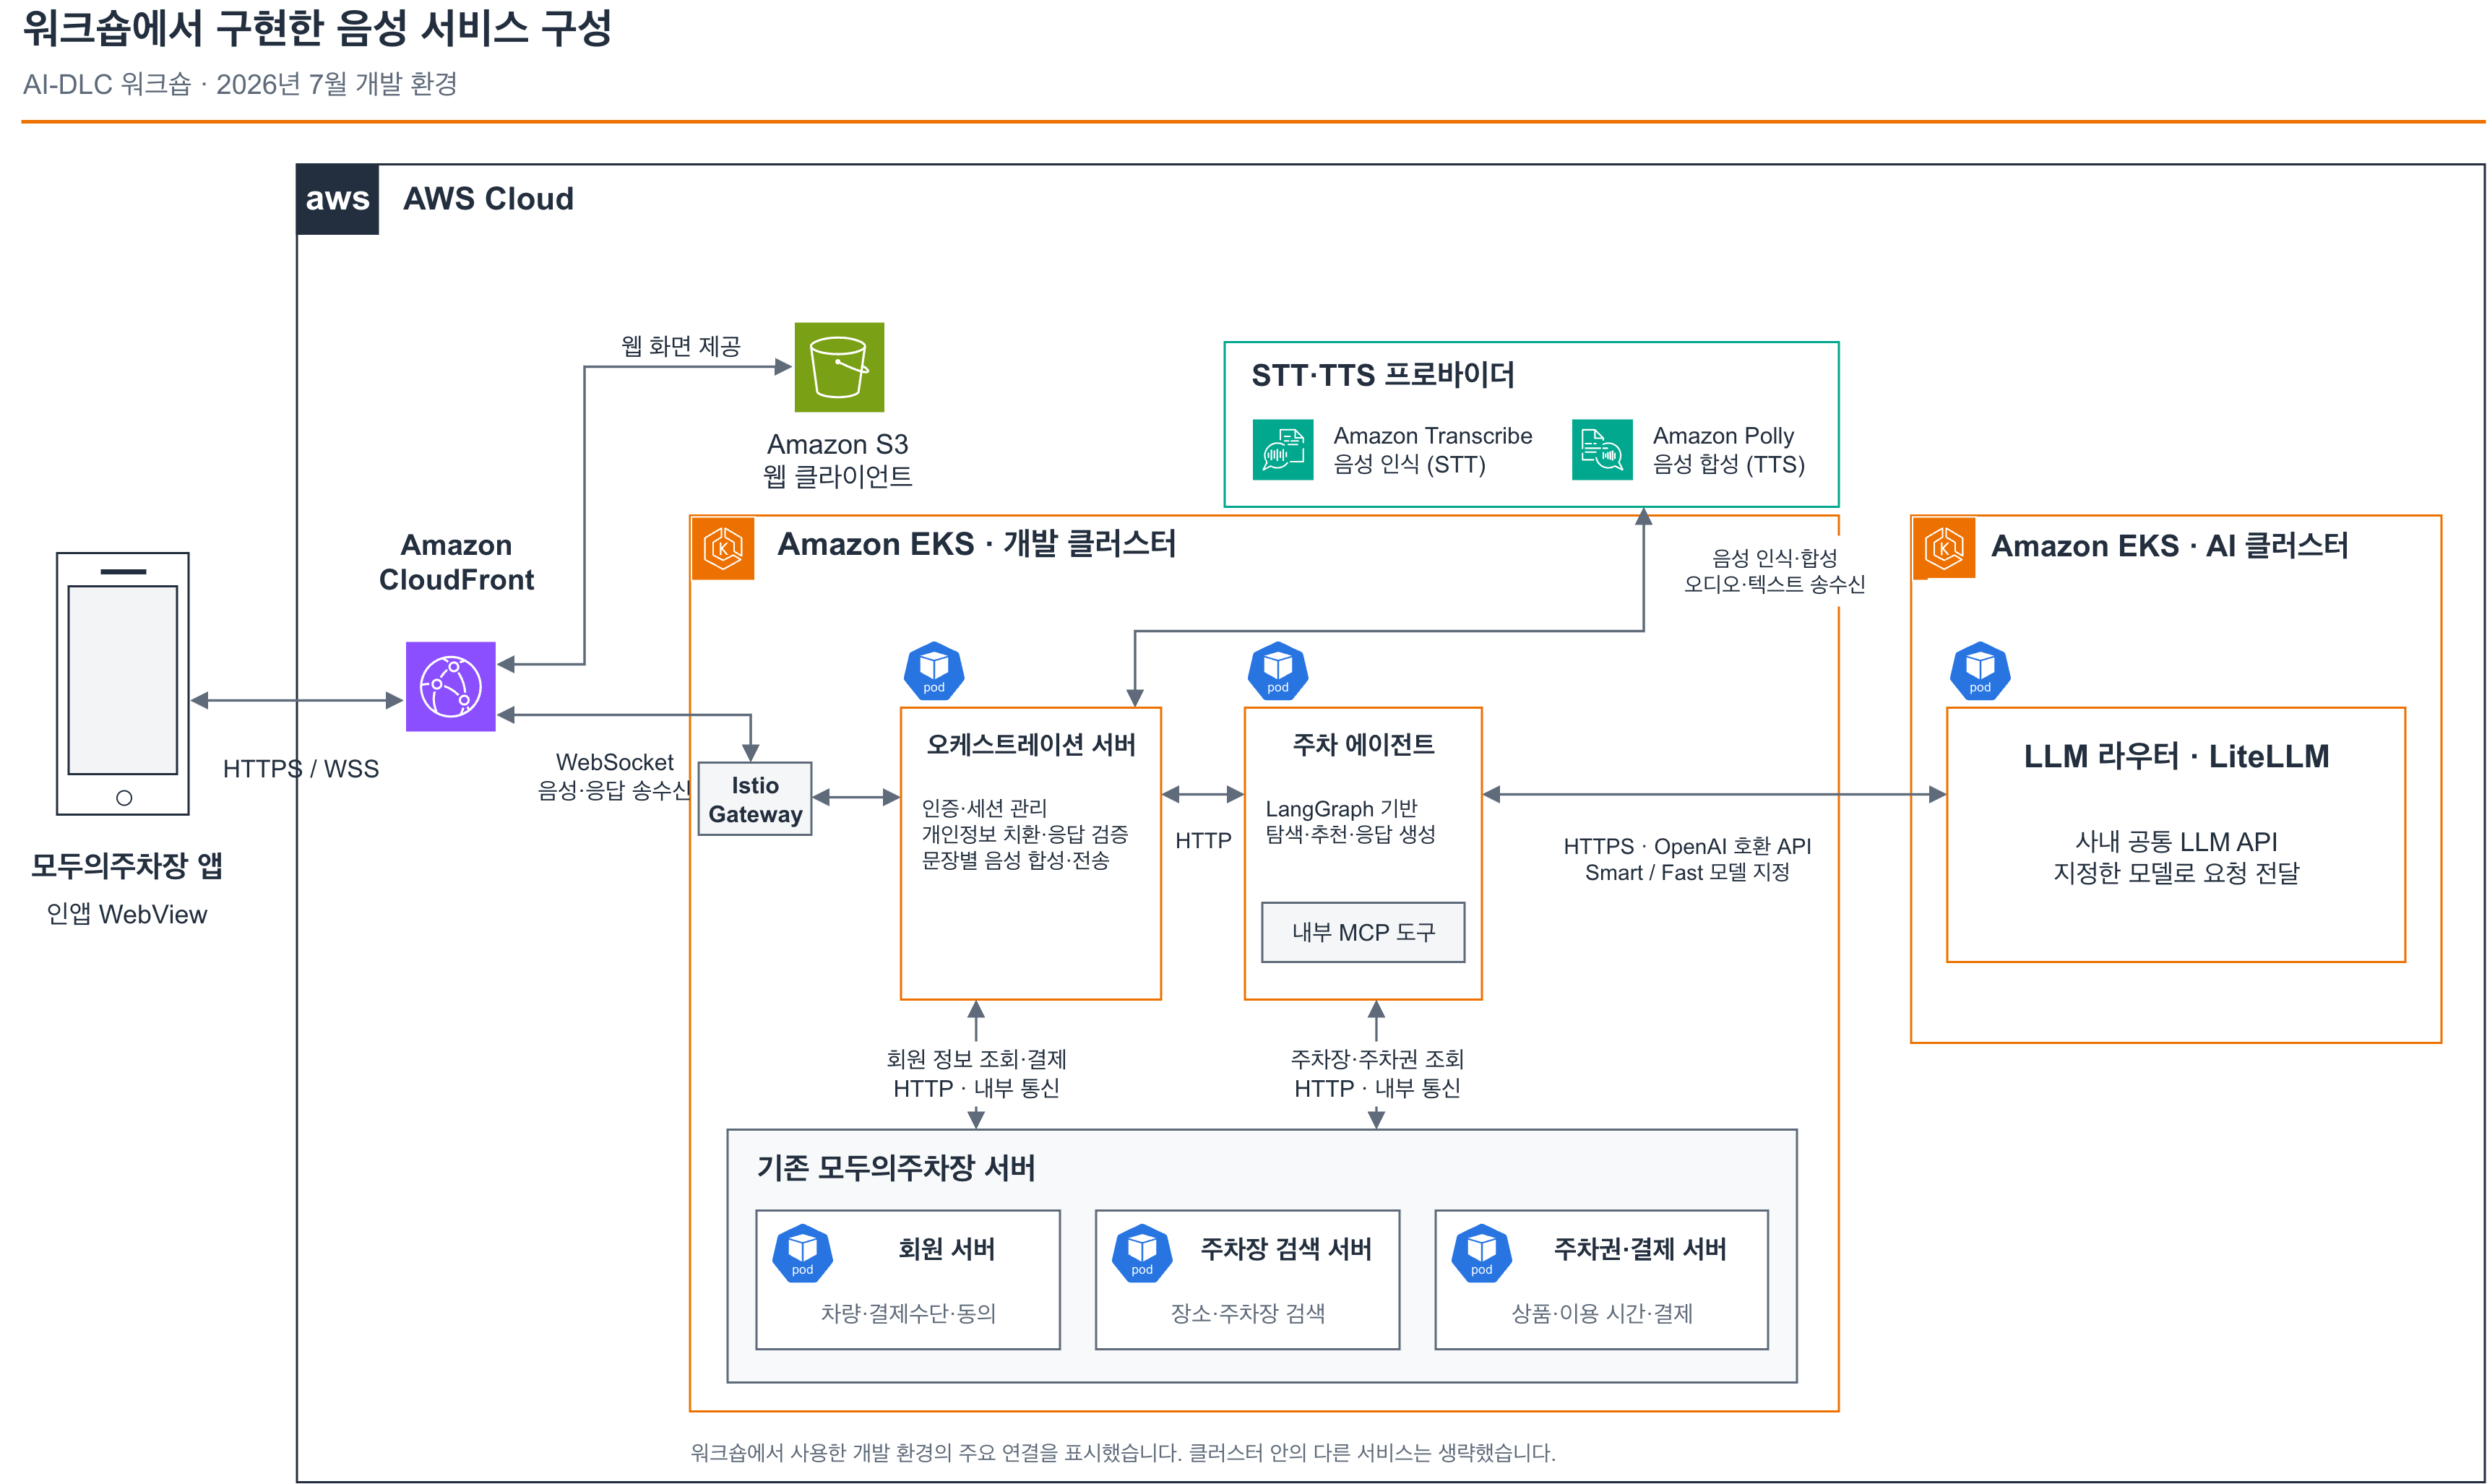
그림 4. 워크숍에서 구현한 음성 서비스의 시스템 구성. 기존 주차 에이전트와 서버를 활용하고, 오케스트레이션 서버에 음성 인식과 합성을 연결했습니다.
이 구성에 사용한 기술은 다음과 같습니다.
| 구분 | 사용 기술 | 프로젝트에서의 역할 |
|---|---|---|
| 클라이언트 | 모두의주차장 앱 인앱 WebView, Amazon S3, Amazon CloudFront | 앱 안의 웹 화면을 S3에 올리고 CloudFront로 제공. 앱과 서버는 HTTPS와 WebSocket으로 음성·응답을 주고받음 |
| 음성 인식·합성 | Amazon Transcribe, Amazon Polly | 사용자의 말을 텍스트로 변환(STT)하고, 음성 안내용 응답을 문장별로 합성(TTS) |
| 실행 환경 | Amazon EKS 개발 클러스터, Istio Gateway | 오케스트레이션 서버와 주차 에이전트를 같은 클러스터에서 실행하고, 외부에서 들어오는 요청은 Istio Gateway로 수신 |
| 오케스트레이션 서버 | 자체 구현 | 인증과 세션 관리, 음성 인식 결과의 개인정보 치환, 에이전트 응답 검증, 문장별 음성 합성과 전송 |
| 주차 에이전트 | LangGraph, 내부 MCP 도구 | 의도 파악과 주차장 탐색·추천, 응답 생성. 기존 텍스트 기반 구현을 그대로 활용 |
| 모델 호출 | 사내 LLM 라우터(LiteLLM) | 별도 AI 클러스터의 사내 공통 LLM API를 OpenAI 호환 방식으로 호출하고, 용도에 따라 Smart·Fast 모델을 지정 |
| 기존 서버 | 회원 서버, 주차장 검색 서버, 주차권·결제 서버 | 회원 정보와 결제 수단 조회, 장소·주차장 검색, 상품과 이용 시간 확인 및 결제 실행 |
음성 끼어들기를 제외하고 턴제로 바꾸기
연결한 기능으로 직접 대화를 주고받자, 사용자의 요청을 음성으로 받고 추천 결과를 읽어주는 흐름은 동작했지만 초기 요구사항에 포함했던 ‘음성 끼어들기’에서 문제가 드러났습니다.
음성 끼어들기는 안내 도중 사용자가 말하면 재생을 멈추고 새 요청을 받는 기능입니다. 그런데 스피커에서 나온 안내 음성이 마이크로 들어가 에이전트가 자신의 말에 다시 응답했습니다. 재생 중 들어오는 음성을 억제하면 실제 사용자의 말까지 버려졌습니다. 재생 여부만으로는 두 음성을 구분할 수 없어 정상적인 대화를 이어가기 어려웠습니다.
음성 끼어들기가 오히려 사용성을 해친다고 판단해, 사용자와 에이전트가 번갈아 말하는 턴제로 바꾸기로 했습니다. 이를 구현하려면 앱과 서버에서 입력을 멈추고 다시 받는 시점을 맞춰야 했습니다.
턴제를 적용하는 과정에서는 다음 발화를 받지 못하는 문제가 생겼습니다. 서버는 사용자의 요청을 확정하면 음성 인식 스트림을 닫고 에이전트를 호출했지만, 안내가 끝난 뒤 다음 말을 받을 스트림을 다시 열지 않았습니다. 앱이 오디오를 보내도 서버에서 처리하지 못했습니다.
이를 해결하려고 요청이 확정된 직후 인식 스트림을 다시 열자, 남은 오디오가 새 요청으로 처리되었습니다. 응답이 중복으로 생성되면서 두 응답의 음성이 섞여 재생되었습니다. 여기까지 확인한 두 문제가 대화 흐름의 어느 지점에서 생겼는지는 그림 5와 같습니다.
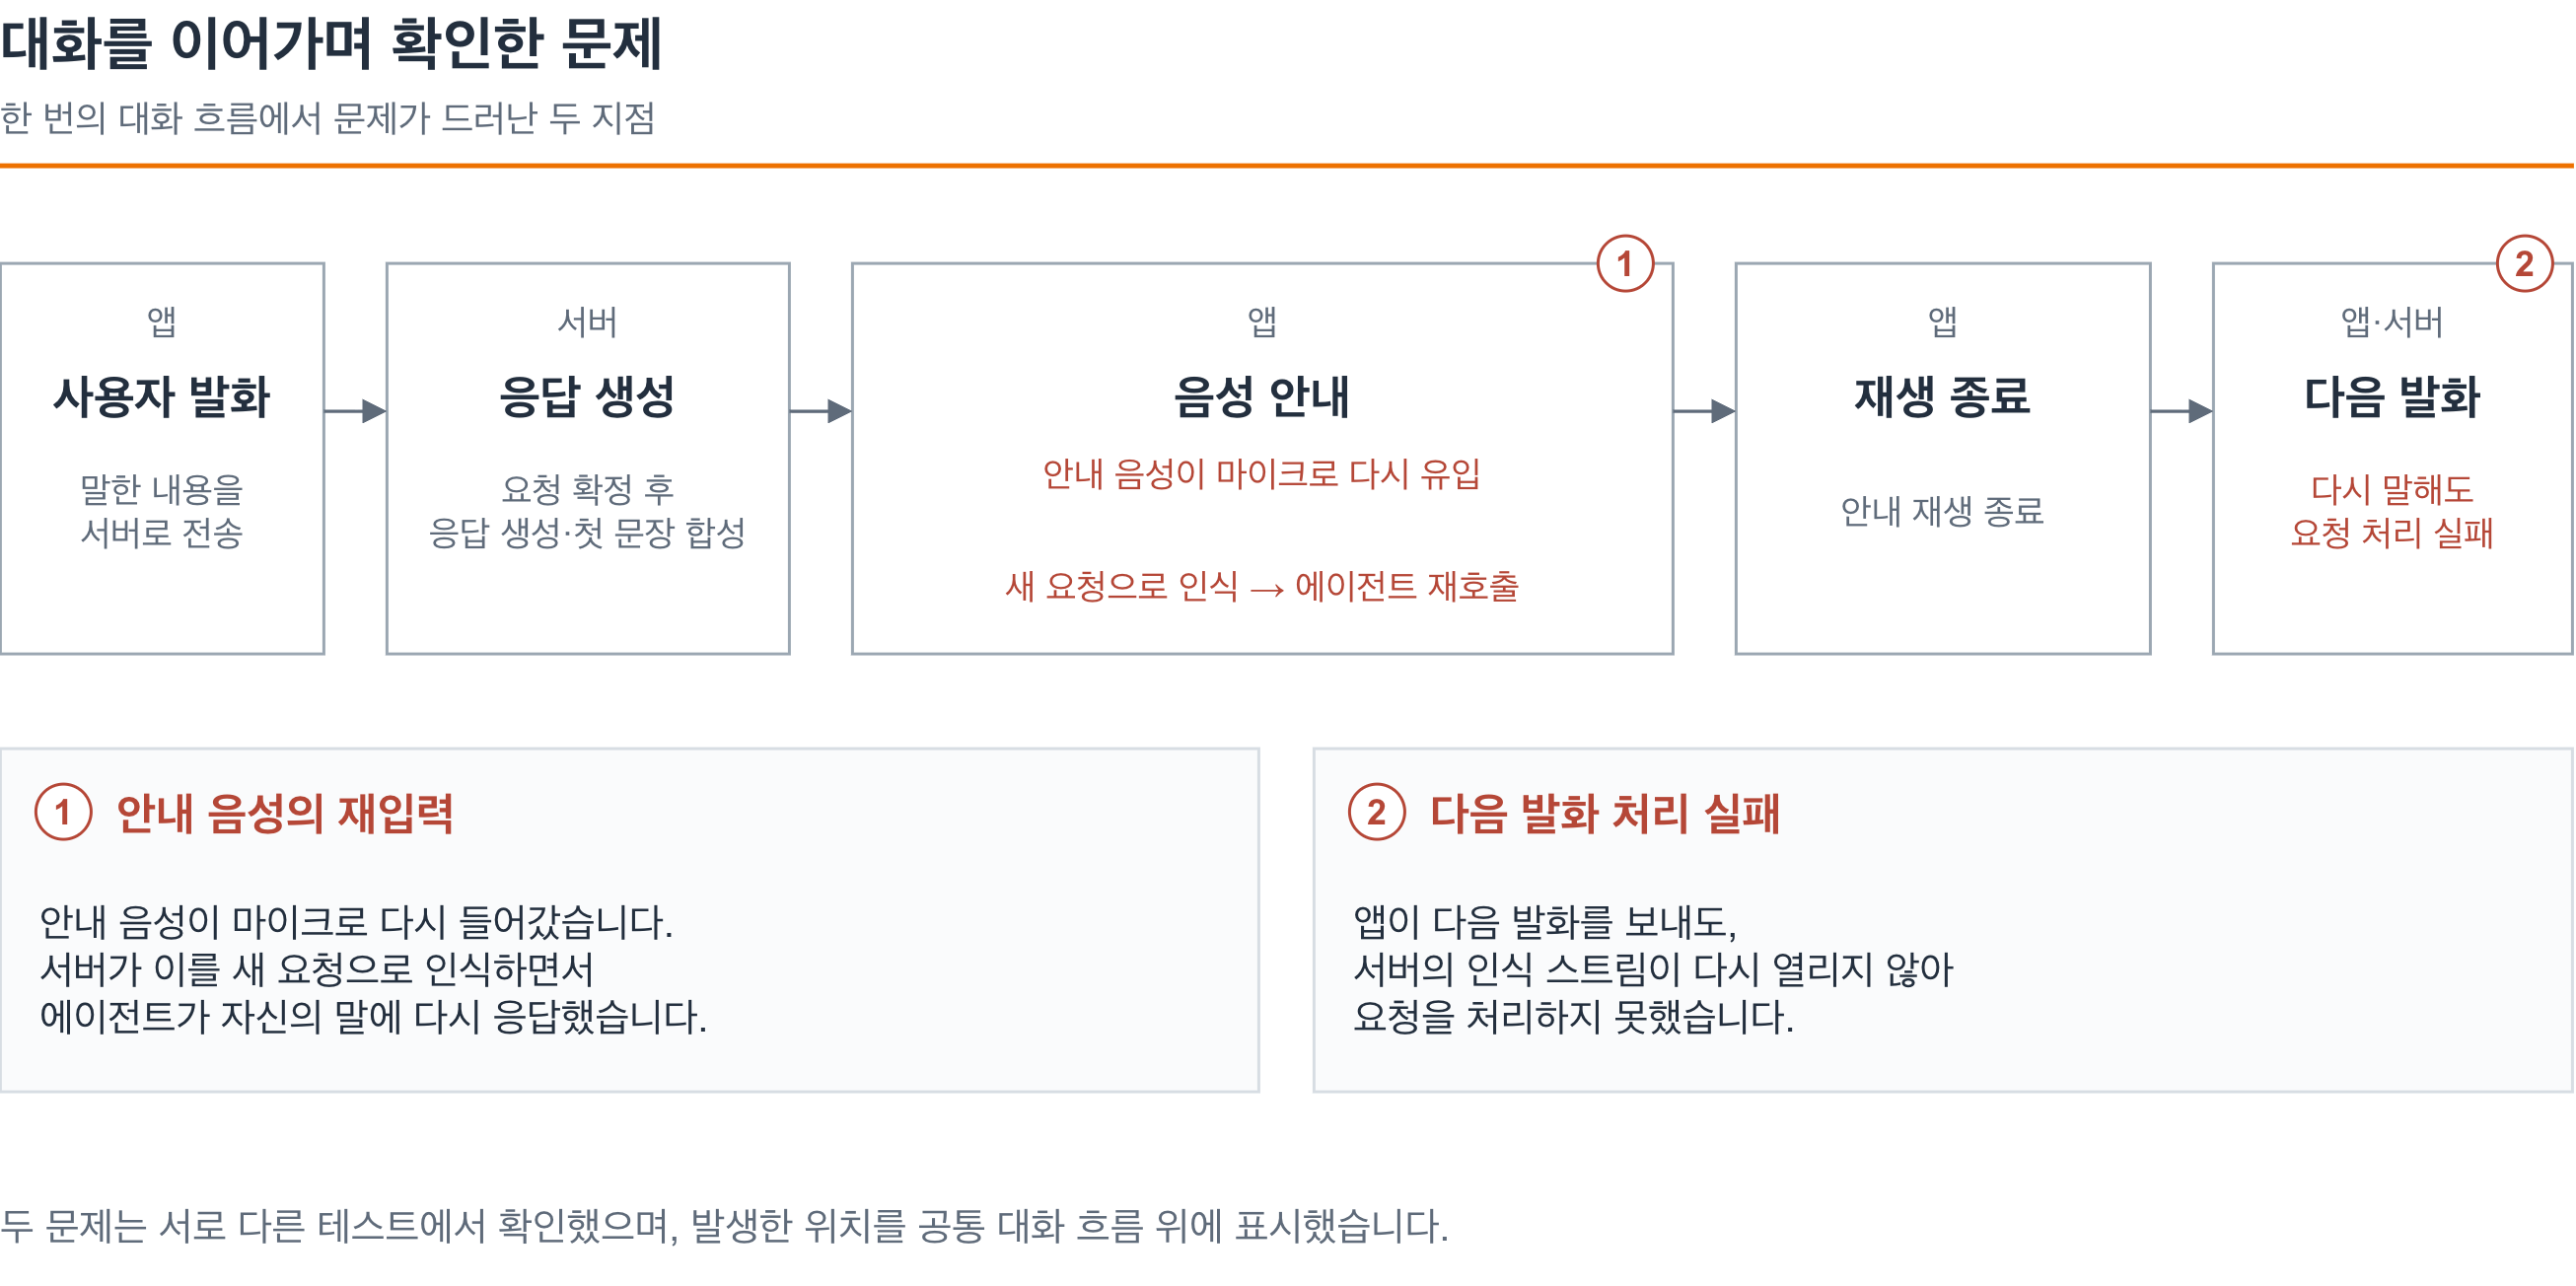
그림 5. ①은 끼어들기를 테스트하며 확인한 안내 음성의 재입력, ②는 턴제를 적용하면서 발생한 다음 발화 처리 실패입니다. ②는 인식 스트림을 다시 여는 시점의 문제로, 스트림을 열지 않아 발화를 놓친 경우와 너무 일찍 열어 남은 오디오가 새 요청이 된 경우를 함께 가리킵니다. 서로 다른 구현 단계에서 생긴 문제를 대화 흐름의 해당 위치에 표시했습니다.
다음 발화를 놓치거나 남은 오디오를 새 요청으로 처리하지 않으려면, 인식 스트림을 다시 여는 시점을 정해야 했습니다. 저희는 앱의 실제 안내 재생이 끝난 뒤에 다음 입력을 받도록 했습니다. 서버가 음성 데이터를 모두 보냈더라도 기기에서는 아직 안내가 나오고 있을 수 있기 때문입니다.
서버는 요청을 확정한 뒤부터 앱의 안내 재생이 끝날 때까지 다음 발화를 처리하지 않도록 했습니다. 앱이 재생을 시작하며 입력 종료를 알리면, 남은 오디오와 인식 결과는 새 요청으로 만들지 않고 정리했습니다. 앱에서도 안내 중에는 마이크 오디오 전송을 멈추었습니다.
안내가 끝나면 앱이 알림음으로 말할 시점을 알려주고 음성 입력을 재개했습니다. 서버도 이때 새 인식 스트림을 열어 다음 요청을 받도록 맞추었습니다.
턴제 적용 후 한 번의 대화 흐름
그림 6의 ①과 ②는 그림 5와 같은 지점을 가리킵니다. ① 안내 재생 중에는 마이크 전송을 멈춰 안내 음성의 재입력을 막고, ② 실제 재생이 끝나면 서버의 인식 스트림을 다시 열어 다음 말을 받도록 했습니다.
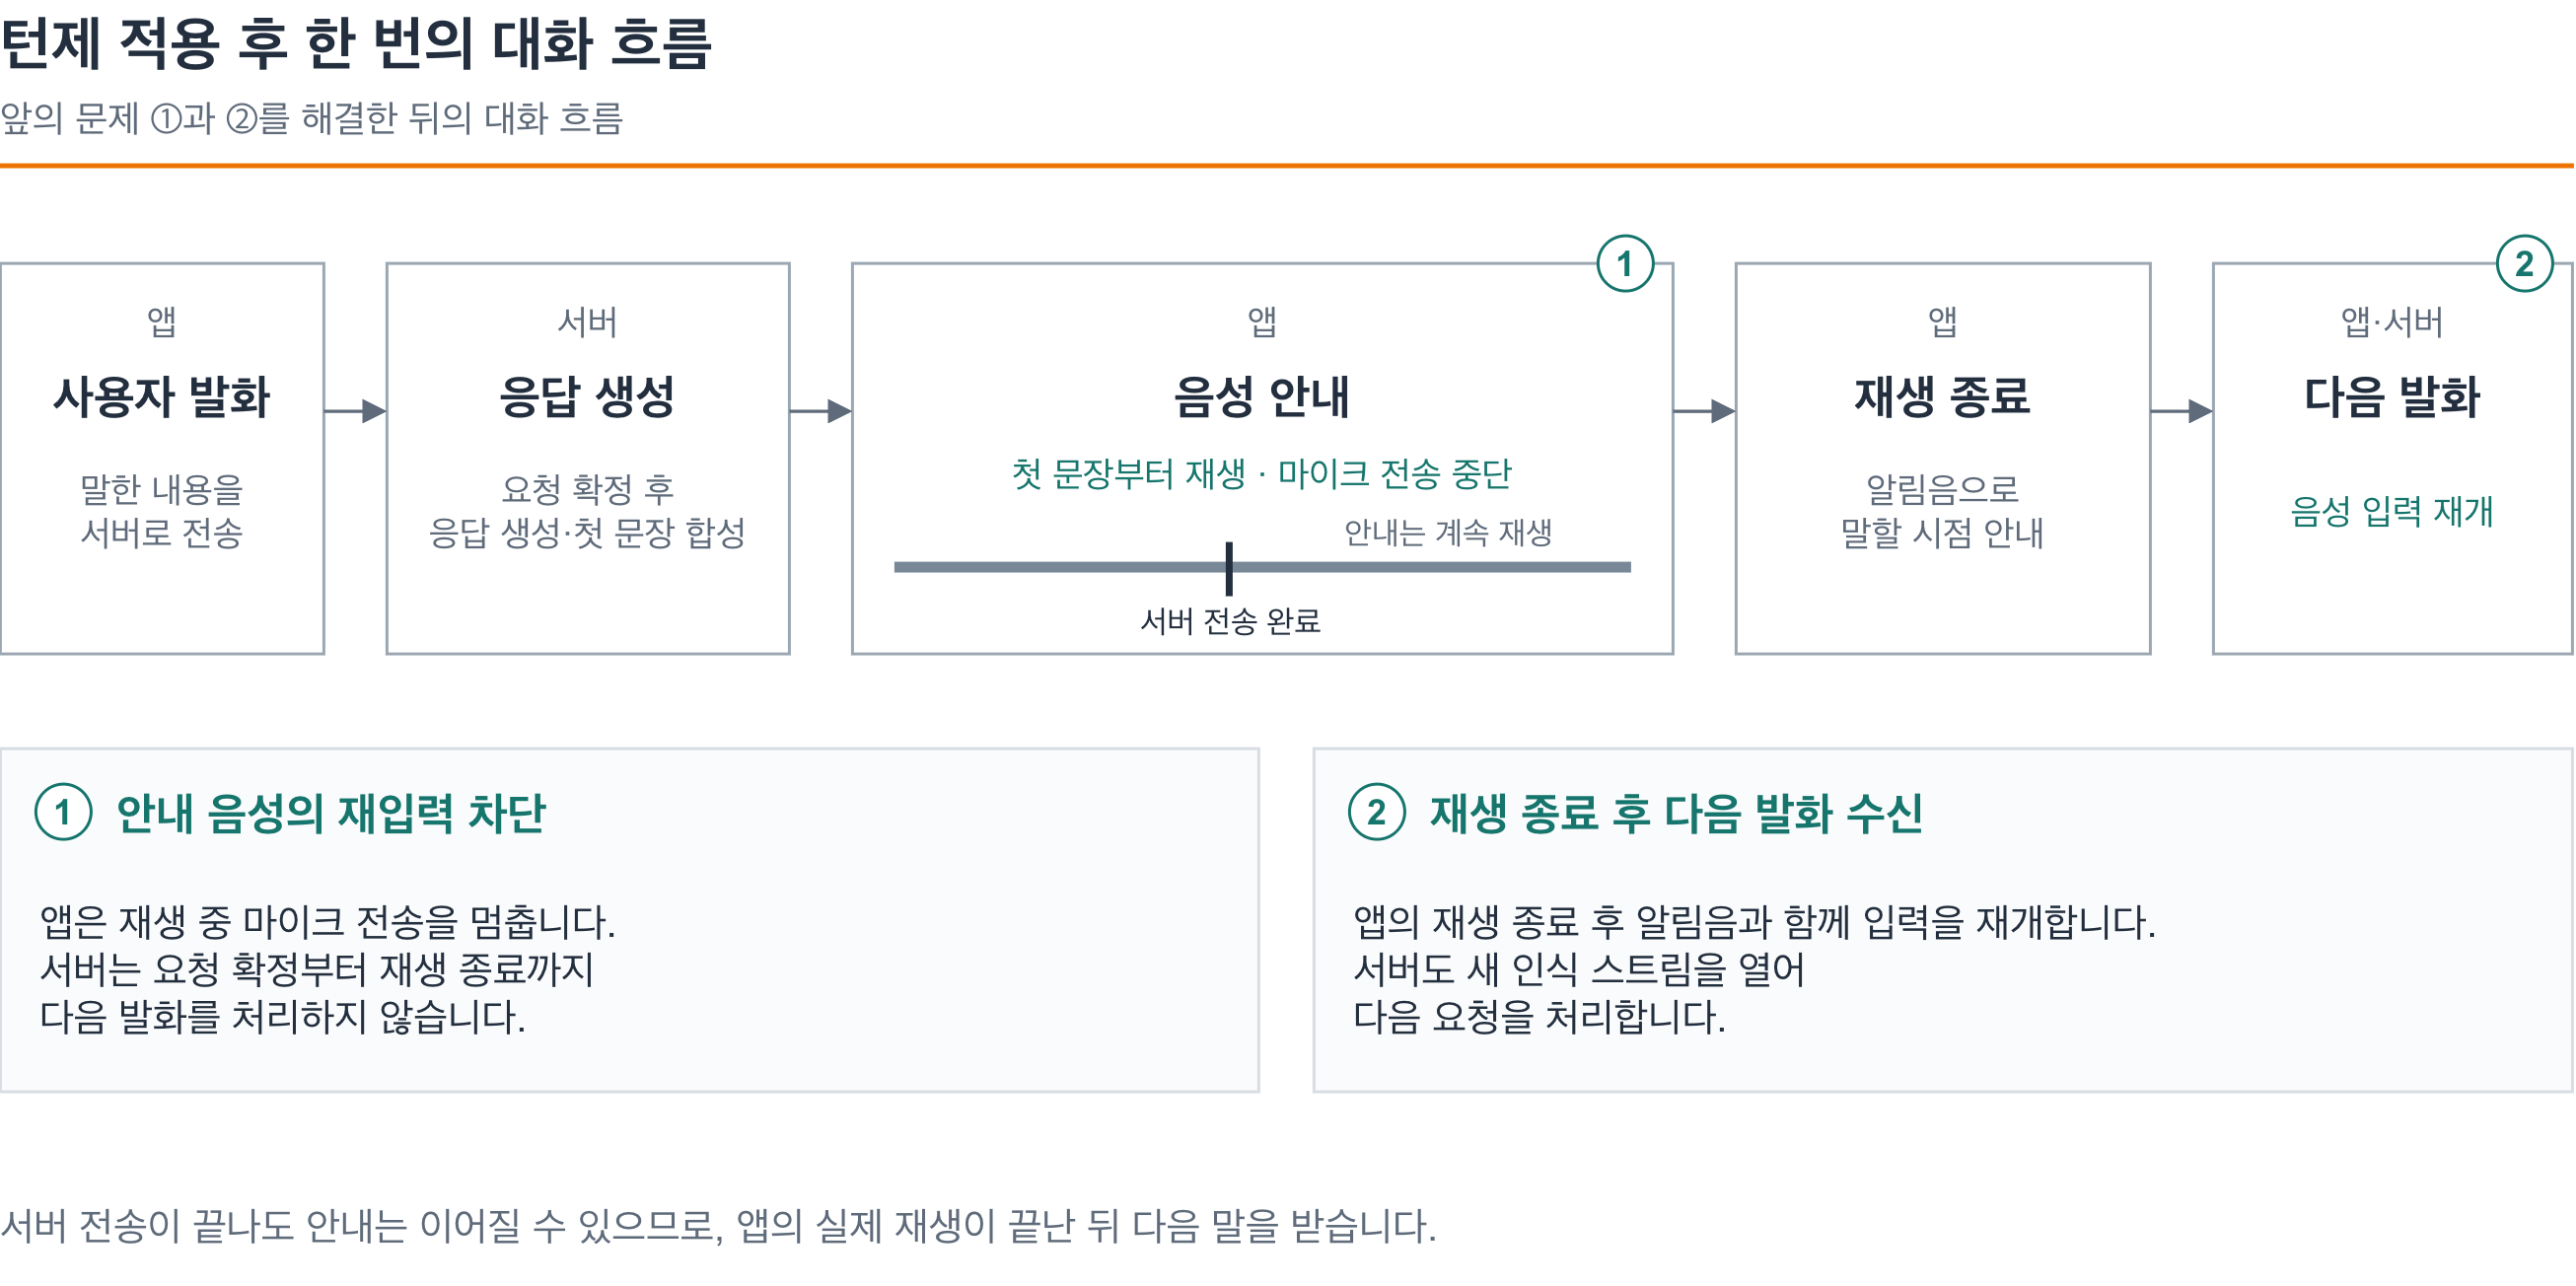
그림 6. 서버의 전송이 끝나도 앱의 안내는 이어질 수 있습니다. 다음 입력은 실제 재생 종료 뒤에 받습니다. 정상 응답 흐름입니다.
이 흐름에 맞춰 사용자 스토리와 설계도 수정했습니다. 이후 직접 대화를 여러 차례 주고받으며 안내 음성이 새 요청으로 들어가지 않는지, 안내가 끝난 뒤 다음 발화를 처리하는지 확인했습니다.
음성 전용 UX로 바꿔 출시하기
첫 출시부터 음성을 제공하기로 정하기
앞서 세운 계획은 텍스트 기반 서비스를 먼저 출시하고, 음성은 다음 단계에서 추가하는 것이었습니다. 그런데 이틀 동안 구현한 음성 기능을 직접 써보면서 첫 출시부터 음성을 제공할 수 있겠다는 확신이 생겼습니다. 모두의주차장은 워크숍 결과를 보완해 9월 2일에 음성을 포함한 서비스를 출시하기로 했습니다.
텍스트 채팅을 걷어내고 음성 화면으로 다시 설계하기
이때까지만 해도 기존 텍스트 채팅과 음성을 함께 제공할 계획이었습니다. 워크숍에서도 텍스트 기반 에이전트와 화면을 활용해 음성을 연결했기 때문에, 두 가지 입력 방식이 모두 남아 있었습니다.
출시를 준비하면서 이 구성을 다시 살펴보았습니다. 음성으로 대화해도 이력은 말풍선에 계속 쌓였고, 음성을 쓰다가 키보드로 바꾸거나 마이크를 쓸 수 없을 때 텍스트로 입력하는 기능도 있었습니다. 두 방식을 함께 지원하려니 화면 설계와 개발, 테스트에서도 계속 양쪽을 챙겨야 했습니다. 정작 운전자가 말로 주차권을 고르고 구매하는 데 필요한 화면과 안내에는 집중하기 어려웠습니다.
프로젝트의 목표는 운전자의 이용 경험을 개선하는 것이었습니다. 모두의주차장은 첫 출시에서 제공할 이용 방식을 음성으로 좁히고, 텍스트 입력창과 키보드 전환 기능을 없애기로 했습니다. 음성 기능을 추가한 뒤에도 남아 있던 텍스트 채팅 중심의 화면을, 음성으로 주차권을 찾고 구매하는 과정에 맞춰 바꾸기 시작했습니다.
첫 화면에는 사용자가 바로 말해볼 수 있도록 발화 예시를 넣었습니다. 대화를 시작하면 앱이 듣는 중인지 응답하는 중인지 표시하고, 화면에는 이전 대화를 계속 쌓는 대신 현재 주고받는 말과 주차권 정보를 보여주었습니다. 사용자는 검색 조건이나 추천 주차장을 말로 바꿀 수 있고, 원하는 주차권을 찾으면 화면의 결제 버튼을 눌러 구매하도록 했습니다.
실기기와 차량 블루투스에서 확인하고 베타 출시하기
음성 전용 UX를 정한 뒤에는 사용자가 말로 주차권을 고르고 구매하는 과정을 테스트했습니다. 이 과정에서 목록의 두 번째 주차장을 요청했는데 세 번째 항목이 선택되는 오류를 찾아 수정했습니다.
음성 입력과 재생은 실제 기기에서도 확인이 필요했습니다. 로컬 브라우저만으로는 마이크 권한이나 차량 블루투스 연결에 따른 동작을 충분히 검증하기 어려웠기 때문입니다. 아이폰과 안드로이드 기기로 테스트하고 차량 블루투스에 연결해서도 확인하면서, 아이폰에서 마이크가 늦게 반응하거나 알림음이 들리지 않는 문제를 수정했습니다.
이렇게 워크숍에서 만든 음성 기능을 보완하고 이용 화면을 다듬어, 9월 2일 모두의주차장 앱에 AI 음성 주차 베타 기능을 출시했습니다. 사용자는 목적지와 조건을 말해 주차권을 추천받고, 화면의 결제 버튼을 눌러 구매할 수 있습니다. 결제 후에는 내비게이션으로 길 안내를 받을 수 있게 되었습니다.
|
음성 입력 대기 |
인식한 요청 표시 |
주차권 확인과 결제 |
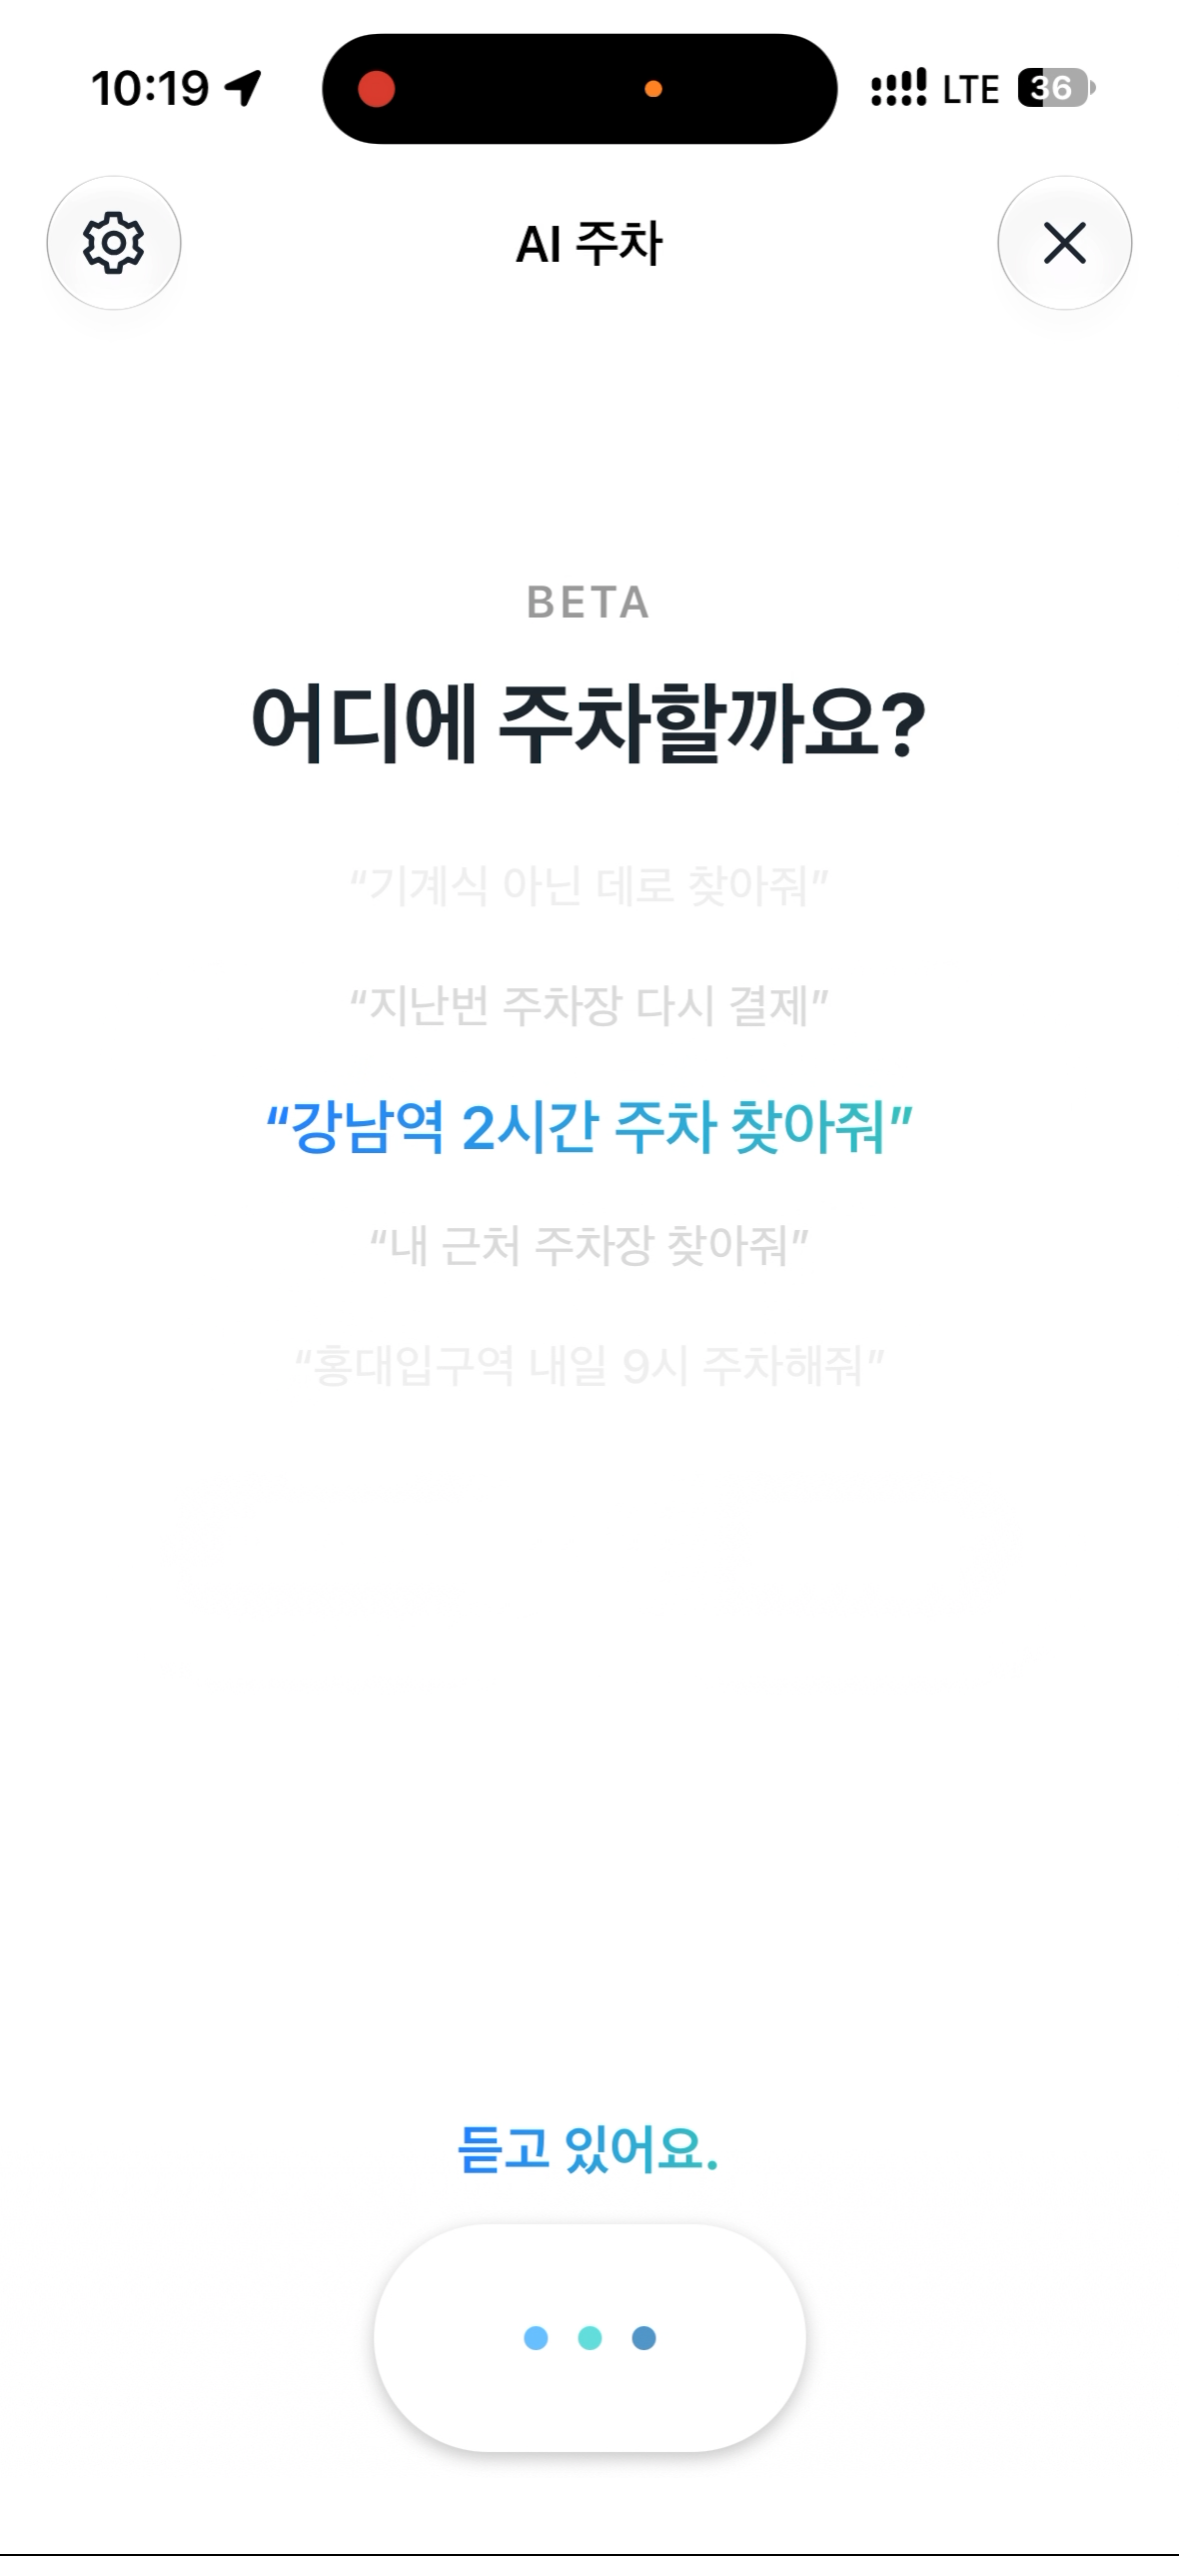
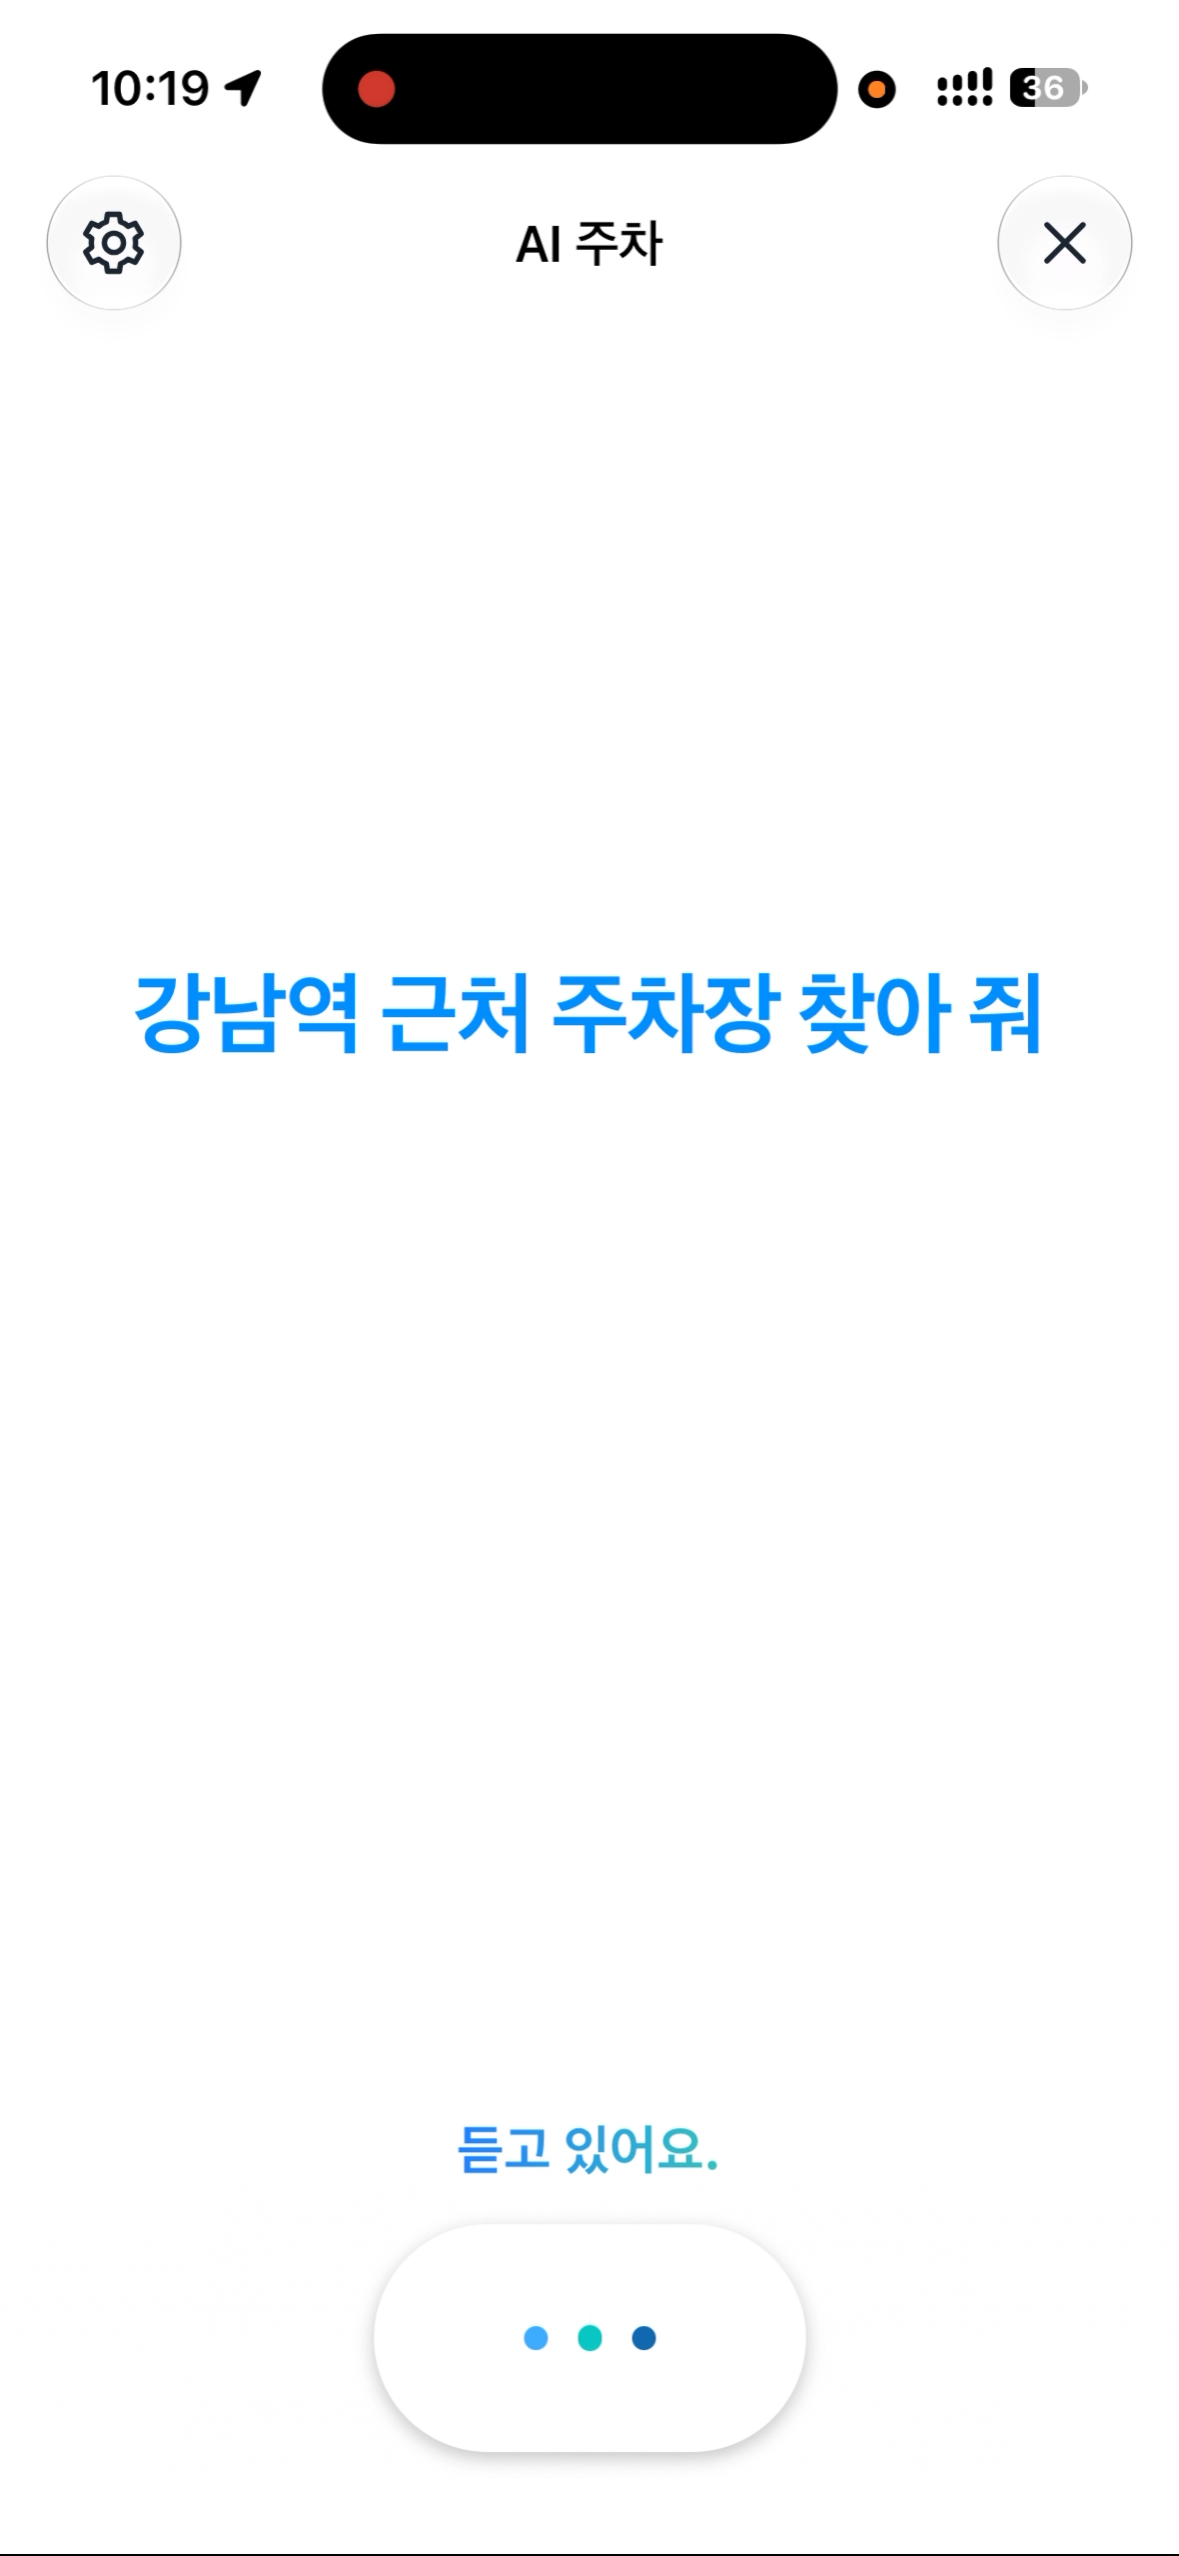
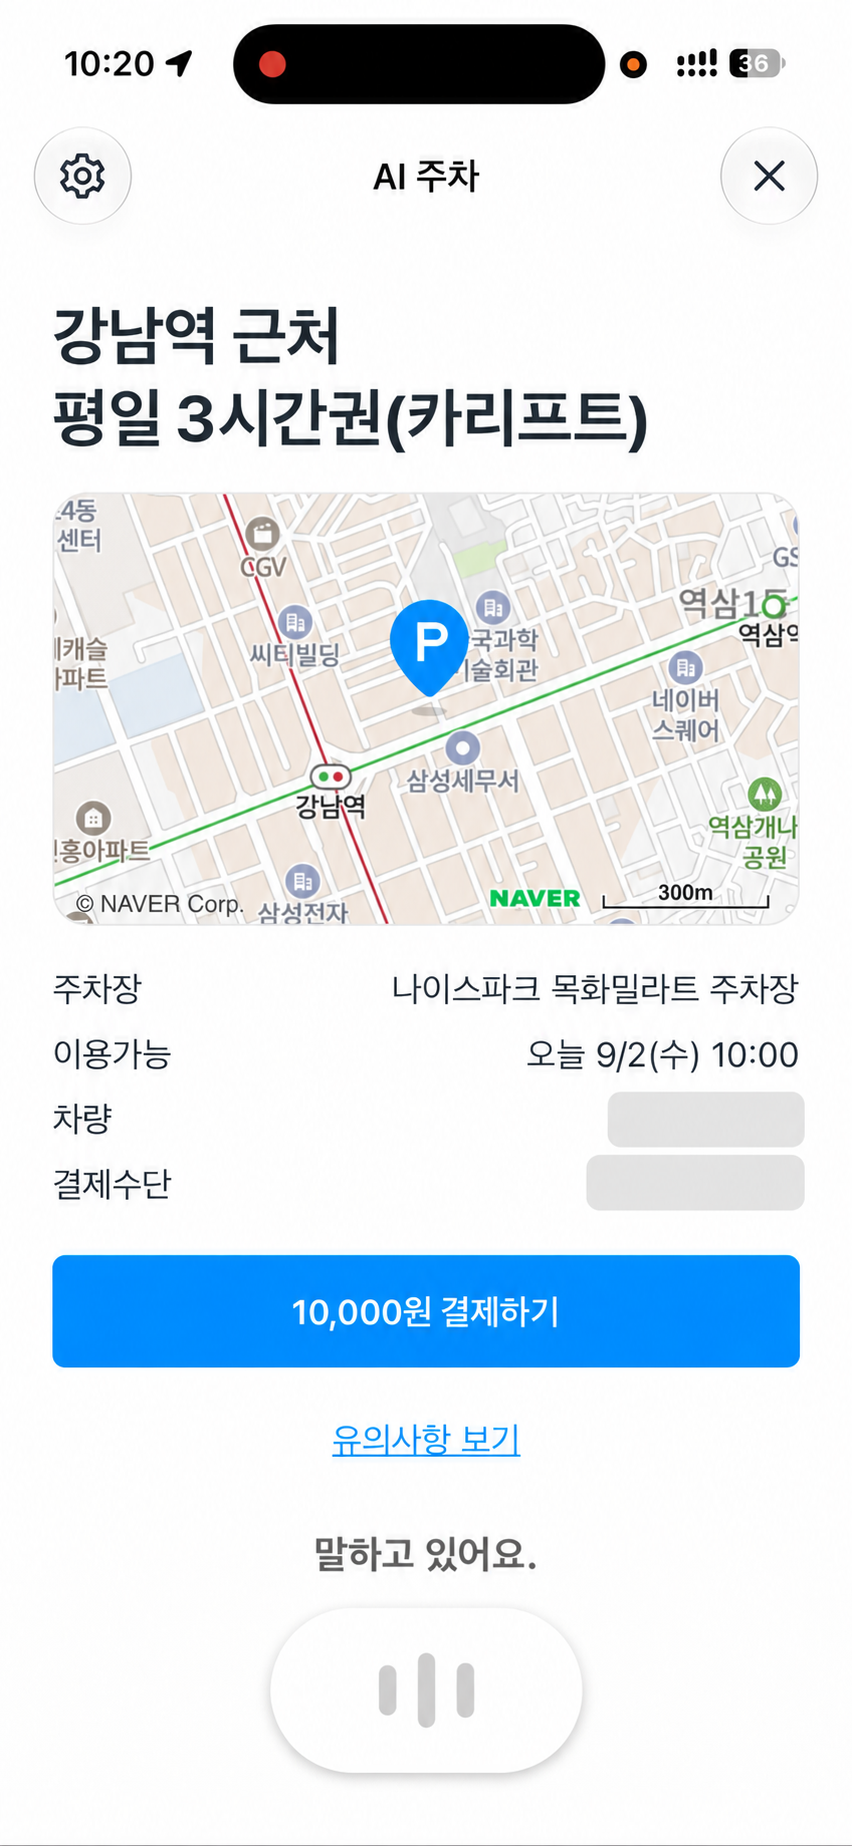
그림 7. 9월 2일 베타 출시 때 공유한 앱 화면. 음성으로 요청하고, 추천받은 주차권의 위치와 이용 조건을 확인한 뒤 결제 버튼으로 구매를 진행합니다. 결제 화면은 차량·카드 정보를 가린 편집본입니다.
AI-DLC를 도입하며
MVP를 빠르게 검증하고 제품에 집중할 수 있었습니다
AI-DLC를 적용해 이틀 안에 음성으로 요청하고 응답을 듣는 MVP(핵심 기능을 갖춘 초기 제품)를 구현했습니다. 직접 대화해보면서 어떤 부분이 불편하고 무엇을 보완해야 하는지 확인할 수 있었고, 첫 출시에 음성을 포함하기로 결정할 근거도 얻었습니다.
동작하는 제품을 일찍 확보한 덕분에 이후에는 사용자가 어떻게 이용할지에 집중할 수 있었습니다. 음성 안내가 끝난 뒤 자연스럽게 다음 말을 할 수 있는지, 화면에는 어떤 정보가 필요한지, 텍스트 입력을 계속 지원해야 하는지 등을 실제 사용 경험을 바탕으로 검토했습니다. 빠른 구현은 출시할 제품의 방향을 정하고 다듬는 데에도 도움이 되었습니다.
의사결정 이력과 개발 방식이 프로젝트 자산으로 남았습니다
워크숍에서 AI와 나눈 질문과 답변, 그 과정에서 내린 결정은 문서로 남았습니다. 이후 개발을 진행하면서 요구사항이 왜 그렇게 정해졌는지, 어떤 조건을 고려해 설계했는지 다시 확인할 수 있었습니다. 새로운 기능을 추가하거나 기존 동작을 수정할 때도 이 기록을 참고했습니다.
AI가 따라야 할 개발 규칙과 단계별 검토·테스트 절차를 정한 ‘개발 하네스’도 함께 남았습니다. 워크숍 이후에도 이 문서와 규칙을 활용해 AI에 프로젝트의 맥락을 전달하고, 작업을 계획하고 검토할 수 있었습니다. 구현한 기능에 더해, 다음 개발에서도 활용할 수 있는 판단 근거와 작업 방식이 쌓였다는 점이 유용했습니다.
마치며
AI를 활용한 개발에서는 코드를 빠르게 작성하는 능력과 함께, 프로젝트의 요구사항과 판단 근거를 다음 작업으로 전달하는 방식도 중요하다고 생각합니다. 개발이 계속될수록 기능과 제약 조건은 늘어나고, 이전에 내린 결정을 이해한 상태에서 다음 변경을 진행해야 하기 때문입니다.
이번 프로젝트에서 AI-DLC는 요구사항을 구체화하고 구현을 검증하는 과정을 안내해주었습니다. 그 과정의 문서와 규칙은 워크숍이 끝난 뒤에도 개발에 활용할 수 있었습니다. 빠르게 구현해 제품을 검증하고, 그때 얻은 판단과 개발 방식을 다음 작업에 이어가는 데 AI-DLC의 가치가 있다고 봅니다. AI와 함께하는 개발에서도 이러한 경험을 프로젝트에 꾸준히 쌓아가려고 합니다.
AI 음성 주차는 현재 모두의주차장 앱에서 베타 기능으로 이용할 수 있습니다.
참고 자료와 문의
이 글에서 다룬 방법론과 문서 구조는 AI-DLC 소개 글과 Amazon Q Developer로 AI-DLC를 적용하는 방법에서 확인할 수 있습니다. AI-DLC 워크숍인 Unicorn Gym 참여에 관심이 있으시면 담당 AWS 계정팀에 문의해주세요.
저자 소개
|
이민택 Product Engineer (쏘카 모두의주차장 코어개발팀) 쏘카의 주차 플랫폼 모두의주차장에서 백엔드 개발을 맡고 있습니다. 사용자가 주차장을 찾고 주차권을 구매하는 과정을 더 편리하게 만드는 일을 하고 있습니다. 최근에는 AI 음성 주차 서비스를 개발하며, 생성형 AI를 제품과 개발 과정에 활용하는 방법을 고민하고 있습니다. |
|
|
이지원 Product Engineer (쏘카 모두의주차장 프로덕트팀) 쏘카의 주차 플랫폼 모두의주차장에서 iOS 개발을 맡고 있습니다. 사용자가 주차장을 찾고 결제하기까지의 앱 경험을 만드는 일을 하고 있습니다. 최근에는 AI 음성 주차 서비스를 앱에 담으며, 사용자가 더 쉽고 편리하게 주차할 수 있는 경험을 만드는 데 집중하고 있습니다. |
|
|
최원제 Product Designer (쏘카 모두의주차장 프로덕트팀) 쏘카의 주차 플랫폼 모두의주차장에서 프로덕트 디자인을 맡고 있습니다. AI 서비스에 쓰이는 컴포넌트와 디자인 시스템을 만들어, 어떤 화면에서든 일관되고 쉽게 쓸 수 있는 UI/UX를 만드는 일을 하고 있습니다. 최근에는 AI 음성 주차 서비스를 디자인하며, 대화형 AI에 어울리는 인터페이스와 디자인 시스템을 어떻게 만들지 고민하고 있습니다. |
|
|
신은세 Technical Leader (쏘카 모두의주차장 코어개발팀) 쏘카의 주차 플랫폼 모두의주차장에서 Technical Leader를 맡고 있습니다. 주차장 검색, 결제, 정산 등 핵심 도메인 API와 개발 플랫폼을 설계하며, 팀이 안정적으로 서비스를 운영하고 빠르게 실험할 수 있는 기술 기반을 만드는 일을 하고 있습니다. 최근에는 AI 시대의 속도에 맞게 조직의 일하는 방식을 바꾸는 것에 관심이 있습니다. |