AWS 기술 블로그
스마일게이트의 MS SQL 데이터베이스 현대화 – AWS Transform for SQL Server와 Claude Code의 하이브리드 전략
SQL Server 기반 .NET 애플리케이션을 Aurora PostgreSQL로 전환한 스마일게이트 STOVE 스토어 사례
스마일게이트는 2002년 설립된 글로벌 게임 기업으로, ‘크로스파이어’, ‘로스트아크’, ‘에픽세븐’ 등을 전 세계에 서비스하고 있습니다.
STOVE 는 스마일게이트가 2015년 선보인 PC 게임 플랫폼으로, 게임 유통과 결제 및 상점 서비스, 인디게임 레이블 ‘스토브인디’를 운영하며 글로벌로 확장하고 있습니다. 이번 사례는 STOVE 스토어의 상점 데이터베이스를 SQL Server에서 Aurora PostgreSQL 로 전환 검증한 프로젝트입니다.
이 글은 AWS가 제공하는 경험기반 가속화 프로그램(Experience based Acceleration Program)을 통해 AWS와 스마일게이트 개발팀 및 데이터베이스 팀과 함께 스마일게이트 STOVE 스토어의 상점 API와 결제 API, 그리고 이들이 공유하는 MS SQL Server 데이터베이스를 Aurora PostgreSQL로 전환하면서 AWS Transform 서비스를 어떻게 활용했고, 해당 도구가 남긴 마지막 작업을 AI 코딩 에이전트인 Claude Code로 어떻게 마무리했는지를 정리한 것입니다.
1. 대상 시스템과 전환 로드맵
1.1 두 개의 API, 하나의 데이터베이스
STOVE 스토어는 두 개의 .NET API로 구성됩니다. 상점 API는 상품, 카테고리, 장바구니, 프로모션 등 상점 기능을 담당하고, 결제 API는 구매와 정산을 담당합니다. 두 API는 다른 .NET 프레임워크 버전 기반으로 작성되었지만 동일한 상점 데이터베이스를 사용하는 시스템입니다.
전체 애플리케이션 코드는 약 10만 라인 이상의 규모이며, 변환 대상 데이터베이스는 테이블 98개, 저장 프로시저 342개(T-SQL 약 5.8만 행), 사용자 정의 테이블 타입 37개, 함수 11개로 구성됩니다. 비즈니스 로직의 대부분이 저장 프로시저 안에 있고, 애플리케이션은 그 프로시저를 호출하는 구조입니다. 이 구조는 데이터베이스 엔진 전환 시 프로시저와 같은 프로그램 가능한 객체의 변환이 전체 변환의 성공을 좌우하는 관건이 되는 부분입니다.
1.2 두 단계 로드맵
상점 API가 .NET Framework 4.5였기 때문에 데이터베이스 전환에 앞서 프레임워크 업그레이드가 선행되어야 했습니다. AWS Transform for SQL Server의 코드 변환은 크로스플랫폼 .NET 6 이상을 전제로 하기 때문입니다. 로드맵은 자연스럽게 두 단계로 나뉘었습니다.
- 1단계 프레임워크 현대화: 상점 API를 결제 API와 같은 .NET 8로 업그레이드합니다. AWS Transform for .NET을 사용하며, 이 단계에서는 데이터베이스를 고정하였습니다.
- 2단계 데이터베이스 현대화: AWS Transform for SQL Server로 상점 데이터베이스 스키마를 Aurora PostgreSQL로 변환하고, 두 API의 데이터 접근 계층을 PostgreSQL에 맞게 변환합니다.
이 글은 두 번째 단계에 집중합니다. 단, 6장의 정량 성과는 상점 API의 1단계 공수를 포함한 이번 프로젝트 전체 수치를 다룹니다.
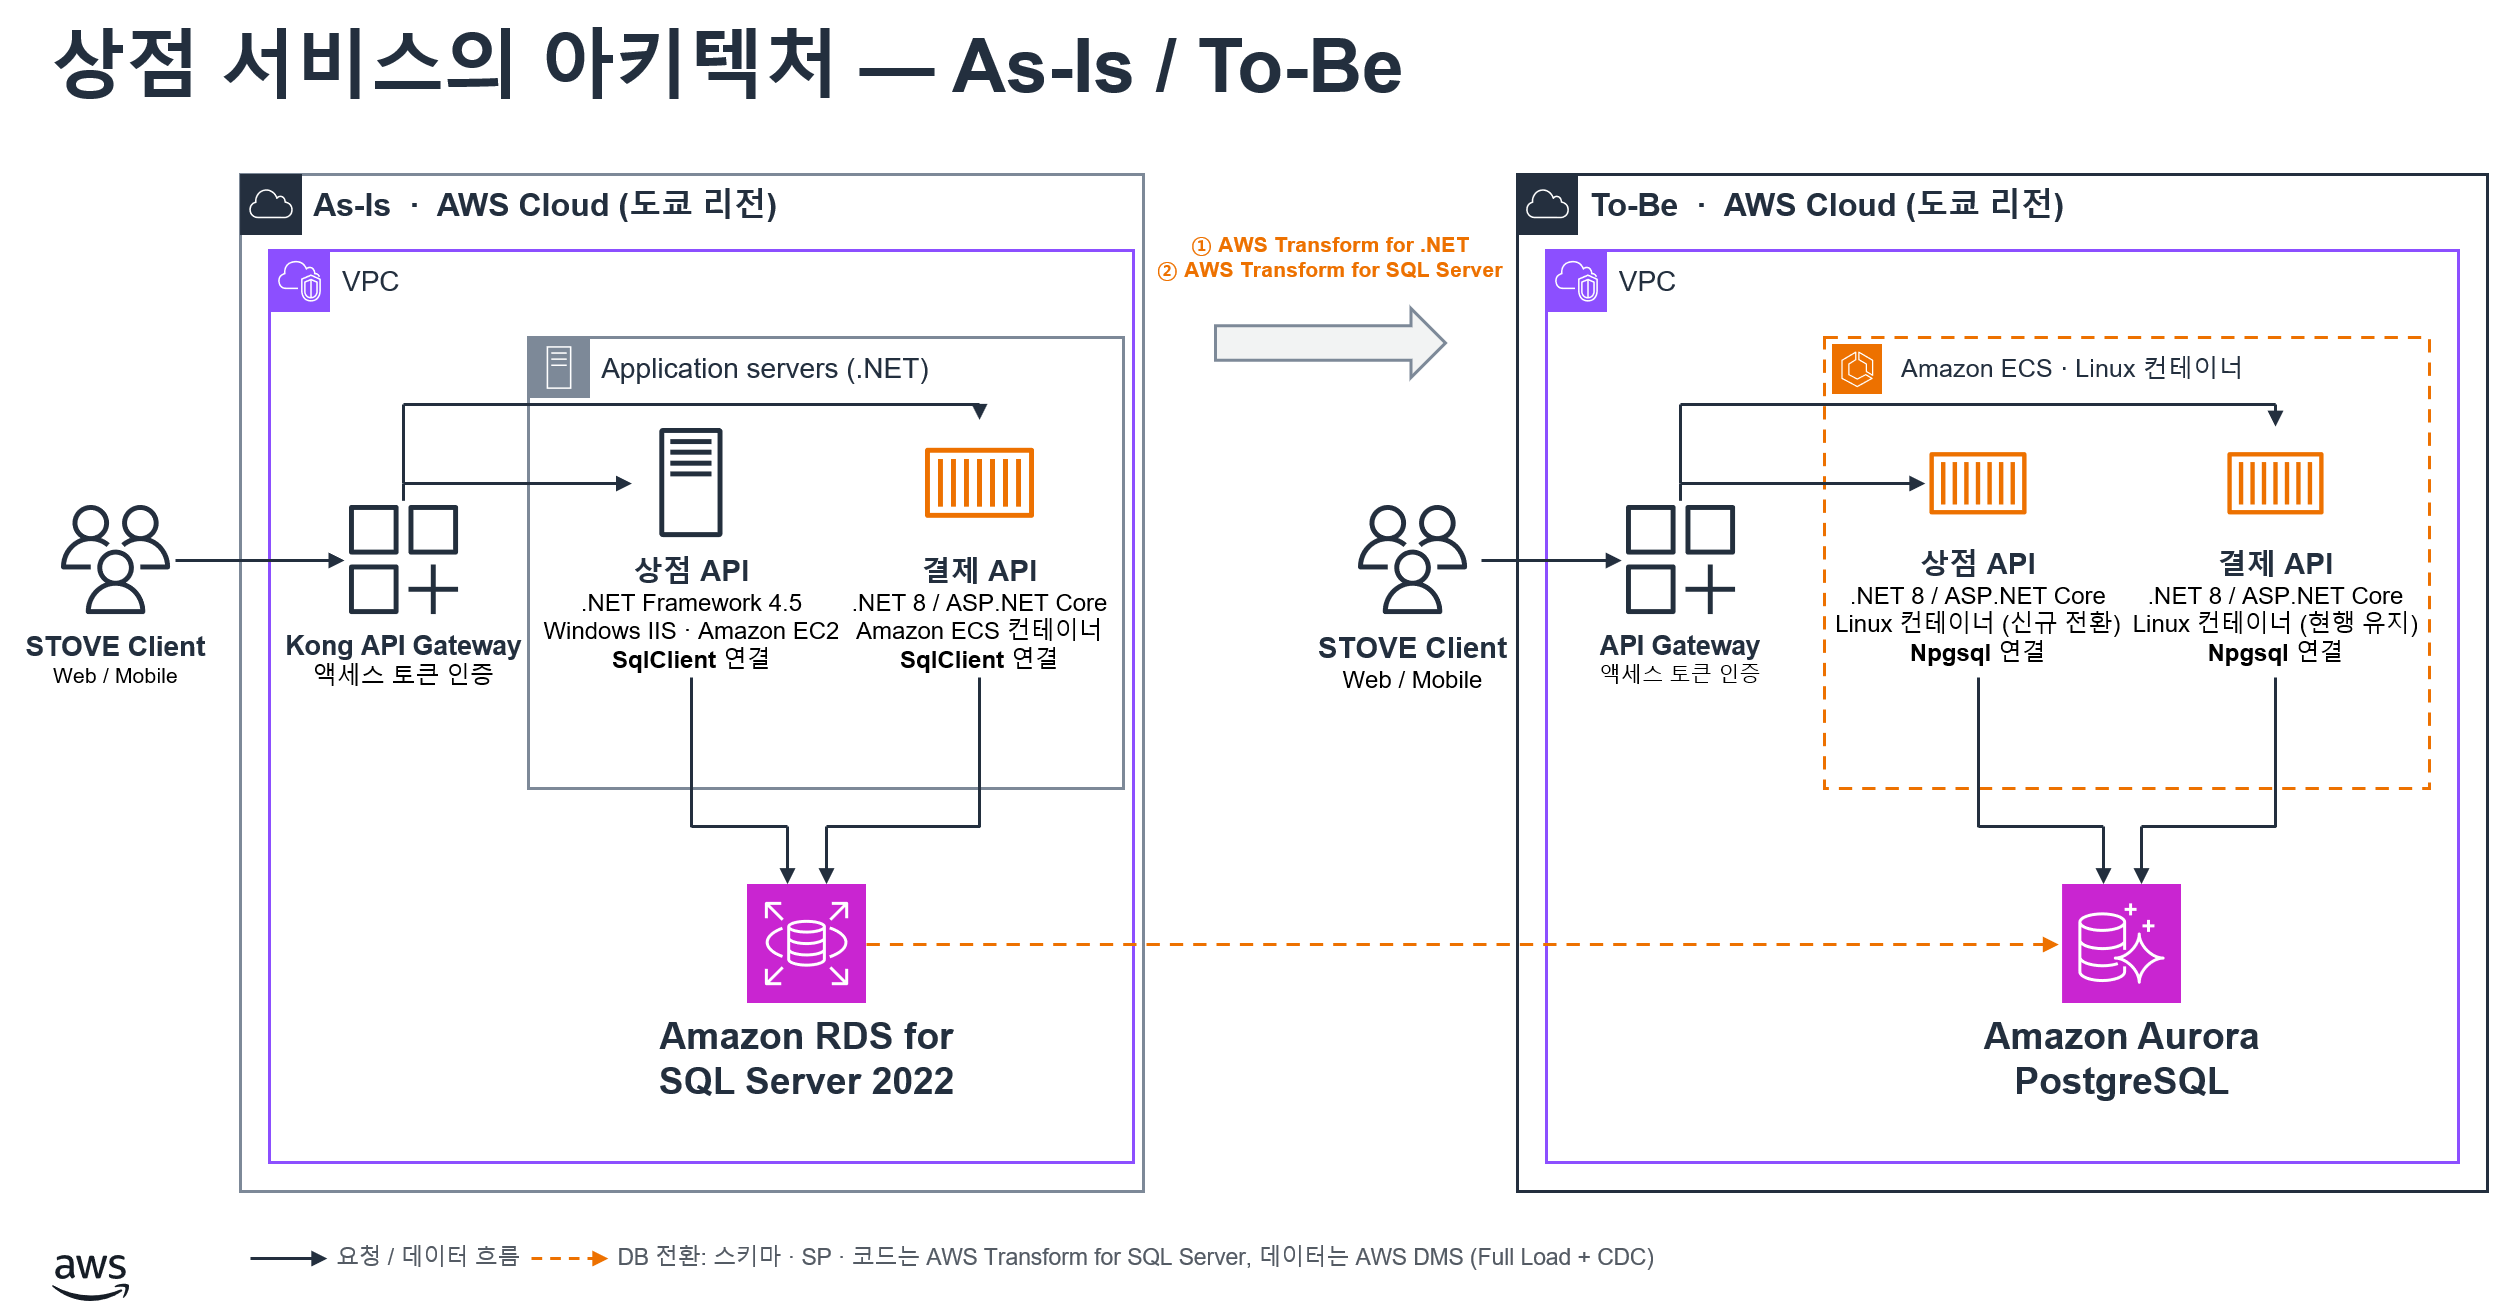
<그림 1. 아키텍처의 변환>
2. 데이터베이스 현대화의 진입 점 — AWS Transform for SQL Server
이기종 데이터베이스로의 이전은 스키마 변환과 데이터 이관만의 문제가 아닙니다. 데이터베이스는 애플리케이션을 통해 사용되므로, 데이터베이스에 종속된 애플리케이션들을 같은 관점에서 함께 변환해야 한다는 점이 현대화를 어렵게 합니다. 레거시 시스템을 현대화 한다는 것은 과거에 DBA팀과 개발팀이 합의했던 설계를 다시 되짚어 새로운 환경에 맞는 스키마와 코드로 하나씩 다시 만들어 내는 일이며, 상당한 인력과 시간이 드는 작업입니다.
AWS Transform for SQL Server는 복잡한 레거시 환경으로부터 현대화를 이끌수 있는 시작점이 됩니다. MS SQL 데이터베이스와 종속 애플리케이션을 같은 맥락에서 평가하고, 데이터베이스 스키마 변환과 애플리케이션 코드 변환을 하나의 워크플로에서 처리합니다.
AWS Transform for SQL Server를 이용하여 변환작업을 완료했을 때, STOVE 스토어의 상점 API와 결제 API, 두 API 모두 빌드에 성공했고, MS SQL 데이터베이스는 프로그램 가능한 객체를 포함한 스키마 변환 산출물이 Aurora PostgreSQL을 대상으로 해당 클러스터에 배포되었습니다. 변환 작업이 진행되면서 생성된 리포트들은 에이전트가 변환한 부분과 그렇지 못한 부분을 구체적으로 기술하여 자료로써 제공합니다. AWS Transform for SQL Server는 결과적으로 현대화를 어디서부터 시작해야 할 지 난감한 부분을 해결하고 전체 변환 과정을 이끌어 줌에 따라 현대화 작업을 가속화합니다.
3. “빌드 성공”이 “실행 가능”은 아니었다
AWS Transform을 이용한 변환 후 Aurora PostgreSQL을 대상으로 실행 검토했을 때 여러 문제가 발생하였습니다. AWS Transform이 변환에 대한 초안을 작성하더라도 개발자 및 DBA의 추가적인 검증이 필요함을 의미합니다.
3.1 경고 없는 스키마 결함
변환된 스키마는 전반적으로 우수했지만, 별다른 표시 없이 잘못 생성된 객체들이 있었습니다. 그리고 일부 프로시저에는 SQL Server의 트랜잭션 제어 구문이 PostgreSQL에서 허용되지 않는 위치에 그대로 남아 있었는데, 변환된 프로시저를 실제로 실행해 보면 문제는 두 갈래였습니다. 하나는 실행이 멈추는 것으로, 미변환 구문, 비어 있는 스텁 함수, 임시테이블 잠금 같은 유형입니다. 실행하면 바로 드러나 계열별로 고칠 수 있었습니다. 다른 하나는 오류 없이 값만 달라지는 것으로, OUTER APPLY 가 CROSS JOIN 으로 바뀌어 행이 사라지거나, SELECT INTO 가 0행일 때 변수에 NULL 이 들어가 검증 분기를 건너뛰거나, 시간 함수가 행마다 다른 값을 내는 유형입니다. 이러한 부분은 실행 테스트로는 잡히지 않기 때문에 원본과 결과(Golden Master Capturing)를 비교하여 문제를 해결했습니다. 긍정적인 부분은 원인이 계열로 묶여 하나를 확정하면 같은 패턴을 일괄 수정할 수 있었기 때문에 빠르게 해결할 수 있었습니다.
| 유형 | 증상 | 영향 | 수정 |
|---|---|---|---|
| OUTER APPLY → CROSS JOIN | 할인 정보가 없는 상품 행이 결과에서 빠짐 | 상점 목록에서 상품이 사라져도 응답은 정상 | LEFT JOIN LATERAL … ON TRUE 로 복원 |
| SELECT INTO 0행 → NULL (COALESCE 변환 오류) | 조회 결과가 없으면 이전 값 대신 NULL | 거절해야 할 요청(없는 상점)이 정상 처리됨 | NOT FOUND 면 이전 값 복원 |
| GETDATE → clock_timestamp | 한 문장으로 만든 행들의 생성 시각이 제각각 | 같은 시각이어야 할 기록이 서로 어긋남 | (SELECT clock_timestamp()) — 문장당 한 번 계산 처리 |
| XML 노드 처리 → 첫 노드만 | 여러 노드 중 첫 노드 값만 추출 | 여러 항목을 넘겨도 일부만 반영됨 | XMLTABLE 헬퍼로 모든 노드 읽기 |
<표 1. 경고 없는 스키마 결함에 대한 유형별 수정 사항>
3.2 코드 변환의 경계
상점 API는 데이터 접근에 Dapper(SQL을 직접 작성해 실행하는 경량 ORM)를 사용합니다. AWS Transform for SQL Server의 코드 변환 범위는 Entity Framework(EF)와 ADO.NET이므로, Dapper 고유의 저장 프로시저 호출 패턴은 평가 단계에서 이미 “수동” 영역으로 분류되어 있었습니다. 그 결과 드라이버 교체와 연결 설정은 변환되었지만, PostgreSQL에서 달라진 프로시저 호출 방식(프로시저가 결과 집합을 refcursor라는 커서로 돌려주므로 CALL 후 FETCH가 필요하고, 출력 파라미터 값은 CALL이 돌려주는 결과 행에서 읽어야 하는 패턴)은 코드에 반영되지 않았습니다. 이것은 누락이 아니라 도구가 사전에 고지한 경계였습니다.
| 변환 작업 | 작업 유형 | AWS Transform 변환 결과 (초안) | 사람+Claude Code 수정 작업 |
|---|---|---|---|
| 완료 | DB 연결 및 드라이버 | Npgsql로 교체 | 추가 수정 없음 |
| 초안 후 추가 작업 | 대소문자 | 스키마만 소문자로 처리 | 엔티티-테이블 매핑 보정 및 접두사 통일 |
| 초안 후 추가 작업 | 임베디드 SQL | 호출문 변환, 접두사 삭제 | search_path 설정 부분 |
| 초안 후 추가 작업 | 데이터 유형 및 정렬 | 대소문자 무시 타입 적용 | 형 변환 및 ICU 콜레이션 변경 |
| 초안 후 추가 작업 | SP 실행 및 타입 매핑 | CALL 호출, 타입 불일치 | 입력 jsonb 통일, 호출 규약 정의 |
| 초안 후 추가 작업 | 결과 집합 및 TVP | refcursor 반환, TVP 불일치 | refcursor 수신처리, TVP는 복합 타입으로 처리 |
| 재작성 | 트랜잭션 및 예외 처리 | 예외 처리 미변환 (실제 예외가 가려짐) | 예외 처리 로직 재작성 |
<표 2. 작업 유형별 추가 변환 작업>
3.3 두 변환을 하나의 계약으로 맞추는 일의 어려움
도구를 이용한 현대화 진행 시 어려웠던 문제는 스키마 변환과 종속된 코드 변환이 서로의 산출물을 참조하여 정확히 맞물리도록 변환하는 일이 생각보다 어려웠다는 점입니다. 이는 도구만의 문제가 아닙니다. 실제 프로젝트에서 개발자와 DBA가 함께 작업할 때도 양 측의 계약을 합의하는 데 많은 협의 시간이 들고, 한 측면에서 먼저 수정하면 다른 편에서 그에 맞춰 다시 조정하는 일이 반복됩니다. (이는 코드 관리에서 Merge시 충돌을 처리하는 것과 유사합니다.) 예를 들어서, 데이터베이스 측 스키마는 테이블 타입 파라미터(TVP, Table-Valued Parameter. 여러 행을 한 번에 프로시저에 넘기는 SQL Server 고유의 파라미터)를 PostgreSQL 복합 타입 배열로 변환했는데, 코드는 JSON 문자열을 보내도록 변환되었습니다. 두 코드 변환 리포트 모두 “프로시저가 JSON을 받아야 한다”는 것이 가정임을 스스로 밝히고 있었고, 평가 리포트는 “스키마 팀과 TVP 전략을 합의하라”고 권고하고 있었습니다.
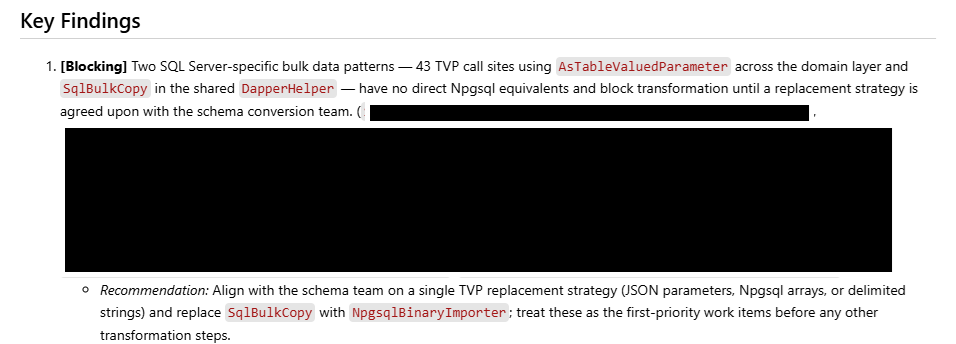
<그림 2. 평가 리포트에서 TVP처리 관련 내용 확인>
각 변환은 자기 영역 안에서는 최선의 처리였지만, 상대 영역의 결정을 알지 못한 채 내린 가정들이 존재하였으며, 이는 현대화 작업의 마무리를 어렵게 합니다. 그러므로, 이에 대한 전략이 필요했습니다.
4. 전략: 변환된 스키마를 검증으로 확정하고, 그 위에서 코드를 마무리한다
스키마 결함은 원본 DDL과 변환된 스키마를 다시 한번 비교 검증을 통해 빠르게 고칠 수 있고, 코드 측 작업은 스키마가 확정되어야 검증 기준이 생깁니다. 그래서 AWS Transform for SQL Server가 변환한 스키마를 기준(baseline)으로 삼아 먼저 데이터베이스 측면에서 검증하고 수정하여 동결한 후, 해당 정보를 기반으로 같은 맥락에서 코드 변환을 마무리하는 순서를 택했습니다. 개발자와 DBA가 서로 다른 전제로 각자 움직이는 대신, DBA 측이 먼저 완결된 스키마를 제공하고 개발자 측이 그것을 유일한 기준으로 삼는 방식입니다. 작업은 Claude Code의 도움을 받아 진행했지만, 순서와 기준은 개발자와 DBA가 결정했습니다.
기준 스키마는 세 단계로 확정했습니다. 변환 산출물을 테스트 클러스터에 올려 실행 오류를 먼저 없애고(실행 보정), 원본 SQL Server 와 타깃에 각각 사본을 두고 같은 입력으로 프로시저를 실행해 결과 집합, 출력 파라미터, 테이블 변화를 비교했으며(동등성 검증), 여기서 드러난 값 차이를 계열별로 고쳤습니다(오변환 수정). 수정이 끝난 DDL 은 도구 산출물이 아니라 DB 카탈로그에서 다시 추출해 하나의 정본으로 만들고, 정적 검수를 거쳐 동결했습니다.
이후 변환된 DDL기반으로 애플리케이션 측 변환 뒤 런타임에서 나온 추가 스키마 수정은 소수였고 재 수정된 DDL은 별도 묶음으로 개발팀에 전달하여 마무리하였습니다.
전반적인 원칙은 아래와 같습니다.
원칙
- 변환된 스키마를 원본 DDL과 대조하고 전수 스캔하여 결함 목록을 확정한다. 이 부분은 Claude Code를 이용하여 확인할 수 있다.
- 목록에 오른 결함만 수정하고 버전을 동결한다. “더 나은 구조로의 개선”은 별도 웨이브로 분리해 기준이 움직이지 않게 한다.
- 동결된 스키마를 테스트 클러스터에 적재하고, 데이터베이스 카탈로그에서 프로시저 시그니처(파라미터 순서와 타입, 커서 개수, 반환 파라미터)를 추출하여 코드 검증의 계약으로 정한다.
- 두 API의 코드를 이 계약에 대해 검증 및 수정한다.
- 통합 테스트 게이트(조회, 프로시저 전수 호출)를 통과한 뒤 컷오버를 준비한다.
5. Claude Code의 역할: 산출물을 컨텍스트로 받아 남은 문제를 해결한다
AWS Transform for SQL Server가 일관된 규칙으로 대량 변환을 수행하고 나면, 남는 일은 성격이 다릅니다. 산출물 사이의 정합성을 확인하고, 도구가 수동으로 분류한 영역을 다시 확인하여 설계하고, 경고 없이 틀린 부분을 찾아내는 일입니다. 이 작업에 Claude Code를 투입했고, 효과가 있었던 이유는 AWS Transform이 풍부한 산출물을 남기기 때문입니다.
| 산출물 | Claude Code가 활용한 방식 |
|---|---|
| 평가 리포트 (Assessment) | 어떤 패턴이 자동/검증 필요/수동으로 분류되었는지 확인 / 수동 영역(예: Dapper 프로시저 호출, TVP)이 곧 우선 작업 목록 |
| 변환 리포트 (Transformation Report) | 변환된 패턴별 위치(파일:라인), 실패 항목, 검증 결과 리포트 서술과 코드를 대조해 오류 탐지 및 판별 |
| 변환된 DDL | 프로시저 시그니처, 커서 개수, 타입 정의를 전수 파싱 / 코드 측 가정(JSON 파라미터 등)과 대조하여 계약 불일치를 정량화 |
| 원본 DDL | 도구가 추론으로 만든 타입 정의를 원본과 대조하여 오류 확정 |
| 변환된 코드 | 저장 프로시저 호출부의 패턴을 일괄 탐지해 수정 대상 인벤토리로 사용 |
<표 3. AWS Transform에서 제공하는 산출물 유형>
5.1 진행 작업
- 검증 도구 제작: 원본과 대상에서 같은 입력으로 프로시저를 실행해 결과를 비교하는 읽기, 쓰기 검증 도구와 결함 계열 분류기를 만들고, 첫 API에서 만든 것을 두 번째 API에 그대로 재사용했습니다.
- 교차 검증: 변환된 스키마와 두 API의 코드 변환 결과를 교차 대조해 계약 불일치(TVP 전송 방식, 함수 vs 프로시저 호출, 식별자 케이스, 반환 값 계약)를 각 관점별로 확정하고 영향 범위를 확인했습니다.
- 경고 없는 결함 탐지: 변환된 DDL의 타입 정의를 원본과 전수 비교하여 오류를 확인하거나, 프로시저 전체의 본문을 스캔하여 잠재적 오류를 찾았습니다.
- 수동 영역 재설계: 리포트가 [Manual]로 분류한 프로시저 호출 실행 모델을 재설계했습니다. 상점 API는 모든 DB 접근이 공통 래퍼(DapperHelper) 한 곳을 경유하므로, Dapper 호출부 256곳을 개별 수정하거나 EF Core로 바꾸는 대신 이 래퍼에서 PostgreSQL 호출 규약(CALL 실행, refcursor 결과 집합 FETCH, INOUT 반환 행에서 출력 파라미터 회수, 파라미터 이름 정규화)을 처리하도록 재작성해 호출부 코드는 그대로 두고 변환된 프로시저 시그니처와 맞추는 방식을 택했습니다.
- 리포트의 재해석: 코드 변환 리포트 서술과 코드 동작을 대조해 오류 탐지 후 판별하고, 반대로 “PASS”로 표시된 항목이 “검사 대상이 없어서 통과”인 경우를 구분했습니다.
5.2 AWS Transform과 Claude Code의 조합의 이유
두 도구의 오류 프로파일이 다릅니다. AWS Transform은 프로시저를 일관된 규칙으로 변환하는 데 강하고, 그 일관성 덕분에 애플리케이션 측이 하나의 파이프라인으로 전체를 처리할 수 있습니다. 반면 산출물 간 정합성이나 원본 대조 같은 “바깥에서 보는” 검증은 하지 않습니다. Claude Code는 대량 변환을 스스로 하기에는 비용과 일관성 면에서 불리하지만, 여러 산출물을 한 컨텍스트에 놓고 대조하고, 발견한 패턴을 코드베이스 전체에 일괄 적용하고, 그 과정을 문서와 skill(Claude Code가 다음 작업에서 재사용할 수 있도록 절차를 정리한 지침 파일)로 남기는 데 강합니다.
| 역할 | AWS Transform for SQL Server | Claude Code |
|---|---|---|
| 대량 변환 | 스키마 프로시저, 코드 수백 패턴을 일관된 규칙으로 변환 | 가능하나 비용 및 일관성 불리 |
| 산출물 간 교차 검증 | 수행하지 않음 | DDL, 코드, 리포트를 한 컨텍스트에서 대조 |
| 경고 없는 결함 탐지 | 리포트에 나타나지 않음 | 원본 대조 및 전수 스캔 |
| 수동 영역 재설계 | 범위 밖으로 고지 | 재설계 및 구현 |
| 절차 재사용 | 커스텀 변환 규칙(자연어 지침) 정의 | skill 문서로 팀 간 이전 |
<표 4. 역할별 AWS Transform과 Claude Code 비교>
6. 결과 및 주요 성과
현대화 작업을 위한 경험기반 가속화 프로그램의 스프린트는 2026년 5월부터 9월까지 5개회차에 걸쳐 진행되었으며, 성과는 두 트랙으로 나누어 측정했습니다. 데이터베이스 트랙은 DB플랫폼팀 DBA 1인이 상점 데이터베이스(SQL Server 2022 → Aurora PostgreSQL 17)의 스키마 변환과 원본 대조 동등성 검증을 수행한 구간이고, 애플리케이션 트랙은 상점 API와 결제 API의 코드 전환과 런타임 검증을 수행한 구간입니다. 비교 기준인 “기존 방식 예상 공수”는 확인된 물량(코드 라인 수(LOC), 저장 프로시저 수, 호출부 수, 라우트 수)을 환산한 보수적인 값입니다. 단, 두 트랙의 전제가 다릅니다. 데이터베이스 트랙의 예상치는 순수 수작업이 아니라 기존 방식, 즉 도구 자동 변환 후 남는 부분을 손으로 포팅하고 검증하는 작업을 팀 내 실측 단가(루틴당 0.4인일, SP 검증 0.25인일)로 환산한 값이고, 애플리케이션 트랙의 예상치는 과거 동일 규모 작업을 수작업으로 수행한 경험을 물량 기준으로 환산한 값입니다. 실제 공수는 작업 세션 로그의 월별 투입 비중을 합산한 값입니다.
6.1 공수 절감 – 기존 방식 예상 대비 실제 투입
| 트랙: 대상 | 전환 성격 | 기존 방식 예상 | 실제 투입 | 생산성 | MM 절감률 |
|---|---|---|---|---|---|
| DB: 상점 데이터베이스 | 테이블 98, 루틴 353 변환, 앱 호출 SP 동등성 검증 | 9.8 MM | 1.27 MM | 7.7배 | 약 87% |
| APP: 상점 API | .NET Framework 4.5 → .NET 8 + DB 계층 전환 (8개 프로젝트 / 64,795 LOC) | 8.0 MM | 2.5 MM | 3.2배 | 약 69% |
| APP: 결제 API | .NET 8 유지, DB 계층 교정 — SP 호출부 77곳 (3개 프로젝트 / 69,710 LOC) | 3.5 MM | 1.1 MM | 3.2배 | 약 69% |
| 합계 (두 트랙 단순 합산) | 21.3 MM | 4.87 MM | 약 4.4배 | 약 77% |
<표 5. 대상에 대한 공수 절감률>
두 트랙은 산정 주체와 기준이 다르므로 합계는 참고용 단순 합산입니다. 결제 API의 예상치에는 DB팀이 수행한 저장 프로시저 342개 변환 공수가 포함되지 않았고, 상점 API의 수치에는 1단계인 프레임워크 업그레이드 구간이 포함되어 있습니다. 도구 활성시간 실측 값은 스키마/루틴 353개 변환 초안이 AWS Transform Job 1회 약 8~10시간, 상점 API 프레임워크/코드 변환이 4개회차 합산 약 24시간, 결제 API가 약 3시간이었습니다. 8 MM 규모 작업(상점 API 전체)의 프레임워크 전환 초안을 도구 활성시간 24시간 안에 확보한 것과, 약 5.8만 행의 T-SQL 루틴 초안을 Job 1회 (약 8~10시간)로 확보한 것이 절감의 직접적인 근거입니다.
6.2 하이브리드 조합의 추가 효과 – Claude Code 단독 수행 대비
AWS Transform(1단계는 AWS Transform for .NET)이 프레임워크/구조 전환 구간을 선행 처리한 덕분에, Claude Code만으로 같은 작업을 수행하는 경우와 비교해도 추가 절감이 발생했습니다. 상점 API의 프레임워크/구조 전환 패키지(8개 프로젝트)는 수작업 3.0 MM, Claude Code 단독 1.0 MM로 추정된 반면 실제로는 0.4 MM에 마무리되었고, 이 구간이 추가 효과의 대부분을 차지합니다. 반대로 런타임 결함 수정 및 API 검증 패키지는 Claude Code 단독 예상 0.9 MM보다 실제 1.0 MM로 오히려 늘었습니다. 도구 산출물에 남은 결함을 이 구간에서 찾아 고쳐야 했기 때문입니다. 초안은 도구가, 검증은 에이전트가 맡는다는 역할 분담이 수치에서도 그대로 드러납니다.
| 구분 | Claude Code 단독 | AWS Transform + Claude Code | 추가 생산성 | 추가 절감 |
|---|---|---|---|---|
| 상점 API | 3.5 MM | 2.5 MM | 1.4배 | 29% |
| 결제 API | 1.5 MM | 1.1 MM | 1.4배 | 27% |
| 합계 | 5.0 MM | 3.6 MM | 1.4배 | 28% |
<표 6. 하이브리드 조합의 추가 절감 비교>
6.3 수치가 말하는 것
절감의 대부분은 초안 생성 구간에서 발생했습니다. 테이블 98개와 루틴 353개가 AWS Transform Job 1회로, 8개 프로젝트의 프레임워크 전환 초안이 도구 활성시간 24시간으로 나왔습니다. 남은 공수는 변환이 아니라 “원본과 같은 값을 내는가”를 확인하고 고치는 일이었고, 이 구간에서 Claude Code가 검증 도구 제작, 결함 분류, 일괄 수정을 맡으면서 데이터베이스 트랙에서는 검증 구간에서도 기존 방식 대비 9.5배의 생산성이 나왔습니다. 반면 애플리케이션 트랙의 런타임 결함 수정 및 API 검증 구간은 2.0배에 그쳤습니다. 동등성 검증처럼 도구로 자동화할 수 있었던 구간과, API를 하나씩 호출해 결함을 찾아야 했던 구간의 차이입니다. 도구가 만든 오 변환의 수정 공수는 예상치에 포함하지 않았으므로, 위 절감률은 보수적인 값입니다. 잔여 작업량은 저장 프로시저 수와 호출부 수에 비례했으며, 인수 후 검증, 교정 공수는 별도 일정으로 확보해야 한다는 점도 함께 확인되었습니다.
7. 후속 전환에 적용할 다섯 가지 원칙
- “성공” 보고를 액면대로 읽지 않는다. 도구의 SUCCEEDED(작업 완료) 표시와 빌드 성공은 개별 산출물의 상태이지 시스템 수준의 정합성이 아닙니다. 정합성은 산출물 간 교차 대조로만 확인됩니다.
- 스키마를 먼저 확정하고 코드 변환에 컨텍스트로 제공한다. 스키마 변환 결과를 먼저 확정하고 그 산출물을 코드 변환의 입력으로 제공합니다. 같은 DB에 대한 변환 결과는 하나만 정본으로 관리합니다.
- 교차 검증을 필수 게이트로 둔다. DB 산출물이 정한 계약과 앱 산출물이 가정한 계약을 아래 대표적인 다섯 항목에서 나란히 대조하고, 하나라도 문제가 있다면 다음 단계로 진행하지 않습니다.
- 객체 타입: DB는 프로시저(CALL)로 만들었는데 앱은 함수(SELECT)로 호출하는지 여부 확인
- 파라미터: SP를 호출할 때 앱이 전달하는 값이 DB가 선언한 프로시저의 시그니처와 타입 및 순서 측면에서 맞는지 여부 확인
- 식별자: DB는 소문자로 접혔는데 앱의 매핑은 원본 대소문자를 유지하고 있는지 여부 확인
- 반환 계약: 출력 파라미터와 결과셋을 PostgreSQL 방식인 CALL로 돌려주는 결과 행 혹은 refcursor를 통해 읽는지 확인
- TVP: 테이블 타입 파라미터를 DB가 정한 형태(복합 타입 배열(composite type array) 또는 JSON)로 보내는지 확인
- 스키마 결함은 우선적으로 해결한다. 스키마 결함을 코드로 우회하면 잠복 결함이 남습니다. 스키마 수정은 AI 코딩 에이전트를 활용한 정적 분석으로 목록을 빠르게 확정하고 원본 대조 동등성 검증으로 확인한 뒤, 그 위에서 코드를 마무리하는 편이 총비용이 낮습니다. 하지만, 더 이상 스키마 결함이 없다는 의미는 아니고 코드 변환 이후에도 검증단계에서 불가피하게 수동적 스키마 변환이 필요할 수 있습니다.
- AWS Transform의 산출물을 AI 코딩 에이전트의 입력으로 사용한다. 평가 리포트, 변환 리포트, 변환된 DDL과 코드는 그 자체가 다음 단계의 컨텍스트입니다. 이 자료를 AI 코딩 에이전트에 그대로 투입하면 일괄 변환 패턴을 빠르게 찾고, 리포트가 가이드한 영역에 집중할 수 있습니다. 첫 API에서 정리한 절차는 skill로 남겨 두 번째 API에서 재사용합니다.
마치며
AWS Transform for SQL Server는 SQL Server에서 Aurora PostgreSQL로 가는 길의 대부분을 자동화해 주었습니다. 약 5.8만 행의 T-SQL이 AWS Transform Job 1회(약 8~10시간)에 PL/pgSQL로 바뀌고, 두 애플리케이션이 새 드라이버로 빌드 되는 경험은 수작업 마이그레이션과 비교할 수 없는 속도입니다. 그러나 마지막 구간, 즉 산출물들이 하나의 동작하는 시스템으로 맞물리는지를 확인하고 고치는 일은 여전히 사람과 그 사람을 돕는 에이전트의 몫이었습니다. 그 결과가 원본과 같은 값을 내는지 확인하는 검증 체계를 만드는 데 비슷한 시간이 들었고, 그 체계는 두 번째 API에서 그대로 재사용됐습니다. AWS Transform이 남긴 풍부한 산출물을 Claude Code의 컨텍스트로 삼아 그 마지막 구간을 닫는 것, 이것이 이번 프로젝트에서 찾은 하이브리드 전략입니다.
유사한 .NET과 MS SQL Server를 운영하는 환경의 현대화를 고민하고 계신다면, 앞서서 설명 드린 전략, 즉 AWS Transform for SQL Server와 Claude Code나 Kiro와 같은 AI 코딩 에이전트를 이용한 하이브리드 전략을 사용하여 비용적인 측면 및 속도 면에서 얻을 수 있는 이점을 얻으시 길 기대합니다.
저자 소개
스마일게이트
김신홍
스토브페이에서 플랫폼 상점 개발/운영 기술 리드를 담당하고 있습니다. 스토브페이가 전 세계 어디서든 믿고 편하게 쓰는 결제 서비스가 될 수 있도록 돕고 있습니다.
최현서
스토브페이 서비스개발팀에서 BackEnd 개발을 담당하고 있습니다. 팀원분들, 그리고 유관 부서분들과 함께 결제 과정에서 마주하는 크고 작은 문제를 풀어가며, 사용자가 믿고 쓸 수 있는 결제 서비스를 만들고 있습니다.
이병민
스마일게이트 DB플랫폼팀에서 게임서비스 및 스토브페이의 결제·상점 데이터베이스 운영을 담당하고 있습니다. 데이터베이스 설계와 튜닝, 운영 자동화, 이기종 DB 전환 검증까지 DBA 가 맡는 일의 범위를 넓혀 가고 있습니다.