O blog da AWS
Operando agentes autônomos em escala no Amazon Bedrock AgentCore
Por Neuton Assis, Enterprise Solutions Architect, AWS AGS.
Quando um agente de IA sai do protótipo e passa a atender times de verdade, três problemas aparecem quase ao mesmo tempo. O primeiro é de capacidade, porque cada skill nova vira alteração de código, deploy e mais uma rodada de testes. O segundo é de custo. Para dar conta das tarefas difíceis, é tentador rodar tudo no modelo mais capaz e a conta cresce na velocidade da adoção. O terceiro é de colaboração e costuma pegar as organizações de surpresa. Muitas vezes o que o agente precisa já existe como outro agente, construído por outro time, com o modelo e o contexto dele. Sem uma forma padrão de encontrá-lo e delegar a ele, resta integrar ponto a ponto ou reconstruir o que já existe.
Este post descreve um modelo de operação que trata os três juntos. A ideia central é simples de enunciar e tem consequências profundas na arquitetura: a plataforma, e não o modelo de linguagem, decide o que o agente pode fazer, com quem ele pode contar e com qual modelo cada capacidade pode ser executada. Implemento o modelo com Amazon Bedrock AgentCore, o AWS Agent Registry e o framework Strands Agents, combinando um catálogo governado de capacidades, colaboração entre agentes pelo protocolo Agent-to-Agent (A2A), seleção de modelo por capacidade e execução gerenciada.
Três problemas que chegam juntos
O caminho natural de um primeiro agente é embutir as ferramentas no código. Funciona bem para uma demonstração. O incômodo começa quando a organização quer que o mesmo agente atenda finanças hoje, gestão de times na semana que vem e suprimentos no mês seguinte: cada capacidade nova mexe no mesmo código, e cada mudança arrisca regressão no que já estava estável. Junto vem a governança. Nem toda equipe pode publicar qualquer capacidade para qualquer agente, e quando as ferramentas vivem no código o controle de quem adiciona o quê fica difuso, sem um ponto claro onde uma capacidade é registrada, revisada e aprovada.
O custo segue a mesma lógica de acoplamento e o volume de tokens agrava o problema. Em um agente, cada chamada ao modelo reenvia todo o contexto acumulado: o prompt de sistema, o histórico e os resultados de ferramenta. Por isso o consumo cresce a cada passo. Na demonstração desta postagem, um único pedido ao agente começou com cerca de 2 mil tokens de entrada na primeira chamada e chegou a 12 mil na última. No conjunto das execuções, foram cerca de nove tokens de entrada para cada token gerado. Se o agente roda inteiro em um modelo grande, ele paga preço de tarefa difícil por todo esse contexto, mesmo quando está só descobrindo o que fazer ou respondendo algo trivial. Nas medições realizadas nesse experimento, responder uma pergunta trivial com o modelo mais capaz custou cerca de nove vezes mais do que com um modelo econômico. A intuição de que o modelo mais capaz resolve tudo esconde um desperdício que se concentra justamente nas tarefas mais simples e só aparece na fatura quando o volume cresce.
O terceiro problema é mais recente e muda o desenho. Conforme os times entregam seus próprios agentes, a capacidade que falta ao seu já foi construída por alguém: um especialista em estimativa de custos, um revisor de arquitetura. Reimplementar isso como ferramenta é desperdício, e chamá-lo por integração ponto a ponto recria o acoplamento de onde partimos, agora entre times. O que se deseja é que o agente descubra os pares disponíveis pelo mesmo mecanismo com que descobre ferramentas, e delegue a eles sob governança.
A plataforma decide e o agente executa
O modelo de operação que descrevo aqui parte de uma separação de responsabilidades. O agente é deliberadamente enxuto: sabe conversar, raciocinar sobre o pedido e coordenar chamadas. O que ele não sabe, de propósito, é o que está disponível no catálogo de capacidades da organização, quem são seus pares nem qual modelo usar para cada tarefa. Essas decisões pertencem à plataforma que o envolve.
Na prática, essa plataforma não é um único componente, e sim um papel arquitetural exercido por um conjunto de serviços: um catálogo governado que guarda as capacidades disponíveis, de ferramentas a agentes, e controla sua publicação; uma camada que expõe ferramentas de forma desacoplada e pesquisável; um protocolo Agent-to-Agent que acionam especialistas sem integração ponto a ponto; uma política que determina qual modelo foi validado para cada capacidade; e um substrato de execução gerenciado que hospeda os agentes com isolamento de sessão e identidade. O agente pede; a plataforma responde o que é possível e sob quais condições.
Três técnicas dão vida a esse princípio, e o restante do post é dedicado a elas:
- Descoberta dinâmica e governada de capacidades: o agente consulta o catálogo em tempo de execução e encontra tanto procedimentos quanto especialistas, sem que nada novo exija alteração no seu código.
- Colaboração entre agentes pelo catálogo: o cartão (Agent Card) de um agente par já é o contrato de capacidade dele, então descobrir e delegar é caminho nativo e equivalente, não caso especial.
- Seleção de modelo por capacidade: cada capacidade declara o modelo validado para ela e a plataforma o aplica no momento certo, começando sempre por um modelo econômico na descoberta.
Arquitetura de referência
A arquitetura combina componentes gerenciados da AWS em torno de agentes que executam em ambientes de execução dedicados.
| Papel na plataforma | Componente nesta implementação |
| Catálogo governado de capacidades (ferramentas, procedimentos e agentes) | AWS Agent Registry |
| Camada de decisão de modelo | Política de modelo no código do agente |
| Acesso desacoplado a ferramentas | AgentCore Gateway com busca semântica |
| Colaboração entre agentes | Protocolo A2A sobre AgentCore Runtime |
| Substrato de execução gerenciado | AgentCore Runtime |
| Malha de confiança e autenticação | AgentCore Identity |
Diagrama de arquitetura da solução:
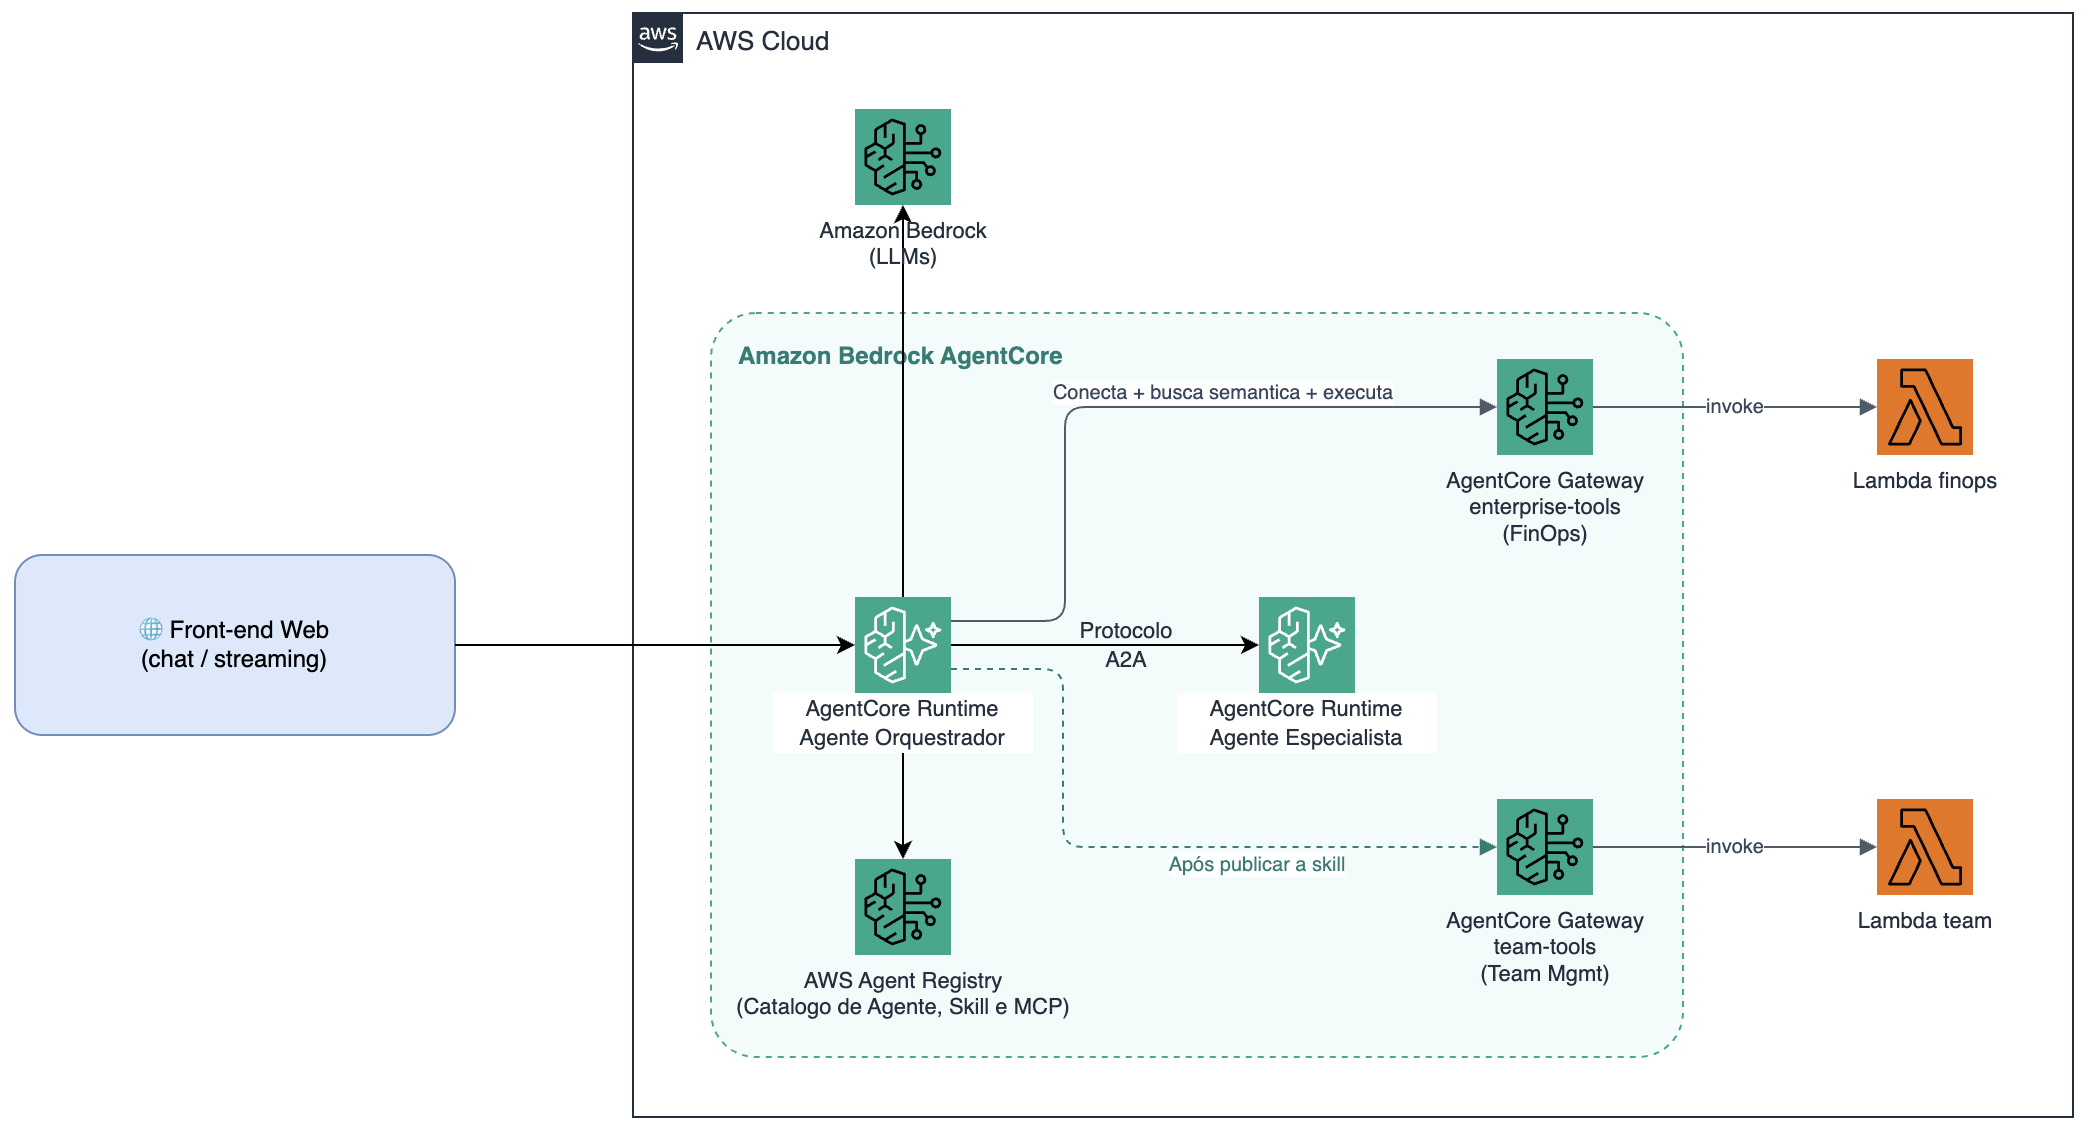 O fluxo tem cinco passos, com uma bifurcação no fim:
- Entrada do usuário: o cliente envia a pergunta ao orquestrador hospedado no AgentCore Runtime, que responde em streaming.
- Descoberta da capacidade: o agente consulta o AWS Agent Registry uma vez e recebe, na mesma resposta, as skills e os pares que combinam com o pedido.
- Seleção de modelo: a plataforma define qual modelo atende o passo seguinte, escalando só quando a capacidade escolhida declara um modelo mais capaz.
- Resolução de provedores: o catálogo traduz nomes lógicos em endereços físicos, seja o de um Gateway de ferramentas, seja o endpoint de um par.
- Execução: o agente executa ferramentas no AgentCore Gateway, que roda funções AWS Lambda, ou delega a um especialista através do protocolo A2A, ou ambos, quando o procedimento pede os dois.
Note a fronteira que isso estabelece. O núcleo do valor, descoberta governada, decisão de modelo, execução de ferramentas e delegação, acontece nos agentes hospedados no Runtime. A interface é periférica, consome o streaming e traduz eventos em algo visível, sem carregar lógica de negócio. Se amanhã ela for um canal de chat corporativo ou uma API, a estrutura do padrão continua íntegra.
Os três tipos de registro do catálogo governado
O Model Context Protocol (MCP) padroniza como agentes descobrem e chamam ferramentas. O protocolo A2A, estabelece como agentes conversam entre si. O AWS Agent Registry acrescenta a ambos uma camada de catálogo e governança, com três tipos de registro:
- Skill: um procedimento governado com objetivo, passos, regras de negócio, formato de resposta e o modelo validado.
- MCP Server: onde as ferramentas realmente estão, com o inventário de tools do servidor.
- Agent: um agente par, pelo seu cartão A2A, com as skills que ele anuncia e o endereço para alcançá-lo.
Cada registro passa por um fluxo de estado, de rascunho até aprovado, o que dá um ponto único de controle. Vale para os três tipos, e isso importa mais adiante: um par não aprovado não é descoberto, então a governança da colaboração já está resolvida no catálogo.
O registro de um servidor MCP guarda o endereço do Gateway, então o agente nunca tem URL fixa no código. Em vez de escrever o inventário de ferramentas à mão, basta solicitar ao Registry que sincronize a partir do próprio endpoint, o que mantém o catálogo fiel ao que o Gateway expõe, incluindo o prefixo de alvo em cada nome.
def publish_mcp_gateway_record(client, registry_id, logical_name, gateway_url, description, gateway_role_arn, region):
    """Publish an MCP record that synchronizes from the Gateway endpoint.

    The Registry connects to the endpoint and populates the server and tool
    metadata itself, so the tool inventory in the catalog always matches what the
    Gateway actually exposes, including the target prefix on each tool name.
    """
    source = {
        "fromUrl": {
            "url": gateway_url,
            "credentialProviderConfigurations": [{
                "credentialProviderType": "IAM",
                "credentialProvider": {"iamCredentialProvider": {
                    "roleArn": gateway_role_arn,
                    "service": "bedrock-agentcore",
                    "region": region,
                }},
            }],
        }
    }
    upsert_record(
        client, registry_id,
        descriptors={"mcpServer": {"source": source}},
        name=logical_name, displayName=logical_name,
        description=description, recordType="MCP", recordVersion="1.0",
    )
Publicar um agente par é o análogo disso para colaboração. O registro carrega o cartão A2A, e o cartão é o contrato: diz o que o agente faz, o que ele anuncia e onde atende. Para um agente no AgentCore Runtime, o endereço acionável é o ARN do runtime.
def publish_agent_record(client, registry_id, agent_name, endpoint, capability, description):
    """Publish an AGENT record carrying the peer's A2A agent card."""
    endpoint = _clean_endpoint(endpoint, agent_name)  # exactly one runtime ARN
    # The Registry validates the card against the A2A Agent Card schema, so the
    # required fields must all be present: protocolVersion, capabilities, the
    # default input/output modes, and tags on each skill.
    agent_card = {
        "protocolVersion": "0.3.0",
        "name": agent_name,
        "description": description,
        # For an agent hosted on AgentCore Runtime the addressable target is its
        # runtime ARN, which is what InvokeAgentRuntime takes.
        "url": endpoint,
        "version": "1.0.0",
        "capabilities": {"streaming": True},
        "defaultInputModes": ["text/plain"],
        "defaultOutputModes": ["text/plain"],
        "skills": [{
            "id": capability, "name": capability,
            "description": description, "tags": capability.split("-"),
        }],
    }
    upsert_record(
        client, registry_id,
        # The descriptor is `a2aAgentCard`, and the card travels as a JSON string.
        descriptors={"a2aAgentCard": {"data": json.dumps(agent_card)}},
        name=agent_name, displayName=agent_name,
        description=description, recordType="AGENT", recordVersion="1.0",
    )
A separação entre capacidade e provedor permite o comportamento mais interessante do modelo. É possível deixar dois servidores de ferramentas registrados desde o primeiro deploy, tratando-os como infraestrutura, e ainda assim manter uma capacidade indisponível: basta não publicar a skill que os utiliza. Publicar a skill depois ativa a capacidade, sem tocar na infraestrutura nem no código do agente.
Decisão sobre o uso de skill ou agente
Skills e agentes resolvem problemas diferentes, e essa distinção determina o quanto a plataforma governa cada capacidade. Uma skill é um procedimento publicado no catálogo: descreve a ordem dos passos, as regras de negócio e o formato da resposta, além de limitar o agente às ferramentas declaradas e indicar o modelo validado para a tarefa. Por ser versionada e aprovada no catálogo, ela pode alterar o comportamento do agente sem mudança de código ou novo deploy.
Um agente especialista, por outro lado, encapsula o próprio modelo, contexto e raciocínio, evoluindo de forma independente sob responsabilidade do time que o construiu. Seu agent card (protocolo A2A) descreve o que ele sabe fazer e onde encontrá-lo, permitindo que seja descoberto e usado assim que aprovado no catálogo, enquanto o orquestrador permanece no modelo econômico e apenas delega.
O critério de escolha é, portanto, a existência de um procedimento a governar. Tarefas que exigem uma sequência de passos sobre ferramentas, ou que combinam vários especialistas numa ordem definida, merecem uma skill; já quando um único especialista resolve a tarefa sozinho, o agent card basta. A especificação A2A estabelece registros curados e descoberta baseada em catálogo como estratégia de primeira classe para ambientes corporativos, em que os servidores publicam seus cartões e clientes consultam por critérios como habilidades. Da mesma forma, o AWS Agent Registry define que o registro contém o cartão que descreve capacidades, skills e interface conforme o A2A: como o cartão já é o contrato, envolvê-lo em uma skill apenas duplica o que ele afirma.
A decisão, então, é separar os dois caminhos e tratá-los como igualmente legítimos:
| Necessidade | Caminho | Motivo |
| Executar um procedimento governado | Encontrar uma skill, ativá-la, usar os provedores que ela resolve | O procedimento é o que está sendo governado |
| Entregar uma tarefa a um especialista | Encontrar um agente, delegar a ele | O cartão do par já é o contrato de capacidade |
A governança, que era a preocupação por trás do desenho original, continua atendida onde pertence: o AWS Agent Registry controla todo registro pelo fluxo de aprovação, inclusive os de tipo AGENT, e um par não aprovado não é descoberto. Não é preciso uma skill para servir de porta de entrada, e o controle de acesso segue no AWS Identity and Access Management (IAM).
Na prática, isso muda a ferramenta de descoberta: uma busca só, devolvendo os dois tipos de resultado juntos com os endpoints dos pares já incluídos, para que as opções sejam comparáveis em um passo.
@tool
def search_catalog(query: str, record_type: str = "") -> str:
    """Search the governed catalog for a capability.

    By default this returns both the skills and the peer agents that match, so the
    two options can be compared in one step. Searching only skills first tends to
    lead to activating a skill that merely shares a topic with the request.
    """
    kind = (record_type or "").upper()
    if kind == "AGENT":
        return find_agents(query)

    reg = registry()
    result = {"skills": [
        {"name": r.get("name", ""), "recordType": r.get("recordType", "SKILL"),
         "description": r.get("description", "")}
        for r in reg.search(query, record_type=kind or "SKILL")
    ]}

    # Peers are shown alongside skills, with their endpoints, so delegation needs
    # no second discovery round and no skill record.
    if not kind:
        result["agents"] = [
            {"name": b.name, "description": b.description,
             "skills": b.skills, "endpoint": b.endpoint}
            for b in reg.discover_agents(query)
        ]

    return json.dumps(result, ensure_ascii=False)
O critério de escolha fica no contrato de comportamento do agente, e não espalhado pelo código. O trecho relevante do prompt de sistema é curto e direto:
How to choose a path
--------------------
Start every request with a single search_catalog call, leaving record_type empty.
The result contains both `skills` and `agents` that match, so compare them before
doing anything.

1. A skill matches — activate it and follow its instructions. A skill exists when
   the objective needs a procedure: an order of steps, business rules, or a
   specific response format.
2. An agent matches and no skill does — call delegate_to_agent with that agent's
   `endpoint` from the search result. Do not activate a skill first, and do not
   search again; you already have what you need. A peer's agent card is its contract.
3. Neither matches — say the capability has not been published. Do not improvise it.
O que uma skill declara como contrato
Uma skill é um contrato que declara o que executar, com quais provedores e qual modelo foi validado para a tarefa. Neste exemplo, o contrato foi salvo em um arquivo SKILL.md, seguindo a especificação aberta Agent Skills. O exemplo também se limitou aos campos que a especificação define, com as extensões confinadas no bloco metadata, como a própria especificação recomenda.
---
name: finops-analysis
description: Reports what the organization actually spent on AWS, from billing data. Produces a per-service breakdown, month-over-month trends, and savings recommendations. Use for questions about spend that already happened. Not for estimating a hypothetical or future workload, which belongs to a cost estimation specialist.
compatibility: Requires the enterprise tools MCP gateway (FinOps cost analysis tools, finops target) registered in the Registry and reachable with IAM credentials.
allowed-tools: finops___get_cost_breakdown finops___get_cost_trend finops___get_savings_recommendations
metadata:
  agentcore-model: global.anthropic.claude-sonnet-5
---
O campo allowed-tools lista os nomes completos das ferramentas, como o Gateway os expõe, e compatibility nomeia o escopo onde procurá-las.
Já metadata.agentcore-model é o ponto central da economia. Uma skill de análise financeira, que compara períodos e raciocina sobre tendências, declara um modelo mais capaz; uma de consulta simples declara um modelo rápido e econômico. A decisão é tomada uma vez, por quem valida a skill, e não é refeita pelo modelo de linguagem a cada pergunta.
Quando o procedimento envolve outros agentes, eles entram em metadata.agentcore-agents, com a mesma convenção de lista separada por espaços:
metadata:
  agentcore-model: global.anthropic.claude-sonnet-5
  agentcore-agents: cost-estimator well-architected-reviewer
A ativação amarra tudo: busca o registro, lê o modelo declarado, aplica a política de modelo e resolve os provedores que o fluxo necessita, traduzindo nomes lógicos em endereços físicos. O agente recebe as instruções e um objeto resolved que delimita com o que ele pode trabalhar.
@tool(context=True)
def activate_skill(skill_name: str, tool_context: ToolContext) -> str:
    """Activate a skill and resolve the providers its flow needs."""
    reg = registry()
    skill = reg.get_skill(skill_name)
    if skill is None:
        return json.dumps({"error": f"Skill '{skill_name}' not found in the Registry."})

    # The platform selects the model; the LLM does not choose it.
    active_model, changed = policy.activate(skill.model)
    if changed:
        apply_model(tool_context.agent, active_model)

    resolved = {}

    # Tool providers: the Gateway that serves the tools this skill declares.
    gateway_scope = reg.resolve_tools(skill.allowed_tools, skill.scope)
    if gateway_scope:
        set_authorized_scope(gateway_scope.gateway_url, gateway_scope.allowed_tools)
        resolved["gateway"] = {
            "gateway_url": gateway_scope.gateway_url,
            "allowed_tools": gateway_scope.allowed_tools,
        }

    # Agent providers: peers this skill's flow orchestrates, if any. A skill that
    # declares none is not a lesser skill; it simply works with tools.
    agents = []
    for agent_name in skill.agents:
        binding = reg.find_agent(agent_name)
        if binding:
            agents.append({"name": binding.name, "skills": binding.skills,
                           "endpoint": binding.endpoint})
    if agents:
        resolved["agents"] = agents

    return json.dumps({
        "skill": skill.name,
        "activeModel": active_model,
        "instructions": skill.instructions,
        "resolved": resolved,
    }, ensure_ascii=False)
Em resolved é onde os dois tipos de provedor se encontram. Nenhuma skill carrega endereço, então a infraestrutura pode se mover sem tocar nos artefatos de negócio, além de um mesmo procedimento combinar ferramentas e agentes sem que o agente saiba previamente onde eles estão.
Colaboração governada por um procedimento
No trabalho colaborativo entre agentes, uma skill se justifica quando existe ordem, regra e formato a governar. O exemplo a seguir é um plano de otimização de custos que nenhum provedor isolado resolve: o gasto real vem de ferramentas, a projeção do estado futuro vem de um especialista, o julgamento arquitetural vem de outro, e cada passo alimenta o próximo.
1. **Establish the baseline.** Run `finops___get_cost_breakdown` for the last full
   month. Note the total and the top three services by spend.
2. **Collect the opportunities.** Run `finops___get_savings_recommendations`.
3. **Model the target state.** Delegate to `cost-estimator`. Describe the workload
   implied by the top recommendations. Include the services, the changes proposed,
   and the region in your message, because the specialist has no access to this
   conversation.
4. **Review the architecture.** Delegate to `well-architected-reviewer`, asking
   whether the changes introduce risk in any pillar.
5. **Synthesize the plan.** Present current spend, target spend as a range, the
   delta, then a prioritized action list.
Essa é a diferença entre chamar um especialista e governar uma colaboração. A skill não substitui os contratos dos pares; ela declara a sequência, o que cada um recebe e como os resultados se combinam. Duas regras do corpo da skill são de negócio, não de tecnologia: nunca inventar números, rotulando estimativas; não pular a revisão arquitetural, porque economia que prejudica confiabilidade não é economia.
A delegação em si é uma requisição A2A padrão. Pares no AgentCore Runtime são endereçados pelo Amazon Resource Name (ARN) do runtime e alcançados por InvokeAgentRuntime, que cuida de SigV4 e do isolamento de sessão; o AgentCore repassa o payload JSON-RPC ao contêiner do par sem alterá-lo.
def _a2a_message_send(text: str) -> bytes:
    """Build a standard A2A `message/send` JSON-RPC request."""
    return json.dumps({
        "jsonrpc": "2.0",
        "id": str(uuid.uuid4()),
        "method": "message/send",
        "params": {"message": {
            "role": "user",
            "parts": [{"kind": "text", "text": text}],
            "messageId": str(uuid.uuid4()),
        }},
    }).encode("utf-8")


@tool
def delegate_to_agent(agent_endpoint: str, message: str) -> str:
    """Delegate a sub-task to a specialist agent over A2A.

    Args:
        agent_endpoint: The peer's address. For peers on AgentCore Runtime this is
            the runtime ARN.
        message: A clear, self-contained task description. The specialist has no
            access to this conversation, so include everything it needs.
    """
    client = session().client("bedrock-agentcore")
    response = client.invoke_agent_runtime(
        agentRuntimeArn=agent_endpoint,
        runtimeSessionId=str(uuid.uuid4()),
        payload=_a2a_message_send(message),
    )
    raw = response["response"].read()
    text = raw.decode("utf-8") if isinstance(raw, bytes) else str(raw)
    return _text_from_a2a_response(json.loads(text))
Do outro lado, um especialista é um agente comum servido como servidor A2A, que declara o próprio modelo validado. É aí que a economia por capacidade se estende dos procedimentos aos pares.
# A capable model: cost estimation involves non-trivial reasoning.
MODEL_ID = os.environ.get("COST_ESTIMATOR_MODEL_ID", "global.anthropic.claude-sonnet-5")

_agent = Agent(
    model=BedrockModel(model_id=MODEL_ID),
    system_prompt=COST_ESTIMATOR_SYSTEM_PROMPT,
    name="cost-estimator",
    description="Estimates monthly AWS cost ranges for a described workload.",
)

# AgentCore Runtime expects A2A servers on 0.0.0.0:9000 at the root path, with the
# agent card at /.well-known/agent-card.json. The Strands A2AServer provides that.
app = A2AServer(_agent, host="0.0.0.0", port=9000)
Uma disciplina acompanha a delegação e é fácil de esquecer: o par não vê a conversa. Cada delegação abre uma sessão isolada no runtime do especialista, o que é bom para o isolamento mas significa que a mensagem precisa ser autossuficiente. Números já coletados, região, premissas assumidas, todo o necessário deve ser compartilhado na mensagem. É importante incorporar isso como regra explícita no prompt do orquestrador e no corpo da skill, porque o sintoma de esquecer é uma resposta que parece apenas ruim, sem nenhuma pista de que faltou contexto.
Caso queira saber mais sobre os cenários de orquestração multiagentes, confira a postagem Minimizando alucinações em orquestrações multiagentes, em que documento os desafios, os experimentos realizados e as práticas que se mostraram eficazes para minimizar essas alucinações.
Seleção de modelo por capacidade, onde mora a economia
O agente começa a atender cada pergunta com um modelo econômico, adequado à fase de descoberta, quando ele apenas consulta o catálogo e compara as opções. A troca para um modelo mais capaz acontece somente quando a capacidade ativada pede, e o modelo ativo volta ao econômico na pergunta seguinte. Quem coordena é a plataforma, encapsulada em uma pequena política de modelo, concentrada em um único lugar de propósito: quem lê o código entende a economia em poucas linhas.
class ModelPolicy:
    """Tracks the active model id and applies the platform's selection rule."""

    def reset(self) -> str:
        """Return to the economical default at the start of each new request."""
        self._active_model_id = self._default_model_id
        return self._active_model_id

    def activate(self, skill_model_id: str) -> tuple[str, bool]:
        """Escalate to the model a skill declares.

        Returns the active model id and whether it changed.
        """
        if skill_model_id and skill_model_id != self._active_model_id:
            self._active_model_id = skill_model_id
            return self._active_model_id, True
        return self._active_model_id, False
Com a colaboração no desenho, a seleção opera em dois níveis, e isso fortalece o argumento de custo. No primeiro, uma habilidade escolhe o modelo do orquestrador. No segundo, cada par roda o próprio modelo validado, decidido por quem construiu o especialista. A consequência é contraintuitiva e boa: numa delegação simples o orquestrador permanece no modelo econômico, porque quem carrega o raciocínio difícil é o especialista. Coordenar é barato, o trabalho pesado é cobrado onde acontece.
Agora um alerta que só se aprende operando: trocar de modelo no meio de uma sessão não é gratuito para o histórico. Modelos com raciocínio explícito deixam blocos de reasoningContent assinados, e enviá-los a um modelo que rejeita o campo faz o turno inteiro falhar, sem nenhuma saída. O efeito é cumulativo, então parece aleatório: a terceira ou quarta pergunta quebra e as anteriores funcionaram. A correção é higienizar o histórico no único ponto onde a troca acontece, para que nenhum chamador possa esquecer.
def apply_model(agent, model_id: str) -> None:
    """Point the agent at a model, keeping its history compatible.

    Always switch models through here. Serving one session with several models means
    the history has to stay portable between them, and a reasoning model leaves
    blocks behind that others reject. Doing the cleanup at the single point where
    the switch happens means no caller can forget it.
    """
    strip_reasoning_blocks(getattr(agent, "messages", None) or [])
    agent.model = build_bedrock_model(model_id)
Ferramentas desacopladas via AgentCore Gateway
As ferramentas não estão no código do agente. Elas vivem atrás de um AgentCore Gateway, um AI Gateway no qual uma de suas funcionalidades possibilita expor funções Lambda e APIs REST como um servidor MCP com busca semântica. O agente descobre o endereço do Gateway no catálogo e pergunta por linguagem natural quais ferramentas atendem à necessidade, em vez de assumir nomes fixos.
@tool
def search_gateway(gateway_url: str, query: str) -> str:
    """Search a resolved Gateway for tools by semantics.

    Args:
        gateway_url: The Gateway URL returned by activate_skill (in `resolved`).
        query: Natural-language description of the tool needed.
    """
    client = gateway_client(gateway_url)
    result = client.call_tool_sync(
        tool_use_id="gateway-search",
        name="x_amz_bedrock_agentcore_search",
        arguments={"query": query},
    )
    return extract_text(result)
A execução passa por uma verificação de escopo contra o que a skill autorizou, e aqui cabe uma distinção que costuma ser mal-entendida: essa verificação é um controle de contrato, não uma fronteira de segurança. Ela mantém o agente dentro da intenção declarada e transforma uma chamada fora do escopo em erro claro em vez de silencioso. A autorização real vive no IAM, no controle de acesso do Gateway e no AgentCore Policy, que valem independentemente do que o modelo decidir. Dimensione essa fronteira ao risco da capacidade, e nunca dependa de aderência ao prompt para capacidades sensíveis.
Execução gerenciada no AgentCore Runtime
Para operar em escala, cada agente precisa de um lugar gerenciado, e é isso que o AgentCore Runtime oferece: sessões isoladas em microVM, com CPU, memória e sistema de arquivos próprios, autenticação e escala a cargo do serviço e resposta em streaming. No exemplo que apresento aqui são três runtimes, um orquestrador e dois especialistas, o que mostra que o mesmo substrato hospeda quem coordena e quem executa.
Isso transforma a fronteira entre núcleo e periferia em uma fronteira de rede. O agente emite eventos semânticos conforme progride: busca no catálogo, descoberta de agentes, skill ativada, modelo selecionado, busca no Gateway, ferramenta executada e tarefa delegada.
Recomendações para operar agentes em escala
Abaixo algumas recomendações práticas que podemos resumir com base no que discutimos aqui:
- Trate o catálogo como produto: defina quem pode publicar skills, servidores e agentes, e use o fluxo de aprovação do Agent Registry como controle real, não como formalidade.
- Escreva descrições que reduzam a ambiguidade: a descrição é o vetor de descoberta. Diga o que a capacidade faz, quando usá-la e, quando houver ambiguidade, diga explicitamente o que ela não é.
- Não crie skill para delegação simples: se não há ordem, regra nem formato a governar durante o trabalho colaborativo entre agentes, o cartão do par já basta. Reserve a skill para quando houver um procedimento a governar.
- Faça toda mensagem de delegação autossuficiente: o par não tem acesso à conversa. Inclua números já coletados e premissas.
- Mantenha os agentes enxutos: resista a embutir ferramentas, endereços de pares ou decisões de modelo no código; esse é justamente o acoplamento que o modelo de operação evita.
- Aplique menor privilégio de ponta a ponta: lembre que o controle de escopo de skill é contrato, não fronteira de segurança.
- Meça antes de otimizar: instrumente consumo por capacidade e por modelo, incluindo os pares, e use esses dados para ajustar as escolhas.
Conclusão
Quando a plataforma, e não o modelo de linguagem, decide o que o agente pode fazer, com quem contar e com qual modelo cada tarefa executa, a capacidade deixa de ser um problema de código. Ela passa a ser uma questão de catálogo, com governança e sem deploy a cada nova skill. A colaboração deixa de ser integração ponto a ponto e passa a ser descoberta, porque o cartão de um par já é o contrato dele. E o custo deixa de acompanhar a capacidade máxima para acompanhar a dificuldade real de cada tarefa, em dois níveis: quem coordena fica barato, e quem raciocina paga pelo raciocínio.
Esse é um modelo de operação, não um produto fechado. O Amazon Bedrock AgentCore e o AWS Agent Registry oferecem uma instância de referência coesa, com catálogo, Gateway, Runtime e A2A, mas o padrão vale para além dela. Se você está levando seu primeiro agente além do protótipo, comece pelas perguntas que guiaram este texto: quais decisões pertencem ao agente e quais pertencem à plataforma ao redor dele. Identifique quando uma capacidade merece um procedimento governado em vez de ser entregue a quem já sabe fazê-la.
Para começar implementar sua plataforma de agentes hoje, consulte o repositório de exemplos oficial da AWS no GitHub para o Amazon Bedrock AgentCore. Pratique utilizando os workshops do Agent Registry, AgentCore Runtime e AgentCore Gateway.
Autor
 |
Neuton Assis é Arquiteto de Soluções na AWS para o segmento de Enterprise e membro da comunidade de AI/ML, com foco em Agentic AI. Antes disso, trabalhou por mais de 10 anos na arquitetura e desenvolvimento de softwares voltados para automação, auditoria de sistemas e gestão de identidade e acesso. Atualmente ajuda clientes da AWS, brasileiros e multinacionais, a implementarem arquiteturas de agentes de IA seguras, escaláveis e confiáveis. |