亚马逊AWS官方博客
Amazon MSK 成本优化实践:费用构成、配置方法与验证
摘要:本文中价格取自 AWS Price List API(AmazonMSK,us-east-1,版本 20260729211408,发布日期 2026-07-29)。实测数据环境 express.m7g.large × 3( us-east-1)、Apache Kafka 3.9(KRaft)集群,客户端为同 VPC 内的 EC2。容量与成本模型基于 AWS 官方 MSK Sizing and Pricing 计算表。正在做 Standard/Express 选型的读者可从第 5 章读起。
目录
一、优化前后的成本对比
先给一个算例,让后续各章的取舍有个参照。输入:压缩前平均写入 100 MB/s 的 JSON 应用日志,峰值写入 200 MB/s,消费量为写入量的 2 倍,retention 168 小时,分区 3000(含副本),RF=3,3 AZ,us-east-1,broker 数量按默认配额上限 30/集群。以 Standard broker 集群为例:
| 场景 | Standard 机型×台数 | Standard $/月 | Express 机型×台数 | Express $/月 |
| 基线:不压缩 · 保留 7 天全部在主存储 · 未开就近消费 | kafka.m7g.xlarge×24 |
52,851 | express.m7g.large×18 |
24,099 |
| ① 开启 zstd 压缩(实测压缩率 0.1464) | kafka.m7g.large×6 |
7,584(−85.6%) | express.m7g.large×3 |
3,637(−84.9%) |
| ① + ②A 保留期 7 天 → 2 天 | kafka.m7g.large×6 |
3,879(−92.7%) | express.m7g.large×3 |
3,019(−87.5%) |
| ① + ②A + ③ 开启就近消费 | kafka.m7g.large×6 |
2,877(−94.6%) | express.m7g.large×3 |
2,017(−91.6%) |
| ① + ②B 启用分层存储(primary 24h,保留期仍 7 天) | kafka.m7g.large×6 |
3,656(−93.1%) | 不支持分层存储 | — |
| ① + ②B + ③ 开启就近消费 | kafka.m7g.large×6 |
2,654(−95.0%) | 不支持分层存储 | — |
存储这一项有两条互替的路径:业务允许缩短保留期时走 ②A,保留 7 天是硬要求时走 ②B。分层存储是 Standard broker 独有的能力,Express 不支持,但 Express 的存储本身按逻辑数据量计一份,保留 7 天并开启压缩与就近消费时为 $2,635(−89.1%),与 Standard 走分层存储路径的 $2,654 基本持平。
基线中 24 台 broker 的数量不是由吞吐决定的,而是由 EBS 容量决定:保留 7 天、RF=3、EBS 目标利用率 50%,需要预置 100 MB/s × 168h × 3600 × 3 ÷ 1024² ÷ 0.5 = 346 TB,而 MSK 每 broker 的存储上限是 16384 GiB(配额文档,不可提额),346 ÷ 16 向上取到 AZ 数的倍数即 24 台。同一份数据在吞吐维度上只需要 18 台。这也解释了为什么②A 和②B 一旦把存储量降下来,台数立刻从 24 掉到 6。
关于这张表有四点需要说明,否则容易得出错误结论。
第一,压缩的收益要靠随后的容量调整才能更进一步节省成本,压缩开启能节省跨 AZ 流量费用 表中从 kafka.m7g.xlarge×24 降到 kafka.m7g.large×6,是压缩把数据量降下来之后重新做容量规划的结果。只改客户端压缩配置而不调整集群规格,只能节省跨 AZ 流量费用。
第二,各项优化不能把百分比相乘。 压缩后数据量下降,保留期和跨 AZ 的绝对节省额随之缩小。上表是用同一个成本模型分别计算各个终态得出的,不是把各项降幅连乘。
第三,基线是「完全不压缩」。 如果集群已经在用 snappy 或 lz4,实际起点接近第二行,可直接从第二行往下看。
第四,保留期从 7 天降到 2 天是业务决策,不是技术优化。 前提是消费者故障恢复窗口确实不需要 7 天。
二、第 1 章 MSK 的费用构成与优化优先级
MSK Provisioned 下分 Standard 和 Express 两种 broker 类型,各自的计费结构不同;MSK Serverless 是独立的 deployment option(MSK 定价)。以下是 us-east-1 的完整计费维度,usagetype 字符串可直接用于 Cost Explorer 过滤。
| 形态 | 计费项 | usagetype | 单价示例(us-east-1) | 计费口径 |
| Standard | Broker 实例小时 | USE1-Kafka.<机型> |
kafka.m7g.large $0.204/hr |
按秒计费,每 broker 独立 |
| Standard | EBS 主存储 | USE1-Kafka.Storage.GP2 |
$0.10/GB-月 | 按 provision 容量,不是实际用量 |
| Standard | 预置存储吞吐(可选) | USE1-Kafka.Throughput |
$0.08/MiBps-月 | 每 broker 预置的 MB/s |
| Standard | 分层存储容量 | USE1-Kafka.Storage.Tiered |
$0.06/GB-月 | 实际用量,逻辑数据量计一份 |
| Standard | 分层存储取回 | USE1-Kafka.DataRetrieval.Tiered |
$0.0015/GB | 每次 consumer 读取冷数据 |
| Express | Broker 实例小时 | USE1-Express.<机型> |
express.m7g.large $0.408/hr |
按秒计费,每 broker 独立 |
| Express | 存储 | USE1-Express.Storage |
$0.10/GB-月 | 逻辑数据量计一份,不乘 RF,无需预置 |
| Express | 数据写入 | USE1-Express.In-Bytes |
$0.010/GB | Standard 没有这一项,与保留时长无关 |
| Serverless | 集群小时 | USE1-KafkaServerless-ClusterHours |
$0.75/hr | 恒定,与流量无关 |
| Serverless | 分区小时 | USE1-KafkaServerless-PartitionHours |
$0.0015/partition-hr | 按分区数计费 |
| Serverless | 数据写入 / 读出 | USE1-KafkaServerless-In-Bytes / -Out-Bytes |
$0.10/GB / $0.05/GB | 写入单价是 Express data-in 的 10 倍 |
| Serverless | 存储 | USE1-KafkaServerless-StorageHours |
$0.10/GB-月 | 实际用量 |
单价示例只取每个维度的一个机型,完整逐机型价目见 MSK 定价页。其中需要注意的是:**Express broker 的小时单价是同规格 kafka.m7g 的 2 倍,
Standard 与 Express 在计费口径上的关键分歧不在单价表,而在两处:一是 Standard 的存储按预置容量计费而 Express 按实际逻辑用量计费;二是 Express 多一项与保留时长无关的 data-in 费。第 4、5 章会展开这两点的成本含义。
跨 AZ 数据传输费($0.02/GB,出入各 $0.01/GB)和 CloudWatch 自定义指标费不在 AmazonMSK product code 下。前者需要在 Cost Explorer 中查 AmazonEC2 服务下的区域内数据传输 usagetype;后者查 AmazonCloudWatch。只查看 AmazonMSK 会遗漏这两项,使优化优先级判断出现偏差。
MSK 官方明确集群内 broker 之间的副本同步(ISR)流量不收费。降低副本因子不会减少数据传输费用,Standard 集群降低 RF 只影响 EBS 预置容量和存储费。
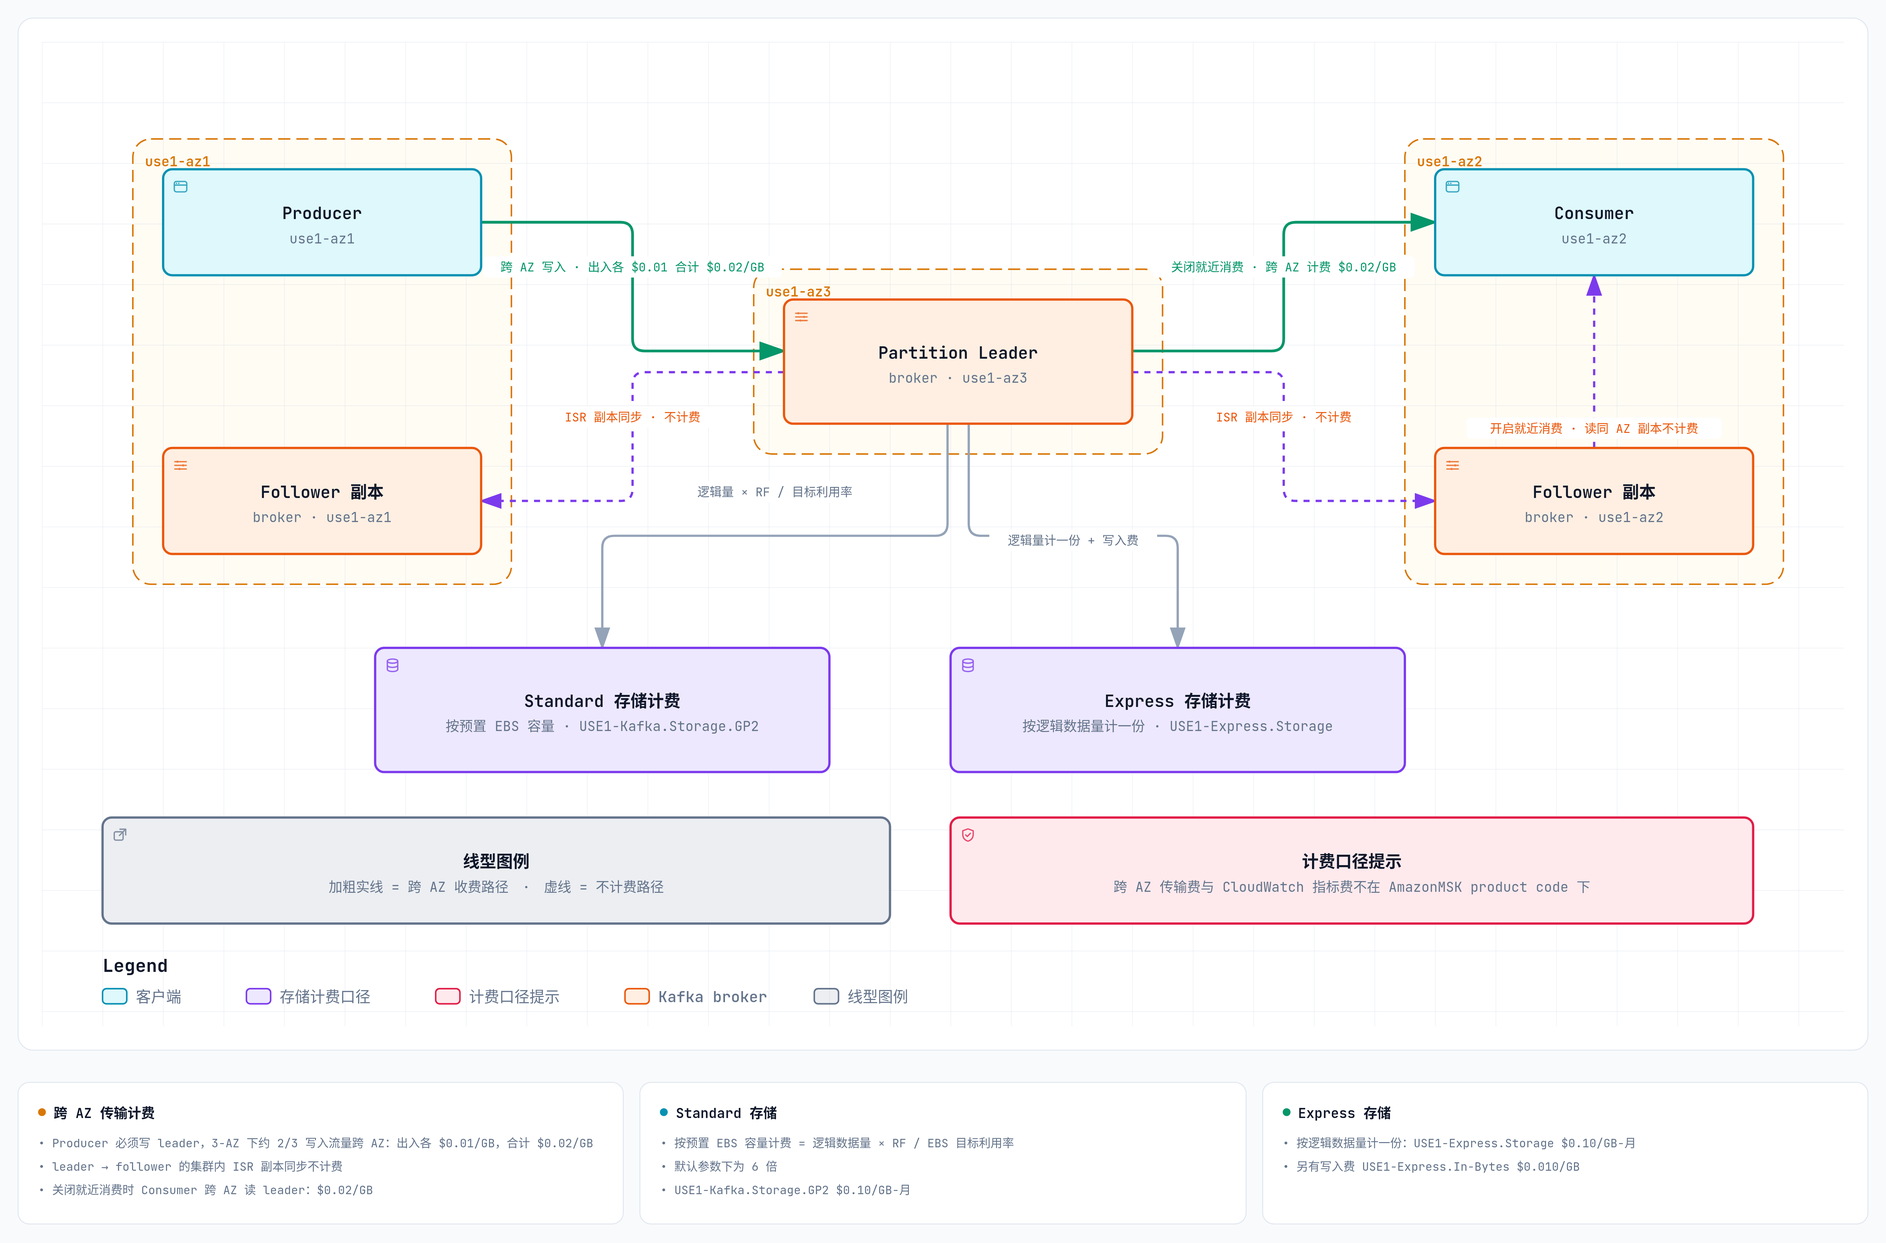
[图 1:加粗实线为跨 AZ 收费路径,虚线为不计费路径] |
集群内 ISR 副本同步不计费,Standard 与 Express 的存储计费口径差异标注在下方两个存储节点上
2.1 费用占比参考(测算)
下表来自 AWS 官方 MSK Sizing and Pricing 计算表 的模型,假设:us-east-1,RF=3,3-AZ,fan-out 2,注意机架感知消费已开启(也就是消费者不再有跨 AZ 费用),Standard EBS 目标利用率 50%,broker 数量上限 30。这是测算值,绝对金额取决于实际参数。
| 集群画像 | Broker 占比 | 存储占比 | Data-In 占比(仅 Express) | 跨 AZ 占比 | 月合计 |
| Standard,10 MB/s,24h 保留 | 51.3% | 29.1% | — | 19.6% | $1,742 |
| Express,10 MB/s,24h 保留 | 56.7% | 5.4% | 16.3% | 21.7% | $1,577 |
| Standard,100 MB/s,72h 保留 | 22.4% | 63.4% | — | 14.3% | $23,970 |
| Express,100 MB/s,72h 保留 | 38.6% | 18.2% | 18.5% | 24.7% | $13,881 |
| Standard,100 MB/s,720h 保留(见下方注) | 8.2% | 89.8% | — | 2.0% | $169,146 |
注:720h 保留一行的 EBS 预置容量需求为 1,518,750 GiB(单副本 247 TiB × RF3 ÷ 50% 利用率),按每 broker 上限 16384 GiB 计算,15 种 Standard 机型无一例外都需要 93 台,超过每集群 30 台的默认配额。该行金额按已申请提额计算(kafka.m7g.large×93)。
Standard 集群上保留期超过三天(72 小时)后,存储成为最大的单项费用:表中 100 MB/s、72 小时保留一行占 63.4%,保留 720 小时时升至 89.8%。Express 集群的存储被压低到两成以内,broker 费转为最大单项(表中两行分别为 56.7% 与 38.6%),跨 AZ 传输费占 21.7% 至 24.7%。只要关闭了机架感知消费且消费者数量较多,跨 AZ 传输会跃升为第一大项。
2.2 优化优先级与阅读顺序
| 当前最大费用项 | 优先阅读章节 |
| 存储费(EBS 或 Express storage) | 第 2 章(压缩)、第 4 章(保留策略) |
| 跨 AZ 传输费 | 第 3 章 |
| Broker 实例费 | 第 5 章 |
| CloudWatch 监控费 | 第 6 章 |
配置动作与验证方法
配置动作:在 Cost Explorer 按 AmazonMSK、AmazonEC2(区域内数据传输)、AmazonCloudWatch 三个产品码分别过滤,确认各费用项的实际占比及趋势。
验证方法:检查是否存在 USE1-Kafka.Throughput(预置存储吞吐)的非零用量,以及 CloudWatch 指标的月度费用是否与预期匹配。
适用边界:跨 AZ 传输费仅在 client 与 broker leader 不同 AZ 时产生,同 AZ 访问为 $0;集群内 broker 间复制不产生传输费。
三、第 2 章 消息压缩与生产端批处理
3.1 压缩的工作路径
压缩在 record batch 级别执行(Kafka producer 配置参考)。当 producer 端的 compression.type 与 topic 端一致(或 topic 设置为 producer),broker 原样落盘和复制,不执行解压或重压缩。这使得一次客户端配置变更同时作用于四段字节路径:produce 网络传输、存储(乘以 RF 数量)、broker 间副本复制、consumer 读取。MSK 的 topic 默认 compression.type=producer,无需额外修改 broker 或 topic 配置。压缩带来的字节减少对账单的影响是多维的:写入速率下降后,broker 台数需求也随之降低(吞吐上限按压缩后字节计算),因此压缩的收益不止体现在存储和传输费,也体现在 broker 实例费。要让账单真正下降,通常需要在压缩之后随之调低 broker 规格或减少 broker 数量。
3.2 各 payload 类型的实测压缩率
以下数据在 express.m7g.large × 3 集群上测得(batch.size=262144,linger.ms=100,acks=all,RF=3)。压缩率 = 单副本落盘字节 / 未压缩落盘字节。
| payload | 平均记录大小 | codec | 压缩率 |
| JSON 应用日志 | 630 B | zstd(默认 level 3) | 0.1464 |
| JSON 应用日志 | 630 B | gzip(默认 level) | 0.1608 |
| JSON 应用日志 | 630 B | lz4(默认 level 9) | 0.2731 |
| JSON 应用日志 | 630 B | snappy | 0.3054 |
| CSV 窄表指标 | 78 B | zstd | 0.2563 |
| JSON 订单文档 | 2409 B | zstd | 0.1063 |
| 高熵二进制(base64 随机数据) | 937 B | snappy | 1.0002 |
压缩率随消息变大单调改善:78 B 时 0.2563、630 B 时 0.1464、2409 B 时 0.1063。大消息中可压缩的结构冗余(重复键名、枚举值、嵌套格式)占比更高,因此在应用层将多条小消息合并成一条大消息,对压缩率的提升往往比切换 codec 更显著。对高熵二进制或已压缩内容,snappy 落盘字节比不压缩多 0.02%,gzip 吞吐下降明显而字节节省有限。这类 payload 应设 compression.type=none。
3.3 批处理参数是压缩率的决定因素
压缩在批次内执行,批次越大,压缩字典越有效。linger.ms=0(Kafka 3.x 默认)时批次无法充分填充,zstd 在等负载(8000 rec/s,630B JSON)下压缩率从 0.1507 劣化到 0.2391,多出 59.5% 的落盘字节。snappy 劣化 +24.1%,lz4 +32.5%,未压缩只变化 +0.5%。压缩算法越强对批次填充越敏感。
linger.ms 细扫结果(zstd,8000 rec/s,batch.size=262144):
| linger.ms | 落盘字节 | 已获可达收益比例 | p99 ms |
| 0 | 23,476,873 | 0%(基准) | 37 |
| 5 | 17,456,003 | 63% | 46 |
| 25 | 15,586,153 | 82% | 60 |
| 50 | 14,990,524 | 89% | 59 |
| 100 | 14,453,918 | 94% | 106 |
| 250 | 13,909,000 | 100% | 244 |
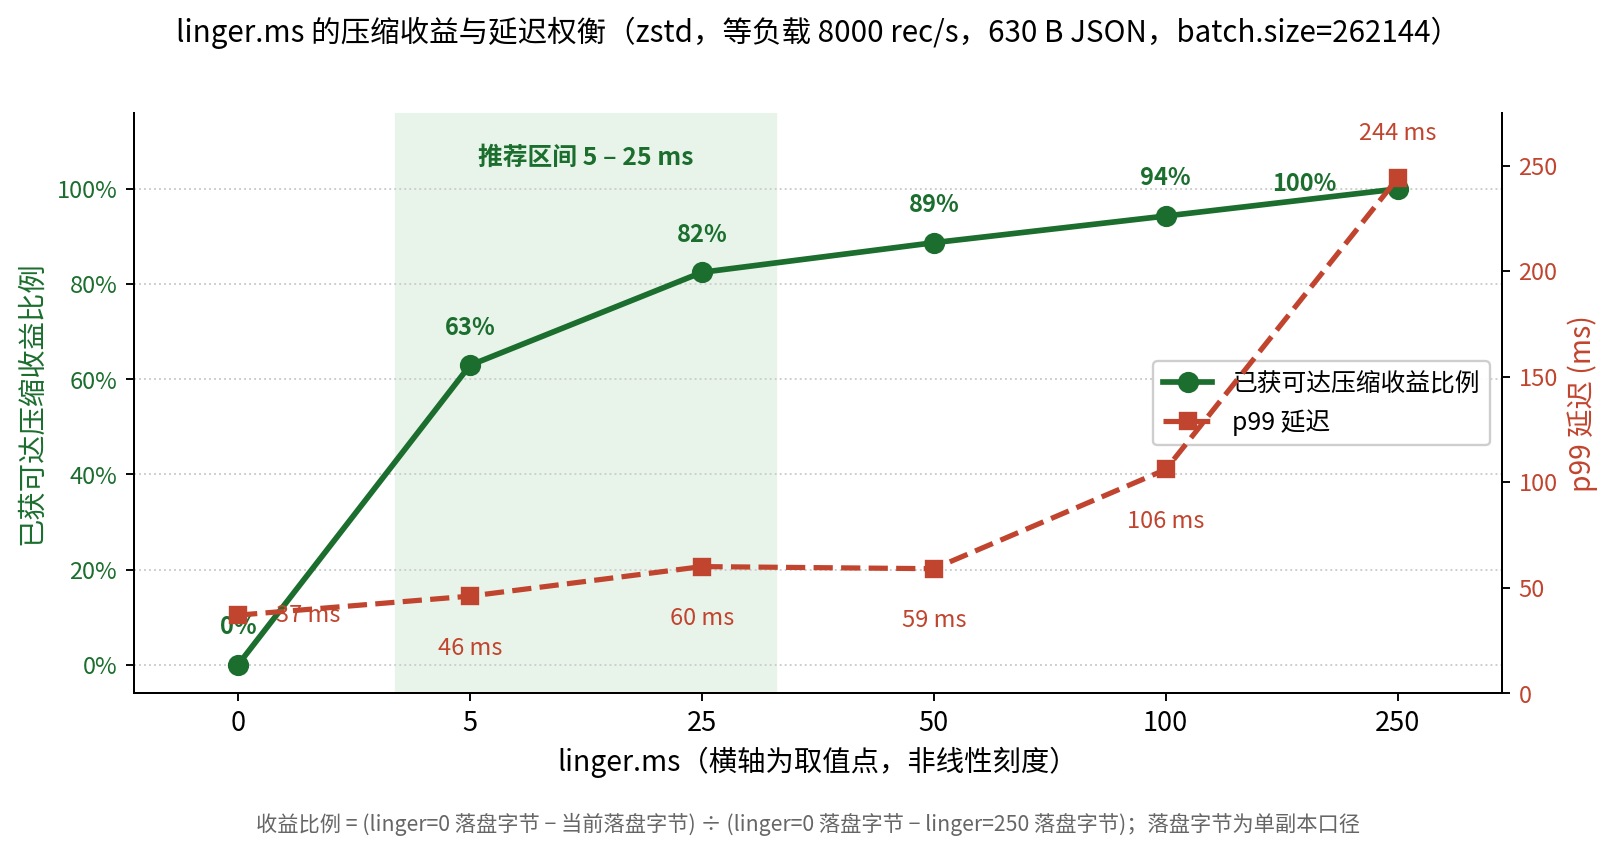
[图 2:收益曲线在 5–25 ms 区间迅速抬升后趋平,而 p99 延迟在 100 ms 之后急剧上升] |
linger.ms=5 以 +9 ms p99 获得 63% 的可达收益,linger.ms=25 获得 82%。超过 100 ms 主要消耗延迟预算而收益增量很小。Apache Kafka 4.0 将 linger.ms 默认值从 0 改为 5,正是基于这一权衡。值得注意的是,linger.ms 的 p99 代价约等于 linger 值本身:zstd 从 linger.ms=0 的 37 ms 到 linger.ms=100 的 106 ms,增量 69 ms 与 linger 设置接近。这个规律可以直接用于延迟预算的前置估算,决定可以接受多高的 linger 值。
满负载下 batch.size 影响(zstd,linger.ms=0,打满吞吐):
| batch.size | 落盘字节(相对 16KiB) | 吞吐 MB/s | p99 ms |
| 16,384(Kafka 默认) | 基准 | 20.83 | 2177 |
| 65,536 | −9.4% | 48.22 | 380 |
| 262,144 | −14.7% | 63.47 | 35 |
| 1,048,576 | −22.0% | 67.33 | 56 |
batch.size=262144(256 KiB)是 p99 的最优点,p99 从 2177 ms 降至 35 ms,吞吐提升 3 倍。继续增大到 1 MiB,落盘字节相对 256 KiB 只再少 8.7%(11,396,862 → 10,411,039 字节),而 p99 反升。
满负载与中等负载各有对应的调优旋钮:满负载下批次靠字节数就填满,linger.ms 几乎不影响压缩率,应调 batch.size;中等负载下批次填不满,linger.ms 是决定压缩率的主要参数。判断方法:看 producer 的 batch-size-avg 指标,若接近配置值则处于满负载区间,若远低于配置值则处于中等负载区间。
3.4 分区器对压缩率的决定性影响
null-key 的 producer 走 Kafka 默认的 uniform-sticky partitioner(KIP-794),它在攒满 batch.size 字节之前不会换分区,批次大小与分区数解耦。实测分区数从 1 扩到 90,zstd 压缩率仅从 0.1506 变动到 0.1520,linger.ms=0 的字节惩罚也基本维持在 +54% 至 +61%。
带 message key 的 producer 走 murmur2(key) % 分区数,每条记录散列到不同分区,批次被真正稀释。测试以 RoundRobinPartitioner 作为逐条散列行为的代理(真实 murmur2 在热点 key 上会重新聚集,实际稀释程度可能更温和):
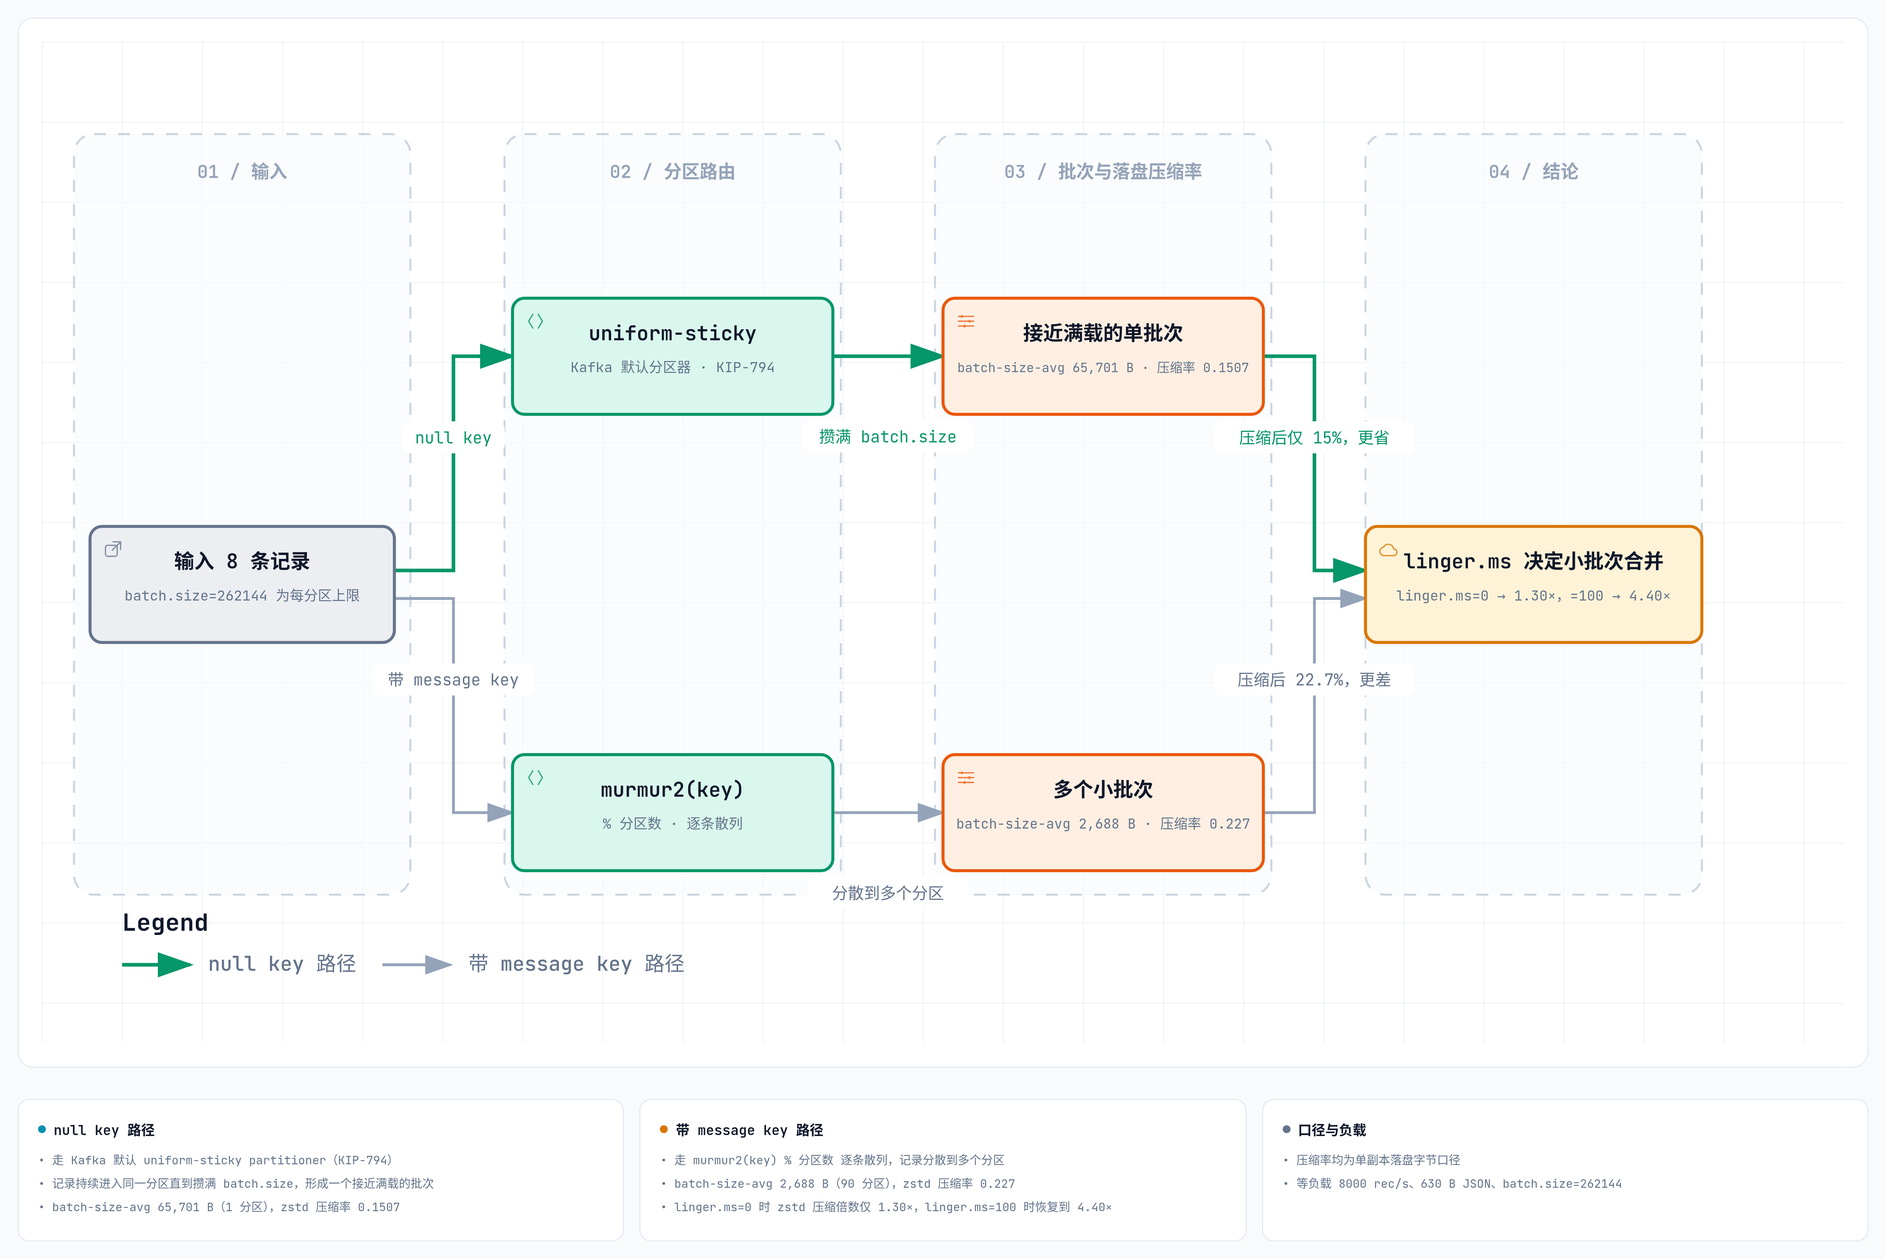
[图 3:同样 8 条记录] |
null key 走 uniform-sticky partitioner 汇成一个接近满载的批次,带 message key 则逐条散列成多个小批次,落盘压缩率随之从 0.1507 劣化到 0.227
| 分区数 | null-key(sticky)linger=0 字节惩罚 | keyed(round-robin 代理)linger=0 字节惩罚 | keyed zstd 压缩倍数 linger=0 | keyed zstd 压缩倍数 linger=100 |
| 1 | +60.8% | +60.7% | 4.13× | 6.64× |
| 6 | +61.1% | +113.8% | 2.90× | 6.20× |
| 30 | +58.1% | +221.4% | 1.71× | 5.50× |
| 90 | +54.1% | +239.9% | 1.30× | 4.40× |
关键在最后两列。带 key 的 producer 在 linger.ms=0 时,zstd 的压缩倍数随分区数从 4.13× 衰减到 1.30× —— 90 分区下等同于没有实质性压缩,而 producer 端的 CPU 开销照付。把 linger.ms 提到 100 ms 后,90 分区的压缩倍数恢复到 4.40×。对带 key 的高分区数 producer,只改 compression.type 而不配 linger.ms,存储费和 data-in 费几乎不会下降。
另一个可靠的自查方法:查看带 message key 的 producer 的 batch-size-avg 指标,它精确预测落盘压缩率。实测从 65,701 B(1 分区)降至 2,688 B(90 分区)时,压缩率就从 0.151 劣化到 0.227。batch-size-avg 远低于配置的 batch.size 值时,说明应增大 linger.ms 而不是 batch.size,因为批次的填充瓶颈不在 batch.size。
3.5 压缩层级配置
zstd: 保持默认 compression.zstd.level=3。提升到 level 6 每减少 1% 字节需付约 4 倍的吞吐损失;level 12 之后吞吐下降 84% 至 97%,字节收益极小。负 level(如 -5)压缩率反而劣化 +65.8% 字节,同时吞吐下降 22%,不应在 Kafka 场景使用。
compression.zstd.level 由 KIP-390 在 Kafka 3.8.0 引入,低版本客户端(如 3.7.2)静默丢弃该配置且不打任何警告,需确认客户端版本 ≥ 3.8.0 才能生效。
lz4: Kafka 源码(Lz4BlockOutputStream 构造函数,4.1.0 标签逐字)中,当且仅当 level == defaultLevel()(即 9)时调用 fastCompressor(),其余所有合法值(1 至 8、10 至 17)均调用 highCompressor(level)(LZ4_HC)。LZ4_HC 即使在最弱档(level 1)也优于 LZ4 fast。实测 compression.lz4.level=1 落盘字节比默认少 13.1%,吞吐几乎不变(50.62 vs 50.84 MB/s)。使用 lz4 时应显式设置 compression.lz4.level=1。LZ4_HC 的第 9 档在 Kafka 中不可达(被 fast 分支占用),若需要 HC 的默认压缩强度应设 8 或 10。
gzip: 默认值 -1 等同于 level 6(实测两次独立运行字节差仅 0.002%)。
compression-rate-avg 的局限: 该客户端指标按批次等权平均,而落盘字节按字节求和,多分区场景下偏差可达 +15%(偏向低估压缩效果)。成本核算只能以 kafka-log-dirs.sh 得到的实际落盘字节为准。
两个验证指标的读取方式。 kafka-log-dirs.sh 汇总的是全部副本的字节数,除以 RF 才是与成本口径一致的单副本落盘量:
batch-size-avg 取自 producer 自身的指标:应用侧读 KafkaProducer.metrics(),或采集 JMX MBean kafka.producer:type=producer-metrics,client-id=<客户端 id>;用 kafka-producer-perf-test.sh 压测时加 --print-metrics,输出中的 producer-metrics:batch-size-avg 行即为该值。
配置动作与验证方法
配置动作:生产端配置 compression.type=zstd、batch.size=262144、linger.ms=25(低延迟场景设 5,带 key 且分区数 ≥30 设 50~100),并按 batch.size × 分区数 × 2 调整 buffer.memory。使用 lz4 时显式设置 compression.lz4.level=1。
验证方法:通过 batch-size-avg 确认批次充分填充;通过变更前后 kafka-log-dirs.sh 输出的落盘字节差异确认压缩收益。不要用 CloudWatch 的 BytesInPerSec 验证批处理调优,该指标是 1 分钟指数加权移动平均,恒定负载下需约 5 分钟收敛,对短时测试会严重低报。
适用边界:已压缩或高熵二进制 payload 不适用压缩;compression.zstd.level 需要客户端版本 ≥ 3.8.0。
四、第 3 章 跨 AZ 流量与机架感知消费
4.1 各类流量的收费情况
| 流量类型 | 是否收费 | 备注 |
| Producer → partition leader(跨 AZ) | 是 | leader 必须写,不可规避 |
| Broker 间副本同步(ISR) | 否 | MSK 官方明确免费 |
| Consumer → broker leader(就近消费关闭,跨 AZ) | 是 | 3-AZ 部署下约 2/3 消费流量跨 AZ |
| Consumer → 同 AZ follower(就近消费开启) | 否 | 同 AZ 传输 $0 |
AWS 对同区域跨 AZ 数据传输的计费口径是「每个方向各 $0.01/GB」(EC2 定价)。这里的两个方向指的是同一批字节从源 AZ 流出、再流入目标 AZ,两次各计一次,合计 $0.02/GB —— 不是请求与响应各计一次。因此单向的大流量同样按 $0.02/GB 计算。
生产侧跨 AZ 流量来自 producer 必须写 leader,3-AZ 部署下约 2/3 的写入流量跨 AZ,与机架感知设置无关,无法通过消费侧配置消除。这一约束在设计阶段就需要纳入成本模型:将写入速率乘以 2/3 再乘以 $0.02/GB,即是每月无法规避的生产侧跨 AZ 基础成本。消费侧跨 AZ 流量则完全可以消除,是本章的优化目标。fan-out(消费组数量)越高,消费侧流量占总跨 AZ 流量的比例越大,开启机架感知消费的绝对收益也越高。
4.2 Express 默认不开启就近消费
本测试集群集群(未应用过任何 cluster configuration)的 broker 配置显示:
synonyms={} 为空意味着 MSK 未在任何位置设置该属性,Kafka 走内置默认(LeaderSelector,所有 Fetch 请求打向 leader)。仅在消费端设置 client.rack 而 broker 端没有 replica.selector.class 时,行为没有任何变化,变更前的 Fetch 目标统计确认了这一点:2/3 的分区跨 AZ 读 leader。
4.3 开启步骤
最小配置文件(只包含这一行,避免与 Express 只读属性冲突):
消费端需要同时配置:
4.4 client.rack 必须使用 AZ ID
MSK 给每个 broker 打的 broker.rack 是 AZ ID(如 use1-az2),而不是 AZ 名称(如 us-east-1a),官方客户端最佳实践中对此有明确说明(Kafka 客户端最佳实践)。RackAwareReplicaSelector 执行精确字符串比较,填入 AZ 名称时静默失效,行为回退到读 leader,不产生任何报错。
AZ 名称到 AZ ID 的映射因 AWS 账号不同而不同,必须在运行时动态获取,不能硬编码:
EKS 上对应节点标签为 topology.k8s.aws/zone-id(AZ ID)。常用的 topology.kubernetes.io/zone 标签是 AZ 名称,不能用于 client.rack。
4.5 实测效果与运维成本
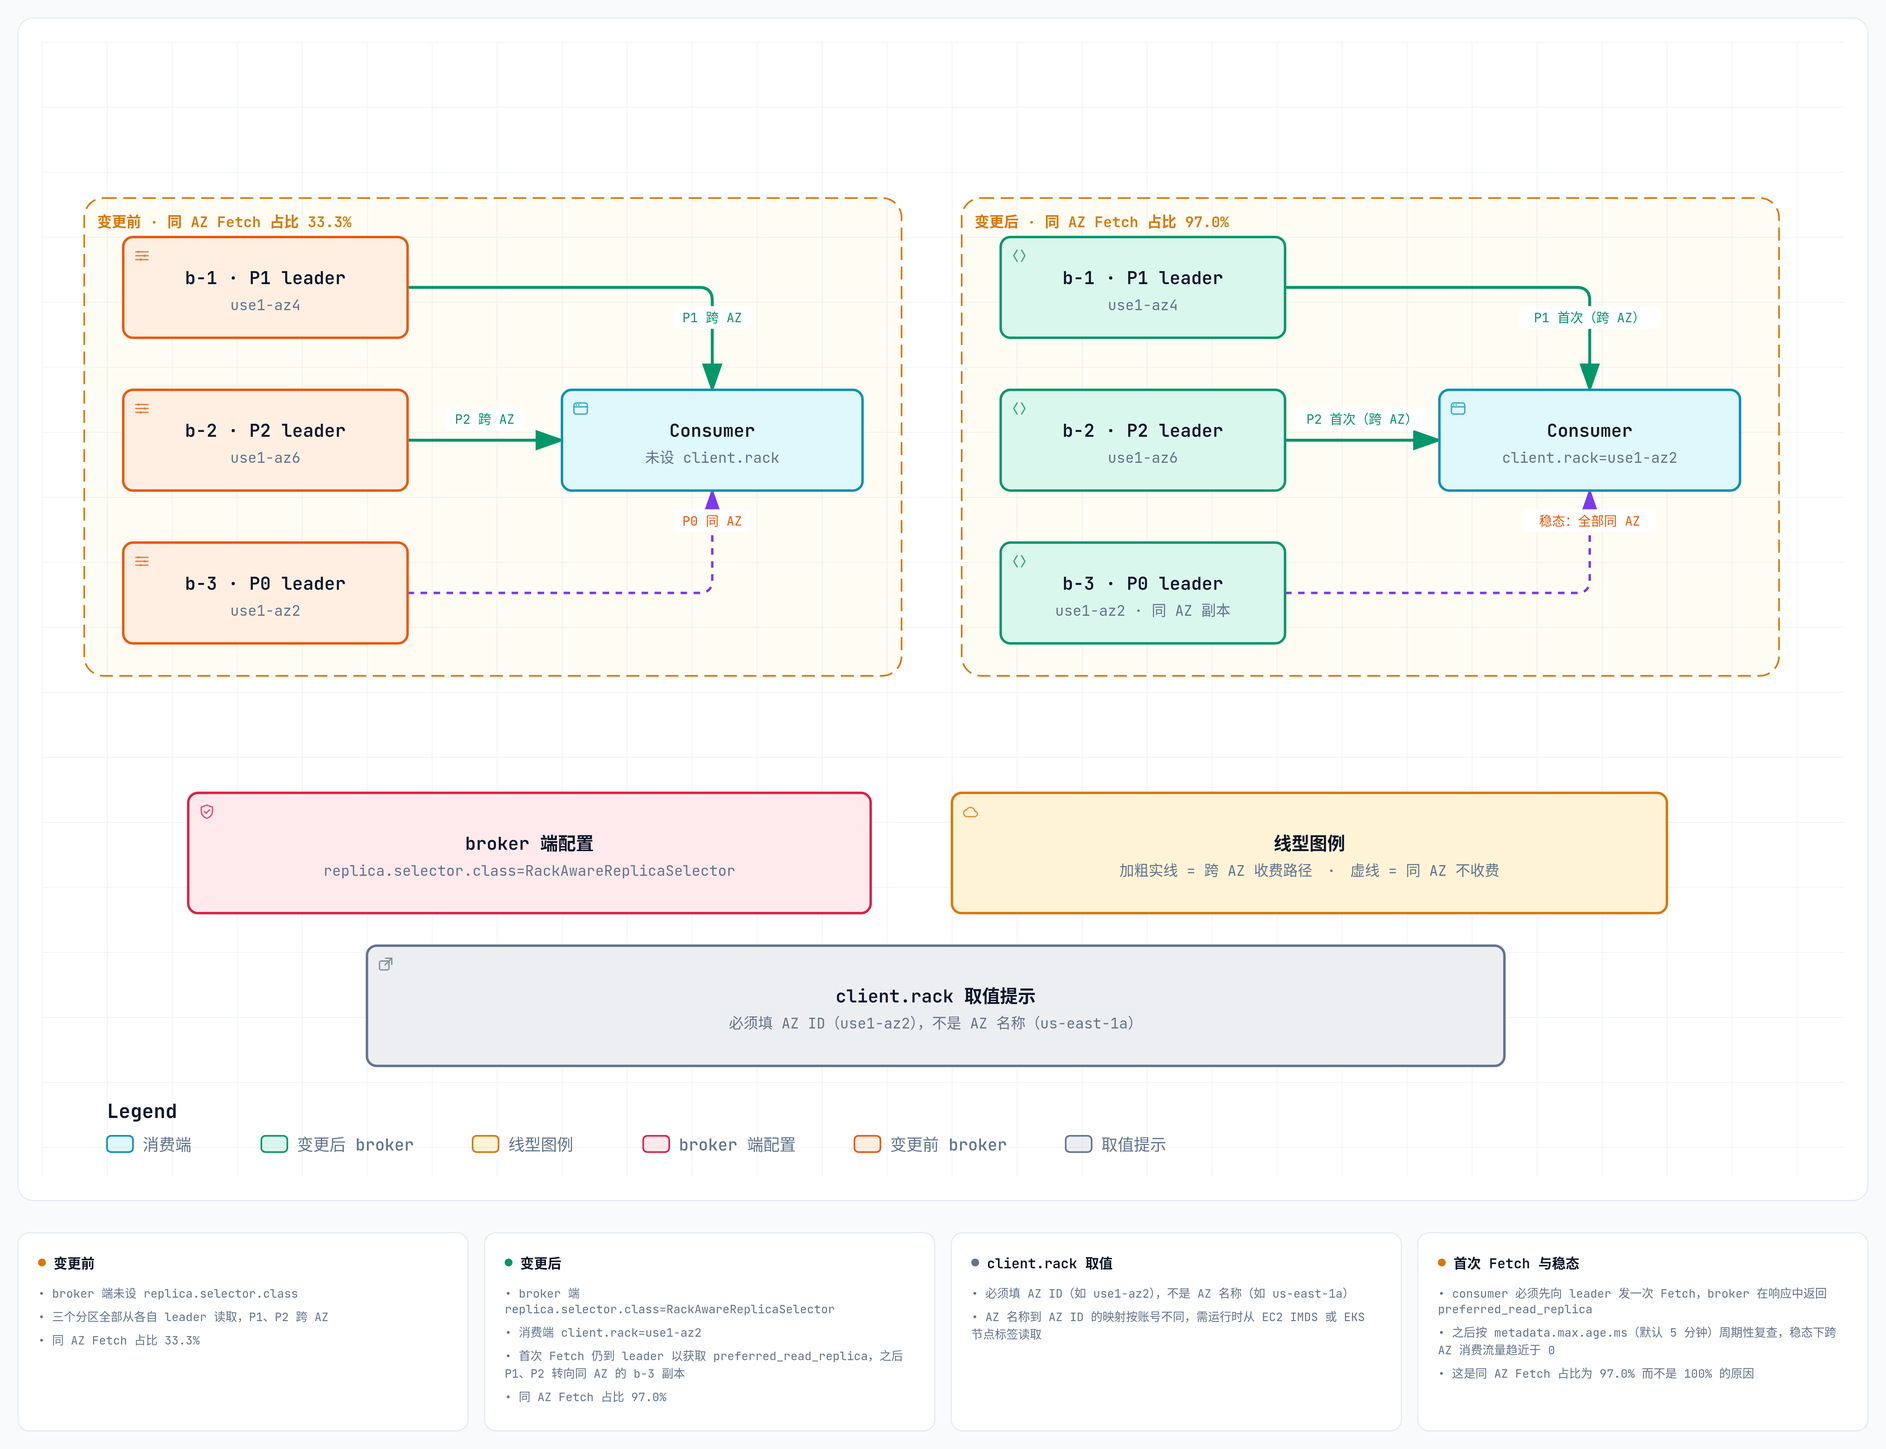
[图 4:变更前三个分区各自读 leader,其中两个跨 AZ;变更后仅首次 Fetch 到 leader 获取 preferred_read_replica,稳态全部转向同 AZ 副本] |
配置生效后,同 AZ Fetch 占比从 33.3% 提升至 97.0%。变更前的 33.3% 等于 3-AZ 下的理论值 1/3,即只有 leader 恰好同 AZ 的那部分分区不跨 AZ。剩余的 3% 是 KIP-392 的固有机制:consumer 必须先向 leader 发一次 Fetch 请求,broker 在响应中返回 preferred_read_replica,consumer 之后按 metadata.max.age.ms(默认 5 分钟)周期性复查。稳态下跨 AZ 消费流量趋近于 0,但不是严格的 0。
replica.selector.class 是静态配置,修改需要一次滚动重启。实测 3 台 express.m7g.large 耗时 48 分钟,大规格或更多 broker 的集群需要相应延长排期窗口。
Express 集群配置生效后,describe-cluster 和 describe-cluster-v2 的 ConfigurationInfo 字段仍返回 null(已实测确认)。任何基于控制面 API 做配置漂移检测的自动化在 Express 上会静默失效。验证配置是否生效应通过 broker 侧:
配置动作与验证方法
配置动作:创建只含 replica.selector.class=org.apache.kafka.common.replica.RackAwareReplicaSelector 的 cluster configuration 并应用,同步更新所有消费端配置,在运行时从 IMDS 或 EKS 节点标签读取 AZ ID 并设置 client.rack。
验证方法:启用消费端 TRACE 级日志(log4j.logger.org.apache.kafka.clients.consumer.internals=TRACE),确认出现 Updating preferred read replica 日志;通过 Cost Explorer 观察跨 AZ 传输费在变更后数天内的趋势变化。
适用边界:生产侧跨 AZ 写入与此配置无关;进行中的消费会有约 1 次额外的跨 AZ Fetch 请求用于协商 preferred replica,之后转为同 AZ 读取。
五、第 4 章 数据保留策略与存储形态
5.1 存储计费的结构差异
Standard 按预置 EBS 容量计费,有效存储量 = 逻辑数据量 × RF ÷ EBS 目标利用率,默认参数(RF=3,利用率 50%)下倍数为 6。Express 只对逻辑数据量计费一次,不乘副本数,也无需预留磁盘余量,有效存储单价是 Standard 的 1/6。这两种模式的差异在保留期较短时不那么突出(data-in 费摊销后 Express 的优势减少),在保留期较长时差异显著放大。从 AWS 官方定价页的算例可以验证:存入 1 TB 逻辑数据,Express 账单为 1,000 GB-月,与副本数无关。
保留时长与写入速率直接相乘决定存储费用。下表基于 AWS 官方 MSK Sizing and Pricing 计算表(价格已通过 Price List API 验证),适用 RF=3、EBS 目标利用率 50%,Express 列含 data-in 费(与保留时长无关)。这是测算值,实际费用请代入自身参数计算。
| 压缩后平均写入 | 2 天 Standard | 2 天 Express | 7 天 Standard | 7 天 Express | 30 天 Standard | 30 天 Express | 30 天 Standard(分层,EBS 保留 1 天) |
| 1 MB/s | $101 | $43 | $354 | $85 | $1,519 | $279 | $202 |
| 10 MB/s | $1,012 | $425 | $3,544 | $847 | $15,188 | $2,788 | $2,025 |
| 100 MB/s | $10,125 | $4,254 | $35,438 | $8,473 | $151,875 | $27,879 | $20,250 |
5.2 保留期的合理设定
MSK 默认 log.retention.hours=168(7 天),实测集群的 topic 级 retention.ms=604800000 已确认为 7 天。大多数业务的 7 天保留期是从未被修改过的默认值,而不是经过需求评估的配置。从保留期与存储成本的关系来看,Standard 上保留期每增加一天,EBS 费用等比例增长;Express 上存储费同样线性增长,但 data-in 是一次性摊销,保留期越长,data-in 占 Express 总存储成本的比例越低。
设定保留期前应做三项检查:
第一,查看 MaxOffsetLag 和 EstimatedMaxTimeLag 的历史峰值。保留期覆盖峰值 lag 的若干倍即可满足消费者故障恢复需求,不需要覆盖极端情况假设。
第二,检查是否有消费组实际读取过较早的数据。如果没有任何消费组的消费位点回溯超过 48 小时,7 天保留期是纯粹的存储浪费。
第三,按 topic 设置 retention.ms,不用集群级 log.retention.hours 统一切。topic 级修改立即生效,无需重启集群。
各业务形态的参考保留期:
| 业务形态 | 保留期的真实约束 | 建议起点 |
| 实时 ETL / CDC 入湖(下游有落地存储) | 消费者故障恢复窗口 | 1 至 2 天 |
| 事件驱动微服务 | 下游服务最长不可用时长 | 2 至 3 天 |
| 多消费组分析管道,偶发重放 | 最长回溯需求 | 3 至 7 天 |
| 事件溯源 / 审计 / 合规 | 法规要求 | 分层存储(Standard)或落 S3 |
| 机器学习特征回放 | 训练窗口 | 落 S3,Kafka 只留 1 至 2 天 |
5.3 分层存储(仅 Standard)
分层存储(文档)远端层单价 $0.06/GB-月,低于 EBS 的 $0.10/GB-月,且远端层只计逻辑数据量一次,不乘 RF、不需预置。对保留期超过一周以上的场景,存储费节省显著。
启用前需要评估三项代价:
第一,写入配额下降。启用分层存储后 Standard 每 broker 的写入性能有所下降。如果当前 broker 数量正好满足吞吐需求,启用后可能需要增加 1 至 2 台 broker,这部分成本应纳入收益计算。
第二,取回费。$0.0015/GB 在每次 consumer 读取冷数据时产生。按本文的 ×6 存储倍数,EBS 有效单价为 $0.60/逻辑 GB-月、远端层为 $0.06/逻辑 GB-月,每 GB 每月省下 $0.54;$0.54 ÷ $0.0015 = 每月完整重放 360 次才会抵消这份节省,常规场景可忽略。
第三,不可回退。集群级启用后无法关闭;topic 级关闭后不可重新启用,且关闭会删除远端数据。
Express 不支持也不需要分层存储。
5.4 日志压缩
cleanup.policy=compact 只保留每个 key 的最新值,适用于 keyed changelog、CDC 快照、配置分发、设备最新状态等 topic。收益完全取决于 key 复用率,key 唯一(事件流型 topic)时收益为零,应在启用前审计目标 topic 的 key 分布。日志压缩与分层存储不能同时使用,且启用后 topic 语义发生变化,依赖读取历史版本的消费者会受影响。
5.5 EBS 目标利用率与自动扩容
Standard 集群的 EBS 按预置容量计费,MSK 不支持缩小存储。将 EBS 目标利用率从 50% 提升到 70%,预置容量随之下降,存储费减少 28.6%、总账单减少 18.1%(测算值:100 MB/s、72 小时保留场景下存储费 $15,188 → $10,848,月合计 $23,970 → $19,631);前提是同时配置存储自动扩容,并在 KafkaDataLogsDiskUsed 达到 70% 时触发告警(分层存储集群建议 60%)。自动扩容的冷却期为 6 小时,对突发写入需要预留足够的起始余量以避免磁盘告警连续触发。
配置动作与验证方法
配置动作:使用 kafka-configs.sh --alter --add-config retention.ms=<ms>,segment.ms=<ms> 按 topic 调整保留期,低吞吐 topic 需同步缩小 segment.ms(否则 log segment 不 roll,保留期实际不生效)。
验证方法:Express 集群修改 retention.ms 后观察 StorageUsed 指标(需用 Sum 统计,见第 6 章)的下降;Standard 集群降低保留期不会自动减少已预置的 EBS 账单,节省体现在未来的自动扩容速度降低以及 Express 的实时计费减少。
适用边界:分层存储不可用于 Express;日志压缩不可用于分层存储的 topic;Standard 集群 EBS 一旦扩容无法缩小,保留期的价值主要体现在新建集群时的容量规划以及 Express 的即时存储计费。
六、第 5 章 Broker 类型选择与容量规划
Standard 与 Express 的三项结构性计费差异
两种 broker 类型的能力差异见 broker 类型对比文档,成本上的差异集中在以下三点。
第一,broker 单价。 Express broker 单价恰好是同规格 kafka.m7g 的 2.00 倍,7 个规格无例外(large $0.408 vs $0.204,16xlarge $13.056 vs $6.528)。同等吞吐需求下,Express 因每 broker 吞吐更高而通常需要更少的 broker,但最终成本取决于分区数、保留期等因素,而非吞吐单一维度。
第二,存储计费口径。 Express 按逻辑数据量计费一次,Standard 按预置 EBS 容量(逻辑量 × RF ÷ 利用率)计费。AWS 官方算例:存入 1 TB 逻辑数据,Express 账单为 1,000 GB-月,Standard(RF=3)则需要 provision 约 3 倍容量再加磁盘余量。
第三,data-in 费用。 Express 有 $0.010/GB 的 USE1-Express.In-Bytes 费用,Standard 没有。这笔费用与保留时长无关,而存储费与保留时长成正比。保留时长越长,Express 的存储节省越能覆盖 data-in 的固定成本。
6.1 选型判断方法
我们下面选择更多是在常规数据吞吐下根据成本做的选择说明,但如果是从运维和性能(Express Broker 是大机型上有更好的性能,最高相比标准有 3 倍性能提升)多方面考虑,Express Broker 无需管理存储,分区自动 Rebalance 且因为存算分离,Rebalance 速度极快,因此建议首先选择 Express Broker.
将各自的存储费与 data-in 费代入公式比较。以每 MB/s 压缩后平均写入为单位, 以下只是参考,可以通过 AWS 官方 MSK Sizing and Pricing 计算表 来计算详细的费用信息
RF / EBS 目标利用率 是 Standard 相对 Express 的存储倍数,默认参数下为 6。两处 ÷ 1024 与本文各表同源(按 GiB 折算),代入 1 MB/s、保留 168 小时可复现第 4 章存储费表的 1 MB/s 行:Standard $354、Express $85。Express 的 data-in 费与保留时长无关,因此保留时长越长,Express 的存储优势越能覆盖这项固定支出。
对已经在运行 Express 集群的场景,直接从 Cost Explorer 读取 USE1-Express.Storage 与 USE1-Express.In-Bytes 的实际用量,比用写入速率推算更准确。最终对比还需加上 broker 台数差异带来的实例费用差额,因此结论取决于具体集群的保留期、写入速率和分区分布,应逐集群计算。
以下四个维度可以指导初步判断:
| 维度 | 倾向 Standard | 倾向 Express |
| 保留时长 | 极短(数小时)或极长(需分层存储) | 数天至数十天的中等保留期 |
| 平均写入吞吐 | < 约 5 MB/s(最小集群规模的固定成本差额) | > 5 MB/s |
| 可用性与弹性需求 | 需要 RF=2、2-AZ 或分层存储 | 接受强制 3-AZ + RF=3 |
Express 的主要约束
Express 强制 3-AZ 部署和 RF=3,没有 RF=2 或单/双 AZ 部署选项。只支持 m7g 实例族。支持 Kafka 版本 3.6、3.8、3.9、4.2(Kafka 4.2 从 2026-07-15 起仅 Express 可用)。不支持分层存储、预置存储吞吐(USE1-Kafka.Throughput)和存储自动扩容。
log.message.timestamp.before.max.ms 和 log.message.timestamp.after.max.ms 默认均为 86400000 ms(24 小时),时间戳偏离超过 24 小时的消息会被拒绝,历史数据回灌场景需特别注意。num.io.threads 和 num.network.threads 等属性在 Express 上是只读的,由 MSK 自动管理(完整只读属性清单见 Express 只读配置文档)。
6.2 Express 各规格吞吐与分区配额
来源:MSK 配额文档
| 规格 | 持续 ingress (MBps) | 最大 ingress (MBps) | 持续 egress (MBps) | 推荐分区数/broker | 最大分区数/broker |
| express.m7g.large | 15.6 | 23.4 | 31.2 | 1,000 | 1,500 |
| express.m7g.xlarge | 31.2 | 46.8 | 62.5 | 1,000 | 2,000 |
| express.m7g.2xlarge | 62.5 | 93.7 | 125.0 | 2,500 | 4,000 |
| express.m7g.4xlarge | 124.9 | 187.5 | 249.8 | 6,000 | 8,000 |
| express.m7g.8xlarge | 250 | 375 | 500 | 12,000 | 16,000 |
| express.m7g.12xlarge | 375 | 562.5 | 750 | 16,000 | 24,000 |
| express.m7g.16xlarge | 500 | 750 | 1,000 | 20,000 | 32,000 |
egress 是 ingress 的 2.0 倍(表中 6 个规格精确成立,express.m7g.xlarge 因文档取整显示为 2.0032,未取整值 31.248 → 62.496 同为 2.0)。Recommended 列是不强制执行的最佳实践建议;Maximum 列是硬上限,超过后会阻止缩减 broker 规格等运维操作。进行容量规划时,分区数应参照 Recommended 列而非 Maximum 列,因为 Recommended 对应的是在全量分区上均匀发送流量的场景;如果实际流量分布严重不均,有效上限更低。
6.3 容量规划:优先调整分区然后看 Broker
同一份写入负载由 1 个分区还是 6 个分区承载,延迟表现差异极大。实测把 25 MB/s 打到单分区 topic 时 p99 达到 6749 ms 且队列持续增长;同样的负载摊到 6 个分区后完全达标,p99 仅 39 ms,此时每台 broker 只承担约 8.4 MB/s,CPU 利用率 22%,request handler 99% 空闲。瓶颈来自单个 leader replica 的串行 append 路径,与 broker 级的 CPU 或线程资源无关,因此增大 broker 规格无法改善单分区的吞吐。
官方文档给出 Express 的 per-partition 最大值为 15 MB/s(硬上限,来自 MSK 配额文档)。容量规划应以该数值为上界并留出余量:高写入速率的 topic 通过增加分区数分摊负载,而不是让单个分区接近上限。分区数的规划同时受每 broker 分区上限约束,也直接影响 CloudWatch 指标费用(PER_TOPIC_PER_PARTITION 档位下指标数随分区数线性增长)。
6.4 CPU 利用率与规格调整
AWS 官方建议将 CpuUser + CpuSystem 维持在 60% 以下(最佳实践文档)。这两项指标在 PER_BROKER 付费档位下才能观测。峰值长期远低于 60% 时,可以考虑降规格或减少 broker 数量。需要注意的是,AWS 官方只给出了”不超过 60%”的上限目标,并没有发布”低于多少可以缩容”的下限值,缩容前应先在测试集群验证降一档规格后 CPU 峰值仍然低于 60%。
降规格通过 aws kafka update-broker-type 原地 rolling 完成,无业务中断,约 10 至 15 分钟每 broker。kafka.m5.* 迁 kafka.m7g.* 单价下降约 2.9%,结合 Graviton3 的吞吐提升,有机会进一步降低规格档位。Standard 上 kafka.m5 至 kafka.m7g 的迁移条件:Kafka 版本 ≥ 2.8.2 或 ≥ 3.3.2;Express 本身已是 Graviton3,无此迁移路径。
2024-05 起 aws kafka update-broker-count 支持缩减 broker 数量,无需新建集群。缩减前需先通过 kafka-reassign-partitions.sh 或 Cruise Control 将待删除 broker 的分区迁走,确认 UserPartitionExists 持续 5 分钟为 0 后再执行。目标 broker 数必须是 AZ 数的整数倍,且仅支持 M5/M7g 系列。
服务配额(均可申请提额):每集群 broker 上限 30,每 KRaft 集群 60,每账号 90,超过默认配额时需提前申请。
broker 类型迁移前检查清单
- 代入自身的压缩后写入速率和保留期,用公式计算 Standard 与 Express 的存储及 data-in 总成本后再做决策
- Express 不支持分层存储,若业务有超长保留期需求应继续使用 Standard
- Express 上
log.message.timestamp.before/after.max.ms=86400000,有历史数据回灌需求时先验证时间戳范围 - 确认所有消费端已配置正确的 AZ ID 作为
client.rack - Standard → Express 必须新建集群后迁移数据,无法通过 API 直接转换
配置动作与验证方法
配置动作:aws kafka update-broker-type 降规格;aws kafka update-broker-count 缩减 broker 数量(需先完成分区迁移);Standard → Express 迁移需新建目标集群。
验证方法:变更后进入 7 天的验证观测窗口,持续观测 CpuUser + CpuSystem(PER_BROKER 级;每个数据点用 Average 统计,取窗口内最高的那个数据点作为峰值),确认峰值低于 60%;通过 ProduceThrottleByteRate(取 Maximum)确认线上吞吐未持续接近 per-broker 持续值。
适用边界:update-broker-type 跨系列降级(如 m7g → t3.small)不被支持;分区数超过目标规格的上限时 API 调用会被拒绝,需先完成分区数治理。
七、第 6 章 监控成本
7.1 CloudWatch 监控档位与指标规模
首先写到前面的是 MSK 支持讲指标信息接入到自己的 Prometheus 监控体系,默认暴露 Prometheus 的 Node 和 JVM 的 Metric 端口,可以直接采集数据,这个是不收取任何费用的。
MSK 在 CloudWatch 提供四个监控档位(各档位包含的指标见 监控指标文档),DEFAULT 级免费,其余三档按 CloudWatch 自定义指标收费:首 10,000 条 $0.30/metric/月,10,001 至 250,000 条 $0.10,250,001 至 1,000,000 条 $0.05,超过 1,000,000 条 $0.02。
对实测集群(3 broker,6 topic,3 消费组,PER_TOPIC_PER_PARTITION 档位)执行 aws cloudwatch list-metrics --namespace AWS/Kafka,结果为 288 条(metric name × dimension 组合),64 个唯一 metric 名称。以下是各维度组合的缩放因子:
| 维度组合 | 唯一指标数 | 缩放因子 |
Broker ID + Cluster Name |
51 | × broker 数 |
Broker ID + Cluster Name + Topic |
3(BytesInPerSec / BytesOutPerSec / MessagesInPerSec) |
× topic 数 × broker 数 |
Cluster Name + Consumer Group + Topic |
4 | × 消费组数 × topic 数 |
Cluster Name + Consumer Group + Partition + Topic |
3(EstimatedTimeLag / OffsetLag / RollingEstimatedTimeLag) |
× 消费组数 × topic 数 × 分区数 |
Cluster Name |
7 | 固定 |
消费组 × topic × 分区数的三重乘积是指标规模爆炸的主要来源。实际条数低于上述系数估算(不是每个 topic 的所有分区都分布在所有 broker 上),上述估算结果为保守上界。一个典型的增长路径是:集群初建时 topic 少、分区少,监控成本不明显;随着业务扩展,topic 数量和消费组数量增长,PER_TOPIC_PER_PARTITION 档位的费用会按三个因子的乘积放大,最终超过 broker 本身的费用。两个可控的增长项:一是档位本身,只对确实需要分区级消费延迟监控的关键 topic 保留 PER_TOPIC_PER_PARTITION;二是消费组数量,定期清理无活跃消费者的消费组 —— 它是三重乘积中最容易被忽视的一项。
以中型集群(6 broker,100 topic,30 分区,5 消费组)为例(估算上界):
| 档位 | 估算指标条数 | 估算月费 |
| DEFAULT | 127 | 免费 |
| PER_BROKER | 313 | $94 |
| PER_TOPIC_PER_BROKER | 2,113 | $634 |
| PER_TOPIC_PER_PARTITION | 49,113 | $6,911 |
表中三档月费按各档位的全部指标条数计价,未扣除 DEFAULT 档免费的 127 条,因此都是上界。以该算例为例,PER_TOPIC_PER_PARTITION 与 PER_BROKER 之间的月度费用差约 $6,817。这个差额说明档位选择在大集群上是一项需要明确决策的成本项,而不是可以忽略的默认配置。绝对金额取决于集群的 topic 数、分区数和消费组数。
7.2 按需定档,而不是一律降档
监控档位不存在统一的最优值,取决于团队实际需要的可观测性粒度。下表是各档位相对上一档新增的观测能力,以及降档会失去什么:
| 档位 | 相对上一档新增的能力 | 降到上一档会失去 | 指标规模随什么增长 |
| DEFAULT | 集群与消费组汇总级基础指标 | — | broker 数(7 项集群级 + 每 broker 20 项) |
| PER_BROKER | 每 broker 的 CPU、内存、网络、请求处理与限流指标(CpuUser、CpuSystem、RequestHandlerAvgIdlePercent、ProduceThrottleByteRate 等 51 项) |
容量规划与规格调整的判断依据,第 5 章的做法将无法执行 | broker 数 |
| PER_TOPIC_PER_BROKER | 每 topic 每 broker 的 BytesInPerSec、BytesOutPerSec、MessagesInPerSec |
定位热点 topic、按 topic 拆分流量的能力 | topic 数 × broker 数 |
| PER_TOPIC_PER_PARTITION | 分区级消费延迟 OffsetLag、EstimatedTimeLag、RollingEstimatedTimeLag |
分区级消费延迟监控,只能看到按 topic 聚合的消费组延迟 | 消费组数 × topic 数 × 分区数 |
实际取舍建议:PER_BROKER 是容量管理的下限,低于它就无法按第 5 章的方法判断规格是否合适。若需要按 topic 定位热点或按 topic 拆分流量、但不需要分区级消费延迟告警,PER_TOPIC_PER_BROKER 即可满足,同时不引入「消费组 × topic × 分区」这个三重乘积。确实依赖分区级消费延迟告警的场景才需要 PER_TOPIC_PER_PARTITION,且可以只对关键 topic 保留细粒度,其余 topic 降档。
调整档位前需要先做一次依赖审计:列出现有的 CloudWatch 告警与看板,确认每一项依赖的指标位于哪个档位(对照 MSK 监控指标文档)。审计结果决定档位,而不是反过来。
7.3 Broker 日志投递
MSK 支持将 broker 日志投递到三类目的地:CloudWatch Logs、Amazon S3、Amazon Data Firehose。三者的计费结构不同 —— CloudWatch Logs 按摄入量与存储量计费,S3 只产生请求费和存储费,Firehose 按处理量计费,具体单价见 CloudWatch 定价 与 Firehose 定价。日志量较大的集群通常选择 S3,配合 Athena 按需查询可以在保留较长历史的同时控制费用。若使用 CloudWatch Logs,应在 Log Group 上显式设置保留天数,默认为永不过期。
需要注意:将 broker 日志级别动态调整为 DEBUG 或 TRACE 时,AWS 建议使用 S3 或 Firehose 作为目的地。使用 CloudWatch Logs 时 MSK 可能持续投递日志采样,会显著影响 broker 性能。
八、实施建议
8.1 第一组:仅修改配置
这一组的变更本身当日生效且可即时回滚,但其中的监控档位一项需要先完成告警依赖审计,审计工作量取决于现有看板规模。
按需确定 CloudWatch 监控档位
配置动作:先审计现有告警与看板依赖的指标档位(对照第 6 章的档位对照表),确认哪些分区级指标确有需要;再据此设定档位,可以只对关键 topic 保留细粒度。PER_BROKER 是容量管理所需的下限,不应低于它。
验证指标:aws cloudwatch list-metrics --namespace AWS/Kafka 统计指标总条数;Cost Explorer 中 AmazonCloudWatch 的月度费用;确认审计清单中的告警在新档位下全部仍能触发。
回滚方式:重新提升监控档位,立即生效,无需重启集群。
调整 broker 日志目的地与保留期
配置动作:在 MSK 集群 Logging 配置中将 broker 日志目的地改为 S3;缩短或删除 CloudWatch Log Group 的保留天数。
验证指标:CloudWatch Logs AmazonCloudWatch 产品的 IngestBytes 用量归零或大幅下降。
回滚方式:恢复原日志目的地配置,立即生效。
清理无用 topic 与消费组
配置动作:枚举 BytesInPerSec 持续为 0 超过 7 天的 topic,核实无活跃消费者后删除;删除无活跃成员的僵尸消费组(kafka-consumer-groups.sh --describe 确认状态为 Empty 或 Dead)。
验证指标:PER_TOPIC_PER_PARTITION 或 PER_TOPIC_PER_BROKER 档位下的指标条数减少;KafkaDataLogsDiskUsed 可能下降。
回滚方式:删除操作不可逆,执行前记录 topic 配置(分区数、保留期、压缩类型等)。
提高 EBS 目标利用率并启用存储自动扩容(仅 Standard)
配置动作:新建集群或扩容时按 70% 而非 50% 的 EBS 目标利用率规划预置容量(第 4 章测算:存储费 −28.6%、总账单 −18.1%);用 Application Auto Scaling 注册 kafka:broker-storage:VolumeSize 并挂 KafkaBrokerStorageUtilization 目标跟踪策略,同时把 KafkaDataLogsDiskUsed 告警阈值设为 85%(分层存储集群 60%)。
验证指标:Cost Explorer 中 USE1-Kafka.Storage.GP2 的预置 GB 量;KafkaDataLogsDiskUsed 未触达 85%,且自动扩容未在 6 小时冷却期内连续触发。
回滚方式:删除 Auto Scaling 策略立即生效;已扩容的 EBS 无法缩小,只能迁移到更小存储的新集群。
审计已启用但未使用的预置存储吞吐
配置动作:通过 CloudWatch 读取 VolumeWriteBytes 和 VolumeReadBytes(PER_BROKER 级),确认每 broker 是否持续低于 250 MiBps 免费基线;若是,通过 aws kafka update-storage --provisioned-throughput Enabled=false 关闭。
验证指标:Cost Explorer 中 USE1-Kafka.Throughput 用量归零。
回滚方式:重新启用 PST 并设置所需带宽值,约 10 至 15 分钟生效。
8.2 第二组:需与业务方确认并走滚动变更
调整 topic 保留期
配置动作:查看 MaxOffsetLag 和 EstimatedMaxTimeLag 历史峰值,确认新保留期足够覆盖消费者最长故障恢复窗口,通过 kafka-configs.sh --alter --add-config retention.ms=<ms> 按 topic 逐一修改,低吞吐 topic 同步缩小 segment.ms。
验证指标:Express 集群观察 StorageUsed(Sum)下降;无消费组因 OFFSET_OUT_OF_RANGE 报错。
回滚方式:将 retention.ms 改回原值立即生效,已删除数据不可恢复。
启用客户端压缩与批处理
配置动作:生产端添加 compression.type = zstd、batch.size=262144、linger.ms=25,带 key 且分区数 ≥30 的 producer 设 linger.ms=50~100,按 batch.size × 分区数 × 2 调整 buffer.memory;使用 lz4 时显式设 compression.lz4.level=1(需客户端版本 ≥3.8.0)。
验证指标:batch-size-avg 确认批次充分填充;kafka-log-dirs.sh 对比前后落盘字节。
回滚方式:回退 producer 配置,已写入数据不受影响(broker 侧 compression.type=producer 保持不变)。
高熵 payload 关闭压缩
配置动作:对已压缩内容或高熵二进制 payload 的 topic,其 producer 设 compression.type=none(实测 snappy 在这类 payload 上落盘字节比不压缩多 0.02%)。
验证指标:kafka-log-dirs.sh 对比前后单副本落盘字节无明显增加;producer CPU 占用下降。
回滚方式:恢复原 compression.type,已写入数据不受影响。
低延迟 topic 走 linger.ms=5 档
配置动作:延迟预算不允许 25 ms 的 producer 设 linger.ms=5,可获得 63% 的可达压缩收益,p99 代价约 +9 ms(第 2 章细扫表)。
验证指标:batch-size-avg 高于 linger.ms=0 时的水平;producer p99 在延迟预算内。
回滚方式:改回 linger.ms=0,立即生效。
启用日志压缩(keyed topic)
配置动作:审计目标 topic 的 key 分布,确认存在 key 复用后,kafka-configs.sh --alter --entity-type topics --entity-name <topic> --add-config cleanup.policy=compact;key 唯一的事件流型 topic 不适用。
验证指标:该 topic 的单副本落盘字节(kafka-log-dirs.sh)下降;无消费者因读不到历史版本而报错。 回
滚方式:改回 cleanup.policy=delete 立即生效,已被压缩删除的历史版本不可恢复;该 topic 不能同时使用分层存储。
开启机架感知消费
配置动作:创建含 replica.selector.class=org.apache.kafka.common.replica.RackAwareReplicaSelector 的 cluster configuration 并应用(触发约 48 分钟滚动重启,以 3 台 large 为基准,大集群需更长时间),更新所有消费端从 IMDS 或节点标签动态读取 AZ ID 并设置 client.rack。
验证指标:消费端 TRACE 日志出现 Updating preferred read replica;Cost Explorer 跨 AZ 传输费在数天内下降。
回滚方式:应用不含 replica.selector.class 的 cluster configuration,需再次滚动重启。
实例规格调整
配置动作:变更前先采集 14 天以上的 CpuUser + CpuSystem(PER_BROKER 级;每个数据点用 Average 统计,取窗口内最高的那个数据点作为峰值)。若峰值长期远低于 60% 目标值,先在测试集群验证降一档规格后峰值仍低于 60%,再通过 aws kafka update-broker-type 原地 rolling 执行生产变更。
验证指标:变更后 7 天的验证窗口内,CpuUser + CpuSystem 峰值(同一取法)低于 60%;ProduceThrottleByteRate 未持续接近 per-broker 持续值。
回滚方式:update-broker-type 恢复原规格,rolling 无中断。
8.3 第三组:需设计评审与迁移窗口
分层存储(仅 Standard)
配置动作:先在测试集群验证,确认可接受每 broker 写入配额下降约 19%(计算表口径,见第 4 章),再对生产集群执行 aws kafka update-storage --storage-mode TIERED,逐 topic 开启 remote.storage.enable=true 并设置 local.retention.ms。
验证指标:KafkaDataLogsDiskUsed 下降;RemoteCopyBytesPerSec 确认搬迁进行中;远端存储计费(USE1-Kafka.Storage.Tiered)出现。
回滚方式:集群级启用后不可回退,需充分评估后再执行;topic 级关闭后不可重新启用。
broker 类型迁移(Standard → Express 或反向)
配置动作:先用公式计算迁移后的预期费用差额,再新建目标 broker 类型集群,迁移 topic 定义和数据,逐步切换 producer 和 consumer 端点,老集群保留观察期后删除。
验证指标:新集群延迟和吞吐指标与老集群基本一致;账单 7 天后对比费用变化趋势。
回滚方式:老集群保留期间可随时切回,删除后不可恢复。
应用层合并小消息
配置动作:对平均记录小于百字节量级的 topic,在应用层把多条小消息打包成一条大消息后再发送(实测压缩率 78 B 时 0.2563、630 B 时 0.1464、2409 B 时 0.1063,收益大于换 codec);消费端同步实现拆包。
验证指标:kafka-log-dirs.sh 对比前后单副本落盘字节下降;MessagesInPerSec 按合并倍数下降。
回滚方式:生产端与消费端需同时回退,切换期间两种格式并存,应保留拆包的兼容分支。
分区数治理
配置动作:识别 BytesInPerSec 持续低的过度分区 topic,新建更少分区的替代 topic,迁移 producer 和 consumer 后废弃旧 topic(分区数不支持减少,只能建新 topic 迁移)。
验证指标:CloudWatch 指标总条数减少;broker CPU 有所下降(高分区数是复制和元数据开销的来源之一)。
回滚方式:保留旧 topic 直至新 topic 运行稳定后再删除。
九、相关链接
相关产品:
- Amazon MSK — 完全托管式 Apache Kafka 服务
- Amazon EBS — 高性能数据块存储
- Amazon CloudWatch — 可观测性工具
- Amazon S3 — 适用于 AI、分析和存档的几乎无限的安全对象存储
- Amazon EC2 — 安全且可调整大小的计算容量
相关文章:
- S3 Tables 实战:两种方案,把 MySQL 数据实时”搬”进 S3 Tables
- 将 AWS DevOps Agent 智能运维能力延伸到中国区
- 如何为 AWS WAF 速率限制的 IP 配置固定封禁时长
- 利用 Amazon Bedrock AgentCore 快速为您的 Agent 接入联网搜索和网页浏览
- 基于 Amazon WorkSpaces Applications 快速搭建企业级应用培训环境
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |