Amazon Web Services ブログ
KDDI における Amazon EKS Auto Mode 商用導入:カスタムコントローラーによる運用課題の解決
本稿は、KDDI 株式会社 コア技術統括本部 情報システム本部 DX システム 2 部 フロント SRE グループ 西 総一朗 氏に寄稿いただきました。
はじめに
KDDI 株式会社(以下、KDDI)では 2026 年 7 月、通信事業のお客さま向けサービスを支える Amazon Elastic Kubernetes Service(以下、EKS)のクラスタを、マネージドノードグループから Amazon EKS Auto Mode(以下、EKS Auto Mode)へ移行しました。移行の目的は、ワーカーノードの更新にかかる運用工数を削減し、そのセキュリティを継続的に担保することでした。EKS Auto Mode の導入に際して、解決すべき課題が 2 つありました。起動時の CPU 需要への対処と、ノードの入れ替え時刻の制御です。後者については、EKS Auto Mode の仕様を本システムの要件に合わせるため、筆者がカスタムコントローラを開発しました。移行完了後、ワーカーノードは AWS が提供する最新の AMI へ自動で入れ替わり、遅くとも 21 日以内には必ず更新されるため、脆弱性への対応のために計画していたワーカーノードの更新作業はなくなり、運用工数の削減に繋がりました。本稿では、採用と対処のそれぞれの判断を支えた実測値とあわせて、導入から運用までの経緯を紹介します。
プロジェクトの概要
KDDI は通信事業を基盤としながら、au PAY・Ponta ポイント・エンタメ・エネルギーなど、ユーザーの生活に密着した多彩なサービスを展開しています。本稿で扱うのは、そのうち通信事業のお客さま向けサービスです。筆者は KDDI の内製 SRE チーム(社内では「クラウド SA(ソリューションアーキテクト)」と呼んでいます)に所属し、AWS 上のインフラの設計・構築・運用を担当しています。開発体制の特徴として、インフラとアプリケーションで変更のリードタイムが異なる点が挙げられます。AWS インフラは KDDI の SRE チームが内製しており、設計変更を短いサイクルで実施できます。アプリケーションは組織をまたいで開発しているため、改修には相応の調整期間が要ります。そこで本事例では一貫して、アプリケーション開発チームの負荷をインフラ側で吸収する方針で設計を進めました。
本稿で言及するワークロードは、複数の Java(Spring Boot)マイクロサービス群で構成されています。トラヒックには季節性があり、繁忙期には平常時の 3 倍以上のリクエストが発生します。1 日の中でも、最大と最小で 6 倍以上の開きがあります。アプリケーションが稼働する EKS クラスタは過去に 7 回のバージョンアップをしてきました。いずれの作業も、切り戻しが容易であることから、既存クラスタとは別に新しいクラスタを構築し、Amazon Route 53 の加重レコードで切り替える Blue/Green 方式で実施していました。直近 2 回のバージョンアップ作業の中で、ノード OS の Bottlerocket OS への変更と、EKS Auto Mode への移行を実施しました。
EKS Auto Mode を採用した理由
脆弱性対応を、人手の作業から切り離したかった
従来の構成では、ワーカーノードへの変更を最小限の差分に留める方針を採っていました。脆弱性への対応が必要になると、対象のミドルウェアにだけパッチを適用し、その作業では EKS のバージョンやほかのミドルウェアは変更しませんでした。変更範囲を絞ることで正常性を確実に確認し、性能や機能のリグレッションを防ぐためです。ワーカーノードを入れ替える際はメンテナンス状態にする必要があるため、アプリケーション側と調整したうえで夜間に作業していました。脆弱性には都度対応できていた一方で、そのたびに調整・検証・夜間作業の工数がかかっていました。また近年はセキュリティ要件が厳格になり、脆弱性へのより迅速な対応が求められるため、人手を前提とした運用では負担が増え続けます。
EKS Auto Mode では、ノードの有効期限を最長 21 日に設定でき、有効期限を迎えたノードは AWS が管理する最新の AMI へ自動で入れ替わります。また、AWS がパッチを適用した新しい AMI を公開すると、有効期限を待たずに自動で最新の AMI へと入れ替わります。人手を介さずにノードを更新できるこの仕組みは魅力的でした。
自動更新を受け入れられると判断した根拠は 2 つあります。
- ノードの更新がアプリケーションに影響しにくいこと。EKS Auto Mode ではカスタム AMI や OS を選べず、ノードに独自のソフトウェアや設定を持ち込めません。本システムはもともと、アプリケーションが必要とする機能をノードに依存させていませんでした。そのため、ノードが入れ替わってもアプリケーションへの影響は小さいと判断しました。
- 互換性の確認を自分たちで行う範囲が減ること。ノード OS と VPC CNI や CoreDNS などの基盤コンポーネントを AWS が一体で管理・更新するため、組み合わせごとの更新計画や互換性の確認を自分たちで抱える必要が少なくなります。
EKS Auto Mode にはノードの Amazon EC2 の料金に加えて管理料金がかかります。それでも、脆弱性への対応にかけていた工数と比較すると、本システムのようなセキュリティ要件の厳しいエンタープライズの用途では、追加料金を上回る効果があると判断しました。
OS の切り替えと EKS Auto Mode の導入を 2 段階に分けることで、リスクを抑えて段階的に移行できる見通しが立った
EKS Auto Mode のノード OS は Bottlerocket OS に固定されています。Bottlerocket OS はコンテナの実行に必要な最小限の構成とイミュータブルなルートファイルシステムにより、攻撃面を小さくする設計の OS です。当時のクラスタは Amazon Linux 2 で動いていました。そこで 2 段階の計画にしました。1 度目のバージョンアップでまずノード OS を Bottlerocket OS へ切り替え、2 度目のバージョンアップで EKS Auto Mode へ移行する順序です。1 回の移行で変える要素を減らし、問題が起きたときに原因を切り分けやすくするためです。あわせて、EKS アドオンとして導入できるコンポーネントはアドオンに集約する方針も採りました。
この 2 段階の間に、アプリケーション側では Graceful Shutdown への対応を進めました。EKS Auto Mode ではノードが人の立ち会いなしに入れ替わります。ノードの入れ替え時にリクエストを途切れさせないためには、Pod が SIGTERM を受けてから処理中のリクエストを完了して終了する動作が必要です。
アーキテクチャ概要
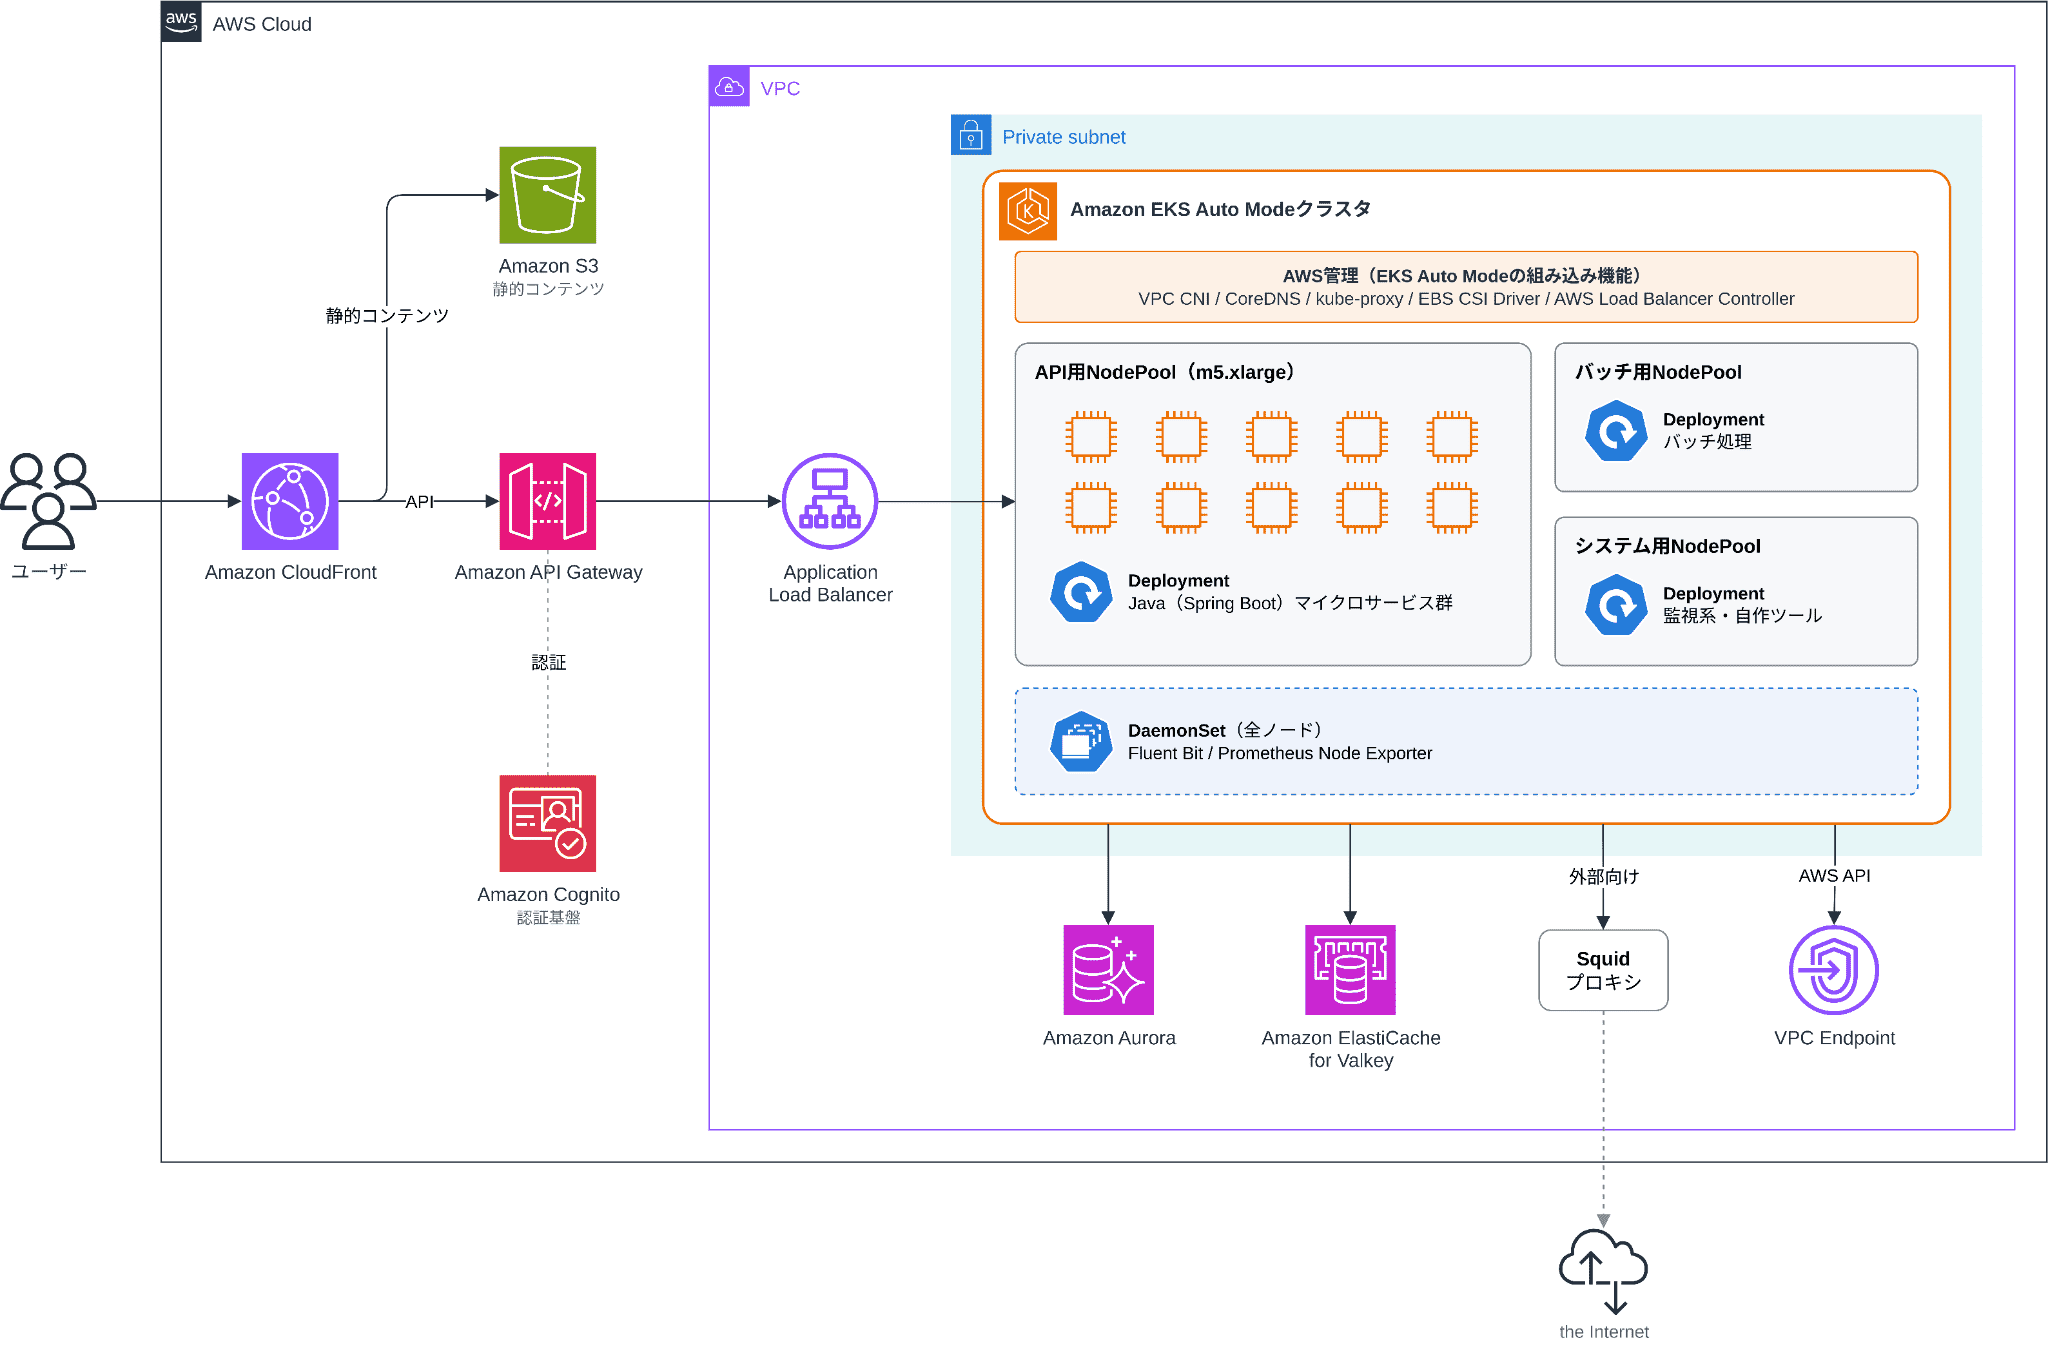
システムを構成する主なサービスは次のとおりです。
| 役割 | サービス |
|---|---|
| 静的コンテンツの配信 | Amazon CloudFront → Amazon S3 |
| API の経路 | Amazon CloudFront → Amazon API Gateway → Application Load Balancer(ALB)→ Pod |
| コンテナの実行基盤 | Amazon EKS Auto Mode(プライベートサブネットに配置) |
| データストア | Amazon Aurora、Amazon ElastiCache for Valkey |
| 認証基盤 | Amazon Cognito |
クラスタは閉域で、ノードからインターネットへの直接の経路はありません。外部向けの通信は Squid によるプロキシを経由し、AWS の API へは VPC エンドポイントを通じて到達します。
EKS Auto Mode に内蔵された Karpenter がノードを起動する単位である NodePool は、用途別に 3 つ用意しました。API を載せる NodePool はインスタンスタイプを m5.xlarge に固定しています。ほかにバッチ用と、監視系のコンポーネントを載せるシステム用の NodePool があります。インスタンスタイプを固定した理由は後述します。
クラスタ内のコンポーネントは、管理主体ごとに次のように分かれます。EKS Auto Mode への移行により、VPC CNI や CoreDNS などのコンポーネントは AWS の管理下に移りました。
| 管理主体 | コンポーネント |
|---|---|
| AWS(EKS Auto Mode の組み込み機能) | VPC CNI、CoreDNS、kube-proxy、EBS CSI Driver、ロードバランサーの管理(AWS Load Balancer Controller 相当の機能) |
| KDDI(EKS アドオンとして導入) | metrics-server、kube-state-metrics、Prometheus Node Exporter、Fluent Bit |
| KDDI(Helm チャートで導入) | Prometheus、本稿で紹介する自作ツール |
導入時の課題と対処:起動時の CPU スロットリング
課題は終了時ではなく起動時にあった
移行前に注力していたのは、終了時の対策でした。Graceful Shutdown に対応すればノードの入れ替えに伴う影響は抑えられるはずでした。検証環境に構築した新バージョンのクラスタでは、ノードの入れ替えが負荷の高い時間帯にも起こりうる前提で、Pod を入れ替えながら負荷試験を実施しました。すると旧バージョンのクラスタと同じ構成のまま、主要なサービスのスループットが半分近くまで落ち、ノードの CPU 使用率は上限に張り付いたままになりました(数値は後述の表にまとめています)。原因を調べると、問題は起動時にありました。これは EKS Auto Mode 固有の性能劣化ではありません。従来は人手で吸収していた Pod 配置の偏りが、無人のノード更新を前提にしたことで導入の障壁として表面化したものです。
API の Pod は CPU の request を 200m、limit を 2000m に設定していました。10 倍のオーバーコミットです。Kubernetes のスケジューラはリソースについては request の値を見て Pod を配置します。そのため、起動時の実際の CPU 需要を合計するとノードの容量を大きく超えるほどの数の Pod が、1 台に載ることがあります。Java アプリケーションは起動直後、JIT コンパイルとクラスロードで limit 近くまで CPU を使います。複数の Pod が同時に起動すると需要が容量を超え、limit に達したコンテナで CPU スロットリングが発生し、同居する Pod の間で CPU の競合も重なります。起動が遅れるだけでなく、同じノードで稼働中の Pod まで CPU を奪われ、通常のリクエストがタイムアウトします。
同じ事象は旧バージョンのクラスタでも発生していました。発生条件は再デプロイ時で、旧バージョンの負荷試験と同じです。EKS Auto Mode への移行時に変化していたのは、人が立ち会うかどうかだけでした。
| 移行前(マネージドノードグループ) | 移行後(EKS Auto Mode) | |
|---|---|---|
| Pod が入れ替わる契機 | 再デプロイ(メンテナンス状態にして人が立ち会う商用作業) | ノードの自動更新(時刻を問わない、無停止) |
| 配置が偏ったとき | 解消するまで再デプロイをやり直す | やり直す人がいない |
| 起動直後の CPU バースト | メンテナンス状態を解除する前に収まる | エンドユーザーのリクエストを受けながら発生する |
| エンドユーザーへの影響 | メンテナンス状態のため、配置の偏りや起動直後の CPU バーストの影響は及ばない | 同じノードのほかのユーザーまでタイムアウトする可能性 |
本システムでは、Pod の配置を自動で適正化する仕組みがなければ EKS Auto Mode を導入できません。これが最初の課題でした。
対処:既存の台数のまま Pod の配置を適正化する
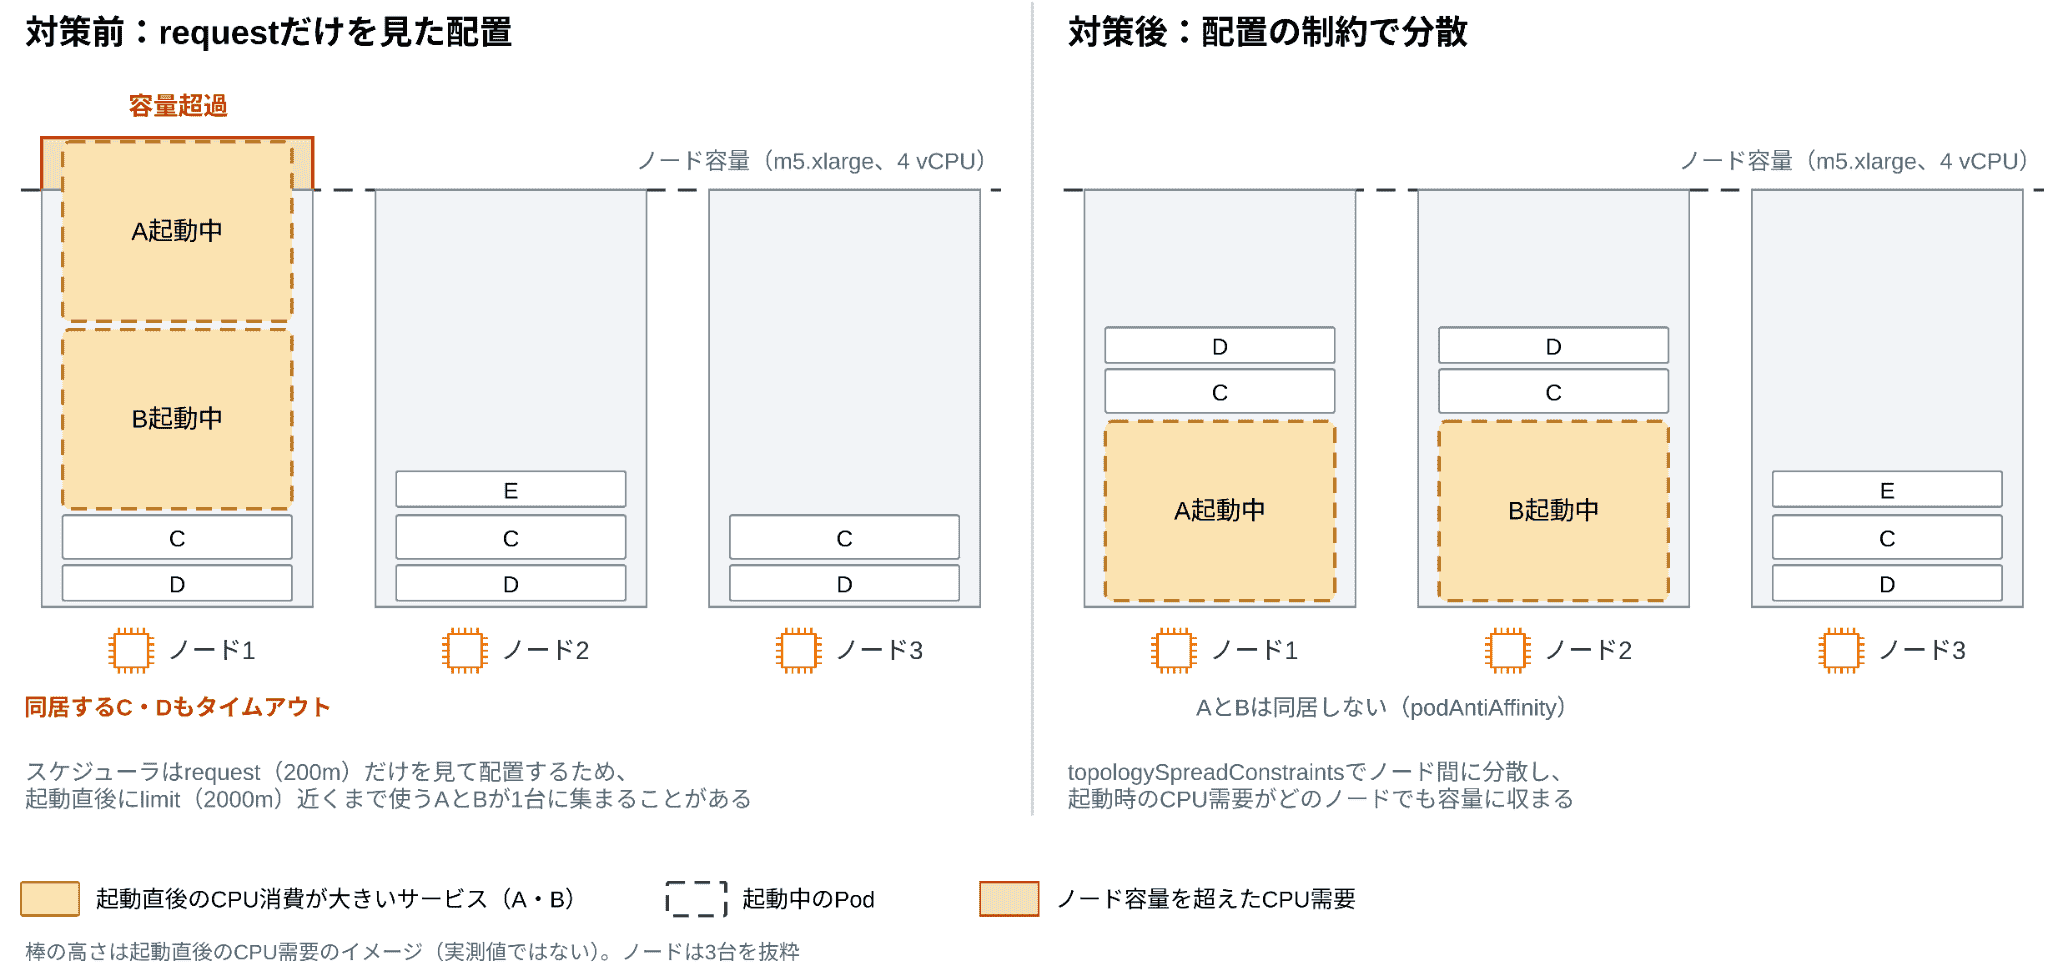
対策として、検討したものの採用しなかった選択肢と、その理由は次のとおりです。
| 選択肢 | 採用しなかった理由 |
|---|---|
| CPU の request を limit と同じ値にする | オーバーコミットは解消するが、商用環境で必要なノードの台数が大幅に増える |
| PodDisruptionBudget | Pod の退避の経路にしか効かず、起動時の集中は防げない |
| NodePool の期限をずらす | 1 ノードに同居する Pod のまとまりは分解できない |
最終的に、ノードの台数を増やさず Pod の配置を適正化する方針を採用しました。具体的には、配置の制御を中心に次の対処を組み合わせました。
| 対処 | 内容 |
|---|---|
| topologySpreadConstraints | ノード間の分散を DoNotSchedule、AZ 間の分散を ScheduleAnyway で制約 |
| podAntiAffinity | CPU 消費の大きいサービス A とサービス B の 1 ペアに限定し、同じノードに同居させない |
| インスタンスタイプの固定 | m5.xlarge に固定。大きいインスタンスを許容すると、ノードの容量で同居数を抑える設計が成り立たない |
| ALB の slow start | 起動直後のターゲットへのトラヒックを段階的に増やし、リクエストの集中を回避 |
ノード間分散の制約には、本構成では matchLabelKeys: pod-template-hash が必要でした。これがないと Rolling Update での更新時に新しい Pod が旧 Pod の載っているノードを回避し続け、maxSurge: 1 の構成では置き場所がなくなって Pending のまま止まります。
負荷試験での効果検証
効果は、検証環境(m5.xlarge)での負荷試験で確かめました。この検証では原因を確認するため、CPU 消費の大きい 3 サービスを podAntiAffinity で 1 ノードあたり 1 Pod に隔離し、その分ノードを増やしています。表には、このうち商用環境で相互排他を適用したサービス A とサービス B の値を示します。
| 指標 | 移行前:Pod 手動入れ替え | 移行後:Pod 入れ替え時・対策前 | 移行後:Pod 入れ替え時・対策後(検証用の隔離構成) |
|---|---|---|---|
| サービス A の RPS | 398 | 216 | 410 |
| サービス B の RPS | 167 | 92 | 179 |
| ノードの CPU 使用率(最大) | 85% | 約 100% | 72% |
スループットと CPU 使用率が移行前と同じ水準に戻り、原因が Pod の配置にあることを確認できました。商用環境では必要台数の増加を抑えるため、隔離の対象を 1 ペアに絞って適用しています。
ただし、オーバーコミットの状態そのものは変わっていないため、CPU スロットリングの発生頻度が下がった段階です。オーバーコミット自体が問題なのではなく、起動直後の CPU 需要が収まる前に Pod がリクエストを受け付けることが問題です。恒久的な対策は、起動直後の CPU 需要が収まってから Pod を healthy にすることだと考えています。この対応については「今後の展望」で触れます。
導入の効果
EKS Auto Mode の導入による一番の効果は、ノードの継続的な更新が運用の一部になったことです。ノードは最長 21 日の周期で、AWS が提供する更新済みの AMI へ入れ替わります。AWS が AMI を更新すると、Karpenter が設定との差異(Drift)を検知してノードを入れ替えます。この入れ替えは、Disruption Budget(中断の台数や時間帯を制限する設定)で許可したメンテナンスウィンドウ内で行われます。商用導入以降は、AMI の更新のたびに全ノードがその時間帯に入れ替わっています。AMI の更新がないまま有効期限が近づいたノードは、後述する node-rotation-controller が同じメンテナンスウィンドウで入れ替えます。ワーカーノード側の脆弱性への対応を求められても、「ノード OS は自動で更新されるため、原則として個別の作業は不要」と回答できるようになり、更新の計画と作業に充てていた工数がなくなりました。また、VPC CNI や CoreDNS などの基盤コンポーネントの更新を AWS に任せられるようになったこともメリットのひとつです。
移行前後の運用を比べると次のようになります。後半の 2 点は EKS Auto Mode そのものの効果ではなく、前述の Pod 配置の対処と、後述する node-rotation-controller によるものです。
| 項目 | 移行前(マネージドノードグループ) | 移行後(EKS Auto Mode) |
|---|---|---|
| ノードの更新 | 脆弱性対応のたびに人が計画し、メンテナンス状態にして夜間に作業 | 最長 21 日の周期で自動で入れ替え。週 1 回のメンテナンスウィンドウで無停止 |
| ワーカーノードの脆弱性への対応 | 依頼のたびに影響を確認し、対象のミドルウェアだけを更新 | 「ノード OS は自動で更新されるため、原則として個別の作業は不要」と回答 |
| 基盤コンポーネント | VPC CNI、CoreDNS、EBS CSI Driver などのバージョンの更新を自分たちで管理 | AWS が管理 |
| Pod の配置 | 再デプロイ時に偏りが出たら人がやり直し | topologySpreadConstraints と podAntiAffinity で自動的に分散 |
| ノードの入れ替え時刻 | 人が作業する時間帯 | メンテナンスウィンドウにて実施(EC2 の中断イベントなどを除く) |
導入後の運用課題:ノードの入れ替え時刻を制御する
導入後にも、ノードが入れ替わるたびに直面する課題がありました。この課題に対して筆者が開発したのが、後述する node-rotation-controller です。
失効による入れ替えは、時間帯を選べない
EKS Auto Mode のノードには、OSS の Karpenter にはない上限があります。有効期限(expireAfter)と、失効後に Pod の退避を待つ猶予(terminationGracePeriod)の合計が 21 日以内でなければならず、ノードは必ず失効します。Karpenter はノードの中断を graceful と forceful に分けています。台数や時間帯を制限する Disruption Budget が効くのは、graceful な中断だけです。
| 中断の種類 | Disruption Budget | 該当する中断 |
|---|---|---|
| graceful | 効く(台数・時間帯を制限できる) | Drift、Underutilized、Empty |
| forceful | 効かない(条件が成立すると Disruption Budget を待たずに開始) | Expiration、Interruption |
実際、AMI の更新に伴う Drift による入れ替えは、Disruption Budget のとおりメンテナンスウィンドウに収まっていました。一方、失効(Expiration)は forceful に分類されているため、時間帯を制限できません。前述のとおり、本システムでは Pod の起動時に CPU の需要が集中します。アクセスの多い日中にノードが入れ替わると通常のリクエストがタイムアウトするため、入れ替えの時刻を制御する手段が必要でした。
対処:失効の前に、メンテナンスウィンドウの中で先回りして置換する
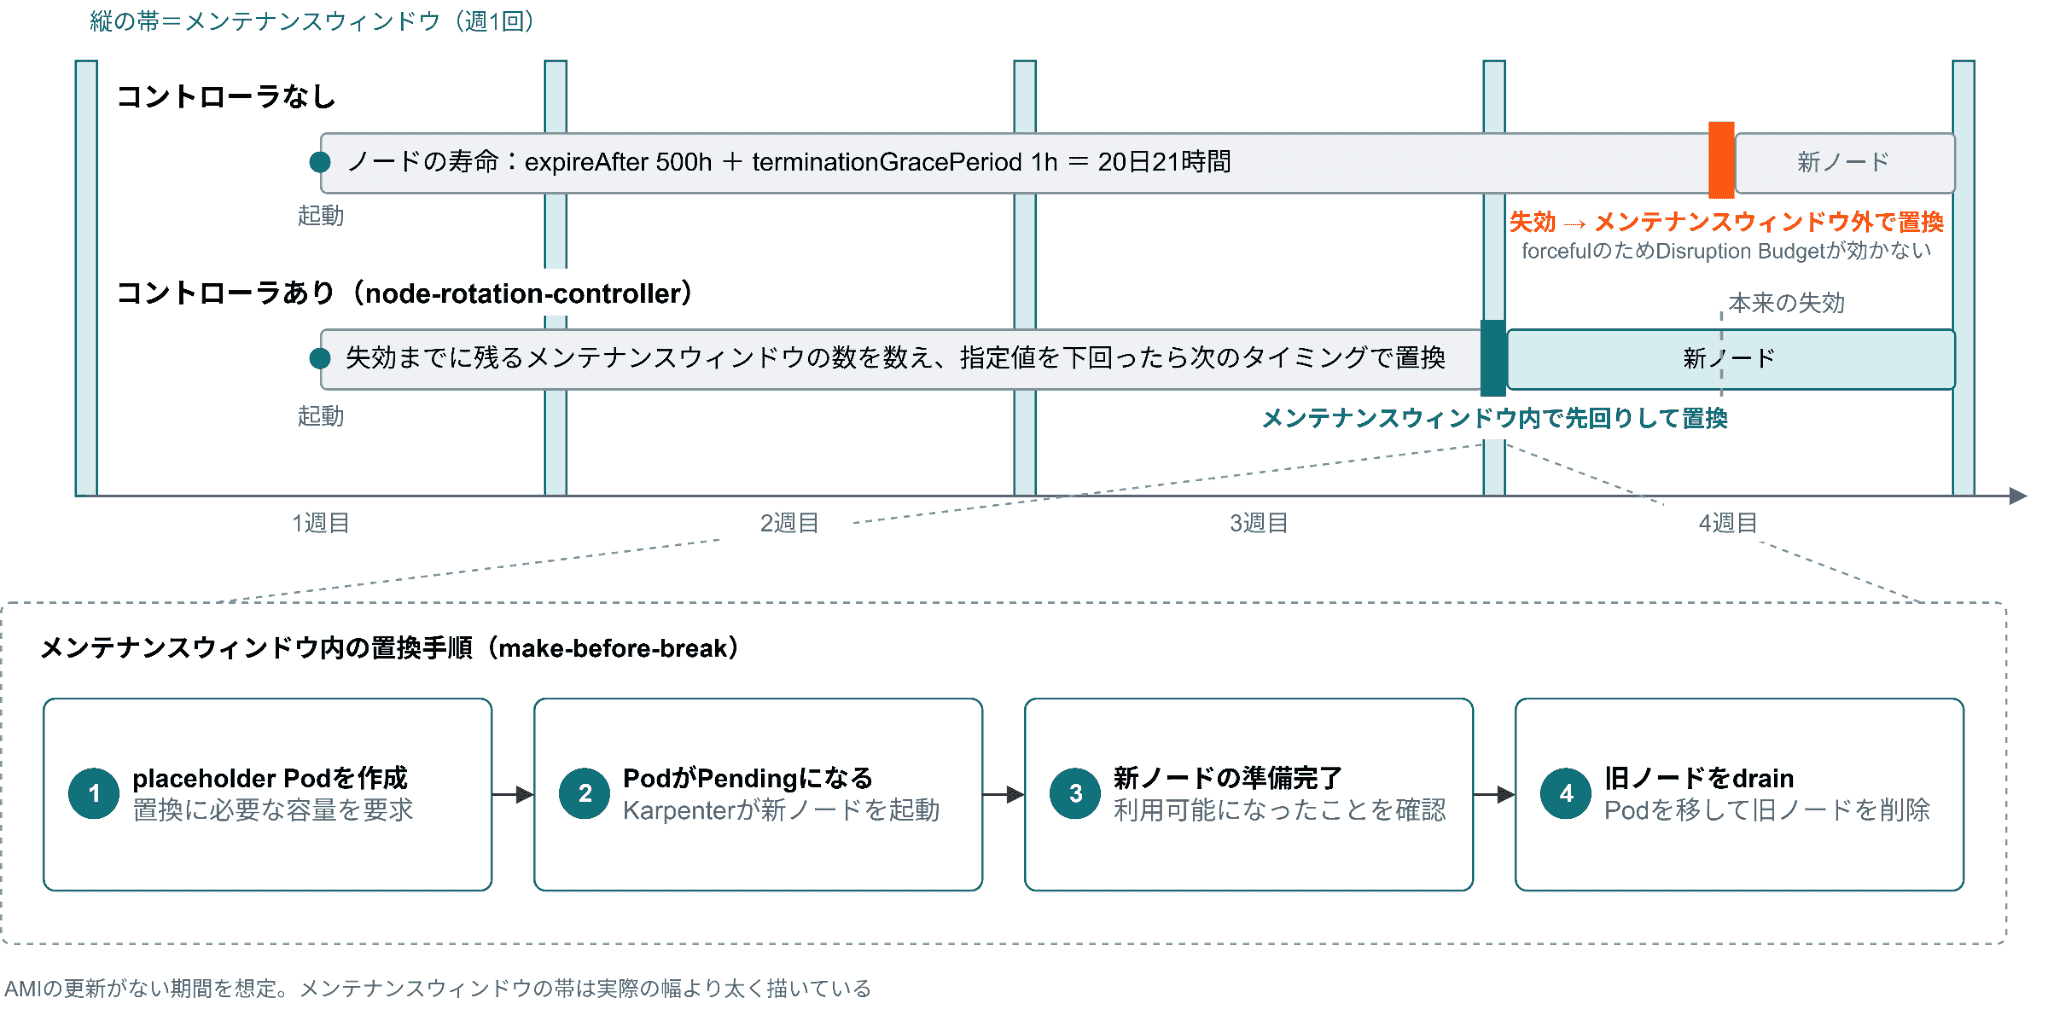
ノードが失効を迎える前に、メンテナンスウィンドウの中で先回りして置換するカスタムコントローラを開発しました。これが node-rotation-controller です。各ノードについて、有効期限までにメンテナンスウィンドウがあと何回巡ってくるかを数え、残りの回数が指定値を下回ったノードを次のウィンドウで置換します。置換は新しいノードを先に用意してから古いノードを削除する方式(make-before-break)で、次の順に進みます。
- 置換に必要な容量を要求する placeholder Pod を作成する
- placeholder Pod が Pending になり、Karpenter が新しいノードを起動する
- 新しいノードが利用可能になったことを確認する
- 旧ノードを drain して Pod を移し、旧ノードを削除する
この方式は、Karpenter が Pending の Pod に応じてノードを起動する NodePool を前提としています。置換中は一時的にノードが増えるため、NodePool の limits や EC2 のクォータには余裕を持たせています。
商用環境の設定は次のとおりです。コントローラのメンテナンスウィンドウと Karpenter 側の Disruption Budget は、同じ時間帯に揃えています。
| 設定 | 値 | 意味 |
|---|---|---|
expireAfter |
500 時間 | ノードの有効期限 |
terminationGracePeriod |
1 時間 | 失効後に Pod の退避を待つ猶予。合計 501 時間(20 日と 21 時間)で、上限の 21 日に対して 3 時間の余裕 |
| コントローラのメンテナンスウィンドウ | 毎週 1 回 | 失効前の置換を実行する時間帯 |
| Disruption Budget(ウィンドウ内) | 同時に最大 1 台 | graceful な中断の同時実行数を最大 1 台に制限 |
| Disruption Budget(ウィンドウ外) | 0 台 | メンテナンスウィンドウ外は設定との差異(Drift)と低使用率(Underutilized)による中断を禁止。空ノードの削除(Empty)は常時、同時に最大 1 台まで許可 |
いつどのノードが入れ替わるかを事前に把握できるよう、置換予定をシミュレーションするツールもあわせて開発しました。
商用導入後の 1 か月は AMI の更新が続き、Drift による入れ替えで有効期限が更新されていたため、コントローラが置換を実行することはありませんでした。その後、AMI の更新が途絶えた期間に初めてコントローラが置換を実行し、メンテナンスウィンドウ内に API ノード全台の置換を完了しました。AMI の更新が再開してからは、Drift による入れ替えに戻っています。失効と Drift によるノードの入れ替えについては、メンテナンスウィンドウに収まる状態になっています。
今後の展望
まず、ログの保全を進めます。移行時点の EKS Auto Mode では kubelet のログローテーション設定を変更できず、1 コンテナあたり合計 50 MiB までしかログが保持されませんでした。そのため、ログの出力量が多い環境では、Fluent Bit が転送する前にログが破棄される恐れがあります。この制約に備えて、筆者はログファイルをハードリンクで退避し、転送の完了を確認してから削除する pod-log-preserver を開発しました。現在は限定的な範囲で検証しています。また、本プロジェクト完了後の 2026 年 10 月のアップデートで、NodeClass の advancedCompute.kubelet.logging から、ログローテーションのサイズと世代数を変更できるようになりました。こちらもあわせて導入を検討していきます。
Pod のオートスケールの導入と、それにあわせたリソースの最適化にも取り組みます。Karpenter は、Pod のリソース要求に応じてノードの台数を自動で決めます。Pod のオートスケールを導入すれば、増減するトラヒックにノードの台数を追随させられます。Karpenter の機能を活かせる次の領域です。あわせて、起動直後の CPU 需要が収まってから Pod を healthy にする対応を、アプリケーション側と進めます。
node-rotation-controller は、本システムのメンテナンスウィンドウの要件を EKS Auto Mode の現時点の機能に合わせて補うものです。失効の時間帯を標準機能で制御できるようになれば、構成を見直す予定です。
まとめ
EKS Auto Mode では、人が立ち会うことを前提にした運用は成り立ちません。ノードは無人の時間帯に入れ替わり、Pod の配置のやり直しも、入れ替え時刻の選択も、人の手には戻ってきません。だからこそ、それらを自動で行う仕組みを自分たちで用意する必要がありました。Graceful Shutdown への対応はアプリケーション側と進め、Pod の配置と入れ替え時刻の制御はインフラ側で補いました。その結果として得られたのが、ノードの継続的な自動更新による運用工数の削減と、ワーカーノードのセキュリティの担保です。EKS Auto Mode の導入を検討されている方、とくにエンタープライズでアプリケーションとインフラを複数のチームで分担して開発されている方の参考になれば幸いです。
著者について
西 総一朗
KDDI 株式会社 コア技術統括本部 情報システム本部 DX システム 2 部 フロント SRE グループ
2024 年に KDDI に入社し、通信事業のお客さま向けサービスを支える AWS 上のインフラの設計・構築・運用に従事しています。本事例では EKS Auto Mode への移行と、node-rotation-controller および pod-log-preserver の開発を担当しました。著者の写真は、AWS re:Invent 2025 参加時に、米国ラスベガスで撮影しました。