Amazon Web Services ブログ
Amazon Bedrock の自動推論ポリシーの自動改善
本ブログは 2026 年 8 月 3 日に公開された AWS Blog “Automated Reasoning policy refinement in Amazon Bedrock” を翻訳したものです。
Amazon Bedrock で自動推論ポリシー (Automated Reasoning policy) を改善する作業は、これまで診断、手作業での編集、再テストを繰り返す手動のサイクルでした。本日 (2026 年 8 月 3 日)、このサイクルのうち診断と修正の作業を自動化するポリシーの自動改善を発表します。改善エンジンが失敗したテストを診断し、形式論理の修正案を提示します。どの変更も、お客様が承認してから反映されます。
自動推論チェック (Automated Reasoning checks) は、Amazon Bedrock Guardrails において形式検証を使用して回答の正しさを証明します。自然言語から形式論理への変換があいまいでなければ、最大 99% の検証精度を実現します。これは「自動推論チェックを使用して、AI のハルシネーションを最小限に抑え、最大 99% の検証精度を実現: 今すぐご利用いただけます」で報告したとおりです。使い始めるには、ソースドキュメントから自動推論ポリシーを構築し、テストケースで検証します。お客様からは、この反復的なチューニングがポリシー開発における最大のボトルネックになっているという声が寄せられていました。
この記事では、2 つの新しい改善モードを解説します。ルールの問題に対応する Iterative Refinement (反復的な改善) と、言語の問題に対応する Ambiguous Variable Refinement (あいまいな変数の改善) です。各モードについて、API ワークフロー全体 (開始、ポーリング、取得) と、失敗するポリシーを合格するポリシーに変えるための再現可能なコンソール手順を紹介します。
自動推論チェックとは何か
自動推論チェックは自然言語を形式論理に変換し、自動推論の技術を適用して次のいずれかの検出結果を生成します。VALID、INVALID、SATISFIABLE、IMPOSSIBLE、TRANSLATION_AMBIGUOUS です。ポリシーの仕組みについて詳しくは、「自動推論チェックを使用して、AI のハルシネーションを最小限に抑え、最大 99% の検証精度を実現: 今すぐご利用いただけます」を参照してください。
訳注: 2026 年 9 月 13 日時点の Amazon Bedrock API リファレンスでは、自動推論チェックが返す検出結果 (finding) として、本文で挙げた 5 種類に加えて NO_TRANSLATIONS と TOO_COMPLEX が定義されており、合計 7 種類があります。参照: GuardrailAutomatedReasoningFinding – Amazon Bedrock API Reference
この記事で重要となる概念は、2 ステップの検証パイプラインです。まず、変換 (translate) ステップでは、ポリシー内の変数の説明を使用して、自然言語の入力/出力を変数の割り当てにマッピングします。次に、検証 (validate) ステップでは、それらの割り当てに形式ルールを適用します。テストが失敗したときは、根本原因はこの 2 つのステップのいずれかにあり、各改善モードはそれぞれ異なるステップを対象としています。図 1 はこのパイプラインを最初から最後まで示しています。
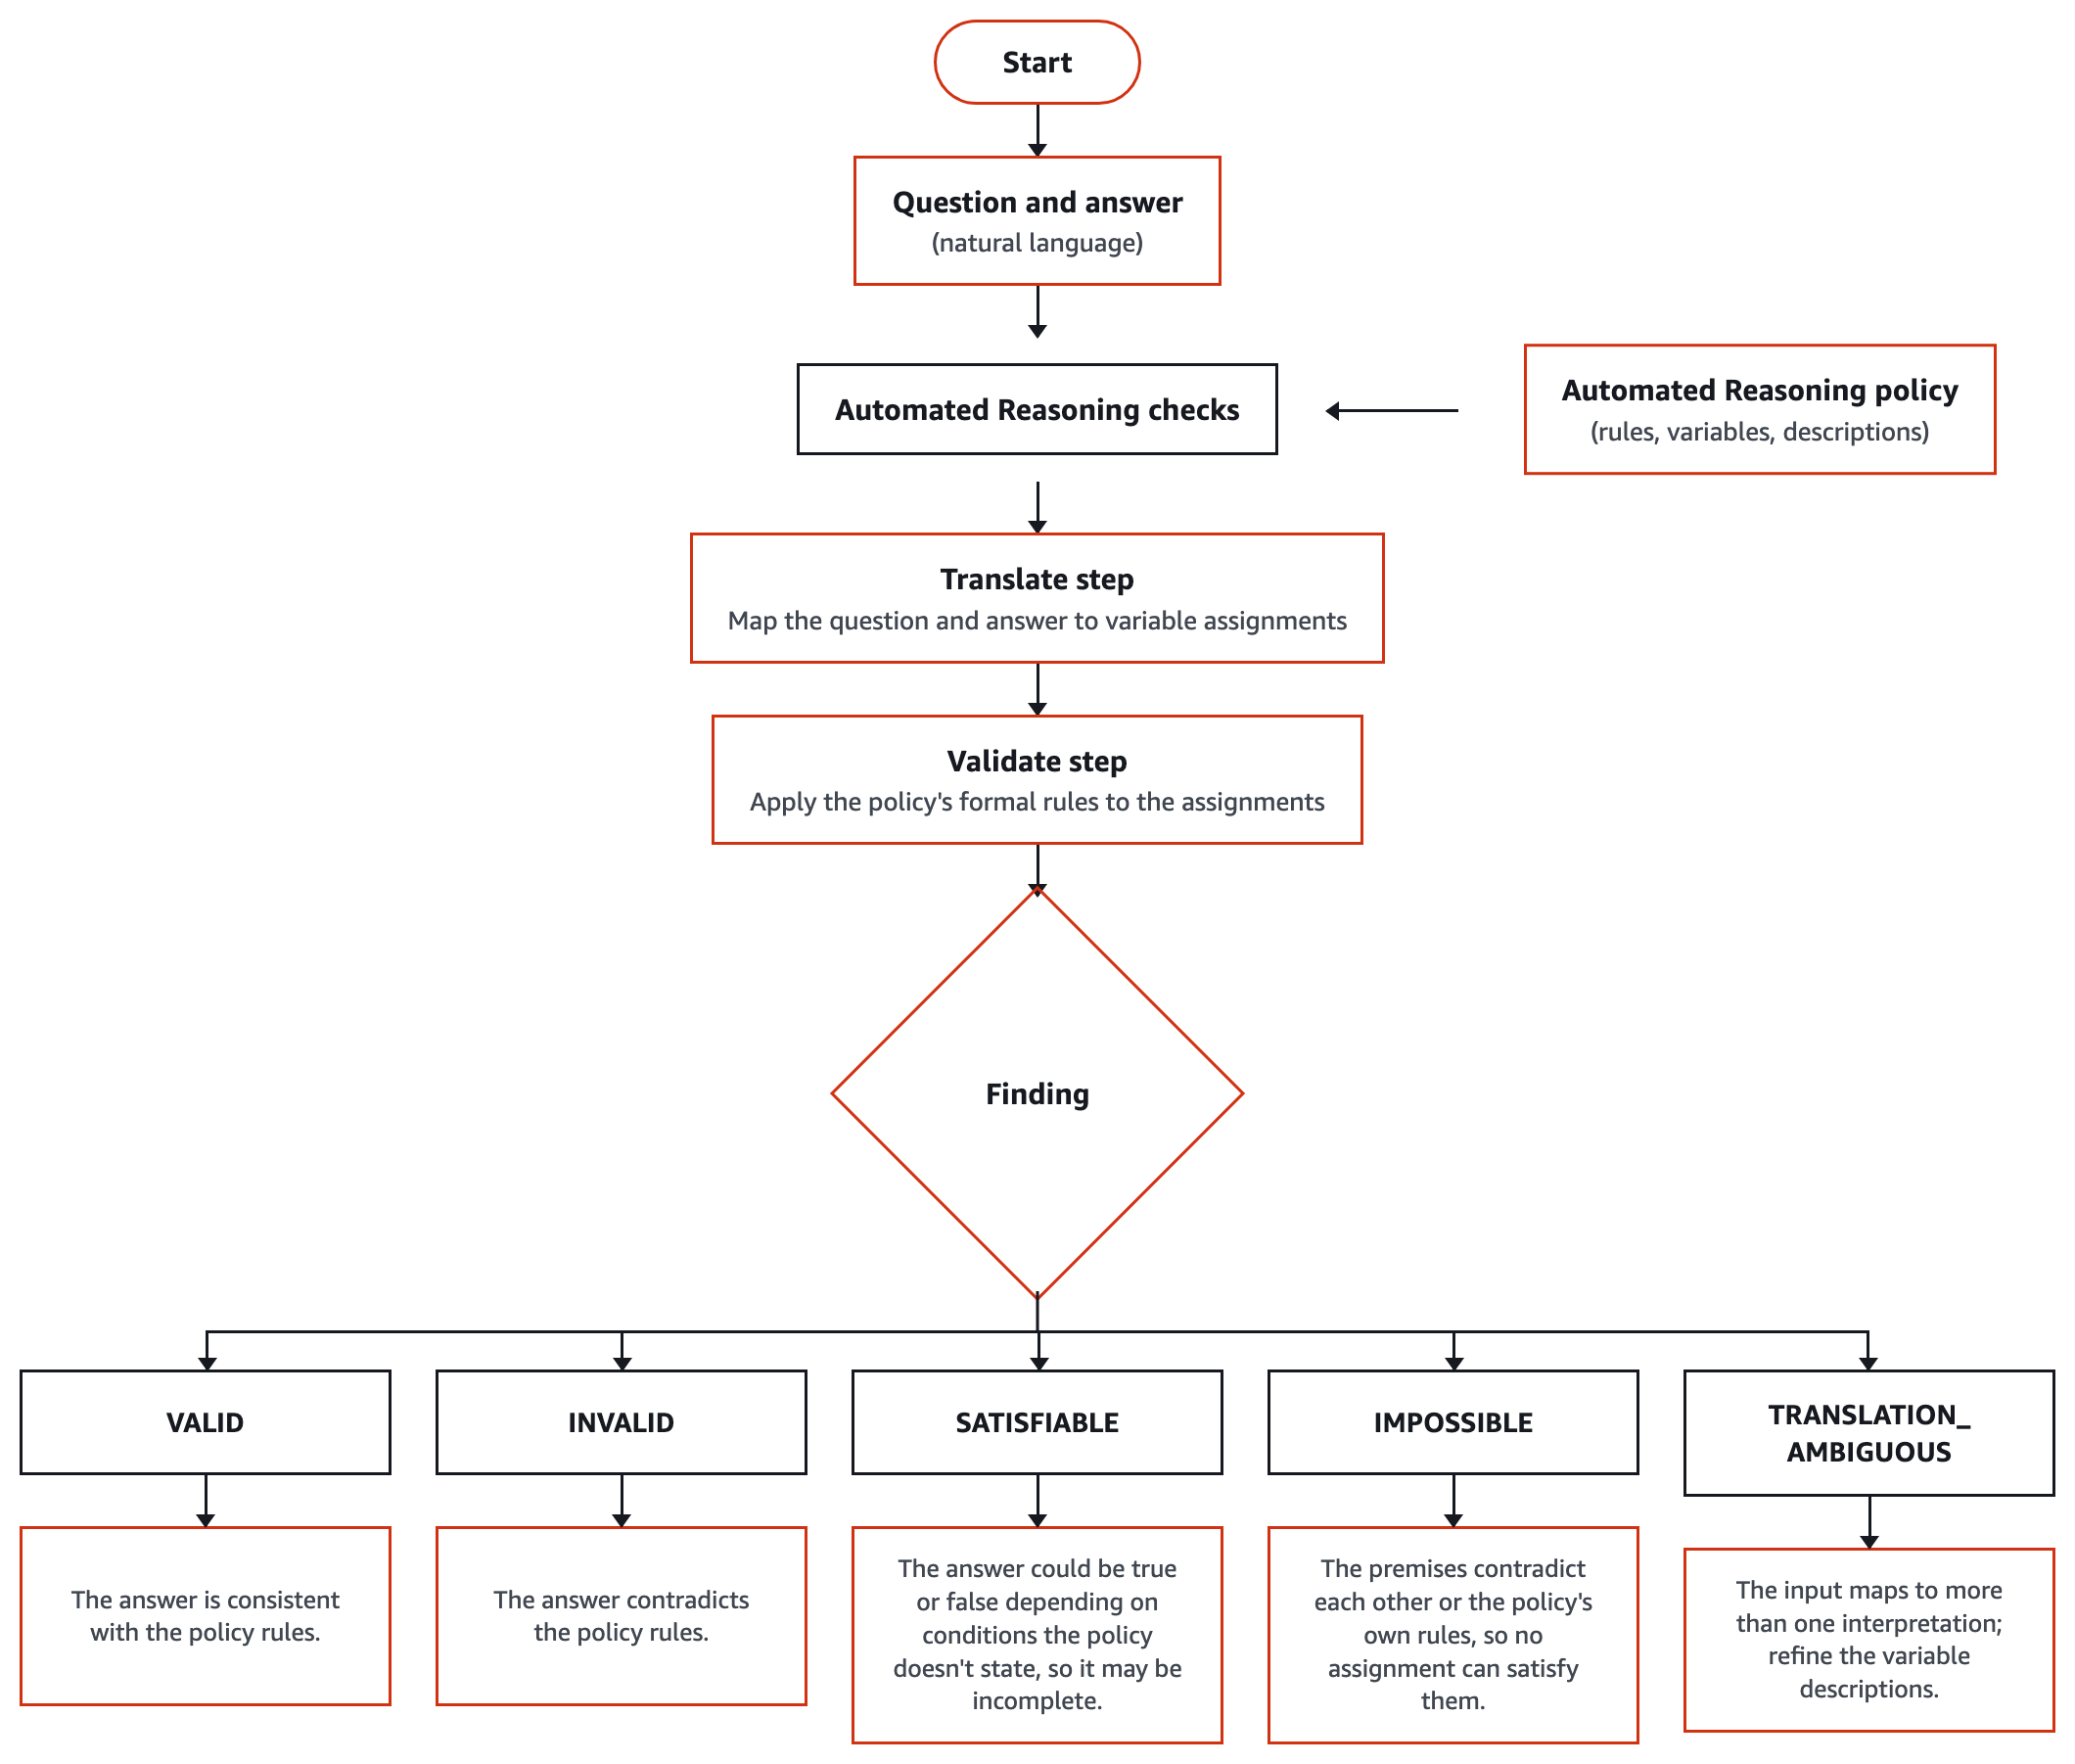
図 1: 自動推論チェックが実行時に応答を検証する仕組み。自動推論チェックは、ポリシーの変数の説明を使用して自然言語を変数に変換し、それらの変数をポリシーの形式ルールに照らして検証し、検出結果を返します。この 2 ステップのパイプラインがあるため、改善には 2 つのモードが存在します。
ポリシーのテスト。ポリシーにテストを追加して検証します。各テストは、入力/出力テキストと期待する結果で構成されます。テストは個別にも一括でも実行できます。失敗結果を見れば、ポリシーが意図からどこで逸脱しているかが正確にわかります。
ポリシーに改善が必要な理由: 2 つの失敗モード
2 ステップのパイプラインを思い出してください。変換 (自然言語から変数の割り当てへ) と、それに続く検証 (形式論理から検出結果へ) です。テストの失敗は、このいずれかのステップが予期しない結果を生成したことを意味します。自動推論チェックは、各ステップに明確に対応する 2 種類の失敗シグナルを提示します。
失敗モード 1: ルールの問題 (論理が誤っている)
ルールの問題による失敗では、変換は正しく機能しています。適切な変数に適切な値が入っているのに、検証結果が期待と一致しません。問題はルールにあり、ルールが緩すぎる、厳しすぎる、あるいはまったく存在しないというケースです。具体的には、不足しているルールや緩すぎるルールが誤った回答を通してしまい、INVALID を期待していたのに SATISFIABLE が返される場合です。逆に、過度に厳格なルールが正しい回答をブロックし、SATISFIABLE を期待していたのに INVALID が返される場合もあります。
考え方: システムは質問を完全に理解していたものの、誤った論理を適用しました。修正すべきなのはルールです。
失敗モード 2: 変換のあいまいさ (言語が誤っている)
テストが TRANSLATION_AMBIGUOUS を返す場合、検証エンジンは動作しますが、どの解釈に従うかによって結果が変わります。自然言語の入力をポリシーの変数にどうマッピングするかで変換モデル間の判断が分かれ、競合する各解釈がそれぞれ異なる検証結果につながるケースもあります。検出結果には、それぞれ独自の変換と結論を持つ 2 つ以上の選択肢が示され、さらに解釈が実際にどこで分かれるかを示す differenceScenarios も提示されます。よくある根本原因としては、変数定義の重複 (「tenure」と「years of service」など)、説明があいまいであること、値の形式が一貫していないこと (「5%」に対して 5 と 0.05 のどちらを使うかなど) が挙げられます。
失敗とモードの対応
次の表は、どの改善モードがどの失敗タイプに対応するかをまとめたものです。
| 失敗モード | 根本原因 | 改善モード | 動作内容 |
| ルールの問題 | 論理が誤っている | Iterative Refinement | ルールまたは変数の追加、編集、削除を提案する |
| 変換のあいまいさ | 言語があいまいである | Ambiguous Variable Refinement | 複数の解釈を 1 つにまとめる、より明確な変数の説明を提案する |
システムが単一の変換を決定できない場合は、Ambiguous Variable Refinement を使用します。続く 2 つのセクションでは、各モードについて、何をするのか、いつ使うのか、レビューゲートはどう機能するのか、そしてプログラムからどう起動するのかを順に説明します。ルールの問題による失敗のほうが多いため、まず Iterative Refinement から始めます。
Iterative Refinement: ルールの修正
論理が誤っているためにテストが失敗する場合 (変換は問題ないが検証結果が期待と一致しない場合)、問題はルールにあります。Iterative Refinement (ITERATIVELY_REFINE_POLICY) は診断と修正のサイクルを自動化するため、各ルールを手作業でたどり、修正内容を推測し、形式論理を手で編集する必要がなくなります。
10~30 個のルールを持つポリシーを考えてみましょう。従来は、1 つの修正のために、対象分野の専門家が手動で診断し、SMT-LIB で記述された形式論理を手作業で編集することを何度も繰り返す必要がありました。この作業は今では、レビューして承認するだけの 1 ステップに集約され、形式論理を手で書く必要はなくなります。
仕組み
Iterative Refinement は 3 つの入力を受け取ります。1 つ目は既存のポリシー定義 (現在のルール、変数、型) です。2 つ目は、本来どう動作すべきかを記述した信頼できる自然言語テキストを含むソースドキュメントです。3 つ目の入力は任意で、望む変更を明示的に指示する自然言語のフィードバックです。
例えば、フィードバックフィールドには次のような内容を記述できます。「改訂版ドキュメントのセクション 3 に規定されているとおり、育児休暇の勤続期間要件を 12 か月から 6 か月に更新してください」。
これらの入力を受けて、改善エンジンは現在のルールがソースドキュメントとフィードバックからどのように逸脱しているかを分析します。そして、ポリシーを整合させる一連の変更候補 (新しいルール、編集されたルール、追加された変数) を提案します。
収束ループ
Iterative Refinement は名前が示すとおり反復処理を行います。内部では、エンジンが変更候補を生成し、保存済みのテストへの影響をシミュレートし、これまで失敗していたテストが合格するようになったかを確認し、そうでなければ調整します。1 回のリクエストで複数の内部サイクルが発生することもあります。特に、1 つのルールの修正が他のルールに波及する場合にそうなります。ただし、この反復は内部的に行われます。中間段階の試行は 1 つずつ表示されず、進行を管理する必要もありません。受け取るのは収束後の結果、つまりどのルールが変わり、どの変数が変わり、その変更がテストスイート内のすべてのテストにどう影響するかを正確に示す差分案です。
レビューゲート
収束後、[Review policy changes] 画面が表示されます。
次に、[Accept changes] または [Discard changes] を選択します。承諾すると、変更が DRAFT ポリシーに書き込まれます。破棄すると、すべてが元のまま維持されます。
前提条件と使用する場面
Iterative Refinement では、ポリシーに少なくとも 1 つのテストが追加されている必要があります。失敗したテストのシグナルがなければ、改善の手がかりが得られないからです。このモードは、変換が正しい (適切な変数と適切な値) にもかかわらず検証結果が予期しないものである場合に使用します。検出結果が TRANSLATION_AMBIGUOUS の場合には使用しないでください。それは言語の問題であり、Ambiguous Variable Refinement で対処するほうが適切です。
API からの実行
改善処理は非同期のビルドワークフローとして実行されます。AWS SDK for Python (Boto3) を使用する場合、フローは 4 つのステップで構成されます。現在のポリシー定義をエクスポートし、ワークフローを開始し、完了をポーリングし、提案された変更を取得します。buildWorkflowType には ITERATIVELY_REFINE_POLICY を設定します。
iterativeRefinementContent ブロックは、1~5 個のソースドキュメント (必須) と、最大 4,000 文字の任意のフィードバックを受け取ります。
この呼び出しは、提案された変更ではなく buildWorkflowId を即座に返します。ワークフローは SCHEDULED から BUILDING へ移行し、最終的に COMPLETED、FAILED、または CANCELLED に到達します。収束にかかる時間はポリシーのサイズに応じて通常 1 分から数分です。ステータスが終端状態に達するまで get_automated_reasoning_policy_build_workflow をポーリングします。その後、get_automated_reasoning_policy_build_workflow_result_assets で収束した提案を取得します。更新されたルールを確認するには POLICY_DEFINITION アセットを、アクションログを確認するには BUILD_LOG をリクエストします。
返されるポリシー定義は提案された DRAFT であり、新しい定義の全体です。これをコミットするには、この定義を指定して update_automated_reasoning_policy を呼び出します。何が変わったかを確認するには、ワークフローを開始する前にエクスポートしたポリシー定義との差分を取ります。コンソールの [Review policy changes] 画面は、この開始・ポーリング・取得という同じ手順をラップし、[Accept changes] ボタンと [Discard changes] ボタンで操作できるように差分を表示しています。
Ambiguous Variable Refinement: 言語の修正
Iterative Refinement はルールの問題に対応しますが、失敗するテストのすべてがルールの問題であるとは限りません。変換そのものが不安定な場合、ルールをいくら編集しても解決しません。この場合は、ポリシーが変数を説明するために使っている言語を修正する必要があります。それを行うのが Ambiguous Variable Refinement です。このモードも同じ非同期の開始・ポーリング・取得パターンに従い、同じレビューと承諾の画面に到達します。違いは提案内容です。提案は変数の説明とマージを中心とし、ポリシーの一貫性を保つために必要に応じてルールと型の更新も適用されます。
テストが TRANSLATION_AMBIGUOUS の結果を生成する場合 (この記事の前半にある失敗モード 2 を参照してください)、競合する変換が異なる検証結果につながっています。あいまいさは、検証対象のコンテンツ自体の表現方法から生じることもあります。このセクションでは、ポリシー変数におけるあいまいさに焦点を当てます。
仕組み
ポリシー変数の問題に起因する変換のあいまいさは、通常いくつかの根本原因から生じます。重複する変数は、2 つの変数が同じ概念を記述している場合に発生します。例えば、tenureMonths (「従業員が何か月働いているか」) と monthsOfService (「従業員の勤続月数」) はどちらも雇用期間をとらえています。その結果、どちらを使うべきかについて、変換モデル間で判断が分かれます。説明が不完全なケースは、変数の説明があいまいすぎて変換を導けないときに起こります。値の形式が一貫していないケースでは、「5%」を interestRate = 5 とすべきか interestRate = 0.05 とすべきかをシステムが判断できず、あいまいさが生じます。変数名に論理が埋め込まれていると混乱を招きます。timelyReportingNotFeasible のような名前は既に否定を含んでいるため、肯定のケースを表現するには否定の否定が必要になります。変換モデルはしばしばこの 2 つの否定のうち 1 つを取りこぼします。
これらは最も一般的なパターンにすぎません。検出は既知の問題の固定リストと照合するのではなく、ポリシーの変数を実際に変換で使用して行われるため、変換の不一致を引き起こす変数レベルの問題は、ここに挙げた以外のものも表面化し得ます。
Ambiguous Variable Refinement を実行すると、どの変数の説明や重複する定義が不一致の原因になっているかを特定し、複数の解釈を 1 つの正確な定義にまとめる、改善された説明を提案します。
改善された説明には、単位変換のルール、同義語、別の表現、明示的な形式のガイダンスが盛り込まれます。次のビフォー/アフターの例は、典型的な提案を示しています。
| 変更前 | 変更後 (提案) |
| tenureMonths: 「従業員が何か月働いているか」 | tenureMonths: 「従業員が継続して雇用されている期間の月数 (1 か月未満の端数は含めません)。ユーザーが勤続年数に言及した場合は月数に変換します (例: 2 年 = 24 か月)。この変数は、雇用期間、勤続期間、在社期間、または勤続年数への言及をとらえます」 |
重複する変数が検出された場合は、マージも提案されることがあります。一方の変数が削除され、それを参照するルールは残った変数を使用するように更新されます。
レビューゲート
Iterative Refinement と同様に、何も適用される前に提案された変更をレビューします。
また、[Test results] も表示されます。以前は TRANSLATION_AMBIGUOUS を返していたテストが、確定的な VALID、INVALID、または SATISFIABLE の結果を生成するようになります。[Accept changes] または [Discard changes] を選択します。承認するまで、DRAFT ポリシーには一切の変更が加えられません。
使用する場面
Ambiguous Variable Refinement は、テストが TRANSLATION_AMBIGUOUS の結果を生成する場合、または VALID/INVALID の検出結果を確認したときに、変換が誤った変数に値を割り当てていることが判明した場合に使用します。変換が正しいのに検証結果が予期しないものである場合には使用しないでください。それはルールの問題であり、Iterative Refinement の対象です。
API からの実行
Ambiguous Variable Refinement は、同じ非同期の開始・ポーリング・取得パターンを使用します。buildWorkflowType には RESOLVE_POLICY_AMBIGUITIES を設定します。このモードはポリシーの変数を直接分析するため、ソースドキュメントも追加済みのテストも必要とせず、workflowContent は省略できます。ただし、現在のポリシー定義は sourceContent に引き続き必要です。Iterative Refinement の場合と同様に、前述の export_automated_reasoning_policy_version を使ってまずエクスポートしてください。
Iterative Refinement と同様に、レスポンスは buildWorkflowId です。ステータスが終端状態に達するまで get_automated_reasoning_policy_build_workflow をポーリングします。その後、get_automated_reasoning_policy_build_workflow_result_assets を assetType="POLICY_DEFINITION" とともに呼び出して、提案された変数の説明とマージを取得します。
承諾するまで、変更は提案の状態にとどまります。
すべての変更はお客様が承認: ヒューマンインザループのゲート
両方の改善モードには、譲れない共通の性質が 1 つあります。お客様が承認するまで、いかなる変更も反映されません。改善エンジンが持つのは提案する権限で、分析し、診断し、提案できます。お客様が持つのはコミットする権限です。DRAFT ポリシー、ひいては本番環境に何を反映するかを決めるのはお客様です。
5 ステップのループ
どの改善モードを使用する場合も、ワークフローは同じ 5 ステップのパターンに従います。第 1 にテストです。保存済みのテストを現在のポリシーに対して実行します。第 2 に確認です。どのテストが期待した結果と一致しないかを特定します。第 3 に提案です。システムがルールまたは変数の説明に対する修正候補を生成します。第 4 にレビューです。提案された差分とテストへの影響を確認します。第 5 に適用です。変更を承諾して DRAFT に適用するか、拒否して何も変更しないかを選びます。
承諾した後は、他のテストを壊さずに問題が解決したことを確認するため、再テストを行います。このようにして、各サイクルの進展が後戻りせずに積み重なっていきます。サイクルごとに、テストに合格するポリシーに近づくか、新たな診断情報が得られるかのいずれかです。
レビュー画面で確認できる内容
レビュー画面では、変更内容そのものだけでなく、その変更の波及効果を把握できます。この画面は 2 つの問いに同時に答えます。エンジンは何を提案したのか、そしてその提案は、重視しているすべてのテストにどう影響するのかです。
提案は 3 つのセクションで示されます。[Changes to rules] には、追加、編集、削除されたルールが、それぞれの形式論理の式とともに一覧表示されます。[Changes to variables] には、更新された変数の説明と、追加または削除された変数が表示されます。変更前の文言と提案された文言が並べて示されるため、両者を直接比較できます。[Changes to custom variable types] は、ポリシーの列挙型に対する変更を扱います。
これらの変更とあわせて、画面には [Test results] セクションが表示され、保存済みのテストとその変更前後の結果が一覧化されます。各行には期待される検出結果と、変更前後でテストが合格したかどうかが示されます。行の [View findings] を選択すると、検出結果そのものを確認できます。このビューは画面上で最も重要な指標です。失敗していたテストが合格し、合格していたテストが引き続き合格しているのであれば、安心して承諾できます。
Fidelity Report による検証
変更を適用した後は、Fidelity Report (忠実度レポート、GENERATE_FIDELITY_REPORT) を生成し、更新後のポリシーがソースドキュメントを引き続き忠実に表現しているかを検証します。このレポートは 3 つの測定値を提供します。カバレッジスコア (0.0~1.0) は、ソースドキュメントのどれだけがポリシーに反映されているかを示します。精度スコア (0.0~1.0) は、ルールが元のドキュメントの意図にどれだけ忠実に一致しているかを示します。ルールごとのグラウンディングは、各ルールを、その裏付けとなるソースドキュメント内の具体的な記述に、根拠とともに結び付けます。
改善の前後で Fidelity Report を比較してください。精度スコアが低下している場合、提案された修正がソース資料から逸脱している可能性があり、拒否するかさらに反復すべきというシグナルになります。
原則
自動改善が加速するのは、失敗を診断し修正候補を生成する作業です。ただし、ガードレールが適用するルールを変更する権限は、引き続きお客様が保持します。すべての修正は、お客様が承諾すると決めるまで提案のままです。
エンジンの方向付け: ソースドキュメントとカスタムフィードバック
適切な修正へより早くたどり着けるようコンテキストを提供すれば、両方のモードを望む方向に導けます。
ソースドキュメント
Iterative Refinement を起動するときは、ポリシーが表現すべきグラウンドトゥルースを表すソースドキュメントを指定します。コンソールでは、そのための 3 つのモードが用意されています。[Recently used] は以前にアップロードしたドキュメントを再選択し、[Upload] は新しい PDF またはテキストファイルを受け取り、[Enter text] は貼り付けたコンテンツを直接受け取ります。ドキュメントが明確で焦点が絞られているほど、提案も正確になります。
カスタムフィードバック: 明示的な if-then ガイダンス
何を修正すべきかをシステムに正確に伝える自然言語のフィードバックを提供することもできます。効果的なフィードバックは具体的で検証可能です。「勤続期間のルールを修正してください」のようなあいまいなフィードバックは、エンジンに過大な裁量を与えてしまいます。次のような具体的で検証可能な代替案と比べてみてください。「従業員がフルタイムで、6 か月 (12 か月ではなく) を超えて勤務している場合、育児休暇の対象となるべきです」。
フィードバックは制約として機能します。システムは、ソースドキュメントとガイダンスの両方を満たす変更を生成します。両者が矛盾する場合は、その矛盾がレビュー用にフラグ付けされます。
ソースドキュメントとフィードバックを同時に指定することもできます。ドキュメントの情報量が多い場合、フィードバックによって重要な特定のセクションにシステムの注意を集中させられます。
エンドツーエンドのウォークスルー
このセクションでは、各改善モードに対応する 2 つのウォークスルーを紹介します。この 2 つを合わせることで、両方の失敗タイプに対する再現可能なワークフローが得られます。
前提条件
Amazon Bedrock の自動推論チェックでポリシーの自動改善を使用するには、次の前提条件を満たしていることを確認してください。
- 有効な AWS アカウント
- 自動推論チェックが利用可能な AWS リージョンの確認と、そのいずれかのリージョンにおける Amazon Bedrock へのアクセス
訳注: 2026 年 9 月現在、自動推論チェックがサポートする言語は英語です。最新の対応状況は、Amazon Bedrock ユーザーガイドの「Amazon Bedrock ガードレールの自動推論チェックとは」を参照してください。 - 自動推論ポリシーを作成、表示、改善し、Amazon Bedrock Guardrails を操作するための IAM アクセス許可
- 強制したいルールを記述したソースドキュメントから作成された、アカウント内の自動推論ポリシー。手順の詳細については、「自動推論ポリシーを作成する」を参照してください。このポリシーには少なくとも 1 つのテストが追加されている必要があります。Iterative Refinement は診断を進めるために失敗したテストのシグナルを必要とします。テストを追加するには、「自動推論ポリシーをテストする」を参照してください。
ウォークスルー A: Iterative Refinement によるルールの問題の修正
休暇の取得資格を定める人事ポリシーに、失敗するテストがあります。アシスタントは、勤続 8 か月のパートタイム従業員が育児休暇の対象になると回答します。テストは INVALID を期待していますが、ポリシーは VALID を返します。
ステップ 1: テストを検証する
- Amazon Bedrock コンソールで [Automated Reasoning] に移動し、ポリシーを開きます。
- [Tests] タブを選択し、次に [Validate all tests] を選択します。図 2 に結果を示します。4 つのテストのうち 3 つは合格し、育児休暇のテストは予期しない
VALIDの検出結果で失敗します。
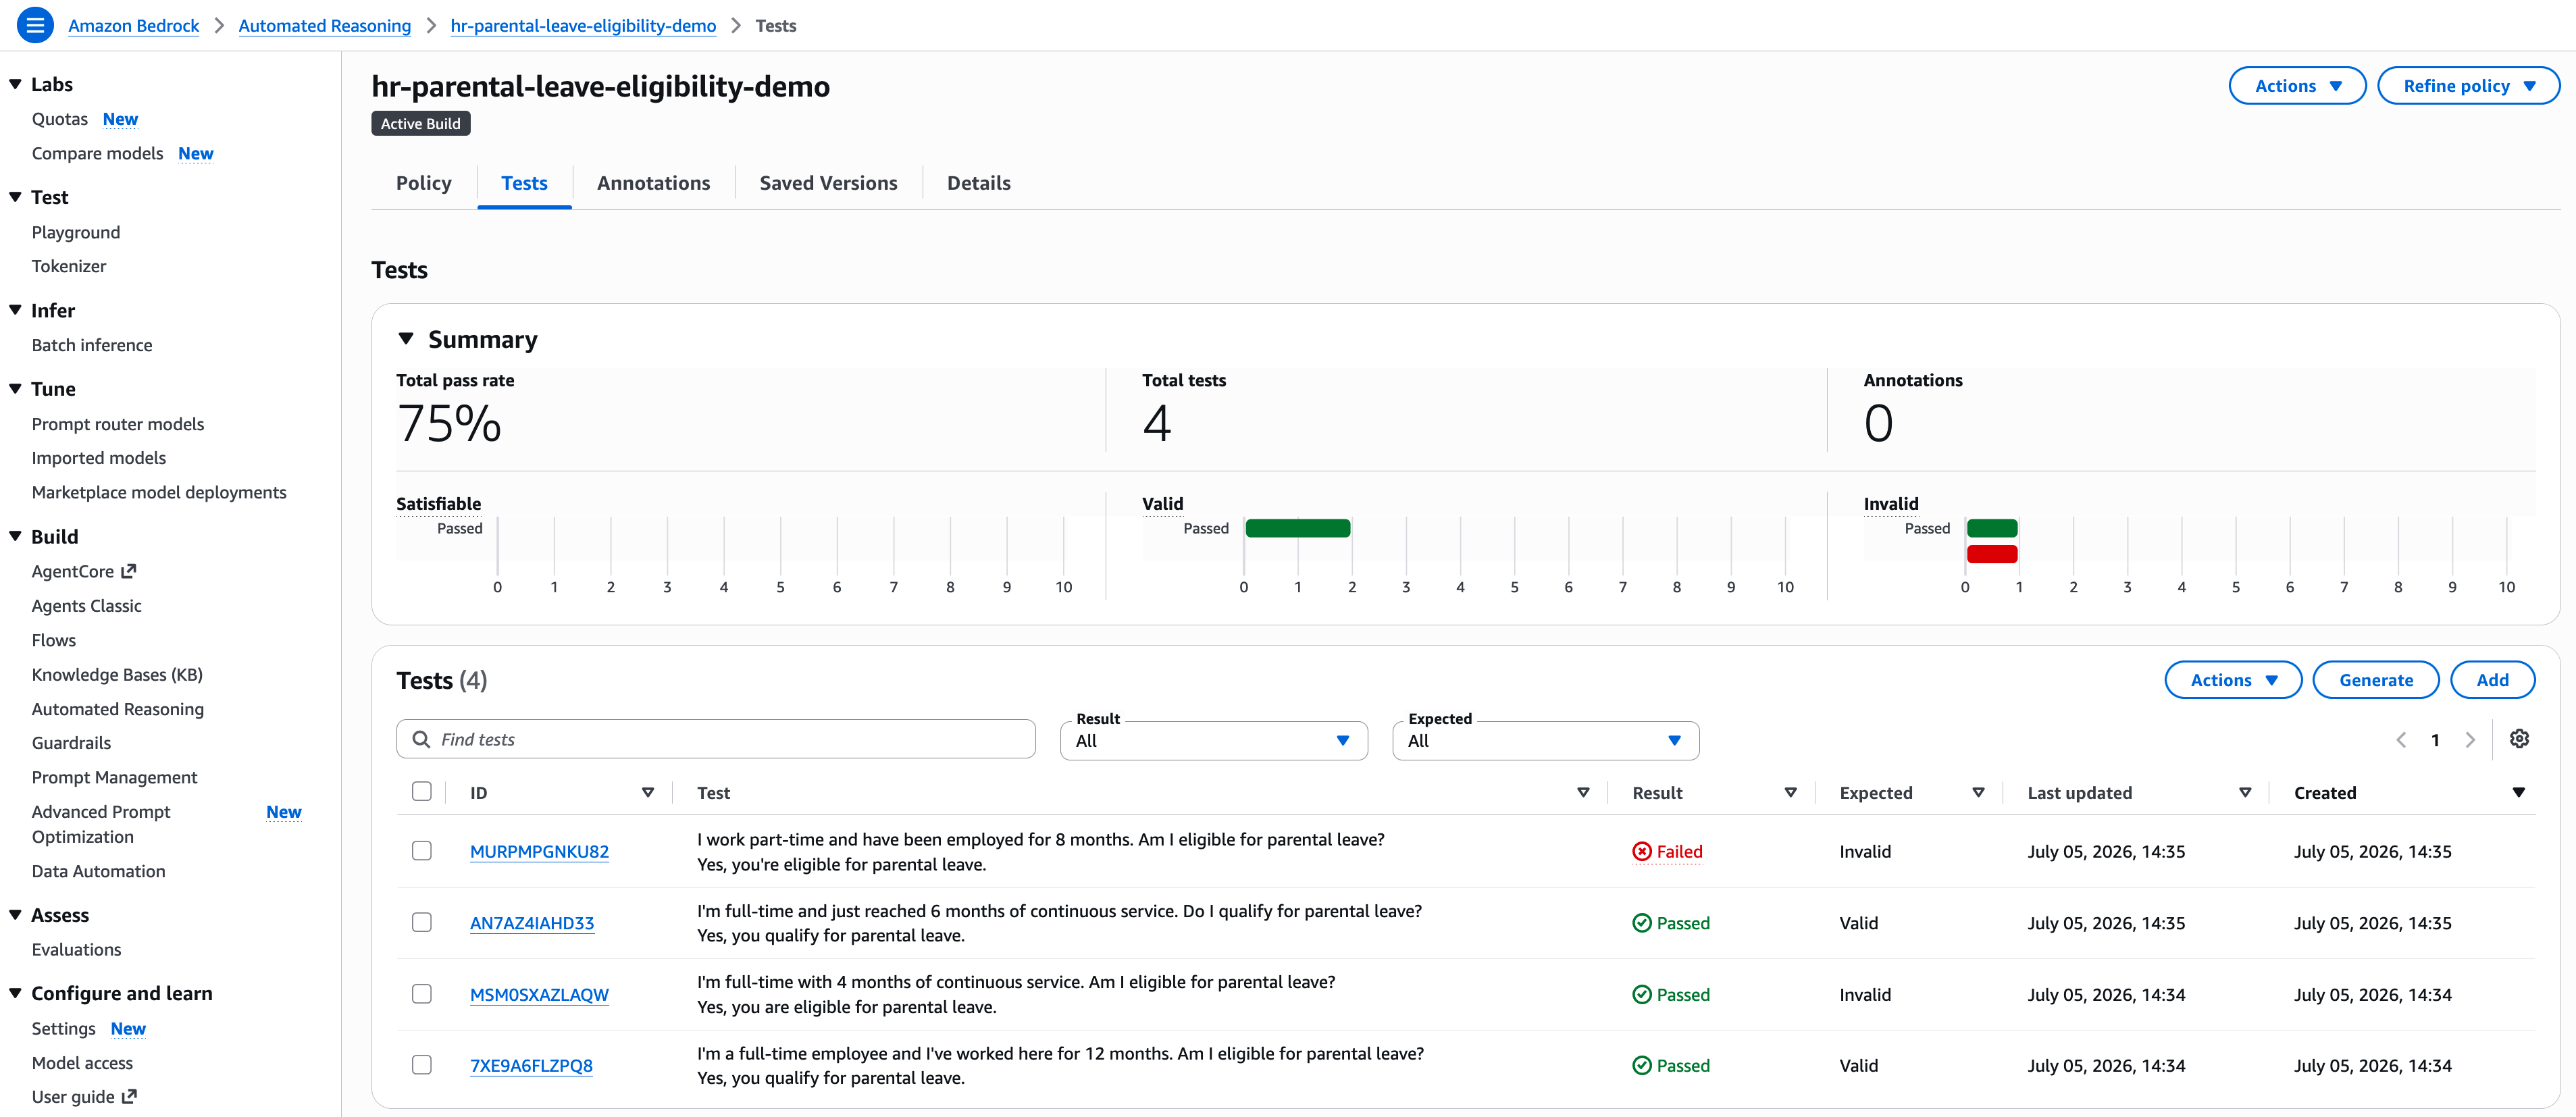
図 2: 検証後の [Tests] タブ。4 つのテストのうち 3 つが合格 (75%)
ステップ 2: 失敗した検出結果を確認する
- 失敗したテストの検出結果を開き、図 3 に示す変換内容を確認します。変数は正しくとらえられています。
- monthsOfContinuousService = 8
- employmentStatus =
PART_TIME
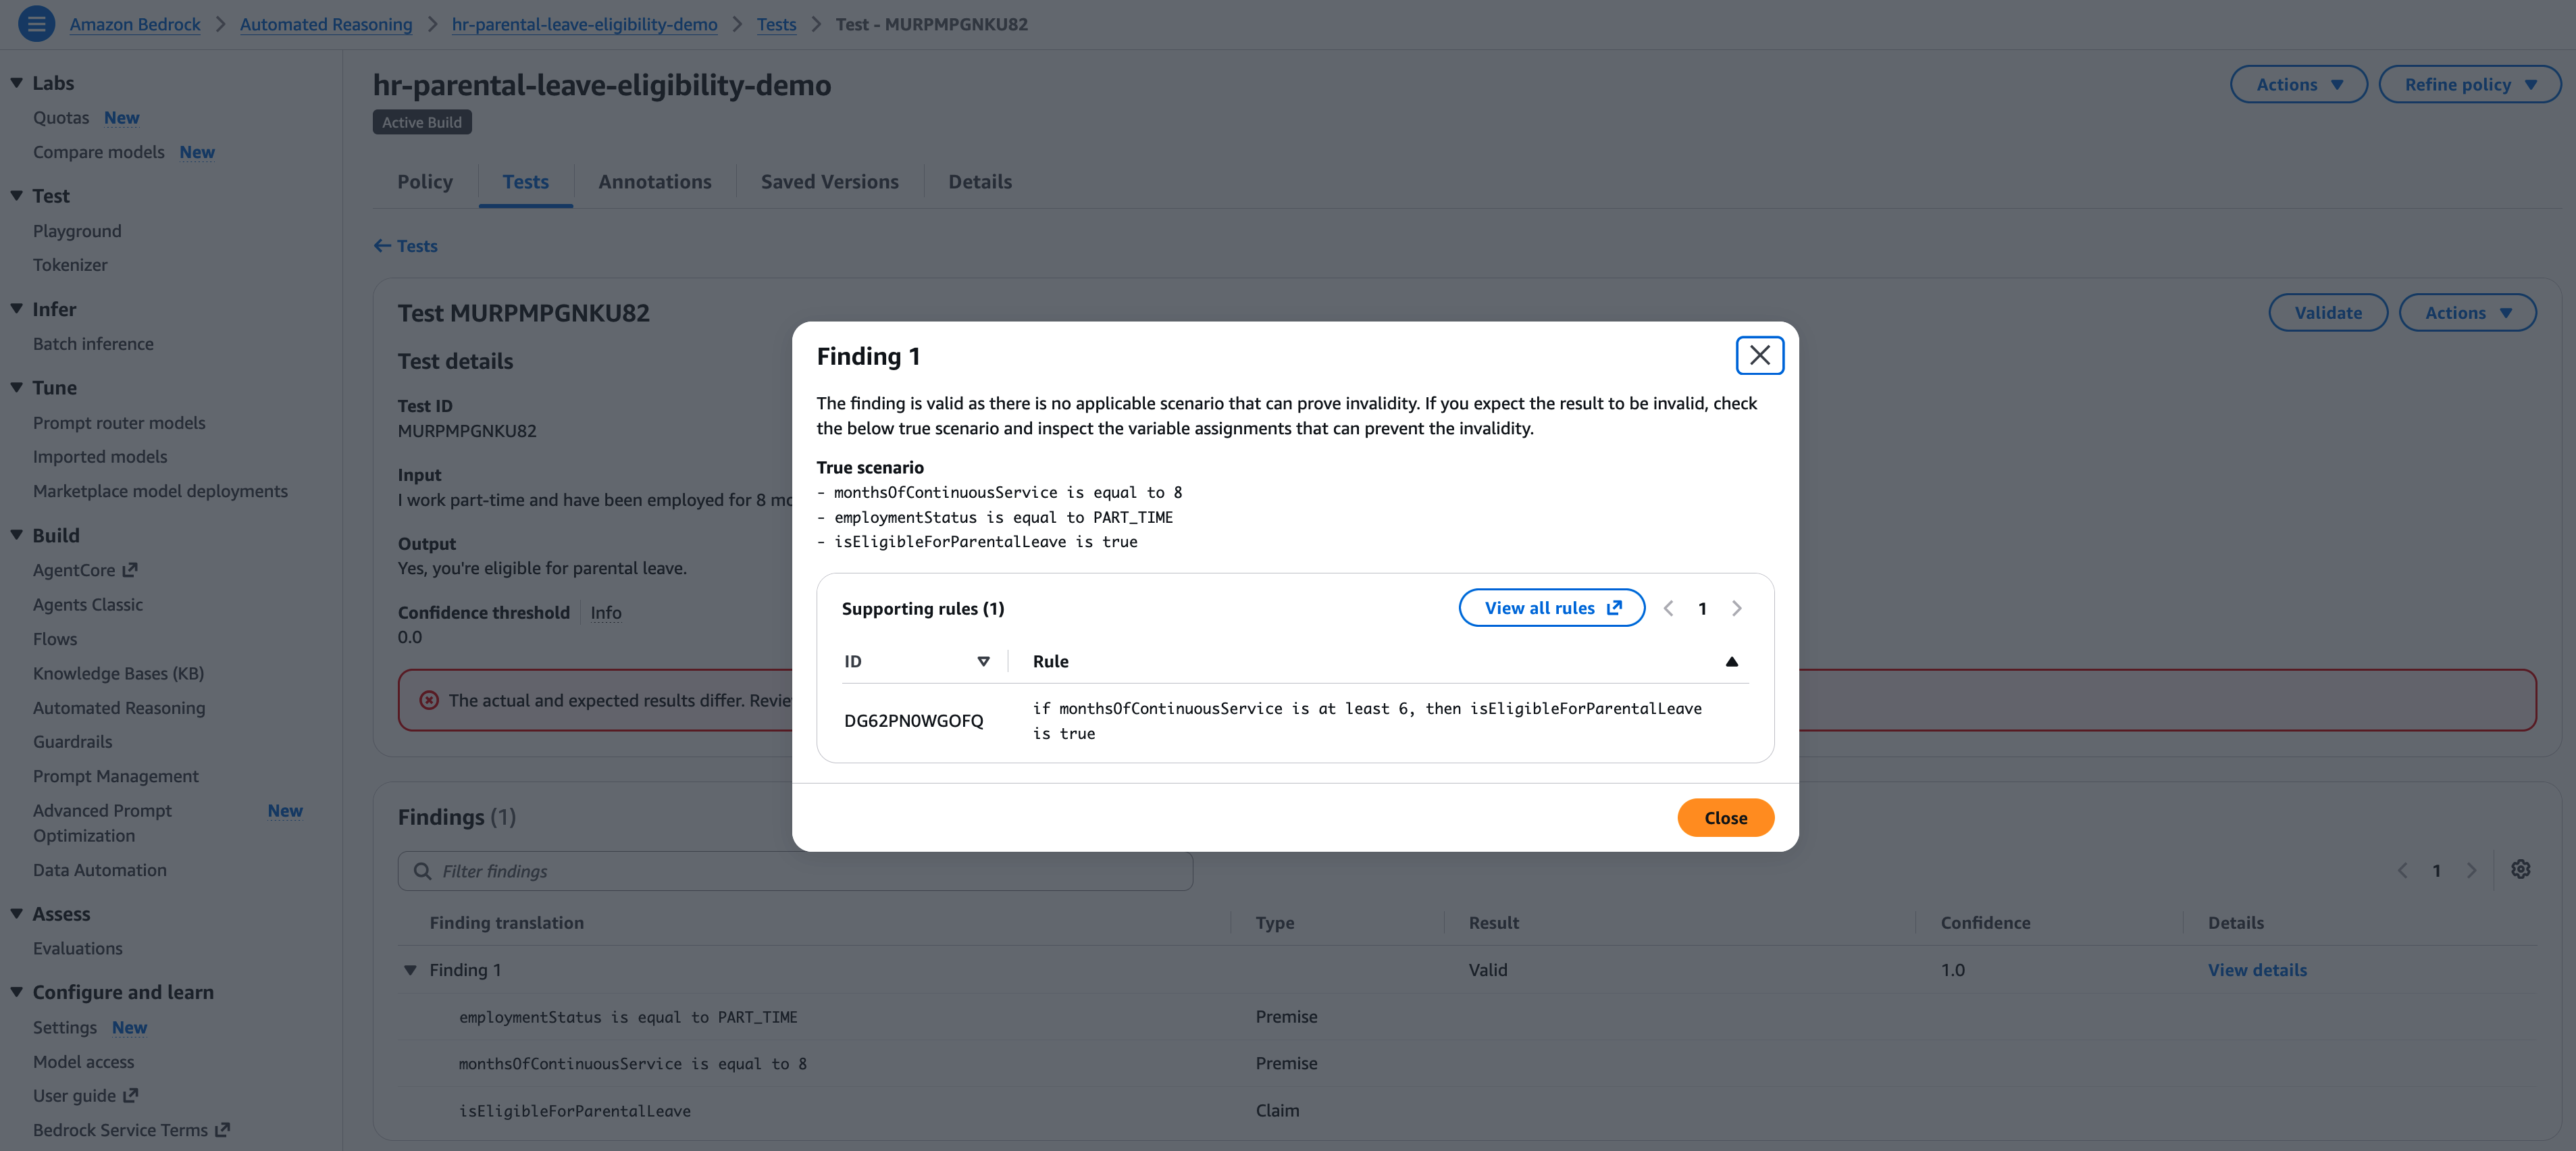
図 3: 失敗したテストの検出結果。変換が変数を正しくとらえていることがわかる
検出結果が VALID となっているのは、根拠となる唯一のルールが継続勤務 6 か月後に資格を付与しており、パートタイム従業員を除外するルールが存在しないためです。変換に問題はなく、論理が誤っているため、これはルールの問題です。
ステップ 3: ポリシーを改善する
- [Refine policy] を選択し、次に [Automatically refine policy] を選択します。
- 改善タイプを Iterative Refinement に設定します。
- 次の 3 つのモードのいずれかを使用して、ソースドキュメントを指定します。
- [Recently used]
- [Upload] (新しいバージョンをアップロード)
- [Enter text] (該当する段落を貼り付ける)
- 必要に応じて、修正の焦点を絞るためのカスタムフィードバックを追加します。例: 「パートタイム従業員を育児休暇の対象外とすることを明示するルールを追加してください」。
- 入力の準備ができたら、[Start] を選択します。
図 4 は、改善タイプを選択し、ソースドキュメントを添付し、カスタムフィードバックを入力した設定完了時の状態を示しています。
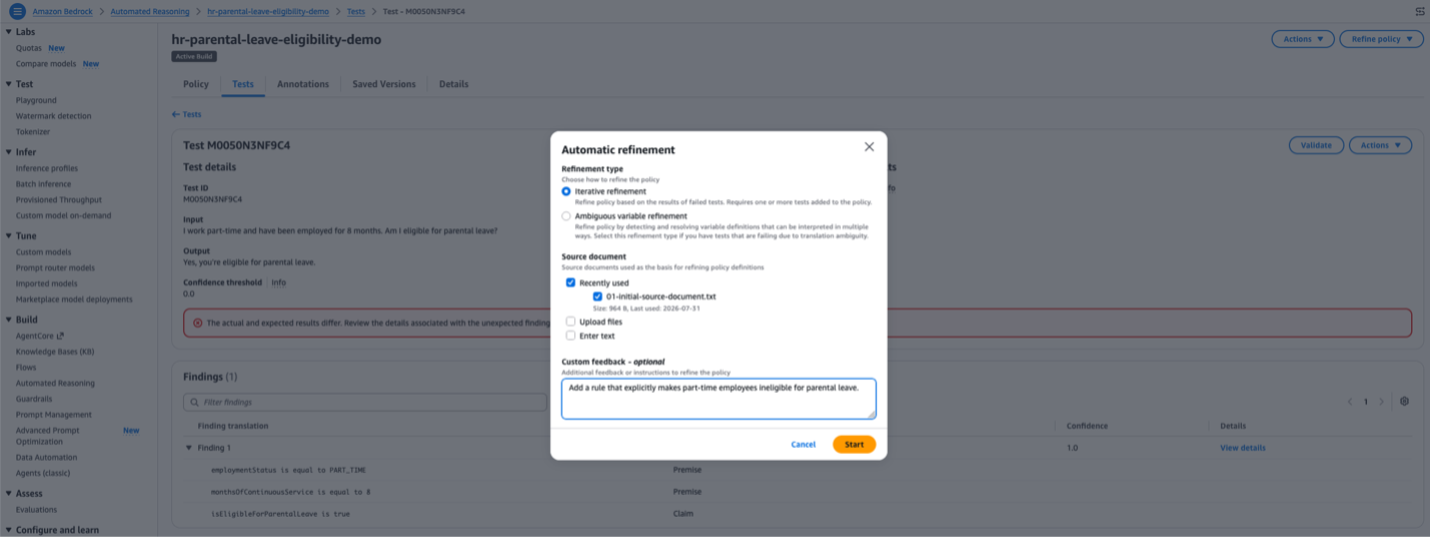
図 4: ソースドキュメントとカスタムフィードバックを指定した Iterative Refinement の設定
ステップ 4: 変更をレビューして承諾する
- 収束が完了すると、[Review policy changes] 画面が表示されます。[Changes to rules] には、削除されたルール 1 件と追加されたルール 1 件の 2 つの変更が一覧表示されます。エンジンは、継続勤務のみで資格を付与していたルールを削除しました。
-
monthsOfContinuousServiceが 6 以上の場合、isEligibleForParentalLeaveはtrueになります
そして、パートタイム従業員を除外するルールを追加しました。
-
employmentStatusがPART_TIMEと等しい場合、isEligibleForParentalLeaveは false になります
-
[Test results] では、パートタイムのテストが [Failed] から [Passed] に変わり、他の 3 つのテストは [Passed] のままです。図 5 は承諾前の画面を示しています。
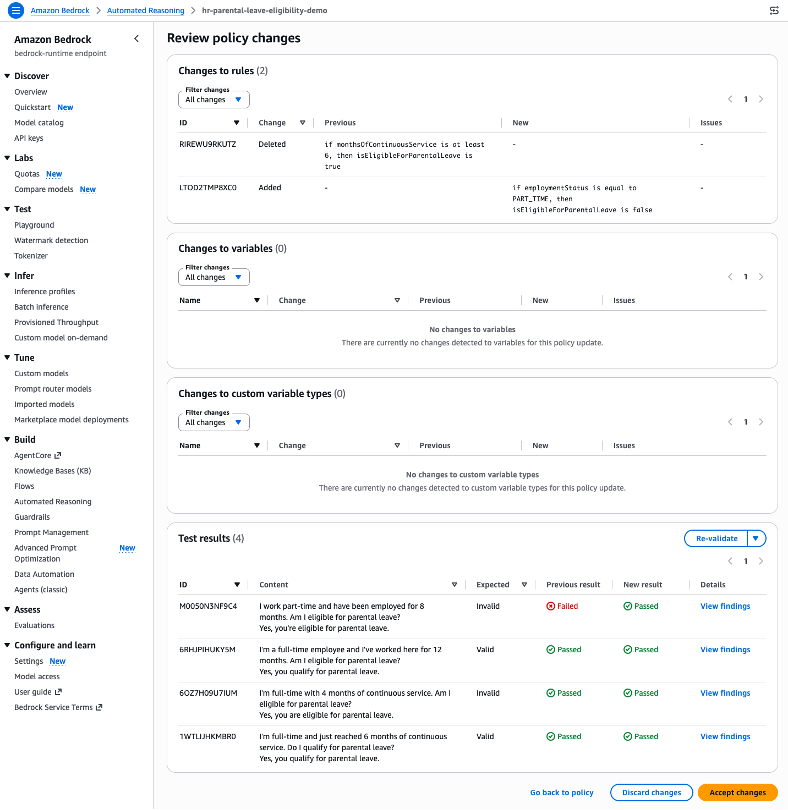
図 5: [Review policy changes] 画面。[Changes to rules] には、削除された勤続期間のみによる資格ルールと、追加されたパートタイム除外ルールが一覧表示され、[Test results] にはパートタイムのテストが Failed から Passed に変わり、リグレッションがないことが示されています。
- [Accept changes] を選択します。
ステップ 5: 修正を確認する
- [Tests] タブに戻り、再度 [Validate all tests] を選択します。
- 図 6 に期待される結果を示します。これまで失敗していたテストが合格し、合格率は 100% に達します。
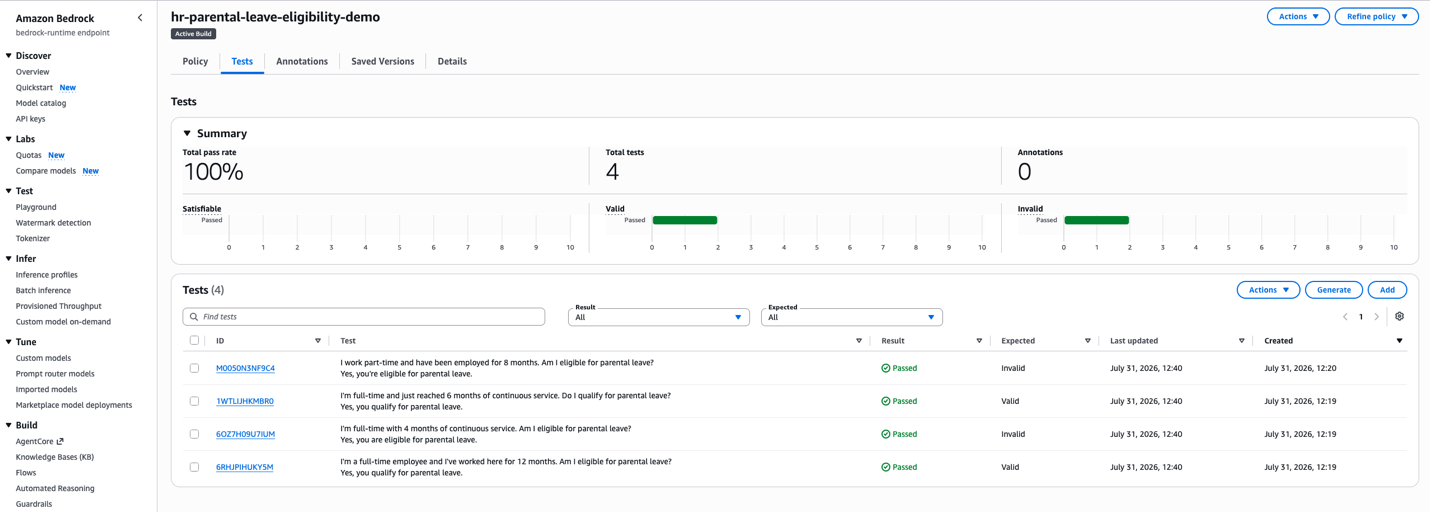
図 6: 改善後の [Tests] タブ。4 つのテストすべてが合格 (100%)
テストが引き続き失敗する場合やリグレッションが発生した場合
1 回の改善サイクルですべての失敗が解消されることや、リグレッションが発生しないことは保証されません。これまで失敗していたテストが依然として失敗する場合、または以前は合格していた他のテストが失敗するようになった場合は、次の手順を行ってください。
- レビュー画面で [Discard changes] を選択します。
- エンジンが前回とは異なる形で何を修正すべきかを説明する、より具体的なカスタムフィードバックを追加します。例: 「このルールは、パートタイム従業員の資格期間を短縮するだけで済ませず、育児休暇の対象から完全に除外すべきです」。
- ソースドキュメントを、失敗しているルールに対応する正確なセクションに絞り込みます。
- これらの絞り込んだ入力で、再度 Iterative Refinement を実行します。
2 回か 3 回試してもテストが合格しない場合は、手作業による編集に切り替えてください。失敗した検出結果の変換内容とルールのトレースを手がかりに、ポリシーエディタで該当するルールを手で編集します。
ステップ 6: レポートを生成してデプロイする
- [Generate Fidelity Report] を選択し、前回のレポートとスコアを比較します。
- 結果に問題がなければ、デプロイ用に番号付きバージョンを作成します。
ウォークスルー B: Ambiguous Variable Refinement による言語の問題の修正
同じ人事ポリシーを使いますが、今回はテストが TRANSLATION_AMBIGUOUS を返します。検出結果には 2 つの選択肢が示されます。
- 一方は「2 years of service」を tenureMonths = 24 と解釈しました。
- もう一方は monthsOfService = 24 と解釈しました。
この 2 つの選択肢から、変数の重複が明らかになります。tenureMonths と monthsOfService はどちらも雇用期間を記述しており、どちらを使うべきかについて変換モデル間で判断が一致しません。この重複があいまいさの根本原因です。
ステップ 1: ポリシーを改善する
- [Refine policy] を選択し、次に Ambiguous Variable Refinement を選択します。
- 図 7 に示すように、このモードではソースドキュメントは必要ないため、設定は 1 つの選択だけで完了します。
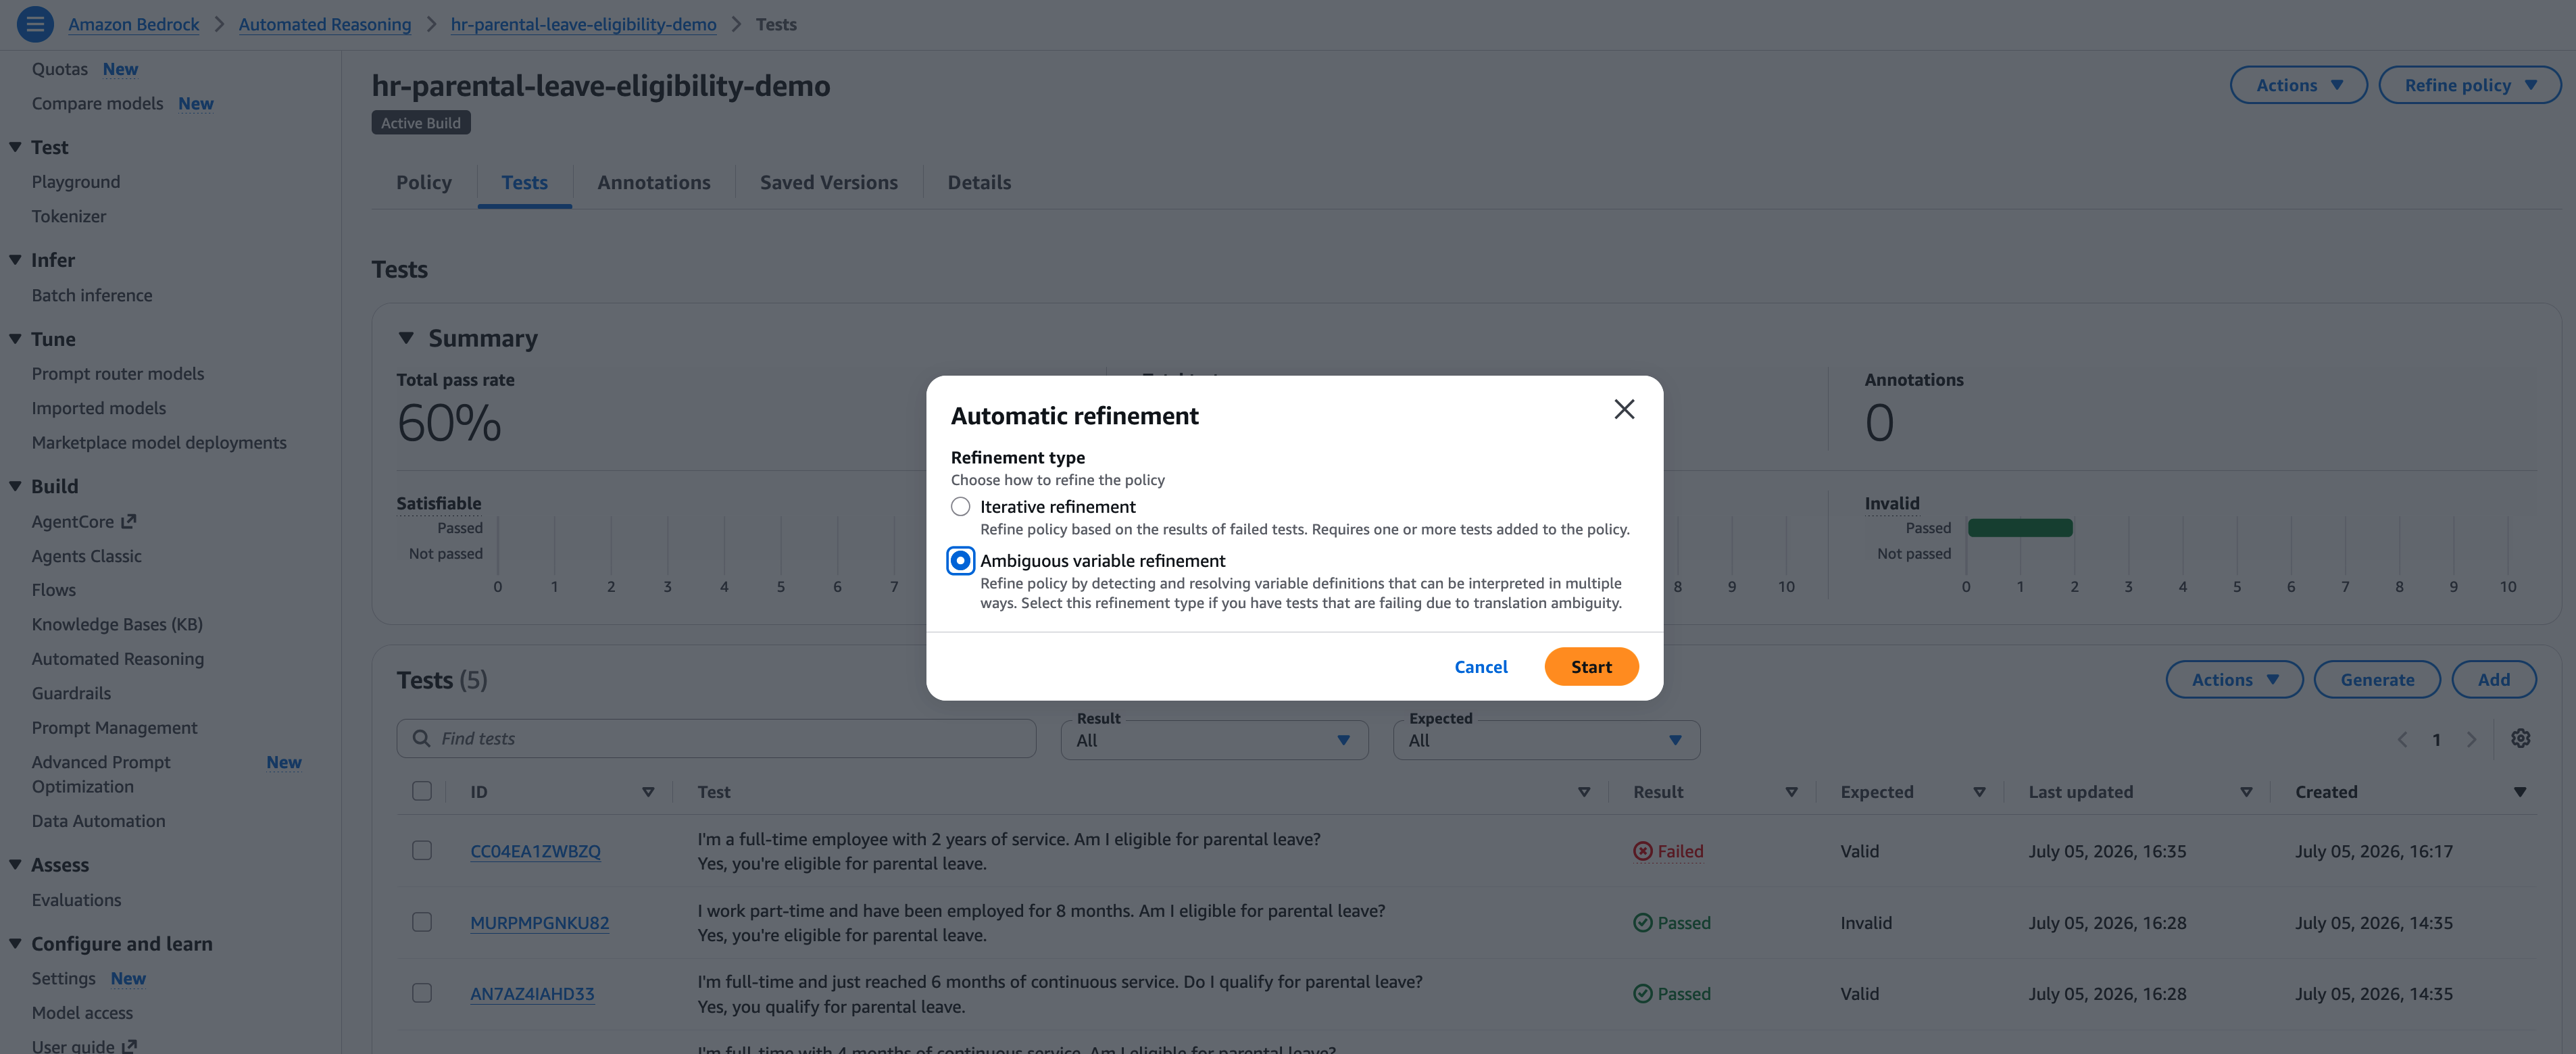
図 7: ソースドキュメントを必要としない Ambiguous Variable Refinement の設定
- [Start] を選択します。
ステップ 2: 変更をレビューして承諾する
- [Review policy changes] 画面で、提案された変数のマージをレビューします。
- monthsOfService が削除されます。
- ルールが tenureMonths を参照するように更新されます。
- tenureMonths の説明が次のように拡張されます。
- 「従業員が継続して雇用されている期間の月数 (1 か月未満の端数は含めません)。ユーザーが勤続年数に言及した場合は月数に変換します (例: 2 年 = 24 か月)。この変数は、雇用期間、勤続期間、在社期間、または勤続年数へのすべての言及をとらえます」
- [Test results] では、これまであいまいだったテストが確定的な
VALIDの結果を生成するようになります。
- [Accept changes] を選択します。
ステップ 3: 修正を確認する
- [Tests] タブに戻り、再度 [Validate all tests] を選択します。
- 図 8 に確認結果を示します。これまで
TRANSLATION_AMBIGUOUSを返していたテストが、確定的なVALIDの検出結果を生成し、合格するようになります。
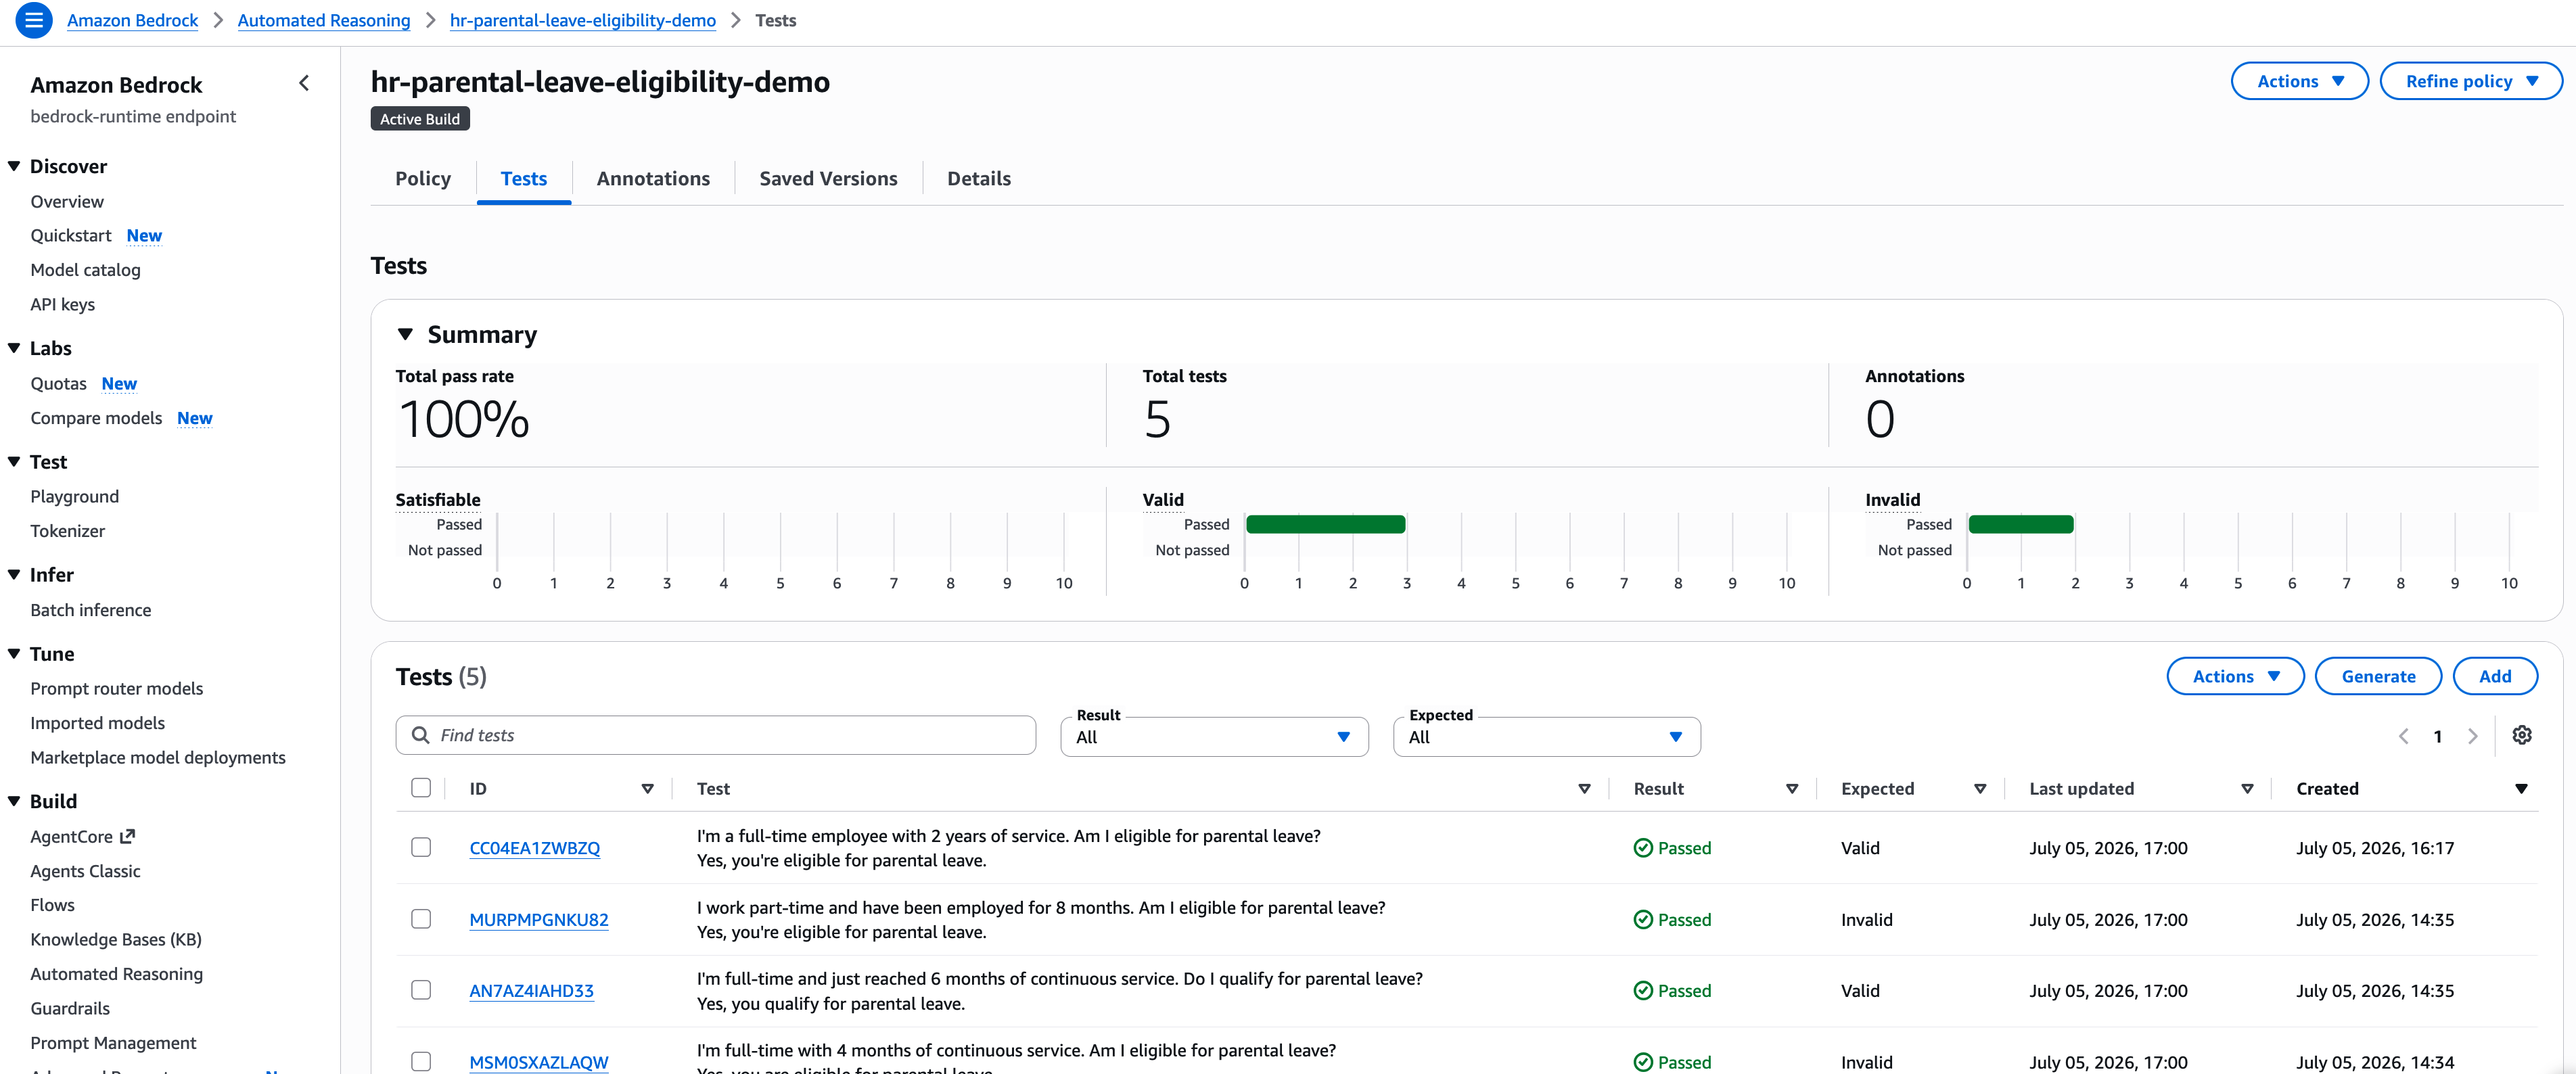
図 8: あいまいな変数の改善を適用した後の [Tests] タブ
ステップ 4: レポートを生成してデプロイする
- [Generate Fidelity Report] を選択し、前回のレポートとスコアを比較します。
- 結果に問題がなければ、デプロイ用に番号付きバージョンを作成します。
注意
どちらの改善モードでも、テストが合格することや、提案された変更がリグレッションを引き起こさないことは保証されません。テストが合格しない場合や、合格していた他のテストが失敗するようになった場合は、変更を破棄して再度試すことができます。
ベストプラクティスと実際のユースケース
改善エンジンは、明確なシグナルと範囲の限定された変更を与えたときに最も効果を発揮します。次のプラクティスはその方法を示し、ユースケースはそれが効果を発揮する場面を示します。
ベストプラクティス
次のプラクティスは、改善がうまくいかなくなる最も一般的な 2 つのパターンから導かれたものです。あいまいな失敗シグナルで改善を実行してしまうケースと、意図した以上にポリシーを変更させてしまうケースです。
- モードを選ぶ前に変換内容を読む。まず失敗した検出結果を開き、変数の割り当てを確認します。適切な変数に適切な値が入っているのに結果が誤っている場合は、Iterative Refinement で対処すべきルールの問題です。割り当てが誤っている場合、または検出結果が
TRANSLATION_AMBIGUOUSの場合は、Ambiguous Variable Refinement で対処すべき言語の問題です。変換内容を確認せずに症状だけでモードを選ぶことが、誤った箇所を「修正」してしまう改善の最も多い原因です。 - 入力の範囲を絞って変更を限定する。ポリシーの一部分 (例えば育児休暇の資格) に範囲を絞ったソースドキュメントに対して改善を実行します。修正が必要なルールが 1 つだけの場合は、具体的な if-then 形式のフィードバックを組み合わせます。焦点の絞られた入力は、「勤続期間のルールを修正してください」のようなあいまいなガイダンスで 40 ページのハンドブック全体をエンジンに与える場合よりも、範囲が限定されレビューしやすい提案を生み出します。
- 差分よりも [Test results] を信頼する。レビュー画面には、変更されたルールと、保存済みのすべてのテストへの影響の両方が表示されます。判断の決め手となるのは [Test results] パネルです。失敗していたテストが合格に転じ、合格していたテストがそのまま合格を維持しているときに承諾してください。きれいに見える差分でも、それによって以前は合格していたテストが失敗するようになるなら、それは修正ではありません。
- バージョンを作成する前に Fidelity Report を比較する。改善処理はテストを合格させるように最適化します。その最適化により、ルールがソースドキュメントの実際の記述から離れてしまうことがあります。承諾した後は、改善前の実行結果と精度スコアを比較してください。スコアの低下は逸脱のシグナルであり、やり直しを盲目的に繰り返すのではなく、拒否して反復すべき理由になります。テストが合格し、レポートの内容にも問題がなければ、番号付きバージョンを作成して変更を本番環境に昇格させます。
実際のユースケース
これらのパターンは規制業界全体に当てはまります。人事制度の適用対象を判定するシナリオでは、従業員ハンドブックが毎年更新されます。Iterative Refinement が新しいドキュメントを取り込んでルールの変更を提案するため、人事チームは形式論理に触れることなくレビューできます。金融サービスでは、debtToIncomeRatio と DTI のような重複する変数が、顧客の多様な表現に対して変換のあいまいさを引き起こします。Ambiguous Variable Refinement はそれらを統合し、決定論的な検証を可能にします。臨床プロトコルが改訂された場合、ヘルスケアのコンプライアンスチームは新しいガイドラインをアップロードします。Iterative Refinement がルールの更新を提案し、チームは本番環境へ反映する前に提案を検証します。製造業の品質保証では、公差が時間とともに厳しくなります。チームはポリシーを反復的に改善しながら、バージョン管理されたスナップショットと Fidelity Report を通じて監査証跡を維持します。
まとめ
規制対象の領域に生成 AI を投入するチームは、隠れたコストを支払ってきました。それがポリシーのメンテナンスです。
ポリシーの自動改善は、変更を承認する権限をお客様に残したまま、必要な作業量を減らします。
ルールと言語の二分法。論理が誤っている場合 (ルールが緩すぎる、厳しすぎる、または存在しない場合) は、Iterative Refinement がソースドキュメントとフィードバックに基づいた形式論理の修正案を提示します。言語が誤っている場合 (変数の重複、あいまいな説明、一貫性のない形式) は、Ambiguous Variable Refinement が、競合する解釈を 1 つにまとめる正確な変数定義を提案します。
承認ゲート。どちらの場合も、システムが提案し、お客様が決定します。提案されたすべての変更は、差分と、保存済みのテストへの影響を示すレビュー画面に表示されます。明示的な承認がなければ、DRAFT ポリシーにも、まして本番環境にも変更は届きません。作業は自動化され、権限はお客様の手に残ります。
次のステップ
テストを追加した自動推論ポリシーをまだお持ちでない場合は、まずソースドキュメントからポリシーを作成し、重要なシナリオをカバーするテストを追加してください。リンクについては、「前提条件」セクションを参照してください。ポリシーと少なくとも 1 つの失敗するテストが手元にあれば、今日のうちに失敗するテストを 1 つ選び、その検出結果を確認してみてください。変換が正しいのに結果が誤っている場合は、焦点を絞ったソースドキュメントを用意して Iterative Refinement を実行します。結果が TRANSLATION_AMBIGUOUS の場合は、Ambiguous Variable Refinement を実行します。
提案を承諾し、再テストを行い、前後で Fidelity Report を比較してください。形式論理を 1 行も手で書くことなく、あいまいでない変換において最大 99% の精度で検証された、より緻密なポリシーが得られます (「自動推論チェックを使用して、AI のハルシネーションを最小限に抑え、最大 99% の検証精度を実現: 今すぐご利用いただけます」を参照してください)。
リソース
- 開始する: セットアップのガイダンスについては、「自動推論チェックのドキュメント」を参照してください。または、Amazon Bedrock コンソールで既存のポリシーを開き、[Refine policy] を選択してください。このサービスの詳細については、Amazon Bedrock をご覧ください。
- 実践的なウォークスルー: 手順を追ったガイドについては、「How to minimize generative AI hallucinations with Automated Reasoning checks」を参照してください。
訳注: 上記の記事はプレビュー期間中 (2025 年 4 月) に公開されたものです。一般提供開始後の機能に基づいた手順は、日本語版ブログの「Amazon Bedrock の自動推論チェックによる信頼できる AI システムの構築 – パート 1」で確認できます。
- 回答を書き換えるチャットボット: チャットボットは、自動推論チェックのフィードバックを利用して回答を反復的に書き換え、証明可能に正しい回答に到達するまでユーザーに確認の質問を投げかけることができます。「自動推論チェックで回答を書き換えてハルシネーションを抑えるチャットボットのリファレンス実装」と、GitHub のサンプルコードを参照してください。
- ポリシー形式化エージェント: エージェントは、自動推論ポリシーを改善するプロセス全体を自然言語で対象分野の専門家に案内できます。そのようなエージェントのオープンソースサンプルを参照してください。
- コードサンプル: GitHub の自動推論チェックのサンプルをご覧ください。
- お客様の成果: Amazon Logistics の導入事例 | PitCrew の導入事例 | PwC の教育分野における責任ある AI の導入事例 | AWS の責任ある AI に関するリソース
- Amazon Bedrock の機能に関する詳細情報: Amazon Bedrock Guardrails | Amazon Bedrock AgentCore
- 責任ある AI のガイダンス: AWS Well-Architected Responsible AI Lens
99% という精度の数値について
冒頭とまとめのセクションで引用している 99% という数値は、自然言語から形式論理への変換があいまいでない場合に、正しい検出結果 (VALID、INVALID、または SATISFIABLE) が得られる割合を測定した検証精度を指します。この数値は一般提供開始のお知らせ「自動推論チェックを使用して、AI のハルシネーションを最小限に抑え、最大 99% の検証精度を実現: 今すぐご利用いただけます」(AWS News Blog、2025 年 8 月 6 日) で初めて公開されました。
著者について
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。