Amazon Web Services ブログ
United Airlines が Amazon Redshift と AWS Glue Data Catalog フェデレーションで Databricks が管理するデータをクエリする方法
本記事は 2026 年 9 月 15 日 に公開された「How United Airlines uses Amazon Redshift and AWS Glue Data Catalog federation to query Databricks-managed data」を翻訳したものです。
本記事は United Airlines の Ankit Aggarwal 氏と Raja Kalluri 氏との共著です。
United Airlines は、Amazon Redshift と Unity Catalog を備えた Databricks にまたがるデータプラットフォームで、1 日あたり数十億件のイベントを処理しています。データを複製せずに両プラットフォームをつなぐために同社のチームが選んだのが、AWS Glue Data Catalog フェデレーションです。
本記事では、AWS Glue Data Catalog フェデレーションで Databricks Unity Catalog に接続し、データを移動も複製もせずに Amazon Redshift からライブの SQL クエリを実行できるようにする設定手順を説明します。
United Airlines がカタログフェデレーションを必要とした理由
United Airlines は、Amazon Simple Storage Service (Amazon S3) 上のメダリオンアーキテクチャ (ブロンズ → シルバー → ゴールド) でペタバイト規模のデータをキュレーションしています。ユーザーインタラクションデータ層だけでも、ニアリアルタイムでストリーミングされるデータが数十テラバイト規模にのぼります。各チームはユーザーインタラクションデータを使って、ウェブとモバイルの各タッチポイントにおける顧客エンゲージメントのパターン、機能の利用状況、コンバージョン行動を測定しています。アナリストは、このキュレーション済みデータを Amazon Redshift Serverless からクエリする必要があります。既存のデータプラットフォームアーキテクチャでは、これらのテーブルは AWS Glue Data Catalog ではなく Databricks Unity Catalog にカタログ登録されています。そのため、Amazon Redshift からはネイティブに参照できません。カタログフェデレーションがなければ、このデータを Amazon Redshift からクエリ可能にする唯一の方法は、Amazon Redshift マネージドストレージ (RMS) にデータを複製し、同期を維持するパイプラインを構築することでした。
AWS Glue Data Catalog フェデレーションにより、こうした複製は不要になりました。Amazon Redshift のユーザーは Amazon S3 に保存されたゴールド層を直接クエリでき、Iceberg メタデータはクエリ実行時に Unity Catalog から解決されるため、データの移動は発生しません。AWS Glue Data Catalog フェデレーションは Amazon Redshift を Unity Catalog のような外部カタログに接続するので、アナリストは同期パイプラインの構築やストレージの重複なしに、プラットフォームをまたいだデータをクエリできます。
Amazon Redshift Serverless は、新しい RG インスタンスファミリーと同じ Graviton ベースのクエリエンジンで動作しており、前世代と比べてデータレイククエリのパフォーマンスが最大 2 倍に向上しています。このエンジンは Apache Iceberg テーブルを Amazon S3 から直接読み取るために設計されており、こうしたフェデレーテッドクエリのワークロードに適しています。
United Airlines は、データプラットフォーム全体への AWS Glue Data Catalog フェデレーションの導入を段階的に進めています。最初の対象は最も利用頻度の高いユーザーインタラクションデータのテーブルで、現在 30 テーブルが本番環境でフェデレーションされ、さらに 70 テーブルの展開が進行中です。今後数か月で、さまざまなビジネスドメインにわたる数百のテーブルを本番環境に追加する計画です。
ソリューションの概要
AWS Glue Data Catalog フェデレーションは、メタデータ層で両プラットフォームをつなぎます。仕組みは次のとおりです。
アーキテクチャは 4 層のフェデレーションチェーンで構成されます。
- Databricks Unity Catalog は、Iceberg REST API エンドポイントでテーブルを公開します。Delta テーブルは UniForm 形式を有効にすると Iceberg 互換になります。
- AWS Glue Data Catalog は、Databricks Unity Catalog に接続するフェデレーテッドカタログを作成し、データを移動せずにメタデータを AWS 内から参照できるようにします。
- デフォルトの AWS Glue カタログにあるリソースリンクデータベースが、フェデレーテッドカタログのデータベースを指す橋渡しになります。リソースリンクは、Amazon Redshift のコンピューティングからアクセスするために必要です。
- Amazon Redshift Serverless は、外部スキーマからリソースリンクデータベースを参照します。クエリが実行されると、Amazon Redshift はリンクをたどって AWS Glue Data Catalog フェデレーションを呼び出し、Databricks Unity Catalog の REST API 経由で Iceberg データを読み取ります。チェーン全体の権限は AWS Lake Formation が管理します。
このソリューションで使う主なサービスと機能:
- AWS Glue Data Catalog – フェデレーテッドカタログと、デフォルトカタログ内のリソースリンク。
- AWS Lake Formation – 認証情報の発行ときめ細かなアクセス制御。
- Amazon Redshift Serverless – 外部スキーマ経由のクエリ。
- AWS Identity and Access Management (IAM) – Amazon Redshift 名前空間と SAML 認証ユーザーに対するロールベースの権限。
- Databricks Unity Catalog – REST API で Iceberg テーブルを公開するソースカタログ。
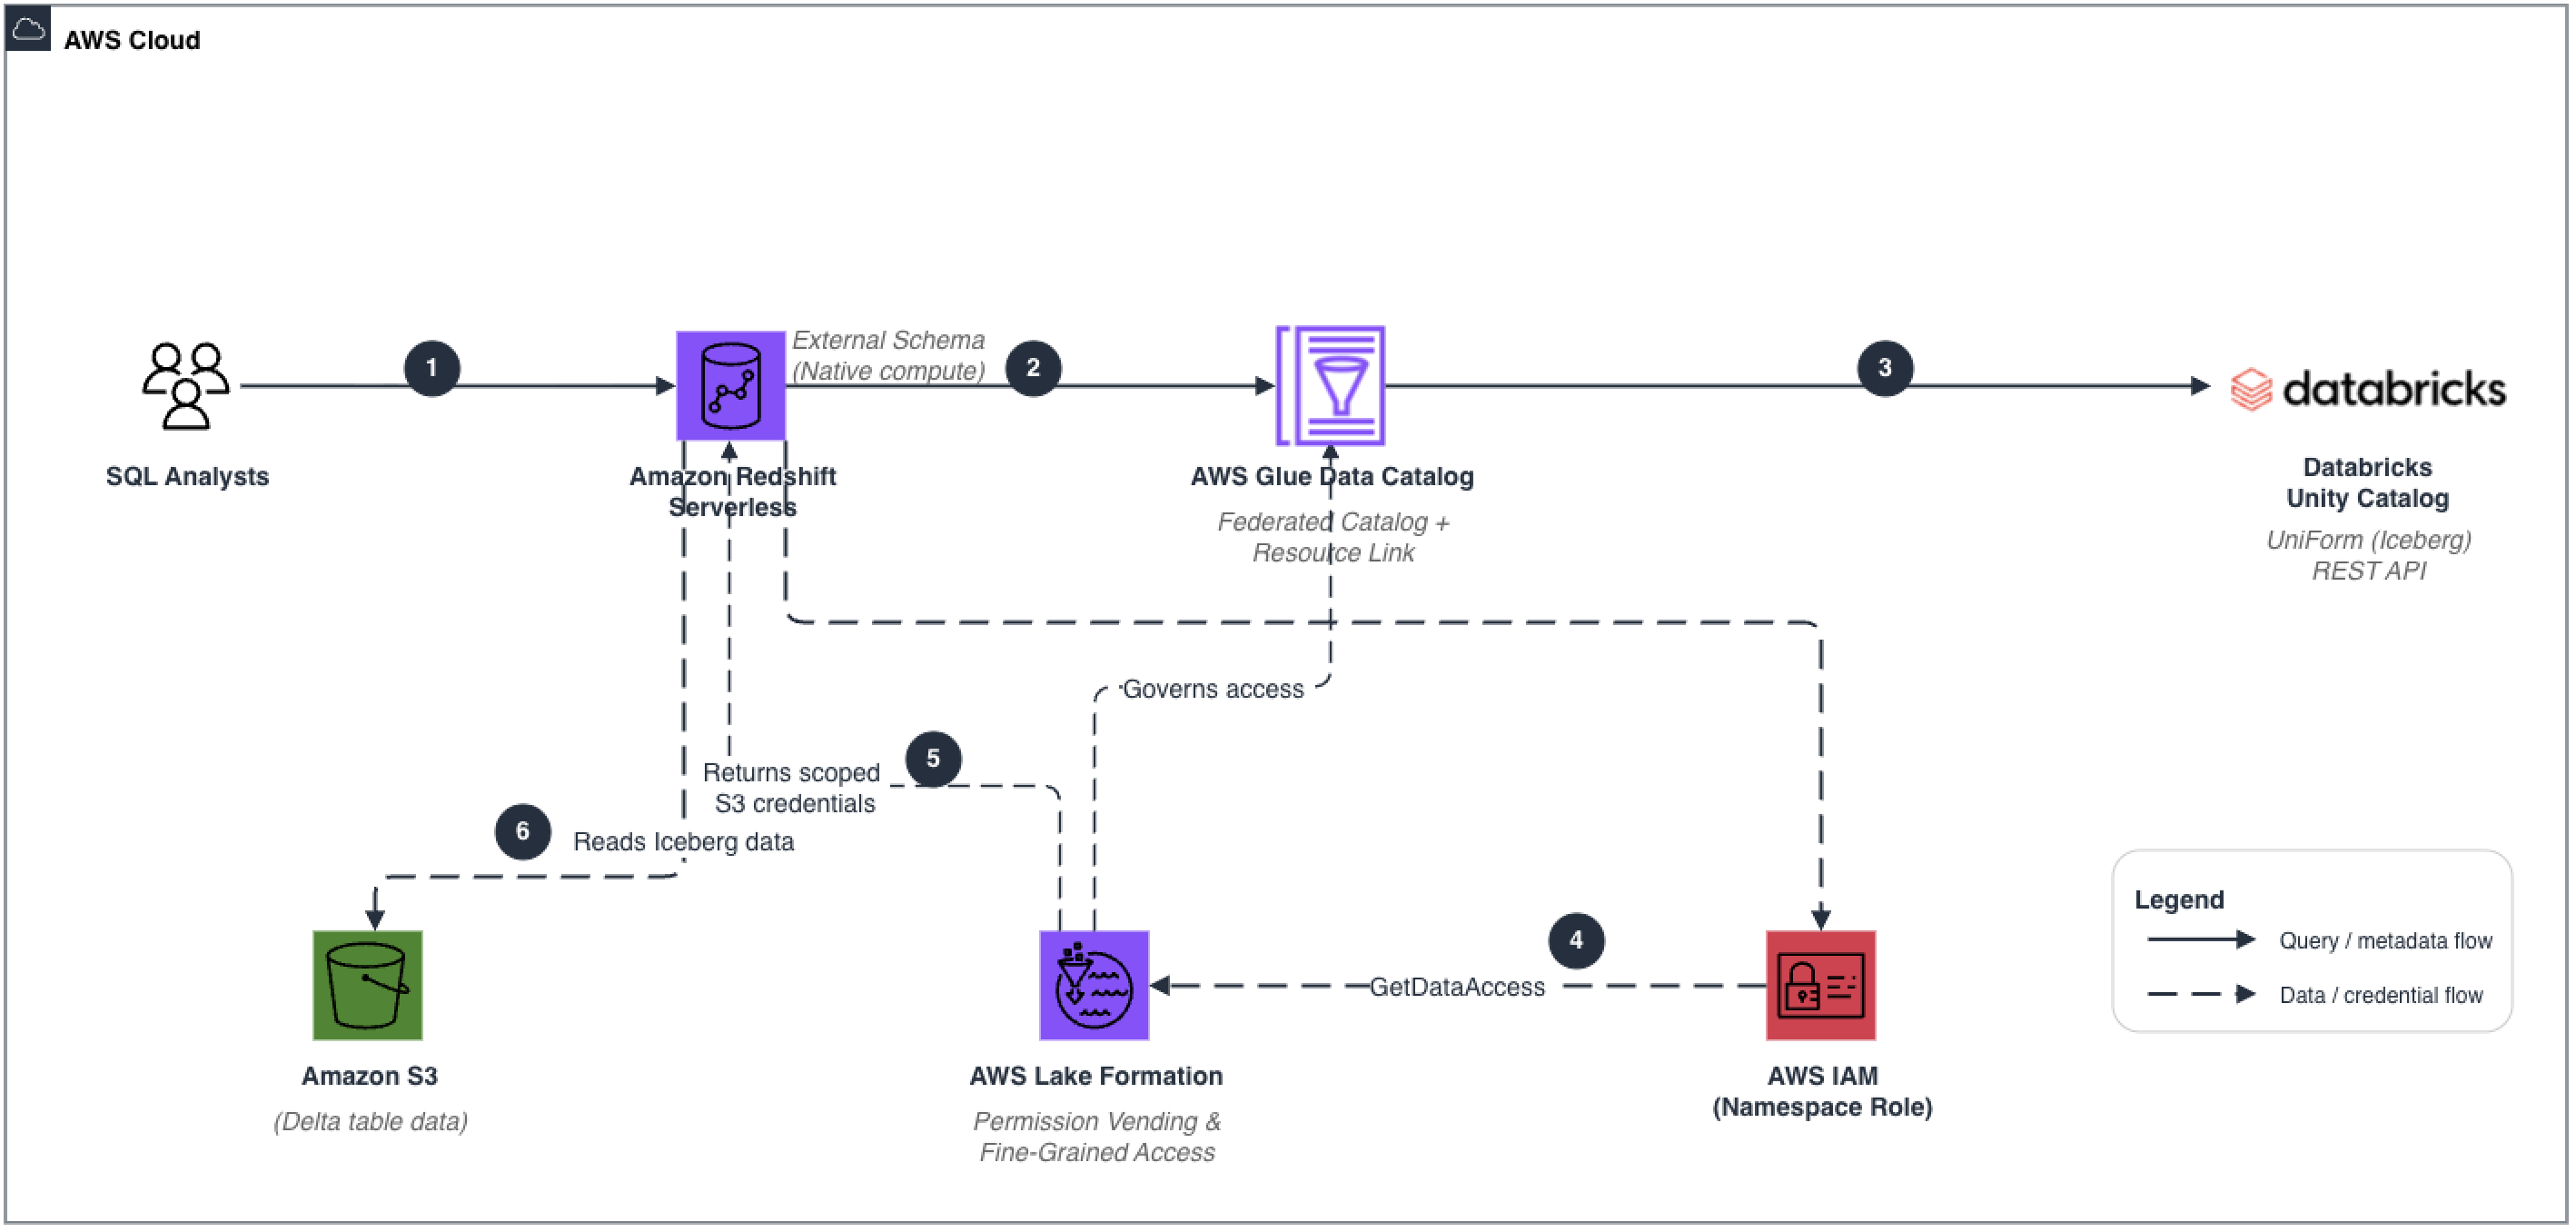
図 1: Databricks Unity Catalog から AWS Glue と Lake Formation を経て Amazon Redshift Serverless に至るフェデレーションチェーン
アーキテクチャは次の 6 つのステップで動作します。
- SQL アナリストが Amazon Redshift Serverless にクエリを送信します。
- Amazon Redshift が AWS Glue Data Catalog (フェデレーテッドカタログへのリソースリンク) で外部スキーマを解決します。
- AWS Glue のフェデレーテッドカタログが Databricks Unity Catalog の Iceberg REST API を呼び出し、最新のテーブルメタデータを取得します。
- 名前空間の IAM ロールが AWS Lake Formation の GetDataAccess を呼び出し、スコープを限定した一時的な S3 認証情報を取得します。
- Lake Formation がきめ細かなアクセスポリシーを評価し、許可されたデータファイルに対する認証情報を発行します。
- Amazon Redshift Serverless が Iceberg データファイルを S3 から直接読み取り、結果をアナリストに返します。
前提条件
始める前に、次の準備が整っていることを確認してください。
- Unity Catalog が有効で、カタログ、スキーマ、テーブルがそれぞれ 1 つ以上ある Databricks ワークスペース。Databricks は UniForm を使って、Amazon S3 上の Delta Lake テーブルに Iceberg メタデータを生成します。
- AWS Glue、AWS Lake Formation、Amazon Redshift Serverless、IAM を管理する権限を持つ AWS アカウント。
- プロビジョニング済みの Amazon Redshift Serverless ワークグループと名前空間。
- データレイク管理者が設定された AWS Lake Formation。
- 適切な認証情報で設定された AWS Command Line Interface (AWS CLI)。
- Amazon Redshift クエリエディタ v2 または SQL クライアントの基本的な使い方の理解。
注: Databricks Unity Catalog 側の設定 (フェーズ 1) は、AWS ブログ記事「Access Databricks Unity Catalog data using catalog federation in the AWS Glue Data Catalog」の手順に従ってください。本記事のウォークスルーは、AWS Glue にフェデレーテッドカタログが作成された後の手順から始めます。
ソリューションのウォークスルー
ウォークスルーは 6 つのステップで構成され、Lake Formation の設定、リソースリンクのパターン、IAM ロールの設定、Amazon Redshift から Databricks テーブルをクエリする方法を順に説明します。
ステップ 1: AWS Lake Formation を設定する
1a. データレイク管理者を追加する
- Lake Formation で Administration を選択し、続いて Administrators を選択して、管理者の IAM ユーザーまたはロールを追加します。
1b. フェデレーテッドカタログが登録されていることを確認する
- Data Catalog、続いて Catalogs を選択し、databricks-federated-catalog が表示され、登録されていることを確認します。
ステップ 2: デフォルトの AWS Glue カタログにリソースリンクを作成する
このステップは、ウォークスルーの中でアーキテクチャ上もっとも重要なポイントです。Amazon Redshift は CREATE EXTERNAL SCHEMA をデフォルトの AWS Glue Data Catalog に対してのみ解決します。フェデレーテッドカタログ (databricks-federated-catalog) は、デフォルトとは別のカタログオブジェクトです。Amazon Redshift からフェデレーテッドデータへの経路を用意するために、フェデレーテッドカタログのデータベースを指すリソースリンクデータベースをデフォルトカタログに作成します。
リソースリンクはデータやメタデータをコピーしません。クエリ実行時に Lake Formation が解決するポインターです。
Lake Formation コンソールでリソースリンクを作成する手順は次のとおりです。
- Data Catalog、Databases、Create database の順に選択します。次に Resource link を選択します。
- Resource link name に databricks_federated_db_link と入力します。
- Target catalog に databricks-federated-catalog と入力します。
- Target database に、AWS Glue クローラーが検出したデータベース名 (例: databricks_federated_db) を入力します。
または、AWS CLI を使います。
ステップ 3: Amazon Redshift Serverless 名前空間の IAM ロールを設定する
Amazon Redshift がリソースリンク経由でクエリを実行する際は、Amazon Redshift Serverless の名前空間にアタッチされた IAM ロールを使って Lake Formation の GetDataAccess API を呼び出します。そのため、Lake Formation の権限はこの名前空間ロールに付与する必要があります。
次の 2 つの方法のいずれかを選びます。
- オプション A – 既存の名前空間ロールに、次のポリシーをインラインで追加する。
- オプション B – 新しい専用ロール (名前は RedshiftServerlessNamespaceRole) を作成し、既存のロールと併せて名前空間にアタッチする。
ロールに次の IAM ポリシーをアタッチします。
注: このポリシーの Resource: “*” は簡潔にするための例です。本番環境では、ユースケースに応じて特定の AWS Glue カタログ ARN、データベース ARN、テーブル ARN にリソースを限定してください。
ロールを作成または更新したら、Amazon Redshift Serverless の名前空間に関連付けます。
- Amazon Redshift Serverless コンソールで Namespaces を選択し、対象の名前空間を選択して、Security and encryption、続いて Manage IAM roles を選択します。
- オプション A の場合、既存のロールにすでに新しい権限が含まれているため、変更は不要です。
- オプション B の場合、既存のロールに加えて新しいロールを追加します。
ステップ 4: Amazon Redshift 名前空間ロールに Lake Formation の権限を付与する
4a. リソースリンクデータベース (デフォルトカタログ) に DESCRIBE を付与する
- Lake Formation で Permissions、Data lake permissions、続いて Grant を選択します。
- プリンシパル: RedshiftServerlessNamespaceRole
- リソース: Named Data Catalog resources、Default catalog、databricks_federated_db_link (リソースリンク)
- データベース権限: DESCRIBE
4b. ターゲットテーブルに SELECT と DESCRIBE を付与する (Grant on Target)
リソースリンク自体に付与できる権限は DESCRIBE と DROP だけです。Amazon Redshift が実際にデータを読み取れるようにするには、フェデレーテッドカタログ内のターゲットテーブルに対して別途 SELECT を付与する必要があります。これが Lake Formation の Grant on Target パターンです。
- プリンシパル: RedshiftServerlessNamespaceRole
- リソース: Named Data Catalog resources、databricks-federated-catalog、databricks_federated_db、続いて Tables
- テーブル権限: SELECT、DESCRIBE
- カタログ権限: DESCRIBE
重要: SELECT は、リソースリンクではなく、フェデレーテッドカタログ内のターゲットテーブルに付与する必要があります。リソースリンクにだけ SELECT を付与しても機能しません。これはよくある設定ミスです。
ステップ 5: Amazon Redshift に外部スキーマを作成する
リソースリンクを作成し権限を付与したら、リソースリンクデータベースを指す外部スキーマを Amazon Redshift に作成できます。外部スキーマがクエリのインターフェイスになります。ユーザーが外部スキーマに対して SQL を実行すると、Amazon Redshift はリンクをたどってフェデレーテッドカタログに到達し、Databricks Unity Catalog からメタデータとデータを取得します。
DATABASE パラメータには、フェデレーテッドカタログ名を直接指定するのではなく、デフォルトの AWS Glue カタログにあるリソースリンクデータベース名 (databricks_federated_db_link) を指定する必要があります。リソースリンクはデフォルトカタログにあり、Amazon Redshift が自動的に解決するため、CATALOG_ARN パラメータは不要です。
スーパーユーザーとして Amazon Redshift クラスターに接続し (例: Amazon Redshift クエリエディタ v2 を使用)、次を実行します。
このアーキテクチャの重要な設計原則は、Amazon Redshift に物理的に保存されているデータと、フェデレーション経由で外部からアクセスするデータを明確に分けることです。外部スキーマは透過的な抽象化層となり、Amazon Redshift のユーザーは S3 に保存されたデータを取り込まずにクエリできます。一貫性と分かりやすさのため、United Airlines は Amazon Redshift のすべてのフェデレーテッドスキーマに {domain}_iceberg という標準の命名規則を適用しています。この命名規則により、データが Amazon Redshift 内にネイティブに保存されているのではなく、AWS Glue と Lake Formation を通じたフェデレーションでアクセスされていることが一目で分かります。この区別は、データを見つけやすくし、ストレージ層間のあいまいさを避け、ハイブリッドなデータ環境を扱う際のアーキテクチャの規律を強めるという点で、アナリストとエンジニアにとって非常に重要です。
User Interactions ドメインは、顧客のインタラクション活動、エンゲージメント行動、チャネル利用パターンを表すキュレーション済みデータセットを公開しています。運用系のデータセットも同じパターンに従い、共通のフェデレーション基盤を通じて、関連するビジネスイベントや参照情報へのガバナンスの効いたアクセスを提供します。
各外部スキーマの上には WITH NO SCHEMA BINDING を使ったビュー層を作成し、アナリストがクエリ実行のたびに常に最新のスキーマを参照できるようにします。例を示します。
ステップ 6: Amazon Redshift から Databricks テーブルを確認してクエリする
外部スキーマを作成したら、Databricks のテーブルが表示されることを確認し、テストクエリを実行します。
テーブルの表示を確認する
Databricks Unity Catalog のテーブルをクエリする
クエリが実行されると、Amazon Redshift は名前空間の IAM ロールで Lake Formation の GetDataAccess を呼び出し、一時的な認証情報を取得します。次に AWS Glue のフェデレーテッドカタログにアクセスし、フェデレーテッドカタログが Databricks Unity Catalog の Iceberg REST API を呼び出してメタデータを取得し、テーブルデータを読み取ります。結果は Amazon Redshift のユーザーに透過的に返されます。
SAML 認証ユーザーの場合は、IdP の JDBC プラグインを使って接続します。
認証は Amazon Redshift JDBC ドライバーが自動的に処理します。ドライバーは IdP で認証して SAML アサーションを受け取り、sts:AssumeRoleWithSAML を呼び出して一時的な IAM 認証情報を取得します。続いて redshift-serverless:GetCredentials を呼び出し、マッピングされたデータベースユーザーとして接続します。
ビジネスへの効果
AWS Glue Data Catalog フェデレーションは、United Airlines にアーキテクチャと運用の両面で測定可能な改善をもたらしました。
| 領域 | 導入前 | 導入後 | 効果 |
| データアクセス | Delta Lake と Amazon Redshift のデータは完全にサイロ化しており、Amazon Redshift のユーザーは Databricks が管理する S3 上のキュレーション済みデータセットにアクセスできなかった | Amazon Redshift のユーザーが、AWS Glue Data Catalog フェデレーション経由で Databricks が管理するデータにリアルタイムでアクセスできる | 第 1 フェーズで約 100 人のアナリストが、新しいパイプラインを追加せずにユーザーインタラクションデータのテーブルにアクセスできるようになった |
| 災害対策 (DR) | クロスリージョンの DR は 3 時間ごとの Amazon Redshift スナップショットに依存していた (目標復旧時点 (RPO) は 3 時間以上) | Delta Lake に対する Amazon S3 のクロスリージョンレプリケーションにより、ほぼ継続的な RPO を実現した。DR リージョンに新しい Amazon Redshift Serverless ワークグループを用意すれば、同じ S3 データにフェデレーションできる | より回復力の高いアーキテクチャ。リージョン間の Amazon Redshift スナップショットとコピーの維持コストを削減 |
| アーキテクチャの簡素化 | データ処理が Databricks と Amazon Redshift の両方で行われ、2 つのプラットフォーム間でカタログを手動で同期する必要があった。運用コストが高く、ずれ (ドリフト) も起きやすかった | フェデレーテッドアーキテクチャでは、データ処理を Databricks に集約し、Amazon Redshift はカタログフェデレーションを通じてユーザーのクエリとダッシュボードを支えるクエリエンジンに専念する | 単一の処理プラットフォーム、同期パイプラインはゼロ、信頼できる唯一の情報源 |
| インフラコスト | データ処理のために、RMS ストレージ、スナップショット、コンピューティングを備えた専用の Amazon Redshift ETL クラスターを稼働させていた | フェデレーションを使うこのユースケースでは、Amazon Redshift は ETL には不要で、クエリエンジンとしてのみ使う。RMS ストレージの重複もスナップショットのレプリケーションも不要 | 冗長な ETL インフラのコストを月額約 3 万ドル削減 |
セキュリティに関する考慮事項
United Airlines では、ID ガバナンスを Azure Active Directory グループで統一しています。AWS 側の利用者は、SAML フェデレーションで Amazon Redshift Serverless に認証します。フェデレーテッドスキーマへのデータベースレベルのアクセスは、AD グループのメンバーシップで決まります。Databricks 側でも、同じ AD グループが Unity Catalog スキーマへのアクセスを管理します。この単一 ID モデルにより、プラットフォームごとにユーザーを別々にプロビジョニングすることなく、両方で一貫したアクセス制御を実現しています。フェデレーテッドクエリ実行中の S3 データアクセスに必要な認証情報の発行は Lake Formation が担い、スキーマレベルのアクセス判断は各プラットフォームの AD グループマッピングで管理します。
アーキテクチャには、フェデレーションチェーンに組み込まれた多層のセキュリティ制御もあります。
- AWS Lake Formation がフェデレーションチェーン全体できめ細かなアクセス制御を管理し、プリンシパルは許可されたデータベース、テーブル、列にのみアクセスできます。
- IAM ロールは最小権限の原則に従います。Amazon Redshift の名前空間ロールの権限は、AWS Glue のメタデータ操作と Lake Formation の GetDataAccess に限定されています。
- SAML ベースの認証はエンタープライズの ID プロバイダーと統合されており、ユーザーはフェデレーテッドデータにアクセスする前に既存の SSO 基盤で認証します。
- Amazon Redshift へのすべての接続で TLS 暗号化 (ssl=true) を強制し、クライアントと Amazon Redshift エンドポイント間の転送中のデータを保護します。
- Lake Formation の認証情報の発行では、長期間有効な静的な認証情報ではなく、クエリ実行ごとに有効期間が短くスコープを限定した認証情報を発行します。
その他の考慮事項
デプロイする前に、カタログフェデレーションのサービス制限を確認してください。主な要件は次のとおりです。
- Delta Lake テーブルは、Iceberg 互換のメタデータを公開するために UniForm を有効にする必要があります。
- フェデレーテッドクエリのパフォーマンスは、書き込み時にデータがどれだけ効率的に整理されているかに左右されるため、ソーステーブルは適切にパーティション分割し、定期的にコンパクションすることをお勧めします。
クリーンアップ
このウォークスルーで作成したリソースに継続して課金されないように、次の順序で削除します。この削除は、Databricks のメタデータや Amazon S3 に保存されている元のデータには影響しません。
- Amazon Redshift の外部スキーマを削除します:
DROP SCHEMA databricks_schema; - デフォルトの AWS Glue カタログにあるリソースリンクデータベース (databricks_federated_db_link) を削除します。
- リソースリンクデータベースとフェデレーテッドカタログ内のターゲットテーブルの両方について、Amazon Redshift 名前空間ロールに付与した Lake Formation の権限を取り消します。
- AWS Glue のフェデレーテッドカタログ (databricks-federated-catalog) を削除します。
- 不要になった場合は、Databricks Unity Catalog 用の AWS Glue 接続の登録を解除します。
- 必要に応じて、このウォークスルーのためだけに作成した IAM ロール (RedshiftServerlessNamespaceRole) を削除します。
まとめ
本記事では、United Airlines が AWS Glue Data Catalog フェデレーションを使って、Amazon S3 上にある数十テラバイトのキュレーション済みユーザーインタラクションデータに、1 バイトも複製せず同期パイプラインも構築せずに、Amazon Redshift Serverless のアナリストがリアルタイムでアクセスできるようにした方法を紹介しました。
このアーキテクチャは、Iceberg REST API、リソースリンクデータベース、Lake Formation による認証情報の発行を組み合わせて、Amazon Redshift と Unity Catalog の間にガバナンスの効いたクエリ経路を構築します。United Airlines は、冗長な ETL インフラのコストをなくし、カタログ同期の必要性を取り除き、Amazon Redshift Serverless をアナリストとダッシュボードのための高性能な専用クエリエンジンへと転換しました。
ご質問やご意見は、本記事にコメントをお寄せください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Woosuk Choi がレビューしました。