Amazon Web Services ブログ
Amazon OpenSearch Serverless NextGen の時系列コレクションのご紹介
本記事は 2026 年 10 月 27 日 に公開された「Introducing time series collections for the next generation of Amazon OpenSearch Serverless」を翻訳したものです。
本日、Amazon OpenSearch Serverless NextGen が時系列コレクションに対応したことを発表します。時系列コレクションを使えば、クラスターのプロビジョニングや管理をせずに、ログ、メトリクス、トレース、イベントデータを取り込み、保存、分析できます。時系列コレクションは取り込みのスパイクを自動で吸収し、直近のデータは高速にクエリでき、数か月から数年分の履歴も低コストで検索可能にします。これらすべてを同じコレクション内で実現します。時系列コレクションは OpenSearch Serverless にアラートと異常検知も追加するため、問題が起きた瞬間に発見して対処できます。コレクションあたり最大 100 TB のホットストレージをサポートし、アプリケーション監視、セキュリティ分析、IoT テレメトリなど大規模なオブザーバビリティワークロードに対応します。
オブザーバビリティデータは量が多く、不具合のあるデプロイや障害など、チームが最も早く答えを求める瞬間に急増します。クラスターのサイジングが不足すると処理が追いつかず、エンジニアが待っているログの到着が遅れるため、チームはピーク負荷に合わせてサイジングし、それ以外の日もその容量分を支払うことになります。履歴が増えるとホットストレージの費用がかさむため、保持期間を短縮したり、古いデータをスナップショットに移したりせざるを得ません。しかしスナップショットからクエリするには、まず誰かが復元する必要があります。クラスターには継続的なチューニングと容量計画も必要で、本来データが支援するはずの調査からエンジニアを引き離してしまいます。あらゆる判断がコスト、保持期間、システムへの疑問に答えるまでの速度のトレードオフになります。
OpenSearch Serverless の時系列コレクションはトレードオフを取り除きます。インシデントでログ量が急増しても、コンピュートが数秒でスケールして追従するため、エンジニアが待っているログは時間通りに届きます。トラフィックが落ち着けばコンピュートはゼロまでスケールダウンするため、ピーク時の容量に支払い続ける必要はありません。古いデータは低コストのウォーム層に移動しますがクエリは可能なので、保持期間を縮めたりスナップショットを復元したりせずに数年分の履歴を保てます。サイジングやチューニングが必要なクラスターはありません。コンピュートの上限といくつかのインデックス設定を指定すれば、あとはサービスが処理します。
クエリ頻度の低いデータは低コストで
時系列データへのクエリの大半は直近数時間から数日を対象としますが、古いデータはクエリ頻度こそ低いものの、引き続き利用可能にしておく必要があります。新しい index.warm.after 設定で、データがホット層に留まる期間を指定し、低コストのウォーム層へ移動するタイミングを決められます。日単位または時間単位で指定でき、最小 1 日 (24h または 1d) から最大 10 年 (3650d) までの範囲で、インデックスの保持期間を超えることはできません。未指定の場合、データは 1 日後にウォーム層へ移動します。
取り込み時、各ドキュメントは低レイテンシーのホット層と Amazon Simple Storage Service (Amazon S3) の両方に書き込まれます。データが指定した経過期間に達すると、古いものから順にホットコピーが解放され、データは Amazon S3 上のウォーム層に残ります。クエリでウォーム層のデータが必要になると、サービスがそのデータをホット層に読み戻して処理します。該当データへの最初のクエリは時間がかかりますが、同じデータへの以降のクエリはホット層のレイテンシーで実行されます。古いデータに対する調査やレポート作成のように、同じ時間範囲を繰り返しクエリする用途に適しています。クエリが両方の層にまたがる場合も、結果は 1 つのレスポンスで返ります。ホットストレージの料金は、ホット層に残っているデータ分だけ発生します。
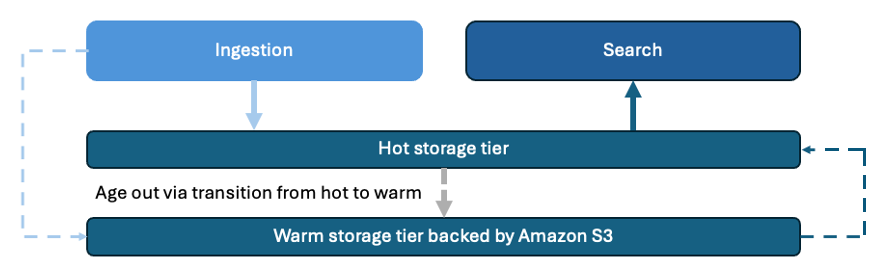
図 1: データは 7 日後にホット層からウォーム層へ移動し、全期間を通じて Amazon S3 に永続化される
ワークロードが必要とする期間だけデータを保持
保持期間はインデックス自体に設定するため、別途ライフサイクルポリシーを作成・維持する必要はありません。インデックステンプレートで index.data.retention を設定すれば、パターンに一致するすべてのインデックスがその設定を継承します。1 日から 3,650 日 (10 年) までの範囲で、日数の整数で指定します。
階層管理と保持期間は独立しています。階層管理はクエリ速度とコストを制御し、保持期間はデータが削除されるタイミングを制御します。たとえばアプリケーションログは 7 日間ホット層に置いて 30 日間保持する、あるいはコンプライアンス要件に合わせて監査データを数年間ウォーム層に残す、といった運用が可能です。監査が必要になったら、同じコレクション内で履歴をクエリするだけで、検索コンピュートが追加負荷に合わせてスケールアップします。スナップショットの復元も、調査用クラスターの立ち上げも不要です。
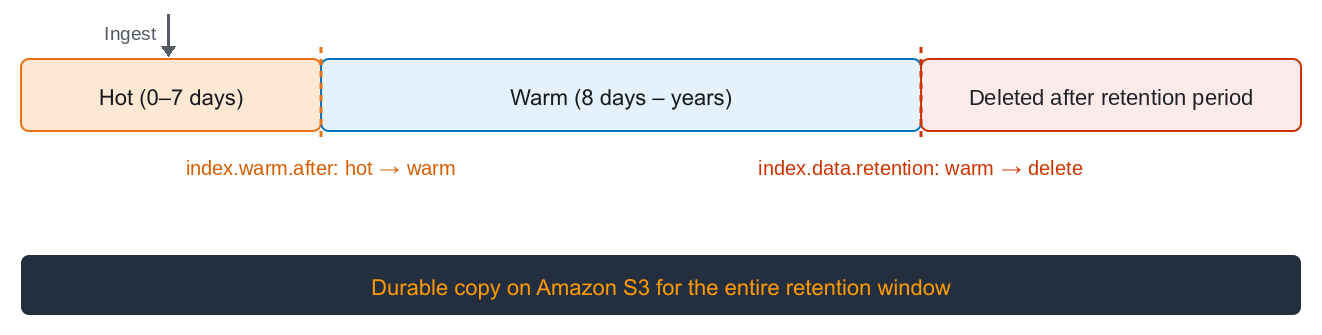
図 2: データの階層管理と保持期間
インデックスごとにイベントタイムスタンプを指定
時系列コレクション内のすべてのドキュメントには、タイムスタンプフィールドが必須になりました。各インデックスには、サービスがデータの整理とソートに使う時刻フィールドが 1 つ指定されており、タイムスタンプが欠落、null、または無効なドキュメントは拒否されます。
デフォルトの時刻フィールドは @timestamp です。イベントが event_time のような別のフィールドをすでに持っている場合は、インデックス作成時またはインデックステンプレートで index.timestamp_field を設定すれば、プロデューサー側を変更せずに済みます。フィールドはトップレベルの date フィールドである必要があり、ドキュメントのタイムスタンプはインデックス登録後に変更できません。
拒否はドキュメント単位で、リクエスト全体には及びません。_bulk リクエストでは有効なドキュメントはインデックス登録され、拒否されたドキュメントはレスポンスの errors ブロックに列挙されるため、1 件の不正レコードでバッチ全体が失敗することはありません。
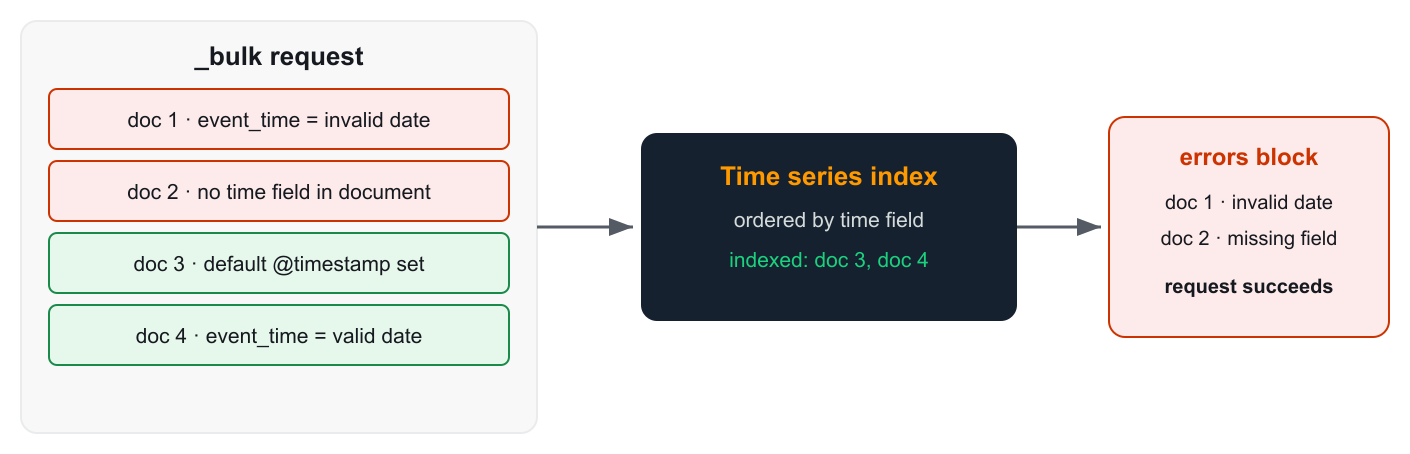
図 3: 時刻フィールドが各ドキュメントのインデックス登録または拒否を決める仕組み
障害に発展する前に問題を見つける
時系列コレクションではアラートと異常検知も使えるようになりました。従来の Classic サーバーレスコレクションでは提供されていなかった機能です。別のシステムに頼って不具合を知らせてもらう代わりに、データを保存しているコレクション自体で監視、検知、通知ができます。運用チームはエラー率やレイテンシーの急増時に通知を受け取れ、セキュリティチームはログイン失敗の急増を検知でき、ビジネスチームは注文数の急落を発見できます。
アラートモニターはスケジュールに従ってデータをクエリし、条件が満たされると選択したチャネルを通じて通知します。Per-query モニターは、平均レイテンシーがしきい値を超えるなど、単一の値に対してアラートを発します。Per-bucket モニターは、エラー率が上がりすぎたホストごとなど、グループを個別に評価します。PPL モニターは Piped Processing Language (PPL) で、より複雑なロジックを扱えます。
異常検知は Random Cut Forest (RCF) 機械学習アルゴリズムでデータの通常パターンを学習し、固定しきい値を推定することなく、ほぼリアルタイムで逸脱を検出します。検出器の結果にモニターを向けておけば、異常が現れた瞬間に通知を受け取れます。
モニターと検出器は OpenSearch UI ワークスペースで管理し、アクセス権はワークスペースのコラボレーター権限に従います。読み取り専用のコラボレーターはモニターとアラートを閲覧でき、読み書きおよび管理者のコラボレーターは作成、更新、確認応答も可能です。Observability ワークスペースではアラートがダッシュボードや PPL クエリと並んで配置されるため、サーバーレスコレクションや既存の Amazon OpenSearch Service ドメインを横断して、アラートから背後のイベントまでたどれます。
使ってみる
ワンクリックで始めるなら、Amazon OpenSearch Service コンソールの Express Create を使います。コレクショングループ、暗号化、ネットワークアクセス、データアクセスを自動で設定してくれます。各ステップを自分で制御したい場合は、以下のように AWS Command Line Interface (AWS CLI) を使います。
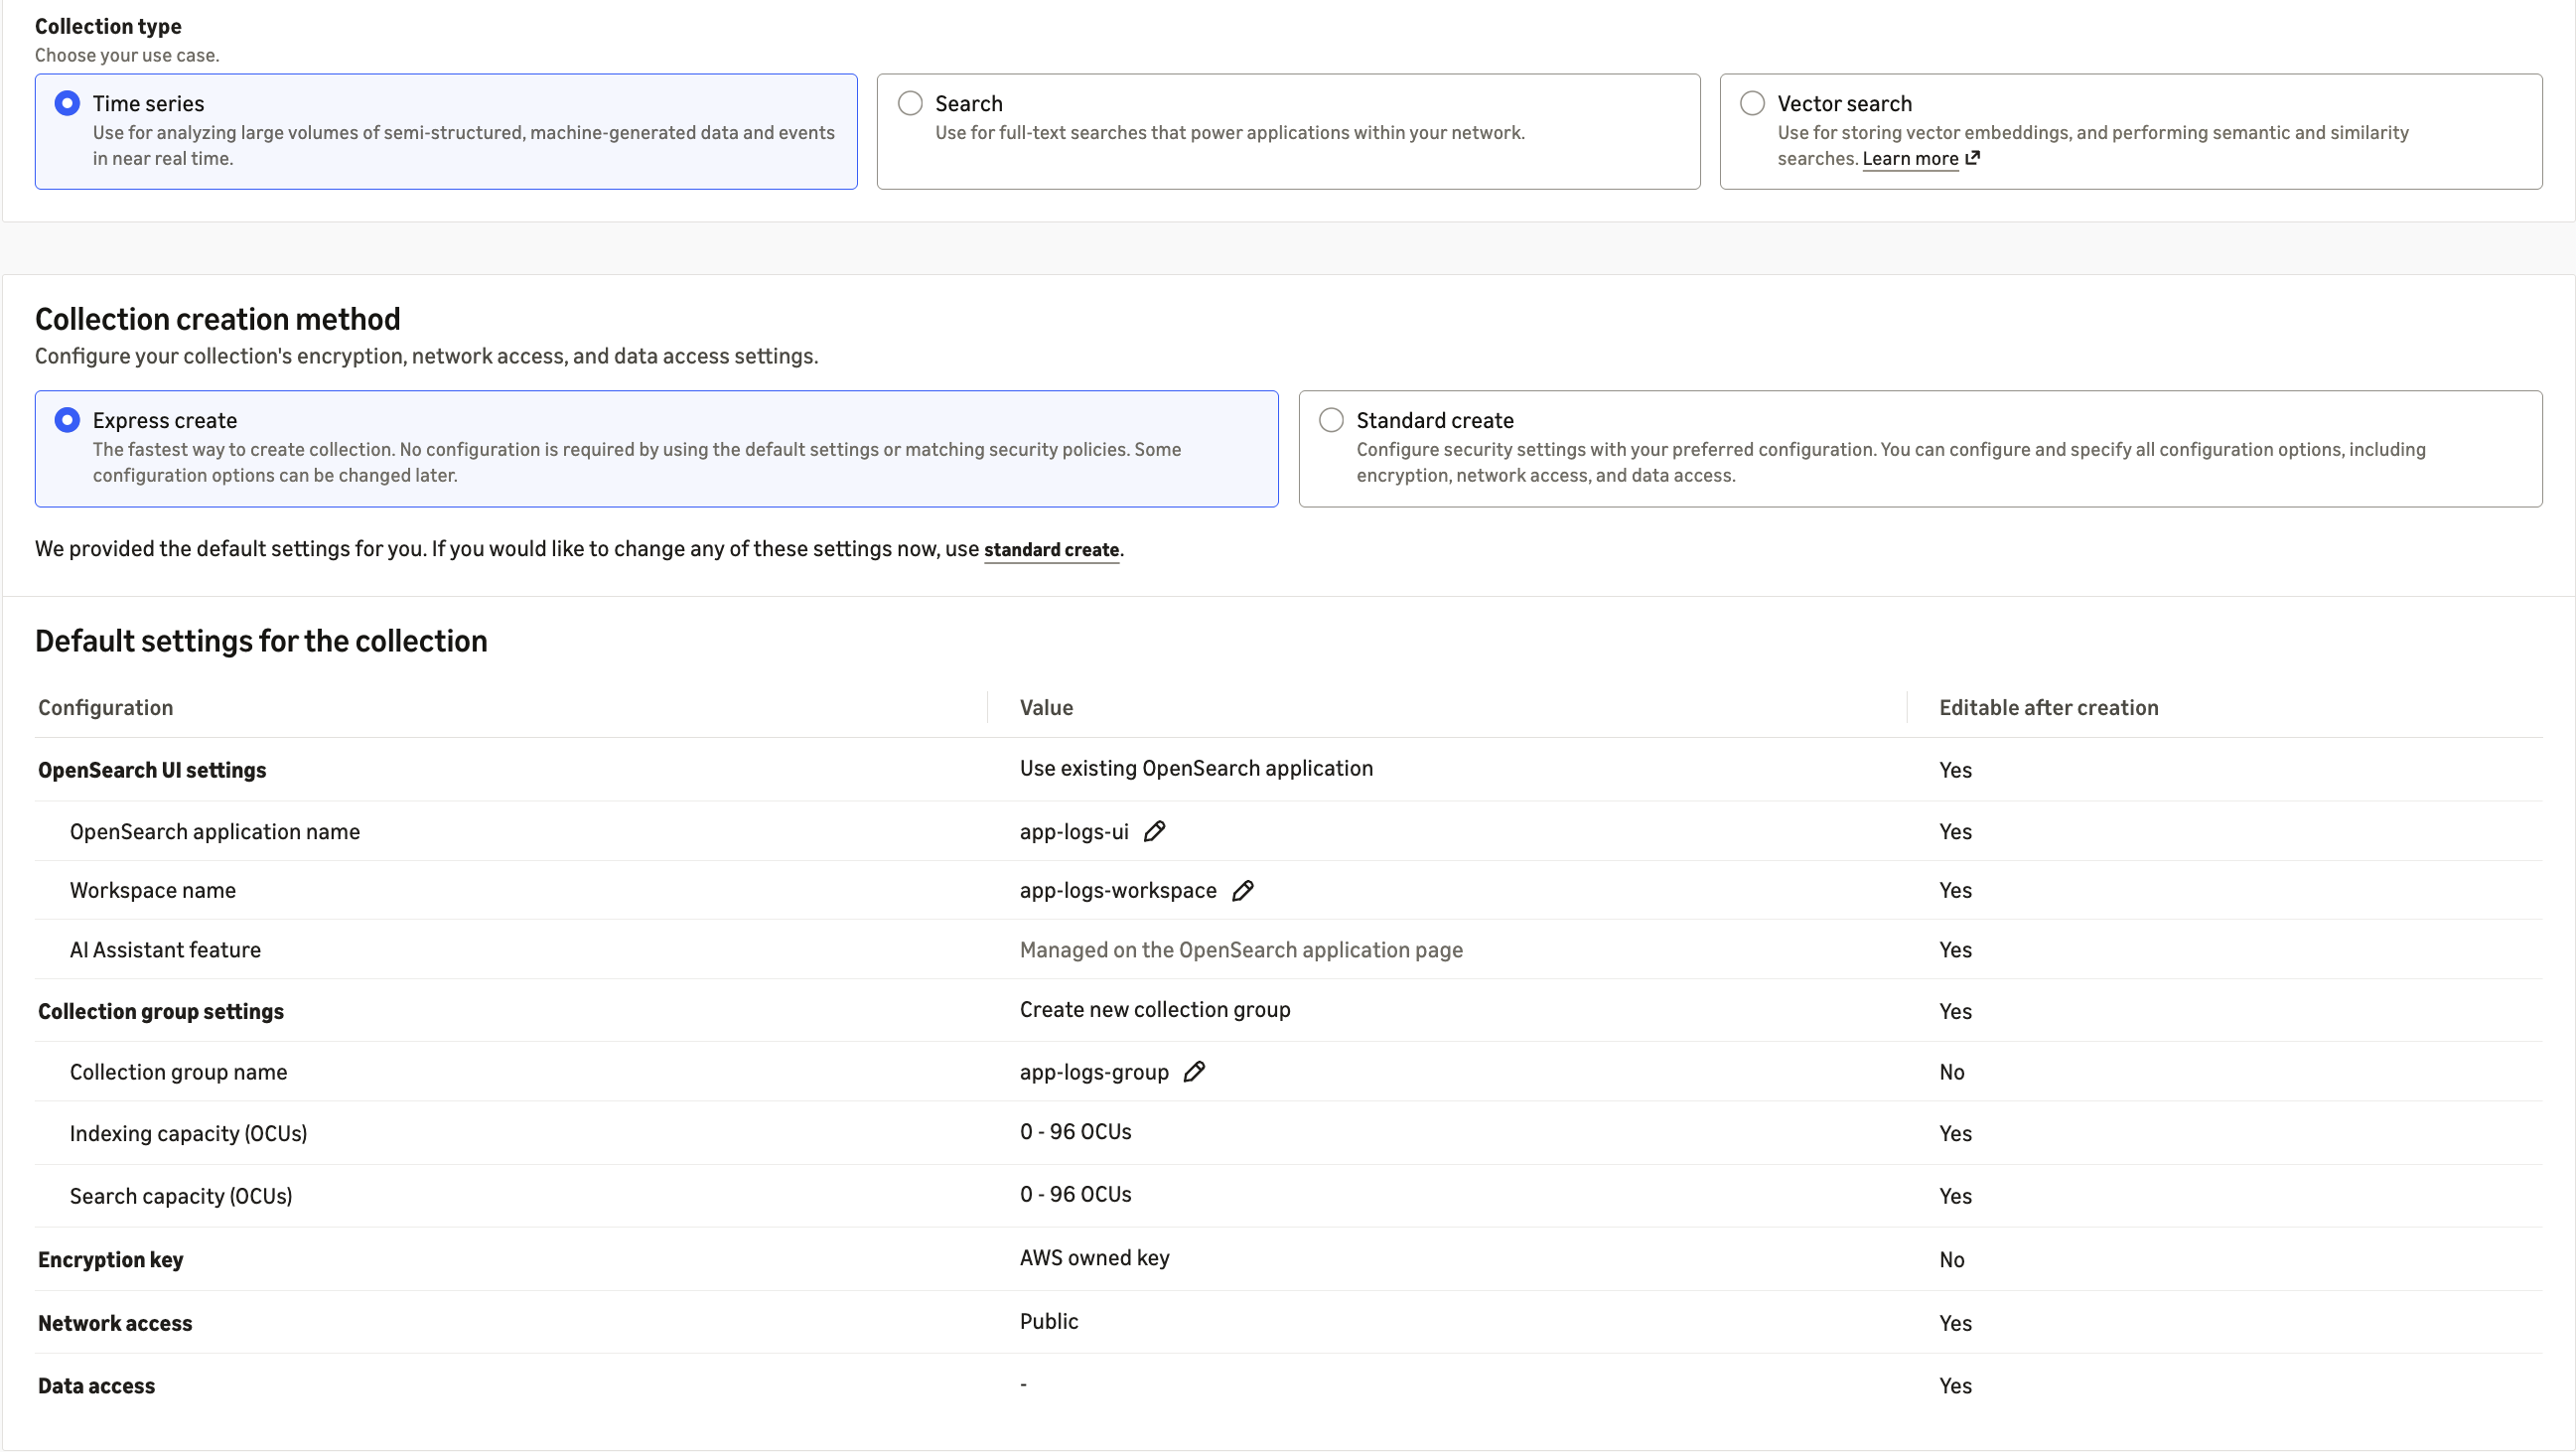
図 4: Express Create がデフォルト設定でコレクショングループ、暗号化、ネットワークアクセスを設定する様子
まず、NextGen のコレクショングループを作成します。コレクショングループは、所属するすべてのコレクションで共有するコンピュート上限を設定します。OpenSearch Compute Unit (OCU) の最小値を 0 にすれば、アイドル時にグループをゼロまでスケールダウンでき、最大値で支出に上限を設けられます。
次に、コレクションへアクセスできる場所を制御する ネットワークポリシー と、どの AWS Identity and Access Management (IAM) プリンシパルがデータを読み書きできるかを制御する データアクセスポリシー を作成します。
続いて、コレクショングループ内に時系列コレクションを作成します。
コレクションがアクティブになったら、時刻フィールド、階層管理、保持期間の設定を含むインデックステンプレートをワークロードに合わせて作成します。名前がパターンに一致するすべてのインデックスが、以下の設定を自動で引き継ぎます。
最後にデータをコレクションに取り込み、OpenSearch UI の Observability ワークスペースを開いて、最初のダッシュボード、モニター、異常検出器を作成します。
本日提供開始
時系列コレクションは、NextGen の OpenSearch Serverless が利用可能なすべての AWS 商用リージョン で本日から提供されます。料金は OCU 単位で使用したコンピュートと、GB 月単位のホットおよびウォームストレージに対して発生します。詳細は Amazon OpenSearch Service 料金ページ をご覧ください。
詳しくは、Amazon OpenSearch Serverless 製品ページ と Amazon OpenSearch Serverless 開発者ガイド を参照してください。
Amazon OpenSearch Service コンソール でぜひお試しいただき、AWS re:Post または普段ご利用の AWS サポート窓口からフィードバックをお寄せください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Sotaro Hikita がレビューしました。