Amazon Web Services ブログ
NTTドコモ モバイルイノベーションテック部における AI-DLC 実践(第1回):フィジカルAI領域でのML開発への適用
※ この投稿はお客様に寄稿いただいた記事です。
本稿では、株式会社NTTドコモ(以下、ドコモ)モバイルイノベーションテック部(以下、MIT 部)が AI-DLC(AI-Driven Development Lifecycle) の TTT(Train The Trainer)に参加し、フィジカル AI 領域における機械学習パイプラインを 3 日間で構築した取り組みについて、全 2 回に分けてご紹介します。
1. はじめに
ドコモの MIT 部ユースケース協創担当では、次世代技術の社会実装に向けた研究開発を推進しています。
私は、注目領域の一つであるフィジカル AI(現実世界で物理的に動作する AI)において、ロボットアームの動作学習を効率化するパイプラインの構築に取り組んでいます。
今回、AWS が提唱する AI-DLC の手法を活用し、模倣学習(IL: Imitation Learning)で獲得した動作知識を強化学習(RL: Reinforcement Learning)で自律的に改善していくパイプラインを 1 つのプロダクトとして捉え、その設計から実装までを AI-DLC のプロセスに沿って、チーム開発で 3 日間という短期間で構築・検証しました。
本記事(第 1 回)では、AI-DLC を ML 領域に適用するに至った私たちの理解と判断、そして Inception フェーズでの要件構造化と設計レビューの実践についてご紹介します。
2. 背景と課題
フィジカル AI における学習の課題
ロボットに動作を学習させるアプローチには、大きく分けて 2 つの方法があります。
- 模倣学習(Imitation Learning, IL):人間のデモンストレーションデータから動作を学習する。学習は安定するが、デモにない状況への汎化が難しい
- 強化学習(Reinforcement Learning, RL):試行錯誤を通じて報酬を最大化するように学習する。未知の状況にも対応できるが、ゼロからの学習はサンプル効率が低い
私たちが対象としたのは、SO-101 ロボットアーム(オープンソースの廉価な 6 軸卓上アーム)による「キューブを持ち上げる」タスクです。
本来模倣学習には 50 件程度のデモデータが推奨されますが、私たちは人手を最小限にしたいと考えており 10 件のデータを収集することから出発しました。模倣学習モデル(ACT: Action Chunking with Transformers)はこの 10 件で成功率 10% でしたが、NVIDIA の提供する COSMOS(物理法則を理解した映像生成によりデータを合成する World Foundation Model)や Mimic(少数のデモから大量の合成軌道を自動生成するデータ増幅フレームワーク)によるデータ増幅を適用したところ、成功率は 45% まで向上しました。しかし、デモデータ 10 件という母数では増幅の効果にも限界があり、改善は頭打ちになりました。
これ以上の改善にはデモデータの追加収集か、別のアプローチが必要です。私たちの目的は少ないデータでタスク成功率を上げることなので、データ収集を増やす方向ではなく、強化学習を組み合わせる方向を選びました。
採用手法:RPD(Refined Policy Distillation)
この課題に対して、私たちは RPD(Refined Policy Distillation) 論文のアプローチを採用しました。RPD は、大規模な模倣学習モデルの知識を軽量なポリシーに蒸留し、さらに強化学習で改善するフレームワークです。
RPD の基本的な流れは以下の通りです。
- 蒸留:大規模モデル(VLA 等)の動作知識を、軽量な MLP(Multi-Layer Perceptron)に教師あり学習で圧縮する
- PPO(Proximal Policy Optimization) Fine-tune:蒸留済み MLP を初期ポリシーとして、KL ペナルティ付きの強化学習で改善する。KL(Kullback-Leibler)ペナルティは、元のモデルをオンラインで推論し、その出力を参照分布として「蒸留ポリシーから離れすぎない」よう制約をかける
RPD 論文では、教師として大規模 VLA(Vision-Language-Action)モデルをリアルタイムで推論しながら KL ペナルティの参照分布に使います。一方、私たちの実装では VLA の代わりに ACT から蒸留した重み固定 MLP を参照分布として使用しました。この前提の違いが実験結果にどう影響したかは第 2 回で詳述します。
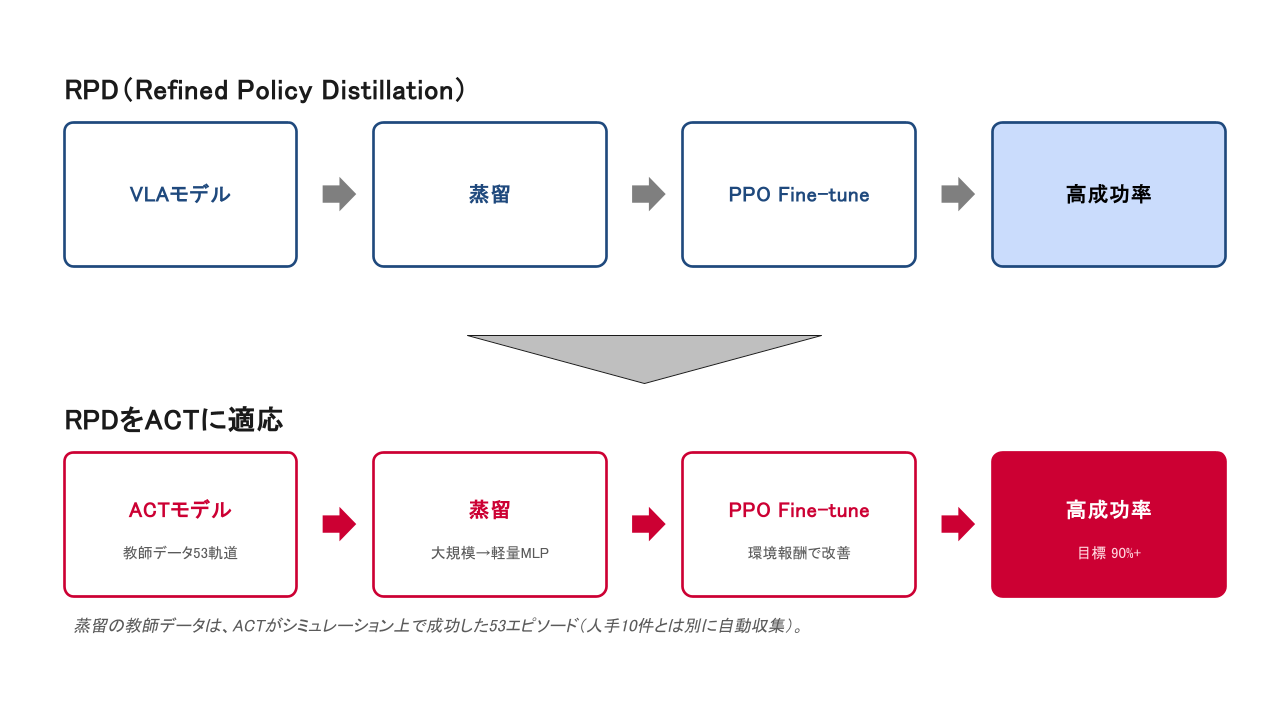
図:RPD 論文のアプローチ(上)と私たちの ACT への適用(下)
ML 開発特有の課題
機械学習パイプラインの構築は、一般的なソフトウェア開発とは異なる課題を持っています。
- 不確実性が高い:論文との細かな前提の差異などから、論文通りに実装しても動作する保証がない
- 専門知識が広範:強化学習の理論、シミュレータの仕様、座標系変換など複数のドメイン知識が必要
- 実験サイクルが長い:仮説→実装→学習→評価のサイクルに時間がかかる
これらの課題は、チームでの開発において「何を作るか」「なぜこの設計にするか」の共有コストを増大させます。
個人で AI と対話しながらコーディングを進める「Vibe Coding」のアプローチでは、こうした構造的な課題を 1 つ 1 つ対話の中で解消しても、その判断やコンテキストが流れてしまい蓄積されません。これでは個人でも知見の蓄積が難しいだけでなく、組織的な研究開発となるとさらに顕著な課題になるのではないかと考えました。
3. AI-DLC 理解と適用判断
AI-DLC とは何か
AI-DLC は、AI を開発プロセス全体に組み込むためのフレームワークです。私たちは TTT を通じて、以下のように理解しました。
AI-DLC の核心は、AI が作業計画を体系的に作成し、人間が意思決定に集中する協働モデルです。具体的には以下のフェーズで構成されます。
- Inception フェーズ:ユーザーストーリーの定義、要件の構造化、設計レビュー。AI が専門知識を補完しながら、人間が「何を作るか」を決定する。Inception の最後で分けた Unit ごとに小規模なモブチームを形成する。
- Construction フェーズ:Unit ごとのモブチームが詳細設計、実装、テストを並行で進める。AI がコード生成を担い、人間がレビューと意思決定を行う。
- Operation フェーズ:デプロイ、運用への移行。
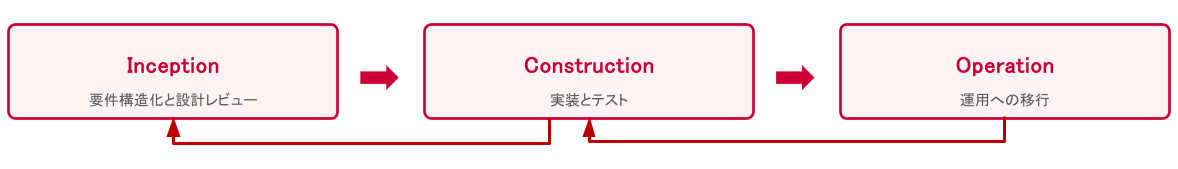
図:AI-DLC の3フェーズ
従来の「Vibe Coding」との違いは、チーム全体で共有可能な構造化ドキュメント(ユーザーストーリー、設計文書、レビューレポート)が生成される点です。これにより、AI と個人の間の暗黙知がチームの共有知に変わります。
なぜ ML 領域に適用したか
AI-DLC の既存事例は Web サービスや業務アプリ開発が中心ですが、私たちは ML 開発への適用をチャレンジしてみました。理由は 3 つあります。
- 論文→実装のギャップを埋める:研究開発では論文の手法を実装に落とし込む過程で、前提条件の違いや暗黙の仮定が問題になる。Inception フェーズで AI と対話しながら要件を構造化することで、これらの曖昧さを事前に可視化できるのではないかと考えました。
- チーム学習の加速:私たちはフィジカル AI に取り組み始めたばかりのチームです。強化学習やシミュレータの専門知識は属人性が高いため、AI-DLC の構造化ドキュメントを通じて、チーム全員が同じ理解水準で議論できる環境を作れると考えました。
- 実験サイクルの管理:ML 実験は「仮説→実装→学習→評価→修正」のサイクルを高速に回す必要がある。AI-DLC のチェックポイント(Inception→Construction→Operation→評価)が、方針転換の判断基準を明確にすると考えました。
私たちは、要件の構造化と設計レビューというプロセスが、不確実性が高く前提条件の検証が必要な ML 開発に適応できるのではないかと考えました。本記事はあくまで ML 領域への適用事例として、私たちの TTT での経験と見解を中心にご紹介するものです。
4. AI-DLC TTT の概要
以上の背景を踏まえ、TTT で実際に取り組んだ内容をご紹介します。
テーマ設定
具体的な目標は以下の通りです。
人手によるデモデータ収集を最小限に抑えつつ、模倣学習によって習得したロボットアームの動作を、強化学習を用いて自律的にブラッシュアップしていくパイプラインを1つのプロダクトとして捉え構築する
参加者を 2 チーム(チームピンク、チームブルー)に分けました。
強化学習を最終段階とするパイプライン構造は共通ですが、ベースとなるモデルが模倣学習の直接的な出力ではなく RPD 論文に基づく蒸留を経由する設計であり、どのように変換を行うかは未検証でした。
そのため、チームごとでアプローチを決め並行して比較検証する方針としました。
両チームの設計判断の詳細は第 2 回でご紹介します。
事前準備
AI-DLC で効果的に開発を進めるために、以下を事前に準備しました。
- 学習データ:ACT の実行から得た成功軌道データ 53 エピソード(蒸留の教師データとして使用。人手で収集した 10 件とは別に、ACT がシミュレーション上で成功した軌道を自動収集したもの)
- 参考論文:RPD、ACT、Knowledge Distillation、PPO の 4 本
- 設計概要ドキュメント:環境差分、手法の設計思想、データ概要
- Amazon EC2 インスタンス:g6e.8xlarge(NVIDIA L40S 48GB)に Isaac Lab(NVIDIA が提供する GPU 並列ロボット学習シミュレーションフレームワーク)環境を構築済み
5. Inception フェーズ:要件構造化(Day 1)
ML パイプラインをプロダクトとして AI-DLC のプロセスに載せた Inception フェーズの具体例を以下に示します。
Inception フェーズでは、フィジカル AI に関する論文や専門情報を Kiro に読み込ませ、要件の構造化とスコープ決定を行いました。
図:チームピンクの Inception の様子、右下に映っているのが SO-101
タスクリストの定義
Kiro との対話を通じて、4 つのタスクリストを定義しました。
| # | タスクリスト | 優先度 |
|---|---|---|
| TL-1 | 蒸留用データの準備(座標系変換+データ整形) | 最高 |
| TL-2 | MLP の蒸留(教師あり学習) | 高 |
| TL-3 | PPO Fine-tune(強化学習による改善) | 高 |
| TL-4 | 評価と比較(100 エピソード評価) | 中 |
各タスクリストには具体的な受け入れ基準を設定しました。たとえば TL-1 では「座標変換後の joint_pos_rel の範囲が [-2.2, 1.5] 程度であること」「NaN/Inf が含まれていないこと」など、ML 特有の検証項目を含めています。
ユニット分割とデータフロー設計
パイプライン全体を 3 つの実装ユニットに分割し、データフローを設計しました。
なお、TL-4(評価)は Unit 3 の出力を受けて実行する工程として Unit 3 に含めています。
以下はチームピンクのデータフローとコンテキストマップです。
act_demos.npz (Amazon S3):座標変換 + データ整形【Unit 1】
    ↓
obs_flat (12次元) + act_flat (6次元):教師あり学習(蒸留)【Unit 2】
    ↓
distilled_mlp.pt:PPO Fine-tune (KLペナルティ付き)+評価【Unit 3】
    ↓ model_<iter>.pt:100エピソード実行【Unit 3】
    ↓
evaluation_report.md
図:コンテキストマップ

図:データフロー(act_demos.npz → 座標変換 → 蒸留 → PPO → 評価)
設計レビューの効果
Inception フェーズではモブスタイル(Mob Inception)を採用し、チーム全員が Kiro を囲んで対話しながら設計を進めました。
この過程で Kiro が設計レビューを実施し、実装前に 11 個の不整合を検出しました。
モブスタイルと AI による支援の組み合わせにより、チーム内でのイメージのすり合わせと合意形成にかかる時間を短縮でき、実際にコードに反映できた点は、AI-DLC ならではの効果だと思いました。
発見された不整合の例:
- チェックポイント形式の不一致(RSL-RL が期待する actor/critic 分離形式との差異)
- 入力次元の食い違い(12D と 28D の混在)
- アクションスケールの不整合(環境間で /0.5 の変換が必要)
これらを実装前に検出できたことで、Construction フェーズでの手戻りを削減できました。ML 実装では「コードが動くが出力が正しくない」という不具合が起きやすいため、設計段階での整合性チェックは価値が高いと実感しました。
第 1 回のまとめと次回予告
本記事では、AI-DLC をフィジカル AI(ML)領域に適用するに至った私たちの理解と判断、そして Inception フェーズでの要件構造化と設計レビューの実践についてご紹介しました。
Inception フェーズだけで、設計レビューにより 11 個の不整合を検出し、30 以上の構造化ドキュメントを生成しました。
第 2 回では、Construction フェーズでの 2 チーム並行開発の実験結果をご紹介します。チームブルーが当初スコープの断念から AI-DLC のフレームに従って軌道修正し成果を出したエピソードや、蒸留初期化についての知見についてお伝えします。