Amazon Web Services ブログ
Amazon EMR のマルチカタログでアカウントとテーブルフォーマットをまたいだクエリを実行する
本記事は 2026 年 10 月 6 日 に公開された「Query across accounts and table formats with multi-catalog in Amazon EMR」を翻訳したものです。
AWS 上の分析チームは、データを複数のオープンテーブルフォーマットで保存していることが多く、そのデータが複数の AWS アカウントに分かれて置かれていることも少なくありません。そこから 2 つの課題が生じます。カタログレベルの複雑さを持ち込まずにテーブルフォーマットをまたいでクエリすること、そしてデータをコピーせずにアカウント間でデータを結合することです。ドメインチームが別々の AWS アカウントでデータを所有し、分析ワークロードは中央で実行されるデータメッシュでは、よく見られる構成です。Amazon EMR 8.1.0 のマルチカタログサポートは、この 2 つの課題を解決します。
Amazon EMR リリース 8.1.0 は、マルチカタログサポートでこの 2 つの課題に対応します。RedirectingSessionCatalog (RSC) は、Spark のデフォルトカタログとして設定するオプトインのカタログです。AWS Glue のメタデータから各テーブルのフォーマットを自動検出してクエリを適切なフォーマットハンドラーにルーティングし、AWS アカウントをまたいだ複数の AWS Glue Data Catalog をサポートします。マルチカタログサポートにより、Iceberg、Hudi、Delta Lake、Hive のテーブルを 1 つの統合カタログでクエリできます。さらに、データをコピーせずに AWS アカウント間でテーブルを結合したり、クエリ実行時にリモートカタログを動的に検出したりできます。
本記事では、Amazon EMR Serverless を使ってこれらの機能を実際に活用する方法を紹介します。
Spark の単一カタログの制約
複数のフォーマット。Spark のデフォルトカタログ (spark_catalog) が受け付ける CatalogExtension は一度に 1 つだけです。Iceberg なら SparkSessionCatalog、Delta Lake なら DeltaCatalog、Hudi なら HoodieCatalog です。いずれか 1 つを設定すると、他のフォーマットのテーブルに対するクエリは、そのテーブルを別のフォーマット固有のカタログに登録していない限り失敗します。
複数のアカウント。Spark の V1 メタストア (ExternalCatalog) はシングルトンで、1 つのアカウントの 1 つの AWS Glue Data Catalog に結び付けられます。Spark の V2 カタログ API は名前付きカタログをサポートしますが、使っているのは Iceberg だけです。Delta Lake、Hudi、Hive のテーブルは依然として V1 に依存しています。そのため、これらのフォーマットでクロスアカウントアクセスを実現するには、複雑で多段階の回避策が必要でした。具体的には、AWS Lake Formation の権限付与、AWS Resource Access Manager (AWS RAM) の共有、リソースリンク、テーブル単位の権限設定などです。
Amazon EMR 8.1.0 は、次のセクションで説明する RedirectingSessionCatalog でこの 2 つの制約を解消します。
RedirectingSessionCatalog
RedirectingSessionCatalog は、オプトインで後方互換性のある 3 つの機能を提供します。RSC をデフォルトカタログに設定すると、フォーマット固有のプレフィックスなしでマルチフォーマットのクエリを実行できます。名前付きの RSC カタログを宣言すると、データをコピーせずにアカウント間で結合できます。AWS Glue Data Catalog リゾルバーを有効にすると、spark.sql.catalog.* の事前設定なしに、クエリ実行時にリモートカタログを検出して登録できます。以降のセクションで各機能を説明します。
マルチフォーマットサポート
Amazon EMR 8.1.0 では、デフォルトカタログを RedirectingSessionCatalog (RSC) に設定します。テーブルの解決時に、RSC は AWS Glue Data Catalog を呼び出してメタデータからテーブルのフォーマットを読み取り、結果をキャッシュしたうえで、対応するフォーマット固有のカタログ (Iceberg、Delta Lake、Hudi、Hive のいずれか) に処理を委譲します。
マルチフォーマットサポートがなければ、フォーマットごとに別々のカタログを登録し、すべてのテーブル参照にプレフィックスを付ける必要がありました。
マルチフォーマットサポートを使うと、カタログのプロパティ 1 つで済みます。
設定内容:
クエリの書き方:
テーブルの解決時、RSC は次の処理を行います。
- AWS Glue Data Catalog を呼び出してテーブルのメタデータを読み取る。
- テーブルの Parameters マップを調べてフォーマット (Iceberg、Delta Lake、Hudi、Hive/Parquet のいずれか) を判定する。
- 適切なフォーマット固有のカタログ実装に操作を委譲する。
次の図は、1 つのクエリが RedirectingSessionCatalog を通って適切なフォーマットハンドラーに届く流れを示しています。
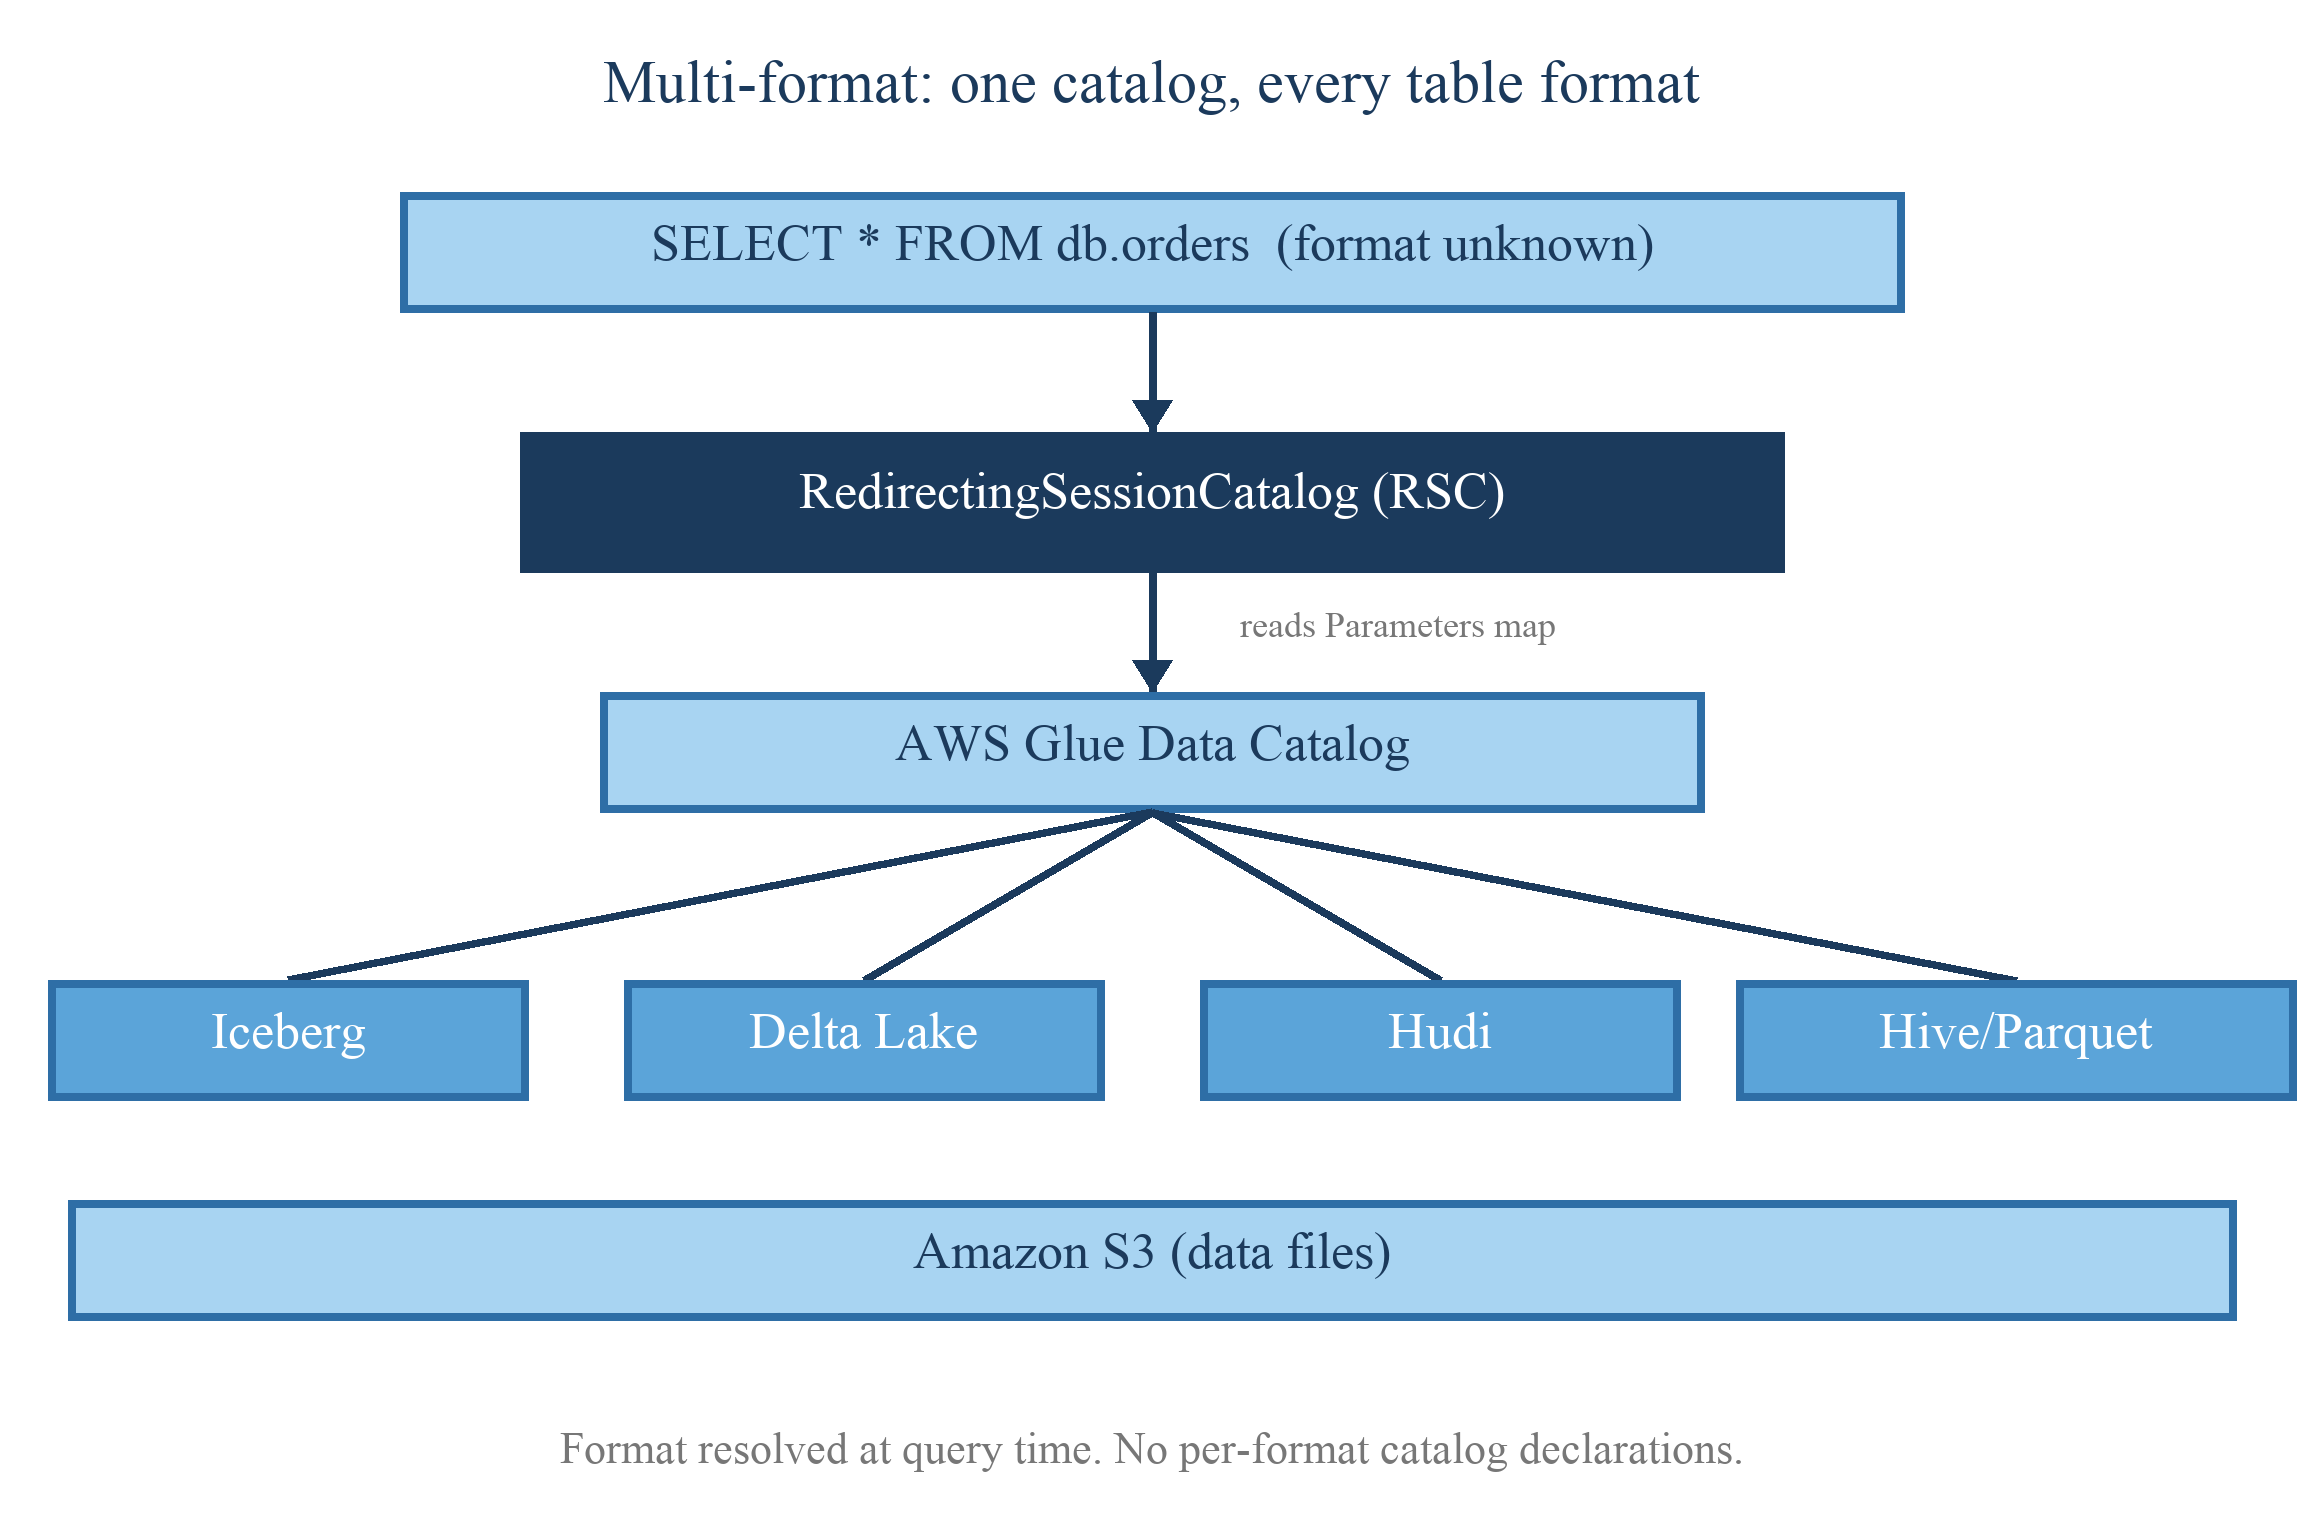
図 1: マルチフォーマットルーティング。1 つのクエリが RedirectingSessionCatalog に入ると、RedirectingSessionCatalog は AWS Glue Data Catalog を呼び出して各テーブルのフォーマットを読み取り、対応するフォーマット固有のハンドラー (Iceberg、Delta Lake、Hudi、Hive のいずれか) にテーブルをルーティングするため、結果は 1 つのカタログから返される
図のように、クエリは spark_catalog (RSC) から入ります。RSC は AWS Glue Data Catalog から各テーブルのフォーマットを読み取り、対応するエンジン (Iceberg、Delta Lake、Hudi、Hive/Parquet) に操作をルーティングします。4 つのフォーマットハンドラーは、基盤となるデータファイルを Amazon Simple Storage Service (Amazon S3) から読み取ります。呼び出し側は、フォーマット固有のカタログプレフィックスなしで 1 つのクエリを発行するだけです。
マルチカタログ: クロスアカウントアクセス
本番データが分析用コンピューティングとは別の AWS アカウントにある場合は、そのアカウントの AWS Glue Data Catalog を指す名前付きの RSC カタログを宣言できます。RSC はリモートアカウントのテーブルもローカルテーブルと同じ方法で解決するため、データをコピーせずに 1 つのクエリでアカウント間の結合ができます。
以前は、クロスアカウントのテーブル解決は Iceberg (V2 カタログ) でしか機能しませんでした。別のアカウントにある Hive、Delta Lake、Hudi のテーブルには、カタログレベルの解決ではなく、Lake Formation と AWS RAM の手動設定が必要でした。Amazon EMR 8.1.0 では、リモートアカウント用に名前付きの RSC カタログを宣言します。
設定:
クエリ:
名前付きの RSC インスタンスはそれぞれ独自の V1 メタストアデリゲートを作成してグローバルな SessionCatalog に登録するため、シングルトンの制限がなくなります。
次の図は、1 つのクエリが名前付きカタログを使って 2 つの AWS アカウントにあるテーブルを結合する様子を示しています。
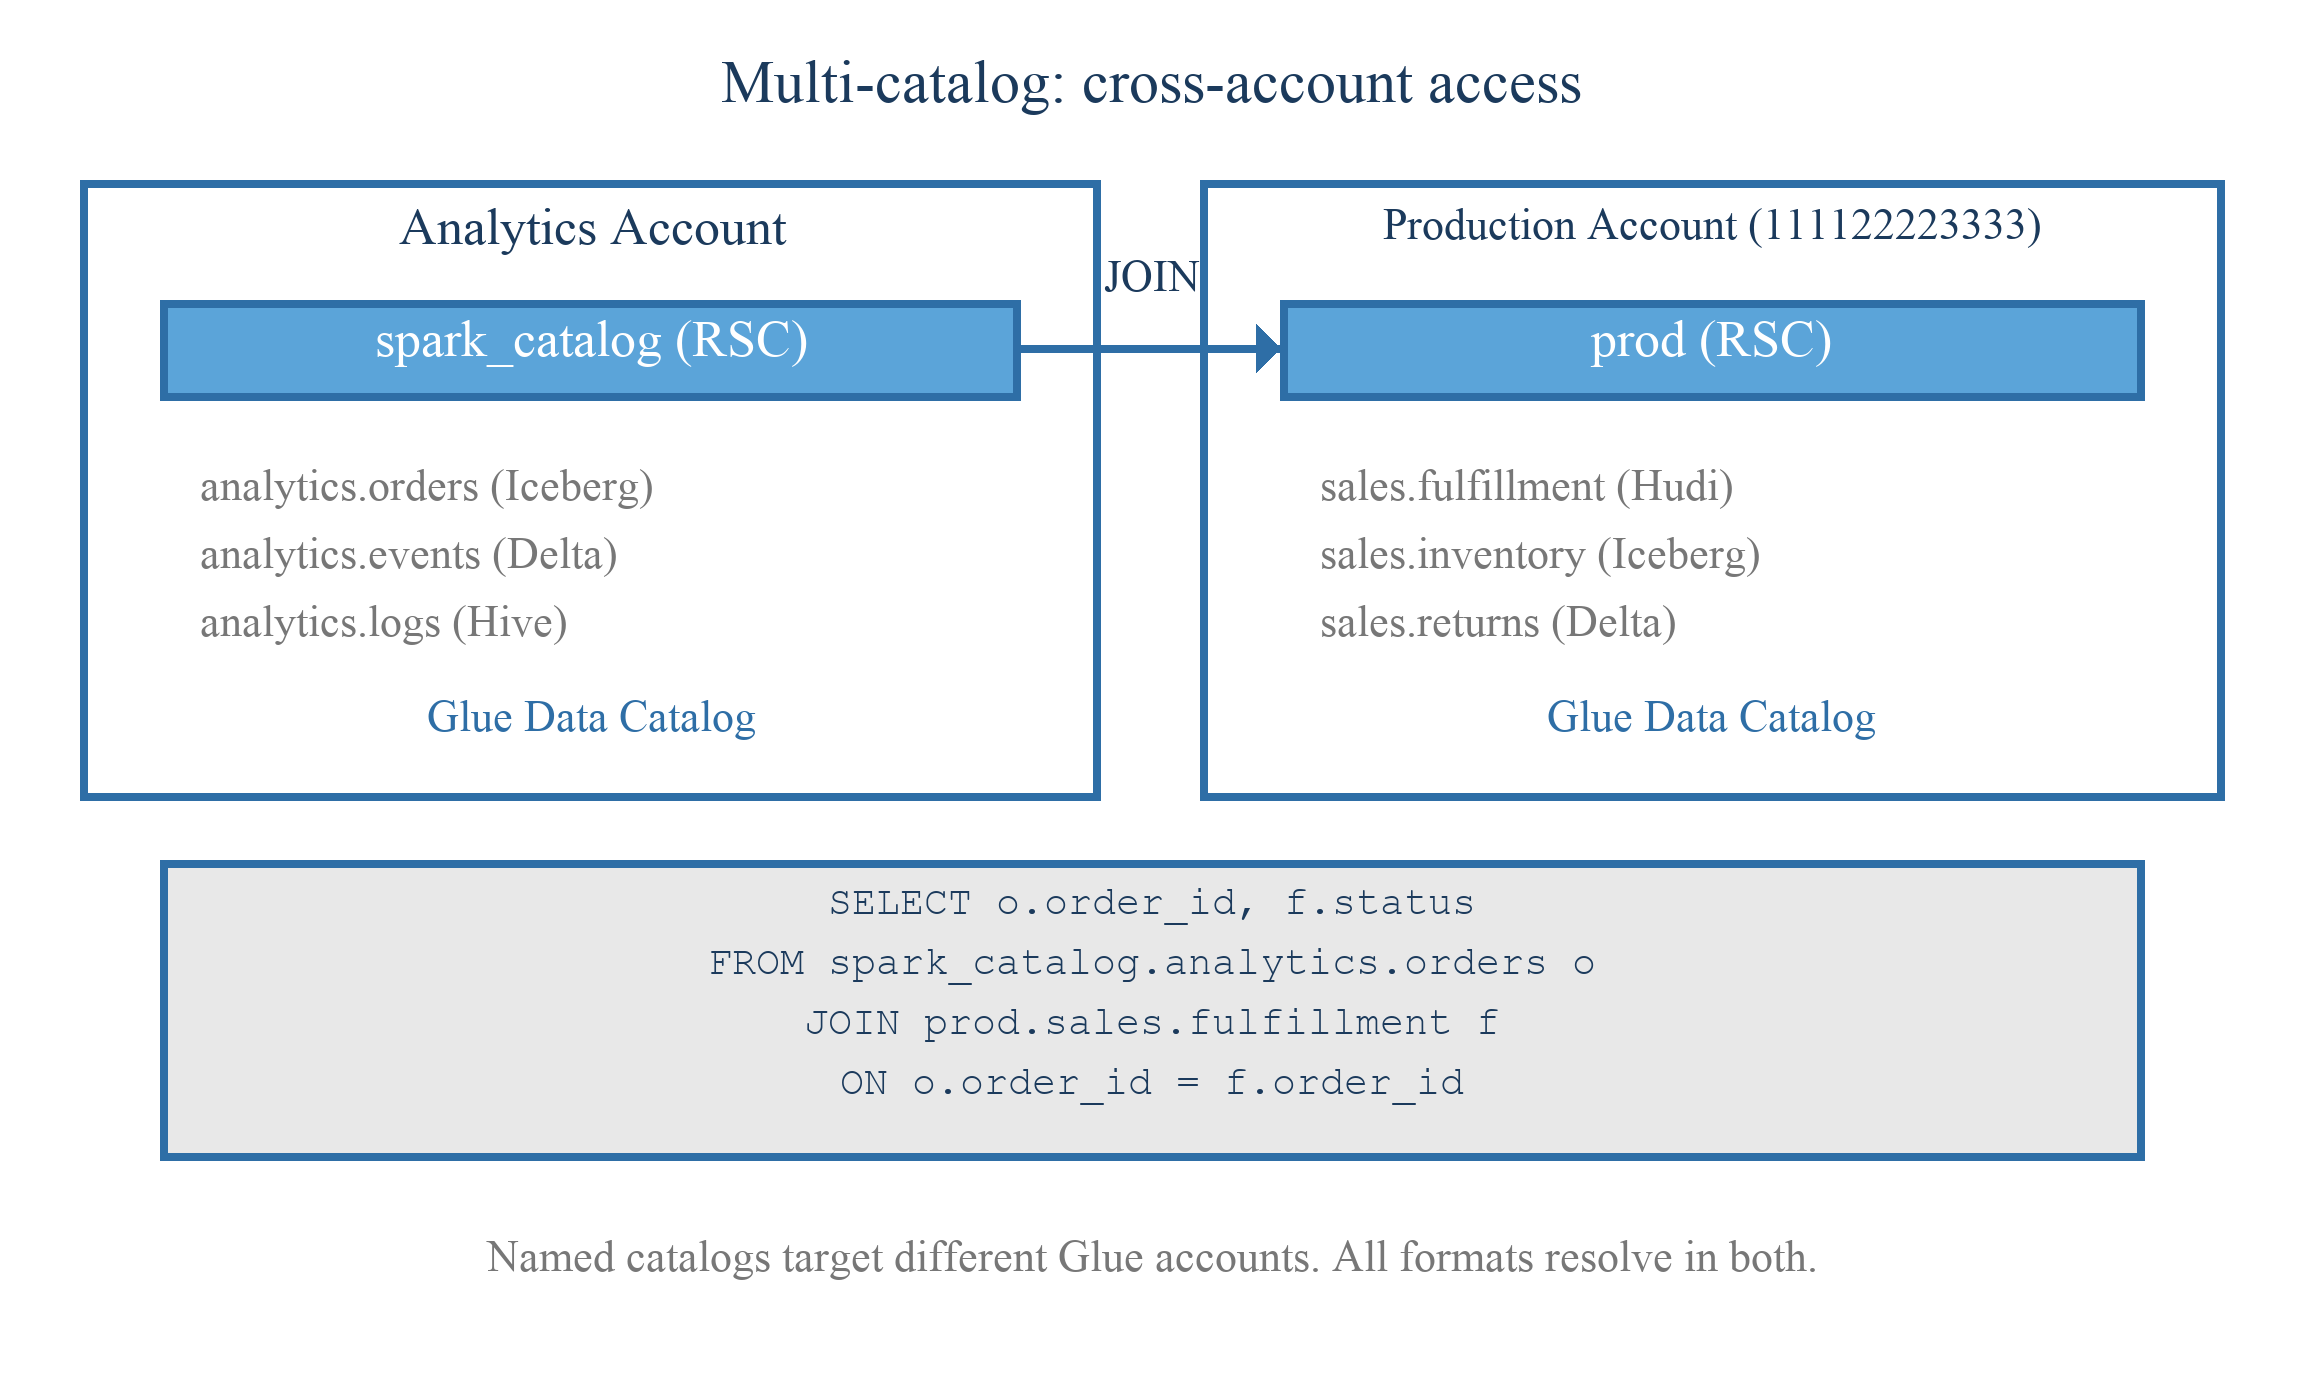
図 2: クロスアカウントアクセス。ローカルアカウントのクエリが、別のアカウントの AWS Glue Data Catalog を指す名前付きの RSC カタログを参照するため、アカウント間でデータをコピーせずにローカルとリモートのテーブルを 1 つのクエリで結合できる
図のように、分析アカウントはローカルの Glue Data Catalog に spark_catalog (RSC) を使い、名前付きカタログ (prod) は本番アカウントの Glue Data Catalog を指しています。2 つのアカウントにまたがる JOIN が示すように、クエリはローカルテーブルとリモートテーブルを 1 つのステートメントで結合します。各アカウントはそれぞれの Glue Data Catalog を保持し、アカウント間でデータはコピーされません。
自動ワイヤリング
前述のマルチカタログの設定では、各リモートカタログを spark.sql.catalog.* プロパティで事前に宣言する必要があります。Amazon EMR 8.1.0 の自動ワイヤリング (Auto-wiring) は、この要件を 2 つのレベルで取り除きます。
Amazon EMR 8.1.0 より前は、リゾルバー、フォーマットごとのハンドラー、各ハンドラーのデリゲートクラスを明示的に宣言していました。
自動ワイヤリングを使うと、次のように簡略化できます。
設定:
クエリ:
AWS Glue Data Catalog リゾルバーはオプトインです。有効にすると、未登録のカタログをクエリが参照するたびに、Amazon EMR が AWS Glue の GetCatalog API を呼び出します。存在しないカタログ名に対する意図しない API 呼び出しを避けるため、デフォルトでは有効になっていません。
ハンドラーレベルでは、デフォルトカタログを RedirectingSessionCatalog に設定するだけで十分です。Amazon EMR が Iceberg、Delta、Hudi のハンドラーを自動的に補うため、handler.* プロパティを書く必要はありません。
カタログレベルでは、Glue カタログリゾルバーを有効にすると、Amazon EMR が新しいカタログをオンデマンドで検出します。未宣言のカタログをクエリが初めて参照したときに、Amazon EMR は AWS Glue の GetCatalog API を呼び出し、接続タイプを調べて、クエリ実行時にそのカタログを登録します。
Amazon EMR 8.1.0 の動的検出は、3 つのカタログタイプで機能します。標準的なクロスアカウントの AWS Glue カタログでは、リゾルバーがリダイレクティングカタログを登録し、マルチフォーマットルーティングが適用されます。Amazon S3 の機能である Amazon S3 Tables では、リゾルバーが AWS Glue のフェデレーテッドメタデータを読み取り、読み取りと書き込みの両方を Iceberg 経由でルーティングします。Amazon Redshift Managed Storage もサポートしています。
次の図は、クエリが初めてカタログを参照したときに、GlueCatalogResolver がそのカタログを検出して登録する流れを示しています。
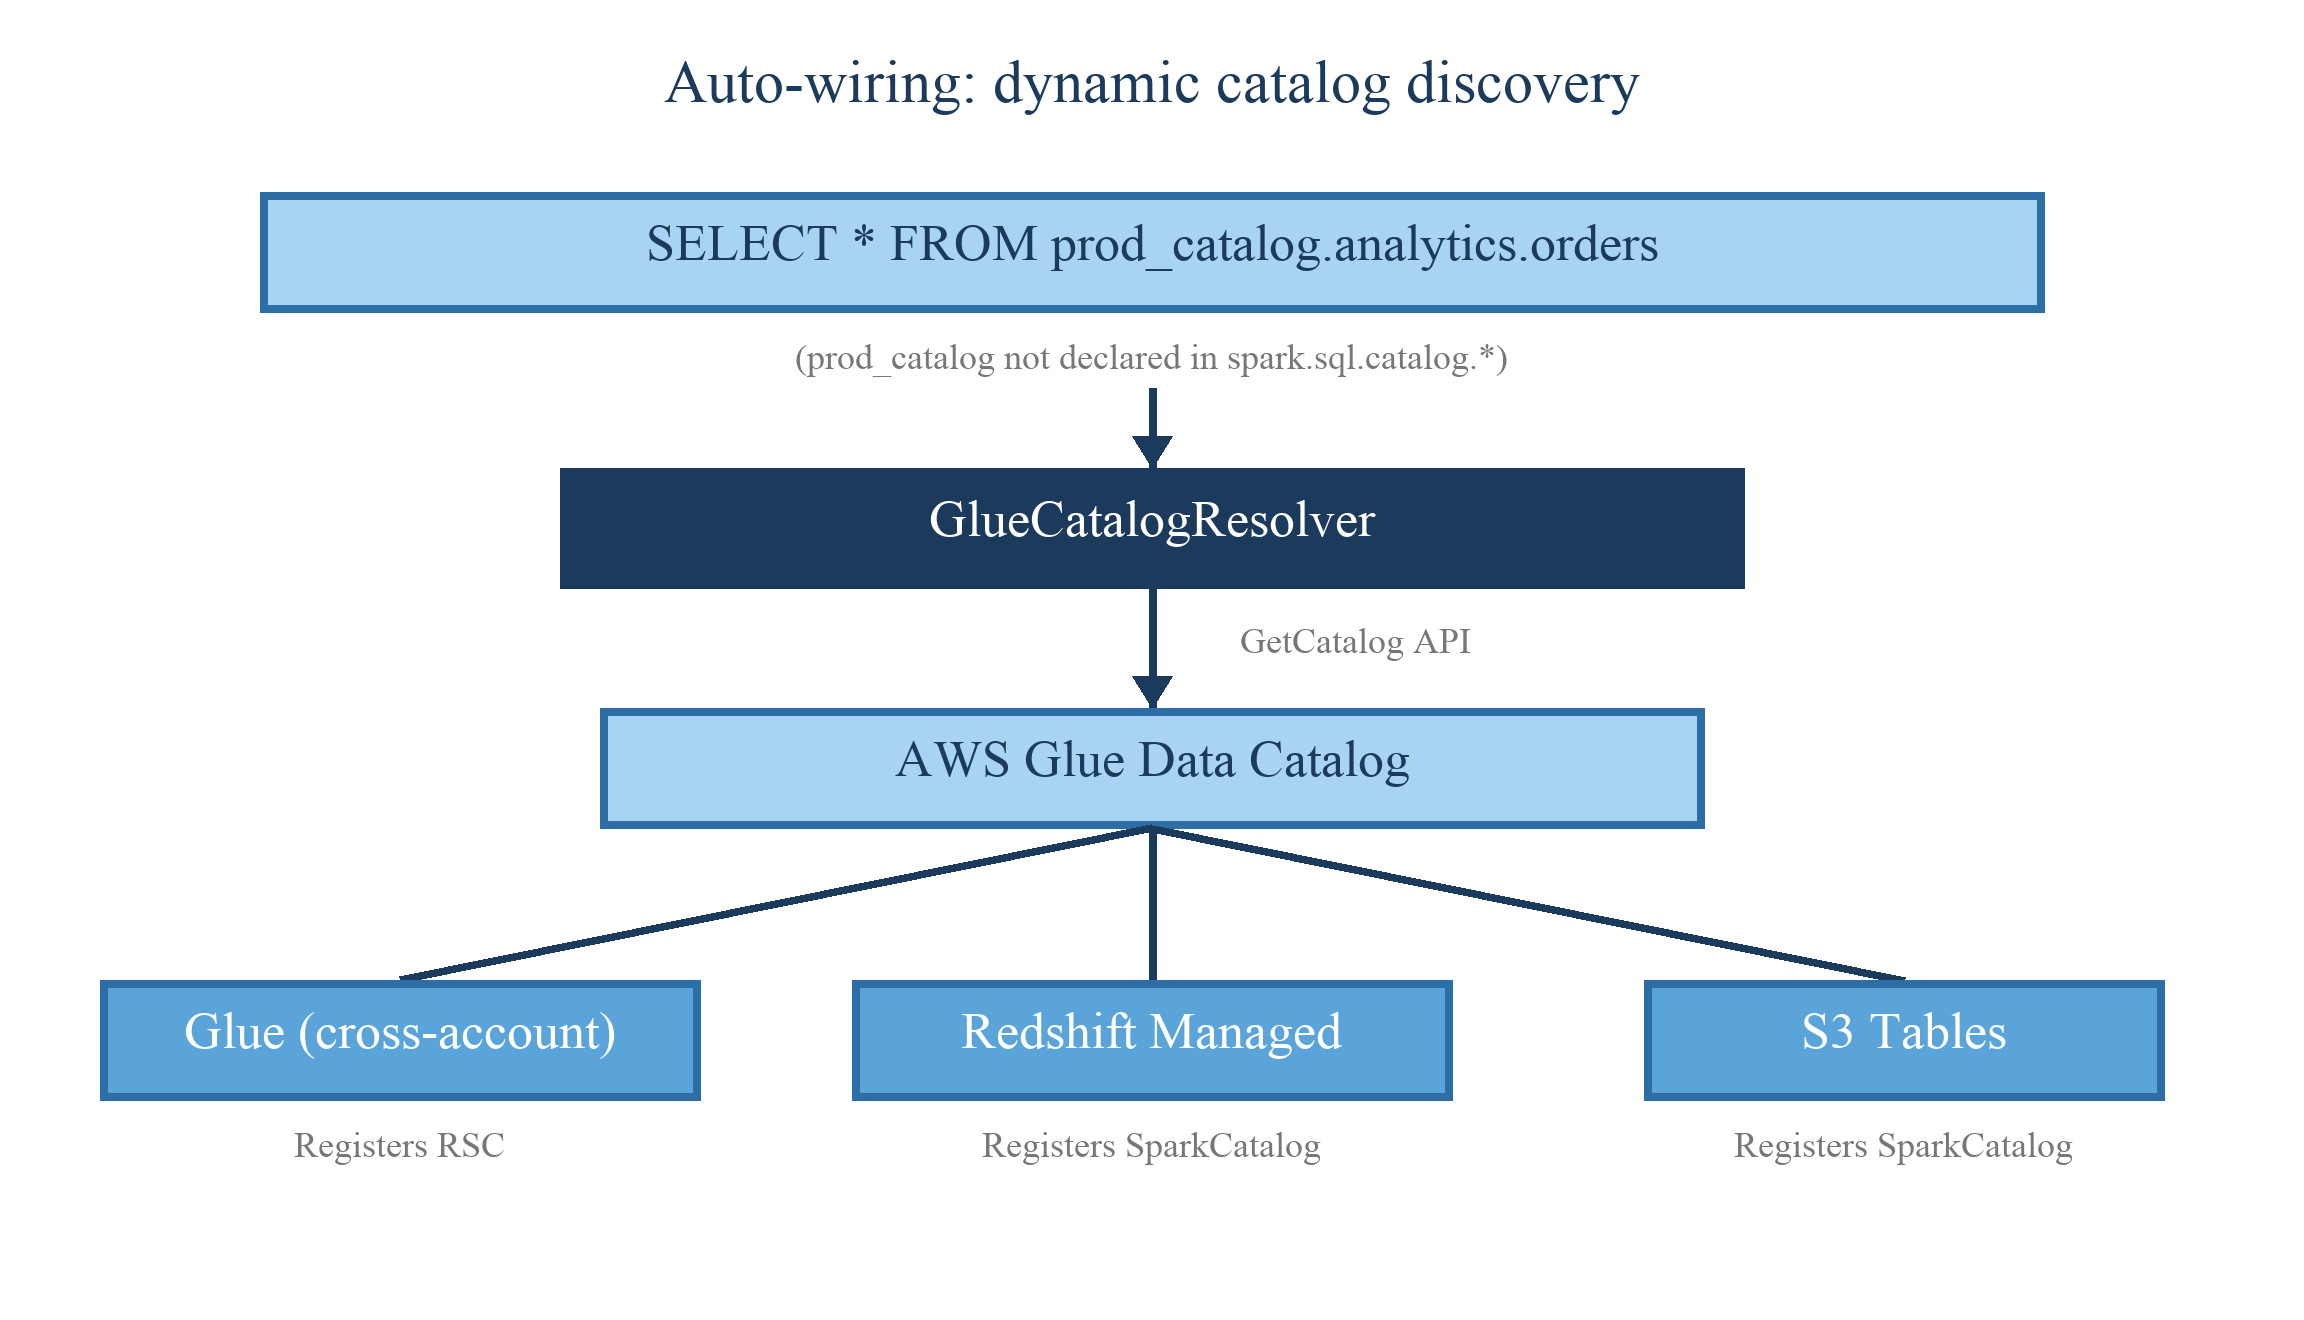
図 3: 自動ワイヤリング。クエリが未宣言のカタログを参照すると、Glue カタログリゾルバーが AWS Glue の GetCatalog API を呼び出し、接続タイプを調べて、クエリ実行時にカタログを登録するため、カタログの事前設定は不要になる
図のように、クエリが未宣言のカタログを参照すると、カタログが見つからないという状態が発生します。GlueCatalogResolver はこれをインターセプトし、GetCatalog API で AWS Glue Data Catalog を呼び出します。リゾルバーは接続タイプに基づいて適切なカタログを登録します。クロスアカウントの AWS Glue Data Catalog にはリダイレクティングカタログ、Redshift Managed Storage にはプッシュダウンカタログ、Amazon S3 Tables には Spark カタログです。登録はクエリ実行時に行われ、事前の設定は不要です。
クイックスタート
既存の Amazon EMR 8.1.0 アプリケーションでマルチカタログサポートを有効にする手順は次のとおりです。
1. spark_catalog を RedirectingSessionCatalog に設定します。
注: Delta Lake または Hudi を使う場合は、オープンテーブルフォーマット (OTF) のセッション拡張も追加します。Hudi にはさらに KryoSerializer が必要です。
注: 別の AWS アカウントをクエリするには、そのアカウントの AWS Glue Data Catalog を指す名前付きカタログを追加します。
2. (オプション) Glue カタログリゾルバーを有効にします。
Iceberg のみのマルチフォーマットクエリであれば、手順 1 だけで十分です。Delta Lake、Hudi、クロスアカウントのシナリオで必要な追加設定は、上の注に記載しています。手順 2 を行うと、カタログがクエリ実行時に解決されるため、事前に宣言する必要がなくなります。
実際に試す
以下のウォークスルーでは、4 つのテーブル (フォーマットごとに 1 つ) を作成し、クロスフォーマットの結合を実行してから、クロスアカウントのクエリへと拡張します。付属のサンプルスクリプトが、リソース作成、ジョブ送信、クリーンアップを処理します。コードは aws-emr-utilities リポジトリにあります。
前提条件
- Amazon EMR Serverless、AWS Glue Data Catalog、Amazon S3 の権限を持つ AWS アカウント。
- リリース emr-spark-8.1.0 (Spark) で実行されている Amazon EMR Serverless アプリケーション。マルチカタログ機能は Amazon EMR on EC2 と Amazon EMR on EKS でも動作します。
- 特定の AWS Glue データベースと S3 プレフィックスにスコープを限定した Amazon EMR Serverless のジョブ実行ロール。
- スクリプトと出力用の S3 バケット (本記事では
s3://amzn-s3-demo-bucket/multicatalog/を使用)。 - (クロスアカウントの場合) Lake Formation の権限付与、AWS Glue リソースポリシー、Amazon S3 バケットポリシー、AWS Key Management Service (AWS KMS) キーポリシーを設定済みのプロデューサーアカウント。
実装手順
手順 1: リポジトリをクローンして設定する
リポジトリには、単一アカウントでのマルチフォーマットとクロスアカウントの 2 つのフェーズが含まれています。.env ファイルには、すべてのスクリプトが参照するリソース識別子を保存します。
手順 2: 環境をブートストラップする
このスクリプトは、AWS Glue データベースを作成し、PySpark スクリプトを S3 にアップロードして、Amazon EMR Serverless アプリケーションが CREATED 状態であることを確認します。.env にアプリケーション ID を設定していない場合は、出力に表示されるアプリケーション ID を控えておきます。
手順 3: 4 つのフォーマットでテーブルを作成する
setup フェーズでは、1 つの AWS Glue データベースにフォーマットごとに 1 つのテーブル (Iceberg、Delta Lake、Hudi、Hive/Parquet) を共通の id/val スキーマで作成する PySpark ジョブを送信します。各 CREATE TABLE の USING 句は異なりますが、すべて同じ spark_catalog を経由します。RSC がそれぞれを適切なエンジンにルーティングします。
ジョブ設定には、RedirectingSessionCatalog、Delta と Hudi 用の OTF セッション拡張、Hudi 用の KryoSerializer が含まれています。ワークロードが Iceberg のみであれば、拡張とシリアライザーは省略できます。
手順 4: クロスフォーマットの結合を実行する
フォーマットプレフィックスを付けず、database.table だけで 4 つのテーブルを参照するクエリを送信します。クエリは、フォーマット固有の設定なしに、1 つのカタログで 4 つのテーブルすべてを結合します。
期待される出力:
各列は異なるテーブルフォーマットから取得されたもので、フォーマット固有のカタログ設定なしに 1 つのクエリで結合されています。
手順 5: (オプション) クロスアカウントに拡張する
クロスアカウントアクセスには、データを所有するアカウントからの権限付与が必要です。各アカウントでブートストラップを 1 回ずつ実行します。
次に、コンシューマーアカウントに戻ってクロスアカウントのフェーズを実行します。
結果として、プロデューサーアカウントのテーブルとローカルの Iceberg テーブルが、データのコピーなしに 1 つのクエリで結合されます。
クロスアカウントのポリシー設定全体 (Lake Formation の権限付与、AWS Glue リソースポリシー、S3 バケットポリシー、AWS KMS キーポリシー) については、「クロスアカウントの設定」セクションを参照してください。
ヒント: どちらのブートストラップスクリプトにも --dry-run を付けると、実行されるすべてのアクション (バケット、ロール、ポリシー、アプリケーション) を、何も作成せずにプレビューできます。
クリーンアップ
継続的に料金が発生しないように、クリーンアップスクリプトを実行するか、リポジトリの README の手順に従ってください。
S3 のデータ、AWS Glue のデータベースとテーブル、Lake Formation の権限、Amazon EMR Serverless アプリケーションが削除されます。
クロスアカウントの設定
クロスアカウントアクセスには、4 つのサービスにわたる設定が必要です。次の例は AWS Glue リソースポリシーです。付属の bootstrap_producer.sh スクリプトが 4 つすべてを設定するため、各ポリシーを手で書く必要はありません。
1. AWS Lake Formation: データベースとテーブルに対する権限をコンシューマープリンシパルに付与します。
2. AWS Glue リソースポリシー: カタログメタデータへのクロスアカウントアクセスを許可します。
3. Amazon S3 バケットポリシー: 基盤となるデータファイルへのアクセスを許可します。
4. AWS KMS キーポリシー: カスタマーマネージドキーを使用します (aws/glue マネージドキーはクロスアカウントの権限付与をサポートしていません)。
例: AWS Glue リソースポリシー
適切な設定の選び方
| 状況 | 設定する内容 |
| データレイクに Iceberg、Delta、Hudi のテーブルがある | spark.sql.catalog.spark_catalog = RedirectingSessionCatalog (Delta と Hudi には追加の spark.sql.extensions が必要。「クイックスタート」を参照) |
| 分析とデータが別々のアカウントにある | リモートの Glue アカウントを指す spark.sql.catalog.<name> (「マルチカタログ」セクションを参照) |
| アカウントが多数あり、事前設定をなくしたい | spark.sql.catalogResolver = GlueCatalogResolver |
| 上記すべて | 3 つすべて。組み合わせて使えます。 |
注: マルチカタログが行うのはクエリ実行時の解決です。アカウント間でデータをコピーしたり、テーブルをレプリケートしたり、アクセスを許可したりはしません。クロスアカウントの読み取りには、引き続き Lake Formation の権限付与、AWS Glue リソースポリシー、Amazon S3 バケットポリシー、(暗号化されている場合は) AWS KMS キーポリシーが必要です。
まとめ
本記事では、Amazon EMR 8.1.0 で RedirectingSessionCatalog を Spark のデフォルトカタログとして設定しました。設定プロパティ 1 つで、RSC は Iceberg、Delta Lake、Hudi、Hive のテーブルをフォーマット固有のプレフィックスなしに 1 つのカタログで解決しました。続いて、名前付きカタログを宣言して 2 つの AWS アカウントにまたがるテーブルを結合し、GlueCatalogResolver を有効にして、spark.sql.catalog.* プロパティを事前に宣言せずにリモートカタログをクエリ実行時に検出しました。
マルチカタログサポートは、Amazon EMR 8.1.0 のすべてのデプロイモデル (Amazon EMR Serverless、Amazon EMR on EC2、Amazon EMR on EKS) で利用できます。ウォークスルーを再現するには、aws-samples/aws-emr-utilities リポジトリをクローンし、「クイックスタート」セクションの手順に従ってください。
詳細や開始方法については、次のリソースを参照してください。
- Amazon EMR
- Amazon EMR ドキュメント
- 付属のウォークスルーコードを含む aws-emr-utilities リポジトリ
- Get a quick start with Apache Hudi, Apache Iceberg, and Delta Lake with Amazon EMR on EKS
- Enforce fine-grained access control on open table formats via Amazon EMR integrated with AWS Lake Formation
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Woosuk Choi がレビューしました。