AWS 기술 블로그
SGLang을 활용한 다국어 및 Multimodal Decision Model 구성하기
생성형 AI 트래픽의 절반은 판단
생성형 AI를 프로덕션에 도입한 조직의 LLM 호출을 들여다보면 두 종류가 섞여 있습니다. 하나는 진짜 생성입니다. 요약하고, 작성하고, 대화합니다. 다른 하나는 판단입니다. “이 요청은 어떤 카테고리인가”, “이 이미지는 어떤 상태인가”, “이 고객 문의는 어떤 조치가 필요한가”를 가리는 일입니다. 판단은 선택지 중 하나를 고르는 일이라 생성이 필요 없는데, 자연어와 이미지를 이해하는 도구가 LLM뿐이었기 때문에 지금까지는 이것도 전부 Claude, GPT와 같은 Frontier Model로 보내 왔습니다.
특히 글로벌 서비스와 산업 현장에서는 이 판단의 입력이 영어 텍스트에 머물지 않습니다. 다국어 고객 문의, 화면 캡처, 영수증, 문서 스캔처럼 다국어 텍스트와 이미지/영상 같은 Multimodal 입력을 함께 판단해야 하는 요구가 늘고 있습니다. 하지만 기존 Decision Model은 특정 언어나 텍스트 중심 Use Case에 제한되는 경우가 많고, Multimodal 지원이 부족하거나 외부 SaaS API에 의존해야 합니다. 규제 산업이나 민감 데이터를 다루는 고객은 자체 VPC 또는 통제된 환경에서 모델을 서빙해야 하므로, Open Source Model로 Decision Model을 직접 구성하고 운영할 수 있는 아키텍처가 필요합니다.
이 글은 SGLang(LLM과 Vision-language Model을 효율적으로 서빙하는 Open Source Framework)으로 Open Weight VLM인 Qwen3-VL-8B를 Decision Model(닫힌 선택지 판단만 전담하며 Typed Answer와 Confidence를 반환하는 모델)로 서빙하는 방법을 다룹니다. Decision Schema를 정의하고, 한국어를 포함한 다국어 텍스트와 이미지 입력에 대해 정해진 선택지와 Confidence를 반환하는 Decision Model API를 구성한 뒤, 이를 Amazon Bedrock AgentCore에서 호스팅되는 Agent의 판단 계층으로 연결합니다. 본문의 모든 수치는 자체 실측 결과이며, 한국어 Workload 실측을 포함합니다.
Prefill만으로 동작하는 Decision Model
LLM 호출 비용의 대부분은 토큰을 한 개씩 순차 생성하는 Decode 단계에서 나옵니다. 반면 입력을 병렬로 한 번에 처리하는 Prefill 단계는 GPU 효율이 높습니다 (두 단계의 구분은 NVIDIA의 LLM Inference Optimization 글 참조). 닫힌 선택지 판단은 선택지마다 Single-token Label(A, B, C, …)을 붙여 질문하면 Prefill이 끝난 시점의 Logits에 이미 답이 들어 있으므로, Label들의 확률만 읽어 Softmax를 취하면 Decode 없이(실측한 모든 요청에서 output_tokens=0) 답과 Confidence를 동시에 얻습니다. 이 방식은 SGLang v0.5.21 이상에서 /v1/systemone Endpoint로 지원됩니다.
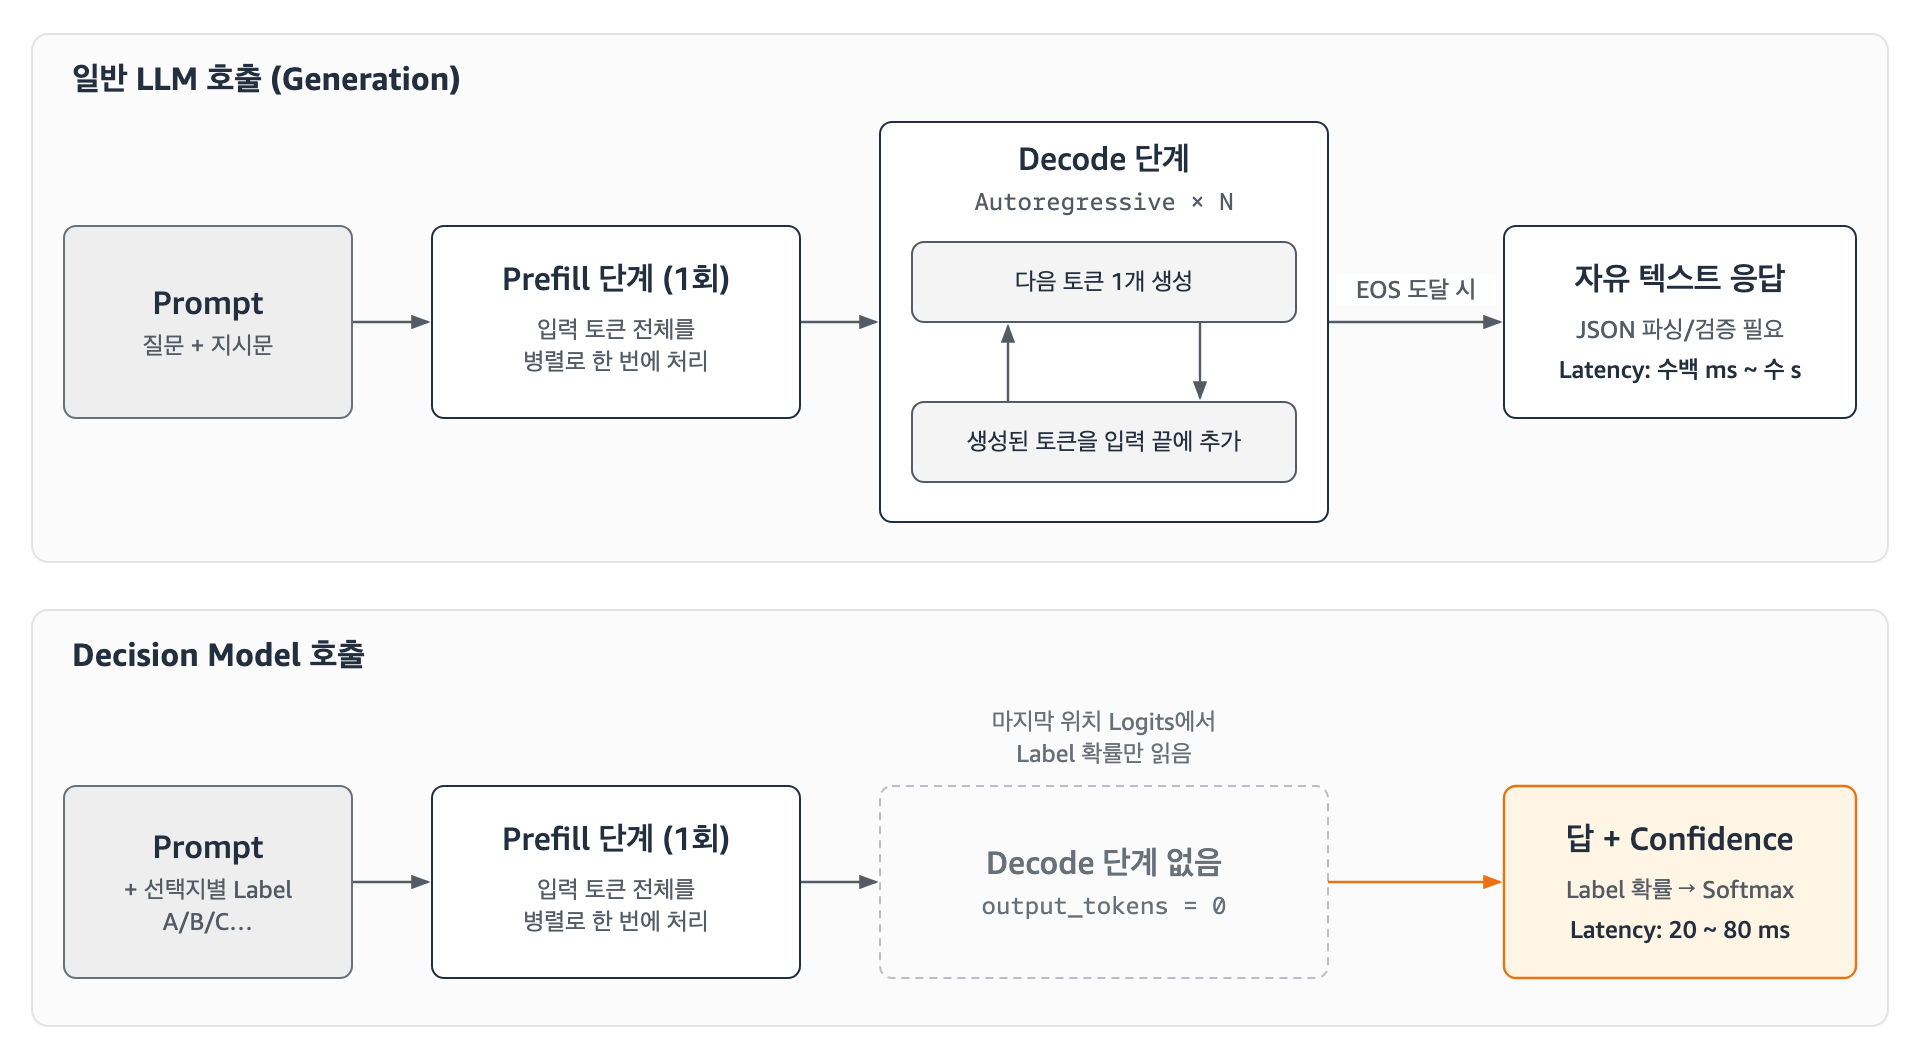 그림 1. 같은 모델, 같은 가중치입니다. 차이는 Decode 제거뿐이며, Confidence는 확률 분포에서 그대로 얻어집니다.
여기서 핵심은 Open Source LLM의 Wvocab(사전학습된 Vocabulary Projection Matrix로, 마지막 Hidden State를 수만 개 어휘 전체의 Logits로 투사하는 |V|×d 행렬)입니다. 사전학습 과정에서 Wvocab에 어휘 전체에 대한 Prior Knowledge가 이미 들어 있으므로, 분류 Task마다 랜덤 초기화된 Classification Head를 붙여 학습하던 기존 Encoder 방식(BERT, RoBERTa 계열 모델의 분류 Fine-tuning)과 달리 Fine-tuning 없이도 Label 토큰의 확률을 바로 읽어 분류할 수 있습니다. 이 성질은 뒤에서 다룰 다국어/Multimodal 결과와 Fine-tuning 논의 전체의 전제입니다.
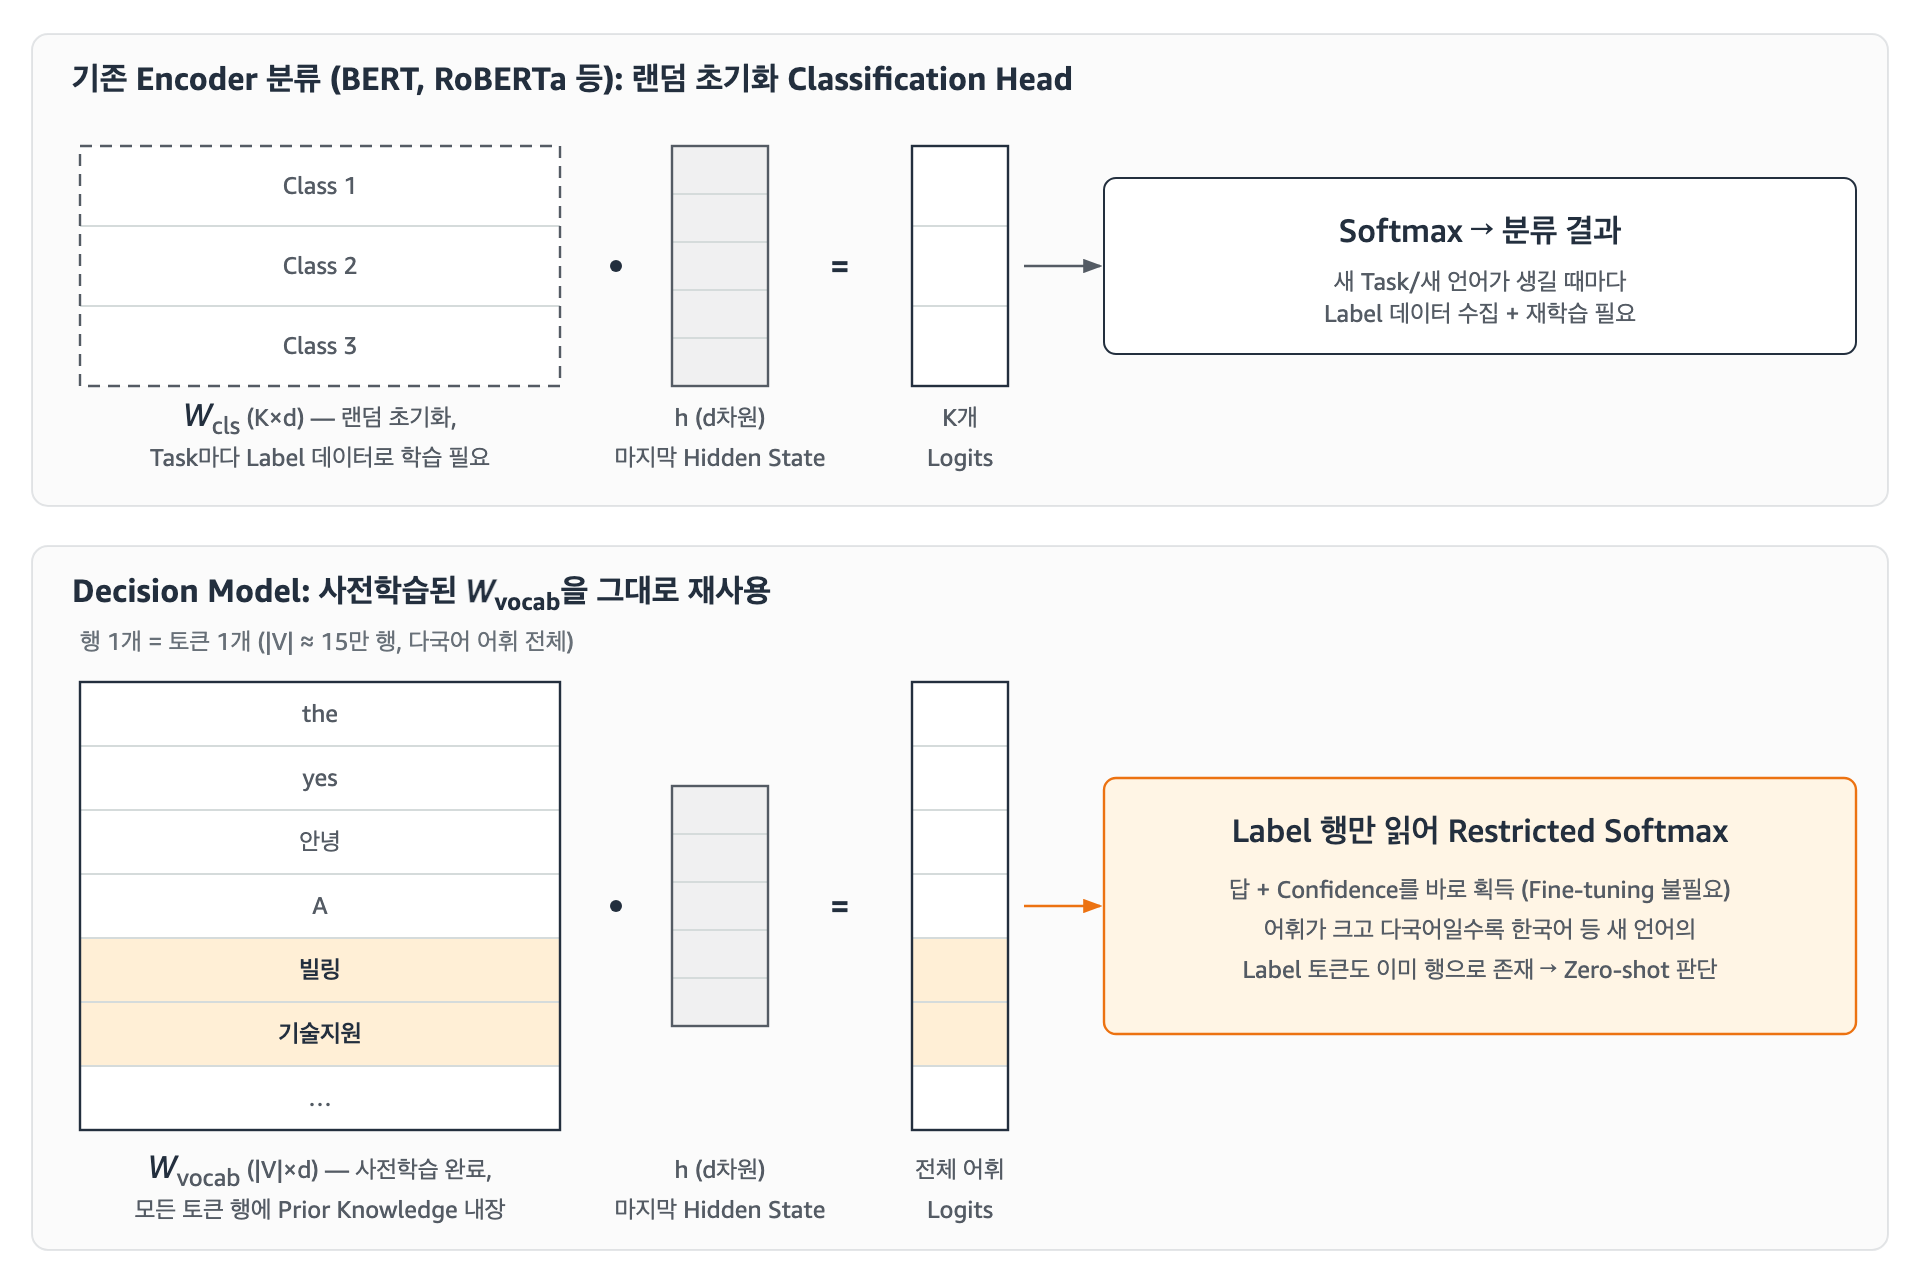
그림 2. Wvocab의 구성과 재사용. Wvocab은 어휘 토큰마다 행이 하나씩 있는 |V|×d 행렬이고, 마지막 Hidden State h와 곱하면 전체 어휘의 Logits가 나옵니다. 기존 Encoder 방식(예: BERT, RoBERTa의 분류 Fine-tuning)은 랜덤 초기화된 Wcls를 Task마다 학습해야 하지만, Decision Model은 사전학습된 Wvocab에서 Label 행만 읽으므로 어휘가 크고 다국어일수록 새 언어의 Label도 Zero-shot으로 처리됩니다.
Decision Schema 설계
먼저 호출 방식을 정확히 이해해야 합니다. Decision Model에 “Confidence를 알려달라”는 특수한 프롬프트를 쓰는 것이 아니고, 일반 질의를 모델이 알아서 닫힌 질문으로 바꿔 주는 것도 아닙니다.
- 자유 텍스트(사용자 발화, 문서, 로그)는
state필드에 그대로 들어가므로 변형이 필요 없습니다. - “무엇을 판단할지 + 선택지”는 애플리케이션이 개발 시점에 정의합니다 (Schema의 필수 필드).
- 프롬프트 Wording과 Label 부여는 서버가 소유하고, Confidence는 모든 응답에 자동으로 반환됩니다.
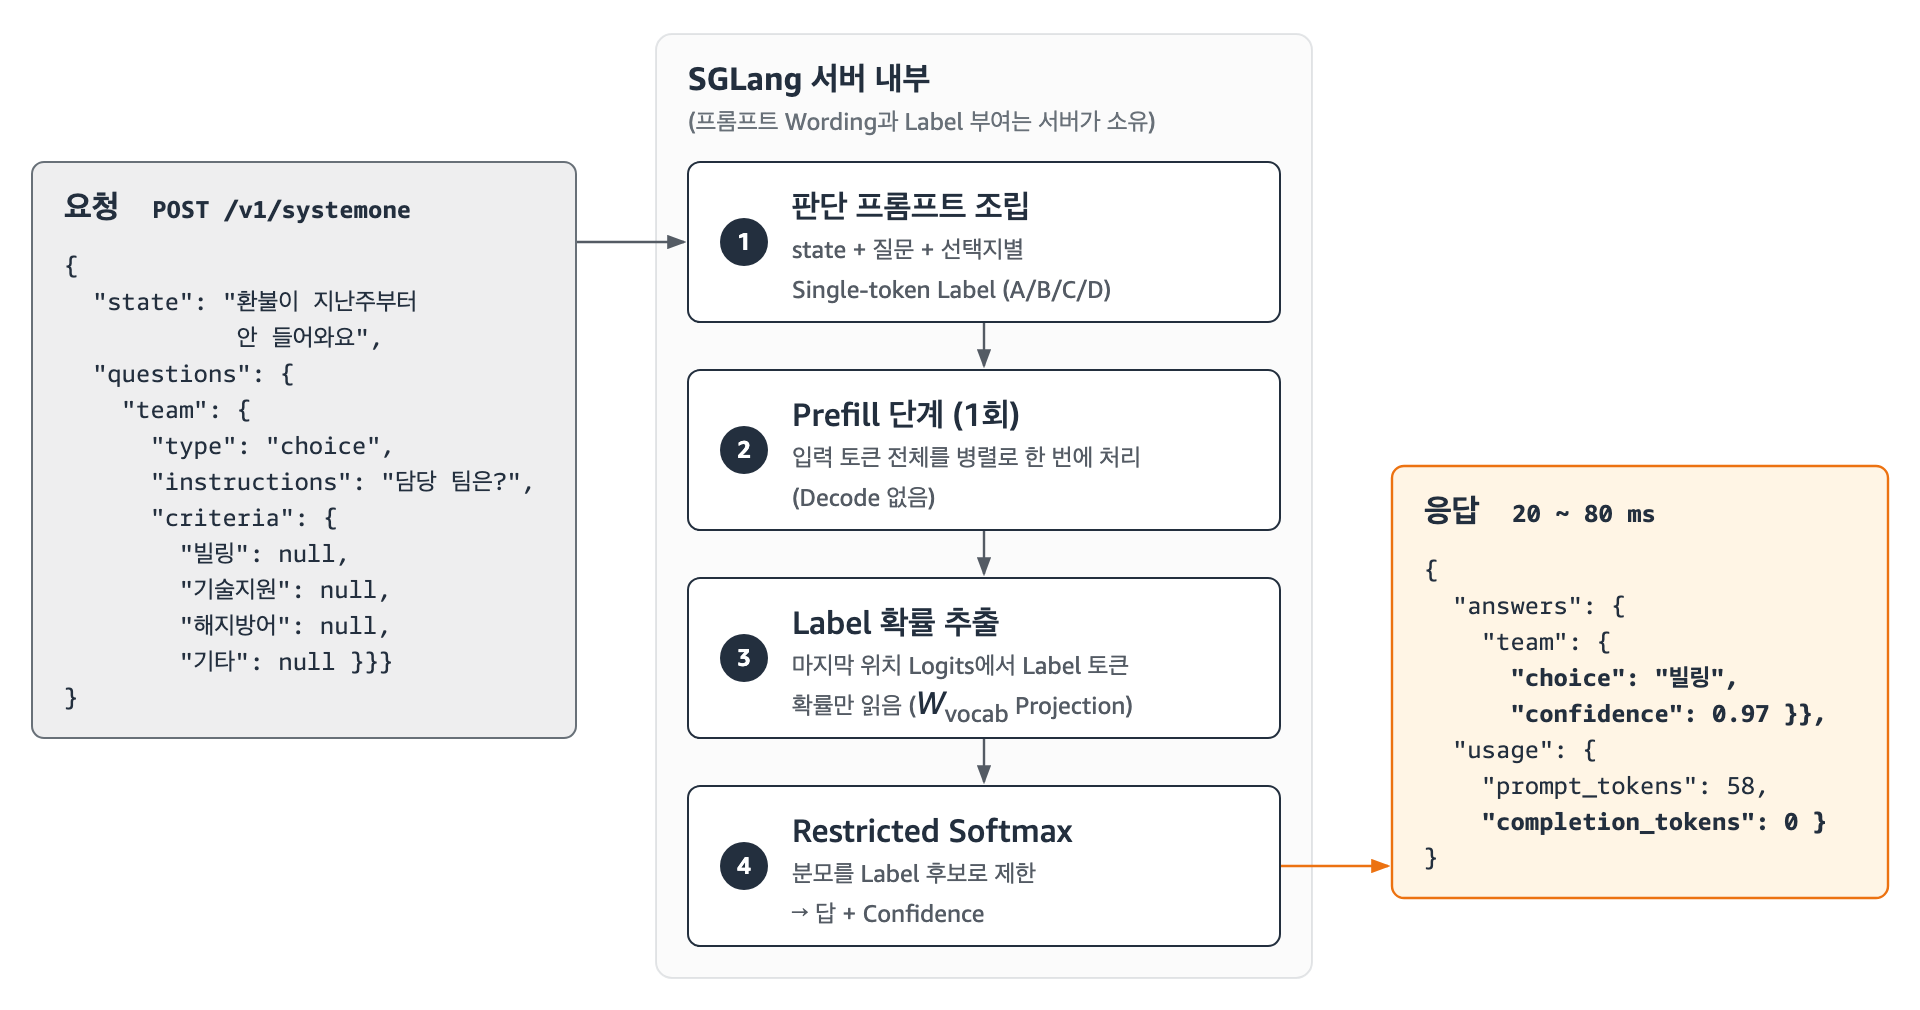
그림 3. Decision Schema 호출 흐름. 요청의 질문/선택지 정의가 서버 내부에서 Label 확률 추출과 Restricted Softmax로 이어집니다.
즉 설계 작업은 “질문을 어떻게 바꿔 묻나”가 아니라 “우리 시스템의 어떤 판단 지점이 닫힌 질문인가”를 찾는 것입니다. 다만 선택지 개수에는 실측으로 확인된 한계가 있습니다. Single-token Label은 알파벳 26자가 상한이라, 선택지가 26개를 넘으면 Two-letter Label로 바뀌면서 품질이 급격히 떨어집니다. Qwen3-1.7B 기준 실측에서 10지선다 정확도 0.686이 26지선다 0.593, 40지선다 0.313, 77지선다 0.187로 급락했습니다. 선택지는 26개 이하로 질문을 분해하는 것이 설계 원칙입니다 (대분류 → 소분류 2단 판단 등).
솔루션 아키텍처
프로덕션에서 판단 요청의 주 호출자는 Agent입니다. Guardrail 통과 여부, 담당 팀 라우팅, 도구 선택, 종료 판정처럼 Agent 한 번의 실행에 판단이 여러 번 발생하기 때문입니다. 이 글의 아키텍처는 AI Agent를 Amazon Bedrock AgentCore Runtime에 호스팅하고, Agent 내부의 판단 노드가 VPC Private Subnet의 SGLang Decision Model을 호출하는 구성입니다. AgentCore는 Agent를 서버리스로 호스팅하는 관리형 서비스로, 세션 격리, 장시간 실행, VPC 연결, Observability를 기본 제공하므로 Agent 운영에 필요한 인프라 코드를 직접 작성하지 않아도 됩니다.
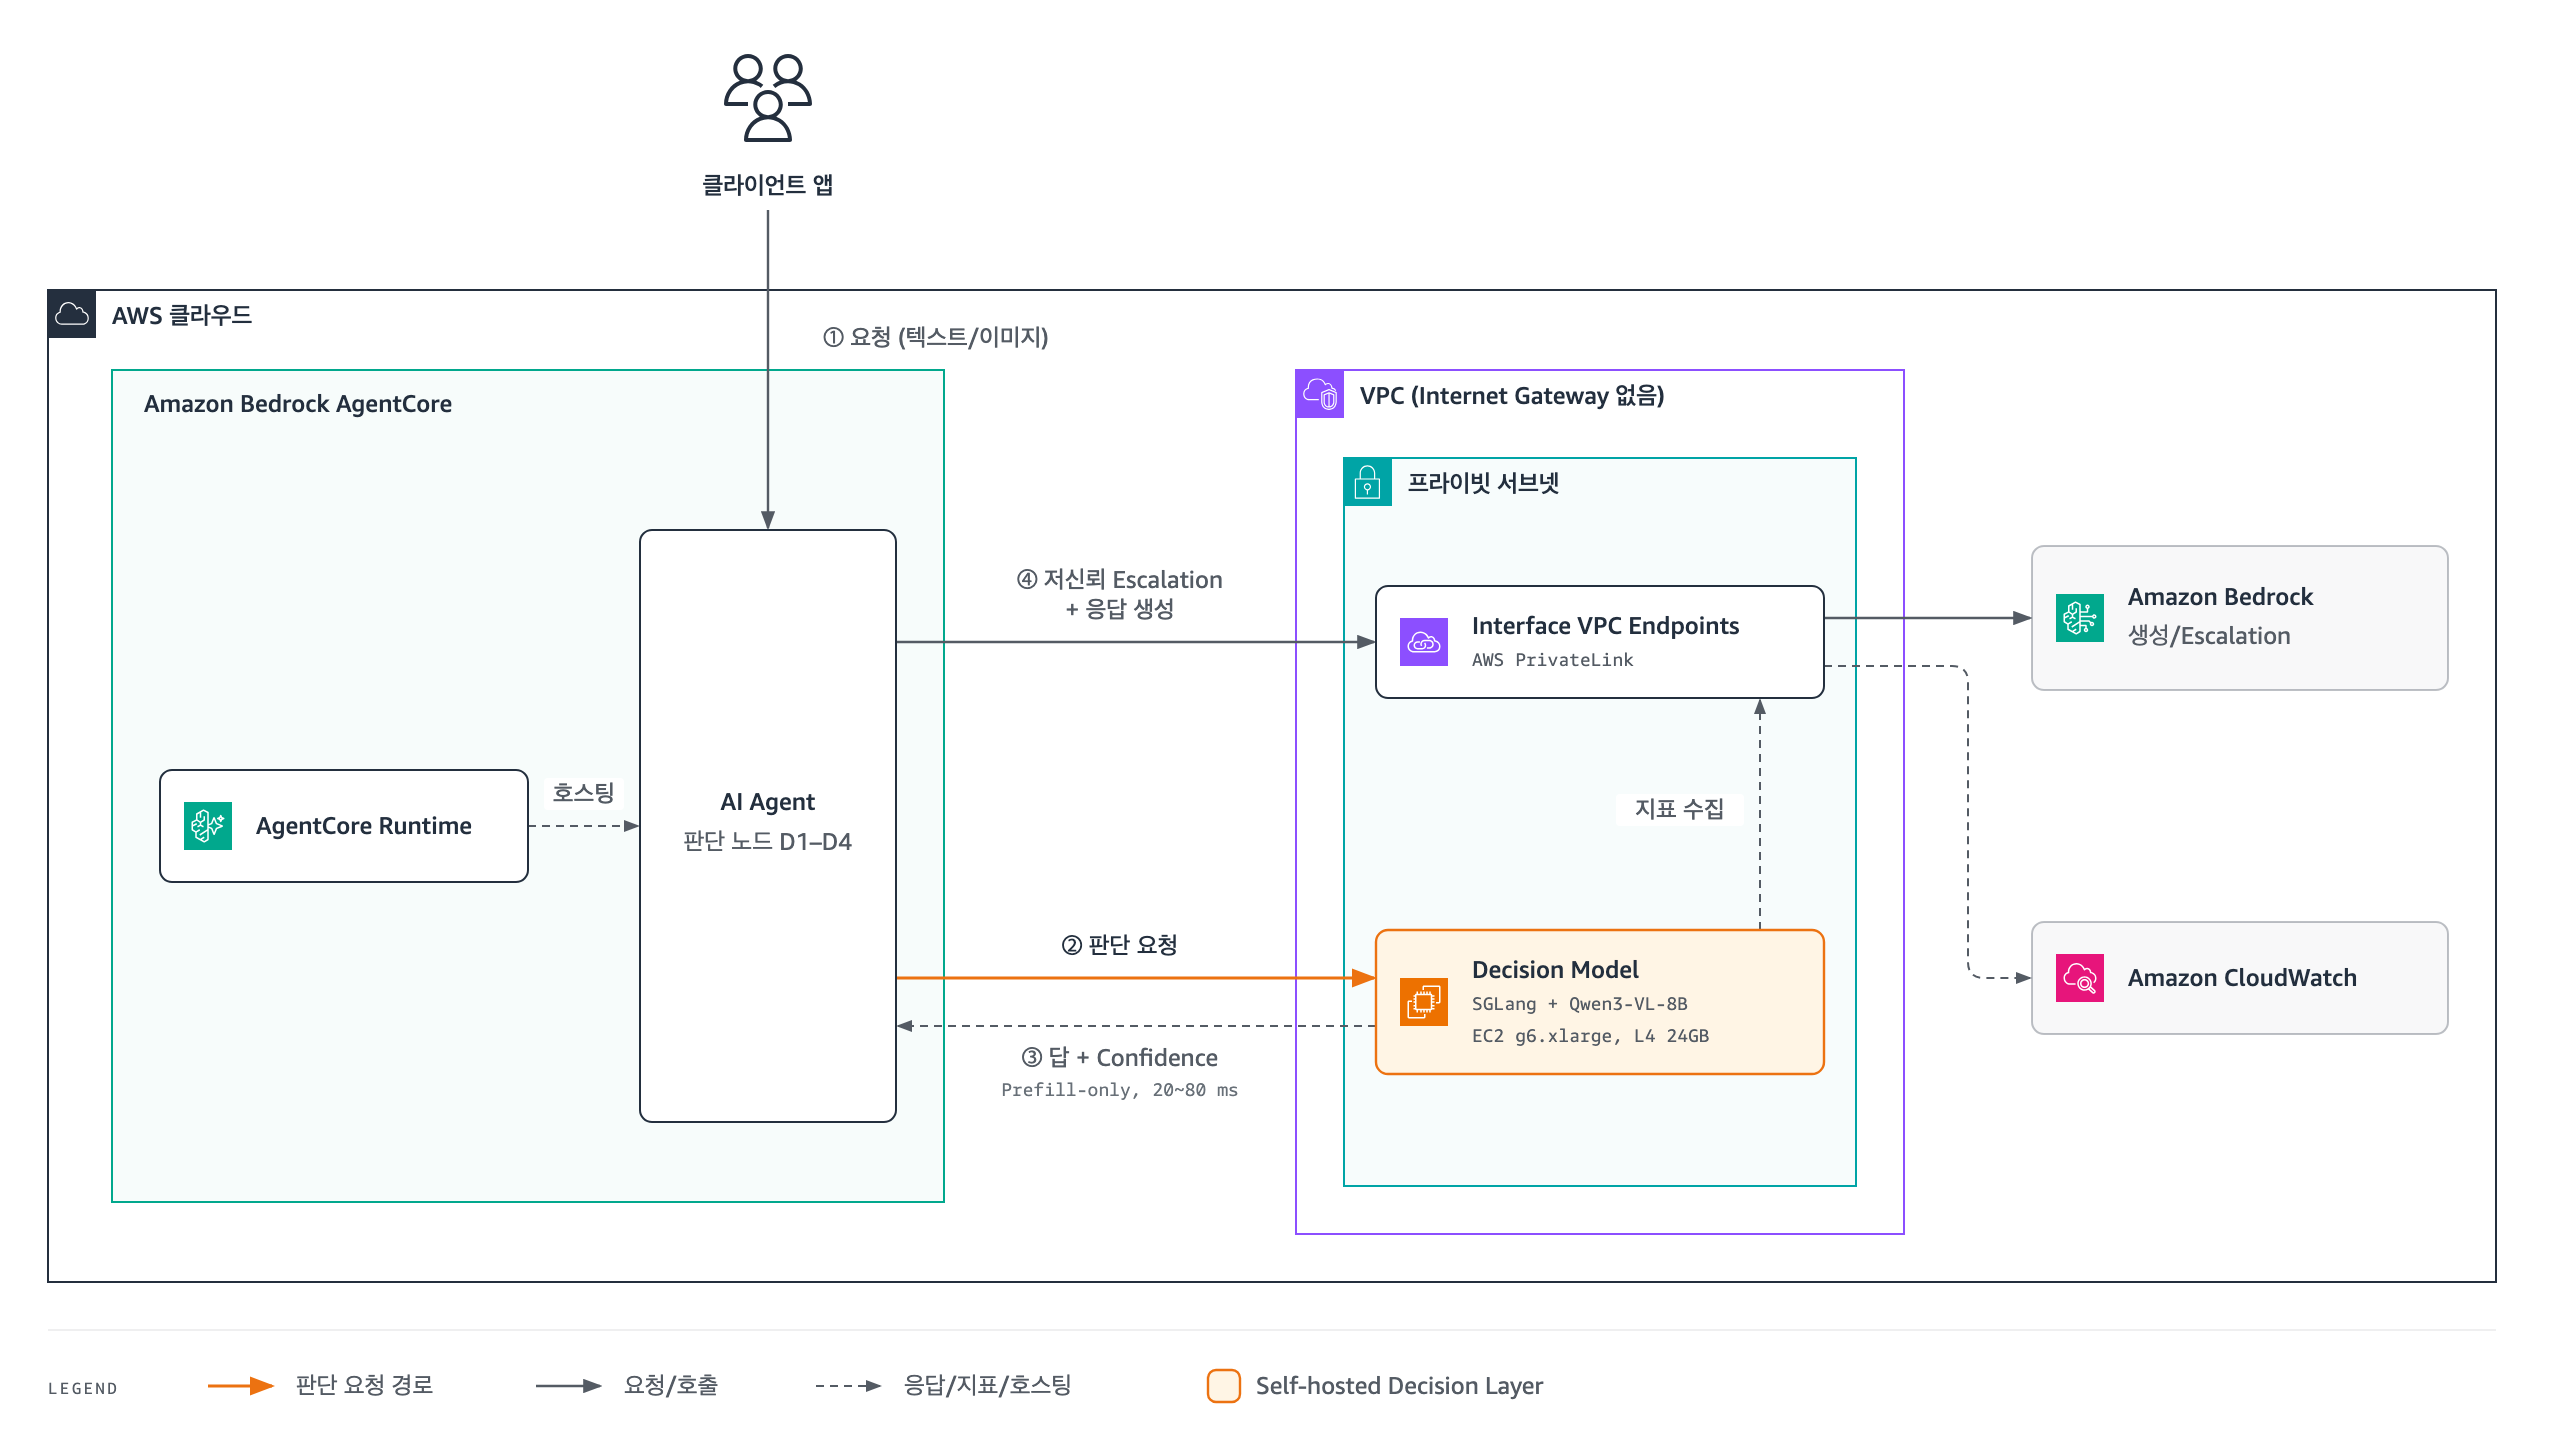
그림 4. 솔루션 아키텍처. Agent는 Amazon Bedrock AgentCore에서 실행되고, 판단은 VPC 내 Decision Model이, 생성과 Escalation은 Amazon Bedrock이 담당합니다.
| 구성 요소 | 역할 |
|---|---|
| Amazon Bedrock AgentCore Runtime | AI Agent 호스팅 (세션 격리, VPC 연결, AgentCore Observability) |
| Amazon EC2 g6.xlarge (L4 24GB) × 1 | SGLang + Qwen3-VL-8B로 구성된 LLM Reasoning & Decision Layer 본체 (텍스트/이미지 판단과 일반 LLM 생성을 한 서버로 담당) |
| Amazon Bedrock | Claude Sonnet 5.5로 최종 응답 생성과 저신뢰(Confidence < Threshold) Escalation 담당 |
| Interface VPC Endpoint (AWS PrivateLink) | Internet Gateway 없는 VPC에서의 Bedrock Private 접근 |
| Amazon CloudWatch | Confidence 분포, 경로별 비율(직접 종결 vs Escalation), GPU 지표 모니터링 |
흐름은 네 단계입니다.
- 클라이언트의 다국어 텍스트/이미지 요청이 AgentCore의 Agent에 도착합니다.
- Agent의 판단 노드가 VPC 내 Decision Model에 판단을 요청합니다.
- Typed Answer와 Confidence가 Prefill-only로 20~80ms에 돌아옵니다.
- Confidence가 Threshold 미만인 판단과 최종 사용자 응답 생성만 Bedrock으로 갑니다.
민감 데이터를 다루는 환경에서는 Decision Model이 Internet Gateway 없는 VPC를 벗어나지 않고, Bedrock 경로도 PrivateLink로 폐쇄됩니다.
이 구성의 효과는 은행 상담 Agent 160개 대화(영어 130건, 한국어 30건) 실측으로 확인했습니다. Agent의 판단 노드 4종(Guardrail, Intent 라우팅, 전문 팀 선택, Escalation 판정)을 Bedrock Claude Haiku 4.5 호출에서 Self-hosted Decision Model로 교체하자, 판단 1회당 Latency가 531~552ms에서 34~38ms로 약 15배 단축되고, 대화 전체(e2e) p50 Latency가 6,167ms에서 4,096ms로 33.6%, 대화당 비용이 18% 줄었으며, Blind Pairwise 평가에서 최종 응답 품질은 저하 없이 대등했습니다(구성 B 소폭 우위, 통계적 유의차 없음). 단, 안전 관련 판단(Guardrail)은 저신뢰 시 Frontier Model로 넘기는 Hybrid 구성을 권장합니다.
이 수치를 얻은 실험 설계와 측정 방법은 다음 섹션에서 설명합니다.
판단 노드 A/B 비교 실측
비교한 두 구성
동일한 Topology의 은행 상담 Agent 두 벌을 준비하고, Agent 내부의 판단 노드 4종만 서로 다른 Backend로 교체했습니다. Agent의 처리 흐름은 실제 콜센터 1선 처리를 본뜬 5단계입니다.
- 접수 심사 (D1 Guardrail): 문의가 정당한 뱅킹 지원 요청(in_scope)인지, 은행 업무와 무관한 질문(out_of_scope)인지, 자금세탁, 타인 정보 요구 같은 규정 위반 소지(sensitive_compliance)인지 판별합니다. 뒤의 두 경우는 전문 상담 없이 정중한 거절/안내 응답으로 직행합니다.
- 업무 분류 (D2 Intent 라우팅): in_scope 문의를 12개 전문 상담 Category 중 하나로 배정합니다.
- 전문 처리 (D3 Tool 선택 + 실행 + 요약): 해당 Category의 Specialist가 보유 Tool 2~4개 중 맞는 것을 고르고(D3), Tool을 실행한 뒤, 결과를 응답 생성 모델이 고객 응대용 사실 요약으로 정리합니다.
- 처리 방침 결정 (D4 Escalation 판정): Tool 결과를 근거로 종결(resolve), 추가 질문(clarify), 상담사 이관(human_handoff)을 결정합니다.
- 고객 응답 생성: 결정된 방침과 사실 요약으로 최종 응답을 작성합니다.
구성 A는 D1~D4를 Bedrock Claude Haiku 4.5가 JSON Label 출력으로 판정하고, 구성 B는 SGLang /v1/systemone + Qwen3-VL-8B가 Prefill-only로 판정합니다. 전문 처리 요약과 최종 응답을 생성하는 추론 노드는 양쪽 모두 같은 Bedrock Claude Sonnet 5.5로 고정해, 판단 Backend가 유일한 변인이 되도록 했습니다. 판단 출력이 형식에 맞지 않으면 사전 정의한 안전한 기본값으로 그래프를 계속 진행하고, 그 비율은 별도 지표로 집계했습니다.
데이터셋과 정답 구성
총 160개 대화(대화당 최대 4회 판단)를 세 Slice로 구성했습니다.
| Slice | 건수 | 구성 |
|---|---|---|
| 영어 본편 | 110 | 실제 네오뱅크 고객 문의 기반 공개 데이터셋 Banking77(77개 Intent)에서 12개 상담 Category별로 층화 추출 (Category당 최소 5건) |
| 범위 외/컴플라이언스 | 20 | out_of_scope 10건 + sensitive_compliance 10건을 직접 작성 (D1 정답만 존재) |
| 한국어 | 30 | 영어 본편에서 층화 추출한 30건을 한국어로 번역하고 정답을 승계 |
판단별 정답(Gold)은 다음과 같이 확보했습니다. D2는 77개 Intent를 12개 Category로 매핑한 표를 정답으로 쓰되, 경계가 모호한 Intent는 인접 Category 배정도 정답으로 인정하는 Lenient 채점을 병행했습니다. D3는 Intent별 정답 Tool 매핑표를 사용했습니다. D4는 Tool을 Stub으로 두고 대화마다 처리 결과를 70% 성공(정답 resolve) / 15% 정보 부족(정답 clarify) / 15% 수동 심사 필요(정답 human_handoff)로 사전 배정했으므로, 모델은 Tool 결과를 읽고 판단해야 하며 정답은 설계 단계에서 객관적으로 정해집니다.
Latency 측정과 통제
판단 1회당 p50과 대화 전체(e2e) p50을 기록했습니다. 측정의 공정성을 위해 세 가지를 통제했습니다. 시간대에 따른 Bedrock Latency 변동이 비교를 오염시키지 않도록 샘플마다 A/B 실행 순서를 교대(Per-sample Interleaving)했고, 구성당 Warm-up 3회는 집계에서 뺐습니다. 실패한 요청은 1회 재시도하되 재시도 건은 Latency 통계에서 제외했습니다 (실측에서는 재시도가 발생하지 않았고 오류도 0건이었습니다).
비용 측정
대화당 비용은 두 요소로 계산했습니다. Bedrock 비용은 요청별 실측 토큰 수 × 공시 단가로 집계했고, 구성 B의 Self-hosted Decision Model에는 GPU 상각(g6.xlarge 시간당 비용을 포화 가동 처리량으로 나눈 판단당 약 $0.0000033)을 더했습니다. 구성 B는 판단용 Bedrock 호출 4회가 사라지면서 대화당 Bedrock 비용이 $0.006115에서 $0.005003으로 줄었고, GPU 상각을 포함한 $0.005014 기준으로도 약 18% 절감이 유지됐습니다. 응답 생성 비용은 양쪽 모두 같은 모델이므로 차이의 원천은 판단 호출뿐입니다.
품질 평가 방법
최종 응답 품질은 LLM-as-judge 방식의 Blind Pairwise 평가로 측정했습니다. 평가 편향을 통제하는 것이 설계의 핵심입니다.
- 심판 모델 분리: 응답 생성에 쓴 모델이 자기 출력을 선호하는 Self-preference 편향을 피하기 위해, 응답 생성에 쓰지 않은 별도 상위 모델(Claude Opus 5.5)을 심판으로 사용했습니다.
- Blind 판정: 심판에게는 어느 응답이 어느 구성(A/B)에서 나왔는지 알려주지 않고, 같은 고객 문의에 대한 두 최종 응답만 제시해 우열을 고르게 했습니다.
- 위치 편향 통제: 먼저 제시된 응답을 선호하는 Position Bias를 상쇄하기 위해 응답 순서를 바꿔 2회 판정하고, 두 판정의 승자가 불일치하면 무승부로 처리했습니다.
- Rubric 병행 채점: 승패 판정과 별개로 Correctness(정확성) / Helpfulness(유용성) / Compliance(규정 준수) 각 1~5점의 Rubric 점수도 기록했습니다.
결과는 구성 A 48승 / 구성 B 62승 / 무승부 50으로 구성 B가 소폭 우위였으나 통계적으로 유의한 차이는 아니었고(비무승부 110건 부호검정 p=0.215), Rubric 평균 점수(Correctness 기준 3.32 vs 3.42)도 유사했습니다. 판단 노드의 개별 정확도 차이가 최종 응답 품질 저하로 이어지지 않았다는 뜻입니다.
결과 요약
| 지표 (대화당) | 구성 A (Haiku 4.5 판단) | 구성 B (Decision Model 판단) | 변화 |
|---|---|---|---|
| e2e Latency p50 | 6,167ms | 4,096ms | -33.6% |
| 판단 노드 Latency 합계 p50 | 2,089ms | 143ms | -93.1% |
| 판단 1회당 Latency p50 | 531~552ms | 34~38ms | 약 15배 단축 |
| 비용 | $0.006115 | $0.005014 (GPU 상각 포함) | -18% |
| D1 Guardrail 정확도 | 0.956 | 0.900 | A 우위 |
| D2 라우팅 정확도 (Strict/Lenient) | 0.671 / 0.743 | 0.664 / 0.736 | 대등 |
| Blind Pairwise 품질 | 48승 | 62승 | 무승부 50, 유의차 없음 (B 소폭 우위) |
e2e -33.6%의 원천은 판단 노드가 e2e Latency에서 차지하던 비중이 약 34%(p50 2,089ms)에서 3.5%(143ms)로 줄어든 것입니다. 개별 판단 정확도의 차이는 D2 라우팅에서는 소폭(-0.7%p)이었지만 D1 Guardrail에서는 -5.6%p(0.956 → 0.900)로 유의미했으며, 이 차이는 Blind 평가의 최종 응답 품질 저하로 이어지지는 않았습니다. 다만 Guardrail(D1)은 구성 B의 정확도가 유의미하게 낮았으므로, 안전 관련 판단은 저신뢰 시 Frontier Model로 넘기는 Hybrid 구성을 권장합니다.
SGLang으로 Decision Model 서빙하기
구성 환경은 Amazon EC2 g6.xlarge(NVIDIA L4 24GB) 1장, Ubuntu 22.04, NVIDIA Driver 550 이상입니다. 버전은 이 구성에서 사용한 0.5.21로 고정합니다 (상위 버전은 API Schema가 다를 수 있으므로 별도 검증 후 상향).
로그에 The server is fired up and ready to roll!이 출력되면 준비 완료입니다. 텍스트 판단 Smoke Test로 다지선다(choice) 분류를 호출합니다:
yes/no 판정(type: noul)은 RAG 관련성 필터나 Guardrail처럼 이진 판단에 사용합니다. 응답의 noul 값은 p(yes)이고 Confidence는 max(p, 1-p)입니다:
한국어 판단 실측 결과
다국어 지원은 Decision Model 선택에서 가장 먼저 검증해야 할 축입니다. 한국어 금융 상담 시나리오 실측에서 두 가지 판단 Task로 세 가지 Open Source Decision Backend를 동일 조건으로 비교했습니다. 평가셋은 앞의 A/B 실험 데이터셋 160개 대화 전체를 한국어로 번역한 별도 세트(전건 한국어)입니다. 따라서 아래 표의 수치는 영어/한국어 혼합 데이터셋으로 측정한 A/B 결과 표의 수치(예: 구성 B의 D1 0.900)와 측정 대상이 다릅니다.
- D1 (Guardrail) 정확도: 고객 발화가 정상적인 은행 상담 요청(in_scope)인지, 은행 업무와 무관한 요청(out_of_scope)인지, 자금세탁, 타인 정보 요구 같은 민감/컴플라이언스 사안(sensitive_compliance)인지 가리는 3지선다 판정입니다. 이 한국어 평가셋의 발화 160건 전체에 대해 사람이 부여한 정답 Label과의 일치율을 측정했습니다. Agent 파이프라인의 첫 관문이라 이 판단이 틀리면 정상 문의가 차단되거나 위험 문의가 통과합니다.
- D2 (12-way 라우팅) 정확도: 고객 문의를 카드, 카드 보안, 이체, 환불, 본인 확인 등 12개 전문 팀 중 하나로 배정하는 라우팅 판단입니다. 140건(160건 중 D2 정답이 없는 범위 외/컴플라이언스 20건을 제외한 수)에 대한 Strict 채점(정답 팀 정확 일치) 기준이며, 경계가 모호한 문의에 대해 인접 팀 배정도 정답으로 인정하는 Lenient 수치는 괄호로 병기했습니다.
| Backend | 파라미터 | D1 (Guardrail) 정확도 | D2 (12-way 라우팅) 정확도 | p50 Latency |
|---|---|---|---|---|
| SGLang + Qwen3-VL-8B | 8B | 0.913 | 0.629 (Lenient 0.707) | 33ms |
| strands-decider 2B (Strands Agents 팀의 전용 Decision Model, 영어 중심 학습) | 2B | 0.613 | 0.500 | 88ms |
| Laya Multilingual (Fine-tuning 없이 Zero-shot 사용) | 322M | 0.419 | 0.357 | 21ms |
결과의 교훈은 명확합니다. 모델 용량이 언어 특화보다 품질 상한을 지배합니다 (8B > 2B > 0.3B). 다국어로 사전학습된 Open Source LLM은 앞서 설명한 Wvocab Prior 덕분에 한국어 판단을 Fine-tuning 없이 Zero-shot으로 수행하며, 소형 전용 모델은 Fine-tuning 전에는 목표 품질에 크게 못 미쳤습니다 (이 간극을 메우는 두 가지 접근은 뒤의 Fine-tuning 섹션에서 다룹니다).
공개 벤치마크 기반 실측에서도 같은 패턴이 확인됩니다. 한국어 공개 데이터셋 4종에서 각 300건을 추출해, 동일한 질문/선택지 조건으로 Decision Model(SGLang + Qwen3-VL-8B)과 비교 대상 LLM(Claude Haiku 4.5)의 정확도를 측정했습니다.
| 벤치마크 | 테스트한 판단 Task | 선택지 구조 | Decision Model 정확도 | Claude Haiku 4.5 정확도 | 실측 결론 |
|---|---|---|---|---|---|
| NSMC (네이버 영화 리뷰) | 리뷰 감성이 긍정인지 판정 | yes/no | 0.807 | 0.853 | 단독으로는 소폭 미달. 고신뢰 구간 직접 종결 + 저신뢰 Escalation 구성으로 운영 |
| KorQuAD 1.0 기반 RAG 관련성 필터 | 검색된 문서가 질문에 답하는 데 관련 있는지 필터링 | yes/no | 0.980 | 0.977 | 동급 정확도를 약 1/20 Latency(p50 35ms vs 687ms)로 수행한 대표 사례 |
| KLUE-YNAT | 뉴스 제목의 주제 분류 | 7지선다 | 0.663 | 0.753 | Frontier Model(Claude Sonnet 5.5, 0.833)과 품질 차이가 커서, 이런 Task는 Frontier Model 경로를 유지하는 것이 적합 |
| MASSIVE 1.1 한국어 Split | 음성 발화의 Intent 분류 | 59지선다 | 0.653 | 0.813 | 선택지가 26개를 넘으면 한 글자 Label(A~Z)이 부족해 두 글자 Label(AA, AB, …)을 쓰게 되는데, 소형 모델은 Label과 선택지의 짝을 맞추지 못해 정확도가 무너지는 반면 8B급은 짝 맞추기는 정확히 해내고 Frontier Model과의 품질 격차만 남음 |
네 Task를 같은 모델, 같은 호출 방식으로 측정했는데도 결과가 “Frontier Model과 동급”부터 “Frontier Model 유지가 적합”까지 갈립니다. Task 적합성은 언어와 무관하게 Task 단위로 사전 실측해야 한다는 뜻입니다.
같은 서버로 처리하는 Multimodal 판단
여기서 중요한 것은 Qwen3-VL-8B라는 특정 모델이 아니라 SGLang이 주는 선택의 폭입니다. SGLang은 Llama, Gemma, Qwen 계열 등 다양한 Open Source Model을 Vision-language Model(VLM)까지 포함해 같은 방식으로 서빙할 수 있으므로, Workload 요구(다국어, 이미지, 모델 크기)에 맞는 모델을 골라 호스팅할 수 있습니다. 이 글은 그 선택지 중 VLM인 Qwen3-VL-8B를 골랐고, 그 덕분에 같은 SGLang 서버가 이미지 판단도 수행합니다. Multimodal을 위한 추가 인프라가 필요 없습니다. 구현할 때는 Endpoint 경로에 주의해야 합니다. SGLang v0.5.21의 /v1/systemone은 이미지 입력 필드를 지원하지 않으므로, 이미지 판단은 OpenAI 호환 /v1/chat/completions 경로를 사용합니다. 이때 두 가지 구성이 필요합니다.
- 응답을 제시된 Label로 제한하는 프롬프트:
/v1/chat/completions는 자유 텍스트를 생성하는 Endpoint라서, 그냥 물으면 모델이 “이 이미지는 환불 분쟁 관련 영수증으로 보입니다”처럼 문장으로 답해 형식이 매번 달라질 수 있습니다. 그래서 프롬프트에 선택지 Label 목록을 명시하고 “반드시 이 중 하나로만 답하라”고 지시해, 응답이 파싱 가능한 Label 하나로 고정되도록 만듭니다./v1/systemone이 기본 제공하는 닫힌 선택지 동작을 프롬프트로 재현하는 것입니다. - base64 Data URL 전송: OpenAI 호환 API의 표준 이미지 입력 방식(
image_url)은 외부 URL과 base64 Data URL(이미지 바이트를 요청 본문에 직접 인코딩해 담는 형식)을 모두 받습니다. VLM에서 base64 전송 자체는 일반적인 방식이며, 이 구성에서 외부 URL 대신 base64를 쓰는 이유는 네트워크입니다. Decision Model이 Internet Gateway 없는 VPC 안에 있어 외부 URL의 이미지를 가져올 수 없고, base64로 요청에 직접 담으면 이미지가 VPC 밖으로 나가지 않은 채 처리됩니다. 반대로, 서빙 Endpoint가 외부 URL에 접근할 수 있는 네트워크 환경이라면 URL을 그대로 전달하면 되고, 이때는 base64 인코딩이 필요 없습니다. 두 방식의 차이는 이미지를 가져오는 주체입니다. 외부 URL 방식은 요청을 받은 모델 서버가 그 URL에 접속해 이미지를 직접 내려받는 방식이고, base64 방식은 호출자가 이미지 바이트를 요청 본문에 담아 보내서 서버가 어디에도 접속할 필요가 없는 방식입니다. 아래는 같은image_url필드를 두 방식으로 쓴 예시입니다.
다만 GitHub Main Branch에는 /v1/systemone의 이미지 입력 지원이 이미 구현되어 있어, 이후 버전에서는 이미지 판단도 같은 Endpoint로 처리할 수 있을 전망입니다.
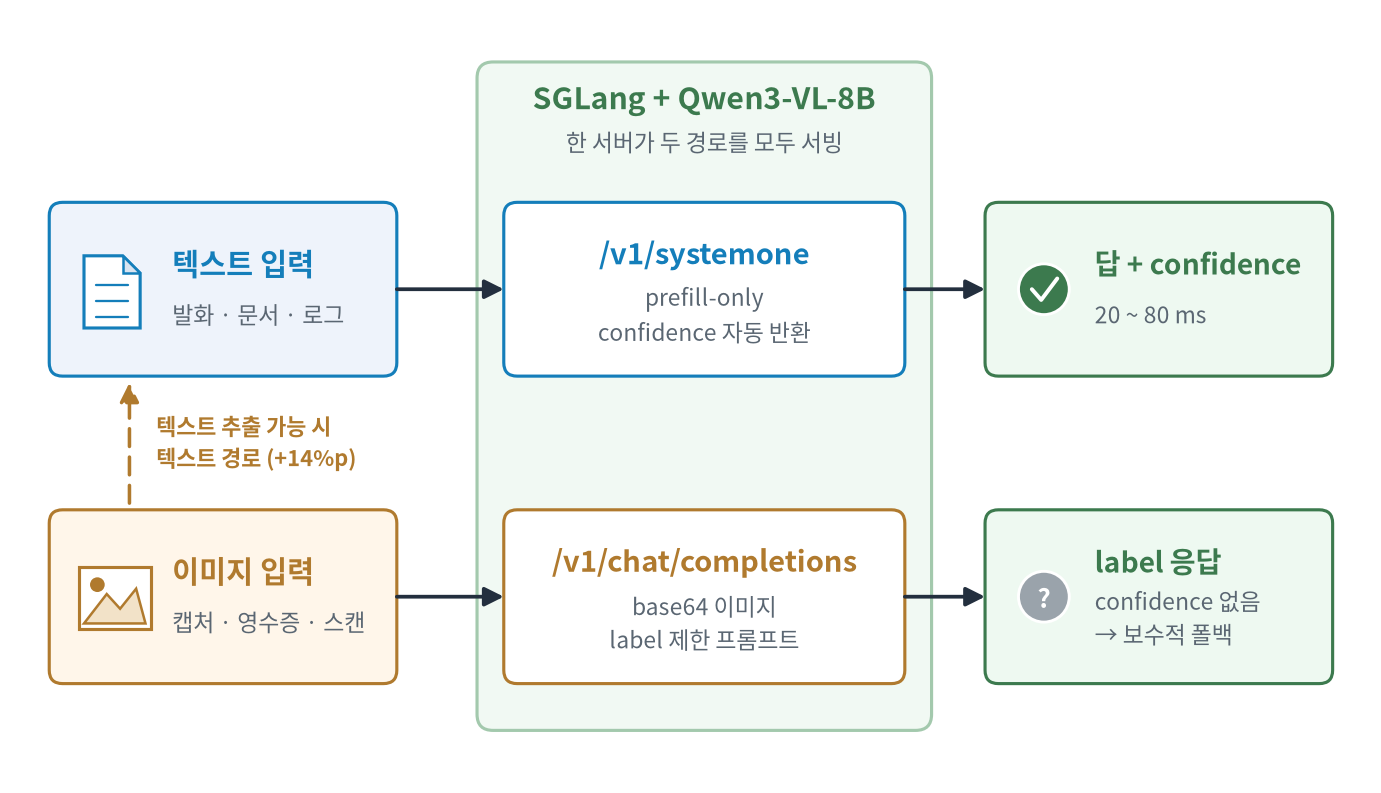
그림 5. 텍스트/이미지 판단 경로. 한 서버가 두 Endpoint로 모두 처리합니다. 텍스트 추출이 가능한 입력은 텍스트 경로가 더 정확합니다.
예를 들어 고객이 업로드한 스크린샷을 Agent가 먼저 판독해 다음 조치를 고르는 시나리오에 적용할 수 있습니다 (아래 이미지는 실제 테스트에 사용한 합성 데이터입니다):
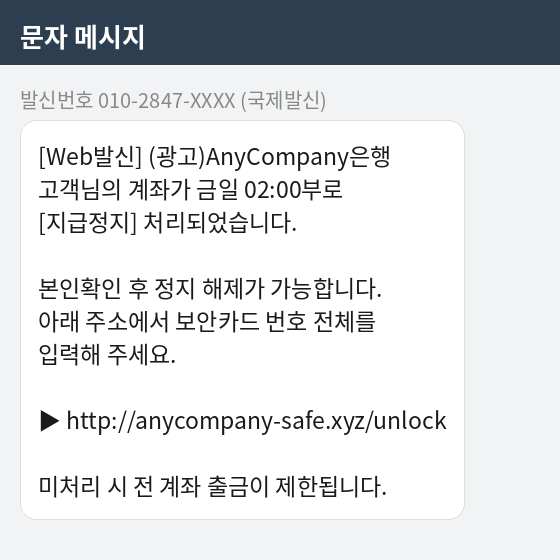
피싱 의심 문자 캡처 → “피싱 의심” 판정 시 보안 팀 플로우로 라우팅
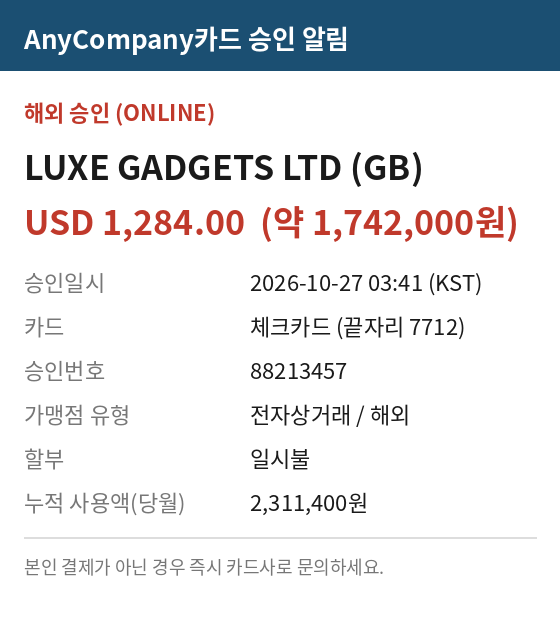
영수증/청구 내역 캡처 → 분쟁 처리 팀으로 라우팅
이미지 판단 실측 결과입니다. 세 조건 모두 동일한 /v1/chat/completions Endpoint로 측정해 경로 차이가 비교를 오염시키지 않도록 했습니다.
| 테스트 | 입력 형태 | Qwen3-VL-8B 정확도 | Claude Haiku 4.5 정확도 | 시사점 |
|---|---|---|---|---|
| 음식 사진 분류 (Food-101 Subset, 10지선다) | 사진 이미지 | 0.98 | 0.93 | 텍스트화할 수 없는 순수 시각 판단에서는 Frontier Model보다 높은 정확도 |
| 감성 판정 (NSMC 리뷰 100건을 한글 폰트로 PNG 렌더링) | 한글 텍스트가 들어간 이미지 | 0.70 | 0.60 | 텍스트가 이미지로 들어오면 모델과 무관하게 품질이 크게 떨어짐 |
| 감성 판정, 같은 100건의 텍스트 원문 (대조 조건) | 텍스트 | 0.84 | 0.853 | 같은 내용도 텍스트로 주면 이미지 대비 +14%p |
이 결과에서 두 가지 운영 원칙을 얻었습니다. 우선 이미지에서 텍스트 추출이 가능하면 텍스트 경로가 항상 더 정확했습니다(실측 품질 차이 약 14%p). 이미지 경로는 텍스트화할 수 없는 입력에만 씁니다. 또한 /v1/chat/completions 경로는 Confidence가 자동 반환되지 않으므로, 판독 실패나 모호한 입력은 보수적 폴백(사람 검토 또는 Frontier Model로 Escalation)으로 설계합니다.
한국어 판단 품질을 확보하는 두 가지 접근
앞서 본 한국어 실측이 보여주듯 한국어(그리고 비영어권 언어 일반) 판단 품질을 확보하는 경로는 현실적으로 두 가지입니다. (A) 다국어로 사전학습된 Open Source LLM을 SGLang으로 서빙해 Fine-tuning 없이 쓰면서 Calibration만 보강하거나(이 글의 기본 구성), (B) 영어권에서 잘 동작하는 경량 Decision Model을 해당 언어로 Fine-tuning하는 것입니다. 두 접근은 트레이드오프가 뚜렷하므로, 각 접근에서 어떤 데이터를 어떤 형식으로 준비해야 하는지까지 구체적으로 살펴봅니다.
접근 A. Open Source LLM을 Fine-tuning 없이 쓰고 Calibration으로 보강
앞서 본 대로 Open Source LLM은 사전학습된 Wvocab에 어휘 전체(한국어 포함)에 대한 Prior Knowledge를 이미 갖고 있어, Fine-tuning 없이 사용할 때 오히려 유리한 지점이 있습니다. 랜덤 초기화된 분류 헤드를 학습할 필요 없이 Label Logit만 읽으면 되고, 실제로 한국어 Guardrail 판정 Zero-shot 정확도 0.913은 동일 조건의 Fine-tuning 전 Laya(0.419, 앞의 한국어 실측 표)를 큰 차이로 앞섭니다. VLM을 고르면 이미지 판단까지 같은 모델로 해결됩니다.
이 접근에서 남는 간극은 정확도가 아니라 Confidence의 품질입니다. 실측에서 Qwen3-VL-8B의 ECE(Expected Calibration Error, Confidence와 실제 정확도의 괴리이며 0이면 완벽)는 NSMC 0.175, KLUE-YNAT 0.317로 일관되게 과신(Overconfident) 상태였습니다. 후보 Label로 분모를 제한한 Softmax가 확률 질량을 부풀리는 구조적 현상입니다. 이 문제는 두 단계로 해소합니다.
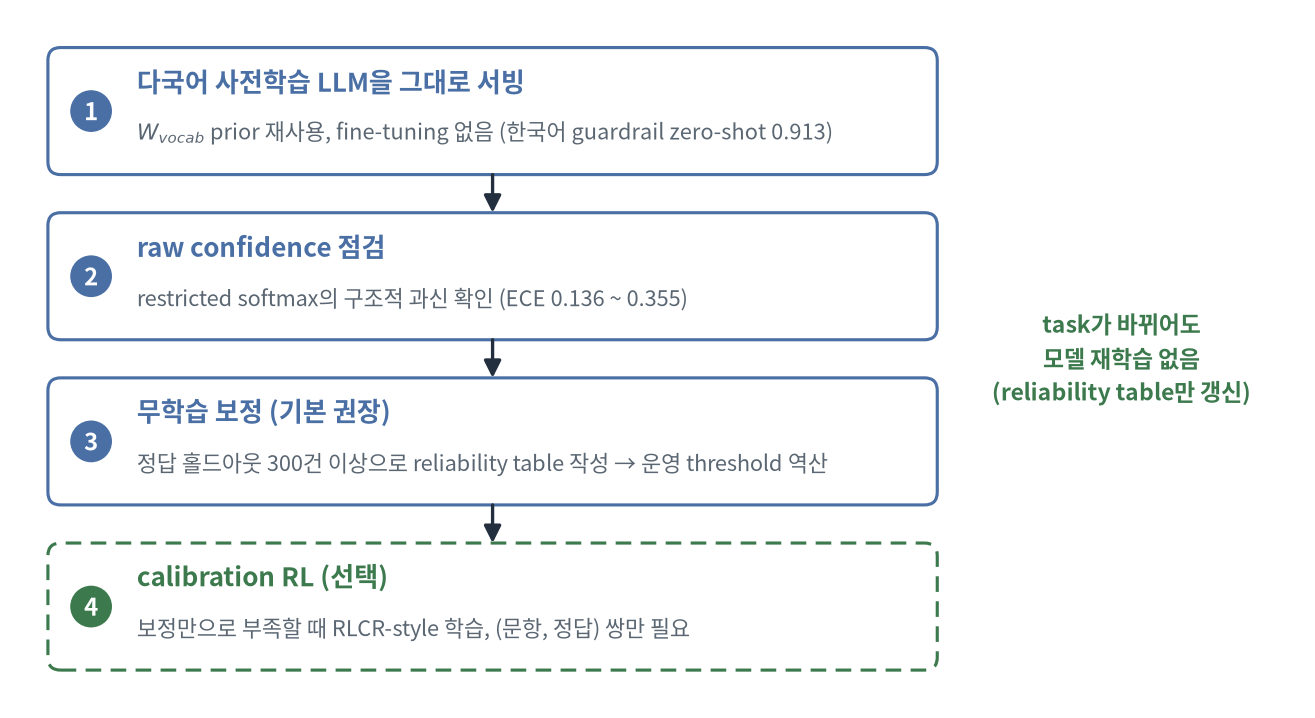
그림 6. 접근 A 파이프라인. Fine-tuning 없이 서빙을 시작하고, 과신된 Confidence를 Reliability Table 보정으로 다듬습니다. Calibration RL은 보정만으로 부족할 때의 선택지입니다.
(i) 무학습 보정 (기본 권장). 정답 Label이 있는 홀드아웃 300건 이상으로 Confidence 구간별 실제 정확도 표(Reliability Table)를 만들고, 목표 정확도를 만족하는 운영 Threshold를 역산합니다. 체계적 과신이 확인되면 Temperature Scaling(위 ECE 논문의 Post-hoc 보정 기법)을 추가합니다. 보정 데이터는 서빙 요청과 동일한 형식에 정답만 덧붙이면 됩니다:
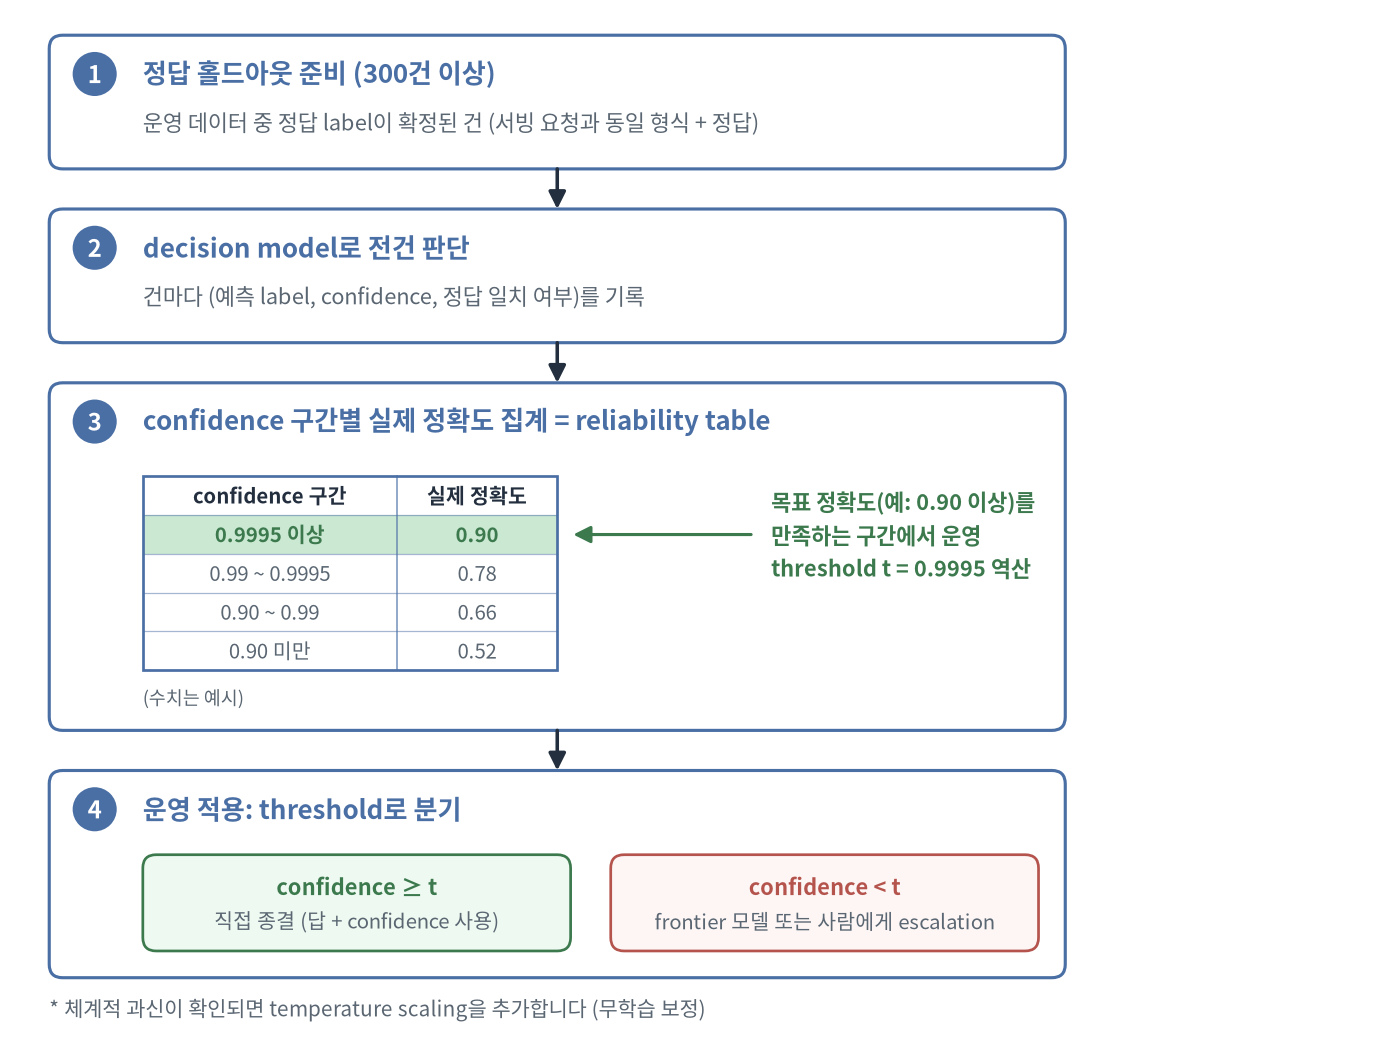
그림 7. Reliability Table 보정 파이프라인. 정답 홀드아웃 300건 이상을 Decision Model로 전건 판단해 Confidence 구간별 실제 정확도 표를 만들고, 목표 정확도를 만족하는 구간에서 운영 Threshold를 역산한 뒤, 운영에서는 이 Threshold로 직접 종결과 Escalation을 분기합니다 (표의 수치는 예시입니다).
여기서 홀드아웃 300건의 준비 시점을 분명히 해 둘 필요가 있습니다. 이 300건은 Decision Model을 사용하기 위한 사전 조건이 아닙니다. 모델은 서빙 즉시 Zero-shot으로 답과 Confidence를 반환하므로 판단 자체는 홀드아웃 없이 바로 가능합니다. 300건이 필요한 것은 Confidence를 운영 분기(직접 종결 vs Escalation)의 기준으로 쓰는 시점부터입니다. Raw Confidence는 과신 상태라, 보정 없이 Threshold를 정하면 실제 품질을 보장할 수 없기 때문입니다. 따라서 현실적인 도입 순서는 다음과 같습니다. 초기에는 판단 결과를 참고치로만 쓰거나 전량 Escalation하는 보수적 운영으로 시작하고, 그 과정에서 사람이 확정한 정답 Label(Escalation 처리 결과, 상담 기록 등)을 쌓습니다. 300건 이상 모이면 Reliability Table을 만들어 Threshold를 역산하고, 그때부터 고신뢰 구간의 직접 종결 비율을 늘려 갑니다. 기존에 보유한 Label 데이터가 있다면 그것을 초기 홀드아웃으로 써서 이 기간을 건너뛸 수 있습니다.
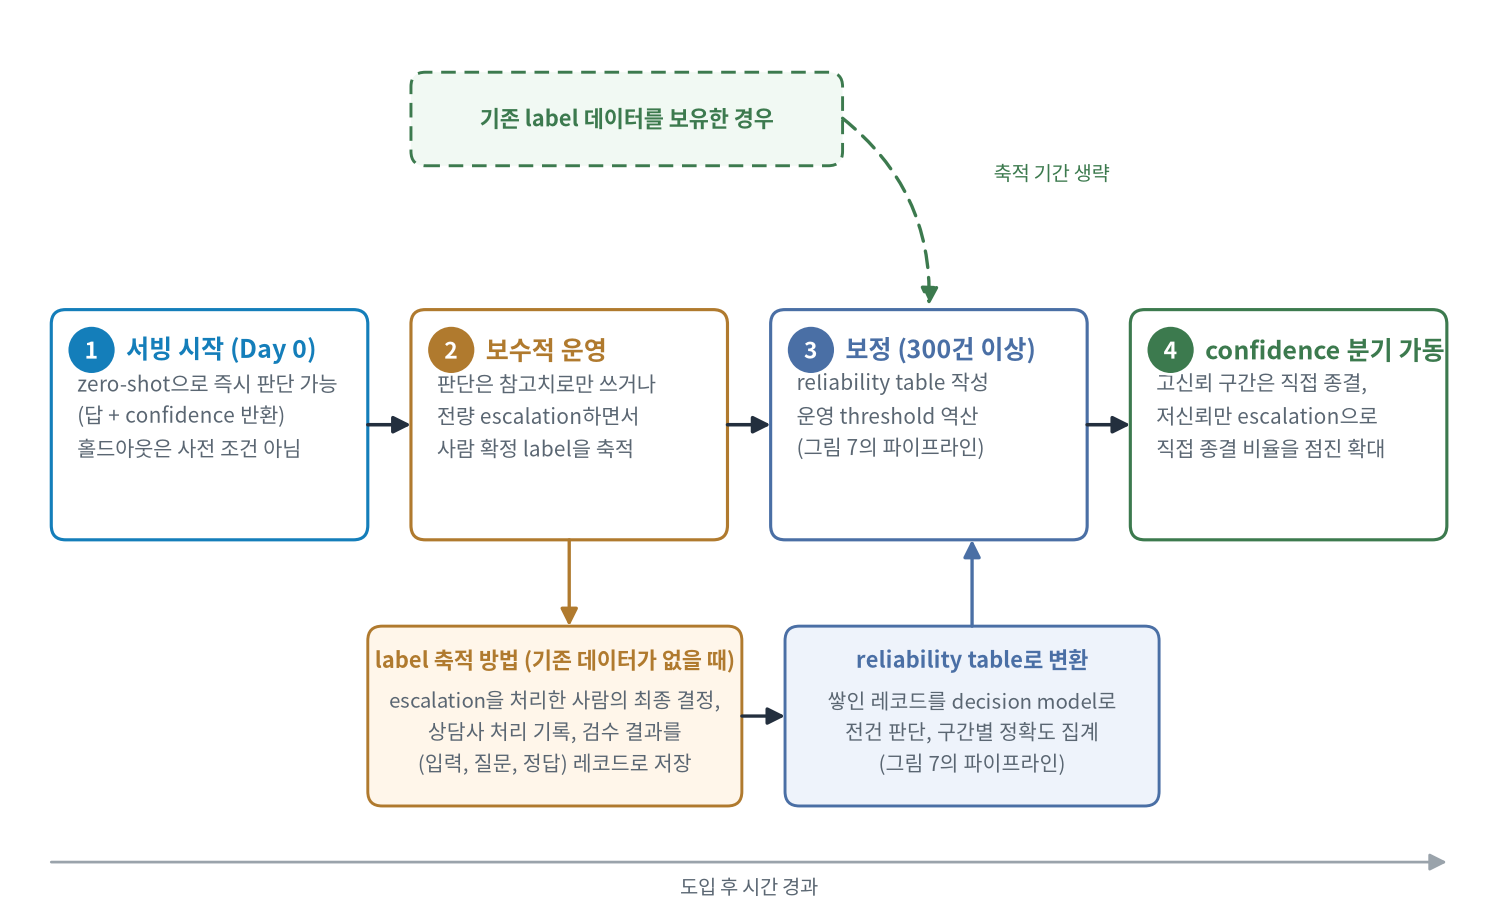
그림 8. Confidence 보정의 단계적 도입 타임라인. 서빙 첫날부터 Zero-shot 판단이 가능하고, 보수적으로 운영하며 쌓은 사람 확정 Label이 300건을 넘으면 보정을 거쳐 Confidence 분기를 가동합니다. 아래 줄은 기존 Label 데이터가 없을 때의 축적 방법(Escalation 처리 결과, 상담사 기록, 검수 결과를 (입력, 질문, 정답) 레코드로 저장)과, 쌓인 레코드가 그림 7의 파이프라인을 거쳐 Reliability Table이 되는 변환 과정을 보여줍니다. 기존 Label 데이터가 있으면 축적 단계를 건너뜁니다.
(ii) Calibration RL (선택). 보정만으로 부족하면 RLCR(Reinforcement Learning with Calibration Rewards, 모델이 답과 함께 표명한 Confidence q에, 정답 지시자 c에 대해 R = c - (q - c)² 형태의 Proper Scoring Rule 보상을 주는 공개 기법) 계열의 Calibration 학습을 적용할 수 있습니다. 이 보상 구조에서는 자신의 실제 정답 확률을 그대로 q로 말하는 전략이 기대 보상을 최대화하며, 공개 실측 기준 HotpotQA ECE를 0.37에서 0.03까지 낮췄습니다. 주목할 점은 데이터 요구입니다. Confidence Label이 필요 없고 (문항, 정답) 쌍이면 충분합니다:
접근 B. 영어권에 강한 경량 Decision Model을 한국어로 Fine-tuning
Laya는 Convai Innovations가 공개한 Open Source(Apache-2.0) Decision Model 패밀리입니다 (Multilingual 322M은 Hugging Face에 공개). Encoder 계열이라 CPU 서빙이 가능할 만큼 가볍고, Proper Scoring Rule(정직한 확률 표명이 기대 보상을 최대화하는 보상 설계) 기반 강화학습인 RLCD(Reinforcement Learning for Calibrated Decisions, 공개 논문은 없으며 Laya Repo가 공개 구현체입니다)로 Calibrated 확률을 반환하도록 학습되어 있습니다.
단, Laya는 “튜닝 전제” 모델입니다. 공식 Typed-decisions Benchmark에서 Zero-shot 0.362가 Fine-tuning 후 0.766으로 오르고, 자체 한국어 실측에서도 Zero-shot은 D1 0.419에 그쳤습니다(앞의 한국어 실측 표). 따라서 이 접근의 핵심은 “한국어 도메인 데이터로 Fine-tuning하는 것”입니다. 전체 흐름은 네 단계입니다.
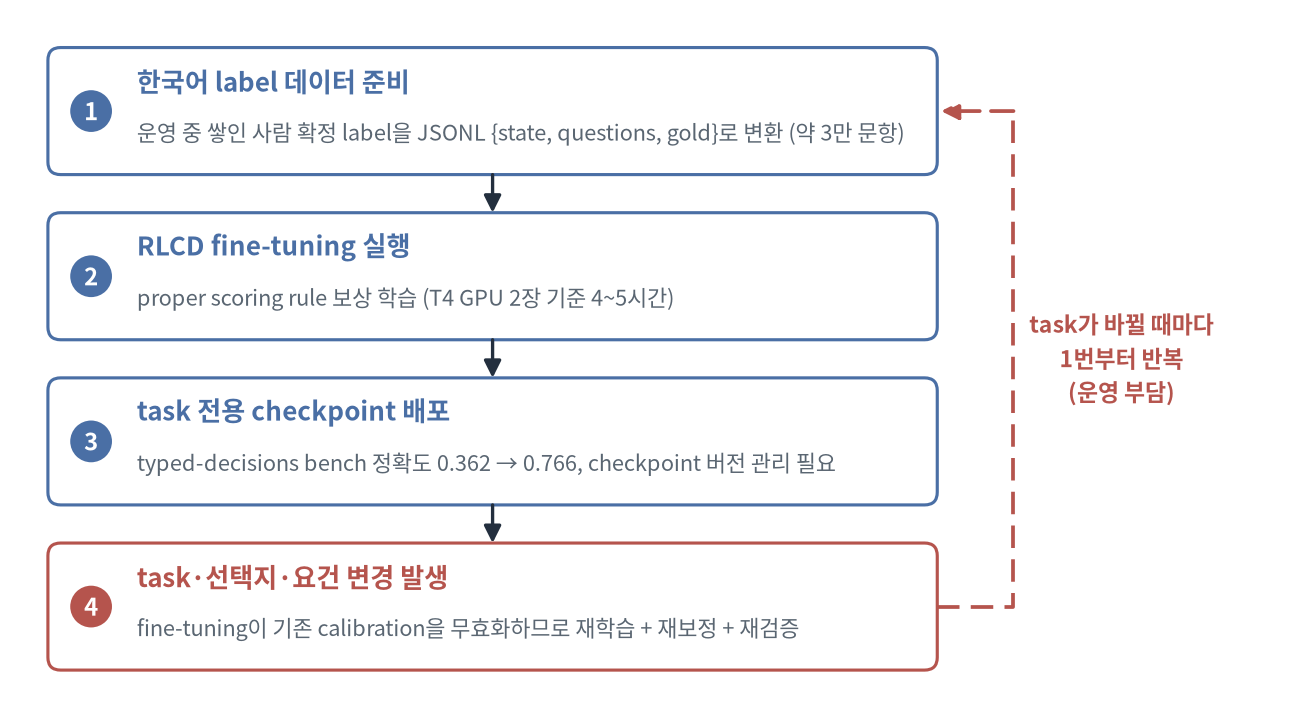
그림 9. 접근 B 파이프라인. 한국어 Label 데이터로 Fine-tuning해 Task 전용 Checkpoint를 배포하고, Task, 선택지, 요건이 바뀌면 재학습, 재보정, 재검증을 반복합니다.
FT 입력 데이터 형식. 공식 Fine-tuning 레시피는 서빙 Wire Format과 동일한 JSONL(레코드마다 {state, questions, gold})을 입력으로 받습니다. 운영 중 쌓이는 사람 확정 Label(티켓 라우팅 기록, Guardrail 심사 레코드, Intent 정답)을 그대로 이 형식으로 변환하면 됩니다:
공식 레시피 규모는 약 3만 문항, 4 Epochs, T4 GPU 2장 기준 4~5시간입니다. Gradient 학습 없이 쓰는 경량 경로(fit())도 있는데, 이때는 state 컬럼과 질문 ID별 정답 컬럼으로 구성된 CSV를 받으며 질문당 최소 약 35행(실용적으로는 수백 행)이 필요합니다.
운영 관점의 핵심 제약. 이 접근을 택하면 Task, 선택지 세트, 요구사항, 상황이 바뀔 때마다 Fine-tuning을 지속하거나 반복해야 하는 번거로움이 생깁니다. Fine-tuning은 모델의 모든 답을 바꾸므로 기존 Calibration이 무효화되어 재보정과 재검증이 뒤따르고, Task별 Checkpoint의 버전 관리도 운영 부담으로 남습니다. 또한 Laya는 텍스트 전용이라 앞서 본 이미지 판단 요구는 이 접근으로 해결되지 않습니다.
두 접근 비교
| 항목 | 접근 A: 무Fine-tuning + Calibration (이 글의 기본 구성) | 접근 B: 경량 모델 Fine-tuning (Laya 322M) |
|---|---|---|
| 시작 품질 (한국어 Guardrail D1) | Zero-shot 0.913 | Zero-shot 0.419 (Fine-tuning 전제) |
| 필요 데이터 | 정답 홀드아웃 300건 이상 (보정용) | 한국어 Label 데이터 약 3만 문항 |
| 학습 비용 | 없음 (RLCR-style Calibration은 선택) | T4 GPU 2장 기준 4~5시간, Task마다 반복 |
| Task/선택지 변경 시 | 모델 재학습 없음, Reliability Table만 갱신 | 재학습 + 재보정 + 재검증 반복 |
| 이미지 판단 | VLM 선택 시 같은 서버로 가능 | 불가 (텍스트 전용) |
| Confidence 품질 | Raw는 과신 상태, Reliability Table 보정 필수 | RLCD 학습으로 Calibrated |
| 서빙 Footprint | GPU 1장 (8B급) | 초경량, CPU 서빙 가능 (322M) |
선택 기준
| 조건 | 권장 접근 |
|---|---|
| 이미지 판단 필요, 다국어 범용성, Task가 자주 바뀜, Label 데이터 적음 | A: 무FT + Reliability Table 보정 (이 글의 기본 구성) |
| Confidence 품질을 더 끌어올려야 함 (정답 데이터 확보 가능) | A + RLCR-style Calibration |
| Task 고정, 사람 확정 Label 풍부, 초경량 CPU 서빙/엣지 Footprint가 최우선 | B: 단, Task 변경마다 재학습/재보정 반복을 운영 계획에 반영 |
Use Case 패턴
위 구성을 그대로 적용할 수 있는 대표 패턴입니다. 닫힌 선택지 판단은 /v1/systemone으로, 생성과 이미지 판단은 /v1/chat/completions로 처리하며, 강조할 점은 이 두 경로를 같은 모델, 같은 가중치의 SGLang 서버 1대가 모두 서빙한다는 것입니다. Decision Model을 위한 서버가 일반 LLM 역할(생성, 요약, 이미지 이해)까지 추가 인프라 없이 겸합니다.
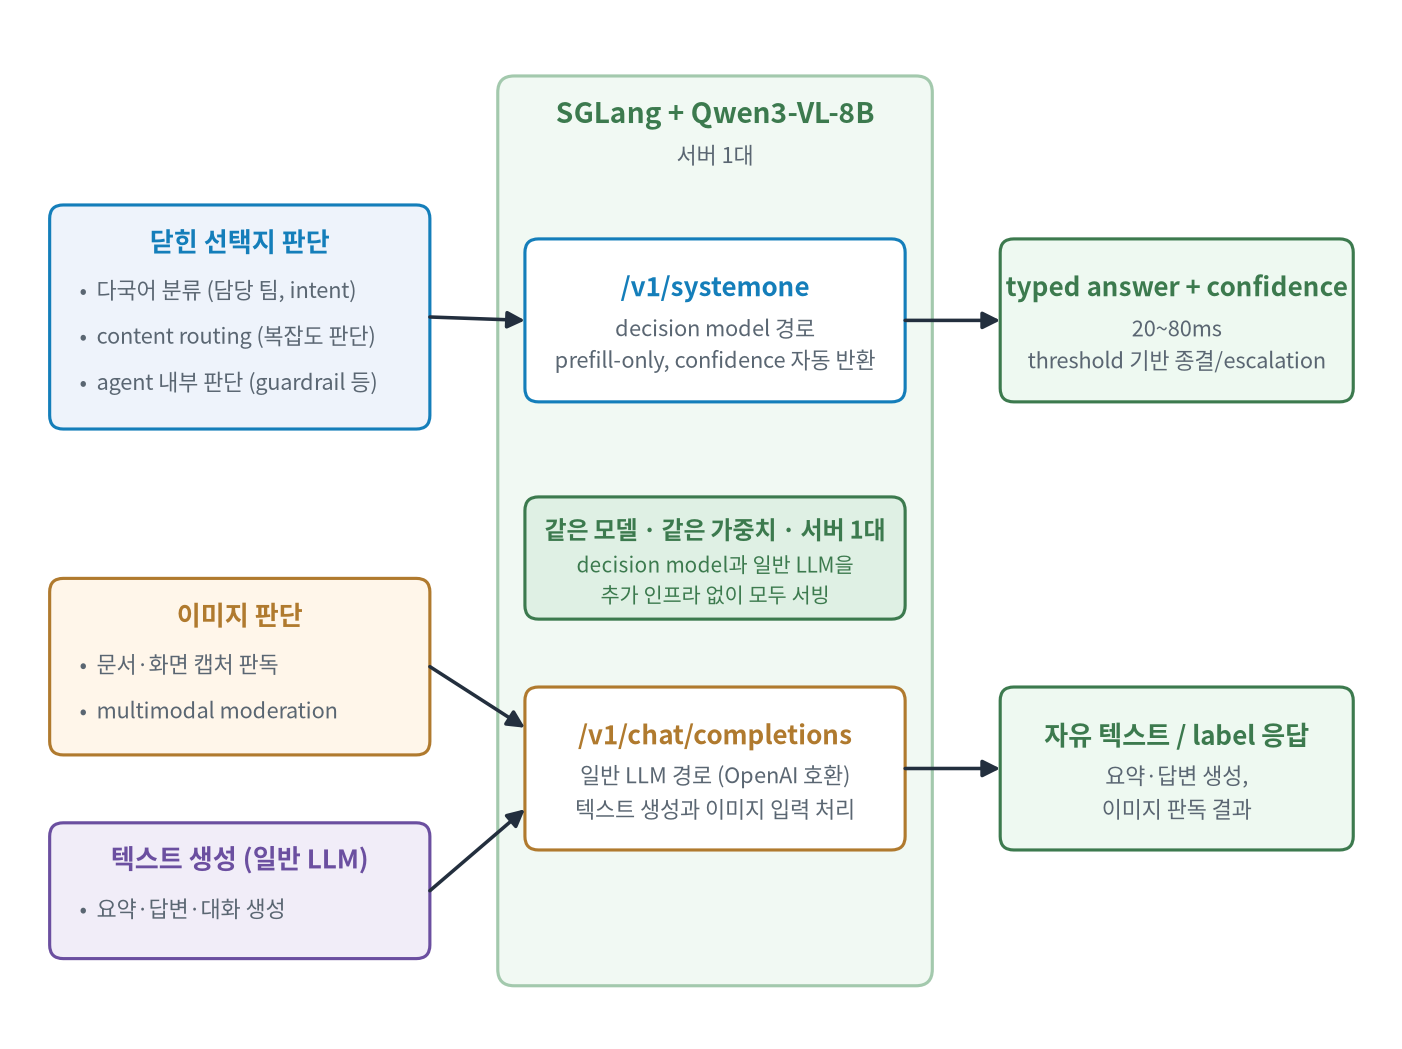
그림 10. Use Case 패턴 개요. 닫힌 선택지 판단, 이미지 판단, 텍스트 생성(일반 LLM)이 용도별로 나뉘지만, 같은 모델, 같은 가중치의 서버 1대가 Decision Model과 일반 LLM을 모두 서빙합니다.
| 패턴 | 판단 질문 (애플리케이션이 정의) | 입력 | 경로 |
|---|---|---|---|
| Multilingual Classification | “담당 팀은?”, “Intent는?” | 다국어 텍스트 | /v1/systemone choice |
| Content Routing | “이 요청은 복잡한가?” → 모델/플로우 선택 | 텍스트 | /v1/systemone 2-choice |
| Document/Image Review | “이 문서(캡처)는 어떤 상태인가?” | 문서 스캔, 화면 캡처 | /v1/chat/completions (텍스트화 가능하면 /v1/systemone) |
| Multimodal Moderation | “정책 위반 요소가 있는가?” | 텍스트 + 이미지 | 양 경로 병행, 저신뢰 시 사람/Frontier Model 검토 |
| Agent 내부 판단 | Guardrail, 도구 선택, 종료 판정 | 대화 상태 | AgentCore 내 판단 노드 → /v1/systemone |
| RAG 전처리 | “이 문서가 질문과 관련 있는가?” | 질문+청크 | /v1/systemone noul (실측 0.980, 35ms) |
비용과 운영
비용 구조. Decision Model은 토큰 종량제가 아니라 인스턴스 고정비입니다. 핵심 수치를 정리하면 다음과 같습니다.
| 항목 | 내용 |
|---|---|
| 과금 방식 | 토큰 종량제가 아닌 인스턴스 고정비 |
| 인스턴스 비용 | g6.xlarge 기준 $0.8048/시간, On-demand 730시간 기준 월 약 $588 (Amazon EC2 온디맨드 요금 기준) |
| 판단 단가 (최대 가동 가정) | 1,000건당 $0.0033 (94-token 입력 기준 보수 환산 67 req/s로 상각) |
| 처리량 특성 | 판단 호출은 Prefill-bound라 처리량이 입력 길이에 반비례 |
| Break-even | Frontier Model(Claude Sonnet 5.5) 단독 구성 대비 월 약 250만 판단 요청, Claude Haiku 4.5 판단 호출 대비 월 약 86만 판단 요청. 그 이하 규모라면 Bedrock 단독 구성이 더 저렴 (비교 단가는 Amazon Bedrock 요금의 실측 토큰 종량 기준) |
| 이미 SGLang 서빙 중인 경우 | Decision Endpoint 추가의 한계비용은 0에 수렴 |
비용 산정의 근거 요금은 Amazon EC2 온디맨드 요금과 Amazon Bedrock 요금 공시 단가입니다. 요금은 리전과 시점에 따라 달라질 수 있으므로, 적용 시 해당 리전의 최신 단가로 재계산하시기 바랍니다.
품질 운영. 세 단계를 권장합니다.
- Reliability Table 먼저: 판단 유형별로 Confidence 구간별 실제 정확도 표를 만들고 운영 Threshold를 데이터로 역산합니다. 실측에서 운영 Threshold는 직관적인 0.7~0.9가 아니라 0.999대에서 잡혔는데, 이는 앞서 설명한 과신 구조 때문입니다.
- Task 적합성 게이트: 신규 판단 유형은 고신뢰 구간 정확도가 Frontier Model Baseline 이상인지 사전 실측으로 확인한 뒤에만 투입합니다.
- 상시 모니터링: Amazon CloudWatch로 Confidence 분포 Drift와 경로별 비율을 모니터링하고, 고신뢰 구간 샘플을 주기적으로 Frontier Model과 대조합니다.
결론
- 하나의 일관된 방식으로 다국어/Multimodal 판단을 처리할 수 있습니다. SGLang으로 서빙한 Open Source VLM 한 대가 한국어 텍스트 판단(Guardrail 0.913, RAG 필터 0.980)과 이미지 판단(10-way 0.98)을 20~80ms에 수행했고, AgentCore 기반 Agent에 연결하면 e2e Latency -34%, 비용 -18%를 품질 저하 없이 얻었습니다.
- 벤더 종속 없이 Use Case별 모델 선택이 가능합니다. Decision Schema는 모델과 분리되어 있으므로, SGLang으로 서빙 가능한 어떤 Open Source Model로도 같은 API를 구성할 수 있습니다.
- 자체 AWS 환경에서 데이터 통제 요건을 충족합니다. 판단 트래픽은 Internet Gateway 없는 VPC를 벗어나지 않고, Bedrock Escalation도 PrivateLink로 폐쇄됩니다.
- 한국어(다국어) 품질은 두 경로로 확보합니다. Wvocab Prior를 활용해 Fine-tuning 없이 쓰면서 Calibration만 더하는 구성(접근 A, 이 글의 기본 구성)과, 경량 모델을 반복 Fine-tuning하는 구성(접근 B, Task가 바뀔 때마다 재학습 부담)입니다. Confidence를 그대로 믿을 수는 없으므로 어느 경로든 Reliability Table 기반 Threshold 보정과 Task 적합성 사전 실측이 전제입니다.