O blog da AWS
Cinco pilares para aplicar governança de IA no Amazon Quick
Por Victor Shinya, Enterprise Solutions Architect na AWS.
Uma automação agendada que ninguém acompanhava roda todas as noites e consome a franquia de IA da empresa; a fatura chega antes da pergunta “quem autorizou isso?”. Cenas assim marcam o momento em que a adoção de assistentes de IA no ambiente corporativo deixa de ser um experimento. Com o Amazon Quick, equipes criam Chat Agents personalizados com conhecimento do negócio, fazem perguntas em linguagem natural sobre seus dados corporativos, conduzem pesquisas aprofundadas e automatizam fluxos de trabalho — no navegador, no desktop e no celular.
Um exemplo claro desse valor são os Chat Agents personalizados: agentes criados sem código, com persona, instruções e conhecimento próprios — uma pessoa constrói, o time inteiro se beneficia. Eles se conectam aos dados que já fluem pelo pipeline analítico da organização, do data warehouse no Amazon Redshift ao data lake no Amazon Simple Storage Service (Amazon S3) consultado com o Amazon Athena, e respondem sobre os mesmos Datasets governados que alimentam os dashboards. A camada semântica ensina o significado de negócio de cada campo, e o Dataset Q&A traduz a pergunta em linguagem natural para uma consulta SQL, executada sobre o dado completo — normalmente em segundos, conforme a fonte e o volume. É a última milha da estratégia de dados: o investimento em pipelines e business intelligence (BI) passa a atender quem nunca abriu um dashboard, do vendedor no campo ao executivo no comitê, sem cópias paralelas em planilhas. E, justamente por multiplicar o acesso aos dados mais valiosos da empresa, ela precisa nascer governada.
Quando essa adoção sai do piloto e chega a dezenas de usuários — e, nas grandes organizações, a centenas ou milhares —, a pergunta que ocupa a liderança de tecnologia muda de natureza: já não é “a tecnologia funciona?”, e sim “como escalamos com previsibilidade de custo, segurança de dados e capacidade de auditoria?”. Os sinais de que essa pergunta chegou são conhecidos — a fatura da abertura é só o primeiro: o agente comercial compartilhado com quem não deveria ver aqueles números; a dúvida do comitê de segurança — “e se o agente responder o que o usuário não poderia ver?” — sem resposta documentada; ninguém que saiba dizer quantas licenças têm uso real, nem se as pessoas confiam nas respostas; e os ativos que ficam sem dono depois de um desligamento. Responder a isso antes que vire incidente é a agenda de governança de IA, e é ela que torna a adoção sustentável. Organizações que enxergam quem consome o quê, auditam interações, controlam a expansão de acesso e garantem que cada resposta respeita as permissões de dados existentes conseguem liberar a tecnologia para mais áreas, mais rápido, com menos fricção com times de segurança, privacidade e finanças.
Nesta postagem, apresento cinco pilares de governança de IA aplicados ao Amazon Quick. Três deles — consumo, interações e ciclo de vida dos dados — combinam controles nativos do serviço com implementações de referência publicadas em um repositório de exemplos (github.com/aws-samples/sample-quick-ai-governance) — módulos independentes, implementáveis com AWS CloudFormation ou AWS Serverless Application Model (AWS SAM). Os outros dois são integralmente capacidades nativas: o controle de compartilhamento, resolvido com permissões customizadas e políticas de aprovação, e a segurança de dados no acesso por agentes — uma propriedade da própria arquitetura do Amazon Quick e um argumento central para comitês de segurança.
- Visibilidade e controle de consumo (FinOps de IA — a gestão financeira do consumo de recursos de IA)
- Auditoria de interações e qualidade das respostas
- Controle de compartilhamento e permissões
- Saúde e ciclo de vida dos ativos de dados
- Segurança de dados no acesso por agentes: permissões herdadas de ponta a ponta
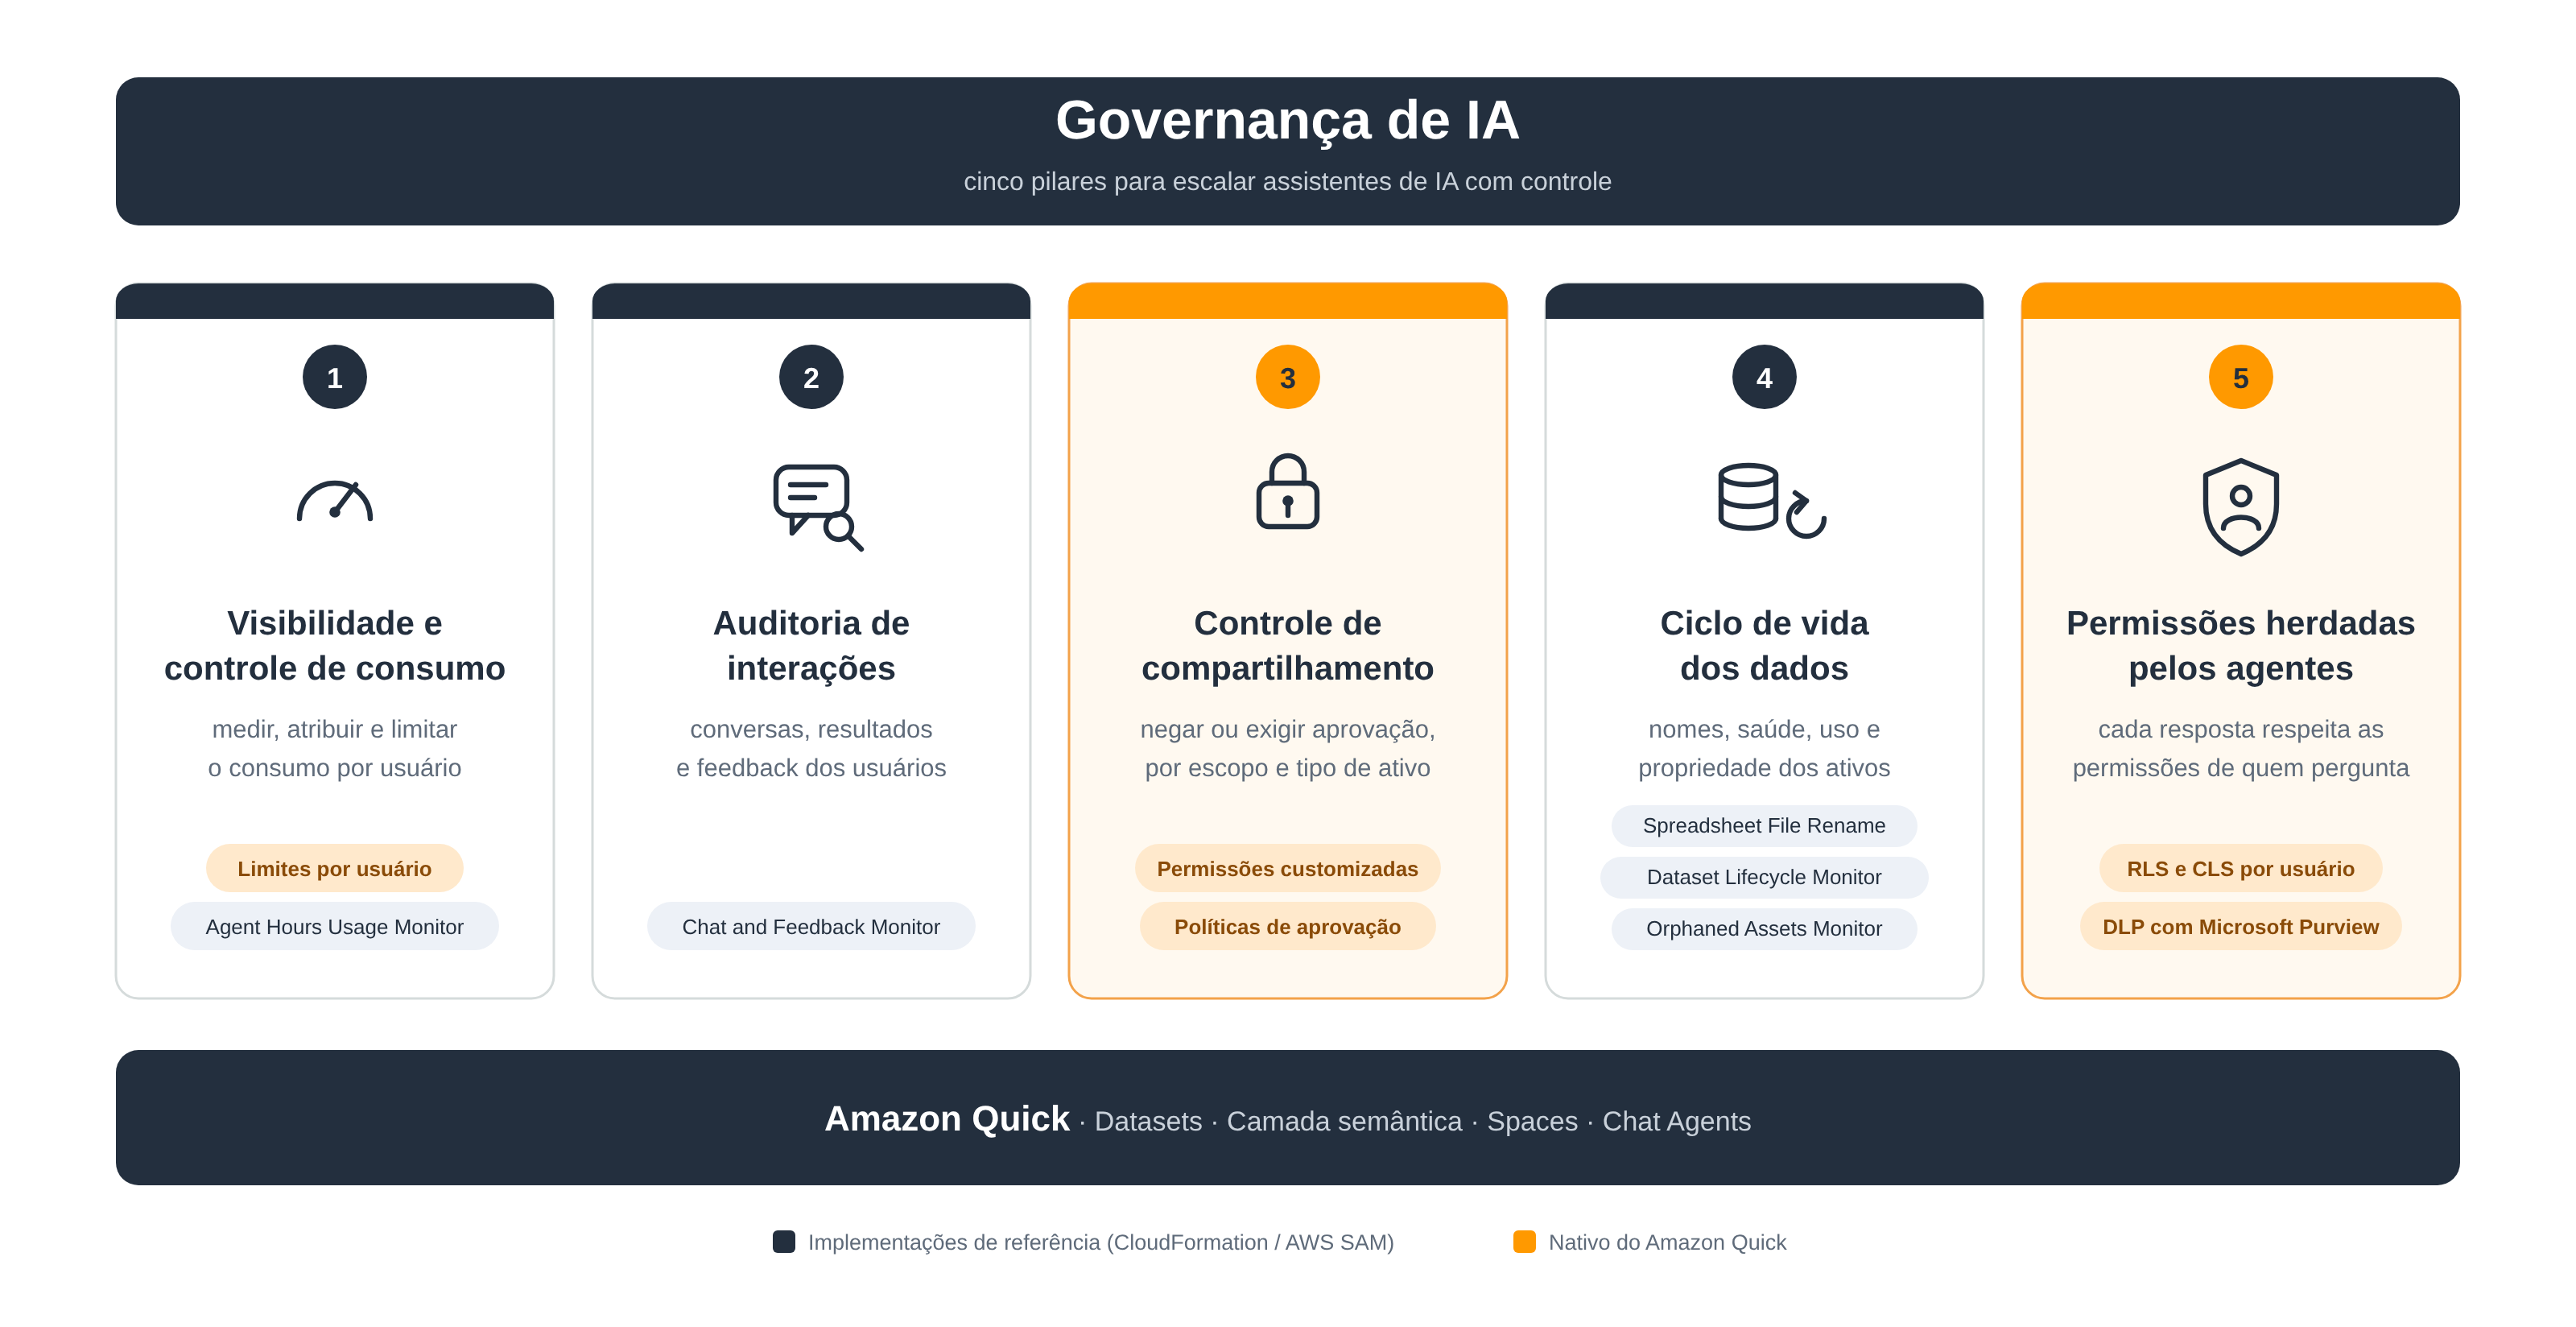
Figura 1 – Os cinco pilares de governança de IA com o Amazon Quick: os pilares 1, 2 e 4 (azul-marinho) combinam recursos nativos com implementações de referência disponíveis no repositório; os pilares 3 e 5 (laranja) são recursos nativos do serviço.
Pilar 1 — Visibilidade e controle de consumo
No Amazon Quick, as funcionalidades de IA — chat, pesquisa, fluxos, automação, geração de artefatos e aplicações ou agentes com tecnologia de IA personalizados criados por usuários — consomem agent hours, a unidade de consumo da assinatura. Com os aplicativos desktop e mobile em disponibilidade geral e com agentes que continuam executando na nuvem mesmo com o computador fechado, parte desse consumo acontece sem ninguém olhando: uma tarefa agendada debita horas a cada execução. O modelo de preços tem três componentes que todo orçamento de adoção precisa contemplar — a assinatura por usuário, a taxa de infraestrutura da conta e o consumo variável além da franquia incluída —, e a diferença de desenho entre os dois planos corporativos importa para o orçamento: no Professional, a franquia de agent hours é um teto, sem excedente; no Enterprise, o excedente existe e é medido por segundo. O quadro a seguir resume os valores vigentes na data desta publicação — consulte a página de preços do Amazon Quick para os valores e condições atuais.
| Componente | Professional | Enterprise |
|---|---|---|
| Assinatura por usuário | US$ 20 por mês | US$ 40 por mês |
| Taxa de infraestrutura | US$ 250 por conta/mês | US$ 250 por conta/mês |
| Agent hours incluídas | 8 horas por usuário/mês | 18 horas por usuário/mês |
| Excedente de agent hours | não disponível — a franquia é um teto | US$ 3 por hora, medido por segundo |
| Armazenamento de índice incluído | 25 GB por usuário, agrupados na conta | 50 GB por usuário, agrupados na conta |
| Excedente de armazenamento de índice | US$ 5 por GB/mês | US$ 5 por GB/mês |
Para quem responde pelo orçamento, três perguntas se impõem: quem está consumindo, em qual funcionalidade, e quanto disso é excedente cobrável?
O painel de analytics nativo do produto agrega o consumo por tipo de assinatura, o que é suficiente para acompanhar o todo, mas não para analisar individualmente áreas e usuários. A fonte granular é o AGENT_HOURS_LOGS, um feed de logs emitido pelo próprio serviço (vended logs) que pode ser entregue ao Amazon CloudWatch Logs, ao Amazon S3 ou ao Amazon Data Firehose. O módulo Agent Hours Usage Monitor provisiona essa entrega para um bucket de analytics compartilhado no Amazon S3 e implanta, junto com ela, um dashboard no Amazon Quick Sight — consultado diretamente pelo Amazon Athena, sem SPICE (Super-fast, Parallel, In-memory Calculation Engine, o motor em memória do Amazon Quick Sight) nem agendamento de atualização — com o total de horas do período, maiores consumidores, tendência de consumo por funcionalidade, horas incluídas na licença versus excedentes, e o detalhamento do excedente por usuário e por automação. Cada hora é atribuída a um usuário identificado ou, no caso de automações agendadas, ao recurso que a executou — nenhuma hora cobrável fica sem dono. Os mesmos dados no Amazon S3 servem a análises no Amazon Athena, no Amazon Managed Grafana ou em outras ferramentas, incluindo o cruzamento com grupos e centros de custo para rateio interno (chargeback).
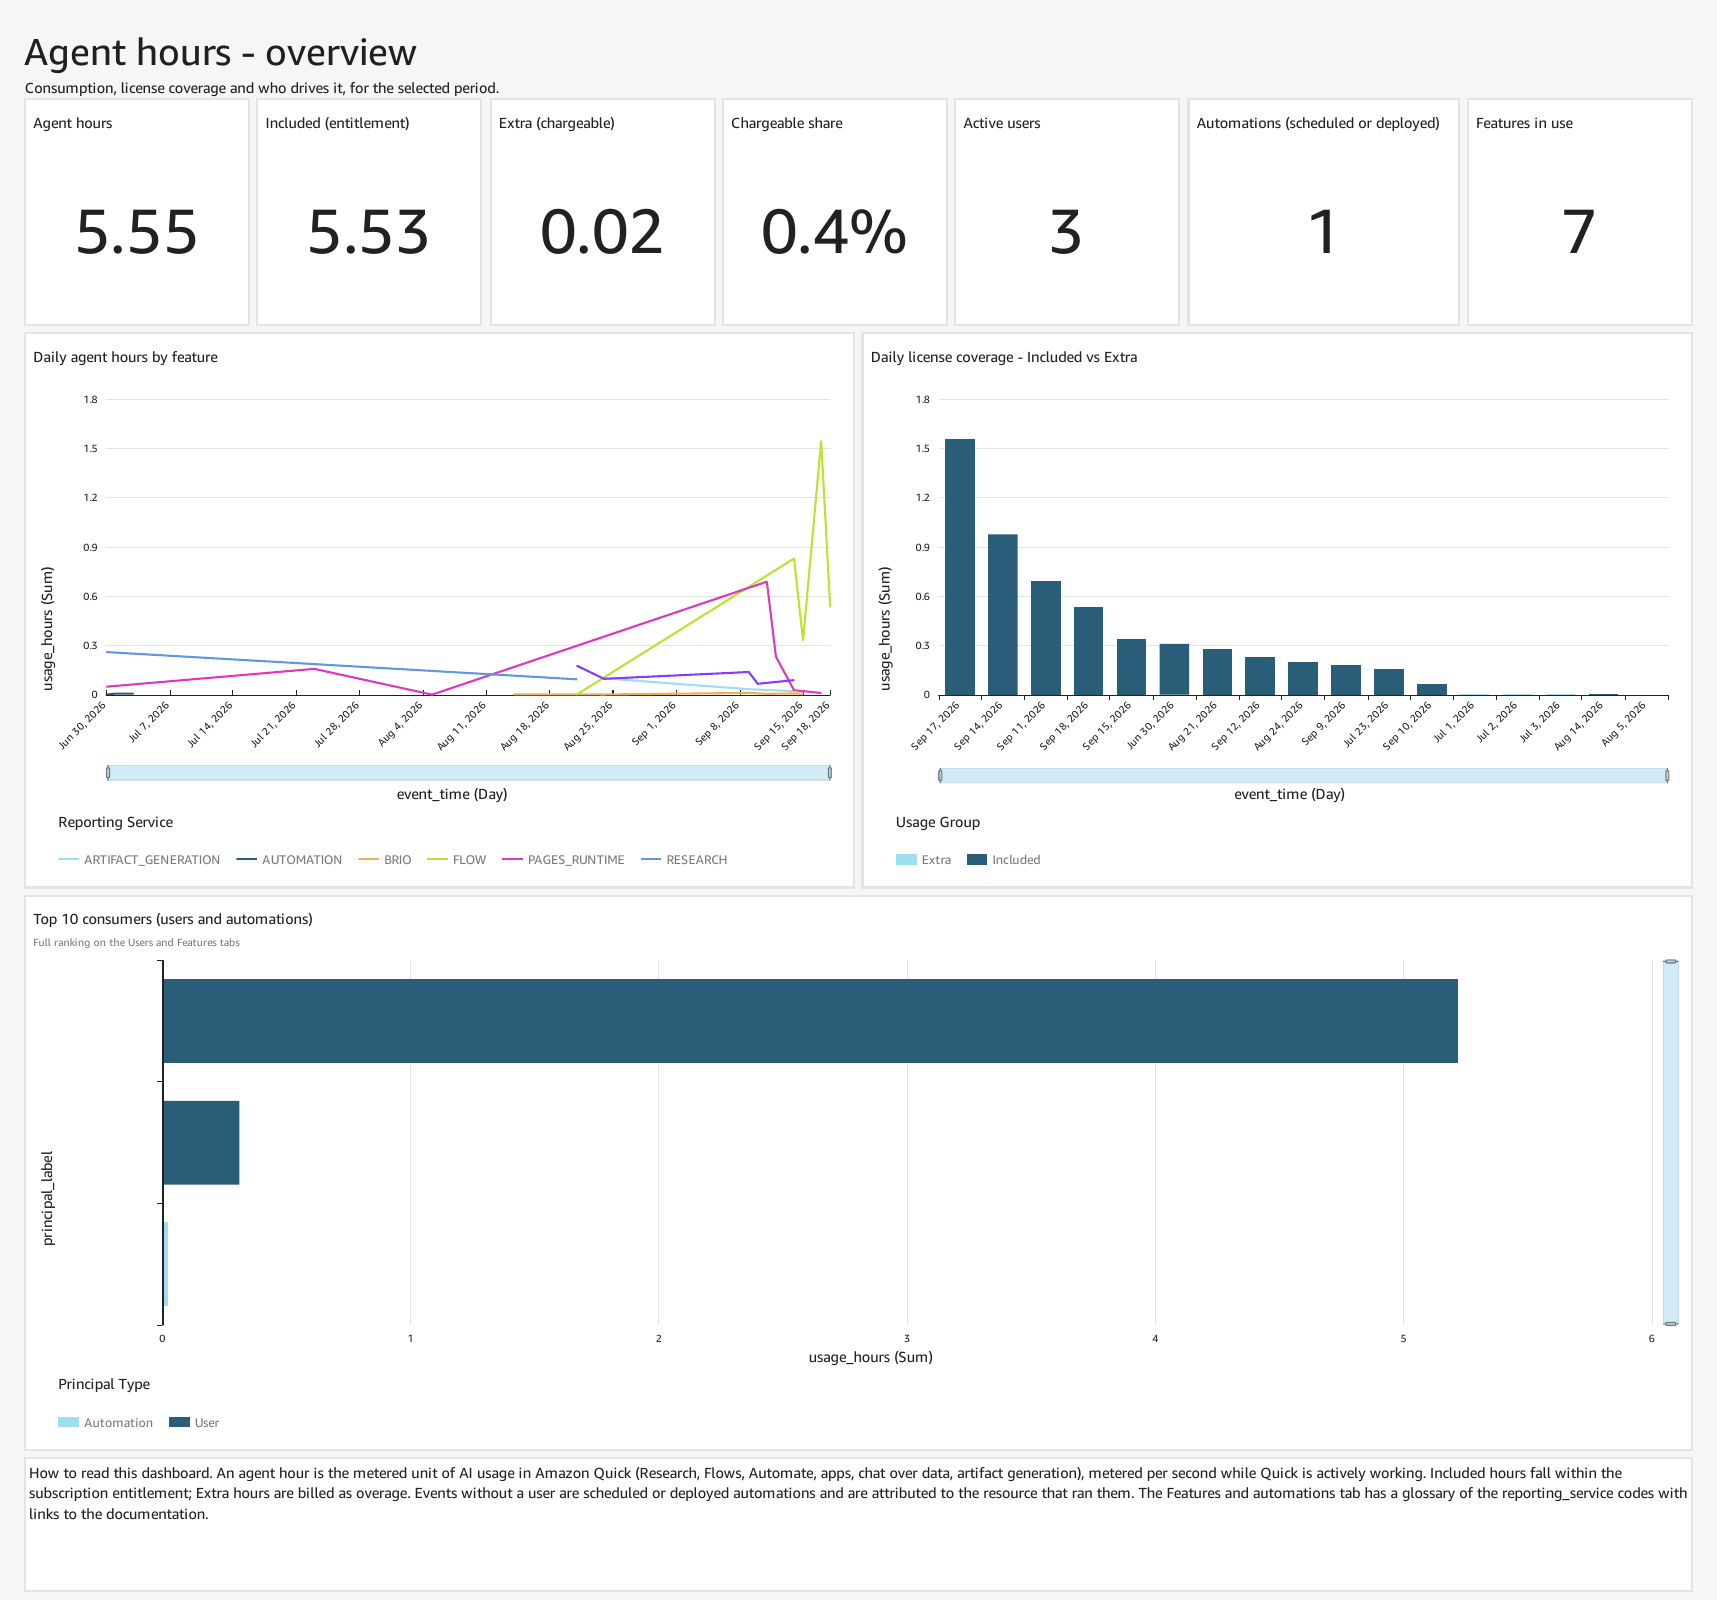
Figura 2 – A aba Overview do dashboard que o Agent Hours Usage Monitor implanta no Amazon Quick Sight: consumo total, cobertura de licença, parcela cobrável e maiores consumidores; as abas de usuários, funcionalidades e eventos detalham o rateio. Dados de demonstração.
Visibilidade, porém, é metade do controle — a outra metade é aplicação. Desde agosto de 2026, o serviço oferece limites de recursos por usuário: o administrador cria perfis de limite (limit profiles) reutilizáveis, com tetos individuais de agent hours por ciclo de faturamento e de armazenamento de índice (index storage), e os atribui a usuários, a papéis ou à conta inteira — vale sempre a atribuição mais específica. Quando o usuário atinge 100% do teto, novas invocações de agente (ou novos uploads e ingestões, no caso de armazenamento) são bloqueadas até o ciclo seguinte; o conteúdo existente é sempre preservado, o limite vale globalmente entre regiões e cada usuário acompanha o próprio consumo em um widget dedicado — transparência que evita surpresas também para quem consome.
O resultado de negócio é previsibilidade em duas camadas: o teto nativo impede que um único usuário esgote a capacidade de índice compartilhada ou gere excedentes de agent hours inesperados, e o monitor responde ao que o teto não responde — quem consome, em quê e com que tendência — além do alarme quando o consumo agregado do mês se aproxima do contratado.
Pilar 2 — Auditoria de interações e qualidade das respostas
As perguntas seguintes de qualquer comitê de adoção são de uso e de qualidade: quantas das licenças contratadas têm atividade real no mês, se as pessoas confiam nas respostas e o que está sendo bloqueado ou ficando sem resposta. O Amazon Quick emite dois feeds de logs para isso — CHAT_LOGS (mensagens e respostas) e FEEDBACK_LOGS (avaliações “útil” / “não útil” com motivos e comentários) — documentados em Monitoring Amazon Quick using CloudWatch Logs.
O módulo Chat and Feedback Monitor entrega os dois feeds duas vezes: completos, a um único grupo de logs criptografado — a trilha de auditoria do conteúdo —, e sem prompts, respostas ou comentários, ao bucket de analytics compartilhado, de onde o dashboard no Amazon Quick Sight lê: volume de mensagens e conversas, usuários ativos no período (a base para comparar com as licenças contratadas) e os mais ativos, agentes mais utilizados (com os nomes amigáveis atualizados a cada renomeação), status das respostas (sucesso, bloqueada, sem resposta), tendência de sentimento com os motivos das avaliações negativas, e uma trilha de auditoria com identificadores que correlacionam pergunta, resposta e avaliação — essencial em investigações.
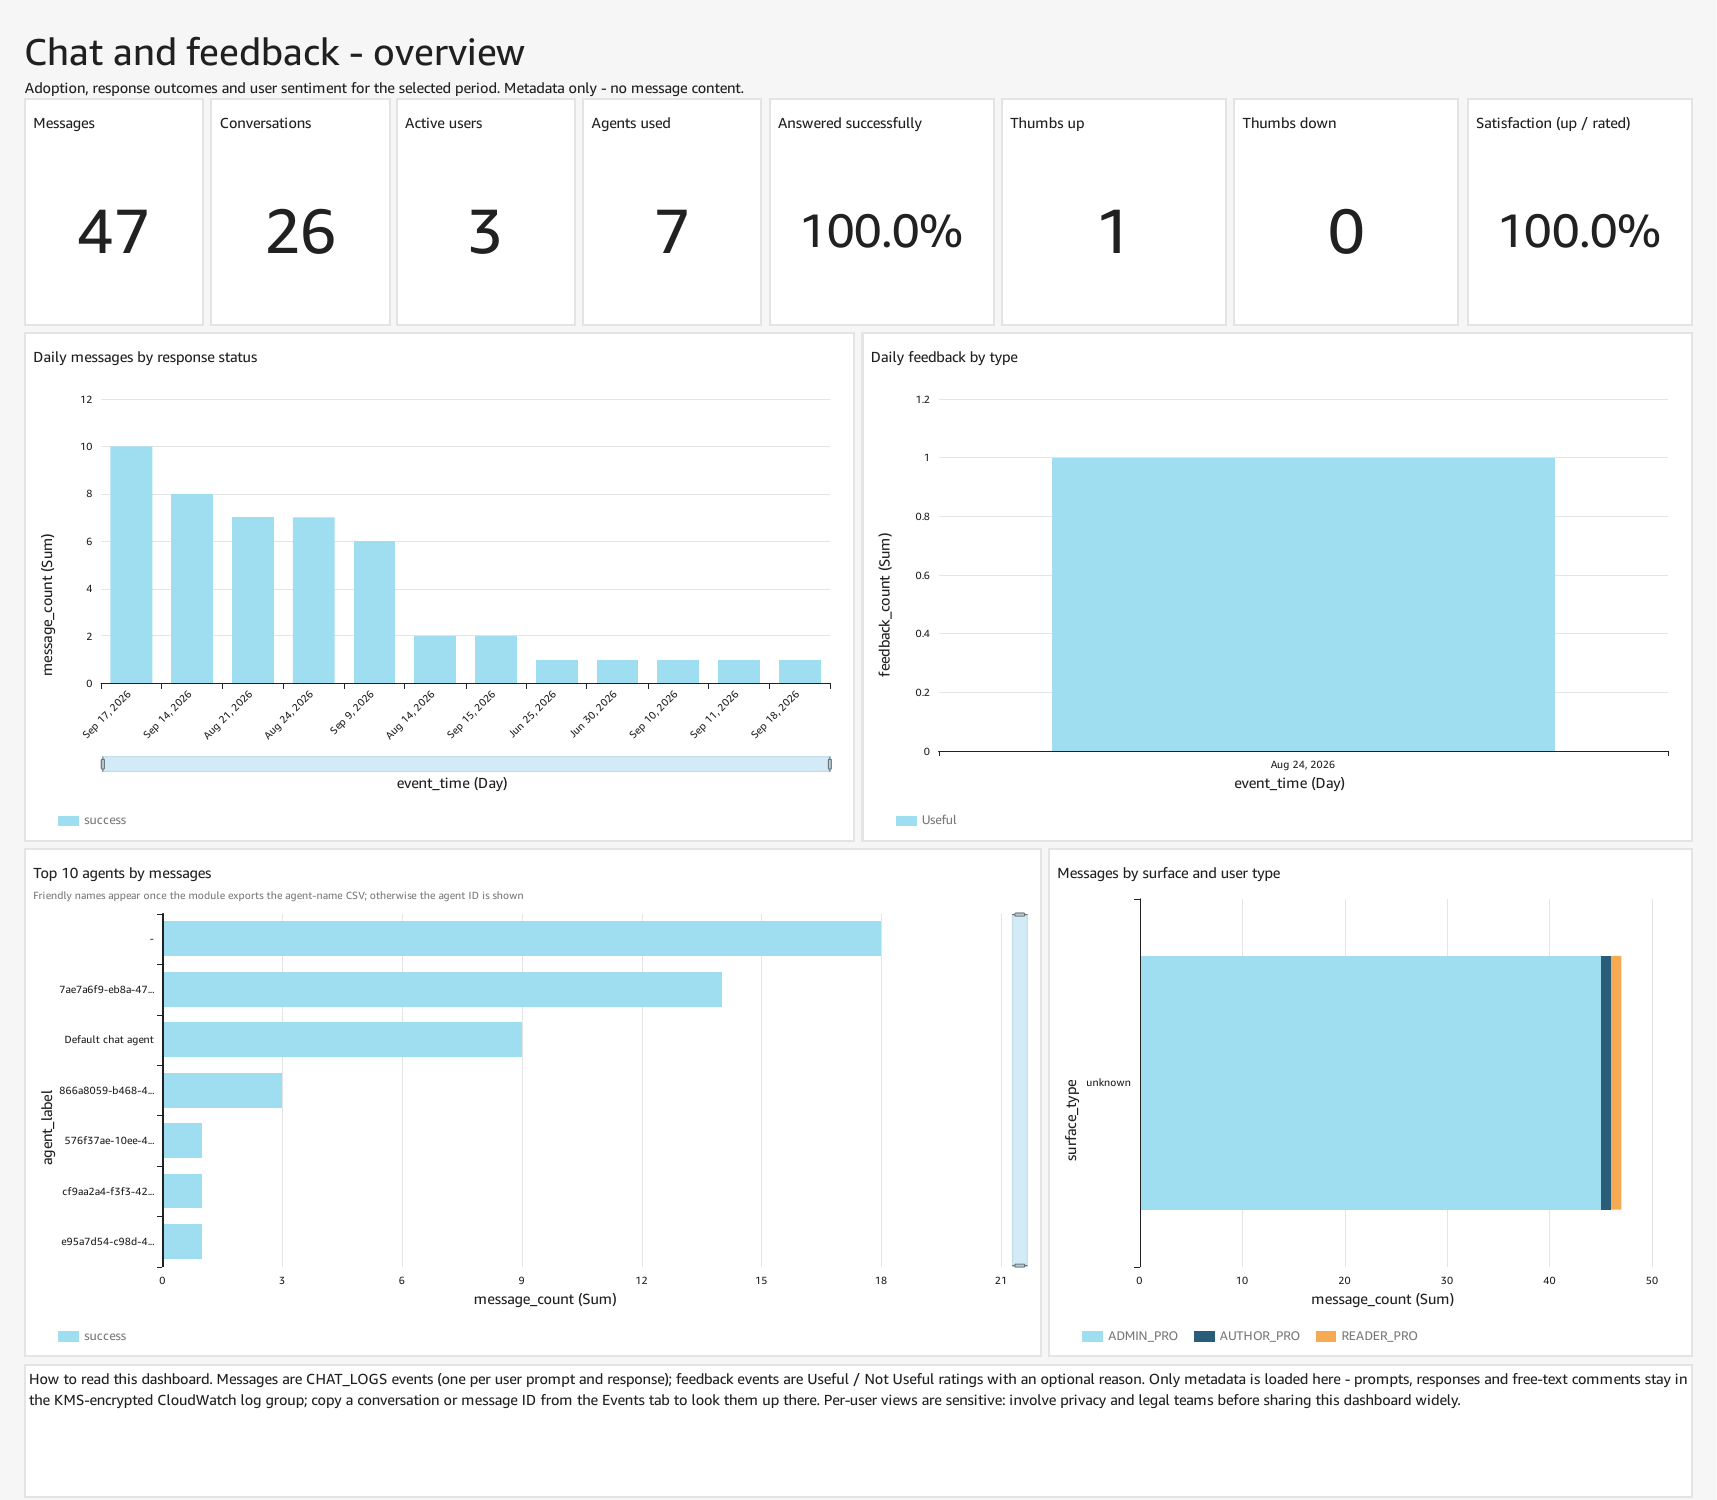
Figura 3 – A aba Overview do dashboard do Chat and Feedback Monitor no Amazon Quick Sight: mensagens, conversas, taxa de sucesso e sentimento — apenas metadados; prompts, respostas e comentários nunca saem do grupo de logs criptografado. Dados de demonstração.
Dois pontos merecem atenção da liderança. Primeiro, logs de conversa contêm prompts e respostas — potencialmente dados sensíveis. Por padrão, o módulo criptografa o grupo de logs com uma chave dedicada do AWS Key Management Service (AWS KMS) e o classifica como sensível, mas o controle de quem acessa essas visões e a conformidade com a Lei Geral de Proteção de Dados (LGPD) e com as políticas internas de monitoramento de colaboradores permanecem responsabilidade da organização — envolva os times de privacidade e jurídico antes de expor rankings por usuário. Segundo, a entrega de logs é regional e não retroativa: habilite o monitoramento cedo, em cada região com atividade do Amazon Quick, porque não há como recuperar o histórico anterior à configuração.
O resultado de negócio: adoção e qualidade mensuráveis — quantas licenças têm uso real, quais agentes merecem investimento, onde as respostas falham — com uma trilha de auditoria que preserva o conteúdo das conversas sob criptografia e acesso restrito.
Pilar 3 — Controle de compartilhamento e permissões
Democratizar a criação de agentes não significa democratizar a distribuição deles. Um Chat Agent bem construído sobre dados comerciais é um ativo valioso — e compartilhá-lo com a audiência errada expande o acesso a esse ativo. O Amazon Quick oferece perfis de permissões customizadas que permitem negar capacidades específicas sem impedir o trabalho.
Tudo acontece no console de administração do serviço, sem código, em quatro passos:
- Em Manage account → Permissions → Custom permissions, crie um perfil.
- Em Capabilities & features, negue as capacidades de compartilhamento — Share chat agents, Share spaces e Sharing datasets — e, se quiser, as de dashboards, análises e fontes de dados.
- Atribua o perfil no escopo desejado: a conta inteira, um papel (por exemplo, todos os autores) ou usuários específicos — a atribuição mais específica prevalece sobre a mais ampla.
- Valide com Check permissions, que mostra qual perfil está valendo para cada usuário e em qual nível.
O efeito prático: os usuários continuam criando e consumindo conteúdo governado, mas a ampliação de audiência passa por um fluxo controlado pelo time central. Perfis customizados só restringem — nunca ampliam — o que o papel do usuário já permite.
Transparência sobre os limites: um perfil bloqueia compartilhamentos futuros, mas não revoga os já concedidos — a remediação de compartilhamentos existentes é um trabalho à parte, que muda acessos vigentes e merece revisão própria. Negar compartilhamento não é prevenção completa de vazamento: exportações e downloads pedem controles complementares. A atribuição é por conta, papel ou usuário — não por grupo.
O mesmo mecanismo ganhou, em agosto de 2026, uma postura para o ritmo de lançamentos do produto: o deny by default. Em vez de enumerar o que negar, o administrador restringe a categoria inteira de capacidades de IA em um perfil e libera explicitamente as que a organização já avaliou; qualquer capacidade de IA que o Amazon Quick lance depois nasce negada para esses usuários, no dia do lançamento, até que alguém a aprove. É a resposta para comitês que exigem avaliação prévia de recursos de IA — políticas de risco de modelo, setores regulados, rollouts controlados — sem que o administrador precise correr atrás de cada novidade.
Negar, porém, não é a única postura possível. O mesmo ciclo de lançamentos de agosto de 2026 trouxe as políticas de aprovação para compartilhamento: fluxos de aprovação opt-in, em que pedidos de compartilhamento de Spaces, knowledge bases (as bases de conhecimento sincronizadas de fontes como SharePoint, OneDrive e Confluence) e Chat Agents personalizados só se concretizam depois de revisados por grupos aprovadores designados — grupos de identidade existentes no AWS IAM Identity Center, em federação com o AWS Identity and Access Management (IAM) ou no Active Directory. O acesso do destinatário só é concedido após a aprovação, e cada evento — submissão, aprovação, negação, revogação — fica registrado no AWS CloudTrail.
O desenho traz dois méritos que comitês de risco apreciam. Primeiro, o aprovador de um Chat Agent pode testá-lo antes de decidir, executando-o no contexto do criador — sem ganhar acesso direto às fontes de dados subjacentes (o Pilar 5 em ação). Segundo, o compartilhamento de um agente pode ser aprovado como pacote: o agente e suas dependências — knowledge bases, conectores, Spaces — em uma única decisão, tudo ou nada, com a lista completa visível ao aprovador. Na prática, a organização passa a dispor de uma escala de três posições por tipo de ativo e população: permitir, exigir aprovação ou negar — as permissões customizadas cobrem a posição mais restritiva; as políticas de aprovação instrumentam o meio-termo governado.
Pilar 4 — Saúde e ciclo de vida dos ativos de dados
A qualidade das respostas de um agente é limitada pela qualidade dos dados que o alimentam. Em escala, o acervo de Datasets cresce rápido — uploads pontuais de planilhas convivem com pipelines governados — e a pergunta operacional vira: o que temos, o que está saudável, o que ainda é usado — e quem ainda é dono? Três módulos atacam esse pilar.
O Spreadsheet File Rename automatiza uma convenção de nomes: quando alguém cria um Dataset a partir do upload de uma planilha, o Amazon EventBridge captura o evento de criação e uma função AWS Lambda renomeia o ativo em segundos com um prefixo padrão (por exemplo, xls-), sem qualquer mudança na experiência de quem fez o upload. Administradores passam a distinguir, à primeira vista, dados de upload manual de dados de pipeline. É governança por convenção — automática e invisível para o usuário.
O Dataset Lifecycle Monitor dá a visão de frota que o console não oferece a um administrador corporativo: status da última sincronização de cada Dataset com o motivo tipado da falha, duração das atualizações (última versus média, completa versus incremental), capacidade SPICE consumida com um sinal estimado de custo, e o último uso observado — sempre com um rótulo de confiança, porque a evidência de uso disponível é indício, não veredito. Essa evidência combina visualizações de dashboards, consultas registradas no AWS CloudTrail, linhagem de topics e — quando o monitor do Pilar 2 está implantado — os ativos citados pelos Chat Agents nas conversas (CHAT_LOGS), cobrindo justamente o caminho de consumo por agentes que a telemetria de dashboards sozinha não enxerga. Novas falhas de atualização geram alertas pelo Amazon Simple Notification Service (Amazon SNS). O desenho importa para o modelo operacional: toda a coleta usa APIs de leitura autorizadas pelo AWS IAM, sem exigir copropriedade dos Datasets — o time de governança enxerga a operação sem ganhar acesso ao dado de ninguém. E o módulo é estritamente observacional: não apaga ativos, não desabilita agendamentos, não altera permissões.
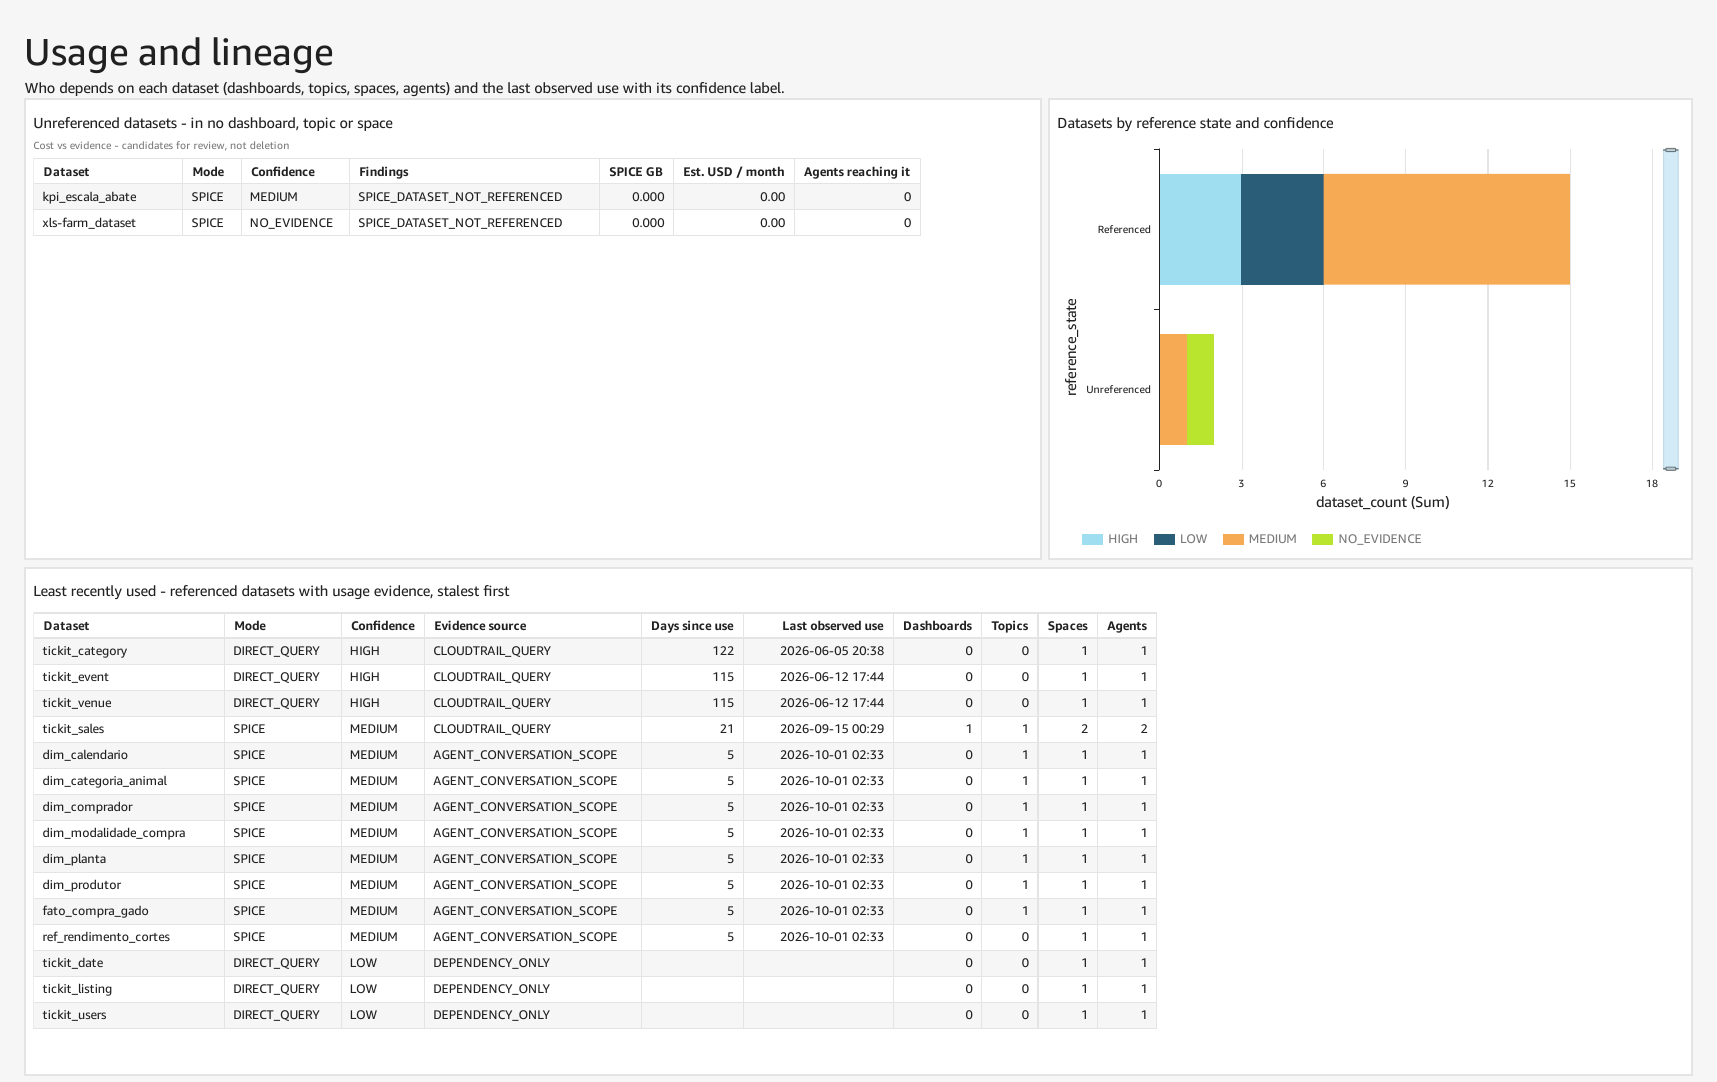
Figura 4 – A aba de uso e linhagem do dashboard do Dataset Lifecycle Monitor no Amazon Quick Sight: para cada Dataset, o último uso observado, o rótulo de confiança e a fonte da evidência — consulta registrada no AWS CloudTrail, escopo de conversa de um agente ou apenas dependência declarada — e quem depende dele. Candidatos a revisão, não a exclusão. Dados de demonstração.
O Orphaned Assets Monitor fecha a lacuna de propriedade. O Amazon Quick não transfere automaticamente os ativos de um usuário removido, e o que acontece depende do caminho da remoção, documentado em User lifecycle and data handling in Amazon Quick: a exclusão pelo console oferece ao administrador transferir ou apagar os ativos; a API DeleteUser não executa qualquer limpeza, e os ativos ficam sem dono até que um administrador os transfira; remoções feitas pelo provedor de identidade apenas movem o usuário para a lista de inativos, com os ativos intactos até a revisão. O módulo reconcilia diariamente, em modo somente leitura, os donos de cada ativo — Datasets, dashboards, análises, fontes de dados, pastas, Spaces, agentes e topics — contra o inventário atual de usuários e grupos, e sinaliza a escada de risco: ativos órfãos ou com donos inexistentes (severidade alta), ativos mantidos por um único dono ativo — a lista a revisar antes de qualquer desligamento — e as recuperações quando a propriedade é restaurada. A remediação permanece deliberadamente humana, no console de gestão de ativos do serviço; e o cruzamento com o Dataset Lifecycle Monitor permite priorizar transferências pelo uso — um ativo órfão que alimenta agentes ativos é urgente; um órfão sem uso é candidato a arquivamento.
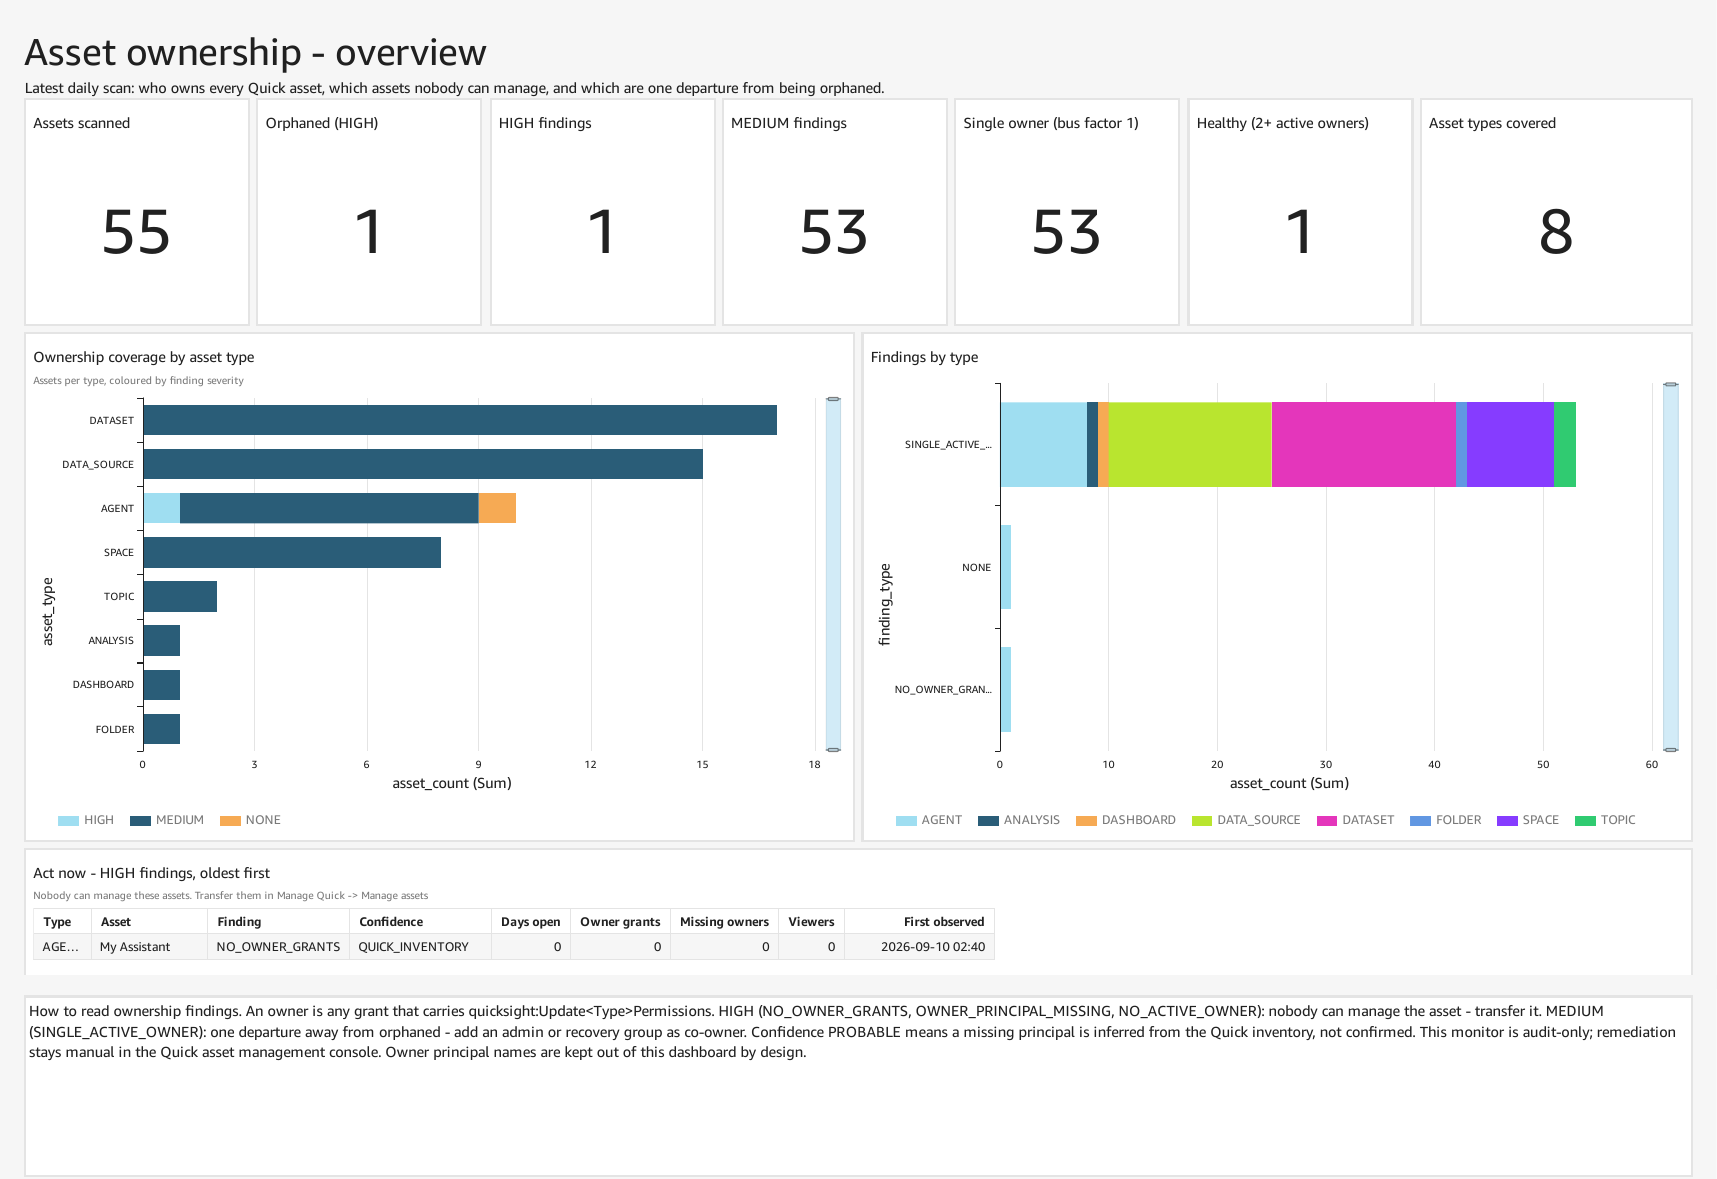
Figura 5 – A aba Overview do dashboard do Orphaned Assets Monitor no Amazon Quick Sight: órfãos, ativos de dono único — a lista a revisar antes de desligamentos — e cobertura por tipo de ativo; nomes de responsáveis ficam fora do painel por design. Dados de demonstração.
O resultado combinado: um acervo curado, explicável e com propriedade clara — exatamente a base de que os agentes do pilar seguinte dependem.
Pilar 5 — Segurança de dados no acesso por agentes: permissões herdadas de ponta a ponta
Este é o pilar que mais gera dúvida em comitês de segurança: “se um agente de IA responde qualquer pergunta sobre os dados, ele não vira um atalho para contornar as permissões?”. No Amazon Quick, a resposta é não — desde que o acesso dos agentes aos dados seja construído pelo caminho governado: Datasets com camada semântica.
O caminho é este: os dados estruturados entram como Datasets, ativos com permissões próprias. Sobre eles, a camada semântica dá significado e estrutura — o Dataset Enrichment descreve o sentido de negócio de cada campo, e os multi-dataset topics definem, uma única vez, os relacionamentos entre Datasets, que o serviço usa para realizar as junções em tempo de execução. Esses ativos são reunidos em Spaces e conectados a Chat Agents personalizados, que respondem perguntas em linguagem natural gerando consultas sobre os Datasets (Dataset Q&A).
O ponto central: o agente não cria um caminho paralelo de acesso ao dado. Cada resposta é gerada no contexto do usuário que pergunta e herda as permissões definidas nos Datasets — incluindo a segurança em nível de linha (RLS) e a segurança em nível de coluna (CLS). Um exemplo concreto: um vendedor pergunta ao agente comercial “quais foram minhas vendas no trimestre?”. Com RLS configurado no Dataset, ele recebe apenas as linhas da sua carteira e região — não os números de toda a força de vendas. O colega de outra regional, fazendo a mesma pergunta ao mesmo agente, recebe o recorte dele; a diretoria comercial, com uma regra mais ampla, enxerga o consolidado. Uma pergunta, três respostas — cada uma limitada ao que aquele usuário já podia ver. Com CLS, colunas restritas (margem, custo, remuneração) simplesmente não ficam disponíveis para quem não tem acesso a elas. E os multi-dataset topics reutilizam as permissões dos Datasets que os compõem: a camada semântica amplia a capacidade de resposta do agente sem ampliar o acesso de ninguém.
A implicação de arquitetura é o que eu levaria a um comitê executivo: a regra de segurança é definida uma vez, na camada de dados, e vale para dashboards, perguntas em linguagem natural, agentes e, desde setembro de 2026, também para os apps construídos no Amazon Quick sobre Datasets, que consultam o dado sob a identidade de quem os abre — em vez de ser reimplementada em instruções de agente, que definem comportamento, não segurança, o que aumenta o risco de inconsistência. Prompt não é controle de acesso. Duas notas de precisão: as regras de RLS valem para quem consome o Dataset — a documentação é explícita: ao compartilhar um Dataset com RLS, os proprietários continuam vendo todos os dados, e os leitores veem apenas o que as regras liberam —, e por isso a propriedade deve ficar restrita aos papéis de dados (o Pilar 3 ajuda a conter a expansão desse grupo); e RLS/CLS são definidos por quem é dono do Dataset — um papel de autor, que no Amazon Quick corresponde à assinatura Enterprise; para quem consome, qualquer assinatura corporativa serve.
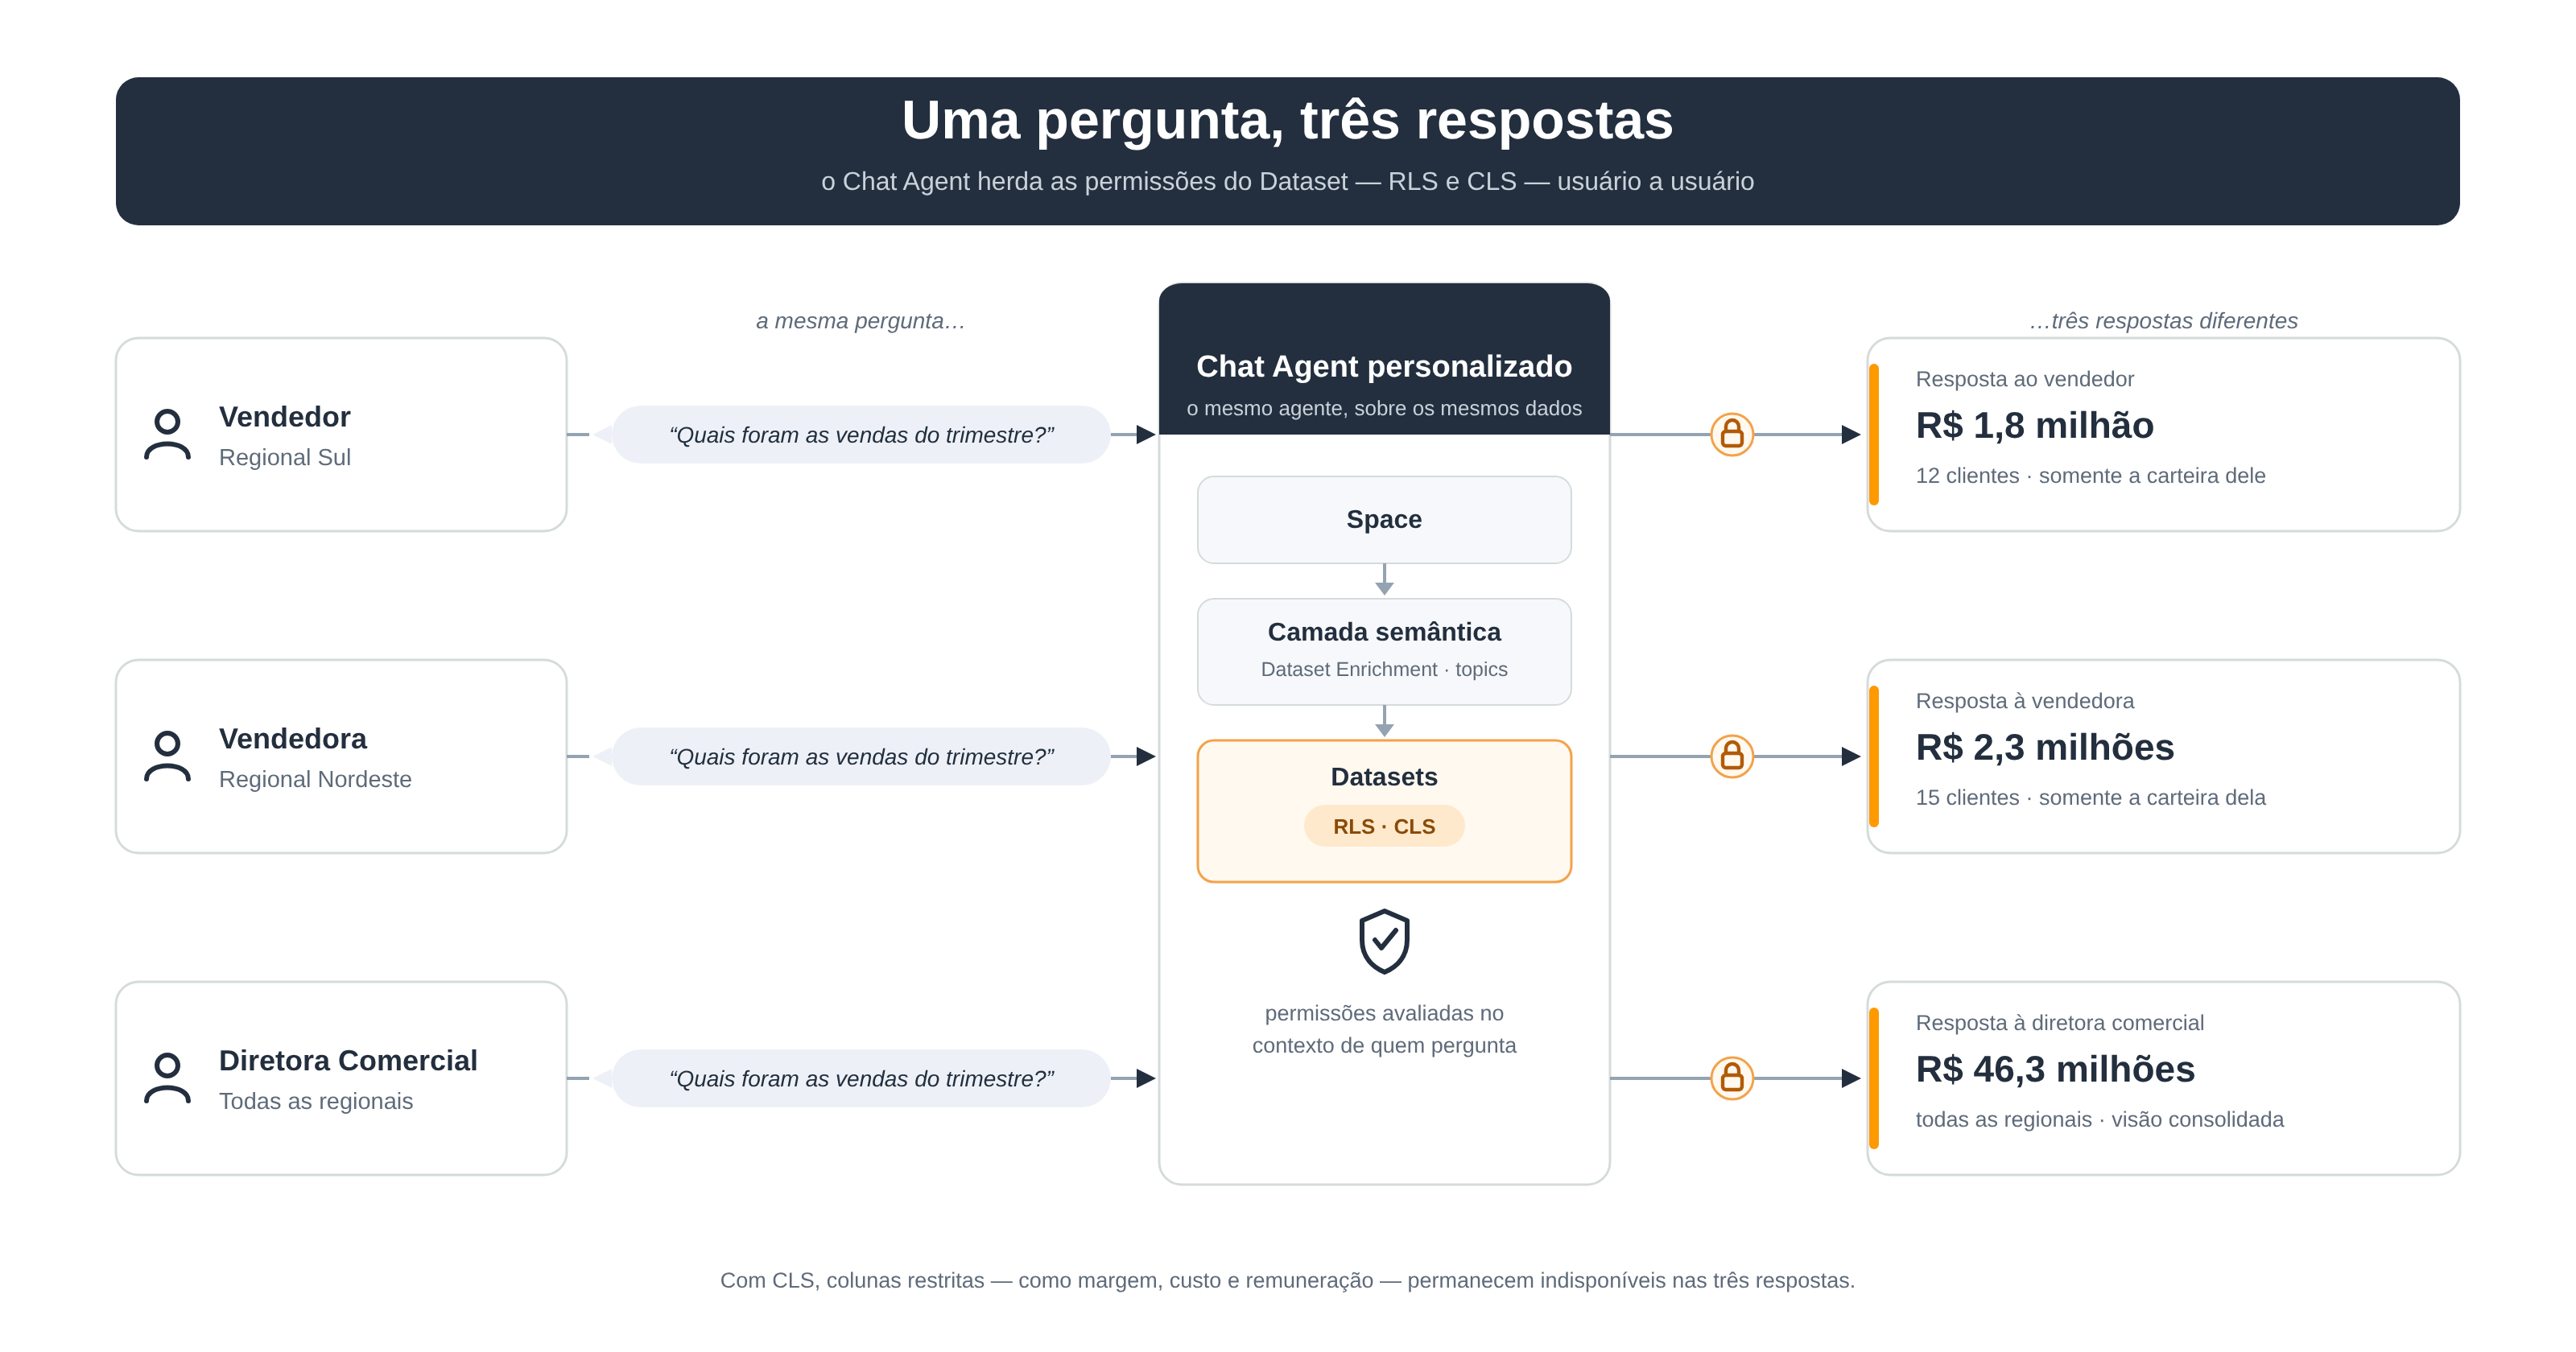
Figura 6 – A mesma pergunta, feita ao mesmo Chat Agent, retorna três respostas diferentes: as regras de RLS do Dataset são avaliadas no contexto de cada usuário, e o CLS mantém colunas restritas fora de qualquer resposta. Valores ilustrativos.
O mesmo princípio — o agente não cria um caminho paralelo — estende-se ao conteúdo não estruturado. Desde agosto de 2026, o Amazon Quick integra-se ao Microsoft Purview para aplicar políticas de prevenção de perda de dados (DLP): organizações que já usam Microsoft 365 reaproveitam os rótulos de sensibilidade existentes no Microsoft Purview — como Confidencial ou Altamente Confidencial — para controlar automaticamente o tratamento de arquivos no chat, em Spaces e em knowledge bases, com ações de bloqueio, aviso ou liberação por rótulo, sem ferramentas adicionais.
Dois detalhes revelam a maturidade do desenho: há uma ação padrão para arquivos sem rótulo ou com rótulos novos, e uma ação específica para indisponibilidade do provedor — que pode ser configurada como fail-closed, bloqueando ingestões enquanto o Microsoft Purview estiver inacessível. A atividade de DLP gera ainda um feed de logs próprio (DLP_LOGS), que se soma ao monitoramento do Pilar 2. Para quem governa dados em um ambiente Microsoft 365, a política de classificação da informação passa a valer dentro do assistente de IA — definida uma vez, aplicada em todos os canais.
O resultado de negócio: um único lugar para definir — e auditar — quem vê o quê, válido para dashboards, perguntas em linguagem natural, agentes e apps. É a resposta que o comitê de segurança precisa ouvir antes do primeiro agente em produção.
Como adotar
O quadro a seguir resume o mapa dos cinco pilares — a pergunta de negócio que cada um responde, o que o Amazon Quick oferece nativamente e o que o repositório de exemplos adiciona.
| Pilar | Pergunta que responde | Nativo do Amazon Quick | Implementação de referência |
|---|---|---|---|
| 1 · Consumo | Quem consome, em quê e com que teto? | Perfis de limite por usuário (agent hours e index storage) | Agent Hours Usage Monitor |
| 2 · Interações | As pessoas usam? Confiam? O que falha? | Feeds de logs CHAT_LOGS e FEEDBACK_LOGS |
Chat and Feedback Monitor |
| 3 · Compartilhamento | Quem pode ampliar o acesso, e como? | Permissões customizadas (com deny by default) e políticas de aprovação | — (capacidade nativa do serviço) |
| 4 · Ciclo de vida dos dados | O acervo está saudável, em uso e com dono? | Eventos do Amazon EventBridge, métricas nativas e console de gestão de ativos | Spreadsheet File Rename · Dataset Lifecycle Monitor · Orphaned Assets Monitor |
| 5 · Segurança no acesso | O agente respeita as permissões de cada usuário? | RLS/CLS herdados pela camada semântica · DLP com Microsoft Purview | — (capacidade nativa do serviço) |
Os cinco pilares formam um modelo operacional simples — e com pré-requisitos modestos de equipe. Os controles nativos — perfis de permissões, políticas de aprovação e perfis de limite — pedem apenas o administrador do Amazon Quick, no console. Os módulos do repositório pedem um engenheiro de nuvem com acesso à conta: são independentes entre si — cada um com seu template, scripts de aplicação e remoção e documentação de pré-requisitos e custos — e o caminho é o mesmo para todos: clonar o repositório, implantar uma vez por região a fundação de analytics (apply-governance-analytics-foundation.sh) e, depois, cada módulo com o próprio script (apply-governance-<módulo>.sh), que publica o módulo e o seu dashboard na conta e nas regiões onde o Amazon Quick opera. Quem opera o conjunto é o time de plataforma ou o centro de excelência em dados, enquanto os times de dados mantêm RLS/CLS e a camada semântica como parte do desenho de cada Dataset.
A fundação compartilhada pelos quatro monitores é o bucket no Amazon S3 em que cada módulo grava, um banco de dados no AWS Glue, um grupo de trabalho do Amazon Athena e a fonte de dados do Amazon Quick — é sobre ela que cada monitor implanta o próprio dashboard no Amazon Quick Sight, sem etapas manuais de console. O custo operacional, em volumes típicos de governança, é da ordem de poucos dólares por mês para o conjunto — entrega de logs e armazenamento no Amazon S3, consultas do Amazon Athena a cada carga de dashboard, o grupo de logs de conversas, alarmes e execuções do AWS Lambda — e cresce com o volume de logs, a frequência de consultas e a retenção; a seção de custos do repositório e o README de cada módulo detalham os componentes.
Uma sequência que recomendo: comece pelos pilares 1 e 5 (consumo sob controle e segurança de dados aplicada desde o primeiro agente, com RLS/CLS configurados nos Datasets), estabeleça o pilar 2 cedo — a entrega de logs não é retroativa — e evolua para os pilares 3 e 4 conforme o volume de criadores e de Datasets cresce.
Para quem está estruturando uma adoção com dezenas de licenças — o ponto em que o piloto vira programa corporativo —, a fundação cabe em quatro decisões, tomadas antes do primeiro agente em produção:
- Licenças e modelo de custo. As assinaturas corporativas vêm em dois níveis por usuário, atribuídos por grupo no provedor de identidade: Professional, para quem consome, pergunta, cria agentes e Spaces; e Enterprise, para quem também cria Datasets, dashboards e automações com o Amazon Quick Automate, aprova e certifica ativos e administra a conta. A governança deste post pede licenças Enterprise em três populações — os donos de dados que definem RLS/CLS, os grupos aprovadores do Pilar 3 e os administradores que mantêm perfis de permissões e de limite —; o restante da organização pode ficar no Professional. É também no Enterprise que existe excedente de agent hours, governado pelos perfis de limite. O orçamento é a soma de licenças, taxa de infraestrutura da conta e excedente previsto, com o monitor do Pilar 1 como fonte da verdade mensal — e vale decidir desde o início se os usuários podem solicitar o próprio upgrade de Professional para Enterprise e se isso exige aprovação do administrador: é uma configuração da conta, e cada upgrade dobra o custo daquela licença — de US$ 20 para US$ 40 por mês, nos valores vigentes — consulte a página de preços do Amazon Quick para os valores e condições atuais.
- Identidade e grupos. Federe os usuários pelo provedor de identidade corporativo e organize grupos que espelhem áreas e papéis: são os grupos que alimentam as regras de RLS, os grupos aprovadores do Pilar 3 e o rateio de consumo por centro de custo. Governança por grupo escala; governança por usuário não.
- Caminho governado para os dados. Dados estruturados entram como Datasets com RLS/CLS e camada semântica desde o primeiro dia — é o que faz o Pilar 5 valer para todo agente criado depois. Uploads pontuais continuam permitidos, mas identificáveis pela convenção de nomes do Pilar 4: liberdade com rótulo.
- Observabilidade e responsáveis desde o dia um. Habilite os feeds de logs em cada região com atividade antes do rollout — não há como recuperar o histórico — e defina os papéis: o time de plataforma responde pelos monitores e pelas políticas; os donos de dados, por RLS/CLS e pela camada semântica; cada criador de agente, pelo que o agente promete fazer.
Repare que nenhuma dessas decisões — e nenhum dos cinco pilares — restringe a criação: os usuários continuam criando agentes, Spaces e análises. O que se governa é o consumo (teto), a distribuição (portão) e o acesso ao dado (herança). Essa separação é o que permite escalar organicamente sem transformar o time central em gargalo. E é ela que sustenta a conversa de retorno: os mesmos monitores que controlam o custo medem a adoção — usuários ativos versus licenças contratadas, horas consumidas versus franquia, perguntas respondidas e avaliações por agente. Um exemplo com os preços da tabela do Pilar 1, vigentes na data desta publicação: 50 licenças Enterprise, a US$ 40 por usuário, custam US$ 2.250 por mês — US$ 2.000 de assinaturas e US$ 250 da taxa da conta; se 20 delas não registram atividade no mês, são US$ 800 pagos sem retorno, e a primeira decisão de retorno sobre o investimento (ROI) não é cortar o programa, é redistribuir licenças para quem vai usá-las. Essa relação entre uso real e custo pago, acompanhada mês a mês, é o que fundamenta a decisão de ampliar, redistribuir ou conter licenças.
Conclusão
Governança de IA sustenta a continuidade da adoção. No Amazon Quick, os mecanismos já existem: feeds de logs gerenciados para consumo e interações, limites de recursos por usuário, permissões customizadas e políticas de aprovação para governar a expansão de acesso, eventos para automatizar convenções, APIs de leitura para observar a frota de dados e, na fundação, permissões de dados que os agentes herdam automaticamente, usuário a usuário. O repositório de exemplos (github.com/aws-samples/sample-quick-ai-governance) transforma esses mecanismos em módulos prontos para implantar. Comece pela visibilidade, garanta a herança de permissões no primeiro agente em produção e expanda os controles no ritmo da sua adoção. Experimente os módulos em uma conta de testes, abra uma issue no repositório com dúvidas e sugestões e compartilhe nos comentários como a sua organização está governando a adoção do Amazon Quick.
Sobre o autor
 |
Victor Shinya lidera a estratégia de adoção de IA e Nuvem para o Agronegócio na AWS Brasil, atuando como Enterprise Solutions Architect junto às maiores empresas do setor no país. Com ampla experiência em Serverless, Modernização de Aplicações e IA Generativa, ajuda times de tecnologia a transformar sistemas complexos em soluções simples, escaláveis e eficientes na nuvem. É presença frequente em palestras e keynotes, orientando executivos do Agronegócio na jornada que vai da adoção da nuvem às estratégias de Dados, IA e Agentes que aceleram resultados de negócio. |