O blog da AWS
Natura reduz custos com Spot e 71% dos incidentes com Karpenter no Amazon EKS
Por Everton Carniato, especialista em Cloud/SRE na Natura; Petros Dimitri Kalligeris, especialista em Cloud/SRE na Natura; Maykon Capuci de Salvi, Gerente de Cloud e SRE responsável pela infraestrutura Cloud do grupo Natura e Breno Costa, Head de Cloud e Platform no grupo Natura.
Otimização em Escala: A Natura aumentou em 168% a economia com Amazon Elastic Compute Cloud (Amazon EC2) Spot Instances e reduziu em 71% os incidentes com Karpenter no Amazon Elastic Kubernetes Service (Amazon EKS).
Fundada em 1969, a Natura é um grupo brasileiro multicanal e multimarcas de cosméticos, líder na América Latina, com operações em 8 países. A companhia conta com cerca de 14 mil colaboradores e uma rede de mais de 2,8 milhões de consultoras e consultores de beleza Natura e Avon, além de uma ampla base de fornecedores e parceiros estratégicos.
1. Contexto e motivação: uma jornada de evolução arquitetural
A trajetória da Natura com Kubernetes pode ser dividida em fases distintas, cada uma marcada por avanços significativos, e pelos desafios que esses avanços inevitavelmente trouxeram.
A jornada de adoção de contêineres na companhia começou em 2016 com o Kubernetes, visando garantir o empacotamento e o isolamento de aplicações. No entanto, a sustentação de um ambiente distribuído dessa magnitude trouxe desafios operacionais severos.
Nos primeiros anos de adoção do Kubernetes, a Natura utilizava a ferramenta kOps para gerenciar a infraestrutura, o que exigia a administração direta dos control planes. A natureza estática e complexa desses componentes exigia dedicação de especialistas para alta disponibilidade e mitigação de falhas. Ainda assim, foram registradas 106 horas de indisponibilidade entre 2018 e 2019.
Com um salto de 80% na quantidade de microsserviços impulsionado pela expansão global e digitalização, a empresa migrou para o Amazon EKS, transferindo a responsabilidade do control plane para a AWS. Contudo, a camada de data plane nodes ainda dependia do Cluster Autoscaler (CAS). O CAS possui uma arquitetura baseada em Amazon EC2 Auto Scaling groups (ASGs), o que torna o provisionamento lento e força a criação de múltiplos ASGs para lidar com diversidade arquitetural das instâncias (como Spot, ARM ou GPU).
Era observada uma ineficiência no escalonamento, com provisionamento excessivo preventivo e lentidão na resposta a picos de tráfego em um ambiente de grande magnitude como o da Natura, que atualmente possui 8 clusters EKS em produção, com mais de 300 nodes provisionados e mais de 800 microsserviços em execução.
2. Arquitetura e componentes: fundação para alta disponibilidade
A solução encontrada foi o projeto open-source Karpenter, uma solução flexível de autoscaling com alto desempenho que observa os pods que estão no status de pendente por falta de recursos e automaticamente provisiona um novo node com a capacidade necessária através da seleção da melhor instância para aquele momento. Como o Karpenter não trabalha com o conceito de node groups, a Natura não ficava restrita a determinados tipos de instâncias e diminuía a necessidade de gerenciamento. O Karpenter avalia todos os recursos e seus requisitos de forma contínua e utiliza diretamente a API da Amazon EC2 Fleet de forma síncrona para recuperar rapidamente a lista de instâncias Amazon EC2 disponíveis e, com isso, entregar menos tempo de provisionamento.
A arquitetura do Karpenter na Natura foi projetada sob diretrizes estritas de alta disponibilidade e isolamento. As premissas arquiteturais incluem:
Alta disponibilidade e Gestão Contínua com Argo CD: Para implementar alta resiliência, a Natura executa dois pods do Karpenter em paralelo, em Zonas de Disponibilidade (AZs) distintas, por cluster. Todo o ciclo de vida do controlador é gerenciado ativamente pelo Argo CD, que define que o Karpenter seja mantido atualizado e em estrita sincronia com a infraestrutura como código (IaC, do original Infrastructure as Code) versionada no repositório do GitHub. Isso possibilita o estado desejado, a alta disponibilidade contínua e previne desvios de configuração.
Isolamento do controlador: Através de regras de Anti-Affinity, cada pod roda em um node distinto. Regras de Node Affinity e Tolerations forçam o Karpenter a rodar exclusivamente em um EKS Managed Node Group On-Demand gerenciado pela própria AWS.
Gestão via CRDs: A operação do Karpenter é orquestrada por três Custom Resource Definitions (CRDs) nativos, cada um com responsabilidade bem definida:
- NodePool: regras de negócio, limites de capacidade e tipos de instâncias permitidas
- NodeClass: configurações da AWS, como AMIs, Subnets e Security Groups
- NodeClaim: a solicitação efetiva da instância à AWS, criada automaticamente pelo controlador
Fundação em Infraestrutura como Código (Terraform): Enquanto o Argo CD e o Helm gerenciam o ciclo de vida dos manifestos Kubernetes do Karpenter (NodePool, NodeClass e NodeClaim), toda a camada de recursos nativos da AWS que sustenta essa operação é provisionada por um módulo Terraform dedicado. Essa separação de responsabilidades (Terraform para os recursos de AWS e Helm/Argo CD para os recursos de Kubernetes) permite que cada camada evolua de forma independente, mantendo rastreabilidade e controle de mudanças em ambas as pontas.
Os principais recursos provisionados pelo módulo Terraform incluem:
- Identidade e permissões (AWS Identity and Access Management (IAM) Roles for Service Accounts – IRSA): criadas duas IAM Roles distintas:
- IAM Role do controlador Karpenter: utiliza uma trust policy federada com o provedor OpenID Connect (OIDC) do cluster Amazon EKS, restrita ao Service Account karpenter:karpenter. Essa role concede ao controlador as permissões necessárias para provisionar e gerenciar instâncias EC2.
- IAM Role dos nodes (KarpenterNodeRole-<cluster>): associada às instâncias EC2 provisionadas pelo Karpenter, com políticas gerenciadas para serviços como Amazon Elastic Block Store (Amazon EBS), EC2 Auto Scaling, AWS Load Balancer Controller, ExternalDNS, Amazon VPC CNI e AWS Systems Manager.
A conexão entre as duas camadas de IaC (Terraform e Helm) acontece por meio do campo role no recurso EC2NodeClass: ele referencia o nome da IAM Role dos nodes criada pelo Terraform, definindo que as instâncias provisionadas pelo Karpenter assumam automaticamente as permissões corretas.
- Fila de Interrupção: uma fila Amazon Simple Queue Service (Amazon SQS) dedicada, associada a regras do Amazon EventBridge que capturam eventos de Spot Interruption Warning, Rebalance Recommendation, Instance State-change e AWS Health Event. É esse canal que permite ao Karpenter antecipar desligamentos abruptos de instâncias Spot e disparar a drenagem dos pods descrita na seção 3, antes que elas sejam interrompidas pelo Amazon EC2.
- Managed Node Group dedicado: o Managed Node Group On-Demand dedicado exclusivamente ao controlador (com taint próprio de isolamento).
- Saídas Consumidas pelo Helm: os ARNs das IAM roles e da fila de interrupção são expostos como outputs do módulo e injetados diretamente no values.yaml do Helm chart do Karpenter, fechando o elo entre o provisionamento em Terraform e a configuração aplicada pelo Argo CD.
Por ser parametrizado – nome do cluster, subnets, tags, entre outros – o módulo é reutilizado de forma padronizada em todos os clusters EKS da Natura, definindo que a base de permissões e a infraestrutura de suporte do Karpenter sejam consistentes, auditáveis e replicáveis a cada novo ambiente.
Diagrama de arquitetura da solução
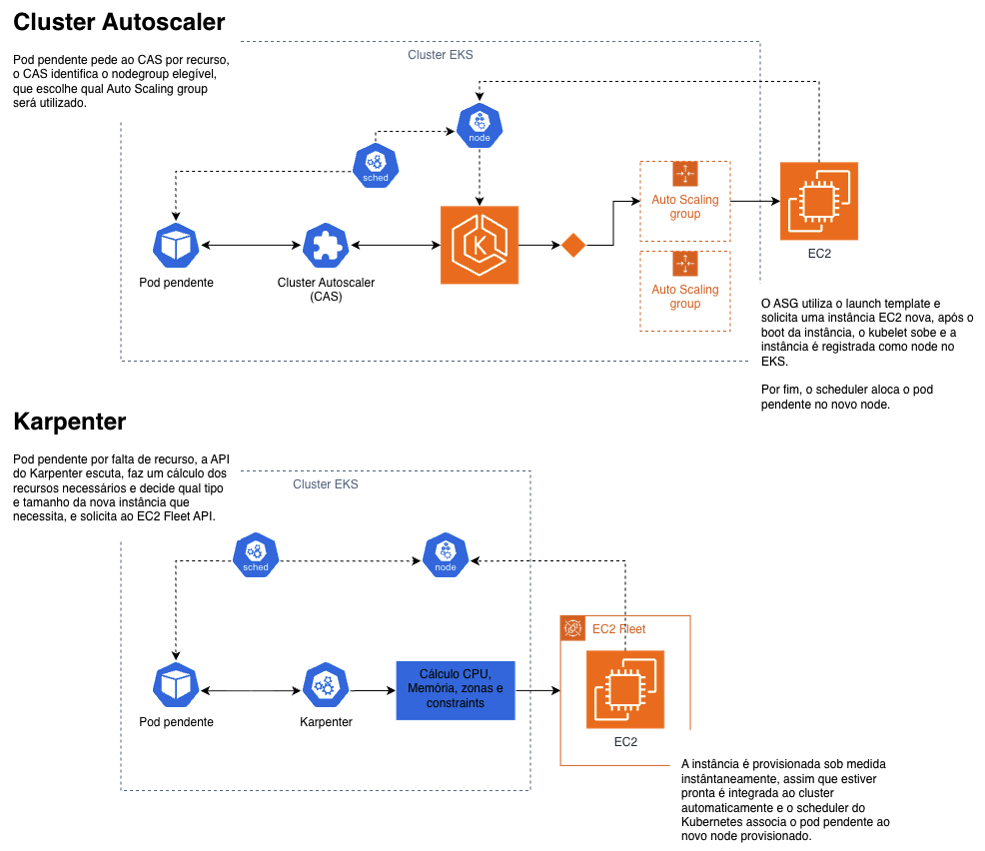
Comparação do fluxo de provisionamento: Cluster Autoscaler (CAS) vs. Karpenter no Amazon EKS
3. Implementação prática: resolvendo desafios reais
A gestão do Karpenter nos clusters é feita pela manipulação de arquivos values.yaml, definindo a interação entre os componentes da AWS e do Kubernetes.
Seleção dinâmica de instâncias: No Karpenter, os requisitos do NodeClaim são derivados diretamente do NodeClaimTemplate no NodePool. Eles são avaliados uma única vez por NodeClaim no momento da criação, o que significa que a seleção é baseada exclusivamente no que o template permite. Como resultado, NodeClaims criados para o mesmo NodePool estático podem resultar no lançamento de diferentes tipos de instância, dependendo da disponibilidade de instâncias, desde que esses tipos de instância sejam compatíveis com os requisitos do NodePool. Na Natura, em vez de restringir o cluster a instâncias rígidas, a configuração dos NodePools utiliza operadores lógicos (como In, Lt – Less Than, e Gt – Greater Than). Com isso, a equipe especifica requisitos amplos (ex: instâncias da família R ou T, com menos de 17 vCPUs e mais de 8GB de RAM), de modo que o Karpenter avalie em tempo real e escolha a opção mais viável e econômica disponível na AWS no momento do provisionamento.
nodepools:
  - name: default-spot
    nodeClassRef: default
    capacityType:
      operator: In
      values:
      - spot
    instanceCpu:
      operator: Lt
      values:
      - "17"
    instanceMemory:
      operator: Gt
      values:
      - "8000"
    instanceCategory:
      operator: In
      values:
      - r
      - t
    instanceGeneration:
      operator: Gt
      values:
      - "5"
    instanceSize:
      operator: NotIn
      values:
      - nano
      - micro
      - xlarge
    weight: 10

 ec2nodeclasses:
  - name: default
    role: $KARPENTER_NODE_ROLE_NAME
    subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: "$DISCOVERY_TAG"
    securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: "$DISCOVERY_TAG"
    tags:
      Environment: $ENV
      Name: $NODECLASS_NAME
Distribuição topológica e balanceamento de AZs: No início da implementação, a equipe encontrou um desafio comportamental do Karpenter. Como ele busca otimizar custos, o controlador, em um determinado momento, subiu todos os novos nodes na mesma AZ, por serem as máquinas mais baratas e abundantes no exato momento da requisição. Em ambientes menores, isso gerou o esgotamento de IPs disponíveis na faixa daquela sub-rede específica e um ambiente topologicamente desbalanceado.
Para solucionar esse comportamento, a Natura configurou a funcionalidade de Topology Spread Constraints nos deployments das aplicações. Essa configuração faz com que o Karpenter favoreça o provisionamento de máquinas e a distribuição dos pods de forma mais uniforme e balanceada entre as diferentes AZs:
topologySpreadConstraints:
  - maxSkew: 1
    topologyKey: kubernetes.io/zone # Força o balanceamento entre as Zonas de Disponibilidade
    whenUnsatisfiable: ScheduleAnyway
    labelSelector:
      matchLabels:
        app: nome-da-sua-aplicacao
Auto-recuperação de nodes (Node Repair): Para aumentar a resiliência do cluster sem intervenção humana, a equipe habilitou a configuração featureGate: NodeRepair no arquivo YAML do Karpenter. Essa funcionalidade permite que o Karpenter atue de forma autônoma na detecção e resolução de problemas estruturais, reciclando nodes que eventualmente venham a travar ou que fiquem presos no status de NotReady, eliminando a necessidade de intervenção manual em madrugadas e finais de semana.
Isolamento de workloads (Taints e Tolerations): Para proteger aplicações críticas ou separar aplicações ferramentais da própria equipe, a Natura aplica um modelo de “fechadura e chave”. O Karpenter configura um Taint (role=tools:NoSchedule) no NodePool, atuando como a fechadura que impede o agendamento de pods comuns naquelas máquinas. Apenas os manifestos que possuem a Toleration correspondente e o NodeSelector conseguem acessar essa infraestrutura dedicada.
Preparação para desligamentos abruptos e Graceful Shutdown: Durante o processo de de-provisioning (Consolidação ou Drift), quando o Karpenter decide remover um node para economizar custos, ele emite ativamente um comando de drain no Kubernetes. É neste momento exato que as rotinas de Graceful Shutdown e a utilização correta do preStop hook evitam que a aplicação sofra indisponibilidade, permitindo que os pods finalizem o processamento de requisições pendentes de forma segura antes da remoção do node. Essa configuração introduz um tempo de espera estratégico de 180 segundos, atrasando o envio do sinal de terminação (SIGTERM) obtendo uma interrupção suave das conexões:
lifecycle:
          preStop:
            exec:
              command:
                - /bin/sh
                - -c
                - sleep 180
Preparação para interrupções de instâncias Spot: A fila SQS integrada ao Amazon EventBridge desempenha um papel fundamental nesse fluxo: ao capturar eventos de Spot Interruption Warning com até 2 minutos de antecedência, o Karpenter consegue provisionar um node substituto e iniciar a drenagem do node em interrupção antes que a instância seja efetivamente interrompida pelo Amazon EC2, tornando as interrupções de instâncias Spot praticamente transparentes para as aplicações.
Automação de liga/desliga em ambientes não produtivos: Para elevar a eficiência de custos fora do horário comercial em ambientes de desenvolvimento e homologação, a equipe criou uma ferramenta própria para agendar o ligar e desligar (start/stop) dos clusters. A automação atua diretamente no Karpenter: no horário programado para o desligamento, a ferramenta injeta um trecho de configuração na spec de cada NodePool existente no cluster, limitando o uso de CPU daquele pool a 0. Ao identificar que o limite de CPU foi zerado, o Karpenter é forçado a realizar o desprovisionamento de todas as máquinas em execução.
Além disso, a automação realiza a drenagem (drain) dos nodes e força o scale-down de workloads que possuem Pod Disruption Budgets (PDB). PDB é um recurso nativo do Kubernetes que define o número mínimo de réplicas de um Pod que devem permanecer disponíveis durante interrupções voluntárias, como drains de nodes, upgrades ou, neste caso, o desligamento programado do cluster. Em operações normais, o Kubernetes respeita o PDB e impede a remoção de Pods que violariam esse limite mínimo, garantindo a disponibilidade da aplicação. No contexto dessa automação, como o objetivo é esvaziar completamente o cluster, a ferramenta força o scale-down dos workloads protegidos por PDB (por exemplo, escalando os Deployments para zero réplicas), o que possibilita que a drenagem dos nodes prossiga sem bloqueios. Dessa forma, o cluster é esvaziado automaticamente, poupando custos até o agendamento de religamento:
spec:
  limits:
    cpu: "0"
4. Resultados e aprendizados: impacto mensurável em escala
A implementação do Karpenter resultou em:
Velocidade de escalonamento: A melhoria mais imediata e visível foi na velocidade de provisionamento de novos nodes. Com redução para 40 a 60 segundos (70% menor quando comparado ao CAS).
Redução de custos e adoção Spot: Graças à velocidade de resposta do Karpenter, a Natura migrou praticamente todos os workloads de negócio para instâncias EC2 Spot – mantendo apenas o controlador do Karpenter em instâncias On-Demand. O resultado foi um aumento de 168% na economia com Spot em relação ao cenário anterior.
Disponibilidade em picos (Black Friday): Ao remover a limitação rígida de famílias e tipos de instâncias pré-definidos, foi destravada uma ampla disponibilidade de capacidade Spot na AWS. Com a flexibilidade configurada nos NodePools, o Karpenter passou a selecionar automaticamente entre múltiplos tipos de instância, o que permite à Natura escalar e sustentar o ambiente mesmo em momentos de altíssima demanda, como a Black Friday e outras datas promocionais críticas.
Eficiência operacional: A simplificação operacional reduziu o esforço de manutenção, por três motivos principais:
- Redução de incidentes: O NodeRepair automatizou o tratamento de nodes NotReady e reduziu os alertas de ~190 para 55 incidentes por mês (queda de 71%), diminuindo a necessidade de intervenção manual, especialmente em madrugadas e finais de semana.
- Upgrades de versão do Amazon EKS: com o CAS, os upgrades eram realizados em três janelas de três horas cada, separando os clusters em cada janela. Com o Karpenter, toda a manutenção em todos os clusters é feita em apenas uma janela de duas a três horas, uma redução de aproximadamente 78% no tempo total de manutenção.
- Atualização automática de AMIs: a utilização do atributo – alias: al2023@latest, em ambientes não produtivos, para o AMI Selector na configuração do Karpenter automatizou completamente o processo de upgrade de Amazon Machine Images (AMI). O que antes levava de 2 a 3 horas de trabalho manual agora acontece de forma gradual e automática assim que uma nova AMI é lançada pela AWS.
5. Próximos passos: a jornada continua
Com a fundação tecnológica estabelecida e operando de forma estável sob o regime massivo de instâncias Spot, o foco da engenharia da Natura se volta agora para o ajuste fino contínuo da camada aplicacional, focando para que a totalidade do ecossistema de microsserviços esteja adaptado ao alto dinamismo do Karpenter.
A equipe identificou três frentes prioritárias para a próxima fase de evolução do ambiente:
- Expansão das políticas de graceful shutdown: Embora as aplicações críticas já estejam preparadas para lidar com os desligamentos dinâmicos, o próximo passo é adequar as demais aplicações que precisam de uma tolerância maior para finalizar seus processamentos de forma segura, sem quebrar ou perder requisições em andamento durante o encerramento do Pod.
- Democratização e aprimoramento do Pod Disruption Budget (PDB): A configuração do PDB é essencial para indicar ao Karpenter quantos pods de uma aplicação podem ficar indisponíveis simultaneamente durante as consolidações de nodes. Até o momento, o ajuste fino do PDB foi implementado estrategicamente apenas nos microsserviços mais críticos do ambiente. O desafio futuro é revisar e melhorar essa configuração para todas as demais aplicações, para que o Karpenter consiga atuar livremente na redução de custos sem nunca ferir a disponibilidade mínima exigida por serviços secundários.
- Sintonia fina do Horizontal Pod Autoscaler (HPA): Continuar a calibração contínua do HPA em todos os projetos, para que os gatilhos de escalonamento horizontal de pods das aplicações acompanhem a velocidade e a elasticidade que a infraestrutura da AWS é capaz de fornecer.
6. Conclusão
A jornada da Natura com o Karpenter é um exemplo concreto de como a evolução arquitetural orientada a resultados pode transformar não apenas a eficiência operacional, mas também a capacidade de inovação de uma empresa. Partindo de um cenário com problemas de indisponibilidade em 2018-2019, passando pela migração para o Amazon EKS e chegando a um ambiente onde cerca de 97% dos workloads de negócio em produção e 100% dos ambientes não produtivos rodam em instâncias Spot, com provisionamento em menos de 60 segundos, a Natura construiu uma infraestrutura que combina resiliência, eficiência de custos e agilidade operacional em escala real.
A abordagem adotada (com isolamento rigoroso do controlador, separação clara de responsabilidades entre Terraform e Helm/Argo CD, e seleção dinâmica de instâncias via operadores lógicos) resultou em uma arquitetura replicável, auditável e padronizada em todos os oito clusters EKS da empresa. Os números falam por si: aumento de 168% na economia com instâncias Spot, 71% de redução em incidentes operacionais e 78% menos tempo em janelas de manutenção são evidências de que a fundação tecnológica está sólida para sustentar o próximo ciclo de crescimento da Natura.
Aqui alguns recursos adicionais sobre esse tópico:
- Otimizando seus custos de computação em Kubernetes com a consolidação do Karpenter
- Documentação do Karpenter
Sobre os autores
 |
Everton Carniato Firmino de Oliveira é especialista em Cloud/SRE na Natura, formado em Engenharia de Software, atua há 8 anos na área de tecnologia da informação, sendo 6 anos na área de infraestrutura Cloud, está sempre em busca de melhorar os processos e aplicar boas práticas no mundo da tecnologia. |
 |
Petros Dimitri Kalligeris é especialista em Cloud/SRE na Natura, formado em Engenharia da Computação pela FIAP. |
 |
Maykon Capuci de Salvi é Gerente de Cloud e SRE responsável pela infraestrutura Cloud do grupo Natura, tem vasta experiência na área de tecnologia, formado em Engenharia da computação, e com MBA em Cloud Computing pela FIAP, aliando estratégia a inovação para garantir uma infraestrutura altamente disponível e de alta performance. |
 |
Breno Costa é Head de Cloud e Platform no grupo Natura, formado em Redes de computadores e Sistemas da Informação, com MBA em Gestão de Pessoas e em Gestão Empresarial pela FGV, com mais de 20 anos de experiência, atuando em ambientes corporativos de grande porte e liderando projetos de TI com excelência e foco na experiência do cliente, na inovação e na melhoria contínua. |
 |
Carlos Guarany é Sr Enterprise Solutions Architect na AWS, com mais de 25 anos de experiência em TI. Nos últimos anos, trabalhou atuando para ajudar clientes a alcançarem seus objetivos de negócio por meio de soluções em nuvem, jornadas de transformação, iniciativas de migração para nuvem e no design de arquiteturas resilientes e escaláveis. |