亚马逊AWS官方博客
Amazon Aurora PostgreSQL 现在支持直接查询数据湖中的 Apache Iceberg 和 Parquet 数据
今天,我们宣布推出 Amazon Aurora PostgreSQL 的一项新功能,您可以使用现有的 PostgreSQL 应用程序和工具,直接查询运营数据,以及以 Apache Iceberg 和 Apache Parquet 格式存储在数据湖中的数据。由于无需从数据湖中提取、转换、加载(ETL)结构化数据到运营数据库,您可以降低操作复杂性并简化应用程序开发。您还可以使用 Aurora PostgreSQL 查询在兼容 Iceberg REST Catalog(IRC)的目录中管理的数据湖中的数据,从而无需移动或复制即可访问各种分析系统的数据。无论您是为实时控制面板提供支持,利用历史上下文丰富交易,还是构建智能体来推理实时和归档数据,您现在都可以通过一个熟悉的界面完成所有工作。
以前,如果您的应用程序需要将 Aurora 中的最新交易数据与 Amazon S3 中存储的历史记录相结合,常见的方法是构建反向 ETL 管线,但这会复制数据,增加基础设施成本,并且需要持续的工程工作才能保持一切同步。随着您越来越多地将智能体嵌入到应用程序中,这一挑战只会愈发严峻,因为要预测并预先复制智能体可能需要的每一个数据集是不现实的。
维护 DuckDB 项目的团队 DuckLabs 最近加入了 Amazon,而这项功能正是 DuckDB 的高效性如何被集成到我们服务中的一个示例。DuckDB 现在直接嵌入到 Aurora PostgreSQL 中,因此您可以在单个查询中,同时查询实时运营数据(包括未提交的写入)和数据湖中的数据。查询处理保留在 Aurora 内,没有额外的网络跃点数,也没有复制数据的 ETL 管线。您可以查询通过 AWS Glue Data Catalog 管理的 Apache Iceberg 表,以及存储在 Amazon S3 和 S3 表类数据存储服务中的 Parquet 和 Iceberg 数据。所有这些操作都是使用熟悉的 PostgreSQL 语法以及现有的应用程序和工具完成的。
我们很高兴能将 DuckDB 的速度和简单性直接引入 Aurora PostgreSQL,这样您和您的智能体就可以使用熟悉的 PostgreSQL 应用程序、工具和已在使用的端点,来查询和合并运营数据和 Iceberg 数据。通过围绕 DuckDB 构建此功能,未来对开源引擎的改进可以继续为 Aurora 和其他 AWS 服务带来性能和功能提升。
新增功能
两个 Aurora PostgreSQL 主要版本支持此功能:17(从 17.11 开始)和 18(从 18.6 开始)。要使用此功能,您需要创建一个 Aurora PostgreSQL 集群,使用 AuroraAnalytics 功能附加 IAM 角色,然后启用 aurora_analytics 扩展。IAM 角色让 Aurora 可以访问您在 Amazon S3 和 AWS Glue Data Catalog 中的数据。然后,您可以创建指向数据湖中的 Iceberg 或 Parquet 数据的外部表,并使用熟悉的 PostgreSQL 语法对这些表进行查询。您可以通过 Amazon RDS 控制台或任何 PostgreSQL 客户端(例如 psql)完成此设置。Aurora PostgreSQL 文档详细记录了这个过程。
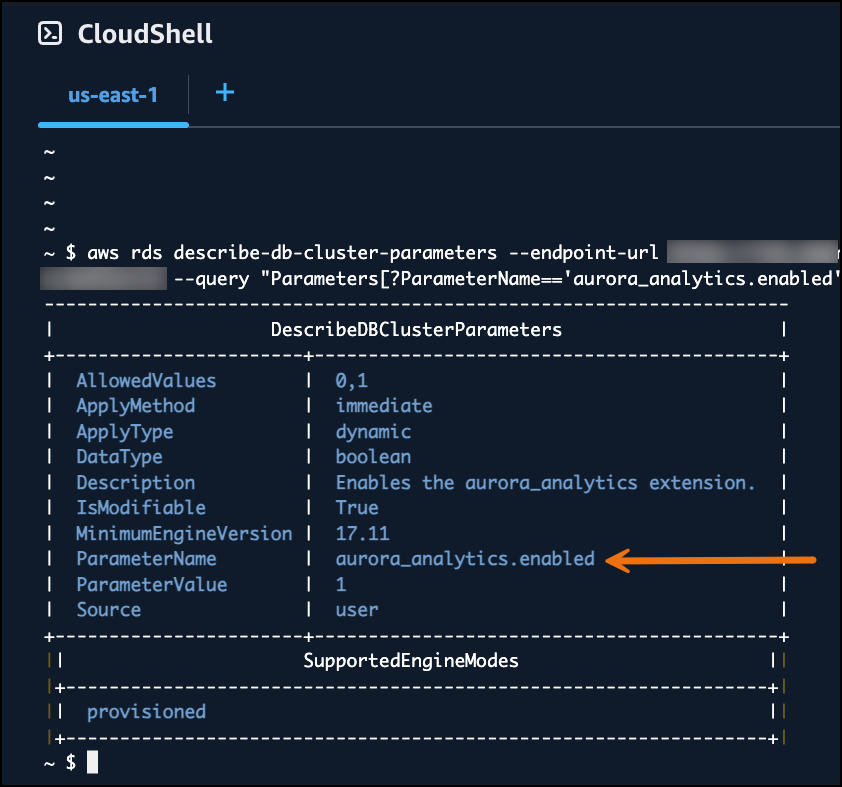
您可以通过 AWS Glue Data Catalog 联合身份验证在兼容 IRC 的外部目录中查询数据。只需在 Glue 中注册一次外部目录,然后为要查询的表创建外部表,就像创建任何 Glue 原生表一样。然后,单个查询即可将存储在 Aurora 中的数据与在多个目录中注册的 Iceberg 表连接起来,因此应用程序无需移动数据或替换现有目录投资即可获得统一视图。
Aurora 还应用了诸如谓词下推和列修剪之类的优化,因此仅读取相关数据。即使基础数据增长,这也能保持查询的效率。经常访问的数据也会缓存在您的 Aurora 实例中,因此针对相同数据的后续查询返回速度更快。您可以使用 aurora_analytics_stat_statements() 检查每个查询的这种行为,检查会报告扫描的行数、从 Amazon S3 读取的字节数和缓存命中率等指标。
为了了解直接查询的工作原理,我使用 psql 连接到我的 Aurora PostgreSQL 数据库并创建了扩展:
CREATE EXTENSION aurora_analytics;在我的演练中,我设置了一个简单的财务场景。我在 Aurora 中有一个包含最近 7 天客户交易的 recent_transactions 表,在 Amazon S3 中有一个包含 5 年历史交易数据的 Parquet 文件。为了让 Aurora 知道历史数据,我在 S3 中创建了一个指向 Parquet 文件的外部表:
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
    location 's3://<my-bucket>/finance/transaction_history.parquet',
    format 'parquet'
);
请注意 CREATE FOREIGN TABLE 语句中的空括号。Aurora 会自动从 Parquet 文件元数据中读取架构,因此您无需手动定义列。对于包含多个表的工作负载,您可以跳过一次创建一个表:一个 IMPORT FOREIGN SCHEMA 语句会为 AWS Glue Data Catalog 数据库中的每个 Iceberg 或 Parquet 表批量创建外部表,自动推理架构。
两个表都准备就绪后,我运行了一个查询,将 Aurora 中的最新运营数据与 S3 中的历史数据相结合:
SELECT merchant, category, amount, transaction_date, 'recent' AS source
FROM recent_transactions
WHERE customer_id = 'C-1001'
UNION ALL
SELECT merchant, category, amount, transaction_date, 'historical' AS source
FROM transaction_history
WHERE customer_id = 'C-1001'
  AND transaction_date >= CURRENT_DATE - INTERVAL '5 years'
ORDER BY transaction_date DESC
LIMIT 15;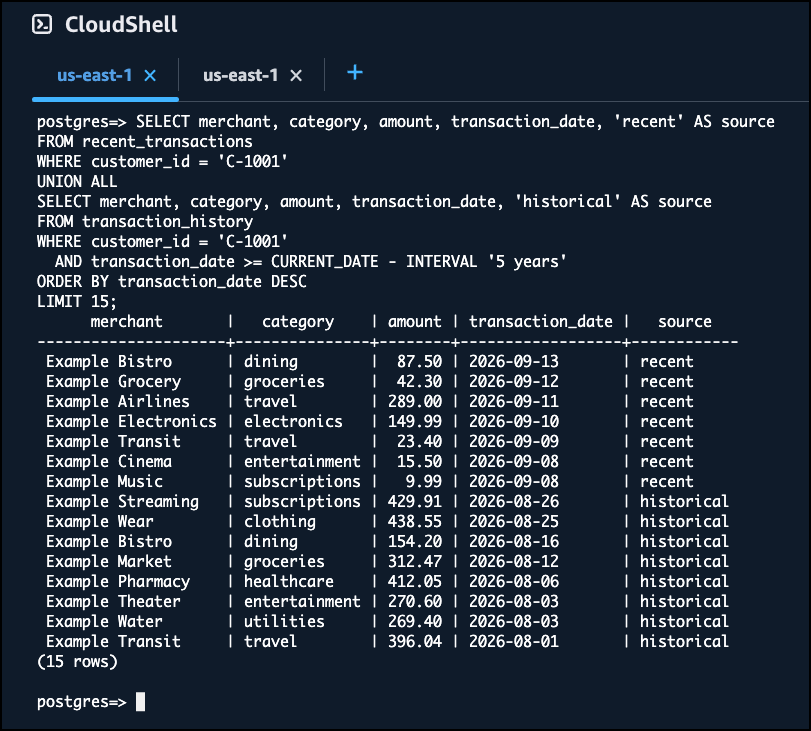
结果在单个结果集中显示近期和历史交易。最近的 7 行来自 Aurora,其余的直接来自 S3 中的 Parquet 文件。DuckDB 在底层处理 Parquet 数据的分析扫描,而 Aurora 负责处理运营数据。以前,这个单一查询需要一个管线首先将历史数据移入数据库。
如果查询模式需要毫秒级的延迟,您可以使用熟悉的命令(例如 CREATE TABLE AS SELECT、INSERT INTO ...SELECT 或 MERGE INTO),将数据湖中的数据实体化到原生 Aurora PostgreSQL 表中。实体化表存在于 Aurora 中,其查询方式与任何其他 PostgreSQL 表一样,无需运行单独的摄取管线,即可为热数据提供低延迟路径。读取查询可以在集群中的任何 Aurora PostgreSQL 实例上运行,无论是写入器还是只读副本,因此您可以从运营工作负载中卸下分析扫描的负载。实体化命令将数据写入 Aurora,因此在写入器实例上运行。
立即开始使用
现在,对来自 Amazon Aurora PostgreSQL 的 Apache Iceberg 和 Parquet 数据的直接查询,已在所有商业 AWS 区域和 AWS GovCloud(美国)区域推出,无需额外付费。您只需为查询消耗的增量 Aurora 计算费用和读取数据湖文件的 Amazon S3 请求费用付费。
要了解更多信息,请访问 Amazon Aurora 功能页面,阅读 Aurora PostgreSQL 文档,或在 Amazon RDS 控制台中试用。欢迎通过 AWS re:Post 或您常用的 AWS Support 联系人提供反馈。