Amazon Web Services ブログ
Amazon Aurora PostgreSQL がデータレイク上の Apache Iceberg と Parquet データへの直接クエリをサポート
本記事は 2026 年 9 月 30 日 に公開された「Amazon Aurora PostgreSQL now supports direct querying of Apache Iceberg and Parquet data in your data lake」を翻訳したものです。
本日、Amazon Aurora PostgreSQL の新機能を発表します。既存の PostgreSQL アプリケーションやツールを使って、運用データと、データレイクに Apache Iceberg および Apache Parquet 形式で保存されたデータを組み合わせて直接クエリできるようになりました。データレイクの構造化データを運用データベースに ETL (抽出、変換、ロード) する必要がなくなるため、運用の複雑さを軽減し、アプリケーション開発をシンプルにできます。また、Iceberg REST Catalog (IRC) 互換カタログで管理されているデータレイクのデータも Aurora PostgreSQL からクエリでき、データを移動したり複製したりすることなく、幅広い分析システムのデータにアクセスできます。リアルタイムダッシュボードの提供、過去の履歴情報によるトランザクションデータの補完、ライブデータとアーカイブデータの両方をもとに推論する AI エージェントの構築など、いずれも 1 つの使い慣れたインターフェースから実現できます。
従来、Aurora 上の最新のトランザクションデータと Amazon S3 に保存された過去のレコードをアプリケーションで組み合わせるには、リバース ETL パイプラインを構築するのが一般的でした。リバース ETL パイプラインではデータが重複し、インフラストラクチャコストが増え、すべてを同期させ続けるための継続的なエンジニアリング作業が必要でした。アプリケーションに AI エージェントを組み込む場面が増えるほど、エージェントが必要とする可能性のあるデータセットをすべて事前に予測して複製しておくことは現実的でなくなり、課題はさらに大きくなります。
DuckDB プロジェクトをメンテナンスする DuckLabs のチームが最近 Amazon に加わりました。今回の機能は、DuckDB の効率性を AWS のサービスに統合していく取り組みの一例です。DuckDB が Aurora PostgreSQL に直接組み込まれたことで、ライブの運用データ (コミットされていない書き込みを含む) とデータレイクのデータを 1 つのクエリで横断的にクエリできます。クエリ処理は Aurora 内で完結し、追加のネットワークホップも、データを複製する ETL パイプラインも不要です。AWS Glue Data Catalog で管理されている Apache Iceberg テーブルに加えて、Amazon S3 や S3 Tables に保存されている Parquet および Iceberg データをクエリできます。これらはすべて、使い慣れた PostgreSQL 構文と既存のアプリケーション、ツールで実行できます。
DuckDB の速さとシンプルさを Aurora PostgreSQL に直接取り込むことで、お客様もお客様のエージェントも、既に利用している PostgreSQL アプリケーション、ツール、エンドポイントから運用データと Iceberg データを組み合わせてクエリできます。今回の機能を DuckDB を軸に構築したことで、オープンソースエンジン側の今後の改善が、Aurora やその他の AWS サービスのパフォーマンスと機能の向上に引き続きつながります。
新機能
今回の機能は、Aurora PostgreSQL の 2 つのメジャーバージョン、17 (17.11 以降) と 18 (18.6 以降) でサポートされています。使用するには、Aurora PostgreSQL クラスターを作成し、AuroraAnalytics 機能用の IAM ロールをアタッチして、aurora_analytics 拡張機能を有効にします。この IAM ロールによって、Aurora が Amazon S3 と AWS Glue Data Catalog 上のデータにアクセスできるようになります。その後、データレイク内の Iceberg または Parquet データを参照する外部テーブルを作成し、使い慣れた PostgreSQL 構文でクエリします。この設定は Amazon RDS コンソールから、または psql などの任意の PostgreSQL クライアントで実行できます。手順の詳細は Aurora PostgreSQL のドキュメントに記載されています。
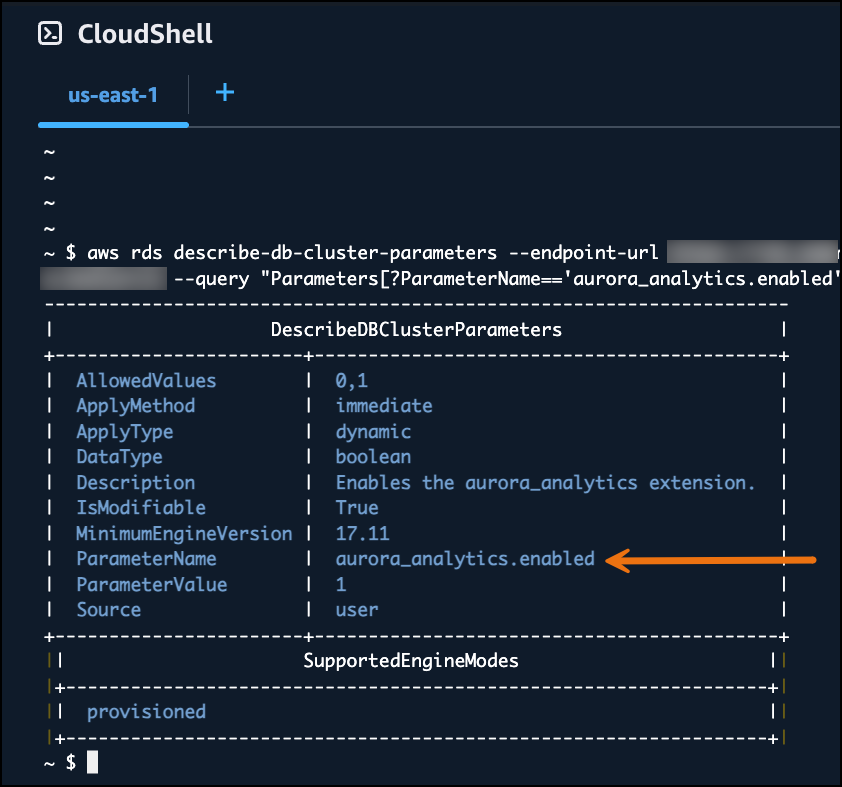
AWS Glue Data Catalog のフェデレーションを通じて、外部の IRC 互換カタログのデータもクエリできます。外部カタログを一度 Glue に登録すれば、あとは Glue ネイティブのテーブルと同じ手順で、クエリしたいテーブルに対応する外部テーブルを作成するだけです。1 つのクエリで Aurora に保存されたデータと複数のカタログに登録された Iceberg テーブルを結合できるため、データを移動したり既存のカタログ資産を置き換えたりせずに、アプリケーションから統合されたビューを得られます。
Aurora は述語プッシュダウンやカラムプルーニングといった最適化も適用するため、必要なデータだけが読み取られます。対象データが増えてもクエリの効率は維持されます。頻繁にアクセスされるデータは Aurora インスタンスにキャッシュされるため、同じデータに対する後続のクエリはより速く返されます。クエリごとの動作は aurora_analytics_stat_statements() で確認でき、スキャンした行数、Amazon S3 から読み取ったバイト数、キャッシュヒット数などのメトリクスが報告されます。
直接クエリの動作を確認するため、psql で Aurora PostgreSQL データベースに接続して拡張機能を作成しました。
CREATE EXTENSION aurora_analytics;今回のウォークスルーでは、シンプルな金融シナリオを用意しました。Aurora には直近 7 日間の顧客トランザクションを格納した recent_transactions テーブルがあり、Amazon S3 には 5 年分の過去のトランザクションデータを含む Parquet ファイルがあります。Aurora から過去データを参照できるようにするため、S3 の Parquet ファイルを指す外部テーブルを作成しました。
CREATE FOREIGN TABLE transaction_history ()
SERVER aurora_analytics_server
OPTIONS (
    location 's3://<my-bucket>/finance/transaction_history.parquet',
    format 'parquet'
);
CREATE FOREIGN TABLE 文の括弧が空になっている点に注目してください。Aurora は Parquet ファイルのメタデータからスキーマを自動的に読み取るため、カラムを手動で定義する必要はありません。テーブルが多数あるワークロードでは、1 つずつ作成する代わりに、IMPORT FOREIGN SCHEMA 文 1 つで AWS Glue Data Catalog のデータベースに含まれるすべての Iceberg または Parquet テーブルに対応する外部テーブルを一括で作成でき、スキーマも自動で推論されます。
両方のテーブルが揃ったところで、Aurora 内の最新の運用データと S3 の過去データを組み合わせる 1 つのクエリを実行しました。
SELECT merchant, category, amount, transaction_date, 'recent' AS source
FROM recent_transactions
WHERE customer_id = 'C-1001'
UNION ALL
SELECT merchant, category, amount, transaction_date, 'historical' AS source
FROM transaction_history
WHERE customer_id = 'C-1001'
  AND transaction_date >= CURRENT_DATE - INTERVAL '5 years'
ORDER BY transaction_date DESC
LIMIT 15;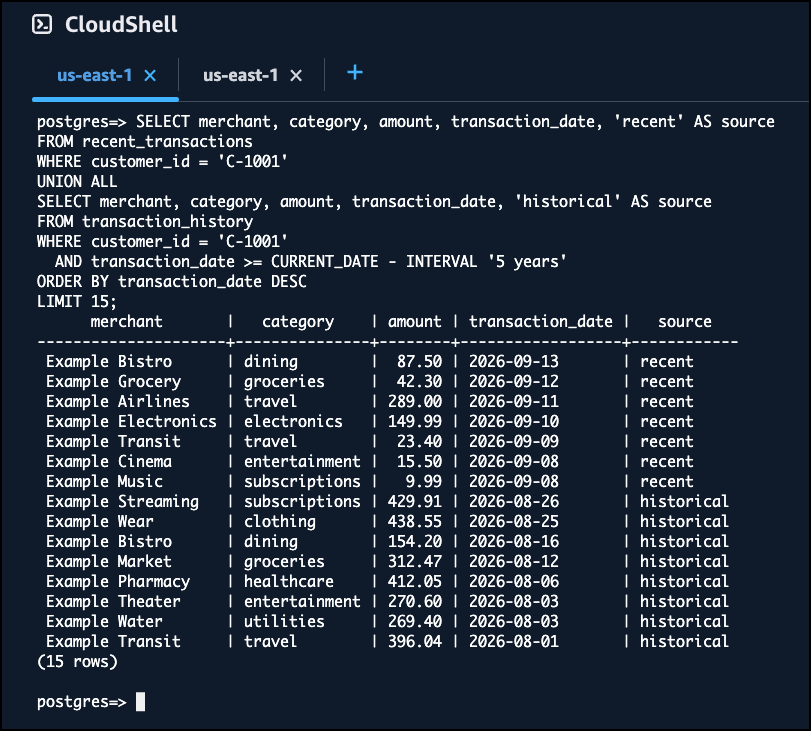
結果には、最新のトランザクションと過去のトランザクションが 1 つの結果セットとして表示されています。直近の 7 行は Aurora から、残りは S3 の Parquet ファイルから直接取得されたものです。内部では DuckDB が Parquet データの分析スキャンを担い、Aurora が運用データを処理しています。従来であれば、この 1 つのクエリを実行するために、まず過去データをデータベースに移動するパイプラインが必要でした。
1 桁ミリ秒のレイテンシーが求められるクエリパターンでは、CREATE TABLE AS SELECT、INSERT INTO ... SELECT、MERGE INTO などの使い慣れたコマンドで、データレイクのデータをネイティブの Aurora PostgreSQL テーブルにマテリアライズできます。マテリアライズされたテーブルは Aurora 内に存在し、他の PostgreSQL テーブルと同様にクエリできるため、別途取り込みパイプラインを運用することなく、ホットデータへ低レイテンシーでアクセスする経路を確保できます。読み取りクエリは、ライターでもリードレプリカでも、クラスター内のどの Aurora PostgreSQL インスタンスでも実行できるため、分析スキャンを運用ワークロードからオフロードできます。マテリアライズ用のコマンドは Aurora にデータを書き込むため、ライターインスタンスで実行します。
今すぐ始めましょう
Amazon Aurora PostgreSQL からの Apache Iceberg および Parquet データの直接クエリは、すべての商用 AWS リージョンと AWS GovCloud (US) リージョンで本日から追加料金なしで利用できます。課金されるのは、クエリが消費する Aurora コンピューティングの増分と、データレイクファイルの読み取りにかかる Amazon S3 のリクエスト料金のみです。
詳細は、Amazon Aurora の機能ページを参照するか、Aurora PostgreSQL のドキュメントをお読みいただくか、Amazon RDS コンソールでお試しください。フィードバックは AWS re:Post または通常の AWS サポート窓口からお寄せください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Sotaro Hikita がレビューしました。