AWS 기술 블로그
데이터 사이언티스트 없이 수요 예측 자동화, 다이닝브랜즈그룹의 Amazon SageMaker Canvas 활용기
들어가며
외식 프랜차이즈에서 식자재 수요예측은 매출과 운영 효율에 직접적인 영향을 미치는 업무입니다. 수요보다 많이 발주하면 재고와 폐기 부담이 커지고, 반대로 부족하면 품절로 이어져 매장 운영과 고객 경험에 영향을 줄 수 있습니다. 특히 신선계육처럼 유통기한이 짧은 품목은 일별 수요 변화에 맞춰 발주량을 예측하는 것이 중요합니다.
다이닝브랜즈그룹은 BHC를 비롯한 다양한 외식 브랜드를 운영하며, 가맹점과 직영점에 식자재를 공급하고 있습니다. 하지만 공급 물량을 정하는 일은 예측 모델 없이 구매팀의 경험에 기대어 왔습니다. 머신러닝 도입을 검토했지만 두 가지 과제가 있었습니다. 첫째, 사내에 전문 데이터 사이언티스트가 없어 모델을 직접 만들고 지속적으로 관리하기 어려웠습니다. 둘째, 모델을 만들더라도 예측 결과를 발주 계획에 반영하려면 별도의 자동화가 필요했습니다. 기존에는 이 과정이 수작업으로 이뤄졌기 때문입니다.
이러한 문제를 개선하기 위해 다이닝브랜즈그룹은 노코드(No-Code) 머신러닝 서비스인 Amazon SageMaker Canvas를 도입해, 전문 데이터 사이언티스트 없이도 IT팀 실무자가 직접 ML 모델을 만들고 비교·운영할 수 있도록 했습니다. 여기에 반복되는 예측 실행과 업무 시스템 연계를 Amazon RDS, Amazon S3, Amazon ECR, AWS Lambda, Amazon EventBridge Scheduler 서비스로 자동화해, 데이터 수집부터 모델 학습 및 예측, 발주 계획 시스템 반영까지 연결되는 수요예측 자동화 체계를 구축했습니다.
이 글에서는 구매팀의 경험과 수작업에 의존하던 수요예측을 머신러닝 기반으로 전환하고, 예측 결과를 발주 계획에 활용하기까지의 과정을 기술 선택과 운영 방식 중심으로 소개합니다.
기존 과제 : Excel과 경험에 의존하던 예측
기존에는 구매팀에서 Excel을 활용하여 수요를 예측했습니다. 전년도 월별·요일별 패턴을 바탕으로 연간 매출 계획을 일 단위로 나누고, 명절과 휴무일을 보정한 뒤 마케팅 일정과 특정일의 시장 상황을 더해 발주량을 정했습니다. 프로모션·신메뉴·매장 오픈과 휴점 같은 정보는 메일이나 대화로 전달받아 그때그때 반영했습니다.
이 방식에는 세 가지 한계가 있었습니다.
첫째, 판단 기준을 정량화하기 어려웠습니다. 변수별 가중치와 보정 폭은 구매팀의 판단에 따라 매번 달라졌고, 어떤 정보를 얼마나 반영했는지 기록이 남지 않아서 예측을 재현하기 어려웠습니다.
둘째, 원재료를 수급하는 구매팀과 전 가맹점의 매출 및 실적 계획을 세우는 가맹기획팀이 발주 수량을 협의할 때 두 팀이 공통으로 신뢰할 수 있는 수치가 없어, 구매팀의 예측이 적정한 것인지 합의하기 어려웠습니다.
셋째, 예측 결과를 실제 발주에 반영하는 과정도 수작업이었습니다. 구매팀은 Excel에 정리한 예측 수치를 바탕으로 수급 업체마다 메신저로 연락해 물량을 조정했습니다. 전체 품목의 약 50%를 차지하는 신선계육은 유통기한이 짧아, 이러한 조정 과정이 길어지거나 발주 일정을 맞추지 못하면 폐기나 재고 부족으로 이어졌습니다.
다이닝브랜즈그룹은 이 문제를 풀기 위해 수요예측 모델의 도입과 함께, 데이터 준비부터 결과 활용까지 자동화할 수 있는 기술과 운영 방식을 검토했습니다.
Amazon SageMaker Canvas를 선택한 이유
다이닝브랜즈그룹은 수요예측 모델을 만들고 운영하는 방식으로 Python 직접 개발, 오픈소스 AutoML 라이브러리, Amazon SageMaker Canvas를 비교했습니다. 비교 기준은 앞서 살펴본 과제에 맞춰, 전문 인력 없이도 모델을 관리할 수 있는지, 특정 담당자에게 의존하지 않는지, 정기 실행과 시스템 연계로 이어질 수 있는지에 두었습니다.
| 비교 기준 | Python 직접 개발 | 오픈소스 AutoML 라이브러리 | Amazon SageMaker Canvas |
|---|---|---|---|
| 필요 역량 | ML 모델링과 코딩 역량 필요 | 코딩 역량 필요 | 웹 기반 노코드 UI로, ML 기초 이해만으로 활용 가능 |
| 모델 구축·버전 관리 | 코드를 직접 작성하고 관리 | 후보 탐색과 튜닝은 자동화, 설정은 코드로 관리 | UI에서 모델을 만들고 버전별로 관리·비교 |
| 운영 환경 | 담당자 PC에 의존 | 실행 인프라와 프레임워크 버전을 직접 관리 | 관리형 환경에서 모델 개발 및 관리 수행 |
| 정기 실행·시스템 연계 | 담당자가 직접 실행 | 별도 자동화 구현 필요 | 모델 등록까지 UI로 수행, 정기 실행은 AWS 서비스 기반 자동화 |
비교 결과, Amazon SageMaker Canvas는 IT팀 실무자가 모델을 지속적으로 관리하고 운영하는 데 세 가지 장점이 있었습니다.
- 코드 없이 모델을 만들고 비교할 수 있습니다. 노코드 UI 기반으로 후보 모델을 생성하고 RMSE·MSE 등으로 성능을 비교하며, Column impact로 입력 변수의 중요도를 확인할 수 있어 코드 작성에 익숙하지 않고 ML 경험이 적은 IT팀 실무자도 모델을 직접 개발하고 관리할 수 있습니다.
- 특정 담당자에게 묶이지 않습니다. 모델과 데이터가 관리형 클라우드 환경에 있어, 특정 담당자의 PC나 실행 시점에 의존하지 않습니다.
- 운영 자동화로 자연스럽게 이어집니다. Model Registry에 등록된 모델 패키지에는 추론 컨테이너와 모델 아티팩트, 평가 지표가 함께 담겨 있어, Lambda에서 SageMaker API로 엔드포인트를 배포하고 호출하는 자동화 파이프라인에 그대로 연결할 수 있습니다.
다이닝브랜즈그룹은 이러한 운영상의 장점을 바탕으로 Amazon SageMaker Canvas를 도입하고, 정기 실행과 업무 시스템 연계를 위한 자동화도 함께 구성했습니다.
솔루션 아키텍처
전체 구조는 모델 개발 흐름과 정기 예측 흐름으로 나뉩니다. Amazon SageMaker Canvas로 모델 개발의 진입 장벽을 낮추고, 반복되는 정기 예측은 AWS 서비스 기반으로 자동화했습니다.
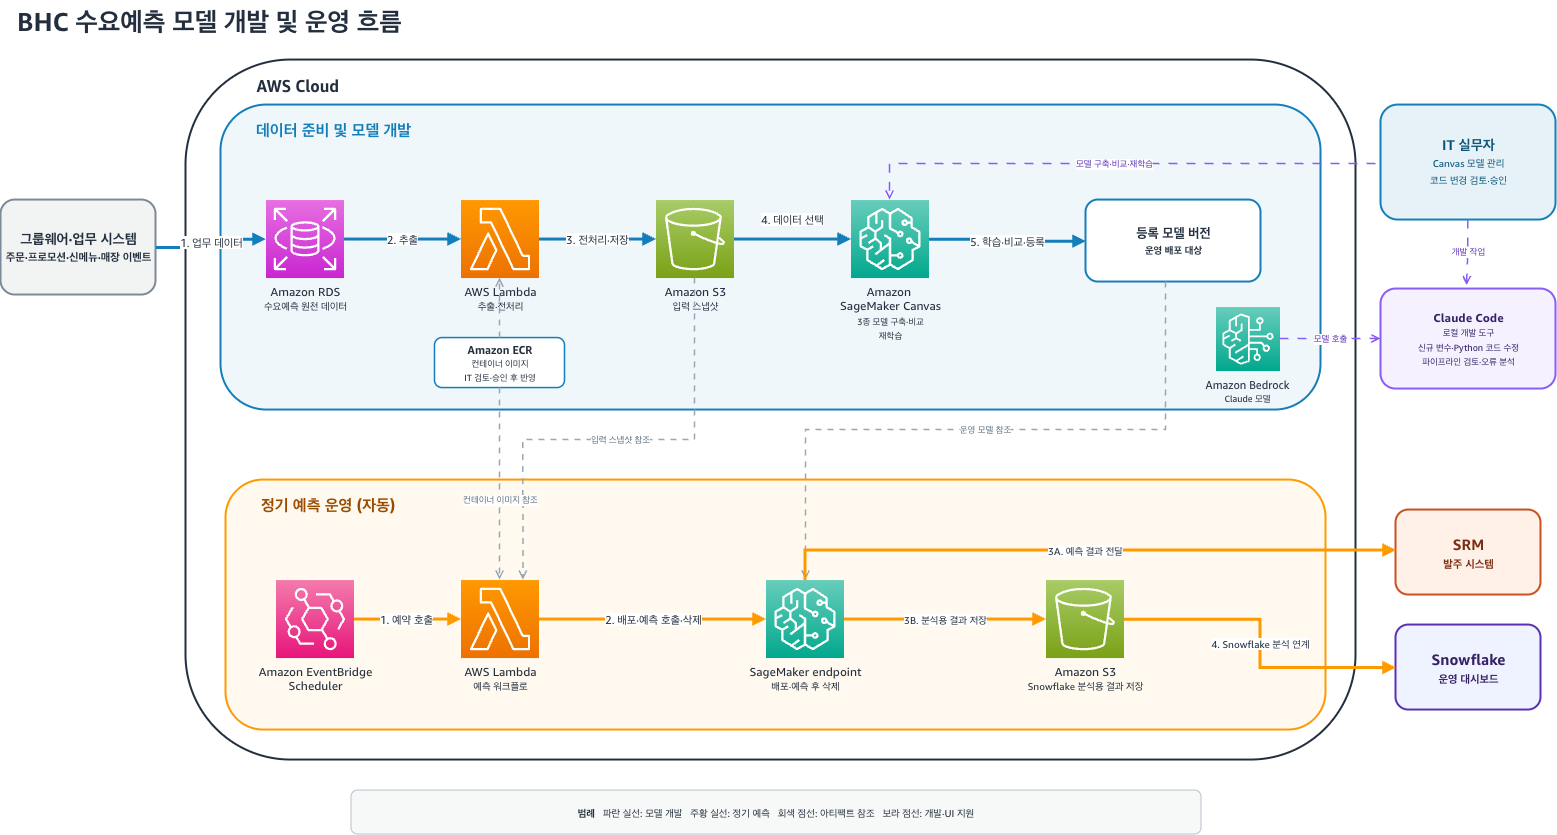
그림 1. BHC 수요예측의 모델 개발과 정기 예측 흐름
모델 개발 흐름은 Amazon RDS의 원천 데이터를 전처리해 Amazon S3에 학습 데이터로 저장하는 데서 시작합니다. IT팀 실무자는 이 데이터를 Amazon SageMaker Canvas로 가져와 모델을 생성·비교하고, 검토를 마친 모델을 운영 버전으로 등록합니다.
정기 예측 흐름은 Amazon EventBridge Scheduler가 AWS Lambda를 호출하면서 시작됩니다. AWS Lambda로 구현한 자동화 로직은 예측 입력 준비, 엔드포인트 배포와 예측 호출, 결과 전달, 리소스 정리를 차례로 수행합니다. 실행에 사용한 입력은 S3에 스냅샷으로 보관합니다. 예측 결과는 발주 시스템인 SRM(Supplier Relationship Management)으로 전달해 발주량 산정에 활용합니다. 같은 결과를 S3에도 저장해, Snowflake 기반 사내 데이터 플랫폼에서 실제 실적과 비교·분석할 수 있도록 했습니다.
두 흐름을 분리했기 때문에 모델 버전을 바꿀 때와 운영 파이프라인을 바꿀 때 서로 영향을 주지 않고 각각 검증할 수 있습니다. 이어지는 구현 과정에서는 1~3단계에서 모델 개발 흐름을, 4단계에서 정기 예측 흐름을 차례로 살펴봅니다.
| 흐름 | 구성 요소 | 역할 |
|---|---|---|
| 공통 | Amazon RDS | 주문 및 운영 관련 원천 데이터 관리 |
| 공통 | AWS Lambda | 데이터 전처리, 모델 배포·호출, 결과 전달 및 리소스 정리 |
| 공통 | Amazon Elastic Container Registry(Amazon ECR) | Lambda 컨테이너 이미지 보관 |
| 공통 | Amazon S3 | 학습 데이터, 실행별 입력 스냅샷, 예측 결과 원본 보관 |
| 모델 개발 | Amazon SageMaker Canvas | 데이터 탐색, 모델 생성·비교, 운영 모델 등록 및 관리 |
| 정기 예측 | Amazon EventBridge Scheduler | 예약된 일정에 따라 정기 예측 워크플로 시작 |
| 정기 예측 | Amazon SageMaker AI 실시간 추론 엔드포인트 | 등록된 운영 모델을 호스팅하고 예측 요청 처리 |
| 결과 활용 | SRM 솔루션 기반 발주 시스템 | 예측 결과를 받아 발주량 산정에 활용 |
| 결과 활용 | Snowflake 기반 사내 데이터 플랫폼 | S3에 보관된 예측값을 실제 실적과 비교해 일별 오차 분석 |
| 결과 활용 | Claude Code on Amazon Bedrock | 신규 변수 반영, Python 코드 수정 및 오류 분석을 지원하는 개발 도구 |
구현 과정
1. 학습 데이터 준비: 메일과 대화에 머물던 이벤트를 데이터로 남기다
과거 주문량만으로는 프로모션이나 신메뉴 출시처럼 수요가 크게 달라지는 시기를 예측하기 어려웠습니다. 수요를 바꾼 원인이 데이터에 남아 있지 않았기 때문입니다. 프로모션·신메뉴·스포츠 행사·매장 오픈과 휴점 같은 정보는 그동안 메일이나 대화로 전달돼, 적용 시점과 변경 이력을 추적하기 어려웠고 같은 조건을 다시 학습시키기도 어려웠습니다.
그래서 다이닝브랜즈그룹은 모델보다 데이터를 먼저 정비했습니다. 사내 영업관리 시스템에 별도 입력 화면을 만들어, 현업 담당자가 프로모션·신메뉴·스포츠 행사·매장 오픈과 휴점 같은 업무 이벤트를 정형 데이터로 등록하도록 했습니다.
| 데이터 범주 | 주요 항목 | 모델에서의 용도 |
|---|---|---|
| 기본 운영 정보 | 과거 주문량, 이동 평균, 품목 정보, 매장 수 변화량, 요일 | 평시 수요 패턴 구성 |
| 마케팅 정보 | 플랫폼(배달 앱/자사 앱) 구분, 최대 할인 금액, 쿠폰 수량, 정액 할인, 무료 증정 | 프로모션 조건 반영 |
| 신메뉴 정보 | 출시 시점, 사용 품목, 과거 신메뉴 출시 후 30일 이내 데이터 | 출시 초기 수요 패턴 반영 |
| 기타 이벤트 | 스포츠 행사, 매장 오픈과 휴점, 특정일 정보 | 평소와 다른 수요가 예상되는 날짜 식별 |
이 데이터는 Lambda에서 전처리를 거쳐 모델이 학습할 수 있는 입력 변수로 가공되고, S3에 학습 데이터로 저장됩니다.
2. 수치 예측 모델 구성: 적용 상황에 따라 모델을 세 가지로 나누다
다이닝브랜즈그룹은 수요예측에 시계열 예측 대신 수치 예측 모델을 사용했습니다. Amazon SageMaker Canvas의 시계열 예측은 SageMaker Autopilot 기반으로 동작하며, 입력 변수의 유형별로 개수 제한이 있습니다. 이에 매장 수 변화, 할인 조건 등 현업에서 고려하는 다양한 변수를 함께 반영하기 위해 수치 예측을 선택했습니다.
또한 평시와 프로모션 기간, 신메뉴 출시 기간은 수요가 움직이는 이유가 다르고, 예측 시점에 알 수 있는 정보도 다릅니다. 다이닝브랜즈그룹은 이러한 차이를 반영해 적용 상황과 입력 변수에 따라 모델을 세 가지로 나눴습니다. 여기서 세 모델은 서로 다른 알고리즘이 아니라, 어떤 상황에 어떤 정보를 반영할지를 구분한 것입니다.
| 모델 | 목적 | 입력 변수 | 적용 구간 |
|---|---|---|---|
| 베이스라인 | 특별한 행사가 없는 평시 수요예측 | 과거 주문량, 이동 평균, 품목 정보, 매장 수 변화량, 요일 등 | 일반 영업일 |
| 마케팅 | 할인과 프로모션에 따른 수요 변화 반영 | 베이스라인 변수, 플랫폼 구분, 최대 할인 금액, 쿠폰 수량, 정액 할인, 무료 증정 등 | 배달 플랫폼 또는 자사 앱 행사 기간 |
| 신메뉴 | 신메뉴 출시와 연계된 품목 수요 반영 | 베이스라인 변수, 과거 신메뉴 출시 후 30일 이내 데이터 등 | 신메뉴 출시 관련 기간 |
세 모델은 모두 주문 수량(qty)을 예측 대상으로 하며, 과거 주문량과 이동 평균 같은 베이스라인 변수에 각 상황에 필요한 정보를 더하는 방식으로 구성했습니다. 처음에는 품목마다 모델을 따로 만들었지만, 지금은 품목 정보도 입력 변수로 넣어 여러 품목을 하나의 모델로 학습합니다. 덕분에 품목별 모델을 따로 관리할 필요가 줄었고, 여러 품목에 공통으로 나타나는 수요 패턴도 모델에 반영할 수 있게 됐습니다.
3. 모델 학습·평가·등록: Amazon SageMaker Canvas에서 운영 모델을 고르다
데이터 점검과 모델 생성
S3에 저장한 전처리 데이터를 Amazon SageMaker Canvas로 가져와 앞서 정의한 세 모델을 구성했습니다. 학습에 앞서 Amazon SageMaker Canvas의 데이터 탐색 기능으로 주문 수량의 분포와 연도·요일별 패턴을 살펴보고, 결측치와 이상치 등 데이터 품질을 점검했습니다.
점검 결과를 바탕으로 입력 변수를 조정한 뒤 모델을 학습했습니다. 변수 구성이 바뀔 때마다 전처리 버전과 학습 데이터셋도 함께 관리해, 이후 모델을 비교할 때 각 모델이 어떤 데이터와 조건으로 학습됐는지 추적할 수 있도록 했습니다.
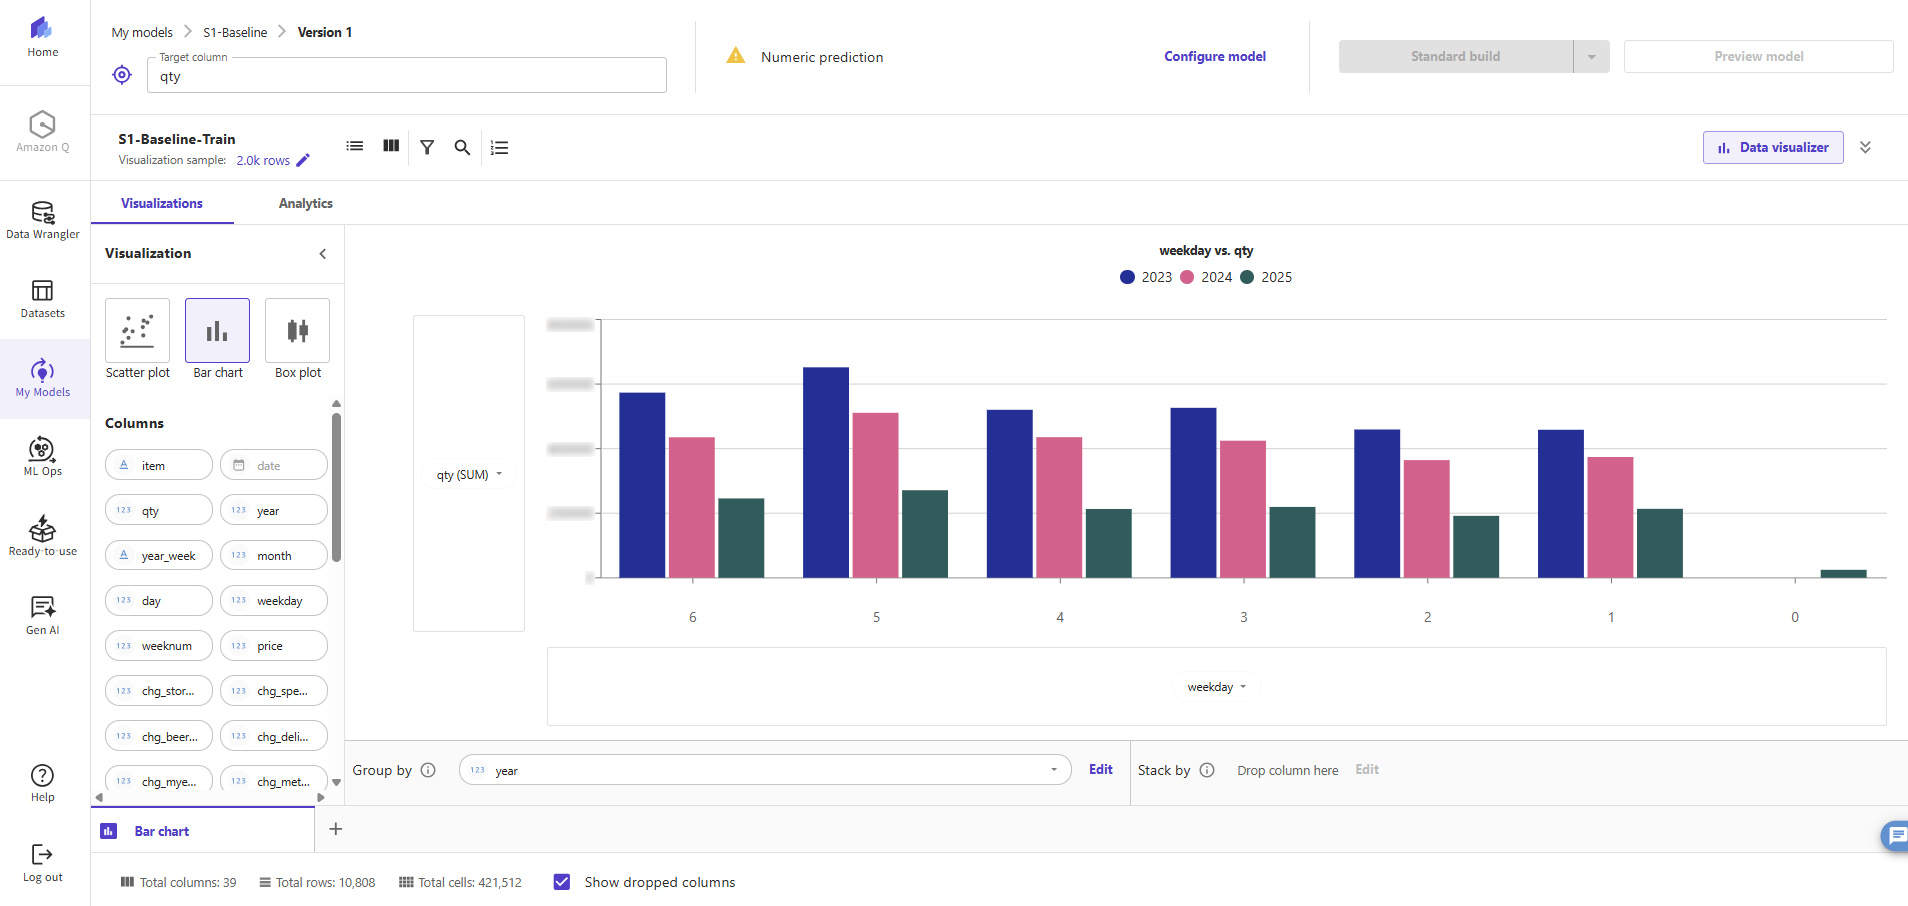
그림 2. Amazon SageMaker Canvas Data visualizer에서 연도별로 구분한 요일별 주문 수량 분포
RMSE를 중심으로 한 모델 성능 비교
학습이 끝난 뒤에는 Amazon SageMaker Canvas가 제공하는 모델 리더보드를 활용해 후보 모델의 성능을 1차 비교했습니다. 평가 결과를 별도로 취합하지 않고도 MSE, MAE, RMSE, R²를 한 화면에서 확인할 수 있어, IT팀 실무자가 운영에 적합한 모델을 검토하는 데 도움이 됐습니다.
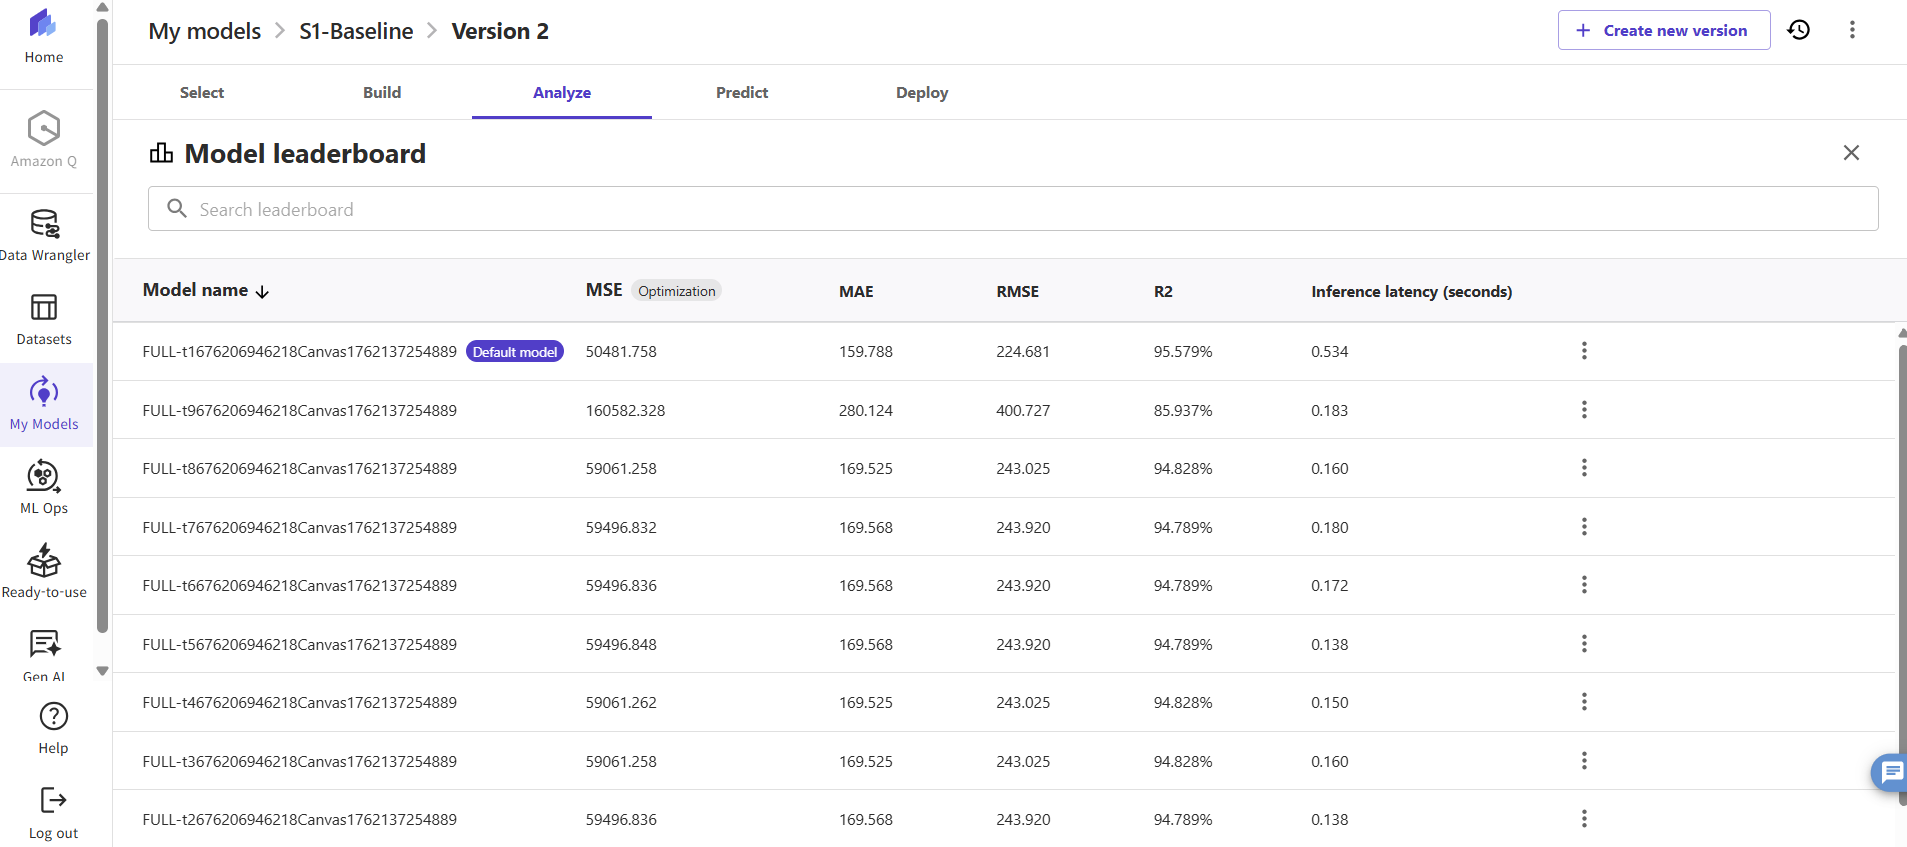
그림 3. Amazon SageMaker Canvas 모델 리더보드에서 후보 모델의 평가 지표 비교
특히 중요하게 본 지표는 RMSE였습니다. 큰 오차에 더 큰 비중을 두고 주문 수량과 같은 단위로 오차를 보여주기 때문에, 과잉 발주나 재고 부족으로 이어질 수 있는 예측 오차를 평가하는 데 유용했습니다. 다만 RMSE 하나만 보지 않고, 동일한 평가 조건에서 MAE도 함께 비교했습니다.
| 지표 | 의미 | 비교 시 활용 |
|---|---|---|
| MSE | 실제값과 예측값 차이를 제곱한 값의 평균 | 큰 오차에 더 큰 비중을 두어 성능 비교 |
| MAE | 절대 오차의 평균 | 평균적으로 주문 수량이 얼마나 빗나갔는지 확인 |
| RMSE | MSE의 제곱근 | 주문 수량과 같은 단위로 오차 규모 비교 |
| R² | 모델이 목표값의 변동을 설명하는 정도 | 모델의 전반적인 설명력 확인 |
최종 검증에는 학습에 사용하지 않은, 학습 기간 이후의 데이터를 사용했습니다. 해당 기간의 일별 실제 주문 수량과 예측값을 대조하고, 큰 오차가 발생한 날짜를 확인했습니다. 이를 통해 리더보드의 평가 지표뿐 아니라 이후 기간의 수요를 얼마나 잘 예측하는지도 검토했습니다.
Column impact로 입력 변수 점검
모델 성능을 비교한 뒤에는 Column impact로 각 입력 변수가 예측에 미치는 상대적 중요도를 살펴봤습니다. Column impact는 각 입력 변수가 다른 입력 변수와 비교해 예측에서 차지하는 가중치를 백분율로 나타낸 점수입니다. 할인 금액, 쿠폰 수량, 이벤트 유형 등 추가한 정보가 모델에서 어느 정도의 중요도를 갖는지 확인하고, 입력 변수 구성을 검토하는 데 활용했습니다.
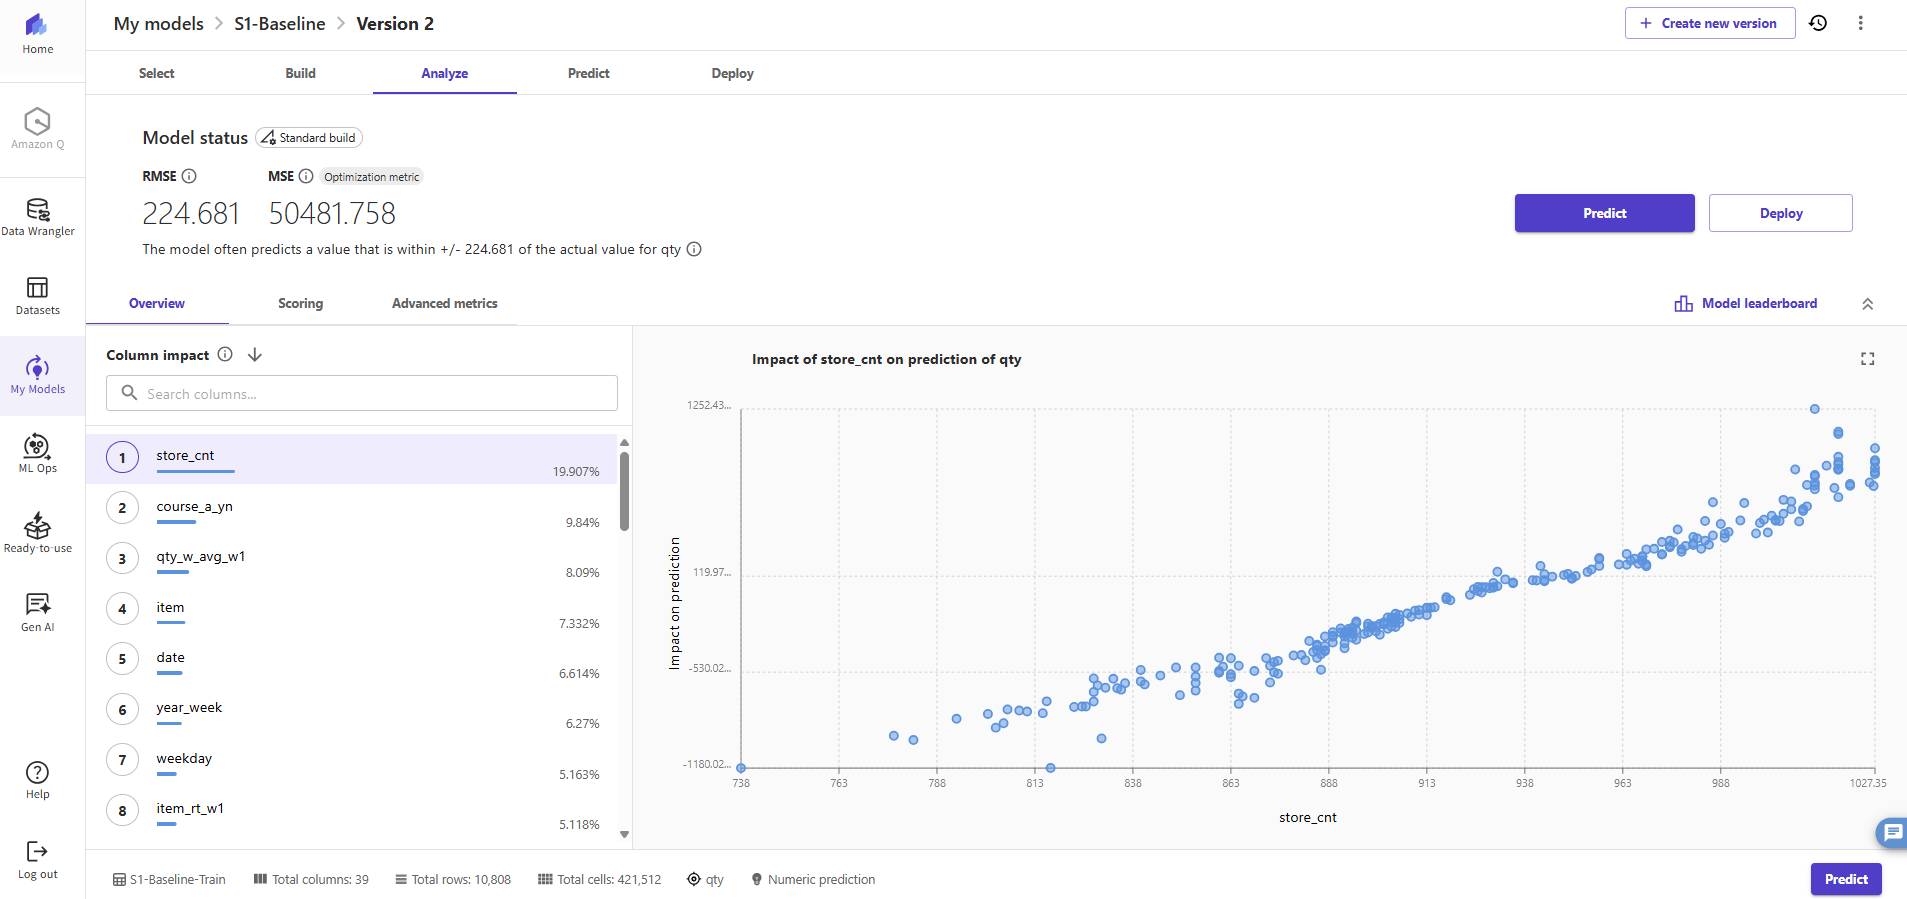
그림 4. Column impact를 통해 입력 변수의 상대적 영향도를 가시적으로 확인
다만 변수의 중요도가 높다고 해서 해당 변수가 실제 수요 증가의 원인이라는 뜻은 아닙니다. Column impact는 인과 관계의 근거가 아니라, 모델이 어떤 변수에 기대어 예측하는지 확인하는 참고 자료로 활용했습니다.
운영 모델 등록
Amazon SageMaker Canvas의 My models 메뉴는 코딩 없이 머신러닝 모델을 생성, 관리, 분석 및 배포하는 핵심 작업 공간입니다. 성능과 입력 변수 검토를 마친 모델은 My models에서 Add to Model Registry를 선택해 Amazon SageMaker Model Registry에 등록했습니다. 모델 그룹 안에서 버전별 학습 지표와 메타데이터를 관리하고, 운영에 사용할 버전을 구분해 관리할 수 있었습니다. 재학습한 모델도 같은 검토 절차를 거쳐 등록하며, 이렇게 등록된 운영 모델이 다음 단계의 정기 예측에 사용됩니다.
4. 정기 예측과 발주 시스템 연계: 예측부터 결과 전달까지 자동으로
등록한 운영 모델을 정해진 일정에 따라 실행하고, 예측 결과를 업무 시스템에 전달하도록 구성했습니다. 데이터 적재, 전처리, 배포·예측·삭제는 세 개의 Lambda가 나눠 담당하며, 각 함수는 15분 이내에 처리를 마칩니다. 실행 코드와 라이브러리는 Amazon ECR에 보관한 컨테이너 이미지로 관리합니다.
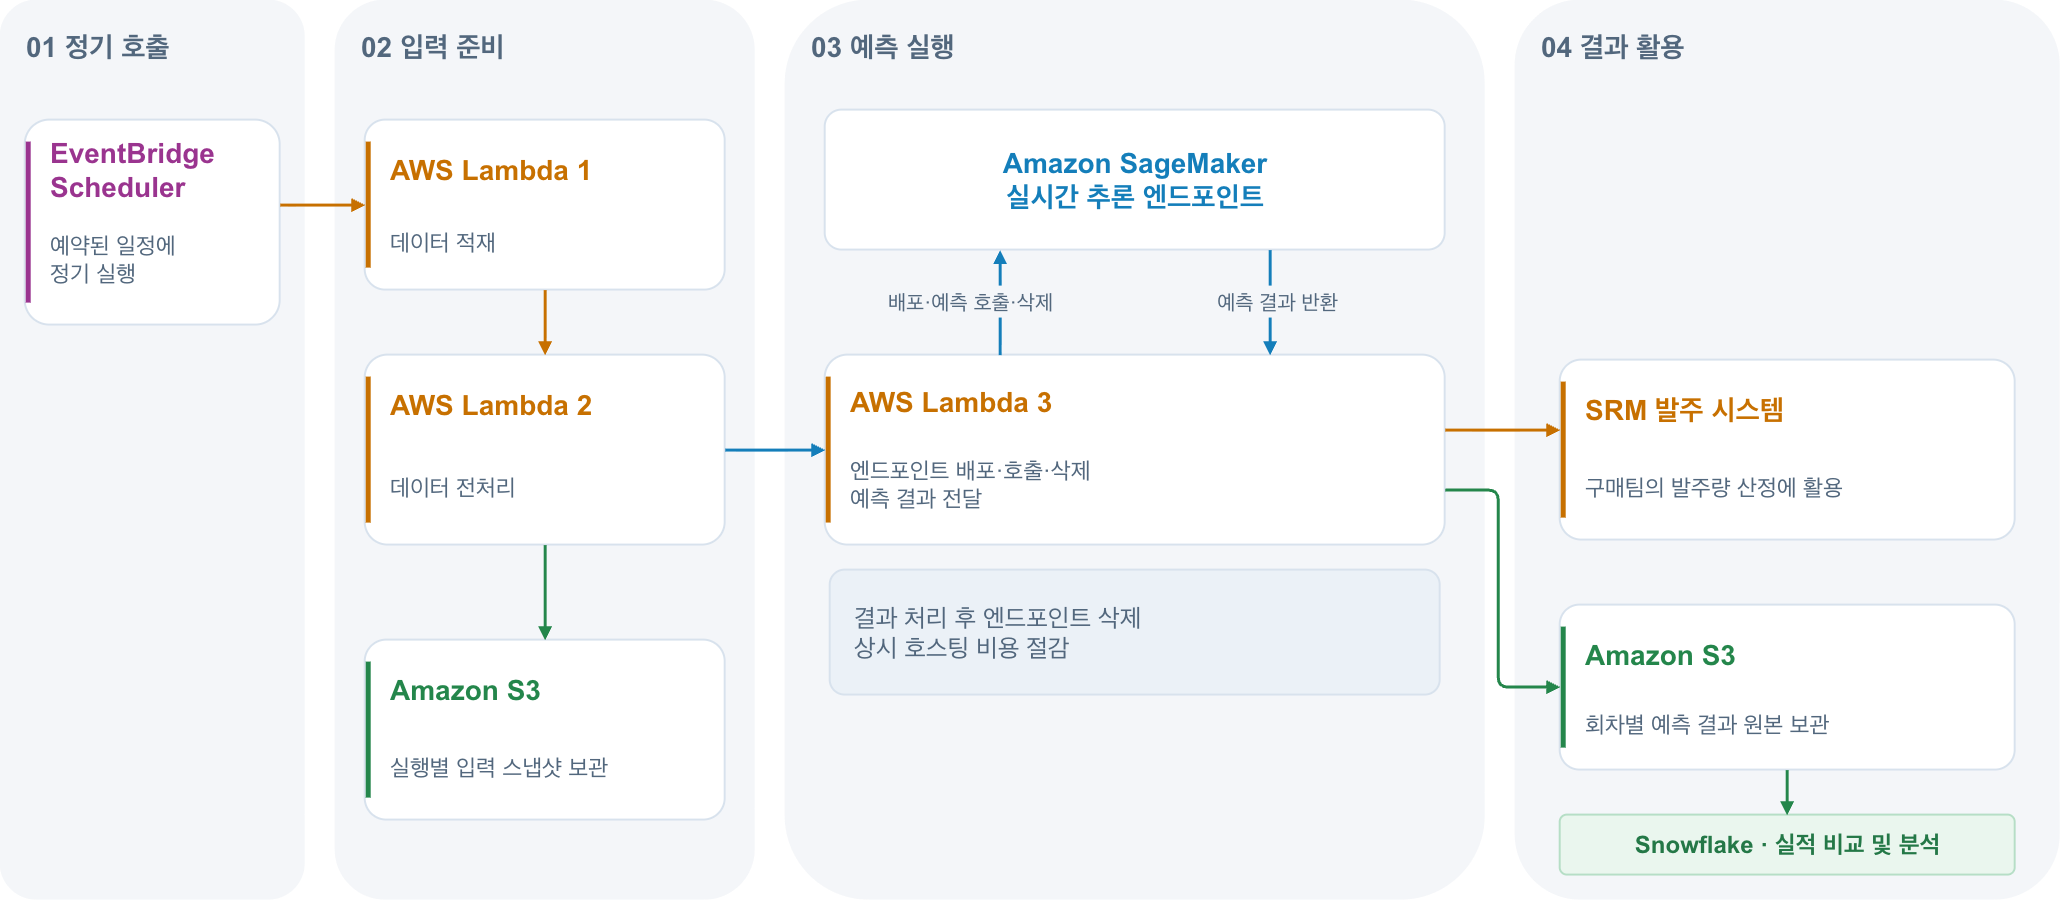
그림 5. 예측 결과를 SRM과 S3로 분리해 전달하는 정기 예측 흐름
정기 예측은 다섯 단계로 진행됩니다.
- 정기 호출: EventBridge Scheduler가 정해진 일정에 따라 데이터 적재를 담당하는 첫 번째 Lambda를 호출합니다.
- 입력 준비: 첫 번째 Lambda가 데이터를 적재하고, 두 번째 Lambda가 원천 데이터와 업무 이벤트를 결합해 예측 입력을 만듭니다. 입력 데이터는 S3에 실행별 스냅샷으로 보관합니다.
- 예측 실행: 세 번째 Lambda는 Model Registry에 등록된 운영 모델을 SageMaker 실시간 추론 엔드포인트로 배포하고, 준비가 완료되면 예측을 호출합니다. 반환된 결과는 같은 함수에서 SRM과 S3로 전달합니다.
- 결과 활용: SRM에 전달한 예측 결과는 구매팀의 발주량 산정에 활용하고, S3에 보관한 회차별 결과는 Snowflake에서 실제 실적과 비교해 모델 개선에 활용합니다.
- 리소스 정리: 예측과 결과 처리가 끝나면 추론 엔드포인트를 삭제합니다.
결과 전달과 보관 경로 분리
SRM과 S3는 예측 결과를 활용하는 목적이 다릅니다. SRM에 전달한 결과는 현업 부서가 발주량을 산정할 때 참고하고, S3에 보관한 회차별 결과는 Snowflake에서 실제 실적과 비교해 모델 개선에 활용합니다.
경로를 나눈 덕분에 장애 대응도 단순해졌습니다. 해당 회차의 결과가 정상적으로 저장돼 있다면, SRM 전달 과정에 문제가 생겨도 모델을 다시 실행할 필요 없이 S3에 보관된 결과를 재전송하면 됩니다.
예측할 때만 리소스를 사용해 비용 절감
Amazon SageMaker의 인스턴스 기반 실시간 추론 엔드포인트는 예측 요청이 없어도 실행 중인 동안 호스팅 비용이 발생합니다. 다이닝브랜즈그룹의 수요예측은 정해진 일정에만 실행되므로, 엔드포인트를 상시 운영하지 않고 예측 시점에 배포했다가 결과 처리가 끝나면 삭제했습니다. 이를 통해 예측을 수행하지 않는 시간의 불필요한 호스팅 비용을 없앴습니다.
Amazon SageMaker Canvas도 모델 개발과 검증이 필요한 동안에만 사용하고, 작업이 끝나면 애플리케이션을 종료해 미사용 시간의 워크스페이스 비용을 줄였습니다.
도입 효과: 경험 중심의 발주에서 데이터 기반 의사결정으로
정량적 성과
가장 먼저 드러난 변화는 업무 시간 단축입니다. 기존에는 데이터를 취합하는 데만 매주 평균 1시간이 걸렸고, 데이터 준비부터 예측 결과 확인까지 전체 작업에 수일이 소요됐습니다. 자동화 이후에는 전체 작업을 약 30분 만에 완료할 수 있게 되어, 반복 작업에 드는 시간과 운영 부담을 줄였습니다.
예측 품질도 안정적으로 유지하고 있습니다. 신선계육 주요 3종의 예측 정확도는 내부 집계 기준 일평균 약 90% 수준입니다. (※ 예측 정확도 = 100% − MAPE, MAPE : 평균 절대 백분율 오차)
운영 방식의 변화
| 영역 | Excel 기반 기존 방식 | 현재 AWS 운영 방식 |
|---|---|---|
| 데이터 준비 | 과거 패턴과 행사 정보를 수기로 반영 | 원천 데이터와 업무 이벤트를 연계해 입력 자동 생성 |
| 예측 기준 | 담당자 경험에 따라 달라짐 | 같은 데이터와 모델 버전으로 재현 가능 |
| 예측 근거 | 담당자 경험 | 버전 관리된 ML 모델 |
| 실행 | 담당자가 직접 산정 | 정해진 일정에 따라 자동 실행 |
| 결과 활용 | Excel 파일 공유 | 발주 시스템 반영과 대시보드 분석 |
업무 자동화와 함께, 예측 결과를 바탕으로 협의하고 개선하는 방식도 달라졌습니다.
- IT팀의 직접 운영: IT팀이 모델 개발부터 정기 예측과 시스템 연계까지 직접 관리할 수 있는 운영 기반을 마련했습니다.
- 재현 가능한 예측 기준: 예측에 사용한 데이터와 모델 버전을 기록해, 같은 조건으로 예측을 다시 실행하고 결과가 달라진 이유를 추적할 수 있게 됐습니다.
- 발주 협의의 공통 기준 마련: 구매팀과 가맹기획팀이 모델 예측치를 함께 참고하며 발주 수량을 협의할 수 있게 됐습니다. 구매팀의 경험에 데이터 기반의 판단 근거가 더해졌습니다.
- 예측 결과의 지속적인 점검: 예측값과 실제 실적을 Streamlit in Snowflake 기반 대시보드에서 함께 확인하고, 오차가 큰 날짜와 품목을 다음 개선 대상으로 검토할 수 있게 됐습니다.
Streamlit in Snowflake 기반 대시보드를 통한 예측 결과 점검
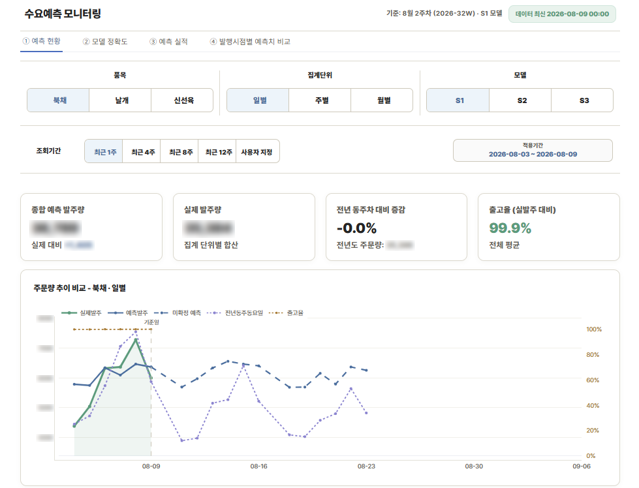
그림 6. BHC 수요예측 대시보드 요약 화면
요약 화면에서는 예측값과 실제 실적, 전년 동주차 수량과 출고율을 함께 보여줍니다. 담당자는 이 화면에서 예측 결과와 최근 운영 현황을 한눈에 파악할 수 있습니다.
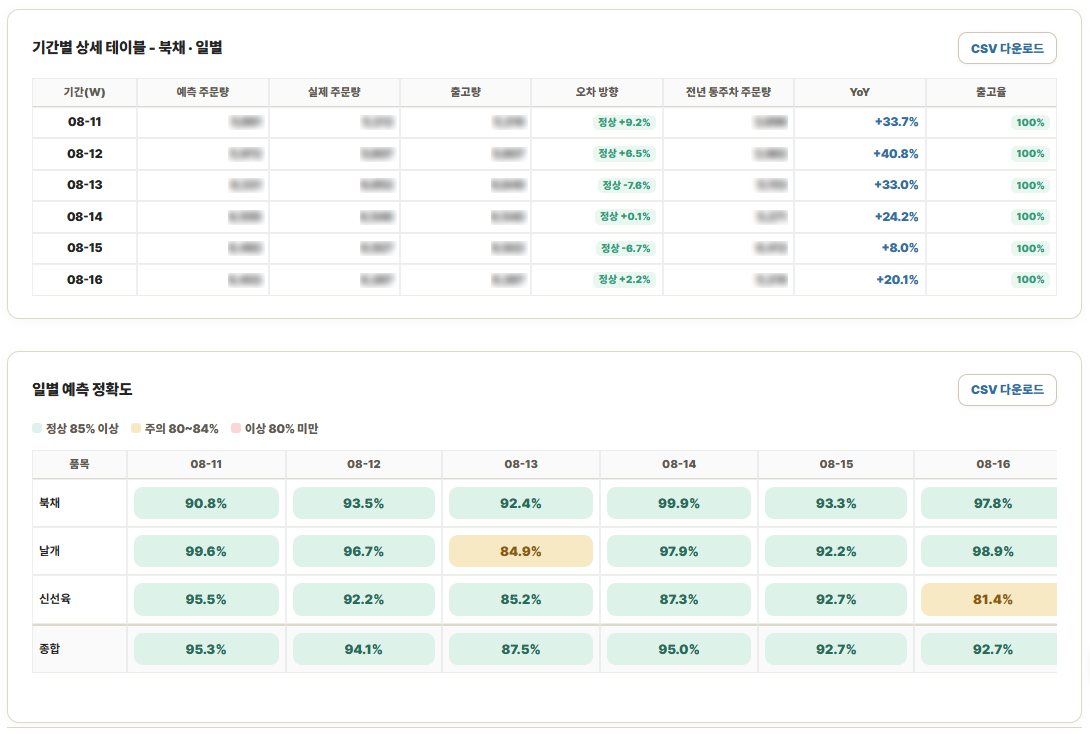
그림 7. BHC 수요예측 대시보드 일별 상세 화면
일별 상세 화면에서는 날짜별 예측값과 실적의 차이를 확인합니다. 기간 평균에 가려지기 쉬운 큰 오차를 살펴보고, 베이스라인·마케팅·신메뉴 모델별 결과도 나눠서 검토합니다.
운영 과정에서 얻은 교훈
Amazon SageMaker Canvas를 활용해 모델 생성과 관리의 부담을 줄이고, AWS 서비스로 정기 예측과 업무 시스템 연계를 자동화할 수 있었습니다. 그 과정에서 배운 점을 네 가지로 정리했습니다.
- 모델보다 데이터를 먼저 구조화해야 합니다.
프로모션·신메뉴·매장 이벤트 정보가 메일과 대화에 머물러 있는 동안에는 어떤 모델을 써도 같은 조건으로 학습하고 검증할 수 없었습니다. 이벤트 정보를 정형 데이터로 남기고 적용 기간과 변경 이력까지 관리하는 것이 모든 개선의 출발점이었습니다. - 모델 개발과 정기 운영의 책임을 나눠야 합니다.
모델 비교와 선택은 Amazon SageMaker Canvas에서, 반복 실행과 외부 시스템 연계는 Lambda 기반의 자동화 파이프라인에서 담당하도록 나누자, 무엇을 바꿨을 때 어디까지 영향을 받는지가 명확해졌습니다. - 평균 정확도 하나로 판단하지 않아야 합니다.
신선식품은 기간 평균 정확도가 높더라도 하루의 큰 오차가 곧바로 품절이나 폐기로 이어질 위험이 있습니다. RMSE와 MAE, 모델별 적용 구간, 일별 큰 오차를 함께 봐야 실제 운영 위험을 찾을 수 있습니다. - 실패 복구와 비용은 처음부터 파이프라인에 포함해야 합니다.
결과 전달과 보관의 역할을 나누고 실패 단계별 재처리 방식을 설계해야 합니다. 정기 예측에서는 엔드포인트의 운영 시간과 삭제 대상도 함께 관리해야 합니다.
향후 고도화 방향
다음 과제는 현재의 예측 정확도를 한 단계 더 끌어올리고, 업무 담당자가 예측 결과를 더 쉽게 활용할 수 있도록 하는 것입니다. 이를 위해 두 가지 방향을 검토하고 있습니다.
- 입력 변수 구성 고도화: Amazon SageMaker Canvas의 Data Wrangler로 Data Quality and Insights 리포트를 만들어 데이터 품질과 입력 변수별 예측력을 점검하는 방안을 검토하고 있습니다. 리포트 결과와 Column impact를 함께 보고 예측력이 낮은 입력 변수는 정리하며, 판매 패턴에 영향을 주는 프로모션·이벤트 정보는 더 세분화해 반영하는 것이 목표입니다.
- AI Agent 기반 의사결정 보조: AI Agent를 통해 SKU별 예측 정확도, 기간별 성능 비교, 예측에 반영된 프로모션·이벤트 정보 등을 자연어로 확인하는 방안을 구상하고 있습니다. 업무 담당자가 지표를 직접 계산하거나 대시보드를 일일이 탐색하는 부담을 줄이고, 예측 결과를 근거와 함께 확인해 업무 판단에 바로 활용할 수 있도록 하는 것이 목표입니다.
*본문의 도표, 예시 코드, 스크린샷 및 수치는 외부 공개 가능한 수준으로 비식별·마스킹 처리하였으며, 일부는 개념 전달을 위해 단순화되었습니다.