AWS 기술 블로그
게임듀오가 Amazon EC2 기반 ClickStack으로 게임 서버 관측성 비용을 절반 이하로 줄인 방법
게임듀오(GAMEDUO)는 10여 종의 모바일 게임을 라이브로 운영하며 250대가 넘는 게임 서버에서 하루 1~2억 건의 로그와 4~6억 건의 요청 추적 기록(스팬)을 수집합니다. 게임듀오는 이 관측성(Observability) 데이터를 SaaS 모니터링 서비스에서 Amazon EC2 기반 ClickStack(ClickHouse + OpenTelemetry + HyperDX)으로 옮겼습니다. 개발팀 7명 중 한 명이 설계부터 구축과 운영까지 맡았고 라이브 게임 이관에는 한 달 남짓 걸렸습니다.
그 결과 게임듀오는 세 가지 장점을 얻었습니다. 관측 비용이 기존 대비 절반 이하로 줄었고 로그 보존 기간은 15일에서 180일로 늘었으며, 비용 때문에 활용하지 못했던 분산 트레이싱도 쓸 수 있게 됐습니다. 이 글은 게임듀오가 Amazon EC2 위에 ClickStack을 구축한 과정을 다룹니다. 이 관측 스택은 로그를 SQL로 자유롭게 검색할 수 있고 ClickHouse가 멈춰도 데이터를 잃지 않으며, 모니터링 대상 서버가 늘어도 비용이 크게 늘지 않습니다.
1. 배경: 게임듀오와 관측 데이터
게임듀오는 캣히어로, 어나더 던전, 악마왕 키우기, 붐붐캡틴 등 10여 종의 모바일 게임을 직접 개발하고 퍼블리싱합니다. 각 게임은 별도의 서버군을 가지고 있어 로그를 보내는 게임 서버만 250대가 넘습니다.
관측 데이터의 규모는 다음과 같습니다.
| 항목 | 규모 |
|---|---|
| 로그 | 하루 1~2억 건, 원문 약 700GB |
| 요청 추적 기록(스팬)* | 하루 4~6억 건 |
| ClickHouse 압축 적재량 | 하루 약 150GB |
| 수집 대상 서버 | 250대 이상 |
| 라이브 게임 | 10여 종 |
* 게임 서버가 요청 하나를 처리하면 DB 조회, 캐시 조회, 다른 서버 호출 같은 단계가 여러 번 생깁니다. 이 단계 하나하나를 기록한 것이 스팬(span)입니다. 요청 하나에 보통 수 개에서 수십 개의 스팬이 생기므로 스팬 수는 요청 수보다 훨씬 많습니다.
전환 전 게임듀오는 SaaS 모니터링 서비스를 로그 검색, 호스트 메트릭 대시보드, 알람의 세 가지 용도로 사용했습니다. 하루 700GB에 가까운 로그(약 1억 4천만 건)를 15일간 검색할 수 있게 보관하고 그 이후 원문은 로그 아카이브 기능으로 Amazon S3에 넘겨 장기 보관했습니다. 서버 200여 대에 에이전트가 설치돼 있었고 커스텀 메트릭은 쓰지 않았습니다.
SaaS 모니터링 서비스의 UI/UX는 비개발자도 바로 쓸 수 있는 수준이라 만족스러웠지만 그만큼 비쌌습니다. 게임과 서버 대수가 늘수록 비용도 정비례로 늘어나는 구조여서 점점 감당하기 힘들어졌습니다. 그 결과 세 가지 제약이 생겼습니다.
첫째, APM(분산 트레이싱)을 켜지 못했습니다. 로그 요금만으로도 벅차서 API 간 연동 문제는 하나씩 손으로 확인해야 했습니다.
둘째, 라이브 환경만 구성했습니다. 런칭 전 프로젝트, 샌드박스, 운영 도구 서버의 로그는 서버에 직접 접속해 파일을 열어 봤습니다.
셋째, 오토스케일링으로 늘었다 줄었다 하는 서버는 호스트당 과금 구조라 요금이 부담스러워 연동을 망설였습니다.
2. 저장소 선택
2.1 Grafana Loki 시도와 한계, 그리고 ClickHouse
대안을 검토하기 위해 요구사항을 정리해 보니 메트릭 대시보드와 알람은 이미 Grafana와 Amazon CloudWatch로 보고 있었습니다. 그래서 고민은 적절한 로그 저장소를 찾는 것 하나로 좁혀졌습니다.
게임듀오는 ClickHouse에 앞서 2025년 7월 Grafana Loki를 시도했습니다. 우선 파일시스템으로 보던 런칭 전 프로젝트와 운영 서버 로그를 Loki로 모으고 소프트 런칭 프로젝트에도 적용해 기능을 검증했습니다. 비용은 확실히 저렴했지만 게임듀오의 로그 특성과는 맞지 않았습니다.
Loki는 라벨로 스트림을 나누고 본문은 통째로 저장하는 구조입니다. JSON 로그의 특정 필드로 검색하거나 집계하려면 쿼리할 때마다 본문을 파싱해야 합니다. 게임듀오는 팀마다 로그 형식이 다를 수 있고 편의상 깊게 중첩된 JSON을 그대로 남기는 경우가 많아서 로그가 조금만 많아져도 검색이 매번 타임아웃되었습니다.
또한 비개발자에게는 조회할 때 쓰는 Loki의 LogQL이 진입 장벽이었습니다.
이 과정에서 요구사항을 좀 더 명확하게 정리할 수 있었습니다. “파싱은 적재 시점에 한 번만 하고, 나머지는 SQL로 뭐든 할 수 있는 저장소.”
이 요구사항에 맞는 저장소가 ClickHouse였습니다. JSON을 적재 시점에 한 번 풀어 컬럼으로 저장하고 이후 검색과 집계는 모두 SQL로 합니다. 파싱을 쿼리마다 반복하지 않으니 로그 형식이 게임마다 달라도 검색 속도가 떨어지지 않습니다. ANSI SQL 기반이라 약간의 차이에는 금세 익숙해졌습니다.
테스트 중에는 이미 공개된 대규모 전환 사례들도 도움이 되었습니다. 하루 수십 TB 규모의 로그를 소수 인원이 ClickHouse 기반 스택으로 옮긴 사례들이 있었고 그 사례들이 Loki를 제외한 이유가 게임듀오가 겪던 문제와 거의 같았습니다. 본문 필드로 검색하려면 전체를 훑어야 하고 집계가 느리며 쿼리 언어의 표현력이 제한적이라는 점입니다. PoC에서 확인한 결과와 이런 사례들을 통해 프로덕션 전환에 확신을 가질 수 있었습니다.
ClickHouse가 OpenTelemetry Collector, HyperDX와 함께 제공하는 관측 스택인 ClickStack으로 묶어 사용하면 검색 UI(HyperDX)까지 따라오므로 비개발자의 접근성 문제도 함께 풀렸습니다.
3. 파이프라인 아키텍처
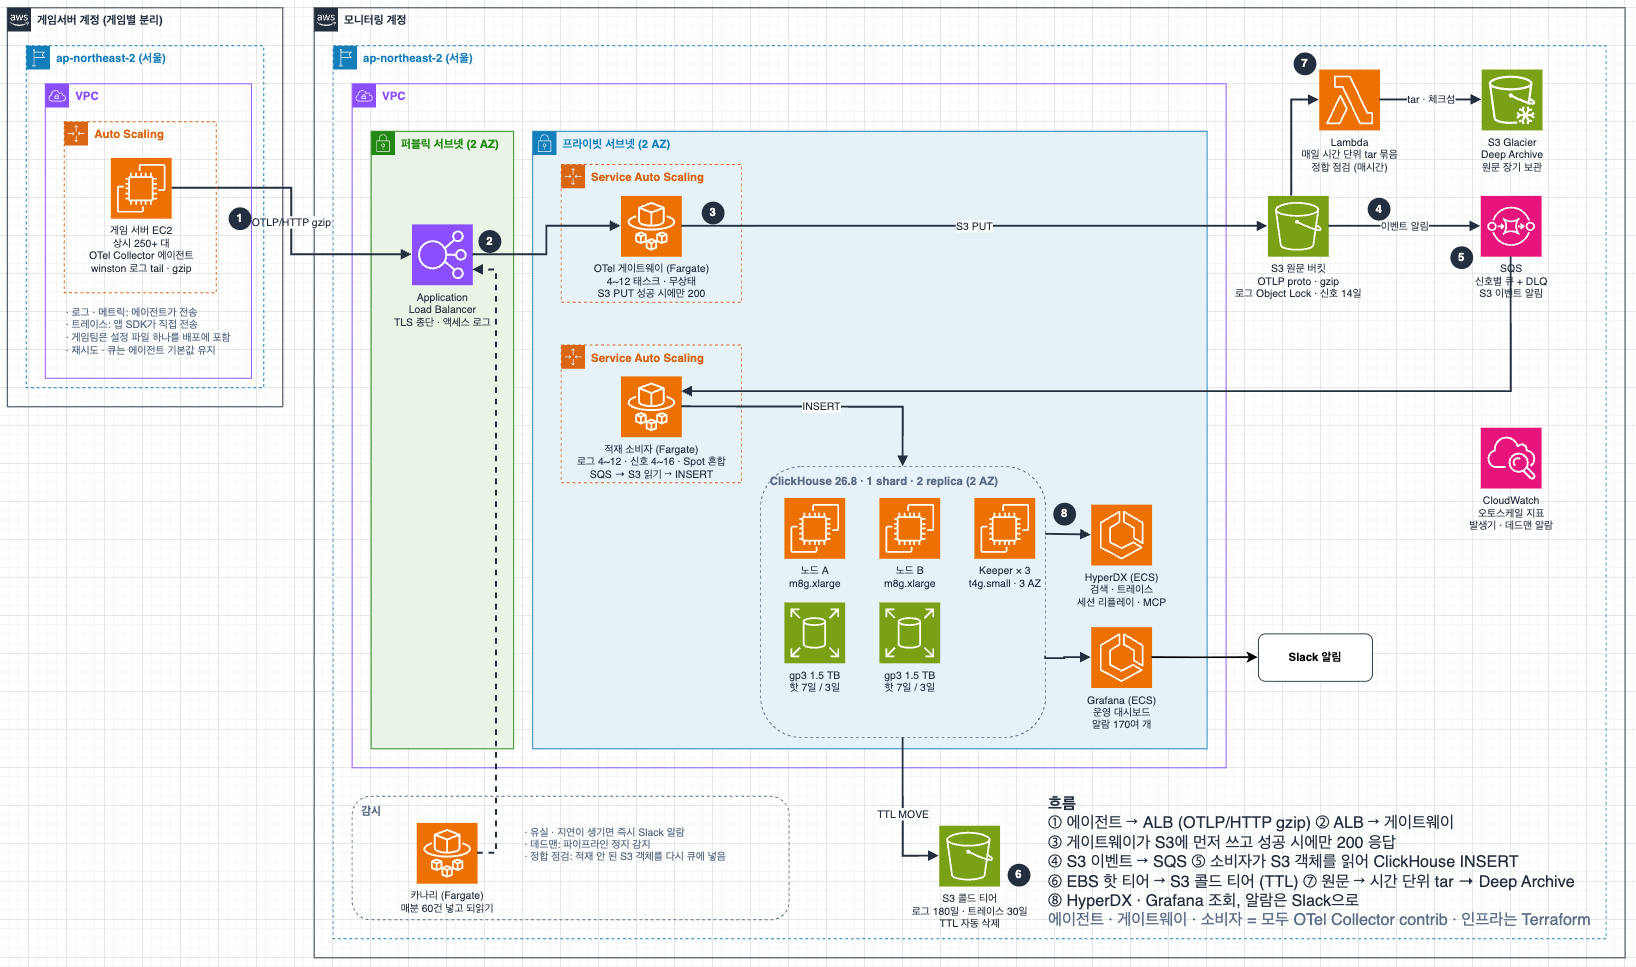
<게임듀오 관측 파이프라인 아키텍처>
데이터는 수집, 저장, 조회와 알람 순서로 흐르며 구간별 구성은 다음과 같습니다.
3.1 수집: OpenTelemetry Collector 활용
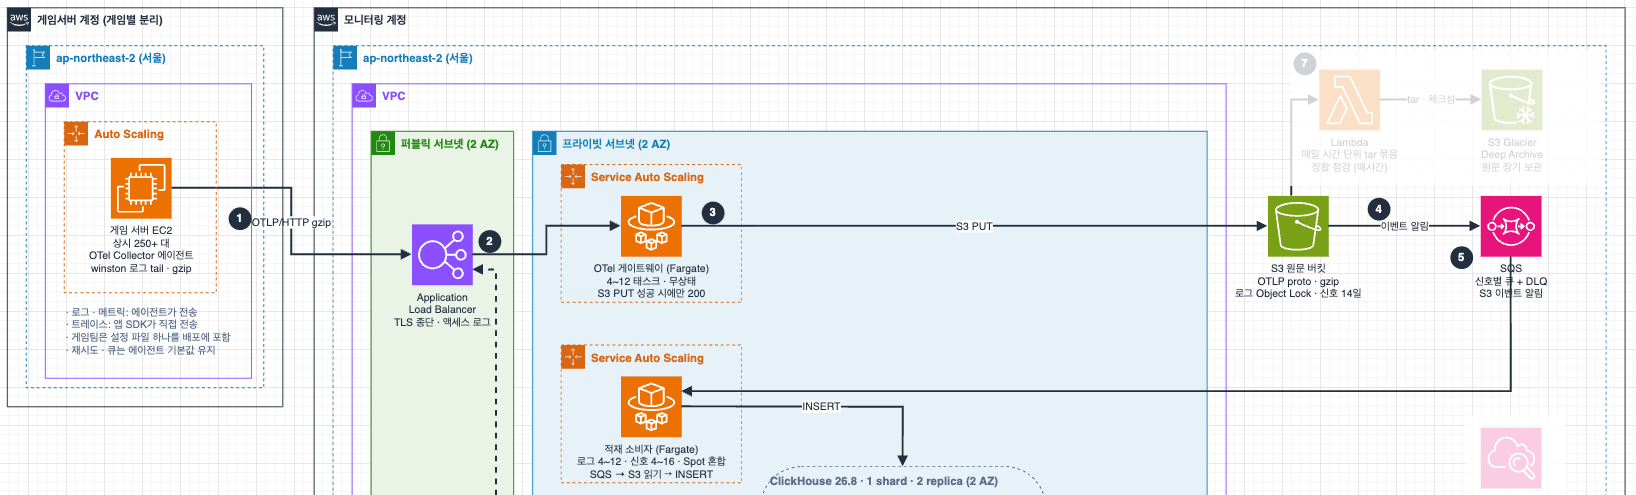
<수집 구간: 에이전트에서 ALB와 게이트웨이를 거쳐 S3와 SQS에 버퍼링한 뒤 Consumer가 ClickHouse에 적재>
OpenTelemetry Collector contrib 배포판으로 에이전트, 게이트웨이, Consumer 세 역할을 모두 구성하고 역할별로 세부 설정만 다르게 했습니다.
- 에이전트(각 게임 서버 EC2): OpenTelemetry Collector(OTel Collector) 에이전트는 각 서버의 로그 파일을 tail해서 JSON으로 파싱하고 gzip으로 압축해 OTLP/HTTP로 게이트웨이에 보냅니다. 게임팀은 설정 파일 하나를 배포에 포함시키면 준비가 끝납니다. 게임 서버는 대부분 Node.js(winston)이고 에이전트의 재시도와 큐 설정은 기본값을 그대로 사용합니다. 트레이스는 게임 서버 애플리케이션의 OTel SDK가 게이트웨이로 직접 보내고 애플리케이션 메트릭은 로컬 에이전트를 거쳐 나갑니다. 게이트웨이는 토큰으로 요청을 인증합니다.
- 게이트웨이(AWS Fargate Task): 로그는 Application Load Balancer(ALB)를 거쳐 게이트웨이로 전달됩니다. 게이트웨이는 받은 데이터를 OTLP proto + gzip 형태로 S3에 쓰고 성공 시 에이전트에 200을 반환합니다. 실패하면 에이전트가 재시도합니다.
- 버퍼(Amazon S3 + Amazon Simple Queue Service, SQS): S3 이벤트 알림과 SQS를 버퍼로 사용합니다. 안정성을 위해 신호(로그, 트레이스, 메트릭, 세션)마다 큐를 분리하고 큐마다 Dead Letter Queue(DLQ)를 둡니다. 다섯 번 처리에 실패한 객체는 DLQ로 옮겨지고 알람이 울리며 다른 객체의 적재는 막히지 않습니다.
- Consumer(AWS Fargate, Spot): OpenTelemetry Collector의 awss3 리시버 SQS Message Mode로 S3 객체를 읽어 ClickHouse에 INSERT합니다. 태스크 하나가 리시버 4개를 병렬로 실행해 분당 최대 약 160만 행까지 처리합니다. 0.5 vCPU 크기의 태스크로 로그는 4~12개, 트레이스와 메트릭과 세션은 4~16개 범위에서 CPU 기준으로 오토스케일링합니다. 각 AZ마다 온디맨드 태스크를 1개씩 두고 나머지는 Fargate Spot으로 실행해 비용을 절감했습니다. Spot 태스크가 회수돼도 처리 중이던 메시지는 Amazon SQS 대기열의 가시성 제한 시간이 지나면 다시 큐에 나타나므로 늦어질 뿐 유실되지 않습니다.
적재 중 ClickHouse가 멈춰도 데이터는 S3에, 처리되지 않은 이벤트는 SQS 큐에 남아 있습니다. 그래서 ClickHouse가 다시 살아나면 이어서 적재됩니다.
아래는 이 구조를 만드는 게이트웨이와 Consumer 설정의 일부입니다.
3.2 저장: Hot Data는 Amazon EBS에, Cold Data는 Amazon S3에 보관
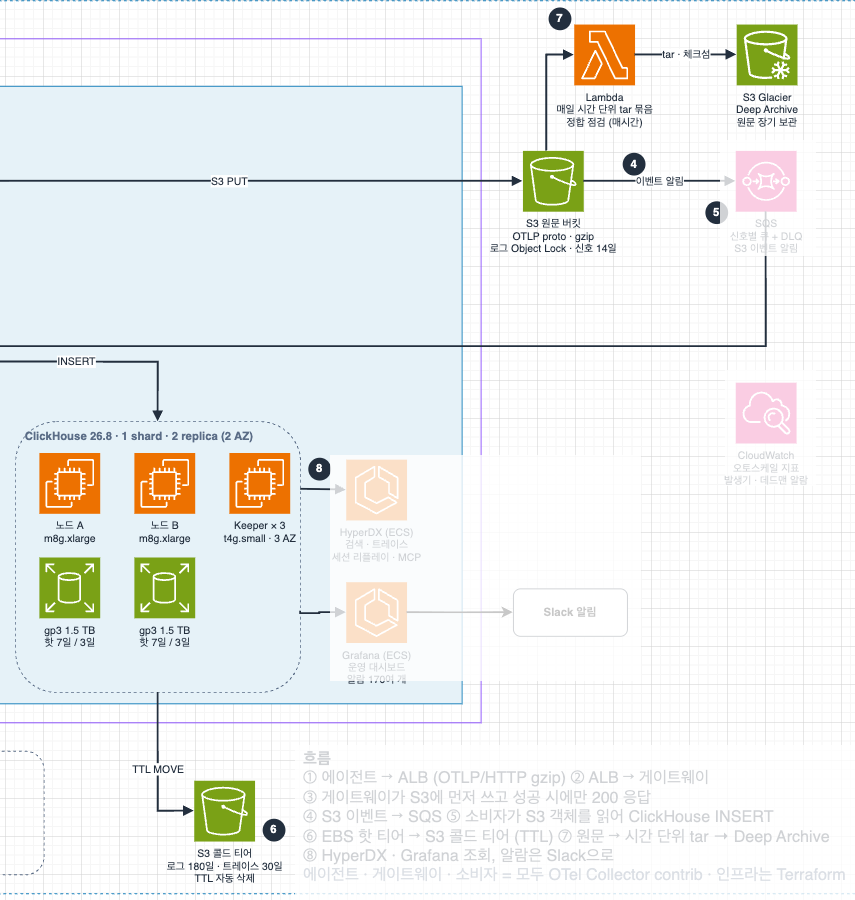
<저장 구간: EBS 핫 티어와 S3 콜드 티어(TTL), 그리고 원문 버킷의 Deep Archive 장기 보관>
ClickHouse는 AWS Graviton4 기반 m8g.xlarge 2대를 서로 다른 AZ에 두고 샤딩 없이 1 Shard 2 Replica로 복제하도록 구성했습니다. 쿼럼용 ClickHouse Keeper는 t4g.small 3대를 각 AZ에 분산 배치합니다. 이 규모에서는 분산 샤딩이 필요하지 않았습니다.
각 EC2 인스턴스의 스토리지는 Amazon EBS gp3 1.5TB입니다. 최근 데이터는 EBS 핫 티어에 두고 보관 기간이 지나면 ClickHouse의 스토리지 정책(Storage Policy)에 따라 Amazon S3 콜드 티어로 자동으로 내려보낸 뒤 TTL 정책으로 삭제합니다. 신호별 티어링 규칙은 다음과 같습니다.
| 구간 | 저장 위치 | 로그 | 트레이스 | 적용 방식 |
|---|---|---|---|---|
| 핫 티어 | Amazon EBS gp3 (노드당 1.5TB) | 0~7일 | 0~3일 | 적재 시 EBS 볼륨에 저장 |
| 콜드 티어 | Amazon S3 (S3 Standard) | 7~180일 | 3~30일 | 스토리지 정책의 TTL(TO VOLUME 'cold')로 자동 이동 |
| 스토리지 클래스 전환 | S3 Standard-IA | 콜드 티어 객체 생성 30일 뒤 | Glacier Instant Retrieval은 읽기 요금 때문에 제외 | |
| 삭제 | – | 180일 | 30일 | TTL(DELETE)로 파트 단위 삭제 |
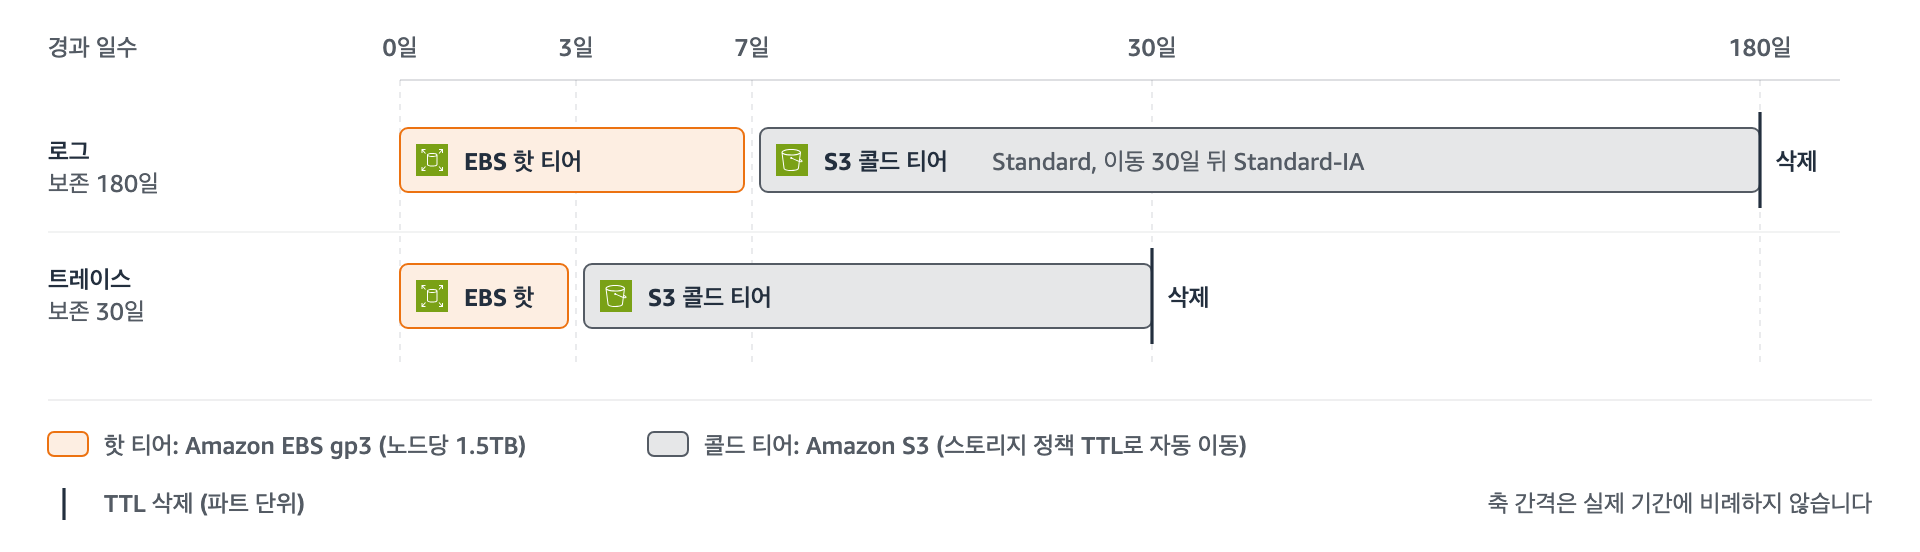
<신호별 스토리지 티어링 타임라인>
게임 서비스 특성상 조회 요청 대부분이 최근 7일 이내에 몰리기 때문에 EBS는 작게 유지하고 나머지는 Amazon S3에 보관하는 방식이 효과적이었습니다. 추가 비용 절감을 위해 Amazon S3 Glacier Instant Retrieval도 적용해 봤습니다. 하지만 AI 에이전트가 MCP로 콜드 구간을 넓게 조회하면 읽기 요금이 Standard-IA의 3배라 오히려 비용이 늘어나서 Standard-IA 클래스까지만 활용합니다.
ClickHouse는 테이블을 정의할 때 티어링과 보존 기간 삭제 규칙을 함께 선언할 수 있습니다. 아래는 게임듀오 로그 테이블 정의의 일부입니다.
압축률은 로그가 원문의 약 7분의 1, 트레이스는 약 20분의 1입니다.
이와 별개로 게이트웨이가 Amazon S3에 쓴 원문은 그대로 이력 추적과 재처리용 원본이 됩니다. 로그 원문은 AWS Lambda가 매일 전날분을 시간 단위 tar로 묶고 체크섬(checksum)과 함께 Amazon S3 Glacier Deep Archive 스토리지 클래스에 장기 보관합니다. 원문은 하루 약 27만 개의 작은 객체라서 수명주기 규칙으로 스토리지 클래스를 전환하면 객체 수에 비례하는 전환 요금이 보관 비용보다 커집니다. 그래서 이 부분은 직접 구현했습니다. 트레이스, 메트릭, 세션 원문은 장기 보관하지 않고 ClickHouse 장애 시 다시 적재할 수 있도록 14일만 S3에 두었다가 삭제합니다.
3.3 조회: HyperDX와 Grafana의 활용
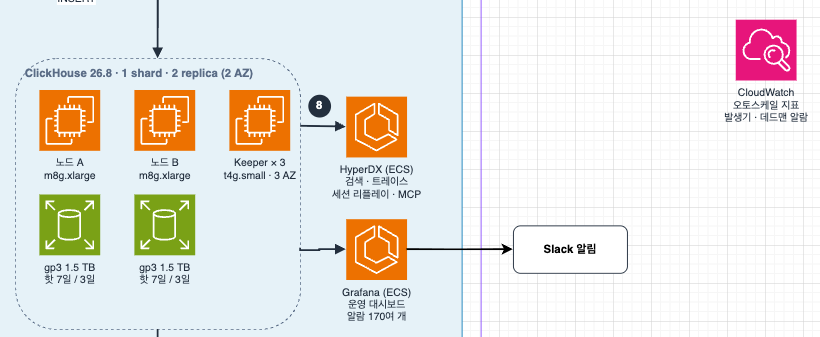
<조회 구간: ClickHouse를 HyperDX와 Grafana가 조회하고 알람은 Slack으로 전달>
- HyperDX(Amazon ECS): HyperDX는 통합 관측성(Observability)과 프로덕션 디버깅을 위한 오픈소스 플랫폼으로 게임듀오 개발팀의 일상 도구입니다. 도구를 바꾸지 않고 로그 검색, 트레이스 워터폴(Trace Waterfall), 세션 리플레이(Session Replay)를 한 곳에서 확인하며 디버깅할 수 있습니다. 마케팅팀과 채팅팀, 게임팀이 쓰는 로그 검색 화면과 20여 개의 대시보드가 있습니다. 로그 검색 UI로 Grafana도 검토했지만 비개발자에게도 직관적인 UX를 제공하는 HyperDX를 선택했습니다.
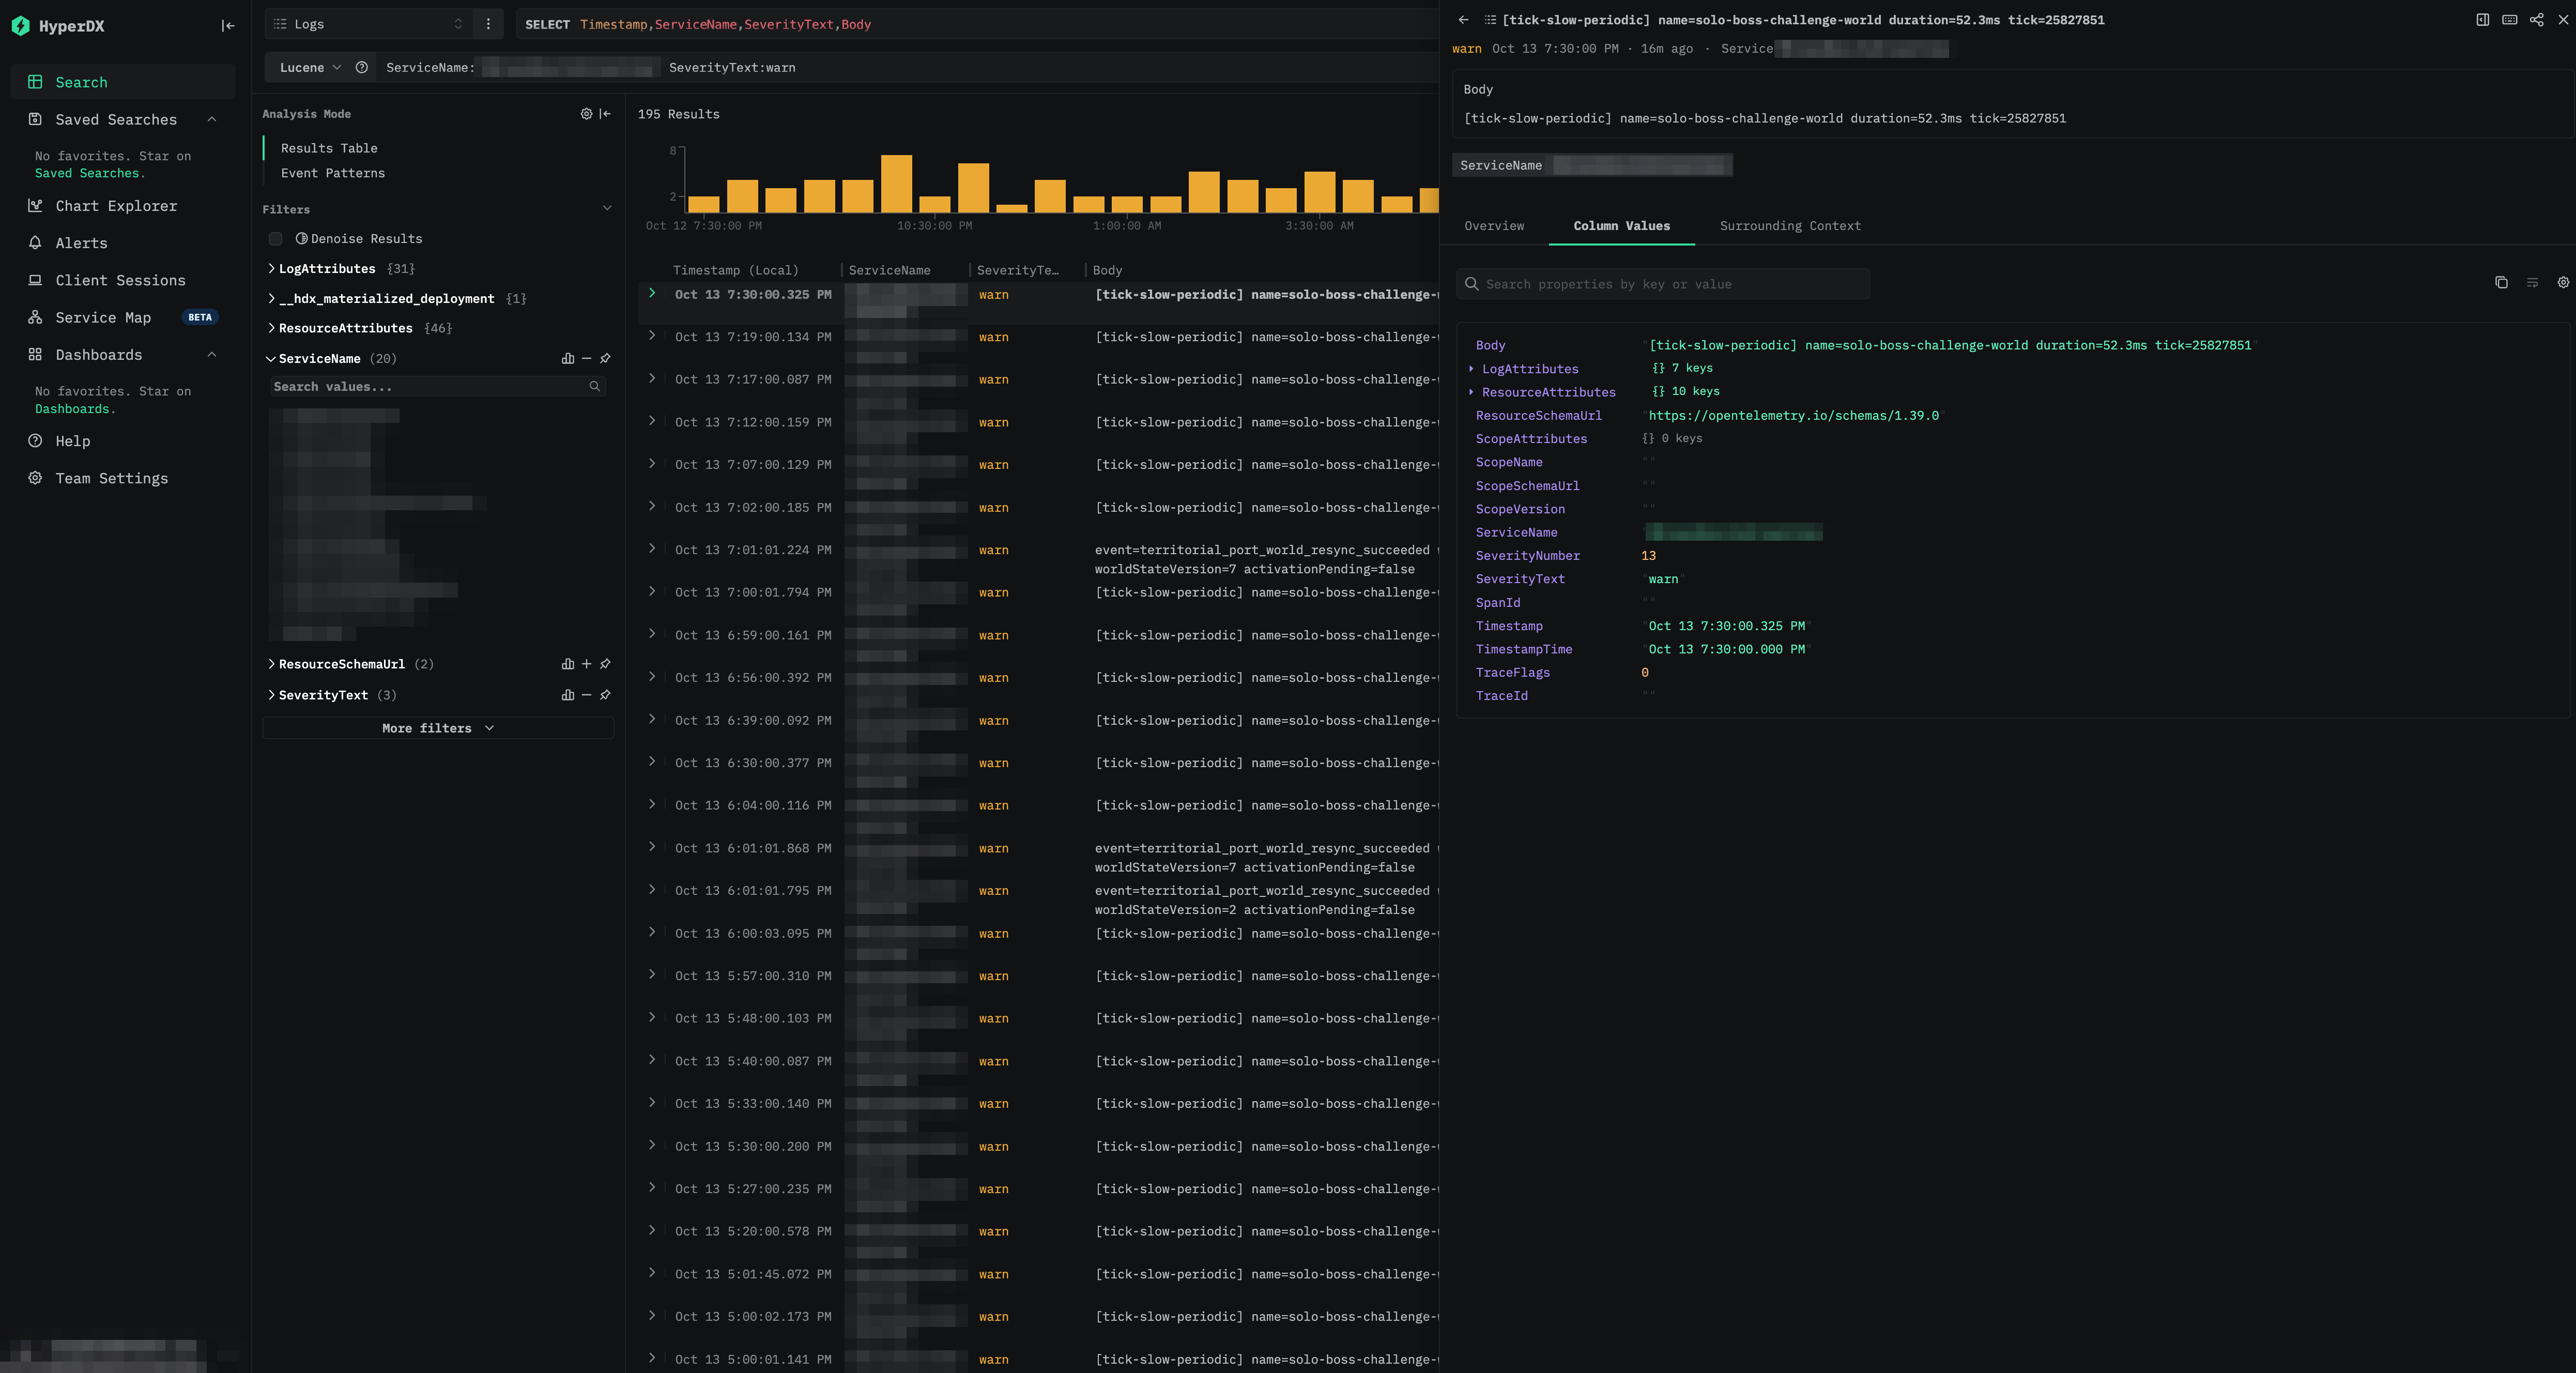
<HyperDX 로그 검색 화면>
- Grafana(Amazon ECS): Grafana는 Amazon ECS에서 운영하며 플랫폼 운영과 CloudWatch 연동을 맡습니다. ClickHouse 자체 상태와 수집 파이프라인, 그리고 RDS, ElastiCache, ALB, EC2 같은 AWS 리소스 메트릭을 여기서 확인합니다. 알람은 Grafana Alerting으로 게임별, 서비스별 Slack 채널에 보내고 대시보드 구성과 알람 규칙은 Terraform으로 관리합니다.
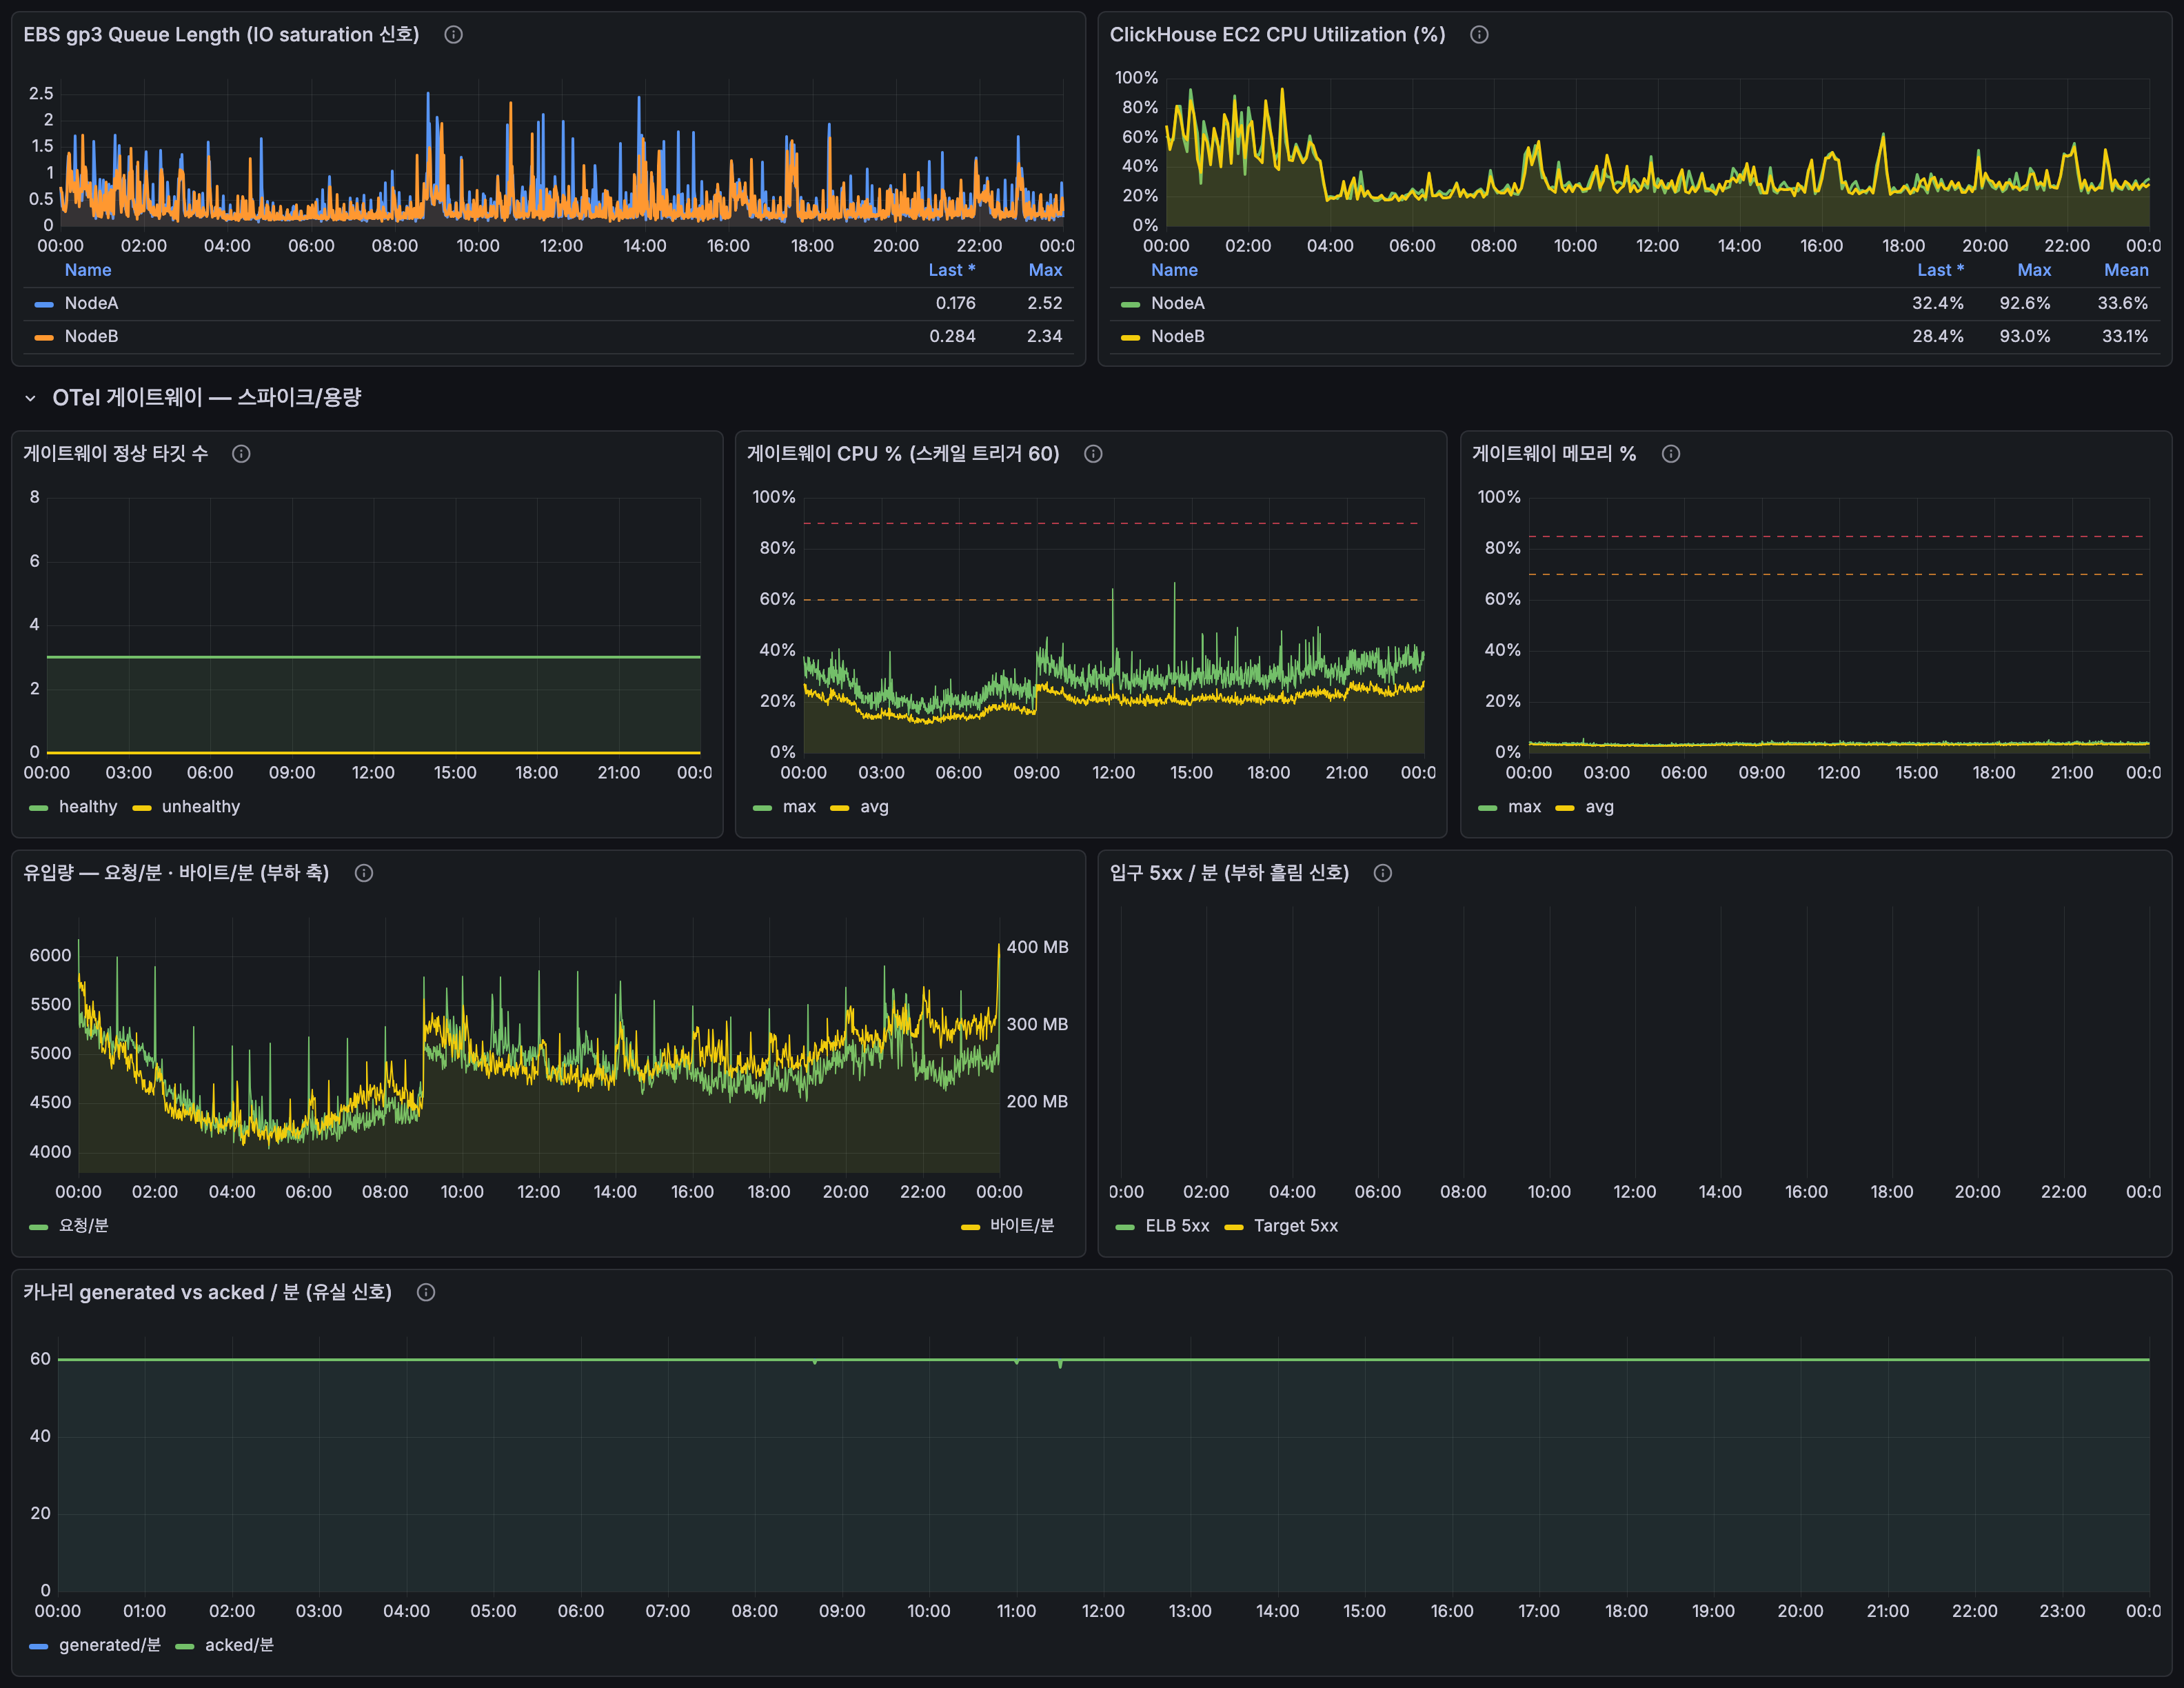
<Grafana 운영 대시보드: ClickHouse 노드와 수집 게이트웨이 상태, 카나리 유실 신호 등 모니터링>
3.4 알람을 더욱 촘촘하게(16개에서 170여 개로)
전환 전에 쓰던 알람은 16개였는데 지금은 170여 개로 늘었습니다. 늘어난 데는 기능보다 시점의 영향이 큽니다. 기존 SaaS 알람은 수집 에이전트를 걷어내면서 모두 멈췄기 때문에 전환하면서 알람을 처음부터 다시 만들어야 했고, 이 기회에 알람 대상 범위를 표준화했습니다. 다음으로 마케팅이나 채팅 같은 사내 서비스의 AWS 리소스 지표 알람도 같은 Grafana에 만들어 활용합니다. 마지막으로 직접 운영하는 파이프라인을 모니터링하는 알람을 만들었습니다. 이전에는 장애가 나면 카나리 알람 하나만 울려 원인을 찾는 데 75분이 걸렸습니다. 지금은 스토리지 임계치 포화, ClickHouse 메모리 부족, 수집기 비정상 종료 등 장애가 번지는 단계마다 알람을 두어 어느 단계에서 막혔는지 5분 안에 알 수 있습니다.
그 결과 이제 모든 게임과 사내 서비스 운영에 필요한 알람이 갖춰졌고 그 기준은 실제로 운영하면서 데이터 발생량에 맞춰 정합니다. 알람을 만들기 전에는 그 조건이 평소 얼마나 나오는지부터 SQL로 잽니다. 평소 거의 나오지 않는 프로세스 크래시나 결제, 지급, 환불 처리 실패는 1건만 나와도 바로 울리고 5xx는 급증할 때 울리도록 기준을 나눴습니다. 알람은 게임별 Slack 채널로 전달되어 그 게임을 맡은 사람이 바로 받아 봅니다.
알람 조건이 SQL이라서 “이 태그가 붙은 로그가 분당 몇 건 이상”처럼 원하는 조건을 그대로 쓸 수 있습니다. 아래는 특정 게임 서버의 5xx 급증 알람 쿼리입니다. 1분 동안 해당 태그가 붙은 로그가 10건을 넘으면 울립니다.
알람 쿼리는 건수와 함께 서로 다른 오류 메시지를 최대 5개까지 묶어 돌려줍니다. 그래서 Slack 알림만 보고도 무엇이 깨졌는지 바로 짐작할 수 있고 알림에 붙은 링크를 누르면 같은 조건이 걸린 HyperDX 검색 화면이 열립니다.
3.5 파이프라인 정상 운영 모니터링
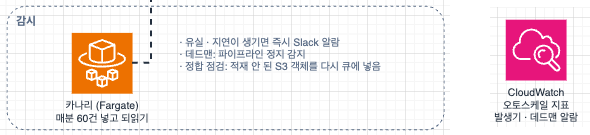
<감시 구간: 수집 계층과 분리된 카나리 Fargate와 CloudWatch 데드맨 알람>
게임듀오는 관측 파이프라인이 정상 작동하는지 다음 세 가지로 모니터링합니다.
- 카나리(Canary)*: Fargate 태스크가 1초에 1건씩 순번을 붙인 로그를 실제 게임 서버와 같은 경로(ALB, 게이트웨이, S3, Consumer)로 보내고 ClickHouse에서 다시 읽어 빠진 순번을 셉니다. 빠진 순번이 곧 유실 건수이고 5초 넘게 비면 Slack으로 알립니다. 카나리를 수집 계층과 분리된 Fargate에 둔 이유는 수집기나 ClickHouse가 멈출 때 지켜보는 쪽까지 함께 멈추지 않게 하기 위해서입니다.
* 카나리: 실제 경로에 합성 로그를 흘려 끝에서 되읽는 프로브입니다. 배포 기법의 카나리와는 다릅니다. - 데드맨 스위치(Dead Man’s Switch): 파이프라인이 멈추면(적재가 0이 되면) 울립니다. 카나리는 ClickHouse에서 자기 로그를 되읽을 때만 CloudWatch에 하트비트를 보내고 5분간 하트비트가 없으면 알람이 울립니다. 알람이 ClickHouse를 조회하는 방식이면 관측 스택이 통째로 멈출 때 알람도 같이 멈춥니다. 그래서 지켜보는 쪽(Amazon CloudWatch, Amazon SNS, AWS Lambda)은 관측 스택과 분리된 관리형 서비스로 구성했습니다.
- 정합성 점검(reconciliation): Amazon S3 이벤트 알림은 ‘최소 1회(At-least-once) 전달’ 방식으로 설계되어 있지만 드문 예외 상황에서는 알림이 누락되거나 중복될 수 있습니다. Consumer는 적재를 마친 Amazon S3 객체에 완료 태그를 붙입니다. Lambda는 매시간 태그 없이 15분 넘게 남아 있는 객체를 찾아 객체 정보를 큐에 다시 넣습니다. 그래서 S3 이벤트 알림이 드물게 누락돼도 데이터가 빈 구간으로 남지 않고, 이미 적재된 객체는 Consumer가 건너뛰므로 중복도 생기지 않습니다.
3.6 ClickHouse를 EC2에서 직접 운영한 세 가지 이유
SaaS의 편리함을 내려놓고 직접 운영하기로 한 결정에는 비용 외에 세 가지 이유가 있었습니다.
수집 경로는 어차피 사용자 몫이다.
SaaS 서비스가 보장하는 것은 데이터베이스 안쪽의 가용성입니다. 그런데 관측 데이터가 실제로 사라지는 곳은 그 바깥, 즉 게임 서버 에이전트에서 저장소 입구까지의 수집 경로입니다. 저장소가 멈춘 동안 들어오는 데이터를 받아 둘 곳은 관리형을 쓰든 직접 운영하든 사용자가 만들어야 합니다. 게임듀오는 이 수집 경로를 S3 우선 적재로 내구성 있게 만들면 저장소가 잠시 멈춰도 데이터를 잃지 않으므로 저장소 자체의 가용성은 직접 운영으로도 충분하다고 판단했습니다.
버전과 서버 설정을 직접 정할 수 있다.
새 버전을 테스트하던 중 HyperDX가 보내는 쿼리 형태에서만 나타나는 정렬 회귀를 만났습니다. 설정으로는 피할 수 없어 마이너 버전을 한 단계 내려 해결했는데 이는 업그레이드 시점과 롤백을 운영자가 정할 수 있어야 가능한 대응이었습니다. 통계 갱신 주기나 메모리 상한처럼 서버 단에서만 바꿀 수 있는 값도 직접 조정합니다.
데이터를 자사 계정 안에 둘 수 있다.
게임듀오의 로그에는 API 요청과 응답 본문이 그대로 들어가고 이것이 전체 용량의 70% 이상을 차지합니다. 외부 SaaS를 쓰면 이 본문이 그대로 제3자 인프라에 저장되고 보존 기간과 접근 통제, 삭제 시점을 그쪽 정책에 맞춰야 합니다.
실행 환경은 컨테이너가 아닌 EC2를 택했습니다. ReplicatedMergeTree는 각 노드가 자기 디스크와 정체성을 유지해야 하므로 태스크가 교체되는 컨테이너보다 Amazon EBS를 붙인 EC2 인스턴스가 이 요건에 맞기 때문입니다. 전체 파이프라인을 직접 구축하고 운영하는 부담은 IaC와 알람, 모니터링 AI 에이전트로 극복할 수 있다고 판단했습니다.
4. 전환 과정과 안정화
전환은 빅뱅이 아니라 병행 운영으로 진행했습니다. 2025년 7월 Loki 시도부터 치면 1년 남짓, 2026년 4월 ClickStack 구축 기준으로는 약 6개월이 걸렸습니다. 라이브 게임을 하나씩 옮기며 기존 SaaS와 나란히 돌린 기간은 8월 말부터 9월 말까지 한 달 남짓입니다. 온보딩은 각 게임 담당 개발자가 에이전트 설정을 배포에 포함시키는 것이 전부라서 기술보다 일정 조율에 시간이 더 들었습니다. 과거 로그는 마이그레이션하지 않았습니다. 기존 아카이브가 S3 Glacier Deep Archive에 그대로 있어 필요하면 복원해서 봅니다.
4.1 초기 운영에서 배운 것
초기에는 ClickHouse의 파트와 머지, TTL 동작을 운영하면서 배웠습니다. 대형 테이블의 TTL 변경이 기존 파트 전부를 재작성한다는 점이나 백필은 사용자가 적어 리소스가 여유 있는 시간에 해야 한다는 점 같은 것들입니다. 배운 것은 매번 절차와 알람으로 남겼고 이것이 이후 운영 자동화의 바탕이 됐습니다.
대표적인 예가 TTL 변경입니다. 운영 중인 로그 테이블의 TTL을 수정했더니 두 노드가 모두 응답을 멈췄습니다. 확인해 보니 기본 설정에서는 이 변경이 기존 파트 전체를 다시 쓰는 작업으로 이어지는데 82GiB를 다시 쓰기 시작하면서 두 노드가 멈춘 것이었습니다. 그 뒤로 TTL을 바꿀 때는 materialize_ttl_after_modify = 0으로 기존 파트를 건드리지 않고 새 규칙이 머지 과정에서 천천히 적용되게 합니다.
백필에서도 같은 교훈을 얻었습니다. 밀린 데이터를 낮 시간에 한꺼번에 다시 넣었다가 당시 2 vCPU였던 노드가 30분 가까이 응답하지 않았습니다. 그 뒤로 백필과 의도적인 재기동은 게임 트래픽이 적은 새벽부터 오전 사이에 합니다.
버전 기본값이 발목을 잡은 적도 있습니다. 당시 운영하던 ClickHouse 26.4의 자동 컬럼 통계는 5분마다 모든 파트의 통계 파일을 다시 읽습니다. S3에 있는 콜드 파트는 읽는 데 시간이 걸려 한 번에 4~5분씩 파트 잠금을 잡았고 그동안 INSERT 커밋이 2~5초씩 밀렸습니다. 통계 생성은 그대로 두고 주기 갱신만 꺼서 해결했습니다.
4.2 직접 INSERT 구조의 한계
전환 초기에는 게이트웨이가 받은 데이터를 ClickHouse에 바로 INSERT했습니다. 물량이 예측 범위 안에 있을 때는 문제가 없었습니다.
그러던 중 라이브 게임 이관과 신규 게임 오픈이 겹치면서 일별 파티션이 며칠 사이 세 배 가까이 커졌습니다. EBS가 차면서 ClickHouse가 S3로 파트를 옮기기 시작했고 그 부하가 직접 INSERT하던 게이트웨이에 그대로 전달돼 메모리 압박으로 이어졌습니다. 카나리가 이 상황을 즉시 감지했습니다. 파트가 S3로 옮겨진 원인을 따라가 보니 파티션이 커지면서 150GB가 넘는 머지 하나가 두 시간 넘게 디스크 공간을 예약하고 있었습니다. 실제 사용률은 78%였지만 예약분 때문에 ClickHouse는 여유 공간이 부족하다고 판단했습니다. 머지 최대 크기를 50GB로 낮춰 이 문제는 바로 막았습니다.
여기서 얻은 교훈은 두 가지입니다. 하나는 용량 산정 방식입니다. 기존 SaaS 화면의 message 길이를 원문 크기로 착각해 저장량을 몇 배 낮게 잡았던 것입니다. 직접 운영해 봐야 정확히 알 수 있던 내용이었고 이후로는 온보딩 전에 바이트 기준으로 측정합니다.
다른 하나는 구조입니다. 게이트웨이가 저장소에 직접 쓰면 저장소의 부하가 수집 경로의 가용성에 영향을 미칩니다. 그래서 수집 경로와 저장소 사이에 내구성 있는 버퍼가 필요했습니다.
4.3 S3 우선 적재로 재설계
이때부터 인스턴스 크기가 아니라 수집 경로의 가용성에 집중했습니다. 게이트웨이가 받은 데이터를 S3에 먼저 쓰고 성공하면 에이전트에 200을 돌려주는 구조로 바꿨습니다. ClickHouse 적재는 S3 이벤트와 SQS를 거쳐 비동기로 진행됩니다.
프로덕션 전환은 단계적으로 검증했습니다. 새 경로를 별도 테이블에 일정 시간 병행 적재해 시간별 건수가 100% 일치하는지 확인했고 카나리와 데드맨 알람을 붙인 뒤 전환했습니다. S3 원문으로 ClickHouse를 다시 만드는 복구 테스트도 두 번 했는데 AI 코딩 에이전트와 함께 하루 만에 테스트를 마치고 다음 날 전환했습니다.
프로덕션 전환 후에는 비용 절감을 위해 인스턴스 크기를 줄여야 했습니다. 하루에 여러 번 노드를 재기동하고 다음 날 데이터 볼륨을 통째로 교체했는데 두 번 모두 카나리 누락이 0이었습니다. ClickHouse가 몇 분 멈춰도 데이터는 S3와 SQS에서 기다리고 살아나면 이어서 적재됩니다. 이 안정성을 확인한 뒤에는 더 작은 EBS 볼륨으로 단계적으로 교체하고 트레이스 압축을 켰습니다.
5. 결과
5.1 비용: 기존 대비 절반 이하로
게임듀오의 관측 비용은 기존 대비 절반 이하로 줄었습니다. 기존 시스템은 실제로 사용하던 호스트 모니터링과 로그만 계산한 값이고 신규 시스템은 트레이스와 메트릭, 세션 리플레이까지 포함한 값입니다. 따라서 같은 범위로 비교하면 절감 폭은 이보다 큽니다. AWS 쪽 비용은 관측 스택만 있는 모니터링 계정의 청구서를 기준으로 EC2, EBS, S3(보관, 요청, 회수), 데이터 전송, 로드밸런서, Fargate, NAT까지 사용 유형별로 합산한 값입니다.
더 중요한 것은 서비스 확장에 따른 비용 증가율이 낮아졌다는 점입니다. 이전에는 로그가 늘면 비용이 정비례로 늘었습니다. 지금 구조에서 EC2 인스턴스는 고정비에 가깝고 로그가 늘면 최근 7일치를 담는 Amazon EBS와 S3 저장 및 요청, 수집 계층(Fargate) 비용이 늘어납니다. 그래도 증가 폭이 완만해서 보관량이 쌓이는 1년 뒤에도 현재의 1.2배 안쪽일 것으로 예상합니다.
5.2 가시성: 보존 기간과 수집 범위 확대
이 프로젝트로 검색 가능한 범위가 15일에서 180일로 늘었습니다. 비용 때문에 사용하지 못했던 분산 트레이싱도 쓸 수 있게 되어 버그나 장애 원인을 찾는 시간이 현격히 줄었습니다. 특히 서버에 접속해 로그 파일을 여는 일은 거의 없어졌습니다.
| 항목 | 전환 전 | 전환 후 |
|---|---|---|
| 검색 가능 보존 | 15일 | 로그 180일, 트레이스 30일 |
| 분산 트레이싱 | 미사용(비용) | 주력 게임과 초기 프로젝트에 적용, 확대 중 |
| 수집 대상 | 라이브 게임만 | 샌드박스, 운영 도구, 오토스케일 서버 포함 |
| 서비스 수 | 라이브 게임 서버 위주 | 약 200개 |
| 알람 | 16개 | 170여 개 |
| 세션 리플레이 | 미사용 | 운영 콘솔 어드민 조작 리플레이 |
호스트가 늘어도 추가 요금이 붙지 않고 로그가 늘어도 비용이 크게 늘지 않으니 서비스와 트레이스를 부담 없이 추가할 수 있었습니다. 그 결과 총 건수는 비슷한데 보이는 범위는 넓어졌습니다.
5.3 운영과 디버깅 방식의 변화
게임 서버 로그에 요청과 응답 본문이 그대로 있어서 엔드포인트별 집계나 문의가 들어온 이용자의 요청 흐름 재현을 SQL 한 번으로 할 수 있습니다. 각 팀은 라우트별 응답시간, 느린 요청 Top 100, 기능별 실패 로그 추적 같은 대시보드를 그 위에 직접 만들어 씁니다.
트레이스를 켠 프로젝트에서는 요청 하나가 어떤 DB 호출과 외부 호출에 시간을 쓰는지 워터폴로 봅니다. 운영 콘솔(웹)은 HyperDX의 Client Sessions로 어드민 조작을 세션 리플레이로 되돌려 봅니다.
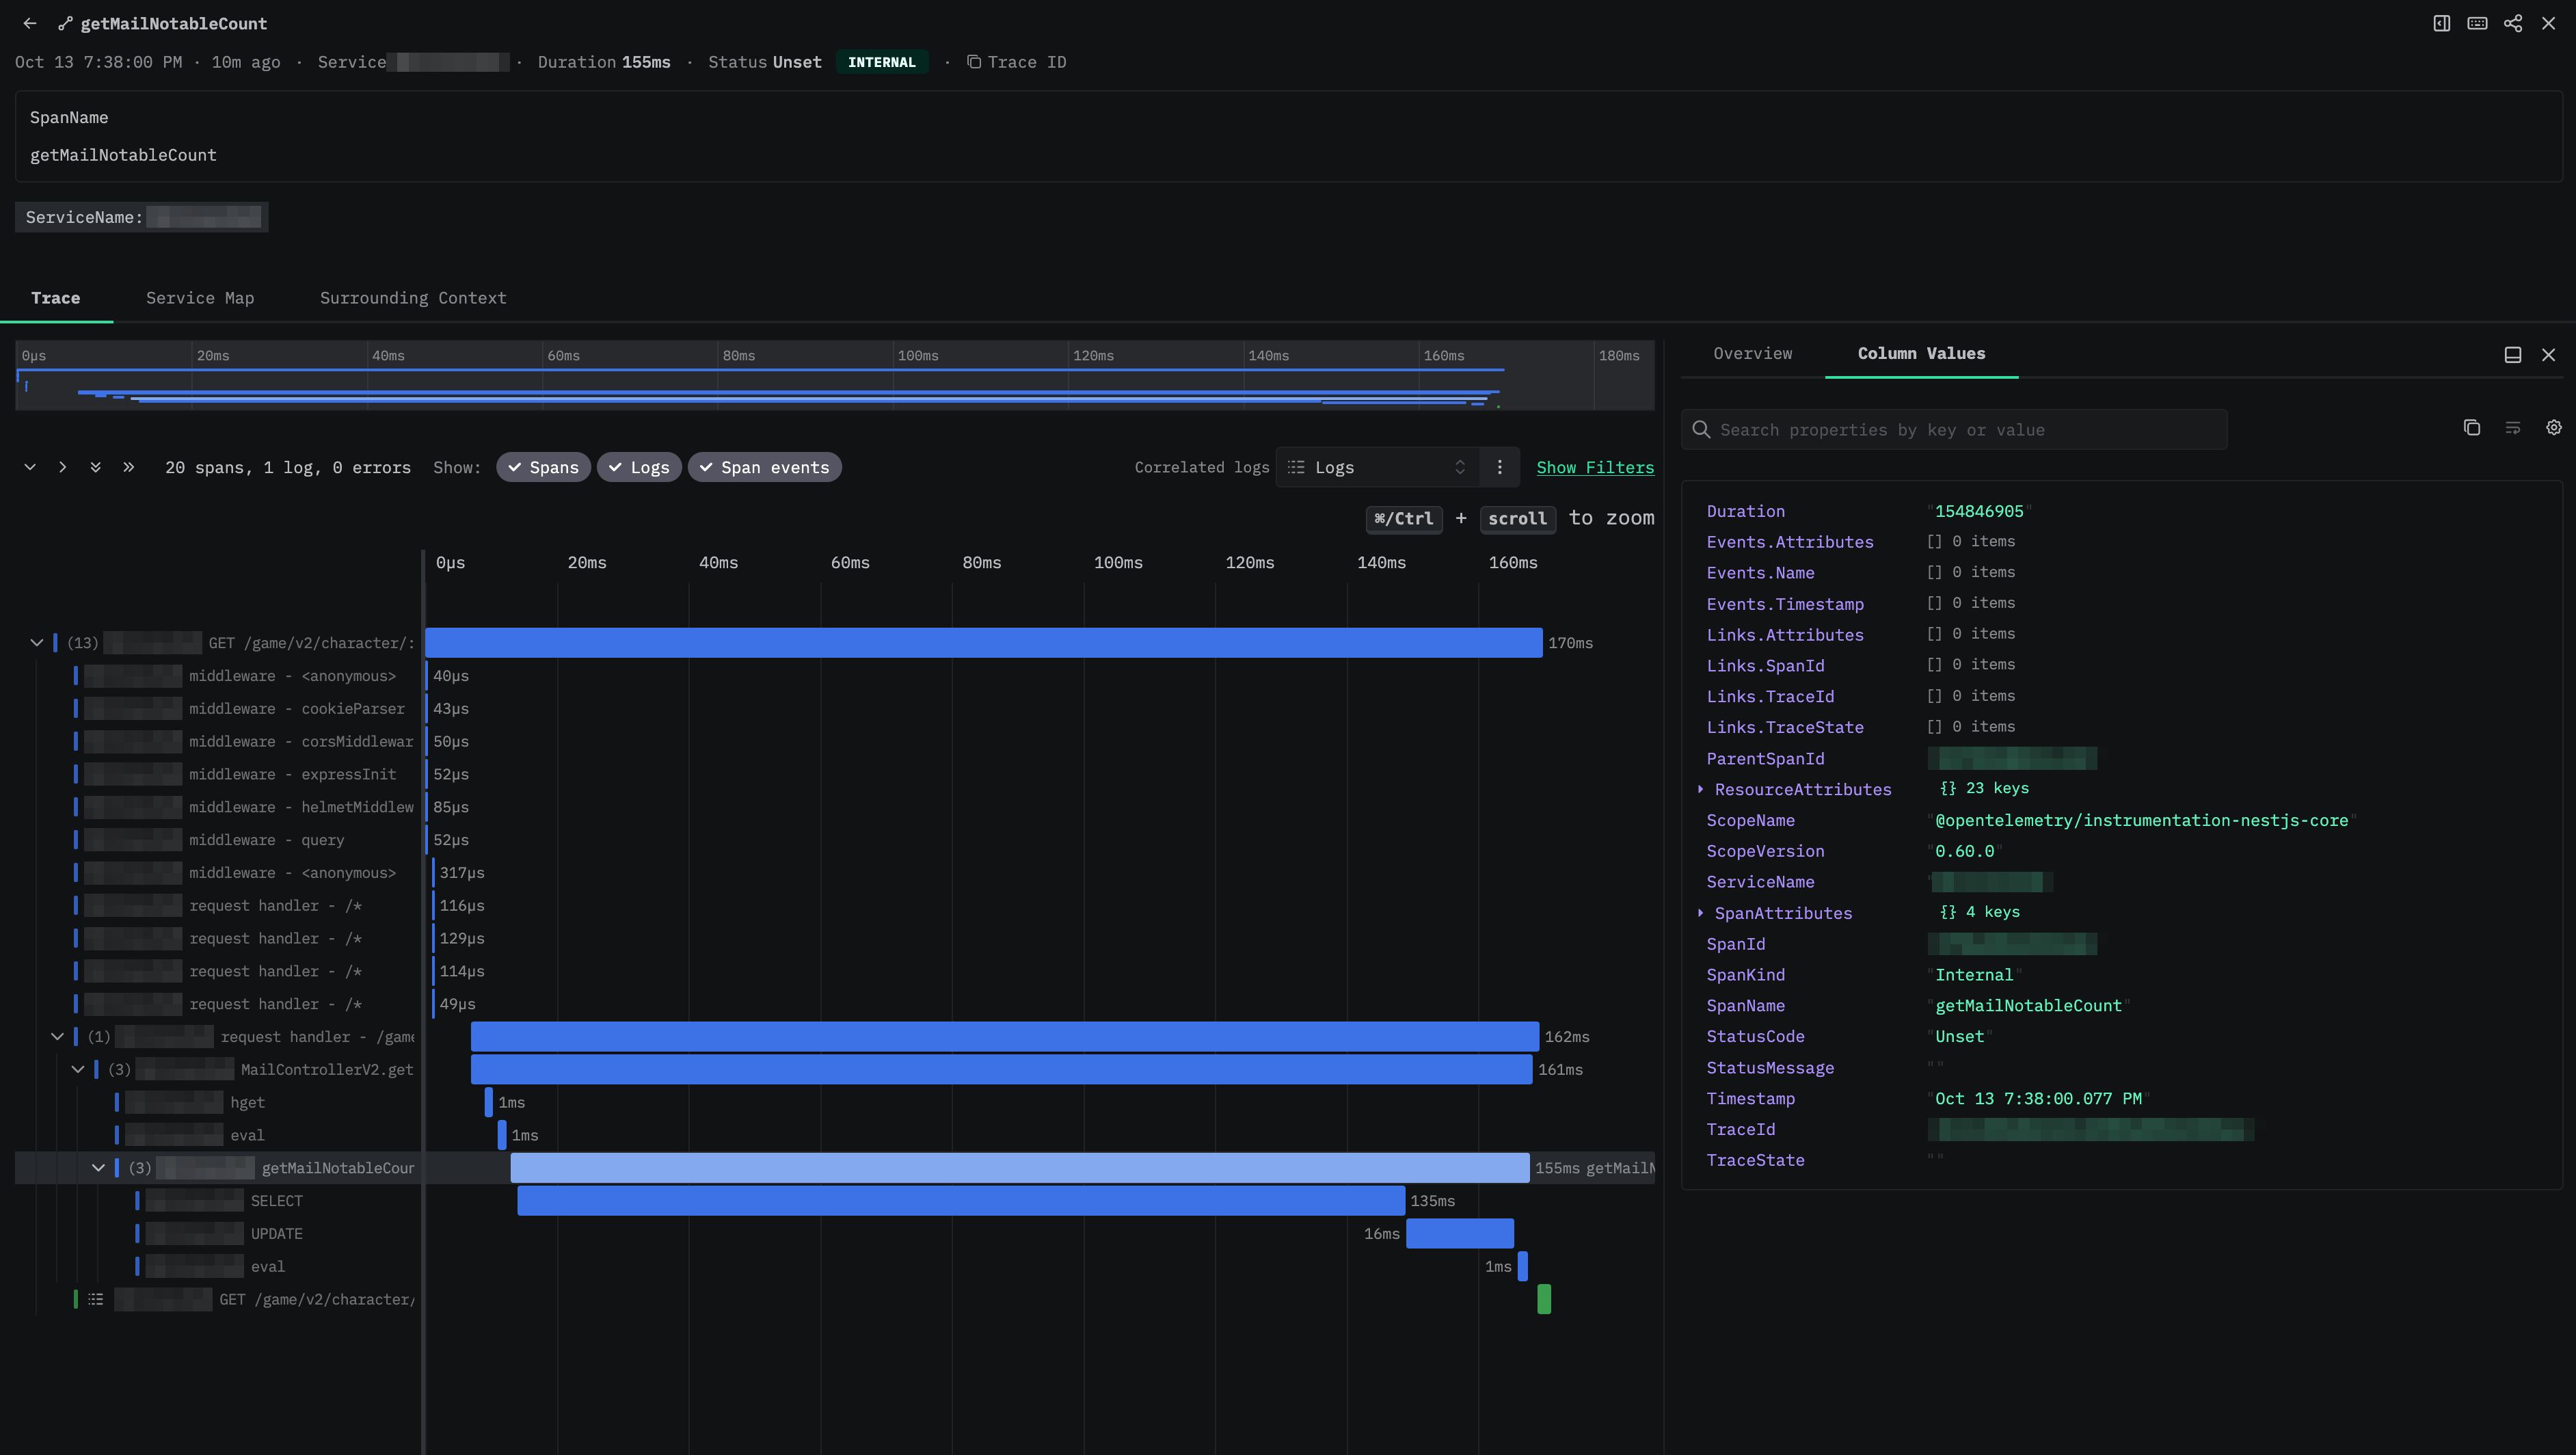
<HyperDX 트레이스 워터폴 예: 170ms 요청 중 DB 조회가 135ms를 차지>
HyperDX가 MCP(Model Context Protocol) 서버를 제공하므로 AI 에이전트가 장애 때 로그와 트레이스를 직접 쿼리해 원인을 좁혀 옵니다. “어제 새벽 이 게임 5xx가 왜 튀었나”를 물어보면 서비스별 건수와 오류 패턴, 해당 트레이스까지 따라가서 답을 가져옵니다. 서창민 팀장은 이것을 원인 추적에서 가장 큰 변화로 꼽았습니다.
6. 운영에서 얻은 다섯 가지 교훈
1. 관측 파이프라인은 첫날부터 스스로를 감시해야 한다.
파이프라인의 문제는 조용히 생깁니다. 순번 로그를 흘려 되읽는 카나리와 적재가 멈추면 울리는 데드맨을 첫날부터 두어야 합니다. 9월 초 수집 경로의 한계를 즉시 알 수 있었던 것도 카나리 덕분이었습니다.
2. 수집 경로와 저장소 사이에 내구성 있는 버퍼를 둔다.
저장소에 직접 INSERT하면 저장소의 부하가 수집 경로로 그대로 전달됩니다. Kafka가 더 알려진 선택지지만 운영 경험이 없었기에 검증된 관리형 서비스 조합이면서 원문 보관까지 겸하는 S3+SQS를 선택했고 지금까지 안정적으로 운영하고 있습니다.
3. 가장 큰 비용 레버는 인스턴스가 아니라 로그 스키마다.
로그 용량의 70% 이상이 요청과 응답 본문이었습니다. 어떤 필드를 남기고 어디까지 잘라낼지 미리 명확히 정했다면 인프라 최적화에 쓴 시간을 줄일 수 있었을 것입니다.
4. 에이전트와 SDK가 압축을 켜고 보내는지 첫날 확인한다.
애플리케이션 SDK가 트레이스를 비압축 JSON으로 보내고 있던 것을 뒤늦게 찾았습니다. gzip을 켜자 트레이스 유입량이 90% 넘게 줄었고 로드밸런서 요금도 절반 아래로 내려갔습니다.
5. 버전과 스키마 변경은 운영 테이블에서 바로 하지 않는다.
새 버전은 복제본 한 대에 먼저 올리고 실제 쿼리 로그를 재생해서 확인한 뒤 나머지에 올립니다. 큰 테이블의 TTL이나 스키마 변경은 기본 동작이 기존 파트 전부 재작성이라서 수백 GB 테이블에서 그대로 실행하면 노드가 응답을 멈출 수 있습니다. 변경은 머지 때 천천히 적용되게 하고 즉시 적용이 필요하면 파티션 단위로 나눠 한산한 시간에 합니다.
7. 결론
게임듀오는 개발자 한 명이 Amazon EC2 위에 ClickStack을 구축해 250대가 넘는 게임 서버의 로그와 트레이스를 자체 관측 스택으로 옮겼습니다. 관측 비용은 기존 대비 절반 이하로 줄었고 로그 보존은 15일에서 180일로 늘었으며, 비용 때문에 미뤄 두었던 분산 트레이싱도 켤 수 있게 됐습니다. 게이트웨이가 S3에 먼저 쓰고 성공해야만 응답하는 구조 덕분에 ClickHouse 노드를 재기동하고 볼륨을 교체하는 동안에도 데이터 유실은 없었습니다.
물론 공짜는 아니었습니다. SaaS였으면 겪지 않았을 운영 이슈를 직접 다뤄야 했고 자동 이상 탐지와 서비스 맵 화면을 대신할 AI 봇과 추가 대시보드도 개발했습니다. 대신 데이터 통제권과 원문이 자사 계정에 있다는 안심, 그리고 호스트와 로그가 늘어도 요금이 따라 늘지 않는 비용 구조를 얻었습니다.
늘어난 운영 부담은 AI 코딩 에이전트 활용과 자동화로 상당 부분 상쇄했습니다. 인프라는 전부 Terraform으로 관리하고 main에 머지되면 GitHub Actions가 적용합니다. 알람 170여 개, 카나리, 데드맨, 매일 아침 오류 리포트, 콜드 티어 이동과 TTL, EBS 확장 시 파일시스템 확장까지 사람 손을 거치지 않습니다. Terraform IaC 도입 과정에서는 AWS 계정팀이 제공한 IaC 워크숍이 많은 도움이 되었습니다.
이제 AI 코딩 에이전트는 운영의 한 축입니다. Terraform 코드 작성, ClickHouse 시스템 테이블 진단, 복구 리허설 스크립트, 청구 데이터 분석, 알람 SQL, 문서화를 에이전트와 함께 합니다. 파이프라인 병목을 디버깅하거나 아키텍처 변경을 시뮬레이션하는 데도 많이 활용합니다. 다만 에이전트도 틀릴 때가 있습니다. 서브넷을 AZ로 착각해 존재하지 않는 절감을 예측에 넣거나 아키텍처 변경 후 비용을 15% 넘게 낙관적으로 예측한 적이 있었습니다. 그래서 “비용 예측은 청구서로 역검증한다”가 팀의 규칙이 됐습니다.
다음 단계는 정해져 있습니다. 트레이스를 나머지 게임에도 켜고 서버 에이전트를 거쳐 압축해 내보내는 방식을 전 게임에 적용합니다. 호스트 메트릭 수집도 전 서버로 넓힐 예정입니다. 클러스터는 당분간 2노드로 충분하므로 확장보다 로그 최적화를 먼저 진행하려 합니다. 로그 용량의 70% 이상을 차지하는 요청과 응답 본문 중 무엇을 남길지 게임팀과 협의할 예정입니다.
같은 고민을 하는 게임사에게 전하는 서창민 팀장의 조언으로 마무리합니다.
“로그 컨벤션이 게임마다 제각각이라 관측 스택 전환을 미루고 계신다면 오히려 지금이 쉽습니다. ClickStack은 JSON을 적재 시점에 한 번 풀어서 필드로 저장하기 때문에 스키마를 미리 통일하지 않아도 데이터가 들어오고 SQL로 뭐든 물어볼 수 있습니다. 저희도 게임 코드는 하나도 고치지 않고 10여 종 게임의 로그를 받았습니다.
인원이 없다는 이유로 SaaS에 머물 필요도 줄었습니다. AI 코딩 에이전트에 Terraform과 관측 도구를 MCP로 붙이면 소규모 팀도 설계부터 구축, 운영, 사고 대응까지 감당할 수 있습니다. 다만 물량 산정과 청구서 검증, 운영에서 배우는 것은 여전히 사람 몫입니다. 그것만 지키면 비용은 크게 줄고 데이터는 사내 계정 안에 머물며, 비용 때문에 미뤄 뒀던 트레이스 같은 기능도 그냥 켤 수 있게 됩니다.”
참고 자료
- ClickStack: The ClickHouse Observability Stack
- OpenTelemetry Collector Contrib
- Amazon S3 이벤트 알림
- ClickHouse: External Disks for Storing Data (S3)
- ClickStack 배포 옵션
- Amazon S3 스토리지 클래스 이해(Standard-IA, Glacier Deep Archive)
- Amazon S3 수명주기 전환 시 고려 사항(객체 수 비례 전환 요금)
- Amazon S3 Object Lock
- Amazon SQS 가시성 제한 시간(Visibility Timeout)
- Amazon SQS에서 배달 못한 편지 대기열 사용
- AWS Fargate Spot 용량 공급자와 중단 알림
- CloudWatch 경보가 누락 데이터를 처리하는 방법 구성
- AWS Graviton 프로세서
저자 소개
서창민
서창민 팀장은 게임듀오 DEV팀에서 게임 서버 개발과 함께 AWS 인프라 운영, 모니터링, 클라우드 비용 관리를 맡고 있습니다. 팀의 개발 생산성과 안정적인 게임 운영 효율을 함께 높이는 것이 주된 관심사입니다.