AWS 기술 블로그
하나의 플랫폼으로 두 가지 에이전트 런타임 운영하기: 웅진씽크빅의 Amazon Bedrock AgentCore 및 Amazon EKS 기반 플랫폼 구축기
들어가며
AI 에이전트 개발에 대한 수요가 폭발적으로 증가함에 따라 사내 AI 에이전트 및 기반 환경을 관리하기 위한 플랫폼에 대한 관심도도 증가하고 있습니다. AI 에이전트를 개발하기 위해서는 업무에 필요한 도구를 연결하고, 대화 이력을 관리하고, 실행 환경에 배포한 뒤 사용자가 실제로 응답을 받을 수 있는지 확인하는 등 일련의 작업이 요구되며, 에이전트가 늘어날수록 이러한 공통 기능을 여러 팀이 재사용할 수 있는 운영 기반이 필요합니다.
웅진씽크빅 AX연구소는 교육 데이터를 기반으로 AI Ready Data 환경을 구축하고, AI 서비스와 Agent를 통해 전사 AI 전환을 추진하는 조직입니다. AI와 데이터 기술을 실제 서비스와 사내 업무에 적용하는 조직으로서 AX연구소는 이러한 문제를 해결하기 위해 AWS 기반의 AI 에이전트 플랫폼을 구축하였습니다. 이 플랫폼에서 사용자는 사내 표준을 준수하면서도 Amazon Bedrock AgentCore 혹은 기존 운영 체계 상의 Amazon EKS를 기반으로 에이전트와 MCP 서버를 등록하고, 지식 기반과 메모리를 연결하며, 배포와 테스트까지 수행할 수 있습니다.
이 글에서는 Amazon AgentCore 배포 및 운영 방식을 플랫폼 형태로 구현하고, 기존 사내 운영 환경과 통합하기 위해 Amazon EKS 기반으로 확장한 과정을 살펴봅니다.
프로젝트 배경
웅진씽크빅은 사내 업무별 AI 에이전트가 늘어나면서 여러 팀이 반복해서 배포하고 운영할 수 있는 체계가 필요했습니다. 특히 기존의 에이전트 개발 및 운영 파이프라인에는 다음과 같은 문제가 있었습니다.
1. 반복되는 배포 준비
팀마다 에이전트 코드를 작성하고, 컨테이너 이미지 빌드 파이프라인과 배포 스크립트를 준비해야 했습니다. 에이전트의 업무 목적이 달라도 실행까지 필요한 준비 과정은 유사했습니다. 새 에이전트를 만들거나 기존 에이전트의 설정을 바꿀 때마다 이러한 작업을 반복해야 했으므로, 업무별 기능 개발에 더해 배포를 위한 공통 구현에도 노력이 들어갔습니다.
2. 에이전트와 도구의 재사용 어려움과 중복 구현
기존에는 어떤 에이전트가 어떤 업무 도구를 쓰는지, 배포된 버전과 연결 설정이 무엇인지 한 곳에서 파악하기 어려웠습니다. 도구 연결에는 입출력 형식, 자격 증명, 접근 가능 여부를, 대화와 문서 기반 답변에는 장단기 메모리와 지식 저장소를 함께 준비해야 했는데, 이를 에이전트마다 따로 구현하다 보니 관리 지점과 반복 개발이 늘고 재사용도 어려웠습니다. 그래서 이런 공통 기능을 업무 로직과 분리해 사내 공용 자산으로 관리할 기반이 필요했습니다.
3. 기존 Amazon EKS 운영 체계와 따로 관리해야 하는 부담
웅진씽크빅은 이미 Amazon EKS, ArgoCD, Helm, Jenkins를 활용하는 배포/운영 체계를 갖추고 있었으며, EKS에서 실행 중인 에이전트와 MCP 서버도 있었습니다. 새로운 플랫폼은 이들 워크로드의 내부 통신과 기존 배포 방식을 함께 수용해야 했습니다.
이러한 배경에서 반복되는 개발/배포 준비를 줄이고, 에이전트와 도구의 연결 관계를 한 곳에서 관리하며, 대화와 지식 저장소 기능을 재사용하는 것을 플랫폼의 목표로 정했습니다.
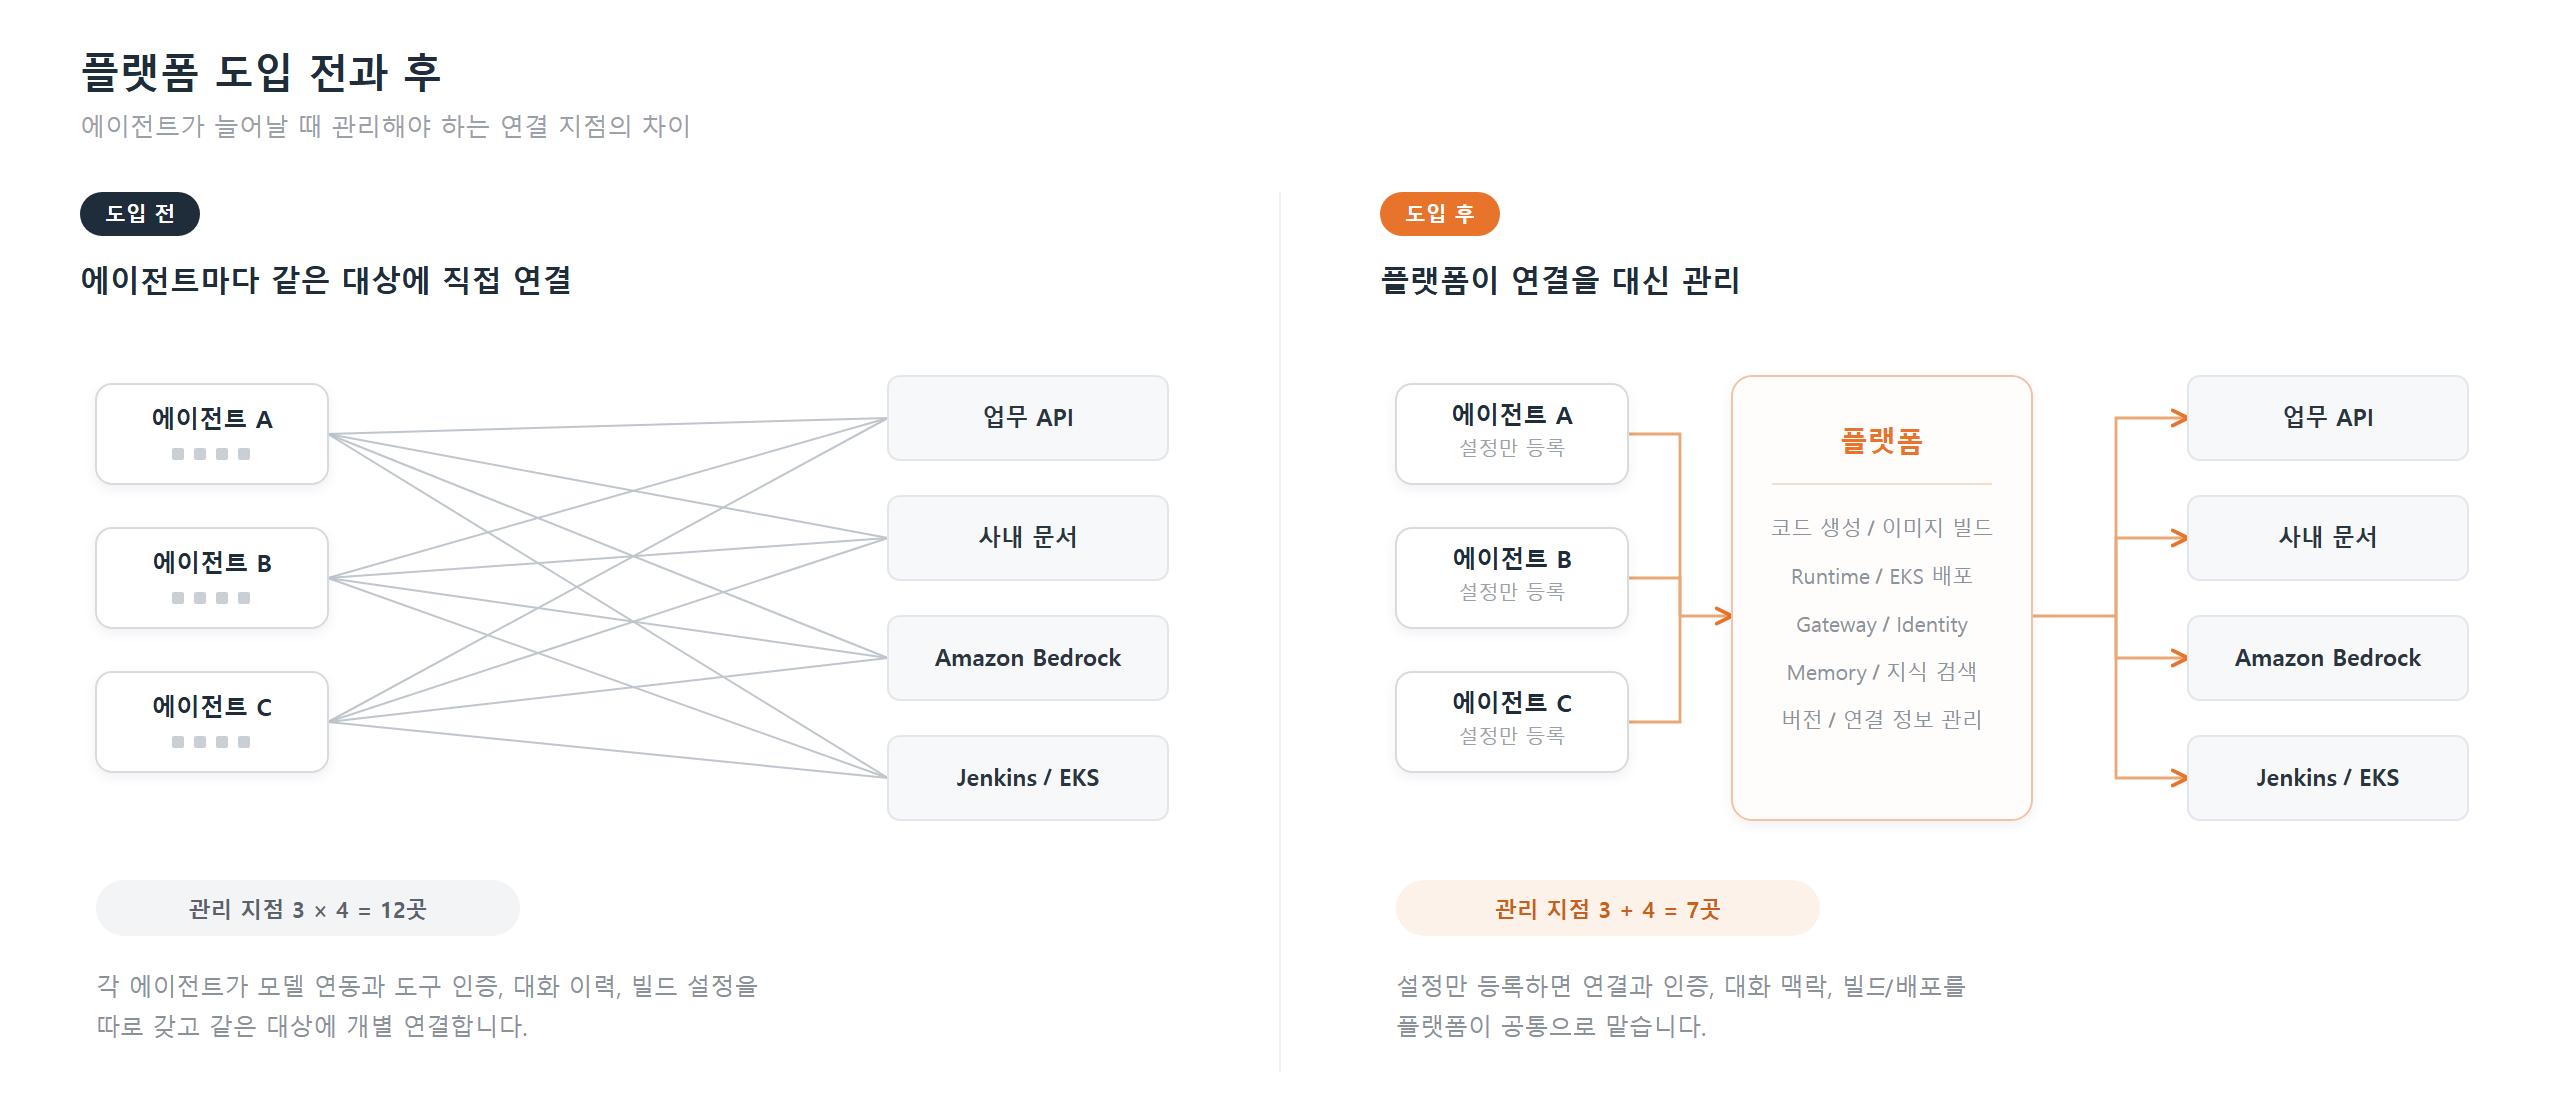
그림 1. 플랫폼 도입 전후로 달라지는 연결 관리 구조.
솔루션 아키텍처
솔루션은 에이전트와 관련 리소스들의 설정과 배포를 관리하는 관리 영역, 컨테이너 이미지를 만드는 빌드 영역, 배포된 에이전트가 질문을 처리하는 실행 영역으로 구성됩니다. 관리 영역은 모델, 지시문, MCP, 지식 기반의 연결 정보를 보관하고, 빌드 영역은 이 설정을 실행 가능한 코드와 이미지로 바꿉니다. 실행 영역에서는 Strands Agents 에이전트가 Amazon Bedrock 모델을 호출하고, 필요한 경우 업무 도구와 지식 검색을 사용합니다.
아래의 아키텍처는 에이전트 설정 및 질의가 AgentCore Runtime의 배포 및 실행으로 이어지는 흐름입니다. 앞쪽에서는 관리 화면의 설정이 실행 소스와 이미지로 바뀌어 Runtime에 배포됩니다. 뒤쪽에서는 사용자의 질문이 백엔드를 거쳐 배포된 Runtime으로 전달되고, 에이전트가 모델과 필요한 도구를 사용합니다. Runtime과 AgentCore Memory를 잇는 선은 대화 맥락을 위해 단기 기억(최근 대화 이벤트)을 복원하고 장기 기억(대화 요약)을 조회하는 관계를 나타냅니다.
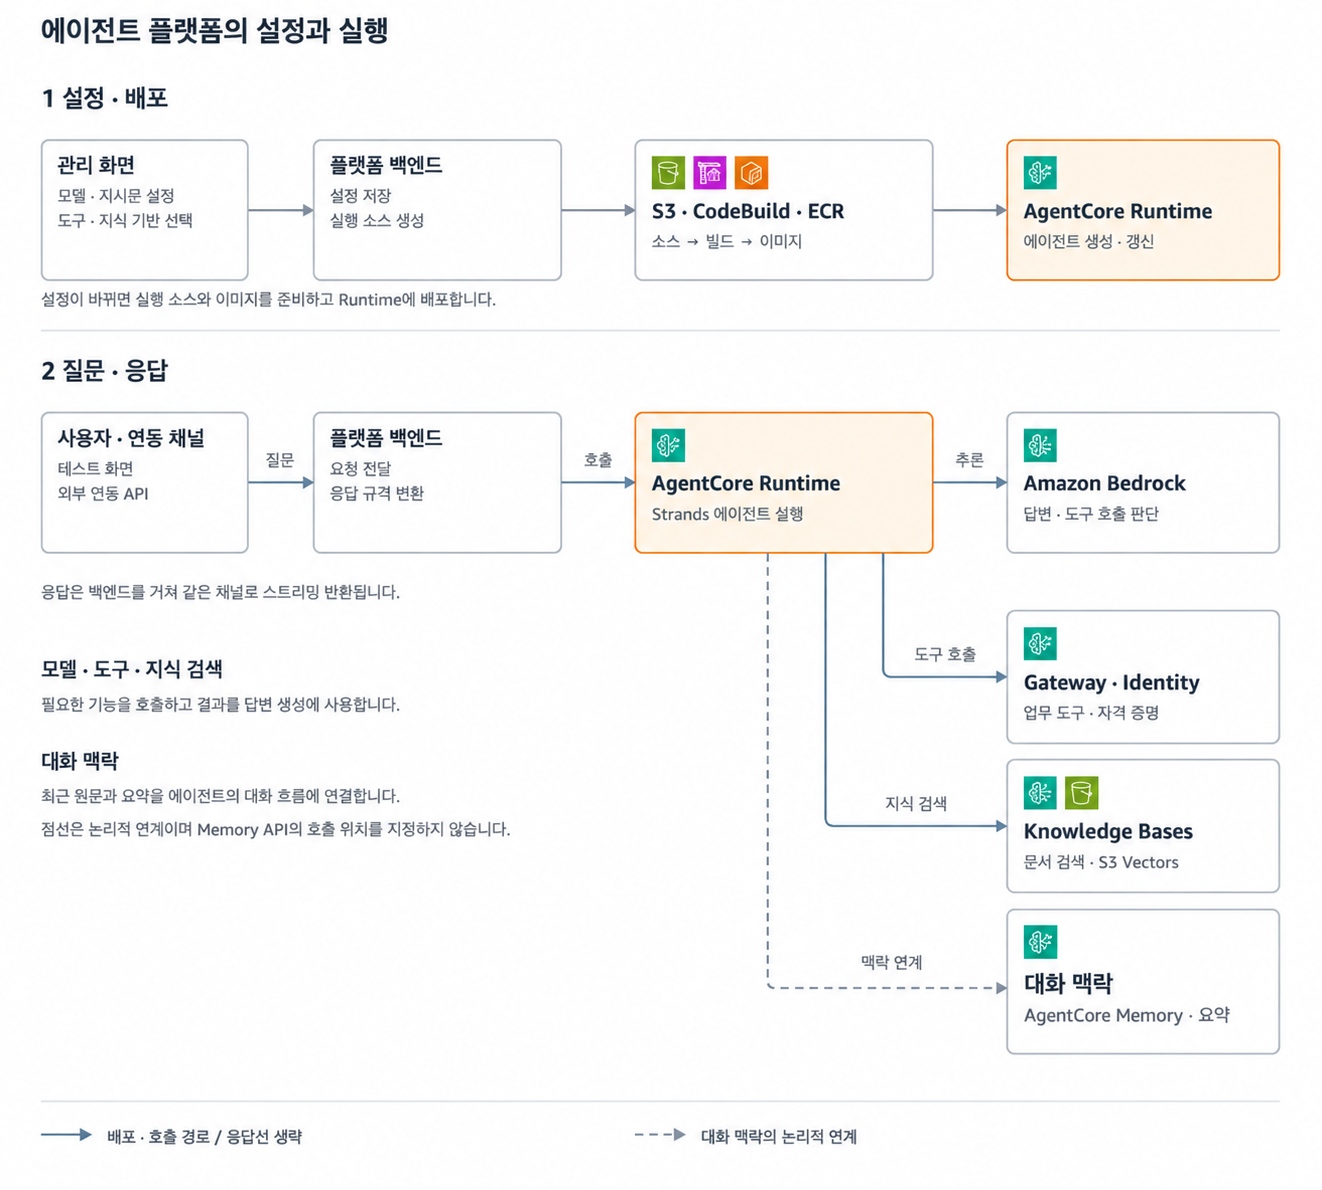
그림 2. 에이전트 설정에서 이미지 빌드, AgentCore Runtime 배포와 호출로 이어지는 논리 구성.
관리 화면
에이전트 목록에서는 등록된 에이전트의 모델, 버전, 연결된 MCP와 지식 기반 수, 생성/수정 정보를 확인할 수 있습니다. 화면 상단의 ‘새 Agent’ 버튼 옆 메뉴에서 AgentCore 또는 EKS를 선택해 해당 배포 대상의 에이전트 생성 흐름을 시작합니다.
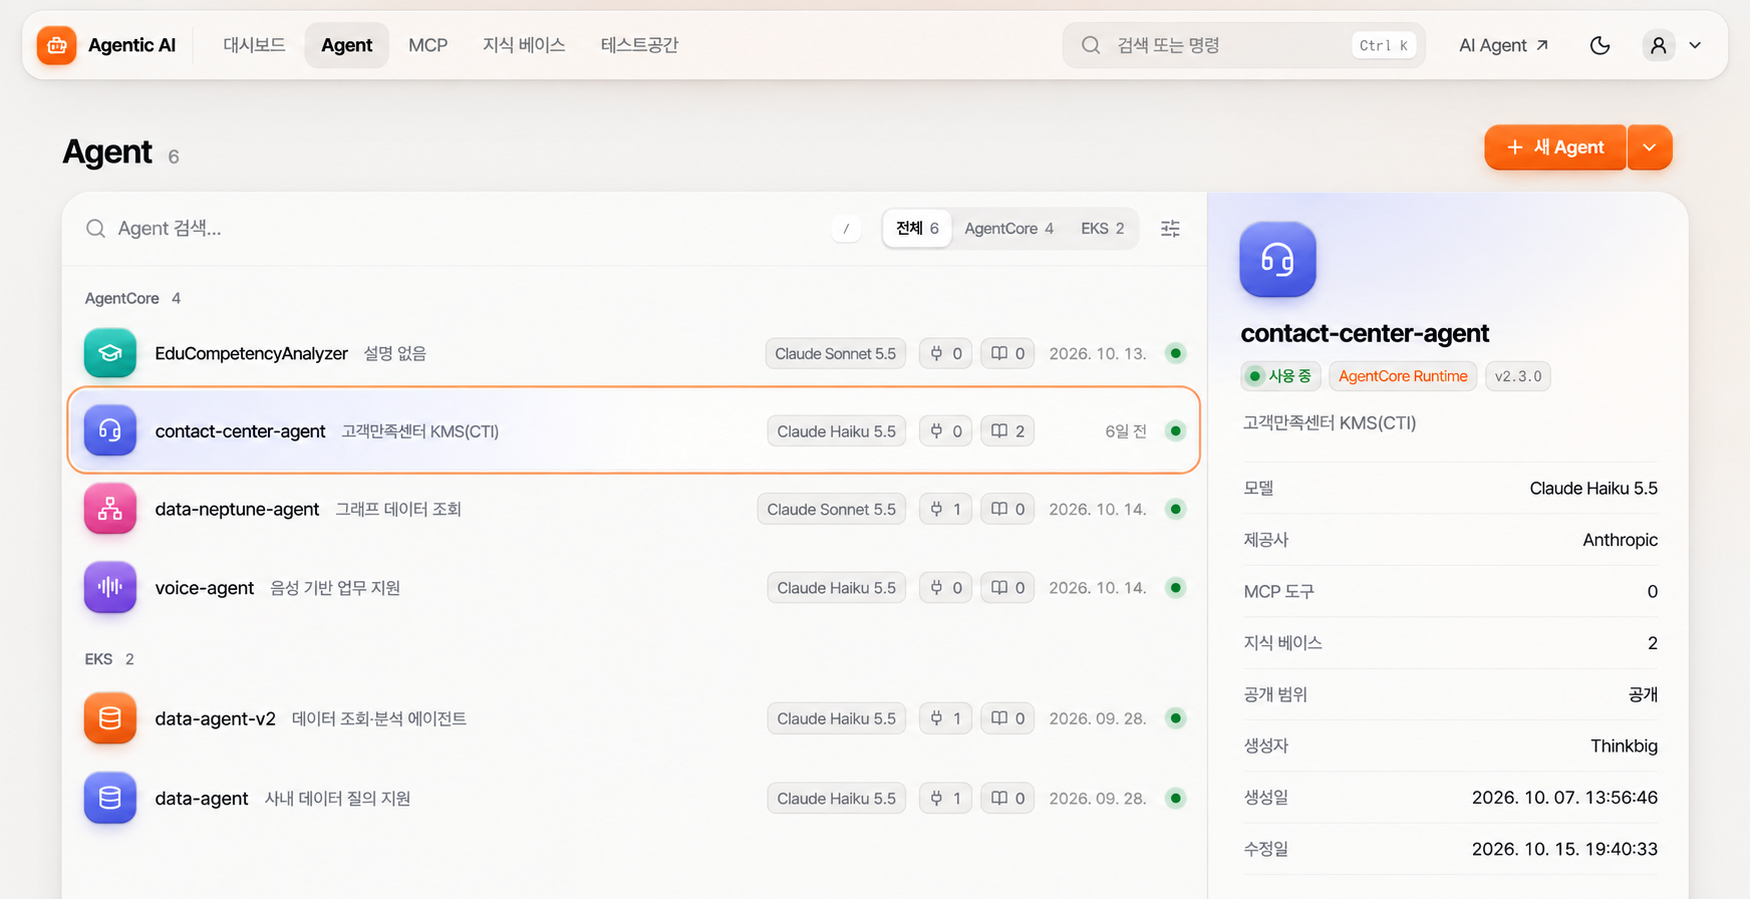
그림 3. 배포 대상(AgentCore/EKS)별로 구분한 에이전트 목록과 상세 정보.
관리 화면에서 선택한 모델, 지시문, 지식 베이스, MCP 설정은 코드 생성기가 Strands Agents 코드를 만들 때 그대로 반영되며, 지식 베이스 검색을 위해 검색 함수가, MCP에는 MCP 클라이언트가 들어갑니다.
사용자 질문이 응답으로 이어지는 과정
사용자 질문이 들어오면 백엔드는 대화 ID와 사용자 ID를 질문과 함께 AgentCore Runtime의 에이전트에 전달합니다. 에이전트는 세션 매니저를 통해 AgentCore Memory에서 같은 세션의 최근 대화를 복원하고, 질문과 관련된 대화 요약을 조회해 모델에 전달할 맥락으로 준비합니다. 모델은 지시문과 이 맥락을 바탕으로, 필요하면 지식 검색 도구로 Amazon Bedrock Knowledge Bases를, 업무 데이터가 필요하면 MCP 도구를 호출해 응답을 생성합니다.
생성된 응답은 백엔드를 거쳐 테스트 화면이나 외부 연동 채널로 전달됩니다. 응답 전달 시에는 내부 실행 이벤트를 채널이 기대하는 스트리밍 규격에 맞춥니다. 초기에는 AgentCore 경로의 내부 이벤트 타입인 text가 그대로 전달되어, 플랫폼 테스트 화면에서는 정상이었지만 delta만 처리하는 외부 채널에서는 에러 로그 없이 빈 화면이 표시됐습니다. 그래서 백엔드 스트리밍 계층에서 text를 delta로 변환하고 중복 종료 이벤트를 한 건으로 통합했습니다.
질문과 응답은 에이전트의 세션 매니저가 AgentCore Memory에 이벤트로 기록하며, 이 이벤트가 이후 질문의 단기 기억과 대화 요약의 원본이 됩니다.
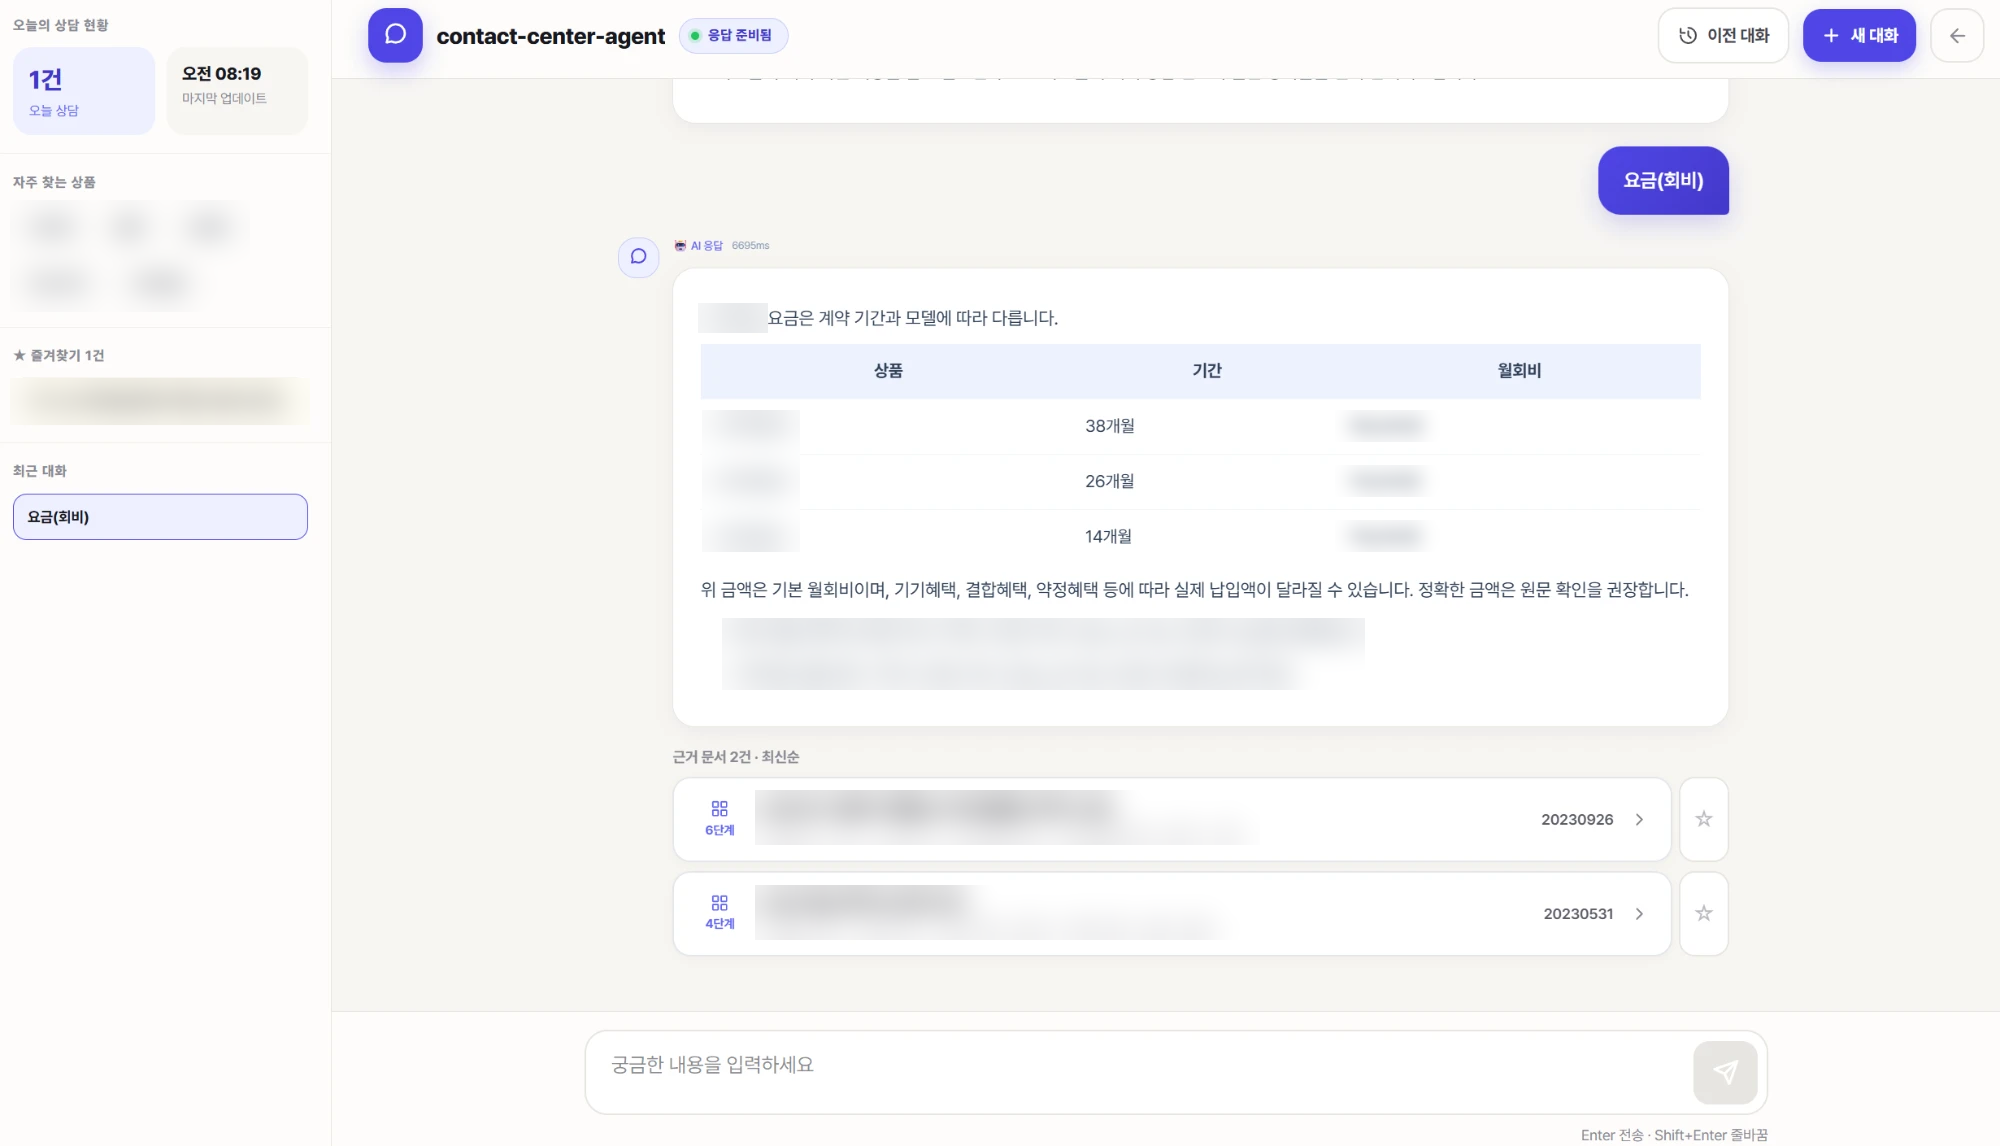
그림 4. 고객 상담 지원 에이전트의 대화 화면과 근거 문서 표시.
모델과 지식 검색
에이전트는 Amazon Bedrock을 통해 Claude Haiku, Claude Sonnet 등의 모델을 활용하며, 비용 추적을 위해 Amazon Bedrock application inference profile을 사용합니다. 자세한 내용은 이 문서에서 확인하실 수 있습니다.
지식 검색은 Amazon Bedrock Knowledge Bases로 구성하며, 신규 지식 기반은 Amazon S3 Vectors를, 기존 지식 기반은 Amazon OpenSearch Service를 벡터 저장소로 사용합니다. 이때는 지식 기반마다 별도의 벡터 인덱스를 두며, 원본 문서는 Amazon S3에 저장합니다.
대화 맥락과 메모리
대화 맥락은 AgentCore Memory 하나에서 단기 기억과 장기 기억으로 나누어 관리합니다. 에이전트의 세션 매니저(AgentCoreMemorySessionManager)는 질문과 응답을 세션 단위 이벤트로 기록해 같은 대화로 다시 호출되면 최근 대화를 복원하고, 쌓인 이벤트는 Summarization 전략으로 비동기 요약합니다. 질문이 들어오면 같은 사용자와 에이전트의 관련 요약을 조회해 질문 앞에 덧붙이며, 요약 반영에는 1분 이상 걸릴 수 있어 방금 나눈 대화는 단기 기억이, 그보다 이전의 맥락은 요약이 보완합니다.
구현 과정
1. 에이전트 설정을 AgentCore Runtime 배포로 연결
에이전트 설정들을 Strands Agents 코드로 변환할 때는 설정 값들로 만든 fingerprint를 이미지 태그에 넣어, 어떤 설정으로 빌드한 이미지인지 구분합니다. 설정이 바뀌면 태그가 달라지므로 새 이미지가 만들어집니다. 관리 화면에서 에이전트를 저장해 배포할 때는 항상 새로 빌드하고, 이미 배포한 버전을 다시 실행하는 경우에는 같은 태그의 이미지가 남아 있는지 확인해 재사용합니다.
코드 생성기는 두 단계로 동작합니다. 먼저 미리 구성해 둔 코드 템플릿에 관리 화면에 저장된 설정값(모델 ID, 지시문, 연결된 지식 기반과 MCP 등)을 채워 에이전트 실행 코드(agent.py), HTTP 서버 래퍼(server.py), 지식 검색 도구(kb_tools.py, 지식 기반이 연결된 경우)와 MCP 도구, requirements.txt를 만듭니다. 그 다음 배포 대상에 맞는 Dockerfile과 AWS CodeBuild 빌드 명세 buildspec.yml을 만듭니다. 템플릿에서 설정 값이 들어가는 부분은 치환되고, 지식 기반이나 MCP가 연결되었는지에 따라 해당 코드 블록이 포함되거나 빠집니다. 예를 들어 모델 ID와 max_tokens(플랫폼 공통값), 지시문은 아래처럼 agent.py의 AGENT_CONFIG에 들어갑니다.
# 템플릿 코드
AGENT_CONFIG = {
    "model_id": {{ model_id | tojson }},
    "max_tokens": {{ max_tokens }},
    "system_prompt": {{ system_prompt | tojson }}
}

# 생성 결과: agent.py (설정이 반영된 모습, 예시 값. 실제 파일에서 한글 문자열은 \uXXXX로 이스케이프됩니다)
AGENT_CONFIG = {
    "model_id": "arn:aws:bedrock:ap-northeast-2:111122223333:application-inference-profile/<profile-id>",
    "max_tokens": 16384,
    "system_prompt": "당신은 사내 인사 정책 문서를 근거로 답변하는 도우미입니다."
}
마지막으로 만들어지는 buildspec.yml은 CodeBuild가 읽는 빌드용 파일입니다. 에이전트 설정은 여기에 들어가지 않고, 대상 환경에 따라 빌드 방식만 달라집니다. AgentCore Runtime용은 buildx로 ARM64 이미지를 빌드해 Amazon ECR에 푸시하도록, Amazon EKS용은 AMD64 이미지를 기본 방식으로 빌드하도록 생성됩니다.
그렇게 코드 생성기를 통해 생성한 소스는 Amazon S3에 저장하고, AWS CodeBuild로 컨테이너 이미지를 빌드해 Amazon ECR에 등록합니다.
AgentCore Runtime은 코드와 의존성을 .zip 아카이브로 올리는 직접 코드 배포도 지원하지만, 이 플랫폼은 컨테이너 방식으로 구성했습니다. 두 실행 환경은 같은 코드 생성기, HTTP 서버 래퍼와 Dockerfile 템플릿, CodeBuild/ECR 파이프라인을 함께 쓰며, 실행 대상에 따라 이미지 아키텍처와 베이스 이미지, AgentCore Runtime용 엔드포인트 포함 여부만 달라집니다. 공통 의존성은 베이스 이미지에 미리 설치합니다.
다만 ARM64 이미지는 직접 빌드하고 관리해야 합니다. 초기에는 EKS와 공유하던 베이스 이미지 때문에 이미지 메타데이터는 ARM64인데 내부 Python 바이너리는 AMD64여서, AgentCore Runtime 기동 시 exec format error가 발생했습니다. 그래서 공통 의존성을 미리 설치한 ARM64 전용 베이스 이미지를 arm64-latest 태그로 분리하고, 최종 이미지 태그에도 -arm64 접미사를 붙여 Amazon EKS용 이미지와 섞이지 않게 했습니다.
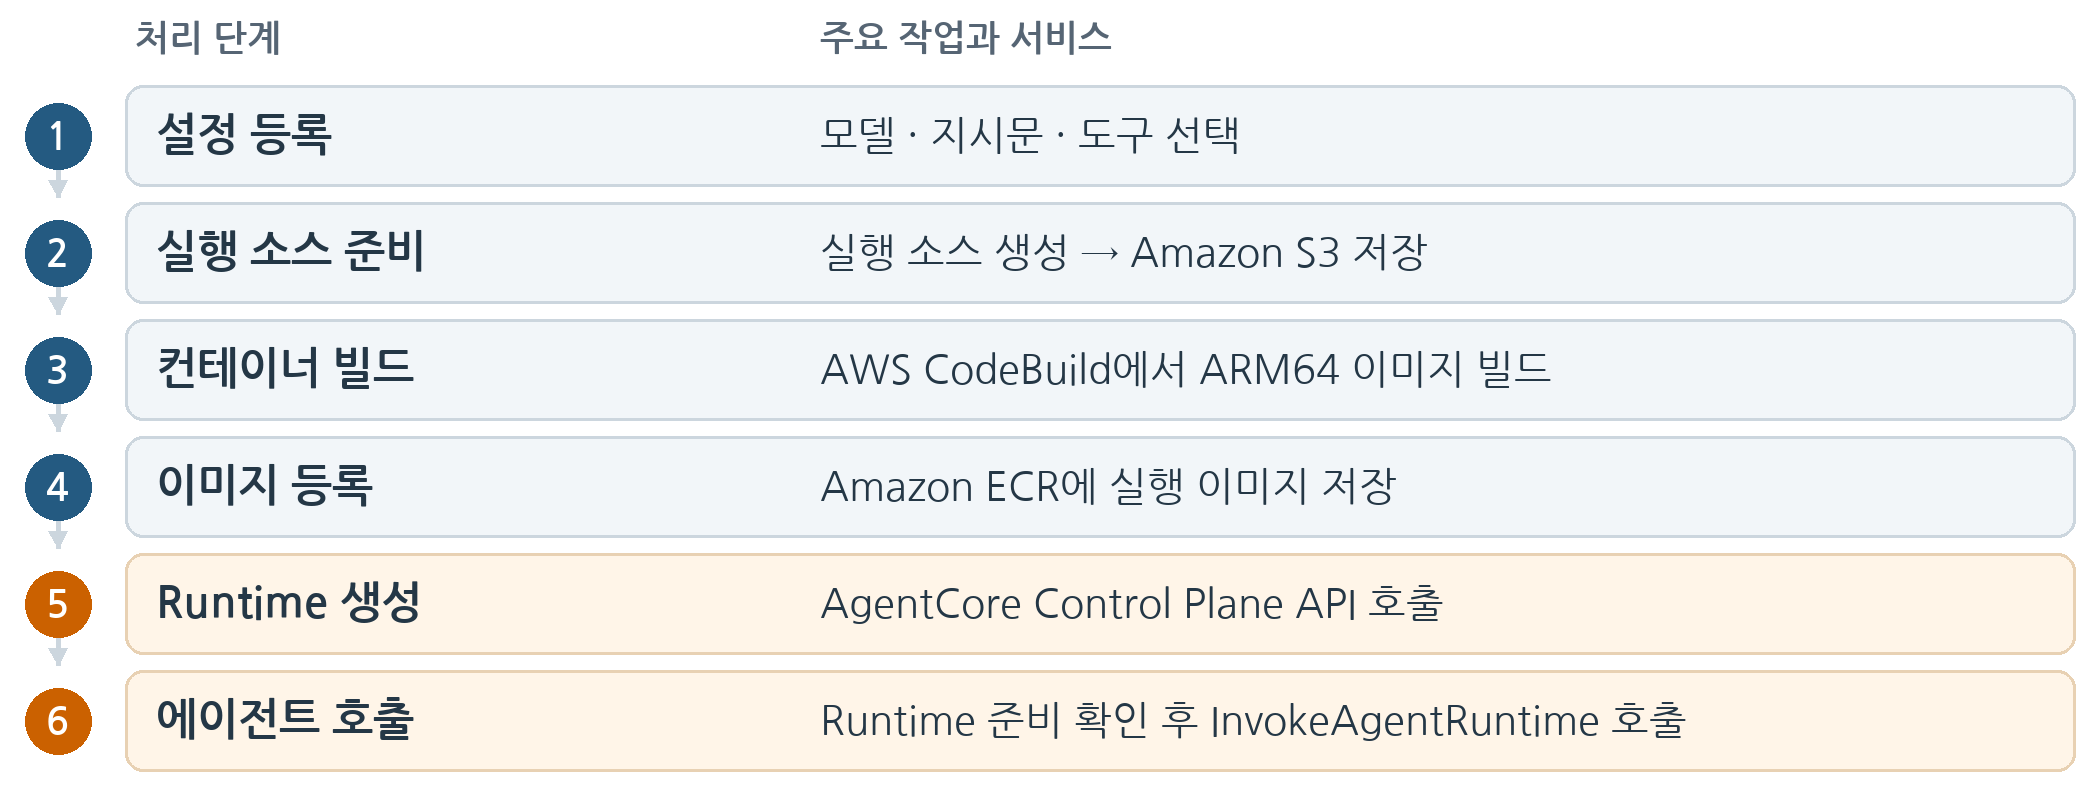
그림 5. 에이전트 설정에서 배포와 호출까지 이어지는 처리 단계.
CodeBuild는 이미지를 빌드해 ECR에 푸시하는 데까지만 담당하고, ECR 이미지를 참조하는 Runtime의 생성과 갱신은 플랫폼 백엔드가 boto3로 AgentCore Control Plane API를 직접 호출해 처리합니다.
AgentCore Runtime 생성 및 갱신: 백엔드의 boto3 호출
에이전트 하나는 AgentCore Runtime 하나를 사용합니다. 백엔드는 배포할 때마다 다음 순서를 따릅니다. 먼저 해당 에이전트의 Runtime을 찾습니다. 이때 Runtime이 없으면 새로 만들고, 있으면 새 이미지로 갱신해 새 Runtime 버전을 만듭니다. 이미 같은 이미지로 떠 있는 Runtime 버전이 있으면 갱신을 건너뜁니다. 그 다음 에이전트 버전별 엔드포인트(예: v1_6_0)가 그 Runtime 버전을 가리키도록 만들거나 옮기고, 엔드포인트가 READY가 되면 배포 정보를 저장합니다. 버전 엔드포인트가 상한을 넘으면 오래된 것부터 정리하고, 정리된 엔드포인트를 쓰던 배포는 더 호출할 수 없으므로 종료 처리합니다. 이후 대화 요청은 이 엔드포인트로 호출합니다.
빌드 결과와 Runtime 준비 상태는 단계별로 따로 확인하므로, 배포가 실패하면 어느 단계에서 실패했는지 바로 알 수 있습니다.
2. AgentCore Gateway와 Identity로 업무 도구 연결
플랫폼은 이미 운영 중인 MCP 서버를 연결하거나, MCP 서버 컨테이너를 배포하거나, 기존 REST API를 MCP 도구로 등록하는 흐름을 제공합니다.
신규 서버는 컨테이너 유형을 고르면 사용자가 Amazon ECR에 올려 둔 MCP 서버 이미지를 AgentCore Runtime에 배포하고 Gateway Target으로 등록합니다(Runtime 직접 호출도 가능하나 하나의 엔드포인트도 관리하기 위함). API 유형을 고르면 REST API 주소와 OpenAPI 스키마를 받아 Gateway Target으로 등록합니다.
인증은 AgentCore Identity 구간에 따라 다른 방식으로 처리합니다. 첫째, 에이전트가 Gateway를 호출하는 구간은 AWS IAM의 SigV4 인증을 사용합니다. 에이전트는 호출 시 자신의 AWS 자격 증명(AgentCore Runtime의 실행 역할 혹은 EKS Pod의 IRSA)으로 요청에 서명합니다. 둘째, Gateway가 실제 도구(Target)를 호출하는 구간은 두 가지 유형이 있습니다. OpenAPI 기반 API 유형은 대상 API가 요구하는 방식에 따라 OAuth2 공급자 정보 또는 API Key를 Target에 연결합니다. 컨테이너 유형의 MCP 서버는 Runtime에 Amazon Cognito 기반 JWT 인증을 설정하고, Gateway는 Identity에서 받아 온 토큰으로 이 Runtime을 호출합니다. 이미 운영 중인 사내 공용 MCP 서버는 인증 없음 또는 사용자가 선택한 OAuth2 공급자를 지정해 등록합니다. 다만 인증 없음으로 등록한 MCP 서버는 에이전트가 원래 주소로 직접 호출하도록 구성했습니다. 이렇게 하면 에이전트 코드에 API 키나 토큰을 넣지 않고 도구별 인증을 한곳에서 관리할 수 있습니다.
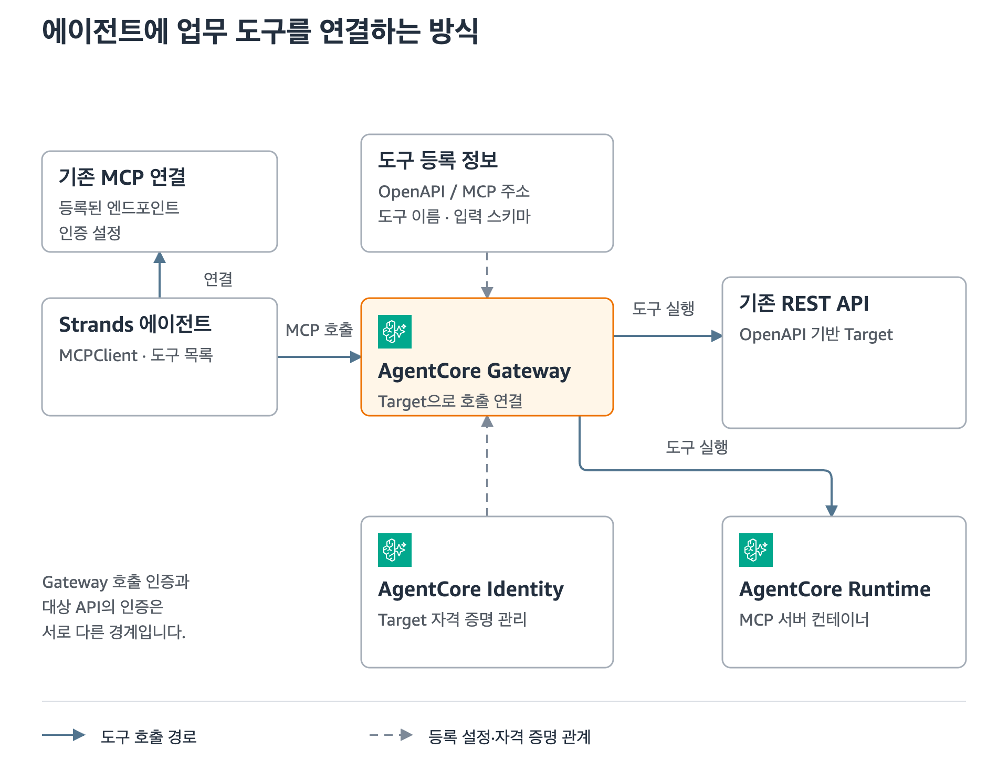
그림 6. AgentCore Gateway와 Identity로 업무 도구를 연결하는 구조.
3. 기존 운영 환경과의 통합
웅진씽크빅은 플랫폼의 프런트엔드와 백엔드를 포함해 기존 에이전트와 MCP 서버를 이미 Amazon EKS, ArgoCD, Helm 기반으로 운영하고 있었습니다. 플랫폼은 이러한 환경에서 관리해야 하는 에이전트와 MCP를 위해 Amazon EKS 배포 유형을 함께 제공합니다. 현재 동일 Kubernetes 클러스터 내에서 Kubernetes Service DNS 주소로 접근 중인 워크로드의 경우 EKS 배포 유형을 사용하여 기존 배포 템플릿 및 운영 체계를 활용합니다.
EKS 유형에서 백엔드는 Helm values의 서비스 항목에 에이전트 또는 MCP 배포 정보를 기록합니다. 이후 Git에 반영된 변경사항은 ArgoCD가 감지하고 EKS에 동기화합니다. 같은 배포 템플릿으로 에이전트와 MCP의 Service, Rollout, HPA 같은 Kubernetes Object 구성 정보와 상태 확인 설정을 관리합니다.
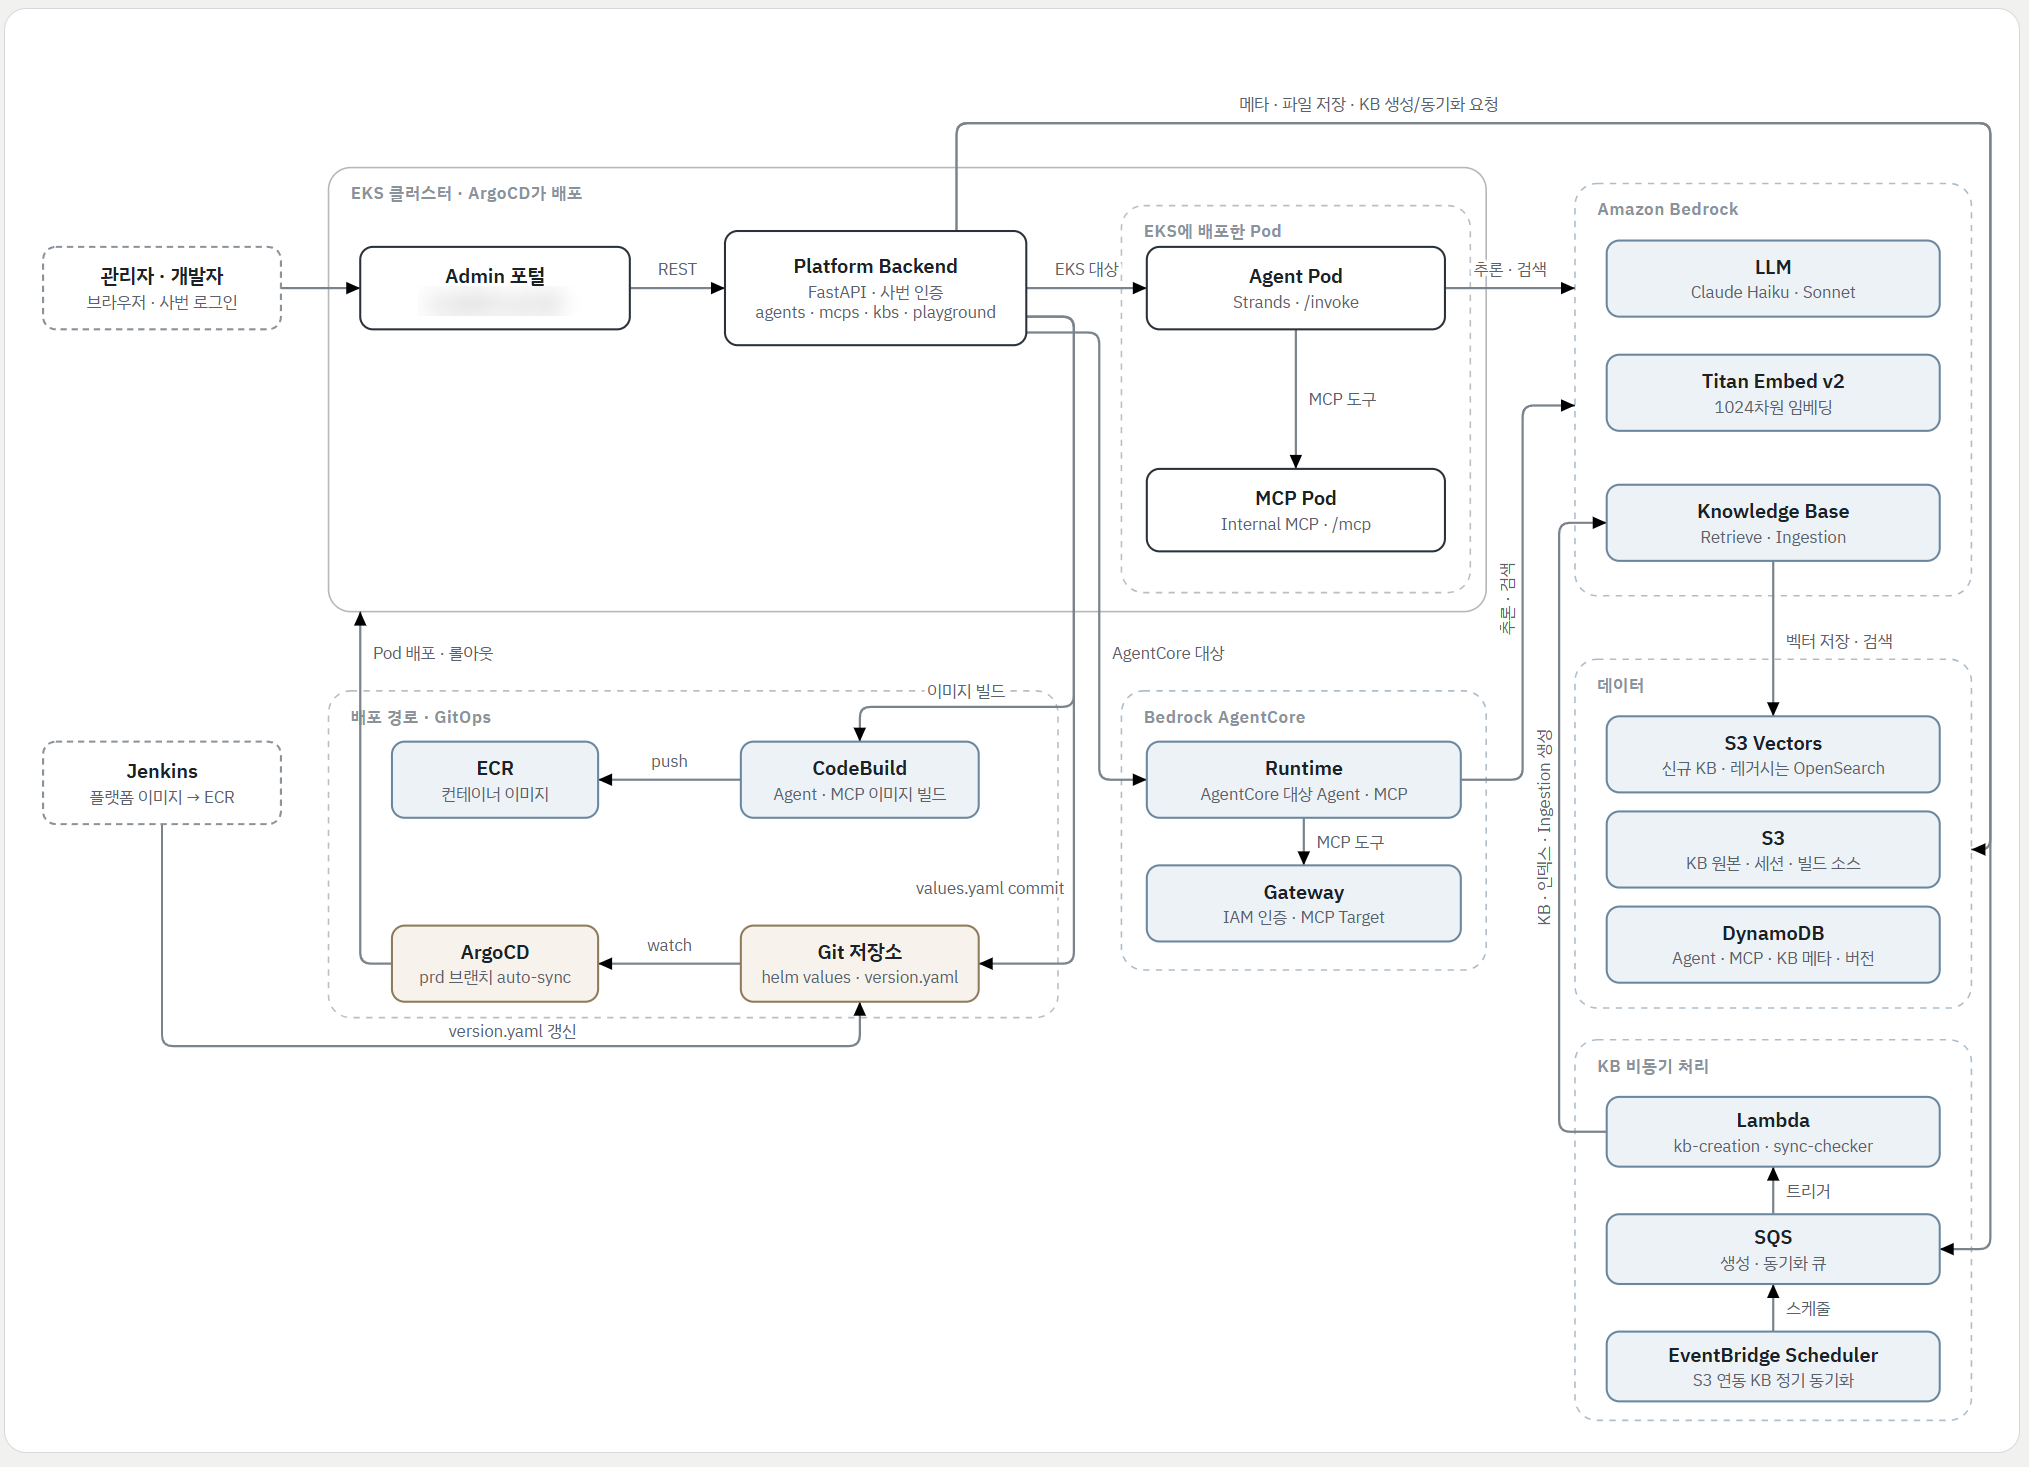
그림 7. EKS/ArgoCD/Helm 통합 유형의 배포 플로우.
MCP 등록 화면에도 이 통합 경로를 반영했습니다. 먼저 ‘무엇을 가지고 있나요?’에서 MCP 서버 주소, 컨테이너 이미지, REST API 스펙 중 하나를 고르고, 컨테이너 이미지와 REST API 스펙은 ‘어디서 실행할까요?’에서 EKS 또는 AgentCore를 추가로 선택합니다. 선택 결과는 화면 오른쪽 패널과 하단 바에 유형 이름으로 표시되며, 이 조합이 아래 표의 다섯 가지 유형입니다.
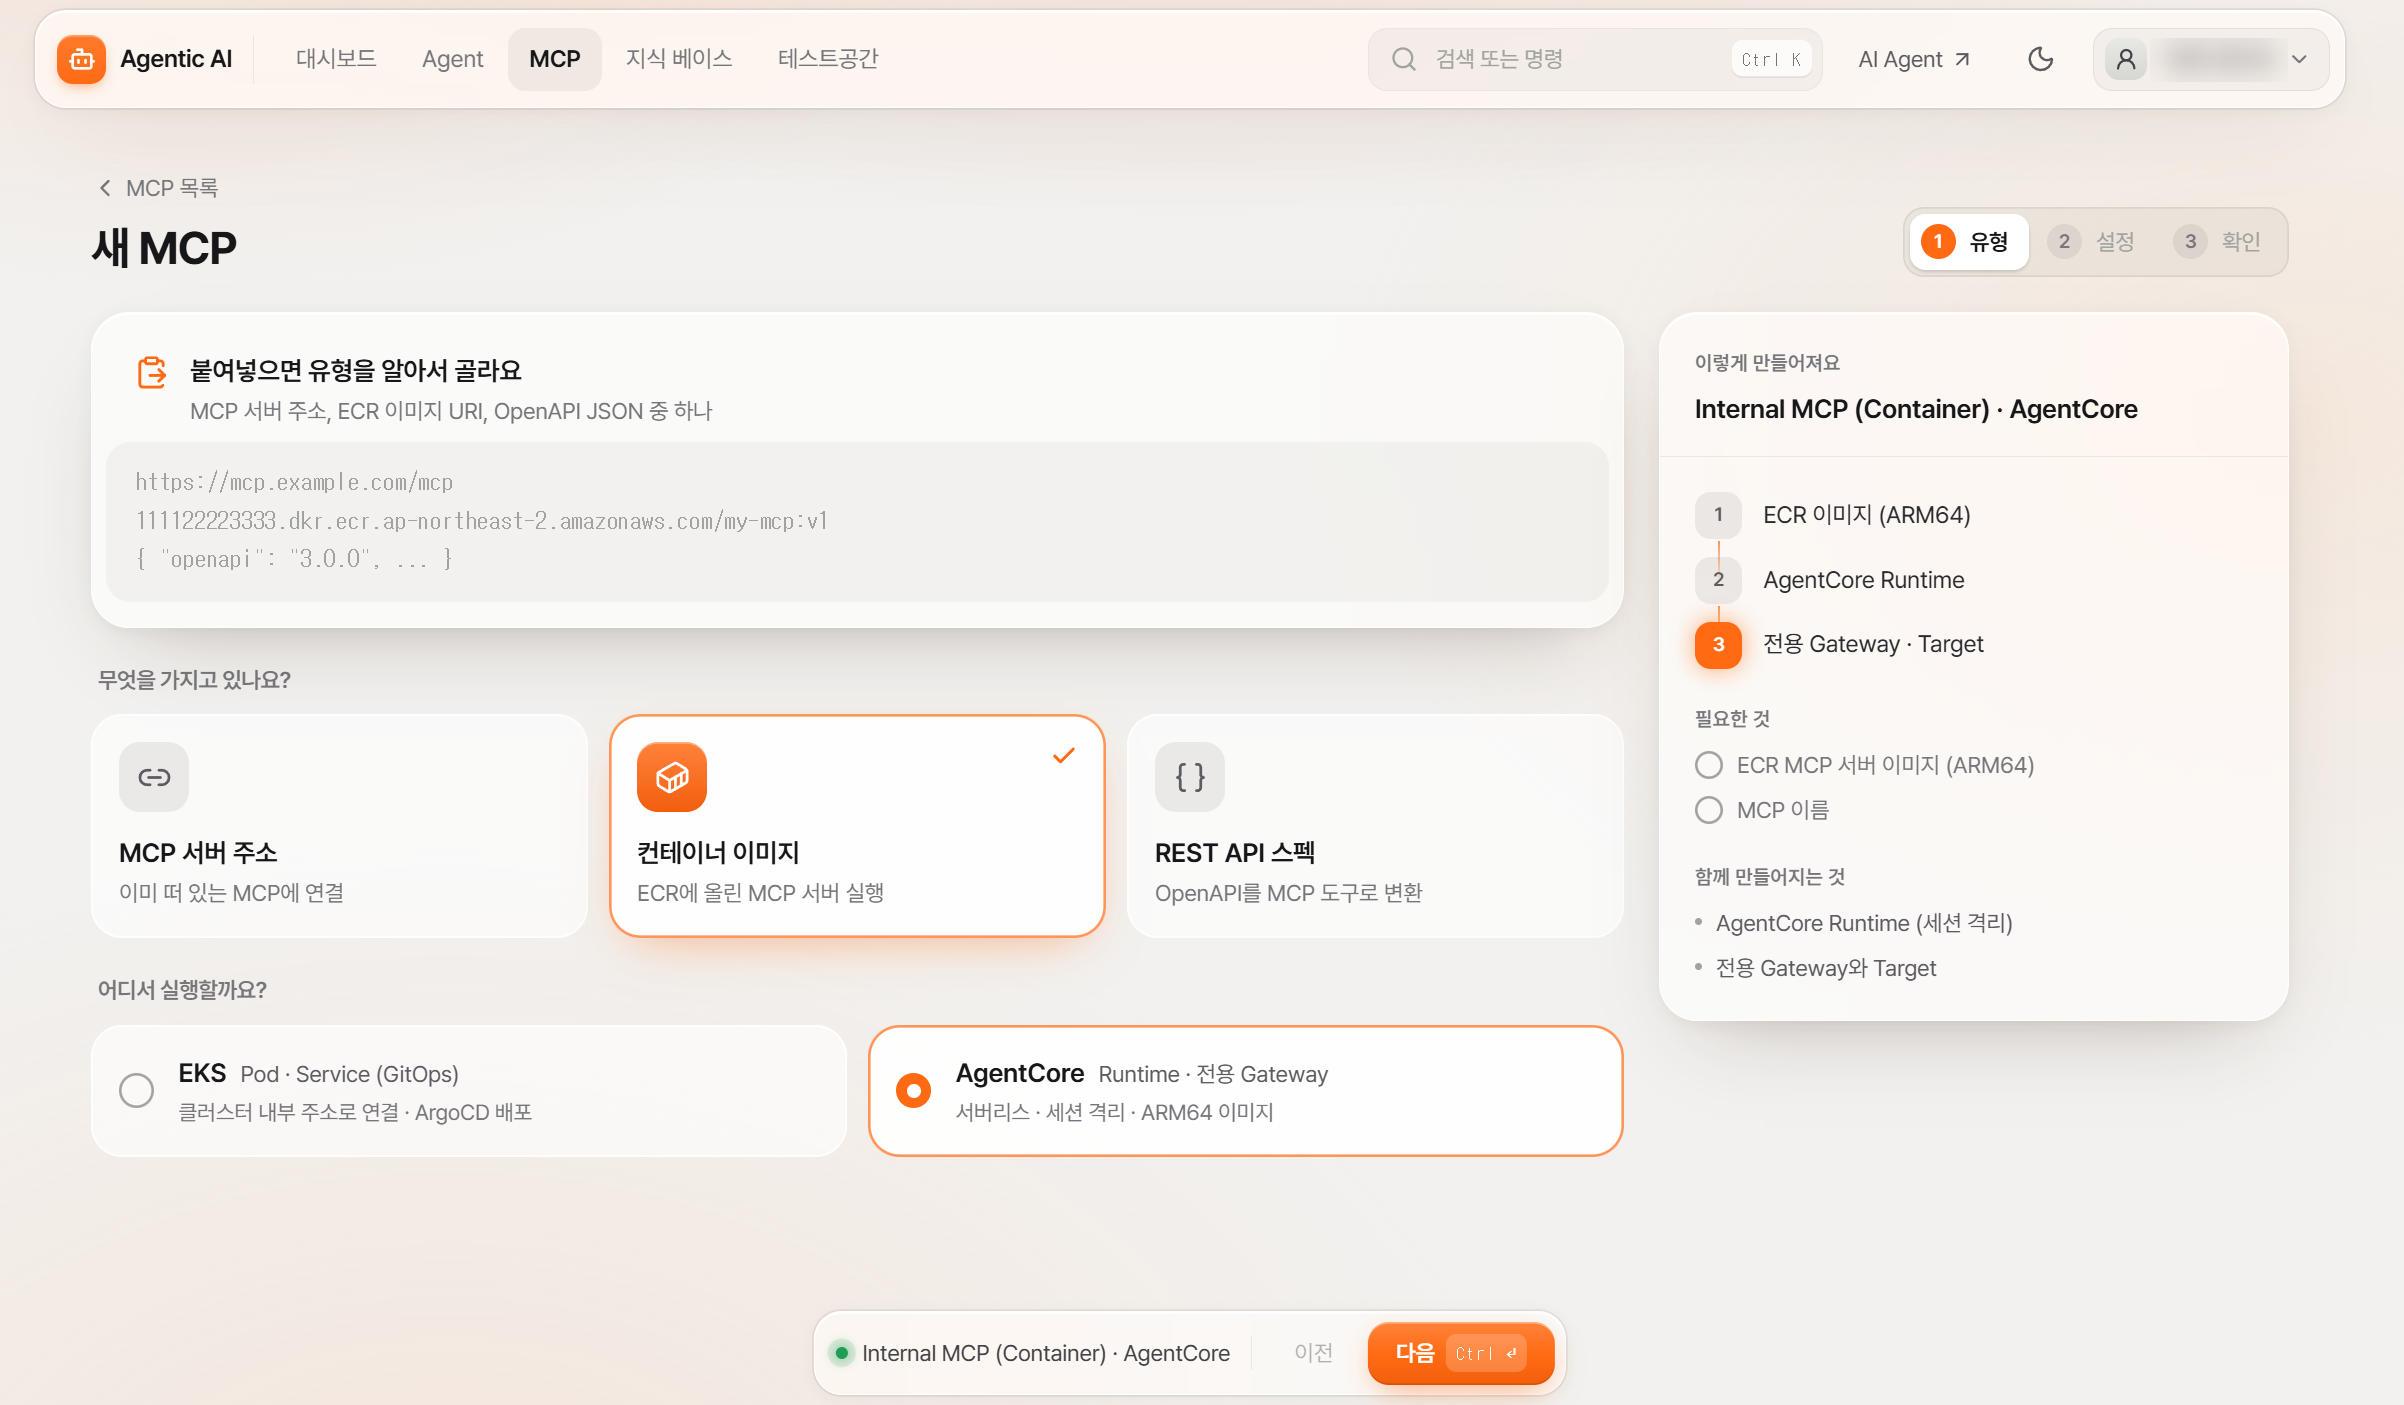
그림 8. AgentCore 기반 MCP 등록과 기존 EKS 운영 환경의 통합을 함께 제공하는 유형 선택 화면.
| 무엇을 가지고 있나요? |
어디서 실행할까요? |
화면에 표시되는 유형 이름 | 입력 | 플랫폼이 구성하는 방식 |
|---|---|---|---|---|
| MCP 서버 주소 | (선택 없음) | External MCP | 운영 중인 MCP 서버 엔드포인트 |
기존 MCP 서버 연결 및 등록 |
| 컨테이너 이미지 | AgentCore | Internal MCP (Container) / AgentCore |
ECR의 MCP 서버 이미지 (ARM64) |
AgentCore Runtime 배포 및 전용 Gateway 및 Target 구성 |
| REST API 스펙 | AgentCore | Internal MCP (API) / AgentCore |
REST API 주소와 OpenAPI 스키마 |
별도 MCP 컨테이너 없이 Gateway API Target 구성 |
| 컨테이너 이미지 | EKS | Internal MCP (Container) / EKS |
ECR의 MCP 서버 이미지 | GitOps를 통한 EKS Pod와 Service 배포 |
| REST API 스펙 | EKS | Internal MCP (API) / EKS | REST API 주소와 OpenAPI 스키마 |
REST-to-MCP 브리지 Pod 배포 |
EKS의 API 유형은 REST-to-MCP 브리지 Pod를 실행합니다. Gateway Target을 구성하는 AgentCore의 API 유형과 구현 방식은 다르지만, 등록한 도구를 에이전트에 연결하는 관리 흐름은 플랫폼에서 함께 제공합니다.
구축을 통해 얻은 효과
첫째, 에이전트 설정부터 AgentCore 배포와 테스트까지 이어지는 과정을 하나의 플랫폼으로 통합했습니다. 사용자가 모델과 지시문, 연결할 도구와 지식 기반을 등록하면 플랫폼이 실행 코드와 빌드 설정을 포함한 파일 5~6개를 자동 생성합니다. 나머지는 모든 에이전트에 공통으로 적용되는 코드로 구성해, 각 팀이 별도의 실행 코드를 개발하지 않고 업무에 필요한 설정만 관리하도록 했습니다.
설정 저장부터 에이전트 호출이 가능한 상태까지 걸리는 시간은 중앙값 기준 약 2분 10초입니다. 이미지 빌드에 약 1분 30초, Runtime 갱신과 버전 엔드포인트 준비에 약 40초가 소요됩니다. 이는 앞에서 설명한 ARM64 베이스 이미지 분리 작업의 결과로, 기존에는 20분의 빌드 제한 시간 내에 완료되지 않던 작업을 수 분 이내로 단축했습니다.
둘째, 도구 연결과 대화 컨텍스트 관리를 플랫폼의 공통 기능으로 구현했습니다. AgentCore Gateway와 Identity를 활용해 기존 API와 MCP 서버를 연결하고, 지식 검색에는 Bedrock Knowledge Bases를 활용했습니다. 지식 기반 1개를 연결하면 약 50줄, MCP 서버 1개를 연결하면 약 300줄의 코드가 공통 템플릿을 기반으로 자동 생성되므로, 사용자가 연결 로직을 직접 개발할 필요가 없습니다. Gateway를 통해 호출하는 도구의 자격 증명도 코드에 포함하지 않고 AgentCore Identity에서 관리하도록 구성했고, 대화 컨텍스트는 AgentCore Memory의 단기 기억과 대화 요약으로 구성했습니다.
셋째, AgentCore Runtime과 기존 EKS 환경을 동일한 배포 체계에서 관리할 수 있도록 구성했습니다. AgentCore Runtime과 EKS에서 실행되는 에이전트는 동일한 코드 생성기와 빌드 파이프라인을 사용합니다. 동일한 설정으로 생성한 코드를 비교하면 약 90%가 동일하며, 핵심 에이전트 로직을 담은 파일은 완전히 같습니다.
또한 에이전트가 증가하더라도 매번 별도의 실행 인프라를 구축할 필요가 없도록 했습니다. AgentCore Runtime은 세션별 격리를 지원하는 관리형 서버리스 실행 환경을 활용하고, EKS에서는 기존 클러스터와 HPA 기반 확장 체계를 활용합니다.
향후 개선 계획
GitOps 배포의 상태 판정과 일관성 보강
EKS 통합 경로에서는 백엔드의 등록 정보, Git에 기록한 배포 구성, 클러스터의 실제 실행 상태가 서로 다른 시점에 갱신됩니다. 현재는 Git push 후 ArgoCD 동기화, 이미지 가져오기, 컨테이너 시작이 끝났는지를 배포 상태 판정에서 직접 확인하지 않아, 화면에는 READY가 표시되지만 서비스가 아직 요청을 받지 못하는 상태가 생길 수 있습니다. 이를 보완하기 위해 배포 요청에 목표 Git commit SHA를 기록하고, ArgoCD의 해당 revision 반영, 워크로드 상태, Pod readiness, 애플리케이션 호출 가능 여부(에이전트는 health 응답, MCP는 initialize 성공 여부)를 순서대로 검증하도록 개선하고 있습니다. 각 단계에는 제한 시간과 실패 사유를 두어, 실패한 단계에 맞는 재시도나 구성 수정을 안내할 계획입니다.
MCP 등록도 metadata 저장과 GitOps 배포 요청이 하나의 트랜잭션으로 묶여 있지 않아, Git push가 실패하면 화면에는 등록 완료로 보이지만 클러스터에는 워크로드가 없을 수 있습니다. 이를 위해 등록 정보와 배포 요청을 함께 기록하는 outbox 방식과 재처리 worker를 검토하고 있으며, DB, Git, 클러스터의 상태를 주기적으로 대조하는 절차도 마련할 계획입니다.
동시 배포에서도 충돌이 생길 수 있습니다. 백엔드는 요청마다 저장소를 clone하고 공통 values 파일을 수정한 뒤 push합니다. 두 배포 요청이 같은 Git revision에서 시작하면 한 요청이 먼저 반영된 뒤 다른 요청의 push가 거부될 수 있습니다. 같은 서비스 이름의 항목을 교체하는 처리는 있지만, 서로 다른 요청이 동시에 저장소를 변경하는 상황을 제어하는 lock 구성이나 충돌 시 재시도 처리는 별도로 필요합니다.
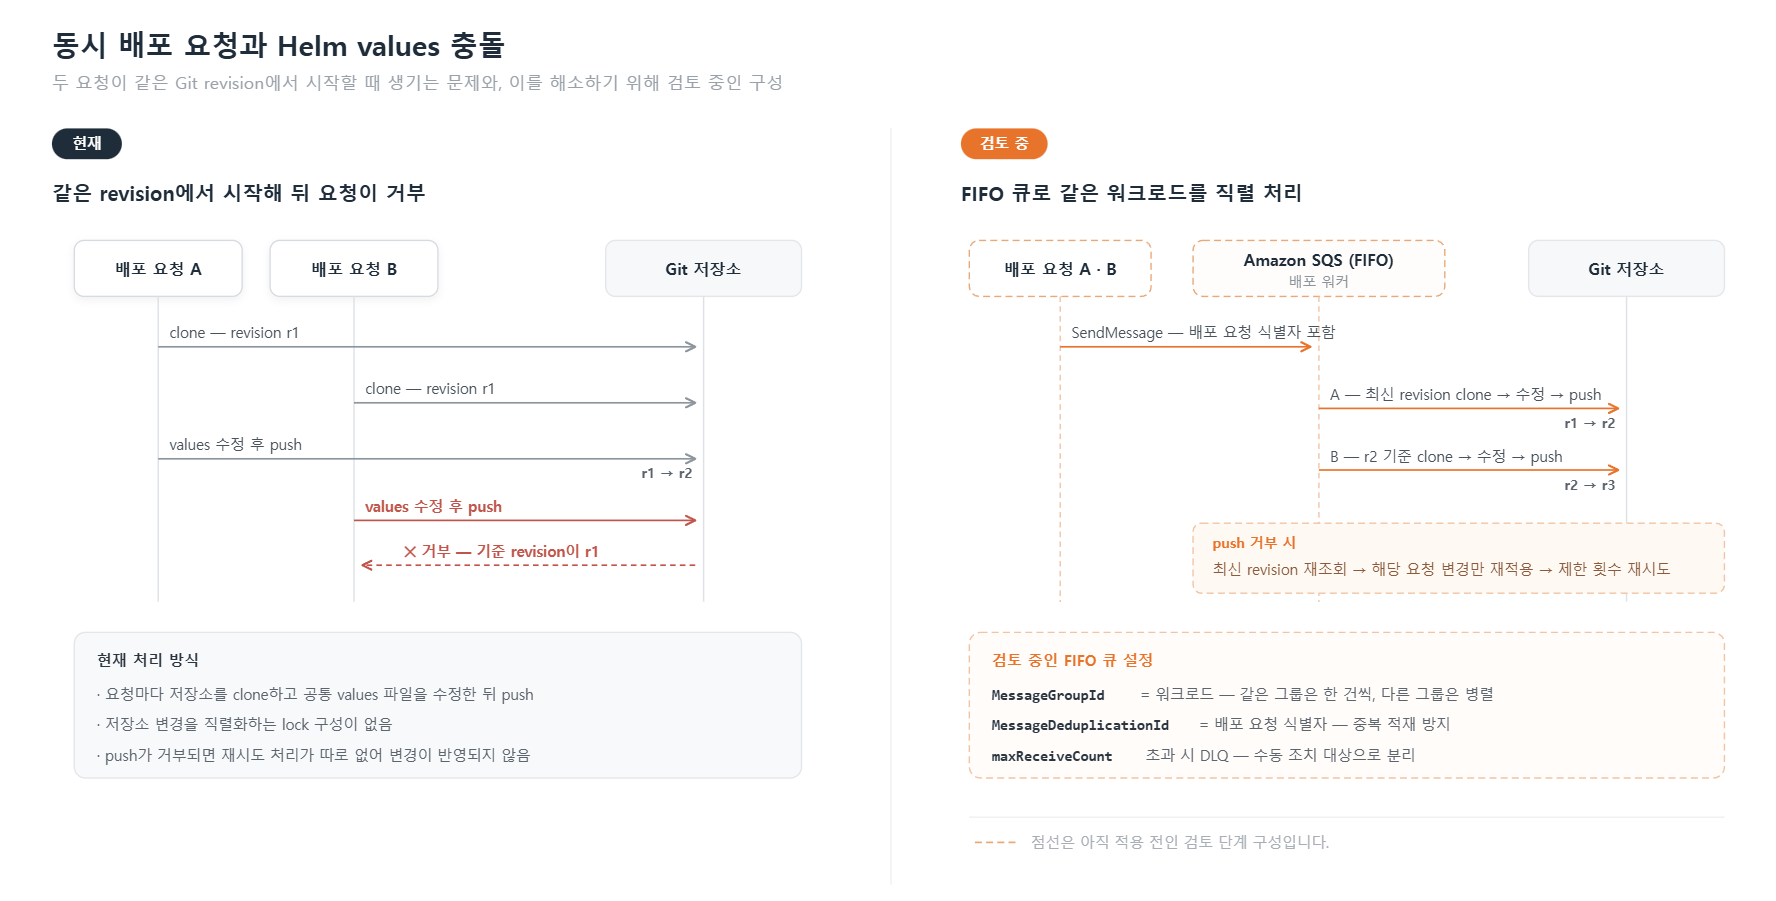
그림 9. 동시 배포 요청에서 Helm values push가 거부되는 현재 상황과, Amazon SQS FIFO 큐로 같은 워크로드의 요청을 직렬 처리하기 위해 검토 중인 구성.
해결 방안으로 Git 변경 요청을 Amazon SQS FIFO 큐에 적재해 순서대로 처리하는 방식을 검토하고 있습니다. 워크로드를 MessageGroupId로 두면 같은 values 파일을 바꾸는 요청은 직렬로, 서로 다른 워크로드는 병렬로 처리됩니다. push가 거부되면 최신 revision에 해당 요청의 변경만 다시 적용해 제한된 횟수로 재시도하고, 한도를 넘긴 요청은 DLQ로 분리할 계획입니다.
응답 품질의 평가와 개선
AgentCore Evaluations는 현재 필요할 때 지정한 대화만 골라 평가하는 온디맨드 방식으로 사용하고 있으며, 앞으로는 플랫폼 안에서 평가 파이프라인을 통합 관리하고 운영할 수 있도록 추가할 예정입니다. 플랫폼에 통합하면 운영 세션을 일정 비율로 표본 추출해 세션, 응답, 도구 호출 단위로 점수를 매기는 온라인 평가를 온디맨드 평가와 함께 운영하고, 관리 화면에서 찾은 문제 대화를 세션 식별자로 골라 바로 평가할 수 있습니다.
평가 결과를 개선으로 연결하는 데는 AgentCore Optimization을 검토하고 있습니다. 실제 트레이스와 목표 평가기를 바탕으로 시스템 프롬프트와 도구 설명의 개선안을 제안받고, 대화 로그에서 모은 사례를 테스트 데이터셋으로 삼아 일괄 평가하거나 A/B 테스트로 검증하는 방식입니다. 플랫폼은 이미 에이전트 버전마다 엔드포인트를 따로 두고 있어, 개선안을 새 버전으로 배포해 기존 버전과 비교하고 점수가 나아진 경우에만 전환할 수 있습니다.
마치며
웅진씽크빅은 이번 프로젝트로 팀마다 따로 만들던 AI 에이전트의 코드 생성, 빌드, 배포, 도구 연결, 대화 맥락 관리를 하나의 플랫폼으로 모았습니다. 이제 사용자는 관리 화면에서 설정만 등록하면 에이전트 및 관련 리소스들을 AgentCore나 기존 EKS 환경에 배포하고 바로 테스트할 수 있습니다.
무엇보다 새로운 관리형 서비스와 기존 운영 체계를 하나로 통합해, 에이전트를 늘릴 때마다 실행 환경이나 운영 방식을 새로 정하지 않아도 되는 기반을 마련했습니다. AgentCore의 Runtime, Gateway, Identity, Memory로 에이전트에 필요한 공통 기능을 빠르게 갖추고, 이미 EKS, ArgoCD, Helm 위에서 운영하던 워크로드는 같은 관리 흐름 안에서 배포합니다. 두 실행 환경 중 하나를 고르는 대신 워크로드에 맞는 환경을 선택할 수 있게 되었고, 개별 팀의 개발 결과를 여러 팀이 함께 쓰는 사내 공용 자산으로 관리할 수 있는 기반을 갖췄습니다.
앞으로는 EKS 경로의 배포 상태 판정과 등록 정보의 일관성을 보강해, 화면에 표시되는 배포 상태와 실제 서비스 상태가 어긋나지 않도록 할 계획입니다. 또한 지금은 필요할 때만 사용하는 AgentCore Evaluations를 플랫폼에 통합해, 운영 중인 대화를 평가하고 그 결과를 지시문과 도구 설명의 개선으로 이어 가는 흐름을 만들고자 합니다. VPC 연결을 바탕으로 사내 시스템과 가까운 업무까지 AgentCore를 적용할 수 있는 범위도 넓혀 갈 예정입니다.
AI 에이전트를 여러 팀이 함께 쓰기 시작하면, 에이전트 하나를 잘 만드는 것보다 에이전트를 만들고 배포하고 연결하는 과정을 반복할 수 있게 만드는 일이 더 중요해집니다. 기존 운영 체계의 이관 부담은 최소화하면서 AgentCore의 장점을 살려 새로운 에이전트 운영 표준을 세우고 싶다면, 이 글처럼 Runtime, Gateway, Identity, Memory 같은 공통 기능은 AgentCore를 기준으로 표준화하고 기존 EKS 워크로드는 같은 관리 흐름에 연결하는 방식을 고려해 볼 수 있습니다. 이 글에서 소개한 구성과 운영 과정에서 겪은 문제가 사내 에이전트 플랫폼을 준비하는 분들께 참고가 되기를 바랍니다.
참고 자료
1. Agentic AI 기반 플랫폼 – 7주만에 기획부터 배포까지, Part1: AI-DLC 방법론과 유용한 도구들
https://aws.amazon.com/ko/blogs/tech/agentic-ai-foundation-platform-part1/
2. Agentic AI 기반 플랫폼 – Part2: AgentCore Gateway, Identity로 구현하는 MCP Registry
https://aws.amazon.com/ko/blogs/tech/agentic-ai-platform-part2-agentcore-gateway-identity-making-mcp-registry/
3. Agentic AI Platform Sample
https://github.com/aws-samples/sample-agentic-ai-platform-with-agentcore