O blog da AWS
Criando aplicações orientadas a eventos em escala com o Amazon EventBridge
Por Nahid Karimaghalou, Jamie Dool e Tolga Orhon, na Amazon Web Services.
Aplicações orientadas a eventos no Amazon EventBridge geralmente começam pequenas e depois se expandem. Uma equipe cria um Custom event bus, adiciona algumas regras e implanta. Outra equipe precisa de alguns desses eventos, então uma regra os encaminha para um bus em uma segunda conta. Uma terceira equipe precisa de um subconjunto do que a segunda equipe recebe, então outra regra encaminha novamente. Um ano depois, a organização opera dezenas de Custom event buses conectados por regras de encaminhamento, e essa topologia se tornou algo a ser operado por si só.
Essa configuração tem um custo, e a menor parte dele é a fatura. Cada salto de encaminhamento é uma ingestão separada, então o custo acompanha a topologia em vez do número de consumidores que precisavam do evento. O problema mais difícil é que ninguém consegue ver o quadro completo. A governança se espalha pelas contas que deveria cobrir. Responder quem publica em um bus, quem consome um determinado tipo de evento, ou o que quebra quando uma equipe para de publicar significa visitar cada conta e ler sua configuração de regras. Rastrear um evento é ainda mais difícil: seu caminho atravessa vários buses em várias contas, cada uma com suas próprias métricas e logs, e nenhuma visão única o acompanha desde a publicação até o consumidor que nunca o recebeu.
As equipes de aplicação também esperam. Publicar em um bus em outra conta, ou consumir de um, requer uma política de recursos, uma role e uma regra de encaminhamento controladas por uma equipe central. A equipe que deseja construir abre um ticket, e a equipe de plataforma se torna uma fila. Tanto a falta de visibilidade quanto a espera crescem a cada equipe integrada.
O Amazon EventBridge recentemente relançou o Custom event bus, que aborda esses desafios diretamente. Uma equipe de plataforma cria um bus, o compartilha em toda a organização e mantém o controle sobre quem pode publicar e quem pode assinar. Todo consumidor desses eventos é listado no único bus, em vez de ser inferido a partir de configurações espalhadas por várias contas. As equipes de aplicação criam seus próprios Subscribers em suas próprias contas. O bus armazena eventos por um período de retenção que você escolhe, preserva a ordem dentro de uma chave definida pelo publicador, aceita Avro e Protocol Buffers (Protobuf) além de JSON (incluindo CloudEvents), e entrega para destinos sem uma função no caminho para traduzir uma chamada. Ele funciona junto com o Custom event bus – classic, então a adoção é incremental.
Nesta publicação, você verá como uma equipe de plataforma cria um bus compartilhado e governa o acesso a ele, como as equipes de aplicação se integram sozinhas com um único recurso Subscriber, e como retenção, ordenação, formatos abertos, transformação e integrações diretas com destinos mudam o que um único bus pode transportar.
Um bus, compartilhado com a organização
O trabalho da equipe de plataforma em um bus compartilhado é mais restrito do que era em uma frota deles. Ela é proprietária do bus e define os limites: quais principais podem publicar e o que seus eventos podem declarar, quais principais podem assinar e, onde importa, no que esses principais têm permissão para filtrar. As equipes de aplicação então gerenciam sua própria configuração dentro desses limites, como filtros, destinos, roles de entrega, políticas de repetição e destinos de falha, nenhum dos quais a equipe de plataforma precisa escrever ou revisar. Essa divisão é o ponto central do design. A equipe de plataforma mantém a governança do bus e para de ser proprietária da configuração de todos os outros, o que a retira do caminho de provisionamento sem abrir mão do controle sobre quem está no bus.
Criar o bus é uma única chamada em uma conta de plataforma.
A retenção é a única configuração que vale a pena decidir com cuidado aqui, em vez de revisitar após um incidente. Ela varia de 1 a 365 dias e pode ser modificada posteriormente, mas uma alteração só se aplica a partir daquele momento. Aumentá-la amplia a janela para eventos publicados a partir desse ponto, e não torna eventos mais antigos legíveis novamente. Sete dias cobre uma semana útil de histórico, o que geralmente é suficiente para integrar um consumidor ou reprocessar após um bug, sem pagar para armazenar um ano de eventos que ninguém vai ler.
Compartilhar o bus é a segunda decisão. O AWS Resource Access Manager é o caminho a ser buscado primeiro: ele se associa automaticamente para contas na mesma organização e alcança contas fora dela por convite que o consumidor aceita. Uma política de recursos escrita diretamente no bus é a alternativa, e também pode nomear contas dentro ou fora da organização.
O acesso é concedido por principal, e publicar e assinar são permissões separadas. Uma equipe que produz eventos de pedidos não ganha capacidade de ler eventos de pagamento do mesmo bus. Uma única concessão não é suficiente para um chamador entre contas, como é comum na AWS: a role que publica ou assina também precisa de sua própria política do IAM permitindo essas ações. A equipe de plataforma decide quais contas podem acessar o bus, e cada equipe consumidora decide quais dos seus próprios principais podem usar esse acesso.
Em conjunto, essas decisões produzem a arquitetura mostrada no diagrama a seguir. Um bus reside em uma conta de plataforma, e as equipes de aplicação publicam nele e assinam a partir de suas próprias contas. Uma função AWS Lambda na conta da Equipe A chama PutRawEvents para publicar eventos no bus do Amazon EventBridge na conta de plataforma. A Equipe B e a Equipe C anexam cada uma seu próprio Subscriber: o da Equipe B entrega para uma função Lambda, o da Equipe C para uma tabela do Amazon DynamoDB.
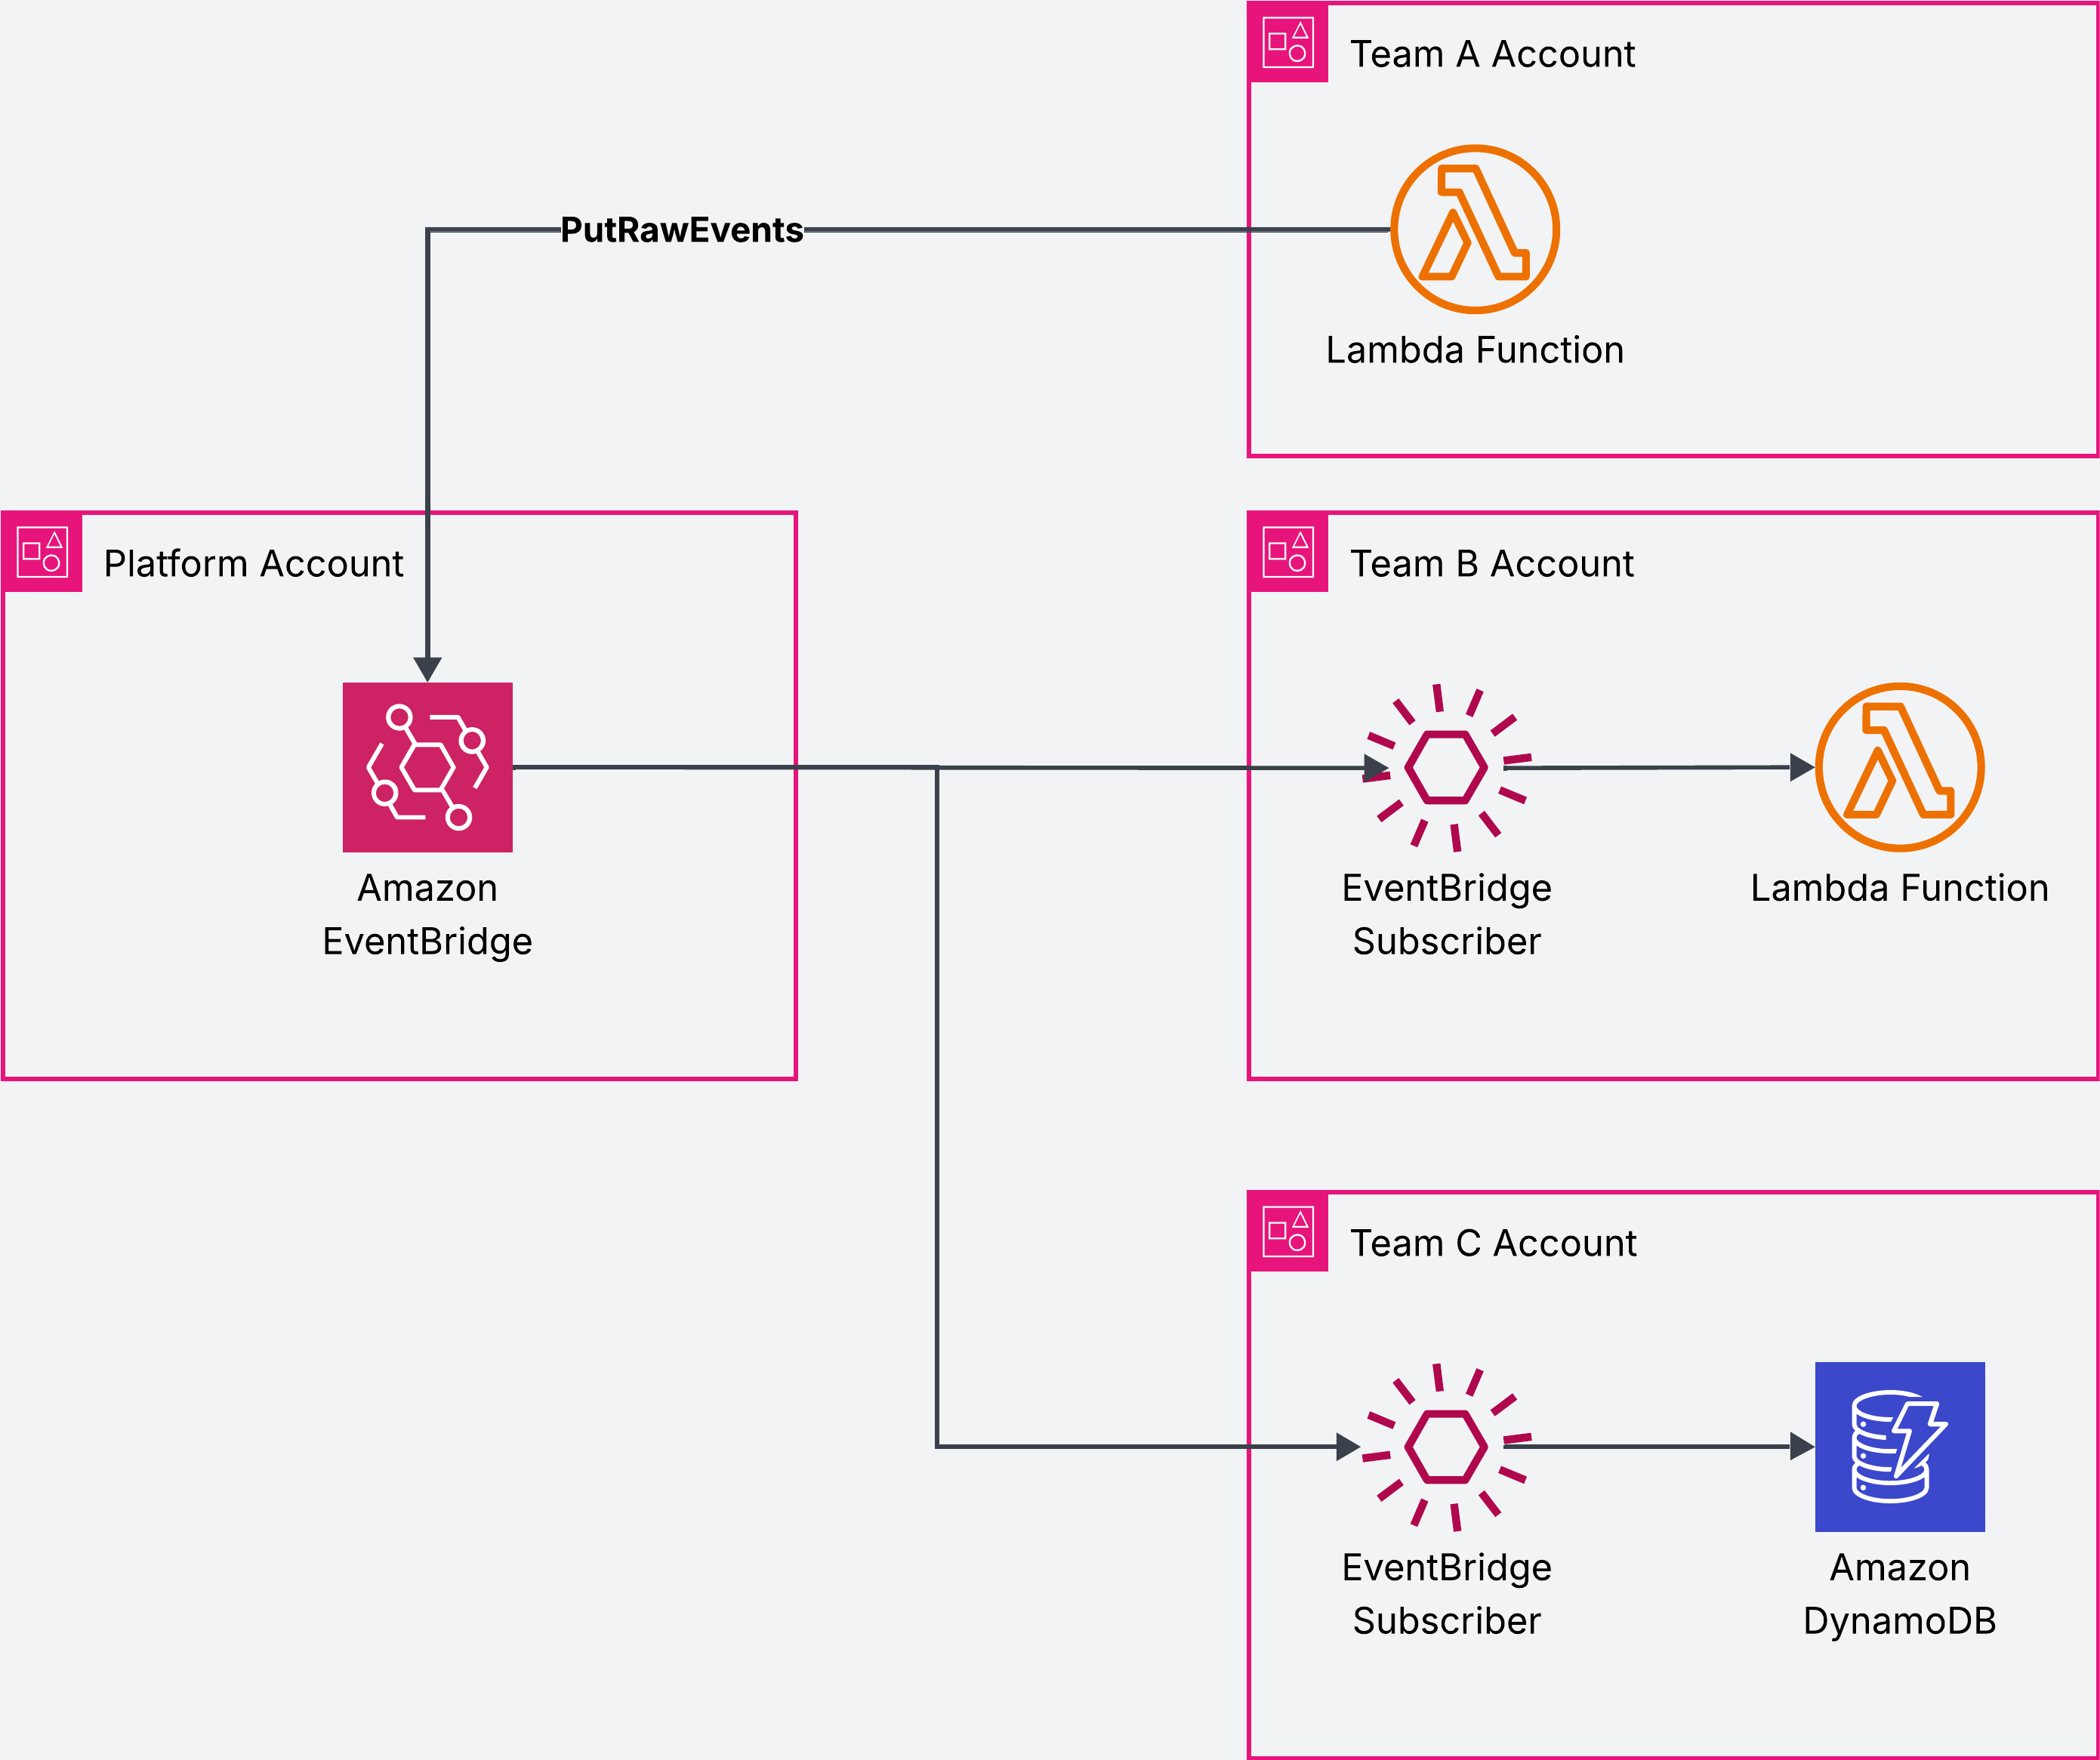
Figura 1: Compartilhamento entre múltiplas contas
O custo acompanha os limites das equipes porque as cobranças separam a ingestão da entrega. A conta que publica um evento paga para colocá-lo no bus, e a conta que possui um Subscriber paga pelo que esse Subscriber consome. O uso de cada equipe aparece em sua própria fatura, o que é o que torna um bus compartilhado algo que uma equipe de plataforma pode repassar como custo, em vez de um centro de custo compartilhado que ninguém consegue decompor. Remover os saltos de encaminhamento também remove a ingestão e a entrega duplicadas que esses saltos criavam: o mesmo evento chegando aos mesmos três consumidores é ingerido uma vez em vez de três.
Publicando no formato que as equipes já usam
Nem todo produtor usa JSON. Equipes que padronizam a troca de eventos em uma organização frequentemente registram schemas e publicam payloads binários compactos, porque o schema é o contrato entre equipes que fazem implantações em seus próprios cronogramas. Aceitar os formatos que esses produtores já emitem é mais simples do que alterar cada um deles para converter para JSON primeiro.
Com o novo Custom event bus, as equipes de aplicação podem publicar eventos nos formatos Avro, Protobuf e CloudEvents (JSON). Para os formatos binários, um schema registry indicado na solicitação é usado para desserializar os eventos.
Existem duas APIs de publicação, e o payload determina qual delas chamar. PutEvents recebe JSON estruturado com os já conhecidos campos Detail, Source e DetailType. PutRawEvents recebe um payload binário mais metadados que você define, e é a opção a usar para Avro, Protobuf, CloudEvents ou bytes que o bus não deve interpretar.
O schema registry pode ser o AWS Glue Schema Registry ou o Confluent Cloud Schema Registry.
Como o bus decodifica o evento antes de os filtros e transformações serem executados, um consumidor que assina eventos Avro escritos por outra equipe não precisa de schema, decodificador ou acesso ao registry. Ele escreve o mesmo filtro que escreveria contra JSON. Produtores e consumidores permanecem desacoplados, e nenhum código de desserialização precisa ser repetido em cada equipe consumidora.
Os publicadores têm mais uma configuração na mesma solicitação: deduplicação. Uma repetição que já teve sucesso deixaria, de outra forma, uma duplicata para cada consumidor tratar. Ela funciona de duas maneiras: o bus gera um hash do conteúdo de cada evento, ou usa um ID de deduplicação fornecido por você. O hash baseado em conteúdo é adequado para produtores sem uma chave natural, já que dois eventos idênticos geram o mesmo hash. Um ID de deduplicação se encaixa quando você já tem um, como um ID de pedido combinado com uma transição de estado. Ele continua correspondendo mesmo quando partes do payload diferem de formas que não deveriam contar como um novo evento.
Integração self-service para equipes de aplicação
O novo Custom event bus introduz um novo recurso chamado Subscriber. As equipes de aplicação criam e configuram seus próprios Subscribers em suas próprias contas, desde que tenham recebido acesso de assinatura ao bus. Um Subscriber é o único lugar onde o comportamento de um consumidor é definido: quais eventos ele recebe, para onde são entregues, como a entrega é repetida, e para onde os eventos vão quando a entrega não é bem-sucedida. Revisar ou alterar um consumidor é uma única coisa a ler e uma única coisa a atualizar.
O escopo de um filtro determina qual parte do evento é comparada com o padrão. DATA corresponde ao payload, METADATA corresponde aos pares chave-valor que o publicador anexou ao evento, e SYSTEM_METADATA corresponde aos campos de sistema do evento: o tipo de conteúdo e a chave de ordenação que um publicador declara, além dos campos que o próprio Amazon EventBridge adiciona. Como os payloads Avro e Protobuf são decodificados no momento em que são publicados, um filtro DATA lê seus campos diretamente, da mesma forma que faria para JSON.
A política de repetição determina como o bus deve se comportar quando um destino está falhando. MaxRetryAttempts define quantas vezes uma entrega é repetida, e MaxEventAgeInSeconds define por quanto tempo um evento permanece elegível para repetição, medido a partir do momento em que foi publicado. As repetições cessam assim que qualquer um dos limites é atingido, então ambos limitam a mesma entrega.
Quando as entregas falham, o motivo aparece nos próprios logs do Subscriber, que as equipes de aplicação podem ativar por conta própria. Eles registram o erro de cada tentativa de entrega junto com a entrada exata enviada ao destino, o que torna rápido localizar um problema. Ver o que o destino realmente recebeu diferencia uma transformação que produziu a forma errada de um destino que rejeitou uma forma correta.
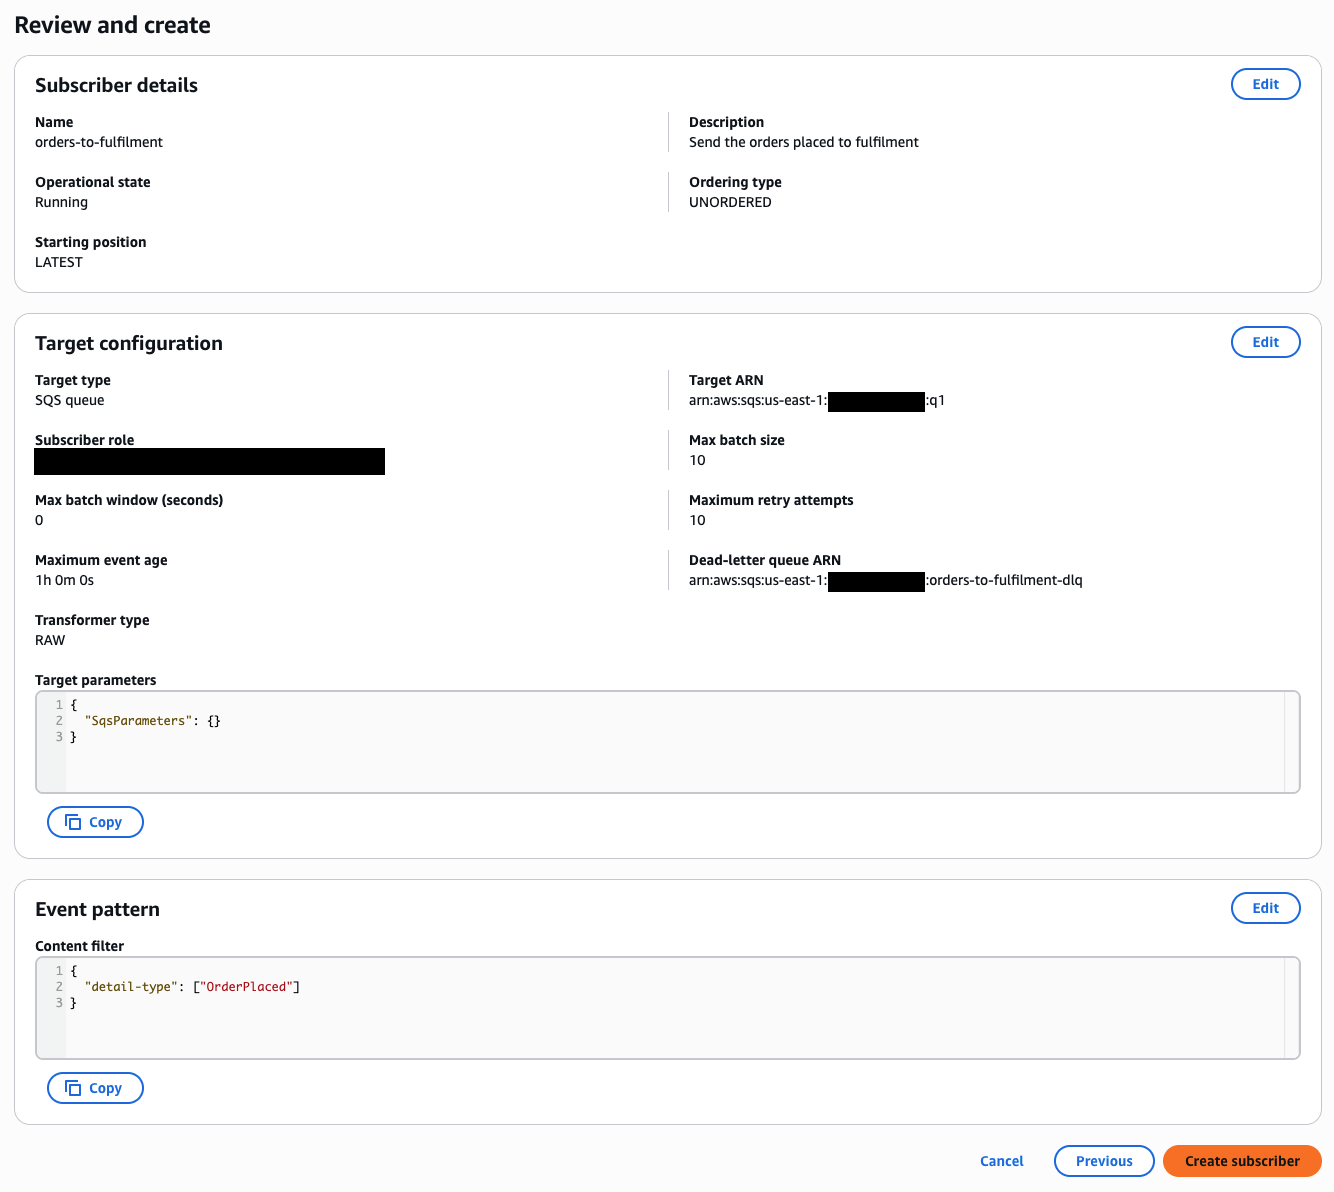
Histórico para consumidores que ainda não existiam
Um Subscriber às vezes precisa de eventos que foram publicados antes de sua existência. Por exemplo, um novo serviço de análise precisa ser alimentado com histórico recente, ou um destino processou incorretamente uma janela de eventos e precisa que essa janela seja reproduzida novamente. Como o bus retém eventos pelo período configurado nele, um Subscriber pode ser criado com uma posição inicial no passado, para que leia o histórico, se atualize e continue com o tráfego em tempo real:
Uma posição inicial é LATEST ou POINT_IN_TIME. Escolher POINT_IN_TIME requer então uma configuração de ponto no tempo: um PointType de TIMESTAMP com um ponto de partida, ou HORIZON para começar no evento mais antigo ainda retido. Um ponto final opcional interrompe a leitura em um momento escolhido, o que é útil ao reprocessar uma janela conhecida como problemática, em vez de se atualizar até o tráfego em tempo real.
Duas coisas a ter em mente. A posição inicial é fixada no momento em que o Subscriber é criado, então ler uma janela diferente significa criar um novo Subscriber. Trate a posição inicial como parte da identidade de um Subscriber, e não como um controle a ser ajustado depois. E a retenção não pode alcançar além da janela de retenção, então a leitura começa no evento retido mais antigo, independentemente de quão longe no passado o timestamp solicite.
Ordem, onde a ordem importa
Em arquiteturas orientadas a eventos, onde os componentes são construídos para funcionar de forma assíncrona, a ordem em que os eventos chegam geralmente não importa. Ainda existem casos de uso em que um consumidor depende de entrega ordenada, e o novo Custom event bus oferece isso como uma opção em Subscribers individuais.
A ordenação é definida por uma chave que o publicador define. Um publicador inclui um ID de grupo de eventos (um ID de cliente, um ID de pedido, um ID de motorista), e um Subscriber criado com tipo de entrega FIFO recebe os eventos de cada grupo na ordem em que foram publicados. Um Subscriber FIFO que lê eventos publicados sem um ID de grupo não tem nada para sequenciar, então os dois lados trabalham em conjunto. Criar um requer a mesma chamada de um Subscriber não ordenado, com o tipo de entrega definido como FIFO:
A ordenação é por grupo, então a taxa de transferência escala com o número de grupos. Se um evento não puder ser entregue, ele bloqueia o restante de seu próprio grupo enquanto outros grupos continuam avançando. Escolher a chave, portanto, é importante: uma que mapeie para uma entidade de negócio, como um pedido ou um cliente, oferece sequenciamento onde é necessário e independência em todo o resto. Uma chave tão ampla que a maioria dos eventos a compartilha coloca todos eles em uma única sequência, e uma chave tão específica que cada evento tem a sua própria não deixa nada para ordenar.
Como a ordenação é definida em cada Subscriber, os consumidores dos mesmos eventos não precisam concordar sobre isso. Um serviço de inventário pode receber os eventos de um grupo em sequência enquanto um serviço de análise que assina esses mesmos eventos os recebe conforme chegam.
Remodelando eventos e entregando diretamente a um destino
A lógica de negócio de um consumidor espera eventos em uma forma específica, e os eventos no bus não estão sempre nessa forma. Onde as duas coisas são reconciliadas é uma decisão de propriedade: dentro do consumidor, onde se torna parte do código dessa equipe, ou no Subscriber, antes dele.
O primeiro caso é a reformatação. Um sistema downstream, frequentemente pertencente a outro domínio ou totalmente externo à organização, espera uma estrutura diferente daquela que o publicador emite. Um transformador JSONata no Subscriber produz essa estrutura antes da entrega, para que o consumidor receba o que já espera. A lógica de negócio permanece onde deve estar, e quando a forma publicada muda upstream, ou outro tipo de evento precisa ser derivado para a mesma entrada, é o transformador que muda, e não o consumidor:
O tipo de transformador determina a forma do que é entregue. RAW entrega o payload do evento como está e é o padrão, então um Subscriber sem configuração de transformador recebe apenas o payload. WITH_METADATA adiciona o envelope do evento junto com ele, e JSONATA remodela o payload com uma expressão envolvida em {% %}.
A transformação remodela eventos apenas para o Subscriber que a possui e não afeta o que outros Subscribers do mesmo bus recebem. Isso também a torna um controle de minimização de dados: um parceiro pode receber apenas os campos de que precisa, em vez de um evento interno completo. Defini-la no Subscriber significa que ela se aplica a todo evento sem que ninguém precise lembrar de remover campos.
O segundo caso é chamar uma API de serviço da AWS. Um Subscriber entrega diretamente a destinos, incluindo Amazon Simple Queue Service (Amazon SQS), Amazon Simple Notification Service (Amazon SNS), AWS Lambda, e Amazon Kinesis Data Streams. Para outros serviços, tem sido prática comum adicionar uma etapa de proxy cujo único trabalho é fazer a chamada. Com destinos universais, o novo Custom event bus pode chamar diretamente uma API de serviço da AWS compatível, com o corpo da solicitação construído por uma expressão JSONata.
Observe que um destino universal define sua entrada por meio desse parâmetro, em vez do transformador anterior, e configurar um transformador em um deles é rejeitado quando o Subscriber é criado. Os dois mecanismos realizam o mesmo tipo de trabalho em destinos diferentes.
Isso remove o processamento de proxy que existia apenas para fazer a chamada. A role de entrega ainda precisa da ação exigida pelo destino, e configurá-la incorretamente é a causa mais comum de um Subscriber que parece saudável, mas não entrega nada.
Conclusão
Executar uma aplicação orientada a eventos em várias contas não significa mais operar vários event buses e o encaminhamento entre eles. Uma equipe de plataforma cria um novo Custom event bus, o compartilha em toda a organização por meio do AWS Resource Access Manager ou de uma política de recursos no bus, e mantém um único lugar para decidir quem publica e quem consome. As equipes de aplicação criam e gerenciam seus próprios Subscribers sem esperar pelo provisionamento. A ingestão e a entrega são cobradas separadamente, então o uso de cada equipe aparece em sua própria fatura, e a ingestão duplicada que os saltos de encaminhamento criavam desaparece junto com os saltos.
Os recursos que antes enviavam equipes individuais para outros lugares agora residem no mesmo bus. A ordenação é por Subscriber e definida por uma chave fornecida pelo publicador, então o requisito de sequenciamento de uma equipe não fragmenta mais uma arquitetura. A retenção possibilita integrar um consumidor que precisa de histórico ao qual nunca esteve inscrito. Avro e Protobuf são decodificados pelo bus, então os produtores mantêm seus contratos binários. Transformação e destinos universais mantêm a lógica de negócio onde ela deve estar, eliminando as etapas de proxy que existiam apenas para remodelar um evento ou fazer uma chamada de API.
Como o novo Custom event bus funciona junto com o Custom event bus – classic, a adoção é incremental. Direcione um novo consumidor para um bus compartilhado ou encaminhe uma parte de um bus existente para ele, e migre o restante conforme as equipes estiverem prontas.
Próximos passos. Crie um bus, adicione um Subscriber e publique um evento, começando pela documentação do Amazon EventBridge para o modelo de recursos e pela referência da AWS Command Line Interface (AWS CLI). Se você já opera Custom event buses, o guia de migração aborda como rotear eventos existentes para um novo Custom event bus sem alterar os produtores. A partir daí, veja as opções de logging e métricas do Subscriber para rastrear um evento desde a publicação até a entrega, e consulte o AWS Resource Access Manager para entender como o compartilhamento e as permissões funcionam em uma organização. Se você tiver dúvidas ou feedback sobre o novo Custom event bus, deixe um comentário nesta publicação. Gostaríamos de saber como você está usando isso.
Este conteúdo foi traduzido a partir da publicação original do blog, que pode ser encontrada aqui.
Biografia do Autores
 |
Nahid Karimaghalou é Principal Software Development Engineer na Amazon Web Services. |
 |
Jamie Dool é Principal Product Manager Technical na Amazon Web Services. |
 |
Tolga Orhon é Senior Technical Account Manager na Amazon Web Services. |
Biografia do tradutores
 |
Daniel Abib é Arquiteto de Soluções Sênior e Especialista em Amazon Bedrock na AWS, com mais de 25 anos trabalhando com gerenciamento de projetos, arquiteturas de soluções escaláveis, desenvolvimento de sistemas e CI/CD, microsserviços, arquitetura Serverless & Containers e especialização em Machine Learning. Ele trabalha apoiando Startups, ajudando-os em sua jornada para a nuvem. https://www.linkedin.com/in/danielabib/ |
 |
Nicolas Tarzia é Senior Technical Account Manager na AWS, com mais de 13 anos de experiência, com ampla experiência em arquitetura cloud, engenharia e design de software. Atualmente está habilitando empresas do ramo de ISV (Independent Software Vendors) simplificando a operação na nuvem e otimizando os custos em cloud. Sua área de interesse são tecnologias serverless. https://www.linkedin.com/in/nicolastarzia |