O blog da AWS
Perguntas e respostas com controle editorial usando Amazon Bedrock
Por Rafael Werneck, Arquiteto de Prototipação Sênior na AWS Brasil e Mary Vigna, Gerente de Programas Sênior na AWS Brasil.
Assistentes de perguntas e respostas baseados em geração de texto com IA generativa oferecem experiências conversacionais ricas, mas apresentam um desafio fundamental: não é possível ter certeza de que as respostas geradas serão sempre precisas. Técnicas como Geração Aumentada via Recuperação (Retrieval Augmented Generation, RAG), instruções de sistema bem elaboradas e filtros de saída reduzem esse risco, mas não o eliminam. Para muitos casos de uso, esse nível de controle é suficiente. Para outros, não é.
Pense em uma organização cujas mensagens externas precisam seguir uma redação aprovada pelas áreas jurídica, de conformidade ou de comunicação. Nesse cenário, uma resposta parcialmente correta, ou correta, mas com um tom inadequado, já é um problema. Para casos assim, uma abordagem alternativa é construir o assistente sobre uma base de perguntas e respostas curadas e pré-aprovadas, em que toda resposta exibida ao usuário passou por controle editorial humano.
Este post apresenta essa abordagem e mostra como usar IA generativa não para gerar respostas em tempo real, mas para expandir continuamente a base curada. Você vai ver uma arquitetura na AWS que combina o controle editorial de conteúdo pré-aprovado com a capacidade da IA de acelerar a criação de novos pares de perguntas e respostas. Também vai ver boas práticas para cada etapa.
Gerar ou recuperar: quando usar conteúdo curado
Um assistente generativo cria a resposta no momento da pergunta. Ele cobre um universo amplo de perguntas e se adapta à forma como cada usuário se expressa, mas cada resposta é nova e ninguém a viu antes de chegar ao usuário.
Um assistente baseado em conteúdo curado faz algo mais restrito. Ele busca, em uma base de pares já aprovados, a pergunta que melhor corresponde à intenção do usuário e exibe a resposta associada, sem criar texto novo. Isso traz algumas propriedades úteis:
- Controle editorial: cada resposta tem redação, tom e nível de detalhe definidos por quem é responsável pelo conteúdo.
- Consistência: cada pergunta curada exibe sempre a mesma resposta aprovada, com a mesma redação.
- Auditabilidade: você sabe com precisão o que foi exibido, porque o conjunto de respostas possíveis é finito e versionável.
- Risco limitado: no pior caso, o assistente exibe uma resposta aprovada que não corresponde à pergunta, e não uma resposta gerada sem revisão.
A limitação também é clara: o assistente só responde o que está na base. Se a base não cobre uma dúvida, o usuário fica sem resposta do assistente e pode, por exemplo, ser encaminhado para um atendimento humano. É aqui que a IA generativa volta a entrar em cena: ela gera respostas candidatas que ajudam a base a crescer, sem atender o usuário diretamente.
Considere o conteúdo curado quando:
- As respostas precisam de aprovação formal antes da publicação.
- As perguntas são numerosas, mas concentradas em temas recorrentes.
- Já existe uma base de perguntas frequentes que pode servir de ponto de partida.
Visão geral da arquitetura
A arquitetura separa dois fluxos com objetivos distintos:
- Fluxo de atendimento: em tempo real, recebe a pergunta do usuário, encontra as perguntas curadas mais parecidas e exibe a resposta aprovada da pergunta escolhida. Não há geração de texto nesse caminho.
- Fluxo de expansão: de forma assíncrona, recebe as perguntas que não encontraram correspondência, gera respostas candidatas a partir de documentos de referência e as encaminha para revisão humana. As respostas aprovadas entram na base curada e passam a atender as próximas perguntas semelhantes, e não são exibidas ao usuário que fez a pergunta original.
A arquitetura usa os seguintes serviços:
- Amazon API Gateway e AWS Lambda: expõem a API do assistente e executam a lógica de cada etapa.
- Amazon Bedrock: fornece os modelos de embeddings, de reclassificação e de linguagem usados nos dois fluxos.
- Amazon Simple Storage Service (Amazon S3): armazena os documentos de referência.
- Amazon S3 Vectors: armazena o índice vetorial da base curada e, separadamente, o índice dos documentos de referência.
- Amazon Bedrock Knowledge Bases: gerencia a ingestão dos documentos de referência e a geração de respostas candidatas com RAG.
- Amazon Bedrock Guardrails: filtra conteúdo inadequado nas perguntas recebidas.
- Amazon DynamoDB: armazena as avaliações dos usuários e as respostas candidatas aguardando revisão.
- Amazon Simple Notification Service (Amazon SNS): notifica os revisores quando há uma nova resposta candidata.
O diagrama a seguir mostra os dois fluxos e como eles se conectam pela base curada.
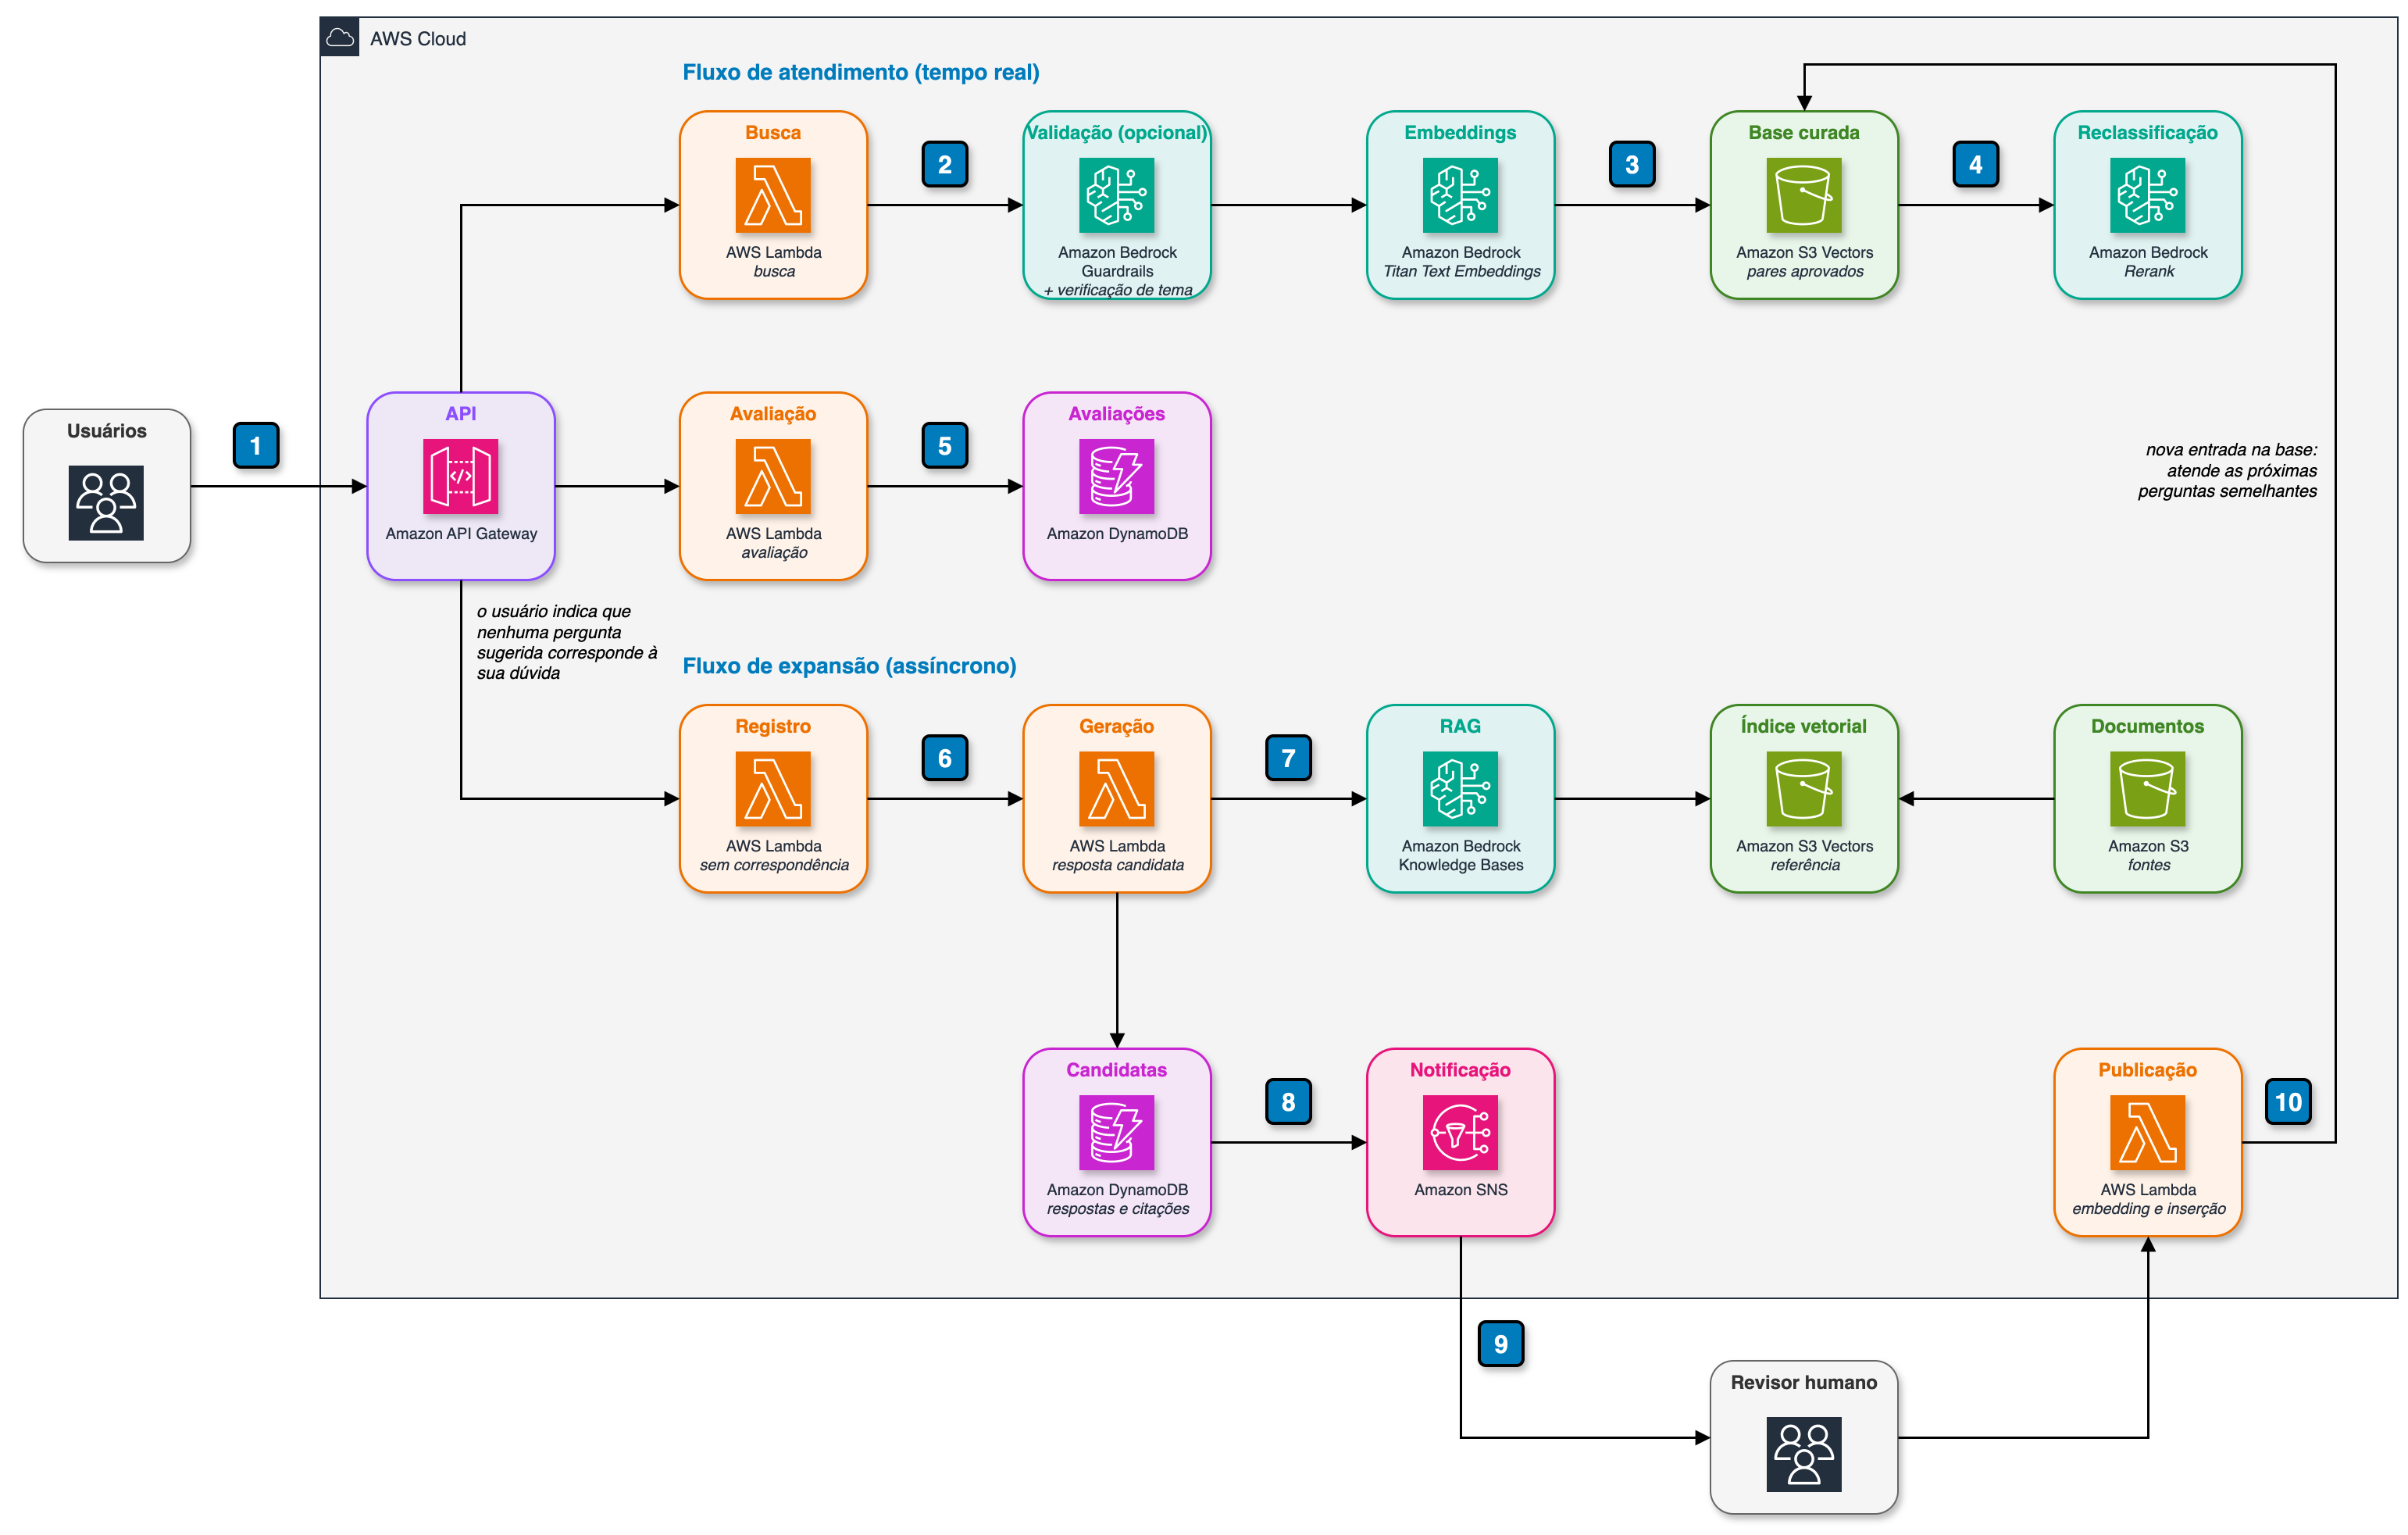
Figura 1: Diagrama de arquitetura com dois fluxos (atendimento e expansão).
Os passos numerados no diagrama são:
- A pergunta do usuário é enviada à API no Amazon API Gateway, que aciona a função de busca.
- Opcionalmente, a função de busca valida a pergunta com o Amazon Bedrock Guardrails e com um modelo que verifica se ela trata dos assuntos da base.
- A função gera o embedding da pergunta e consulta as perguntas curadas mais próximas no índice da base curada.
- Um modelo reclassificador descarta os resultados abaixo do limiar de relevância. O usuário escolhe uma das perguntas sugeridas e vê a resposta aprovada.
- O usuário avalia a resposta, e a avaliação é gravada no Amazon DynamoDB.
- Quando nenhuma das perguntas sugeridas corresponde à dúvida do usuário, ele indica isso e pode ser encaminhado para um atendimento humano. A função de registro dispara a geração de uma resposta candidata, que, depois de revisada, poderá atender perguntas futuras.
- O Amazon Bedrock Knowledge Bases recupera trechos dos documentos de referência e redige uma resposta candidata.
- A resposta candidata e as citações são gravadas no Amazon DynamoDB, e o Amazon SNS notifica o revisor.
- O revisor aprova, edita ou rejeita a resposta candidata.
- A resposta aprovada é inserida na base curada e passa a atender as próximas perguntas semelhantes.
Fluxo de atendimento: encontrar a pergunta certa
O trabalho do fluxo de atendimento é de busca semântica, não de geração. Cada par curado é armazenado no Amazon S3 Vectors como um vetor gerado a partir do texto da pergunta, por exemplo com os Modelos Incorporador de Texto do Amazon Titan. Quando o usuário envia uma pergunta, a função de busca gera o embedding dela com o mesmo modelo e consulta o índice pelos vizinhos mais próximos usando distância de cosseno.
Algumas práticas tornam esse fluxo mais simples e mais preciso:
Guarde a pergunta e a resposta como metadados do vetor. Com o S3 Vectors, você pode associar metadados a cada vetor e recuperá-los junto com os resultados da consulta. Declare a pergunta e a resposta como metadados não filtráveis na criação do índice, já que esse tipo de metadado comporta textos maiores. Assim, você recupera o par completo em uma única chamada, sem um segundo banco de dados no caminho do atendimento. Para mais informações, consulte Filtragem de metadados.
Reclassifique os resultados e aplique um limiar de relevância. A busca vetorial retorna os vizinhos mais próximos mesmo quando nenhum deles é realmente relevante. Um modelo reclassificador, como o Cohere Rerank 3.5 disponível no Amazon Bedrock, compara a pergunta do usuário com cada candidato e atribui uma pontuação de relevância. Descartar os candidatos abaixo de um limiar transforma “o mais próximo” em “próximo o suficiente”. Esse limiar controla o equilíbrio entre precisão e cobertura. Valores altos retornam menos resultados, porém mais relevantes, e geram mais casos sem correspondência. Valores baixos fazem o contrário. Ajuste o limiar com um conjunto de perguntas reais e avalie também se o reclassificador deve comparar a pergunta do usuário apenas com a pergunta curada ou com a pergunta e a resposta concatenadas. Para mais informações, consulte Melhore a relevância das respostas de consulta com um modelo reclassificador no Amazon Bedrock.
Em novembro de 2026, os modelos reclassificadores do Amazon Bedrock não estão disponíveis na região América do Sul (São Paulo). Se os seus requisitos de residência de dados exigirem que as perguntas dos usuários sejam processadas em uma região sem reclassificador, você pode dispensar essa etapa. Nesse caso, aplique o limiar diretamente sobre a distância retornada pela busca vetorial. Para conferir as regiões disponíveis, consulte Regiões e modelos compatíveis com reclassificação no Amazon Bedrock.
Deixe o usuário escolher a pergunta. Em vez de exibir diretamente a resposta do melhor resultado, apresente as perguntas candidatas, por exemplo as três mais relevantes. O usuário seleciona a que corresponde à sua dúvida. Essa etapa de confirmação reduz o risco de exibir uma resposta aprovada para a pergunta errada, que é o principal modo de falha dessa abordagem. Além disso, quando nenhuma das opções serve, o usuário pode indicar isso explicitamente, e essa indicação dispara o fluxo de expansão.
Colete avaliações das respostas. Depois de exibir a resposta, peça uma avaliação simples, como uma nota de uma a cinco estrelas, e grave-a no DynamoDB associada ao identificador do par. Com essas avaliações, você identifica respostas que precisam ser revisadas mesmo quando a correspondência está correta.
Validação de entrada proporcional ao risco
Em um assistente generativo, validar a entrada é essencial, porque uma pergunta inadequada pode induzir o modelo a produzir conteúdo nocivo. Em um assistente curado, esse risco não existe da mesma forma, porque toda resposta exibida vem da base aprovada. Se alguém enviar uma pergunta ofensiva ou fora do tema, o pior que pode acontecer é o assistente sugerir perguntas curadas que não têm relação com o que foi perguntado.
Por isso, a validação de entrada é opcional e deve ser avaliada como uma melhoria de experiência do usuário: com ela, o assistente responde com uma mensagem clara em vez de sugestões sem sentido. Duas camadas complementares funcionam bem:
- Filtros de conteúdo: o Amazon Bedrock Guardrails avalia a pergunta com a operação
ApplyGuardrail, sem precisar invocar um modelo de linguagem, e bloqueia categorias como discurso de ódio, insultos e tentativas de injeção de prompt, devolvendo uma mensagem padronizada. Como não há texto gerado, você pode deixar os filtros de saída desativados. Para mais informações, consulte Detectar e filtrar conteúdo nocivo usando as Barreiras de Proteção do Amazon Bedrock. - Verificação de tema: um modelo de linguagem pequeno e rápido verifica se a pergunta trata dos assuntos cobertos pela base. Se não tratar, o assistente informa ao usuário com quais assuntos pode ajudar. No prompt, instrua o modelo a considerar a pergunta dentro do tema quando houver dúvida. Assim, ele não rejeita perguntas legítimas só porque foram escritas de um jeito inesperado.
Os filtros de conteúdo e a verificação de tema fazem, cada um, uma chamada extra ao Amazon Bedrock antes da busca, o que aumenta a latência e o custo de cada pergunta. Avalie com dados reais se o ganho de experiência compensa. Em alguns casos, o limiar de relevância do reclassificador já descarta boa parte das perguntas fora do tema, porque elas não alcançam a pontuação mínima.
Fluxo de expansão: IA generativa para criar respostas candidatas
O fluxo de expansão começa quando o usuário informa que nenhuma pergunta curada atende à sua dúvida. Nesse caso, o assistente não tem uma resposta para esse usuário. Ele informa que a pergunta foi registrada e, opcionalmente, encaminha o usuário para um atendimento humano.
A API também invoca uma função Lambda, de forma assíncrona, para gerar uma resposta candidata. Essa resposta não é exibida ao usuário que fez a pergunta: depois de revisada, ela expande a base e atende perguntas futuras. Para detalhes, consulte Invocar uma função do Lambda de modo assíncrono.
Essa função gera uma resposta candidata com RAG usando o Amazon Bedrock Knowledge Bases. A base de conhecimento indexa um conjunto separado de documentos de referência, como manuais, normas internas e regulamentos, armazenados no Amazon S3 e vetorizados no S3 Vectors. A operação RetrieveAndGenerate recupera os trechos relevantes e usa um modelo de linguagem para redigir uma resposta fundamentada neles. Para configurar essa integração, consulte Usar o S3 Vectors com Bases de Conhecimento do Amazon Bedrock.
Mantenha a base curada e os documentos de referência separados. A base curada contém as respostas que podem ser exibidas aos usuários. Os documentos de referência não são exibidos: eles servem de fonte para que o modelo redija respostas candidatas, que vão expandir a base curada depois de revisadas.
Para facilitar a revisão, personalize o prompt de geração com instruções de tom, tamanho e estrutura, para que a resposta candidata já siga o estilo da base. Para mais informações, consulte Configurar e personalizar consultas e geração de respostas. Grave a resposta candidata no DynamoDB com as citações dos trechos usados como fonte, para que o revisor confira a fundamentação, e com status, como pendente, aprovada ou rejeitada.
Tenha cuidado também com dados pessoais. A pergunta que inicia o fluxo de expansão pode conter informações de identificação pessoal e, sem tratamento, seria enviada ao modelo de geração e gravada no DynamoDB. Por isso, trate esses dados logo na entrada do fluxo. Na função de registro, antes de disparar a geração, aplique os filtros de informações confidenciais do Amazon Bedrock Guardrails para bloquear ou mascarar esses dados. Em seguida, descarte a pergunta ou siga apenas com a versão anonimizada. Evite também registrar a pergunta original nos logs das funções. Para mais informações, consulte Remova as PII das conversas usando filtros de informações confidenciais.
Revisão humana e publicação
A revisão humana é o que sustenta a propriedade central da abordagem: o fluxo de atendimento exibe apenas respostas aprovadas. Um fluxo de revisão típico tem quatro passos:
- Notificação: quando uma nova resposta candidata é gravada, o revisor responsável é avisado, por exemplo por e-mail com o Amazon SNS, com a pergunta, a resposta e as citações.
- Decisão: o revisor aprova, edita e aprova, ou rejeita a candidata. Uma interface administrativa básica, com a fila de pendentes e as citações ao lado de cada resposta, costuma ser suficiente.
- Publicação: ao aprovar, o sistema gera o embedding da pergunta com o mesmo modelo usado na base e insere o novo vetor, com a pergunta e a resposta como metadados, no índice da base curada. A partir desse momento, o próximo usuário que fizer uma pergunta semelhante vai encontrá-la no fluxo de atendimento.
- Registro: o status da candidata é atualizado e a decisão é registrada com data, responsável e conteúdo publicado.
Trate a base curada como um ativo editorial versionado, com uma trilha de auditoria do que foi adicionado, alterado ou removido, e por quem. Para alterar uma resposta publicada, substitua o vetor correspondente (consulte Vetores) e mantenha o histórico de versões fora do índice para poder reverter alterações.
Antes de enviar uma candidata para revisão, verifique também se outra candidata pendente já cobre a mesma pergunta, para evitar trabalho repetido. Para isso, gere os embeddings das perguntas pendentes com o mesmo modelo usado na base e armazene-os em um índice separado no S3 Vectors. Quando chegar uma nova pergunta sem correspondência, consulte esse índice. Se houver uma pendente com distância abaixo de um limiar, associe a nova pergunta a ela em vez de criar outra candidata.
Fechando o ciclo com sinais dos usuários
Os dois fluxos produzem sinais que, juntos, mostram onde a base precisa evoluir:
- Perguntas sem correspondência indicam lacunas de cobertura. A frequência com que perguntas semelhantes aparecem ajuda a priorizar a fila de revisão.
- Avaliações baixas em respostas com correspondência correta indicam conteúdo que precisa ser reescrito ou atualizado.
- Pontuações de relevância do reclassificador, acompanhadas ao longo do tempo, indicam se o limiar está bem calibrado e se a base está acompanhando a forma como os usuários se expressam.
Acompanhe também o tempo médio entre a geração de uma candidata e a decisão do revisor, que mostra se a revisão humana está acompanhando a demanda.
Conclusão
Ao separar o caminho de atendimento do caminho editorial, é possível construir um assistente de perguntas e respostas em que toda resposta exibida foi aprovada por uma pessoa, sem renunciar à IA generativa. No atendimento, os modelos de embeddings e de reclassificação identificam a pergunta curada mais próxima da intenção do usuário. Na expansão, um modelo de linguagem redige respostas candidatas fundamentadas em documentos de referência, e a decisão de publicar continua com quem é responsável pelo conteúdo. O resultado é uma base que cresce a partir das dúvidas reais dos usuários, com o mesmo controle editorial do primeiro dia.
Esse padrão é útil em domínios em que a precisão e a forma da comunicação importam mais do que a flexibilidade de uma resposta gerada na hora.
Próximos passos
- Crie seu primeiro índice vetorial seguindo Trabalhar com o S3 Vectors e buckets de vetores.
- Configure uma base de conhecimento para os documentos de referência com Recuperar dados e gerar respostas de IA com as Bases de Conhecimento do Amazon Bedrock.
- Se a base cobrir mais de um assunto, armazene o assunto como um metadado filtrável de cada vetor e filtre a consulta por ele.
- Experimente diferentes limiares e estratégias de reclassificação com um conjunto de perguntas reais dos seus usuários.
- Para aumentar a cobertura da busca, use IA generativa para sugerir variações de redação das perguntas curadas. Submeta as variações à mesma revisão humana e indexe cada uma como um vetor que aponta para a mesma resposta.
Autores
 |
Rafael Werneck é um Arquiteto de Prototipação Sênior na AWS Brasil. Anteriormente, trabalhou como Software Development Engineer na Amazon.com.br e no Amazon RDS Performance Insights. https://www.linkedin.com/in/rafael-werneck/ |
 |
Mary Vigna é Gerente de Programas Sênior na AWS Brasil. Trabalha com clientes em engajamentos de prototipação para transformar idéias em soluções na AWS, com foco em IA generativa. Com mais de 20 anos de experiência em gestão de programas técnicos e liderança de equipes de entrega, atualmente foca em programas relacionados a tecnologias emergentes. https://www.linkedin.com/in/mavigna/ |