O blog da AWS
Resiliência a desconexões de rede com Amazon EKS Hybrid Nodes
Por Bruno Lopes, Sr. Specialist Solutions Architect de Containers na AWS.
Seus workloads Kubernetes on-premises estão rodando normalmente. Então o link para a sua AWS Region cai: um rompimento de fibra, uma renegociação de VPN que falha, uma mudança de firewall durante uma janela de manutenção. Em menos de um minuto, kubectl get nodes reporta seus nodes on-premises como NotReady. Uma única pergunta separa um incidente completo de uma indisponibilidade que seus usuários nunca percebem: as aplicações naquele data center continuam servindo tráfego?
Para um número crescente de organizações, a resposta precisa ser sim. Uma plataforma de pagamentos regulada, os operários no chão de fábrica de uma indústria, um sistema hospitalar ou uma internal developer platform (IDP) que hospeda serviços de produção em dois data centers compartilham um requisito rígido: se a conexão com a cloud é perdida, o data center precisa continuar operando.
O Amazon EKS Hybrid Nodes permite conectar infraestrutura on-premises e de edge a um cluster Amazon Elastic Kubernetes Service (Amazon EKS) como remote nodes, de forma que um único control plane gerencia workloads onde quer que eles rodem. Essa arquitetura coloca o control plane na AWS Region por design, o que levanta uma pergunta de todo time de plataforma que a avalia: o que acontece on-premises quando a Region se torna inalcançável?
Os pods em execução continuam rodando. Por quanto tempo eles continuam rodando depende da configuração que você aplica de antemão. O Kubernetes já absorve uma interrupção breve: pods em um node inalcançável só são evicted (o termo do Kubernetes para a remoção de pods de um node) depois de 5 minutos, e esses 5 minutos são um default aplicado a pods que não declaram uma preferência, não um teto. Um link que oscila e recupera dentro dessa janela não custa nada a você. O problema é que falhas reais raramente cabem em 5 minutos. Um reparo de fibra, um circuito com defeito ou um incidente do provedor duram horas, e passada essa janela default o Kubernetes começa a fazer eviction de pods saudáveis de nodes que ele simplesmente não consegue alcançar.
Essa é a decisão arquitetural que exploramos nesse post. Você pode aceitar o padrão e tratar uma desconexão mais longa como um evento de disaster recovery, com failover para outro site e tudo o que vem com isso, ou pode configurar o cluster para que o data center atravesse a desconexão no lugar e reconcilie quando o link voltar. A segunda opção é normalmente mais barata e muito menos disruptiva, mas não é o default, e várias dependências que parecem locais na verdade resolvem pela cloud. Você não consegue corrigir nenhuma delas enquanto está desconectado, porque toda correção é uma operação de control plane.
Neste post, percorremos o comportamento de falha do EKS Hybrid Nodes durante uma desconexão de rede e configuramos quatro camadas de resiliência: controle de eviction de pods, DNS interno do cluster, disponibilidade local de imagens de container e um ponto de entrada local de tráfego. Injetamos a falha com o AWS Fault Injection Service (AWS FIS) para que os resultados sejam reproduzíveis, e somos explícitos sobre as limitações que nenhuma configuração remove.
Pré-requisitos
- Um cluster EKS com EKS Hybrid Nodes registrados, com pelo menos dois nodes on-premises
- Cilium como Container Network Interface (CNI), que é o CNI que a AWS suporta para hybrid nodes, ou Calico, documentado como exemplo no repositório EKS Hybrid Examples
- Nada de Amazon VPC CNI, que não é compatível com hybrid nodes e vem com anti-affinity para a label
eks.amazonaws.com/compute-type: hybrid - Conectividade privada via AWS Direct Connect ou AWS Site-to-Site VPN
- Familiaridade com taints, tolerations e Services do Kubernetes
- Permissões para executar experimentos do AWS FIS, e
kubectl, Helm e Terraform instalados
O que uma desconexão quebra
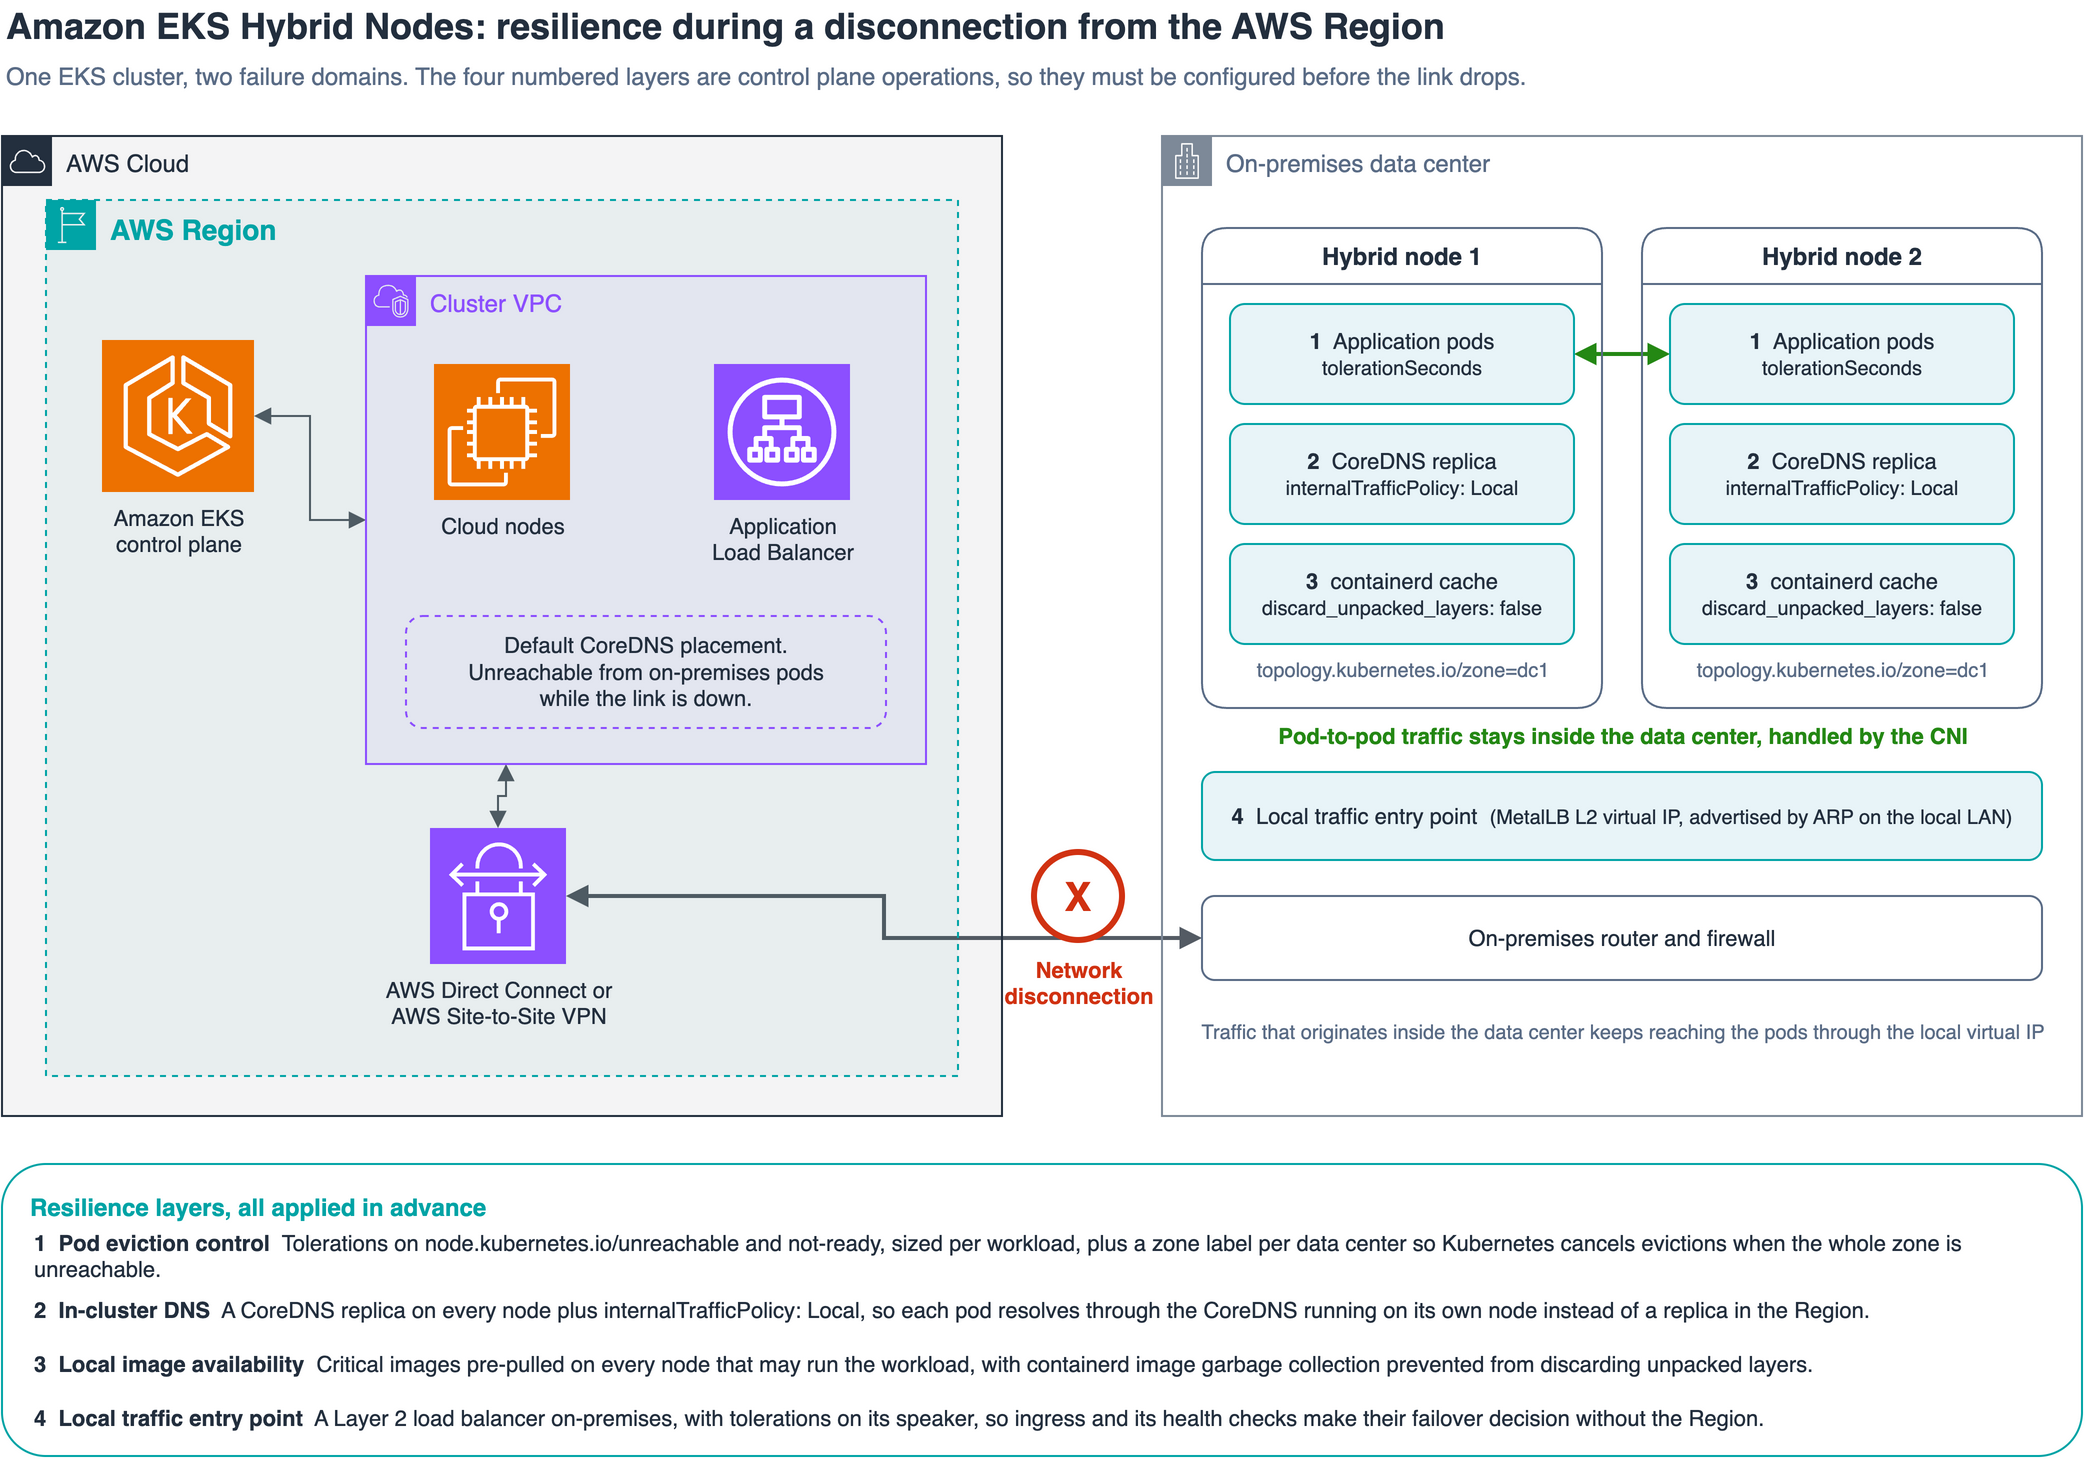
Figura 1: Um único cluster EKS abrangendo a AWS Region e um data center on-premises, com as quatro camadas de resiliência aplicadas aos hybrid nodes.
Para raciocinar sobre a falha, você precisa saber quais caminhos existem. A documentação de network traffic flows para hybrid nodes detalha cada um deles. Três importam aqui:
kubeletpara o control plane do EKS. Okubeletreporta o status do node e busca as specs dos pods. Com um endpoint de cluster público, esse tráfego resolve para um IP público e sai pela sua borda de internet. Com um endpoint privado, ele atravessa o AWS Direct Connect ou a sua VPN.- Control plane do EKS para o
kubelet. O API server alcança a porta10250no IP do node através da sua VPC e da conexão híbrida. Esse caminho carregakubectl logsekubectl exec. - Pod-to-pod nos hybrid nodes. O tráfego east-west entre pods nos seus nodes on-premises permanece dentro do seu data center e é tratado pelo CNI.
Esse terceiro caminho é o motivo pelo qual o data center sobrevive. O tráfego pod-to-pod entre nodes on-premises não transita pela AWS. Nos nossos testes com o Cilium em modo Virtual Extensible LAN (VXLAN), a comunicação entre pods em nodes diferentes dentro do data center retornou HTTP 200 durante toda a desconexão, porque o datapath VXLAN é programado no kernel via extended Berkeley Packet Filter (eBPF) e não consulta o API server para encaminhar um pacote.
Os caminhos que quebram são os que se originam na Region ou transitam por ela: operações de control plane, um Application Load Balancer roteando para pods on-premises, métricas enviadas para o Amazon CloudWatch e qualquer coisa que resolva um nome através de um componente rodando na cloud.
Dois gatilhos independentes produzem sintomas diferentes, e confundi-los causa diagnóstico errado:
- Cortar o data path (Region para on-premises) quebra o tráfego de pods entre os dois lados do cluster e o ingress originado na Region. Se o endpoint do seu cluster é público, o node continua alcançando o API server pela internet e permanece
Ready. - Cortar o caminho do control plane (node para API server) faz o node ir para
NotReadye inicia o relógio de eviction. No nosso ambiente, os dois nodes reportaramNotReadycerca de 60 segundos depois de bloquearmos o endpoint.
Em produção com um endpoint privado sobre AWS Direct Connect, uma única falha de link corta os dois caminhos ao mesmo tempo. Quando você testar, corte os dois.
Camada 1: Impeça o Kubernetes de fazer eviction de pods saudáveis
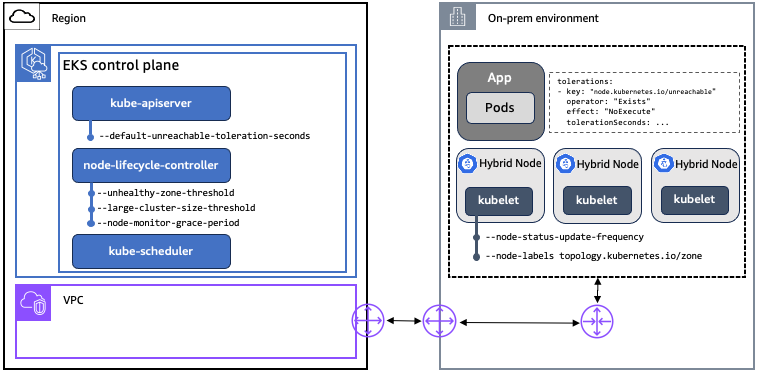
Figura 2: Os componentes do Kubernetes que decidem o failover de pods durante uma desconexão. Fonte: Amazon EKS Best Practices Guide.
Quando um node para de enviar heartbeats, o node lifecycle controller aplica o taint node.kubernetes.io/unreachable com efeito NoExecute. Por default, os pods são evicted 300 segundos depois. Durante uma desconexão esse eviction é inútil: o scheduler não consegue colocar os pods em nenhum outro lugar, porque os únicos nodes com capacidade são exatamente os que ele não alcança. Ele remove capacidade que estava funcionando e não ganha nada.
As tolerations controlam essa janela:
tolerations:
  # The node lifecycle controller adds these taints when the node stops responding.
  # Declaring them here OVERRIDES the 300s default that the DefaultTolerationSeconds
  # admission controller would otherwise inject: the value below is the effective one.
  # Omitting tolerationSeconds means the pod tolerates the taint indefinitely.
  - key: "node.kubernetes.io/unreachable"
    operator: "Exists"
    effect: "NoExecute"
    tolerationSeconds: 3600
  - key: "node.kubernetes.io/not-ready"
    operator: "Exists"
    effect: "NoExecute"
    tolerationSeconds: 3600
Verifique se o workload em execução as carrega:
kubectl get deploy <deployment-name> -n <namespace> \
  -o jsonpath='{.spec.template.spec.tolerations}' | jq '.'
De onde vem o default de 300 segundos, e como a sua toleration o sobrepõe
Este é o ponto que causa mais confusão, então vale ser preciso sobre os dois níveis distintos envolvidos.
Nível 1, o default do cluster. Você nunca declarou aquela janela de 300 segundos. O admission controller DefaultTolerationSeconds a injeta. Na admissão do pod, o plugin adiciona uma toleration para node.kubernetes.io/unreachable e node.kubernetes.io/not-ready com tolerationSeconds vindo das flags do API server --default-unreachable-toleration-seconds e --default-not-ready-toleration-seconds, ambas 300 por default. Ele injeta essa toleration somente em pods que ainda não declaram uma para aquele taint.
No Amazon EKS as flags do API server são gerenciadas pelo serviço. O Amazon EKS Best Practices Guide lista default-unreachable-toleration-seconds com valor 300 e o marca como não configurável no EKS, ao lado de node-monitor-grace-period (40 segundos), que é o motivo pelo qual um node leva de 40 a 60 segundos para ser marcado como não saudável em primeiro lugar. Ou seja, você não move o piso do cluster.
Nível 2, a pod spec, que prevalece. Isso não é um limite para os seus workloads. Justamente porque o admission controller pula qualquer pod que já tenha uma toleration para aqueles taints, um tolerationSeconds que você declara na pod spec não é mergeado com o default nem limitado por ele. Ele o substitui. Declare 3600 e a janela efetiva de eviction daquele pod é 3600 segundos, não 300. Omita tolerationSeconds por completo e o pod tolera o taint indefinidamente.
A leitura prática: 300 segundos é o default de quem fica calado, não é um teto. Defina no pod template do seu Deployment, StatefulSet ou DaemonSet e o valor passa a ser seu.
Duas consequências operacionais decorrem de isso ser uma mutação em tempo de admissão:
- Pods existentes não são atualizados. A toleration é resolvida quando o pod é criado. Adicionar tolerations ao pod template de um Deployment dispara um rollout, e somente os pods novos carregam a janela nova. Pods criados antes da mudança mantêm os 300 injetados.
- Valide no pod, não no Deployment. O Deployment mostra o que você pediu. O pod mostra o que o API server realmente admitiu, incluindo qualquer coisa injetada:
# What the admission controller resolved for a running pod
kubectl get pod <pod-name> -n <namespace> \
  -o jsonpath='{range .spec.tolerations[?(@.effect=="NoExecute")]}{.key}{"="}{.tolerationSeconds}{"\n"}{end}'
Um pod que não declara nada retorna o default injetado:
node.kubernetes.io/not-ready=300
node.kubernetes.io/unreachable=300
Um pod usando o manifesto anterior retorna o seu valor:
node.kubernetes.io/unreachable=3600
node.kubernetes.io/not-ready=3600
Se essa segunda saída ainda mostrar 300 depois de você aplicar o patch no Deployment, o rollout ainda não alcançou aquele pod.
Escolher tolerationSeconds é uma decisão de negócio
Não existe um valor universalmente correto, e este é o trade-off mais importante do design. O control plane não consegue distinguir uma desconexão de rede de um node morto, porque os dois parecem idênticos: nenhum heartbeat.
Se é uma desconexão, o node está vivo e servindo, então uma toleration longa é o correto. Se é uma falha real de node, os pods se foram, e uma toleration longa significa que o Kubernetes espera o tolerationSeconds completo antes de reagendar nos nodes saudáveis. Seu tempo de recuperação passa a ser igual à sua janela de toleration, enquanto o Kubernetes default teria se recuperado em 300 segundos.
A mesma configuração que te protege em um cenário te atrasa no outro, então escolha por workload:
| Perfil de workload | tolerationSeconds sugerido |
Justificativa |
|---|---|---|
| Stateless, réplicas em vários nodes | 300-900 | Outras réplicas absorvem o tráfego, então failover rápido em falha real de node importa mais |
| Stateful singleton | Longo ou indefinido | Um eviction falso arrisca split-brain |
| Batch e consumidores de fila | 60-300 | O trabalho é reenfileirado de qualquer forma, então reagendamento rápido ganha |
| Serviços críticos do data center | Longo, mais réplicas em múltiplos nodes | Sobrevive à desconexão via tolerations, sobrevive à falha de node via réplicas |
Duas coisas reduzem a pressão sobre essa decisão.
Réplicas em múltiplos nodes. Com réplicas em três nodes, uma toleration longa custa pouco. A falha de um único node degrada capacidade em vez de causar indisponibilidade, e o caso de desconexão fica totalmente coberto.
Zone labels. Se todo hybrid node de um data center carrega uma label topology.kubernetes.io/zone, o Kubernetes cancela os evictions quando uma zona inteira se torna inalcançável, mesmo sem tolerations customizadas. Esse é exatamente o caso “o data center inteiro perdeu a Region”, protegido por default. Dois adendos do Amazon EKS Best Practices Guide: esse cancelamento se aplica a clusters com mais de três nodes, e a AWS documenta uma race condition ocasional em que pods de exatamente um node inalcançável ainda podem ser evicted. Trate as zone labels como uma forte rede de segurança default, não como substituto das tolerations em workloads críticos. Defina a label no registro do node via nodeadm:
spec:
  kubelet:
    flags:
      - --node-labels=topology.kubernetes.io/zone=dc1
As tolerations passam a importar apenas para falhas parciais, em que alguns nodes estão inalcançáveis e outros não.
Como o default do cluster não pode ser movido, todo ajuste acontece por workload. As boas práticas para estabilidade durante desconexões de rede documentam três opções:
- DaemonSets, que são automaticamente configurados para tolerar o taint unreachable, então seus pods permanecem vinculados aos nodes durante uma desconexão sem configuração extra. Essa é a escolha certa para qualquer coisa que precise rodar em todo node.
tolerationSecondsna pod spec, como mostrado anteriormente, para os workloads onde você quer uma janela explícita de sobrevivência.- Um controller customizado que observa o taint unreachable com efeito
NoExecute, verifica métricas de saúde específicas da aplicação e remove o taint quando a aplicação está realmente saudável. Essa é a opção mais sofisticada, e é a única que permite distinguir um node alcançável mas não monitorado de um que realmente falhou.
A maioria dos times precisa apenas das duas primeiras. Recorra ao controller customizado quando a sua janela de sobrevivência precisa ser ilimitada mas você ainda quer detecção real de falha.
Camada 2: Corrija a dependência de DNS que você não vê
Esta é a falha que mais surpreende os times, e somente um teste de caos a revela.
Construímos uma stack de monitoramento que roda inteiramente nos hybrid nodes: Prometheus e Grafana on-premises, deliberadamente independentes da Region. Durante a desconexão o dashboard ficou em branco. O Prometheus estava rodando, o Grafana estava rodando, e os dois estavam no mesmo node. O problema é que o Grafana alcança o Prometheus por nome, e resolver esse nome exige o CoreDNS.
Verifique onde o CoreDNS roda:
kubectl get pods -n kube-system -l k8s-app=kube-dns -o wideEm um cluster EKS default, as réplicas do CoreDNS são agendadas em nodes na Region. Durante uma desconexão, pods nos hybrid nodes não conseguem alcançá-las, as queries de DNS dão timeout e toda aplicação on-premises que resolve um nome de Service falha, mesmo que o workload inteiro rode localmente. A stack local tinha uma dependência escondida da cloud na sua camada mais básica.
A correção tem três partes, todas aplicadas nesta ordem antes de qualquer desconexão:
# 1. Lift the cloud pin.
kubectl -n kube-system patch deploy coredns --type merge \
  -p '{"spec":{"template":{"spec":{"affinity":null}}}}'

# 2. One CoreDNS replica per schedulable node (match replicas to your node count).
#    maxSurge=0 forces kill-then-create so the topology spread converges.
kubectl -n kube-system patch deploy coredns --type merge \
  -p '{"spec":{"strategy":{"rollingUpdate":{"maxSurge":0,"maxUnavailable":1}},"replicas":3,"template":{"spec":{"topologySpreadConstraints":[{"maxSkew":1,"topologyKey":"kubernetes.io/hostname","whenUnsatisfiable":"DoNotSchedule","nodeTaintsPolicy":"Honor","labelSelector":{"matchLabels":{"k8s-app":"kube-dns"}}}]}}}}'
kubectl -n kube-system rollout restart deploy coredns

# 3. Only after step 2 shows one replica per node: node-local DNS.
kubectl -n kube-system patch svc kube-dns --type merge \
  -p '{"spec":{"internalTrafficPolicy":"Local"}}'
A ordem é determinante. O passo 1 importa porque o add-on CoreDNS do EKS fixa as réplicas fora dos hybrid nodes por design, garantindo o DNS do lado da cloud antes de você tornar a resolução node-local. O topology spread do passo 2 é um no-op no hybrid node enquanto esse pin existir. O passo 3 aplicado cedo demais é o perigoso: internalTrafficPolicy: Local significa que um node sem réplica local do CoreDNS fica sem DNS nenhum, então você só o ativa depois que o passo 2 mostrar uma réplica por node.
O internalTrafficPolicy: Local é a parte que faz isso funcionar. Sem ele, um pod consulta o ClusterIP do kube-dns e o kube-proxy faz load balancing entre todos os endpoints do CoreDNS, incluindo os que estão na Region. Algumas queries têm sucesso e outras dão timeout, o que produz falhas intermitentes dolorosas de diagnosticar. Com Local, o tráfego fica restrito aos endpoints no mesmo node. Em uma única execução de teste durante uma desconexão ativa, a resolução de nomes de um pod on-premises falhou aproximadamente uma vez em três sem a configuração, e teve sucesso em todas as 8 tentativas com ela. A amostra é pequena e ilustrativa em vez de estatisticamente rigorosa, mas o modo de falha que ela expõe é determinístico: sem a configuração, uma parcela das queries é balanceada para endpoints na Region.
Três detalhes de implementação merecem atenção:
- Topology Aware Routing não é substituto. Em um cluster pequeno ou assimétrico os topology hints frequentemente não são populados. Validamos tanto a annotation de topology mode quanto o
trafficDistribution, e os hints ficaram vazios nos dois casos. O Kubernetes documenta o motivo: nenhum hint é atribuído quando existem menos endpoints que zonas ou quando falta a label de zona em um node, e os hints são simplesmente ignorados em um Service cominternalTrafficPolicy: Local. Para clusters em mixed mode, a AWS recomenda Service Traffic Distribution em vez de Topology Aware Routing pelo mesmo motivo, previsibilidade. - Todo node que roda pods precisa de uma réplica local do CoreDNS, caso contrário o DNS é descartado naquele node. O topology spread constraint anterior fornece essa cobertura.
- NodeLocal DNSCache não funciona com Cilium por default, porque depende de interceptação por iptables e o Cilium contorna o iptables. Usá-lo como camada de cache exige uma
CiliumLocalRedirectPolicy. É uma otimização, não um requisito.
Para produção, mova as mudanças do Deployment (affinity, réplicas e o topology spread) para o configurationValues do Amazon EKS add-on do CoreDNS, que o Amazon EKS valida contra o schema de configuração do add-on, e use a chave replicaCount do schema, não replicas. Um detalhe pode custar a você a configuração que acabou de montar: o configurationValues não é persistente. A AWS documenta que configurações avançadas não sobrevivem entre chamadas da API do add-on e são sobrescritas pelos defaults se você não incluí-las de novo, então cada chamada de update-addon precisa reenviar o conjunto completo. O resolveConflicts: PRESERVE protege edições feitas fora da API do add-on; ele não faz o configurationValues persistir. O internalTrafficPolicy vive no Service kube-dns, e não no schema do add-on, então mantenha essa mudança na sua automação Kubernetes usual. Os patches diretos sobrevivem à operação normal porque o add-on reconcilia apenas na criação e na atualização, mas uma chamada posterior de update-addon pode sobrescrevê-los.
Camada 3: Mantenha as imagens de container disponíveis localmente
Se um pod crasha enquanto está desconectado, ele reinicia?
Sim. O kubelet aplica o restartPolicy localmente e não precisa do API server, desde que a imagem já esteja no cache do containerd. Paramos um container durante uma desconexão ativa e ele reiniciou em 2 a 5 segundos, com o contador de restart incrementando, enquanto o node estava NotReady. Crashes repetidos aplicam backoff exponencial localmente, exatamente como fazem quando conectados.
A dependência é a imagem. Se o node reinicia e a imagem foi coletada pelo garbage collection, o pod não sobe, porque não existe rota para o Amazon Elastic Container Registry (Amazon ECR). Duas práticas tornam isso confiável: faça pre-pull das imagens críticas em todo node que possa rodar o workload, e impeça o garbage collection de imagens de deletá-las. O componente que deleta imagens é o kubelet, que remove imagens não usadas quando o uso de disco cruza os seus thresholds, então a proteção vive na configuração do kubelet. A configuração discard_unpacked_layers = false do containerd complementa isso retendo as layers comprimidas no content store do containerd, mas sozinha ela não impede o kubelet de coletar imagens no garbage collection. Esse último ponto é a leitura dos autores sobre como os dois mecanismos interagem, não comportamento documentado. Os dois valores são overrides que você precisa declarar, e vale verificar os dois no node depois. No lado do kubelet, não leia o /etc/kubernetes/kubelet/config.json: o nodeadm aplica a configuração do kubelet como drop-in, então as chaves de garbage collection de imagens não aparecem naquele arquivo mesmo quando estão em vigor. Pergunte ao kubelet em execução, pelo /api/v1/nodes/<nome-do-node>/proxy/configz. No lado do containerd o arquivo é autoritativo, e o que medimos em um hybrid node real foi discard_unpacked_layers = true, escrito pelo nodeadm e o oposto do default do próprio containerd, que é false, então a configuração abaixo é uma mudança, não uma confirmação. As duas são definidas via configuração do nodeadm:
spec:
  kubelet:
    config:
      imageGCHighThresholdPercent: 90
      imageGCLowThresholdPercent: 80
      imageMinimumGCAge: 168h
  containerd:
    config: |
      [plugins."io.containerd.grpc.v1.cri".containerd]
        discard_unpacked_layers = false
O TOML anterior é a versão 2 da configuração do containerd, que é o que o nodeadm instala hoje. O containerd 2.0 introduziu a versão 3, em que a chave passa para [plugins.'io.containerd.cri.v1.images'], então confira a versão no node antes de copiar o snippet.
Existe uma regra geral aqui. Objetos da API do Kubernetes são imutáveis enquanto você está desconectado, e a configuração local do node não é. Você não consegue alterar tolerationSeconds durante uma indisponibilidade, porque é um campo da pod spec e escrevê-lo exige o API server. Você consegue alterar configurações do containerd por SSH, porque isso é estado local. Tudo da primeira categoria precisa estar correto antes de a desconexão começar.
Para troubleshooting enquanto o control plane está inalcançável, trabalhe diretamente no node. O nodeadm não instala o crictl, então instale-o enquanto você ainda tem conectividade ou inspecione o cache com o cliente do containerd que está presente, sudo ctr -n k8s.io images list. Tanto kubectl exec quanto kubectl logs dependem do API server alcançar o kubelet na porta 10250.
Camada 4: Forneça um ponto de entrada local de tráfego
Um Application Load Balancer que serve de porta de entrada para pods on-premises é um caminho originado na Region. Quando o link cai, esse ingress para de funcionar, corretamente e por design.
Se o tráfego se origina dentro do data center, termine-o dentro do data center. As boas práticas de networking do EKS Hybrid Nodes observam que um load balancer de Layer 2 como o MetalLB permanece estável durante desconexões de rede. Usamos o MetalLB em modo L2, que anuncia um IP virtual na LAN local via Address Resolution Protocol (ARP):
helm install metallb metallb/metallb \
  --namespace metallb-system --create-namespace \
  --set 'speaker.tolerations[0].key=node.kubernetes.io/unreachable' \
  --set 'speaker.tolerations[0].operator=Exists' \
  --set 'speaker.tolerations[0].effect=NoExecute'
Note as tolerations no speaker. O componente que anuncia o seu IP virtual precisa sobreviver à mesma desconexão que a sua aplicação.
Se você já opera um load balancer de hardware, o padrão é idêntico: aponte-o para um NodePort nos hybrid nodes. O que importa é que o ponto de entrada e os seus health checks vivam on-premises e tomem a decisão de failover sem consultar o Kubernetes ou a Region. Os target types IP e instance, que você talvez conheça do AWS Load Balancer Controller, descrevem como um load balancer do Elastic Load Balancing na Region alcança os seus targets, então não se aplicam a esses pontos de entrada on-premises; o load balancer de hardware apontado para um NodePort é o equivalente on-premises do instance mode.
Durante a nossa desconexão o endpoint do Application Load Balancer parou de responder enquanto o IP virtual local continuou retornando HTTP 200 dos mesmos pods. Mesmo workload, dois pontos de entrada, dois blast radius diferentes.
Mantendo a observabilidade durante a desconexão
Métricas e logs enviados para o CloudWatch ou para o Amazon Managed Service for Prometheus param de fluir enquanto você está desconectado, porque esses são endpoints regionais. Se você aceita isso, fica cego exatamente quando precisa de visibilidade.
Um segundo backend, local, resolve. O collector do AWS Distro for OpenTelemetry (ADOT) suporta mais de um exporter em um pipeline, então você pode enviar a mesma telemetria para um Prometheus local e para o seu backend regional:
exporters:
  # Local backend: survives the disconnection
  prometheusremotewrite/local:
    endpoint: "http://prometheus.onprem-monitoring:9090/api/v1/write"
  # Regional backend: has a gap for the disconnection window
  awsemf/cloudwatch:
    region: <aws-region>
    namespace: HybridNodes

service:
  pipelines:
    metrics:
      receivers: [prometheus]
      processors: [batch]
      exporters: [prometheusremotewrite/local, awsemf/cloudwatch]
Os dois exporters rodam o tempo todo, em paralelo, e cada um faz o seu próprio retry, sem estado compartilhado. O exporter local mantém os seus dashboards on-premises populados enquanto a Region está inalcançável. O exporter regional falha durante toda a desconexão e, sem uma fila persistente, descarta o que não consegue entregar quando os retries se esgotam, então o backend regional fica com um buraco naquela janela e não há catch-up quando o link volta. A série completa existe apenas no Prometheus local. Se você também precisa dessa janela na Region, use um exporter regional cuja sending queue seja persistida em disco pela extension file_storage, e dimensione a fila para a desconexão mais longa que você quer cobrir. O exporter awsemf usado aqui não expõe uma sending queue, então ele não segura essa janela. Esta é a leitura dos autores sobre a documentação de resiliência do OpenTelemetry Collector, não um resultado medido.
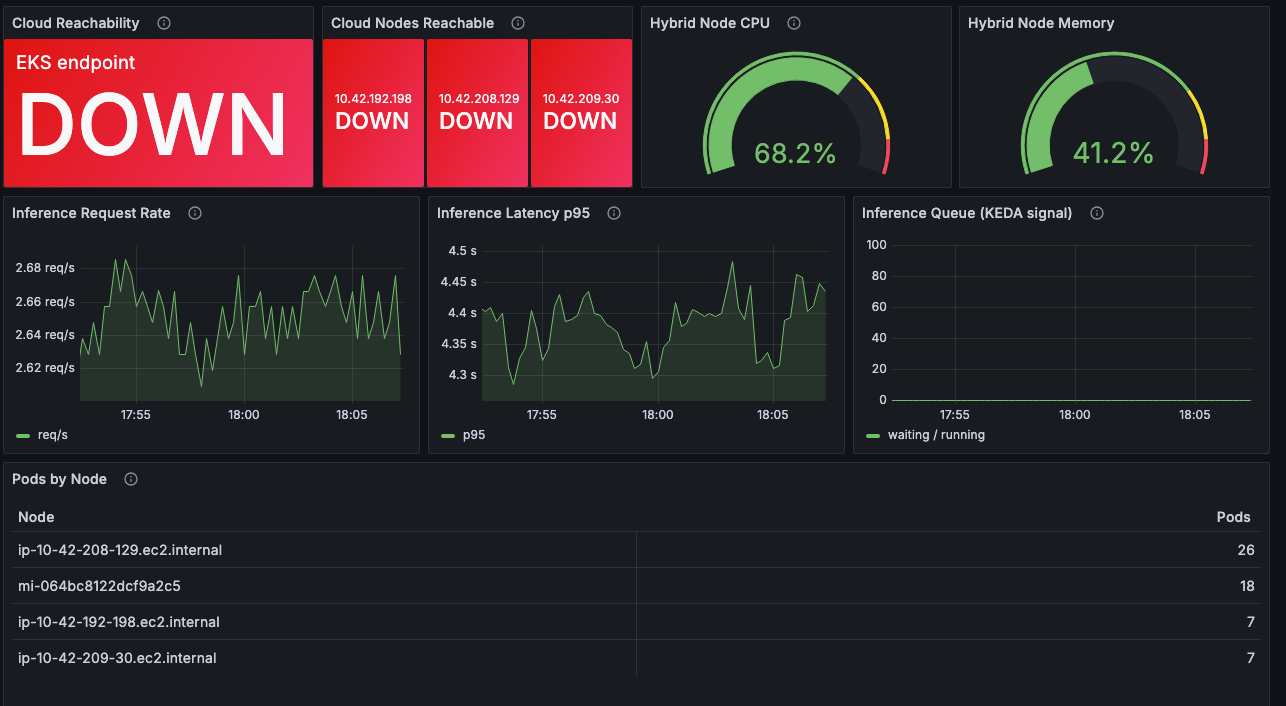
Figura 3: O dashboard do Grafana on-premises durante uma desconexão ativa. A conectividade com a Region e os tiles dos cloud nodes reportam como inalcançáveis, enquanto os hybrid nodes continuam reportando porque toda a stack de monitoramento roda localmente.
Instale o collector via ADOT Amazon EKS add-on, e complete o quadro com um alarme do CloudWatch em NodeNotReady a partir dos logs do control plane, de forma que a própria desconexão levante um alerta.
Teste com o AWS FIS
Resiliência que você não testou é uma suposição. O AWS FIS te dá uma falha controlada, auditável e limitada no tempo, em vez de uma improvisada. Usamos a ação aws:network:disrupt-connectivity com escopo nas subnets do cluster, com uma prefix list para os CIDRs on-premises. Dois limites documentados restringem esse desenho: a prefix list precisa ser customer managed e aceita no máximo 10 entradas, e qualquer escopo diferente de all limita a network access control list (network ACL) clonada a 20 entradas. Inicie o experimento:
EXPERIMENT_ID=$(aws fis start-experiment \
  --experiment-template-id <experiment-template-id> \
  --region <aws-region> \
  --query 'experiment.id' --output text)
Duas lições de construir esse teste. Primeiro, mire nas subnets, não nas instâncias de gateway: nosso design inicial bloqueou tráfego nos nodes de gateway, o que cortou apenas o data path, porque o heartbeat do kubelet não atravessa esses nodes. Segundo, combine com a sua configuração de endpoint: com um endpoint de cluster público, o kubelet alcança o API server pela internet, então um experimento com escopo na VPC não o afeta. Para reproduzir NotReady nesse cenário, bloqueie também os IPs do endpoint no próprio node, o que corta apenas o caminho para o control plane e deixa a LAN local intacta.
A recuperação não exigiu intervenção manual. Depois de pararmos o experimento e removermos as regras no node, os nodes voltaram para Ready em 10 a 30 segundos, o tráfego entre os dois lados do cluster recuperou-se por conta própria e os pods que estavam Pending foram agendados.
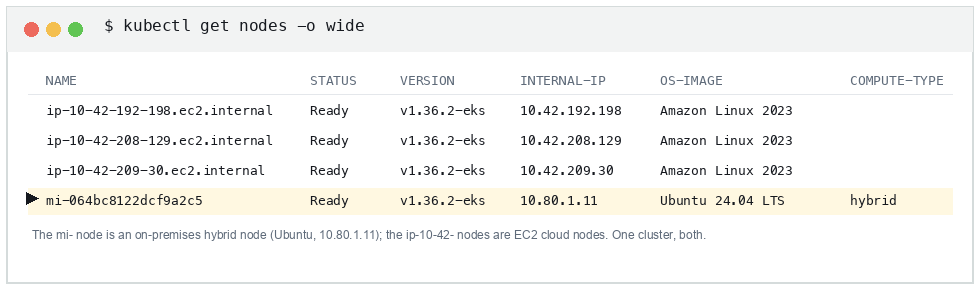
Figura 4: Hybrid nodes e cloud nodes coexistindo em um único cluster EKS, via kubectl get nodes. O hybrid node carrega um machine ID mi-, o seu endereço on-premises 10.80.x e a label eks.amazonaws.com/compute-type=hybrid; os cloud nodes rodam em Amazon Elastic Compute Cloud (Amazon EC2) com endereços 10.42.x da VPC.
Limitações que você não configura para desaparecer
Seja transparente sobre estas com os seus stakeholders. Elas são propriedades de um control plane hospedado na Region.
| Limitação | Impacto | Mitigação |
|---|---|---|
| Nenhuma operação de control plane enquanto desconectado | Pods novos ficam Pending, e não há scheduling, scaling ou rollout |
Dimensione as réplicas para a carga esperada (N+1 ou N+2) com antecedência |
| Restart de node enquanto desconectado | Os pods não voltam até a reconexão, porque o kubelet precisa do API server na inicialização |
Réplicas em múltiplos nodes |
| Credenciais do host expiram | As hybrid activations do AWS Systems Manager emitem credenciais de 1 hora, e o AWS IAM Roles Anywhere emite 1 hora por default e até 12 horas | Use IAM Roles Anywhere com um durationSeconds maior, e defina o MaxSessionDuration da IAM role dos hybrid nodes com um valor maior que ele. Os pods em execução não são afetados, porque as credenciais governam a comunicação node-para-AWS, não os workloads locais |
| Ingress originado na Region falha | Os caminhos do Application Load Balancer para pods on-premises param | Load balancer local para tráfego originado no data center |
| Admission webhooks em hybrid nodes | Com failurePolicy: Fail, um backend de webhook inalcançável bloqueia operações no cluster inteiro |
Rode webhooks críticos em cloud nodes, ou use failurePolicy: Ignore com réplicas nos dois lados |
| Volumes do Amazon Elastic Block Store (Amazon EBS) | Não disponíveis em hybrid nodes, porque volumes EBS têm escopo de Availability Zone | Persistent volumes locais, hostPath ou um CSI driver de terceiros para o seu storage on-premises |
Se você adotar o Amazon EKS Hybrid Nodes gateway para rotear tráfego entre a VPC e os pods nos hybrid nodes, trate-o como uma dependência regional: os seus dois pods rodam em active-standby em nodes EC2 na VPC, então o gateway fica inalcançável durante uma desconexão, como os outros caminhos hospedados na Region desta tabela.
Uma consideração adicional sobre a escolha de CNI. As boas práticas para estabilidade durante desconexões de rede observam que o agente do Cilium reinicia continuamente enquanto está desconectado do control plane do Kubernetes, porque o seu health check é acoplado ao acesso ao control plane. Quando você usa o Cilium BGP Control Plane para load balancing, o BGP speaker roda dentro desse mesmo agente, então as sessões BGP dos seus pods e Services podem cair junto. A documentação aponta para o Cilium CFP #31702, que adiciona uma melhoria opt-in no Cilium v1.17. Opt-in importa: só atualizar para a v1.17 não muda o comportamento. Rodamos o Cilium 1.17 em modo VXLAN em vez de BGP, o que contorna o problema por completo porque o datapath não depende de uma sessão BGP. Se você anuncia Services via BGP, valide esse comportamento explicitamente antes de produção.
Limpeza dos recursos
Remova os recursos que você criou para evitar cobranças contínuas:
# Stop the FIS experiment if it is still running
aws fis stop-experiment --id <experiment-id> --region <aws-region>

# Remove the workloads
kubectl delete namespace <namespace>

# Remove MetalLB
helm uninstall metallb --namespace metallb-system
kubectl delete namespace metallb-system

# Remove the FIS experiment template, IAM role, and prefix list
terraform destroy
Se você aplicou as mudanças no CoreDNS apenas para teste, reverta-as:
kubectl -n kube-system patch svc kube-dns --type merge -p '{"spec":{"internalTrafficPolicy":"Cluster"}}'Conclusão
Workloads no Amazon EKS Hybrid Nodes continuam servindo tráfego durante uma desconexão da AWS Region, e a comunicação pod-to-pod dentro do data center continua funcionando, porque esse datapath não depende do control plane. O que determina se isso é verdade no seu ambiente é a configuração que você aplica com antecedência: tolerations dimensionadas por workload, zone labels por data center, CoreDNS em todo node com internalTrafficPolicy: Local, imagens fixadas no cache local do containerd, um ponto de entrada local de tráfego e um backend local de telemetria.
Cada uma dessas é uma operação de control plane, e você não consegue aplicar nenhuma delas enquanto está desconectado. Isso faz do sequenciamento a lição real: construa a configuração primeiro, depois verifique com uma falha controlada, em uma janela de manutenção dedicada em vez de durante um incidente. Nos nossos próprios testes, aplicar patch no CoreDNS enquanto os nodes oscilavam degradou o networking pod-to-pod e exigiu um rollout completo do CNI para recuperar-se.
Para começar, revise as boas práticas para hybrid nodes durante desconexões de rede, e então desenhe um primeiro experimento do AWS FIS para um cluster que não seja de produção. Se você está avaliando o EKS Hybrid Nodes para um data center que não pode parar, teste a desconexão antes de precisar sobreviver a uma.
Se você quiser colocar esses passos em prática, o workshop Amazon EKS Hybrid Nodes: Resiliência On-Premises e GPU Cloud Bursting guia você para conectar nodes on-premises simulados a um cluster do EKS, injetar uma desconexão com o AWS FIS e validar que seus workloads continuam servindo tráfego.
Conte como você aborda resiliência híbrida nos comentários, ou compartilhe o seu feedback no AWS containers roadmap.
Sobre os autores
 |
Bruno Lopes é Senior Specialist Solutions Architect para Containers na AWS, baseado em Curitiba, Brasil. Ele trabalha com clientes enterprise na América Latina em Kubernetes, modernização de aplicações e platform engineering. Fora do trabalho, está seguindo o caminho da certificação Kubestronaut e produz conteúdo técnico para a comunidade brasileira de desenvolvedores. LinkedIn |