亚马逊AWS官方博客
从告警到根因 AWS DevOps Agent 在 Amazon EKS 上的排障实战
摘要:告警响起后,如何更快找到故障原因?本文结合客户协同排障案例与 Amazon EKS 故障注入测试,介绍 AWS DevOps Agent 的调查能力、告警接入和结论回传流程,并分享事件归并、权限配置与成本控制的实践经验。本文面向 SRE 和平台团队,结合 Amazon EKS 上的故障注入测试,介绍如何将 AWS DevOps Agent 接入现有告警流程,以及落地时需要关注的问题。收到告警后,值班工程师通常要先回答几个问题:服务端指标是否异常?最近有没有发布?权限或配置是否发生过变化?线索散落在 CloudWatch、CloudTrail、Kubernetes、代码仓库和第三方监控中。真正耗时的,往往是把这些线索串起来,判断下一步该查哪里。AWS DevOps Agent 可以承担这部分调查工作:收到告警后,结合可访问的数据提出假设、收集证据,并给出根因分析和修复建议。本文从一个已匿名的客户排障案例出发,说明这类工作的难点,再分享我们在 Amazon EKS 上的测试结果。重点关注三个问题:它能查到什么、如何接入现有流程,以及调查效果和成本如何衡量。
目录
一、一个真实的排障案例
一家互联网客户的在线业务运行在 Amazon EKS 上,缓存使用 Amazon ElastiCache(Redis OSS,6 个分片、12 个节点)。业务日志中间歇性出现 i/o timeout,一天约 8,700 次,主要集中在晚间业务高峰。客户最初怀疑是 Redis 服务端响应变慢。
超时日志本身不足以说明问题出在哪里。这次排障由工程师与 DevOps Agent 协同完成:工程师负责客户端侧,DevOps Agent 负责 AWS 上的服务侧。两侧分别收集以下证据:
- 服务端:检查引擎 CPU 和节点 CPU、网络配额、缓存逐出量(Evictions)、各类命令延迟、慢日志,以及连接数和新建连接数;同时核对故障转移、维护和快照等集群事件。
- 客户端:根据日志中的客户端 IP 定位 EKS 节点,检查 CPU、网络和 EBS 指标,再结合 SDK 版本核对超时配置和连接池行为。
排查没有发现服务端存在持续性瓶颈,线索逐渐集中到客户端:高峰期连接数达到平时的三倍,新建连接数明显增加,需要进一步检查连接池容量和连接复用;业务侧的超时配置明显短于所用 SDK 的默认值;部分客户端实例的 CPU 长时间接近 100%,入方向带宽也触及了限额。这些证据比“Redis 慢了”更具体,也为后续调整提供了方向。
这个案例体现了协同排障的价值:DevOps Agent 调查 AWS 上的服务侧,工程师结合客户端指标、SDK 配置和连接池行为继续定位问题。把两侧证据放在一起,才能判断超时从何而来。接下来,我们在独立的 EKS 测试环境中注入故障,进一步验证 Agent 的调查能力,以及告警触发和结论回传的完整流程。
二、AWS DevOps Agent 能做什么
DevOps Agent 在 Agent Space 中工作。团队通过 Agent Space 配置关联的账号、集群和工具,并通过相应权限限定访问范围。Agent 会发现应用、服务和资源之间的依赖关系,形成调查时使用的拓扑。主要能力如下,详细说明见产品功能页。
| 能力 | 说明 |
| 自主事件调查 | 告警或工单触发后,关联遥测、代码和部署数据,分析根因并提出缓解方案 |
| 事件预防 | 分析历史事件,提出代码、可观测性、基础设施韧性和治理方面的改进建议 |
| 按需 SRE 任务 | 通过自然语言查询资源、指标、日志和拓扑 |
| 发布管理(预览) | 执行发布前就绪检查和自动化发布测试 |
| 可扩展技能(Skills) | 将运维手册、架构规范和操作惯例整理为可复用的技能 |
| 多云与本地环境 | 支持调查 AWS、Azure 和本地环境中的应用 |
2.1 接入方式
| 方式 | 适合的场景 |
| Web App / 控制台 | 人工发起调查、查看调查时间线和结论 |
| 原生集成 | Datadog、Dynatrace、New Relic、Splunk、Grafana、ServiceNow、PagerDuty 等告警或工单自动触发调查 |
| Generic webhook(HMAC 或 API key) | 任何能发 HTTP 请求的系统,包括 CloudWatch Alarm(经 SNS + Lambda)和自建监控(文档) |
API / SDK / CLI(服务名 devops-agent) |
程序化管理 Agent Space、发起调查(CreateBacklogTask)、读取调查过程和结论(GetBacklogTask、ListJournalRecords)、配置定时触发器 |
| Remote MCP server | 在 Kiro、Claude Code、Cursor 等 IDE 和 CLI 里直接发起调查、追问结论。Kiro 有现成的 AWS DevOps Agent power(文档) |
| A2A(Agent-to-Agent) | 让你自己的 agent 和 DevOps Agent 协作 |
| Slack / Microsoft Teams | 在频道里接收调查进展,也可以 @agent 发起对话 |
| Amazon EventBridge | 订阅调查生命周期事件(source = aws.aidevops),把结论写回任意系统 |
2.2 可以联动的服务和工具
| 类别 | 服务 / 工具 | DevOps Agent 用它做什么 |
| AWS 可观测性 | Amazon CloudWatch(指标、日志、告警、Logs Insights) | 调查的主要数据来源 |
| AWS 变更与审计 | AWS CloudTrail、IAM | 定位“谁在什么时候改了什么” |
| 容器 | Amazon EKS(通过 access entry + AmazonAIOpsAssistantPolicy) |
读 Pod 状态、日志、集群事件和 Deployment 历史 |
| 事件驱动 | Amazon EventBridge、Amazon SNS、AWS Lambda | 触发调查,分发结论 |
| AWS Support | AWS Support Center、Incident Detection and Response | 在控制台里一键“Ask for human support”,调查结论会自动带到支持工单 |
| 开发工具 | Kiro、Claude Code(MCP) | 工程师在 IDE 里追问结论,并把修复建议转成代码改动 |
| 第三方可观测性 | Datadog、Dynatrace、New Relic、Splunk、Grafana、Prometheus | 读取已有监控的告警、指标、日志和 trace |
| 代码与 CI/CD | GitHub、GitLab、Azure DevOps | 把事件和部署、代码变更关联起来 |
| 工单与协作 | ServiceNow、PagerDuty、Slack、Microsoft Teams | 从工单触发调查,把结论写回原工单或频道 |
| 自定义扩展 | 私有或远程 MCP server(可走私有连接) | 接入内部系统、自建监控和内部 runbook |
三、实测 告警自动触发 DevOps Agent
我们在 Amazon EKS 上搭建了一个测试环境,主动注入几类常见故障,验证从告警触发、自动调查到结论回传的完整流程。
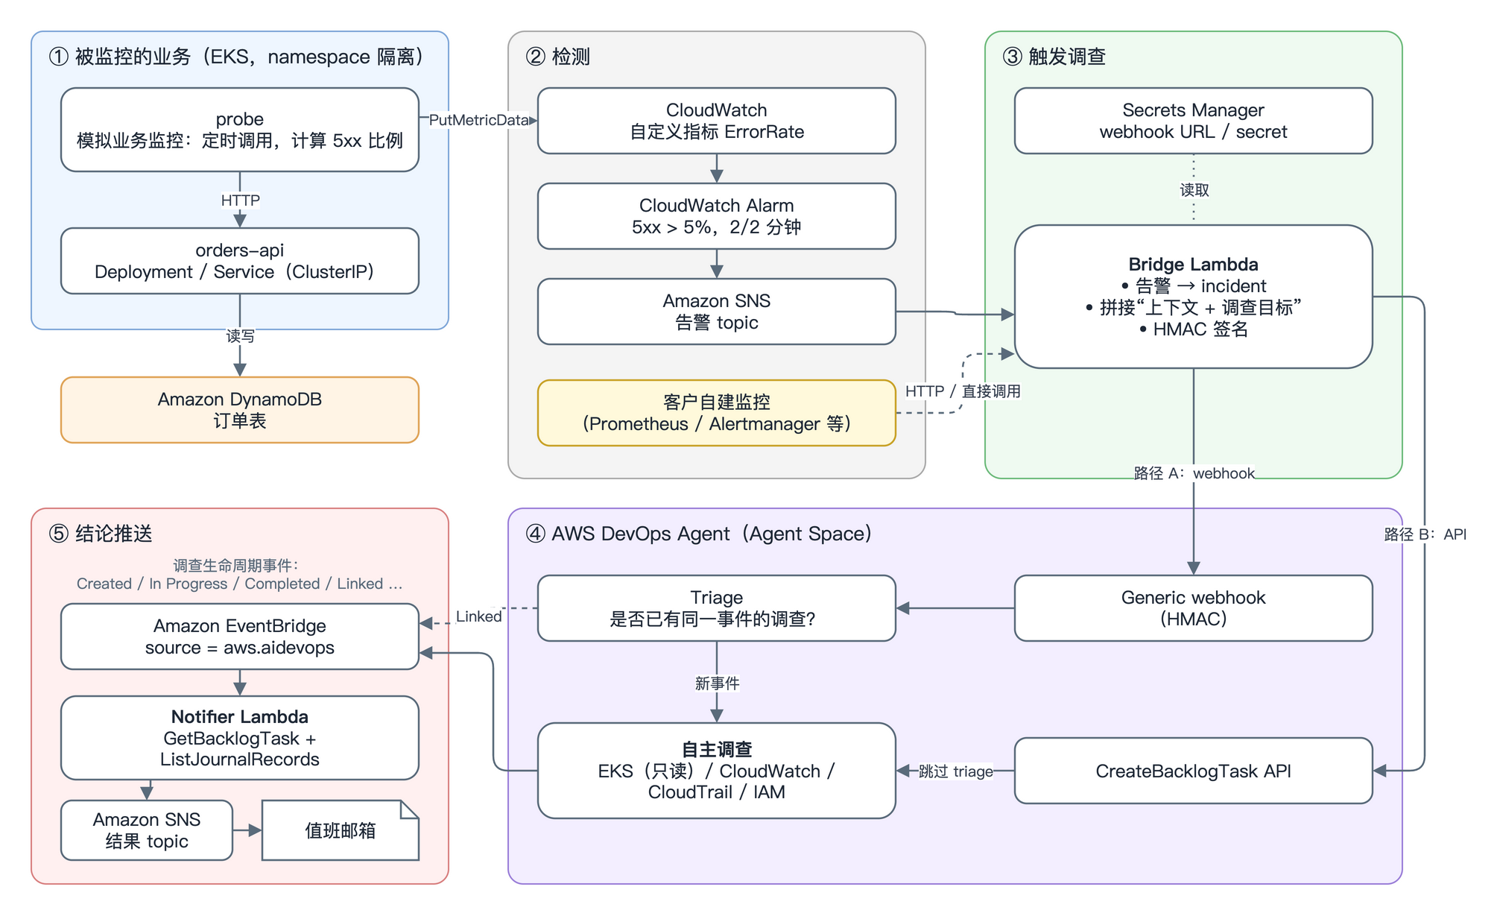
[图 1:测试环境架构] |
- 样例应用
orders-api运行在 EKS 上,以 Amazon DynamoDB 为后端,通过 ClusterIP 提供服务,不对公网暴露。 - 集群内的探测程序模拟业务请求,将 5xx 比例写入 CloudWatch;连续 2 分钟超过 5% 时触发告警。
- 告警经 SNS 触发 Bridge Lambda。该函数整理告警内容,在描述中补充环境信息和调查目标,再用 HMAC 签名后发送到 DevOps Agent webhook;测试中也使用了
CreateBacklogTaskAPI 发起调查。 - 调查状态变化通过 EventBridge 触发 Notifier Lambda,由它读取调查结论并发送邮件。
- DevOps Agent 对 EKS 集群的访问采用只读权限,范围限定在应用所在的 namespace。
环境信息和调查目标统一写入 webhook 请求的 description 字段,便于 Agent 开始调查时找到相关资源。我们使用的描述模板如下:
3.1 故障场景
| 场景 | 注入方式 | 难点 |
| 错误配置发布 | 发布新版本,将环境变量中的表名改为错误值 | 需要关联到具体的发布和配置变化 |
| 自建监控告警 | 注入相同的表名配置错误,由非 CloudWatch 监控系统发出告警 | 验证自建告警源的接入流程 |
| IAM 权限收紧 | 改写 Pod 角色策略,移除 dynamodb:Scan |
Kubernetes 配置未变,需要从 CloudTrail 查找权限变更;错误率约为 50% |
| 内存泄漏 | 发布新版本,启用没有淘汰机制的缓存 | Pod 反复出现 OOMKilled,服务间歇恢复,导致告警反复触发 |
测试覆盖了 webhook 和 API 两种触发方式,也比较了两种告警描述:一种包含完整环境信息和调查目标,另一种只写“5xx 升高,请排查”。共产生 17 个任务,其中 11 个完成了完整调查,6 个被关联到已有调查。以下结果来自这组有限样本。
3.2 结果
1. 11 次完整调查均定位到注入的故障。 调查结论不仅指出了问题,还给出了可供核查的证据:
- 错误配置发布:定位到具体的 Deployment revision 和错误表名,并核对 Pod 角色的授权范围。
- IAM 权限变更:在 CloudTrail 中找到
PutRolePolicy事件,指出变更时间和被移除的权限。 - 内存泄漏:从 OOMKilled 追溯到新版本新增的缓存开关;在完整调查中,也区分了同一时段的两起事件。
- 额外发现:多次调查指出,应用的健康检查接口没有访问数据库,因此 readiness 检查无法发现这类数据库访问故障。
2. 完整调查用时为 4–12 分钟。 以首次由 CloudWatch 告警触发的测试为例,Alarm 进入 ALARM 状态后 3 秒,webhook 请求送达;15 秒后,调查进入分析阶段。从告警到调查完成约 4 分 20 秒,结论邮件也在此时送达。这是其中一次测试的耗时,不能代表所有故障场景。
3. 在只读配置下,修复建议没有被执行。 测试中的建议均标注为“只读提案,未执行”,并列出执行前的校验步骤;需要审批的调用被拦截。Agent 也会说明证据缺口,例如集群未开启控制面审计日志时,无法确认发布的执行者。这里的只读边界依赖实际权限和审批配置,告警描述中的约束用于说明调查要求。
4. 两种触发方式的事件分诊行为不同。 在本次测试中,webhook 触发的任务会先经过事件分诊(triage),判断是否应与已有调查关联;API 触发的任务则直接进入调查流程。观察到的差异如下:
| 观察项 | webhook | CreateBacklogTask API |
| 初始状态 | PENDING_TRIAGE |
PENDING_START |
| 本次测试中的行为 | 先判断与已有调查的关联;被归并的任务在 7–16 秒内进入 LINKED,并附归并理由 |
直接进入完整调查 |
| 适用场景 | 持续接收告警,通过事件分诊减少重复调查 | 明确发起一次调查,或用于经规则判断后需要重新调查的事件 |
在一组内存泄漏测试中,告警在 20 分钟内触发了 4 次,其中 3 次被正确关联到已有调查,最终只执行了一次完整调查。这能减少同一故障反复告警带来的重复工作。
5. 事件归并也可能判断错误。 测试中也出现了一次误归并:内存泄漏告警沿用了前一起 IAM 故障的告警规则,服务相同,两次故障相隔约 20 分钟。Agent 将新告警归并到已经结束的调查,直到约 10 分钟后告警再次触发,才开始新的调查。因此,不能只关注调查是否完成,还要检查归并是否合理。按错误率、延迟、OOM 等不同信号设置告警,并为持续异常保留重新调查的路径,有助于降低这类风险。
6. 补充上下文在部分场景中缩短了调查时间。 两种描述都得到了正确结论,但错误配置发布和 IAM 变更场景中,提供完整上下文的调查更快;内存泄漏场景则基本没有差异。下面是对应测试的记录,尚不足以推断普遍的性能提升:
| 场景 | 带完整上下文 | 只写一句话 |
| 错误配置发布 | 5 分 05 秒 | 6 分 42 秒(慢约 30%) |
| IAM 变更 | 5 分 20 秒 | 7 分 33 秒(慢约 40%,调查记录多近一倍) |
| 内存泄漏 | 6 分 06 秒 | 6 分 02 秒(OOMKilled 在 Pod 状态里很明显) |
四、将自动调查接入现有告警流程
基于上述测试,可以按下图组织接入流程。生产落地时,除了触发调查,还需要处理结论分发和异常归并。
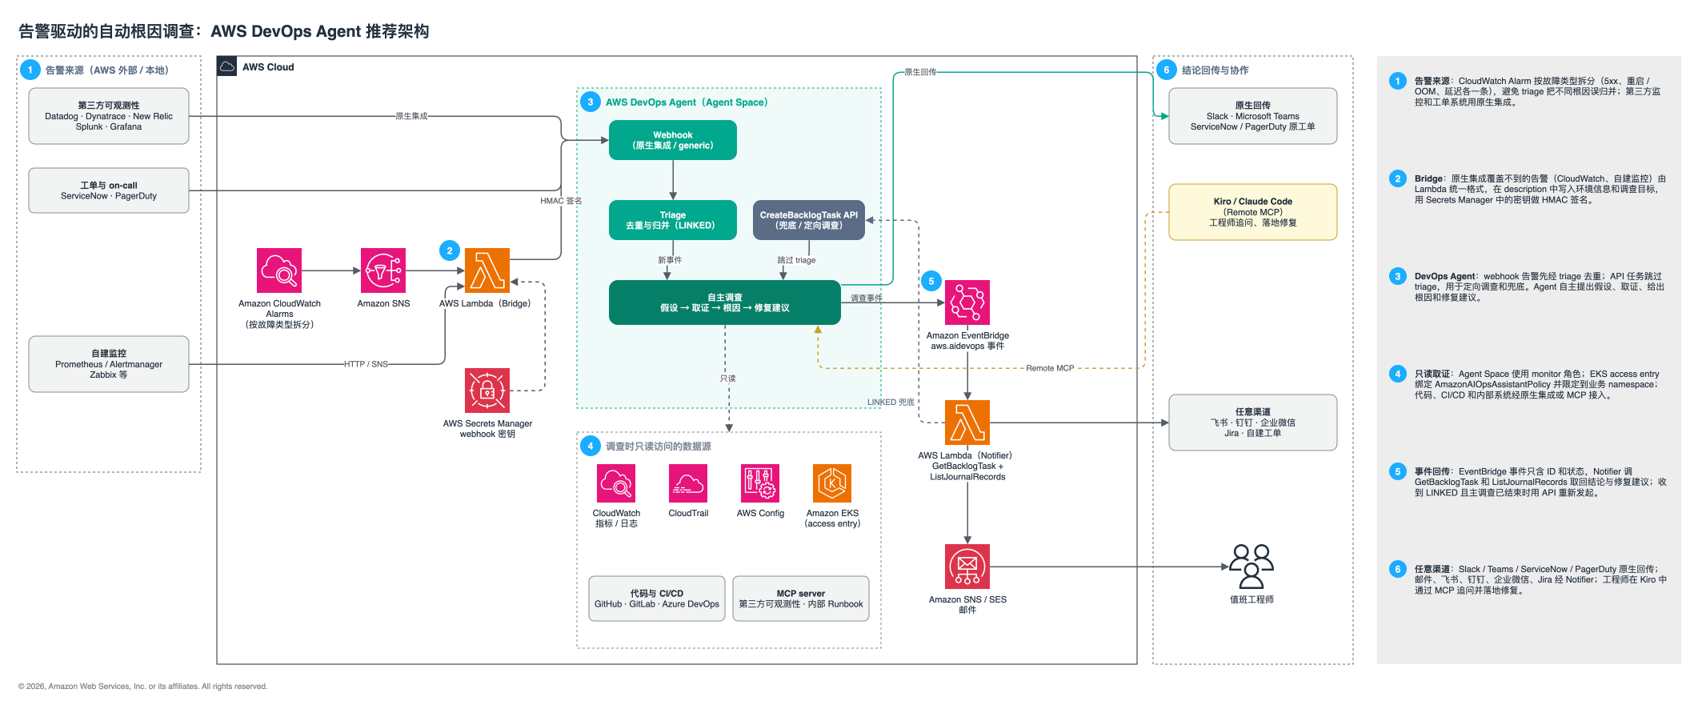
[图 2:告警驱动的自动调查与结论回传架构] |
① 告警来源:按错误率、Pod 重启或 OOM、延迟等信号分别设置告警,并提供服务和资源标识,帮助 Agent 判断事件之间的关系。第三方监控和工单系统已有原生集成时,可优先使用。
② 告警接入:对于需要自行转换的告警源,可参考本次 CloudWatch 测试,使用 Bridge Lambda 统一格式,在描述中补充服务、集群、namespace、依赖资源和调查目标,再使用存储在 Secrets Manager 中的密钥完成 HMAC 签名。如需筛选告警,可在触发 Bridge Lambda 前使用 Amazon EventBridge 事件规则,仅转发符合条件的告警,减少无关事件带来的调用和调查开销,降低后端过载风险。
③ 自动调查:告警通过 webhook 接入,利用事件分诊减少重复调查,同时观察归并结果。先以只读方式配置 Agent Space 的监控角色,将 EKS access entry 的访问范围限定在业务 namespace。开启 EKS 控制面审计日志,并在 Deployment 中记录 kubernetes.io/change-cause,有助于补全发布和变更证据。
④ 结论回传
- 已有协作渠道:Slack、Microsoft Teams、ServiceNow 和 PagerDuty 可使用对应的原生集成回传结果。
- 自定义渠道:邮件、飞书、钉钉、企业微信、Jira 或自建工单系统,可通过 EventBridge 和 Notifier Lambda 对接。EventBridge 事件包含任务标识、状态等元数据,不包含完整调查结论。Notifier 可调用
GetBacklogTask获取任务信息,再通过ListJournalRecords读取investigation_summary_md;如已生成修复建议,再读取mitigation_summary_md。处理时需考虑摘要尚未生成或不存在的情况。 - 误归并处理:收到
Investigation Linked事件后,可结合主调查结束时间、告警是否持续以及是否出现新异常,判断是否通过CreateBacklogTask发起新的调查。重新调查的阈值应结合业务设定,并使用clientToken做请求幂等处理,避免重复事件触发多次调用。这是针对测试中误归并问题的设计建议,仍需在实际告警流量下验证。 - 工程师跟进:工程师可在 Kiro 或 Claude Code 中通过 MCP 追问证据,将修复建议转为代码改动,再按现有流程审查、测试和发布。
五、定价
以下信息来自 AWS DevOps Agent 定价页 和 FAQ,以官方页面的最新内容为准。
按 Agent 的累计工作时长计费:调查、评估和按需 SRE 任务的费率均为每 agent-second 0.0083 美元,约合每分钟 0.50 美元,按秒计费,无需预付承诺。这里的工作时长是 Agent 执行各项活动的累计活跃时间,与告警到调查完成的端到端耗时不是同一口径;空闲或等待时间不计费。发布管理在预览期间不额外收费。
相关服务费用另计:调查过程中使用的 CloudWatch 查询、追踪数据检索及第三方服务等,可能产生各自的用量费用,需按对应服务的定价单独评估。
新客户可免费试用:AWS DevOps Agent 新客户从首次运维任务开始享有 2 个月试用期。每月覆盖最多 10 个 Agent Space,并包含 20 小时调查、15 小时评估和 20 小时按需 SRE 任务。超出试用额度的部分按标准价格计费。
5.1 AWS Support 客户的抵扣额度
符合条件的 AWS Support 计划每月提供 DevOps Agent 专用抵扣额度(credit),金额按上月 AWS Support 费用的一定比例计算。各计划的比例和示例如下:
| Support 计划 | 抵扣比例 | 示例:上月费用 → 本月抵扣额度 |
| Business Support+ | 30% | 1,000 美元 → 300 美元 |
| Enterprise Support | 75% | 10,000 美元 → 7,500 美元 |
| Unified Operations | 100% | 100,000 美元 → 100,000 美元 |
抵扣额度的使用规则如下:
- 每月 10 日前发放,用于抵扣当月的 DevOps Agent 费用。
- 当月未用完的额度在月底过期,不结转至下月。
- 按每 agent-second 0.0083 美元的标准费率抵扣。
额度是否足够,取决于实际任务量和工作时长。官方定价页的“企业部署”示例包含 10 个 Agent Space、每月 500 次事件调查(平均每次 8 分钟),以及评估和按需 SRE 任务,合计约 2,366 美元。如果该客户上月的 Enterprise Support 费用为 10,000 美元,对应的 7,500 美元额度可以覆盖示例中的 DevOps Agent 费用;相关服务的额外费用仍需单独计算。这个示例可用于估算,不能替代对自身用量的监控。
5.2 我们实测的用量
本次测试的 17 个任务(11 次完整调查、6 次归并)共消耗约 4,092 agent-seconds。数据来自 CloudWatch AWS/AIDevOps 命名空间下的 ConsumedInvestigationTime,按标准费率折算约 34 美元,未扣除免费试用或抵扣额度。由于这是全部任务的汇总用量,不能据此单独计算每次完整调查或归并任务的实际成本。
日常可按 Agent Space 监控 AWS/AIDevOps 下的 ConsumedInvestigationTime、ConsumedEvaluationTime 和 ConsumedOnDemandTime,分别跟踪调查、评估和按需任务的工作时长,并设置用量告警。ConsumedChatRequests 记录的是调查内聊天请求次数,不是计费时长,也不包含按需任务的聊天用量,统计时需要区分。
六、总结
在本次测试中,AWS DevOps Agent 完成的 11 次完整调查均定位到了注入的故障,用时为 4–12 分钟,并通过既有通知流程回传了证据和建议。它能帮助工程师提前收集线索,但误归并和审计数据缺失也会影响调查结果。接入时,建议优先做好以下几件事:
- 通过 webhook 接收告警,观察事件归并结果,并为持续异常设置重新调查的条件。
- 在描述中提供环境、依赖资源和调查目标,减少 Agent 搜索无关资源的时间。
- 从只读调查开始,将访问权限限定在业务需要的范围内。
- 补齐结构化日志、EKS 控制面审计日志和发布记录,让结论有证据可查。
- 按实际工作时长监控费用,再结合试用和 Support 抵扣额度,逐步扩大接入范围。
➡️ 下一步行动:
相关产品:
- Amazon DevOps Agent — 解决和预防事故的代理
- Amazon EKS — 托管式 Kubernetes 服务
- Amazon EventBridge — 大规模构建事件驱动应用程序
- Amazon CloudWatch — 可观测性工具
- AWS Lambda — 无需服务器即可运行代码
相关文章:
- AWS DevOps Agent 实战:如何使用生成式 AI 加速故障演练
- 星合互娱借助 AWS DevOps Agent 构建多游戏智能运维体系
- 基于 Amazon Bedrock AgentCore 与 AWS DevOps Agent 打造对话式多账户运维助手
- 利用 Amazon Athena managed query results 让 AWS DevOps Agent 查询 Amazon S3 中的日志
- AWS DevOps Agent 接入 AWS 中国区(二):多账号扩展、跨云接入与无长期 AK/SK 认证
七、参考资料
- AWS DevOps Agent 产品页 | 定价 | FAQ
- Announcing General Availability of AWS DevOps Agent
- Accessing DevOps Agent
- Invoking DevOps Agent through Webhook
- Integrating AWS DevOps Agent with Amazon EventBridge
- Connecting to the DevOps Agent MCP server
- AWS EKS access setup
- Best Practices for Deploying AWS DevOps Agent in Production
- Integrate AWS DevOps Agent with third-party tools using Amazon EventBridge
- Amazon ElastiCache:Large number of connections (Valkey and Redis OSS)
- Vended logs and metrics
*前述特定亚马逊云科技生成式人工智能相关的服务目前在亚马逊云科技海外区域可用。亚马逊云科技中国区域相关云服务由西云数据和光环新网运营,具体信息以中国区域官网为准。
本篇作者
AWS 架构师中心:云端创新的引领者探索 AWS 架构师中心,获取经实战验证的最佳实践与架构指南,助您高效构建安全、可靠的云上应用
|
 |