Amazon Web Services ブログ
Amazon OpenSearch intelligent ingestion で Amazon S3 のデータから RAG 対応インデックスを構築する
本記事は 2026 年 10 月 23 日 に公開された「Build RAG-ready indexes from Amazon S3 with Amazon OpenSearch intelligent ingestion」を翻訳したものです。
組織の価値ある知識の多くは、契約書、製品マニュアル、調査レポート、サポートの runbook、財務書類などのドキュメントに蓄積されています。こうしたコンテンツは Amazon Simple Storage Service (Amazon S3) に、構造化データ (JSON、NDJSON、JSON 配列) と非構造化データ (PDF、Word、テキスト、Markdown) として保存されています。生成 AI アプリケーション、検索拡張生成 (RAG) アシスタント、エンタープライズ検索の体験の品質は、こうしたコンテンツにどれだけアクセスできるかで決まります。しかし、こうしたデータは検索対象として扱いやすい形にするのが最も難しい部類に入ります。データを抽出するには、顧客は複数のステップから成る複雑な取り込みパイプラインを運用する必要があります。
- レイアウト、読み順、表を保ったままテキストを抽出するドキュメントパーサーの実行
- ドキュメント内のチャート、図、スクリーンショットの抽出と内容の解釈
- 抽出したテキストのチャンク分割と埋め込みモデルによる処理、ベクトルインデックスへの書き込み
レイヤーごとに専用のインフラ、スケーリングの検討、起こりうる障害のパターンがあります。複雑さは積み重なり、エンドツーエンドで動かすまでに数週間を費やす組織も少なくありません。
本日、Amazon OpenSearch intelligent ingestion を発表します。Amazon OpenSearch Serverless (NextGen) 上で動作するフルマネージドかつサーバーレスの取り込み機能です。コレクションから Amazon S3 のデータを指定し、処理方法を選ぶだけで利用できます。残りは intelligent ingestion が引き受けます。S3 からコンテンツを発見し、ドキュメントを解析し、画像の内容を記述し、コンテンツをチャンクに分割し、ベクトル埋め込みを生成し、結果をインデックスに書き込みます。設定が必要なパイプラインも、運用するドキュメント処理インフラも、事前に見積もるキャパシティもありません。
intelligent ingestion で以下のことができます。
- 手動パイプラインなしで生のドキュメントからセマンティック検索へ。 PDF、Word、Markdown ファイルを取り込み、レイアウトや表を保ったまま解析して、セマンティック検索やハイブリッド検索に対応したインデックスに格納します。
- 視覚的なコンテンツも検索可能に。 ドキュメントにチャート、図、スクリーンショット、写真が含まれる場合、ビジョン言語モデルが詳細なテキスト記述を生成します。画像にしか含まれない情報も検索できます。
- パイプラインのコードなしで構造化データを取り込み。 JSON、NDJSON、CSV のデータを読み込み、取り込み時に変換を適用できます。オプションでセマンティック検索向けの付与も可能です。
- 単発の取り込みと継続的なストリームを選択可能。 移行やバックフィルなど一度きりまたは定期的なロードには Ingestion Jobs を使い、バケットに新しいオブジェクトが到着するたびにインデックスを継続的に同期するには Ingestion Streams を使います。
- 実際の処理分だけ課金。 キャパシティはワークロードに合わせて自動的にスケールし、アイドル状態の取り込みキャパシティには課金されません。
本記事では、intelligent ingestion の仕組みと、Ingestion Jobs と Ingestion Streams の使い分けを説明します。続いて、Amazon S3 の非構造化ドキュメントをまとめて取り込み、Amazon OpenSearch Serverless (NextGen) で RAG 対応のインデックスとして処理するまでの流れを示します。ログや構造化データも同じワークフローで取り込めます。アプリケーションログ、監査証跡、商品カタログなどの JSON、NDJSON、JSON 配列データを Amazon S3 から読み込み、取り込み時に変換を適用し、オプションでセマンティックエンリッチメントも適用できます。RAG のナレッジベースとログ分析で同じ取り込み体験を共有できます。
ソリューション概要
intelligent ingestion は Amazon OpenSearch Serverless (NextGen) コレクションの内部で動作し、S3 バケットからインデックスまでの経路全体を管理します。Ingestion Job または Ingestion Stream を作成するときに指定するのは次の 2 つだけです。
- ソース – データが格納された Amazon S3 バケットとプレフィックス
- デスティネーション – 処理されたデータの格納先となる Amazon OpenSearch Serverless (NextGen) コレクション内のインデックス
この指定を受けて、intelligent ingestion は以下のステップを実行します。
- データ検出: intelligent ingestion は S3 プレフィックス配下のオブジェクトを自動的にスキャンします。Ingestion Streams では、Amazon Simple Queue Service (Amazon SQS) 通知を使って新しいオブジェクトの到着を検出します。
- ドキュメント解析: PDF や Word ファイルを検出すると、intelligent ingestion は見出し、読み順、表を保ったまま構造化されたコンテンツに解析します。
- 画像からの情報抽出: PDF や Word ファイル内に画像を検出した場合、豊富なテキスト記述を生成し、視覚的なコンテンツを周囲のテキストと並べてインデックス化できるようにします。
- チャンク分割と埋め込み: intelligent ingestion は検索に適したサイズにコンテンツをチャンク分割し、OpenSearch Automatic Semantic Enrichment を使ってベクトル埋め込みを生成します。
- インデックス化: intelligent ingestion はチャンク、スパース埋め込み、メタデータをインデックスに書き込みます。コレクショングループで事前に設定した OpenSearch Compute Unit (OCU) の上限内で、ワークロードに応じてキャパシティを自動的にスケールします。
Ingestion Jobs と Ingestion Streams
| Ingestion Jobs | Ingestion Streams | |
| 使うタイミング | 固定のデータセットを一度だけロードする | データが継続的に到着または変化する |
| 典型的なシナリオ | 初期ロード、移行、バックフィル、PoC | 成長を続けるナレッジベース、継続的に更新されるドキュメントライブラリ |
| 動作 | プレフィックス配下の全オブジェクトを取り込んで完了する | 新しいオブジェクトが到着するたびにインデックスを同期し続ける |
前提条件
本記事の内容を試すには、以下が必要です。
- Amazon OpenSearch Serverless (NextGen) コレクションの作成と管理の権限を持つ AWS アカウント
- データを格納した Amazon S3 バケット
- intelligent ingestion が Amazon S3 からデータを読み取るための AWS Identity and Access Management (IAM) ロールと権限
仕組み
Amazon OpenSearch Serverless の AWS マネジメントコンソールページに、新しく Ingestion タブが追加されました。Create ingestion job を選んで取り込みを開始したり、タブ上で既存のジョブを確認したりできます。
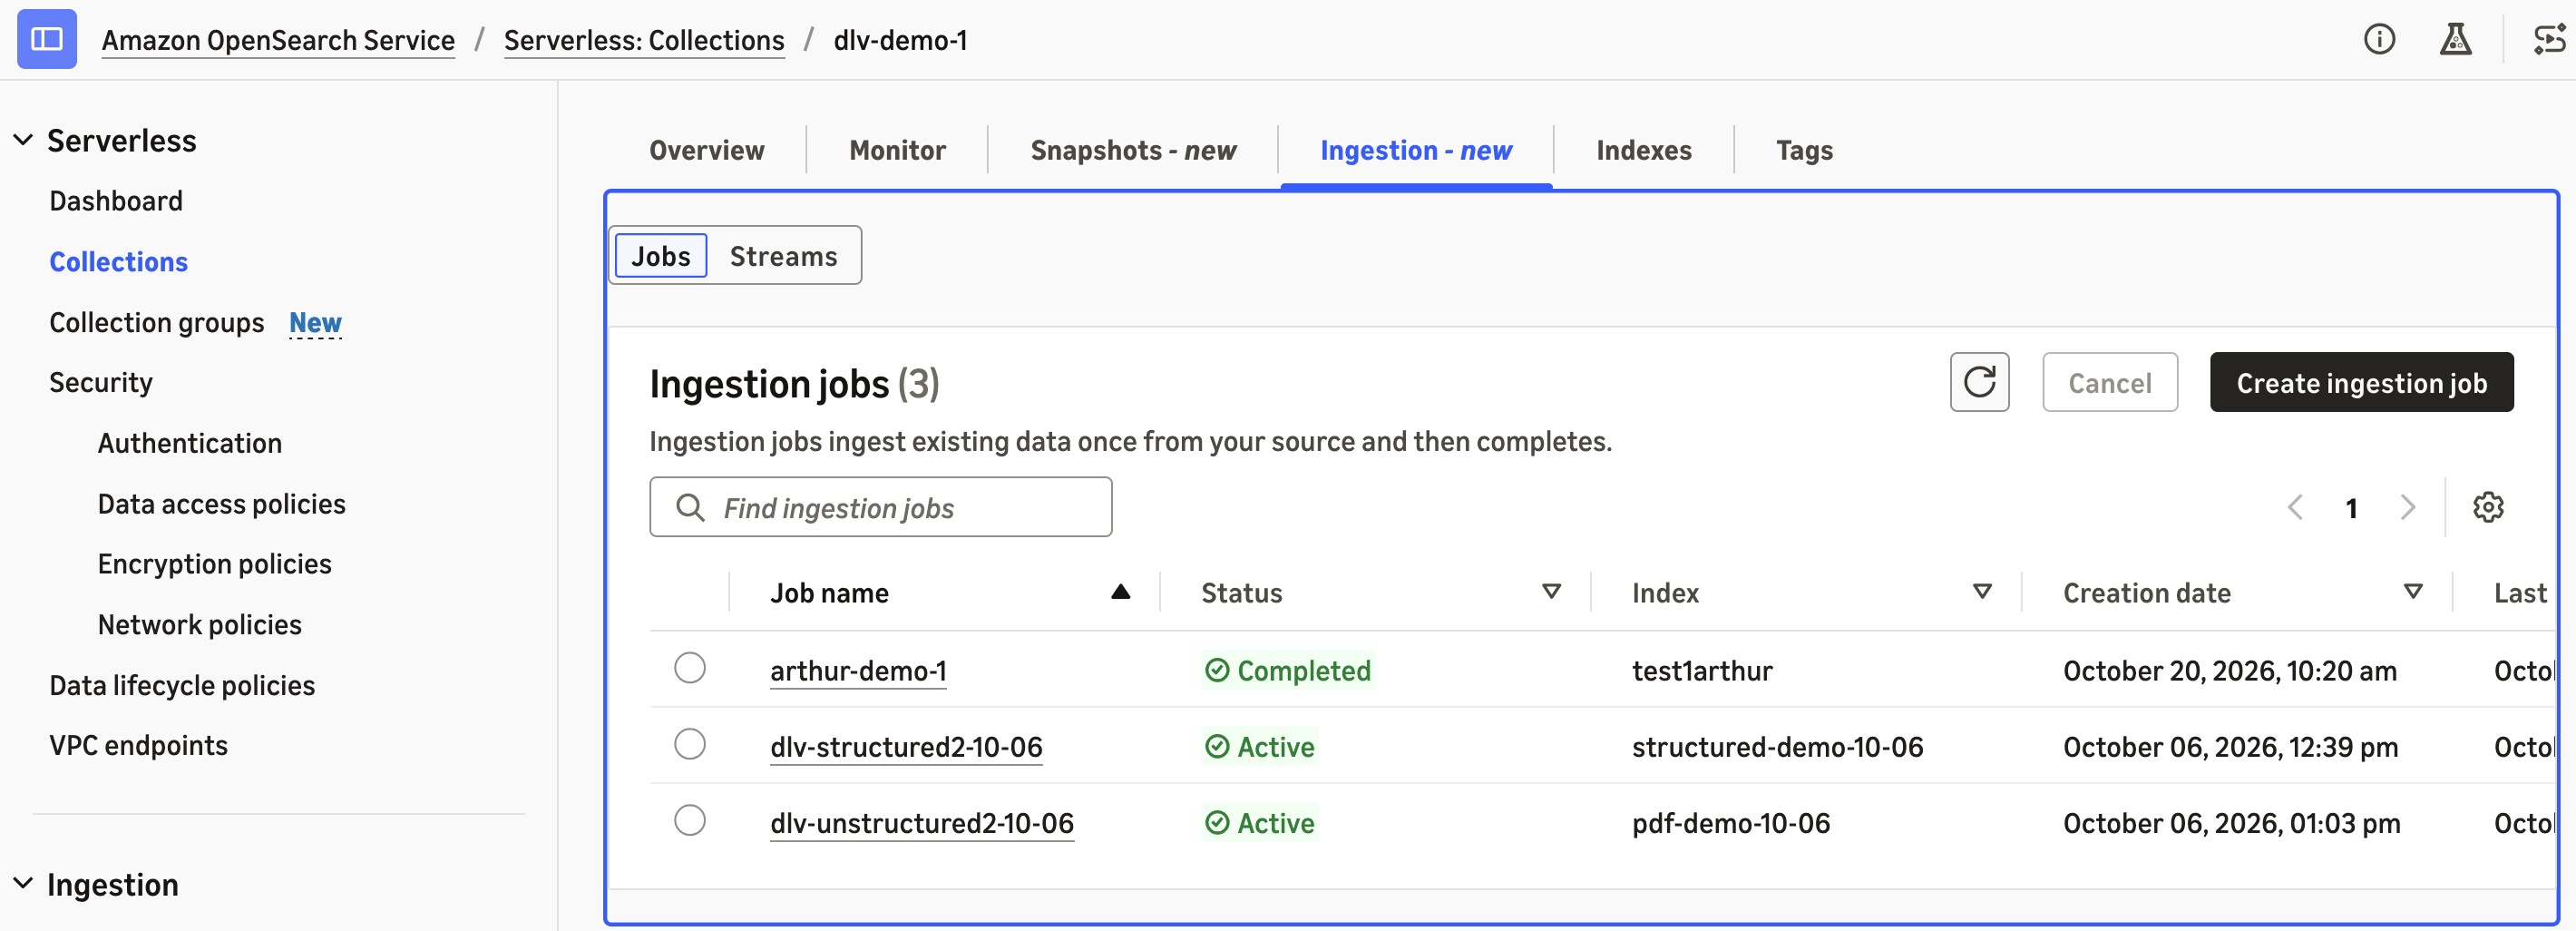
図 1: Amazon OpenSearch Service コンソールの Ingestion タブ
intelligent ingestion はソースの構成に応じて 3 つのモードをサポートします。Amazon S3 上の静的なデータセットには One-time batch を選択します。一度取り込みを行い、取り込みジョブは完了後に自動で終了します。
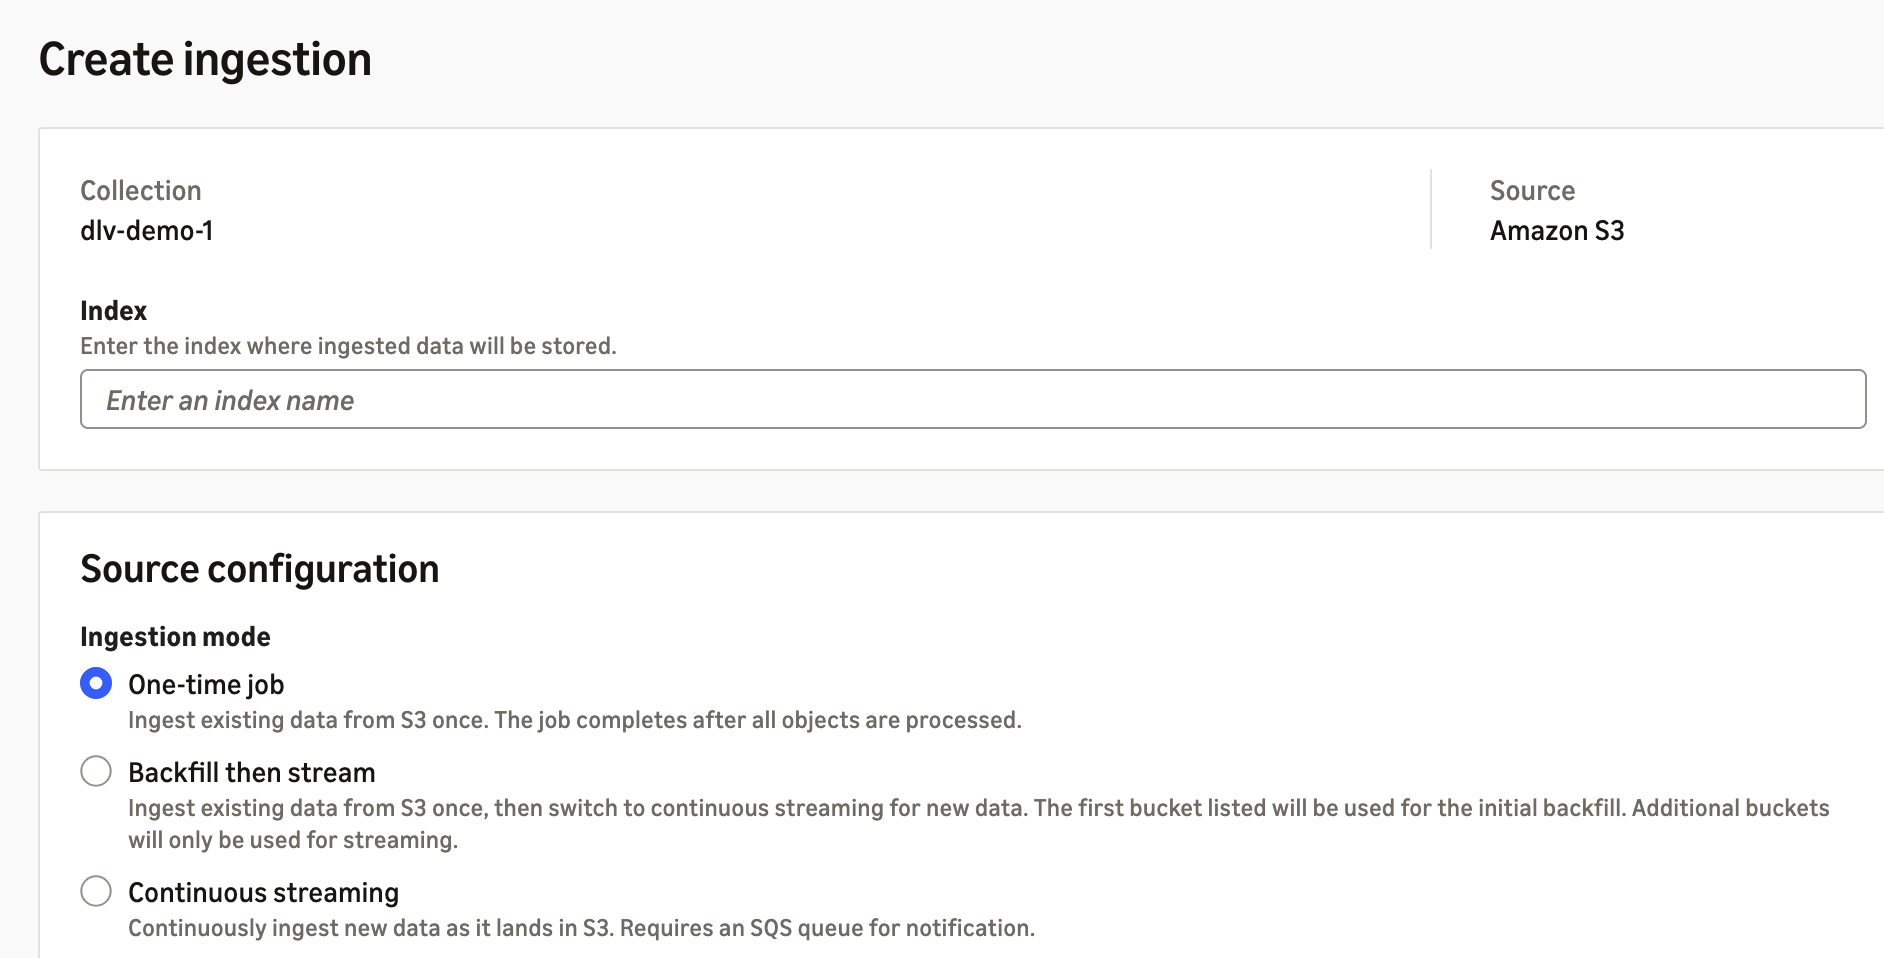
図 2: One-time batch 取り込みモードの選択
これから新しいデータが入ってくる S3 バケットには Continuous streaming を選択すると、通知を継続的に監視し、新しいデータが到着するたびに取り込みを行います。S3 バケットに既にデータが入っている場合は Batch then stream を選択すると、既存データを取り込んでから継続ストリーミングモードに切り替わります。いずれのシナリオでも、intelligent ingestion は Amazon SQS キューを使って Amazon S3 のオブジェクト通知を受け取り、データ取り込みのために引き受ける IAM ロールの Amazon Resource Name (ARN) を必要とします。
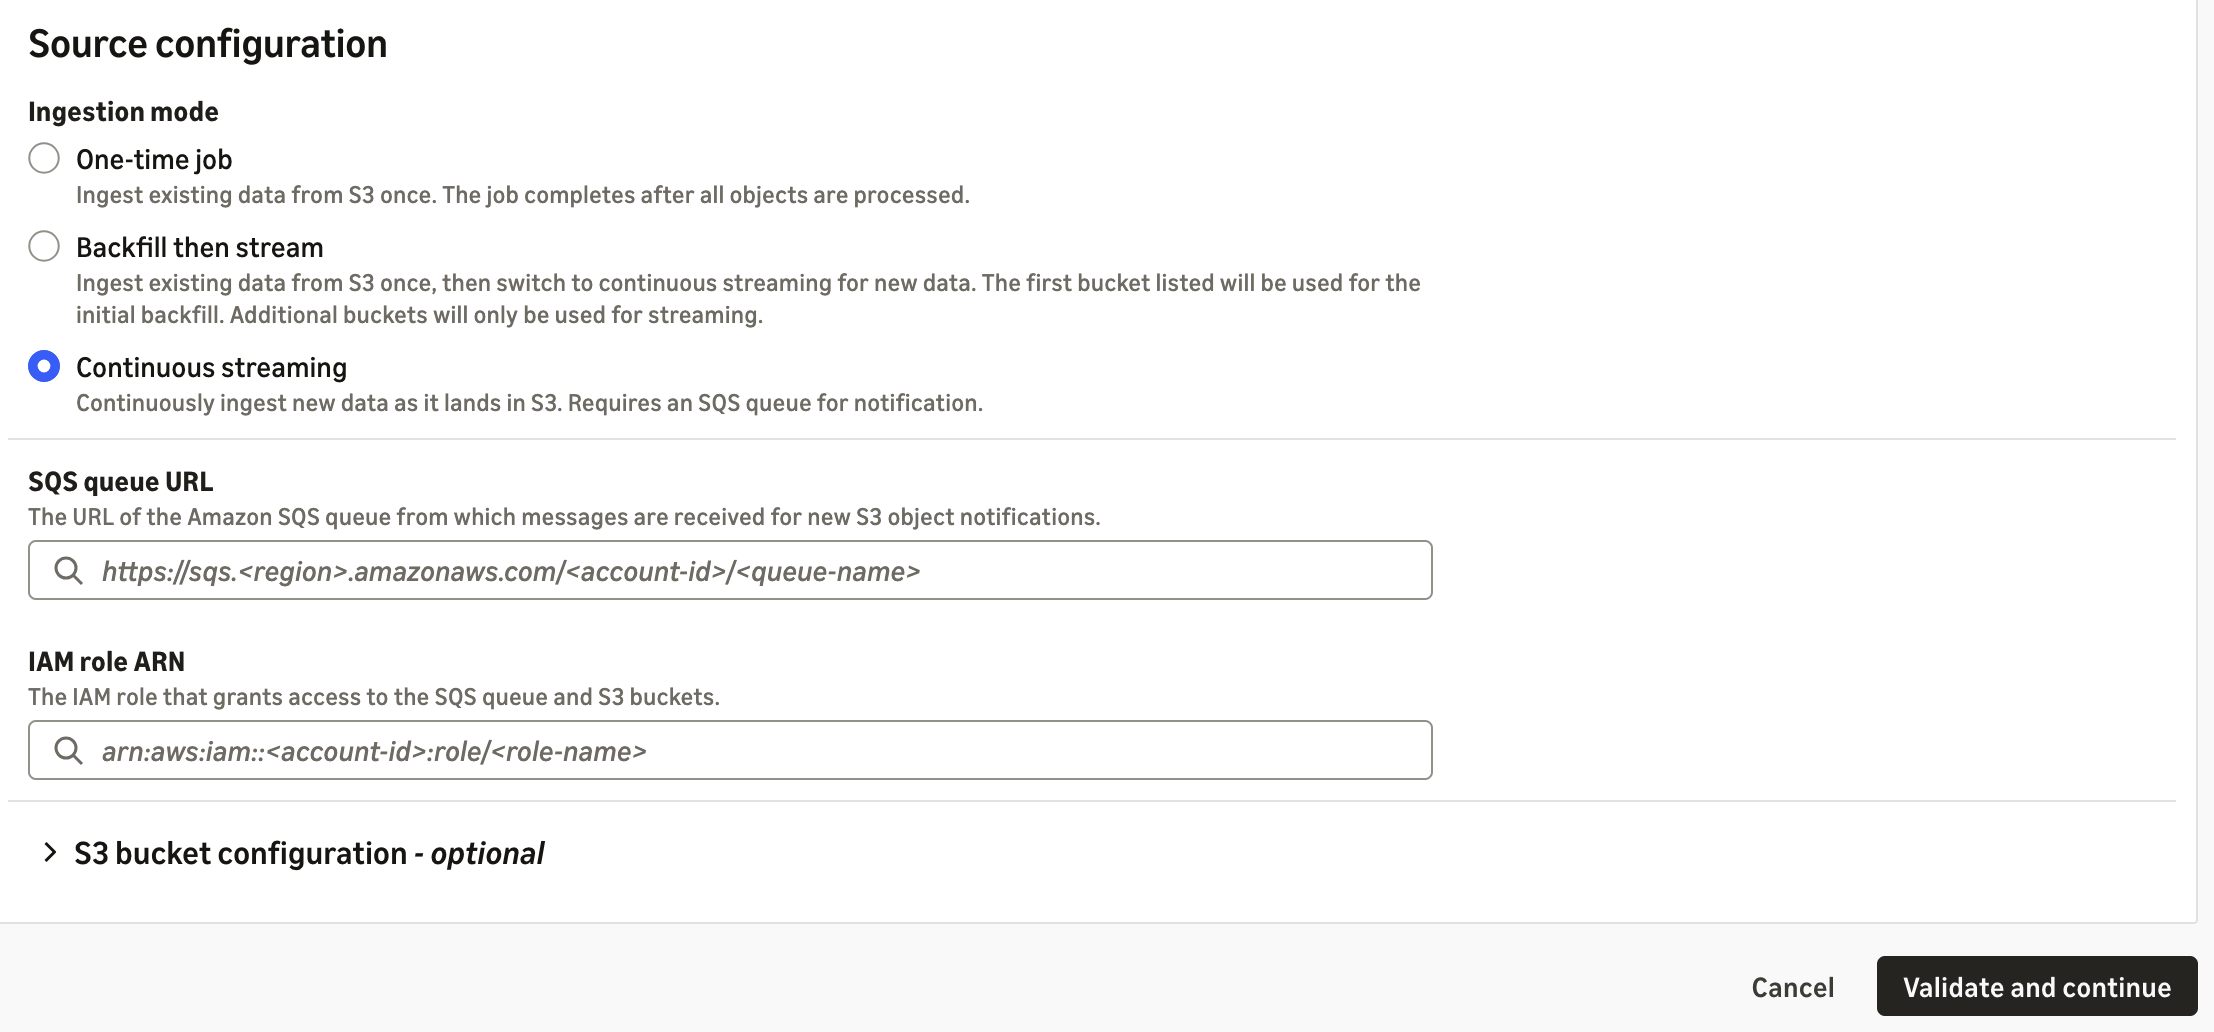
図 3: Amazon SQS キューと IAM ロールを使った Continuous streaming の設定
Backfill then stream は上記 2 つのモードを組み合わせた動作です。初期バックフィル用に 1 つのバケットを指定し、新しいデータのストリーミング用に別のバケットを追加できます。
intelligent ingestion は同一 AWS アカウント内の S3 バケットと自動で連携します。このページで S3 バケットを選択し、オプションでプレフィックスを指定して、バケット内のどのフォルダやファイルを取り込むかを絞り込めます。別の AWS アカウントの S3 バケットにも対応しています。クロスアカウントで利用する場合は、対象アカウントの AWS アカウント ID、Amazon S3 バケット、IAM ロール ARN、そして両方のリソースにアクセスするためにオプションで Amazon SQS を指定します。
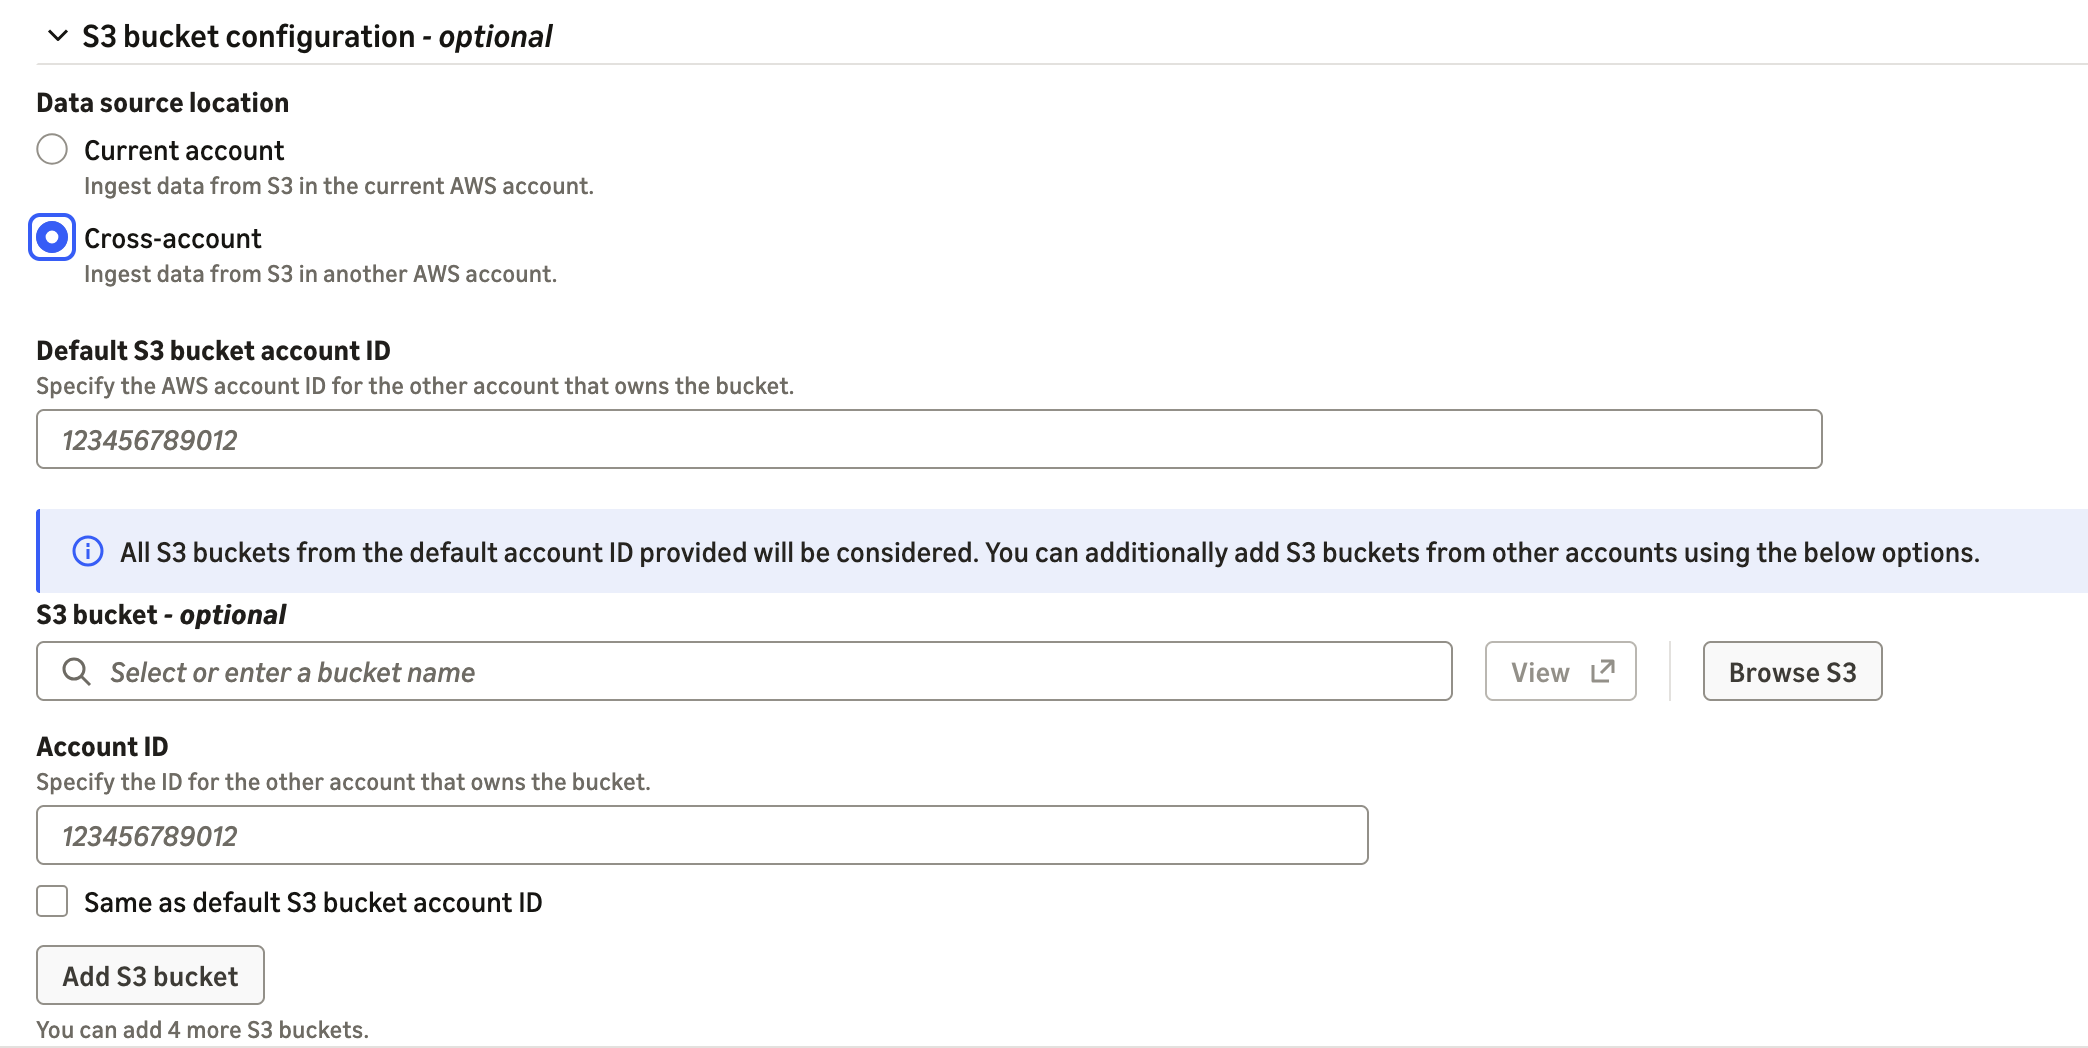
図 4: Amazon S3 バケットの選択とクロスアカウントアクセスの設定 (オプション)
開始するには、Create ingestion job を選んで設定を完了し、Validate and continue を選択します。このページで設定を確認し、取り込みジョブまたはストリームの名前を入力して、取り込みを開始します。開始した取り込みジョブまたはストリームは、Amazon OpenSearch Serverless (NextGen) コレクションの Ingestion タブに表示され、まとめて管理できます。
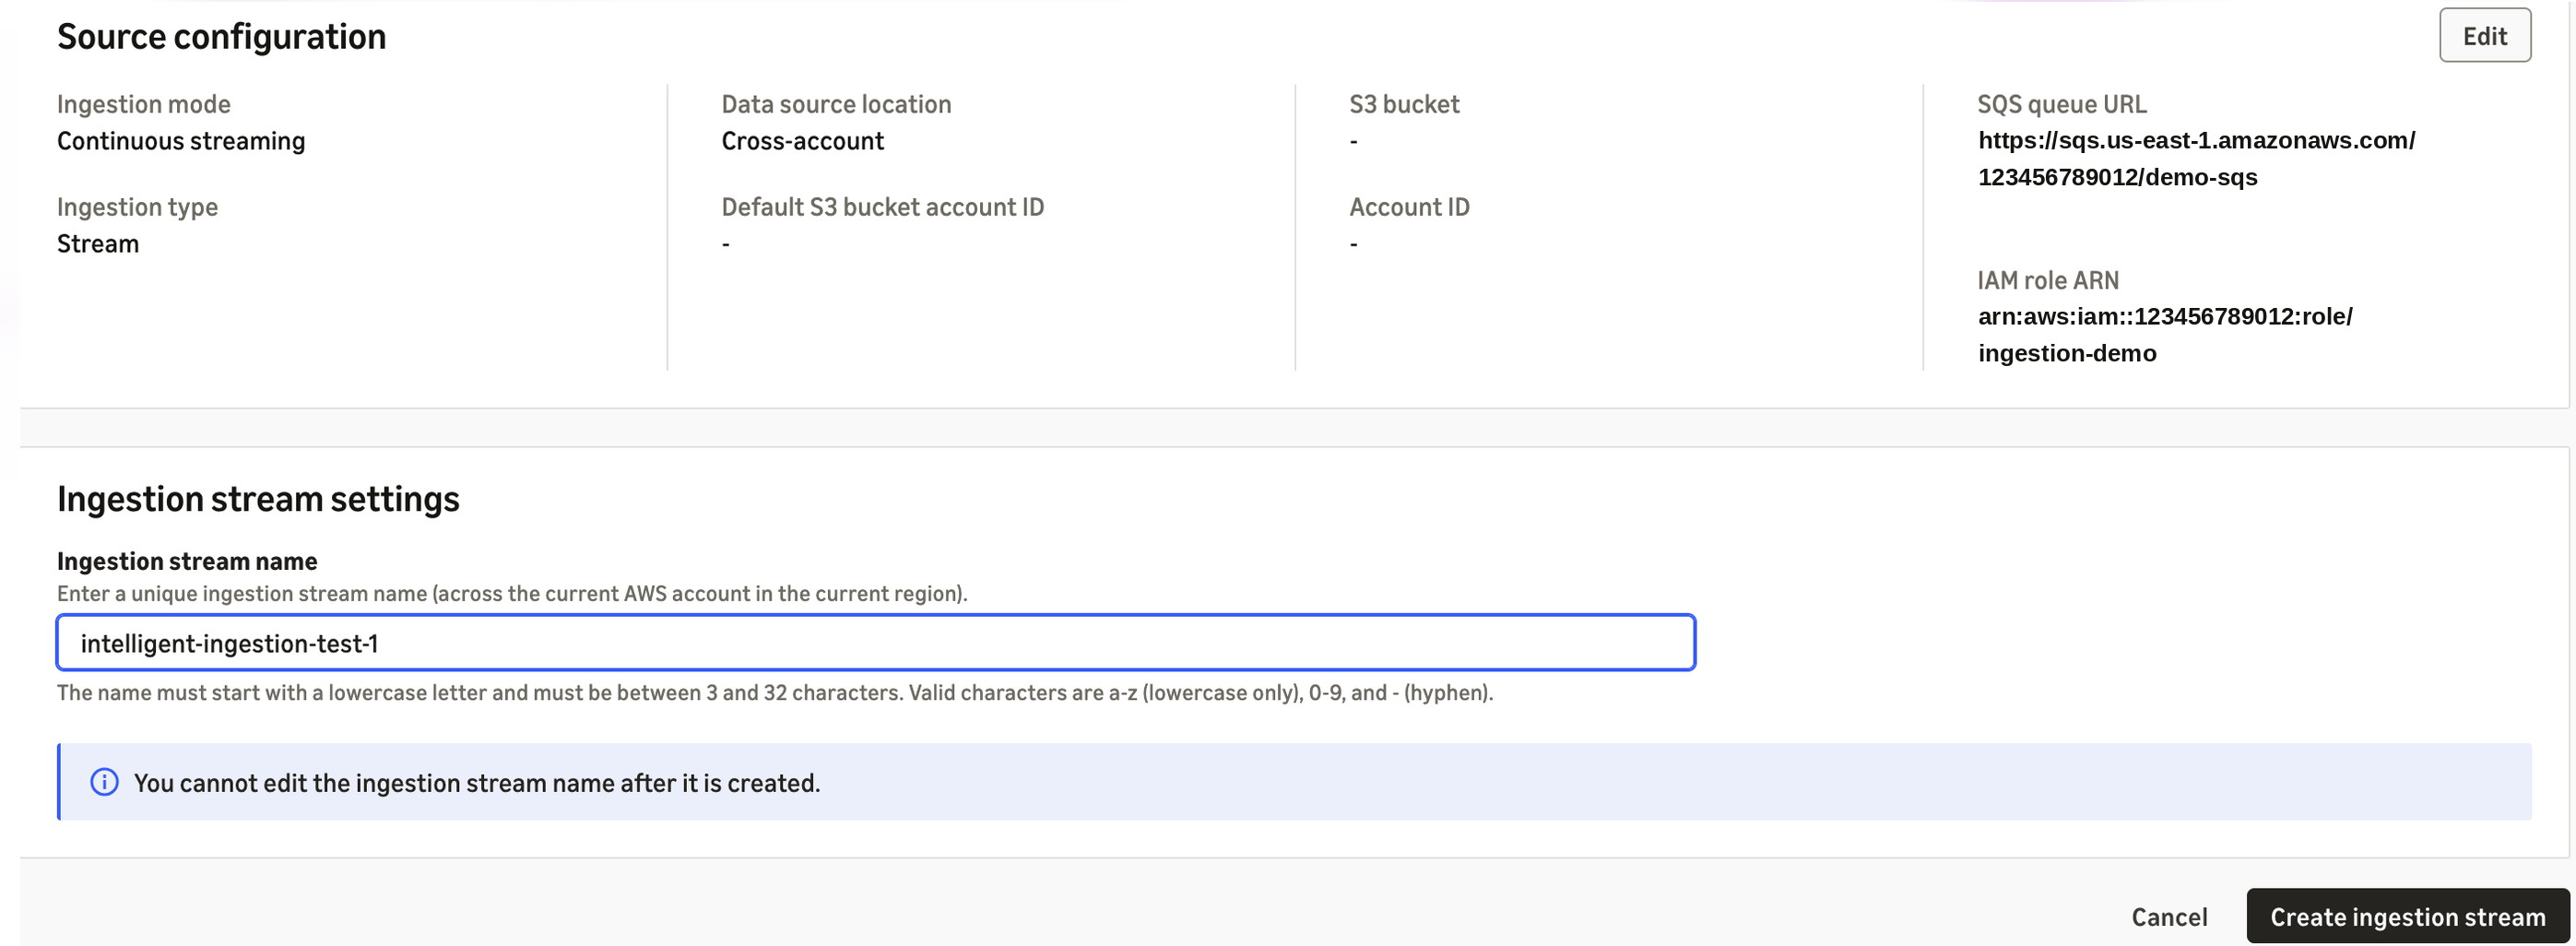
図 5: 取り込みジョブの設定と名前を確認してから開始
開始後、intelligent ingestion はまず S3 バケット内のデータ型をスキャンし、コンテンツ (構造化データ、非構造化データ、画像を含むデータ) に応じた処理方式を決定します。取り込みに必要な作業は intelligent ingestion が自動的に行います。同じページでスキャン済みおよびインデックス化済みのドキュメント数を確認できます。これでデータが Amazon OpenSearch Serverless で検索可能になります。
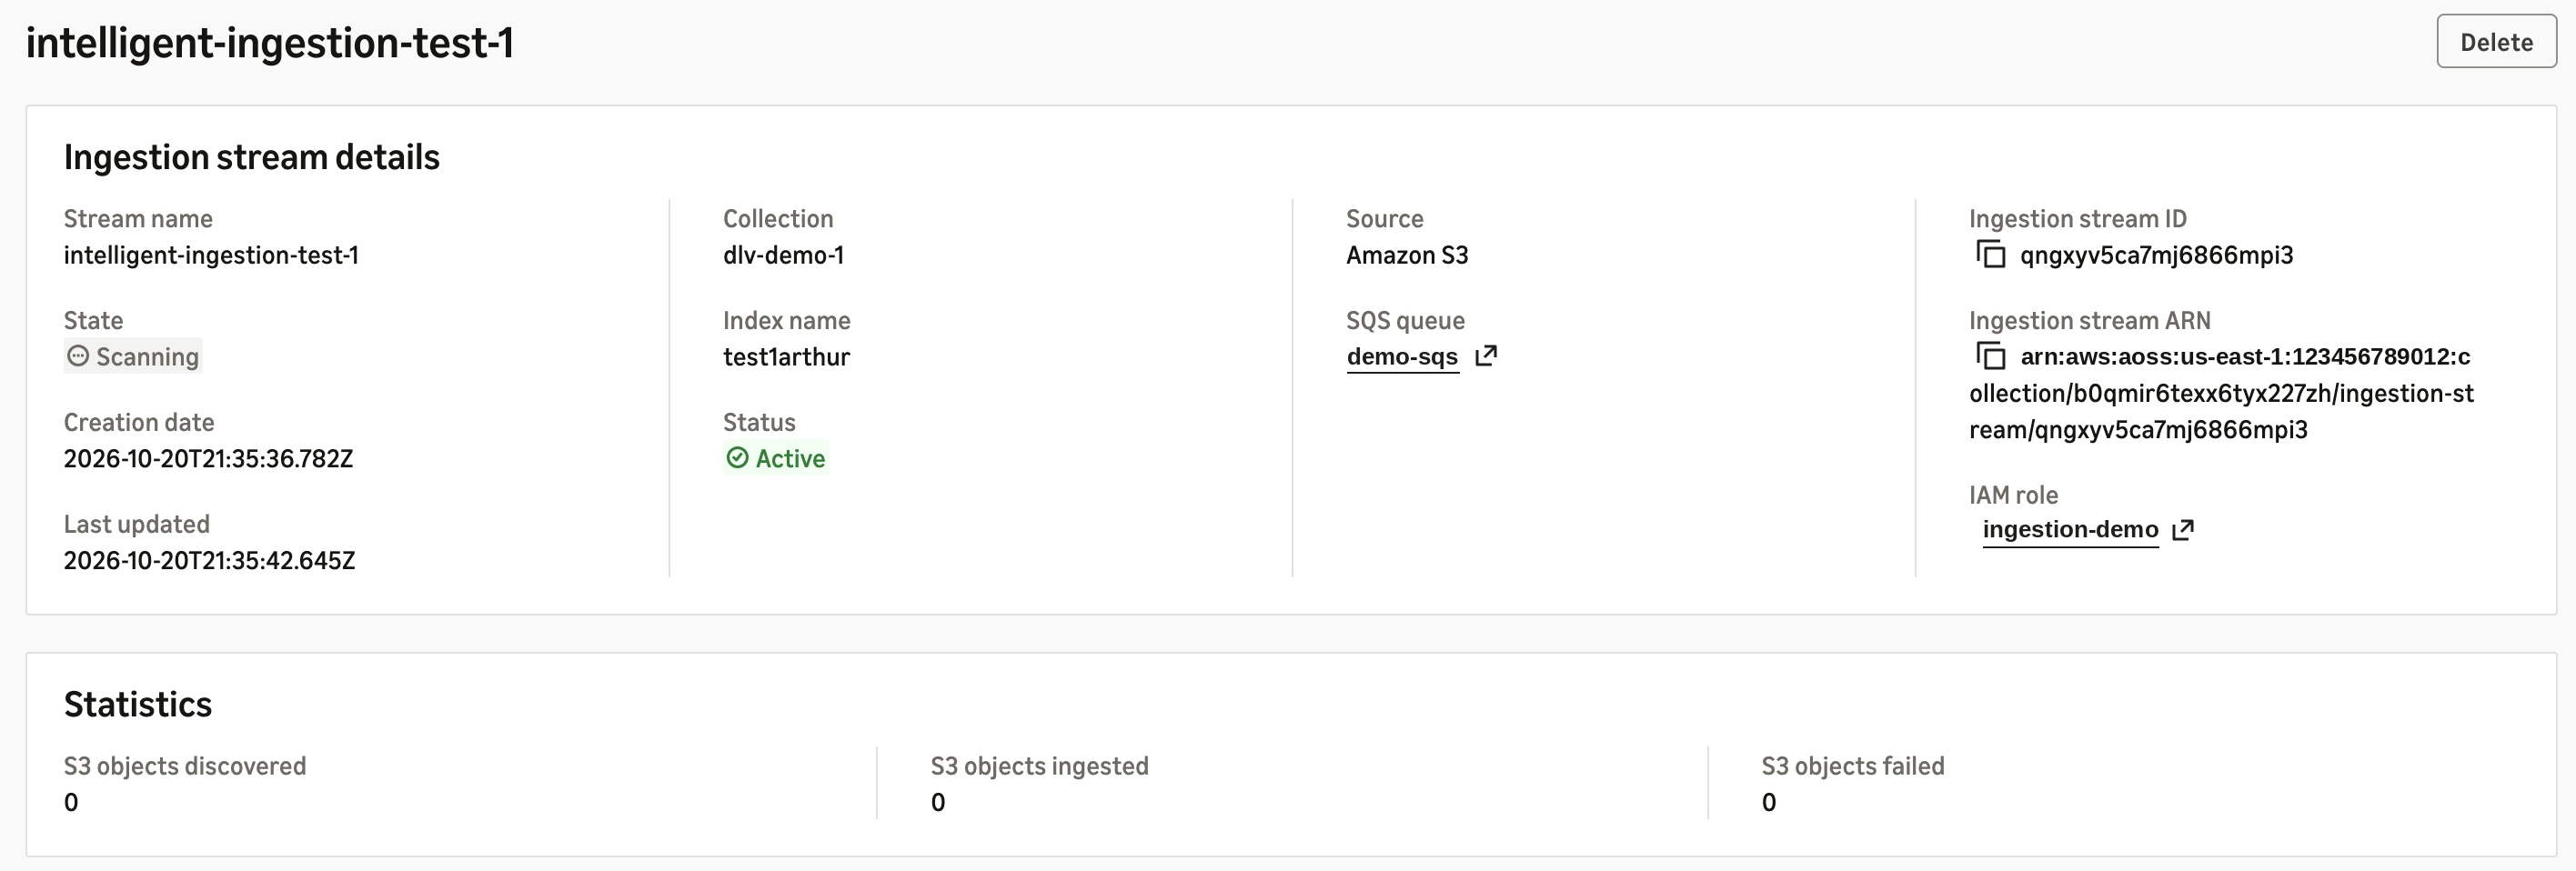
図 6: スキャン済みおよびインデックス化済みドキュメント数のモニタリング
料金
intelligent ingestion は実際に利用した分だけ課金されます。
JSON などの構造化データは、OpenSearch Serverless に直接取り込んでインデックス化できます。各データ取り込みワーカーが実際に動作している時間に対して標準の OCU 料金が発生します。取り込みジョブが完了すると自動的に終了し、課金も停止します。
PDF や Word ドキュメントなどの非構造化データは、追加の解析とチャンク分割、場合によっては画像からの情報抽出を必要とします。intelligent ingestion は、事前に設定した上限の範囲内でサーバーレスインデックス作成 OCU を自動的に使い、テキストを抽出してページを構造化データにチャンク分割します。料金は標準の OCU レート、たとえば US East (バージニア北部) で 1 時間あたり 0.24 USD です。この料金は構造化データ取り込みに上乗せで発生します。社内テストによると、追加で 1 OCU あれば 1 時間あたり 600 ページの PDF を処理でき、取り込み可能な状態まで処理するコストは PDF 1,000 ページあたり 0.40 USD となります。intelligent ingestion は Amazon Nova 2 Lite を使って PDF や Word ファイル内の画像から情報を抽出します。Amazon Bedrock のモデル推論料金は Nova 2 Lite の Amazon Bedrock 公開料金 と同じで、入力トークン 100 万あたり 0.30 USD、出力トークン 100 万あたり 2.50 USD です。社内テストによると、画像 1,000 枚あたり平均で入力トークン 50 万、出力トークン 50 万を消費します。画像 1,000 枚の処理コストはおよそ 1.40 USD になります。
クリーンアップ
今後の課金を避けるため、本記事のウォークスルーで作成したリソースを削除します。作成した Ingestion Streams を削除し、不要であれば OpenSearch コレクションと S3 バケット内のサンプルドキュメントも削除します。Ingestion Jobs は完了後にキャパシティの消費が停止します。
まとめ
本記事では、Amazon OpenSearch intelligent ingestion が Amazon S3 のエンタープライズドキュメントを、管理対象の取り込みパイプラインなしに RAG 対応の情報源に変換する方法を紹介しました。ソース、処理動作、デスティネーションを選ぶだけで、intelligent ingestion がドキュメントを解析し、画像の内容を記述し、コンテンツをチャンクに分割し、ベクトル埋め込みを生成し、結果をインデックス化します。ワークロードに応じてスケールし、実際の処理分だけ課金します。これまでパイプラインの構築に数週間かかっていた作業が、わずか数クリックまたは 1 回の API 呼び出しで完了します。チームは、ユーザーが求める検索や生成 AI の体験づくりに集中できます。intelligent ingestion は本日より、6 つの対応 AWS リージョンで Amazon OpenSearch Serverless (NextGen) コレクションの Amazon S3 データソースとして利用可能です。
ドキュメントを検索可能にしたい方は、Amazon OpenSearch Service コンソール を開き、コレクションを選択して、最初の Ingestion Job を作成してください。少量のドキュメントから始めれば、数分で結果を確認できます。その後、Ingestion Stream を追加すれば、コンテンツの増加に合わせてインデックスを同期し続けられます。詳細は Amazon OpenSearch Service 開発者ガイドの Intelligent ingestion を参照してください。料金の詳細は Amazon OpenSearch Service の料金 を参照してください。
著者について
この記事は Kiro が翻訳を担当し、Solutions Architect の Sotaro Hikita がレビューしました。