AWS 기술 블로그
AV 3.0과 데이터 플라이휠: 자율주행의 승부처가 모델에서 데이터 파이프라인의 회전 속도로 옮겨 가는 이유 (1부)
들어가며
자율주행은 이제 모델 성능만의 경쟁이 아니라, 자사 데이터로 얼마나 빠르게 재학습·검증하느냐의 경쟁으로 옮겨가고 있습니다. NVIDIA CEO 젠슨 황이 CES 2026에서 “Physical AI의 ChatGPT 모멘트”를, GTC에서 자율주행을 “최초의 수조 달러 규모 로보틱스 산업”이라 표현한 것도 이 변화를 가리킵니다.
Physical AI는 물리 세계를 인지·추론·행동하는 AI이고, 자율주행은 그 대표 분야입니다. 2026년 3월 AWS와 NVIDIA가 공개한 자율주행 3.0용 Physical AI 데이터 파이프라인 참조 아키텍처는 바로 이 “데이터 루프”를 어떻게 구성할지에 대한 청사진입니다. 이 글은 그 참조 아키텍처를 중심으로 다룹니다. (원문의 한국어 번역본도 AWS 기술 블로그에 게시되어 있습니다.)
앞서 소개한 참고 블로그는 데이터 파이프라인 구축 방법을 8단계로 설명합니다. 지금 이 시리즈는 그 글을 읽고 직접 실행해 보려는 분들을 위해 썼습니다. 1부에서는 파이프라인이 중요해진 산업적 배경을, 2부에서는 서울 리전에서 실행하는 Blueprint Lab과 이를 고객 환경으로 확장하는 방법을 다룹니다. 설명은 NVIDIA DRIVE 플랫폼과 Alpamayo·Cosmos 계열 오픈 모델을 사용하는 참조 아키텍처를 중심으로 하며, 자체 칩과 모델을 선택한 기업의 사례도 3절에서 함께 살펴봅니다.
> NOTE: 데이터 파이프라인과 데이터 플라이휠
데이터 파이프라인은 차량 데이터의 수집·처리·학습·검증을 연결하는 구조입니다. 모든 데이터가 여덟 단계를 같은 순서로 통과하는 것은 아닙니다. 데이터 플라이휠은 검증과 운행에서 발견한 실패 사례를 다음 데이터 수집과 학습에 반영하는 반복 과정을 뜻하며, 한 번의 개선 주기에 드는 시간과 비용이 관건입니다.
AV 3.0에서는 모델 성능뿐 아니라 자사 차량 데이터로 재학습·검증하는 속도가 중요해지고 있습니다. NVIDIA가 Alpamayo·Cosmos 모델과 AlpaSim을 공개하면서 이를 활용한 개발이 가능해졌지만, 데이터의 수집·관리와 학습·검증 체계는 각 기업이 직접 마련해야 합니다. AWS는 이 과정을 지원하는 관리형 서비스를 제공합니다. 이 글의 수치와 사양은 2026년 10월 기준이며, 요금과 쿼터는 계정과 리전마다 다릅니다.
1. AV 3.0, 무엇이 바뀌었나
AV 3.0 데이터 파이프라인의 참조 아키텍처는 자율주행 소프트웨어의 변화를 세 세대로 구분합니다. 업계 표준 명칭은 아니지만, 이 글도 같은 설명 틀을 따릅니다. 1.0은 인지·예측·계획·제어 모듈과 그 사이의 인터페이스를 각각 설계하는 방식입니다. 2.0은 입력에서 출력까지 통합해 학습하는 엔드투엔드 방식이고, 3.0은 여기에 판단 근거를 설명하는 추론(reasoning)을 더합니다. 3.0의 대표적인 구현이 비전-언어-행동(VLA) 모델이며, 카메라 영상과 주행 이력을 받아 주행 궤적과 그 판단 근거를 함께 출력합니다.
> NOTE: 추론의 두 가지 의미 – inference와 reasoning
inference와 reasoning은 우리말로 모두 ‘추론’으로 번역되지만 의미가 다릅니다. inference는 학습을 마친 모델이 입력을 받아 결과를 내놓는 과정입니다. 자율주행에서는 주행 중에 센서 입력을 받아 주행 궤적을 출력하는 것이 inference입니다. reasoning은 그 결과에 이르는 판단 과정과 근거입니다. “보행자가 횡단보도로 다가오고 있으니 감속한다” 같은 것이 reasoning입니다. 두 가지를 함께 하는 대표적인 모델이 NVIDIA Alpamayo 같은 비전-언어-행동(VLA) 모델입니다. 이 모델은 카메라 영상과 주행 이력을 입력받아 주행 궤적과 그 판단 근거를 함께 출력합니다.> NOTE: VLA(Vision-Language-Action) 모델
영상과 언어를 이해하는 비전-언어 모델(VLM)에 행동 출력을 더한 모델입니다. 자율주행에서는 행동을 미래 주행 궤적으로 표현합니다.
판단 근거에 대한 설명은 실패 원인을 분석하고 추가로 수집할 데이터를 정하는 데 도움이 됩니다. 예를 들어 “공사 구간이라 좌회전 차선이 막혔다고 판단해 우회했다”는 추론은 장면 인식이나 경로 선택의 오류를 점검할 단서가 됩니다. 다만 추론 텍스트가 실제 판단 과정을 충실히 반영하는지(faithfulness)는 연구 중인 문제입니다. 따라서 이를 진단의 단서로 활용하되, 안전성은 폐루프 평가 결과와 함께 확인해야 합니다.
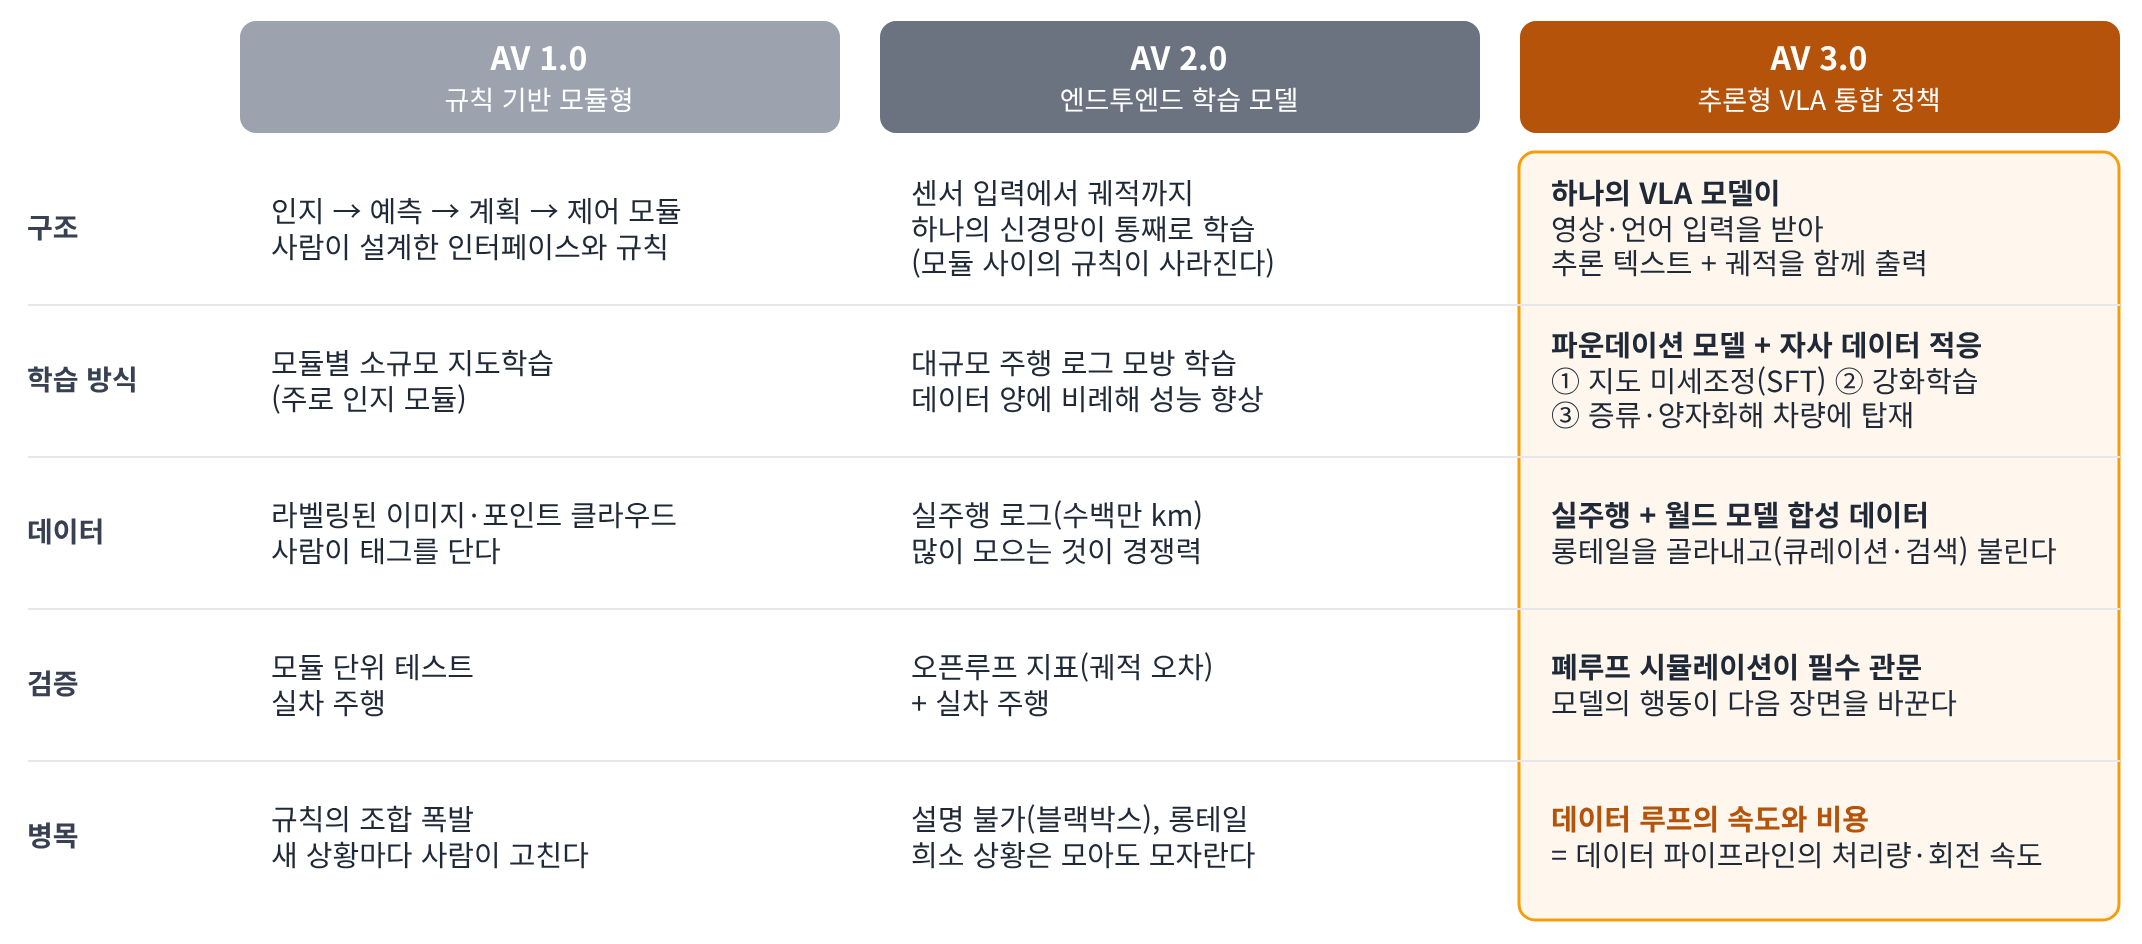
그림 1-1. 세 세대에서 구조·학습·데이터·검증·병목의 변화.
이 변화는 데이터와 검증 방식에도 영향을 줍니다. 파운데이션 모델을 자사 데이터에 맞게 학습시키는 과정에서 부딪히는 대표적인 과제가 롱테일 문제(long-tail problem)입니다.
롱테일 문제란, 실제 도로에서 드물게 발생하는 상황의 종류가 너무 많아 각 상황의 학습·검증 데이터를 충분히 확보하기 어려운 문제를 말합니다. 주행 상황을 발생 빈도순으로 늘어놓으면, 차선 유지나 신호 대기처럼 흔한 장면은 앞쪽에 모이고 도로 낙하물이나 경찰 수신호를 따라야 하는 장면은 뒤쪽으로 긴 꼬리처럼 이어집니다. 개별 상황은 드물어도 종류가 많고, 일부는 사고로 이어질 수 있어 빈도가 낮다고 무시할 수 없습니다.
이런 장면을 실제 주행만으로 모으려면 많은 시간과 비용이 들고, 위험한 상황을 일부러 재현하기도 어렵습니다. 그래서 합성 데이터로 부족한 학습 사례를 보완하고, 시뮬레이션에서 드문 상황을 반복해 모델의 대응을 검증합니다. 검증은 두 가지를 함께 씁니다. 기록된 궤적과 모델의 예측을 비교하는 오픈루프 평가, 그리고 모델의 행동이 다음 상황에 반영되는 폐루프 시뮬레이션입니다. 다만 합성 데이터와 시뮬레이션은 실제 주행 데이터를 보완하는 수단이므로, 생성한 장면과 평가 환경이 실제 도로의 특성을 충분히 반영하는지 확인해야 합니다. 이 작업들을 반복하려면 선별된 데이터, GPU 연산 자원, 시뮬레이션용 장면을 연결해야 합니다. 데이터 파이프라인의 처리량과 반복 주기가 모델 개발 속도를 좌우하는 이유입니다.
> NOTE: 월드 모델(World Model)과 폐루프 시뮬레이션(Closed-Loop Simulation)
월드 모델은 장면의 변화나 다음 상태를 예측·생성하며, 주행 영상의 날씨를 바꾸거나 새로운 시나리오를 만드는 데 쓰입니다. 폐루프 시뮬레이션에서는 모델의 행동이 가상 환경의 다음 상황에 반영되므로 충돌 여부, 주행 경로 이탈 등을 평가할 수 있습니다.
2. NVIDIA의 전략: 세 종류의 컴퓨터, 하나의 아키텍처, 오픈 모델
NVIDIA는 자율주행에 필요한 컴퓨팅을 세 종류로 정의합니다. 데이터센터에서 모델을 학습하는 컴퓨터(NVIDIA DGX), 합성 데이터를 만들고 시뮬레이션을 돌리는 컴퓨터(NVIDIA RTX 기반 NVIDIA Omniverse 및 NVIDIA Cosmos), 차 안에서 추론하는 컴퓨터(NVIDIA DRIVE AGX)입니다. 차에서 모은 데이터가 학습 컴퓨터로, 학습된 모델이 시뮬레이션 컴퓨터로, 검증된 모델이 다시 차로 돌아갑니다. NVIDIA 스스로 이 구조를 “실제 주행 데이터를 수십억 마일의 가상 주행으로 바꾸는 클라우드-투-카(Cloud-to-Car) 개발 파이프라인”이라고 부릅니다. 이 개발 과정에 사용하는 모델도 오픈 모델로 공개하고 있습니다.
> NOTE: 클라우드와 차량의 컴퓨팅 역할
AWS에서는 GPU 인스턴스와 SageMaker HyperPod로 학습·시뮬레이션용 연산 자원을 구성합니다. DRIVE AGX는 차량에 탑재하는 컴퓨터이며, 현 세대 칩은 Thor입니다.
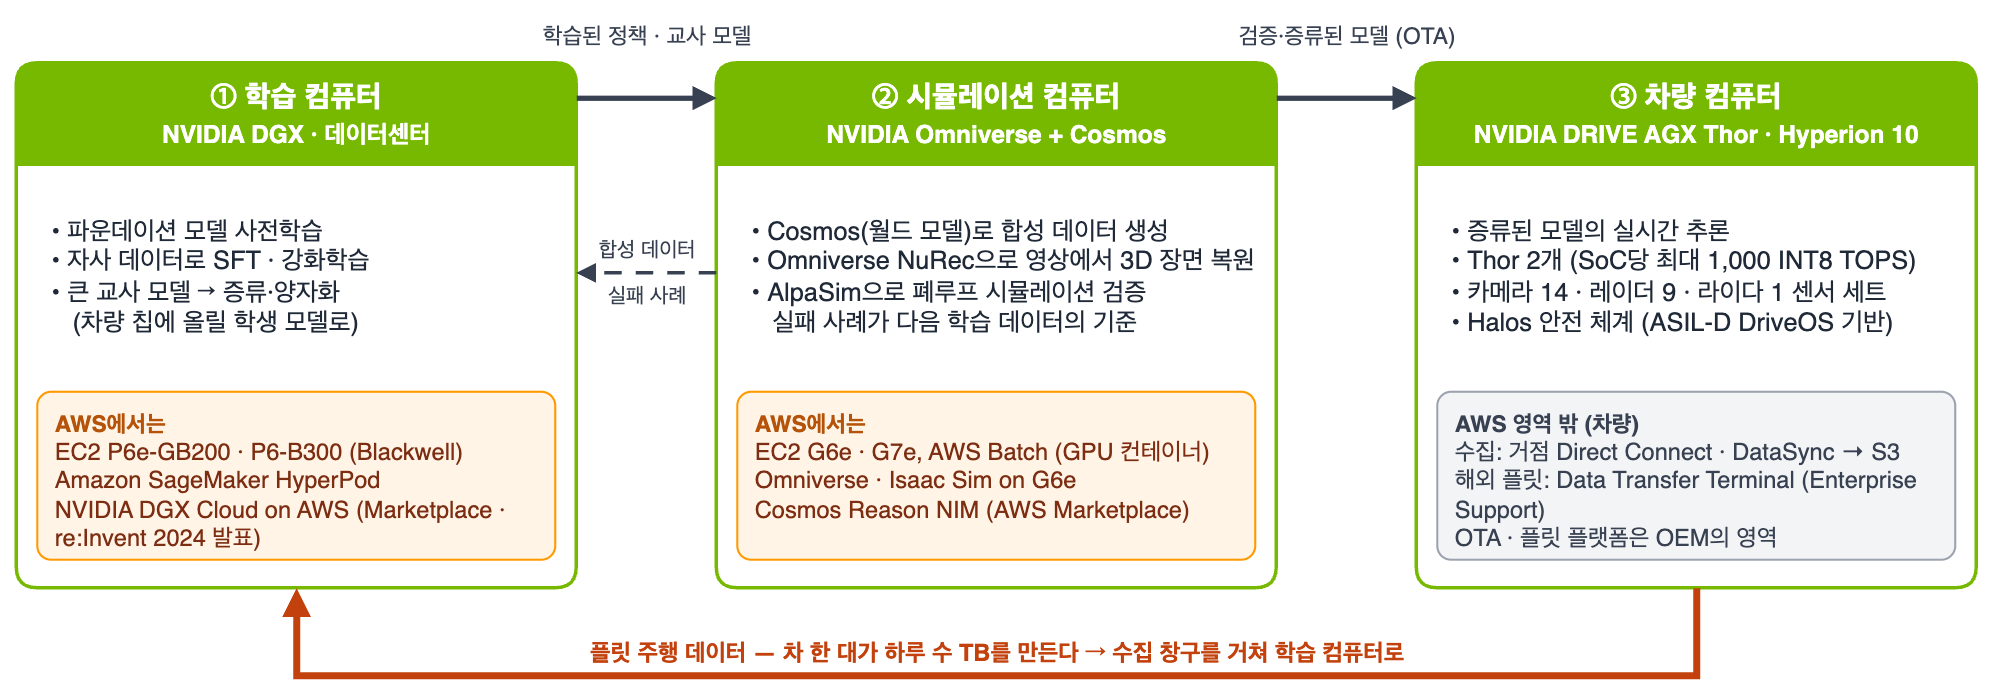
그림 1-2. 차량 데이터가 클라우드의 학습·검증을 거쳐 차량용 모델 개선으로 이어지는 구조.
차량 쪽의 NVIDIA Hyperion은 L2 운전 보조부터 L4 자율주행까지 지원하는 참조 아키텍처입니다. 컴퓨트와 센서를 확장하며 공통 소프트웨어를 활용하도록 설계했습니다. 현행 Hyperion 10은 DRIVE AGX Thor 두 개와 카메라 14대·레이더 9개·라이다 1개로 구성됩니다(2026년 9월 “DRIVE Hyperion”에서 “Hyperion”으로 개칭). 안전 체계 Halos는 AI 스택과 별도의 안전 스택을 병행하는 구조이며, 기반 운영체제 DriveOS는 ASIL-D(Automotive Safety Integrity Level D, 자동차 안전 무결성 최고 등급) 인증을 받았습니다.
차량용 컴퓨터는 전력·메모리·지연 시간에 제약이 있어, 수백억 개 파라미터의 대형 모델을 그대로 탑재하기 어렵습니다. 따라서 데이터센터에서 활용하는 대형 모델과 차량에서 실행할 모델의 역할을 나눠야 합니다. NVIDIA는 Alpamayo 계열의 대형 주행 모델을 교사 모델로 활용해 차량용 소형 모델을 개발하는 구조를 제시합니다. 개발사는 자사 데이터에 맞게 모델을 조정하고, 교사 모델의 출력을 활용해 작은 모델을 학습시키는 증류 등의 기법으로 차량의 실행 제약에 맞춥니다. 이렇게 개발한 차량용 모델은 Hyperion 플랫폼에 탑재된 DRIVE AGX Thor에서 실행됩니다.
이 흐름을 지원하는 모델은 역할에 따라 나뉩니다. Alpamayo는 주행 판단을 위한 모델이고, Cosmos는 학습·검증에 필요한 데이터를 생성·증강하는 월드 모델입니다. 2026년의 주요 모델 공개는 다음과 같습니다.
| 발표 시점 | 모델 | 주요 변화 |
|---|---|---|
| 2026.01 (CES) | Alpamayo | 판단 근거를 인과 체인으로 출력하는 오픈 VLA |
| 2026.03 (GTC) | Alpamayo 1.5 | 내비게이션·텍스트 지시, 멀티카메라, 사후 학습 스크립트 |
| 2026.05 말 | Alpamayo 2 Super (34B) | 차량용 소형 모델로 증류할 교사 모델, 추론 자동 라벨링 |
| 2026.06 | Cosmos 3 | 월드 모델 3세대 |
공개된 모델과 학습 도구를 활용하면 개발사는 자사 데이터로 모델을 조정하고, 차량의 실행 조건에 맞게 최적화할 수 있습니다. 이때 활용하는 대표적인 기법이 증류와 양자화입니다.
> NOTE: 증류(Distillation)와 양자화(Quantization)
증류는 큰 교사 모델의 출력을 활용해 작은 학생 모델을 학습시키는 기법입니다. 양자화는 숫자 정밀도를 낮춰(예: 16비트→8비트·4비트) 메모리와 연산량을 줄입니다. 차량의 전력·지연 시간 제약에 맞춰 모델을 최적화할 때 활용합니다.
3. 완성차 업체는 어떻게 선택하고 있나
각사의 공개 발표를 기준으로 채택 방식을 네 가지 패턴으로 정리했습니다. 설명을 위한 분류이며, 각사의 공식 입장은 아닙니다. 2026년 10월까지의 발표를 반영했고, BYD·Geely·Nissan은 GTC 2026 발표에 근거합니다.
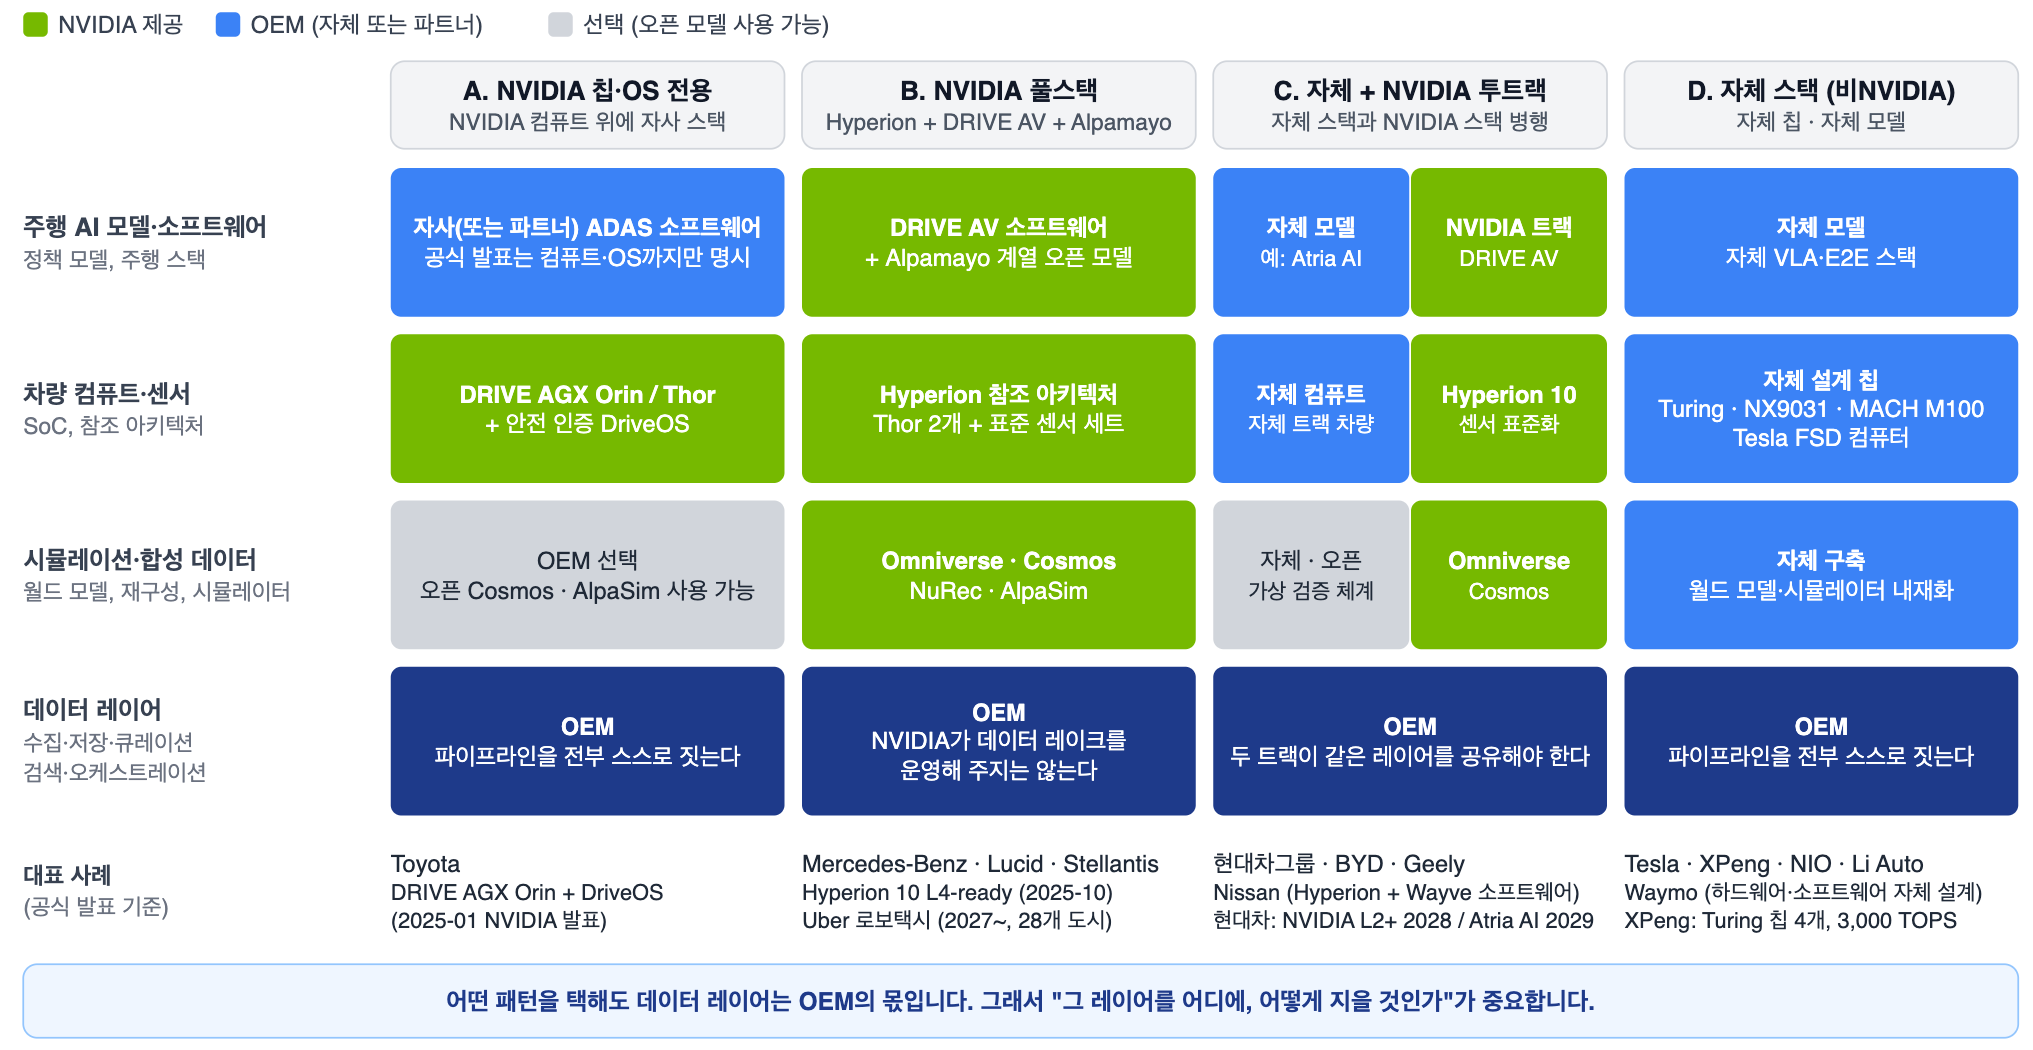
그림 1-3. 네 채택 패턴의 주행 소프트웨어·차량 컴퓨트·시뮬레이션 구성 비교.
- Hyperion을 채택했다고 해서 NVIDIA 풀스택을 쓴다고 볼 수는 없습니다. Nissan은 NVIDIA 하드웨어에 Wayve 소프트웨어를 조합했고, Toyota의 발표 범위는 컴퓨트와 운영체제에 한정됩니다. 하드웨어 선택과 주행 소프트웨어 선택을 구분해야 합니다.
- 같은 기업도 양산 ADAS와 L4를 다르게 구성합니다. BYD·Geely에 대한 NVIDIA 발표는 L4 프로그램에 한정되어 있어, 표에서는 C로 분류했습니다. L4는 센서 이중화와 안전 설계 요구가 큰 반면, 양산 ADAS는 원가와 기존 공급망의 제약이 선택에 더 크게 작용하는 것으로 보입니다.
- 자체 주행 칩을 쓰는 기업도 오픈 월드 모델을 데이터 도구로 활용할 수 있습니다. NVIDIA의 Cosmos 3 발표문은 Li Auto를 Cosmos 플랫폼에서 자율주행을 개발하는 기업으로 소개합니다. 차량용 스택의 선택과 데이터 증강 도구의 선택이 꼭 같을 필요는 없습니다.
- 채택 방식과 관계없이, OEM은 데이터 파이프라인의 구축·운영 방안을 정해야 합니다. 특히 자체 스택과 NVIDIA 기반 프로그램을 함께 가져가는 투 트랙(Two-Track) 전략에서는, 두 스택이 데이터를 공유할 수 있도록 표준화하는 작업이 중요합니다.
> 사례: 현대차그룹의 투트랙
현대차그룹은 2025년 1월 NVIDIA와 전략적 제휴를 맺은 뒤 2026년 3월 파트너십 확대를, 9월 13일 투 트랙 전략과 “데이터 플라이휠” 로드맵을 발표했습니다. 첫 트랙은 NVIDIA 솔루션 기반 L2+ 양산(2028년 상반기)과 L2++(같은 해 하반기)로 Hyperion 10 중심의 센서 표준화를 포함하고, 둘째 트랙은 자체 엔드투엔드 모델 Atria AI 기반 L2++ 양산(2029년 하반기)입니다. 발표는 전용 데이터 수집 차량 약 40대, 하드 예제 마이닝, 지속 학습, 가상 검증을 플라이휠의 구성 요소로 들었습니다. 두 개발 경로에 활용할 데이터와 검증 체계를 함께 마련하는 사례입니다.
4. 데이터 파이프라인에서 플라이휠로: AWS와 NVIDIA가 함께 그린 8단계
AV 3.0 데이터 파이프라인의 참조 아키텍처는 Ingest, Data Processing, Train, Validate 네 페이즈와 여덟 개 기능 단계로 구성됩니다. 아래 표는 각 단계의 역할과 구성 요소를 요약합니다. AWS 서비스를 선택한 이유는 이어지는 문단에서, Lab 모듈과의 대응 관계는 블로그 2부에서 다룹니다.
| 단계 | 역할·주요 산출물 | AWS | NVIDIA |
|---|---|---|---|
| 1. 데이터 수집 | 차량 로그를 클라우드에 저장 | Data Transfer Terminal, Amazon S3 | — |
| 2. 품질 검증·추출 | 채널 검증, 센서별 데이터 추출 | AWS Batch | — |
| 3. 큐레이션 | 클립·캡션·임베딩 생성 | Amazon SageMaker HyperPod | Cosmos Curator·Reason·Embed |
| 4. 검색·색인 | 학습할 장면 검색 | Amazon OpenSearch Service 또는 Amazon EKS | Cosmos Dataset Search |
| 5. 선택·증강 | 학습·재구성용 데이터 선별, 조건 변환 | Amazon EC2 GPU, Amazon DCV | Cosmos Transfer |
| 6. 장면 재구성 | 실측 센서 데이터로 3D 장면 생성 | AWS Batch, Amazon S3 | Omniverse NuRec |
| 7. 모델 학습 | 5단계 데이터로 주행 모델 학습 | HyperPod, EC2 GPU | Alpamayo |
| 8. SiL 검증 | 6단계 장면에서 7단계 모델 평가 | EC2 GPU, AWS Batch | AlpaSim |
표의 단계 번호는 모든 작업의 직렬 실행 순서를 뜻하지 않습니다. 몇 가지만 짚어두겠습니다.
- 참고 블로그에서도 일부 페이즈는 단계가 서로 겹칩니다.
- 참고 블로그의 Figure 1은 7·8번이 본문과 반대로 표시되어 있어, 이 글은 본문 기준(7번 학습, 8번 검증)을 따릅니다.
- 장면 재구성(6)과 주행 모델 학습(7)은 서로 다른 경로입니다.
- 모델 버전이 바뀌어도 데이터 처리·학습·검증을 잇는 파이프라인을 계속 재사용할 수 있도록 설계하는 것이 중요합니다.
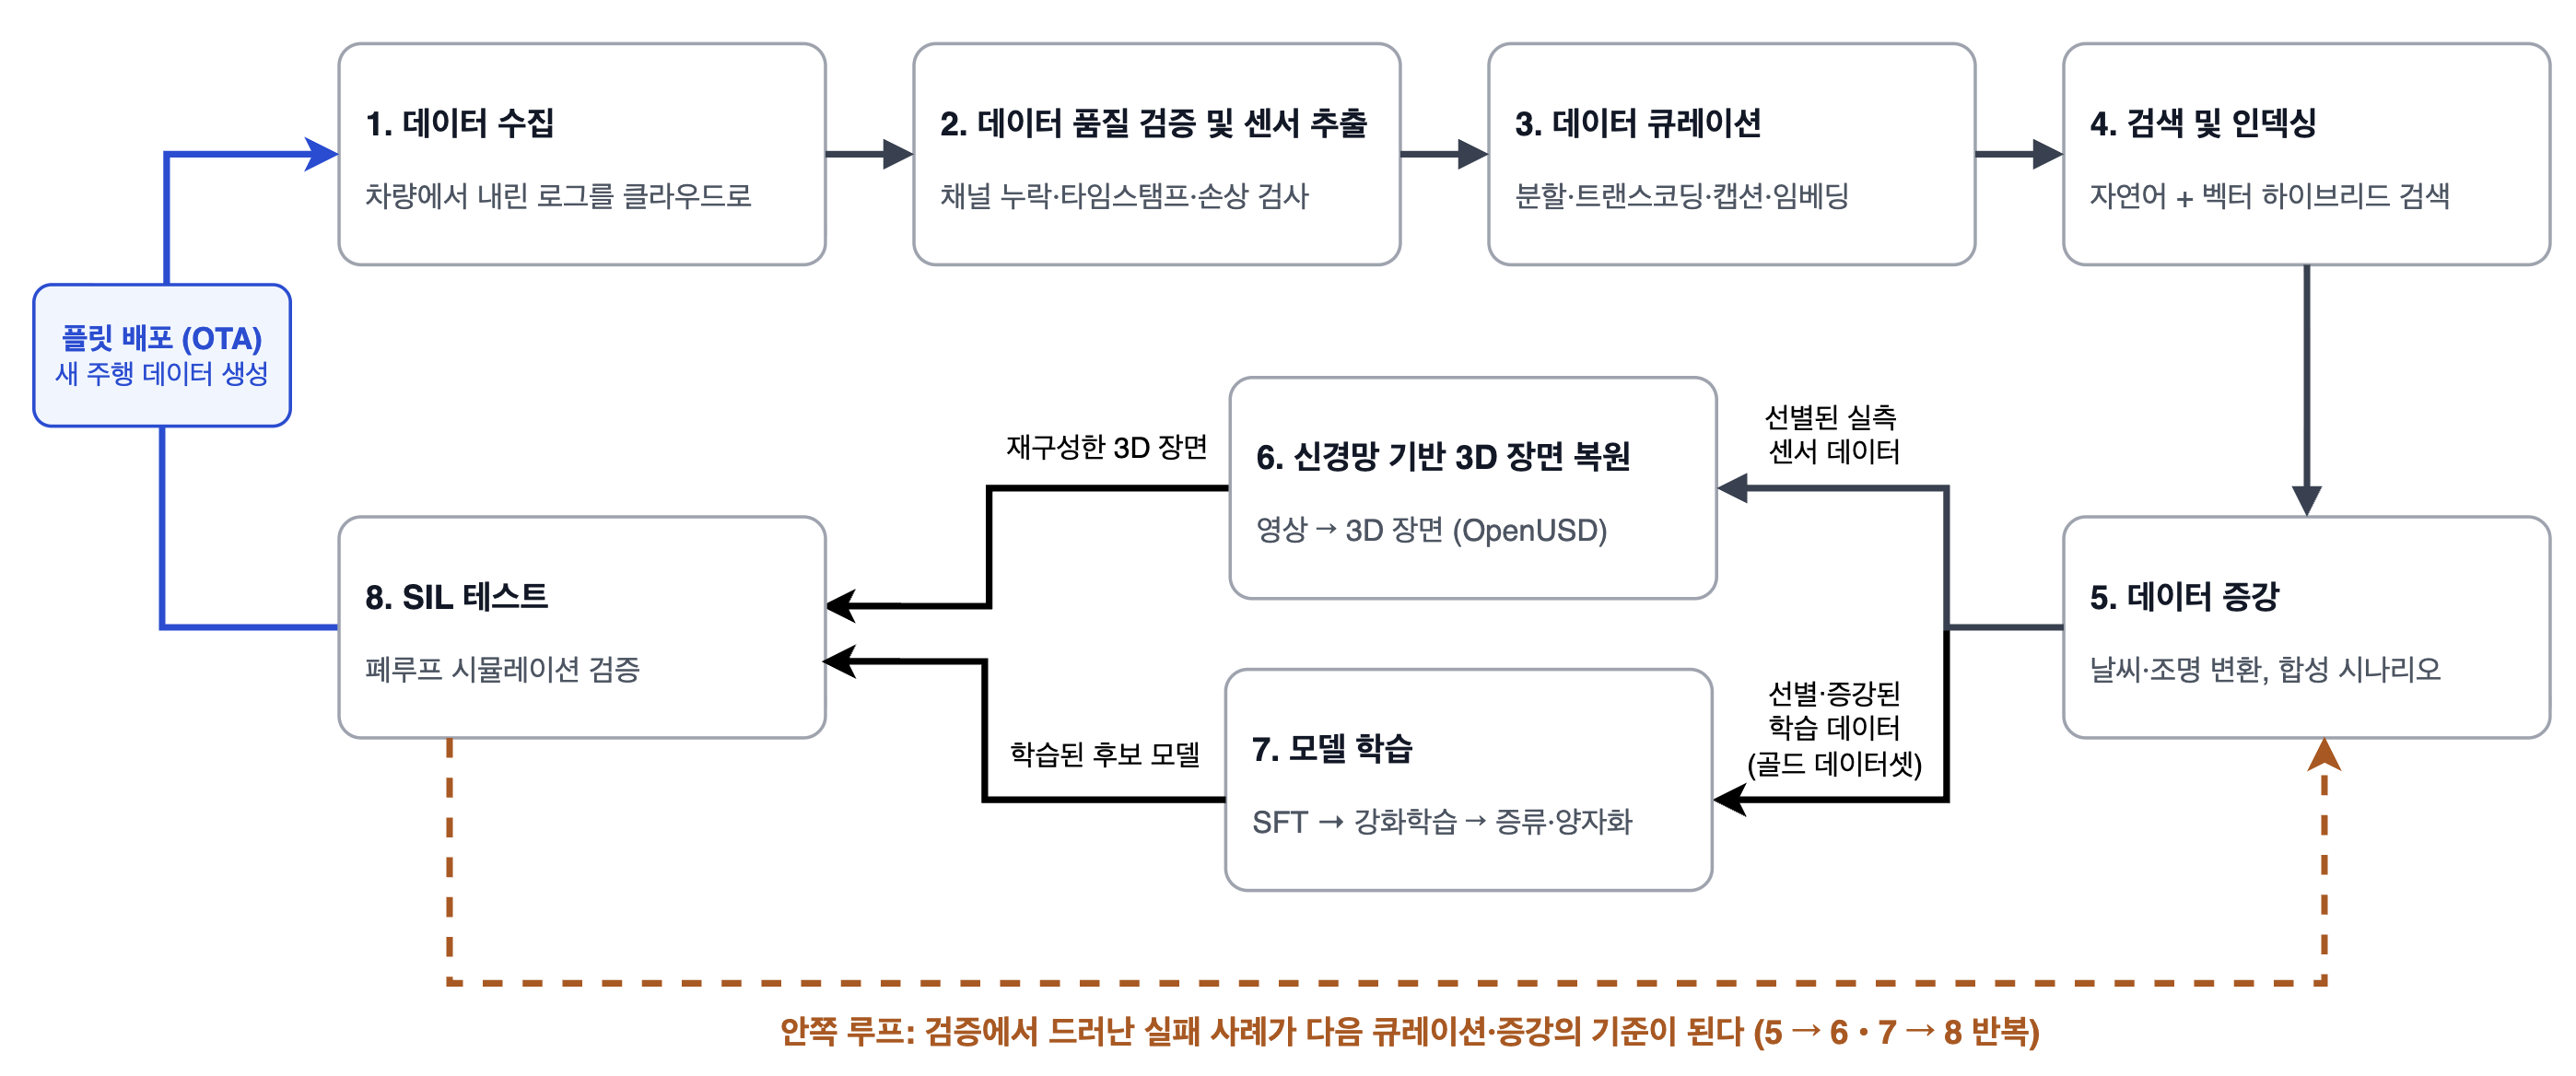
그림 1-4. 데이터 선택(5)에서 재구성(6)·학습(7)으로 분기하고 검증(8)에서 합류하는 안쪽 루프와, 차량 배포·재수집으로 연결되는 바깥 루프.
5단계에서 선별한 실측 센서 데이터는 6단계의 3D 장면 재구성에, 선별·증강한 학습 데이터는 7단계의 모델 학습에 사용합니다. 8단계에서는 재구성한 장면 안에서 후보 모델을 실행하고, 그 실패 사례를 다음 데이터 선택에 반영합니다. 이처럼 데이터 선택이 순환을 이끌기 때문에, 참고 블로그는 이를 “검색이 이끄는(retrieval-driven)” 개발 과정이라고 부릅니다. 추가 안전 검증과 배포 승인을 거친 모델이 차량에 적용되면, 운행 중 수집한 어려운 장면이 다시 1단계로 들어옵니다. 재구성한 장면을 학습에도 쓰려면 학습용 시뮬레이션 경로를 별도로 구성하면 됩니다.
반복 과정의 효과는 다음 세 범주의 지표로 평가할 수 있습니다.
| 지표 범주 | 측정 기준 |
|---|---|
| 사이클 시간·비용 | 데이터 선별부터 재학습·폐루프 평가까지의 시간과 비용 |
| 롱테일 적중률 | 검색한 클립 중 목표 실패 조건에 해당하는 비율 |
| 폐루프 성능 변화 | 동일한 평가 조건에서 사이클 전후의 충돌률 등 비교 |
예를 들어 Cosmos Transfer로 비 오는 장면을 생성해 재학습한 뒤, 같은 평가 조건에서 성능 변화를 확인할 수 있습니다. 이때 데이터 준비와 학습에 걸린 시간·비용을 함께 기록하면 다음 실험의 우선순위를 정하는 데 도움이 됩니다.
이 구성에서 NVIDIA의 모델·시뮬레이터를 실행하고 데이터를 연결하는 인프라에 AWS를 활용할 수 있습니다.
5. Why AWS: 파이프라인의 단계마다
AWS의 관리형 서비스는 단계별 병목을 해결하는 데 활용할 수 있습니다. NVIDIA 소프트웨어나 고객이 사용 중인 도구를 AWS 인프라와 조합하고, 입출력 규약을 유지하며 필요한 단ㅂ계부터 교체할 수 있습니다.
- 수집
자율주행 플릿은 차 한 대가 하루에 수 테라바이트에서 수십 테라바이트를 쏟아냅니다. 이를 차량에서 셀룰러망으로 바로 올리면, 5G 사용자 체감 업링크(약 50 Mbps) 기준으로 하루 540GB 남짓이 한계라 턱없이 부족합니다. 그래서 현장에서는 차량의 저장 장치를 테스트 거점(차고지나 테스트 센터)에서 분리해 유선으로 올리거나 물리적으로 반입합니다. 거점에 AWS Direct Connect 전용 회선이 있으면 서울 리전의 S3로 바로 올릴 수 있고, 네트워크로 전송할 만한 규모는 AWS DataSync가 맡습니다. 전용 회선이 없는 해외 테스트 플릿에는 AWS Data Transfer Terminal이 선택지이며, Rivian이 자율주행 데이터 수집을 이 방식으로 전환한 사례가 공개돼 있습니다. 다만 Data Transfer Terminal은 현재 Enterprise Support 고객만 이용할 수 있고, 시설도 미국·유럽·도쿄·시드니 등에 있을 뿐 국내에는 아직 없습니다(2026년 10월 기준). 과거 대용량 반입에 흔히 쓰이던 AWS Snowball Edge는 2025년 11월 7일부터 기존 고객 전용으로 전환됐으므로, 새 설계에서는 제외하는 것이 맞습니다.
> NOTE: AWS Data Transfer Terminal
AWS가 운영하는 물리적 데이터 반입 시설입니다. 예약 후 저장 장치를 들고 방문하면 고대역폭 연결로 S3에 직접 업로드합니다.
- 저장
장기 보관하는 주행 데이터에는 접근 빈도에 맞는 계층이 필요합니다. 참조 아키텍처는 Amazon S3 Intelligent-Tiering을 사용하고, 학습 중 고속 I/O가 필요하면 Amazon FSx for Lustre나 S3 Express One Zone을 함께 검토할 수 있습니다. S3를 공통 저장소로 두면 모든 단계가 같은 데이터와 산출물에 접근하게 됩니다.
> NOTE: Amazon S3와 스토리지 계층
S3는 데이터를 객체 단위로 저장합니다. 스토리지 계층은 접근 빈도와 필요한 검색 시간을 기준으로 고르며, Intelligent-Tiering은 접근 패턴에 따른 계층 이동을 자동화합니다. 접근 빈도가 낮은 계층이라고 모두 느린 것은 아닙니다.
- 처리와 학습
큐레이션(3단계)은 수천 시간의 영상을 GPU로 훑는 작업이라 클러스터가 필요합니다. 참고 블로그는 Amazon SageMaker HyperPod 위에 SLURM 스케줄러를 얹어 Cosmos Curator를 돌립니다. 반면 품질 검증·센서 추출(2단계)처럼 녹화 파일 하나하나가 독립적인 작업은 AWS Batch가 수천 개를 병렬로 처리합니다. 시뮬레이터와 시험 대상 시스템을 컨테이너로 나눠 함께 실행하는 Batch의 멀티컨테이너 작업은 자율주행 시뮬레이션을 겨냥해 설계된 기능으로, AWS는 국내 시뮬레이션 기업 MORAI를 사용 고객으로 소개했습니다. 학습(7단계)과 증강(5단계)에는 Blackwell 세대 인스턴스를 씁니다. GB200 기반 P6e UltraServer와 P6-B300이 제공되고, Cosmos Transfer가 요구하는 65GB급 GPU 메모리를 한 장으로 감당하는 G7e(RTX PRO 6000 Blackwell, 96GB)도 참고 블로그가 5단계 하드웨어로 지정합니다. G7e(2026년 3월)와 P6-B300(2026년 8월)은 서울 리전에도 들어와 있어, 데이터와 대규모 학습을 같은 리전에 둘 수 있습니다. HyperPod는 자동 노드 복구와 체크포인트 재시작으로 장시간 학습의 운영 부담을 덜어 줍니다.
> NOTE: GPU 인스턴스 이름과 메모리
AWS GPU 인스턴스는 P 계열을 대규모 학습에, G 계열을 그래픽·추론·중규모 학습에 주로 씁니다. GPU 한 장의 메모리에 모델이 다 들어가지 않으면 여러 장에 나눠야 하므로, 총메모리뿐 아니라 장당 메모리도 확인해야 합니다. HyperPod는 SLURM이나 Kubernetes(EKS) 기반으로 클러스터 작업을 관리합니다.
- 검색
큐레이션한 데이터에서 필요한 장면을 찾기 위해, 참고 블로그는 두 가지 검색 경로를 제시합니다. 하나는 Amazon OpenSearch Service의 하이브리드 검색(자연어 텍스트 + 벡터 유사도)에 NVIDIA cuVS 기반 GPU 가속을 더하는 경로이고, 다른 하나는 Amazon EKS 위에 Cosmos Dataset Search를 올리는 경로입니다. 어느 쪽이든 목적은 같습니다. “비 오는 날 비보호 좌회전” 같은 문장이나 “충돌할 뻔한 이 장면과 닮은 클립”이라는 예시로, 수백만 클립 중 몇백 개를 골라내는 것입니다. OpenSearch Service의 GPU 가속 벡터 색인 생성은 2025년 12월 정식 출시되어 AWS 발표 기준 색인이 최대 10배 빠르고 비용은 4분의 1이지만, 출시 당시 지원 리전에 서울이 빠져 있었으므로 배포 리전에서 확인하시기 바랍니다.
> NOTE: 벡터 검색
OpenSearch는 로그와 문서를 색인하고 검색하는 엔진이며, 벡터 검색(k-NN) 기능을 켜면 임베딩 벡터 사이의 거리로 “의미가 비슷한” 항목을 찾습니다. 서버 관리가 필요 없는 Serverless 옵션도 있습니다.
- 오케스트레이션과 거버넌스
반복 실행할 작업은 Amazon SageMaker Pipelines의 의존 관계 그래프(DAG)로 정의할 수 있습니다. 재구성과 학습의 분기, 검증에서의 합류를 표현하고 단계별 입출력 이력(리니지)을 기록하면, 재실행과 결과 추적이 쉬워집니다. - 생태계
NVIDIA 소프트웨어는 AWS 인프라·서비스와 연계해 쓸 수 있습니다. re:Invent 2024 발표 기준으로 NVIDIA DGX Cloud는 AWS Marketplace를 통해 제공되고, Omniverse와 Isaac Sim은 EC2 G6e 인스턴스에서 실행되며, Cosmos Reason은 NIM 마이크로서비스로 Marketplace에 등재돼 있습니다. 즉 OEM이 NVIDIA 툴체인을 선택했다고 해서 클라우드 선택이 묶이지 않으며, 자체 모델로 가는 OEM도 같은 인프라 위에서 Cosmos 같은 오픈 모델을 데이터 증강 도구로만 골라 쓸 수 있습니다.
정리하며
2부에서는 nuScenes 데이터로 실행하는 AV 3.0 Blueprint Lab을 소개합니다. 실행 결과를 통해 데이터 증강의 처리 시간과 출력 영상, Alpamayo의 예측 궤적, AlpaSim 평가 지표를 확인하고 고객 데이터로 확장할 구성을 살펴봅니다.
자사 환경에 맞는 채택 방식과 데이터 파이프라인 구성을 논의하려면 담당 AWS 어카운트 팀으로 연락 주십시오.
참고자료
- 참고 블로그: Building an End-to-End Physical AI Data Pipeline for Autonomous Vehicle 3.0 on AWS with NVIDIA (AWS Industries Blog, 2026-03-16) · 한국어 번역 (AWS 기술 블로그, 2026-03-31)
- NVIDIA: Alpamayo 모델 계열 소개 · Alpamayo 1.5 모델 카드 (Hugging Face) · Three Computers for Physical AI
- AV 3.0 Blueprint Lab 저장소 — 2부에서 다루는 실습 환경