O blog da AWS
Como o Santander está transformando a investigação de fraudes financeiras com Amazon Neptune
Por Rogerio Santos, Arquiteto de Dados no Santander, e Emerson Vargas, Arquiteto de Soluções na AWS.
Em um estudo controlado conduzido pela área de Segurança Corporativa do Santander, o uso do Amazon Neptune, serviço gerenciado de banco de dados de grafos da AWS, reduziu em 80% o tempo da fase de análise investigativa de fraudes financeiras. Este artigo apresenta a motivação, a arquitetura de referência, o modelo de grafo adotado, os três pilares da validação e os próximos passos da jornada.
O cenário de fraudes financeiras no Brasil é desafiador. Segundo a Serasa Experian [1], o país registrou mais de 11,5 milhões de tentativas de fraude em 2024, aproximadamente uma a cada 2,74 segundos. Globalmente, a INTERPOL reportou crescimento de 30% nas fraudes financeiras, impulsionado pelo uso de inteligência artificial por organizações criminosas [2].
Esquemas complexos operam por meio de redes de relacionamentos indiretos entre pessoas, contas, empresas e dispositivos. Investigá-los com análise tabular e correlação manual entre sistemas exige muito tempo do analista para mapear conexões, validar hipóteses e identificar os atores centrais.
O desafio: fraudes que operam em rede
Fraudes sofisticadas raramente se limitam a uma conta ou cadeia de transações. Elas se manifestam em redes que combinam pessoas físicas e jurídicas, contas, dispositivos e movimentações com relacionamentos indiretos, por meio de técnicas como layering e structuring.
Layering (estratificação) — múltiplas movimentações em camadas para distanciar os recursos de sua origem ilícita. Exemplo: transferir da conta A para B, de B para uma empresa de fachada C e de C para uma conta no exterior D.
Structuring (fracionamento), também chamado de smurfing — divisão de um valor alto em várias transações menores para não atingir os limites que disparam alertas. Exemplo: em vez de transferir R$ 50 mil de uma vez, o fraudador faz dezenas de transferências em dias diferentes.
No processo convencional, cada caso complexo demandava dezenas de horas de um analista, com lead time (tempo total de resolução) longo e profundidade limitada pelas ferramentas tabulares, sem exploração multi-hop (múltiplos saltos) nem descoberta de vínculos indiretos. A análise do processo mostrou que 61% do tempo se concentrava na análise e correlação de dados e 30% na preparação de informações; a entrada do caso respondia por 1% e a confirmação final, por 8%.
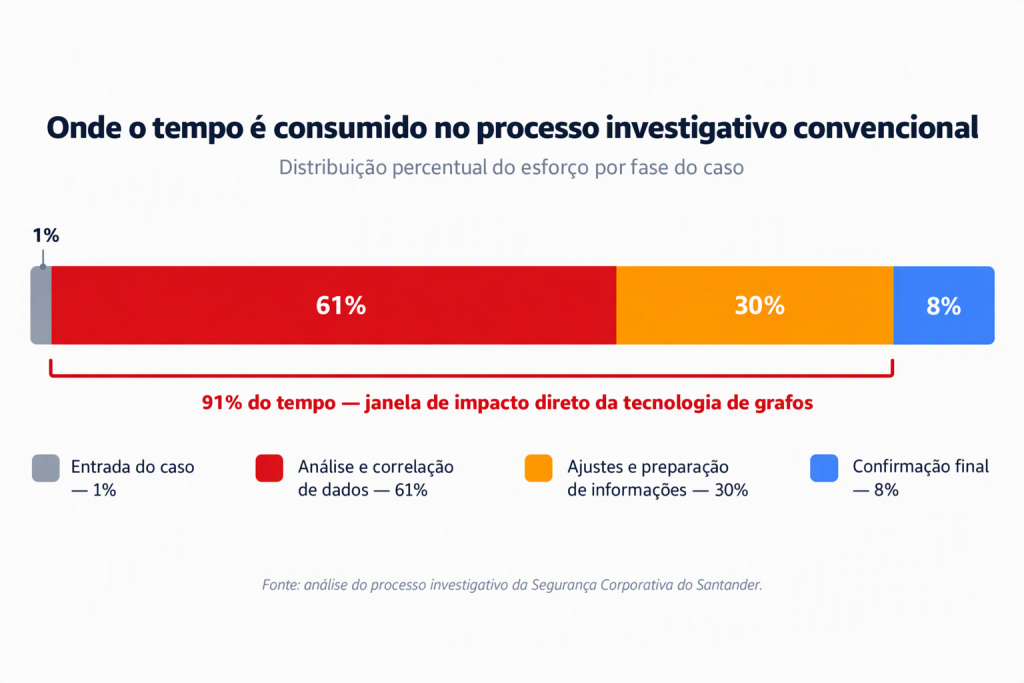
Figura 1 — Distribuição do tempo no processo investigativo convencional. Preparação e análise concentram 91% do esforço.
A abordagem de grafos para investigação de fraudes
Em vez de armazenar dados em tabelas e depender de joins complexos, bancos de dados de grafos modelam entidades como vértices e relacionamentos como arestas. Assim, uma única consulta percorre múltiplos níveis de separação e revela, por exemplo, que uma conta suspeita está ligada a uma empresa de fachada que recebe transferências de contas de passagem vinculadas a um mesmo dispositivo, algo que exigiria dezenas de consultas manuais no modelo tabular.
Na prevenção a fraudes e à lavagem de dinheiro, grafos oferecem três vantagens. A primeira é revelar relações ocultas: vínculos indiretos, como endereço, dispositivo ou beneficiário final compartilhados, emergem da travessia do grafo. A segunda é detectar padrões estruturais: esquemas como funnel accounts (afunilamento), fan-out (dispersão) e cycling (circularidade) são topologias fáceis de identificar em grafos e custosas em análises tabulares. A terceira é o contexto temporal: arestas com atributos de tempo e valor revelam sequências de movimentações típicas de structuring.
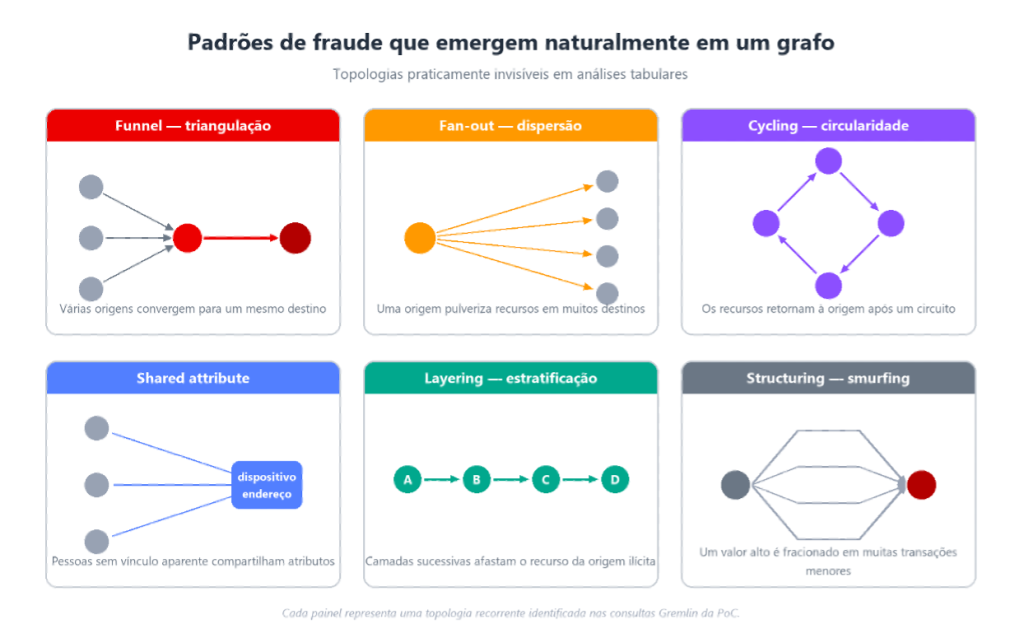
Figura 2 — Padrões estruturais de fraude expressos como topologias de grafo: funnel, fan-out, cycling, shared attribute, layering e structuring.
Um estudo publicado na Scientific Reports [3] indica que abordagens baseadas em grafos podem reduzir falsos positivos entre 40% e 60% e identificar redes organizadas (fraud rings) que modelos tabulares detectam de forma indireta e limitada. No Brasil, onde o PIX ampliou o volume e a velocidade das transações, essa capacidade é especialmente relevante.
Por que Amazon Neptune
A escolha do Amazon Neptune considerou o contexto corporativo e a maturidade do uso da AWS no Santander. Por ser totalmente gerenciado, o serviço elimina tarefas como aplicação de patches e gerenciamento de infraestrutura; na opção serverless, a capacidade também se ajusta automaticamente à demanda. O Amazon Neptune integra-se nativamente ao Amazon Simple Storage Service (Amazon S3), ao AWS Identity and Access Management (IAM), ao AWS Key Management Service (AWS KMS), ao Amazon CloudWatch e à Amazon Virtual Private Cloud (Amazon VPC) [4]. Além disso, o Santander configura as roles do IAM, as sub-redes e os grupos de segurança.
Para uma instituição financeira regulada, os controles de segurança nativos foram determinantes: criptografia em repouso e em trânsito, controle de acesso granular com o IAM e isolamento de rede com a Amazon VPC apoiam o atendimento aos requisitos regulatórios, dentro do modelo de responsabilidade compartilhada da AWS. Como a criptografia em repouso com o AWS KMS é definida na criação do cluster, a organização deve exigi-la por meio de políticas do IAM ou de políticas de controle de serviço (SCPs) do AWS Organizations. Completam o cenário a alta disponibilidade com replicação em múltiplas Availability Zones, o modelo pay-as-you-go e o suporte a Gremlin, openCypher e SPARQL, entretanto o estudo usou somente Gremlin.
Como a arquitetura já nasce no ecossistema em que o Santander opera, a escolha simplifica a integração e os processos de compliance e acelera o caminho até a produção.
Arquitetura da solução
A arquitetura a seguir é o desenho-alvo do ambiente produtivo. O Santander a definiu desde o início para que o estudo já nascesse alinhado à pilha final.
O fluxo começa nas fontes corporativas: transações e cadastros de clientes consolidados no data lake, dados de geolocalização e transações do aplicativo bancário. A camada de ingestão mapeia, normaliza e enriquece esses dados no formato de vértices e arestas, em dois regimes: lote e fluxo contínuo.
Em lote, o AWS Glue grava arquivos CSV de vértices e arestas em uma área de staging no Amazon S3, e o bulk loader do Amazon Neptune os carrega no grafo. Como o cluster fica em uma VPC privada, um gateway endpoint da Amazon VPC para o Amazon S3 mantém essa leitura fora da internet.
Em fluxo contínuo, funções do AWS Lambda consomem eventos do Amazon Kinesis Data Streams e do Amazon Managed Streaming for Apache Kafka (Amazon MSK) por meio de event source mappings. As funções convertem cada evento em vértices e arestas e os gravam com consultas Gremlin idempotentes, como mergeV() e mergeE(), o que evita duplicidades em reprocessamentos. As funções executam na mesma VPC privada do cluster.
Nesta fase, duas ferramentas consomem o grafo:
- Amazon Neptune notebook: ambiente Jupyter baseado no Amazon SageMaker AI, provisionado na VPC do cluster e integrado ao Amazon Neptune pela biblioteca graph-notebook. Nele, analistas e cientistas de dados executam consultas Gremlin e análises exploratórias.
- Graph Explorer: ferramenta open source da AWS para explorar grafos visualmente, sem escrever código: buscar vértices, expandir vizinhanças e filtrar por rótulos e propriedades. Como a ferramenta exige acesso à VPC privada, é possível implantá-la como contêiner no Amazon Elastic Container Service (Amazon ECS) ou em uma instância de notebook do Amazon SageMaker AI com acesso à VPC [5].
Com essas ferramentas, os analistas podem gerar evidências estruturadas para a decisão de fraude. Na arquitetura-alvo, o motor preditivo no Amazon SageMaker AI e o serviço de aplicação no AWS Lambda também consomem o grafo.
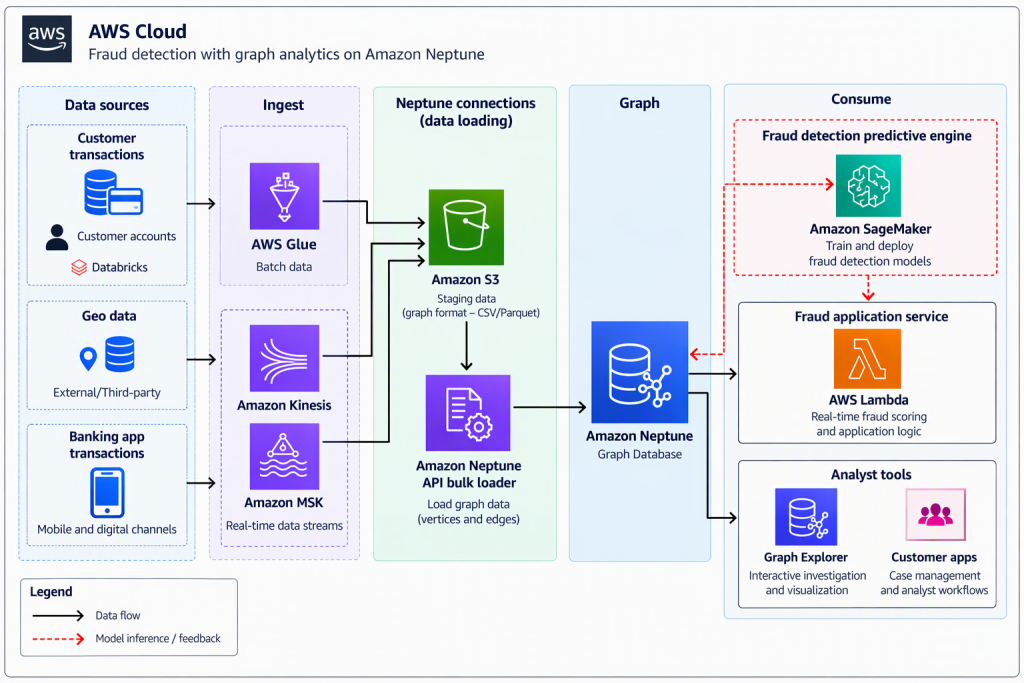
Figura 3 — Arquitetura de produção de referência na AWS para investigação de fraudes com Amazon Neptune.
No estudo, o Santander implementou parte dessa arquitetura: o Databricks gerou os CSV de vértices e arestas a partir do data lake e os gravou no Amazon S3, de onde o bulk loader fez a carga. A exploração ocorreu no Amazon Neptune notebook e no Graph Explorer. A ingestão em fluxo contínuo permanece como alvo da arquitetura de referência.
Formato dos arquivos de carga (bulk loader)
Os exemplos a seguir mostram o formato CSV usado no estudo.
| ~id | ~label | penumper:String | cpf_cnpj:String | nome:String | tipo:String |
|---|---|---|---|---|---|
| PESSOA-EXEMPLO-001 | Pessoa | PESSOA-EXEMPLO-001 | DOC-EXEMPLO-001 | NOME-EXEMPLO-001 | F |
| PESSOA-EXEMPLO-002 | Pessoa | PESSOA-EXEMPLO-002 | DOC-EXEMPLO-002 | NOME-EXEMPLO-002 | F |
| ~id | ~label | banco:String | agencia:String | conta:String |
|---|---|---|---|---|
| CONTA-EXEMPLO-001 | Conta | BANCO-EXEMPLO-001 | AGENCIA-EXEMPLO-001 | CONTA-EXEMPLO-001 |
| CONTA-EXEMPLO-002 | Conta | BANCO-EXEMPLO-002 | AGENCIA-EXEMPLO-002 | CONTA-EXEMPLO-002 |
| ~id | ~from | ~to | ~label |
|---|---|---|---|
| PESSOA-EXEMPLO-001_CONTA-EXEMPLO-001 | PESSOA-EXEMPLO-001 | CONTA-EXEMPLO-001 | pertence_a |
| PESSOA-EXEMPLO-002_CONTA-EXEMPLO-002 | PESSOA-EXEMPLO-002 | CONTA-EXEMPLO-002 | pertence_a |
| ~id | ~from | ~to | ~label | valor:Double | data:Date |
|---|---|---|---|---|---|
| TRX-EXEMPLO-0000000001 | CONTA-EXEMPLO-001 | CONTA-EXEMPLO-002 | transacao | 350.20 | 2023-11-24T09:12:45 |
| TRX-EXEMPLO-0000000002 | CONTA-EXEMPLO-001 | CONTA-EXEMPLO-002 | transacao | 120.00 | 2023-11-24T16:40:03 |
Nas arestas de transação, o ~id usa o identificador único da transação no sistema de origem. Um ~id composto apenas pelas contas e pela data, como CONTA-EXEMPLO-001_CONTA-EXEMPLO-002_20231124, se repetiria sempre que as mesmas contas transacionassem mais de uma vez no mesmo dia, como nas duas linhas do exemplo. Nesse caso, o Amazon Neptune trataria transações distintas como uma única aresta, e o grafo perderia justamente os padrões de recorrência que interessam à investigação. Com um identificador estável vindo da origem, cada transação gera uma aresta própria, e reprocessamentos — seja pelo bulk loader, seja por mergeE() no fluxo contínuo — atualizam a mesma aresta em vez de criar duplicidades.
Quando o sistema de origem não fornecer esse identificador, o ~id pode ser composto com as contas de origem e destino, o timestamp completo e um sequencial, por exemplo CONTA-EXEMPLO-001_CONTA-EXEMPLO-002_20231124T091245_0001. O sequencial diferencia transações registradas no mesmo segundo e mantém o ~id determinístico entre cargas.
Modelo de grafo
O modelo-alvo representa o ecossistema investigativo de fraude financeira. Os vértices representam:
- pessoas físicas: indivíduos sob análise;
- pessoas jurídicas: empresas e seu quadro societário;
- contas: uma propriedade do vértice define o tipo (corrente, poupança, pagamento, entre outros);
- dispositivos: usados em operações digitais, com fingerprinting;
- endereços: atributos cadastrais que podem ser compartilhados;
- alertas: eventos gerados pelo monitoramento transacional.
As arestas representam:
- transações financeiras: Transferência Eletrônica Disponível (TED), PIX e outras modalidades, com atributos de valor e data/hora;
- titularidade: relação de propriedade entre uma conta e uma pessoa (física ou jurídica);
- vínculos societários: relação jurídica entre pessoa física e pessoa jurídica.
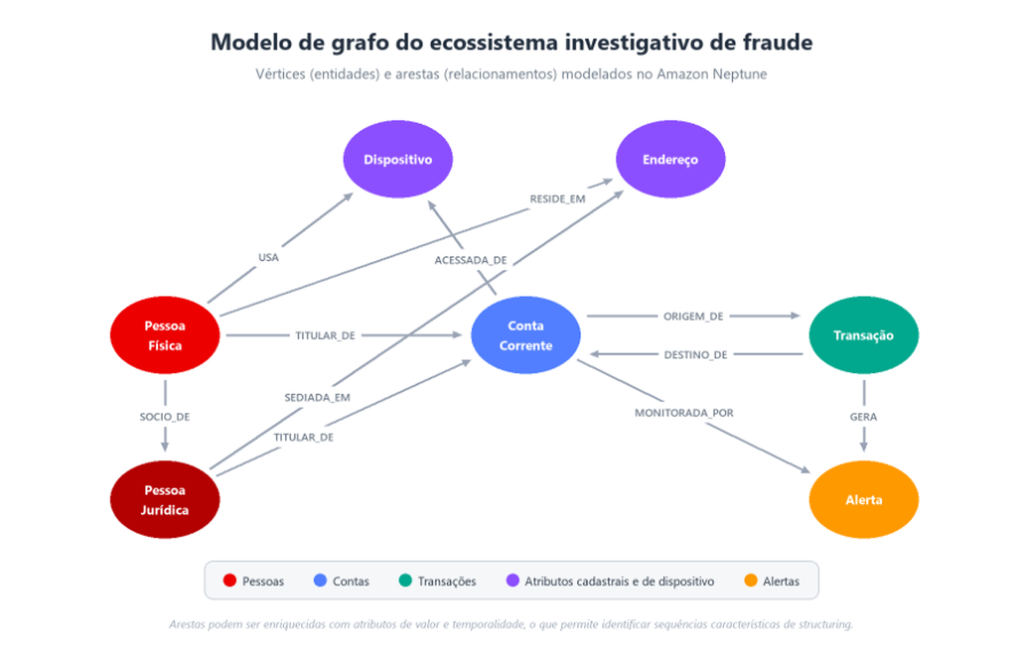
Figura 4 — Modelo de grafo do ecossistema investigativo.
O trabalho do analista segue um fluxo padronizado: o caso chega pelo monitoramento transacional, o analista escolhe as entidades-semente, percorre o grafo com Gremlin no Amazon Neptune notebook e explora a rede no Graph Explorer. As evidências embasam a decisão, que pode gerar novas hipóteses.
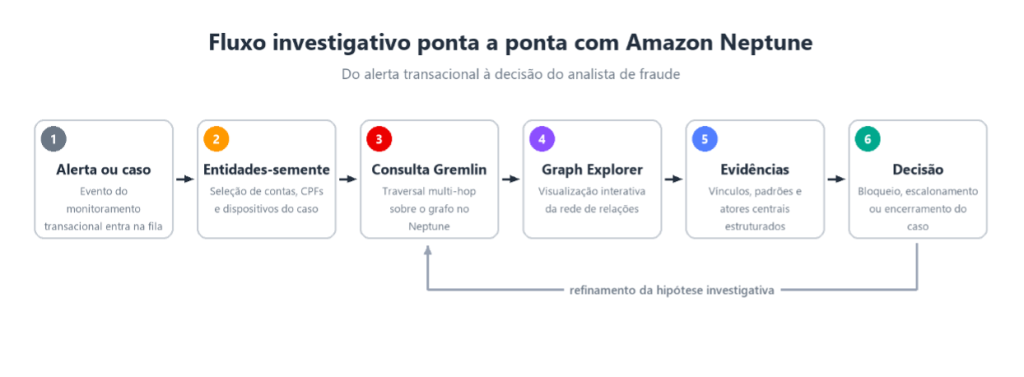
Figura 5 — Fluxo investigativo ponta a ponta, do alerta à decisão do analista, com realimentação da hipótese.
Execução: validação estruturada em três pilares
O Santander organizou a validação em três pilares, cada um com uma métrica de sucesso definida antes da execução:
- Eficácia investigativa: validar, no grafo, hipóteses investigativas que envolvem conexões indiretas e travessias multi-hop, difíceis de explorar no processo convencional.
- Eficiência operacional: reduzir o tempo de análise de um caso complexo em relação ao processo convencional.
- Viabilidade técnica: executar o ciclo completo, da carga à visualização interativa, com um volume de dados representativo do ambiente real.
Durante o estudo, foram atendidos todos os requisitos de isolamento de infraestrutura: o cluster do Amazon Neptune ficou em uma Amazon VPC privada, com acesso restrito por meio de políticas do AWS IAM e com proteção dos dados por criptografia em repouso via AWS KMS, em conformidade com as políticas internas de segurança e privacidade do Santander e com a Lei Geral de Proteção de Dados (LGPD).
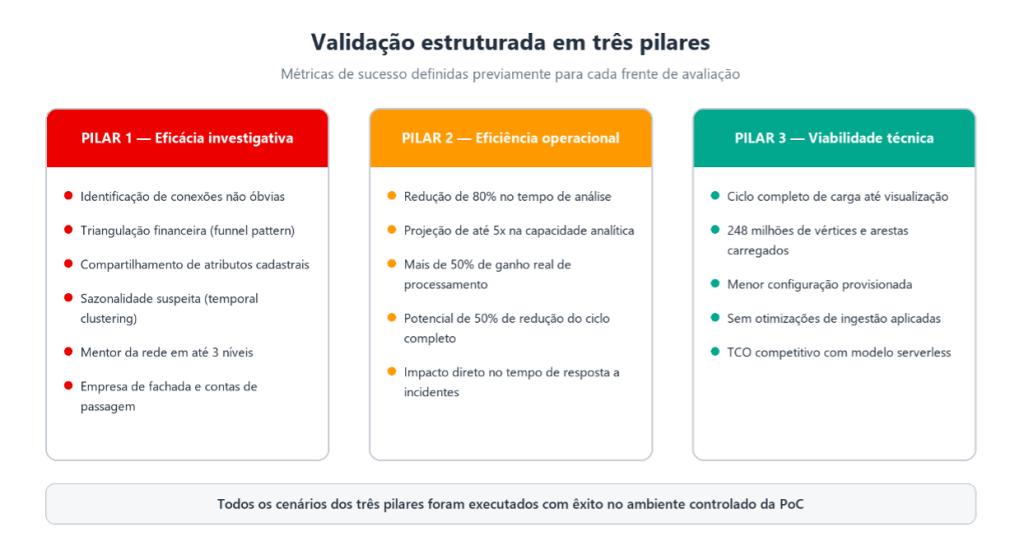
Figura 6 — Estrutura da validação em três pilares e respectivas métricas de sucesso.
Pilar 1 — Eficácia investigativa
O primeiro pilar avaliou se a análise em grafos aprimora as investigações. Para identificar conexões não óbvias, o Santander executou duas consultas sobre o grafo carregado: convergência financeira (funnel pattern), que encontrou pessoas distintas recebendo de uma mesma origem e repassando a um mesmo destino; e sazonalidade suspeita (temporal clustering), que revelou contas interconectadas com padrões temporais anômalos. A consulta de compartilhamento de atributos cadastrais (shared attribute pattern), que detecta indivíduos sem relação direta com endereço, telefone ou dispositivo em comum, depende de vértices ainda não carregados e está prevista para a próxima fase (veja Resultados e próximos passos).
Para validar hipóteses complexas, o Santander reproduziu investigações com base em casos históricos reais, todas concluídas com êxito: identificação do mentor da rede, o indivíduo conectado, em até três níveis de separação, ao maior número de fraudadores confirmados, mesmo sem participar diretamente das transações; detecção de empresas de fachada (shell company detection), pessoas jurídicas com alto volume de recebimentos de pessoas físicas e sem atividade de saída compatível; e mapeamento de contas de passagem (mule account detection), contas recentes com depósitos de múltiplas origens e transferências rápidas para um destino único.
O trecho a seguir expressa a hipótese de contas de passagem em Gremlin, no modelo do estudo, em que as transações são arestas entre contas. Rótulos e limiares são ilustrativos. A consulta filtra as contas pela data de abertura para restringir a análise a contas recentes, mas, para manter a legibilidade, não aplica janela de tempo às transações.
A consulta retorna as 20 contas com maior valor recebido que atendem ao padrão, para priorizar a análise do investigador. Escrita a partir de g.V().hasLabel('Conta'), ela percorre todos os vértices de conta para aplicar os filtros, o que é custoso em um grafo com dezenas de milhões de contas. No uso investigativo, o analista parte das entidades-semente do alerta, por exemplo com g.V(ids) e as contas envolvidas, e aplica o mesmo padrão à vizinhança delas. Varreduras globais do grafo são mais adequadas ao Amazon Neptune Analytics, descrito em Resultados e próximos passos.
Pilar 2 — Eficiência operacional
O segundo pilar mediu o impacto na produtividade dos analistas. O Santander selecionou um caso complexo já investigado pelo processo convencional, com o tempo de cada fase registrado, e o reanalisou com o Amazon Neptune, cronometrando as mesmas fases. Para reduzir o viés, nenhum profissional da análise original participou da reanálise no estudo.
Um processo investigativo tem quatro fases, cada uma com uma parte do esforço total:
| Fase | % do esforço total |
|---|---|
| Entrada (registro) do caso | 1% |
| Análise e correlação de dados | 61% |
| Ajustes e preparação de informações | 30% |
| Confirmação final | 8% |
O Amazon Neptune atua na fase de análise e correlação de dados, a mais demorada do processo. No estudo, o tempo dessa fase caiu 80%. Os valores absolutos não são divulgados em razão das políticas internas de confidencialidade do Santander.
Com base nesse resultado, o Santander estimou o efeito no processo completo:
- Na fase de análise: com o tempo reduzido a um quinto, a capacidade do analista nessa etapa aumenta até 5x.
- No processo completo: como a análise representa 61% do esforço, a redução de 80% nessa fase diminui o tempo total por caso em cerca de 49% (61% × 80% = 48,8%). Por exemplo, um caso que levava 40 horas passaria a levar cerca de 20,5 horas.
Esses valores para o processo completo são projeções calculadas a partir da redução medida no estudo. Eles não foram medidos diretamente.
Pilar 3 — Viabilidade técnica
O terceiro pilar validou a viabilidade técnica da solução no volume-alvo. O Santander executou o ciclo completo, da carga à visualização interativa, com 23 milhões de vértices de pessoas, 26 milhões de vértices de contas, 26 milhões de arestas pessoa-conta e 173 milhões de arestas de transações: cerca de 248 milhões de elementos (49 milhões de vértices e 199 milhões de arestas). O bulk loader concluiu a carga em cerca de 3 horas, sem otimizações de ingestão.
Os resultados foram obtidos em uma instância db.t3.medium, escolhida pelo custo durante o estudo. A AWS não recomenda instâncias burstable para cargas de produção; para esse ambiente, a recomendação é usar classes otimizadas para memória, como db.r6g ou db.r7g, ou o Amazon Neptune Serverless. O fato de o ciclo completo ter sido executado nessa configuração, sem otimizações, indica margem de melhoria em produção.
Com base nesse cenário, o Santander projetou o custo total de propriedade (TCO) para o Amazon Neptune Serverless, que escala conforme a demanda de consultas dos analistas. A projeção será confirmada com os dados de uso do ambiente de produção.
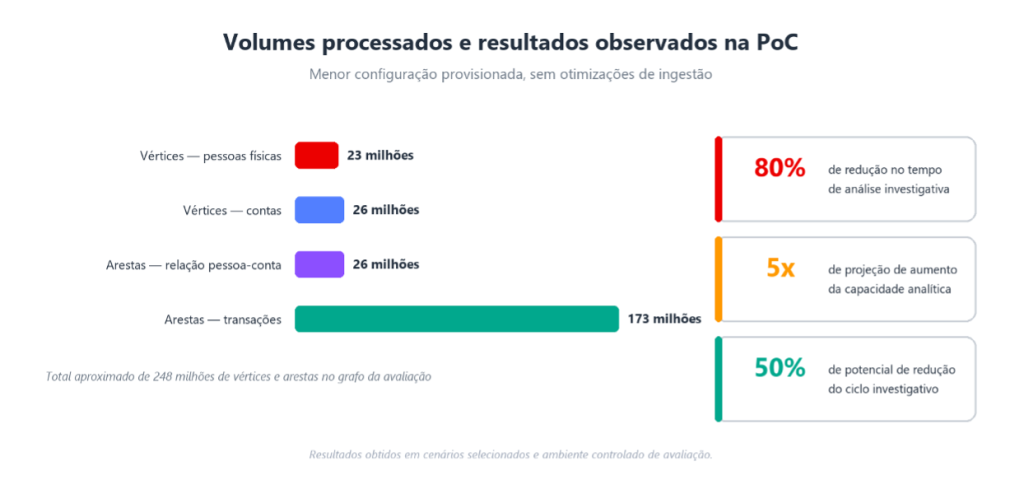
Figura 7 — Volumes carregados no grafo e resultados observados na avaliação.
Lições aprendidas
Três decisões tomadas durante o estudo merecem registro para quem for construir uma solução semelhante:
- Identificador da aresta de transação: um
~idcomposto apenas pelas contas e pela data colapsa transações distintas em uma única aresta e apaga os padrões de recorrência. Usar o identificador do sistema de origem, ou compor o~idcom timestamp completo e sequencial, resolve o problema e mantém a carga idempotente. - Transações como arestas: representar cada transação como uma aresta entre contas, com valor e data como propriedades, manteve o modelo simples, acelerou a carga e permitiu expressar os padrões temporais diretamente nas travessias.
- Classe de instância: durante o estudo a instância burstable atendeu com baixo custo, mas o dimensionamento para produção precisa ser feito em classes otimizadas para memória ou no Amazon Neptune Serverless.
Resultados e próximos passos
Os resultados vêm de cenários investigativos selecionados para validar a abordagem em ambiente controlado e devem ser interpretados nesse contexto. Com base neles, o Santander está expandindo o modelo de dados para todos os cenários, incorporando novas fontes e preparando a integração com os workflows dos analistas. O roadmap parte do estudo concluído e evolui em quatro frentes:
- Ingestão automatizada: pipelines alimentam o grafo continuamente com transações PIX, TED e outras modalidades a partir do data lake corporativo, transformando a solução em um motor de análise contínua.
- Detecção de comunidades com o Amazon Neptune Analytics: algoritmos nativos como Louvain e label propagation identificam clusters de entidades que operam de forma coordenada, acelerando o mapeamento de redes organizadas.
- Detecção proativa com o Amazon Neptune ML (Neptune ML): o Neptune ML treina redes neurais de grafos (GNNs) no Amazon SageMaker AI para classificação e regressão de nós e de arestas e para link prediction. Como a detecção de anomalias não é uma tarefa nativa, o Santander planeja derivá-la dessas tarefas: a classificação de nós, treinada com casos de fraude confirmados, atribui a contas e entidades uma probabilidade de pertencer à classe suspeita; a classificação de arestas aplica o mesmo princípio às relações; e o link prediction antecipa conexões entre membros de uma rede antes que os sistemas tradicionais gerem alertas. Os embeddings do treinamento também podem alimentar modelos customizados no Amazon SageMaker AI.
- GraphRAG com o Amazon Bedrock: analistas fazem perguntas em linguagem natural, como “quem são os intermediários entre a conta X e a empresa Y?”, sem conhecer linguagens de consulta. O Santander avalia duas abordagens: o GraphRAG gerenciado das Amazon Bedrock Knowledge Bases, que usa o Amazon Neptune Analytics com openCypher, e um agente customizado que traduz as perguntas em consultas Gremlin no Amazon Neptune Database, onde o grafo de investigação reside hoje.
Para garantir a confiabilidade e a segurança das respostas, o Santander prevê três controles:
- Amazon Bedrock Guardrails: filtram entradas e saídas do modelo, bloqueiam tópicos fora do escopo investigativo e ajudam a proteger informações sensíveis.
- Consultas somente leitura: permissões do IAM restritas à leitura impedem que consultas geradas pelo modelo alterem ou excluam dados.
- Revisão humana: os analistas validam as evidências geradas pelo agente antes de qualquer decisão; a responsabilidade pela conclusão de cada caso permanece com o Santander.
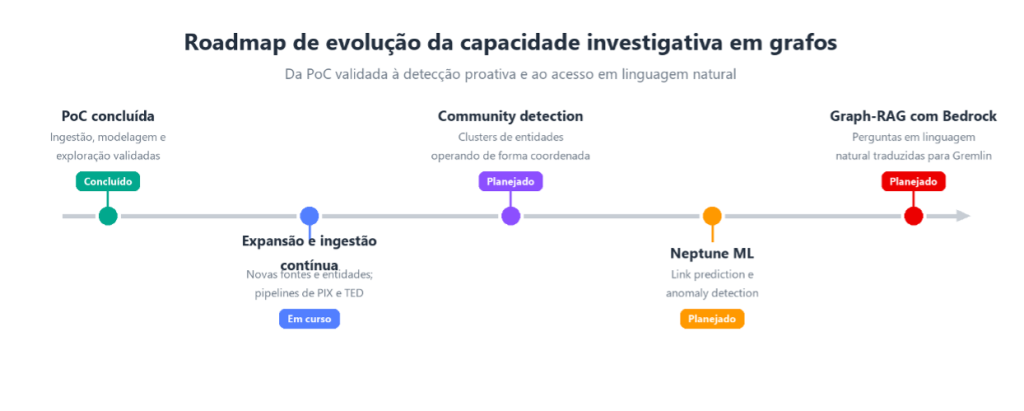
Figura 8 — Roadmap de evolução, do estudo concluído à detecção proativa com Neptune ML e ao acesso em linguagem natural via GraphRAG com Amazon Bedrock.
Conclusão
Bancos de dados de grafos mudam a forma de investigar fraudes financeiras: em vez de ficarem restritos a relações diretas e consultas predefinidas, os investigadores exploram conexões de forma interativa, identificam padrões emergentes e validam hipóteses complexas. Como serviço totalmente gerenciado, o Amazon Neptune reduz o esforço operacional e permite que as equipes de segurança corporativa se concentrem em investigar redes de fraude com mais rapidez e profundidade.
Os resultados do estudo permitiram ao Santander estruturar um roadmap para ampliar as frentes de investigação e detecção de fraudes e avançar para a fase de produção.
Para começar a explorar bancos de dados de grafos em seu próprio ambiente, consulte a documentação do Amazon Neptune, o guia do Amazon Neptune Analytics e o repositório aws/graph-explorer no GitHub. Fale também com a sua equipe de conta da AWS para discutir cenários aplicáveis ao seu negócio.
Referências
[1] Serasa Experian — “Relatório de Identidade e Fraude 2025” (dados referentes ao ano de 2024). Disponível em: https://www.serasaexperian.com.br/conteudos/relatorio-de-identidade-digital-e-fraude-2025/. Acesso em: 6 de julho de 2026.
[2] INTERPOL — “Global Financial Fraud Assessment 2024” (Avaliação Global de Fraudes Financeiras 2024). PDF Disponível em: Global Financial Fraud Assessment Public Version 2024 – arquivo PDF. Acesso em: 6 de julho de 2026.
[3] Scientific Reports — “Reinforcement learning with graph neural network (RL-GNN) fusion for real-time financial fraud detection: a context-aware community mining approach” (Fusão de aprendizado por reforço com redes neurais em grafos (RL-GNN) para detecção de fraudes financeiras em tempo real: uma abordagem de mineração de comunidades sensível ao contexto), dezembro de 2025. Disponível em: https://www.nature.com/articles/s41598-025-25200-3. Acesso em: 6 de julho de 2026.
[4] Amazon Web Services — “Amazon Neptune User Guide” (Guia do usuário do Amazon Neptune). Disponível em: https://docs.aws.amazon.com/neptune/latest/userguide/intro.html. Acesso em: 6 de julho de 2026.
[5] Amazon Web Services — “Graph Explorer” (repositório aws/graph-explorer no GitHub). Disponível em: https://github.com/aws/graph-explorer. Acesso em: 6 de julho de 2026.
Sobre os autores
 |
Rogerio Santos é Arquiteto de Plataforma de Dados no Santander Brasil e integra a área de Arquitetura de Dados da F1rst Digital Services. Atua na definição e evolução de arquiteturas de referência para plataformas e soluções de dados adotadas pelos times do Santander no Brasil e em outros países. |
 |
Emerson Vargas é Arquiteto de Soluções na AWS, especializado no setor de serviços financeiros (FSI). Na AWS desde 2021, acumula cinco anos de experiência como Technical Account Manager no AWS Enterprise Support. Atualmente, apoia instituições financeiras na identificação de oportunidades estratégicas, como o uso de bancos de dados de grafos para investigação de fraudes, acelerando a adoção de tecnologias que geram resultados concretos de negócio. |