Le Blog Amazon Web Services
Décliner une campagne marketing en visuels avec un agent IA
Décliner une campagne en dizaines de visuels, c’est un travail qu’un agent IA peut confier à ComfyUI, un moteur open source de génération d’images. Une équipe marketing publie la même annonce sous de nombreuses formes. Il lui faut un format vertical et un format paysage, puis une version par langue, par marché et par audience. Chaque déclinaison demande son propre visuel, et la campagne doit garder une seule direction créative.
Des assistants créatifs, des assistants de production vidéo et des copilotes de design savent produire ces déclinaisons. Ils ont besoin de contrôler chaque image : quel modèle, quel prompt, quelle graine (la valeur qui rend un rendu reproductible) et combien de variantes. Ils ont aussi besoin d’un moteur de génération qui tienne la charge d’une campagne, pas d’une démonstration.
Cet article décrit l’architecture que nous avons construite sur AWS pour donner à ces agents un accès contrôlé à ComfyUI. Il présente l’architecture et ses choix, sans fournir de code.
ComfyUI et MCP
ComfyUI est le moteur open source qui exécute des modèles de génération d’images comme FLUX, Qwen-Image ou Stable Diffusion. Un workflow ComfyUI est un graphe de nœuds : charger un modèle, encoder le prompt, échantillonner, décoder, enregistrer. Cette granularité donne à l’utilisateur un contrôle complet sur chaque étape du rendu.
Le Model Context Protocol (MCP) est le protocole ouvert qu’un agent utilise pour découvrir et appeler des outils. Un serveur MCP placé devant ComfyUI permet donc à un agent de piloter le moteur.
Le problème
Des clients AWS du secteur média et publicité veulent qu’un agent pilote ComfyUI pour produire ces déclinaisons, avec trois exigences. Les modèles et les images restent dans leur compte AWS. L’accès passe par AWS Identity and Access Management (IAM). La consommation GPU apparaît sur leur facture AWS. Ces exigences demandent d’exécuter le moteur dans le compte AWS du client, et quatre obstacles se dressent alors entre un agent hébergé sur AWS et ComfyUI.
Un GPU inactif coûte quand même. ComfyUI tourne habituellement comme un serveur sur une machine GPU qui reste allumée. Un agent génère par rafales : quelques images, puis rien pendant des heures. Une machine maintenue allumée entre deux rafales facture chaque heure d’inactivité. Une instance Spot abaisse le prix horaire, mais ne supprime pas ce gaspillage : tant qu’elle reste allouée entre deux rafales, elle facture son temps d’inactivité.
Un agent distant n’a pas de disque partagé. Un serveur MCP qui tourne à côté de ComfyUI communique habituellement par stdio, l’entrée et la sortie d’un processus local. Il échange workflows et images sous forme de chemins de fichiers sur son propre disque. Un agent hébergé n’a pas de disque à partager avec lui.
La capacité GPU se planifie. Un quota de service autorise l’usage d’un type d’instance, sans réserver de capacité. Selon la région, le type d’instance et le moment, une instance GPU peut donc être disponible tout de suite ou plus tard. Une architecture qui cherche la capacité dans plusieurs régions et sur plusieurs types d’instance réduit l’attente. Les poids des modèles s’ajoutent au temps de démarrage : les poids des quatre modèles fournis pèsent environ 74 Go.
Chaque appelant dépense votre argent. Quiconque peut appeler les outils démarre des jobs GPU et écrit des fichiers dans votre bucket. Chaque appelant doit être authentifié, et rien de ce qu’il envoie ne doit s’exécuter comme du code.
Vue d’ensemble de la solution
Nous avons construit mcp-comfy, un serveur MCP qui expose ComfyUI à un agent. mcp-comfy transforme un agent en « creative technologist » : il génère des images, cherche des modèles, des nœuds et des templates, et exécute de vrais workflows. Il est conçu pour la génération par lots, la reproductibilité et le travail en équipe.
Trois propriétés décrivent ce qu’un agent créatif obtient avec mcp-comfy.
Le moteur complet, pas un bac à sable. L’agent pilote le même outil que l’équipe créative. Il dispose des workflows multi-étapes et des templates de bonnes pratiques.
Reproductible par conception. Chaque génération est un workflow que l’on peut relancer, partager et confier à un collègue. mcp-comfy est fait pour les projets longs plutôt que pour les générations ponctuelles.
Le GPU à la demande, dans votre compte. Le GPU démarre pour un lot d’images et s’arrête ensuite. Les workflows, les modèles et les images restent dans votre compte AWS.
L’agent suit un parcours simple : découvrir, choisir ou construire un workflow, le valider, l’exécuter, suivre le job, récupérer les images.
L’agent contrôle chaque entrée de façon explicite. Il choisit un template, c’est-à-dire un workflow stocké avec des emplacements nommés comme le prompt, la graine, la largeur ou la hauteur. Il peut aussi envoyer son propre workflow, ou en construire un nœud par nœud. Il peut demander un lot de prompts, ou un balayage d’une valeur, dans un seul job.
Le serveur expose 27 outils, regroupés en familles qui suivent le parcours de l’agent. La figure 1 montre ces familles et le parcours principal.
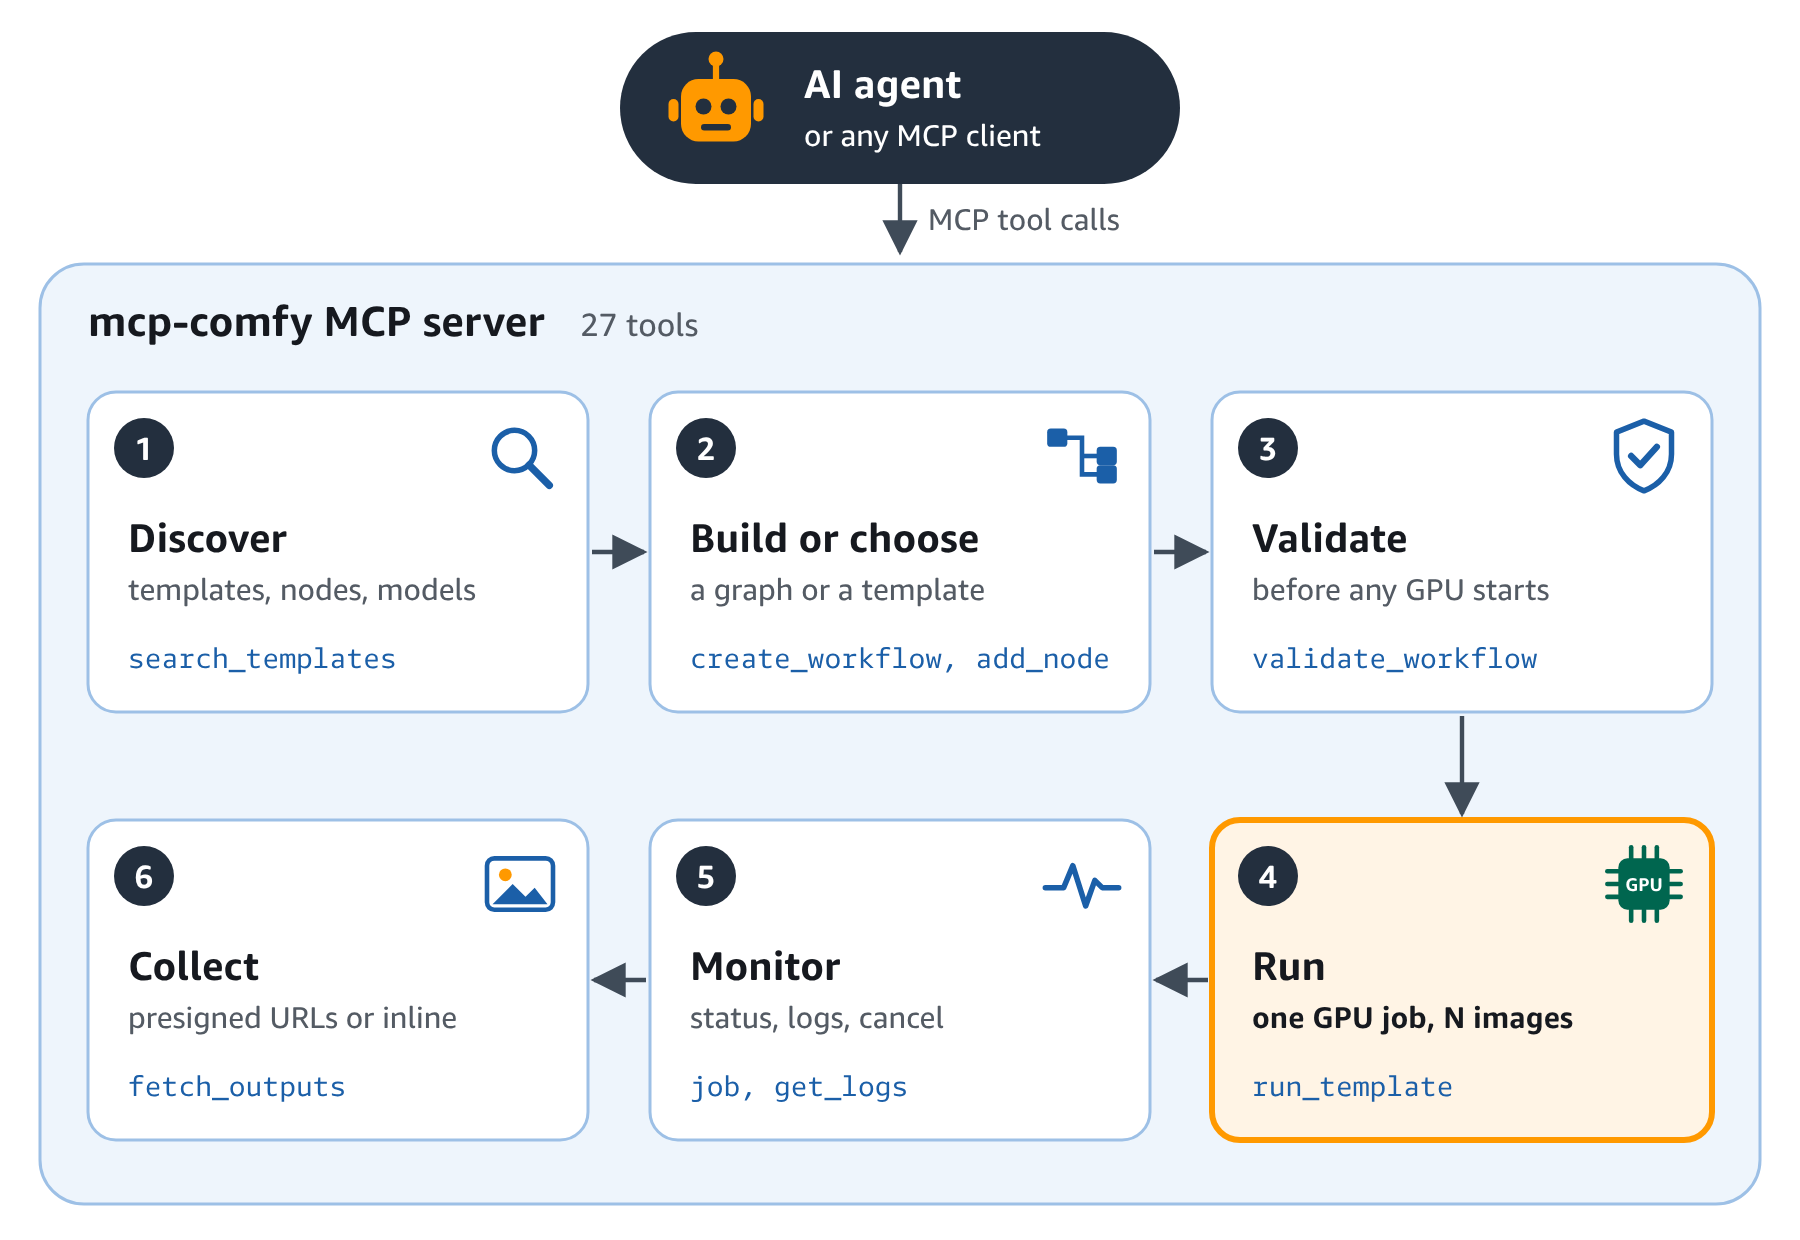
Figure 1 : vue fonctionnelle, les familles d’outils et le parcours principal d’un agent.
Les outils de découverte décrivent l’infrastructure, les templates, les nœuds et les fichiers de modèles disponibles. Les outils de construction modifient un graphe ComfyUI sans état côté serveur, puis le valident. Les outils d’exécution démarrent un job GPU qui rend jusqu’à 16 graphes. Les outils de suivi et de collecte accompagnent le job jusqu’aux images.
Architecture
La figure 2 montre les services AWS, les régions et les rôles IAM derrière ces outils.
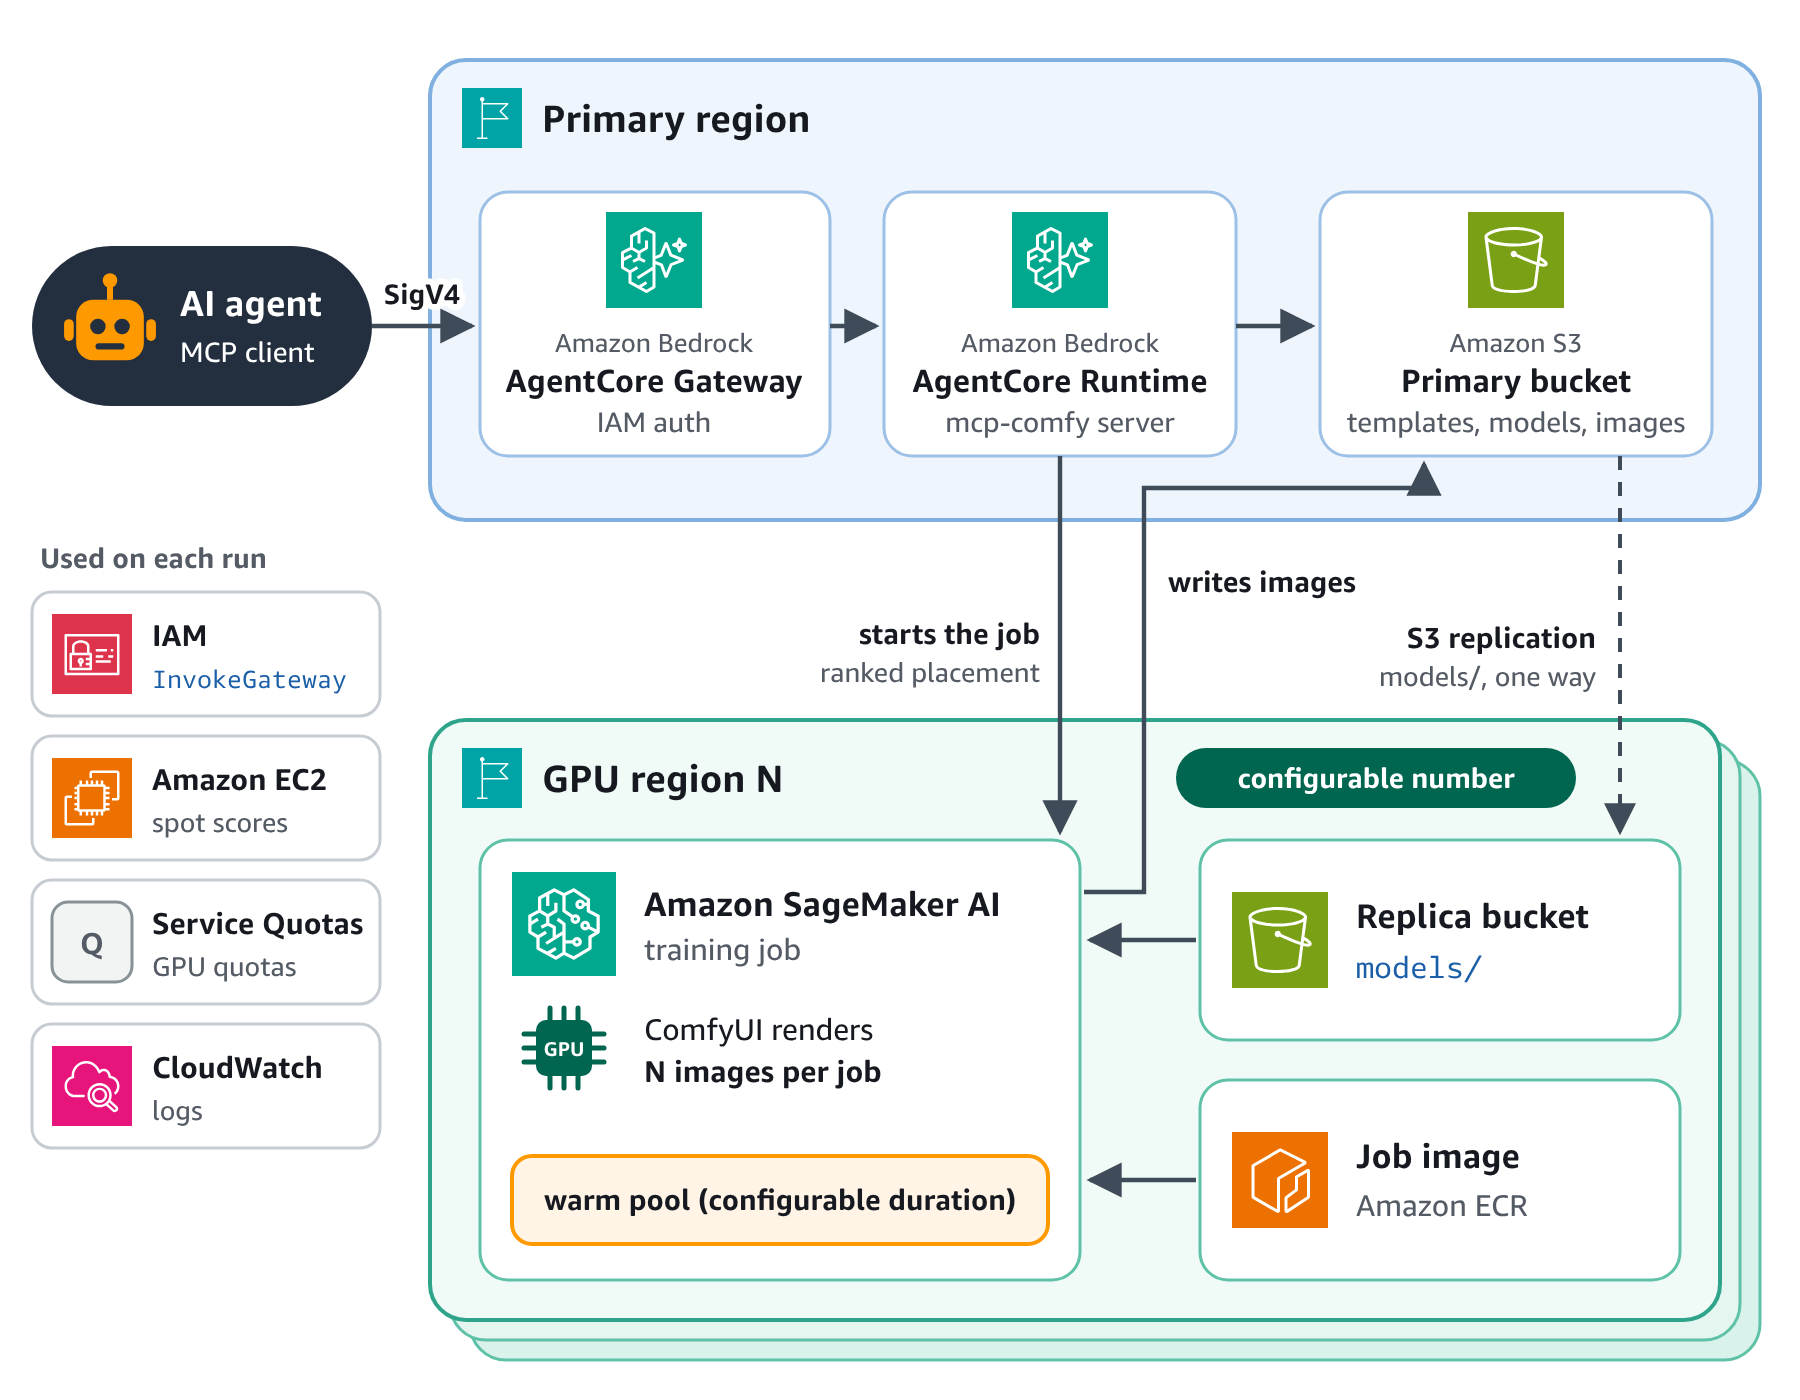
Figure 2 : architecture technique, avec la région principale et un nombre configurable de régions GPU secondaires ; les régions représentées ne sont qu’un exemple.
Les services AWS et leur rôle
Chaque service répond à un ou plusieurs des obstacles décrits plus haut.
Amazon Bedrock AgentCore Gateway est le point d’entrée de l’agent. Il expose les outils MCP à un agent distant, sans disque partagé, et vérifie la signature IAM de chaque requête. Seul un appelant autorisé peut ainsi démarrer un job GPU.
Amazon Bedrock AgentCore Runtime héberge le serveur MCP, sans GPU. Le serveur valide les graphes, classe les placements GPU et démarre les jobs. Il reste disponible sans immobiliser de GPU entre deux rafales.
Les jobs d’entraînement Amazon SageMaker AI fournissent le GPU pour la durée d’un lot seulement, dans la région qui a de la capacité.
Amazon Simple Storage Service (Amazon S3) remplace le disque partagé. La région principale est celle où l’application est déployée. Son bucket contient les poids des modèles, les fichiers d’entrée et les images rendues. La réplication S3 copie les poids vers un bucket de chaque autre région GPU.
Amazon Elastic Container Registry (Amazon ECR) stocke, dans chaque région GPU, l’image figée que le job exécute. Seul le code de cette image s’exécute sur le GPU.
Les sections suivantes expliquent les choix derrière ces services, puis la séquence d’une exécution.
Un GPU par lot, facturé à la seconde
Le GPU n’est alloué que pour un lot d’images. Nous utilisons un job d’entraînement SageMaker AI (training job) comme lot GPU. Il démarre à la demande, exécute un conteneur jusqu’à la fin et facture à la seconde. Un seul job rend jusqu’à 16 graphes : un seul démarrage GPU sert ainsi un lot de workflows ou de variantes.
Les jobs d’entraînement sont conçus pour l’entraînement de modèles. Leur contrat convient pourtant à un rendu par lots : un rôle, une instance GPU et des données lues depuis Amazon S3. Aucune ressource GPU ne reste active entre deux jobs, hormis la fenêtre de warm pool décrite au paragraphe suivant.
Quand le compte dispose du quota correspondant, les warm pools gérés de SageMaker AI gardent l’instance et les poids copiés pendant une fenêtre configurable, cinq minutes par défaut, après un job. Cette fenêtre est facturée. Elle permet de servir la rafale suivante sans nouveau démarrage à froid.
Trouver de la capacité GPU
Un placement combine une région, un type d’instance et une option d’achat, à la demande ou Spot. Avant chaque exécution, le serveur classe les placements compatibles. La figure 3 montre ce classement.
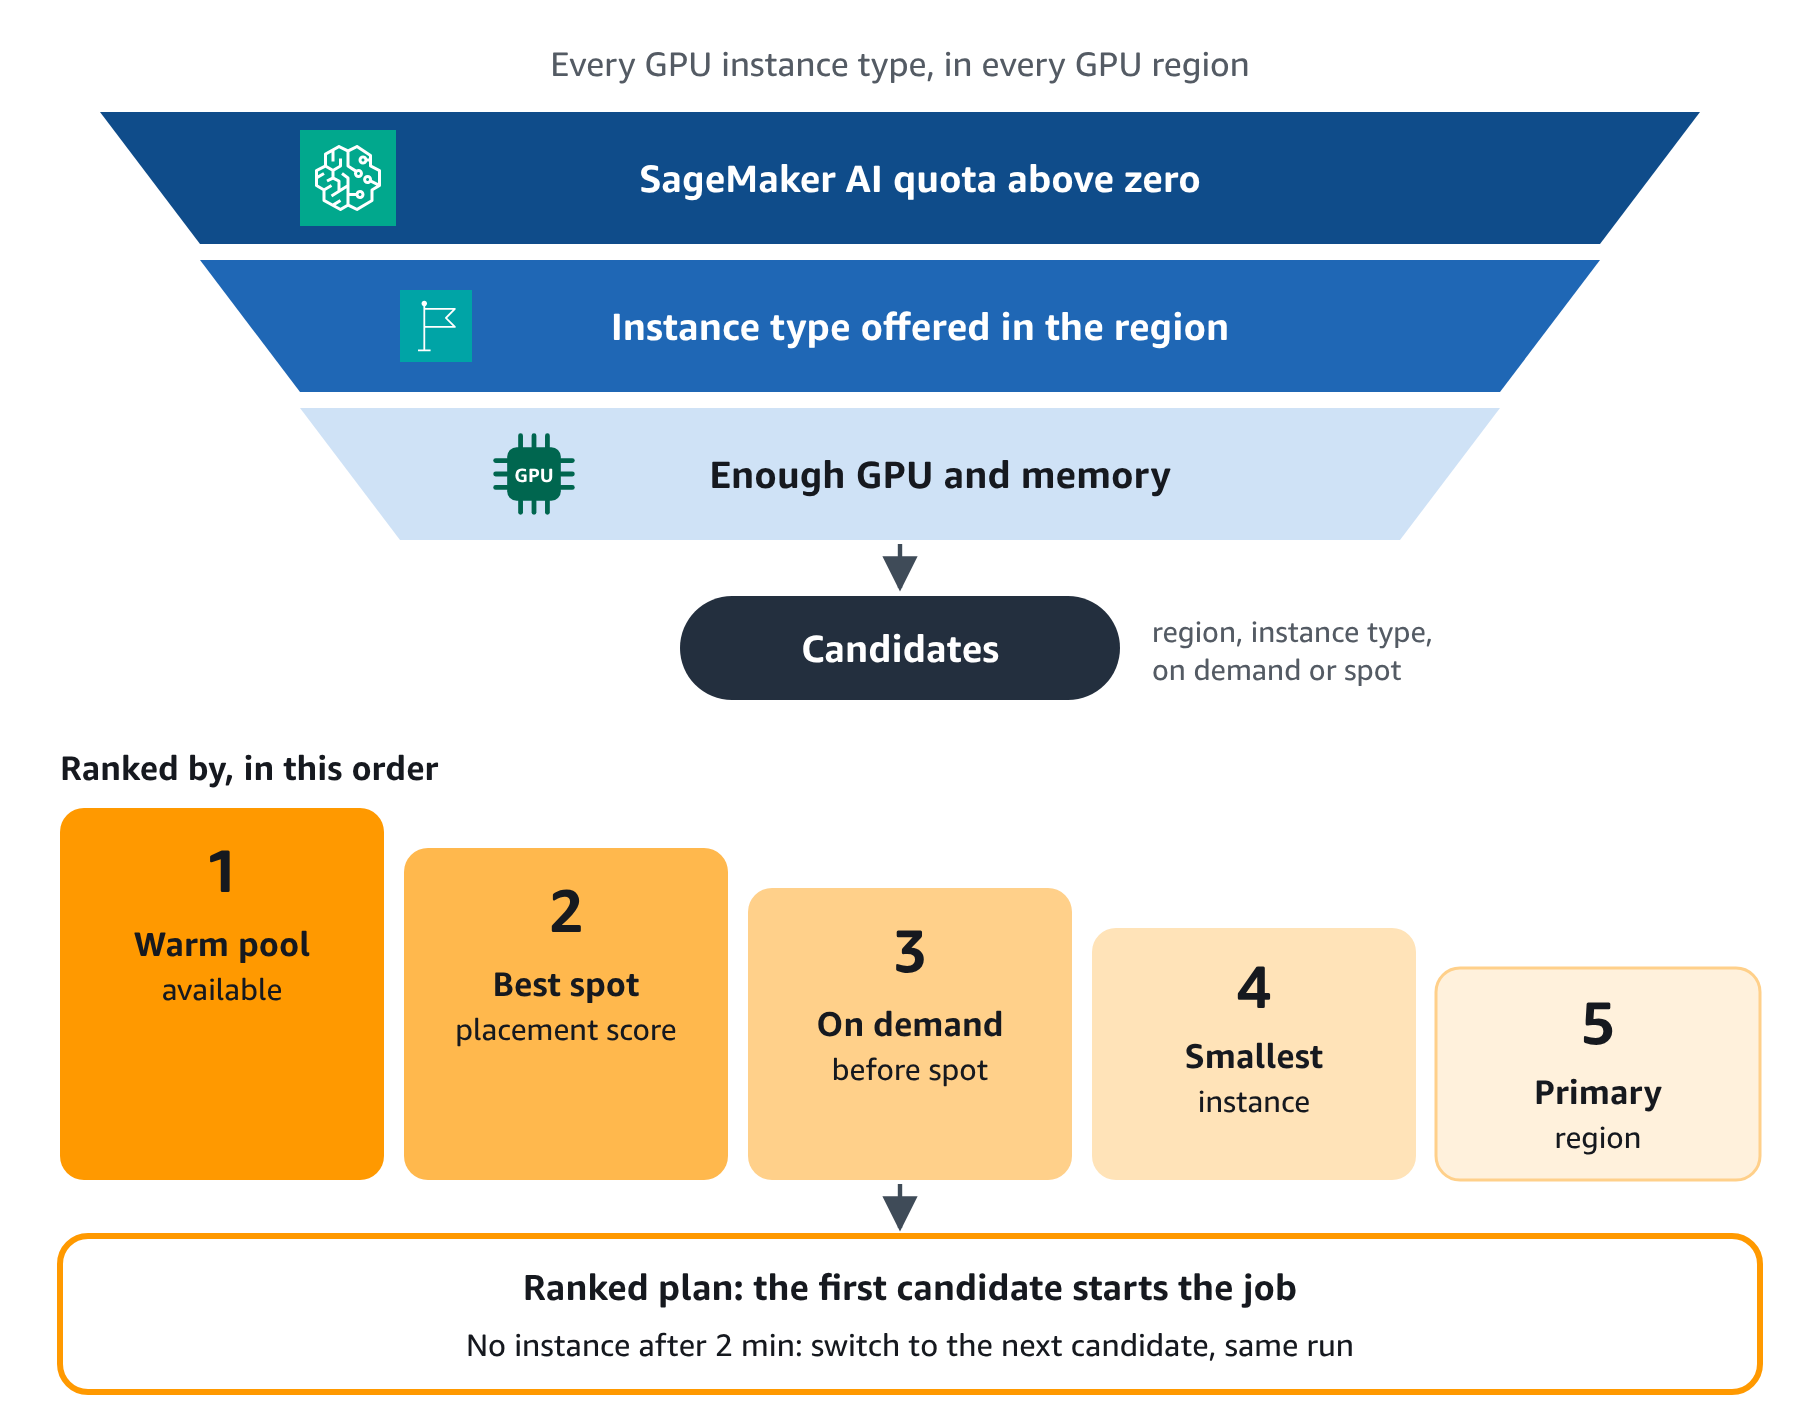
Figure 3 : sélection et classement des placements GPU.
Le serveur retient d’abord les types d’instance qui ont un quota SageMaker AI dans la région. Il garde ceux que la région propose et dont le GPU et la mémoire suffisent aux modèles. Il place en tête un warm pool disponible, puis le meilleur score de placement Spot d’Amazon Elastic Compute Cloud (Amazon EC2). Viennent ensuite la capacité à la demande avant Spot, la plus petite instance, puis la région principale.
Si aucune instance n’est attribuée après deux minutes, l’exécution passe au placement suivant. Elle garde le même identifiant, et l’agent ne voit qu’une exécution, même si elle a changé de région.
La réplication S3 copie les poids dans un seul sens, de la région principale vers les autres régions GPU. Un job lit ses poids dans sa propre région, ou dans la région principale pour un fichier qui n’est pas encore répliqué. L’architecture ne suppose aucune région précise : vous choisissez la région principale et le nombre de régions GPU secondaires selon vos besoins, sans limite imposée.
Valider avant de payer
La validation intervient avant tout démarrage de GPU. Le serveur vérifie chaque graphe contre le catalogue de nœuds de la version de ComfyUI embarquée dans l’image du job. Il le vérifie aussi contre les fichiers de modèles et d’entrées présents dans le bucket. Un nom de modèle inconnu ou une valeur hors limites renvoie une erreur nommée, sur le nœud concerné, sans démarrer de job. Un agent qui construit un workflow nœud par nœud corrige ainsi ses erreurs sans dépenser de temps GPU.
Séquence d’une exécution
Une exécution enchaîne ces services en cinq étapes.
- L’agent appelle un outil d’exécution à travers AgentCore Gateway, qui vérifie sa signature IAM.
- Le serveur MCP, hébergé sur AgentCore Runtime, valide les graphes et classe les placements GPU possibles. Il démarre un job d’entraînement SageMaker AI et renvoie l’identifiant de l’exécution avant que le GPU ne démarre.
- Le job copie les poids dont il a besoin depuis le bucket S3 de sa région. Une version figée de ComfyUI, sans interface navigateur, rend les images sur un GPU NVIDIA A10G, L4 ou L40S.
- Le job écrit les images dans le bucket de la région principale, puis s’arrête.
- L’agent suit le job, puis récupère les images. Il les reçoit sous forme de liens S3 présignés, valides une heure au plus, ou directement dans la réponse.
La figure 4 détaille cette séquence, de l’appel de l’agent au téléchargement des images.
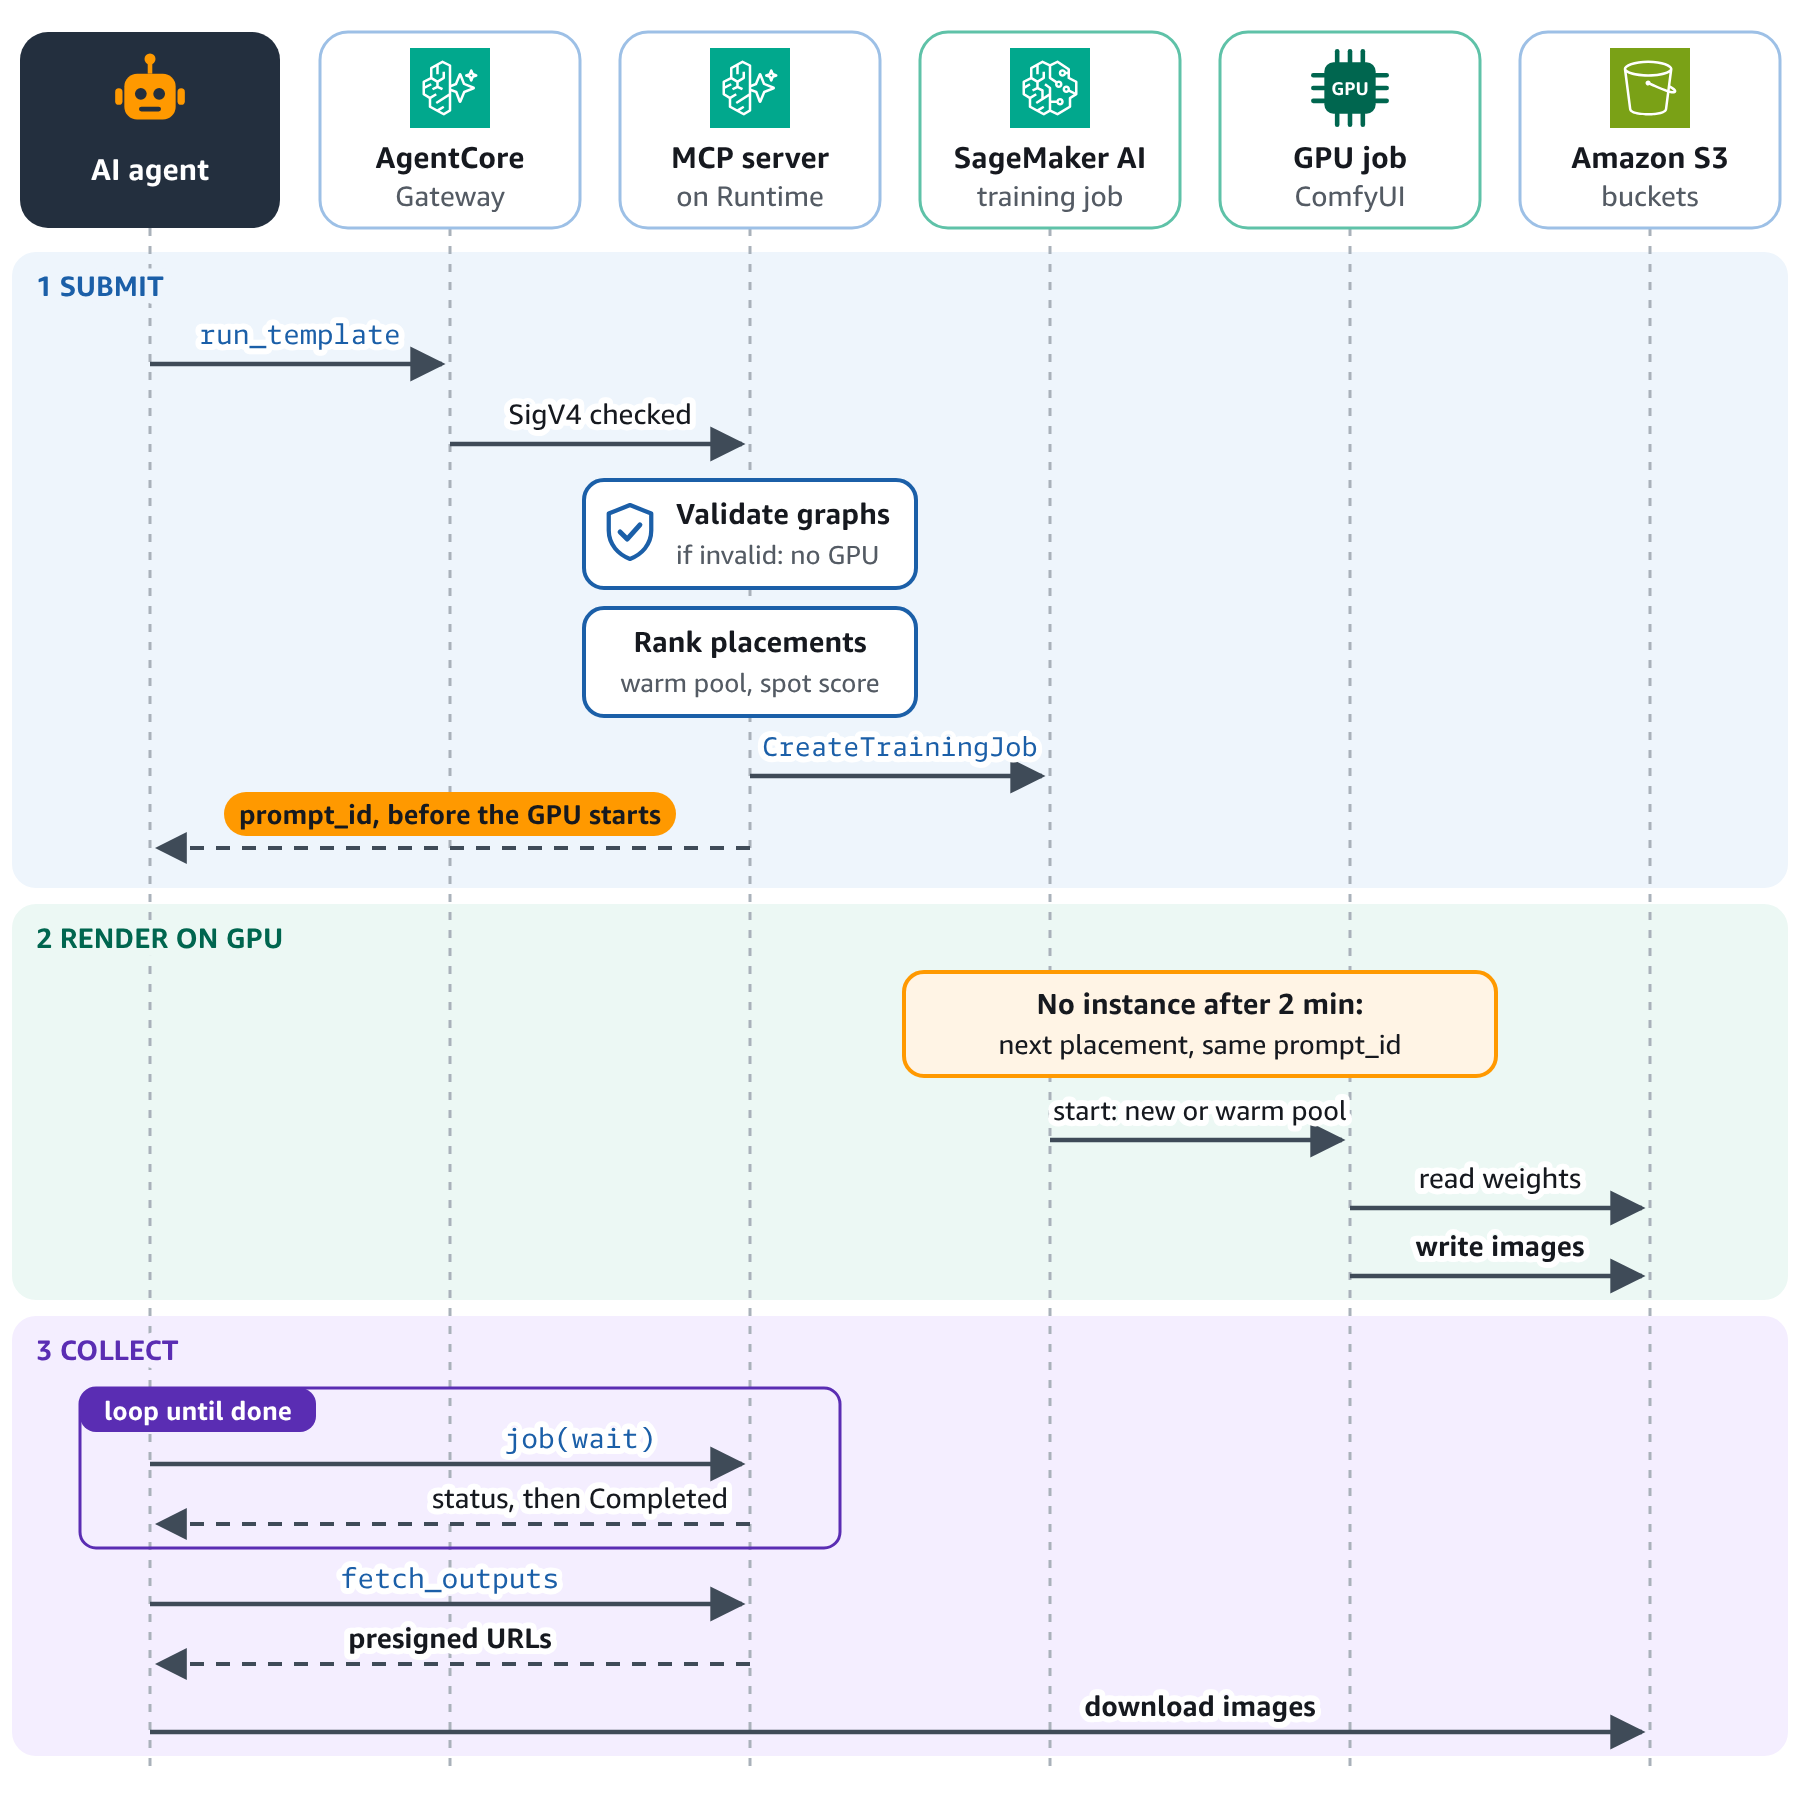
Figure 4 : séquence d’une exécution.
Sécurité
La sécurité est une responsabilité partagée entre AWS et vous. L’architecture fournit des mécanismes, et vous décidez qui y accède.
AgentCore Gateway autorise uniquement par IAM et vérifie la signature SigV4 (la signature des requêtes AWS) de chaque requête. Pour appeler un outil, une identité doit disposer de l’action bedrock-agentcore:InvokeGateway. Accordez-la aux agents et aux personnes autorisés à consommer du temps GPU, et à personne d’autre.
L’architecture est conçue pour qu’aucun contenu du bucket ne s’exécute comme du code. ComfyUI démarre avec les nœuds personnalisés désactivés. L’image du job est figée : image de base par empreinte, ComfyUI par commit, dépendances par fichier de verrouillage. Aucun outil n’écrit dans le dossier des modèles, dont la liste est déclarée dans la configuration de l’infrastructure et téléchargée au déploiement.
Les buckets bloquent l’accès public, imposent TLS et chiffrent les objets au repos. Les rôles de l’application ne couvrent que ses propres ressources.
Résultats
Nous avons mesuré plusieurs exécutions à travers AgentCore Gateway, toutes sur un GPU NVIDIA L4 dans la région eu-west-3. Ces chiffres sont des mesures passées, pas un engagement de niveau de service.
| Exécution | Instance | Délai avant le rendu | Durée facturée |
|---|---|---|---|
| Deux images Stable Diffusion 3.5 Large, instance froide | ml.g6.4xlarge |
55 s | 244 s |
| Deux images FLUX.2, warm pool | ml.g6.4xlarge |
4 s | 84 s |
| Quatre prompts Z-Image-Turbo dans un seul job, warm pool | ml.g6.4xlarge |
6 s | 106 s |
| Une image Z-Image-Turbo, servie après trois bascules de placement | ml.g6.16xlarge, quatrième placement |
7 min depuis le début de l’exécution | 209 s, plus 1 s pour les trois jobs arrêtés |
Le warm pool ramène le démarrage de près d’une minute à quelques secondes. La dernière ligne montre la bascule de placement. L’exécution a changé trois fois de placement, et le quatrième a rendu l’image. Les trois jobs arrêtés n’ont coûté qu’une seconde au total.
Ajouter un modèle consiste à déclarer son fichier dans la configuration de l’infrastructure et à redéployer.
Coûts
Vous pouvez estimer le coût avec le AWS Pricing Calculator. Le temps SageMaker AI est facturé à la seconde pendant chaque job, ainsi que la fenêtre du warm pool quand elle est active (cinq minutes par défaut, configurable). Les poids, environ 74 Go, sont stockés dans chaque région GPU. Les images restent dans Amazon S3 jusqu’à leur suppression.
S’y ajoutent l’image du job dans Amazon ECR et les appels à AgentCore Gateway. Comptez aussi le temps de calcul d’AgentCore Runtime et les journaux Amazon CloudWatch. Aucun GPU ne tourne entre deux rafales au-delà de la fenêtre de warm pool.
Ce que l’architecture ne couvre pas
L’architecture se concentre sur la génération d’images à partir de modèles ouverts, dans votre compte. Elle ne propose ni partage de workflow par URL ni mode application, et elle ne sert pas l’éditeur visuel ComfyUI. Les templates enregistrés sont partagés entre tous les appelants d’AgentCore Gateway.
Conclusion
L’architecture que nous avons décrite exécute ComfyUI dans votre compte AWS, sous le contrôle d’un agent. Amazon Bedrock AgentCore héberge le serveur et authentifie chaque appel par IAM. Un job d’entraînement SageMaker AI rend chaque lot sur un GPU facturé à la seconde, et la recherche de capacité GPU s’étend sur plusieurs régions. Au-delà de la fenêtre de warm pool, aucun GPU ne reste alloué entre deux lots.
Vos équipes marketing et créatives déclinent ainsi une campagne en dizaines de visuels. Elles gardent un contrôle complet sur chaque image, sans payer un GPU inactif entre deux rafales.
Pour aller plus loin, consultez la documentation Amazon Bedrock AgentCore et la documentation des warm pools gérés de SageMaker AI. Vous préparez une production d’images pilotée par des agents ? Contactez votre équipe de compte AWS pour en discuter, ou partagez vos questions en commentaire.