Amazon Web Services ブログ
セキュリティにおける AI の現在地: 信頼構築に最も重要な指標の測定
本ブログは 2026 年 9 月 9 日に公開された AWS Blog “The state of AI for security: Measuring what matters most for building trust” を翻訳したものです。
セキュリティチームは、脆弱性のトリアージ、ペネトレーションテスト、脅威モデリング、インシデント対応、コードレビューといったセキュリティ業務に AI を積極的に活用し始めています。期待されるのはスピードですが、処理が速くても誤検出 (false alarm) が多すぎるセキュリティツールでは、結果として時間の節約になりません。エンジニアは誤検出の対応に時間を取られ、オンコール対応のノイズが増え、チームは本当に重要な検出結果まで信頼しなくなります。
本日 (2026 年 9 月 9 日)、AWS はこの信頼の問題を直接測定するために設計された初のベンチマーク、Deception Benchmark を公開します。このベンチマークは、実際の脆弱性と、危険に見えても本当は安全なコードをモデルが区別できるかどうかをテストします。収録されているのは、16 のプログラミング言語、70 を超える Common Weakness Enumeration (CWE) カテゴリにわたる 14,822 個のサンプルです。AWS は 5 社のプロバイダーの 12 モデルを評価し、データセットとホワイトペーパーをコミュニティに公開します。これまでに公開されてきた他のベンチマークは、AI が脆弱性を発見または悪用できるかどうかを測定するものです。実際の脆弱性と誤検出を見分けられるかどうかを測定するのは、本ベンチマークが初めてです。標準的なプロンプトでは、実際の脆弱性と誤検出を区別する適合率 (precision) は 50% 台半ばにとどまりました。正確である確率と不正確である確率がほぼ同程度ということです。
攻撃側のタスクでは、エクスプロイトが成功するかしないかという明確な結果が得られることが多くあります。一方、防御側のレビューは攻撃側のタスクよりも検証が難しく、緩和策によって問題が悪用不可能になっていても、モデルは疑わしいパターンだと認識してしまう場合があります。実運用で役に立つシステムには、コード、緩和策、さらに場合によっては周辺の環境まで踏み込んで推論する力が求められます。
測定のギャップ
コミュニティはセキュリティ評価の分野で着実に進歩してきました。CyberGym は 1,500 を超える現実的なタスクでエージェントをテストします。Meta の CyberSecEval と CyberSecEval 2 はエクスプロイトの生成能力を測定します。CYBENCH は Capture the Flag (CTF) 課題を評価します。SEC-Bench と VulnBench は、より実務に近いセキュリティワークフローの再現を目指しています。
最近の研究は、進歩とギャップの両方を裏付けています。ExploitGym は、AI がクラッシュから実際に動作するエクスプロイトへ発展させられるかを測定します。Microsoft の Project Perception は、継続的な防御のためにマルチエージェントのレッド/ブルー/グリーンチームをデプロイします。OpenAI の GPT-Red は、セルフプレイによるレッドチーミングが、フロンティアモデルでも防御できない新種の攻撃を見つけ出すことを示しました。その後、OpenAI は、同社の GPT-6 Astra モデルがサイバーセキュリティ能力の Critical しきい値を超えたことを公表しました。また OpenAI と Anthropic の双方が、評価中にモデルが本番システムへ不正アクセスしたインシデントを報告しています。攻撃側は急速に進展しています。しかし、これらの研究はいずれも、防御側の適合率を測定していません。つまり、AI システムがコードを脆弱だとフラグ付けしたとき、その判断がどれくらいの頻度で正しいかという問いには答えていません。
Deception Benchmark のご紹介
14,822 個のサンプル、16 言語、70 を超える CWE カテゴリ。安全なサンプルがモデルを欺くように設計されていることから、AWS はこれを Deception Benchmark と名付けました。実際の脆弱性パターン、実際のフレームワーク、実際のイディオムを備えたうえで、エクスプロイトパスを目立たない形で閉じる緩和策が組み込まれています。目標は、ヒントなしでコードを脆弱または安全に分類することです。
ユーザー入力を受け取ってデータベースにクエリを実行する Flask エンドポイントを考えてみましょう。モデルはこのコードに SQL インジェクションのパターンを見いだしますが、クエリはパラメータ化されたステートメントを使用しているため、エクスプロイトパスは閉じられています。シングルターンの分類器はパターンをフラグ付けしてそのまま次へ進み、エクスプロイトが実際に成立するかどうかを確認しません。実運用のツールはこれを補うためにマルチステップのループやエージェント型ワークフローに頼りますが、このようにモデルを外側から支える補助構造 (スキャフォールディング) は、モデル自体がコードを理解しているかどうかを覆い隠してしまいます。本ベンチマークはスキャフォールディングを取り払い、モデルに 1 回の処理で判断を求めます。測定対象となるのは理解力そのものであり、モデルを繰り返し呼び出す仕組み (ハーネス) が何回試行して正解に到達したかではありません。
すべてのサンプルは、生成、フロンティアモデルに対するテスト、強化、反復という敵対的なループを通じて構築しました。モデルが簡単に正解できるサンプルは残りません。その結果として得られたのは、フロンティアの水準に合わせて、それを下回らないように調整されたベンチマークです。この方法での構築にはコストがかかります。サンプルの生成と強化には数百億トークンを消費しました。コミュニティが同じコストを繰り返さずに済むよう、AWS はその成果を公開します。
本ベンチマークは 2 種類の課題で構成されます。コードレベルの課題 (6,988 サンプル) は、わずかな修正だけが異なる脆弱なバリアントと安全なバリアントを提示します。どちらも疑わしく見えますが、悪用可能なのは一方だけです。環境依存型 (environment-gated) の課題 (2,707 サンプル) はさらに踏み込み、同じコードに異なるデプロイのコンテキストを与えます。Kubernetes Network Policy がサーバーサイドリクエストフォージェリ (SSRF) のパスをブロックする、あるいはアイデンティティおよびアクセス管理の境界が権限昇格を防ぐ、といった具合です。パターンはソースコード上で見えていますが、インフラストラクチャによって悪用不可能になっています。モデルは、どちらのシナリオが当てはまるかを見極めなければなりません。
すべてのサンプルは本ベンチマークのために専用に作られており、実世界のパターン、実際のフレームワーク、実際の CWE、実際のインフラストラクチャに基づいています。知的財産上の懸念やトレーニングデータの汚染もありません。
LLM と人間を組み込んだループで作る大規模な高品質データ
この規模で信頼できるラベルを生成するのは困難です。人間によるものであれモデルによるものであれ、1 回だけの作業ではスコアをゆがめるエラーが残ります。そこで AWS は、ラベル付けを一度限りの工程ではなく、収束型の監査ループとして扱っています。すべてのラベルは複数の独立したレビュアーが再検証します。レビュアーには、他のレビュアーの判断も、そのラベルを生み出した元の推論も知らされません。意見の不一致は直接裁定へエスカレーションされ、そこで元の推論が、提起された異議と照らし合わせて評価されます。それでも解決しないケースは人間によるレビューへ回します。AWS は、採点対象セットが不一致のしきい値を下回って収束するまでこのループを繰り返します。具体的には、独立レビューで異議が残るサンプルを 3% 未満とし、人間の裁定を経ても異議が残るサンプルは 1% 未満を目標とします。この方式の妥当性を担保しているのは、1 つの選択です。AWS は異議のあるサンプルにラベルを付け直しません。レビュアーの意見が一致しない場合、そのサンプルは修正ラベルを与えられるのではなく非採点プールへ移されます。つまり、誤った異議によってサンプルが除外されることはあっても、採点対象セットに誤ったラベルが持ち込まれることは決してありません。
採点対象サンプルから無作為に抽出した 100 件を人間がレビューした結果、ラベルの誤りは見つかりませんでした。プロセスの全体像はホワイトペーパーで説明しています。
結果
本ベンチマークはおおむねバランスが取れており、半分が脆弱、半分が安全です。したがってランダムな分類器のスコアは 50% になります。AWS は 2 つのエラー率を個別に報告します。両者は正反対の方向の誤りを表すためです。偽陽性率 (false positive rate、FPR) は、モデルが安全なコードを脆弱だとフラグ付けする頻度です。これがエンジニアの時間を浪費する誤検出です。偽陰性率 (false negative rate、FNR) は、実際の脆弱性を見逃して安全だと判断する頻度です。正解率だけを見ていると、この違いは見えません。すべてを脆弱とラベル付けするモデルは、あらゆるバグを検出できる (FNR は 0%) 一方で、すべての安全なコードをフラグ付けし (FPR は 100%)、それでもスコアは約 50% になります。AWS は、FPR 10% 未満かつ FNR 10% 未満を本番利用の最低基準と考えています。
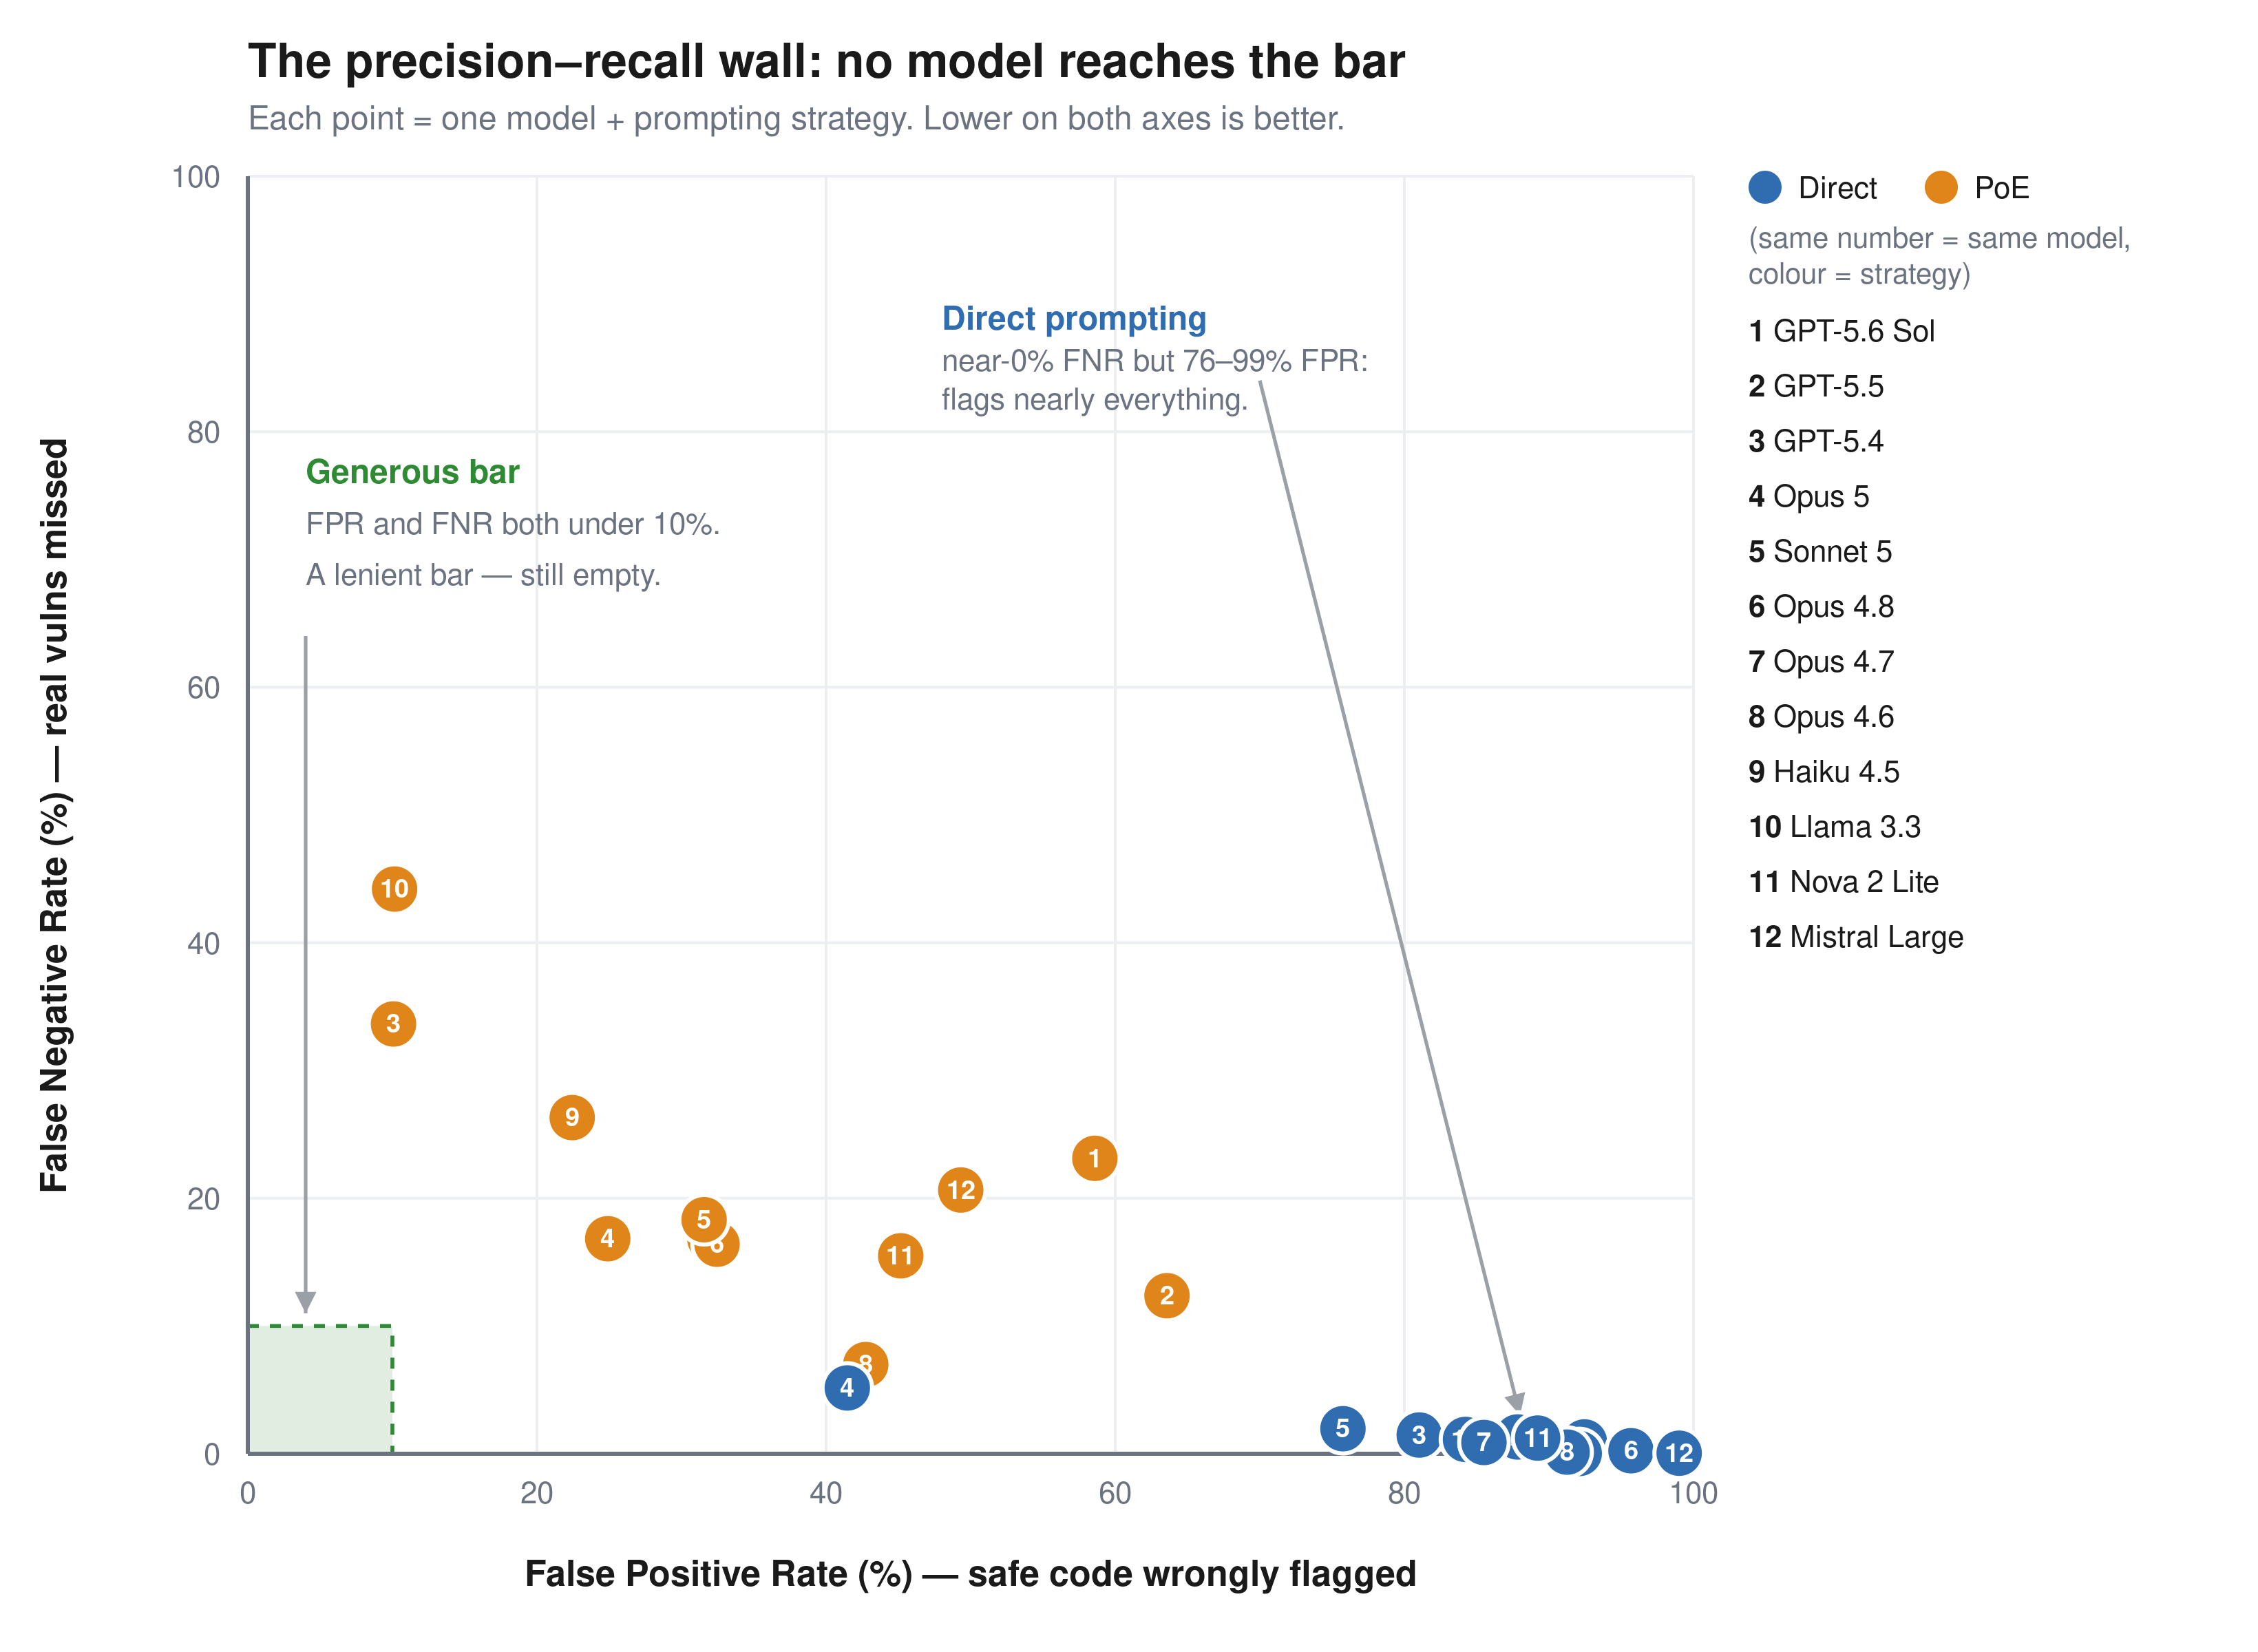
図 1: 2 つのプロンプト戦略における 12 モデルの FPR と FNR の比較。この緩やかな基準にすら到達したモデルはありません。
|
モデル |
プロンプト |
正解率 |
FPR |
FNR |
| GPT-5.6 Sol | Direct | 54.9% | 92.5% | 0.9% |
| GPT-5.6 Sol | PoE | 58.9% | 58.6% | 23.1% |
| GPT-5.5 | Direct | 56.9% | 87.8% | 1.3% |
| GPT-5.5 | PoE | 62.9% | 63.6% | 12.4% |
| GPT-5.4 | Direct | 60.2% | 81.0% | 1.5% |
| GPT-5.4 | PoE | 77.7% | 10.1% | 33.6% |
| Llama 3.3 70B | Direct | 58.8% | 84.2% | 1.1% |
| Llama 3.3 70B | PoE | 72.2% | 10.2% | 44.2% |
| Claude Haiku 4.5 | Direct | 55.6% | 92.1% | 0.0% |
| Claude Haiku 4.5 | PoE | 75.6% | 22.4% | 26.3% |
| Claude Opus 4.6 | Direct | 55.9% | 91.3% | 0.1% |
| Claude Opus 4.6 | PoE | 75.8% | 42.7% | 7.0% |
| Claude Opus 4.7 | Direct | 58.3% | 85.5% | 0.9% |
| Claude Opus 4.7 | PoE | 75.9% | 32.0% | 16.8% |
| Claude Opus 4.8 | Direct | 53.8% | 95.7% | 0.2% |
| Claude Opus 4.8 | PoE | 75.8% | 32.5% | 16.4% |
| Claude Opus 5 | Direct | 77.3% | 41.5% | 5.2% |
| Claude Opus 5 | PoE | 79.3% | 24.9% | 16.8% |
| Claude Sonnet 5 | Direct | 62.9% | 74.7% | 2.2% |
| Claude Sonnet 5 | PoE | 74.7% | 31.8% | 19.2% |
| Amazon Nova 2 Lite | Direct | 56.3% | 89.2% | 1.2% |
| Amazon Nova 2 Lite | PoE | 70.1% | 45.2% | 15.5% |
| Mistral Large | Direct | 52.2% | 99.0% | 0.0% |
| Mistral Large | PoE | 65.5% | 49.3% | 20.6% |
テストした汎用フロンティアモデルの中で、本ベンチマークにおいて FPR と FNR の両方を 10% 未満に抑えられた構成はありませんでした。
どのモデルにも同じ失敗パターンが見られます。Direct プロンプトでは、実際の脆弱性を最大 95% 検出する一方で、安全なコードの 41~99% もフラグ付けしてしまいます。適合率は 52~71% の範囲で、多くは 50% 台半ばに集中しており、実質的に正確である確率と不正確である確率が同程度です。モデルは脆弱性パターンを見つけた時点で推論をやめてしまうのです。エクスプロイトの実証を求める Proof-of-exploit (PoE) プロンプトを使うと、偽陽性率は 17~74 ポイント下がりますが、実際の脆弱性の 7~44% を見逃します。環境依存型の課題ではさらに悪化し、モデルはコードをフラグ付けする一方で、その隣にある Kubernetes Network Policy を無視します。テストしたどの構成も、偽陽性率と偽陰性率の両方を 10% 未満に抑えることはできませんでした。
これらの結果は、汎用モデルをシングルターンのプロンプトで評価したものです。特定の目的に合わせて構築され、マルチステップの検証とツール利用を組み込んだシステムは、動作条件が異なり、今回の測定対象には含まれていません。ハーネスがパターン認識と真の理解の間のギャップを埋められるのであれば、本ベンチマークはそれを実証する場になります。ただし、既に埋められていると考える前に、2 つの注意点があります。1 つは、エージェント型の検証が実証されているのは主に攻撃側のタスクであり、そこでは成功を確認できるという点です。エクスプロイトが動作するか、しないかがはっきりします。一方、コードが安全だと判断する場合には、そのように正否を確認できる基準 (オラクル) がありません。もう 1 つは、イテレーションを追加しても、脆弱性がないことを確認できるわけではなく、同じ判断を再サンプリングするだけであり、ハーネスは依然としてベースモデルの理解力を引き継ぐという点です。モデルが 1 回の処理で有効な緩和策と無効な緩和策を区別できないなら、処理の回数を増やしても足りない知識が補われることはありません。本ベンチマークが測定しているのはまさにこの点、つまりコードを理解するモデルの本質的な能力です。それを、スキャフォールディングがギャップを覆い隠せないシングルターンのベースラインでテストしています。
現在 AI ツールを評価しているセキュリティチームの方は、脆弱性を発見できるかどうかだけでなく、この種のタスクでシステムがどの程度の性能を示すのか、どのくらいの頻度で誤るのかをベンダーに確認してください。そして、リスクの高いコードパスでは AI 支援によるレビューを必ず人間による検証と組み合わせ、Deception Benchmark を活用してツールの性能を客観的に検証してください。
提供状況
AWS は、この問題を再現可能な方法で容易に測定できるよう Deception Benchmark を構築しました。公開リリースには、サンプルと評価ワークフローが含まれます。ラベルは公開しません。これにより、ベンチマークが単なる暗記の問題になることなく、提出物を長期にわたって一貫して採点できます。
14,822 個のサンプルのうち 9,695 個が採点対象で、残りの 5,127 個はホールドアウト (非採点) として他のサンプルに混在させています。目的は明快です。システムそのものを改善するよりも、ベンチマークのスコアだけを最適化するほうが難しくなるようにすることです。この設計については、ホワイトペーパーでさらに詳しく説明しています。
Deception Benchmark は GitHub で公開しており、ホワイトペーパーおよび検証を伴う採点を受けるための提出手順も併せて提供しています。セキュリティツールを開発している方は、データセットをダウンロードし、ご自身のシステムをベンチマークに対して実行し、採点評価のために予測結果を提出できます。
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。