AWS 기술 블로그
CJ대한통운 해외 IDC의 AWS 전환기 2편: 컷오버와 안정화
이 글은 CJ대한통운 해외 IDC의 AWS 전환 과정을 다룬 시리즈 중 2편입니다.
- 1편: CJ대한통운 해외 IDC의 AWS 전환기 1편: 의존성 분석과 랜딩존 설계
- 2편: CJ대한통운 해외 IDC의 AWS 전환기 2편: 컷오버와 안정화
1편에서는 CJ대한통운이 해외 거점 IDC 마이그레이션을 시작한 배경과 ADS 기반 분석, AWS Transform MGN 선택, 그리고 Control Tower 랜딩존과 WorkSpaces, GWLB 기반 보안 아키텍처를 소개했습니다. 2편에서는 이 기반 위에서 실제로 서버를 옮긴 과정을 다룹니다. Windows 서버와 SQL Server, Active Directory 이전, 다국적 조직의 협업 체계와 마이그레이션 프레임워크, Wave 전략과 컷오버 시나리오, 그리고 오픈 이후 안정화 과정에서 얻은 교훈과 비용 이야기를 순서대로 풀어 보겠습니다.
온프레미스 Windows 서버를 AWS로 옮기기
Windows 서버는 Linux에 비해 다뤄 본 경험이 적었습니다. AWS SA와 해외 거점 인프라 담당자의 협업, 그리고 Microsoft와 AWS 공식 문서를 참고하며 마이그레이션을 진행했습니다. Active Directory처럼 종속성을 고려해야 하는 부분은 신중한 검토가 필요했지만, 구성 요소의 원리와 절차를 이해하고 나니 개별 설정 자체는 복잡하지 않았습니다. 오히려 중요했던 것은 기술 난이도보다, 운영 환경에 주는 영향을 최소화할 수 있는 표준 절차를 만드는 일이었습니다.
온프레미스 SQL Server 데이터베이스 이전
데이터베이스 이전을 준비하면서 가장 부담스러웠던 부분은 접속 정보 변경과 데이터 동기화였습니다. 특히 접속 정보 변경은 DB 한 대만 손보면 끝나는 일이 아니었습니다. 오랜 기간 운영되며 연결된 수많은 애플리케이션, 배치 작업, 연계 시스템을 모두 찾아내야 했습니다. 담당자의 기억과 문서에만 기대면 이전하고 나서야 문제가 드러나는 서비스가 반드시 나옵니다.
이 문제는 1편에서 소개한 ADS로 풀었습니다. 실제 네트워크 연결을 기준으로 의존 관계를 수집해 보니 문서에 드러나지 않았던 연계 서비스까지 찾아낼 수 있었고, 접속 정보 변경을 빠뜨려 발생할 수 있었던 장애를 대부분 미리 막을 수 있었습니다.
SQL Server를 AWS로 옮길 때 가장 먼저 정해야 했던 것은 Amazon RDS for SQL Server와 EC2 중 어디에 올릴지였습니다. 관리 부담을 줄이려면 RDS가 낫지만, 지금 시스템이 실제로 쓰는 기능을 RDS가 모두 받아줄 수 있는지가 관건이었습니다.
이 검토는 AWS팀과 함께 진행했습니다. RDS for SQL Server가 지원하는 기능과 기존 시스템이 쓰는 기능을 항목별로 비교했고, 저희 운영에 꼭 필요한 일부 기능에서 제약이 있다는 것을 확인했습니다. 이를 근거로 EC2에 SQL Server를 직접 구성하는 방향을 빠르게 정할 수 있었습니다. 자체적으로 문서를 뒤지며 검토했다면 몇 주는 걸렸을 판단을, AWS팀과 함께 짧은 시간 안에 근거 있는 결론으로 만들 수 있었습니다.
이전 대상 가운데 CPU와 메모리 사용률이 높지 않은 서버는 골라서 사양을 낮췄습니다. 온프레미스에서는 한 번 들인 장비를 몇 년씩 써야 하기 때문에 도입할 때 자원을 넉넉하게 잡아 두는 경우가 많습니다. 게다가 막상 운영해 보면 처음 예상만큼 자원을 쓰지 않는 서비스도 있습니다. 결국 상당한 유휴 자원을 안고 운영하고 있었던 셈입니다. AWS 전환은 이 차이를 정리할 기회였고, 비용을 줄이기 위해 실사용량 기준으로 사이징을 다시 했습니다.
이렇게 과감하게 줄일 수 있었던 건 언제든 다시 올릴 수 있었기 때문입니다. 온프레미스였다면 사양을 줄이는 결정 자체가 큰 부담이었겠지만, AWS에서는 부족하면 간단하게 올릴 수 있기 때문에 ‘우선 실사용량에 맞춰 시작한다’는 접근이 가능했습니다. 실제로 오픈 후 성능 문제가 생겼을 때도 인스턴스 유형 변경과 EBS 볼륨의 IOPS / 처리량 조정을 바로 적용해 빠르게 대응했습니다.
비슷한 사양으로 만든 DB를 온프레미스와 비교해 보면, 최신 세대 CPU와 메모리 덕분에 성능이 크게 좋아진 경우가 많았습니다.
반면 성능이 그대로이거나 오히려 떨어진 경우도 있었습니다. 서버 환경이 바뀌면서 SQL Server가 쿼리를 어떤 방식으로 처리할지 정하는 실행 계획(Execution Plan)이 달라진 영향으로 보고, 안정화 기간 동안 쿼리 단위로 튜닝한 뒤 프로젝트를 마무리했습니다.
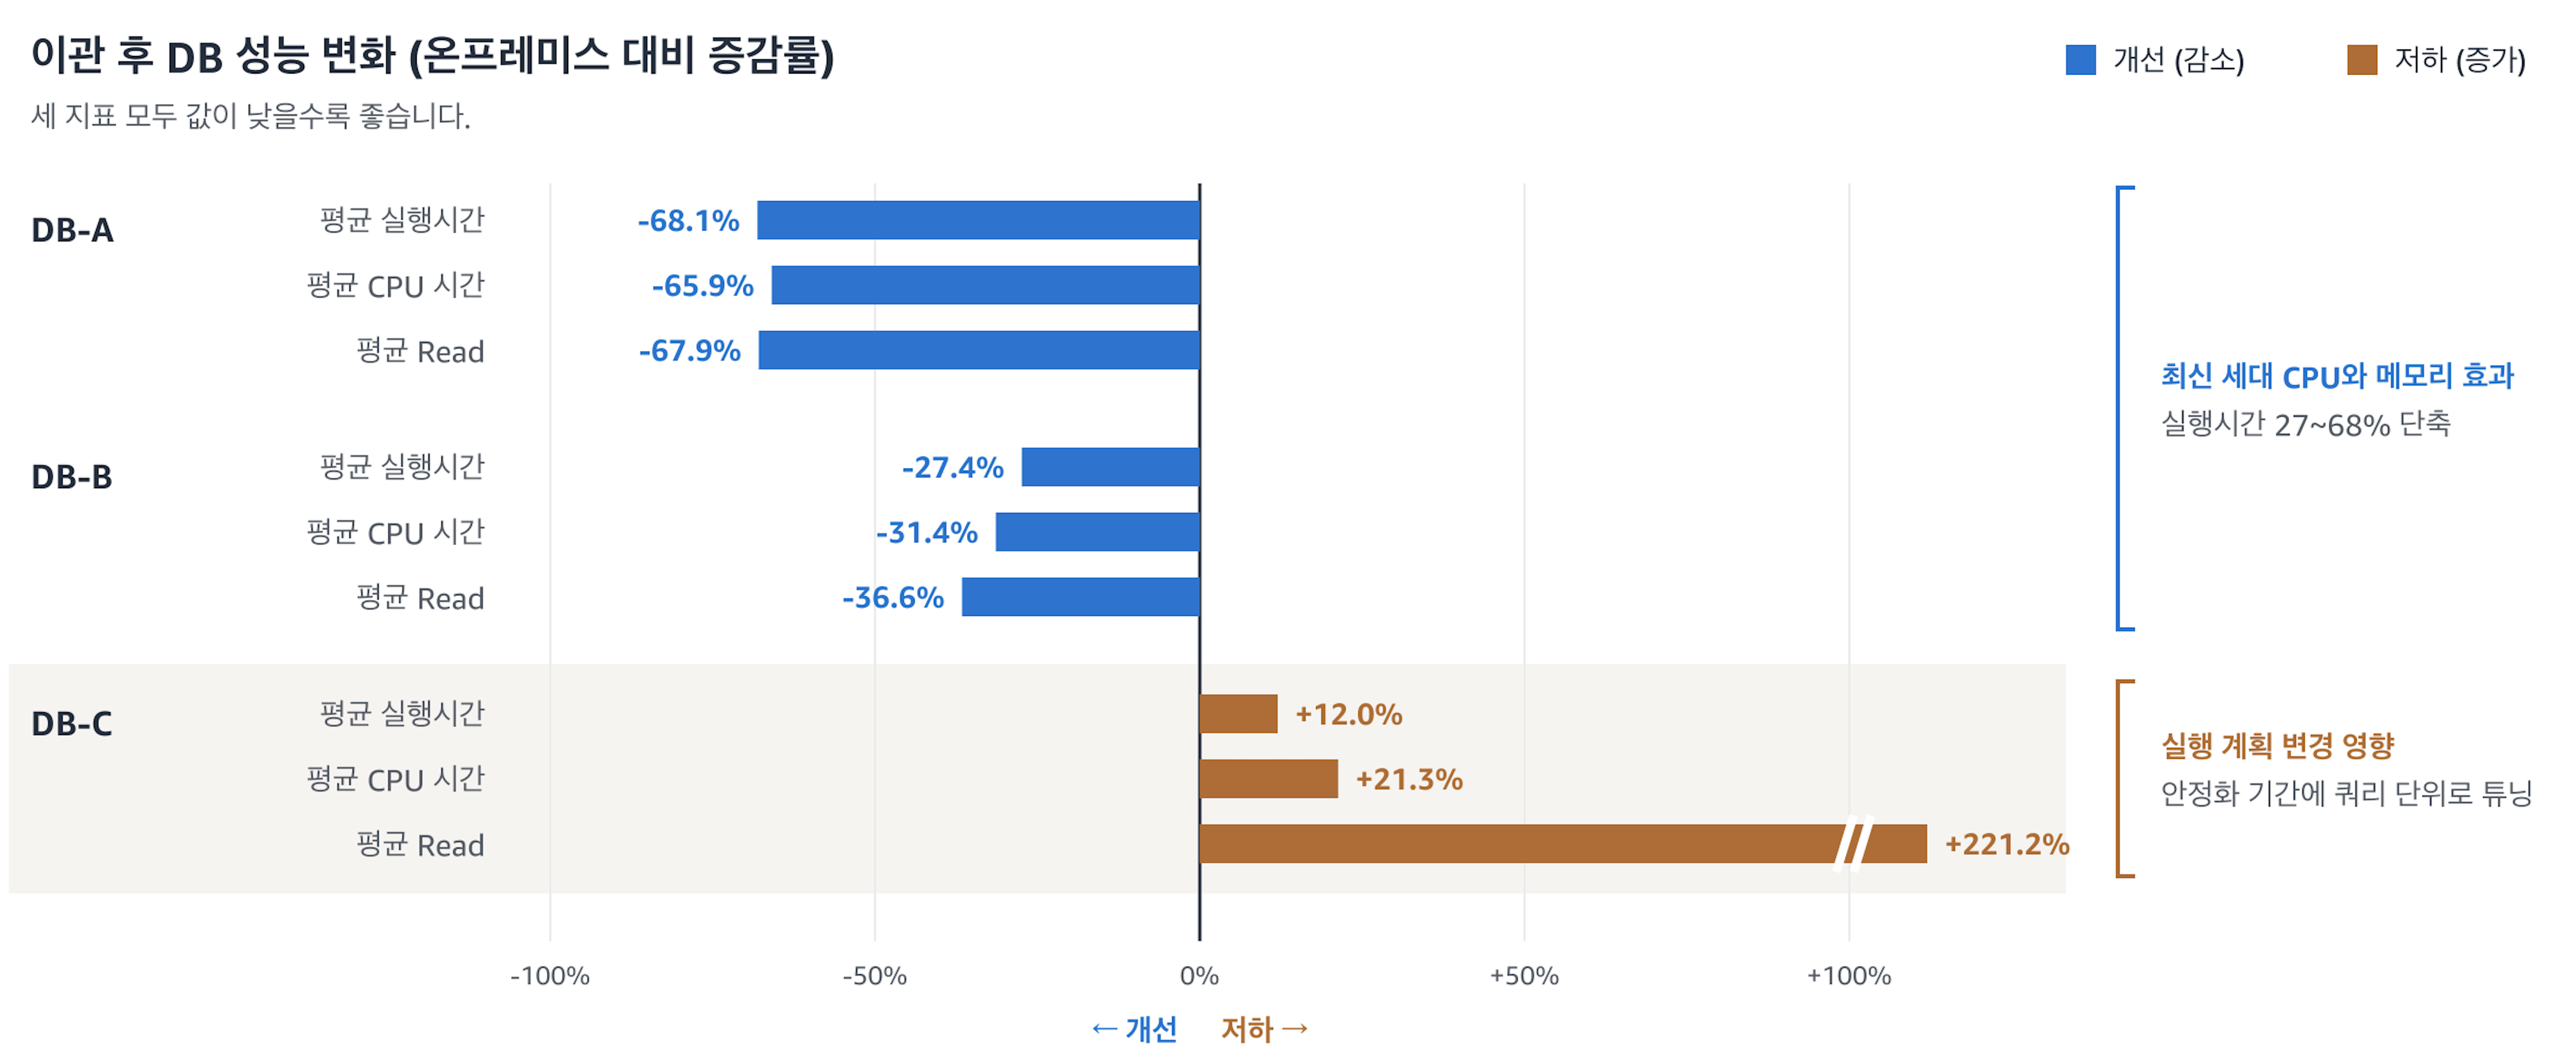
그림 1. 이관 후 DB 성능 변화 (온프레미스 대비 증감률)
Active Directory 재구성과 FSMO 역할 이전
해외 거점 IDC는 단일 포리스트, 단일 도메인 구조의 Active Directory를 쓰고 있었고, 마이그레이션 중에도 이 인증 체계를 그대로 유지해야 했습니다. AD 구조가 바뀌면 서비스 인증과 운영 환경 전반에 영향이 크기 때문에 기존 구조를 최대한 지키는 것이 중요했습니다.
그래서 AWS에도 같은 AD 구조를 두고 EC2에 새 도메인 컨트롤러를 구축했습니다. 기존 도메인 컨트롤러와 복제를 맺어 디렉터리 정보를 동기화하고 정상 동작을 확인한 다음, FSMO(Flexible Single Master Operations) 역할을 EC2 도메인 컨트롤러로 넘겨 AD 운영의 중심을 클라우드로 옮겼습니다. 덕분에 기존 서비스와의 호환성을 지키면서 인증 인프라를 안정적으로 이전할 수 있었습니다.
Active Directory SID 충돌 막기
AWS Transform MGN은 서버를 디스크 단위로 복제하기 때문에 기존 컴퓨터 계정과 SID 정보가 그대로 따라옵니다. 그러다 보니 운영 환경에서 컴퓨터 계정, DNS, 인증 정보가 충돌할 가능성을 고려해야 했고, 안전한 컷오버 절차가 필요했습니다.
이를 위해 도메인 탈퇴(Disjoin)와 재가입(Join) 절차를 표준화하고, 컴퓨터 이름 변경, DNS 등록, OU 배치까지 담은 운영 가이드를 수립했습니다. 또한 작업 전에 로컬 관리자 계정 검증과 네트워크 제어 절차를 함께 적용하여 작업 중에 예상치 않은 운영 영향을 최소화했습니다. 표준 절차를 기반으로 Windows 서버를 동일한 방식으로 AWS의 AD 환경에 편입했고, 도메인 인증의 안정성과 운영 일관성을 확보하면서 반복 가능한 마이그레이션 방식을 갖추게 됐습니다.
MGN 복제와 예외 처리 표준화
Windows 서버는 OS 버전과 드라이버 구성에 따라 MGN으로 복제한 뒤 부팅이 안 되거나 드라이버 호환성 문제가 생길 수 있습니다. 서버마다 네트워크와 보안 설정도 달라서 반복 작업이 많았습니다. 이걸 모두 손으로 하면 일관성을 지키기 어렵고 실수할 가능성도 커집니다.
이를 해결하기 위해 Launch Template 구성, EC2 복제, Windows Server 복구, AD 편입 같은 주요 작업을 프롬프트로 정리해 표준화했습니다. 이 프롬프트를 템플릿으로 만들어 두고 AI 도구를 활용해 여러 서버의 작업을 한꺼번에 진행할 수 있게 했습니다. 일부 구형 OS는 클라우드 인프라와의 드라이버 호환성 때문에 부팅에 실패하는 경우가 있어, 오프라인 복구 절차도 표준으로 정리해 예외 상황에서도 같은 방식으로 처리할 수 있게 했습니다. 반복 작업의 속도는 올라가고 품질은 고르게 유지됐으며, 운영자는 남는 시간을 리스크 분석과 의사결정에 쓸 수 있었습니다.
다국적 조직의 협업 체계와 프레임워크
글로벌 협업과 기술 커뮤니케이션 체계
언어와 문화가 다른 수십 명의 인력이 단일 컷오버 일정을 향해 움직여야 하는 상황에서, 역할 혼선과 정보 비대칭이 그 어떤 기술적 문제보다 먼저 터질 수 있는 리스크였습니다.
이번 프로젝트에는 다국적 구성원 수십 명이 참여하여 설계부터 테스트, 컷오버까지 함께 수행했습니다. 이를 위해 공통 용어와 작업 절차를 표준화하고, Sprint 및 Scrum 기반의 프로젝트 운영 방식을 적용하여 동일한 기준으로 협업할 수 있는 환경을 구축했습니다. 또한 정기적인 기술 리뷰와 의사결정 체계를 마련하여 조직 문화 차이에도 불구하고 신속하게 이슈를 해결할 수 있었습니다. 이러한 글로벌 협업 체계는 마이그레이션 이후에도 클라우드 운영 역량을 본사 중심으로 내재화하는 기반이 되었습니다.
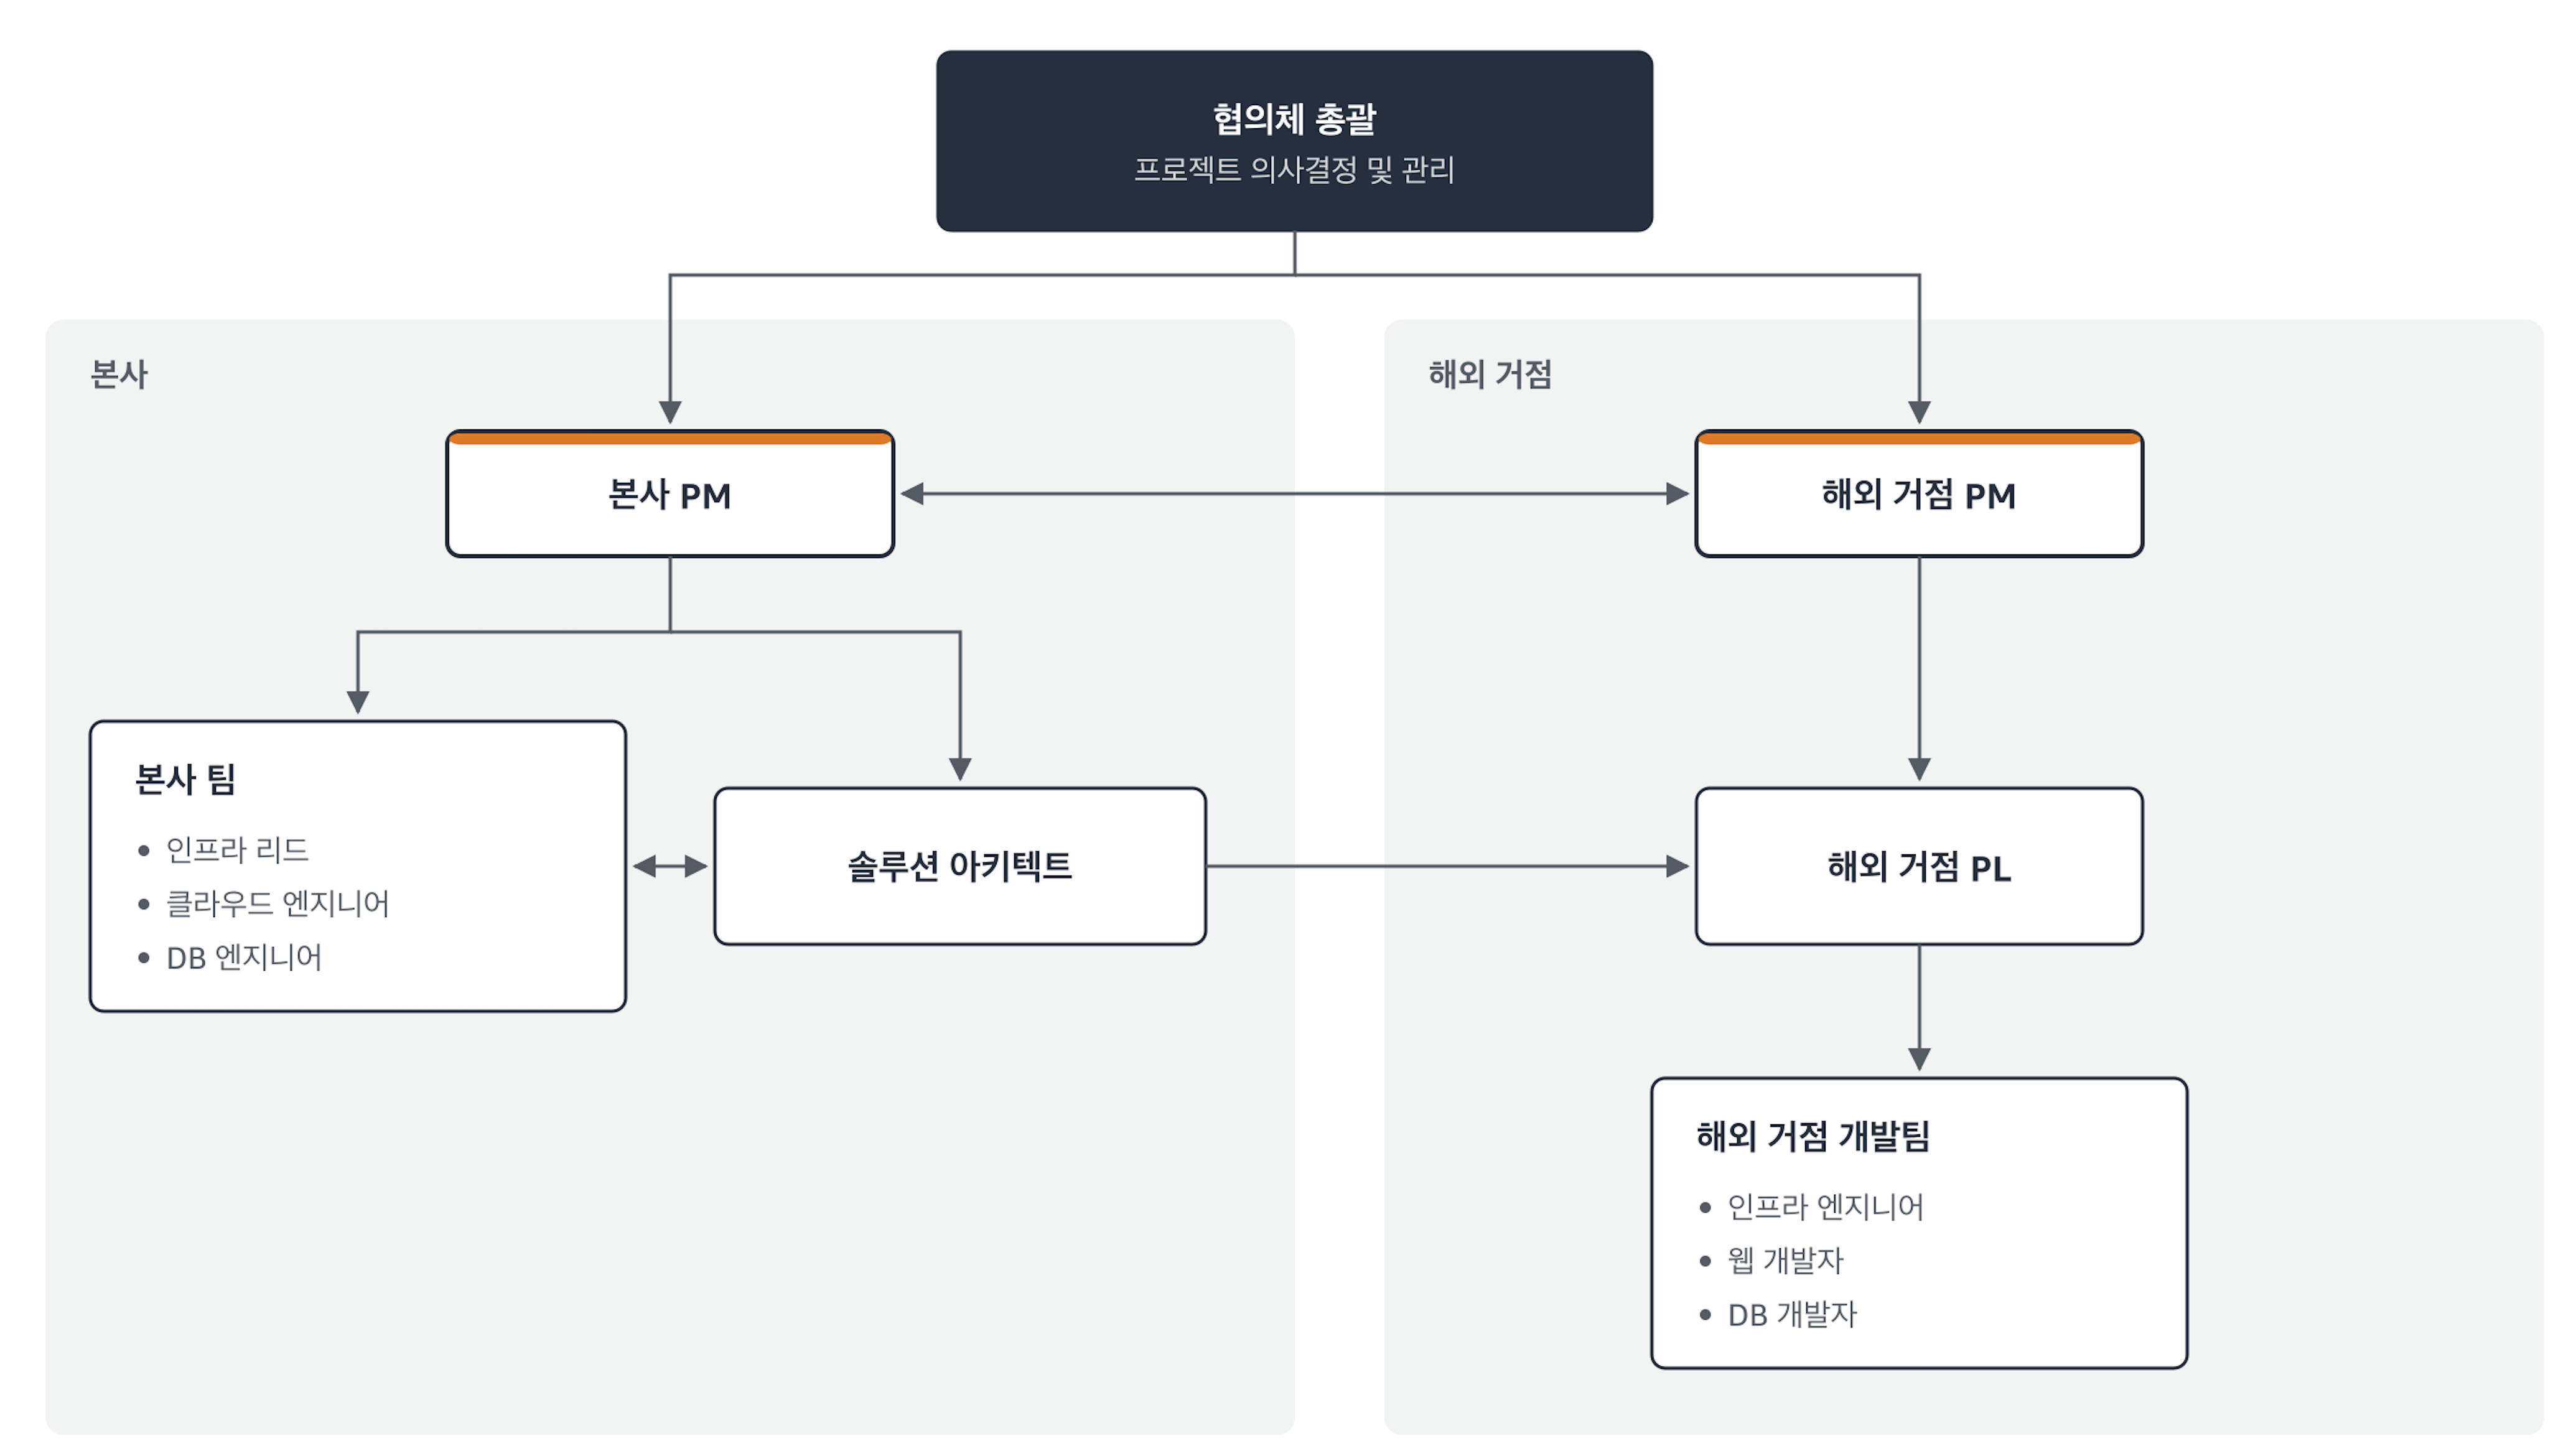
그림 2. 본사와 해외 거점의 협업 조직과 역할
마이그레이션 프레임워크 구축
서비스마다 담당 조직과 운영 방식이 달라서, 누가 어떤 순서로 무엇을 해야 하는지를 미리 정해두지 않으면 컷오버 작업에서 의사결정이 마비될 수 있었습니다.
대규모 마이그레이션에서는 서버 한 대를 잘 옮기는 것보다 반복 가능한 표준 절차를 수립하는 것이 더욱 중요했습니다. 이에 주요 서비스에 대해 워크로드 분석부터 Assessment, Wave 설계, 사전 점검, 테스트, 컷오버, 검증에 이르는 전체 마이그레이션 프로세스를 표준 프레임워크로 정의했습니다.
단계별 체크리스트와 산출물, 역할과 책임(R&R)을 명확히 규정하여 프로젝트 참여자 누구나 동일한 기준으로 작업을 수행할 수 있도록 했습니다. 이 프레임워크는 이번 프로젝트에만 활용된 것이 아니라, 미국, 인도를 비롯해 향후 글로벌 워크로드를 AWS로 이전하는 과정에서도 재사용할 수 있는 표준 운영 자산으로 자리 잡았습니다.
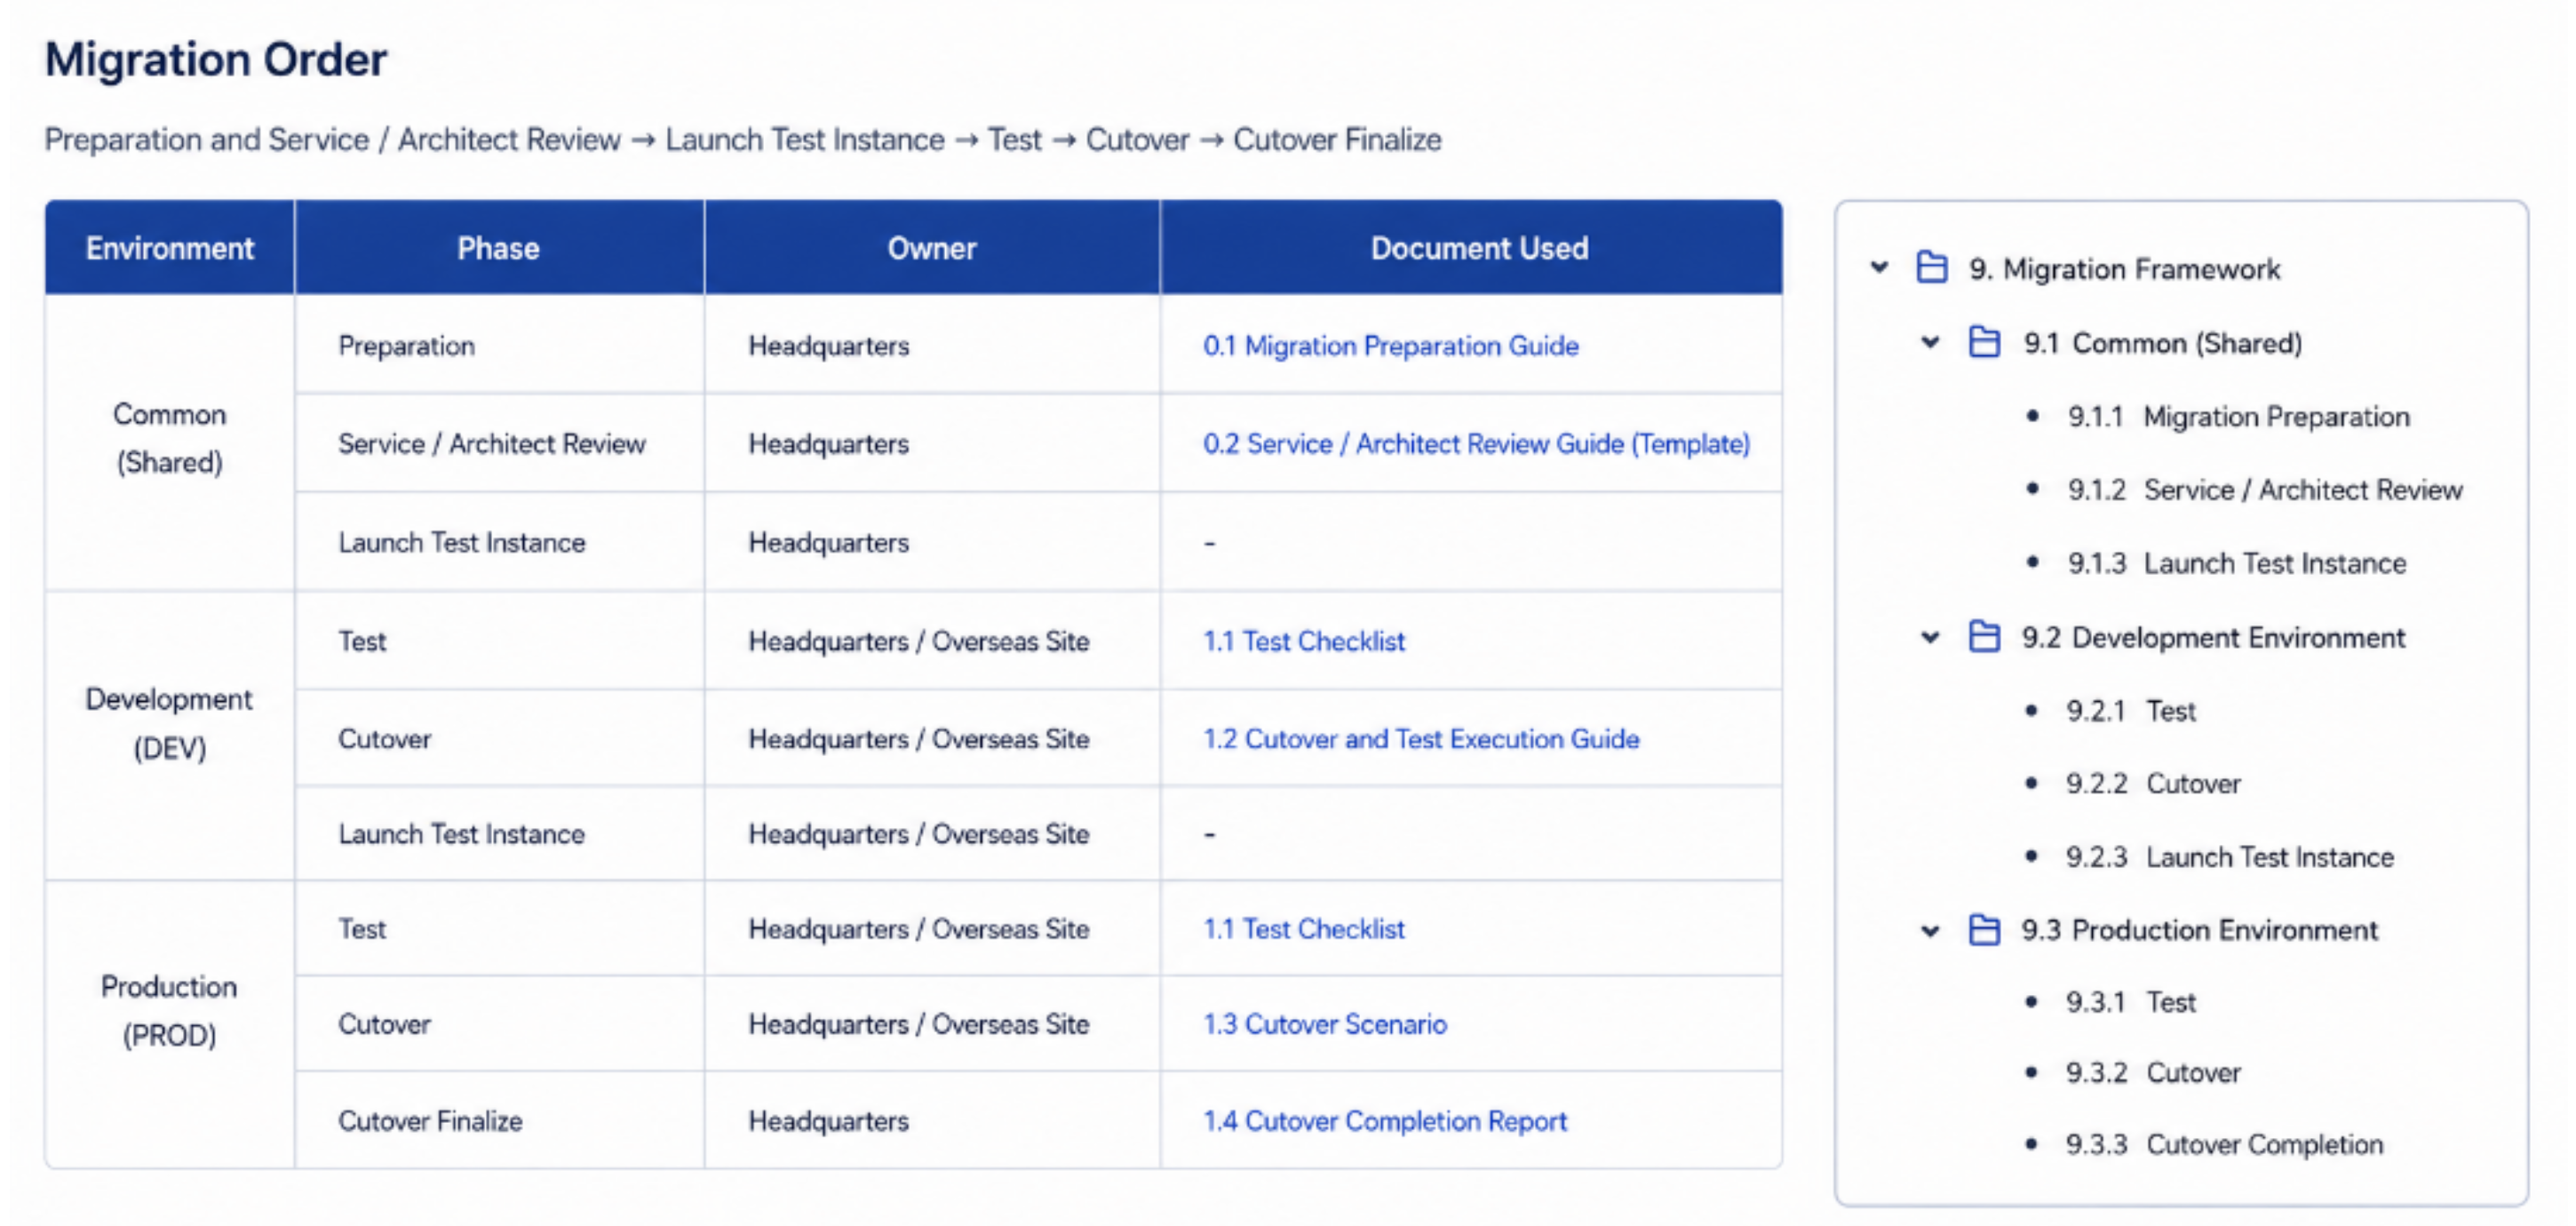
그림 3. 환경별 마이그레이션 단계와 담당, 산출물
서비스별로도 이 절차를 표준화했고, 그대로 Jira에 옮겨 모든 작업이 프레임워크 안에서 진행되도록 했습니다.
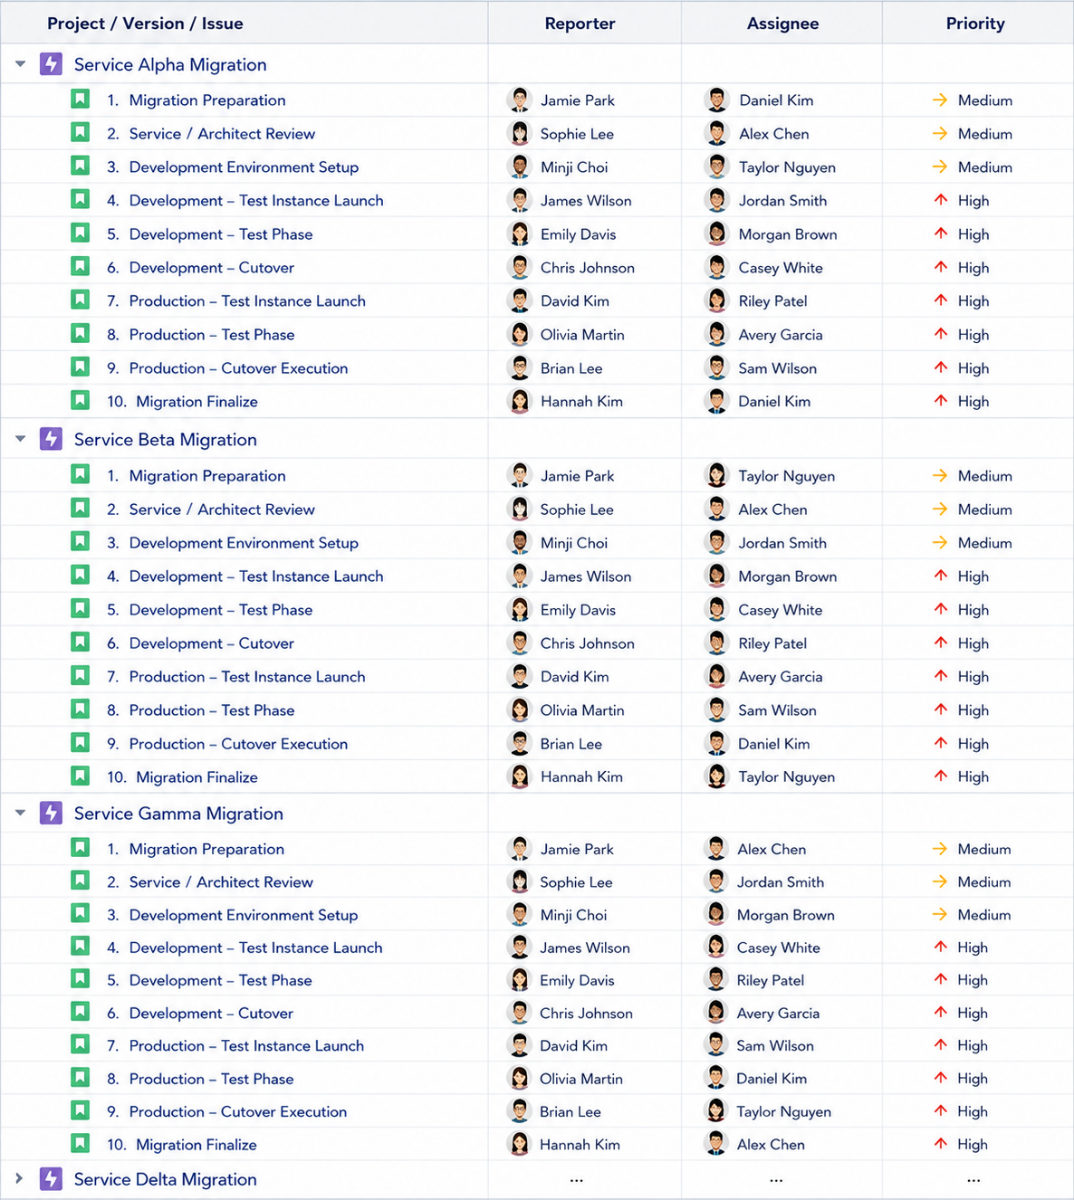
그림 4. 마이그레이션 프레임워크를 적용한 Jira 예시
(위 이미지는 에픽과 티켓 이름을 가명으로 바꾼 예시입니다.)
마이그레이션 Wave 전략 수립
서비스 사이의 의존성이 얽혀 있어서 어떤 순서로 옮겨도 영향이 생기는 구조였습니다. 비즈니스 중요도와 기술 리스크를 함께 고려해 Wave 순서를 정하는 것이 단순한 서버 나열이 아닌 설계 문제였습니다.
AWS Application Discovery Service(ADS)를 통해 수집된 워크로드 의존성과 기획자와의 인터뷰, 서비스 특성을 바탕으로 위험도를 고려한 단계별 Wave 전략을 수립했습니다. 단순히 서버 개수로 나누지 않고 서비스 영향도와 운영 리스크를 기준으로 순차적으로 이전하는 방식을 선택했습니다.
Wave 1. PoC와 운영 검증
첫 번째 Wave 대상은 내부에서 사용하는 비교적 단순한 대시보드 웹 애플리케이션이었습니다. 이 단계에서는 AWS Transform MGN 기반 복제, 네트워크 연결, 보안 정책, 운영 절차 등 마이그레이션 전 과정을 실제 환경에서 검증하는 데 중점을 두었습니다. 이를 통해 이후 Wave에서 활용할 표준 절차와 체크리스트를 보완했습니다.
Wave 2. 사용자 서비스 이전
두 번째 Wave에서는 실제 사용자가 이용하는 주요 서비스를 대상으로 마이그레이션을 진행했습니다. 이미 검증된 프레임워크를 기반으로 리허설과 기능 검증을 반복 수행하며 서비스 중단을 최소화했고, 운영 안정성을 확보하면서 본격적인 워크로드 이전을 수행했습니다.
Wave 3. EAI(Enterprise Application Integration) 서비스 이전
마지막 Wave는 외부 고객과 연계되는 EAI 서비스였습니다. EAI는 서로 다른 애플리케이션과 시스템 간의 데이터 교환을 연결해 주는 통합 서비스로, 이 시스템은 글로벌 고객사의 시스템과 주문, 재고, 배송 정보 등을 주고받는 역할을 합니다. 고객사별로 연계 방식과 데이터 형식이 달라 맞춤형으로 제공되고 있으며, 고객의 운영 일정과도 밀접하게 연결되어 있습니다. 따라서 기술적인 마이그레이션은 완료하되, 실제 서비스 전환은 고객과의 사전 협의 및 일정 조율을 거쳐 고객별로 순차적으로 진행하는 방식을 채택했습니다. 이를 통해 고객 영향도를 최소화하면서 안정적으로 서비스를 이전할 수 있도록 했습니다.
리허설 수행 및 검증
글로벌 서비스는 24시간 운영되기 때문에 컷오버를 반드시 150분 이내에 완료해야 하는 극한의 제약 조건이 있었으며, 이를 충족하기 위해 수행 방법론을 지속적으로 수정하고 리허설을 진행하며 최적화했습니다.
마이그레이션 프레임워크와 글로벌 기술 커뮤니케이션 체계를 기반으로 실제 운영 환경을 가정한 리허설을 총 5회 수행했습니다. 각 리허설에서는 복제, 애플리케이션 기동, 서비스 검증, 롤백 절차까지 전 과정을 반복 검증하며 발견된 이슈를 지속적으로 개선했습니다. 그리고 롤백 기준도 이때 정했습니다. 사용자가 들어오기 전까지는 롤백할 수 있도록 하되, 실제 사용자 트래픽이 들어오기 시작한 뒤에는 롤백하지 않기로 했습니다. 그 시점부터는 되돌리는 것보다 데이터 상태를 바로 확인하고 빠르게 조치하는 쪽이 훨씬 적은 공수로 안정화할 수 있다고 판단했기 때문입니다.
리허설을 거치며 컷오버 절차와 작업 순서를 다듬었고, 서비스별 특성을 반영한 최종 컷오버 시나리오를 완성할 수 있었습니다. 최종 컷오버는 리허설을 통해 검증된 절차에 따라 수행되었으며, 주요 서비스의 기능 검증과 안정성 확인을 거쳐 성공적으로 AWS 환경으로 전환을 완료했습니다. 반복 검증과 표준 절차는 이번 프로젝트의 리스크를 줄였을 뿐 아니라, 향후 유사한 마이그레이션에서도 재사용 가능한 운영 경험과 노하우로 축적되었습니다.
컷오버 시나리오 구성
전체 컷오버를 4개 Phase로 나눴습니다. 각 Phase에는 작업 절차뿐만 아니라 담당자와 책임 범위(R&R), 완료 조건(Exit Criteria), Go/No-Go 판단 기준, 롤백 기준을 함께 정했습니다. 이렇게 하니 컷오버 시나리오는 단순한 작업 절차서(Runbook)를 넘어, 프로젝트를 통제하는 실행 프레임워크이자 의사결정 모델 역할을 하게 됐습니다.
Phase를 기준으로 작업을 구조화하면서 모든 참여자는 현재 진행 현황과 자신의 역할을 동일한 관점에서 이해할 수 있었고, 각 Phase의 완료 시점은 자연스럽게 다음 단계로 진행할지 여부를 결정하는 기준점이 되었습니다. 또한 Phase가 진행될수록 롤백 비용이 커진다는 점도 모두가 알고 있었고, 특정 시점 이후에는 롤백보다 즉시 복구와 안정화를 우선한다는 원칙까지 사전에 합의할 수 있었습니다. 그 결과 컷오버 당일에는 개인의 경험에 의존하지 않고, 동일한 기준에 따라 신속하게 의사결정을 내릴 수 있었습니다.
Phase 1. 데이터베이스 컷오버
모든 단계 중 가장 무게감이 큰 단계입니다. DB가 넘어가기 전까지는 사실상 아무것도 시작되지 않은 것이고, DB가 넘어가고 나면 전환의 절반은 완료된 셈입니다. 롤백 비용이 가장 낮은 이 시점에 가장 무거운 작업을 배치한 것이 Phase 1의 핵심 설계 의도였습니다.
세부 순서는 다음과 같습니다.
- 서비스 중단과 트래픽 차단: IIS를 멈춰 외부 유입을 막고, EAI 배치와 작업을 모두 중지합니다. 이 시점부터 공식 다운타임이 시작됩니다.
- DB 읽기 전용 전환과 마지막 트랜잭션 로그 백업: 새 트랜잭션이 완전히 멈춘 것을 확인한 뒤 각 DB를 읽기 전용으로 바꾸고 마지막 로그를 백업합니다.
- 백업 파일 업로드와 다운로드: 백업 파일을 Amazon S3에 올리고 AWS 쪽에서 내려받습니다. 수십 개 DB를 병렬로 처리해 시간을 줄였습니다.
- AWS에서 DB 복원: 다운로드된 덤프 파일을 EC2의 SQL Server 인스턴스에 복원합니다.
- 데이터 검증: 사전에 작성한 테이블 건수 검증 쿼리로 IDC와 AWS의 데이터가 일치하는지 확인합니다.
Phase 1 완료 조건은 전체 DB의 데이터 검증 통과입니다. 이 단계에서 불일치가 발견되면 롤백을 결정합니다. Phase 1이 완료되고 나면 데이터는 AWS에 있지만, 아직 서비스는 열리지 않은 상태입니다.
Phase 2. WEB과 DB 연결 검증
운영 도메인을 바꾸기 전에 꼭 거쳐야 하는 내부 검증 단계입니다. DNS 변경은 TTL 안에서 되돌릴 수 있다고 하지만, 이미 캐시를 들고 있는 클라이언트까지 제어할 수는 없습니다. 운영 도메인을 건드리기 전에 AWS 환경이 정상인지 확인하는 것이 이 단계가 있는 이유입니다.
테스트 전용 서브도메인은 미리 AWS의 ALB를 바라보도록 만들어 두었습니다. 이 도메인으로 들어가 AWS의 WAS와 DB 사이 통신, 각 서비스의 로그인과 기본 기능을 확인했습니다. 이때 테스트는 핵심 업무 로직에 트랜잭션이 생기지 않는 범위 안에서 구성해야 합니다.
이 단계에서 실제로 규칙과 설정 값 누락을 사전에 발견할 수 있었습니다. 이 단계가 없었다면 사용자가 먼저 겪었을 문제들입니다.
Phase 2 완료 조건은 모든 서비스의 기본 기능 정상 동작입니다. 여기까지 풀리지 않는 이슈가 있으면 롤백을 결정합니다.
Phase 3. Go-Live와 UAT
내부 검증이 끝났으니 이제 DNS 레코드를 바꿔 실제 트래픽을 AWS로 돌릴 차례입니다.
고객 데이터에 트랜잭션이 생기기 시작하는 Phase 3부터는 롤백하지 않는 것으로 정했습니다. 롤백하려면 고객 데이터를 추적해 영향 범위를 파악한 뒤 되돌려야 하는데, 그보다는 오류를 바로 고치거나 해당 데이터를 직접 수정하는 편이 훨씬 효과적이기 때문입니다.
이 단계에서 가장 중요한 순서 결정은 두 가지였습니다. DNS 변경을 맨 앞에, EAI 재개를 맨 뒤에 둔 것입니다.
DNS를 먼저 바꾸는 이유는 전파에 시간이 걸리기 때문입니다. CNAME을 바꾸고 기존 캐시가 만료되기를 기다리는 동안 Amazon CloudWatch 모니터링과 성능 지표 확인을 함께 진행합니다. EAI를 마지막에 여는 이유는 그 반대입니다. 인바운드 데이터가 들어오기 시작하면 멈추기가 복잡해지므로, 다른 서비스가 안정된 것을 확인하고 가장 마지막에 엽니다.
DNS를 전환한 뒤 UAT(User Acceptance Testing)는 안쪽에서 바깥쪽으로 순서를 잡았습니다.
- 개발자 내부 검증: 서비스별 시나리오가 모두 통과하는지 확인합니다.
- 연계 시스템 담당자 테스트: 창고 관리 플랫폼, 설비 연동 시스템, 트래킹 플랫폼, SAP 같은 외부 연계 시스템을 확인합니다.
- 최종 사용자 UAT: 리전 오피스 직원과 고객사 담당자가 확인합니다.
이 순서는 문제가 생겼을 때 영향 범위를 좁히기 위한 것입니다. 개발자가 먼저 찾은 문제는 사용자에게 노출되기 전에 처리할 수 있습니다.
Phase 3 완료 조건은 모든 UAT 시나리오 통과 후, PM의 Go-Live 최종 선언입니다.
Phase 4. 마무리와 안정화
서비스는 살아났습니다. 이제 남은 일은 이 상태를 안정적으로 자리 잡게 하는 것입니다.
- DB 백업 스케줄 설정: AWS 환경에 맞춰 재설정합니다.
- 고객 완료 공지: 서비스가 정상화되었음을 안내합니다.
- DNS TTL 원복: 60초로 줄여 두었던 TTL을 86,400초로 되돌립니다.
- D+1 모니터링: 다음 날 업무 시간까지 집중해서 모니터링합니다.
DNS 변경을 빠르게 반영하려면 작업 하루 전에 TTL을 300초로, 작업 한 시간 전에 60초로 낮춰 두는 것을 권장합니다. 기존 TTL이 길게 잡혀 있었다면 그 시간만큼 앞서 낮춰야 이전 값의 캐시가 모두 만료됩니다. Go-Live 선언과 “정말 끝났다”는 판단 사이에는 간격이 필요합니다. D+1 모니터링을 마친 시점이 이번 마이그레이션의 진짜 마무리였습니다.
컷오버 결과는?
일부 준비 격차와 운영 이해도 편차로 인해 실제 컷오버는 약 200분이 걸려 목표보다 약 50분 늦어졌습니다. 일부 솔루션에서는 여러 고객사의 프로젝트를 동시에 진행하고 있어서 리허설에 충분히 참여하지 못한 개발자가 있었고, 그만큼 절차와 실제 운영 사이의 이해도에 차이가 생겼습니다. 이 차이는 컷오버 당일 그대로 드러났습니다. 리허설에는 빠짐없이 참여해서 준비해야 한다는 것을 다시 한번 느꼈습니다.
추가로 방화벽을 수십 차례 점검했음에도 오픈 이후 안정화 기간에 통신이 안 되는 문제가 계속 발생하였습니다. 오픈 후 약 1주일간은 계속해서 시스템 지표와 고객 채널을 모니터링하고 보안팀과 협업하며 즉시 조치를 취했습니다.
안정화 기간에 이관 관련 이슈가 다수 발생했습니다. 유형별로 보면 시스템 간 연계 구성, 배치 작업, 접근 설정, 신규 인프라 구성, 성능 등이었으며, 대부분 애플리케이션 결함이 아니라 환경 전환에 따른 구성 정합성 문제였습니다. 이슈들은 한꺼번에 나오지 않았습니다. 상당수는 당일이나 이틀 안에 드러났지만, 일부는 며칠이 지나서야 나타났습니다. 늦게 드러난 것일수록 영향이 컸습니다.
컷오버 당일: 옮겼다고 생각한 것이 옮겨져 있지 않았다
당일 가장 먼저 드러난 문제는 배치 작업 상당수가 옮겨지지 않은 것이었습니다. 애플리케이션 서버는 MGN으로 디스크 단위로 복제했지만, MSSQL 데이터베이스는 다운타임을 줄이기 위해 백업/복원 방식으로 옮겼습니다. 이 방식에서는 업무 데이터베이스만 대상으로 하기 때문에, SQL Server 시스템 데이터베이스(msdb, master)에 저장된 배치 작업 같은 인스턴스 수준 객체는 함께 이전되지 않습니다.
원본 환경이 살아 있어서 당일 바로 복구했지만 교훈은 남았습니다. 데이터베이스를 옮긴 것과 그 데이터베이스가 하던 일을 옮긴 것은 다릅니다. 이전 인벤토리에는 데이터뿐 아니라 스케줄 작업, 연계 정의, 로그인과 권한이 따로 항목으로 들어가야 합니다.
이틀 뒤: 늘어난 배치 실패의 실체
다음 날부터 배치 실패가 쌓이기 시작해 여러 시스템에서 적지 않은 건수에 이르렀습니다. 그런데 작업 단위로 묶어 보니 원인은 몇 개 되지 않았습니다. 한 시스템의 실패는 대부분 소수의 작업이 반복된 것이었고, 이전하기 전의 이력과 대조해 이전과 무관한 건으로 분류했습니다. 나머지는 다른 시스템을 호출하는 작업이 새 환경의 아웃바운드 허용 목록에서 빠져 있어서 생긴 것이었고, 목록을 정비해 해결했습니다.
실패 건수와 실패 원인의 수는 다릅니다. 그리고 이전하기 전에 기준값을 측정해 두지 않으면 원래 있던 문제까지 이전 탓으로 떠안게 됩니다.
며칠 뒤: 남겨둔 것과의 경계에서
1시간마다 도는 배치의 실제 수행 시간이 약 12시간까지 늘어났습니다. 작업 이력을 스텝별로 살펴보니 연계 스텝 하나가 2시간 48분을 쓰고 있었습니다. 프로시저 안을 읽기와 쓰기로 나눠 측정해 보니 읽기는 26초였고, 나머지는 모두 원격 테이블에 쓰는 시간이었습니다. 인덱스와 정렬 기준에는 문제가 없었습니다. 같은 조인을 조회(SELECT)로만 따로 실행해 보면 14초 만에 끝났지만, 같은 조건으로 갱신하면 몇 시간이 걸렸습니다.
원인은 연결된 서버(Linked Server)의 동작 방식에 있었습니다. 로컬 임시 테이블과 조인한 원격 테이블을 갱신하면, 이 작업은 원격 서버에 한 번에 넘어가지 못하고 행 단위로 처리됩니다. 같은 데이터센터 안에서는 눈에 띄지 않던 비효율이, 데이터베이스가 클라우드로 옮겨 가고 연계 대상 데이터베이스는 IDC에 남으면서 행 하나를 처리하는 데 약 3초가 걸리는 지연으로 바뀐 것입니다. 코드는 그대로였고 바뀐 것은 거리뿐이었습니다.
대상 키를 1,000건씩 묶어 원격 서버에서 직접 실행되도록 바꿨고, 같은 패턴을 쓰는 연계 데이터베이스 11개에 모두 적용했습니다. 그 결과 해당 스텝은 2시간 48분에서 29초로, 전체 배치는 약 12시간에서 6~7분으로 줄어 1시간 주기 스케줄이 정상으로 돌아왔습니다. 처리 로직이 여러 번 다시 실행해도 결과가 같도록 멱등하게 만들어져 있어 데이터 정합성에는 문제가 없었습니다. 사용자에게는 잘못된 데이터가 아니라 늦은 데이터가 보였을 뿐입니다.
이번 안정화 과정에서 가장 큰 영향을 준 문제는 AWS로 이전한 시스템과 IDC에 남아 있는 시스템 사이의 연계 구간에서 발생했습니다. 이 경험을 바탕으로 다음 프로젝트에 적용할 세 가지 기준을 정했습니다.
- 마이그레이션 대상 목록에 인스턴스 수준 객체를 포함합니다.
- 작업 전 성능 지표와 오류 발생 이력을 확보해 비교 기준을 마련합니다.
- IDC에 남아 있는 시스템과의 연계 구간을 별도로 점검하고 관리합니다.
그래서 비용은 줄었는가?
결론부터 말씀드리면, 3년 기준 운영 비용은 기존 IDC와 거의 같았습니다. 이번 프로젝트는 처음부터 비용 절감이 목표가 아니었고, 기존 IDC보다 비용이 늘어나지 않는 것이 조건이었습니다. 따라서 비용이 비슷하게 나온 것은 예상했던 결과입니다.
이유는 이전 방식에 있습니다. Lift & Shift로 기존 구조를 그대로 옮겼기 때문에, 옮겨 온 시점의 리소스는 IDC 사양 그대로입니다. IDC에서는 증설하려면 조달과 설치가 필요해서 대부분의 시스템이 여유를 크게 잡고 있었고, 그 여유분까지 함께 넘어왔습니다. 여기에 라이선스 포함 방식으로 옮겨야 했던 워크로드가 있어 라이선스 비용이 더해졌고, 비교 대상인 IDC 자산은 이미 감가상각이 꽤 진행되어 비용이 낮게 잡히는 상태였습니다.
이 수준도 저절로 나온 것은 아닙니다. Savings Plans를 적용해 맞춘 결과입니다. 온디맨드 기준이었다면 기존 IDC보다 비쌌을 것이고, 3년을 비교 기간으로 잡은 것도 약정 기간에 맞춘 것입니다. 해외 거점의 핵심 업무 시스템은 3년 안에 없어질 워크로드가 아니라서 기본 사용량을 예측할 수 있었고, 그 부분에 약정을 거는 식으로 구성했습니다.
그렇다면 같은 비용으로 무엇을 얻었는지가 판단 기준이 됩니다. 글로벌 서비스를 위한 랜딩존과 거버넌스 체계를 갖췄고, 보안 인프라를 거점별로 따로 두지 않고 공통 기반으로 배치해 이후 글로벌 계정이 추가될 때 별도 구축 없이 바로 편입할 수 있었습니다. 마이그레이션 프레임워크와 표준 운영 절차는 다음 워크로드를 옮길 때 그대로 다시 씁니다. 외부 수행사 없이 모든 과정을 직접 해냈기 때문에 운영 역량도 조직 안에 남았습니다. 또 해외 거점의 물리 서버 가운데 아직 쓸 수 있는 자원을 골라 국내로 옮겼는데, 그 규모가 수억 원에 달합니다.
비용, ‘고정’에서 ‘조정’으로
가장 큰 변화는 비용의 크기가 아니라 성격입니다. IDC에서 인프라 비용은 조달과 설치가 따라붙는 고정비였고, 줄일 방법이 사실상 없었습니다. 한 번 넉넉하게 잡은 사양을 되돌릴 수 없었기 때문입니다.
3년 약정을 걸었으니 결국 같은 것 아니냐고 볼 수도 있습니다. 하지만 묶이는 대상이 다릅니다. IDC의 고정비는 특정 하드웨어에 묶입니다. 반면 Savings Plans로 약정한 것은 시간당 사용 금액이지 특정 인스턴스 구성이 아닙니다. 그래서 약정 기간 안에서도 어떤 사양을 어떤 조합으로 쓸지는 계속 바꿀 수 있습니다. 다만 Compute Savings Plans와 EC2 Instance Savings Plans는 적용 범위가 다르니, 이런 유연성이 필요하다면 유형을 고를 때 함께 따져 보셔야 합니다.
이 차이가 다음 단계를 가능하게 합니다. 지금은 안정화 기간에 모은 사용률 지표를 근거로 인스턴스 적정화를 진행하고 있고, 이후에는 서비스 특성에 따라 컨테이너와 관리형 서비스를 쓰는 현대화로 구조 자체를 개선할 계획입니다. 실제 효율화는 이 두 단계에서 만들어집니다.
이번 단계의 비용 성과는 얼마나 줄였는가가 아니라 줄일 수 있는 상태가 되었는가입니다. IDC에서는 사용률 데이터를 보고 인프라를 조정한다는 선택지 자체가 없었고, 이제는 그 선택지가 생겼습니다.
마무리: Lift & Shift를 넘어 Cloud Native로
이번 프로젝트는 빠듯한 일정과 서비스 전환 리스크를 고려해, 기존 시스템 구조를 그대로 두고 AWS로 옮기는 Lift & Shift 방식으로 진행했습니다. 워크로드를 빠르고 안정적으로 옮기고 AWS 기반 거버넌스와 운영 체계를 세웠지만, 레거시 애플리케이션 구조와 운영 방식을 근본적으로 바꾸는 데까지는 가지 못했습니다.
지금은 마이그레이션으로 만든 랜딩존과 거버넌스를 바탕으로 CI/CD 파이프라인과 운영 프로세스를 한국 본사 표준에 맞춰 차례로 통합하고 있습니다. 앞으로는 서비스 특성에 따라 컨테이너와 관리형 서비스를 활용하는 현대화 작업도 단계적으로 진행할 계획입니다.
이번 프로젝트는 마이그레이션의 끝이 아니라, 글로벌 Cloud Native와 AI Native 환경으로 가기 위한 첫걸음이었습니다. 앞으로도 표준화와 자동화를 꾸준히 넓혀 가며 클라우드 플랫폼의 가치를 키워 나가겠습니다.
AWS SA의 한마디
이번 마이그레이션은 외부 수행사 없이 CJ대한통운이 직접 분석부터 컷오버, 안정화까지 수행한 프로젝트입니다. 30일 이상의 통신 로그로 그린 의존성 지도, 다섯 차례의 리허설, Phase별 Go/No-Go 기준으로 이어진 이번 접근 방식은 마이그레이션을 준비하는 다른 고객에게도 권하고 싶은 방식입니다. AWS는 이렇게 마련된 랜딩존과 운영 체계를 바탕으로 인스턴스 적정화, 그리고 컨테이너와 관리형 서비스 기반의 현대화로 나아가는 CJ대한통운의 다음 여정도 함께하겠습니다.
참고 자료
AWS 문서
- AWS Transform MGN 컷오버 인스턴스 시작
- AWS Transform MGN 컷오버 완료 처리
- AWS Transform MGN 이전 후 Active Directory 연결 문제
- AWS Transform MGN 명칭 변경 FAQ
- Amazon RDS for SQL Server에서 지원하지 않는 기능
- Amazon EC2 인스턴스 유형 변경
- Amazon EBS Elastic Volumes로 볼륨 수정
- Amazon Route 53 DNS 모범 사례
- Savings Plans 유형
- AWS의 Microsoft 라이선스 옵션