AWS 기술 블로그
Amazon Bedrock 및 Amazon Neptune을 이용한 미래에셋증권의 상품지식 온톨로지 및 상품AI검색 서비스구축기 ( 혁신금융서비스 )
“AI 프로젝트의 95%가 실패하는 이유는 모델이 아니라 데이터다” GenAI 프로젝트가 실패하는 원인은 대부분 모델 성능이 아니라 데이터의 준비 상태에 있습니다. MIT NANDA 보고서의 의하면 GenAI 파일럿의 95%가 AI-Ready Data 부재로 프로덕션에 도달하지 못했고, Gartner는 조직의 63%는 AI-Ready 데이터 관리 체계를 갖추지 못했다고 분석했습니다. 이러한 리서치가 보여주듯 AI-Ready Data가 준비되어 있지 않으면 기업의 AI 프로젝트는 성공하기 어렵습니다.
미래에셋증권의 PB(Private Banker)가 이런 질문을 했습니다. “A ETF의 보수율 및 벤치마크 인덱스를 알려줘”는 간단해 보이는 질문이지만, 답하려면 RDB 기반의 정형 데이터와 각종 문서 기반의 비정형 데이터를 함께 확인해야 합니다. 이 중 어느 하나라도 빠지면 답이 틀립니다. 그리고 당시에는 이 둘을 연결할 수 있는 시스템이 없었습니다.
미래에셋증권의 상품 정보는 크게 4개 영역(사내 시스템 DB, 외부 공시정보, 수작업 기반 내부 문서, 전문 리서치 자료)으로 나뉘어 관리되고 있었습니다. 이 영역들이 서로 연결되어 있지 않아 Cross-domain 검색이 불가능했습니다. ETF 시스템에서 펀드를 검색할 수 없고, 채권 시스템에서 관련 리서치를 불러올 수 없습니다. 각 시스템은 자신의 데이터만 알고 있을 뿐입니다. 가장 널리 쓰이던 검색 방식은 LIKE 검색, 즉 키워드 일치 방식이었습니다. “로봇”이라는 단어가 이름에 포함된 상품만 찾아줍니다. “휴머노이드”나 “자동화” 같은 유사 개념은 검색되지 않고, “삼성전자 자회사를 편입한 ETF”처럼 관계를 묻는 질문은 아예 불가능합니다.
현업 부서 직원들이 겪던 상품 검색의 불편함을 바탕으로, 목표로 한 검색 시나리오는 다음과 같습니다.
고객센터 A: “정확한 키워드를 입력하지 않으면 검색이 되지 않아요. 유사어나 카테고리로도 찾고 싶어요.”
목표: 의미 기반 검색, 유사어 질의
PB 직원 B: “투자대상, 보수율, 수익률을 한 번에 요약해서 보고 싶어요. 추천 사유도 함께 나오면 좋겠어요.”
목표: 관계 기반 요약, 근거 제시
마케팅팀 C: “여러 조건을 한 번에 검색할 수 없어 불편해요. 엑셀이나 BI가 아니라 대화하듯 검색하고 싶어요.”
목표: 자연어 질의, 복합 조건
상품관리 D: “오늘의 채권 추천 안내를 매일 보내는데 고객이 같은 질문을 반복해요. 대신 답해주는 시스템이면 좋겠어요.”
목표: 지식 기반 반복 질의 자동 응답
네 가지 요구는 모두 같은 Goal을 가리키고 있었습니다. 관계와 맥락을 아는 지식이 필요하며, 이를 쉽고 효율적으로 찾아볼 수 있는 AI 기반의 상품검색DB가 필요했습니다.
Target 아키텍처
위 요구사항을 해결하기 위한 지식 추출 과정과 구성에는 여러 사항이 고려되었습니다. 먼저 핵심 서비스인 Amazon Bedrock을 사용하려면 혁신금융서비스 심사와 등록이 필요했고, 이를 위한 보안 요건을 준수하여 심사를 준비했습니다. AWS Control Tower로 멀티 계정 환경을 구축하고, AWS Transit Gateway를 통해 온프레미스와 AWS 간 네트워크를 모두 Private로 구성하여 모든 서비스를 내부 네트워크로 연결했습니다.
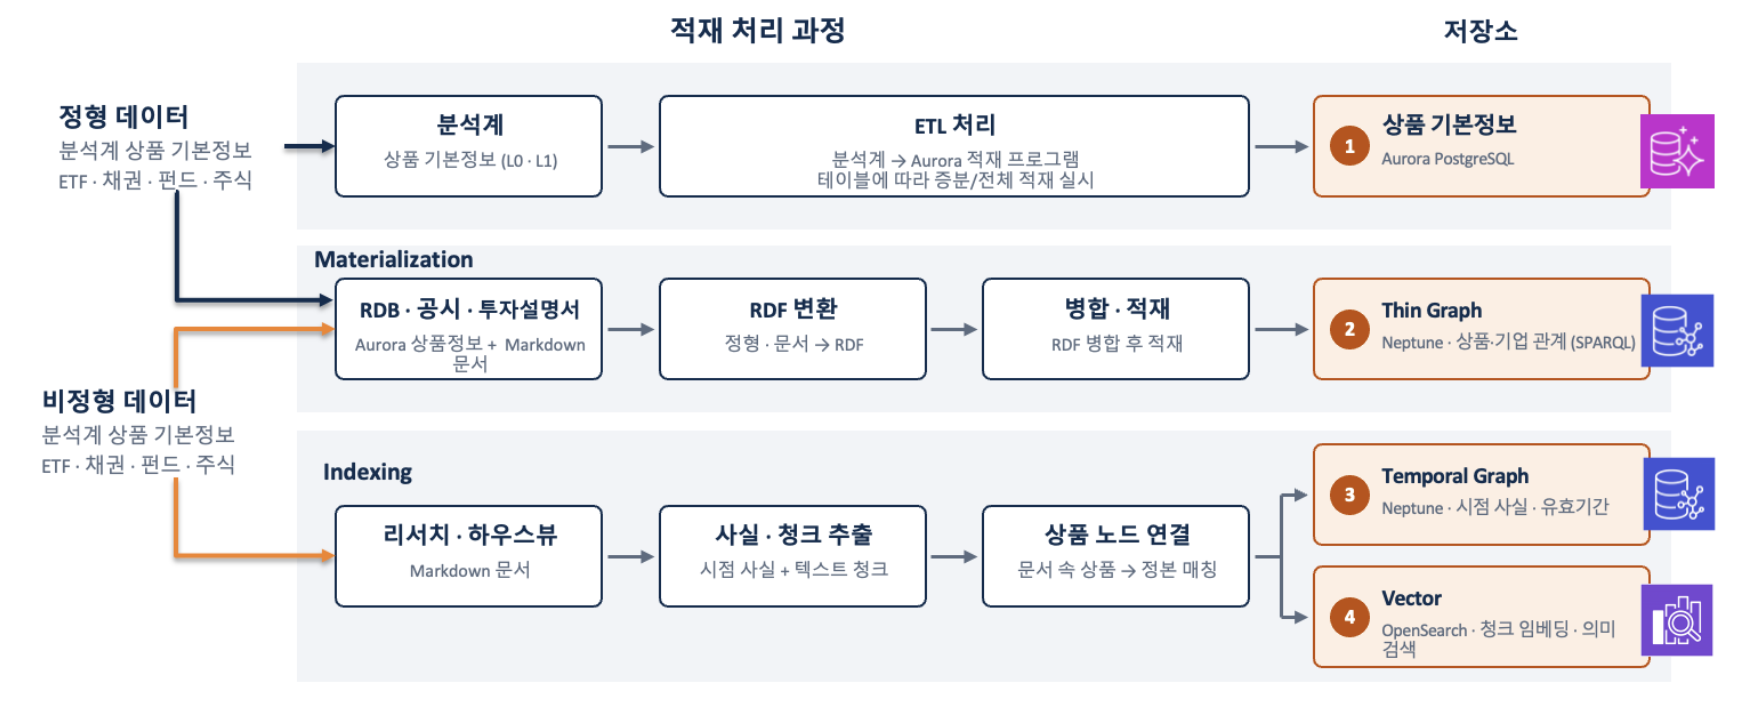 [Figure-01] 데이터와 지식 저장소 매핑
위 그림은 실제 데이터와 지식 저장소 간의 매핑을 나타냅니다. 정형 데이터인 상품 기본정보는 DB와 Thin Graph에 저장되며, PDF 등 비정형 문서는 OCR 등의 인식 과정을 거쳐 Temporal Graph와 Vector 저장소에 적재됩니다. 자세한 내용은 아래에서 소개합니다.
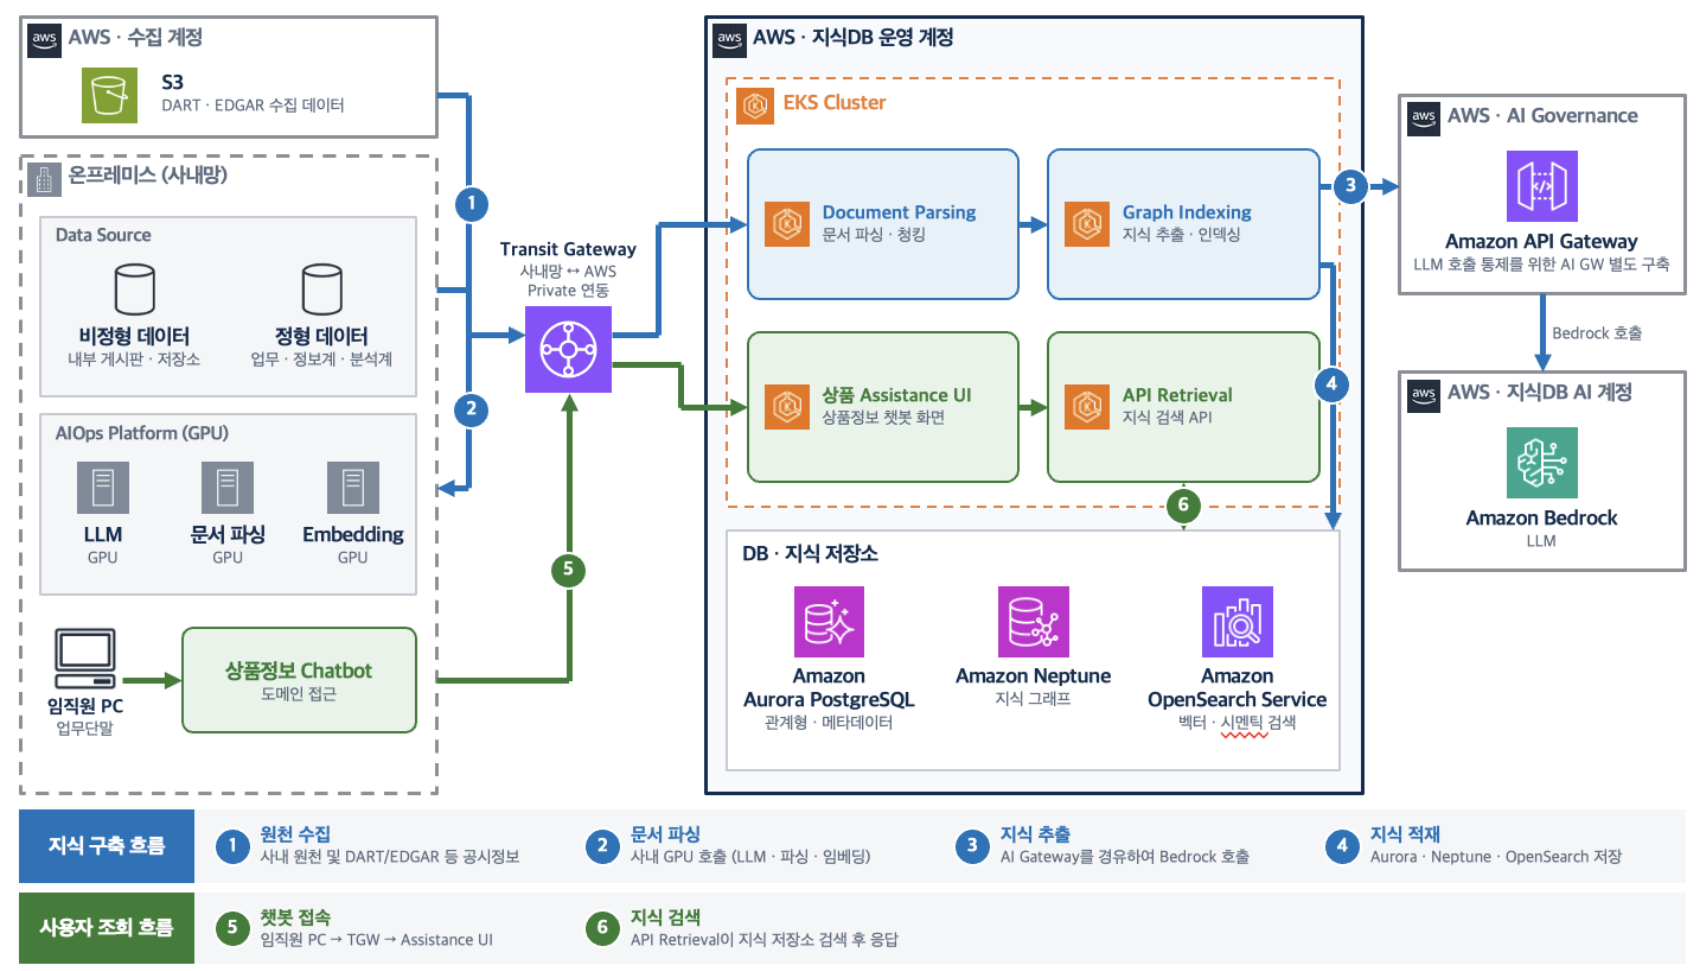
[Figure-02] 전체 논리 아키텍처
계정 및 영역 구성
| 계정 / 영역 | 구성 |
|---|---|
| AWS 데이터 플랫폼 계정 (망분리 예외 계정) | Amazon Simple Storage Service (Amazon S3)에 DART, EDGAR 등 공시 데이터 수집 |
| 온프레미스 | 정형(업무계, 정보계, 분석계) 및 비정형(사내 게시판, 저장소) 데이터, AIOps GPU 플랫폼(LLM, 문서 파싱, Embedding) |
| AWS 지식DB 운영 계정 | Amazon Elastic Kubernetes Service (Amazon EKS)(Document Parsing, Graph Indexing, Assistant UI, API Retrieval), Amazon Aurora PostgreSQL-Compatible Edition, Amazon Neptune, Amazon OpenSearch Service |
| AWS AI Governance 계정 | AI Gateway로 LLM 호출 통제 |
| AWS 지식DB AI 계정 | Amazon Bedrock의 파운데이션 모델(FM) 호출 |
지식 구축 흐름
- Step 1. 원천 수집: 사내 원천 데이터와 Amazon S3에 수집된 DART, EDGAR 공시 정보를 가져옵니다.
- Step 2. 문서 파싱: Amazon EKS의 Document Parsing 서비스가 사내 GPU 플랫폼(LLM, 파싱, 임베딩)을 호출해 문서를 Markdown으로 변환하고 청킹합니다.
- Step 3. 지식 추출: Graph Indexing 서비스가 AI Gateway를 경유해 Amazon Bedrock을 호출하고 사실과 관계를 추출합니다.
- Step 4. 지식 적재: 관계형 데이터와 메타데이터는 Amazon Aurora PostgreSQL에, 지식그래프(RDF, LPG)는 Amazon Neptune에, 벡터 및 시맨틱 검색 인덱스는 Amazon OpenSearch Service에 저장합니다. 적재는 매일 자동으로 실행됩니다.
사용자 조회 흐름
- Step 5. 챗봇 접속: 임직원 PC에서 AWS Transit Gateway를 거쳐 Amazon EKS의 상품 Assistant UI에 접속합니다.
- Step 6. 지식 검색: Agent가 API Retrieval을 호출하면, API Retrieval이 지식 저장소를 검색해 검색 결과와 근거(evidence)를 함께 반환합니다.
Amazon Bedrock 호출은 모두 자체 구축한 AI Gateway를 거치도록 해 통제 지점을 하나로 모았습니다. AI Gateway는 Bedrock을 호출하기 전에 미리 설정한 PII 데이터나 주요 정보를 탐지하고, 토큰 사용량 관리와 필요 시 모델 차단 같은 보안 조치를 적용하는 사전 차단 지점입니다. Bedrock 호출 이후에는 Amazon Bedrock Guardrails로 입력과 출력 모두에서 유해 콘텐츠나 개인정보 노출 여부를 점검해 보안 안정성을 높였습니다. 또한 혁신금융서비스 요건을 만족하는 모델이라면 아키텍처 변경 없이 즉시 교체하거나 추가할 수 있도록 설계했습니다.
프로덕션 환경은 실험 환경과 달리 보안, 성능, 가용성, 확장성 같은 까다로운 요구사항을 충족해야 하며, 장애가 곧바로 사용자에게 영향을 줍니다.
그중에서도 가장 중요한 것은 확장성입니다. 여기서 확장성은 코드가 관심사별로 명확히 나뉘어 한 곳의 수정이 다른 곳으로 번지지 않고, 기능 확장을 ‘더하기’로 해결할 수 있는 구조를 뜻합니다. 이 시스템은 네트워크, 컴포넌트 분리, 관측의 세 축에서 확장성을 갖추도록 설계했습니다.
확장성 있는 네트워크 설계
네트워크는 변경에 따른 영향이 크기 때문에 서비스마다 다른 노출 요건을 만족시키되 서비스가 늘어도 재구성을 최소화하는 구조가 필요했습니다.
이를 위해 Ingress를 같은 설정을 공유하는 공통 ingress와 구체적인 규칙을 담은 서비스별 ingress로 분리했습니다. 신규 서비스가 추가되면 같은 group.name으로 새 ingress만 생성하면 됩니다. 기존 Application Load Balancer(ALB)에 규칙이 더해질 뿐 다른 리소스는 건드리지 않으므로, 확장이 ‘더하기’로 이루어집니다.
수집 파이프라인 컴포넌트 분리
수집 파이프라인을 한 덩어리로 두지 않고 역할별로 Phase(parsing, ontology, indexing, materialization)를 분리했습니다. 이 실행 및 스케쥴에 있어서는 Argo workflow를 사용하고 있으며, 현재 Airflow로의 통합도 진행하고 있습니다.
각 Phase를 독립 패키지로 만들고 WorkflowTemplate으로 각각 실행하므로, 특정 Phase를 고쳐도 다른 Phase의 빌드와 동작이 깨지지 않습니다. 새로운 Phase가 필요하면 기존 코드 수정 없이 패키지와 WorkflowTemplate을 더하는 방식으로 손쉽게 확장할 수 있게 설계 하였습니다.
표준화되고 통합된 Observability
이 시스템은 LLM을 사용하며, 요청 하나가 Agent부터 Federated Query까지 여러 단계를 거치므로 분산 트레이싱과 메트릭에 더해 LLM 특화 관측이 반드시 필요했습니다. 프로젝트 초기에는 오픈소스인 LangFuse를 사용하여 LLM Tracing에 활용하였지만, 운영 효율성을 위하여 Amazon OpenSearch Service에 Observability를 통합하기로 결정하였습니다.
Observability는 OpenTelemetry 표준을 따라 특정 벤더에 종속되지 않는 구조로 구성했습니다. 또한 수집을 담당하는 OpenTelemetry Collector와 적재 및 가공을 담당하는 Data Prepper로 나눈 2계층 파이프라인을 택해, Data Prepper 설정만 바꾸면 백엔드를 손쉽게 교체할 수 있습니다.
로그, 메트릭, 트레이스는 Amazon OpenSearch Service 한곳에 통합했습니다. 세 정보를 한 대시보드 화면에서 볼수 있으며, 어느 단계에서 어떤 문제가 생겼는지 쉽게 파악할 수 있으며, 직접 운영하는 부담도 제거하였습니다.
문서 수집 및 파싱
지식 추출 과정에서 가장 어려운 부분은 PDF 같은 비정형 문서에서 필요한 내용을 정확히 인식해 가져오는 일입니다. 이는 최근 AI 프로젝트에서 가장 중요한 영역이기도 합니다. 이번 과제에서는 성격이 다른 4종의 문서를 수집했습니다.
- 국내 공시
- 국외 공시
- 상품 설명 문서
- 사내 리서치 문서
문서마다 원본 형식이 달라, 처리 방식도 다음과 같이 나누었습니다.
| 문서 | 원본 형식 | 처리 방식 |
|---|---|---|
| DART 반기보고서 | XML | 태그 기반 파싱 (OCR 미사용) |
| EDGAR 10-K / 497K | HTML | 섹션 파싱 (OCR 미사용) |
| 간이투자설명서 | 디지털 PDF (텍스트 레이어 포함) | 문서 파싱으로 표 구조 인식 + PDF 원문 글자 결합 |
| 리서치, 하우스뷰 | 이미지 PDF (텍스트 레이어 없음) | 문서 파싱 후 선택적 교정, 표와 차트 요약 |
공시는 XML과 HTML로 제공되므로 원본 구조를 그대로 파싱하고, PDF 문서에만 OCR(dots.mocr)을 적용했습니다. 이때 글자만 읽는 OCR이 아니라, 레이아웃 분석, 텍스트 인식, 표 구조 인식을 한 번에(End-to-End) 수행하는 VLM 기반 문서 파싱 모델을 사용했습니다. 모델이 반환한 영역 유형(본문, 표, 그림 등)에 따라 이후 처리 경로가 정해집니다. 처리 결과는 모두 YAML frontmatter(제목, 작성 부서, 게시일 등)가 붙은 Markdown으로 통일되며, 파이프라인은 매일 신규 문서를 처리합니다.
간이투자설명서: 표 구조는 파싱 모델에서, 글자는 PDF에서
간이투자설명서의 보수, 위험등급 같은 핵심 정보는 대부분 표에 있습니다. PDF 텍스트 레이어에는 글자가 정확히 들어 있지만 어느 셀에 속하는지 알 수 없고, 파싱 모델은 표 구조를 잘 잡지만 숫자 한 자리를 틀릴 수 있습니다. 그래서 모델이 인식한 표 격자에 PDF 텍스트 레이어의 글자를 좌표 기준으로 배치하고, 이 글자로 채우지 못한 셀만 VLM으로 보정했습니다.
리서치와 하우스뷰: 선택적 교정과 차트 요약
리서치와 하우스뷰 문서는 파싱 후 두 단계를 더 거칩니다. 먼저 선택적 교정은 인식 오류가 의심되는 영역만 골라 VLM으로 다시 읽어, 문서 전체를 재인식하지 않고도 오류를 고칩니다. 교정 모델로는 GPT-5.6 Luna를 적용해, 리서치 문서의 레이아웃 텍스트 387개로 구성한 정답(Ground Truth) 데이터셋 기준 글자 오류율(CER) 0.90%를 확보했습니다.
다음은 표와 차트 요약입니다. 리서치 문서에서 차트는 본문 주장을 뒷받침하는 근거 데이터를 담고 있고, 여러 계열이 겹친 선 차트나 막대와 선이 섞인 복합 차트, 좌우 이중 축 차트처럼 구조가 복잡한 경우가 많습니다. 차트 요약은 중요하지만, 이미지만 넣어 요약하면 할루시네이션이 다량 발생했습니다. 저희는 사람이 차트를 읽는 방식을 따라 요약 과정을 세 가지로 보강했습니다.
- 유형 분류와 Multi-view 이미지: 먼저 차트 유형(선, 막대, 파이, 복합 등)을 분류하고, 유형에 맞게 축과 범례 영역을 확대한 이미지와 값을 읽기 쉽도록 보조 눈금선을 덧씌운 이미지를 원본과 함께 보냅니다. 범례와 다중 축 정보를 모델이 정확히 인식하게 하기 위해서입니다.
- 문서 문맥 주입: 그림 제목, 직전 섹션 제목, 자료 출처 같은 앞뒤 텍스트와 문서 메타 정보를 함께 넣어, 차트의 주제와 단위를 문맥 안에서 해석하게 합니다.
- 적정 수준의 추론: 추론(reasoning) 강도를 단계별로 비교했습니다. 추론을 켜면 통과율이 크게 올랐지만, 가장 높은 강도에서는 과잉 추론(overthinking)으로 추세나 수치를 잘못 해석하는 오류가 늘어, medium보다 오히려 낮아졌습니다. 그래서 최종적으로 medium을 적용했습니다.
리서치 문서의 차트 88건을 고정해 두고 요약 모델과 방법을 바꿔가며 통과율(pass rate)을 비교한 결과는 다음과 같습니다.
| 단계 | 요약 모델 | 방법 | LLM Judge | 사람 검수 |
|---|---|---|---|---|
| 1 | Anthropic Claude Sonnet 4.5 | 원본 이미지만 | 20.5% | – |
| 2 | Anthropic Claude Sonnet 4.5 | OCR 텍스트 + 4분할 Multi-view + 추론(budget 4,096) | 75.0% | – |
| 3 | Qwen 3.8 Flash Next | 문서 문맥 + 유형별 Multi-view + 추론(effort medium) | 84.1% | 93.2% |
| 4 | OpenAI GPT-5.6 Sol | 문서 문맥 + 유형별 Multi-view + 추론(effort medium) | 88.6% | 98.9% |
금융 규제상 승인된 모델만 서비스에 적용할 수 있어, 초기에는 Amazon Bedrock의 Claude Sonnet 4.5로 실험했습니다. 이후 다른 모델에서의 추가 개선 가능성을 확인하기 위해 승인 전까지 Qwen 모델을 직접 서빙해 방법론을 검증했고, 이후 승인을 받은 GPT-5.6 Sol을 Amazon Bedrock으로 호출해 최종 적용했습니다. 모든 단계는 사람의 판정과 가장 정렬된 모델과 프롬프트를 LLM Judge로 사용해 같은 기준으로 비교했고, 최종 후보인 3~4단계는 사람이 한 번 더 검수했습니다. 최종적으로 차트 요약의 통과율은 사람 검수 기준 98.9%에 도달했습니다.
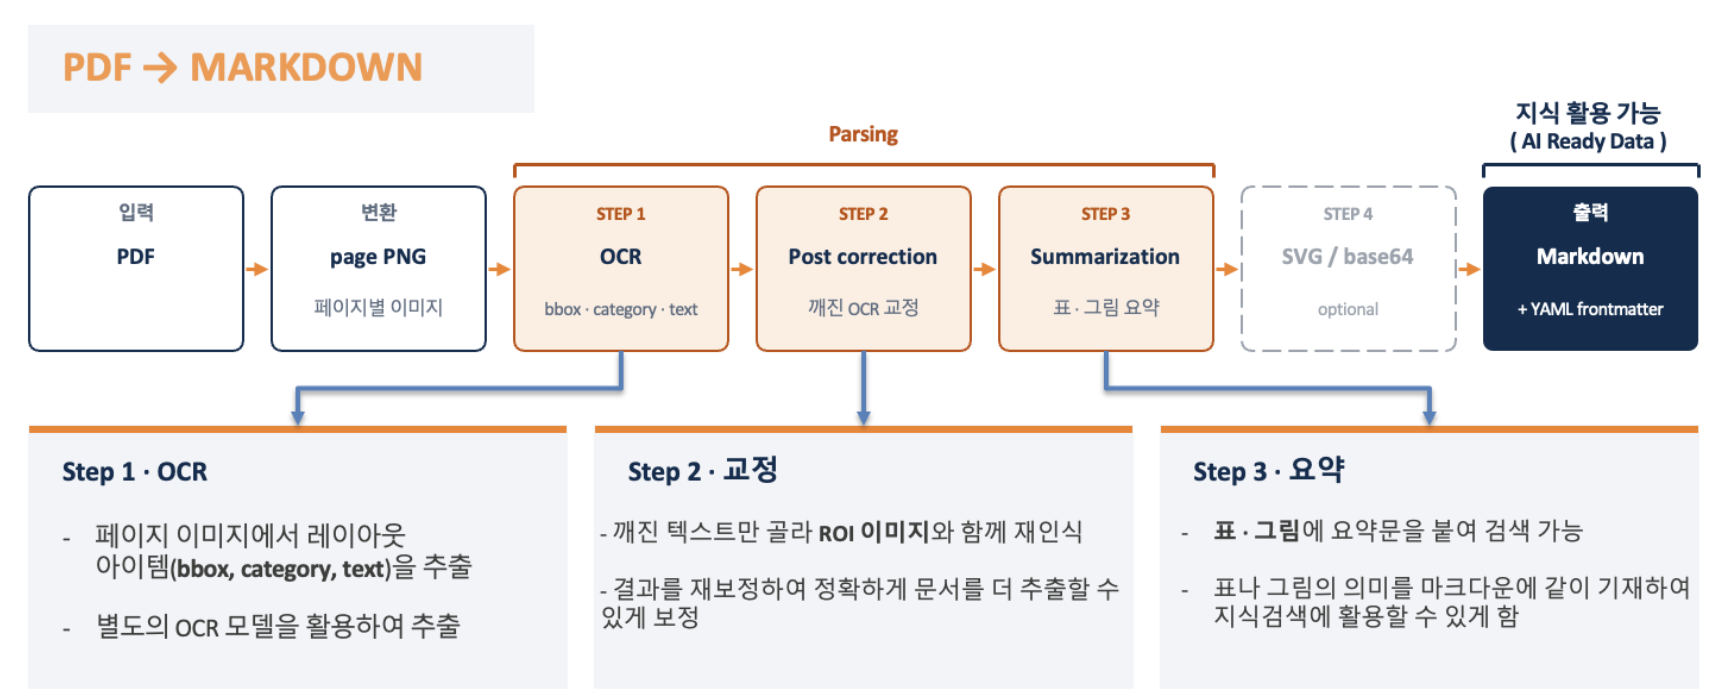
[Figure-03] 문서 변환 파이프라인
다음 장에서는 이렇게 만든 Markdown에서 사실과 관계를 추출하는 과정을 살펴봅니다.
상품지식 추출 및 적재
앞 단계에서 PDF, HTML 같은 원본 문서를 Markdown으로 변환했지만, 아직 “질문에 답할 수 있는 지식”은 아닙니다. 상품을 기준으로 데이터를 연결 해, 사용자 질문에 답할 수 있는지 지식으로 만드는 과정이 필요합니다. 이 때, 데이터에 담긴 정보의 특성에 따라, 지식화 방법과 보존할 맥락을 정합니다. 상품을 식별하고 수익률을 비교하는 데 필요한 정형 관측값, 상품의 구조를 설명하는 정의·속성, 특정 시점의 전망·의견은 검색에 필요한 정보가 서로 다릅니다.
| 원천 | 데이터 성격 | 추출 방식 | 적재 위치 |
|---|---|---|---|
| 상품 기준정보 (RDB) | 확정된 사실 | 매핑 규칙으로 RDF(Resource Description Framework) 변환 | Amazon Neptune |
| DART, EDGAR 10-K/497K, 간이투자설명서 | 확정된 사실 | 스키마에 맞춘 속성 추출 후 RDF로 변환 | Amazon Neptune |
| 리서치, 하우스뷰 | 시점이 있는 의견과 추천 | 자기완결 명제 추출과 유효기간 설정 후 LPG(Labeled Property Graph)로 변환 | Amazon Neptune, Amazon OpenSearch Service |
| 시황 리서치 | 시장과 산업 맥락 | 벡터 임베딩 | Amazon OpenSearch Service |
이 장에서는 사용자 질문을 바탕으로 온톨로지를 정의하고, 그에 맞춰 정형 데이터와 문서에서 사실과 관계를 뽑아 지식그래프와 벡터 인덱스에 적재하는 과정을 설명합니다.
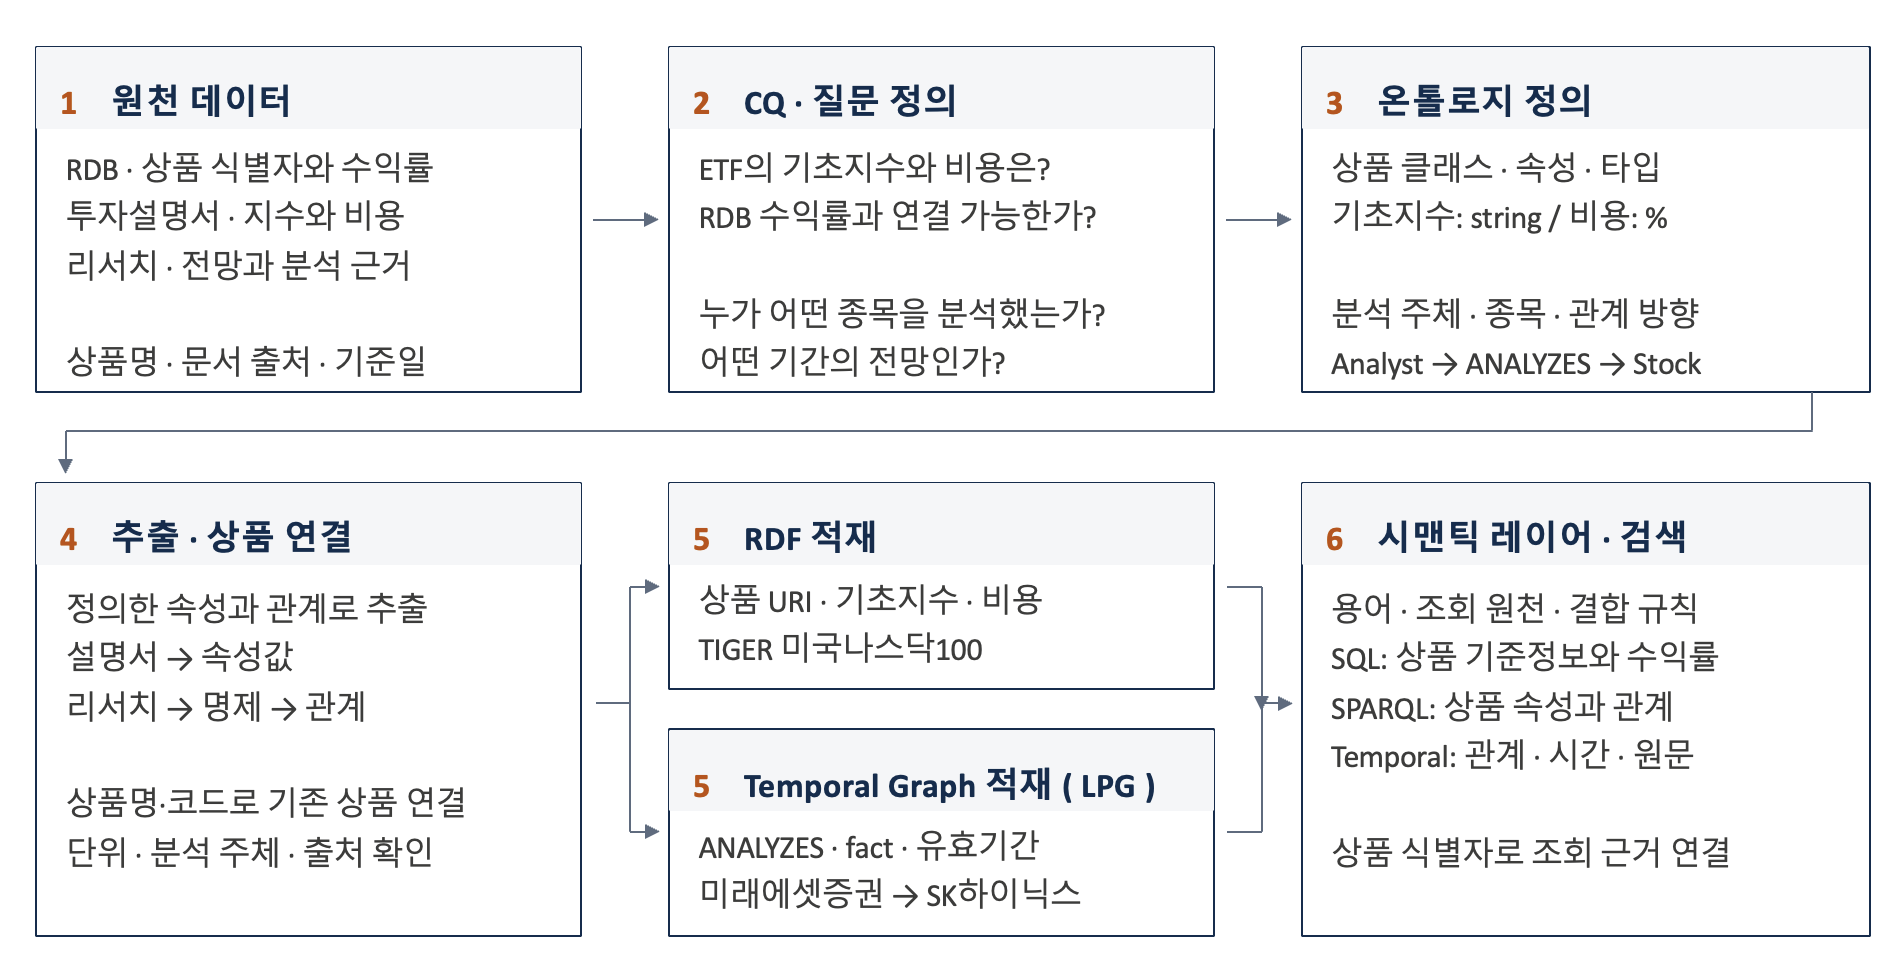
[Figure-04] 지식 추출 및 검색 과정
원천 데이터 확인
“TIGER 미국나스닥100의 기초지수, 비용과 1년 수익률은?”라는 질문에 답하기 위해, 관계형 데이터베이스(RDB)를 조회하면 상품 식별자, 상품명, 수익률이 있지만 기초지수와 비용 정보는 부족합니다.
| 업무 항목 | 조회값 | 의미 |
|---|---|---|
| 상품 식별자 | KR7133690008 | 상품을 연결할 ISIN(국제증권식별번호) |
| 상품 약칭 | TIGER 미국나스닥100 | 검색에 사용하는 상품명 |
| 기초지수 | 공백 | 기초지수 값 부재 |
| 보수 정보 | 0 | 설명서의 비용 정보로 보강할 대상 |
| 1년 수익률 | 54.50 | RDB의 수익률 관측값 |
기초지수는 공백이고 보수 정보는 문자열 “0”입니다. 이 값을 무보수로 판단하지 않고, 같은 상품의 간이투자설명서에서 기초지수와 비용을 확인합니다. 다음은 투자목적, 투자전략, 분류를 포함한 TIGER 미국나스닥100의 간이투자설명서 본문 발췌입니다.
미래에셋TIGER미국나스닥100증권상장지수투자신탁(주식) 작성기준일: 2026년 05월 21일
투자목적 미국의 나스닥증권시장에 상장된 해외주식을 주된 투자대상자산으로 합니다.
투자전략 NASDAQ OMX Group이 발표하는 “The NASDAQ-100® Index”를 기초지수로 하는 상장지수투자신탁으로서, 이 지수를 구성하는 미국 나스닥증권시장에 상장된 주식에 투자신탁 자산총액의 60% 이상 투자하여 보수차감전 투자신탁의 수익률 이 기초지수 수익률과 유사하도록 운용하는 것을 그 목적으로 합니다.
분류 투자신탁, 증권(주식형), 개방형(중도환매가능), 추가형(추가납입가능), 상장지수집합투자기구(ETF)
투자자가 부담하는 수수료 및 총보수 (단위: %)
| 클래스 종류 | 판매수수료 | 총보수 | 지정참가회사보수 | 동종유형 총보수 | 총보수·비용 |
|---|---|---|---|---|---|
| 투자신탁 | — | 0.0068 | 0.0001 | — | 0.1068 |
비교지수: The NASDAQ-100® 지수(원화환산) * 100%
RDB와 간이투자설명서를 함께 조회하면 같은 상품의 수익률, 기초지수와 비용을 확인할 수 있습니다. 상품 검색에서는 이러한 속성값 외에도 종목에 대한 전망과 판단을 다룹니다. 예를 들어 “SK하이닉스의 HBM 매출 비중을 어떻게 전망하며, 그 근거는 무엇인가?”라는 질문에는 리서치의 분석 내용이 필요합니다.
리서치의 수치는 분석 주체의 추정이나 판단일 수 있으므로, 대상 종목뿐 아니라 누가 어느 기간에 대해 어떤 근거로 제시한 값인지도 확인해야 합니다. 다음은 2026-10-06 SK하이닉스 리서치의 같은 청크에서 연속한 세 문단을 발췌한 내용입니다.
일각에서 HBM 일회성 비용이 반영될 가능성이 제기되나, 금번 실적에 미칠 영향은 제한적인 것으로 판단한다. 솔리다임 중복 상장 가능성에 대해서는 동사가 10/1 공식 입장을 통해 미확정 및 주주가치와 기업가치 최우선 원칙을 밝혔다. 중복 상장 우려에 앞서 상장설 자체가 낸드 Capa가 절실하다는 방증이라는 판단이다.
동사의 HBM 가격에 대한 우려도 과하다. 범용 D램 가격 급등으로 HBM과의 마진 격차가 생겼으나, 이를 좁히지 못하면 공급사가 HBM 대신 범용 전환을 택하게 되는 구조다. 고객도 인상을 수용할 수밖에 없다. 빅테크 ASIC향 HBM3E도 내년 가격 상승 여지가 있다. HBM 마진은 내년 추가 상승해 상당 기간 유지될 전망이다.
HBM 수요는 예상보다 강하다. 주요 GPU와 ASIC 고객의 요구 물량을 채우지 못해 업계는 증설 일정을 앞당기는 중이며, 동사의 HBM 매출 비중은 올해 15% 전후에서 내년 20%로 확대될 것으로 추정한다. 고객은 탑재량을 낮추더라도 연산침 대수를 최대화하고 있어, 향후 메모리 증산은 곧 탑재량 증가로 흡수될 전망이다.
설명서의 기초지수와 비용은 상품의 속성으로, 리서치의 HBM 매출 비중 전망은 분석 주체가 종목에 대해 제시한 의견으로 추출합니다. 다음 단계에서는 각 자료로 답해야 할 질문을 정리하고, 필요한 속성과 관계를 정의합니다.
역량질문(CQ) 정의
CQ(Competency Question, 역량질문)는 온톨로지가 답해야 하는 질문입니다. 문서 분석에서 찾은 개념·관계 후보와 RDB 스키마를 입력으로 CQ를 생성하고, 현업 질문이 있으면 함께 반영합니다.
예를 들어 앞서 인용한 투자전략에는 “The NASDAQ-100® Index”라는 값과 그 지수를 기초지수로 삼는 ETF가 등장합니다. 문서 분석에서는 ETF와 기초지수, 두 개념의 연결을 찾습니다. CQ는 이를 개별 상품의 값에서 일반화해 “ETF는 어떤 기초지수를 추적하는가?”처럼 온톨로지가 답해야 할 질문으로 표현합니다.
앞 절의 원문과 질문을 대응하면 다음과 같습니다.
| 원문 | 생성 된 CQ |
|---|---|
| 미래에셋TIGER미국나스닥100증권상장지수투자신탁(주식) 작성기준일: 2026년 05월 21일 투자목적 미국의 나스닥증권시장에 상장된 해외주식을 주된 투자대상자산으로 합니다. 투자전략 NASDAQ OMX Group이 발표하는 “The NASDAQ-100® Index”를 기초지수로 하는 상장지수투자신탁으로서, 이 지수를 구성하는 미국 나스닥증권시장에 상장된 주식에 투자신탁 자산총액의 60% 이상 투자하여 보수차감전 투자신탁의 수익률 이 기초지수 수익률과 유사하도록 운용하는 것을 그 목적으로 합니다. 분류 투자신탁, 증권(주식형), 개방형(중도환매가능), 추가형(추가납입가능), 상장지수집합투자기구(ETF) 투자비용(단위: %) 클래스 종류: 투자신탁 / 판매수수료: — / 총보수: 0.0068 / 지정참가회사보수: 0.0001 / 동종유형 총보수: — / 총보수·비용: 0.1068 비교지수: The NASDAQ-100® 지수(원화환산) * 100% |
ETF는 어떤 기초지수를 추적하는가? 운용전략은 ETF의 어떤 속성으로 모델링되는가? 총보수와 총보수·비용을 구분할 수 있는가? |
|
일각에서 HBM 일회성 비용이 반영될 가능성이 제기되나, 금번 실적에 미칠 영향은 제한적인 것으로 판단한다. 솔리다임 중복 상장 가능성에 대해서는 동사가 10/1 공식 입장을 통해 미확정 및 주주가치와 기업가치 최우선 원칙을 밝혔다. 중복 상장 우려에 앞서 상장설 자체가 낸드 Capa가 절실하다는 방증이라는 판단이다. 동사의 HBM 가격에 대한 우려도 과하다. 범용 D램 가격 급등으로 HBM과의 마진 격차가 생겼으나, 이를 좁히지 못하면 공급사가 HBM 대신 범용 전환을 택하게 되는 구조다. 고객도 인상을 수용할 수밖에 없다. 빅테크 ASIC향 HBM3E도 내년 가격 상승 여지가 있다. HBM 마진은 내년 추가 상승해 상당 기간 유지될 전망이다. HBM 수요는 예상보다 강하다. 주요 GPU와 ASIC 고객의 요구 물량을 채우지 못해 업계는 증설 일정을 앞당기는 중이며, 동사의 HBM 매출 비중은 올해 15% 전후에서 내년 20%로 확대될 것으로 추정한다. 고객은 탑재량을 낮추더라도 연산침 대수를 최대화하고 있어, 향후 메모리 증산은 곧 탑재량 증가로 흡수될 전망이다. |
HBM 매출 비중을 어느 기간에 얼마나 전망했는가? 어떤 분석 주체가 SK하이닉스를 분석했는가? |
리서치 문장의 “동사”, “올해” 등은 청크만으로 해석하지 않고 문서의 대상 종목과 기준일을 함께 확인합니다. 분석 주체도 문서 정보에서 확인합니다. 이 정보가 있어야 정보를 “SK하이닉스에 대한 미래에셋증권의 전망”이라는 완결 된 지식으로 표현할 수 있습니다.
온톨로지 정의
CQ를 정한 뒤에는 각 질문에 답하는 데 필요한 클래스, 속성, 그리고 관계를 정의합니다. “어떤 상품인가?”에는 상품 클래스와 식별자가, “기초지수는 무엇인가?”에는 기초지수 속성이, “누가 어떤 종목을 분석했는가?”에는 분석 주체와 종목을 연결하는 관계가 필요합니다.
RDB 스키마에서 상품과 식별자의 기본 정의를 만들고, 문서와 CQ를 바탕으로 기초지수·비용 등 필요한 속성을 추가합니다. 관리자는 대규모 언어 모델(LLM)이 생성한 초안의 정의, 타입, 매핑 규칙을 검토한 뒤 승인합니다.
앞에서 살펴 본 CQ에 대응하는 온톨로지 정의를 함께 보면 다음과 같습니다.
| 생성 된 CQ | 대응하는 온톨로지 요소 |
|---|---|
| ETF는 어떤 기초지수를 추적하는가? | 클래스 etf:ETF, 속성 etf:tracksIndex |
| 운용전략은 ETF의 어떤 속성으로 모델링되는가? | etf:investmentStrategyDescription |
| 총보수와 총보수·비용을 구분할 수 있는가? | common:totalFee, common:totalExpenseRatio |
| 설명서 속성을 RDB 수익률과 함께 조회할 수 있는가? | common:productCode, common:productName |
| 어떤 분석 주체가 SK하이닉스를 분석했는가? | 엔티티 유형 Analyst, Stock, 관계 (Analyst)-[ANALYZES]->(Stock) |
| HBM 매출 비중을 어느 기간에 얼마나 전망했는가? | ANALYZES 관계의 fact와 문서 출처·시간 정보 |
이를 TTL (Turtle)로 표현하면 다음과 같습니다.
etf:ETF a owl:Class .
common:FinancialProduct a owl:Class .

etf:tracksIndex a owl:DatatypeProperty ;
    rdfs:domain etf:ETF ;
    rdfs:range xsd:string .

etf:investmentStrategyDescription a owl:DatatypeProperty ;
    rdfs:domain etf:ETF ;
    rdfs:range xsd:string .

common:totalFee a owl:DatatypeProperty ;
    rdfs:domain common:FinancialProduct ;
    rdfs:range xsd:decimal .

common:totalExpenseRatio a owl:DatatypeProperty ;
    rdfs:domain common:FinancialProduct ;
    rdfs:range xsd:decimal .

common:productCode a owl:DatatypeProperty, owl:FunctionalProperty ;
    rdfs:domain common:FinancialProduct ;
    rdfs:range xsd:string .

common:productName a owl:DatatypeProperty ;
    rdfs:domain common:FinancialProduct ;
    rdfs:range xsd:string .
지식 추출
앞 단계에서 정의한 온톨로지의 속성과 관계를 실제 Markdown 문서에 적용합니다. 간이투자설명서에서는 속성에 해당하는 문구와 표의 값을 찾고, 리서치에서는 분석 대상과 주장을 식별해 명제로 정리한 뒤 관계 추출에 사용합니다.
앞서 인용한 간이투자설명서의 투자전략과 비용 표를 TBox의 속성에 대응시켜보면 다음과 같습니다.
| 실제 청크의 문구·표 항목 | 매핑한 온톨로지 속성 | 실제 추출값 |
|---|---|---|
| 미래에셋TIGER미국나스닥100증권상장지수투자신탁(주식) 작성기준일: 2026년 05월 21일 투자목적 미국의 나스닥증권시장에 상장된 해외주식을 주된 투자대상자산으로 합니다. 투자전략 NASDAQ OMX Group이 발표하는 “The NASDAQ-100® Index”를 기초지수로 하는 상장지수투자신탁으로서, 이 지수를 구성하는 미국 나스닥증권시장에 상장된 주식에 투자신탁 자산총액의 60% 이상 투자하여 보수차감전 투자신탁의 수익률 이 기초지수 수익률과 유사하도록 운용하는 것을 그 목적으로 합니다. 분류 투자신탁, 증권(주식형), 개방형(중도환매가능), 추가형(추가납입가능), 상장지수집합투자기구(ETF) 투자비용(단위: %) 클래스 종류: 투자신탁 / 판매수수료: — / 총보수: 0.0068 / 지정참가회사보수: 0.0001 / 동종유형 총보수: — / 총보수·비용: 0.1068 비교지수: The NASDAQ-100® 지수(원화환산) * 100% |
etf:tracksIndex | The NASDAQ-100® Index |
| etf:investmentStrategyDescription | 미국 나스닥증권시장 상장 주식을 자산총액의 60% 이상 편입하여 The NASDAQ-100® Index의 수익률을 추종하도록 운용합니다. | |
| common:totalFee | 0.0068 | |
| common:totalExpenseRatio | 0.1068 |
기초지수는 이름을 추출하고, 운용전략은 투자 대상·비중·운용 목적을 설명하는 문장으로 정리합니다. 비용은 숫자와 함께 표의 열 이름·단위를 확인합니다. 0.0068은 0.0068%이며, 별도 열에 있는 지정참가회사보수를 더하지 않습니다. 기초지수와 비교지수도 구분해 각각 tracksIndex, benchmarkedAgainst에 매핑합니다.
리서치 문서 역시, 앞서 인용한 SK하이닉스 리서치 문서의 원본 청크에서 명제를 추출하고, TBox의 속성에 대응시키면 다음과 같은 결과를 얻을 수 있습니다.
| 실제 청크의 문구·표 항목 | 매핑한 온톨로지 속성 | 실제 추출값 |
|---|---|---|
|
일각에서 HBM 일회성 비용이 반영될 가능성이 제기되나, 금번 실적에 미칠 영향은 제한적인 것으로 판단한다. 솔리다임 중복 상장 가능성에 대해서는 동사가 10/1 공식 입장을 통해 미확정 및 주주가치와 기업가치 최우선 원칙을 밝혔다. 중복 상장 우려에 앞서 상장설 자체가 낸드 Capa가 절실하다는 방증이라는 판단이다. 동사의 HBM 가격에 대한 우려도 과하다. 범용 D램 가격 급등으로 HBM과의 마진 격차가 생겼으나, 이를 좁히지 못하면 공급사가 HBM 대신 범용 전환을 택하게 되는 구조다. 고객도 인상을 수용할 수밖에 없다. 빅테크 ASIC향 HBM3E도 내년 가격 상승 여지가 있다. HBM 마진은 내년 추가 상승해 상당 기간 유지될 전망이다. HBM 수요는 예상보다 강하다. 주요 GPU와 ASIC 고객의 요구 물량을 채우지 못해 업계는 증설 일정을 앞당기는 중이며, 동사의 HBM 매출 비중은 올해 15% 전후에서 내년 20%로 확대될 것으로 추정한다. 고객은 탑재량을 낮추더라도 연산침 대수를 최대화하고 있어, 향후 메모리 증산은 곧 탑재량 증가로 흡수될 전망이다. |
common:Analyst | 미래에셋증권 |
| stock:Stock | SK하이닉스 | |
| common:Analyzes | 미래에셋증권은 SK하이닉스의 HBM 매출 비중은 올해 15% 전후에서 내년 20%로 확대될 것으로 추정했다. |
상품 연결과 적재
문서에서 추출한 상품 정보와 관계를 RDB 상품 기준정보에 연결합니다. 상품명이 서로 다르게 표기되어도 동일 상품의 속성과 리서치를 함께 조회하려면 이 연결이 필요합니다.
RDB 상품 기준정보는 승인된 TBox와 매핑 규칙에 따라 RDF 인스턴스로 변환합니다. RDF(Resource Description Framework)는 정보를 주어–서술어–목적어로 표현합니다. ISIN을 상품 인스턴스 식별자로 사용하고, 설명서의 상품명 등을 대조해 추출값을 기존 상품 URI에 연결합니다. 이 예시에서는 상품 etf:KR7133690008이 주어, 기초지수 속성이 서술어, “The NASDAQ-100® Index”가 목적어입니다.
etf:KR7133690008 a etf:ETF ;
common:productCode "KR7133690008" ;
etf:tracksIndex "The NASDAQ-100® Index" ;
common:totalFee 0.0068 ;
common:totalExpenseRatio 0.1068 .
리서치에서도 대상 종목인 SK하이닉스를 기존 상품 마스터에 연결합니다. 관계의 fact에는 분석 내용과 근거를, 메타데이터에는 문서 출처와 유효기간을 기록합니다.
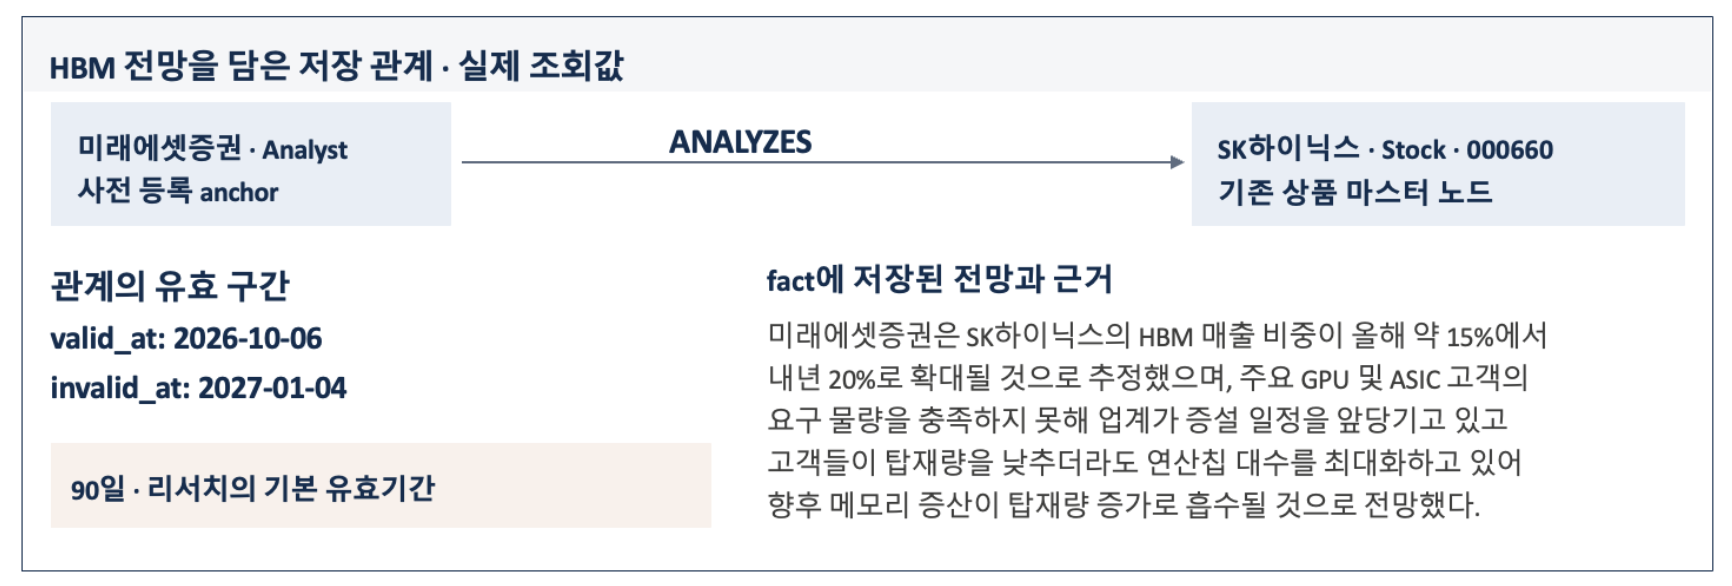
[Figure-05] 문서 저장시의 유효기간 설정
분석 주체는 미래에셋증권, 대상은 기존 상품 마스터의 SK하이닉스(000660), 관계 유형은 ANALYZES입니다. HBM 매출 비중 전망과 근거는 fact에 저장되어 있습니다. valid_at은 2026-10-06, invalid_at은 2027-01-04입니다. 이 90일은 리서치 지식을 검색에 사용하는 기본 유효기간이며, 전망의 대상 기간인 “내년”과 다릅니다. 중복·상충 판정으로 관계를 관리하고, 관계는 Amazon Neptune의 속성 그래프에, fact 검색 인덱스와 원문 청크는 Amazon OpenSearch Service에 저장합니다.
시맨틱 레이어 설정
지식그래프에 사실이 있어도, 사용자가 쓰는 말과 데이터의 구조는 다릅니다. “국내 ETF”를 예로 들면, 업무에서는 국내에 상장된 ETF 전체를 뜻합니다. 그런데 이름만 보고 국내 주식형 ETF로 해석하면 미국 지수를 추종하는 국내 상장 ETF가 결과에서 빠집니다. 시맨틱 레이어는 이런 차이를 명시적으로 기록해 Agent가 질문을 정확한 조회로 바꾸도록 돕는 층입니다. 보다 구체적으로, 시맨틱 레이어에는 용어의 의미, 조회할 데이터 원천, 속성 매핑, 조회 결과의 결합 규칙 등을 정의합니다.
| 구성 | 담는 내용 | 예 |
|---|---|---|
| 업무 규칙 | 업무 용어의 정의와 기본 조건 | “국내 ETF” = 국내 상장 ETF 전체 |
| 속성 사전 | 사용자 표현과 실제 속성 및 컬럼의 대응 | “월분배”는 분배 주기 속성으로 해석 |
| 스키마 설명 | 컬럼의 의미, 단위, 주의점 | 수익률 컬럼의 기간과 단위 |
| 관계 질의 경로 | 상품 경계를 넘는 질문의 그래프 경로 | “자회사를 편입한 ETF”는 기업, 자회사, 주식, ETF 순으로 탐색 |
| 이름 별칭 | 고객이 부르는 이름과 정식 식별자 | “네이버”는 NAVER, “슈드”는 SCHD |
| 질의 예시 | 질문 유형별 모범 질의 | 다중 조건 채권 검색 예시 |
앞서 살펴본 예시에서 정의하고 추출한 지식을 조회하기 위해서는, 다음과 같은 도메인 규칙이 시맨틱 레이어에 정의되어야 합니다.
| 업무 용어 | 조회할 RDF 속성 |
|---|---|
| 기초지수 | etf:tracksIndex |
| 비용 | common:totalExpenseRatio 우선, 없으면 common:totalFee |
비용 조회는 총보수·비용을 우선하고, 값이 없으면 총보수를 사용합니다. 두 속성도 조회 결과에 별도로 유지해 어떤 지표인지 확인할 수 있도록 합니다. 이 때, RDB 결과와 RDF의 결합 규칙은 RDB의 ISIN ↔ etf:{ISIN}입니다.
다음 장에서는 Agent가 시맨틱 레이어를 기반으로 사용자 질문을 해석하고, 연결된 지식에서 근거를 찾아 답하는 과정을 살펴봅니다.
상품검색 Assistant Agent
앞에서 구축한 지식을 사용자에게 잘 전달하려면, 검색 질의가 들어왔을 때 어떤 맥락에서 무엇을 찾아야 하는지, 어떤 순서로 검색하고 답할지를 Agent가 상황에 맞게 판단해야 합니다. 그래서 역할을 둘로 나눴습니다. Assistant Agent는 대화 맥락을 관리하고 검색 계획을 세운 뒤, 돌아온 근거를 종합해 출처와 함께 답변을 작성합니다. 상품 검색 Agent는 RDB, Vector DB, Graph DB 중 어디를 어떻게 탐색할지 정하고 근거와 출처를 돌려줍니다. 상품 검색 Agent는 대고객 챗봇 같은 다른 Agent도 함께 쓰는 검색 플랫폼 역할을 합니다.
초기 버전을 운영하며 답변 정확도를 떨어뜨린 원인을 분석해 보니 크게 다섯 가지 유형이 있었습니다.
| 문제 유형 | 문제가 된 부분 | 설계 원칙 | 적용 방식 |
|---|---|---|---|
| 검색 전 선판단 | 검색 전에 LLM이 답을 짐작해 검색 범위를 좁힘 | 특화 Agent Orchestration | Planner는 검색 계획만 수립 |
| 멀티턴 대상 유실 | 앞 턴의 상품이나 종목이 빠진 채 검색 | 재질의 가이드 | 불분명한 요청은 앞 턴 대화 내용을 활용 |
| 복잡한 질의 해석 | 여러 대상과 조건이 섞인 질문을 한 번에 검색 | 중간 판단 | 단계별 결과를 확인한 뒤 다음 단계 판단 |
| 도메인별 특성 | 상품 도메인마다 다른 용어와 표시 규칙 | 시맨틱 레이어 활용 | 정식 명칭과 도메인별 표시 정책을 저장해 사용 |
| 검색 후 지식 추가 | 근거에 없는 LLM 사전 지식이 섞임 | 원문 보존 | Writer는 근거 원문 그대로 인용 |
이 원칙을 반영해 Assistant Agent를 Planner, Executor, Writer(P-E-W) 세 Agent로 나눈 구조로 설계했습니다. 검색 계획, 실행, 답변 작성을 분리해 각 단계가 자기 역할만 하도록 만든 것입니다.
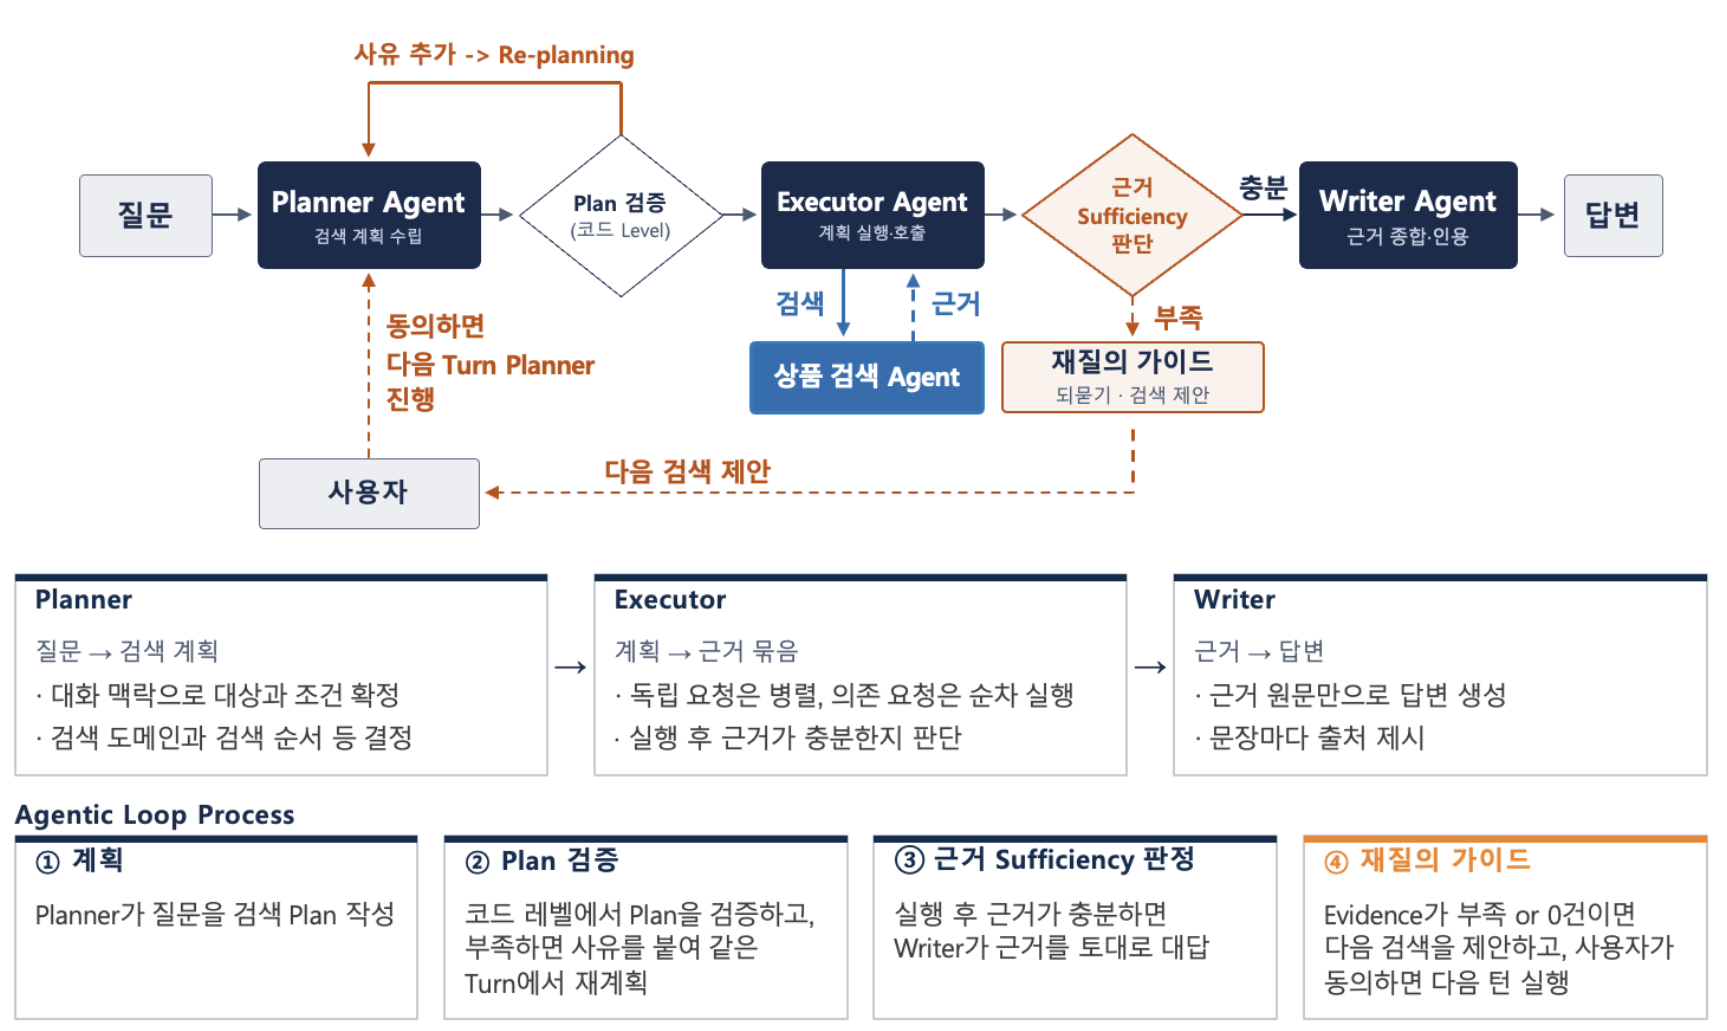
[Figure-06] 상품 검색 Agent의 동작 구조
| 구성 | 입력 | 출력 | 하는 일 |
|---|---|---|---|
| Planner Agent | 질문 | 검색 계획 | 대화 맥락으로 대상과 조건을 확정하고, 검색 도메인과 순서를 결정 |
| Executor Agent | 검색 계획 | 근거 묶음 | 독립 요청은 병렬로, 의존 요청은 순차(Wave)로 실행한 뒤 근거가 충분한지 판단 |
| Writer Agent | 근거 묶음 | 답변 | 근거 원문만으로 답변을 작성하고 문장마다 출처를 제시 |
세 Agent는 하나의 Agentic Loop로 묶여 동작합니다.
- 계획: Planner가 질문을 검색 Plan으로 작성합니다.
- Plan 검증: 코드 레벨에서 Plan을 검사하고, 어긋나면 사유를 붙여 같은 턴 안에서 다시 계획하게 합니다.
- 근거 충분성(Sufficiency) 판정: 실행 후 근거가 충분하면 Writer가 그 근거만으로 답합니다.
- 재질의 가이드: 근거가 부족하거나 0건이면 답을 지어내지 않고 다음 검색을 제안합니다. 사용자가 동의하면 다음 턴에서 실행합니다.
주요 답변 예시
P-E-W 구조는 기존 시스템으로는 한 번에 답할 수 없던 복합 질의에서 특히 효과를 보입니다. 실제 질의를 세 가지 유형으로 소개합니다.
- 기준일10.15 이며, 현재 시황과는 차이가 있습니다.
Type 1. 단일 주제 복합 질의
“S&P500을 추종하는 ETF 중에 AUM 높은 순으로 알려줘. 그리고 수익률로 비교해줘”
Planner는 ‘S&P500 추종’을 ETF 속성 조건으로 바꿔 검색 1건으로 계획합니다. 순자산 정렬과 기간별 수익률 비교가 검색 한 번에 처리되고, Writer는 10종 비교표에 “순자산 1위 TIGER 미국S&P500(21조 3억원)은 2위 KODEX 미국S&P500의 약 2배이며, 환헤지형 KODEX 미국S&P500(H)의 1년 수익률이 +13.02%로 가장 높다”는 해석을 붙여 답합니다. 계획부터 답변까지 약 20초가 걸립니다.
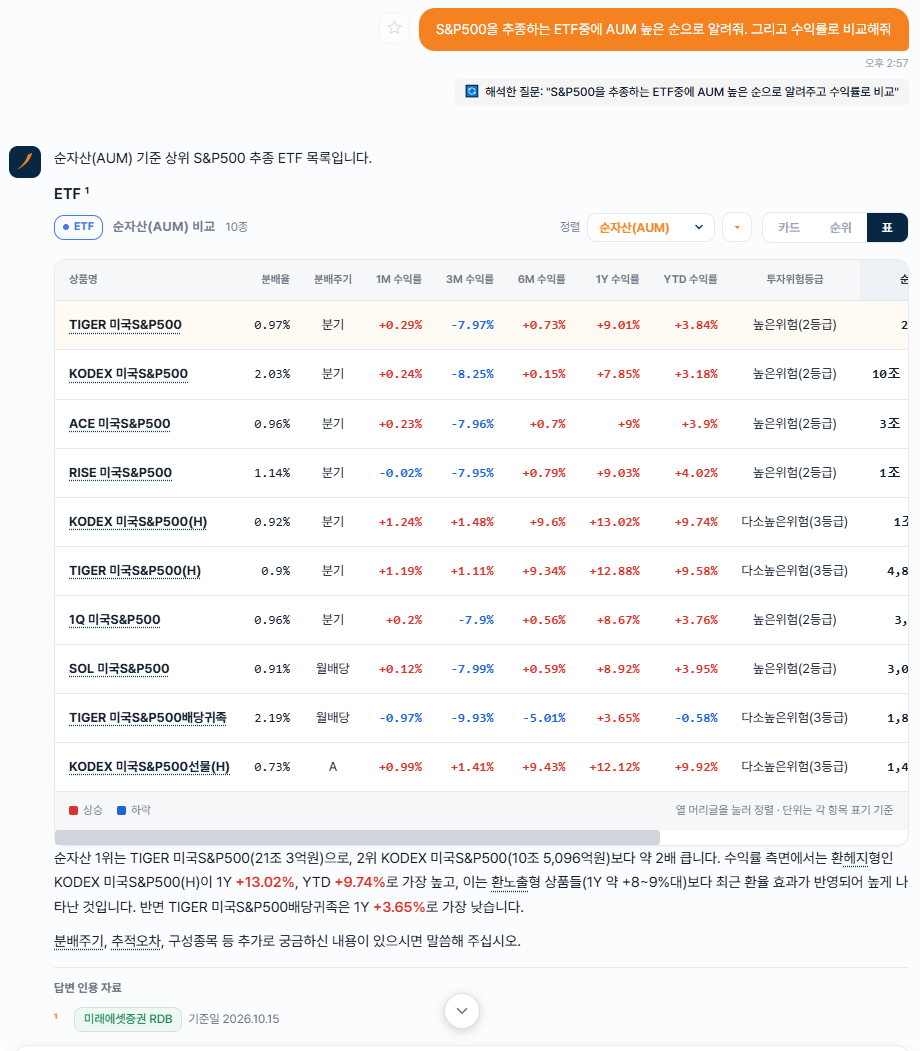
[Figure-07] Type 1: 단일 주제 복합 질의
Type 2. 다중 주제 복합 질의 (Cross Domain)
“현대자동차 어제 종가와 관련 ETF 상품 알려줘”
주식과 ETF 두 도메인에 걸친 질문입니다. Planner는 상대 시간인 ‘어제’를 실제 날짜(2026-10-15)로 바꾸고, 서로 의존하지 않는 두 검색을 병렬로 실행하도록 계획합니다. 주식 검색은 전일 종가 295,500원과 PER, 배당수익률을, ETF 검색은 현대차를 편입한 ETF 7종(비중 1위 RISE 현대차고정피지컬AI, 22.95%)을 근거로 돌려주고, Writer가 이를 도메인별 표로 나눠 정리합니다.
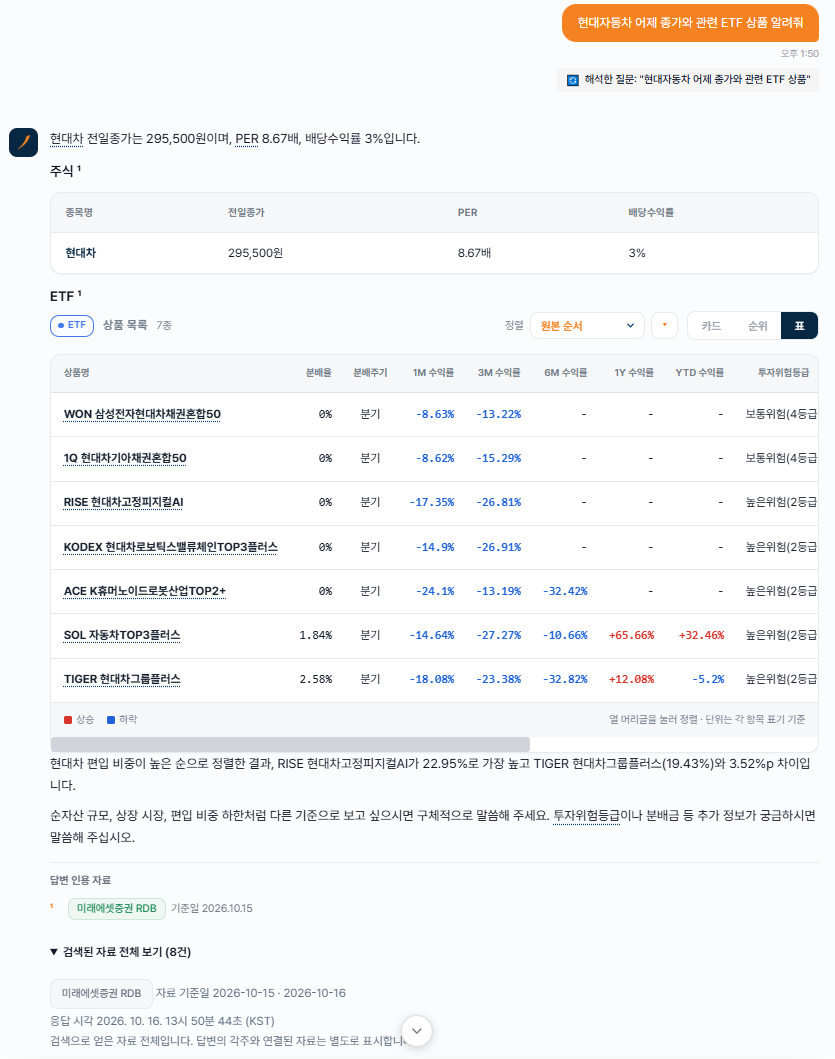
[Figure-08] Type 2: 다중 주제 복합 질의 (Cross Domain)
Type 3. 다중 주제 순차 질의
“반도체 ETF 중에 AUM 높은 순으로 정렬해서 최근 수익률 비교해주고, 이 ETF들에서 편입 비중이 가장 높은 2개 종목을 찾아 향후 전망에 대한 리서치를 찾아봐줘”
앞 단계의 결과가 있어야 다음 검색을 만들 수 있는 질문입니다. Planner는 3단계 순차 계획을 세우고, Executor가 이를 Wave 단위로 실행합니다.
- Wave 1: 반도체 ETF 10종을 순자산 순으로 찾고 최근 수익률을 비교합니다(1위 TIGER 반도체TOP10, 8조 1,673억원).
- Wave 2: 찾은 ETF마다 ‘비중 상위 종목’ 검색을 만들어 실행하고, 공통 비중 1~2위인 삼성전자와 SK하이닉스를 뽑습니다(TIGER 반도체TOP10 기준67%, 24.92%).
- Wave 3: 두 종목의 향후 전망 리서치(2026년 5~9월)를 검색합니다.
- Writer: 수익률 비교표와 리서치 요약을 작성하고, RDB, 리서치, 지식DB 출처 7건을 인용합니다.
사람이라면 시스템 여러 곳을 오가며 엑셀로 정리해야 했을 작업을, Agent는 약 1분 안에 근거와 함께 답합니다.
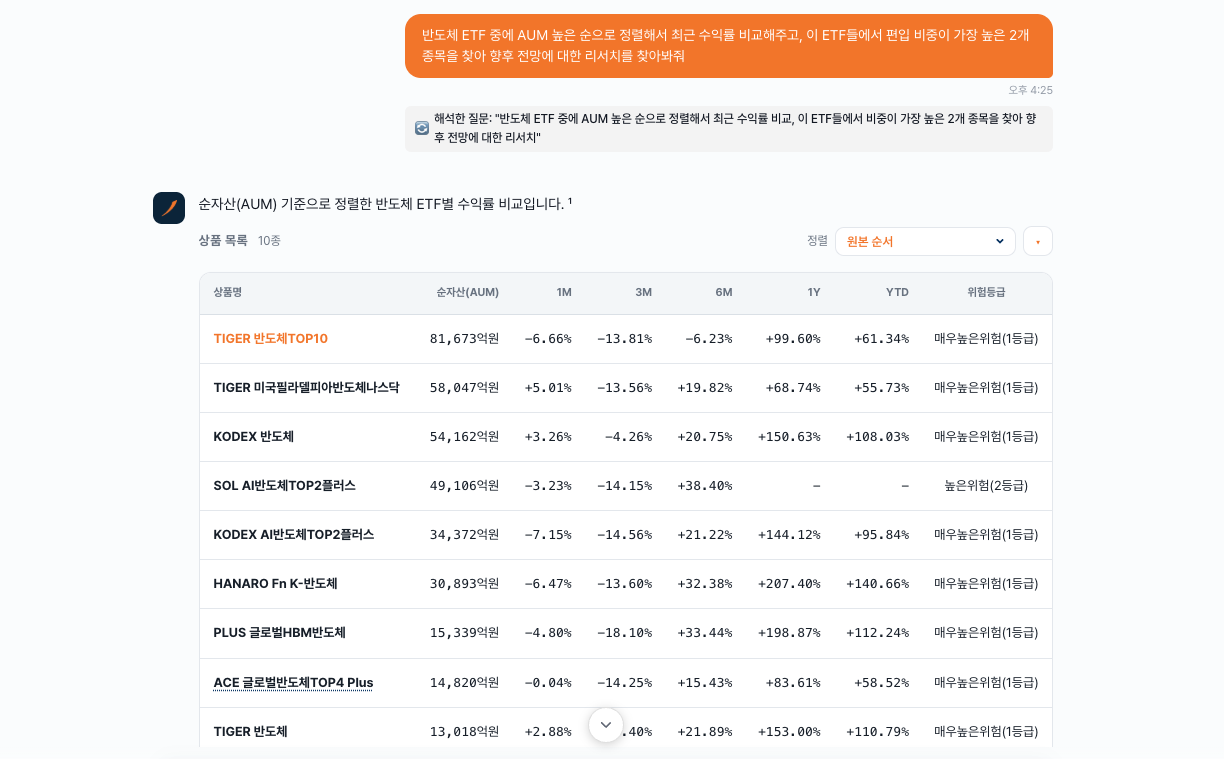
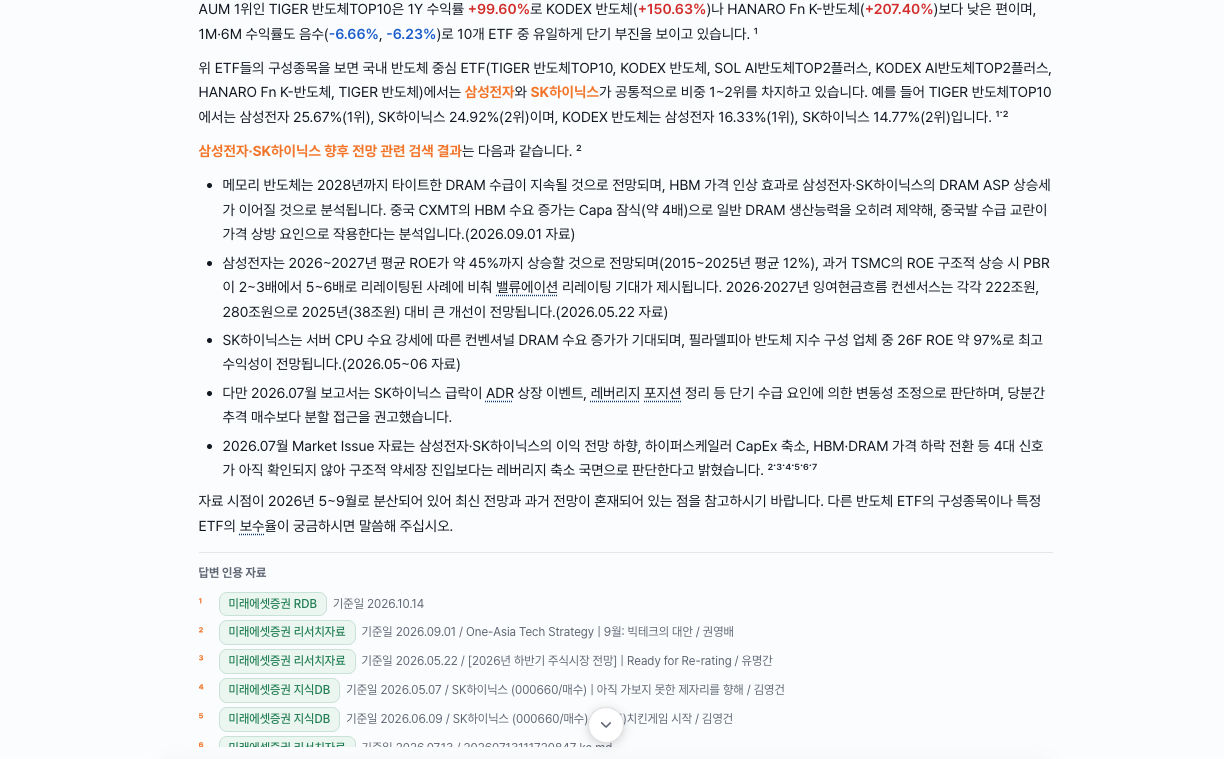
[Figure-09] Type 3: 다중 주제 순차 질의
확장 가능한 Agent 모듈 표준화
상품 외의 업무 영역으로도 확장할 수 있도록 Agent 모듈을 세 계층으로 나눴습니다. P-E-W 루프, Plan 검사 장치(Policy 게이트), 인용 Writer는 고정(Static) 모듈로 수정 없이 재사용합니다. 도메인별 검색 및 표시 정책과 용어집(Glossary)은 교체(Dynamic) 모듈이어서, 세금이나 법률 같은 새 업무를 붙일 때는 이 부분만 바꾸면 됩니다. 재질의 가이드, 역할별 LLM Fallback, Trace 연결, 모니터링은 모든 Agent가 함께 쓰는 공통(Common) 모듈입니다.
평가 체계와 답변 정확도 개선
Agent를 바꿀 때마다 품질이 실제로 좋아졌는지 확인하기 위해 자체 평가 시스템을 만들었습니다. 6개 시나리오 묶음(기준 질문, 채권 조건 검색, 별칭과 복합 요청, 현업 인터뷰, 지원 불가 및 근거 부족 등)으로 구성한 250개 질문을 3회씩 독립 실행하고, 정적 검사 4개 항목과 LLM Judge 26개 항목(정확성, 근거 확보, 근거 충실성, 설명 책임, 요구 충족, 일관성, 안전 및 정책)으로 채점합니다. 판정 원칙은 엄격하게 두었습니다.
- 한 회차의 중대한 오류를 다른 회차의 평균으로 덮지 않도록, 3회 점수의 중앙값으로 판정합니다.
- 검색 계층과 답변 계층 중 낮은 점수를 종합 점수로 씁니다.
- 관측하지 못한 항목은 임의 점수로 채우지 않습니다.
PoC부터 2차 고도화까지 다섯 번 측정한 결과는 다음과 같습니다.
| 측정일 | 단계 | 평균점수 (0~1) | 첫 답변 토큰 (초) |
|---|---|---|---|
| 03.26 | EBA (PoC) | 0.450 | 28.68 |
| 06.30 | 1차 오픈 | 0.419 | 29.15 |
| 08.26 | 2차 오픈 (Amazon Bedrock, Single Agent) | 0.523 | 22.72 |
| 09.11 | 1차 고도화 (Multi Agent 전환) | 0.623 | 25.13 |
| 10.18 | 2차 고도화 | 0.828 | 21.41 |
평균점수는 0.450에서 0.828로 84% 올랐고, 첫 답변 토큰까지의 시간은 28.68초에서 21.41초로 25% 줄었습니다. 9월 Multi Agent(P-E-W) 전환으로 정확도가 크게 올랐고, 10월 2차 고도화에서는 정확도와 응답 속도를 함께 개선했습니다.
첫 답변 토큰까지 20초 이상이 걸리는 것은 Planner가 계획을 세우고, 상품 검색 Agent가 여러 저장소를 검색해 근거를 모은 뒤, Writer가 답변을 작성하기까지 여러 단계를 거치기 때문입니다. 금융권 보안 요건에 따른 AI Gateway와 Amazon Bedrock Guardrails 점검 시간도 포함되어 있습니다. 앞으로 경량 모델과 신규 모델을 조합해 응답 시간을 더 줄일 계획입니다.
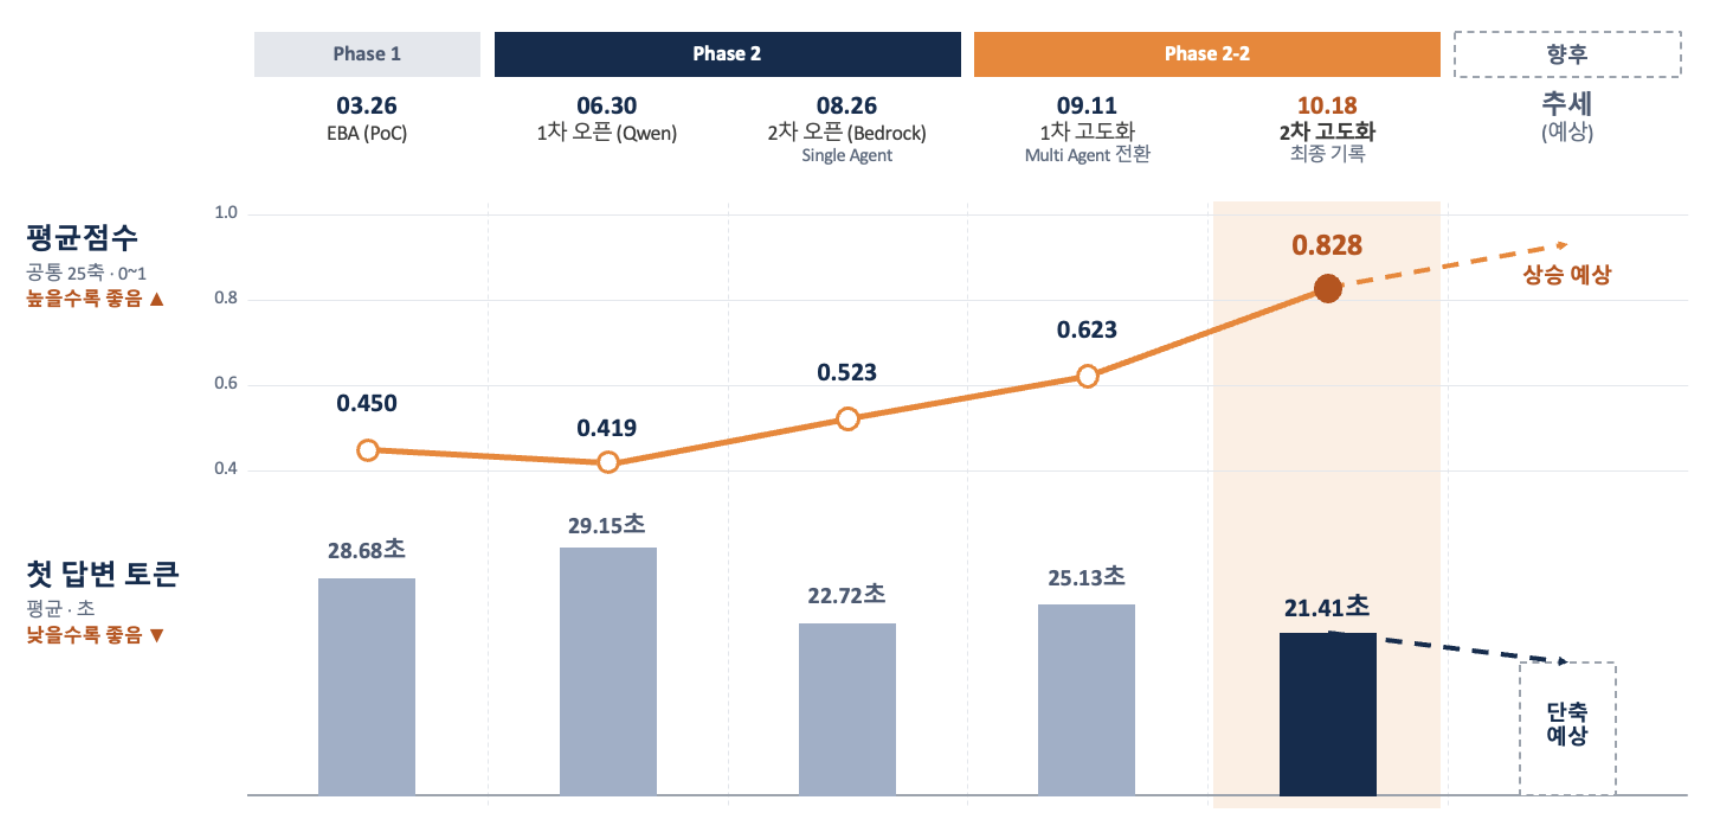
[Figure-10] 평균점수와 첫 답변 토큰 시간 추이
마치며
이 글의 처음에 “AI 프로젝트가 실패하는 이유는 모델이 아니라 데이터”라고 이야기했습니다. 이번 프로젝트는 그 의미를 다시 한번 확인하는 과정이었습니다. 흩어져 있던 상품 DB와 공시, 설명서, 리서치 문서를 온톨로지로 연결해 지식으로 만들었고, 그 위에 근거와 출처를 함께 제시하는 Agent를 개발했습니다. 그 결과 상품 지식 검색은 2026년 8월 미래에셋증권의 1호 혁신금융서비스로 실제 운영에 들어갔고, PB를 중심으로 450명 이상의 사용자가 2,000건이 넘는 복합 질의에 활용하고 있습니다.
아래와 같이 기존 검색에서는 답변하지 못한 부분을 시맨틱 레이어와 온톨로지 등으로 관계를 이해하고 정확하게 질의를 해석하여 답변을 할 수 있게 만들었습니다. 그리고 이를 통한 답변의 정확도 및 가장 중요한 잘못된 정보로 대답할 수 있는 할루시네이션을 대폭 완화하였습니다.
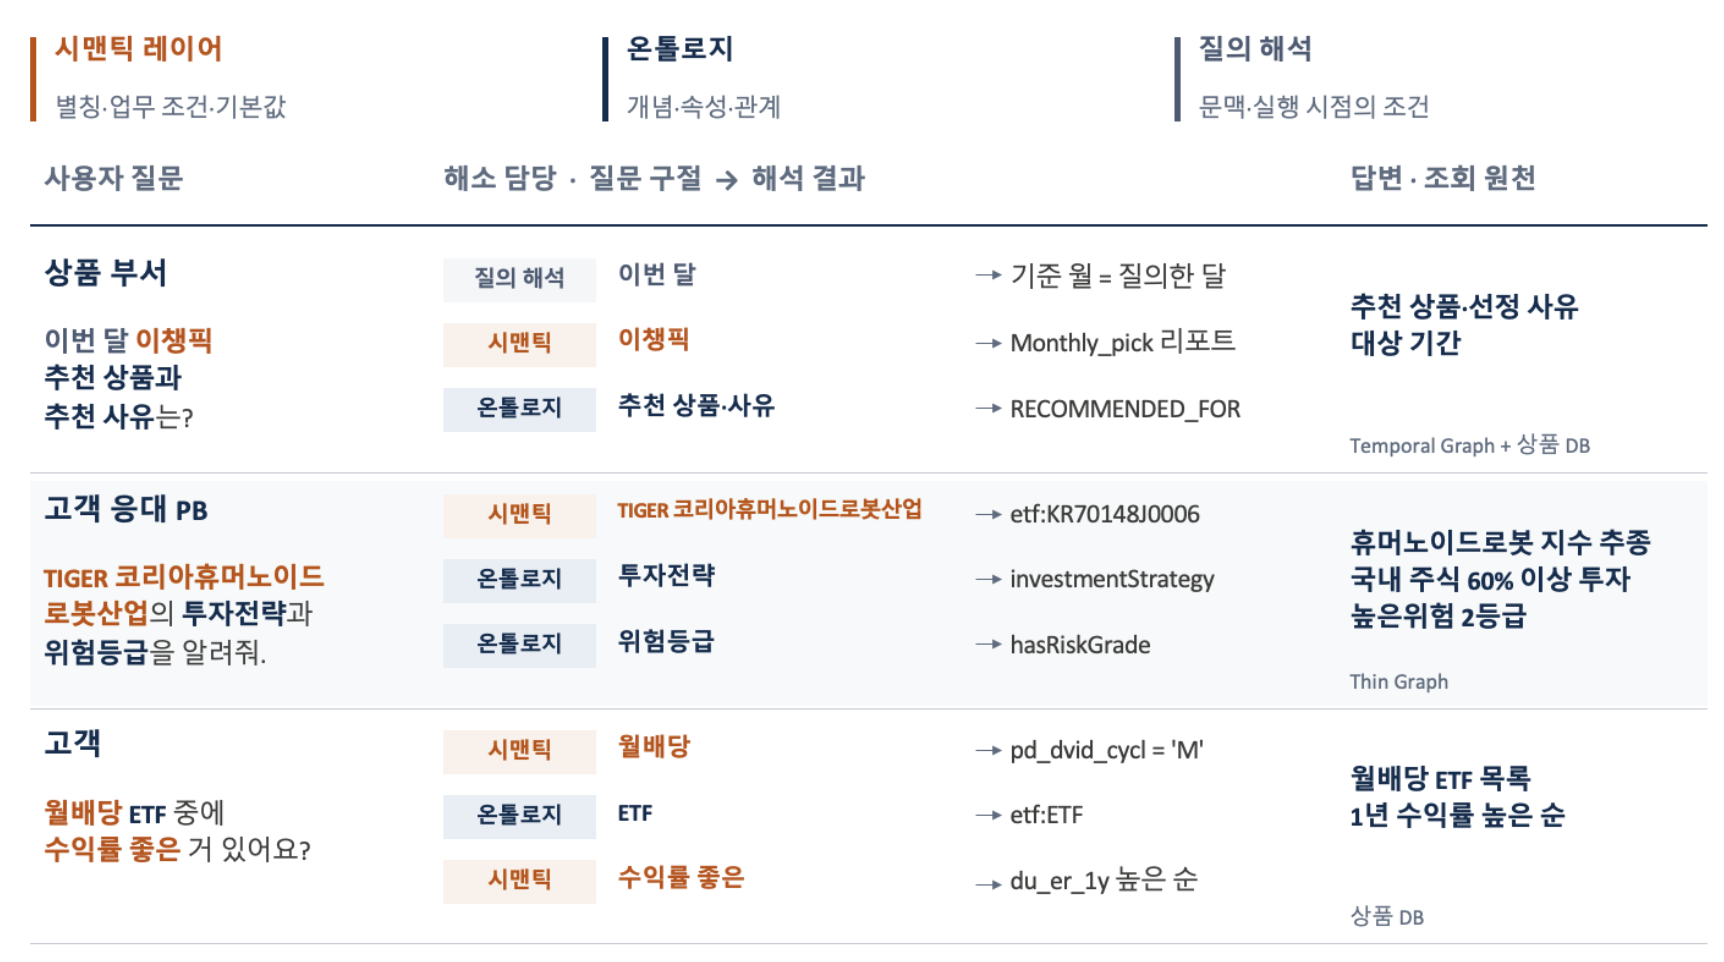
[Figure-11] 시맨틱 레이어 -> 온톨로지 -> 질의 해석과의 관계
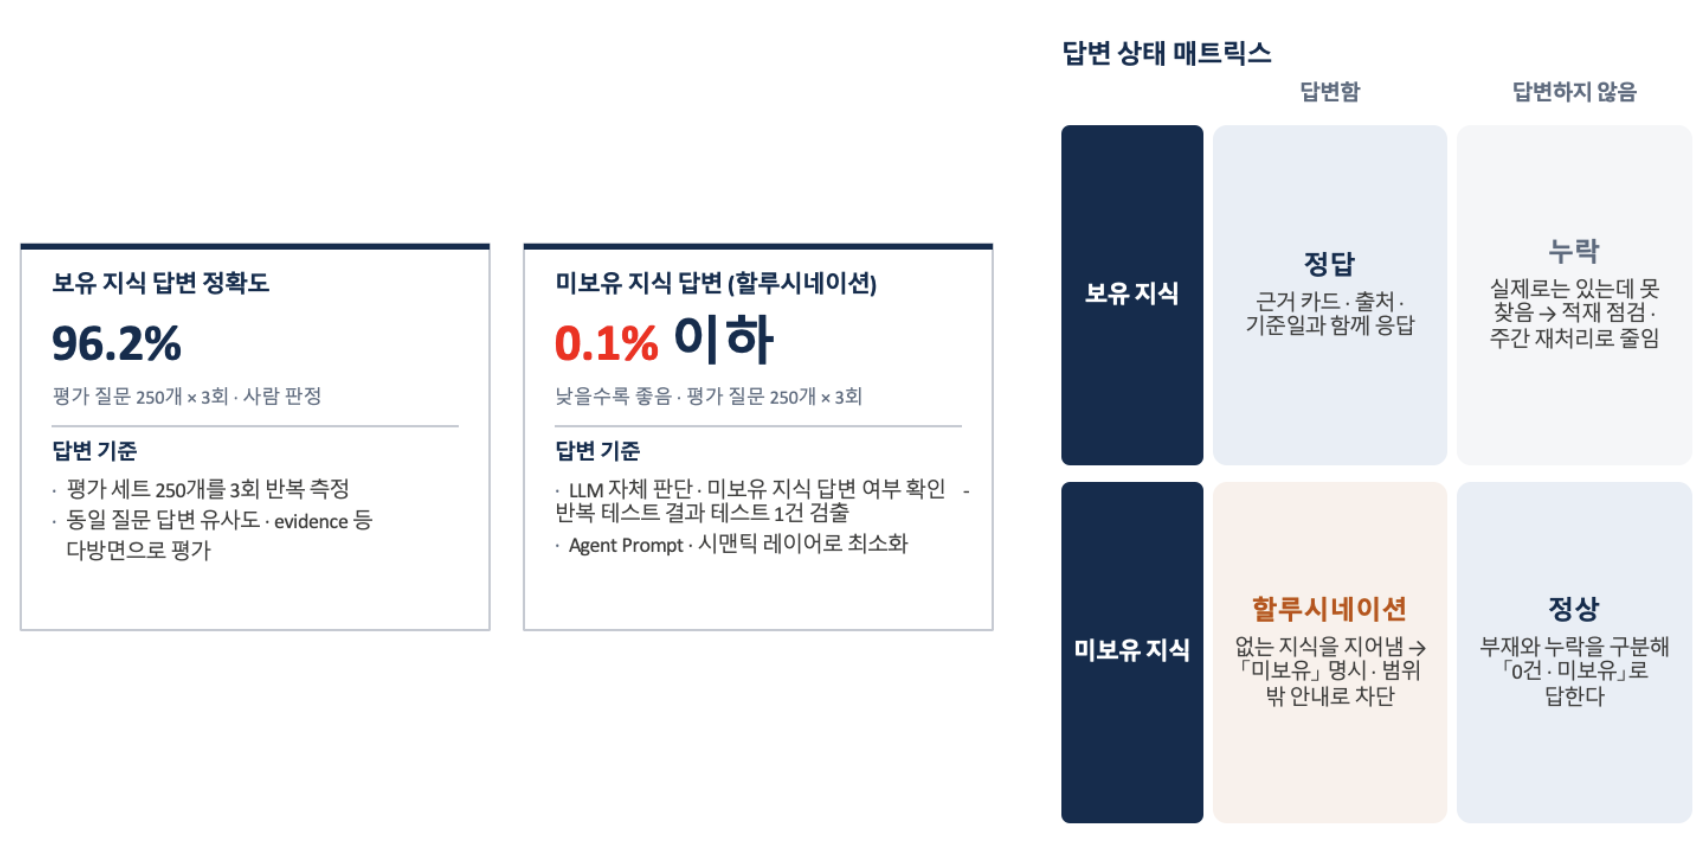
[Figure-12] 보유 지식 답변 정확도와 미보유 지식 답변(할루시네이션) 비율, 답변 상태 매트릭스
무엇보다 큰 성과는 이 과정을 다시 쓸 수 있는 표준으로 만들었다는 점입니다. 질문(CQ) 정의, 온톨로지, 지식그래프, 시맨틱 레이어, 평가로 이어지는 흐름은 다른 업무 지식에도 활용할 수 있습니다. 물론 다른 도메인에 적용하려면 새롭게 겪어야 할 문제들이 있겠지만, 실제 개발과 운영에서 얻은 경험이 그 과정을 가능하게 해줄 것이라 믿습니다. 금융권에서 생성형 AI를 실제 서비스로 운영하려는 분들께 이 원칙과 저희의 경험이 작은 참고가 되기를 바랍니다.