Amazon Web Services ブログ
Amazon Bedrock AgentCore Policy がエージェンティックワークフローの保護に Cedar を採用した理由
本ブログは 2026 年 5 月 20 日に公開された AWS Blog “Why Policy in Amazon Bedrock AgentCore chose Cedar for securing agentic workflows” を翻訳したものです。
エージェントには主体性 (agency) があります。状況に適応し、問題を解決するための複数の方法を見つけ出します。この自律性は、セキュリティ上の根本的な課題を生み出します。エージェントの中核にある大規模言語モデル (LLM) は非決定論的であり、その判断を事前に予測したり保証したりすることはできません。LLM はハルシネーションを起こし、有害なアクションを完全な確信を持って生成してしまうことがあります。また、プロンプトインジェクション攻撃に対して脆弱です。この攻撃では、攻撃者がツールの応答やユーザー入力を通じて悪意のあるコマンドを注入します。LLM はコマンドとデータを確実には区別できません。LLM にとっては、すべてが単なるトークンにすぎないからです。こうした理由から、多層防御を実現するには、セキュリティの観点から LLM を信頼できないアクターとして扱う必要があります。
ここで重要なのは、LLM が外部の世界に直接影響を与えることはできないという点です。LLM は、その出力に基づいてツールを呼び出すオーケストレーターを経由する必要があります。制御を適用すべきなのは、まさにこのポイントです。この境界で必要なのは認可、つまり各ツール呼び出しを許可すべきかどうか、またどのような条件で許可すべきかの判断です。オンライン小売業者のカスタマーサービスエージェントを例に考えてみましょう。適切な制御がなければ、このエージェントは認められた上限を超える返金を処理したり、除外すべき製品カテゴリに割引を適用したり、ある顧客のセッションを処理している最中に別の顧客のデータを参照したりする可能性があります。
エージェントのツールへのアクセスを制御すれば、エージェントが自由に動作できる安全境界 (safety envelope) を確立できます。これは、一般的ではあるものの十分とはいえない次の 2 つのアプローチとは異なります。
- ハードコードされたワークフローを作成すると不確実性はなくなりますが、それだけでは、エージェントの頭脳として LLM を使用する意味がなくなります。LLM のインターフェイスを備えた従来型のアプリケーションを構築したことになるからです。さらに、このように制限したとしても、いずれかのステップで LLM の出力を使用すれば、同じリスクが生じる可能性があります。内容が十分に把握されているワークフローには有用な手法ですが、適応が求められるエージェントには十分ではありません。
- ヒューマンインザループ (Human-in-the-loop) は重要な操作のセーフティネットとなり、今後も一定の役割を果たし続けます。しかし、これを主要な制御メカニズムとして頼ると、自律性が犠牲になり、承認疲れにつながる可能性があります。
必要なのは、安全かつ自律的なエージェントです。そのためには、エージェントとツールの外部に配置された、監査可能で決定論的な適用レイヤーが必要です。なぜ外部なのでしょうか?信頼できないのは LLM の計画そのものであり、LLM に自身の制約を適用する責任を負わせることはできないからです。システムプロンプトやトレーニング時のアライメントなど、LLM レイヤーでの制御は、プロンプトインジェクションやハルシネーションによって回避される可能性があります。エージェントやツールのコードにハードコードされたチェックはより堅牢ですが、大規模になると監査や管理が難しくなります。特に、セキュリティロジックが多数のツールやサービスに分散している場合はなおさらです。エージェントとツールの両方の外部で認可を一元化すれば、LLM が回避できない単一のチェックポイントを設けられます。このチェックポイントは監査可能であり、アプリケーションコードとは独立して検証できます。
そこで役立つのが AgentCore Policy です。Amazon Bedrock AgentCore Gateway は、エージェントと、エージェントが呼び出すリモートツールとの間に配置されます。Policy を Gateway に関連付けると、デフォルトですべてがブロックされます。ポリシーは、どのツール呼び出しをどのような条件で許可するかを指定することで、この境界を選択的に開放します。このポリシーの適用対象は、Gateway を経由するすべてのツールトラフィックです。このアプローチをスケールさせるには、エージェントの動作について推論するよりも、ポリシーについて推論する方が容易である必要があります。
AgentCore で使用するポリシーは Cedar で記述します。Cedar は AWS が開発したオープンソースの認可ポリシー言語で、2025 年 12 月に Cloud Native Computing Foundation (CNCF) に参加しました。Cedar は、まさにこうした特性を備えるように設計されています。認可に特化して構築されており、人間が読みやすく、自動推論を使用して機械で分析できます。これにより、企業はポリシーの定義と適用を AI エージェントにまで拡張できます。
Amazon Bedrock AgentCore における Cedar の活用方法
Amazon Bedrock AgentCore は、エージェントを大規模にデプロイおよび管理するためのインフラストラクチャを提供します。これには、エージェントをホストするための AgentCore Runtime、Model Context Protocol (MCP) を使用してエージェントがツールに接続する方法を管理するための AgentCore Gateway、そして AgentCore Policy が含まれます。Policy は、AgentCore Gateway を経由するすべてのエージェントトラフィックをインターセプトし、ツールへのアクセスを許可する前に、ポリシーエンジンで定義されたポリシーに照らして各リクエストを評価します。このポリシーレイヤーを支えているのが Cedar です。
AgentCore Policy は、AgentCore Gateway のワークフロー内の複数の段階で、Cedar とその数学的分析機能を使用します。Cedar 認可エンジンはポリシーの評価時に使用され、Cedar Analysis はポリシーの作成時とコントロールプレーンで使用されます。
ポリシー作成: 開発者は、Cedar ポリシーを直接記述することも、自然言語で記述してニューロシンボリック AI のフィードバックループで Cedar に変換することもできます。ニューロシンボリック AI は、機械学習の柔軟性と、自動推論の証明可能な正しさを組み合わせたものです。LLM が自然言語からポリシーを生成し、Cedar Analysis がシンボリックかつ数学的な推論を使用してそれらを検証します。次の図は、このワークフローを示しています。
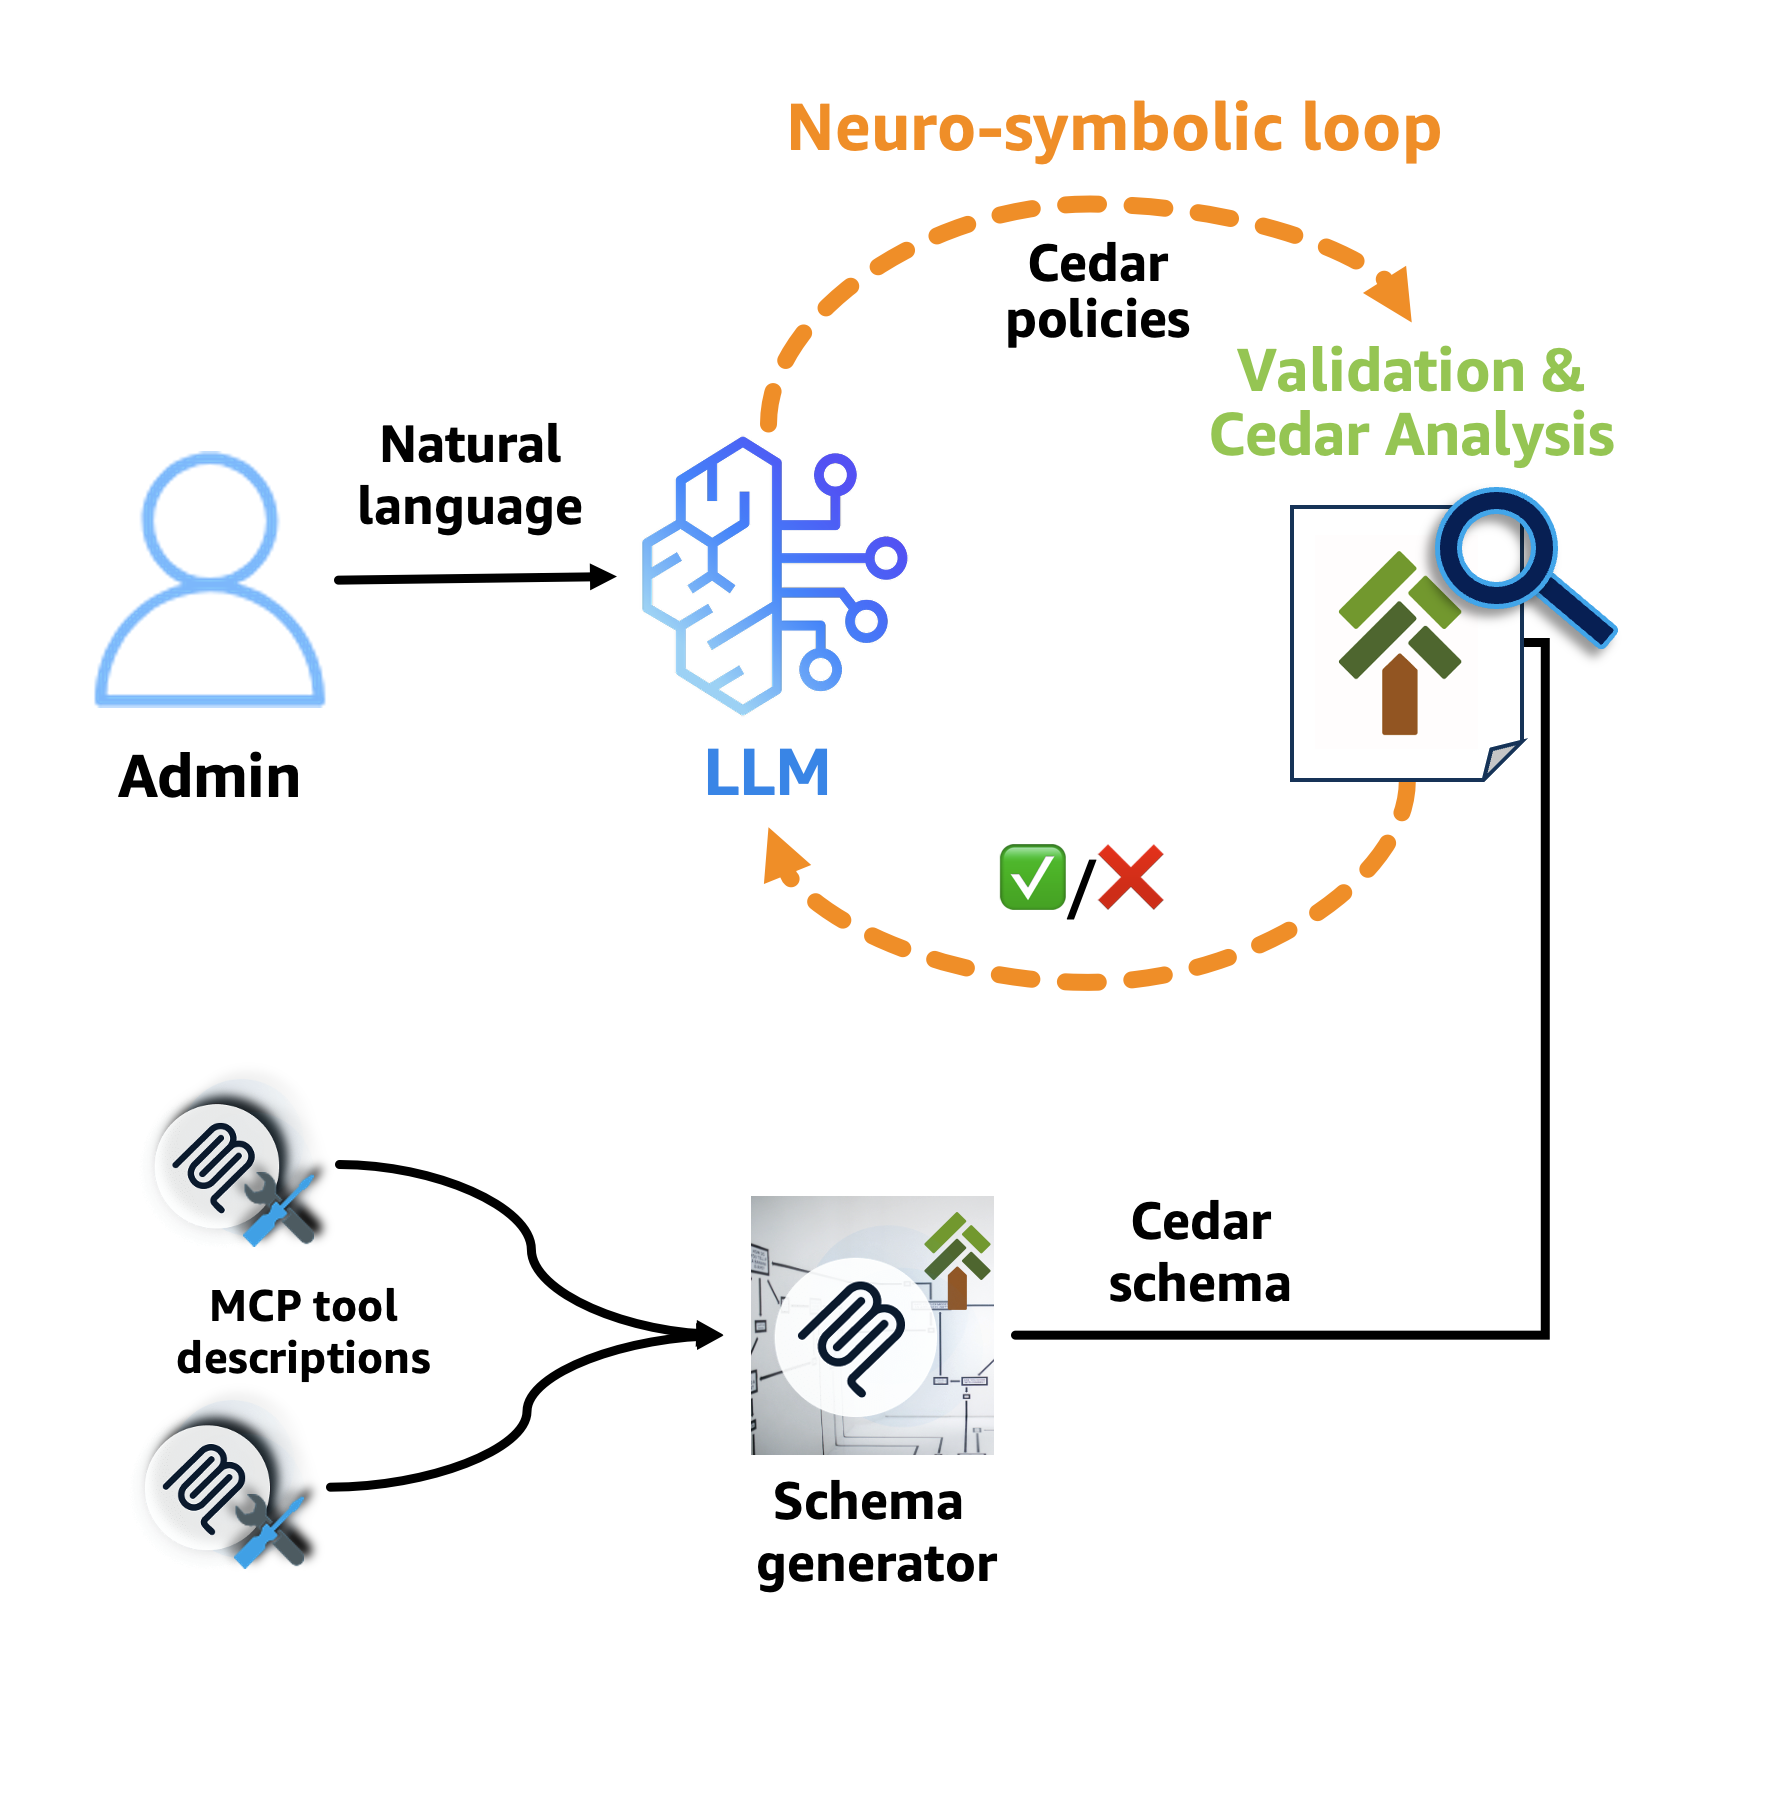
図 1: Cedar ポリシー生成のワークフロー
管理者は、エージェントがどの MCP ツールをどのような条件で呼び出せるかを自然言語で指定します。次に、ニューロシンボリックなフィードバックループがこの記述を Cedar ポリシーとして形式化します。仕組みは次のとおりです。まず、LLM が自然言語を Cedar ポリシーに変換します。次に、これらのポリシーに対して 2 段階の検証が実行されます。第 1 段階では、AgentCore Policy が Cedar のスキーマジェネレーターを使用します。このジェネレーターは MCP ツールの説明を受け取り、Cedar スキーマを生成します。Cedar はこのスキーマに照らしてポリシーを検証します。これにより、ポリシーが有効なツールとパラメータを参照していることを確認するとともに、さまざまな種類のランタイムエラーをまとめて排除できます。検証に合格すると、第 2 段階で Cedar Analysis が実行されます。Cedar Analysis は各ポリシーを数式としてエンコードし、すべてを許可または拒否するポリシーや、成立し得ない条件を含むポリシーなどの問題を検出します。こうした数学的証明によって、自然言語の記述から Cedar ポリシーへの変換プロセスで生じたエラーが特定され、修正の方向性が示されます。
ニューロシンボリックなフィードバックループにより、生成されるポリシーの精度が大幅に向上します。これは、ニューラルアプローチとシンボリックアプローチを組み合わせることの威力を示しています。LLM は自然言語からの創造的な変換を担い、自動推論は厳密な検証を担います。
コントロールプレーン: ポリシーを AgentCore Gateway にアタッチする際、Cedar Analysis はポリシーセット全体を包括的に分析します。ポリシーを個別に分析するのではなく、ポリシーどうしがどのように相互作用するか、またそれらを組み合わせた場合の効果を調べます。この分析により、競合するポリシーや冗長なポリシーなどの潜在的な論理エラーが特定され、ポリシーセットが意図しない認可結果を生み出すかどうかが検出されます。Cedar Analysis がこれらのエラーを検出すると、操作は失敗して問題の説明が返されるため、ポリシー作成者は修正して再試行できます。チェックの例については、「ポリシー検証のための形式的分析」セクションを参照してください。
MCP ツール呼び出しへのポリシー適用: AgentCore Gateway に送信されるエージェントの各ツールリクエストは、Cedar ポリシーに照らして評価され、指定された引数による MCP ツール呼び出しを許可すべきかどうかが判断されます。これにより、安全境界を形成しつつ、エージェントが業務を遂行するために必要な経路を開放します。
MCP ツールのフィルタリング: Cedar は、ツール呼び出しが発生する前の段階で機能する追加の保護レイヤーも実現します。エージェントがツール一覧の取得コマンドを発行すると、AgentCore Gateway は Cedar の部分評価機能を使用して、現在のポリシーセットのもとで常に拒否されるアクションを判断します。それらのアクションは、ツール一覧のレスポンスから除外されます。エージェントとその基盤となる LLM がそれらのツールアクションを目にすることはないため、ある種類のリスクを完全に排除できます。エージェントと LLM は、存在を知らないツールを呼び出そうとすることができないからです。これは Cedar の部分評価がもたらす直接的なメリットです。実際のツール呼び出しの試行を待たなくても、特定のツールアクションに到達できないことをシステムが判断できます。
なぜ Cedar なのか: 分析可能性が大規模環境での安全性を実現する
自然言語は、セキュリティが重要なインフラストラクチャで使用するにはあいまいすぎます。一方、Python などの汎用プログラミング言語は非常に表現力が高いものの、分析が困難すぎます。意図しない副作用や停止性の問題が生じる可能性があり、理解するのも難しい場合があります。
Cedar は、ループやステートフルな操作を排除することでこれらの問題を回避しています。そのため、一般的なケースではポリシー評価が O(n) 時間で終了します。このように実行時間に上限があるため、エージェントはユーザーエクスペリエンスやワークフローの効率を損なうことなく認可の判断を行えます。
Cedar は読みやすい言語です。規制コンプライアンスやセキュリティ監査では、人間が理解して検証できるポリシーが求められます。Cedar ポリシーは構造化された自然言語のように読めるため、セキュリティチーム、コンプライアンス担当者、ビジネスステークホルダーにとっても理解しやすくなっています。
技術的なバックグラウンドを持たない監査担当者でも、このポリシーは理解できます。「50 個以上注文するプラチナ顧客には大量購入割引を許可する。ただし、限定版または季節限定の特別製品は除く」という意味です。unless 句によって例外が明確になります。これは、ビジネスルールを自然言語で表現する際の一般的な書き方と同じです。この 1 つのポリシーが、2 つの異なるデータソースを制約している点に注目してください。顧客ティアは JSON Web Token (JWT) のクレームから取得されるため、LLM によるハルシネーションや改ざんの影響を受けません。一方、注文数量や製品タイプなどのツール入力は、LLM のツール呼び出しに由来します。Cedar ポリシーはこれらの入力を許可された値のみに制約するため、LLM が予期しない引数を生成した場合でも、ポリシーの適用レイヤーによって決定論的に拒否されます。
Cedar が適切な選択肢である理由は、高速で、読みやすく、自動推論によって分析可能だからです。この分析可能性があるからこそ、Cedar ポリシーとして表現されたエージェントの安全境界について推論できるのです。エージェンティックシステムが成長するにつれて、ツールの数も増えていきます。適切な管理ツールがなければ、ポリシー管理は手に負えなくなります。ポリシーが競合したり、セキュリティ上のギャップが生じたり、意図しない認可結果が生まれたりする可能性があります。
このセクションの残りの部分では、Cedar の分析可能性が、決定論的かつ数学的に健全な分析によって、この課題にどのように直接対処するかを見ていきます。Cedar の分析は大規模なポリシーセット全体にわたって競合や論理エラーを確実に検出できるため、ニューロシンボリック AI によるスケーラブルなポリシー管理が可能になります。
ポリシー検証のための形式的分析
Cedar ポリシーは、シンボリックエンコーダーを通じて数式にエンコードし、自動推論の手法で分析できます。これにより、AgentCore Policy は、ポリシーの作成時をはじめとするさまざまな場面で、高度なポリシー検証機能を提供できます。AgentCore Policy はポリシーの作成時やアタッチ時にこの分析を使用して、競合するポリシーや冗長なポリシーなどの論理エラーの可能性を検出します。ポリシー比較を含むポリシー分析は、オープンソースの CLI ツールとして利用できます。ここからは、これらのチェックの具体例をいくつか見ていきましょう。
ポリシーの論理エラーの検出: Cedar Analysis は、ポリシーに含まれる論理エラーを検出できます。例えば、次のポリシーには矛盾する制約があるため、どのリクエストも許可できません。顧客ティアが同時にゴールドとプラチナの両方になることはあり得ないからです。本来は || を使う意図でしたが、誤って && が使われています。このような間違いは、ポリシーを作成する人間と AI システムのどちらにも起こり得ます。
同様に、Cedar Analysis は、特定のアクションを常に許可するポリシーも検出できます。このようなポリシーは、通常、許可範囲が広すぎることを示しています。例えば、次のポリシーはすべての ApplyBulkDiscount リクエストを許可します。どのような注文数量であっても、100 以上か 100 未満のいずれかに該当するからです。
このような論理エラーを人間が見つけるのは容易ではなく、パターンマッチングで検出することもできません。数学的分析による形式的な厳密さが必要であり、それこそが Cedar Analysis の役割です。
ポリシーの競合の検出: Cedar Analysis は、ポリシーセット全体を分析して、個々のポリシー間の不整合を検出することもできます。
permit ポリシーはゴールド顧客に対して 100 USD 未満の返金処理を許可していますが、forbid ポリシーはゴールド顧客 (およびプラチナ顧客) による 500 USD 未満の返金処理をブロックしています。Cedar では forbid が permit より優先されるため、permit ポリシーがあるにもかかわらず、forbid ポリシーによってゴールド顧客の返金はすべてブロックされます。
ポリシー変更の比較: ポリシーを更新する際、Cedar Analysis は変更による正確な影響を判断することもできます。unless 句に対する次の更新を考えてみましょう (+ の付いた行は追加された行、- の付いた行は削除された行です)。更新後は、ApplyBulkDiscount がブロックされるのは、数量が 200 を超え、かつ製品タイプが limited_edition の場合のみです。
一見すると、unless 句に条件を追加すれば、制限がより厳しくなるように思えるかもしれません。しかし、実際にはその逆です。unless が適用される範囲が狭まるため、permit が対象とするリクエストは増えることになります。例えば、limited_edition 製品を 73 個注文した場合、更新前はブロックされていましたが、更新後は許可されます。Cedar Analysis はこれを自動的に検出し、元のポリシーセットと更新後のポリシーセットの許可範囲の違いを示す次の表を生成します。
|
プリンシパルタイプ |
アクション |
リソースタイプ |
ステータス |
|
OAuthUser |
ProcessRefund |
Gateway |
同等 (Equivalent) |
|
OAuthUser |
ApplyBulkDiscount |
Gateway |
許可範囲が拡大 (More permissive) |
この分析結果から、更新後のポリシーは ProcessRefund リクエストについては以前とまったく同じ範囲を許可する一方で、ApplyBulkDiscount リクエストについてはより多くを許可することがわかります。
エージェントが自律的に動作し、現実世界に影響を与える可能性がある場合、このような形式的検証の機能は不可欠です。組織には、ポリシーが意図したとおりに動作するという数学的な確実性が必要です。
信頼性の高いガバナンスを実現する決定論的な動作
確率的な AI モデルとは異なり、エンタープライズセキュリティには決定論的な保証が必要です。Cedar ポリシーは、評価順序やシステムの状態にかかわらず、同一のリクエストに対して常に同じ認可の判断を下します。Cedar の「デフォルトで拒否する」「forbid が優先される」「評価順序に依存しない」というセマンティクスは、予測可能な動作の確保に役立ちます。
permit ポリシーと forbid ポリシーのどちらが先に評価されても、500 USD を超える返金リクエストは常に拒否され、注文日から 90 日を過ぎて行われる返金も拒否されます。この予測可能性があるからこそ、企業は安心してエージェントのガバナンスを行えます。
ポリシーから本番環境へ
AgentCore Policy と Cedar を選択すれば、組織は、エージェントが正しく動作することをただ期待するのではなく、数学的に推論できるポリシーを備えた自律型エージェントをデプロイできます。Cedar は表現力、可読性、形式的検証を兼ね備えているため、動作に必要な柔軟性と、セキュリティチームが求める確実性の両方を備えたエージェントを設計できます。
自動推論は、アクセスポリシーを検証する AWS IAM Access Analyzer から、ネットワーク設定の証明可能なセキュリティに至るまで、AWS 全体で既にその価値を実証しています。同じ手法をエージェンティック AI に適用するのは自然な流れです。エージェントが担う責任が大きくなるにつれて、数学的な根拠に基づく保証の必要性は高まる一方です。この記事で説明したニューロシンボリックなアプローチは、LLM の柔軟性と自動推論の厳密さを組み合わせたものです。このアプローチは、検証が自律性と歩調を合わせて進むことで、エージェントがより自律的であると同時に、より信頼できる存在になる未来を示しています。
詳細情報
Policy は現在、Amazon Bedrock AgentCore Gateway の一部として利用できます。Cedar とその機能の詳細については、Cedar ウェブサイトにアクセスするか、Cedar プレイグラウンドをお試しください。また、Cedar コミュニティには Slack から参加できます。
Amazon Bedrock AgentCore Gateway の Policy の詳細については、AWS ドキュメントを参照するか、AgentCore Gateway コンソールをご確認ください。
本ブログは Security Solutions Architect の 中島 章博 が翻訳しました。