AWS 기술 블로그
KB증권 AI 에이전트는 어떻게 최적의 모델을 선택할까? – Amazon Bedrock 기반 Context Tier-Routing
들어가며 – 모든 질문을 같은 LLM으로 처리하는 게 맞을까?
KB증권은 ‘슈퍼 금융 에이전트’를 지향하며, 다양한 스킬(Skill)과 도구(Tool)를 자율적으로 선택하고 활용하는 사내 에이전틱 AI 서비스 ‘깨비AI’를 자체 구축해 운영하고 있습니다.
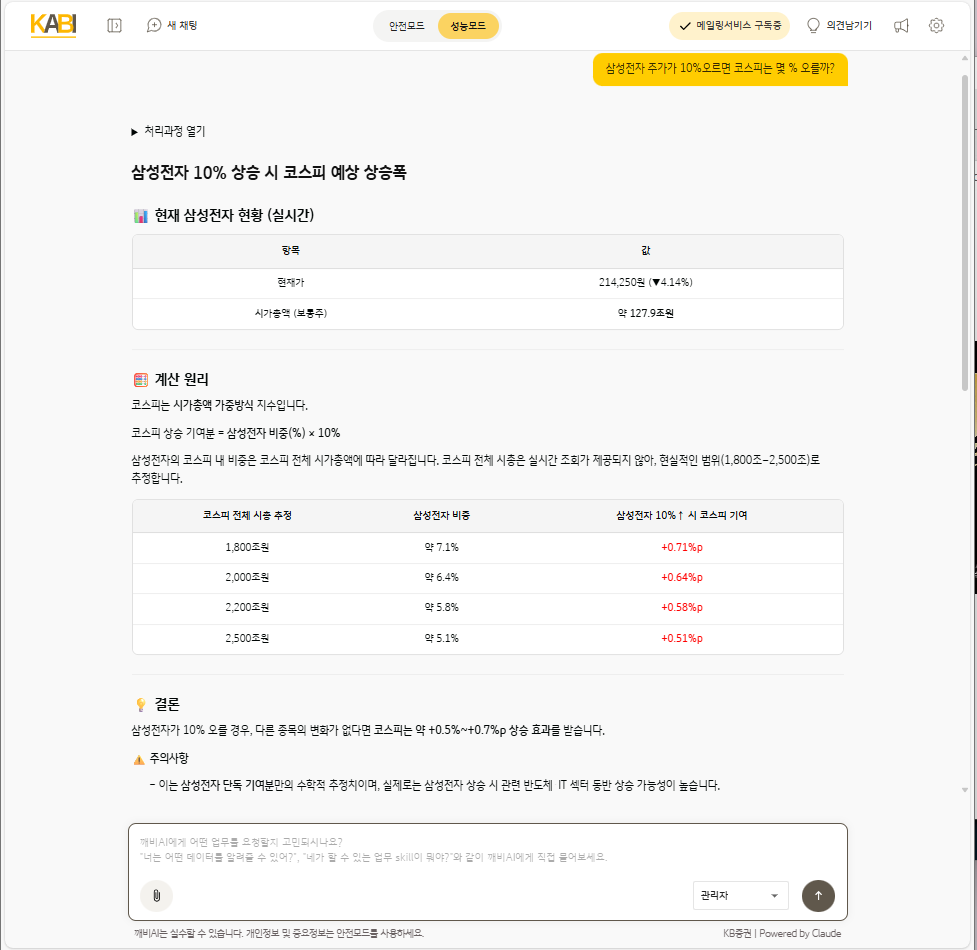
깨비AI는 KB증권 전 임직원을 위한 AI 어시스턴트입니다. 업무 지식 검색, 투자 분석, 문서 작성 및 검토, 계약서 법무검토 등 증권 업무 및 사내 업무에 특화된 다양한 서비스를 지원하고 있습니다.
깨비AI를 운영하면서 사용자 질의마다 요구되는 작업의 복잡도가 크게 다르다는 점을 확인했습니다. 단순한 정보 조회부터 여러 단계의 추론과 데이터 분석이 필요한 요청까지, 다양한 유형의 질의가 유입되고 있었습니다.
| 구분 | 단순 조회형 질의 | 복합 분석형 질의 |
|---|---|---|
| 질의 예시 #1 | 삼성전자 현재 주가 알려줘. | 삼성전자와 SK하이닉스의 최근 4개 분기 실적을 비교하고, 실적 개선 속도가 더 빠른 회사를 분석해줘. |
| 질의 예시 #2 | PER이 뭐야? | 최근 3년간 금리 변화와 코스피·증권업종 지수의 움직임을 비교하고, 금리 인하기에 상대적으로 유리했던 증권주를 찾아줘. |
| 작업 특성 | 단순 정보 조회 및 개념 설명 | 복수 데이터 조회, 비교 분석 및 다단계 추론 |
| 요구 역량 | 상대적으로 낮은 추론 복잡도 | 상대적으로 높은 추론 복잡도 |
<표 1. 깨비AI에 유입되는 질의 유형별 작업 특성과 요구 역량 비교>
이처럼 서로 다른 수준의 작업을 요구하는 질의를 모두 동일한 LLM으로 처리하는 것이 최선일까요?
단순 조회형 질의는 비교적 적은 추론으로 답변할 수 있는 반면, 복합 분석형 질의는 여러 단계의 데이터 조회와 분석이 필요합니다. 모든 질의를 고성능 LLM으로 처리하면 불필요한 비용이 발생할 수 있고, 반대로 경량 LLM만 사용하면 복잡한 작업에서 응답 품질이 저하될 수 있습니다.
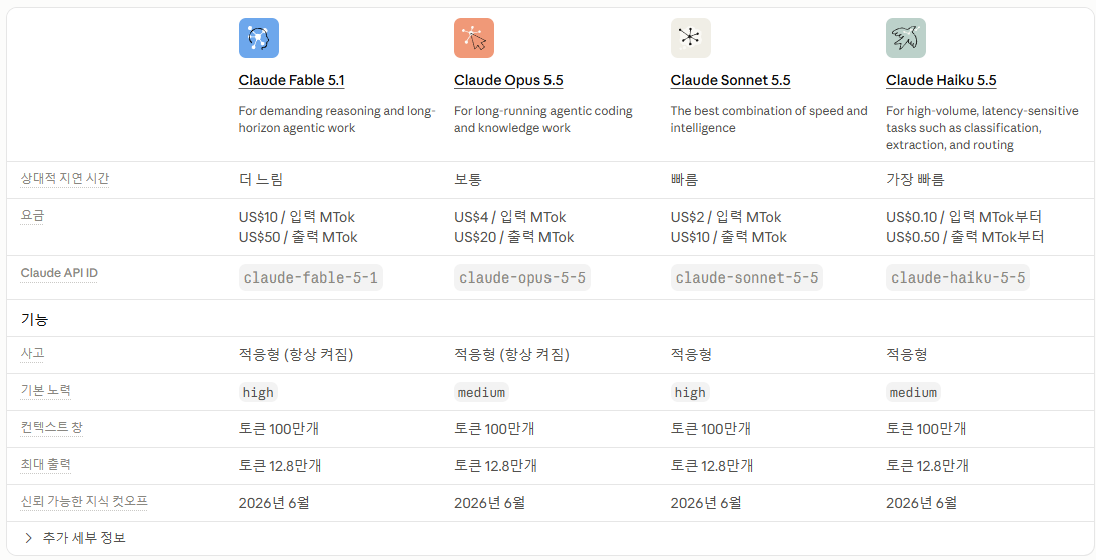
<표 2. Claude 모델별 지연 시간과 단가 비교 (출처: Anthropic Models Overview, 2026년 10월 기준)>
이에 KB증권은 작업의 복잡도에 따라 적절한 LLM을 선택하는 Tier-Routing 방식을 도입하고자 했습니다.
그러나 이를 구현하기 위해서는 두 가지 핵심 질문에 답해야 했습니다.
첫째, 무엇을 어려운 작업으로 판단할 것인가?
둘째, 어느 시점에 그 난이도를 판별할 것인가?
이 글에서는 KB증권이 Amazon Bedrock과 Amazon SageMaker AI 기반의 학습 환경을 활용해 깨비AI에 Tier-Routing을 도입한 과정을 공유합니다. 평가 결과, 평균 품질 점수 차이를 0.4점 이내로 유지하면서 토큰 사용량은 36%, 클라우드 모델 호출 비용은 16% 줄었고, 중간 난이도 요청의 응답 시간은 29% 단축되었습니다. 그 과정에서 마주한 문제와 해결 방법도 함께 소개합니다.
참고: 이 글에 등장하는 설계 규칙, 구체적 수치, 학습 규칙, 임계값 등은 비즈니스 기밀 보호를 위해 일반화된 예시로 대체되었습니다. 솔루션의 구조와 방법론은 실제 구현을 충실히 반영합니다.
문제 정의
깨비AI의 라우팅을 설계하면서 세 가지 질문에 답해야 했습니다.
- 무엇을 어려운 질의로 볼 것인가: 문장의 길이나 어휘가 아니라, 그 질의를 처리하는 데 필요한 추론과 Tool 사용량이 기준이 되어야 했습니다. (질문 1.)
- 어느 시점에 난이도를 판별할 것인가: 사용자 질의가 들어온 순간인지, 매 LLM 호출 직전인지에 따라 설계가 완전히 달라집니다. (질문 2.)
- 난이도마다 모델을 바꿀 것인가: 모델이 바뀌면 그동안 쌓인 프롬프트 캐시를 새 모델에서 다시 만들어야 하므로, 잦은 전환은 오히려 비용과 응답 시간을 늘립니다. 그래서 모델은 STANDARD에서 ADVANCED로 올라갈 수만 있고, 한 번 올라간 뒤에는 다시 내려가지 않도록(Elevate-only) 했습니다. (질문 2.)
이 문제를 어렵게 만드는 것은 깨비AI가 단순 질의응답이 아니라 에이전트라는 점입니다. 에이전트 루프는 LLM 호출 1회와 그 결과로 실행되는 0개에서 N개의 Tool로 구성되고, 사용자 질의 하나가 최종 답변에 도달하기까지 이 루프가 여러 번 반복됩니다.
게다가 깨비AI가 사용하는 Tool은 90여 종에 이르고, 현재 날짜, 시간을 조회하는 단순한 Tool부터 여러 데이터를 조합해 분석하는 무거운 Tool까지 난이도 편차가 큽니다.
예를 들어 현재 시각을 알려주는 now Tool과, 모델이 SQL을 직접 작성해 DB를 조회하는 SQL 조회 Tool을 비교해 보면 차이가 분명합니다.
| 관점 | now(현재 시각 조회 Tool) | pg_query(SQL 쿼리문 생성 Tool) |
|---|---|---|
| 모델이 채울 입력 | 없음 | SQL 문장 전체 |
| 필요한 사전 지식 | 없음 | 테이블·컬럼·타입·데이터 형식 |
| 호출 횟수 | 1번 | 테이블 탐색 → 구조 확인 → 조회, 틀리면 재시도 |
| 결과 크기 | 한 줄 고정 | 0행부터 수천 행 이상 |
| 실패 시 | 사실상 없음 | 오류 메시지를 읽고 쿼리를 고쳐야 함 |
<표 3. now Tool과 pg_query Tool의 작업 난이도 비교>
now는 어떤 모델이 호출해도 결과가 같습니다. 반면 SQL 조회는 모델이 DB 구조를 추론하고, 오류를 읽고 쿼리를 고치는 능력에 따라 결과가 달라집니다. 날짜가 ‘20260701’ 같은 문자열로 저장된 컬럼에 DATE ‘2026-07-01’로 조건을 걸면 결과가 비어 나오는데, 이를 알아채고 고치려면 높은 추론 능력이 필요합니다. 같은 질의라도 어떤 Tool을 거치느냐에 따라 각 LLM 호출이 요구하는 능력이 달라집니다.
즉 “질의의 난이도”와 “그 질의를 처리하는 각 LLM 호출의 난이도”는 같지 않습니다.
에이전트 루프가 만드는 비용 구조
깨비AI는 질의 하나에 한 번 답하고 끝나지 않습니다. 모델이 필요한 스킬과 Tool을 골라 호출하고, 결과를 읽은 뒤 다음 행동을 다시 정합니다. 언제 멈출지도 코드가 아니라 모델이 판단합니다. 모델이 Tool을 더 부르지 않고 텍스트로만 응답하면 그것이 최종 답변이 되고 루프가 끝납니다. 코드는 이 판단에 끼어들지 않고, 루프가 너무 길어지지 않도록 질의당 모델 호출과 Tool 호출 횟수에 상한만 둡니다.
이 구조 덕분에 깨비AI는 답을 한 번에 짐작하지 않고, 필요한 데이터를 충분히 모은 뒤 답합니다. 사용자가 만족할 만한 답변이 나오는 이유이기도 합니다. 하지만 같은 구조가 비용을 키웁니다.
자료를 하나 조회할 때마다 서류철 전체를 처음부터 다시 읽어야 하는 담당자를 떠올려 보면 쉽습니다. 조회가 늘수록 서류철은 두꺼워지고, 다음 판단 전에 읽어야 할 분량도 계속 늘어납니다.
LLM이 바로 이렇게 동작합니다. LLM은 이전 호출을 기억하지 못하기 때문에, 호출할 때마다 아래 내용을 모두 입력으로 다시 받습니다.
그래서 비용은 호출 횟수에 비례하는 데 그치지 않습니다. 호출이 거듭될수록 매 호출의 입력 자체가 커지기 때문에 더 빠르게 늘어납니다. 특히 금융 데이터를 조회하는 Tool은 결과가 큰 경우가 많은데, 한 번 받은 Tool Result는 그 뒤의 모든 호출에 계속 실립니다. 모델이 쿼리를 잘못 써서 오류를 보고 다시 호출하는 경우에도, 그 시도와 오류 내용이 그대로 맥락에 쌓입니다.
이 구조를 들여다보면서 두 가지를 확인했습니다.
- 호출 대부분은 중간 단계입니다. 한 Agent Run 안의 LLM 호출 중 최종 답변을 쓰는 호출은 마지막 한 번뿐입니다. 나머지는 Tool 결과를 확인하고 다음 Tool을 고르는 단계이고, 그중 상당수는 상위 모델이 아니어도 처리할 수 있습니다.
- 반복 전송되는 맥락이 많습니다. 매 호출마다 같은 System Prompt와 이전 맥락이 다시 전송되므로 Prompt Cache의 효과가 큽니다. 반대로 루프 도중 모델이 바뀌면 그때까지 쌓은 캐시를 처음부터 다시 만들어야 합니다.
첫 번째는 질의 단위가 아니라 호출 단위로 라우팅해야 하는 이유(질문 2.)이고, 두 번째는 모델 전환을 줄여야 하는 이유입니다. (질문 3.)
질문 1. 맥락 없이, 질문 단건에 대한 난이도 판단하기
처음에는 사용자 질의 하나하나를 독립된 요청으로 보고, 각 질의의 난이도를 Easy, Medium, Hard 세 단계로 분류했습니다.
그리고 각 난이도에 대해 Amazon Bedrock의 Anthropic Claude Haiku, Sonnet, Opus로 보내도록 했습니다.
학습 데이터로는 깨비AI에 쌓인 사용자 질의 약 6.3만 건을 수집해 Anthropic Claude Opus 모델로 난이도 라벨을 붙였습니다. 이 데이터로 질의 임베딩을 입력받아 등급을 예측하는 분류기를 학습시켰습니다.
- 고난도 질의에는 Sonnet과 Opus 등 고성능 모델을 활용하여 응답 정확도 및 품질 향상
- 저난도 질의에는 자체 서빙 LLM을 활용하여 응답 비용 절감 및 처리 시간 단축
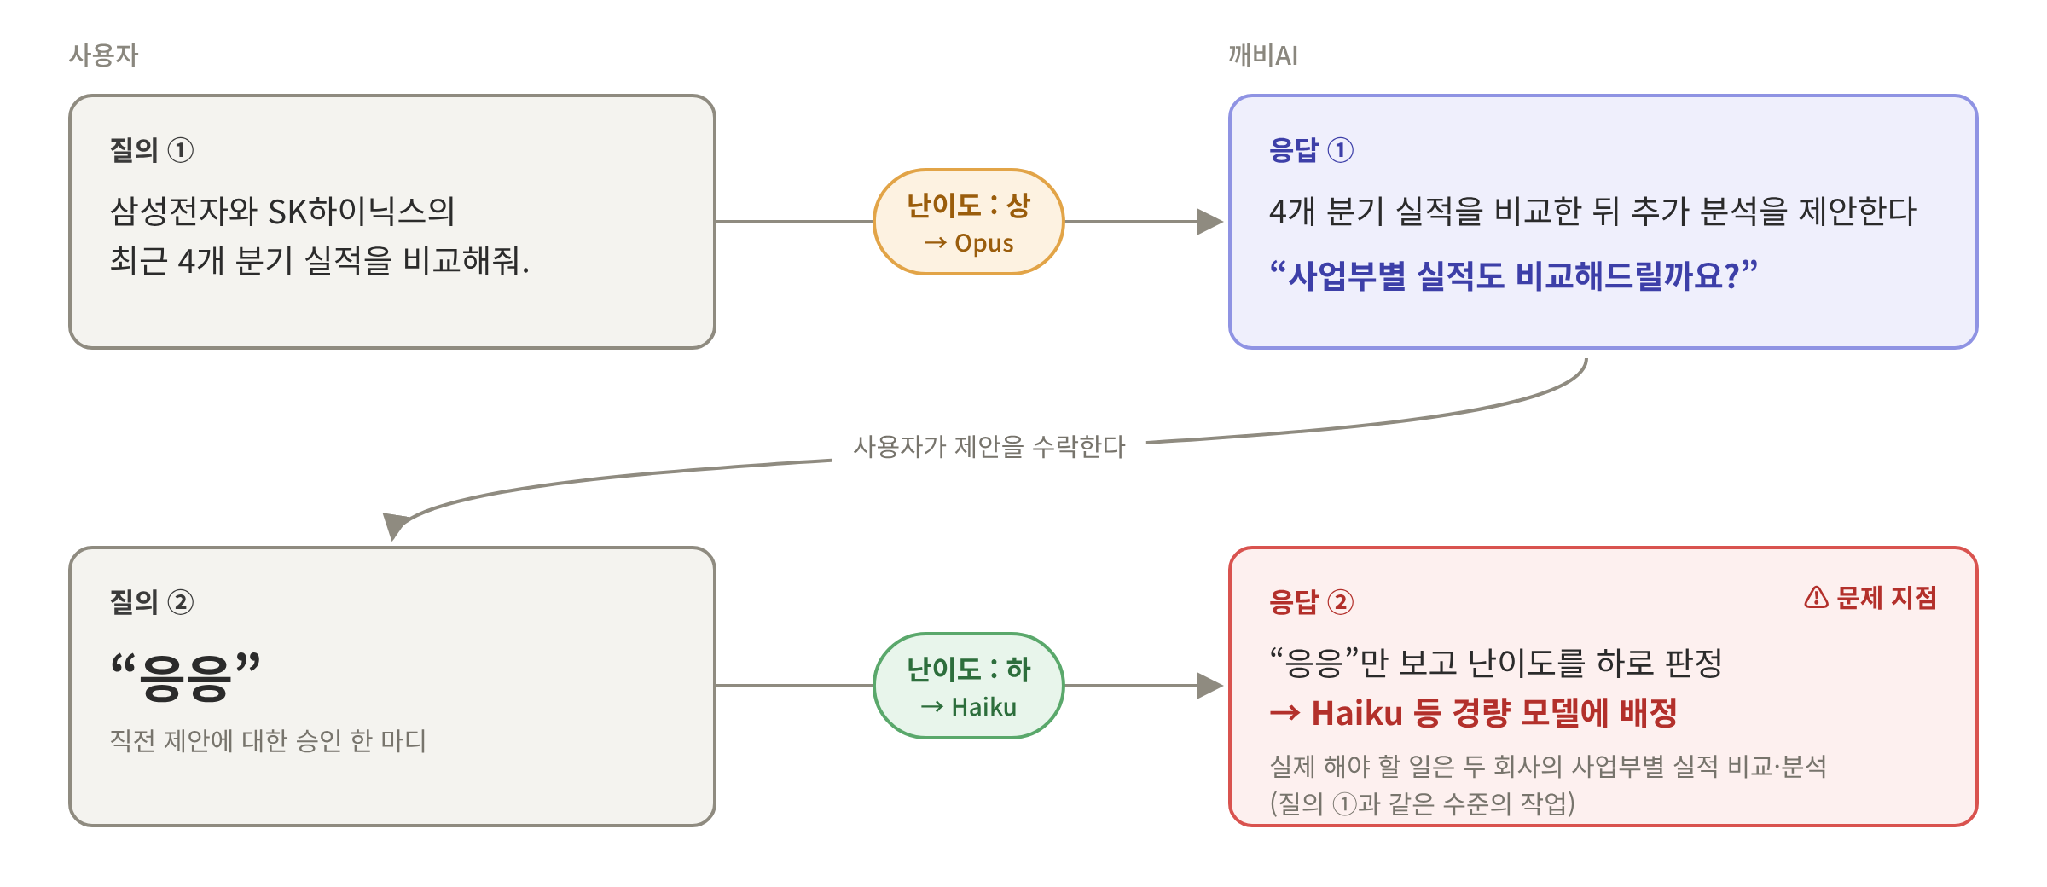
<그림 1. 단일 질의 기반 라우팅(User Query → Embedding → ML Router → Easy/Medium/Hard)의 난이도 오판 사례>
초기 라우팅 방식의 한계
운영 환경에 적용하기 전, 별도의 테스트 환경에서 라우팅을 적용하고 며칠간 실제 에이전트의 동작을 모니터링했습니다.
그 결과, 초기 라우팅 방식에서 세 가지 한계를 발견했습니다.
1. 멀티턴 대화의 맥락을 반영하지 못하는 문제
초기 라우팅은 현재 사용자의 질문만을 기준으로 난이도를 판단했습니다. 하지만 멀티턴 대화에서는 짧고 단순한 질문이라도 이전 대화에 따라 복잡한 작업을 이어가야 할 수 있습니다. 예를 들어, 사용자가 기업의 재무제표 분석을 요청한 후 추가 분석을 제안받고 “응”이라고 답하는 경우입니다.
실제로는 기존의 복잡한 분석을 이어가야 하지만, “응”이라는 짧은 발화만 평가하면 저난도 질의로 분류되어 모델이 하향되는 문제가 발생했습니다.
2. 사용자 질문의 난이도와 실제 작업 난이도가 다른 문제
AI 에이전트는 사용자 질문에 바로 답변하기도 하지만, 필요한 도구(Tool)를 호출하고 그 결과를 분석하는 과정을 반복하기도 합니다. 이때 사용자 질문 자체는 단순하더라도, Tool 실행 결과를 해석하거나 여러 정보를 종합하는 과정에서는 높은 추론 능력이 필요할 수 있습니다.
그러나 초기 라우팅은 사용자 질문의 난이도에 초점을 맞추고 있어, 에이전트가 현재 수행해야 하는 작업의 복잡도를 충분히 반영하지 못했습니다.
3. 잦은 모델 전환으로 프롬프트 캐싱을 활용하기 어려운 문제
초기 방식에서는 질의마다 독립적으로 모델을 선택했기 때문에, 동일한 대화에서도 모델이 빈번하게 전환되었습니다. 깨비AI는 응답을 생성할 때마다 긴 System Prompt를 함께 전달합니다. 동일한 모델을 연속해서 사용하면 프롬프트 캐싱을 통해 이전에 처리한 내용을 재사용할 수 있지만, Haiku·Sonnet·Opus처럼 서로 다른 모델 간에는 캐시를 공유할 수 없습니다.
따라서 모델이 자주 변경되면 캐시 활용률이 낮아지고, 긴 프롬프트를 반복적으로 처리하면서 오히려 비용과 응답 시간이 증가할 수 있습니다.
즉, 개별 질의에 저렴한 모델을 선택하는 것이 반드시 전체 운영 비용의 절감으로 이어지는 것은 아니었습니다.
질문 2. 대화 맥락과 실행 상태까지 반영하여, LLM 호출마다 판단하기
“사용자의 질문이 얼마나 어려운가?”에서 시작해, “지금 이 순간 LLM이 수행해야 할 작업이 얼마나 어려운가?”를 판단하는 라우터로 발전시켰습니다.
흐름
사용자들이 보기에는 질의 → 응답이지만 실제로는 아래 그림과 같이 LLM 호출과 Tool 실행이 여러 번 반복됩니다.
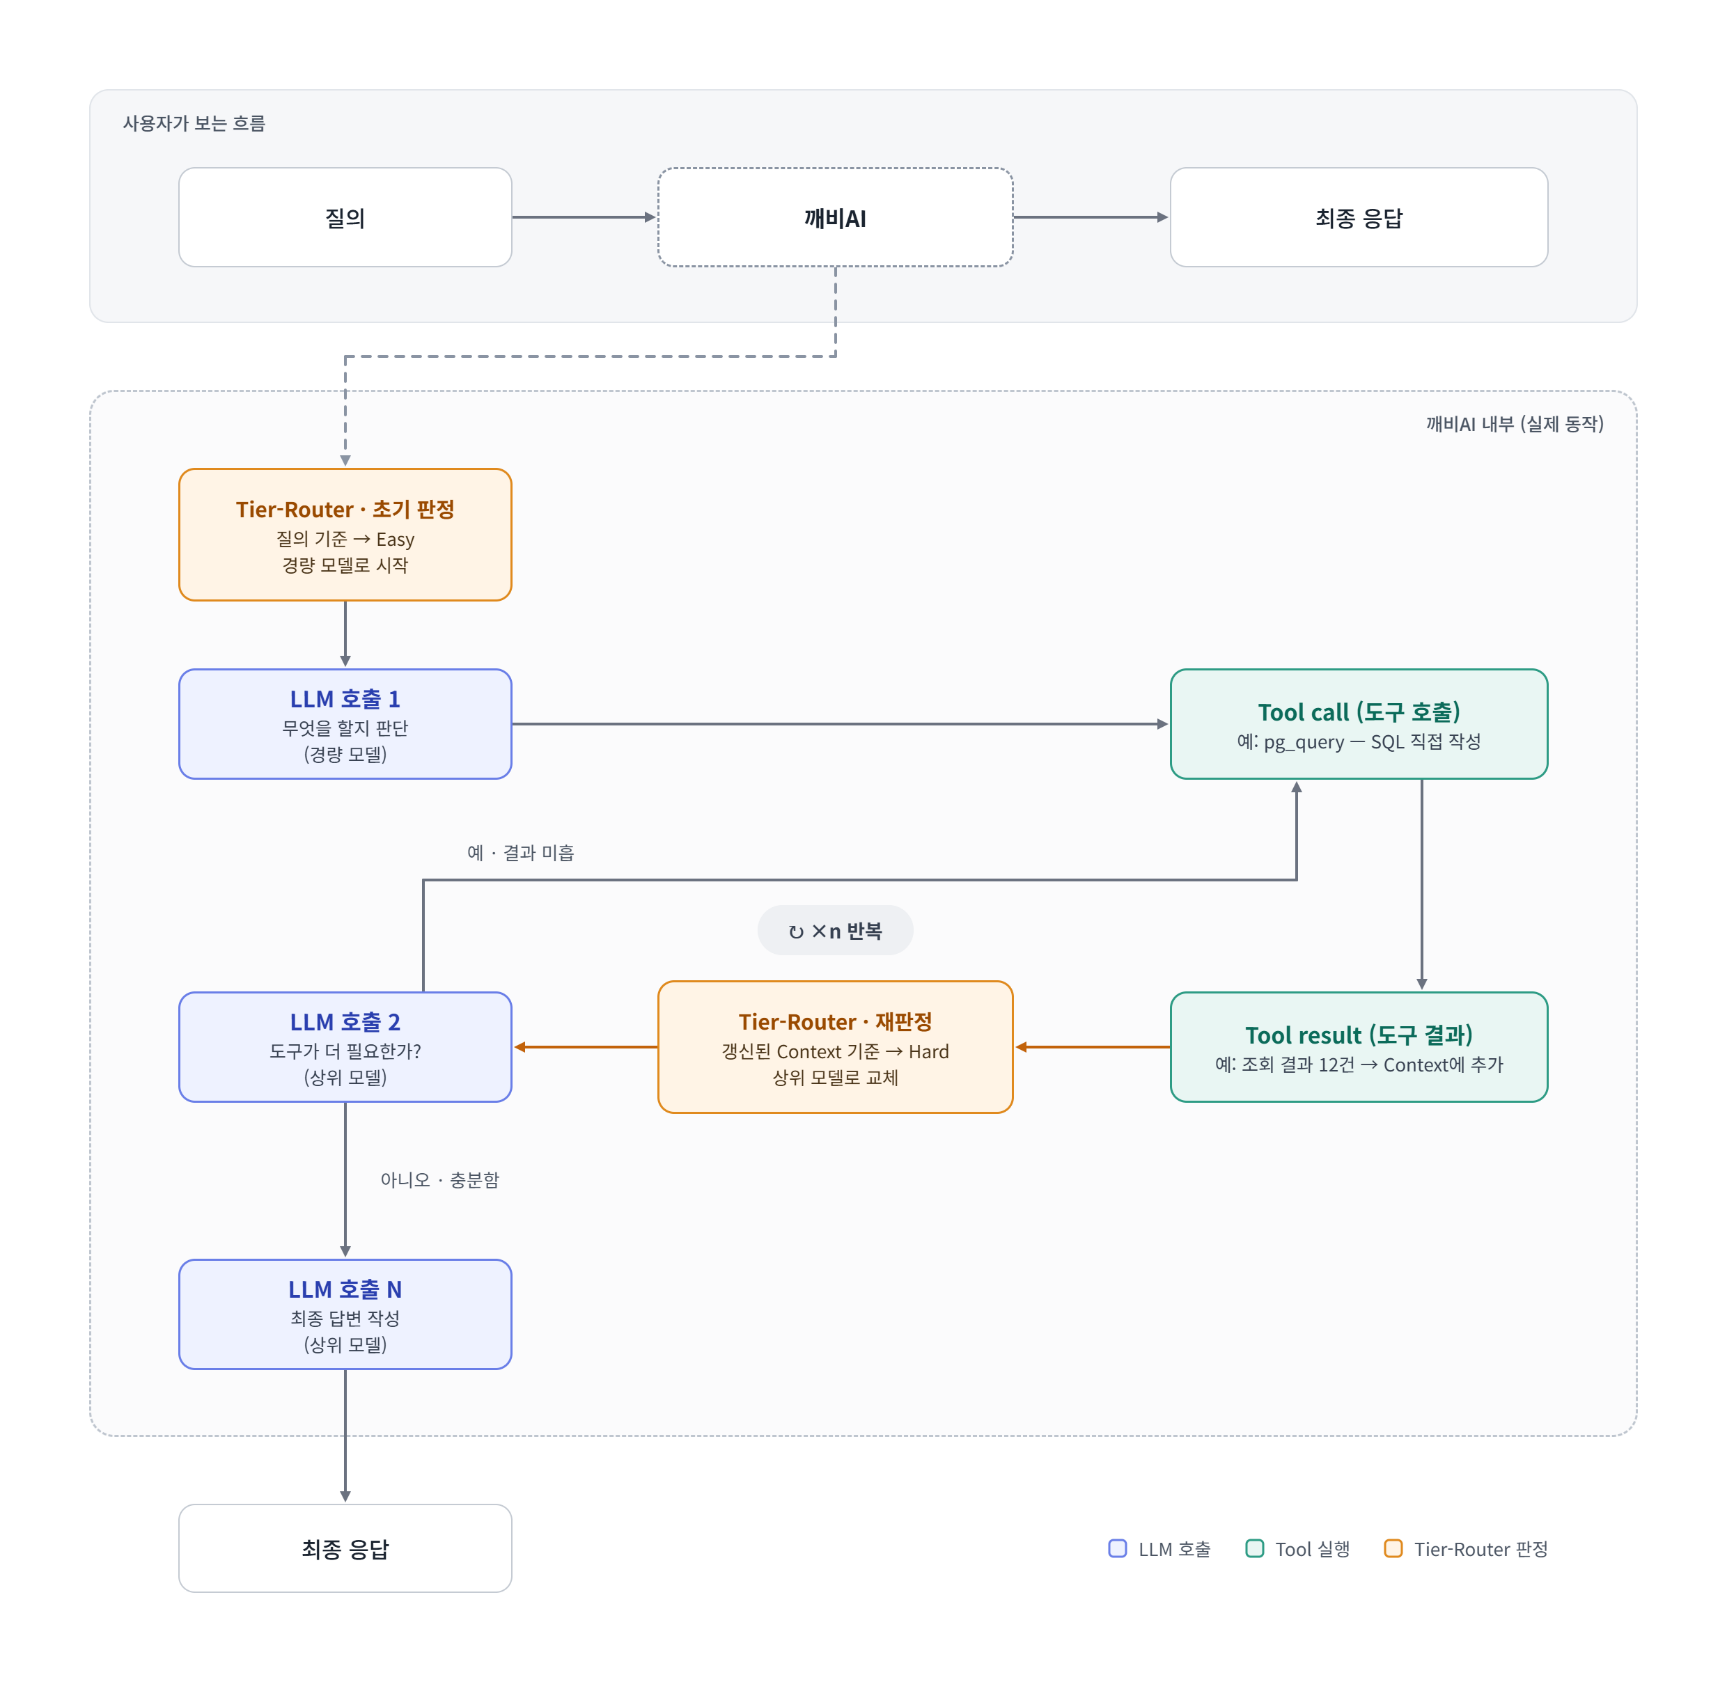
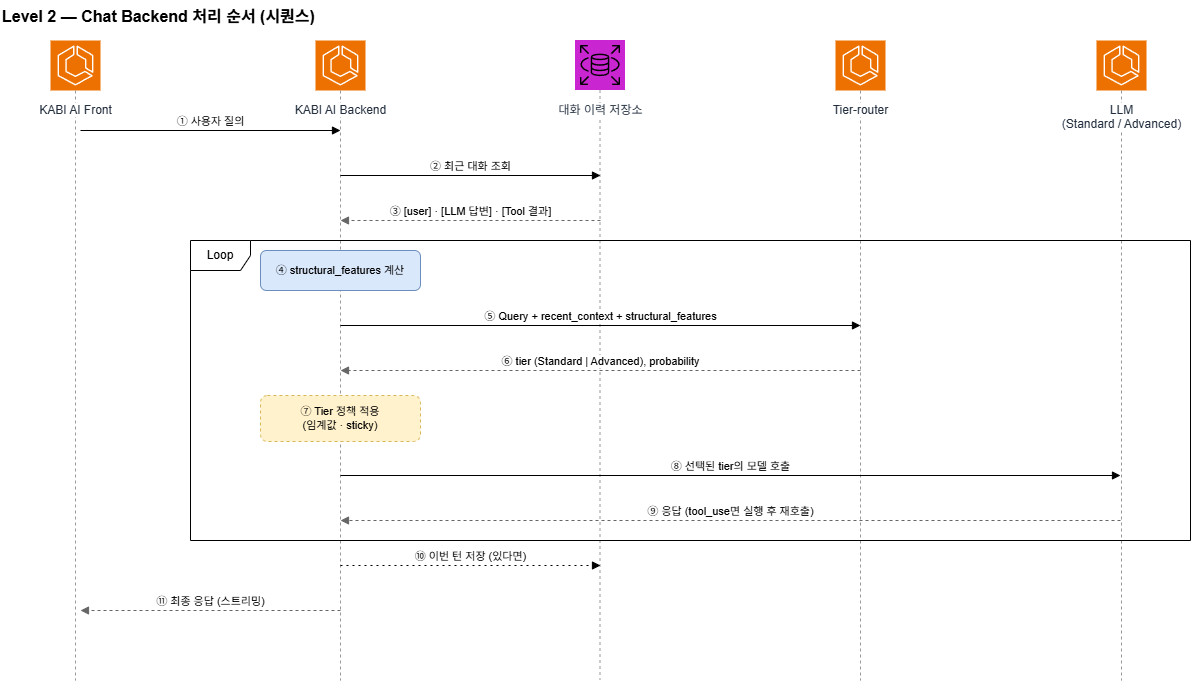
<그림 2. 하나의 질의에서 여러 번 일어나는 LLM 호출과 호출 시점별 Tier-Routing 재판정 흐름>
따라서 최초 사용자 질의만으로 전체 Agent Run의 난이도를 결정하는 대신, 각 LLM 호출 시점의 대화 맥락과 에이전트 실행 상태를 함께 고려하도록 라우팅 방식을 확장했습니다.
| 구분 | Feature | 설명 |
|---|---|---|
| 현재 요청 | current_user_query | 현재 사용자의 질의 내용 |
| 대화 맥락 | recent_context | 현재 LLM 호출 직전까지의 대화, Tool Call 및 Tool Result |
| 실행 상태 | tool_roundtrip_depth | Tool 호출 → 결과 반환이 몇 차례 반복되었는지 |
| turn_tool_call_count_before | 현재 시점까지 해당 Turn에서 호출된 Tool의 누적 개수 | |
| latest_tool_result_count | 직전 단계에서 반환된 Tool Result 개수 | |
| latest_tool_result_char_length | 직전 Tool Result의 전체 데이터 길이 |
<표 4. 라우터 입력으로 사용한 현재 요청·대화 맥락·실행 상태 Feature>
실행 상태 Feature는 앞서 본 Tool 난이도 차이를 담기 위한 것입니다. SQL 조회처럼 탐색과 재시도가 이어지는 작업은 tool_roundtrip_depth와 turn_tool_call_count_before에, 한 줄부터 수천 행까지 들쭉날쭉한 결과 크기는 latest_tool_result_char_length에 드러납니다. 사용자 질문만으로는 알 수 없던, 지금 이 호출이 처리해야 할 일의 무게를 라우터가 볼 수 있게 됩니다.
표에서 정의한 Feature는 라우터를 호출하는 시점에 그대로 요청 payload로 구성됩니다.
최초 사용자 질의만 전달하는 대신, 현재 질의와 최근 대화 맥락, Tool 사용 횟수와 결과의 크기 등을 함께 라우터에 전달하도록 요청 구조를 확장했습니다.
Tool 실행 이후 다시 판단하기
이 요청 구조는 첫 번째 LLM 호출 전에 한 번만 사용되는 것이 아닙니다. 첫 호출 전에도 라우팅을 수행하고, 이후 Tool 실행으로 새로운 정보가 Context에 추가될 때마다 현재 Context를 바탕으로 다음 호출에 사용할 모델을 다시 결정하도록 구성했습니다.
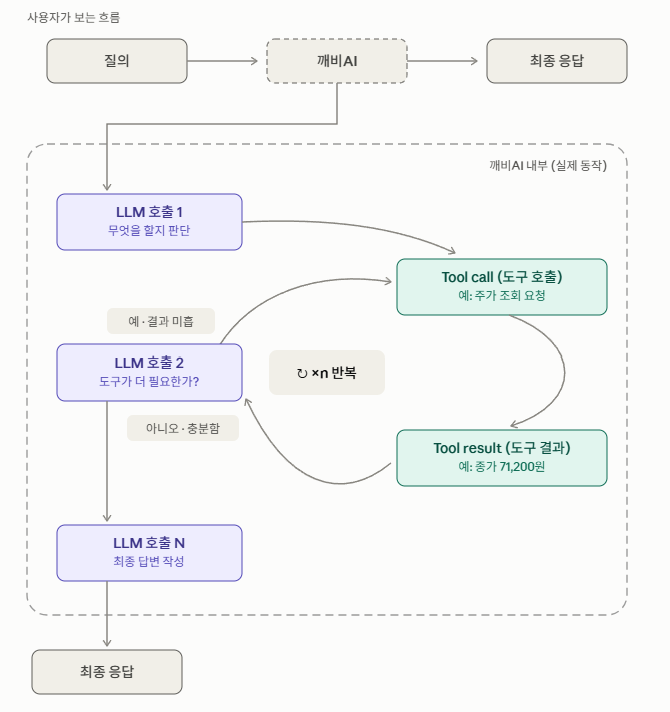
<그림 3. 사용자에게는 한 번의 응답이지만 내부적으로 N회의 LLM 호출이 일어나는 구조>
실제 구현에서는 Tool 실행이 끝나고 다음 Turn을 준비하는 시점에 라우터를 다시 호출합니다.
라우터 호출이 실패하면 직전 모델을 그대로 유지하는 fail-open 방식을 적용하여, 라우팅 장애가 깨비AI 실행을 중단시키지 않도록 했습니다.
학습한 분류기는 Amazon ECS 위에 별도의 추론 서버로 배포하여, 에이전트가 매 LLM 호출 직전에 호출할 수 있도록 했습니다.
이슈. 라우터는 맞았지만 비용은 나빠졌다
테스트 환경에 Tier-Routing을 적용하자 예상하지 못한 결과가 나왔습니다. 같은 Agent Run 안에서 라우터가 ADVANCED를 예측한 뒤 다시 STANDARD를 예측하는 구간이 생겼고, 그때마다 모델이 하향 전환되면서 Prompt Cache가 무효화되었습니다. 난이도 예측 자체는 타당했지만, 그 예측을 그대로 모델 전환에 연결한 탓에 비용과 응답 시간이 오히려 나빠지는 구간이 발생한 것입니다.
질문 3. 예측 결과를 그대로 쓰지 않기 (Elevate-only)
라우터의 예측은 각 LLM 호출 시점마다 독립적으로 이루어지기 때문에, 같은 Agent Run 안에서도 STANDARD → ADVANCED → STANDARD와 같이 결과가 오르내릴 수 있습니다. 각 시점의 예측 결과를 그대로 모델 변경으로 연결하면 Standard와 Advanced 모델 사이를 반복적으로 오가게 됩니다.
이를 방지하기 위해, Agent Run에서 한 번 상위 Tier로 전환된 이후에는 다시 하위 Tier로 내려가지 않는 Elevate-only Policy를 적용했습니다.
핵심은 rank >= currentRank 한 줄입니다. 이 조건 때문에 라우터의 예측이 STANDARD → ADVANCED → STANDARD로 나오더라도 실제 사용 모델은 STANDARD → ADVANCED → ADVANCED로 유지됩니다. Tier 값을 하드코딩하지 않고 설정된 tierRank 순서로 비교하기 때문에, Tier 구성이 바뀌어도 정책은 동일하게 동작합니다.
이를 통해 응답 품질의 일관성을 유지하면서 불필요한 모델 전환을 줄이고, 동일 모델을 연속적으로 사용할 가능성을 높여 Prompt Cache 활용에도 유리하도록 설계했습니다. 깨비AI는 반복되는 System Prompt의 고정 영역에 Prompt Cache를 적용하고 있기 때문에, 모델이 유지될수록 Cache Read의 이점을 그대로 가져갈 수 있습니다.
또한 한 번 올라간 모델은 같은 세션이 끝날 때까지 유지되어 캐시 낭비를 최소화하였습니다.
구현
솔루션 아키텍처
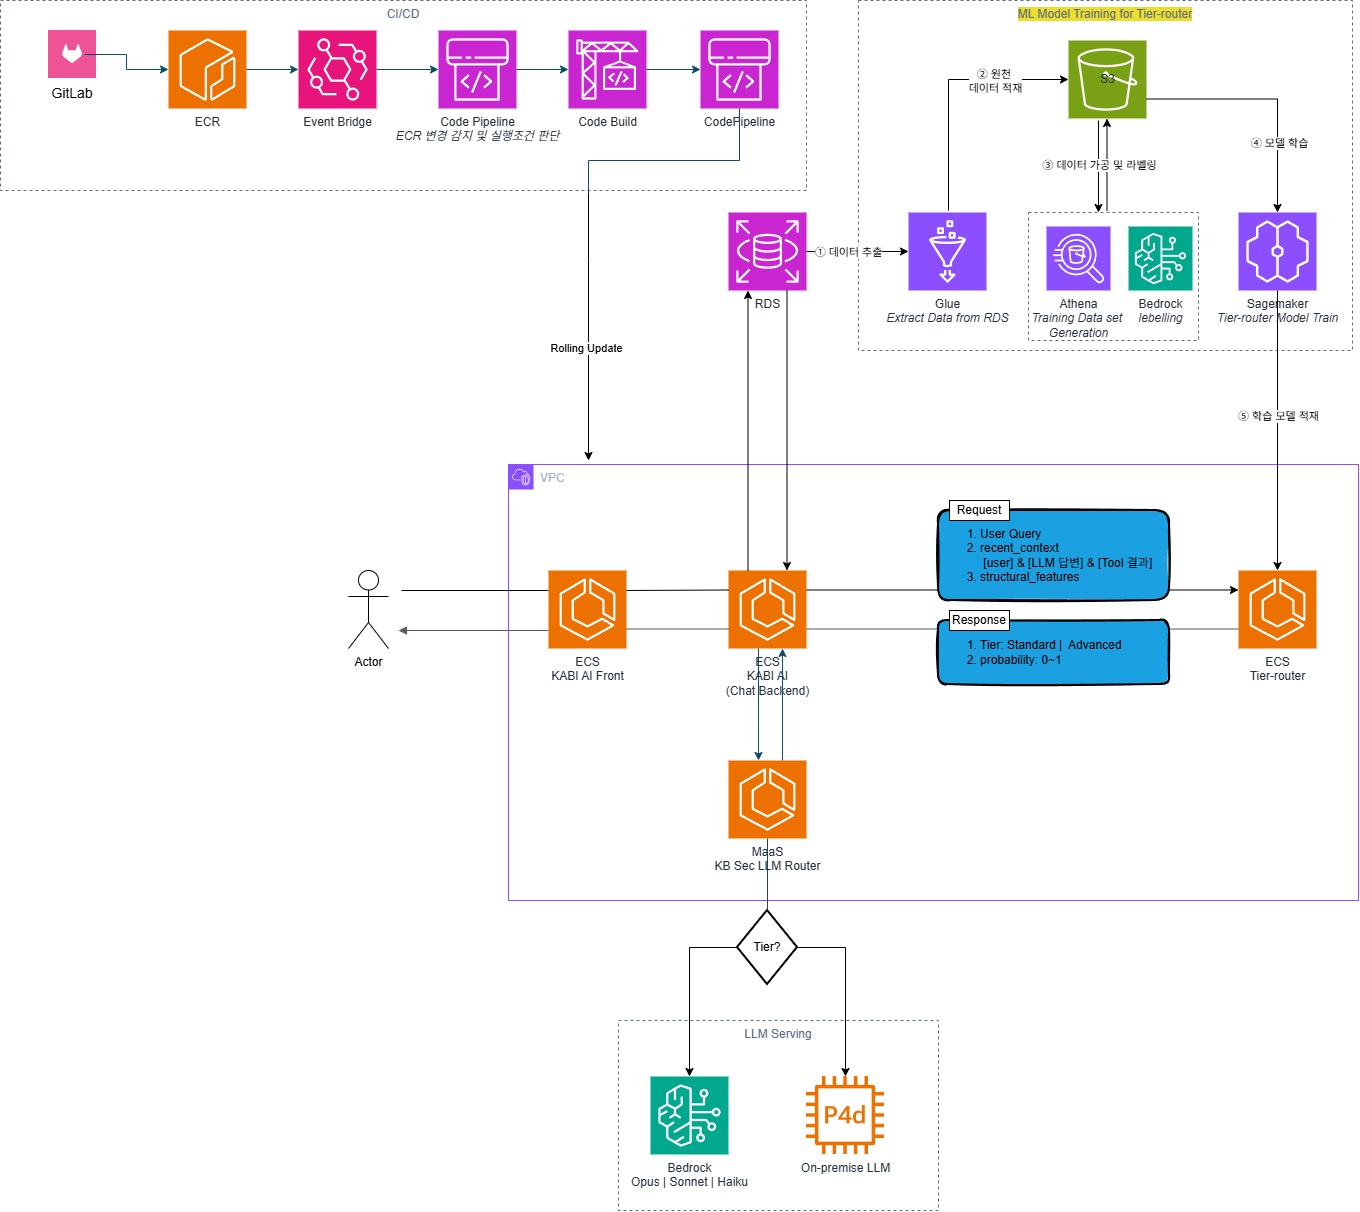
<그림 4. 멀티턴 Context Tier-Routing 솔루션 아키텍처>
설계한 멀티턴 Context Tier-Routing을 실제 분류 모델로 구현하기 위해 Amazon SageMaker AI 환경에서 1. 원본 로그로부터 라우팅 시점별 Feature 추출 → 2. 텍스트 임베딩과 구조적 Feature 결합 → 3. XGBoost 분류기 학습 및 평가의 과정을 수행했습니다. 학습 데이터와 산출물은 Amazon S3를 통해 단계별로 전달했습니다.
여기서 학습 대상은 단순한 사용자 질의 한 건이 아닙니다. 에이전트 실행 중 다음 assistant 응답을 생성하기 직전의 라우팅 판단 시점을 하나의 학습 샘플로 구성했습니다.
라우팅 판단 시점별 Feature 추출
먼저 원본 에이전트 로그를 모델 입력에 사용할 수 있도록 변환했습니다. extract_routing_features(records) 함수는 로그를 session_id별로 묶고, seq 순으로 정렬한 다음 assistant 메시지를 순회합니다. 각 assistant 메시지 직전을 라우팅 판단 시점으로 간주하고, 그 시점까지 확인할 수 있는 정보만 추출합니다.
직전 메시지가 사용자 발화이면 USER, Tool 실행 결과이면 TOOL_RESULT로 구분해 맥락을 구성합니다. 이렇게 하면 최초 사용자 요청뿐 아니라 Tool 실행 후 이어지는 LLM 호출도 별도의 라우팅 샘플로 표현할 수 있습니다.
각 라우팅 샘플은 current_user_query, recent_context, 그리고 에이전트 실행 상태를 표현하는 structural_features로 구성됩니다.
핵심은 Feature를 결정론적으로 추출하는 단계와 라우팅 정답 레이블을 부여하는 단계를 구분했다는 점입니다. 이 함수는 라우팅 시점의 관찰 가능한 정보만 생성하며, STANDARD 또는 ADVANCED 정답을 만들어 내지는 않습니다. 다음 단계에서는 별도로 준비된 레이블이 포함된 학습용 데이터를 사용했습니다.
Query와 Context를 각각 임베딩
사용자 질의와 최근 대화 맥락은 텍스트이므로 트리 기반 분류 모델에 바로 입력할 수 없습니다. 이를 수치 벡터로 변환하기 위해 intfloat/e5-large 임베딩 모델을 사용했습니다.
질의와 맥락은 역할이 다르기 때문에 하나의 문자열로 합치지 않고 각각 임베딩했습니다. 구현 코드에서는 사용자 질의에 query: 접두어를, 최근 맥락에 passage: 접두어를 적용했습니다.
학습 입력으로 사용한 벡터의 구성은 다음과 같습니다.
| Feature 그룹 | 차원 | 구성 |
|---|---|---|
| Query Embedding | 1,024 | 현재 사용자 질의 |
| Context Embedding | 1,024 | 최근 대화 및 도구 실행 맥락 |
| Structural Features | 4 | Tool 왕복·호출 횟수 및 최근 결과 정보 |
| 전체 | 2,052 | 각 샘플에 대한 모델 입력 벡터 |
<표 5. XGBoost 분류기 학습에 사용한 입력 벡터 구성>
Feature 추출 함수에는 attachment_count도 존재하지만, 이번 학습용 임베딩 생성 코드에서는 앞의 구조적 Feature 4개만 결합했습니다. 따라서 실제 XGBoost 입력 차원은 2,052차원입니다.
생성된 Feature 행렬과 STANDARD=0, ADVANCED=1 레이블은 NumPy NPZ 형식으로 저장하고 Amazon S3에 업로드했습니다. 임베딩 모델명, 샘플 수, Feature 구성 등도 별도 메타데이터로 저장하여 학습 과정에서 사용한 입력 구성을 추적할 수 있도록 했습니다.
XGBoost 기반 Tier 분류기 학습
다음으로 Amazon S3에 저장한 NPZ 파일에서 Feature 행렬 X와 정답 y를 불러와 XGBoost 이진 분류기를 학습했습니다.
라벨 분포를 유지하기 위해 stratify=y 옵션을 사용해 학습 데이터 80%, 평가 데이터 20%로 무작위 분할했습니다.
분류기는 입력 Feature를 바탕으로 ADVANCED 클래스의 확률을 예측합니다.
또한 feature_importances_를 이용해 중요도를 추출하고, Query Embedding(앞의 1,024차원), Context Embedding(다음 1,024차원), Structural Features(마지막 4차원)의 중요도 합계를 비교하도록 구현했습니다. 이는 라우팅 판단이 어떤 입력 그룹에 상대적으로 더 의존하는지 살펴보기 위한 분석입니다.
학습된 XGBoost 모델과 Feature 이름은 tier_routing_xgb_model.pkl 파일로 저장하고, 학습 설정 및 평가 지표는 JSON 메타데이터로 별도 저장했습니다. 두 산출물은 Amazon S3에 업로드하여 추론 서버에서 사용할 수 있도록 준비했습니다.
학습 결과와 실제 서비스의 연결
이 과정을 거쳐 완성된 모델은 현재 질의 임베딩 + 최근 맥락 임베딩 + 구조적 Feature를 입력으로 받아 STANDARD 또는 ADVANCED에 대한 예측을 생성하는 분류기입니다.
서비스 호출 시에도 학습과 동일한 임베딩 모델, 접두어, 텍스트 직렬화 방식, Feature 순서를 적용해야 합니다. 앞서 설명한 에이전트 실행 로직은 이 예측을 입력받아 임계값과 Elevate-only 정책을 적용하고, 최종적으로 사용할 LLM을 결정합니다.
즉 Amazon SageMaker AI에서 수행한 학습 파이프라인은 작업 복잡도를 예측하는 모델을 만드는 단계이고, 실제 모델 전환을 결정하는 Routing Policy는 별도의 실행 단계입니다. 두 책임을 분리함으로써 분류 모델의 개선과 서비스 운영 정책의 변경을 독립적으로 관리할 수 있도록 설계했습니다.
Tier 분류기 성능 평가
학습된 분류기의 성능을 확인하기 위해, 전체 라우팅 샘플 약 6,900건 중 20%인 1,383건(STANDARD 659건, ADVANCED 724건)을 평가 데이터로 사용했습니다.
| 평가지표 | 결과 |
|---|---|
| Accuracy | 85.83% |
| ROC-AUC | 0.9440 |
| PR-AUC | 0.9555 |
<표 6. Tier 분류기 성능 평가 결과 (평가 데이터 1,383건)>
- ROC-AUC는 분류기가 ADVANCED 샘플에 STANDARD 샘플보다 높은 확률을 매길 가능성을 나타냅니다.
- PR-AUC는 ADVANCED를 빠짐없이 찾으면서도 오판을 얼마나 적게 하는지를 나타냅니다. 두 지표 모두 특정 임계값에 의존하지 않아, 운영 중 임계값을 조정하는 깨비AI의 라우터 성능을 평가하는 데 적합합니다.
분류기는 현재 질의, 대화 맥락, Tool 실행 상태만으로 STANDARD와 ADVANCED를 85.83%의 정확도로 구분했고, ROC-AUC 0.944, PR-AUC 0.956을 기록했습니다.
다만 분류기가 레이블을 잘 맞힌다고 해서 실제 서비스의 응답 품질이 보장되는 것은 아닙니다. 그래서 분류 성능과 별개로, 실제 에이전트에 Tier-Routing을 적용했을 때의 응답 품질, 비용, 응답 시간을 비교해 서비스 관점의 효과를 검증했습니다.
성과
요약: 평균 품질 점수 85.6 → 85.2 (-0.4점) · 전체 토큰 35.9% 감소 · Sonnet 처리 케이스 52% 감소 · 클라우드 API 비용 15.8% 감소
Tier-Routing의 목표는 상위 모델 호출을 줄이는 것 자체가 아닙니다. 응답 품질을 가능한 한 유지하면서 비용과 응답 시간을 줄이는 것입니다. 이를 확인하기 위해 같은 테스트셋을 두 가지 구성으로 실행해 비교했습니다.
Tier-Routing 구성에서 STANDARD Tier에는 KB증권이 자체 GPU 인프라에서 서빙하는 gemma4-31B-it 모델을, ADVANCED Tier에는 Amazon Bedrock의 Claude Sonnet 4.6을 사용했습니다.
평가 환경
| 항목 | 내용 |
|---|---|
| 테스트 케이스 | 340건 (Easy 154 / Medium 67 / Hard 119) |
| Baseline | 모든 호출을 Claude Sonnet 4.6으로 처리 |
| Tier-Routing | STANDARD는 자체 서빙 경량 모델(gemma4-31B-it), ADVANCED는 Claude Sonnet 4.6 (실제 운영 구성과 동일) |
| 품질 평가 | LLM-as-Judge (Claude Opus 4.8), 7개 지표 |
| 평가 입력 | 사용자 질의, Tool 호출 내역(입력·출력·오류 여부), 최종 답변 |
| 비교 항목 | 품질, 토큰 사용량, API 비용, E2E 응답 시간 |
<표 7. Baseline과 Tier-Routing 비교를 위한 평가 환경>
Easy, Medium, Hard는 결과를 나눠 보려고 테스트 케이스마다 미리 붙여 둔 평가용 레이블입니다. 라우터는 이 레이블을 모른 채, 매 LLM 호출에서 STANDARD와 ADVANCED 중 하나를 고릅니다.
적용 결과
| 지표 | Baseline | Tier-Routing | 변화 |
|---|---|---|---|
| 평균 품질 점수 | 85.6점 | 85.2점 | -0.4점 |
| 평균 응답 시간 (E2E) | 22.8초 | 17.1초 | -5.7초 (-25.0%) |
| 전체 토큰 사용량 | 122,667,977 | 78,673,416 | -35.9% |
| Sonnet 처리 케이스 | 340건 (100%) | 163건 (48%) | -52% |
| API 비용 (Sonnet 4.6 단가 기준) | $80.72 | $67.96 | -15.8% |
<표 8. Tier-Routing 적용 전후 품질·응답 시간·토큰·비용 비교>
전체 340건 중 177건을 gemma4-31B-it가 처리했습니다. 평균 품질 점수는 0.4점 낮아졌고, 토큰 사용량은 35.9% 줄었습니다.
지표별로 보면 하락과 상승이 섞여 있습니다.
| 지표 | 의미 | Baseline | Tier-Routing | 차이 |
|---|---|---|---|---|
| routing | 올바른 스킬/도구 선택 | 89.4 | 87.2 | -2.2 |
| toolArgs | 인자 정확성 (종목/기간/SQL) | 89.2 | 88.7 | -0.5 |
| grounding | 도구 출력 수치 전사 충실도 | 83.9 | 84.5 | +0.6 |
| completeness | 질문 충족도 | 79.7 | 77.5 | -2.2 |
| conciseness | 불필요한 장황함이 없음 | 84.1 | 86.2 | +2.1 |
| clarity | 전달 명확성 | 89.6 | 89.5 | -0.1 |
| honesty | 환각(없는 사실 단정)과 회피(게으른 포기) 감점 | 83.6 | 83.1 | -0.5 |
| 평균 | 85.6 | 85.2 | -0.4 |
<표 9. 품질 평가 7개 지표별 점수 변화>
금융 업무에서 가장 민감한 두 지표는 전체 기준으로 큰 변화가 없었습니다. 도구 출력을 답변에 옮기는 정확도(grounding)는 오히려 올랐고, 없는 사실을 단정하거나 답을 회피하는 정도(honesty)도 비슷했습니다.
하락한 routing과 completeness는 모두 “필요한 도구를 끝까지 써서 요청을 채웠는가”에 해당합니다. 경량 모델이 사실을 지어냈다기보다, 도구를 더 써야 할 자리에서 멈춘 경우가 손실의 주된 원인으로 보입니다.
토큰이 36% 줄었는데 비용은 16%만 줄어든 이유는 프롬프트 캐시입니다.
| 비용항목 | Baseline | Tier-Routing | 차이 |
|---|---|---|---|
| Cache Read | $33.72 | $18.48 | -$15.24 |
| Cache Write | $35.60 | $30.12 | -$5.48 |
| Output | $11.39 | $8.42 | -$2.97 |
| Input | $0.01 | $10.95 | +$10.94 |
| 합계 | $80.72 | $67.96 | -$12.76(-15.8%) |
<표 10. 비용 항목별 Baseline과 Tier-Routing 비교>
Baseline은 캐시 적중률이 92%에 달해, 정가로 처리된 입력이 340건 전체에서 2,199토큰에 그쳤습니다. 반면 Tier-Routing에서는 캐시 없이 정가로 처리된 입력 토큰이 2,199개에서 약 365만 개로 늘었습니다.
즉 줄어든 토큰의 상당수는 원래도 저렴했던 캐시 토큰이었고, 모델이 바뀌는 지점에서는 캐시를 새로 만드는 비용이 생겼습니다. 질문 3.에서 모델 전환을 최소화하는 정책을 둔 이유가 숫자로 드러나는 대목입니다.
※ 비용은 Anthropic Claude Sonnet의 Amazon Bedrock 요금(2026년 10월 기준) 토큰 단가를 기준으로 한 추정치입니다. gemma4-31B-it의 GPU 비용과 라우터 운영 비용은 포함하지 않았습니다.
난이도별 분석
| 구간 | 품질 (Baseline → 적용) | 처리 모델 (케이스 기준) | E2E 응답 시간 (Baseline → 적용) |
|---|---|---|---|
| Easy (154건) | 88.2 → 88.5 (+0.3) | gemma4-31B-it 67% / Sonnet 33% | 8.9초 → 10.0초 (+1.1초) |
| Medium (67건) | 84.6 → 86.1 (+1.5) | gemma4-31B-it 51% / Sonnet 49% | 29.2초 → 20.8초 (-8.4초) |
| Hard (119건) | 83.4 → 81.1 (-2.3) | gemma4-31B-it 34% / Sonnet 66% | 40.3초 → 38.7초 (-1.6초) |
<표 11. 난이도 구간별 품질·처리 모델·응답 시간 비교>
Medium은 gemma4-31B-it가 절반을 처리했는데도 품질 점수가 1.5점 올랐고, 응답 시간은 8.4초(29%) 줄었습니다. 모든 요청을 상위 모델로 처리하는 것이 항상 최선은 아니라는 근거입니다. 토큰 절감률도 Medium이 42.1%로 가장 높았습니다(Easy 37.6%, Hard 32.1%).
Easy는 응답 시간이 1.1초 늘었습니다. 원래 짧은 요청이라 라우터 호출에 드는 시간이 상대적으로 크게 드러난 것으로 보입니다.
한계: Hard 구간
Hard 구간의 품질 점수는 2.3점 떨어졌습니다. 지표별로는 completeness(-5.6)와 routing(-4.5)의 하락이 컸고, 전체 기준으로는 유지됐던 grounding(-2.1)과 honesty(-2.0)도 이 구간에서는 낮아졌습니다.
원인을 보기 위해, Hard 케이스 중 라우터가 STANDARD로 판단해 gemma4-31B-it가 처리한 41건만 떼어 보았습니다.
- 이 41건의 평균 점수는 Baseline 86.6점에서 82.2점으로 4.4점 낮았습니다.
- 22건(54%)은 2점 넘게 하락했고, 4건은 비슷했으며, 14건(34%)은 2점 넘게 상승했습니다.
- 하락 폭(최대 -31점)이 상승 폭(최대 +27점)보다 컸습니다.
하락 폭이 큰 사례에는 두 가지 공통점이 있었습니다.
- 문장은 짧지만 이전 대화나 사용자 데이터를 이어서 처리해야 하는 요청 (예: “조금 전에 같이 본 거래 내역에서…”)
- 근거를 갖춘 판단이 필요한 투자 관련 질문
반대로 점수가 오른 사례는 대부분 필요한 문서나 조건이 질의 안에 모두 주어진 요청이었습니다.
평가 레이블과 다른 모델이 선택됐다는 사실만으로 라우터가 틀렸다고 단정할 수는 없습니다. 레이블 자체가 모델별 실제 품질 차이와 정확히 일치하는 것은 아니기 때문입니다. 다만 겉보기에는 짧고 단순하지만 실제로는 무거운 작업이 경량 모델로 내려가는 영역이 있다는 점은 분명합니다.
이를 줄이기 위해 다음 세 가지를 검토하고 있습니다.
- ADVANCED 판정 임계값 재조정
- 이전 맥락을 참조하는 요청의 신호를 라우터 입력에 강화
- 라우터 판정과 평가 레이블 간 일치율, 난이도별 품질 추이를 운영 지표로 추적
마치며
에이전틱 AI에서 최적의 모델을 선택하는 것은 단순히 사용자 질문의 난이도를 분류하는 문제가 아니었습니다.
처음에는 사용자 질의를 Easy, Medium, Hard로 구분하고 난이도별로 모델을 배정했습니다. 그러나 실제 에이전트 실행에서는 짧은 질문이 이전 대화에 따라 복잡한 작업으로 이어지기도 했고, 하나의 요청을 처리하는 동안에도 LLM이 수행해야 하는 작업의 복잡도가 계속 달라졌습니다.
그래서 KB증권은 라우팅의 단위를 사용자 질의에서 LLM 호출로 바꿨습니다. 현재 질의뿐 아니라 최근 대화 맥락과 Tool 실행 상태를 함께 보고, 한 번 상위 모델로 올라간 뒤에는 다시 내려가지 않는 Elevate-only 정책으로 모델 전환에 따른 Prompt Cache 손실을 줄였습니다.
이 과정에서 얻은 가장 큰 교훈은, 더 저렴한 모델을 고르는 것보다 모델을 덜 바꾸는 것이 중요할 때가 있다는 점입니다. 캐시를 고려하지 않은 라우팅은 개별 호출을 싸게 만들어도 전체 비용을 줄이지 못할 수 있습니다.
평가에서는 평균 품질 점수 차이를 0.4점 이내로 유지하면서 토큰 사용량을 36%, 클라우드 모델 비용을 16% 줄였고, 중간 난이도 요청의 응답 시간은 29% 단축되었습니다. 다만 복잡한 작업에서는 일부 품질 저하가 관찰되었습니다. 모델을 효율적으로 배분하는 것만큼, 고성능 모델이 반드시 필요한 작업을 정확히 식별하는 것이 중요하다는 뜻입니다. 앞으로는 이 사례들을 중심으로 라우팅 기준을 개선하고, 대화 맥락과 Tool 실행 특성을 더 정교하게 반영할 계획입니다.
비슷한 라우팅을 고민하는 팀이라면 다음 세 가지부터 점검해 보기를 권합니다.
- 판단 단위: 질의가 아니라 LLM 호출 단위로 난이도를 보고 있는가
- 예측과 정책의 분리: 라우터의 예측을 그대로 모델 전환에 쓰고 있지는 않은가
- 전환 비용: 모델을 바꿀 때 잃는 캐시 비용을 계산에 넣었는가
에이전틱 AI의 활용 범위가 넓어질수록, 하나의 고성능 모델에 모든 작업을 맡기기보다 각 실행 단계에 맞는 모델을 고르고 전체 실행 과정의 효율을 관리하는 기술이 더 중요해질 것입니다.
저자 소개
KB증권
KB증권 AI디지털본부 AI Tech부 김동철 차장
KB증권 AI디지털본부에서 금융 업무를 지원하는 Agentic AI를 개발하고 있습니다. Agent가 여러 단계의 업무를 수행할 수 있도록 오케스트레이션을 개발·개선하고, 사용자의 요청을 얼마나 정확하고 안정적으로 수행하는지 평가합니다.
KB증권 AI디지털본부 AI Tech부 최윤 주임
KB증권 AI디지털본부에서 임직원 약 3,000명이 쓰는 사내 AI 에이전트 플랫폼의 LLM 인프라를 운영하고 있습니다. AWS 기반 서비스 배포와 vLLM 자체 모델 서빙을 맡고 있으며, 질의 난이도에 맞는 모델을 자동으로 고르는 LLM 라우팅 시스템을 설계·개발합니다.